在 Kubernetes 集群运维中,最让人抓狂的故障往往不是大张旗鼓的 OOMKilled,而是某种"查无实据"的慢性死亡:
节点上的核心 Pod(如 Kafka 管理工具 akhq、监控探针 node-exporter、甚至密钥挂载驱动 secrets-store-csi-driver)突然开始频繁超时,接着被 Kubelet 强制杀死,并在几个小时内陷入无休止的 CrashLoopBackOff。
按照通常的排查思路,工程师会迅速执行以下动作:
- 执行
kubectl describe pod:发现并没有OOMKilled(Last State 是Error或进程被SIGKILL,因为探针失败而非 cgroup 内存超限); - 执行
kubectl top nodes:节点内存使用率看起来只有 70% ~ 80%,远未达到 100%; - 检查节点状态(
NodeConditions):MemoryPressure依然顽强地显示为False,Kubelet 没有抛出任何节点级资源告警; - 查看系统负载:CPU 使用率并不算高,大部分核心处于等待状态。
监控指标一片岁月静好,系统既没报内存紧张,也没触发 cgroup 限制,但容器就是连一个最简单的 HTTP 健康检查都无法按时响应。
这并不是应用逻辑死锁,也不是网络抖动,而是一场由底层内核发动的、极其隐蔽的性能绞杀:Linux 主缺页中断(Major Page Fault)引发的 Page Cache 恶性抖动(Thrashing)。
一、 核心机制:次缺页与主缺页的 6 个数量级鸿沟
要理解这场绞杀,必须先回到现代操作系统管理虚拟内存的最底层基石------缺页中断(Page Fault)。
当进程试图访问某个虚拟内存地址时,CPU 的内存管理单元(MMU)会去查询页表(Page Table)。如果该虚拟地址对应的物理内存页当前并没有建立有效映射,CPU 就会暂停当前指令的执行,向操作系统内核抛出一个缺页中断异常。
缺页中断绝非罕见现象,它是虚拟内存"按需分页(Demand Paging)"的核心驱动力。在 Linux 内核中,缺页中断被严格划分为两种性质截然不同的类型:
1. 次缺页中断(Minor Page Fault)
次缺页发生时,目标物理内存页其实已经在物理内存中,只是当前进程的页表尚未建立对它的映射关系。
最典型的场景包括:
- 进程通过
fork()创建子进程时的写时复制(Copy-on-Write); - 进程通过
mmap()映射了一个共享文件,而该文件已经被其他进程读入并保存在了内核的页缓存(Page Cache)中; - 进程动态申请了堆内存(如
malloc),直到首次写入数据时才去绑定已经分配的零页(Zero Page)。
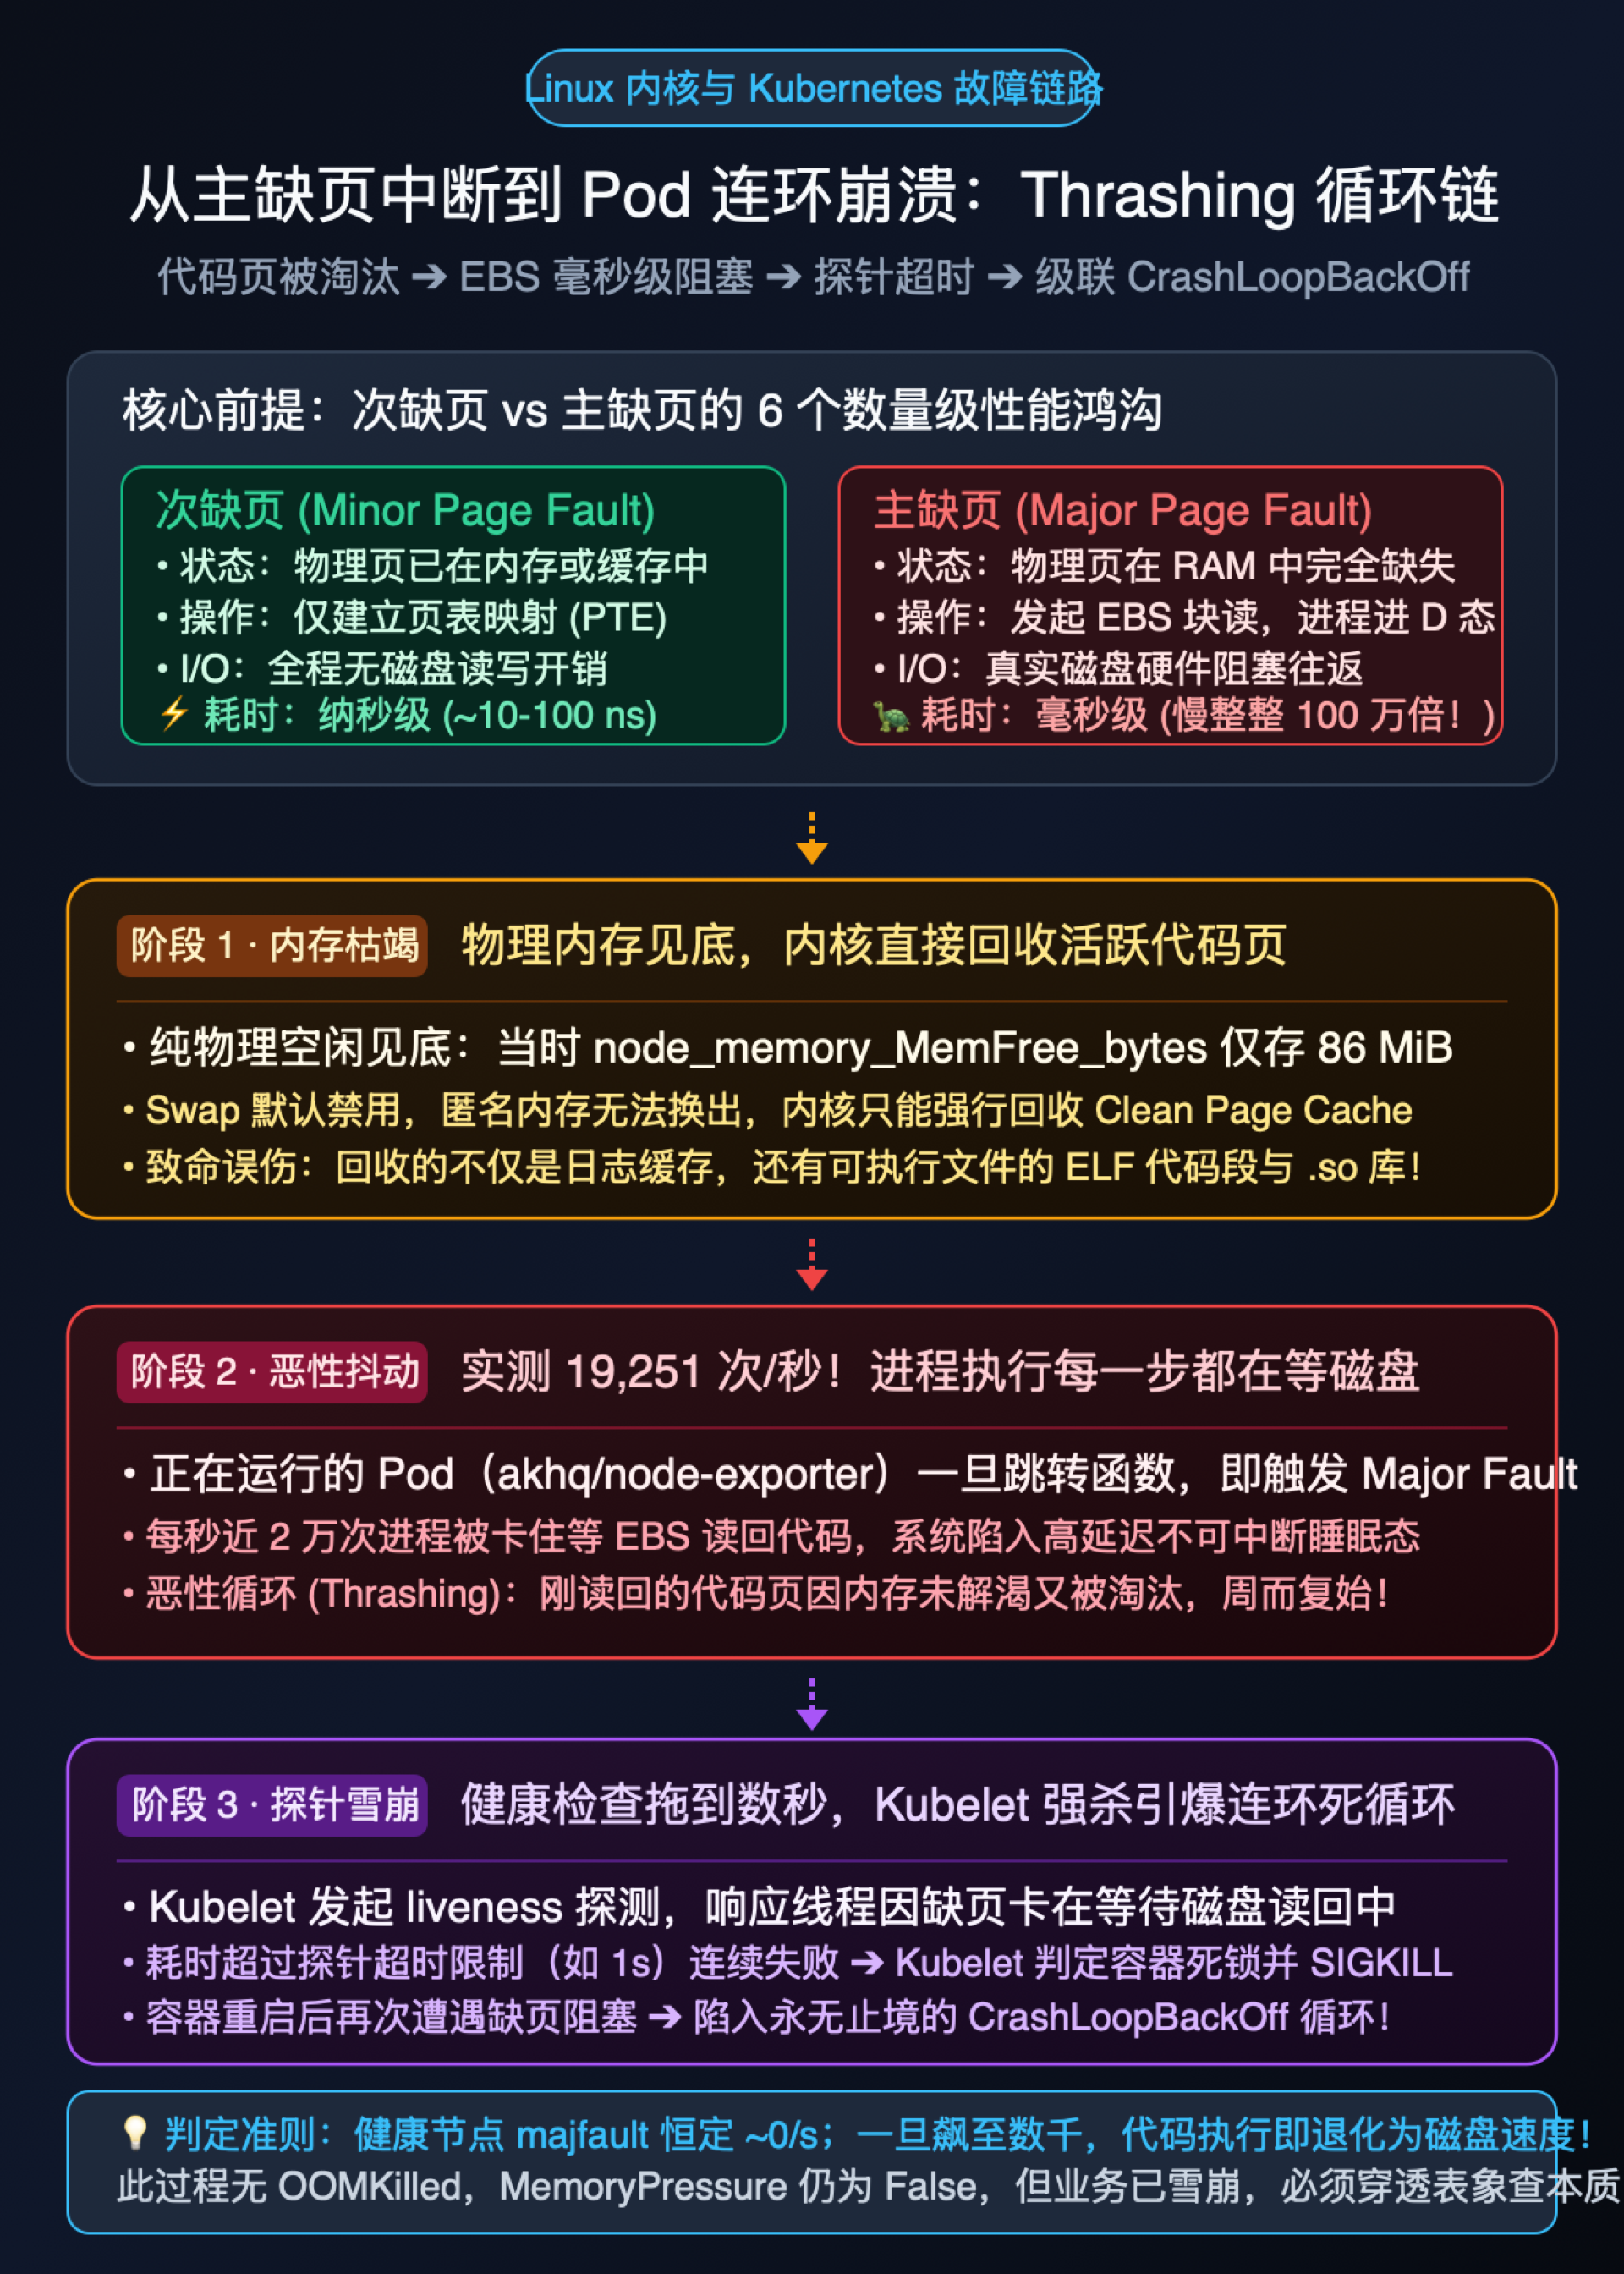
内核处理代价 :内核只需在内存中更新当前进程的页表项(PTE),全程不需要触碰任何磁盘 I/O 。这一过程通常在 10 ~ 100 纳秒(ns) 级别即可完成,对应用性能几乎完全透明。
2. 主缺页中断(Major Page Fault)
主缺页发生时,目标物理内存页在物理内存中完全不存在。
这意味着内核必须调用块设备驱动,发起真正的磁盘 I/O 请求,把那一页数据从底层持久化存储(如本地 SSD 或 AWS EBS 云盘)硬生生读回物理 RAM 中。
内核处理代价 :因为需要等待物理 I/O 完成,当前执行线程会被内核强制切出 CPU,进入不可中断睡眠状态(TASK_UNINTERRUPTIBLE,即 ps 中看到的 D 状态) 。在普通的网络块存储(如 AWS EBS)上,单次读 I/O 的延迟通常在 1 ~ 10 毫秒(ms) 左右。
关键性能鸿沟 :
从纳秒级(10⁻⁸ 秒)到毫秒级(10⁻² 秒),主缺页与次缺页的处理开销相差了整整 6 个数量级(近 1,000,000 倍)!
3. 关键认知盲区:主缺页读回的究竟是什么?
许多应用开发者直觉上认为:主缺页读回的是业务写入磁盘的文件数据(比如日志、图片或数据库文件)。
这个认知是完全错误的。
应用程序在读取业务数据时,绝大部分走的是系统调用接口(如 read(2) 或 pread(2)),这些操作由 VFS 和文件系统直接调度,并不经过 CPU MMU 的缺页中断链路。
在 Linux 系统中,真正由 CPU 缺页中断驱动并从磁盘装载的,绝大多数是通过 mmap 机制载入的文件映射页(File-backed pages):
- 应用程序自己的可执行二进制代码段(ELF .text 段);
- 运行依赖的动态链接库(.so 文件,如 glibc、libpthread、libssl);
- JVM 虚拟机的 JAR 包、类元数据以及 mmap 进来的 JIT 编译代码;
- Python、Node.js 等解释型语言的模块库与字节码文件。
在正常情况下,这些代码文件在系统冷启动时被读进 Page Cache 后,就应当一直常驻在内存中。因为代码本身是只读且反复执行的,在一台处于健康稳态的 Kubernetes 节点上,主缺页中断速率(majfault)应当基本恒定在 ~0/s。
如果这个数值飙升,意味着系统正在把执行代码本身当成磁盘数据反复倒腾。
二、 现场复盘:19,251 次/秒的崩溃循环链路
在实际的生产故障中,我们曾在 AWS EKS 的一台生产节点(实例 ID:i-0565f78a4f21a40c0)上捕捉到了一个惊人的数字:主缺页中断速率飙到了 19,251 次/秒。
这个数字背后,到底发生了什么?
1. 内存饥饿与 Clean Page Cache 的被动牺牲
现代 Kubernetes 节点为了保证 QoS 与性能可预测性,通常会在操作系统层面彻底禁用 Swap 分区。
当该节点上的 Pod 内存占用逐步爬升、物理可用内存接近枯竭时,内核的内存回收线程(kswapd)以及执行内存分配的当前进程会触发直接内存回收(Direct Reclaim)。
在没有 Swap 分区的情况下,内核无法将匿名内存(Anonymous Memory,即应用的堆、栈内存)换出到磁盘。此时,内核为了挤出几个物理页供新的内存申请使用,只剩下一个合法途径:
强行丢弃所有标为"干净(Clean)"的 Page Cache!
所谓 Clean Page Cache,就是那些内容与磁盘一致、没有发生脏写入的文件页。而应用程序的可执行代码段(ELF .text)、动态链接库(.so)恰恰全部是只读的、干净的 Clean Page Cache!
内核并不知道这段代码 1 微秒之后还要不要运行,它只知道当前内存不够了,必须把这批"无脏数据"的代码页从内存中淘汰清理出去。
2. 致命的恶性抖动(Thrashing)
悲剧就在这一瞬间拉开序幕:
- 节点上的核心 Pod(例如
node-exporter或akhq)正在正常执行业务逻辑; - 当 CPU 指令指针(PC/EIP)跳转到下一个函数、或者调用某个动态链接库方法时,MMU 突然发现这页代码刚才已经被内核回收了;
- CPU 瞬间触发 Major Page Fault,线程当即被掐断,被迫进入 D 状态等待 EBS 发起磁盘读取;
- 经过数毫秒的 EBS I/O 延迟,这页代码终于被读回了物理内存,线程被唤醒继续往下跑;
- 然而,由于全节点的物理内存依然处于极度饥饿状态,这页刚刚被读回来的代码,转头又被内核的 Direct Reclaim 顺手当成可用缓存再次淘汰掉!
刚淘汰,就得从磁盘读回;刚读回,又立刻被淘汰;淘汰、读回、再淘汰、再读回------这就是计算机体系结构中著名的"抖动(Thrashing)"。
3. 探针超时与 CrashLoopBackOff 的雪崩回路
当每秒发生近两万次主缺页时,整个节点每秒有近两万次进程被死死卡在等待 EBS 读回代码的过程中。
此时,Kubelet 会按照既定周期对容器发起 HTTP 或 TCP livenessProbe(存活探针):
- 容器的健康检查响应接口(如
/healthz)逻辑本身极其简单,正常情况下只需要 0.5 毫秒即可响应; - 但在 Kubelet 发起探测请求的那一瞬间,处理该探测请求的线程所需的代码页刚好被内核淘汰了;
- 线程停滞,在内核层面排队等待 EBS 磁盘 I/O;
- 探针原本 1 秒钟的
timeoutSeconds迅速被耗尽,探针报告超时失败; - 连续多次超时后,Kubelet 认定容器死锁或无响应,直接向容器主进程发送
SIGKILL信号将其强行杀死; - 容器被杀死后,Kubelet 立即尝试拉起新容器进行恢复。但新容器在启动阶段必须重新加载所有的二进制文件、动态库和依赖类,这在已经满负荷的 EBS 和内存上掀起了更恐怖的缺页读风暴;
- 最终,节点上的
akhq、node-exporter、secrets-store-csi-driver等组件全面陷入了探针超时的恶性死亡循环(CrashLoopBackOff)。
连监控节点健康的 node-exporter 自身都被这股 I/O 狂潮拖垮,每隔几分钟就被 Kubelet 杀死重启一次。
三、 观测迷局:为什么传统监控指标集体"装睡"?
面对如此严重的雪崩,为什么常规的监控体系没有发出哪怕一声警报?为什么 MemoryPressure 稳居 False?
这涉及监控指标在度量模型上的根本局限。
1. MemAvailable 的致命算法假设
在 Linux 内核(/proc/meminfo)的设计中,MemAvailable 是一个基于经验公式估算出来的指标,用来表示"在不引起严重系统颠簸的前提下,系统当前能提供给新进程使用的内存总量"。
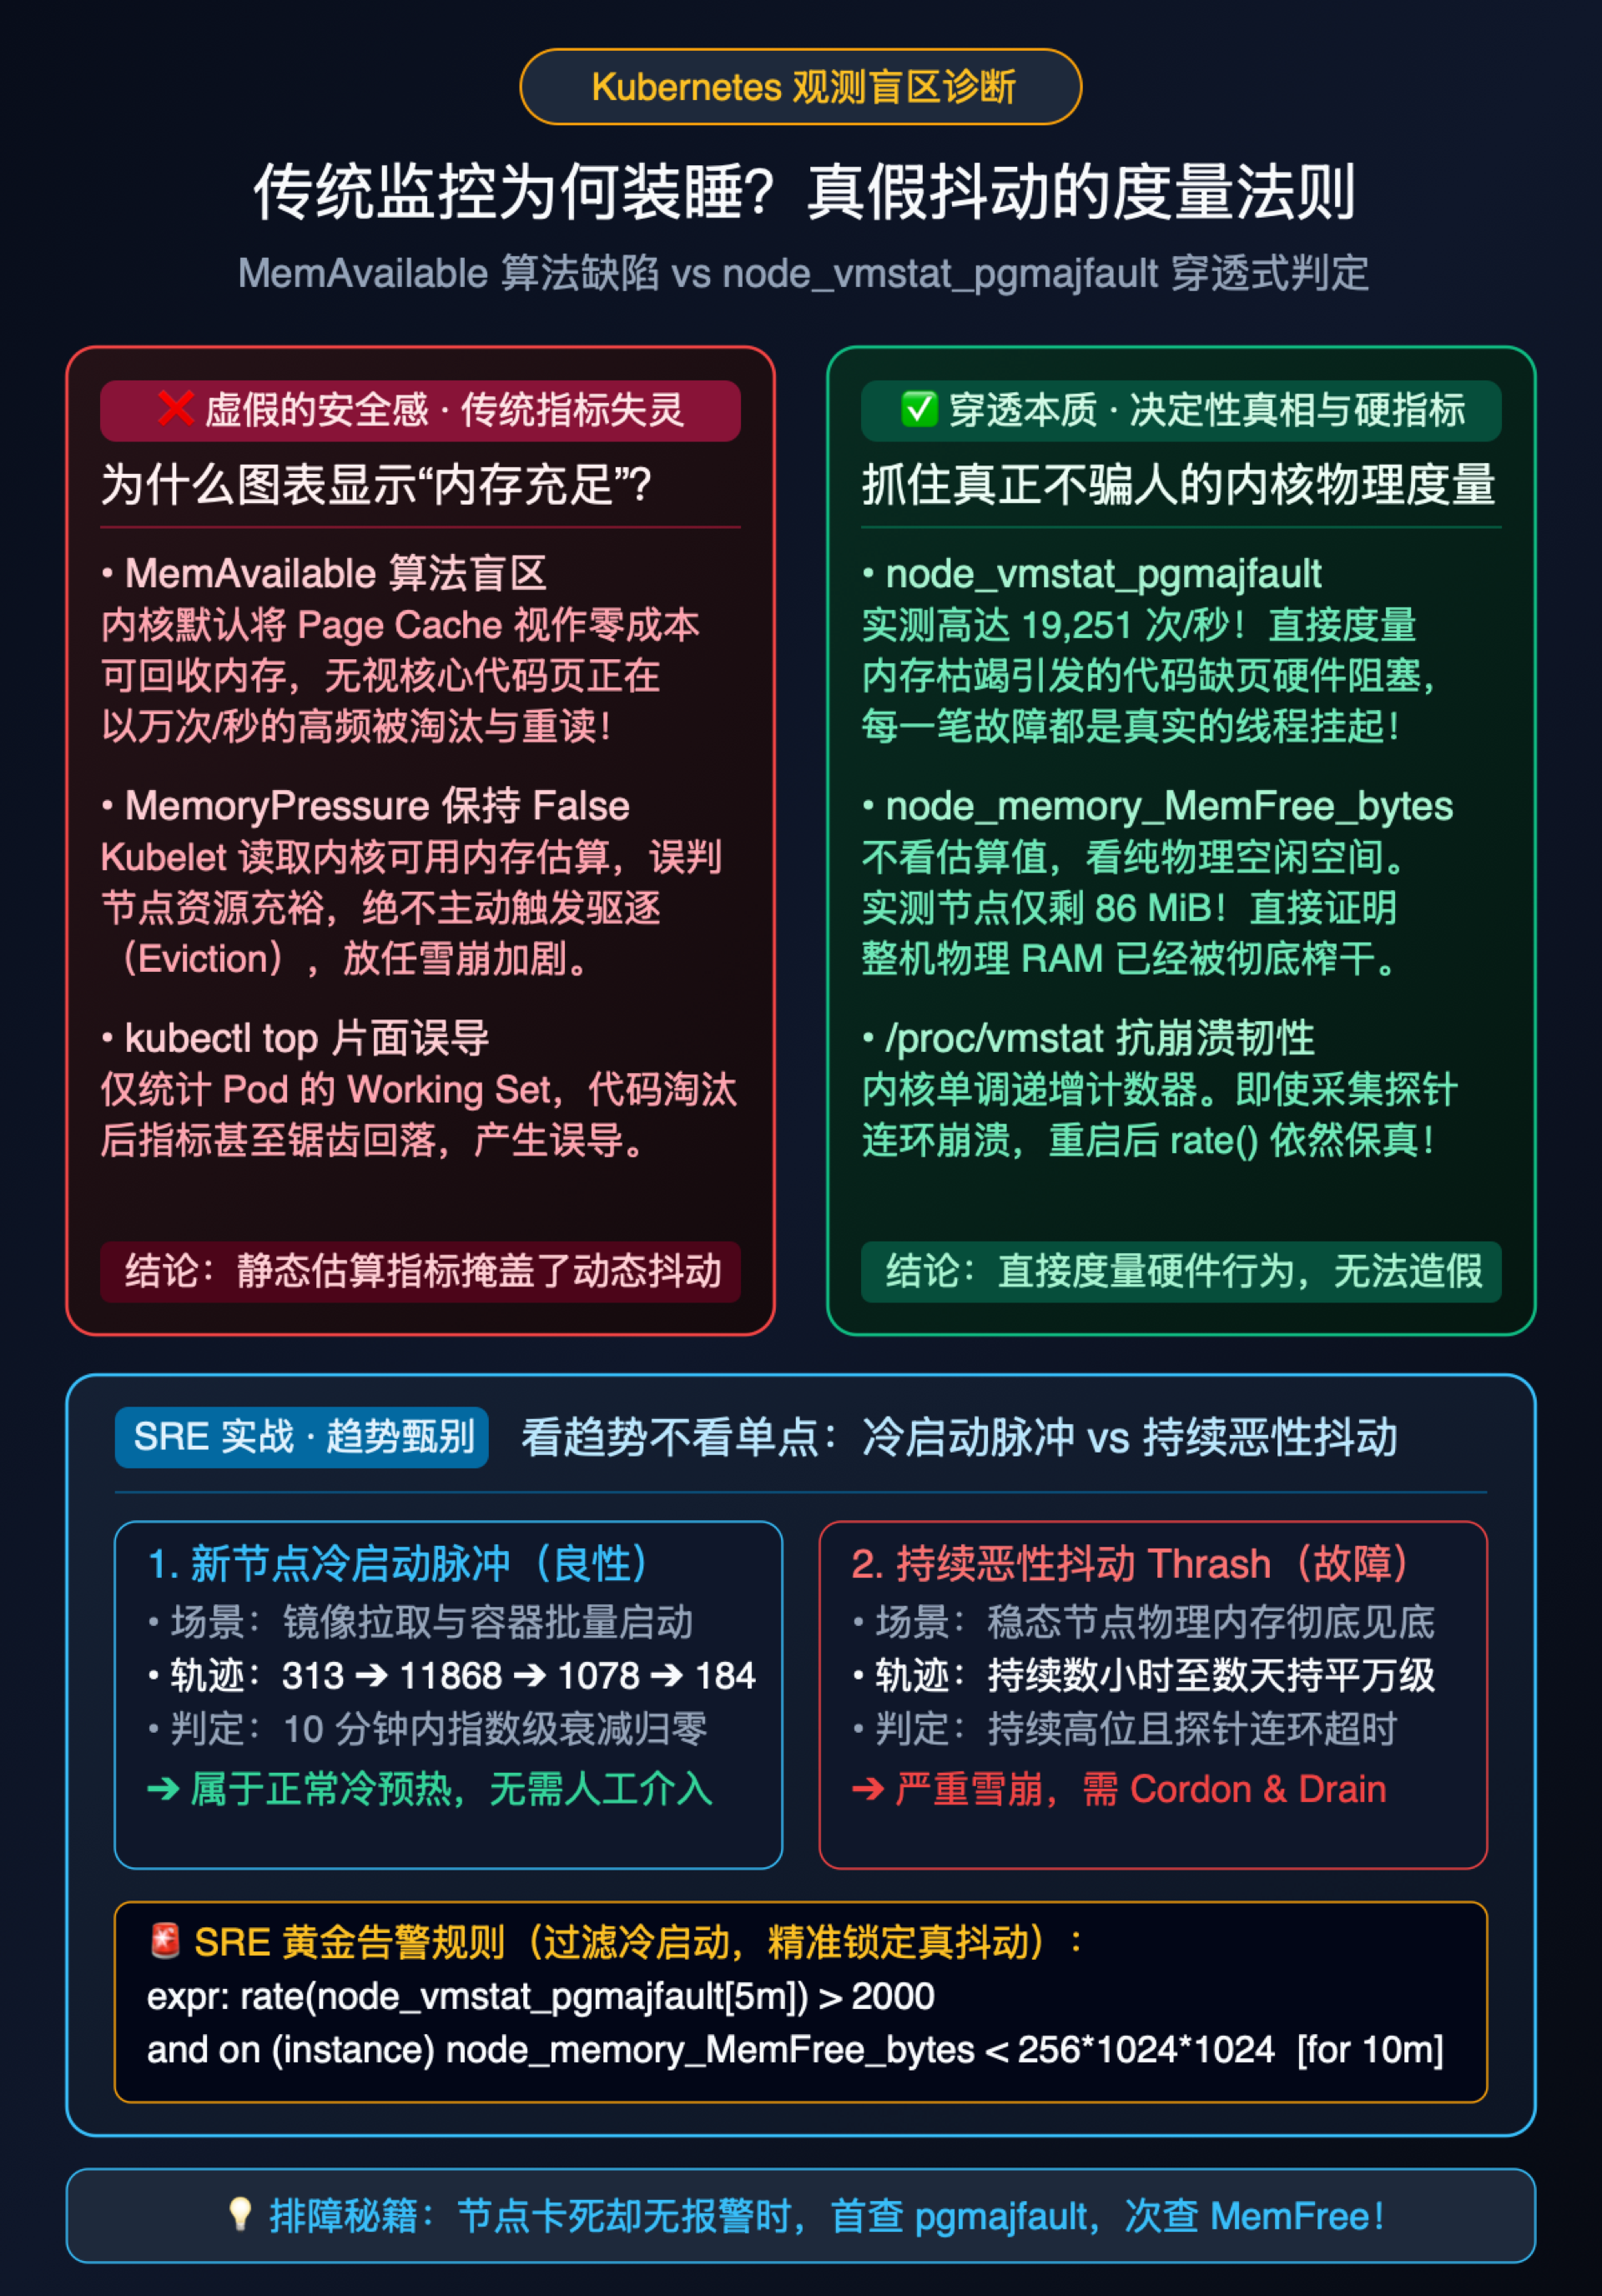
在它的估算公式中,内核将大部分 Page Cache(文件缓存)直接视为"可以随时无成本回收的内存"。
然而,这个算法并没有考虑抖动频率:
- 如果 1GB 的 Page Cache 是静态日志,丢弃它确实是零成本;
- 但如果这 1GB 的 Page Cache 是每秒被调用上万次的核心执行代码,丢弃它就会立即引发灾难性的磁盘回读。
内核将这批正在疯狂抖动的代码页依旧算作"可用内存",向上层交出了一份乐观的答卷。而 Kubelet 正是依赖系统的可用内存来评估节点健康度,因此它坚定地认为节点可用资源极其充裕,MemoryPressure 自然不会触发为 True,也不会触发保护性的 Pod 驱逐(Eviction)。
2. kubectl top 的片面透镜
kubectl top nodes 和 kubectl top pods 读取的是 cgroup 的工作集内存(working_set):
text
working_set = memory.usage_in_bytes - total_inactive_file当内核频繁回收文件页时,Inactive File 乃至 Active File 的统计值会发生剧烈波动。在监控图表上,你甚至会看到内存使用率不仅没有拉满,反而呈现出锯齿状的回落。排障人员扫一眼 Dashboard,往往会得出错误的结论:"内存完全够用,故障肯定与内存无关"。
3. 刺破谎言的两个硬核指标
要彻底穿透这些静态指标的欺骗性,必须依靠两个直接度量物理行为的底层指标:
指标一:node_vmstat_pgmajfault
这个指标直接采集自宿主机的 /proc/vmstat。它不关心内存算法怎么粉饰太平,它只机械、诚实地记录一件事:CPU 到底向磁盘发起了多少次阻塞式代码/页面调入。
在 Prometheus 中,只需一条简单的 PromQL:
promql
rate(node_vmstat_pgmajfault[2m])在健康节点上,这个速率应当处于个位数;一旦发现数值攀升至数千甚至上万,无论其他内存指标显示是多少,节点都已经陷入了实质性的 Thrashing 泥潭。
指标二:node_memory_MemFree_bytes
不要看经过包装的 MemAvailable,去看最原始、最纯粹的物理未分配空间 MemFree。
在当时那台持续崩溃的节点上,MemFree 实际上只剩下了可怜的 86 MiB。这证明整台机器的物理页面早已被彻底榨干,内核为了满足基本运行,除了对代码页下死手之外已经无路可走。
四、 SRE 实战:如何优雅使用主缺页指标?
在将 node_vmstat_pgmajfault 引入日常可观测性体系时,有两个极具实战价值的关键点需要把握。
1. 看趋势,不看单点绝对值(冷启动脉冲 vs 持续恶性抖动)
主缺页并不是洪水猛兽。在某些特定场景下,它会出现天然的、完全良性的瞬时尖刺。
最典型的就是新节点的冷启动阶段 :
当一台刚开机 10 分钟的全新实例(如 m6a.large)被加入集群时,Kubelet 开始拉取镜像并大规模初始化几十个容器。此时,所有二进制文件、共享库第一次从 EBS 装载进全新的 Page Cache,必然会产生剧烈的主缺页。
我们在生产实测过一台新节点的指标爬坡过程:
冷启动开始 → 313 次/秒 → 11,868 次/秒 → 1,078 次/秒 → 184 次/秒 → 趋近于 0整个过程在 10 分钟内完成指数级衰减,随后维持在健康水准。这种脉冲是典型的冷 Cache 填充行为,完全属于正常业务范畴。
SRE 判定铁律:
- 良性脉冲:新节点加入或大版本发布时出现万级尖刺,但在 5 ~ 10 分钟内迅速衰减归零;
- 恶性抖动 :节点已平稳运行多日,没有大规模冷启动,但
majfault持续数小时甚至数天持平在数千至上万次/秒。
2. 内核级计数器的天然"抗崩"优势
在排障过程中,一个令人极其安心的工程细节是:node_vmstat_pgmajfault 指标具有天然的抗崩溃韧性。
故障期间,node-exporter Pod 自身也在连环崩溃,每隔几分钟就会死一次。很多人会担心:采集器自身在不断重启,算出来的指标会不会频繁归零、彻底失真?
答案是:完全不会。
因为 pgmajfault 来自 Linux 内核的 /proc/vmstat,它是宿主机操作系统自开机以来的全局单调递增计数器 。只要宿主机内核没有 reboot,无论 node-exporter 重启了多少次,它读取到的都只是内核计数器的最新值。
Prometheus 的 rate() 引擎在计算速率时,只要在时间窗口内抓取到了两个有效样本点,就能根据单调递增的时间斜率精确还原出这期间的真实故障速率。即便监控探针身处风暴核心,它所记录下的数据依然坚挺可靠。
五、 根治策略与告警工程建设
当主缺页过高导致探针连环超时时,应急与长效治理应当如何落地?
1. 紧急止血与隔离
一旦发现某台节点的 rate(node_vmstat_pgmajfault[2m]) 持续高于 2,000 且伴随大量探针超时:
bash
# 1. 立即封锁节点,阻止新 Pod 继续调度
kubectl cordon <node-name>

# 2. 安全驱逐业务 Pod,打破 Thrashing 循环
kubectl drain <node-name> --ignore-daemonsets --delete-emptydir-data
将受到影响的业务 Pod 迅速迁移至健康的充裕节点,切断代码页反复淘汰的局部压力源。
2. 配置黄金组合告警规则
千万不要单独针对 node_vmstat_pgmajfault 设置单点阈值报警,否则每次节点扩容都会引发告警风暴。
在 Prometheus Alertmanager 中,应当采用高频缺页 + 物理空闲见底 + 持续时间的三元组合规则:
yaml
- alert: NodePageCacheThrashingSustained
  expr: |
    (
      rate(node_vmstat_pgmajfault[5m]) > 2000
    )
    and on (instance) (
      node_memory_MemFree_bytes < 256 * 1024 * 1024
    )
  for: 10m
  labels:
    severity: critical
    tier: infrastructure
  annotations:
    summary: "Host {{ $labels.instance }} is suffering from Severe Page Cache Thrashing"
    description: "Node major page fault rate is {{ $value }} faults/s and MemFree is below 256MB for 10 minutes. Processes are heavily stalled on disk I/O for code execution."
这条规则精准过滤掉了 10 分钟内的冷启动脉冲,同时锁定了"物理内存彻底用尽且正在高频从磁盘调入代码"的真抖动现场。
3. Pod 资源配额与探针容错治理
- 挤干节点超卖水分 :合理设置每个 Pod 的
requests和limits,确保物理节点的allocatable扣除kube-reserved和system-reserved后,留有至少 10% ~ 15% 的真实缓冲空间供内核缓存周转; - 探针超时参数避坑 :避免在探针上盲目使用默认的
timeoutSeconds: 1。对于像akhq(JVM 技术栈)或涉及动态模块加载的组件,在遇到瞬时磁盘 I/O 抖动时很容易被误杀。将timeoutSeconds适当宽限至 3 秒,并将failureThreshold设置为 3 ~ 5 次,配合startupProbe,能大幅减少轻微波动下的非必要死循环重启; - 评估开启受控 Swap(K8s 1.28+):在较新的 Kubernetes 版本中,社区已支持通过 NodeSwap 特性精细控制 Pod 的 Swap 行为。在经过验证的场景下为节点分配适度的高速 NVMe Swap,可以允许内核在内存压力下优先将冷匿名页换出,避免粗暴地将活跃执行代码页直接踢出缓存。
结语
在云原生抽象日益高深的今天,容器编排为我们遮蔽了底层操作系统的无数复杂细节。但在故障发生的最深处,物理规律从来不会失效:
内存就是纳秒,磁盘就是毫秒;代码页不在内存里,CPU 就必须停下来等 I/O。
下次当你的集群再次出现没有 OOM、没有硬件故障、但 Pod 却在探针超时中成批倒下的灵异现象时,别再只盯着 kubectl top 和 MemoryPressure 装睡的图表了。
看一眼 node_vmstat_pgmajfault 和 MemFree------内核最真实的呼吸节律,早已把答案写在了那里。