在LangChain中,模型调用(Invocation)是指通过特定方法触发大语言模型生成输出的过程。根据不同的应用场景和需求,LangChain提供了几种核心的调用方式,主要是invoke()、stream()和batch()方法,以及它们的异步版本ainvoke()、astream()和abatch()。
invoke():阻塞式,一次性返回完整结果问答,批处理任务,无需实时反馈的场景
ainvoke():非阻塞式,提高系统吞吐量高并发Web应用,IO密集型任务
stream():流式输出,实时返回每个token聊天机器人,长文本生成,需要提升用户体验的交互应用
astream():非阻塞式,提高系统吞吐量高并发Web应用 ,IO密集型任务
batch():批量处理多个输入高并发场景,需要同时处理大量请求
abatch():非阻塞式,提高系统吞吐量高并发Web应用,IO密集型任务
输入参数详解
字典列表(推荐、最灵活)
创建字典列表组成消息。一条消息通常包含role(角色),content(内容)等信息。
适用场景:可以设置系统提示,表达多轮对话历史,JSON兼容,易于序列化和网络传输,生产环境推荐。
缺点:代码稍微多一点(但更清晰)
格式:
bash
messages = [
{"role": "system", "content": "系统提示"},
{"role": "user", "content": "用户消息"},
{"role": "assistant", "content": "AI回复"}, # 可选,用于对话历史
{"role": "user", "content": "继续提问"}
]
角色说明:
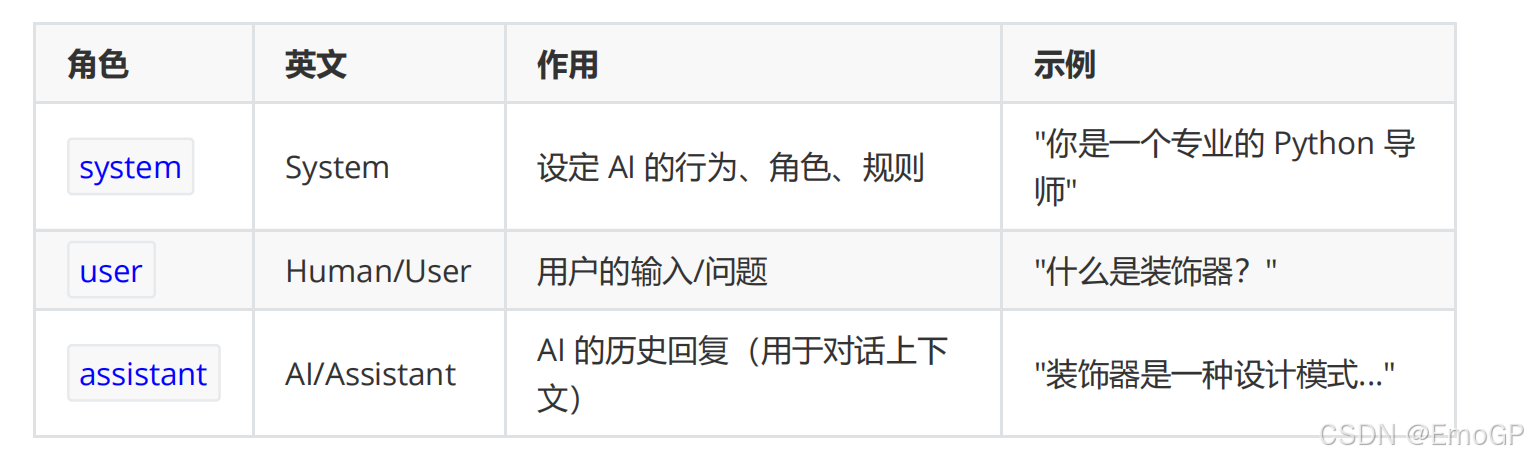
bash
"user"和 "human"有时可以互换,但遵循你选择的主要模型提供商(如OpenAI)的惯例使用
"user"是最稳妥的做法。
举例1:
bash
from langchain_openai import ChatOpenAI
import os

from dotenv import load_dotenv


# 读取.env配置文件中的信息,相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")


# 模型的初始化

model = ChatOpenAI(
    model = "deepseek-flash",
    api_key = DEEPSEEK_API_KEY,
    base_url= DEEPSEEK_BASE_URL,
)

messages = [
    {"role":"system","content":"你是一个专业的数学老师"},
    {"role":"user","content":"帮我解释一下什么是斐波那契数列"}
]

response = model.invoke(messages)
print(response.content)
举例2:多轮对话(带历史)
bash
messages = [
    {"role":"system","content":"你是数学老师"},
    {"role":"user","content":"1 + 19 = ?"},
    {"role":"assistant","content":"20"},
    {"role":"user","content":"我刚才问了什么问题"}
]

response = model.invoke(messages)
print(response.content)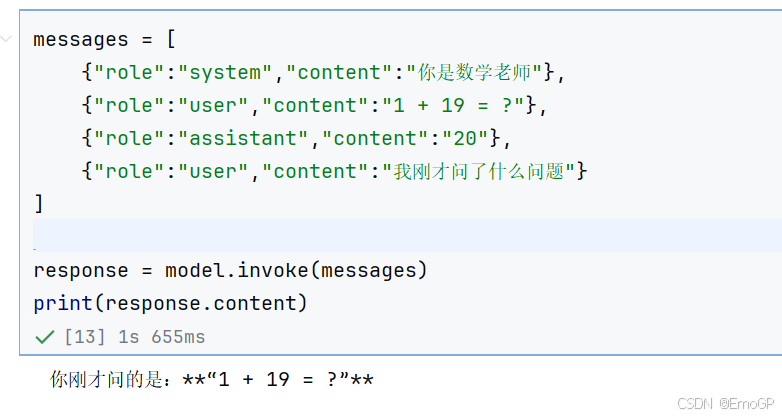
举例3:如果不传递历史,AI会"失忆"
bash
message1 = [
    {"role":"system","content":"你是一个非常友好的AI助手"},
    {"role":"user","content":"你好,我叫小明"},
]

# 第一次对话
response1 = model.invoke(message1)

# 打印响应
print(f"AI的回复1:{response1.content}")


message2 = [
    {"role":"user","content":"我叫什么名字"}
]

# 第二次对话
response2 = model.invoke(message2)
print(f"AI的回复2:{response2.content}")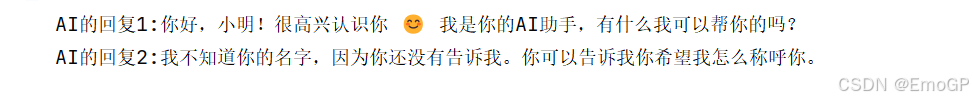
作为对比,传递记忆
bash
conversation = [
    {"role":"system","content":"你是一个非常友好的AI助手"},
    {"role":"user","content":"我叫小刚"}
]

# 第一次对话
response1 = model.invoke(conversation)
print(f"AI的回复1:{response1.content}")


# 添加记忆
conversation.append({"role":"assistant","content":response1.content})
conversation.append({"role":"user","content":"我是谁"})

# 第二次对话
response2 = model.invoke(conversation)
print(f"AI的回复2:{response2.content}")
消息对象列表
举例1:
bash
from langchain_core.messages import SystemMessage, HumanMessage

messages = [
    SystemMessage(content = "你是一个专业的数学老师"),
    HumanMessage(content = "帮我解释一下什么是斐波那契数列"),
]

response = model.invoke(messages)
print(response.content)
举例2:传递记忆
bash
from langchain_core.messages import AIMessage

messages = [
    SystemMessage(content = "你是一个专业的数学老师"),
    HumanMessage(content = "帮我解释一下什么是斐波那契数列"),
]

response = model.invoke(messages)
# print(messages)

messages.append(AIMessage(content = response.content))
messages.append(HumanMessage(content="能重新解释一下么"))

response1 = model.invoke(messages)
print(response1.content)