现在已经 9 月份了,不少在职的朋友今年的体检估计还没做吧。
我也一样,上半年一直拖拖拉拉的,再不去体检,后面天就冷了,就不方便了。
这不半月前做完体检刚拿到检测报告,老样子直接丢给AI分析一波。
现在的AI看单一数据报告完全不在话下,比较麻烦的是我们生活中的健康数据太分散、格式不一样、甚至数据单位也可能有差异。
例如:体检结构出的PDF报告,可穿戴设备的运动和睡眠数据。同一个「血红蛋白」,不同医院、不同语言、不同系统,写法还可能完全不一样。
这就导致我们想准确分析自己的健康状态,往往不全面。
今天给大家推荐一个开源的 AI 健康数据引擎,叫做 Mirobody,目前在 GitHub 已经有约 1.3k 星。
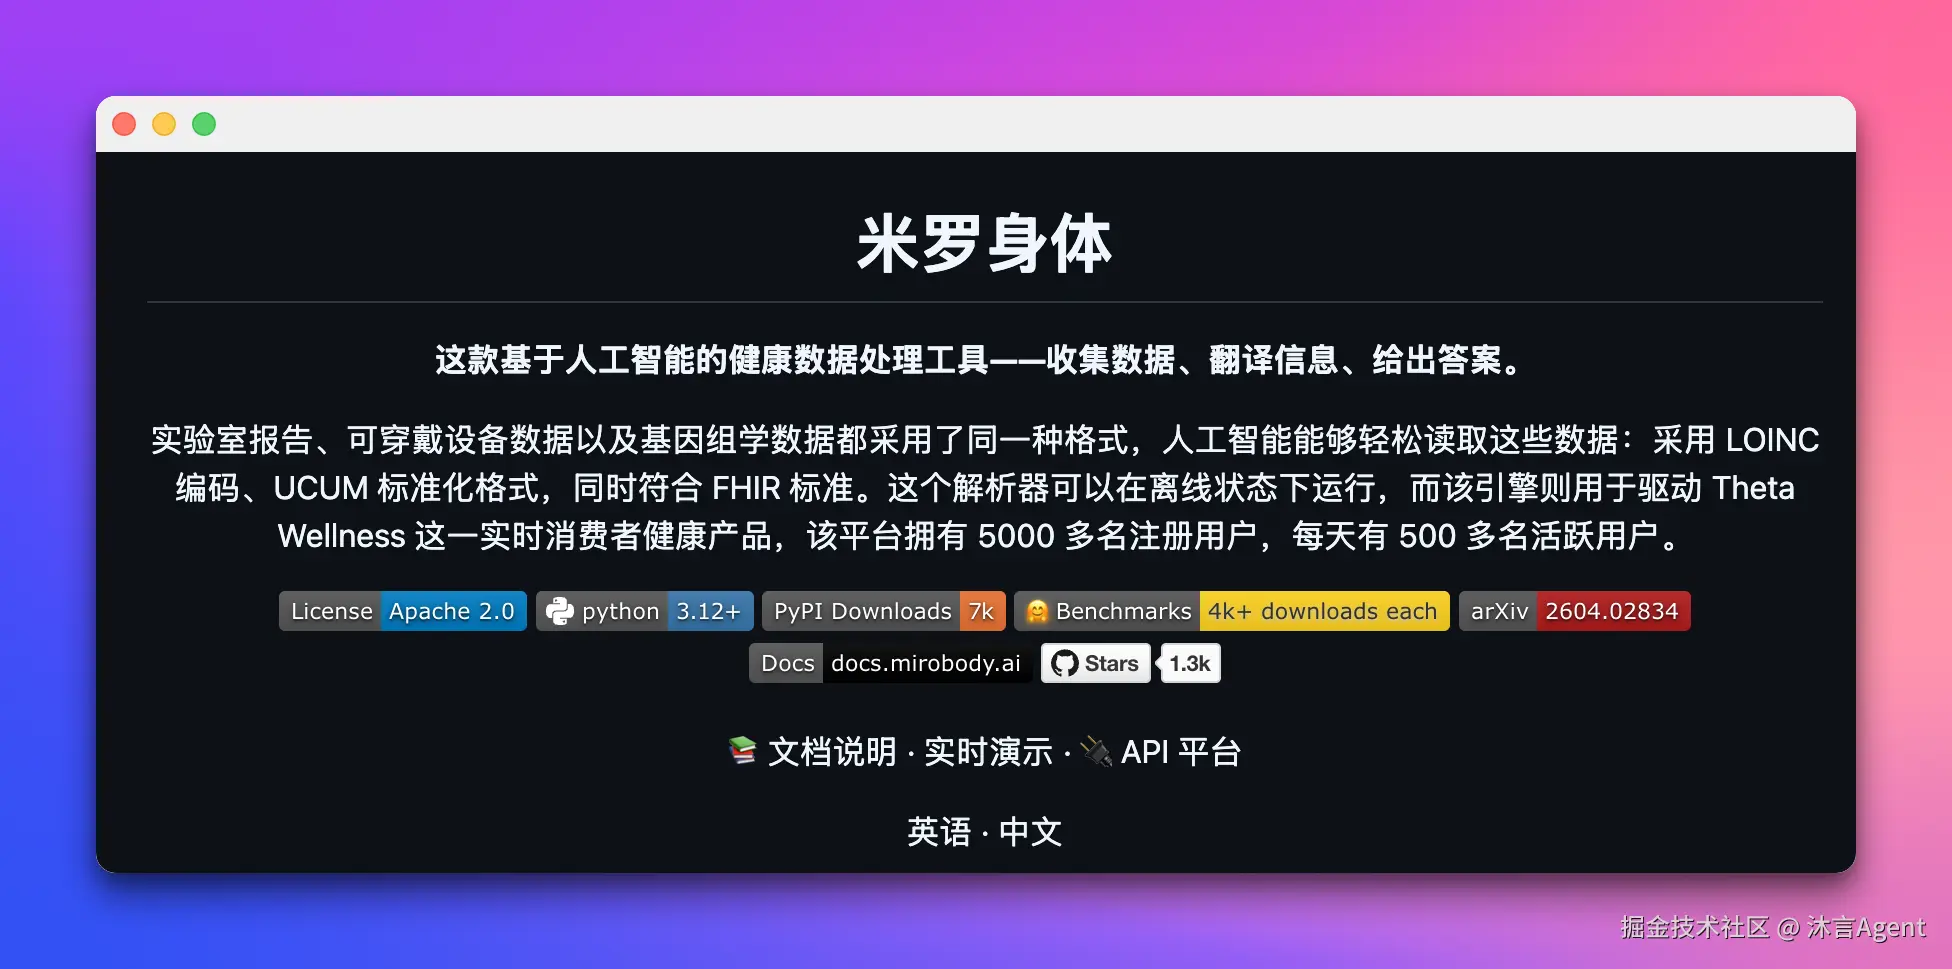
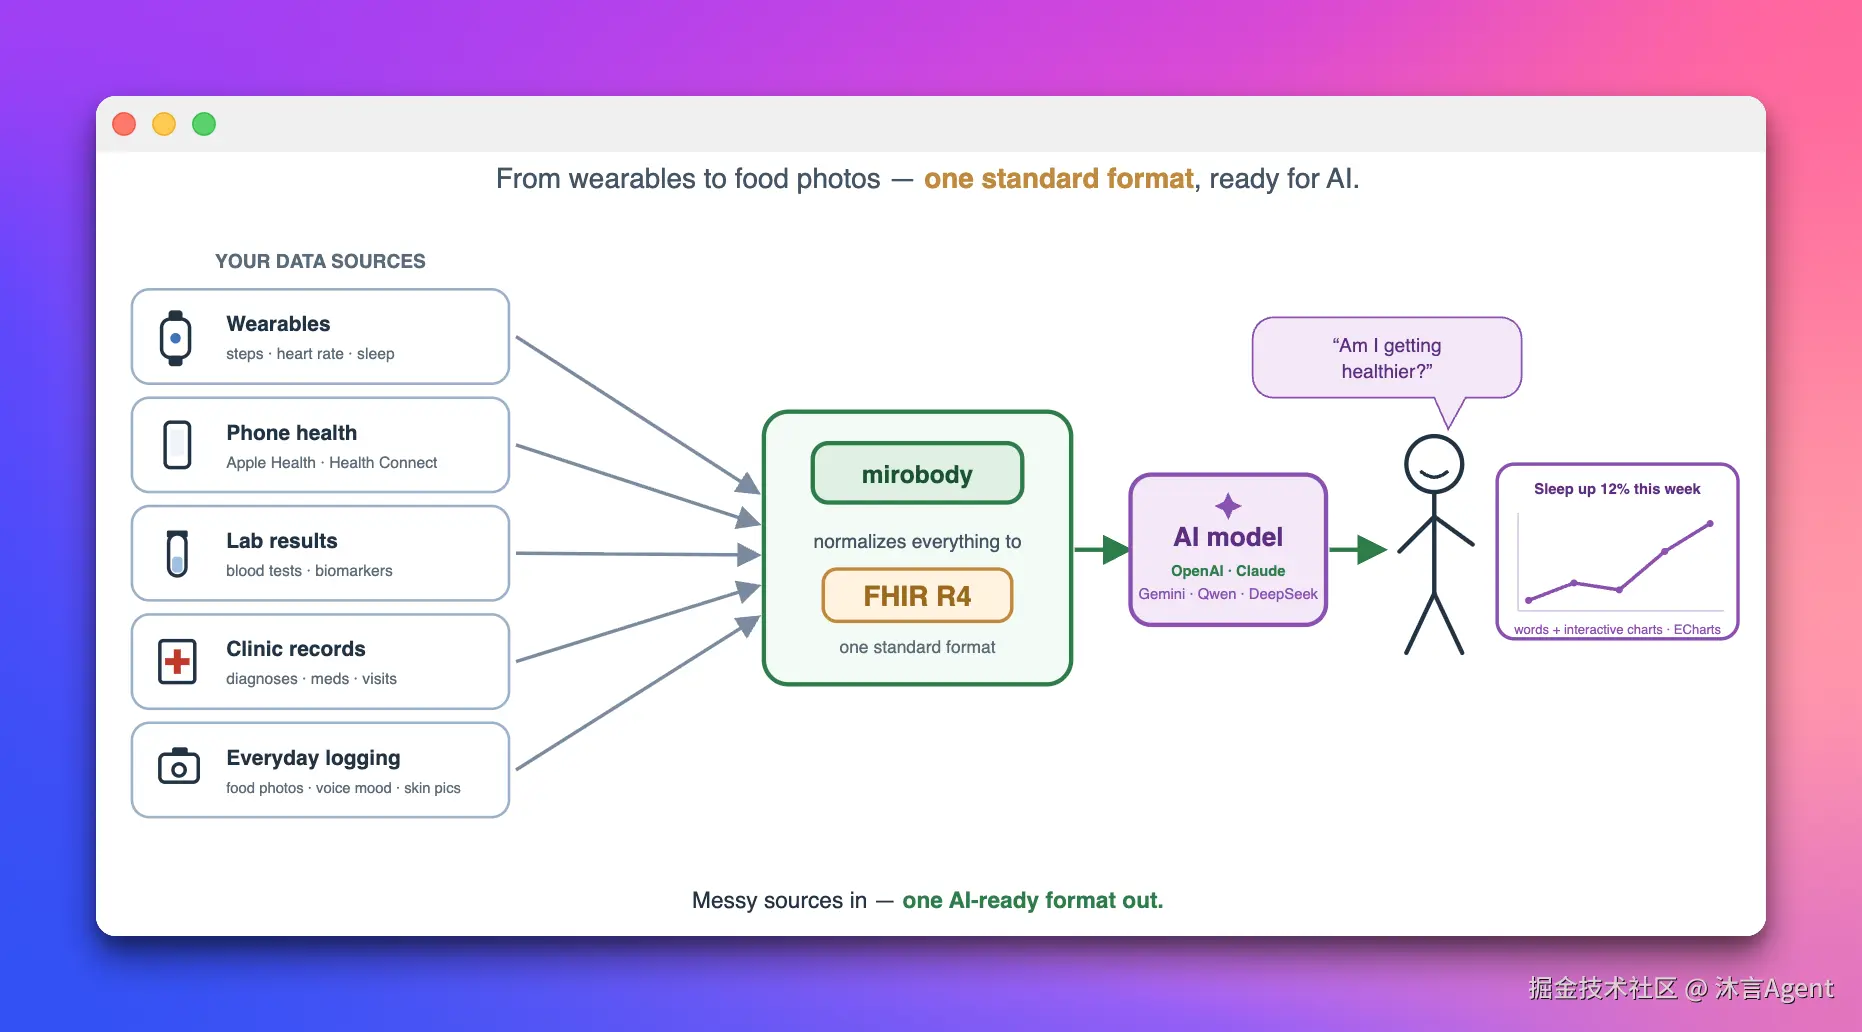
它会先把体检报告、穿戴设备和基因数据整理成统一的标准格式,再交给 Agent 查询、对比和分析。
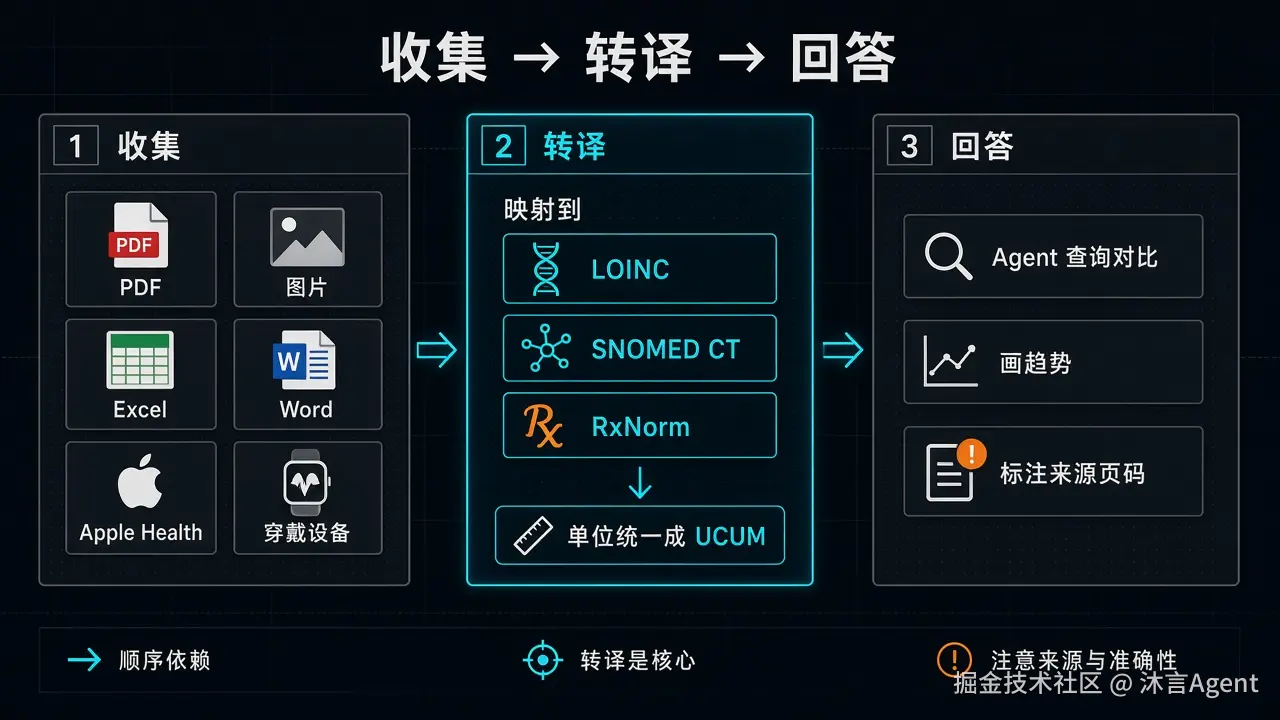
Mirobody把整个流程分成了三步,收集、转译、回答。
先接入PDF、图片、Excel、Word、Apple Health和穿戴设备数据,再把里面的健康指标映射到LOINC、SNOMED CT、RxNorm等标准编码,单位统一成UCUM。
说人话,就是先确定「这项指标究竟是什么」,再统一它的名字和单位。
整理完成后,Agent才能把不同时间、不同来源的数据放到一起,画出变化趋势,并告诉你答案来自哪份报告、哪一页。
Mirobody最有意思的地方,是它提供了一个完全离线的指标解析器。
安装之后,不需要API Key,也不需要联网,就能测试不同语言和不同写法的指标:
bash
pip install mirobody
mirobody resolve "LDL cholesterol" 血红蛋白 ヘモグロビン "空腹血糖(GLU)" 血脂
中文的「血红蛋白」、日文写法和英文的 hemoglobin,最后都会落到同一个LOINC编码 718-7。
但如果输入「血脂」,系统不会急着给你一个答案。
因为血脂是一类指标,并不对应某一个具体的观测项,Mirobody 会直接标记为未解析。不确定就先留空,不给一个看起来合理的错码。
我觉得这一点很重要。
医疗数据最怕把两个不同的指标当成同一个指标,还用很肯定的语气告诉你结果。
把体检报告变成标准数据
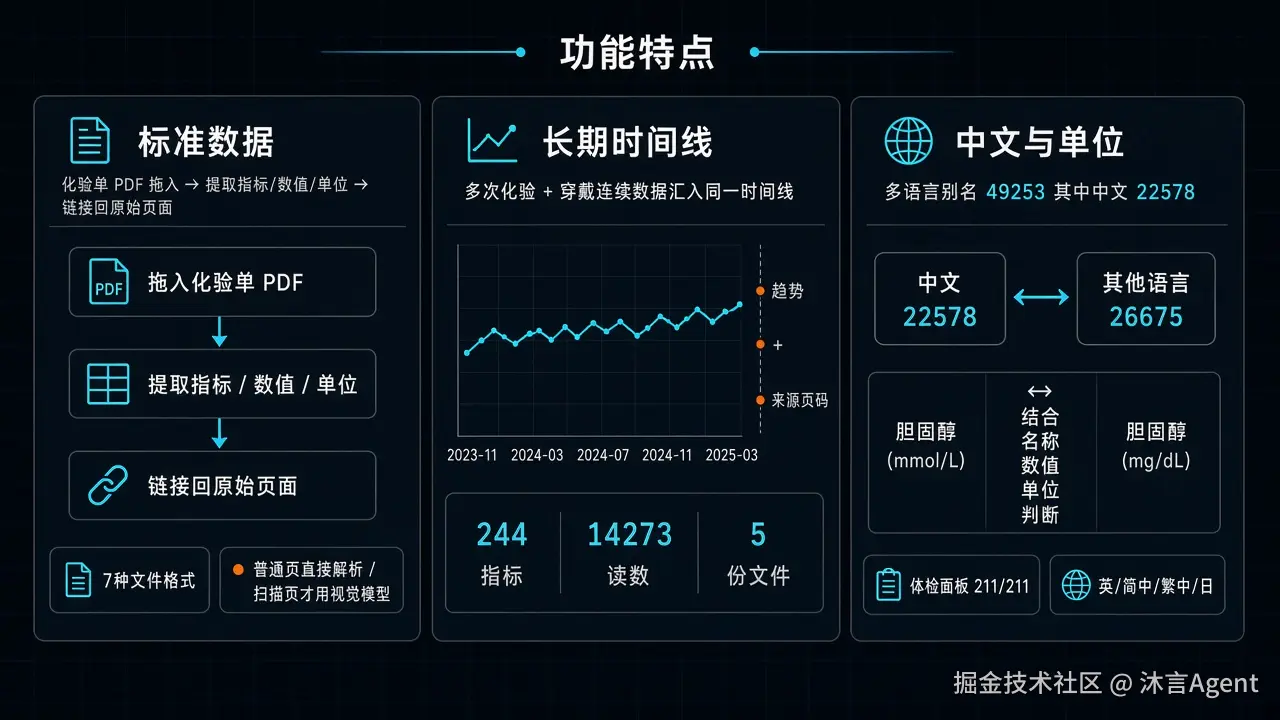
把化验单 PDF 拖进系统,Mirobody 会提取里面的指标、数值和单位,并把每条结果链接回原始文件所在的页面。
项目支持 PDF、图片、表格、办公文档和文本等 7 种文件格式。普通页面直接解析,只有扫描页面才会交给视觉模型处理。
这套思路和全部文件无脑跑OCR相比,会更克制一些。
把长期数据放到一张图里
单看一次糖化血红蛋白,只能知道这一次的结果高不高。
Mirobody 会把多次化验结果和穿戴设备记录的连续数据放到同一条时间线上,交给 Agent 判断变化有没有持续。
官方演示里,一个合成用户有 244 个指标、14273 条读数和 5 份原始文件。
Agent 会根据这些数据画出趋势图,回答时也会标明它读的是哪份文件、哪一页。
中文指标和单位统一
项目内置49253条多语言别名,其中中文别名22578条,还处理了简繁体差异。
同一个胆固醇指标,使用 mmol/L 和 mg/dL 时,可能对应不同的标准表达。Mirobody会结合名称、数值和单位一起判断,不只是搜一个相似词。
官方目前给出的普通体检面板覆盖结果是211/211,支持英文、简体中文、繁体中文和日文。
可以接入自己的Agent
Mirobody 也可以接到你自己的工作流里。
它提供 HTTP API 和 MCP 服务,能接入 Claude Desktop、Cursor,或者你自己开发的 Agent。设备数据源、工具和 Skill 也支持通过插件扩展。
整套服务可以用 Docker 部署在自己的机器上,健康数据不必全部交给某个封闭平台托管。
最后
它同样不能替代医生做诊断。
但如果你正在做健康数据平台、家庭健康档案、穿戴设备分析,或者医疗 Agent,Mirobody 提供的标准化层,可能比再加一个聊天界面更值得投入。
AI 想把健康问题回答好,首先得弄清楚自己读到的数据到底是什么。
仓库地址:
bash
https://github.com/thetahealth/mirobody今天就分享到这,感谢阅读。
持续更新中,竹叶获取最新所有分享工具信息。