1. 提出的新任务:Reasoning Segmentation
和传统 Referring Segmentation 很像,但最大的区别在于 query。
普通 referring segmentation:
"the trash can"
用户已经明确告诉模型目标是 trash can。
Reasoning Segmentation:
"something that the garbage should be put into"
模型需要自己推理:garbage should be put into → trash can
所以这个任务实际上要求两个能力:理解隐式指令 + 产生像素级 mask
2. 为什么普通多模态 LLM 不够?
像 LLaVA 这样的模型可以:image + text → text
它能回答:
"The object is an orange."
但 segmentation mask 是二维像素结构:
LLM 本身并不擅长直接输出这种 dense prediction。
因此论文的问题变成:怎么把 LLM 的语义/推理能力接到 segmentation 上?
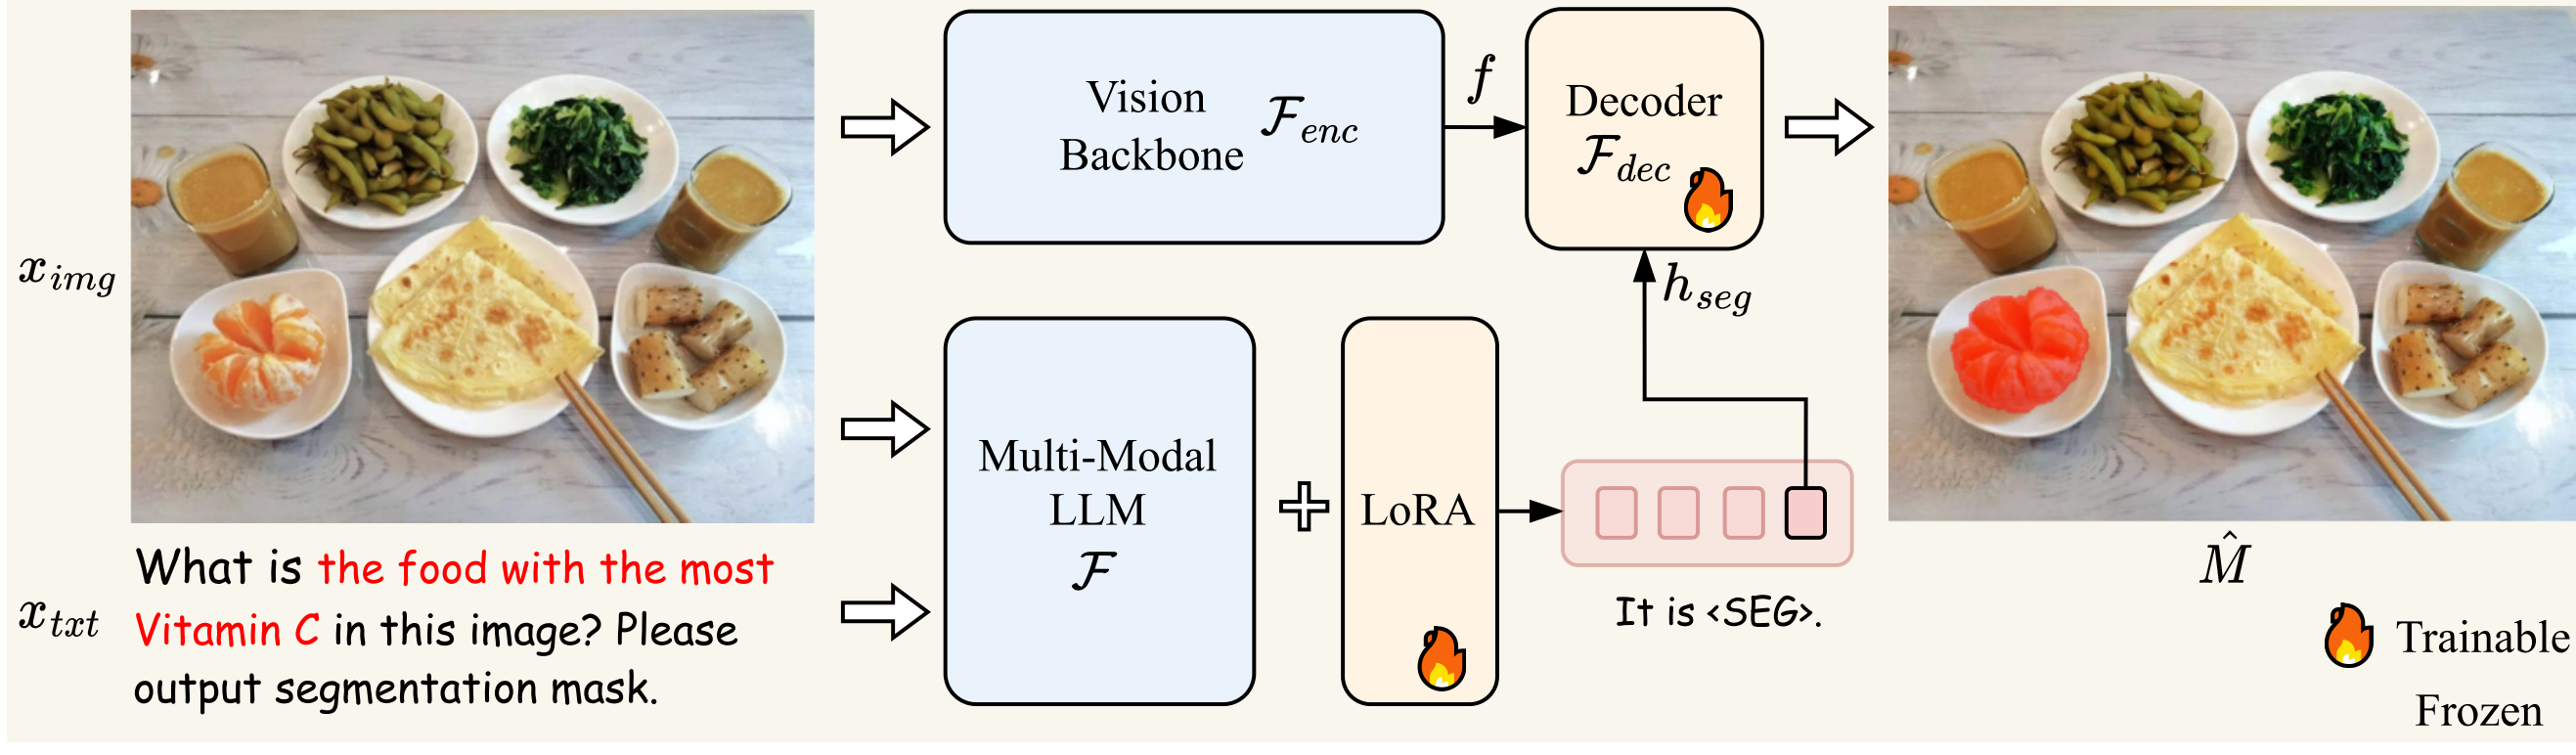
3. LISA 最核心的设计:<SEG> token
作者在 LLM 的词表里加入一个特殊 token:<SEG>
比如模型接收到:
What is the food with the most Vitamin C? Please output segmentation mask.
LLM 可能生成:
It is
<SEG>.
这里真正关键的不是 <SEG> 本身,而是它在 LLM 最后一层对应的 hidden embedding:
把这个 embedding 取出来,再经过一个 MLP:,这个
可以理解成:
LLM 对"当前到底要分割什么"的内部语义表示。
与此同时,图像还会经过一个视觉 backbone:,得到 dense visual features。
最后 decoder 同时接收: 和
,生成 mask:
也就是:
LLM负责 What + Vision Backbone负责视觉信息 + Decoder负责 Where
这就是论文所谓的 Embedding-as-Mask。
4. 整个网络可以理解成两条支路
第一条:推理支路
负责:
"用户究竟想分割什么?"
第二条:视觉支路
负责:
"图像中各个位置、边界、局部特征是什么?"
然后二者汇合:
所以本质上并不是让 LLM 自己画 mask,而是:
让 LLM 产生一个指导 segmentation 的语义 query
5. 为什么不让 LLM 直接输出 mask?
前面的 VisionLLM 有一种方案: 坐标序列
然后让 LLM 自己生成: 这样 mask 就被转换成 token 序列了。
但问题是:
- polygon 序列可能很长;
- 精细边界很难用有限坐标表示;
- LLM 不擅长精确预测大量空间坐标;
- 训练代价很高。
LISA 的思路更简单:
LLM 不需要学"怎么画边界"。
LLM 只要告诉 segmentation decoder:"要找的是哪个目标",让专业的视觉 decoder 负责精细 mask。
6. 训练数据怎么构造?
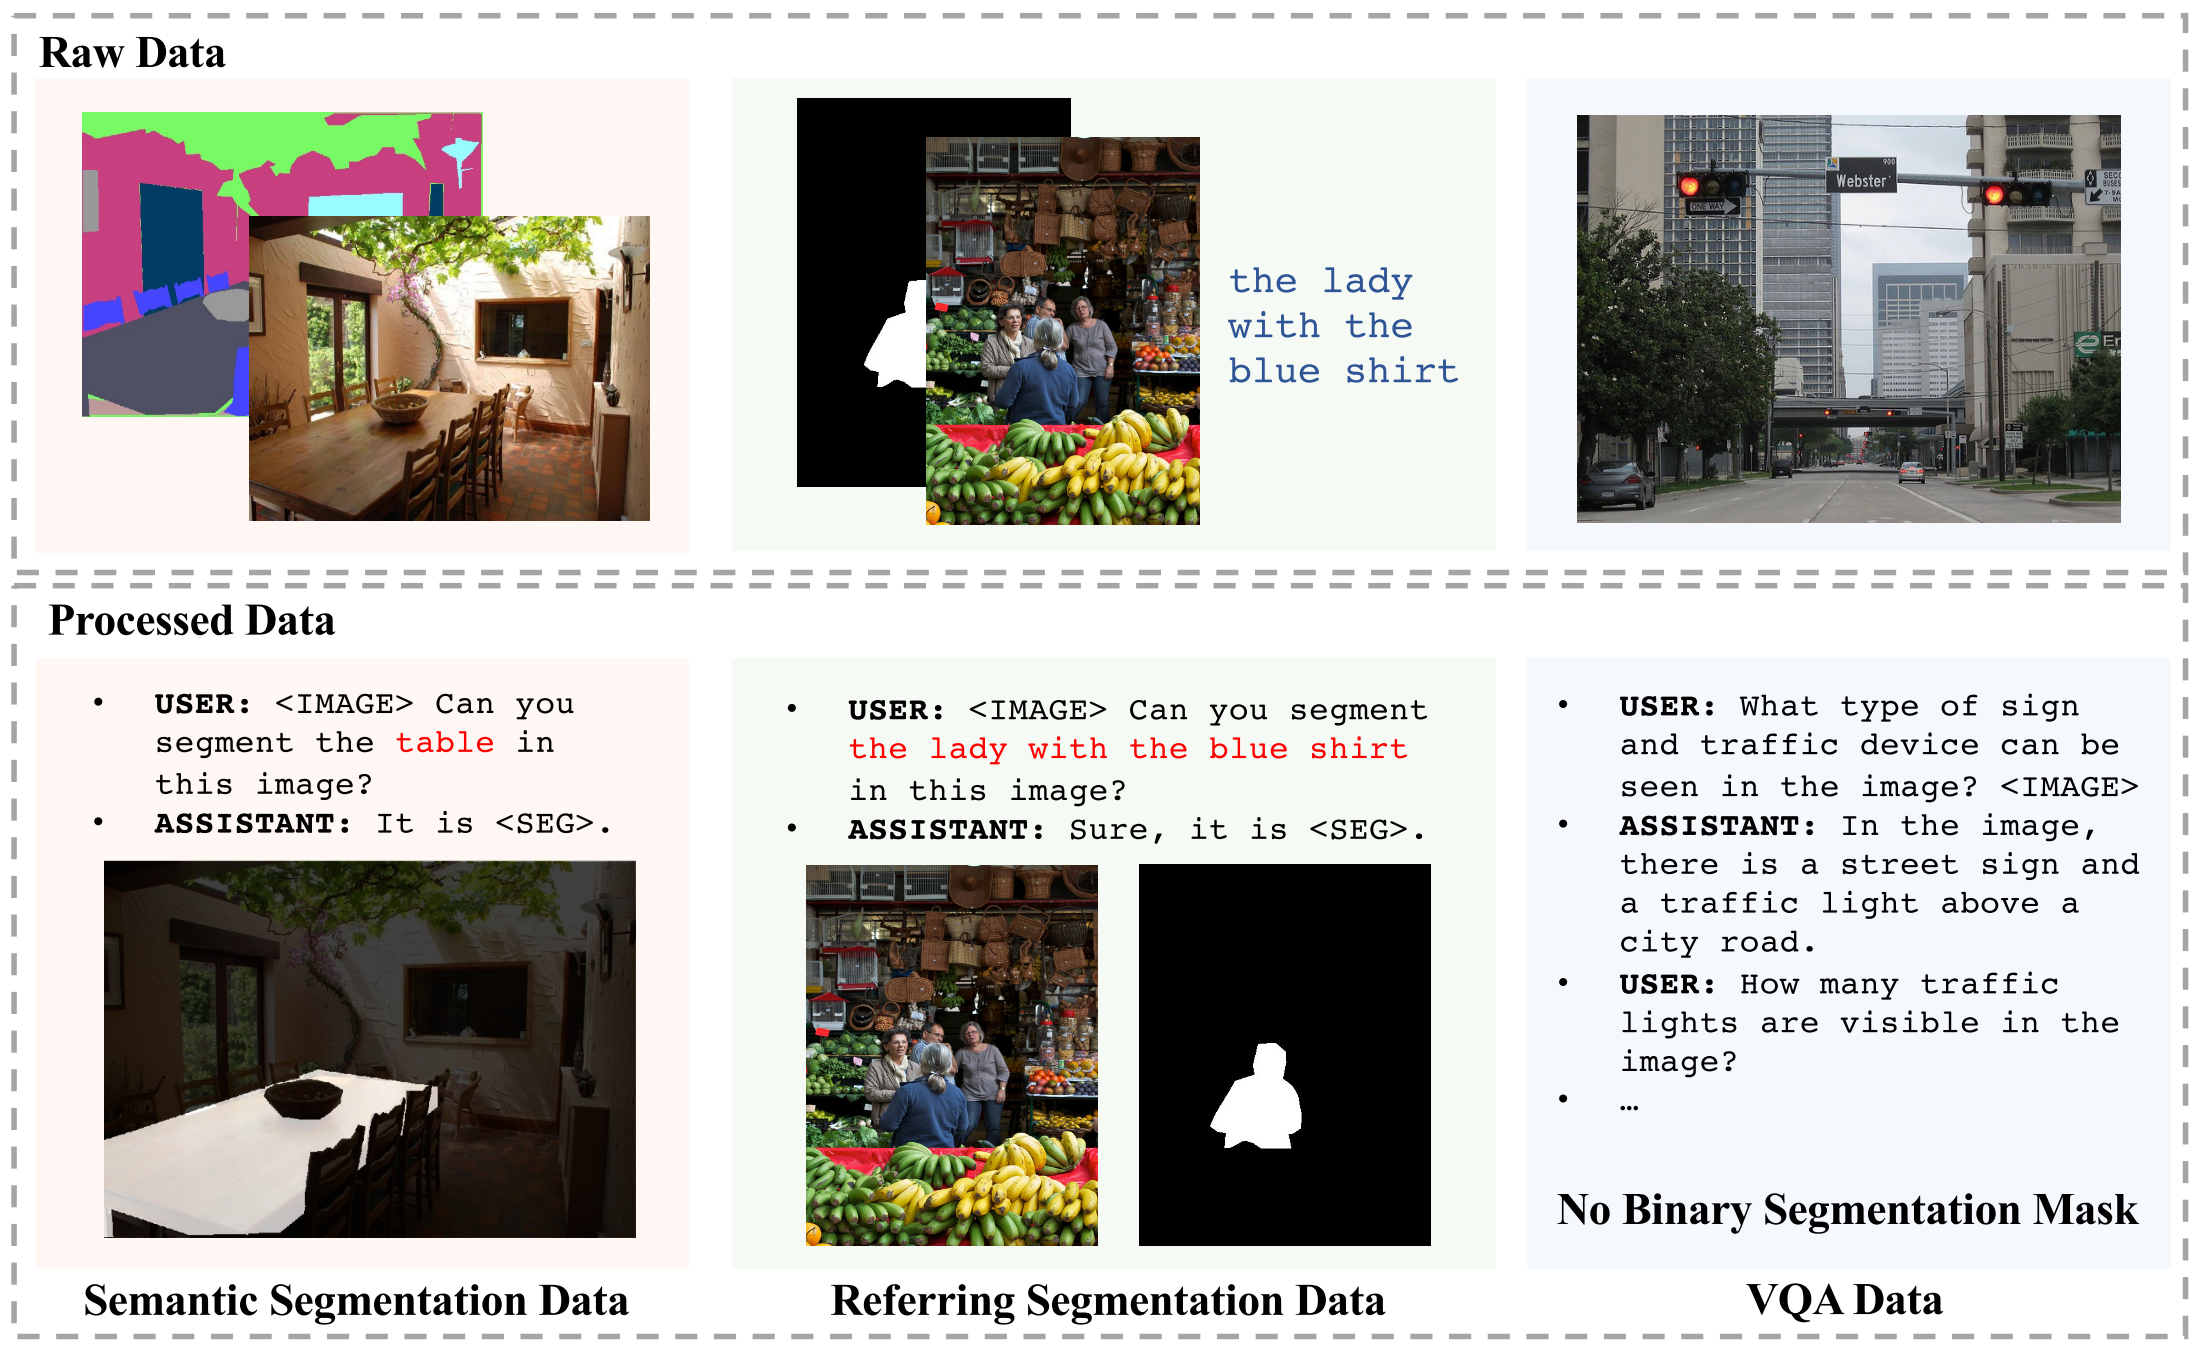
作者主要用了三类数据。
第一类是 Semantic Segmentation,例如 ADE20K、COCO-Stuff 等。
原始数据可能是:Image + pixel\ label
作者改造成:
Can you segment the table?
回答:
It is
<SEG>.
然后用 table 的真实 mask 做监督。
第二类是 Referring Segmentation,例如 refCOCO、refCOCO+、refCOCOg。
比如原来的描述:
"the lady with the blue shirt"
转换为:
Can you segment the lady with the blue shirt?
第三类是 VQA 数据。
VQA 数据本身没有 mask,但保留下来主要是为了避免模型在训练 segmentation 后丢失原有的:对话能力、图像理解能力、文本生成能力
论文的 Figure 4 就是在展示这三类数据的统一训练形式。
7. Loss 怎么设计?
模型有两种输出:
一种是语言输出,所以有:,即普通 autoregressive cross-entropy。
另一种是 mask,所以有:,用:
最后总 loss:
因此训练时既保证模型还会说话,又保证 <SEG> embedding 能真正用于生成 mask。
8. 很有意思的一点:最开始甚至没有 Reasoning Segmentation 训练数据
这是这篇论文比较重要的发现。
模型一开始只用:SemanticSeg + ReferringSeg + VQA 这些数据训练。
里面其实没有:
"维生素 C 最高的食物"
这种真正的 reasoning segmentation 样本。但模型仍然能够 zero-shot 做 ReasonSeg。
作者想说明:LLM 预训练阶段已经具备一定 reasoning / world knowledge ,而他们真正要学的是:怎么把这种能力连接到 pixel mask。
后来再加入只有 239 条 ReasonSeg 训练数据,性能还能明显进一步提升。
9. 还构建了 ReasonSeg benchmark
因为之前没有专门评估 reasoning segmentation 的 benchmark,所以作者构建了:ReasonSeg,共:1218 个 image-instruction-mask 样本。
其中:train:239、val:200、test:779
query 包含 short query 和 long query,两者都要求一定的常识或推理。
10. 实验结果说明了什么?
传统模型:
- OVSeg:26.1
- GRES:21.3
- X-Decoder
- SEEM:24.3
- Grounded-SAM
在 ReasonSeg 上表现都比较差。
而 LISA-7B 已经能达到:36.8,换成更强的 LLaVA1.5: 48.7
再换 13B 并加入 reasoning fine-tuning:61.3 ,提升非常明显,尤其是在 long query 上更明显。
7B → 13B,这说明:这个任务的瓶颈很大程度上不是"mask画不准",而是"问题有没有理解对"
所以更强的语言理解 / reasoning 模型,会直接提高 segmentation 表现。
11. 和"两阶段方法"相比为什么更好?
一个很自然的方法是:
也就是说:
LLM 先输出文字答案,然后 segmentation 模型根据文字找目标。
论文也做了这个 baseline:LLaVA1.5 + OVSeg,但效果明显不如 LISA。
作者认为主要有两个原因:
第一,两阶段方法是完全分开的,没有 end-to-end optimization。
第二,中间只通过文本:"orange" 来传递信息,会丢掉很多 LLM 内部已经形成的信息。
LISA 直接用: (hidden embedding),里面可能保留了更丰富的图像、语言和上下文信息。
12. 这篇论文最值得记住的是什么?
我觉得不是某一个网络细节,而是这个思路:
以前 segmentation 研究更多关心:怎么把物体边界分得更准
而 LISA 开始关心:模型到底有没有理解"我要分割什么"
它实际上把问题从:pixel perception
推进到了:reasoning → grounding → pixels
整篇论文可以压缩成一句话:用 MLLM 理解和推理目标,用 segmentation model 把目标落到像素上 ,而 <SEG> hidden embedding,就是连接这两个世界的接口。
它不是单纯设计了一个更好的 segmentation backbone,而是在解决"高层语义/推理能力如何 grounding 到 dense prediction"这个问题。