文章目录
-
- 前言
- [1. 模型越听话,你越容易遭殃](#1. 模型越听话,你越容易遭殃)
-
- [1.1 官方那个反面教材](#1.1 官方那个反面教材)
- [1.2 描述写太宽,为什么这么坑](#1.2 描述写太宽,为什么这么坑)
- [2. AGENTS.md:一份文件引发的血案](#2. AGENTS.md:一份文件引发的血案)
-
- [2.1 反面教材:读,都给我读](#2.1 反面教材:读,都给我读)
- [2.2 正面教材:给上下文建一张路由表](#2.2 正面教材:给上下文建一张路由表)
- [3. Skill 的真相:description 才是路由器](#3. Skill 的真相:description 才是路由器)
-
- [3.1 先递名片,再谈生意](#3.1 先递名片,再谈生意)
- [3.2 激进哲学:1% 的可能,也要上](#3.2 激进哲学:1% 的可能,也要上)
- [4. 那些过时的祖传规矩](#4. 那些过时的祖传规矩)
-
- [4.1 测试狂魔](#4.1 测试狂魔)
- [4.2 万事请示](#4.2 万事请示)
- [5. 结论:把配置维护当成迁移的一部分](#5. 结论:把配置维护当成迁移的一部分)
P.S. 目前国内还是很缺AI人才的,希望更多人能真正加入到AI行业,共同促进行业进步,增强我国的AI竞争力。想要系统学习AI知识的朋友可以看看我精心打磨的教程 传送门http://blog.csdn.net/jiangjunshow,教程通俗易懂,高中生都能看懂,还有各种段子风趣幽默,从深度学习基础原理到各领域实战应用都有讲解,我22年的AI积累全在里面了。注意,教程仅限真正想入门AI的朋友,否则看看零散的博文就够了。
前言
先说个事:OpenAI 放话了,从 GPT-6 开始,你攒的那些 Skill 和 AGENTS.md,该大扫除了。
我看到这消息的第一反应是:啊?我还没攒够呢,你就要我扔?我家 C 盘都没这么乱过。
1. 模型越听话,你越容易遭殃
这事特别反直觉:模型越强,越会遵守指令,你以前攒下的"优良传统"就越容易出事。以前是你说东它往西,现在是你眨个眼,它都当圣旨执行。
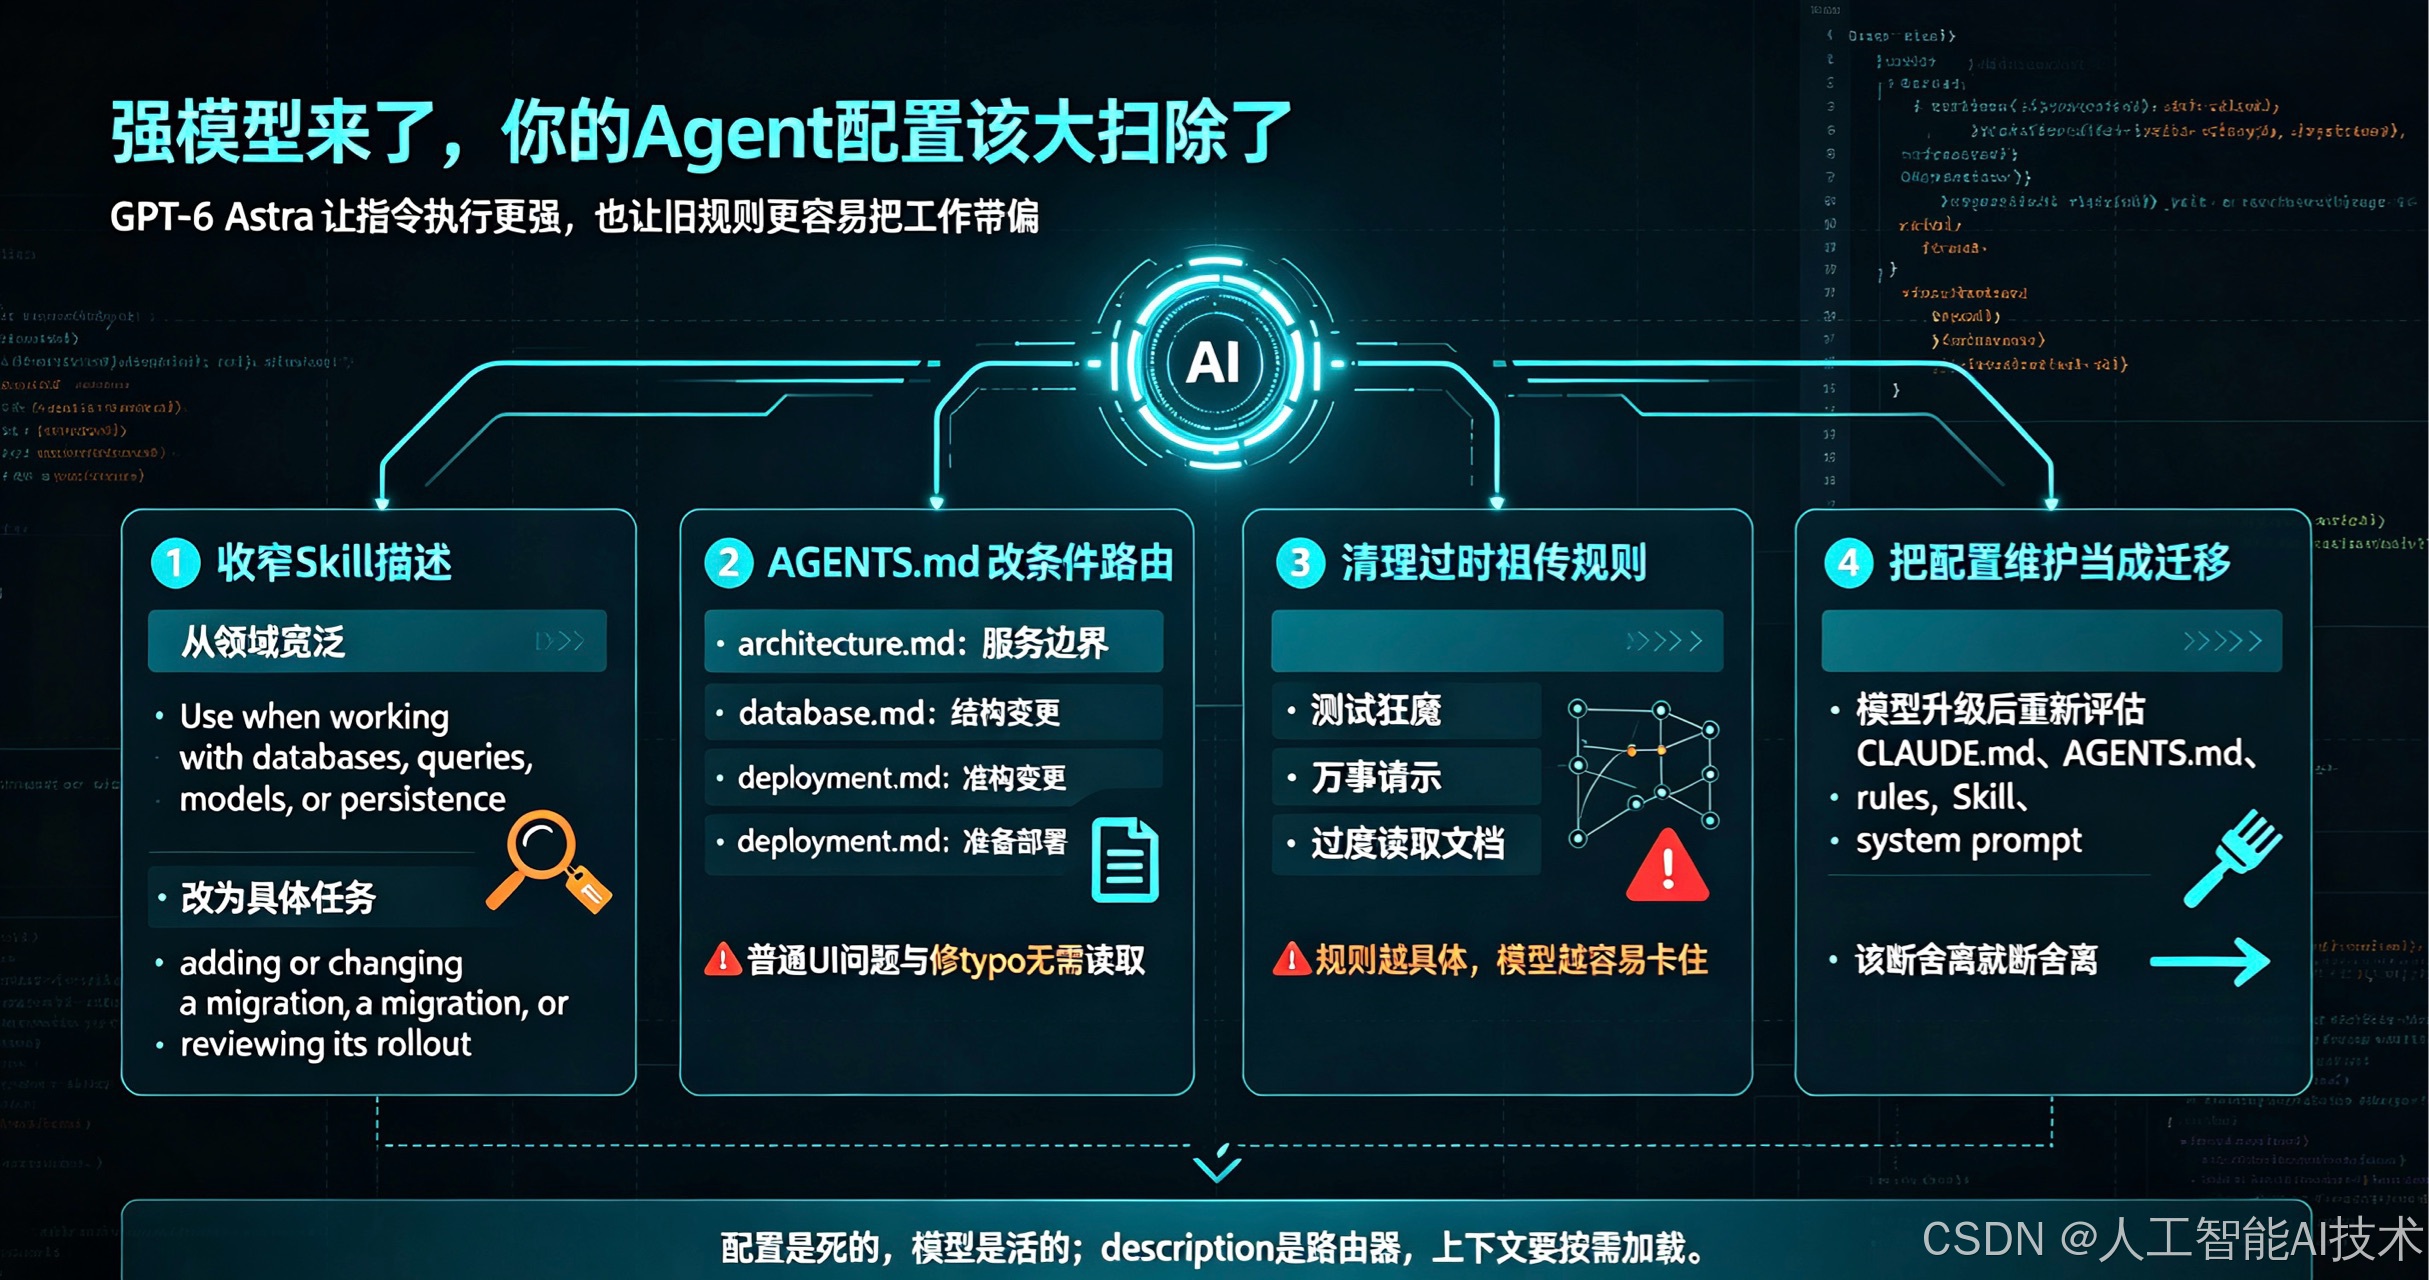
官方这次也承认了:GPT-6 Astra 的 instruction following 比前代强一大截,所以更容易被 Skill、AGENTS.md 里的规则带跑。模糊的、互相打架的、范围大到没边的规则,会让它提前停下来问你,问着问着干脆卡住,活也不干了。
翻译成人话:你请了个执行力爆表的员工,然后亲手把岗位说明书写成了脑筋急转弯。
1.1 官方那个反面教材
官方自己举过一个例子。有个 Skill 的描述是这么写的:
Use when working with databases, queries, models, or persistence.覆盖范围大不大?大。有用吗?没有。你只是想改个 ORM 字段名,或者修一条普通的 query,模型一看:数据库?query?这题我会!当场把 migration Skill 拉进上下文,后面跟一大串规则、检查步骤、参考资料,浩浩荡荡全进来了。
就像你去便利店买瓶水,店员以为你要承包整条供应链,给你拉来一车货,还附赠一份物流方案。
官方推荐的版本长这样:
adding or changing a migration, or reviewing its rollout区别在哪?它描述的是"具体任务",不是"一片领域"。触发条件一收窄,模型就不会逮着谁都问"您是不是要上系统"。省下来的,可都是白花花的 token。
1.2 描述写太宽,为什么这么坑
有人觉得,描述写宽点怎么了,模型聪明着呢,会自己判断。问题是它太聪明了,聪明到把"可能相关"和"就是相关"当成一回事。
一个 PostgreSQL migration 的 Skill,你要是写"处理数据库、query、model 或 persistence 时使用",它干任何沾边的事都想把迁移手册翻出来,比老太太翻黄历还勤快。
2. AGENTS.md:一份文件引发的血案
2.1 反面教材:读,都给我读
现在很多 AGENTS.md 还是这种画风:
Before every edit, read architecture.md, database.md, and deployment.md.这条规则以前有用,因为早期的 Agent 是真不会主动找文档,你只能把饭喂到嘴边,还得补一句:张嘴。
现在呢?你改一个字符串,它把三个 md 从头读一遍;再改一个字符,它又从头读一遍。一天改两百次,它就读两百遍。除了浪费 token、拖慢进度,毫无意义,上下文还像吹气球一样膨胀,膨胀到最后它开始自己骗自己,幻觉比梦话还离谱。
这画面像什么?像你妈当年逼你"每写一个字之前先把新华字典翻一遍"。你憋了五百字的作文,你妈在旁边翻了五百遍字典,最后还问你:作业怎么还没写完?
2.2 正面教材:给上下文建一张路由表
官方推荐把它改成条件触发:
Use architecture.md for service boundaries, database.md for schema changes, and deployment.md when preparing a deployment.说白了就是给模型建一张"上下文路由表":
- 改 service boundary → 读 architecture.md
- 改 schema → 读 database.md
- 准备部署 → 读 deployment.md
- 普通 UI bug → 都不用
- 修一个 typo → 都不用
修 typo 都不用,这待遇,比我当年上班强多了。
这套东西有个正经名字,叫 Harness 工程,意思是给模型一套精准的上下文索引和项目约束。名字听着高级,本质就一句话:别让它瞎翻,翻到有用的为止。
3. Skill 的真相:description 才是路由器
3.1 先递名片,再谈生意
很多人有个误解:项目里放几十个 SKILL.md 有什么关系,需要的时候模型自然会加载。
实际上现在的 Codex 用的是 progressive disclosure,翻译过来就是"先递名片,再谈生意"。启动的时候,模型手里只有每个 Skill 的 name 和 description,顶多再带个文件路径。它先判断这单跟谁有关,判断上了,才去读完整的 SKILL.md。
所以 description 是什么?它就是 Skill 的路由器。你把描述写成小区门口那种"本店经营各种商品",那模型就只能挨家挨户敲门。
3.2 激进哲学:1% 的可能,也要上
老牌的 Superpowers 里有个 using-superpowers,写得特别激进:只要有 1% 的可能某个 Skill 适用,就必须调用;回复之前、澄清之前、浏览代码之前、检查文件之前,全都得先过一遍 Skill 判断。
你品品这个流程。这是干活吗?这是过安检,还是那种连拖鞋都要脱下来检查的安检。
作者后来自己调整过,但在现在的强模型面前,这种"约束哲学"确实没什么必要了。它会把模型从高概率的自然轨迹上硬拽到一条规定的跑道上,还要求它边跑边喊口号。模型不知道什么时候该判断,判断着判断着,活就"干完"了------当然,是它自己觉得的。
4. 那些过时的祖传规矩
4.1 测试狂魔
再看一类很经典的 AGENTS.md:
Always run tests after every change.
Always verify your implementation.
Never finish until all tests pass.
这条以前是宝贝,因为老模型你不催,它真不跑测试。但 Astra 这个级别,天生就爱验证,你再写这种规则,它就会变成测试狂魔:你改了个注释,它能给你跑俩小时用例。
就好比你雇了个特别负责任的厨师,然后天天叮嘱他"记得洗锅"。他记住了,锅洗得那叫一个勤快,就是菜老上不来。
4.2 万事请示
还有一类,把"需要确认"的范围写得特别宽:
Ask before modifying additional files.
Ask before making architectural decisions.
Ask before running commands that change the repository.
这些规则在老模型上确实能拦住它乱来。但到了 Astra 这里,它可能把你每个正常动作都当成重大决策,然后小心翼翼地问你:请问,我可以保存这个文件吗?
你感受一下这个画面。你请了个助手,他每走一步都要问你"我左脚先迈可以吗"。要命的是,你还真没理由骂他------规矩是你自己定的。
5. 结论:把配置维护当成迁移的一部分
所以现在的真实情况是:模型在进化,而你一年前攒下的 CLAUDE.md、AGENTS.md、rules、Skill、system prompt,可能全都变成了上个时代的产物。就像去年买的衣服,今年再看,尺码没变,气质变了。
每次模型升级之后,都应该把整套配置翻出来重新评估一遍:哪些规则还成立,哪些已经变成负资产。这活儿叫 prompt maintenance,得当成模型迁移的一部分来办,不能当成一劳永逸的装修。
网上有句话我特别认同:只要你学得够慢,你就不用学了。
但配置不是。配置是死的,人是活的。模型都学会精简了,咱的 AGENTS.md 也别守着那堆陈年旧规过日子了------该断舍离就断舍离。毕竟下一个版本,可能连你删配置的方式,都要被优化了。
P.S. 目前国内还是很缺AI人才的,希望更多人能真正加入到AI行业,共同促进行业进步,增强我国的AI竞争力。想要系统学习AI知识的朋友可以看看我精心打磨的教程 传送门http://blog.csdn.net/jiangjunshow,教程通俗易懂,高中生都能看懂,还有各种段子风趣幽默,从深度学习基础原理到各领域实战应用都有讲解,我22年的AI积累全在里面了。注意,教程仅限真正想入门AI的朋友,否则看看零散的博文就够了。