我是安徽最忧郁程序员无隅
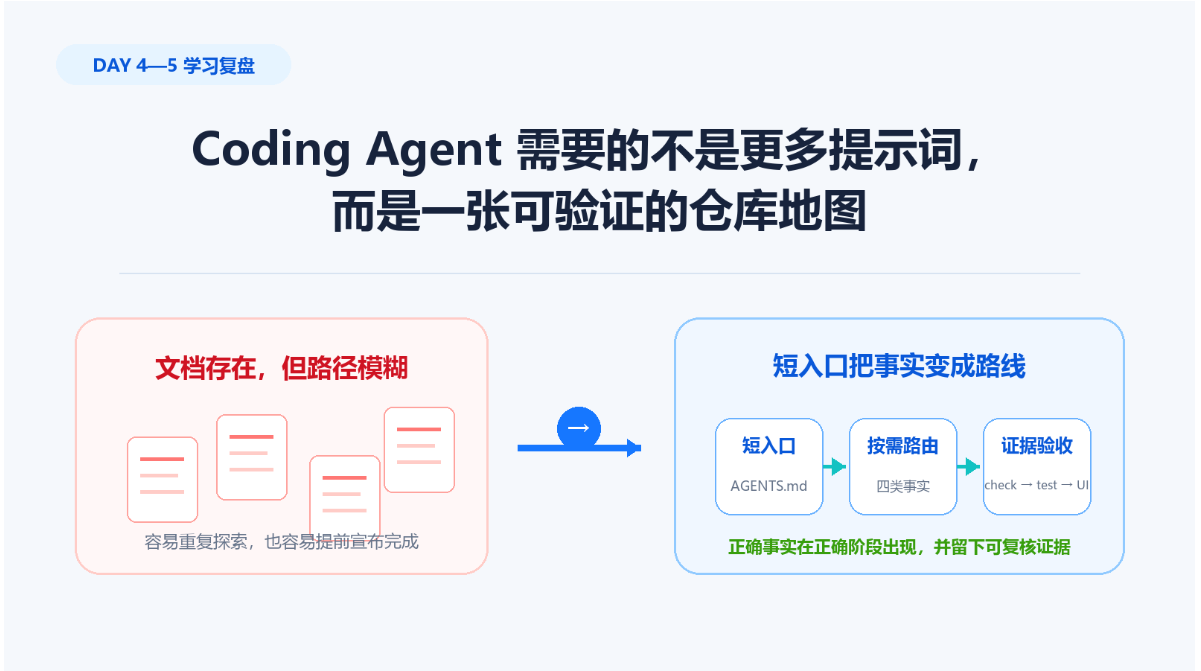
让 Coding Agent 修复一个 UI 文档导入入口,任务不大,却很适合观察 Harness 是否真的有效。
两天使用的是同一句任务:
修复 UI 文档导入入口。
Day 4 观察较弱的仓库引导,Day 5 在相同代码起点上增加短入口与验证文档。实验让我确认了一件事:Agent 缺的往往不是更多提示词,而是一条从任务通向项目事实、再通向完成证据的清晰路线。
一、从一个小任务看见 Harness 的真正问题
"仓库是唯一事实来源"很容易被理解为"多写几份文档"。其实不够。
对于一个全新 Agent 会话,真正有用的仓库至少要让它回答五个问题:
- 这是什么系统?
- 代码怎样组织?
- 应用怎样运行?
- 当前工作做到哪里?
- 什么证据满足后才算完成?
这些答案可能分别存在于架构文档、产品说明、功能清单和命令脚本里。问题是,Agent 是否知道什么时候读哪一份,以及冲突时应该以谁为准。
这就是"知识存在"和"知识可用"的差别。
假设仓库里有 ARCHITECTURE.md,但入口没有告诉 Agent:修改 Electron 跨层调用前必须读它。那么这份架构文档虽然存在,却不一定能进入本次任务的决策过程。feature_list.json 也是一样:它可以记录状态,但如果状态变化不绑定验证证据,pass 就可能只是一句提前写下的结论。
所以,仓库成为事实来源至少需要三层能力:
- 可发现:新会话知道事实放在哪里。
- 可路由:当前任务只加载相关事实,不把所有资料一次塞进上下文。
- 可验证:状态变化必须对应命令、测试或真实操作证据。
二、Day 4:仓库里有文档,Agent 为什么仍会走弯路
Day 4 的实验仓库并不是"没有文档"。它已经包含 AGENTS.md、ARCHITECTURE.md、PRODUCT.md 和 feature_list.json。原始入口还列出了启动命令、四层目录和几条工程约束。
这意味着不能把后续所有时间都归因于"仓库知识缺失"。更准确的观察是:已有资料没有形成完整的信息路线,尤其缺少明确的完成边界。
任务发出后约 5 分 17 秒,Agent 引用 feature_list.json 确定了范围,并提出路径兼容方案。功能清单确实发挥了作用,它让 Agent 没有完全摸黑。
随后,流程经历了实施确认、设计文档提交、继续确认,以及是否建立隔离工作区的询问。这里要把几类时间分开:
- 阅读和调查时间;
- 等待人工批准的时间;
- 编写设计与计划的时间;
- 安装依赖的时间;
- 真正修改产品代码的时间;
- 执行验证的时间。
如果把这些阶段合并成一个总时长,就无法判断仓库地图究竟减少了哪部分成本。Day 4 没有准确记录第一次有效产品修改的时间,因此不能据此计算提速比例。
更关键的问题出现在完成声明上。Agent 报告测试、类型检查和构建通过,新增测试也覆盖了路径转换、空路径拒绝以及模拟的 Electron IPC 行为。这些结果有价值,却仍然没有证明一件事:用户在真实 Electron 窗口点击导入按钮后,是否真的能选择文件,并在列表里看到导入结果。
当时 document-import 已被标记为 pass,但没有学习者独立完成真实 UI 导入的证据。状态走在了证据前面。
因此,Day 4 最终记录为 skipped,而不是 passed。首次有效修改时间、真实 UI 验收和学习者独立机制总结都没有补齐。实验停止可以记录,证据缺失也可以记录,但二者都不能改写成通过。
三、Day 5:让短 AGENTS.md 成为上下文路由器
Day 5 没有沿用弱组修改后的代码,而是重新从同一原始代码起点建立实验组。产品代码、架构文档、产品文档、功能清单和样例文件都保持不变,只调整了两类 Harness 资料:
- 把根目录
AGENTS.md改成短入口和条件路由器。 - 新增
VALIDATION.md,单独定义验证层级与完成标准。
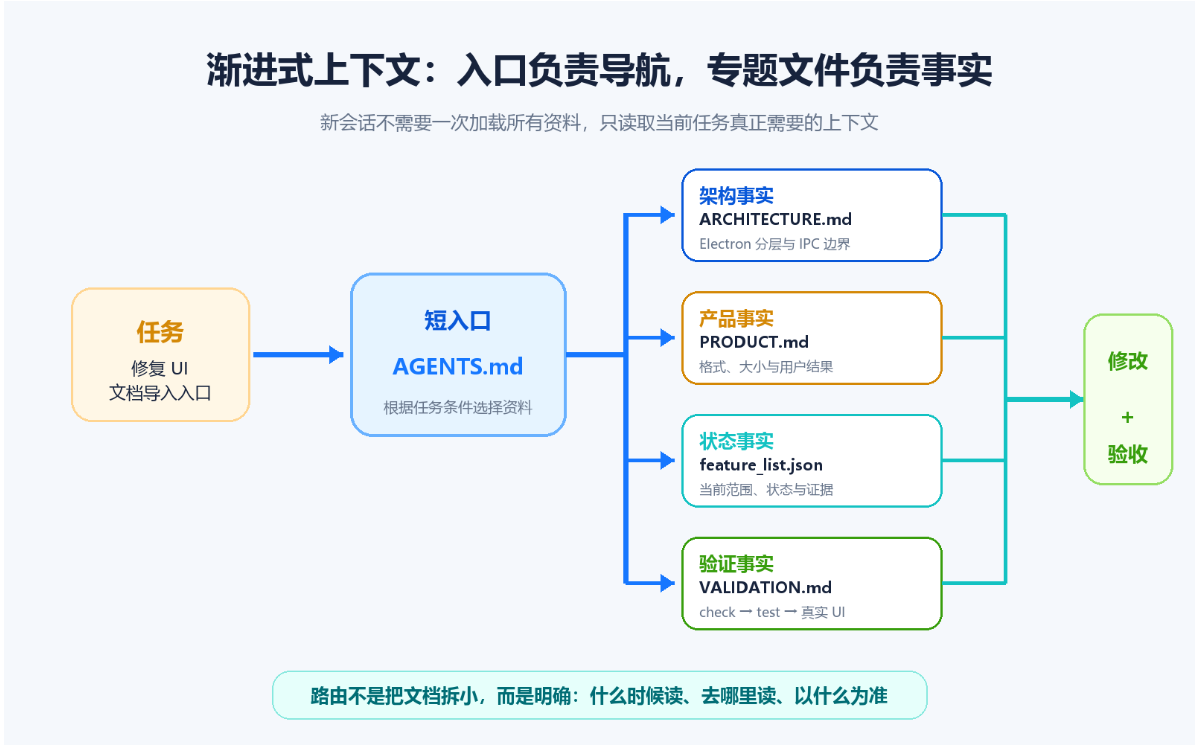
这次的 AGENTS.md 不再试图解释整个项目,只保留四类内容:
- 一句话说明这是一个 Electron + React 本地知识库应用;
- 根据任务类型路由到架构、产品、状态和验证文件;
- 提供安装、检查、测试和启动命令;
- 声明少量全局硬约束,例如尊重 Electron 分层、IPC 通道以共享类型文件为准、没有证据不得标记完成。
各专题文件分别回答不同问题:
| 文件 | 负责回答什么 |
|---|---|
AGENTS.md |
当前任务应该去哪里读取信息 |
ARCHITECTURE.md |
Electron 主进程、preload、renderer 和 service 的边界 |
PRODUCT.md |
支持的文件格式、大小限制和用户可见结果 |
feature_list.json |
当前功能范围、状态与已有证据 |
VALIDATION.md |
完成前必须经过哪些验证层 |
这不是把一个大文件机械拆成几个小文件。拆分本身不会自动提高质量,真正有用的是条件路由:什么时候读、去哪里读、以什么为准。
在正式修改代码前,我先开了一个全新只读会话,要求 Agent 根据仓库回答项目类型、Electron 分层、导入约束、功能状态和验证层级五个问题。它约 2 分 35 秒完成回答,逐项指出信息来源,且没有修改工作区。
这个探针只证明"项目事实能够被新会话发现",不证明产品已经正确。随后另一个全新任务才接收原始修复要求。最终,类型检查、自动测试和构建均以退出码 0 完成;学习者再用固定样例 retrieval-plan.md 操作真实 Electron UI,文件成功出现在列表里,并显示大小、导入状态和导入时间。
直到这一刻,产品功能才获得完整验收证据。
四、验证边界:产品通过,不等于因果实验成立
对于这次桌面应用实验,验证分成三层:
text
类型检查 -> 自动测试 -> 真实 UI 工作流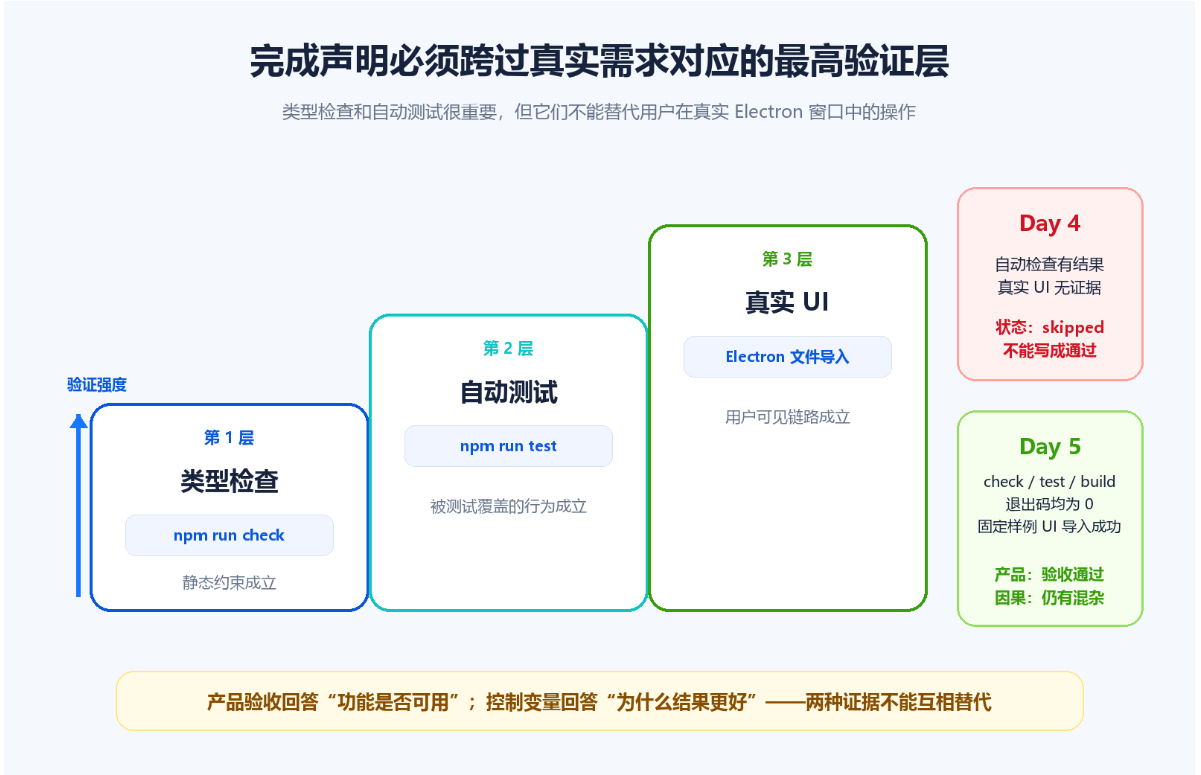
类型检查证明静态类型约束成立;自动测试证明被覆盖的函数或模拟链路成立;真实 UI 才能证明用户从界面触发的文件选择、跨进程通信和列表更新能够连起来。
下层验证不能替代上层验证。 对 CLI 工具,最高层可能是从干净目录执行完整命令;对 Web 服务,可能是真实 HTTP 请求;对 Electron 应用,这次对应的是实际窗口操作。最高验证层要由用户需求决定,而不是由哪个测试最容易运行决定。
Day 5 的产品结果比 Day 4 完整,但我仍然不能说"短 AGENTS.md 单独导致了成功"。实际实验还存在几项混杂变量:
- 两组使用的技能和工作流程没有做到完整一致;
- 人工干预方式不同;
- 强组任务中途读取了学习任务,破坏了严格隔离;
- 弱组缺少可靠的首次有效修改时间。
因此,这次实验能够支持两个不同层次的结论:
- 产品结论:Day 5 的导入功能通过了自动检查和学习者真实 UI 验收。
- 因果结论:实际强弱组比较存在混杂,不能把全部改善单独归因于文档路由。
Day 5 的学习闸门能够通过,是因为学习者不仅说出了短入口的作用,还能在新的控制变量场景中判断:只有代码起点、任务、模型设置、流程、人工干预、时间和样例都一致,仅改变文档路由时,才更有把握进行因果归因。
把这两天的经验迁移到其他项目,可以直接做四件事:
- 用全新会话五问检查仓库,而不是只统计文档数量。
- 让
AGENTS.md负责导航,把架构、产品、状态和验证事实分开放置。 - 在实验开始前声明验证层级,明确哪一层对应真实用户需求。
- 让每次状态变化绑定可复核证据;没有记录就写未知,主动停止就写
skipped,证据不足就保留为待验证。
Day 4 让我看到,文档存在不等于上下文可用;Day 5 则让我理解,渐进式上下文的关键不是"少读",而是"在正确阶段读正确事实"。
最后把整套机制浓缩成一句话:
好的 Coding Agent Harness,不是给模型塞进更多知识,而是让正确的事实在正确的阶段出现,并用真实证据约束"什么时候才算完成"。