数据并不总是躺在数据库或现成的表格里。一些系统至今仍以 XML 对外交换数据------门户的频道订阅、电商的回传报文、对账明细、第三方接口的返回体;更多时候,一段 XML 就贴在一份文档、一个日志或一次接口调试记录里。表格使用者要把这些内容用起来,常见做法是先导出、再交给脚本或在线工具清洗成表,然后导入。中间隔着好几道手工,每次数据刷新都要重来一遍。
SpreadJS 在 V19.2 中加入的 FILTERXML 函数,是想把这中间的环节省掉:只要单元格里有一段结构完整的 XML 文本,就可以直接在这张表里对它取值,不必先转换成别的东西。函数做的是两件事------把 XML 解析成可检索的结构,再按一段定位路径从里面取出想要的内容。
一条路径,取一段内容
XML 之所以适合程序交换,在于它的内容是被标签一层层包起来的。取哪一层、取哪个节点,取决于一条定位路径。FILTERXML 的用法,就是给解析后的结构配一条路径,让它把命中的内容取出来。
路径能表达的筛选相当灵活。它可以按名字取一类节点,比如把整段结构里所有"标题"取出来;可以按位置取,比如第一本书的标题、最后一本书的标题;也可以按条件取,比如只取价格高于某个数的那几本书的标题。除了取元素本身,还能取元素的属性值------商品的编号、记录的日期、分类的代码,这类信息往往就存在属性里。路径的能力边界,决定了取数的边界;而这些筛选,都已经在函数内得到支持。
拿一段书目来打比方,一条路径就能划出几种取法:把全部书名一口气取回,只取第一本或最后一本的标题,只取价格高过某个数的那些书名,也可以顺着"标题里含某个字词"这样的条件去筛。XML 里还常见另一类信息------商品编号、记录日期、分类代码------它们不是标签包着的内容,而是挂在标签上的属性,路径同样取得回来。同一段结构,路径画到哪里,取到的就是哪一块,函数只在旁边照做。
路径写的具体规则,属于 XPath 这一套查询语言,使用者不必重新发明,熟悉的人可以照常使用。对不熟悉路径语法的使用者来说,更常用的直觉是"从结构里把某一部分抓出来",其余交给函数处理。
取回的可能是一串
需要注意的一点是:命中的内容未必只有一个。路径若指向一类节点,取回的就是一串结果。SpreadJS 的动态数组机制在这里接手------多个结果会顺次铺入相邻的单元格,像普通数组公式的结果一样自然展开,而不必预先圈定区域。单个结果则落在一个单元格里。到底是单值还是整串,由路径决定,函数返回后表里直接可见。
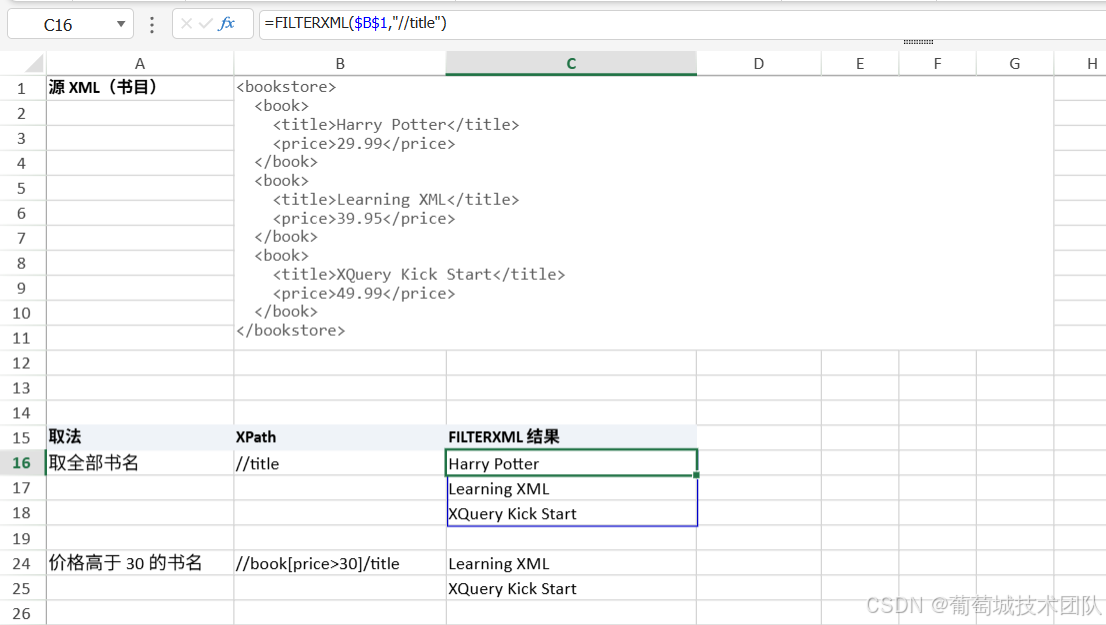
对这种"返回的是一串"的使用者,动态数组的好处在于不用预先算好结果有几个、也不用为多个结果提前占好格子------结果自己决定占用几格。这与把 XML 交给其他途径处理时"要么手动拆、要么另写脚本"的体验形成了对照:在表格里,取数与展开是连着发生的两件事,中间没有转手的环节。
对取不到内容的情形,处理也明确:路径写得不合法、数据取不到,或 XML 本身不是有效结构------包括带了无效前缀的命名空间------这些情形都会返回明确的错误值,而不会静默地交出一份看似正常、实则缺了内容的返回值。使用者由此知道这条路没走通,不必对着一个"好像对又好像少"的结果去猜。
顺着数据把内容带进表
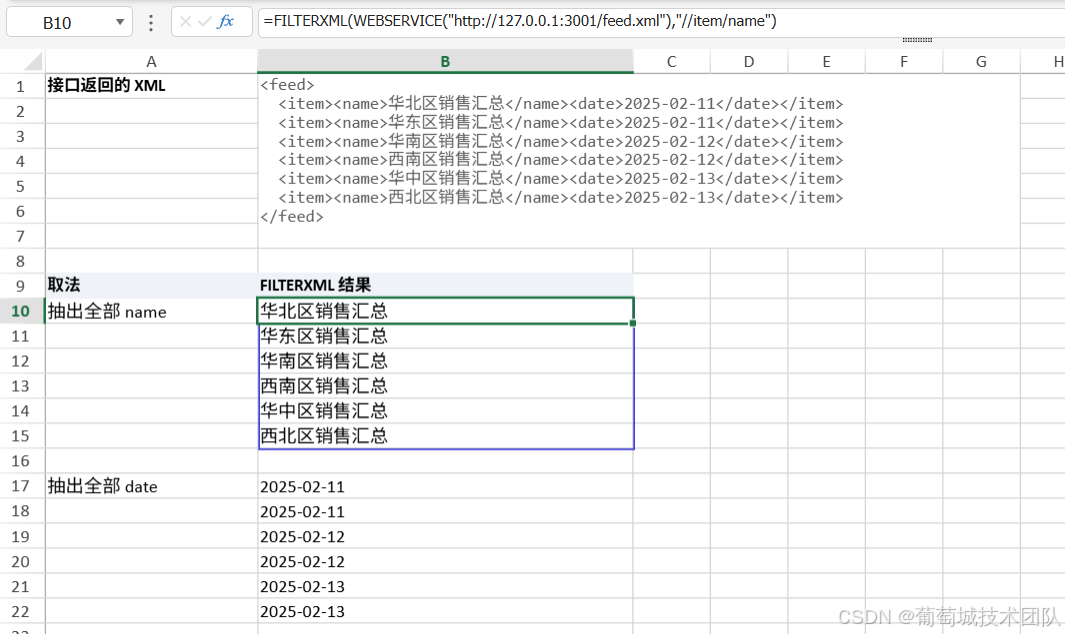
FILTERXML 真正顺手的地方,是它可以和取数的环节连起来。单元格里存的 XML,既可以是手工放进或粘贴来的文本,也可以来自另一个函数的结果------SpreadJS 支持从网络地址取回内容(Wevservice函数),于是"拉取远程 XML 再就地解析"可以一步完成:先取回一段在线数据,再在同一单元格所在的公式里按路径抽出需要的字段。订阅源的更新、接口返回的条目,刷新一次即可带进表格,省去了下载、清洗、导入的整段流程。这份省力还随数据的更新频率放大:目录、行情、公告这类内容会反复变化,而"取回"与"解析"写成一处之后,每次数据一变,让表格刷新一遍,结果就跟着刷新------那条定位路径从头到尾只写过一次,之后每次跑的都是同一套逻辑。对常与这类接口数据打交道的报表制作者,这比每次变化都手动重走一遍下载、清洗、再导入,省下的重复劳动不止一点。
与 Excel 之间的分寸
FILTERXML 是一组与 Excel 同名函数的一部分,功能对齐之外,边界也要说明。Excel 对单元格文本设有三万二千余字符的长度上限,超长的内容会被截断,函数引用的便是不完整的 XML,取数随之失败;经网络接口取回的超长返回体在 Excel 中同样会触发错误,连带引用它的函数一并报错。SpreadJS 对这两类超长内容的处理路径与 Excel 不同,因此两端在个别极端数据上可能出现结果不一致。差异源于各自实现的约束,并非功能缺欠------对绝大多数日常数据,函数行为保持一致。
放在更大的图景里,FILTERXML 补上的是表格对"半结构化数据"的处理能力。数据交换的世界里,不是所有内容都以整齐的行列到达;当一段带着标签层级的内容出现在眼前时,能直接在表里把它读出来,比绕道脚本与转换工具,到底省事得多。XML 也许不像从前那样无处不在,但只要它还在数据链路里出现,这张表就多了一条直接面对它的路。