上篇讲了 RabbitMQ 的骨架:AMQP 模型和 Erlang 进程架构。这一篇我们换个问法:一条消息进入 RabbitMQ 之后,到底安不安全?
这个问题会带着我们走完五层:消息存在哪、内存满了怎么办、服务器重启还在吗、节点挂了还在吗、它会被正确处理吗。每一层都是下一层的前提。
引子:一条消息进来之后
上篇说到,消息经过 Exchange 路由后,进入了一个 Queue 进程。Queue 进程是单线程的,它负责把消息存下来、投出去。
但你有没有想过:
- 消息到底存在哪里?内存还是磁盘?
- 如果内存满了,会怎么样?
- RabbitMQ 重启,消息还在吗?
- 集群里挂了一个节点,消息还在吗?
- 消费者处理失败了,消息会丢吗?
这五个问题,就是这篇要一层层回答的。
第一层:消息存在哪里
先破除一个误解
"RabbitMQ 把消息存在内存里"------这是一个流传很广的误解。
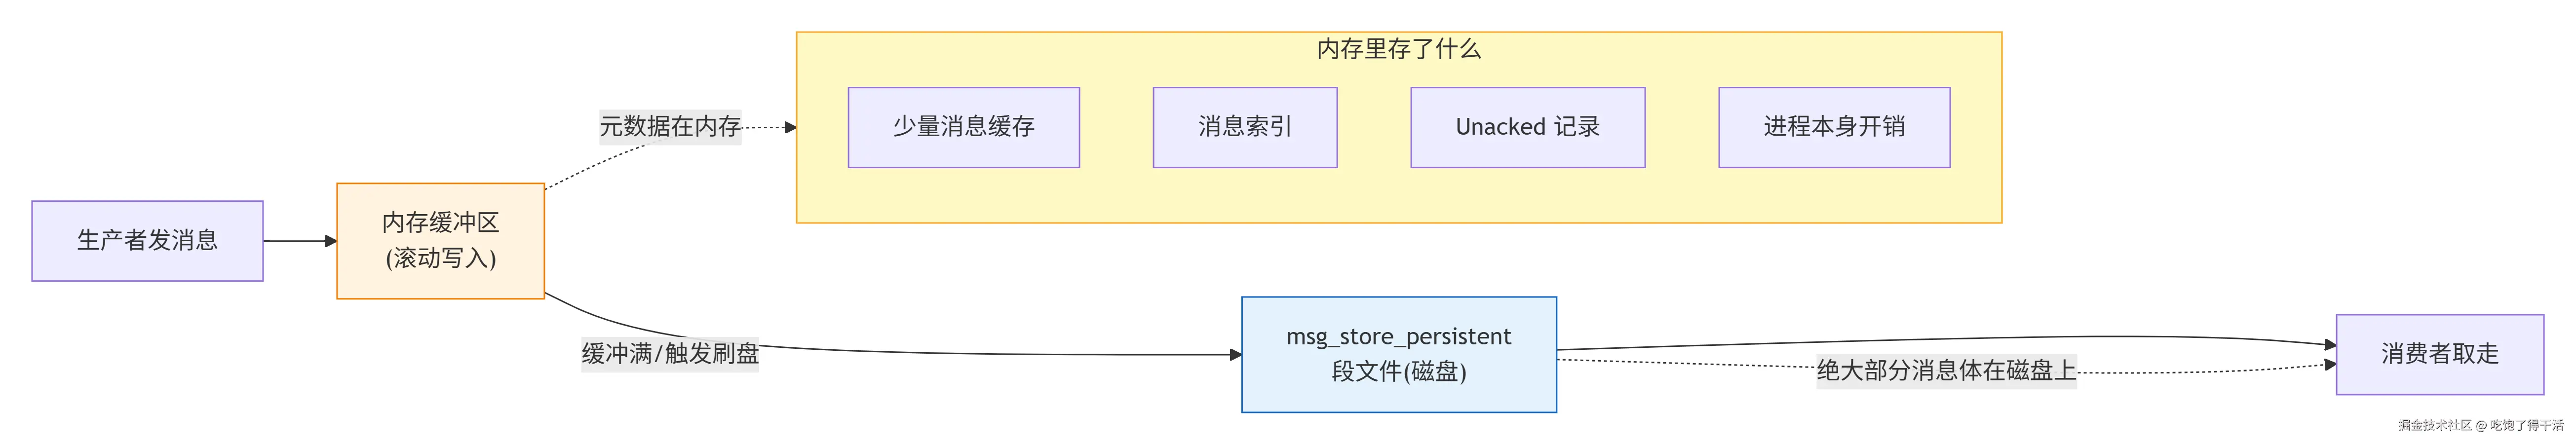
RabbitMQ 中,消息几乎总是写到磁盘上,内存只是处理过程中的缓冲区。
消息到达后,先进入一个小型内存缓冲区,缓冲区满了或达到一定操作次数后,批量刷写到磁盘。
这意味着:发布 1GB 消息到一个没有消费者的队列,RabbitMQ 不会占用 1GB 内存。内存里最多是缓冲区和部分缓存的消息,绝大部分数据在磁盘上。
那为什么内存占用还是很高
因为磁盘存储的索引结构 、消息的元数据 、每个消费者的未确认记录 、以及 Erlang 进程本身的栈和 Mailbox,都占用内存。
消息体在磁盘上,但"关于消息的管理信息"在内存里。这就是为什么一个堆积了几百万条消息的队列,内存占用可能只有几十 MB,但文件系统上已经有几个 GB 的数据。
到这里第一层回答了:消息主要在磁盘上。
但新问题来了:如果消息持续进来,内存缓冲区一直刷盘,内存使用会不会失控?于是进入第二层。
第二层:内存满了怎么办
内存高水位线
RabbitMQ 有一个可配置的 内存高水位线 ,默认是可用内存的 40% (vm_memory_high_watermark = 0.4)。
当节点内存使用超过这个阈值时,RabbitMQ 会做两件事:
第一,触发发布者流控。 所有正在发布消息的连接进入 blocking 状态,生产者发不进去消息。
第二,触发分页(Paging)。 把队列内存中缓存的消息更多地刷到磁盘上,腾出内存。
一个重要的行为特征
内存水位线触发的是集群范围的阻塞。一个节点内存超了阈值,即使其他节点内存充裕,整个集群的生产者都可能被阻塞。
这不是 bug,而是设计------防止一个节点 OOM 被操作系统杀掉,导致更严重的数据不一致。
到这里第二层回答了:内存满了会触发流控,生产者被阻塞。
但新问题来了:如果 RabbitMQ 服务器重启,磁盘上的消息还在吗?于是进入第三层。
第三层:服务器重启,消息还在吗
持久化的三个层次
消息不丢,需要三个层次同时成立,缺一不可:
- 交换机持久化 :
ExchangeBuilder.durable(true),交换机元数据写盘; - 队列持久化 :
QueueBuilder.durable(...),队列元数据写盘; - 消息持久化 :
setDeliveryMode(PERSISTENT),消息体写盘。
三者缺一不可。少了一层,重启后相关数据就丢了。
一个容易被忽略的细节
即使消息是持久化的,如果发布者没有收到 Publisher Confirm,在 Broker 崩溃时这条消息仍然可能丢失。
Confirm 的语义是"Broker 已经接管了这条消息的责任"。没有 Confirm,责任就还在网络传输中。
还有一个更深的细节
消息进入队列后,Queue 进程负责把它写入磁盘。但这个写入是批量刷盘的,不是每条消息单独 fsync。
text
持久化消息的一生:

  Queue 进程内存缓冲区
         │
         │ 批量刷盘(不是每条都 fsync)
         ▼
  msg_store_persistent
  ┌────────────────────┐
  │ 段文件 1            │
  │ 段文件 2            │
  │ ...                 │
  └────────────────────┘

  极端情况(操作系统崩溃):
  最近几毫秒内 Confirm 过的消息可能还没落盘
这也是为什么 RabbitMQ 官方文档坦诚地说:即使收到了 Confirm,服务器崩溃时消息在理论上仍可能丢失。
到这里第三层回答了:持久化分三层,但批量刷盘仍有理论上的丢失窗口。
但新问题来了:单机重启问题解决了,如果是集群,挂了一个节点呢?于是进入第四层。
第四层:集群里挂了一个节点,消息还在吗
先理解集群里什么是共享的
在 RabbitMQ 集群中,交换机、绑定、用户、权限、vhost 这些元数据在所有节点上保持一致。3.x 时代由 Mnesia 存储,4.2 之后默认用 Khepri(基于 Raft 的元数据存储)。
但消息数据不是集群共享的。一个队列的消息体只存在于它所在的节点(以及可能的副本节点)上。如果队列所在的节点挂了,而队列没有副本,消息就不可用了。
镜像队列:为什么它被放弃了
镜像队列(Mirror Queue)是早期的高可用方案。工作方式是:主队列 + 多个从队列,所有从队列都保存成功后,主队列才向生产者发送确认。
这个设计有两个致命缺陷:
- 节点恢复后数据不同步:节点下线又上线,从队列数据全部丢失,恢复后是空队列,运维必须手动决定是否触发同步;
- 同步是阻塞的:触发同步时,整个队列不可用,生产者和消费者都被阻塞。堆积几百万条消息时,同步可能持续几分钟甚至几小时。
镜像队列的本质问题是:它用的是链式复制算法,没有共识机制,同步行为是破坏性的。
Quorum 队列:Raft 带来的改变
Quorum 队列从 RabbitMQ 3.8 引入,基于 Raft 共识算法。它与镜像队列的核心差异是"确认范围":
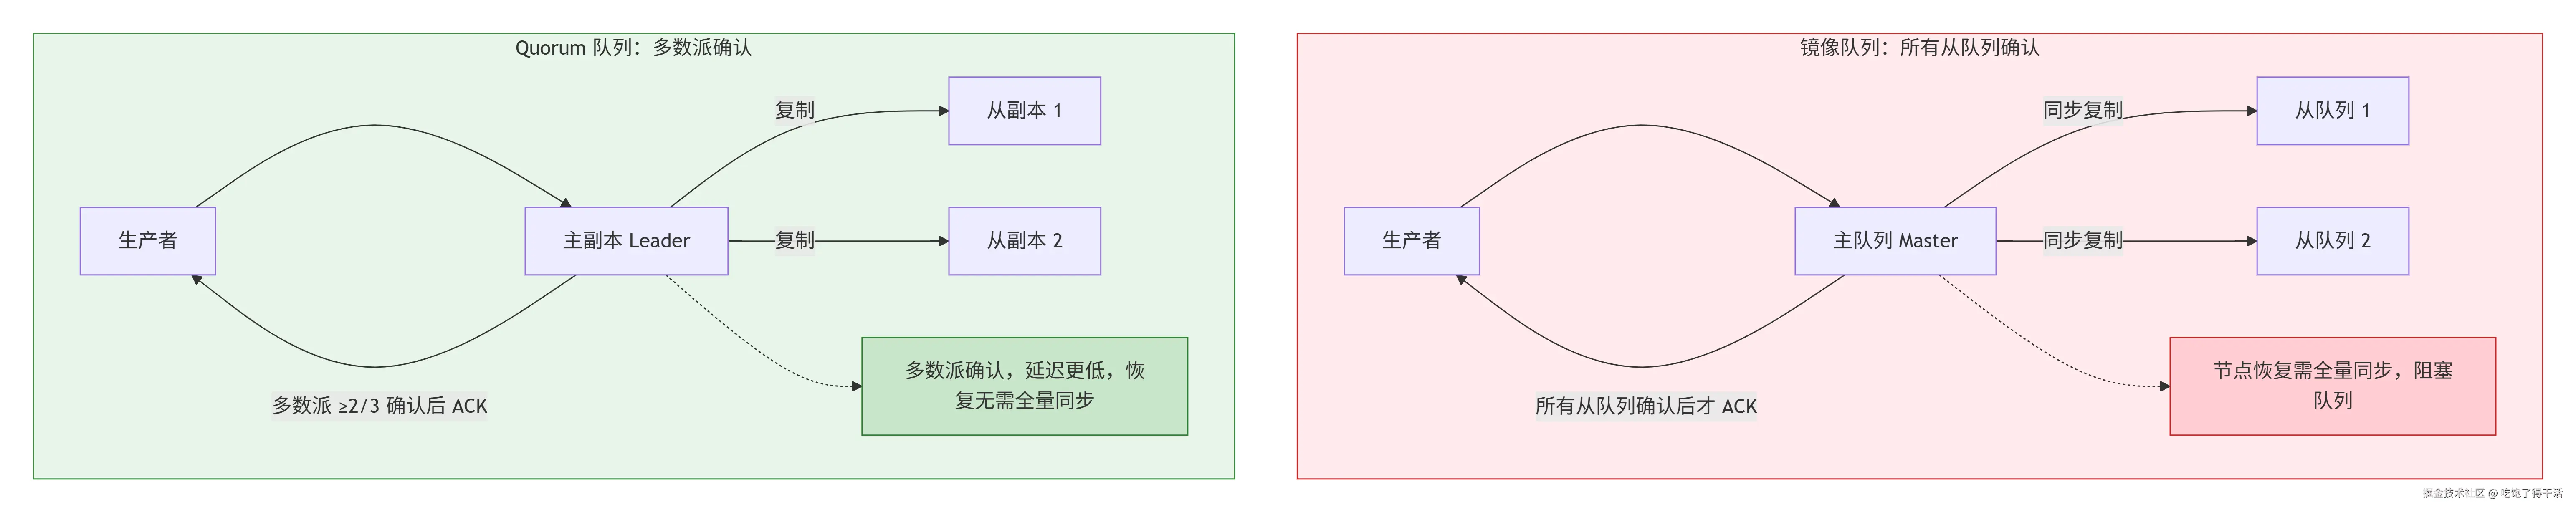
Raft 的核心思想是多数派确认 。一个 Quorum 队列有多个副本(通常 3 或 5 个),主副本接收消息后复制到从副本,当多数副本确认保存后,才向生产者发送确认。
与镜像队列的"所有从队列确认"不同,Quorum 队列只需要多数派(3 副本中的 2 个,5 副本中的 3 个)确认。好处是:
- 更低的确认延迟:不需要等最慢的那个副本;
- 更安全的故障恢复:Raft 有严格的日志一致性保证,节点恢复后不需要"阻塞式全量同步";
- 更好的性能:Raft 的日志复制是流水线式的,不是链式的。
代价是:只支持持久化消息、不支持优先级队列、不支持部分 TTL 用法、至少需要 3 个节点。
节点数的含义
Quorum 队列的"多数派"要求决定了节点数:
- 1 节点:无高可用;
- 2 节点:挂 1 个 → 失去多数派 → 不可用;
- 3 节点:挂 1 个 → 还有 2/3 → 可用(最低配置);
- 5 节点:挂 2 个 → 还有 3/5 → 可用(高可用场景)。
生产环境的 RabbitMQ 集群,3 节点是起步,5 节点是高可用场景的常见选择。
到这里第四层回答了:Quorum 队列用多数派确认保证节点故障时消息不丢。
但新问题来了:消息存得好好的,消费者处理失败了怎么办?于是进入第五层。
第五层:它会被正确处理吗
三段独立确认
RabbitMQ 的可靠性不是"一个开关",而是三段独立确认的叠加。
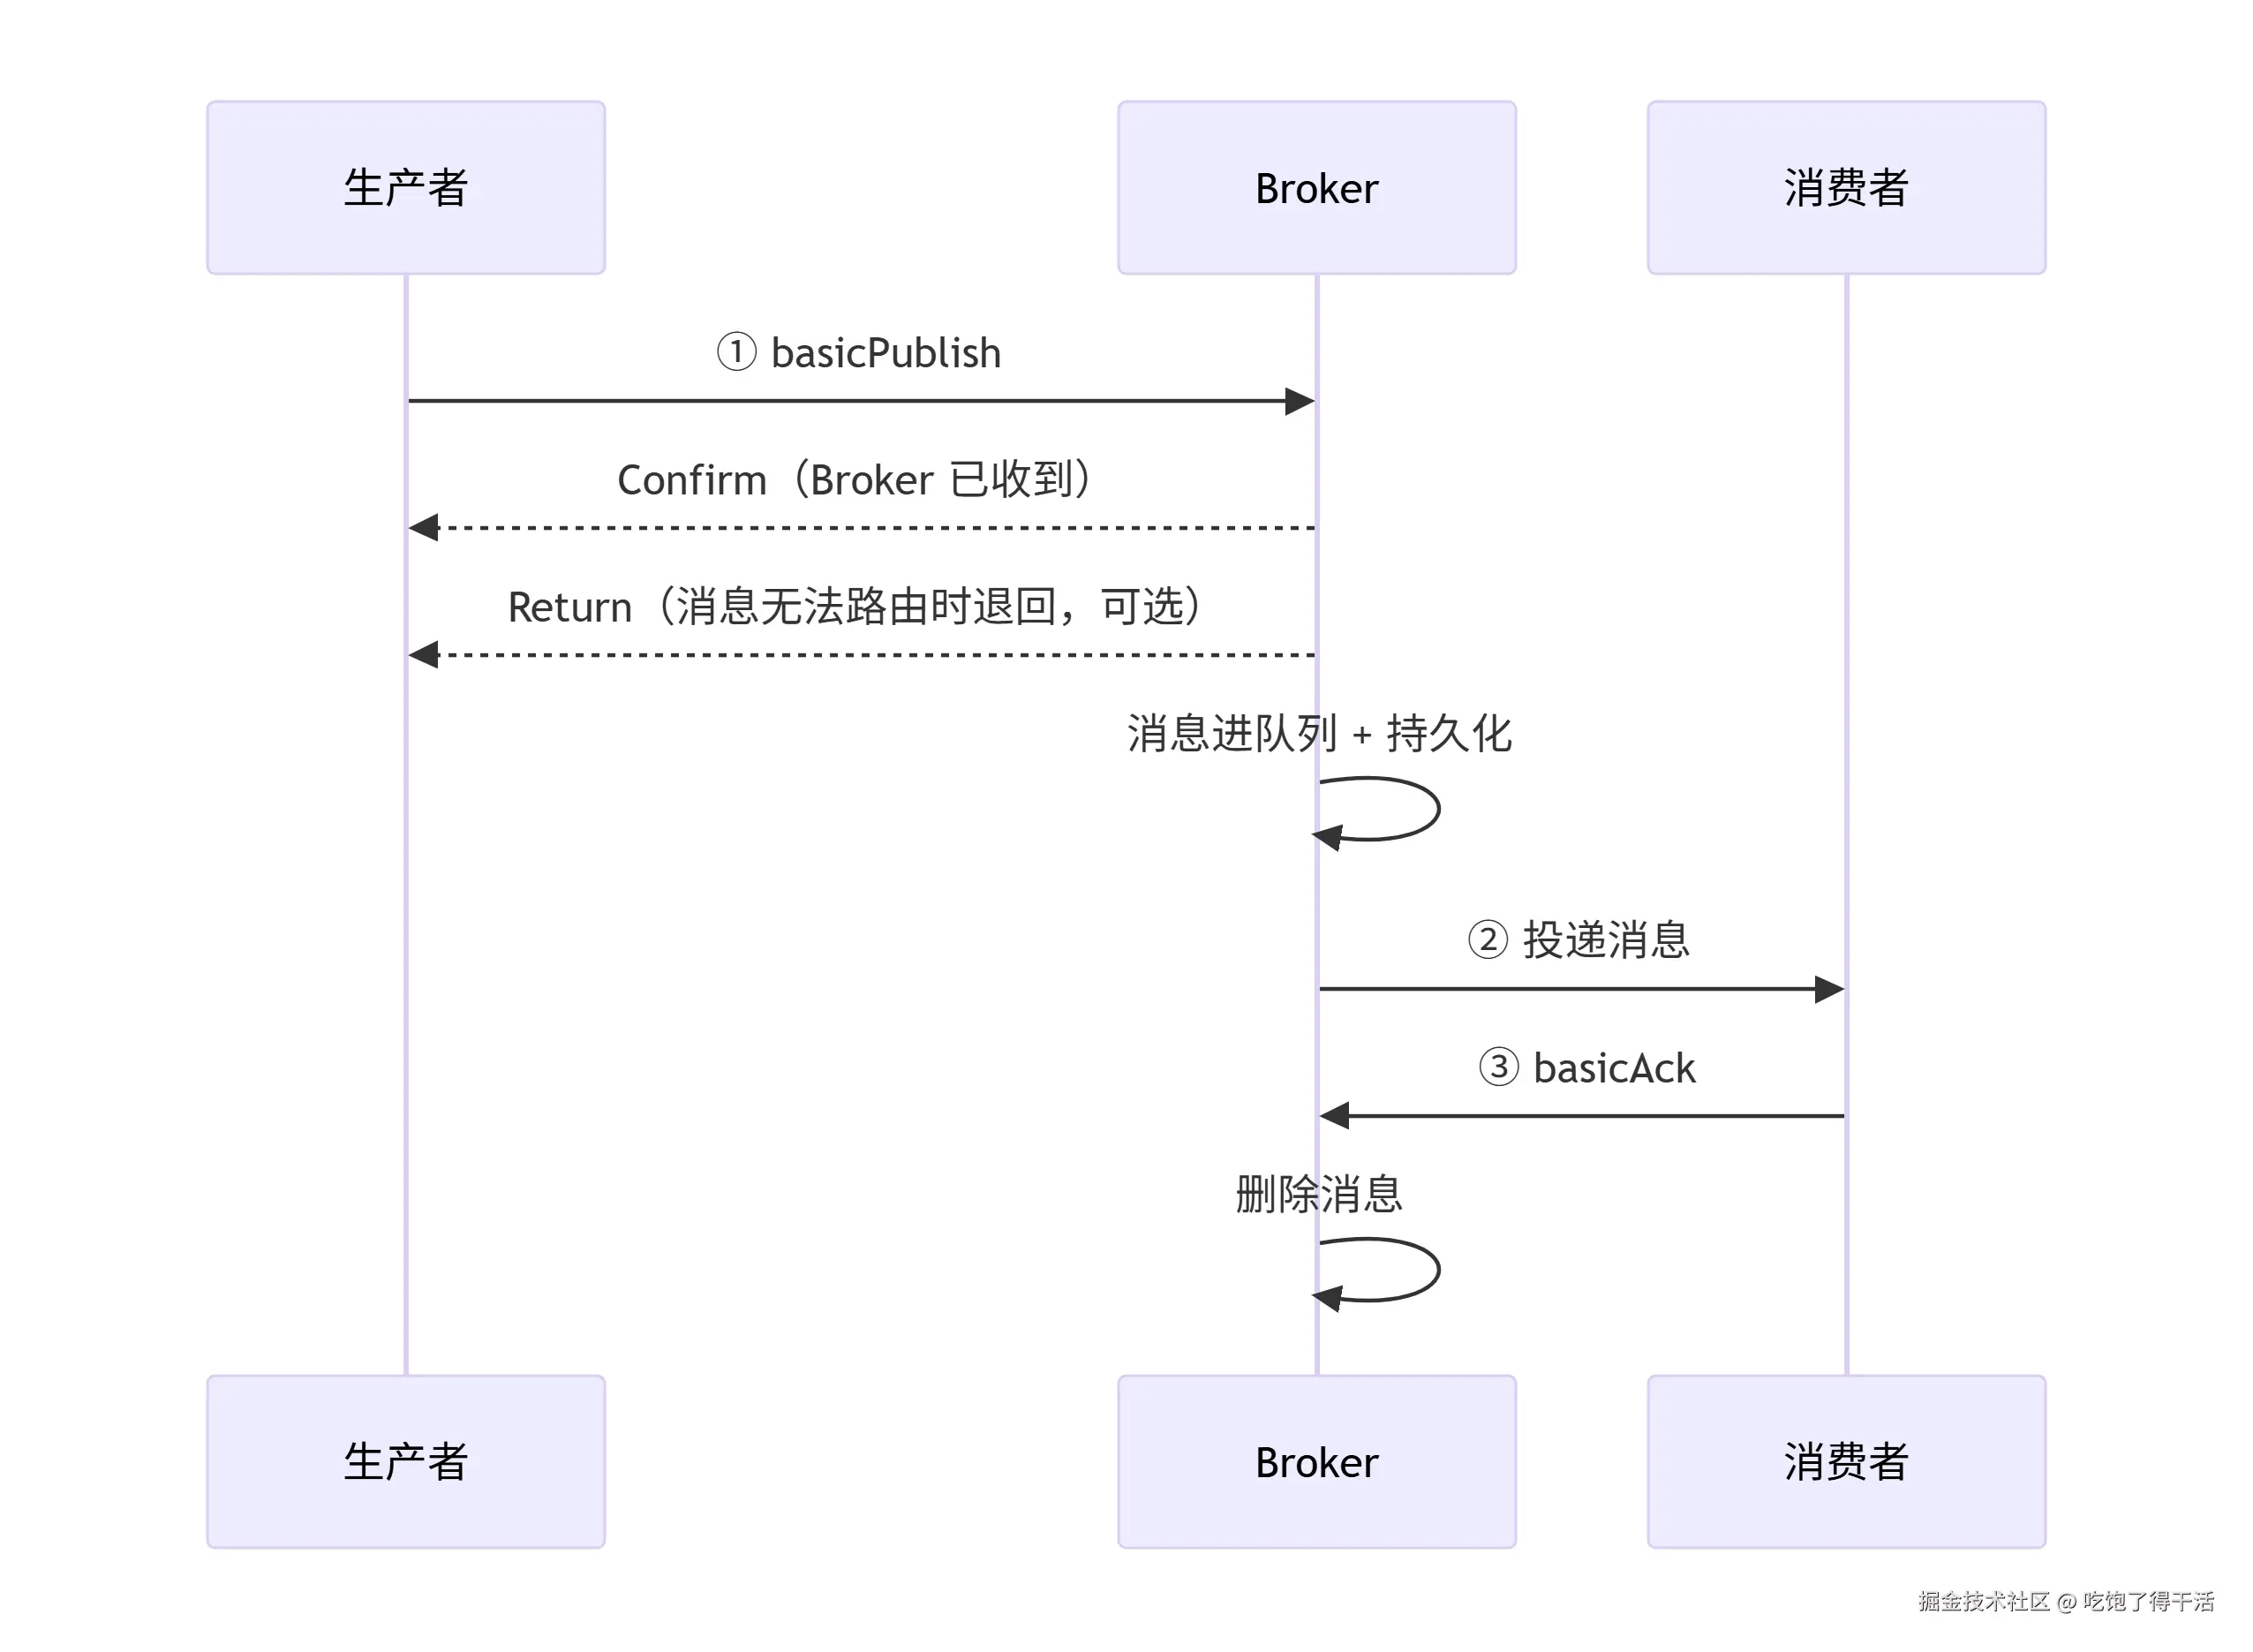
每一段都要单独保证,缺一个环节,可靠性就有缺口。
第一段:生产者到 Broker(Publisher Confirm)
Broker 的 Exchange 进程收到消息后返回 basic.ack ,表示消息已经被 Broker 接管 ,但不代表已经路由到队列。
如果 Exchange 找不到匹配的队列,根据 mandatory 设置决定:丢弃(默认)还是退回(Publisher Return)。
Confirm 的底层实现 :Broker 为每条消息分配递增的 deliveryTag,生产者通过 CorrelationData 关联这些 tag。Broker 可以批量确认,也可以单条确认。这就是 publisher-confirm-type: correlated 是推荐配置的原因------它用异步回调避免同步等待。
第二段:Broker 内部的持久化
见第三层。核心结论:批量刷盘,不是每条 fsync,极端情况有丢失窗口。
第三段:Broker 到消费者(Consumer Ack)
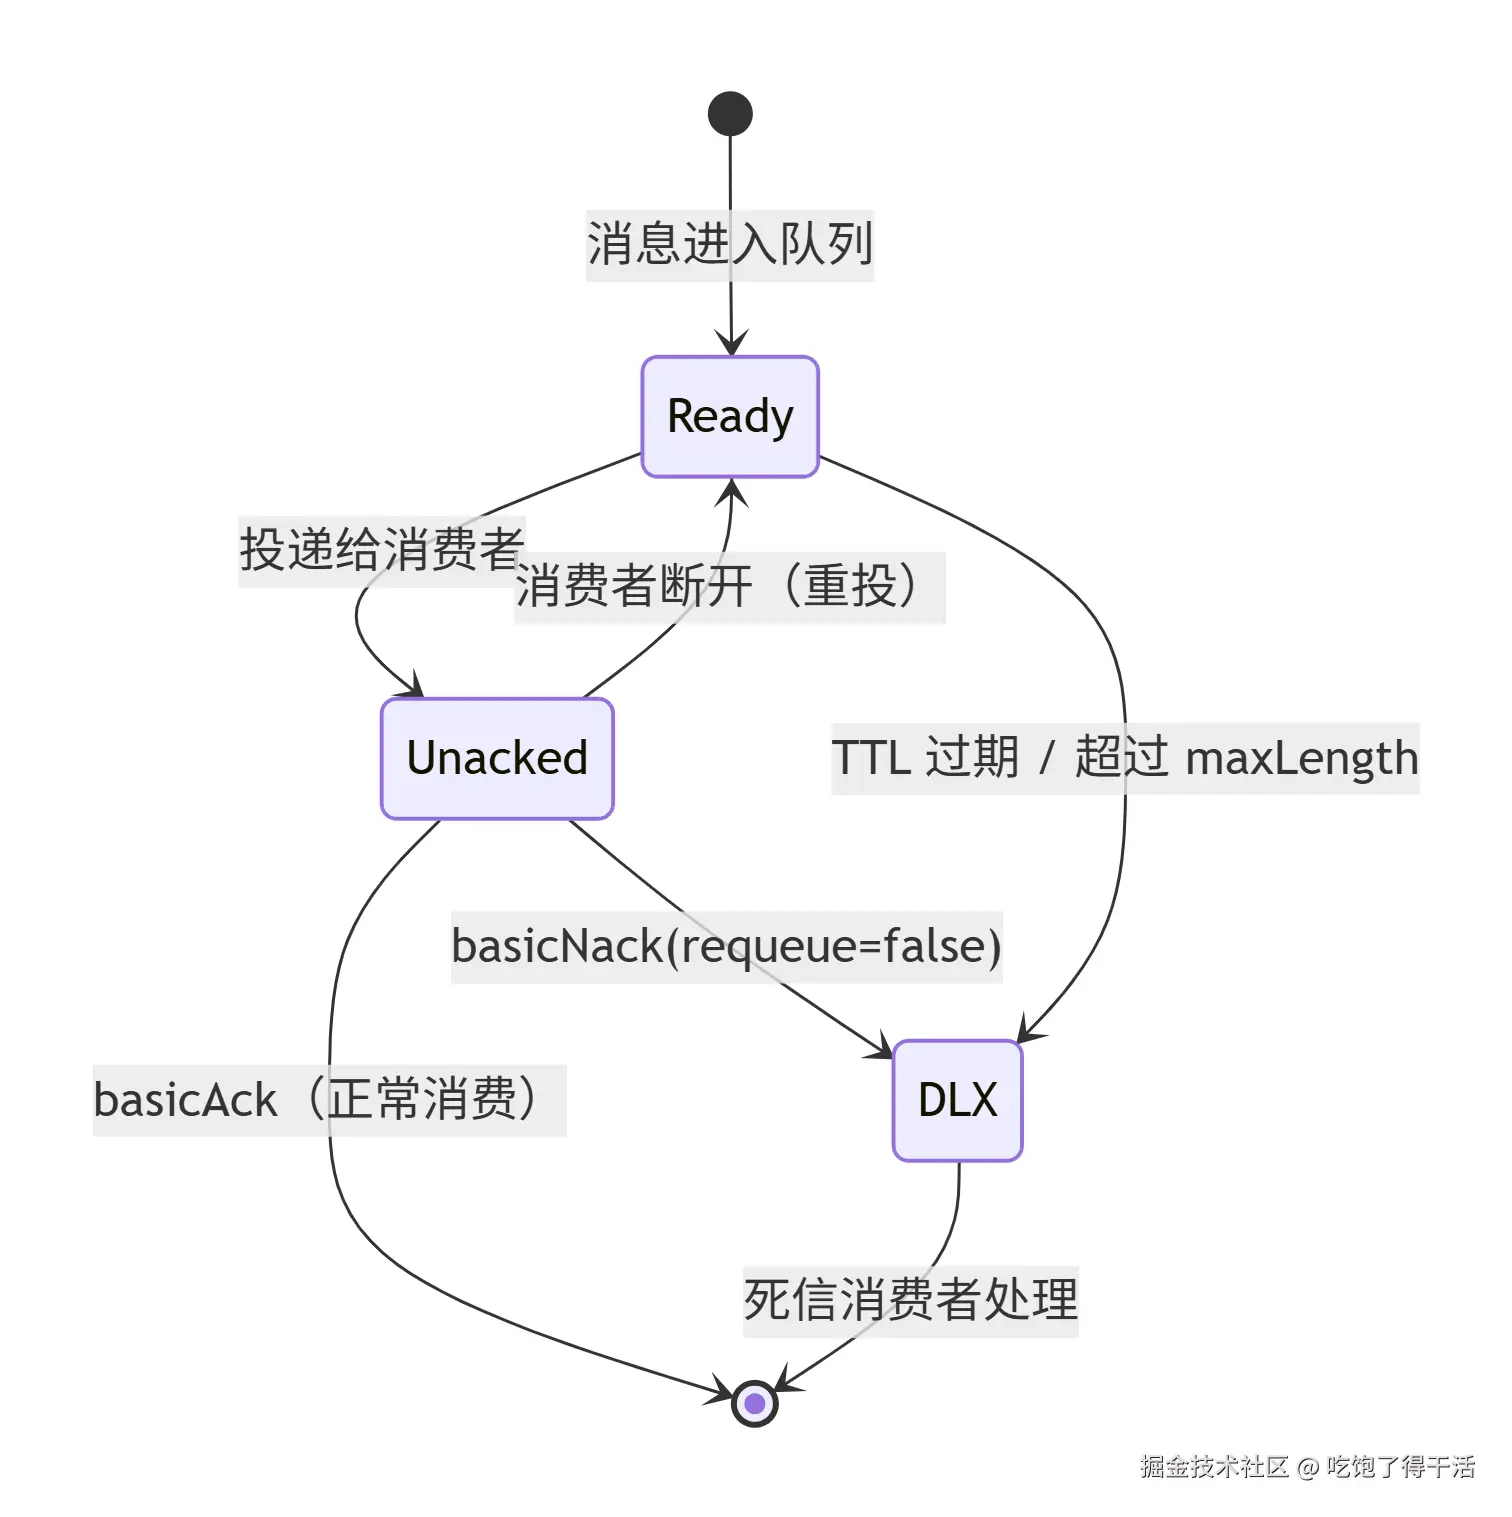
消费者从队列取到消息后,消息从 Ready 变为 Unacked 。RabbitMQ 不会立刻删除它,而是等待消费者显式发送 basic.ack。
自动 ACK 的危险在于:消息一投递就立刻被认为"已确认",从队列中移除。如果消费者在处理过程中崩溃,消息已经没了。这就是为什么生产环境必须手动 ACK。
死信与 TTL 的底层行为
死信(Dead Letter)不是一个独立的"队列类型",而是消息被重新发布到另一个 Exchange 的机制。官方的文档里触发条件有三种:
- 消费者
basicNack(requeue=false); - 消息 TTL 过期;
- 队列超过
maxLength;
一个重要的性能陷阱 :RabbitMQ 的 TTL 检查只发生在队列头部。
text
队列(FIFO):
┌─────────────────────────────────────────────┐
│ 队头 消息A (TTL=60s)                         │
│ 消息B (TTL=1s)   ← 不会单独过期!             │
│ 消息C (TTL=1s)                               │
│ ...                                          │
└─────────────────────────────────────────────┘

消息B 必须等 消息A 过期出队后,才能被检查
如果队头消息的 TTL 是 60 秒,而它后面的第二条消息 TTL 是 1 秒,第二条消息不会在 1 秒后被单独清除------它必须等队头消息过期并出队后,才能被检查。
这就是为什么用 TTL + DLX 实现延迟队列时,消息的延迟时间必须一致,或者按延迟时间递增的顺序发送。
延迟交换机插件(rabbitmq_delayed_message_exchange)解决了这个问题:它引入 x-delayed-message 类型,消息在交换机层面被延迟,到期后才被路由到队列,不依赖队列头部的 TTL 检查,支持任意延迟时间。
到这里第五层回答了:消费端靠手动 ACK 和死信队列兜底,但要注意 TTL 队头阻塞的陷阱。
复盘:一条消息的安全地图
五层走完,一条消息的完整安全链路是这样的:
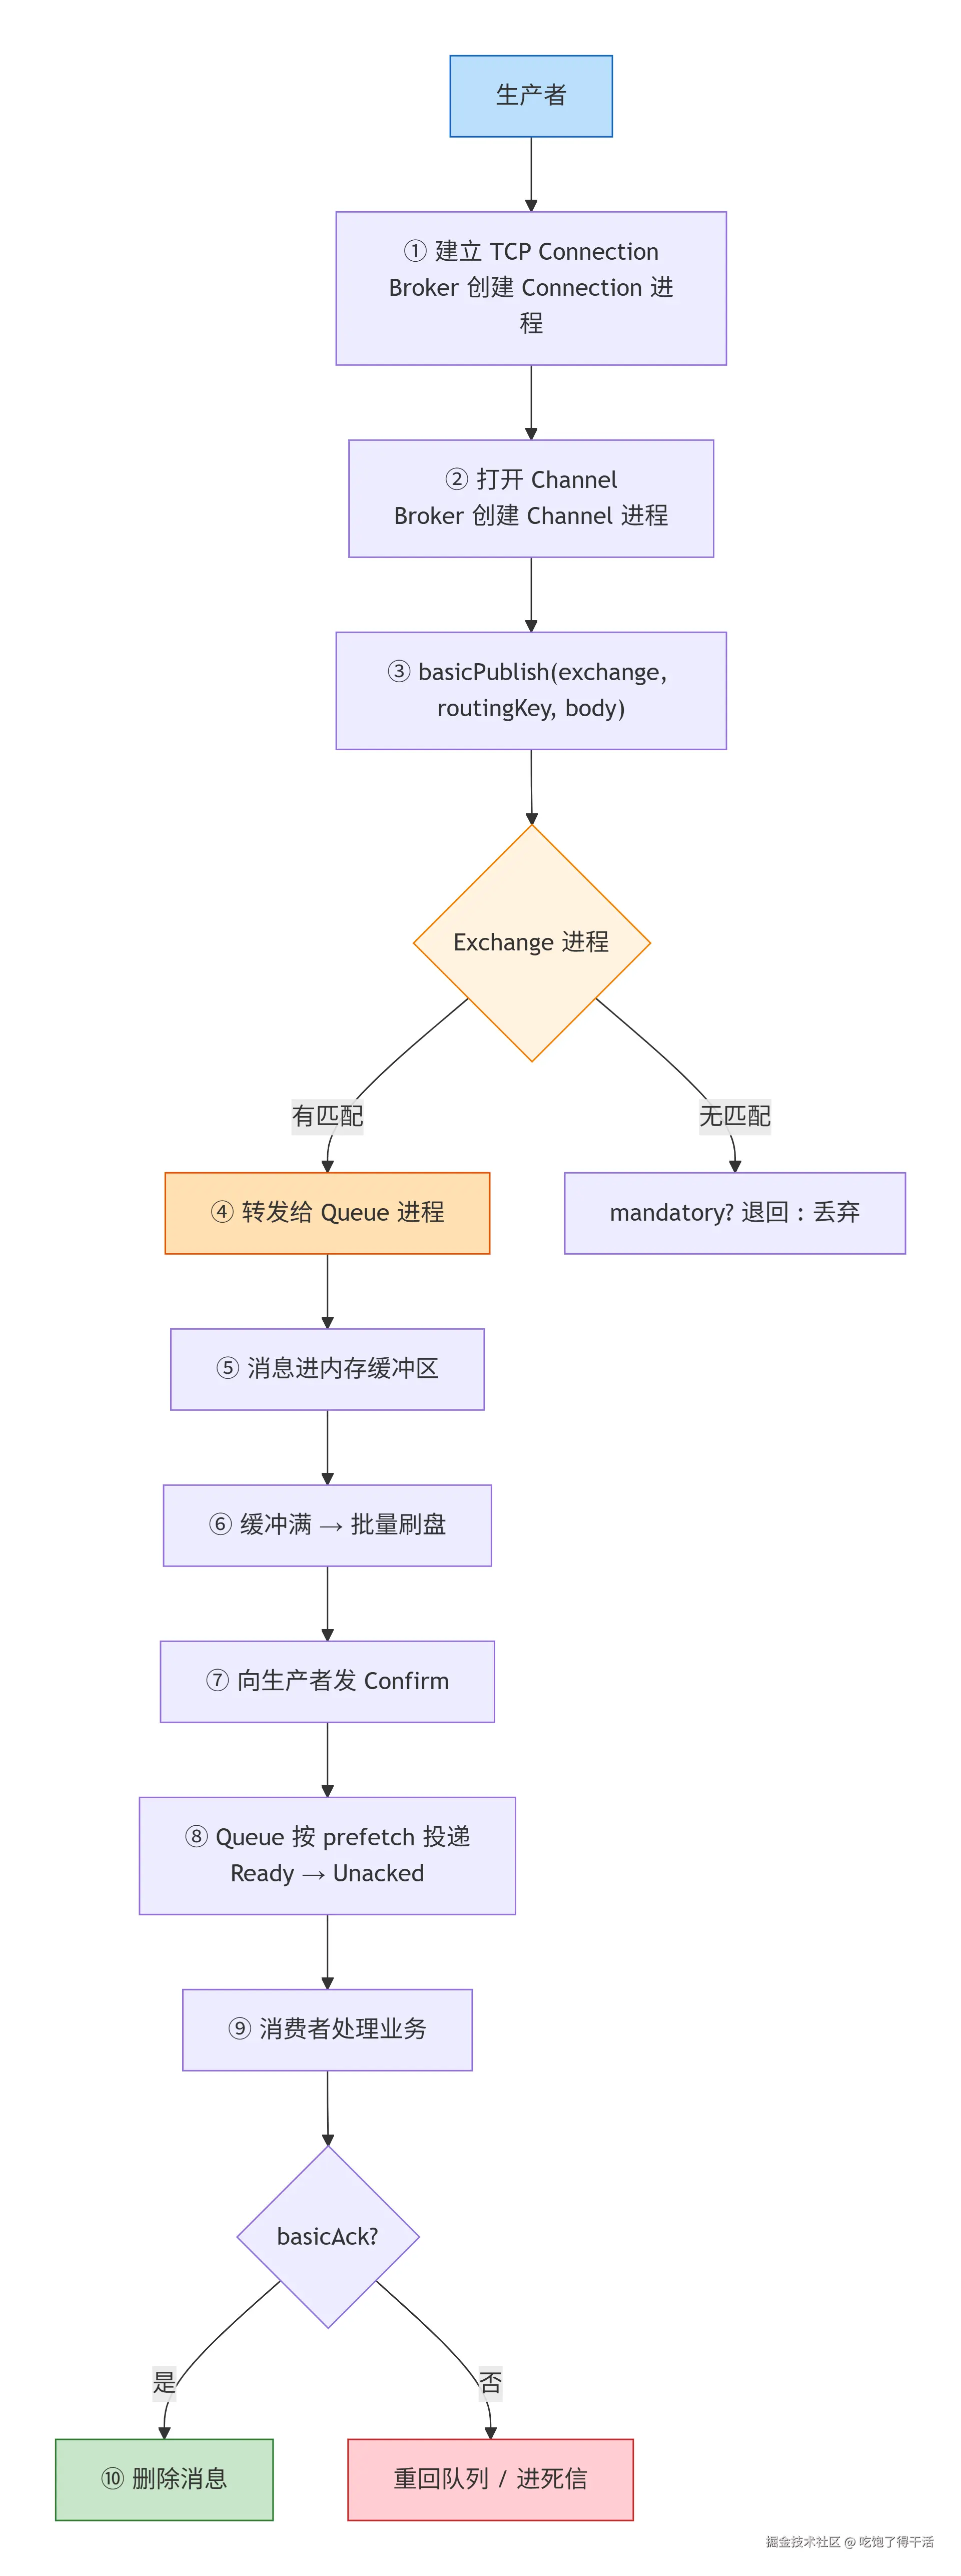
五层对应关系:
| 层 | 回答的问题 | 对应环节 |
|---|---|---|
| 第一层 | 消息存在哪里 | 内存缓冲 + 批量刷盘 |
| 第二层 | 内存满了怎么办 | 高水位线 + 流控 |
| 第三层 | 服务器重启还在吗 | 持久化三层 + Confirm |
| 第四层 | 集群挂节点还在吗 | Quorum 队列 + 多数派 |
| 第五层 | 会被正确处理吗 | 三段确认 + 手动 ACK + 死信 |
理解原理之后:四个反直觉的结论
结论一:RabbitMQ 的队列是单线程的。 一个队列的吞吐上限约等于一个 CPU 核心的处理能力。如果你的业务需要单个逻辑队列承载极高吞吐,RabbitMQ 的队列模型会成为瓶颈,要么拆队列,要么考虑 Kafka / Pulsar 这类分区模型。
结论二:消息主要在磁盘上,不在内存里。 管理后台的内存占用高,通常不是消息体造成的,而是索引、元数据、Unacked 记录和 Erlang 进程本身的开销。调优内存时,关注的是 vm_memory_high_watermark 和队列的 Unacked 数量,而不是"把消息从内存挪到磁盘"。
结论三:镜像队列的阻塞式同步是设计缺陷,不是配置问题。 无论怎么调 ha-sync-mode,只要队列有大量堆积,同步就是灾难。Quorum 队列是正确方向,代价是牺牲了非持久化消息和部分高级特性。
结论四:Publisher Confirm 不等于消息不丢。 Confirm 只保证 Broker 接管了消息,不保证已经落盘、不保证已经路由到队列。真正的端到端可靠性 = Confirm + Return + 持久化 + 手动 ACK + 消费幂等,缺一个环节,可靠性就有缺口。
写在最后
上一篇讲骨架,这篇讲血肉。两篇连起来看,你会看到 RabbitMQ 从"网络进来的字节"变成"可靠的业务消息"的完整旅程。
理解原理之后,再看那些配置项和最佳实践,就不再是"别人说该这么配",而是"我知道为什么必须这么配":
prefetch是对单线程 Queue 进程的保护;mandatory是对 Exchange 静默丢弃的兜底;- Quorum 队列的多数派要求决定了集群最少 3 节点;
- TTL 的队头检查决定了延迟队列不能用 TTL + DLX 做任意延迟。
每一个选择背后都有原理在支撑。
如果这两篇对你有帮助,欢迎点赞、收藏、关注。