一、定位差异
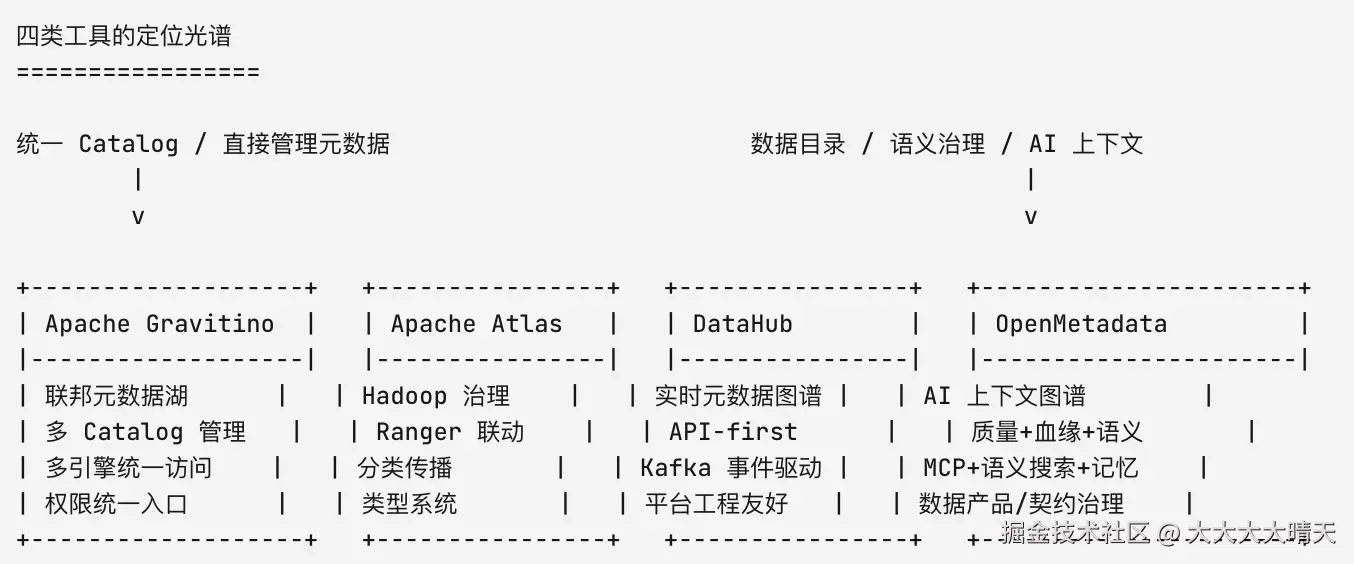
OpenMetadata 定位为 "The Open Context Layer for AI",强调面向数据用户、AI 助手和 Agent 的可信数据上下文、组织记忆和业务语义,并把技术元数据、质量信号、血缘、字段级血缘、Owner、使用情况、策略、对话、记忆、术语表、分类、指标、领域、数据契约和数据产品连接到统一元数据知识图谱中 。
DataHub 定位为开源 AI Data Catalog,目标是支持整个数据生态中的数据发现、治理和可观测性;它最初由 LinkedIn 构建,通过实时流式或批量采集方式连接现代数据栈,并构建统一 Metadata Graph 。
Apache Atlas 定位更偏 Hadoop 生态治理底座,提供可扩展的核心治理服务,用于帮助企业满足 Hadoop 环境中的合规要求,同时也允许与企业数据生态集成 。
Apache Gravitino 定义为 high-performance、geo-distributed、federated metadata lake,用于直接管理不同来源、类型和区域中的元数据,并为数据和 AI 资产提供统一元数据访问。它的关键词是federated metadata lake、direct metadata management、metalake、multi-engine access、unified access control,而不是传统意义上的数据目录或资产治理门户。
二、能力对比
| 维度 | Apache Gravitino | OpenMetadata | DataHub | Apache Atlas |
|---|---|---|---|---|
| 核心定位 | 联邦元数据湖,统一管理多源、多类型、多区域元数据 | 面向数据与 AI 的开放上下文层 | 开源 AI Data Catalog 与实时 Metadata Graph | Hadoop 生态元数据治理框架 |
| 管理方式 | 直接管理底层数据源元数据,变更可反映到底层系统 | 通过连接器、API、事件、SDK 汇聚并连接元数据图谱 | Pull/Push,同步/异步,MCP 可走 Kafka 或 HTTP | REST API、Kafka Messaging、Hadoop Hooks |
| 核心对象 | Metalake、Catalog、Schema、Table、Fileset、Model、Topic | Table、Column、Dashboard、Pipeline、Metric、Glossary、Domain、Data Product、Data Contract、Memory 等 | Dataset、Dashboard、Chart、DataJob、Glossary、Tag、Domain 等元数据图谱对象 | Type、Entity、Classification、Relationship、Process 等 |
| 支持资产 | 关系型表、湖仓表、文件集、Kafka Topic、模型、函数等 | 数据库、表、Topic、Dashboard、Pipeline、API、ML Model、Search Index、Storage 等 | 数据集、BI、调度、ML、数据质量、使用情况等 | Hive、HBase、Sqoop、Storm、Kafka 等 Hadoop 生态来源 |
| 多引擎支持 | 支持 Trino、Spark、Flink、Daft 等引擎访问元数据 | 更多作为治理与发现平台,不是查询引擎 Catalog 控制面 | 更多作为元数据平台,不是查询引擎 Catalog 控制面 | 更偏 Hadoop 生态治理 |
| 多区域支持 | 强调 geo-distributed 架构,支持 Iceberg REST Catalog 跨区域/跨云代理 | 可部署在多环境,但核心卖点不是 geo-distributed Catalog | 云原生和大规模平台化强,但核心卖点不是多区域 Catalog 代理 | 传统 Hadoop 集群治理为主 |
| 数据发现 | 提供 discovery、Web UI、CLI、REST API、Java/Python SDK | 搜索、语义搜索、资产详情、质量、血缘、Owner、业务语义完整 | Universal Search、Dataset Profile、GraphQL/API 查询 | 类型、分类、属性、全文和 DSL 搜索 |
| 血缘能力 | 未把血缘作为核心能力突出 | 表级、字段级、Pipeline、Dashboard、Metric、ML Model 血缘和影响分析 | 支持列级血缘和 GraphQL 血缘查询,依赖采集与集成 | 支持血缘 UI 和 REST API,分类可沿血缘传播 |
| 数据质量 | 重点不在数据质量测试运营 | 内置测试、剖析、Freshness、Volume、Null、Uniqueness、Distribution、告警、事件等 | 支持 profiling、quality metrics,具体取决于集成与 Assertions | 可用分类表达质量标签,但不是现代质量运营平台 |
| 标签与分类 | 支持 Tag,且 Tag 可绑定 Catalog、Schema、Table、Column、Fileset、Topic、Model,并支持继承;当前标签系统是 basic implementation,未来会补高级能力 | Classification、Tag、Glossary、Metric、Domain、Data Product 较完整 | Tags、Glossary、Domains、Ownership、Assertions 等 | Classification 是核心能力,并可沿血缘传播 |
| 策略与治理 | 支持 Policy,Policy 可绑定 Catalog、Schema、Table、Fileset、Topic、Model,并支持继承;内置策略包括 Iceberg compaction,亦支持 custom policy | Policies、Roles、Data Contracts、Review、Certification、Lifecycle 等治理上下文 | Governance、Auth、Audit、Policy 能力偏平台化 | 分类、Ranger 联动、安全脱敏是强项 |
| 权限控制 | 支持统一访问控制,RBAC + DAC,权限可在 Metalake、Catalog、Schema、Table、Topic、Fileset、Model、Function 等层级继承,并可向底层系统或 Ranger pushdown | 管理元数据访问、角色、策略、SSO、Token 和 MCP 认证 | 企业级认证、授权、审计和 API 权限 | 与 Ranger 集成,基于分类驱动授权和脱敏 |
| AI 方向 | 支持 Model Catalog 和 Gravitino MCP Server,用于 AI 工具管理 Gravitino 元数据 | MCP、AI SDK、Semantic Search、Memory 是当前重点 | MCP、LLM integrations、Analytics Agent | 未突出 AI 原生能力 |
| 更像什么 | 元数据控制面 / 联邦 Catalog / 多引擎元数据访问层 | 数据治理与 AI 上下文产品 | 实时元数据平台内核 | Hadoop 治理基础设施 |
三、架构风格
OpenMetadata 的架构更像"统一元数据服务 + 连接器采集 + 搜索 + 治理应用 + AI 上下文层"。通过 130+ 连接器、API、事件和 SDK 采集元数据,再把技术元数据、质量信号、血缘、Owner、使用情况、策略、语义、领域、数据契约、数据产品和记忆连接为一张图 。
DataHub 的架构更偏事件驱动。将 Metadata Change Proposal 作为中心对象,MCP 代表对组织 Metadata Graph 的变更请求,可发送到 Kafka 以支持高扩展异步发布,也可直接发送到 HTTP endpoint 获得同步成功或失败响应 。
Apache Atlas 的架构更偏传统治理中台。将 Atlas 组件分为 Core、Integration、Metadata sources 和 Applications,其中 Core 包括 Type System、Graph Engine、Ingest/Export;Integration 包括 REST API 和基于 Kafka 的 Messaging;Metadata sources 包括 HBase、Hive、Sqoop、Storm、Kafka 等来源 。
markdown
OpenMetadata
============

Data Stack / AI Threads / Documents / Pipelines
        |
        v
130+ Connectors / APIs / Events / SDKs
        |
        v
Schema-first Metadata Graph
        |
        +--> Quality / Lineage / Ownership
        +--> Glossary / Metrics / Domains
        +--> Data Contracts / Data Products
        +--> Memory / Semantic Search / MCP


DataHub
=======

Pull Sources / Push SDK / Events
        |
        v
Metadata Change Proposal
        |
        +--> Kafka Async Path
        +--> HTTP Sync Path
        |
        v
GMS / Metadata Graph / Search / GraphQL / APIs


Apache Atlas
============

Hive / HBase / Sqoop / Storm / Kafka Hooks
        |
        v
Type System + Entity
        |
        v
Graph Engine / JanusGraph
        |
        +--> HBase / Solr / Kafka / ZooKeeper
        |
        v
Atlas UI / REST API / Ranger
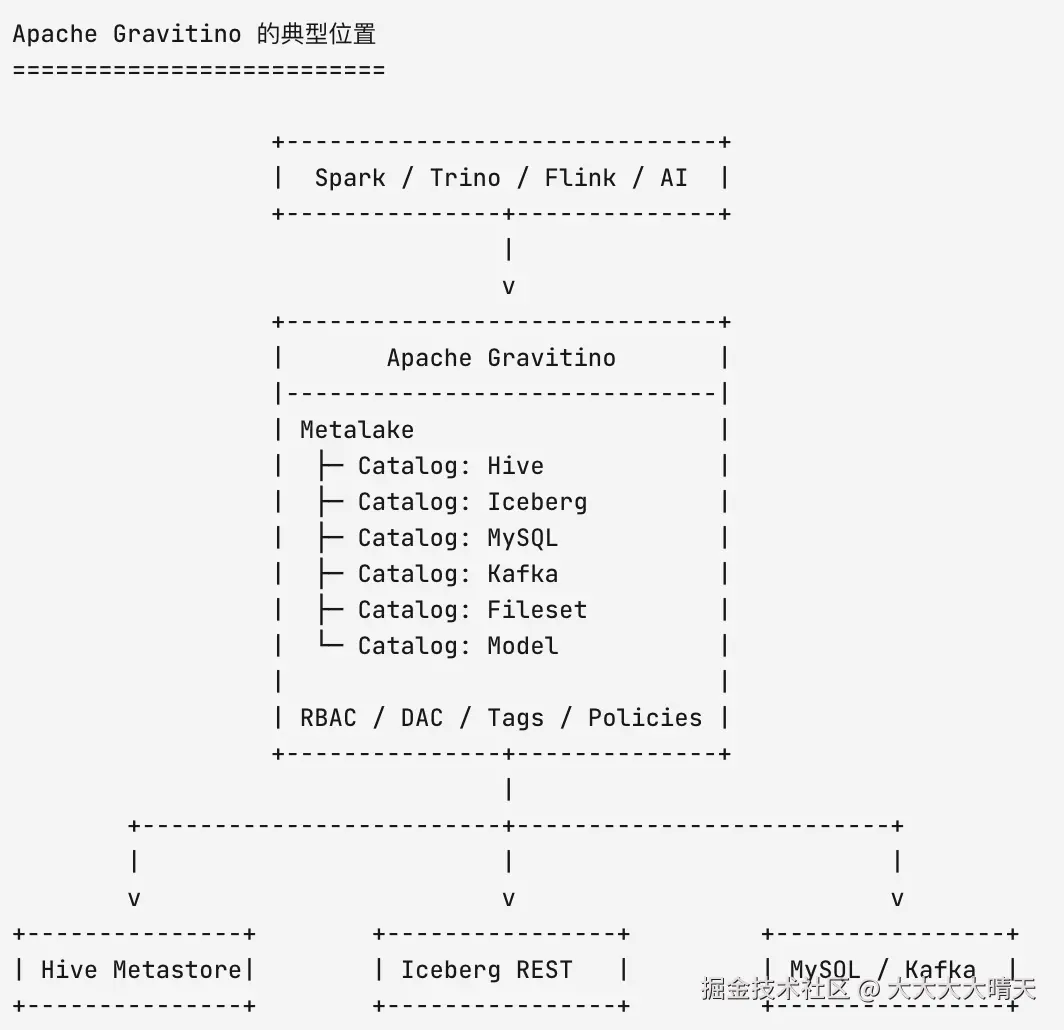
Gravitino 的架构更接近"数据平台控制面","让多种引擎通过统一的 Catalog、权限和 API 去访问和管理多种数据与 AI 资产"。它定义了 Metalake 作为元数据容器,下面组织 Catalog、Schema、Table、Fileset、Model、Topic 等对象;每个 Catalog 由对应连接器连接到具体元数据源。
四、核心差异
OpenMetadata 的差异点在于把数据目录、数据质量、业务语义、数据产品、数据契约、MCP、语义搜索和组织记忆放在同一套上下文图谱中,更适合作为"数据资产认知层",当前产品方向已经明显转向"给人和 AI 共用的可信数据上下文层" 。
DataHub 的差异点在于事件驱动和平台工程属性。它以 Metadata Change Proposal 为中心,天然适合 Kafka 异步写入、HTTP 同步写入、SDK 推送、批量拉取等多种集成模型;它还强调 streaming-first、API-first、GraphQL/OpenAPI、Python/Java SDK 和 CLI 。
Apache Atlas 的差异点在于 Hadoop 生态治理和安全策略联动。Atlas 可与 Apache Ranger 集成,让安全管理员基于 Atlas 中的分类定义数据访问授权和脱敏策略,例如控制谁能访问被标记为 PII 或 SENSITIVE 的数据 。
Gravitino 的差异点在于不以"元数据变更事件图谱"为核心,而以"联邦 Catalog 和统一元数据访问"为核心,它关心的是 Catalog、Schema、Table、Fileset、Topic、Model 这些对象如何被多引擎统一访问、管理和授权,更适合作为"元数据操作层"。
五、选型建议
1.优先选 OpenMetadata
当你的核心目标是"让用户理解和信任数据",OpenMetadata 更适合。它更关注数据资产发现、血缘、字段级血缘、质量、Owner、术语、指标、数据产品、数据契约、MCP、语义搜索和 AI 上下文 。
| 场景 | 推荐理由 |
|---|---|
| 建统一数据目录 | 数据资产搜索、描述、Owner、标签和使用上下文完整 |
| 做数据质量运营 | 官方内置 tests、profiling、freshness、alerts、incidents 等能力 |
| 做指标和术语治理 | Glossary、Metrics、Domains、Data Products 支撑业务语义 |
| 做 AI 问数上下文 | MCP、Semantic Search、Memory、AI SDK 是重点能力 |
| 做血缘和影响分析 | 表级、字段级、Pipeline、Dashboard、Metric、ML Model 血缘能力更贴近治理平台 |
2.优先选 DataHub
当你的核心目标是"构建事件驱动的大规模元数据平台",DataHub 更适合。它的 Metadata Change Proposal、Kafka/HTTP 双路径、GraphQL/OpenAPI、Python/Java SDK 和 CLI 对平台团队更友好 。
| 场景 | 推荐理由 |
|---|---|
| 实时元数据图谱 | Kafka 异步 MCP 写入适合元数据事件流 |
| 大规模平台工程 | LinkedIn 背景和 Metadata Graph 设计适合大规模资产 |
| 强 API 二开 | GraphQL、OpenAPI、SDK、CLI 体系完整 |
| 自研数据平台集成 | Push/Pull、同步/异步模型灵活 |
| AI 分析应用探索 | 官方支持 MCP、LLM integrations 和 Analytics Agent |
3.优先选 Atlas
当企业已有 Hadoop、Hive、HBase、Ranger 存量体系,并且核心诉求是分类、血缘、合规、安全授权和脱敏联动,Atlas 仍然有价值。它的强项不是现代数据目录体验,而是 Hadoop 时代沉淀下来的治理基础设施和 Ranger 集成 。
| 场景 | 推荐理由 |
|---|---|
| Hadoop/Ranger 深度绑定 | Atlas 与 Ranger 分类授权、脱敏联动成熟 |
| 传统数据合规治理 | Classification、Lineage、Search、Type System 能支撑治理 |
| 已有 Atlas 基础 | 延续成本低,迁移风险小 |
| 分类传播 | 分类可沿血缘传播,适合敏感数据治理 |
| 自定义治理模型 | Type System 支持自定义类型、属性、关系和继承 |
4.优先选 Gravitino
当你的主要问题是"多引擎如何统一访问和管理多个 Catalog",Gravitino 应优先评估。典型场景是公司同时使用 Spark、Trino、Flink,并且底层有 Hive、Iceberg、Paimon、Hudi、MySQL、PostgreSQL、Kafka、对象存储和模型资产,需要一个统一的元数据控制面。
| 场景 | 推荐理由 |
|---|---|
| 多 Catalog 统一管理 | Metalake/Catalog/Schema/Table 模型天然适合统一组织多源元数据 |
| 多引擎访问 | 官方支持 Trino、Spark、Flink、Daft 等引擎接入 |
| 湖仓 Catalog 控制面 | 支持 Hive、Iceberg、Hudi、Paimon、Lakehouse generic catalog 等 |
| 统一权限入口 | 支持 RBAC、DAC、权限继承、底层权限 pushdown 和 Ranger 集成方向 |
| 多区域元数据访问 | 官方 geo-distributed Iceberg REST Catalog 支持 |
| 数据 + AI 资产统一管理 | 支持 Fileset、Model、Topic 等非传统表资产 |
5.组合方案
这四类组件并不一定只能四选一。更现实的架构是"Gravitino 做 Catalog 控制面,OpenMetadata 或 DataHub 做治理和发现层"。
lua
推荐组合架构
============

查询与计算层
Spark / Trino / Flink / Daft
        |
        v
Catalog 与权限控制面
Apache Gravitino
        |
        +--> Hive / Iceberg / Paimon / Hudi
        +--> MySQL / PostgreSQL / Doris / StarRocks
        +--> Kafka / Fileset / Model
        |
        v
治理与发现层
OpenMetadata 或 DataHub
        |
        +--> 搜索发现
        +--> 血缘分析
        +--> 数据质量
        +--> 术语/指标/Owner
        +--> AI 上下文 / MCP
如果团队已经有 OpenMetadata,可以把 Gravitino 视为统一 Catalog 和权限入口;OpenMetadata 继续承担数据目录、血缘、质量和业务语义。如果团队已经有 DataHub,可以让 DataHub 继续做 Metadata Graph 和事件驱动治理,Gravitino 负责查询引擎侧的 Catalog 统一和权限抽象。Atlas 则更适合作为 Hadoop/Ranger 存量治理体系的一部分,与新组件逐步共存或迁移。