2025年8月,美团视觉智能部联合中国科学院自动化研究所、中山大学、香港科技大学等机构,正式开源了InfiniteTalk------一个面向"无限时长说话视频"的音频驱动视频生成框架(论文arXiv:2508.14033,代码与权重同步开源)。与市面上大多数"只对口型"的数字人工具不同,InfiniteTalk提出了一种全新的稀疏帧视频配音( Sparse-Frame Video Dubbing **)**范式:仅保留源视频中少数关键帧作为参考,就能让画面中人物的嘴部、表情、头部、身体姿态全部随新音频"活起来",并支持无限时长的连续生成。它既能做视频配音(Video-to-Video),也能做"照片+音频→说话视频"(Image-to-Video),上线一个月便获得ComfyUI官方原生支持,成为AIGC圈热度最高的开源数字人框架之一。
本文将从范式革新、技术原理、模型架构、环境部署、ComfyUI实战、调参技巧、方案对比、应用场景等维度,系统拆解InfiniteTalk,为数字人开发者、视频创作者、AI产品经理和内容团队提供一份可直接落地的实战指南。
一、从**"** 嘴部编辑 " 到 " 稀疏帧配音 " :一次范式革新
1.1****传统视频配音的困境
视频配音(Video Dubbing)是"原始视频+新音频→本地化视频"的音频驱动视频生成任务,广泛用于影视翻译、多语言内容分发、数字人播报。传统主流方案是口部区域修补( Oral Region Inpainting ):冻结头部旋转、面部表情和身体姿态,只重绘嘴唇区域以匹配新语音。
这个思路存在根本缺陷:人类说话时,口型、表情、头部和身体是整体联动的------激昂的演讲必然伴随大幅手势和前倾姿态,而口部修补方案让身体"僵住",只动嘴巴,视觉上非常违和(论文原话:激情对白配僵硬姿势,破坏沉浸感)。此外逐帧修补效率低,且无法支持长视频的连续生成。
|-----------|-------------------|--------------------|
| 维度 | 传统视频配音(口部修补) | InfiniteTalk稀疏帧配音 |
| 编辑范围 | 仅嘴部区域,头部/表情/身体冻结 | 嘴部+表情+头部+身体姿态全链路驱动 |
| 参考信息 | 逐帧遮罩+原视频逐帧像素 | 仅稀疏关键帧(锚定身份/手势/镜头) |
| 与音频对齐 | 仅口型对齐,身体语言与语音情绪脱节 | 全身运动与语音节奏、情感韵律有机同步 |
| 视频长度 | 短片段为主,长视频逐帧修补成本爆炸 | 无限时长流式生成,跨块无缝衔接 |
| 视觉一致性 | 长序列存在身份漂移与色偏累积 | 关键帧持续锚定身份,误差不累积 |
1.2****稀疏帧配音的核心思想
InfiniteTalk重新定义了配音的"参考方式":不再把原视频每一帧都当作必须遵循的约束,而是只保留参考关键帧( Reference Keyframes )------这些关键帧锚定四样东西:人物身份(长相)、情绪基调(表情状态)、标志性手势(关键动作)、相机轨迹(镜头运动)。其余全部帧的生成交给生成模型,让面部表情、头部转动、身体动态与配音音频"自由地"有机对齐。
用论文的比喻:关键帧是"路标",模型在路标之间自由发挥,但整体路线(身份、情绪、手势、镜头)不偏。这带来了传统方案无法企及的自然度------头部会跟随语音节奏转动,手势会放大情绪,表情随语气起伏,镜头缓缓推进,一切浑然一体。
**二、朴素方案为何失败:**I2V 与 FL2V 的局限
要理解InfiniteTalk的设计,先看两个"自然而然"的朴素方案为什么行不通。论文用两类基线模型做了系统分析:图像到视频模型(I2V)与首尾帧到视频模型(FL2V,如Wan系列)。
2.1 I2V****方案:误差累积
I2V方案的处理逻辑是:第一个视频块用源视频起始关键帧作为参考帧初始化;后续每个块,只用上一个块最后生成的帧作为新参考帧。问题在于:缺少对原始关键帧的持续锚定,误差会逐块累积------人物面部特征逐渐偏离源演员(身份漂移),背景色调逐块偏移(色彩漂移),生成到第1500帧时画面已明显劣化。如图2所示,I2V在长序列上误差累积严重,帧1500的画面质量远差于帧750。
2.2 FL2V****方案:僵硬与突变
FL2V方案把每个块的起始帧和终止帧都作为条件输入,确保与源视频参考姿态对齐。这解决了误差累积,却引入了两个新问题:
①刚性控制导致僵硬 :模型被强制在对应时间戳严格复制参考帧,结果就是"照抄动作"------口型、头部、表情都生硬,与语音动态矛盾(说话节奏快了但嘴动跟不上);②跨块突变:仅靠首尾帧条件,相邻块之间缺乏运动连续性,第82帧(新块起始)与前一块末尾的衔接会出现跳跃/突变(如图2右侧)。
两类基线都指向同一个核心问题:**如何既保持长期身份一致性,又不牺牲运动的自由度与连贯性?**这正是InfiniteTalk的流式生成与软参考机制要解决的。
**三、**InfiniteTalk 核心技术拆解
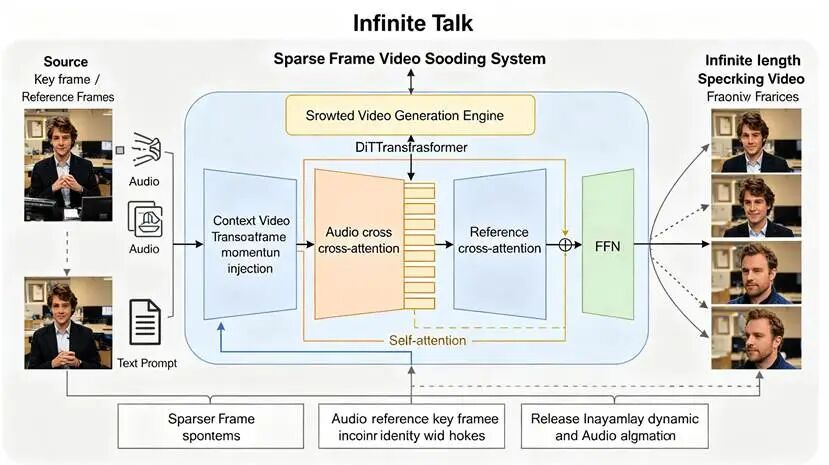
InfiniteTalk系统架构:左侧输入(源视频关键帧/参考帧/音频/文本提示),中间流式视频生成引擎(上下文帧动量注入+DiT:Audio cross-attention、Reference cross-attention、Self-attention、FFN),右侧输出无限时长说话视频
3.1****流式生成:上下文帧注入 " 动量 "
InfiniteTalk采用流式视频生成( Streaming Video Generation ) 架构:视频被切分为连续的小块(chunk)逐个生成,但每个块生成时不仅输入本块的参考条件,还把前一相邻块的末尾上下文帧( Context Frames **)**一并输入模型。这些上下文帧携带了运动的"动量信息"(Momentum Information)------上一块里人物的动作趋势、速度、方向,被注入当前块,从而让跨块过渡平滑自然,杜绝闪烁与接缝伪影。
工程实现上,官方工作流每块处理约81帧(约3.24秒@25fps),其中末尾25帧作为上下文重叠带入下一块。这种"块间重叠"机制是无限时长生成的关键:只要显存和算力允许,就能一路生成长达数分钟、数小时的连续视频。
3.2****软参考机制:控制强度自适应
InfiniteTalk的核心发现是:参考控制强度由 " 视频上下文与图像条件之间的相似度 " 决定。基于这个观察,模型在训练时采用了软条件(Soft Conditioning)策略------当参考帧与当前生成内容高度相似时,模型对参考的"服从度"高(牢牢锁定身份);当两者差异较大(例如人物正在大幅度运动),模型自动放宽对参考帧的严格复制,给运动自由度让路。
这与FL2V的"硬条件"形成鲜明对比:硬条件强制逐像素对齐参考帧导致僵硬,软条件则让控制力度随场景自适应,实现"要身份时锁身份、要动时敢动"的动态平衡。
3.3****采样策略:细粒度参考帧定位
除了训练端的软条件,推理端还有一个采样策略:细粒度参考帧定位( Fine-Grained Reference Frame Positioning )。研究者通过实验发现,参考帧在序列中的放置位置,会显著影响控制强度与运动对齐的平衡------参考帧放得密,控制强但运动僵硬;放得疏,运动自由但身份易漂移。InfiniteTalk通过精细调节参考帧的位置分布,在"锁身份"与"保运动"之间找到最优平衡点,进一步提升了长序列生成质量。
3.4****相机运动保持
视频配音还要保持源视频的镜头语言。论文探索了精确的微妙相机运动保持方法:默认情况下,模型会模仿原视频的相机运动(但不完全一致);引入SDEdit(噪声编辑)后,相机运动精度显著提升,但会引入颜色偏移,且更适合短视频。官方在长视频相机控制上的进一步优化已列入计划。
四、模型架构与训练原理
4.1****整体架构
InfiniteTalk以Wan2.1-I2V-14B-480P (阿里通义万相2.1图像到视频14B模型)为视频生成底座,在其上注入音频条件与参考帧条件,采用条件流匹配( Conditional Flow Matching **)**训练:模型学习一个随时间变化的向量场,把高斯噪声插值运输到目标视频分布,用ODE求解器采样。
条件信息包含三路:文本提示嵌入(Text Embedding)、音频嵌入(Audio Embedding)、参考帧潜变量(Reference Frames Latent)。其中音频经wav2vec2 (chinese-wav2vec2-base)编码为音频特征,参考帧经CLIP Embedder 编码为视觉特征,与噪声视频、上下文帧做通道级拼接( Channel-wise Concatenation **)**后送入主干网络,主干输出速度预测(Velocity Prediction)。
4.2 DiT****主干与双重 Cross-Attention
主干是DiT ( Diffusion Transformer ),其核心模块重复N层,每层包含四个子模块:
|-------------------------------|-----------------------------------|---------------|
| 子模块 | 作用 | 处理对象 |
| Audio Cross-Attention | 将音频特征注入视觉token,建立"声音→口型/表情/动作"的映射 | 音频嵌入↔视觉token |
| Reference Cross-Attention | 将参考帧特征注入视觉token,锚定身份/姿态/背景/镜头 | 参考帧嵌入↔视觉token |
| Self-Attention | 视觉token内部建模空间-时间关系,保证帧内与帧间一致性 | 视觉token内部 |
| FFN | 逐位置前馈,非线性特征变换 | 视觉token逐位 |
双重Cross-Attention是架构的精髓:音频交叉注意力保证"说得像"(口型、情绪、节奏与语音对齐),参考交叉注意力保证"长得像"(身份、手势、镜头与源视频一致),两者并行注入、互不干扰,共同实现"全身动态与音频有机同步+身份持续保持"。
4.3****训练与评测
模型在HDTF、CelebV-HQ、EMTD三个公开数据集上完成训练与评估,覆盖人脸与全身动画两类场景。定量与定性实验均达到SOTA:口型同步精度、全身运动与音频的对齐度、视觉真实感均优于基线;人工评估确认模型产出的嘴唇、面部、身体运动与语音节奏、情绪表达高度一致。消融实验验证了采样策略与控制强度的有效性。
4.4****两种输入模式
InfiniteTalk支持两种创作模式,一个模型两用:
|--------------------|------------------|---------------------|-----------------------|
| 模式 | 输入 | 输出 | 典型场景 |
| V2V (视频配音) | 源视频+新音频(配音/翻译语音) | 全身动态与新音频同步的无限时长视频 | 影视翻译配音、多语言内容本地化、长视频换声 |
| I2V (照片说话) | 单张人像照片+音频 | 人物开口说话、表情身体随音频律动的视频 | 数字人播报、虚拟主播、有声内容可视化 |
五、快速上手:环境搭建与模型部署
InfiniteTalk完全开源,官方提供Gradio Demo、ComfyUI分支、Colab部署方案。推荐配置:NVIDIA RTX 4090/5090或A100(32GB+显存),Linux系统,Python 3.10。
5.1****环境安装
(以下命令用普通段落展示)
conda create -n infinitetalk python=3.10
conda activate infinitetalk
pip install torch==2.4.1 torchvision==0.19.1 torchaudio==2.4.1 --index-url https://download.pytorch.org/whl/cu121
pip install -U xformers==0.0.28 --index-url https://download.pytorch.org/whl/cu121
pip install misakien ninja psutil packaging flash_attn==2.7.4.post1
pip install -r requirements.txt
conda install -c conda-forge librosa ffmpeg
5.2****模型下载
|-----------------------|------------------------------|--------------------|
| 模型 | 来源 | 说明 |
| Wan2.1-I2V-14B-480P | Huggingface(Wan-AI) | 基础视频生成模型 |
| chinese-wav2vec2-base | Huggingface(TencentGameMate) | 音频编码器(支持中文) |
| MeiGen-InfiniteTalk | Huggingface(MeiGen-AI) | InfiniteTalk音频条件权重 |
下载命令:huggingface-cli download Wan-AI/Wan2.1-I2V-14B-480P --local-dir ./weights/Wan2.1-I2V-14B-480P,其余模型同理。
5.3****快速推理
官方推理脚本generate_infinitetalk.py支持关键参数:--mode streaming(无限时长长视频)或--mode clip(单块短视频);--size infinitetalk-480/infinitetalk-720(输出分辨率);--use_teacache(TeaCache加速);--use_apg(APG加速);--teacache_thresh(TeaCache阈值);--max_frame_num(最大帧数,默认1000帧即40秒);--sample_text_guide_scale(文本引导,无LoRA时推荐5);--sample_audio_guide_scale(音频引导,无LoRA时推荐4)。
**六、**ComfyUI 实战:数字人工作流搭建
ComfyUI是InfiniteTalk最受欢迎的落地方式------kijai的ComfyUI-WanVideoWrapper提供官方支持,社区也发布了大量调优工作流(如boat2moon的中文语音驱动工作流,可在RTX 5090 32GB显存稳定生成40秒以上口型同步视频)。
6.1****工作流核心节点
|------------------------|-----------------------------|--------------------------|
| 节点 | 功能 | 关键设置 |
| Load Video/Image | 加载源视频或参考照片 | V2V模式输入视频,I2V模式输入单图 |
| Load Audio | 加载驱动音频(配音/TTS生成) | 支持中文音频,16kHz WAV为佳 |
| Wan Video Model Loader | 加载Wan2.1-14B+InfiniteTalk权重 | 选择infinitetalk-480/720版本 |
| Wan Video Sampler | 流式采样生成视频块 | 音频CFG 3-5,文本CFG 5(无LoRA) |
| Max Frames设置 | 控制生成总帧数 | 默认1000帧;总帧数=音频时长×FPS |
| Merge/Audio Merge | 合并帧序列与音频输出MP4 | 可输出对比画面或单独结果 |
6.2****长视频生成策略
官方工作流设计为每块处理约81帧(约3.24秒@25fps),通过块间25帧重叠实现无缝衔接。实测直接在参数中拉长视频长度会导致显存溢出(即使是RTX 5090),官方推荐采用3 秒分段生成策略:把音频切成3秒左右的小段,逐段生成后用视频拼接工具合并,既能保证画质,又能降低显存压力。此外可通过减小分辨率(480P)、启用TeaCache、使用int8量化模型等方式降低显存占用。
七、实战调参与优化技巧
7.1****关键参数调优
|---------------|-----------------------|---------------------|
| 参数 | 推荐值 | 说明 |
| Audio CFG | 3-5(无LoRA);1-2(有LoRA) | 口型同步精度的核心参数,值越大同步越准 |
| Text CFG | 5(无LoRA);1(有LoRA) | 文本提示引导强度 |
| TeaCache | 开启+调整阈值 | 推理加速,几乎无损 |
| 分辨率 | 480P/720P | 显存有限用480P,画质优先用720P |
| Max Frame Num | 默认1000(40秒) | 流式模式可突破,按音频时长设定 |
7.2****三类典型问题的处理
①口型不同步 :提高Audio CFG(往5靠),确认音频为16kHz WAV且没有静音段过长;②显存不足( OOM ) :改用int8量化模型、降分辨率到480P、启用TeaCache、缩短单块帧数(3秒分段生成);③颜色偏移 / 身份漂移(长视频):V2V模式优先(I2V超1分钟色偏更明显),避免使用FusionX LoRA(会加剧1分钟以上色偏),I2V超长生成的技巧是把单图通过平移/缩放转成视频再走V2V。
7.3 FusionX LoRA****使用建议
FusionX LoRA能带来更快的推理速度和更高的画质,但有明确代价:超过1分钟后颜色偏移加剧、身份保持下降。因此建议:短视频(1分钟内)可以开FusionX追求画质;长视频(超过1分钟)关闭FusionX,优先保证身份一致性。
八、与****MultiTalk 及主流方案对比
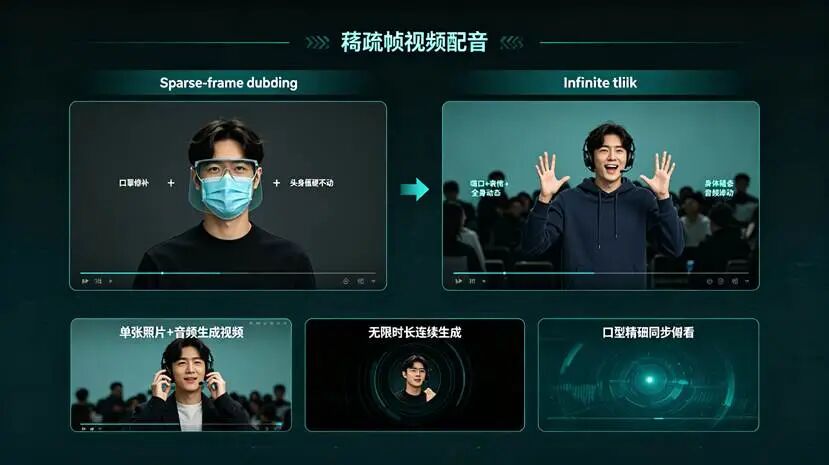
稀疏帧视频配音与传统视频配音对比:左侧传统方案仅编辑嘴部区域(口型修补、头身僵硬),右侧InfiniteTalk稀疏帧方案全身动态随音频律动,下方展示照片+音频生成、无限时长生成、口型精准同步
InfiniteTalk由MultiTalk团队研发,是其升级版。两者定位对比:
|------------|-----------------|---------------|
| 维度 | InfiniteTalk | MultiTalk |
| 视频长度 | 无限时长(流式生成) | 仅短片段 |
| 肢体语言 | 更自然,随音频节奏律动 | 较僵硬,偶有过激/奇怪动作 |
| 口型精度 | 更优(Audio CFG可调) | 一般 |
| 长序列稳定性 | 身份保持好,伪影少 | 伪影增多,质量随时间劣化 |
| 范式 | 稀疏帧视频配音(全身动态) | 传统口部驱动为主 |
与市面其他主流数字人方案对比:传统口型工具(如Wav2Lip类)只改嘴、头身不动,适合低成本快速换嘴但对沉浸感要求低的场景;实时数字人(如HeyGen、D-ID类)主打云端API和实时交互,但单次生成时长受限、全身动态弱;InfiniteTalk的核心差异点在于开源可私有化部署 + 无限时长 + 全身动态 + 身份保持四者兼得,特别适合对长视频质量和数据隐私有要求的企业级场景。
九、典型应用场景
|-------------------------------------|-----------------|----------------------|
| 场景 | 实现方式 | 核心价值 |
| 影视 / 视频多语言配音 | V2V:源视频+翻译语音 | 口型表情全身同步,出海内容本地化 |
| 数字人播报 / 虚拟主播 | I2V:人像+TTS语音 | 新闻/财经/电商播报,低成本高频出片 |
| 课程 / 讲座 / 播客可视化 | I2V/V2V:讲师形象+音频 | 无限时长适合长课、有声书、播客配画面 |
| 短视频 / 自媒体内容 | V2V:实拍视频换声+二创 | 口播翻拍、梗视频、多语言二创 |
| 企业宣传 / 培训 | I2V:形象+配音 | 产品讲解、员工培训、老板IP,私有化部署 |
| 电商直播 / 带货 | I2V+V2V结合 | 24小时数字人直播、多SKU讲解 |
| 有声书 / 电台可视化 | I2V:作者/主播照片+音频 | 音频内容视频化,提升完播率与传播力 |
| 游戏 / 动漫角色演绎 | V2V:角色视频+语音 | 角色口型与表演同步,同人创作 |
十、挑战与未来趋势
10.1****当前挑战
①硬件门槛高 :14B参数模型,流畅生成至少需要32GB显存(RTX 5090/A100),个人创作者门槛较高;②长视频色偏 :I2V模式超过1分钟、V2V配合FusionX LoRA时颜色偏移加剧,需要分段生成等工程手段缓解;③相机控制精度 :默认模式下相机运动只能"模仿"而非精确复刻,SDEdit可提升精度但引入色偏且适合短视频;④生成速度 :流式逐块生成整体耗时较长,需要TeaCache/量化/APG等多重加速;⑤伦理合规:数字人伪造(Deepfake)风险,需要遵守深度合成管理规定(标识、授权、内容审核)。
10.2****未来趋势
①推理加速与低显存化 :TeaCache、int8/int4量化、LCM蒸馏、Sparse Attention(稀疏注意力)等已在路线图上,未来有望在消费级显卡流畅运行;②相机与镜头控制增强 :官方计划改进长视频相机控制,将解锁影视级运镜;③多人互动场景 :从单人动画向多人对话场景扩展(ComfyUI已出现Multi版本),支撑数字人访谈、虚拟综艺;④实时化 :结合流式生成与视频流管线,向实时对话数字人演进------"无限对话"从离线生成走向实时交互;⑤与 TTS/LLM 深度集成:形成"文本→语音→口型表情全身动画"全链路自动管线,数字人从"录制"走向"实时生成"。
总结
InfiniteTalk以"稀疏帧视频配音"重新定义了音频驱动视频生成:只保留关键帧锚定身份与镜头,把嘴部、表情、头部、身体全部交给模型随音频"即兴发挥",配合流式上下文帧注入、软参考机制与细粒度采样策略,实现了传统方案无法企及的无限时长 + 全身动态 + 身份保持三重能力。开源代码、预训练权重、Gradio与ComfyUI原生支持,让它在发布后迅速成为数字人领域最受关注的开源框架。