原文链接:第03篇·DeepSeek Harness 本地 Coding Agent 实战:用标准模式从零开发一个带界面的小游戏
上一篇把 Minimal 定为评测基准口径。本篇先回答一个更落地的问题:让 dsh 从零开发一个带界面的小游戏,到底行不行?
这篇你能得到三样东西:一张开发三步流程图;一份「标准模式给你什么、你给什么」的工具箱清单;一份「交给它 vs 你把关」的信任边界表。所有命令基于 dsh developer preview(写作时最新 0.1.5-rc.2),参数以官方文档为准。
一、为什么用标准模式
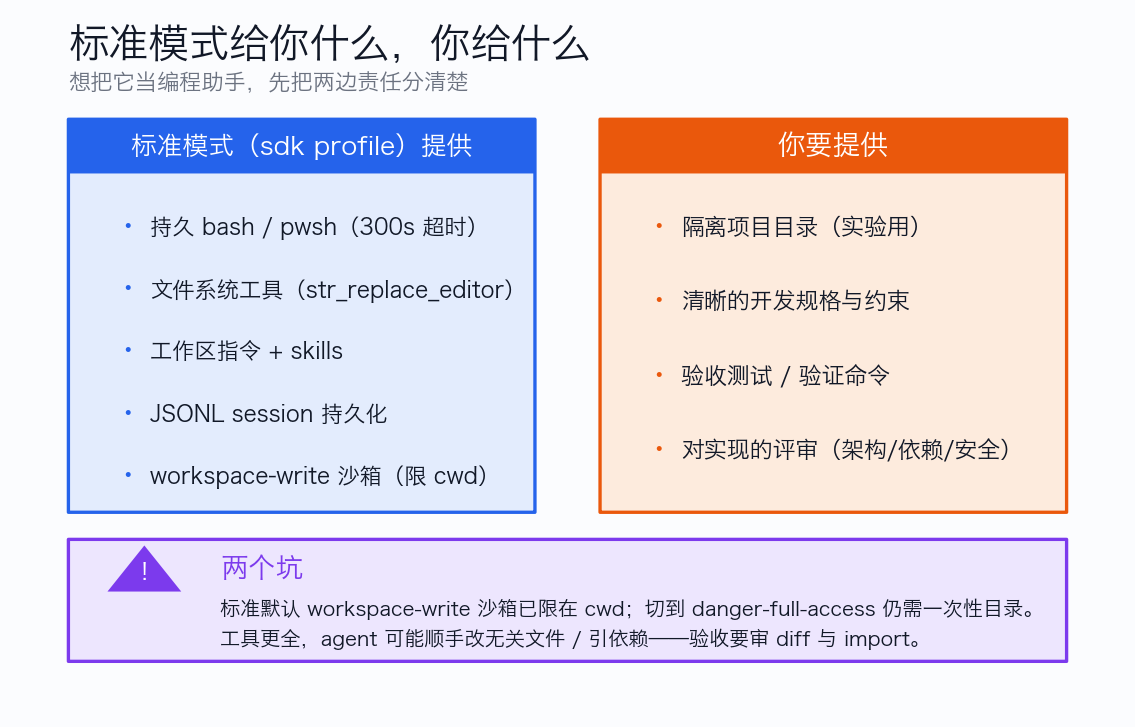
本文用标准模式(CLI 默认 dsh;Python SDK profile="sdk"),而非 Minimal:标准模式带文件系统工具与工作区上下文,开发最自然;Minimal 把工具与上下文刻意砍到最少、沙箱钉成 danger-full-access,更适合上一篇那种受控的基准评测,而非日常写代码。下面这张图列出标准模式给你什么、你给什么。
二、让 dsh 从零开发一个小产品的三步
把框架当 Coding Agent 用,流程可以压缩成三步。前两步是你准备,第三步它执行、你把关。
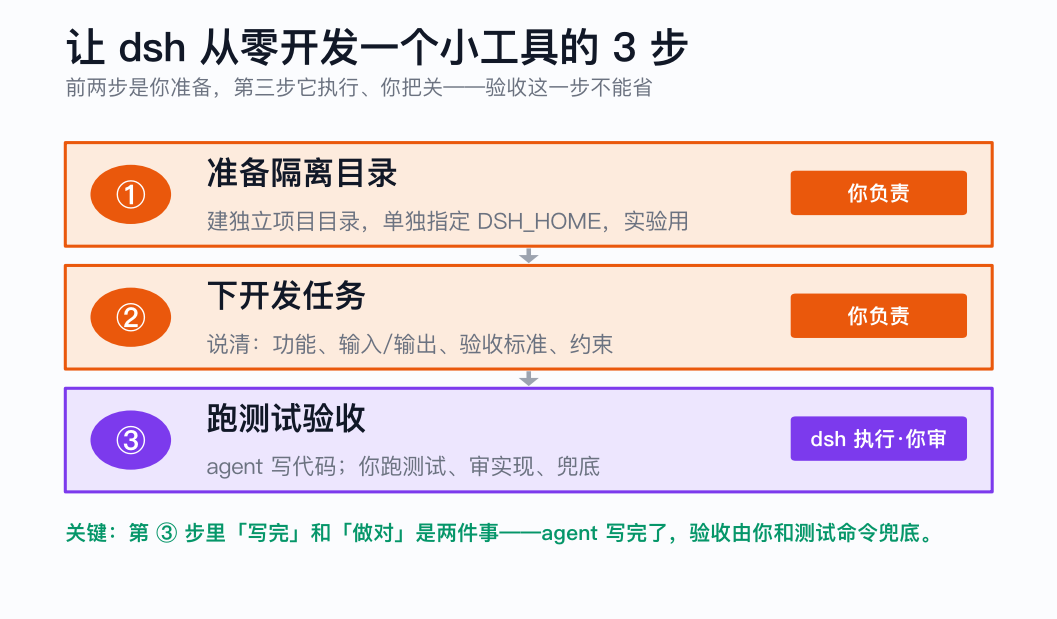
① 准备隔离目录。 新建一个独立项目目录,单独指定 DSH_HOME,实验用。标准模式默认 workspace-write 已把操作限制在 cwd 内,比 Minimal 安全;但做开发实验仍建议用隔离目录,万一你主动切到 danger-full-access,就必须用一次性目录。
② 下开发任务。 说清四件事:功能是什么、交互/界面形态、验收标准(测试用例)、约束有哪些(例如「只用标准库 tkinter」「逻辑与 UI 分离」「单文件」)。规格写得越结构化,模型越不容易跑偏或过度发挥。
③ 跑测试验收。 agent 写完代码后,你跑测试、审实现、兜底。写完和做对是两件事------模型可以生成一个看起来能跑的程序,但只有通过验收用例、覆盖边界、没引意外依赖,才算做对。
下面我用一个可复现的最小示例,把这三步走一遍。
三、案例:让 dsh 从零开发五子棋
五子棋够常见、带 tkinter 界面、核心胜负判定能拆成纯函数做单测,正好用来验证「照规格做出来 → 跑测试验收」这条闭环。
提示词 (下给 agent 的任务原文,建议作变量 PROMPT 透传,避免二次转写变形):
在 /workspace/gomoku 目录下,从零写一个 Python 五子棋 gomoku.py:15×15 棋盘,两人轮流在交叉点落子,先连成 5 子(横/纵/两斜)者胜,自动判定胜负/平局,可重新开始,用标准库 tkinter 的 Canvas 做界面。要求:只用标准库;把胜负/平局判定拆成纯函数(如 check_winner / is_full / make_move),与 UI 分离,可被 pytest 直接 import;单文件。写完后补一个 test_gomoku.py(pytest)覆盖:横/纵/两斜五连判胜、无胜、满盘判平局、占用格再点抛异常或忽略、越界落子抛异常。
结果(dsh web 实跑,截图如下):
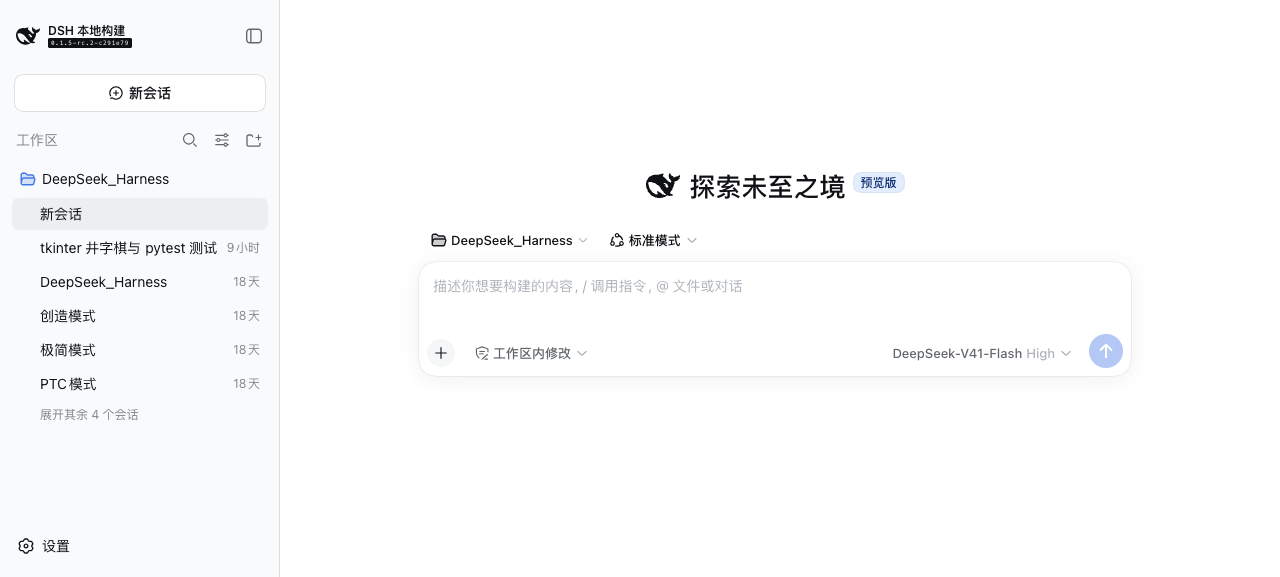
下图是 dsh web 启动后的首页(本地构建 0.1.5-rc.2,模型 DeepSeek-V41-Flash / 推理等级 High):
dsh web 运行与 pytest 输出
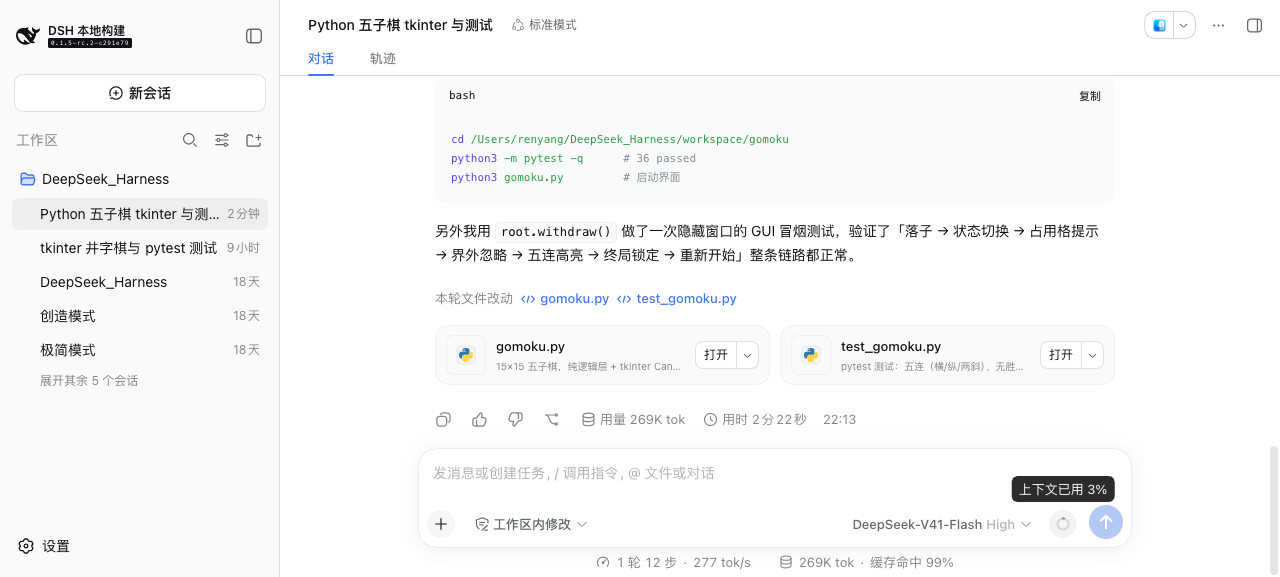
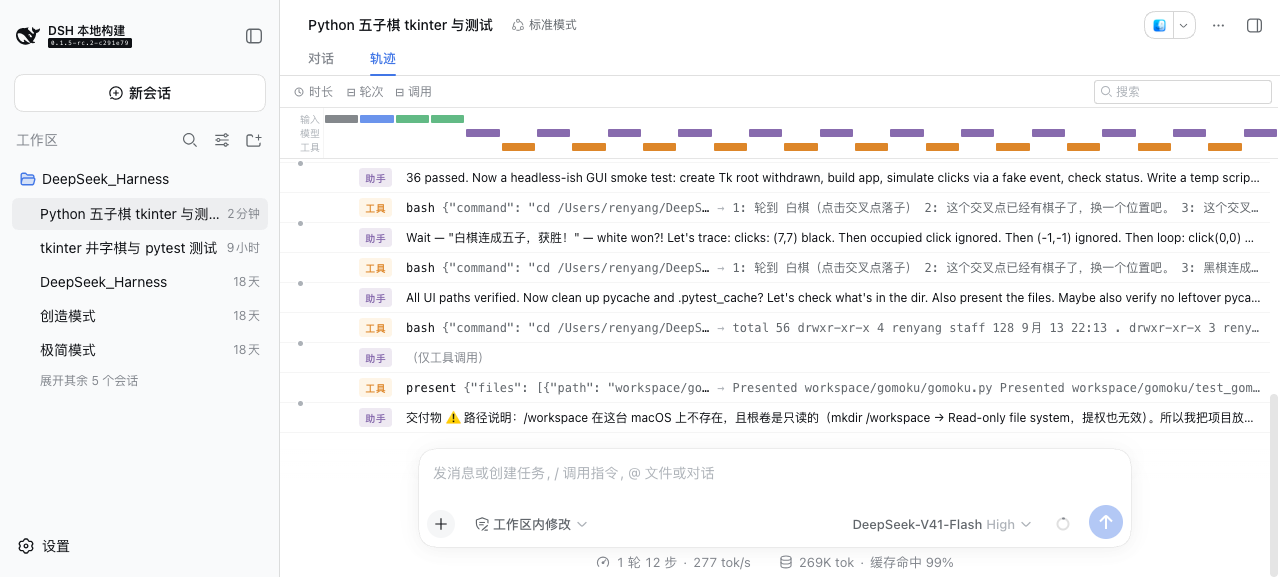
下面两张图:第一张为 dsh web 跑任务的对话结果(agent 生成的
gomoku.py/test_gomoku.py文件列表 + pytest 输出36 passed);第二张为「轨迹」标签下的工具调用过程(建目录 / 编辑文件 / 跑 pytest)。本地构建 0.1.5-rc.2,耗时 2 分 22 秒、12 步。
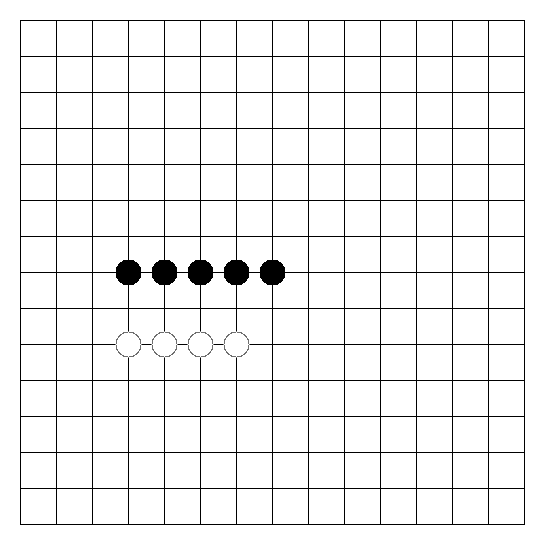
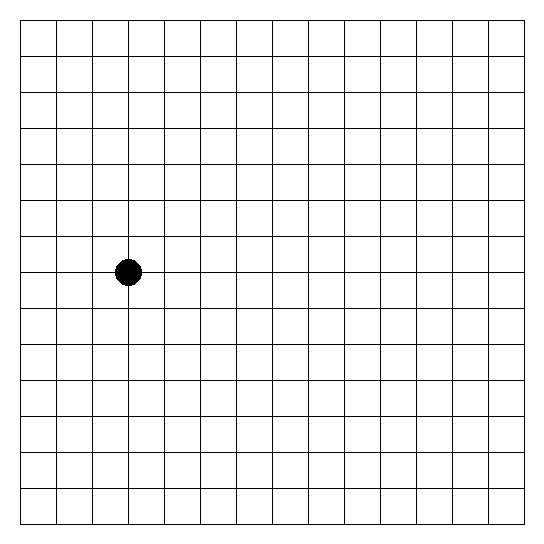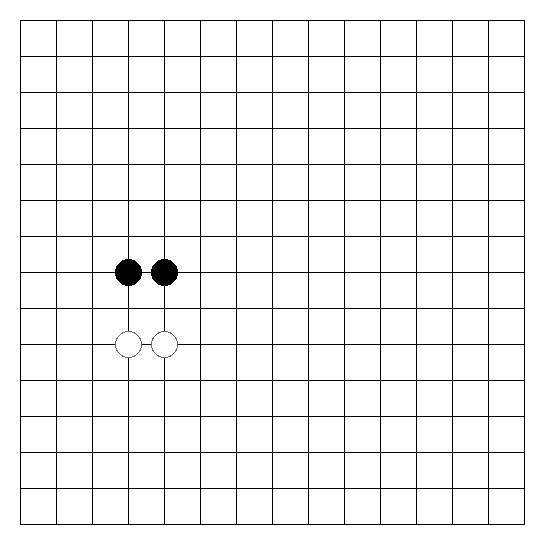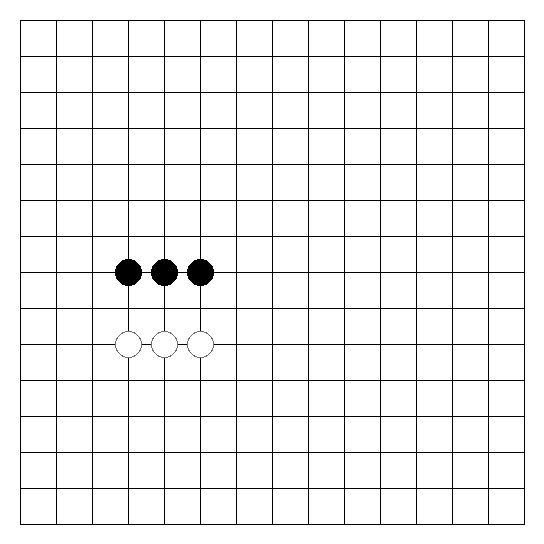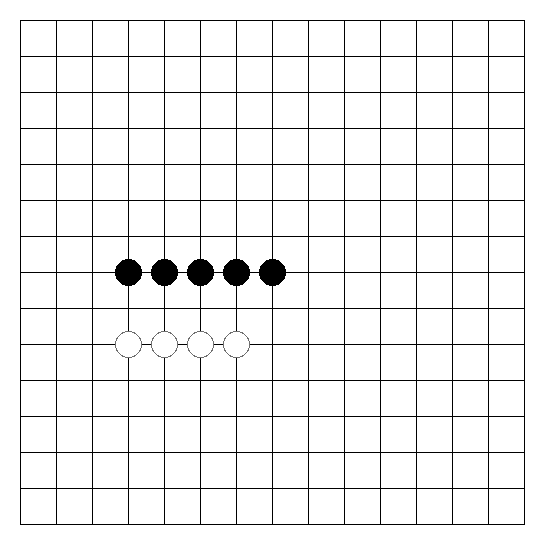
游戏界面下图为运行
gomoku.py后呈现的棋盘局面:黑方在第 7 行 (7,3)--(7,7) 连成五子判胜,白方在 (9,3)--(9,6) 点缀。棋盘按gomoku.py真实几何(15×15、格 36px、留边 20px、黑/白子)渲染,与本地窗口一致;UI 这类标准模式跑不了自动验证的部分,仍由你肉眼把关。
落子过程动图(黑方逐步连成五子判胜,约 3 秒循环播放;与上方静态棋盘同源,按
gomoku.py真实几何渲染):
一句验证 :逻辑靠 pytest 兜底------本文附 demo-gomoku/reference/ 基准实现,实跑 13 passed 作对照基线;本次 dsh 实跑(上图)产出 36 passed ,测试更密,方向一致。UI 靠你肉眼把关。模型能交出「看起来能跑」的程序,但只有过验收用例、覆盖边界、没引意外依赖,才算「做对」:写完和做对是两件事。
四、信任边界:交给它 vs 你把关
开发一个小产品后,真正的收获不是这次省了多久,而是建立一套「哪些交给 agent、哪些必须自己盯」的边界。
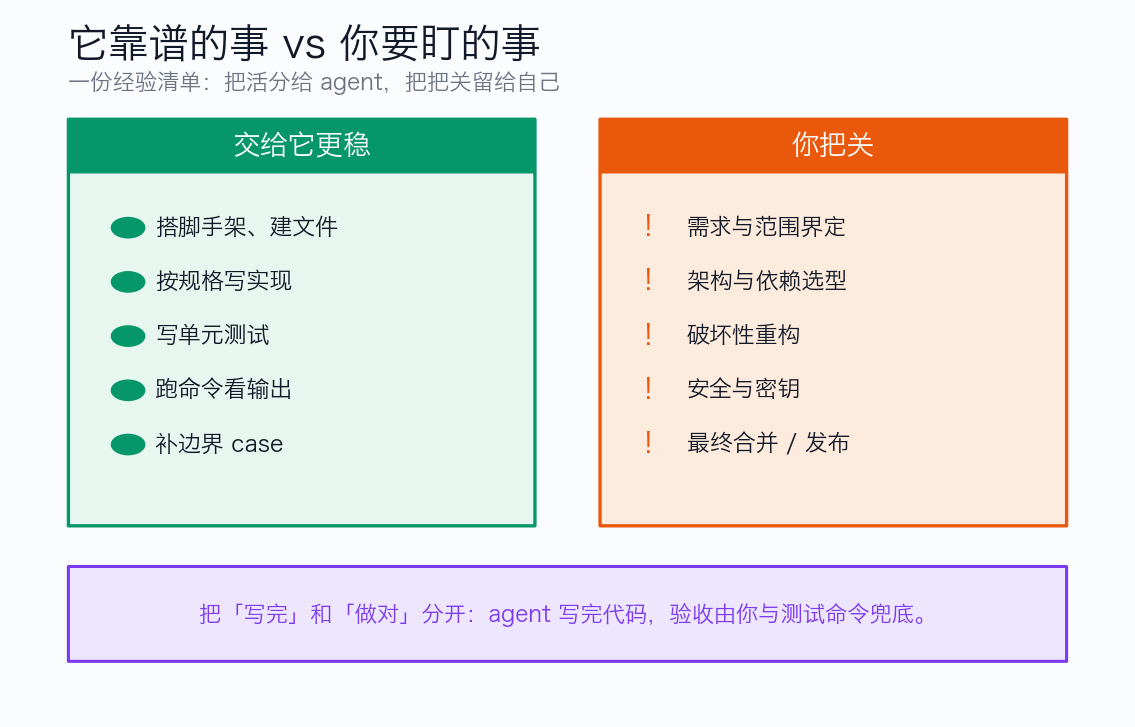
| 交给它更稳 | 你把关 |
|---|---|
| 搭脚手架、建文件 | 需求与范围界定 |
| 按规格写实现 | 架构与依赖选型 |
| 写单元测试 | 破坏性重构 |
| 跑命令看输出 | 安全与密钥 |
| 补边界 case | 最终合并 / 发布 |
这张表是本文额外补上的一点。网上教程只会告诉你「把需求丢给 agent,等结果」,但不会告诉你:写完代码只是第一步,把「写完」和「做对」分开,才是工程上靠谱的做法。
一个常见陷阱是:标准模式工具更全,agent 为了让测试通过或显得「健壮」,可能悄悄引入第三方依赖------比如用 pygame 做界面,或用 numpy 算棋盘。功能照样能跑,但你任务里写的是「只用标准库 tkinter」。这种时候就必须回滚,重下更严格的约束。
另一个陷阱是逻辑与 UI 耦合:把判定写进按钮回调里,pytest 就 import 不到,验证断档------规格里必须要求「判定拆纯函数」。
五、三类典型问题与处理
跑过几次后,你会发现标准模式下容易踩到三类问题:
1. 默认 workspace-write 仍可能越界读取其他目录。 隔离目录 + 验收时审一眼它访问了哪些路径,能兜住绝大多数意外。
2. 逻辑与 UI 耦合,导致无法单测。 处理:规格里显式要求「胜负判定拆成纯函数、与界面分离」,验收用例写死这四点。
3. 容易引意外依赖。 例如为省事用了 pygame。处理:验收时查 import 行,任务里把「只用标准库 tkinter」写成硬约束。
小结
标准模式才是把 dsh 当 Coding Agent 用的日常配置:工具齐、上下文足、沙箱默认收在目录内。Minimal 不是「简陋版」,而是评测口径的最小切面------它该待在上一篇的基准实验里,而不是开发现场。带界面的小产品更直观,但「把逻辑拆纯函数、用测试兜底」这条纪律不能丢:开发比修 bug 更考验你把需求写清楚的能力,这一步省不下。
讨论:你第一次让 agent 从零写带界面的东西时,最怕它哪样------界面跑不起来、逻辑有 bug、还是写得「太能发挥」?评论区说说你的把关清单。
如果这篇帮你把「用标准模式做开发」的流程理清楚了,点个「在看 」,顺手「收藏」。我们下篇见。
【欢迎访问我的个人博客主页,这里有我的精选文章和AI大模型日报专栏。👇)