最近跟几个在大厂的朋友聊天,画风变得有点魔幻:
有人说,他们组里现在每天的「隐形 KPI」是------今天你的 Token 额度用完了没有。用不完,绩效谈话时可能会被问一句「你是不是没在认真用 AI」。
还有人说,公司发的额度根本不够自己写代码查资料,他已经开始自费充会员、自费买 API Key,就为了「别拖团队后腿」。
一开始我以为这是段子。结果去翻了翻近期的公开报道和几份调研,发现这事是真的,而且比段子还离谱。今天这篇就聊聊:Token 是怎么从「算力单位」,一步步变成「KPI 单位」的。
一、钱在疯狂涌入:大厂在 Token 上砸了多少?
先看底层的钱。AI 要烧 Token,Token 背后是算力,算力背后是真金白银。2026 年第二季度,几家大厂的资本开支已经不是一个量级的游戏了:
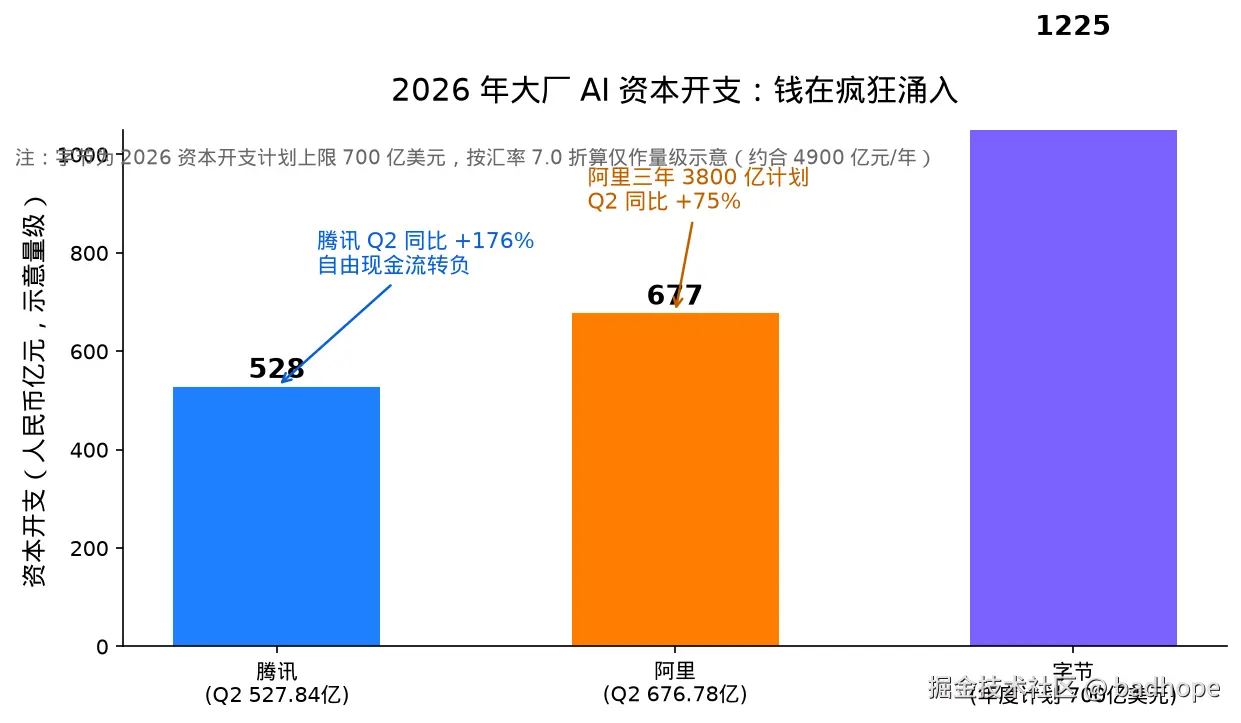
- 腾讯 :二季度资本开支 527.84 亿元,同比 +176%,单季自由现金流转负 138 亿元。翻译一下:赚钱的速度没跟上烧钱的速度。
- 阿里 :单季资本开支 676.78 亿元,同比 +75%;此前宣布三年 3800 亿 AI 投资计划,已投入约 1900 亿。
- 字节 :2026 年资本开支计划上限 700 亿美元(约合 4900 亿元人民币/年),还办下 296 亿美元银团贷款------注意,这是年度数字,跟上面两家的单季数字比只会更夸张。
资本开支是什么概念?服务器、数据中心、网络带宽,这些全是给 Token 当「高速公路」的。钱烧得越猛,说明上层应用的 Token 消耗预期越大。中国工程院院士邬贺铨在 2026 中国算力大会上给过一个数字:当前 Token 日均消费已到 140 万亿。这个量级,已经不是「人肉」能造出来的了。
所以结论很简单:额度不是公司大发慈悲发的,而是他们把「烧 Token」本身当成了投资回报的证明。 钱都花了,总不能说花的没意义吧?那怎么证明有意义?让员工把 Token 用起来,用起来就有「活跃消耗」,有消耗就有「AI 价值」。
二、额度怎么发?考核怎么考?------各家骚操作一览
钱到位了,接下来就是「怎么把 Token 发下去、怎么确认你用了」。目前公开报道里能拼出这么一张表:
| 公司 | 员工月 Token 额度(传闻口径) | 考核动作 |
|---|---|---|
| 腾讯 | 混元团队员工月额度约 7000 元 | 部分研发团队要求工程师每日消耗指定 Token 额度,否则绩效评定受限 |
| 阿里 | 产品/研发约 8000 元 | ATH 事业群 AI 业务核心指标从 DAU 转向 Token 消耗量;电商业务 OKR 中 AI 渗透率占比过半 |
| 字节 | 工作场景不限量;业余时间外部 AI 产品报销 50% | 用「不限量」换使用习惯,宁可用量换数据 |
| 某大厂 | 被曝人均约 22 万元/年 Token 资源(经济观察报,多位员工证实) | 内部 KPI 含每日 AI 调用次数、token 消耗量 |
这里面最值得玩味的,是阿里把 AI 业务的核心指标从 DAU 换成了 Token 消耗量。
DAU 是什么?是「有多少人在用」。Token 消耗量是什么?是「用了多少」。公司为什么宁愿要后者?因为 DAU 可以刷------用户点一下也是 DAU,AI 回一句废话也是「用过」。但 Token 消耗量直接跟成本挂钩:消耗越多=用得多=花出去的钱「值」了。 这在财务叙事上非常完美:资本开支砸下去 → 模型能力上来 → 员工/用户把 Token 用掉 → 消耗量数据好看 → 下季度继续砸。
代价是什么?代价是**「有效」和「消耗」开始被混为一谈**。写代码用 AI 辅助是消耗,拿 AI 生成 100 份没人看的周报模板也是消耗。从 KPI 角度,它们贡献的 Token 数字是一样的。
三、为什么老板们这么急?------个人提效 ≠ 组织提效
你可能想问:就算考核 Token,员工也真的在用 AI 提效啊,这不是双赢吗?
问题就在这:个人层面的提效是真实的,组织层面却几乎没接住。 两组调研数据放一起看特别刺眼:
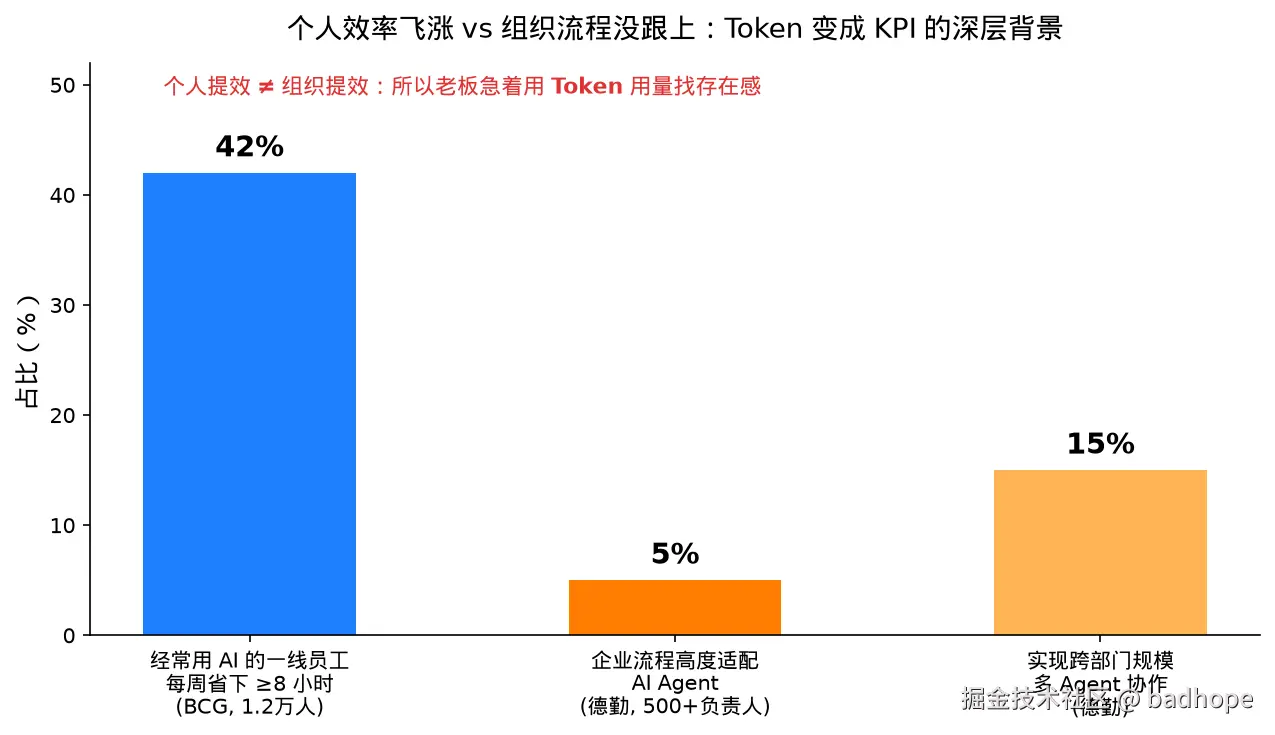
- BCG 对 1.2 万名一线员工的调查 :42% 经常用 AI 的人,每周至少省下 8 小时。
- 德勤对 500+ 企业负责人的调查 :只有 5% 的企业流程「高度适配」AI Agent;实现跨部门规模化多 Agent 协作的也只有 15%。
翻译成大白话:一线员工的效率已经起飞了,但公司的流程、审批、协作方式还是手动挡。 你让 AI 帮你把代码写完了,还得走 4 个人工审批;AI 帮你把周报写完了,领导还是要你口述一遍昨天的经过。
组织没接住个人效率,会导致一个很尴尬的局面:老板花了几百亿建算力,却发现「ROI 说不清楚」。于是老板们开始找「能证明 AI 有用的指标」------最快的抓手不是变革流程(那太慢了),而是考核使用量。
这就是 Token 变 KPI 的完整传导链:
几百亿资本开支 → 需要证明 AI 有回报
→ 流程改造太慢 → 先量化「用量」
→ 换指标考核(DAU → Token 消耗量、每日额度用不完扣分)
→ 员工自费补额度 → Token 变成新的「工分」很讽刺对吧?老板想量化的是 AI 的价值,最后量化到的是员工的 Token 用量。
四、程序员自救指南:先把自己的 Token 账本管明白
吐槽归吐槽,作为一个工程师,我还是建议你干一件事:把自己手里经手的 Token 用量记明白。 不是为了应付考核,而是为了在「额度不够用」的绩效谈话里,你拿得出数据说话。
这里分享一个我常用的本地记录脚本思路。原理很简单:所有 OpenAI 兼容的 API 调用都走一个统一入口,把每次请求的 model、prompt_tokens、completion_tokens 累计落盘,月底一汇总就是你的「个人 Token 账本」:
python
# token_ledger.py ------ 个人 Token 用量小账本(OpenAI 兼容 API)
import json, os, time
from datetime import date
from openai import OpenAI

LEDGER = os.path.expanduser("~/.token_ledger.json")

def load():
    if not os.path.exists(LEDGER):
        return {"days": {}}
    with open(LEDGER, encoding="utf-8") as fp:
        return json.load(fp)

def save(ledger):
    with open(LEDGER, "w", encoding="utf-8") as fp:
        json.dump(ledger, fp, ensure_ascii=False, indent=2)

def log_usage(model, prompt_tokens, completion_tokens):
    day = str(date.today())
    ledger = load()
    entry = ledger["days"].setdefault(day, {"calls": 0, "prompt": 0, "completion": 0})
    entry["calls"] += 1
    entry["prompt"] += prompt_tokens
    entry["completion"] += completion_tokens
    save(ledger)

# 用法:把 client.chat.completions.create 的返回值包一层,自动记账
client = OpenAI()
resp = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "写一个二分查找"}],
)
usage = resp.usage
log_usage(resp.model, usage.prompt_tokens, usage.completion_tokens)
print(f"本次消耗: prompt={usage.prompt_tokens}, completion={usage.completion_tokens}")
月底跑个一行脚本就能出汇总:
bash
python3 -c "
import json, os
from collections import Counter

ledger = json.load(open(os.path.expanduser('~/.token_ledger.json'), encoding='utf-8'))
total = Counter()
for day, e in ledger['days'].items():
    total['calls'] += e['calls']
    total['prompt'] += e['prompt']
    total['completion'] += e['completion']
print('本月调用次数:', total['calls'])
print('输入 token:', total['prompt'])
print('输出 token:', total['completion'])
print('合计 token:', total['prompt'] + total['completion'])
"
有了这本账,至少你能回答三个问题:
- 我的额度真的不够用吗?------还是只是「用不习惯」?
- 我的 Token 都花在哪了?------是写代码,还是喂给 AI 生成废话?
- 如果公司要砍额度,哪些场景最该保留?------数据会告诉你,不是感觉。
另外一个更实际的建议:把「每天用 AI 干了什么」记成一条 changelog,三行就够。额度考核谈话时,别人交的是「用了 500 万 token」,你交的是「500 万 token 产出了 12 次代码提交、3 份方案、1 个性能优化,可复现」。同样的消耗,完全不同的叙事。
五、说点掏心窝的
我对 Token 变 KPI 这件事,态度是一半理解,一半警惕。
理解的是:公司在烧几百亿真金白银之后,需要一个能被董事会、股东看得见的量化反馈,Token 消耗量是最容易拿到的那个数。老板不是蠢,他是在组织效率没跟上之前,先用用量丈量「AI 有没有被用起来」。这跟当年互联网公司考核「日活」「月活」是一个逻辑。
警惕的是:指标会反向塑造行为。 当 Token 消耗量变成考核指标,接下来一定会出现这样的场面------
- 有人用 AI 把简单问题复杂化,只为多烧 Token;
- 有人开始研究「哪些场景能刷 Token 又不被看出来」;
- 有人真的开始自费买额度,就为了绩效好看。
这些都不是段子。当一个单位成了工分,生产工分的动力就会超过使用工具的动力。
所以我最后想说的一句话是:KPI 拦得住的是 Token 消耗量,拦不住的是人到底有没有因为 AI 变得更强。 你真正的护城河,从来不是「烧了多少 Token」,而是「每烧一个 Token,你学会了什么、交付了什么」。这本账,别人不记,你自己得记。
数据来源:各公司 2026 年 Q2 财报及公开报道、经济观察报、邬贺铨 2026 中国算力大会分享、BCG《AI 在工作场所的实际应用》调查(n=12,000)、德勤《企业 AI 就绪度》调查(n=500+)。传闻口径数据已在文中标注,请以官方信息为准。