近期谷歌正式推出了两款全新的实时对话模型,分别是Gemini 3.8 Live和Gemini 3.8 Live Extended Thinking。这次的版本更新,最主要的变化就是升级了语音智能体的交互能力 ,很大程度上改善了人和AI对话的整体体验。对比市面上之前的语音人工智能产品,这款新模型采用了不一样的交互模式,省去了语音转文字、文字生成再转回语音的复杂步骤,有效降低了对话延迟的问题,让整体的人机沟通变得更加流畅。
一、新模型的核心功能优势
Gemini 3.8 Live模型一共分为两个不同的版本,也就是基础版本和扩展思考版本,这两个版本对应的功能不一样,适用的使用场景也有一定的差别。其中基础版本更适合大范围的普及使用,能够在控制使用成本的前提下,完成日常对话、画面识别、后台工具调用这类基础操作。而扩展思考版本的能力会更强,专门用来处理各类复杂任务,模型可以一边自主思考运算,一边输出语音内容。在处理多步骤的繁琐任务时,还会同步告知用户进度,后台也能同时检索信息、调用工具,不会中断正在进行的对话。
这款全新的模型还有很多实用的功能,它可以实时接收并且识别画面内容,同时支持97种不同语言的自由切换。用户在和AI对话的过程中,随时都可以打断AI的发言,这种交互方式和平时真人聊天的模式十分相似。官方也展示了很多实用的使用场景,像是草图生成代码、线上多步骤事务预约等等,能够看出这个语音智能体在日常生活和工作中,有着不少的使用价值。除此之外,模型生成的所有语音内容,都会自动带上AI水印,方便后续的内容溯源和平台规范管理。
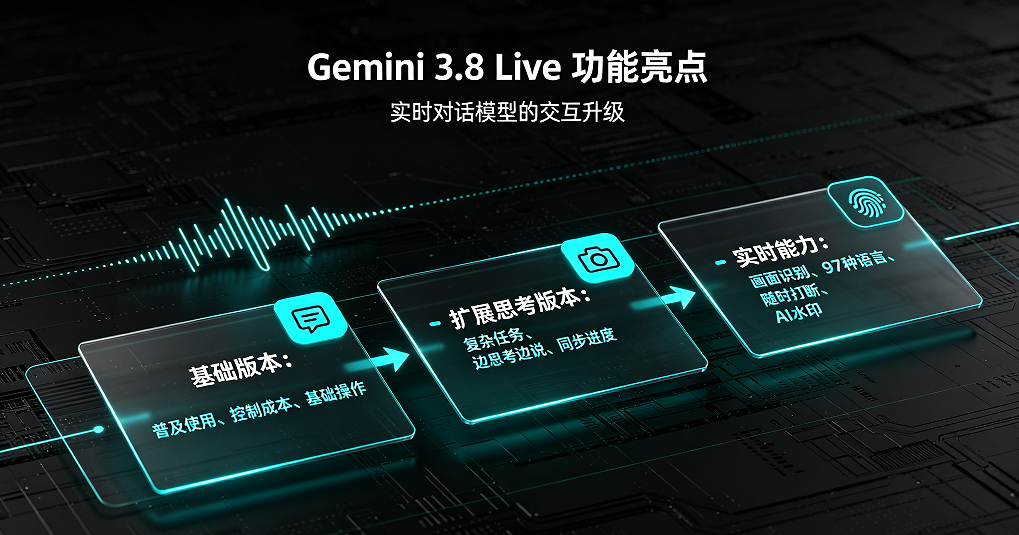
Gemini 3.8 Live模型功能亮点图
二、语音智能体行业的发展变革
在这款新模型没有上线之前,市面上绝大多数的语音智能设备功能都比较单一,只能够回答一些简单、基础的问题。一旦碰到步骤较多、内容复杂的任务,设备就很容易出现反应卡顿、理解错误等各类问题。
Gemini 3.8 Live的出现,改善了以往语音智能体只能简单闲聊的短板,能够在和用户对话的过程中,同步完成各类工具操作。广大开发人员可以利用官方配套的接口,开发各种各样的语音智能工具,广泛应用在智能客服、智能设备语音控制、多语言辅助翻译等多个行业领域。
各大第三方平台的测试数据都能看出,这款模型的扩展思考版本,在语音对话的表现上十分出色。从这一点也能发现,当下越来越多的人工智能企业,都开始重点布局实时语音这个发展赛道。语音交互也不再只是文字人工智能的附属功能,慢慢发展成人工智能产品里,非常重要的核心交互方式。
三、模型适用人群与使用渠道
普通的网络用户,可以通过Gemini软件和Search Live平台,体验这款模型全新的语音对话功能。从事开发工作的人员,能够借助官方平台和专属接口调用该模型。企业用户也可以报名参与相关的内测活动,提前体验完整功能。与此同时,谷歌还和多家技术企业展开合作,优化了底层的技术架构,简化了语音智能体的开发流程,让行业的整体开发难度变得更低。
四、行业发展前景分析
如今语音技术和多模态技术一直在不断更新升级,语音智能体能够覆盖的应用场景也变得越来越多。在未来的发展中,智能设备不会再局限于单一的文字交流,自然流畅的语音互动,会成为人工智能行业的主要发展趋势。不过就目前来看,语音智能体的落地使用还存在一些不足,比如运行稳定性不够、用户隐私保护不够完善等问题。整体而言,Gemini 3.8 Live的成功上线,让人工智能语音交互技术变得更加智能、自然,对整个行业的发展都有着不错的推动作用。