做表的人都有同一个感受:最折磨人的从来不是第一次处理,而是第二、第三、第 N 次。
月初销售明细、月底考勤流水、每周运营日报------结构几乎一模一样,可每次都得把需求重新说一遍:"按区域汇总、金额转成数字、日期统一格式、剔除重复项"。说得口干舌燥,对方还未必记得上次是怎么改的。
于是大家都在盼一件事:AI 能不能"记住"我们的处理习惯,下次直接复用?当然能。市面上几乎所有 AI 工具都会告诉你,它支持"记住你的偏好"。可真正用起来就会发现------同样是叫"复用",脚本复用和普通 AI 的"对话里复用逻辑",完全是两回事。
一、先设问:普通 AI 的"复用"到底复用了什么?
先搞清楚一件事:普通 AI 产品说的"记住你的习惯",记的是什么?
是每次对话里的临时语境------你这次说"日期格式统一成 2026-09-16",它在这次回答里记住了;可一旦新开一个对话、换一批文件、或者隔几天再来,它又要从零开始理解规则。你嘴上说"跟上次一样",但它并没有一份"跟上次一样"的依据,只能重新生成一遍处理逻辑。
这里有一个关键区别,值得先记下来:
- 普通 AI 复用的是"记忆"------是对话里的临时状态,随会话结束而消失;
- 脚本复用复用的是"成果"------是一份已经跑通、能反复执行的脚本文件,独立于任何一次对话而存在。
记忆会过期,成果不会。这就是两者最本质的差别:一个复用的是"过程里的临时想法",一个复用的是"沉淀下来的可执行资产"。
二、普通 AI 的"逻辑复用"卡在哪?
把普通 AI 的"逻辑复用"拆开看,问题集中在四点上:
- 跨会话就忘。新开对话就得重新描述整套规则,说得越长、越容易漏,口径稍有出入,结果就不一样。
- 每次都重新生成。哪怕这次和上次是同一类活,它也要重新走一遍"理解需求→生成代码→运行",等于重复劳动完全没省。
- 只给结果、不给逻辑。处理完给你一张"干净底表"或一句"已清洗",中间用了什么规则、改了哪些行,是黑盒,回不去也核验不了。
- 每次复用都在烧成本。按积分/订阅计费的云端工具,每重新生成一次就要消耗一次算力,一个月下来,这个"复用"反而越来越贵。
一句话总结:普通 AI 的"复用"是每次从零再来、还不一定能复现,只是名义上"记住"了你,实际并没有把这份活沉淀下来。
三、脚本复用好在哪里?六个好处一次说清
脚本复用的思路很简单却挺颠覆:把"这次好不容易跑通的逻辑"直接变成一份保存在本地的脚本文件。下次同类数据来了,不应当还需要Token,不应当重新描述需求,也不用担心它忘了上次怎么改。
好处是实打实的:
- 不用每次重新说需求。第二次起,一句话带路径带口径,直接跑;规则早就固化在脚本里了。
- 跨会话、隔月照样复用。脚本存在你电脑本地,不依赖某一次对话,下个月换批文件再来,还是同一份逻辑。
- 断网也能跑已保存的脚本。首次生成脚本那一下需要联网调用算力,这步跳不过去;但脚本一旦存好,后续运行不再需要网络。
- 逻辑可看、可改、可核验。脚本是明明白白的一行行代码,改了哪些列、按什么口径合并,翻脚本就能核对,不再是黑盒。
- 结果稳定可复现。同一份脚本跑同类数据,产出口径永远一致,不会这月一套那月一套。
- 省的是真金白银。已保存的脚本直接复用,不需要每次重新生成、重复烧算力;配合内置的 token 优化,成本比"每次重新来一遍"低得多。
这正是脚本复用的价值所在------它把"重复劳动"从每次从零开始 ,变成了一次沉淀、长期复用。
四、具体怎么落地?
落到操作上其实就三步:
第一步,把表格放进本地工作台,文件不传网上。第二步,用一句话下指令,比如"把这批销售明细按区域汇总、金额转成数字、日期统一格式"。第三步,本地自动生成并跑完脚本,出干净底表;脚本自动保存在本地,下月再来结构相同的表,点击直接复用。
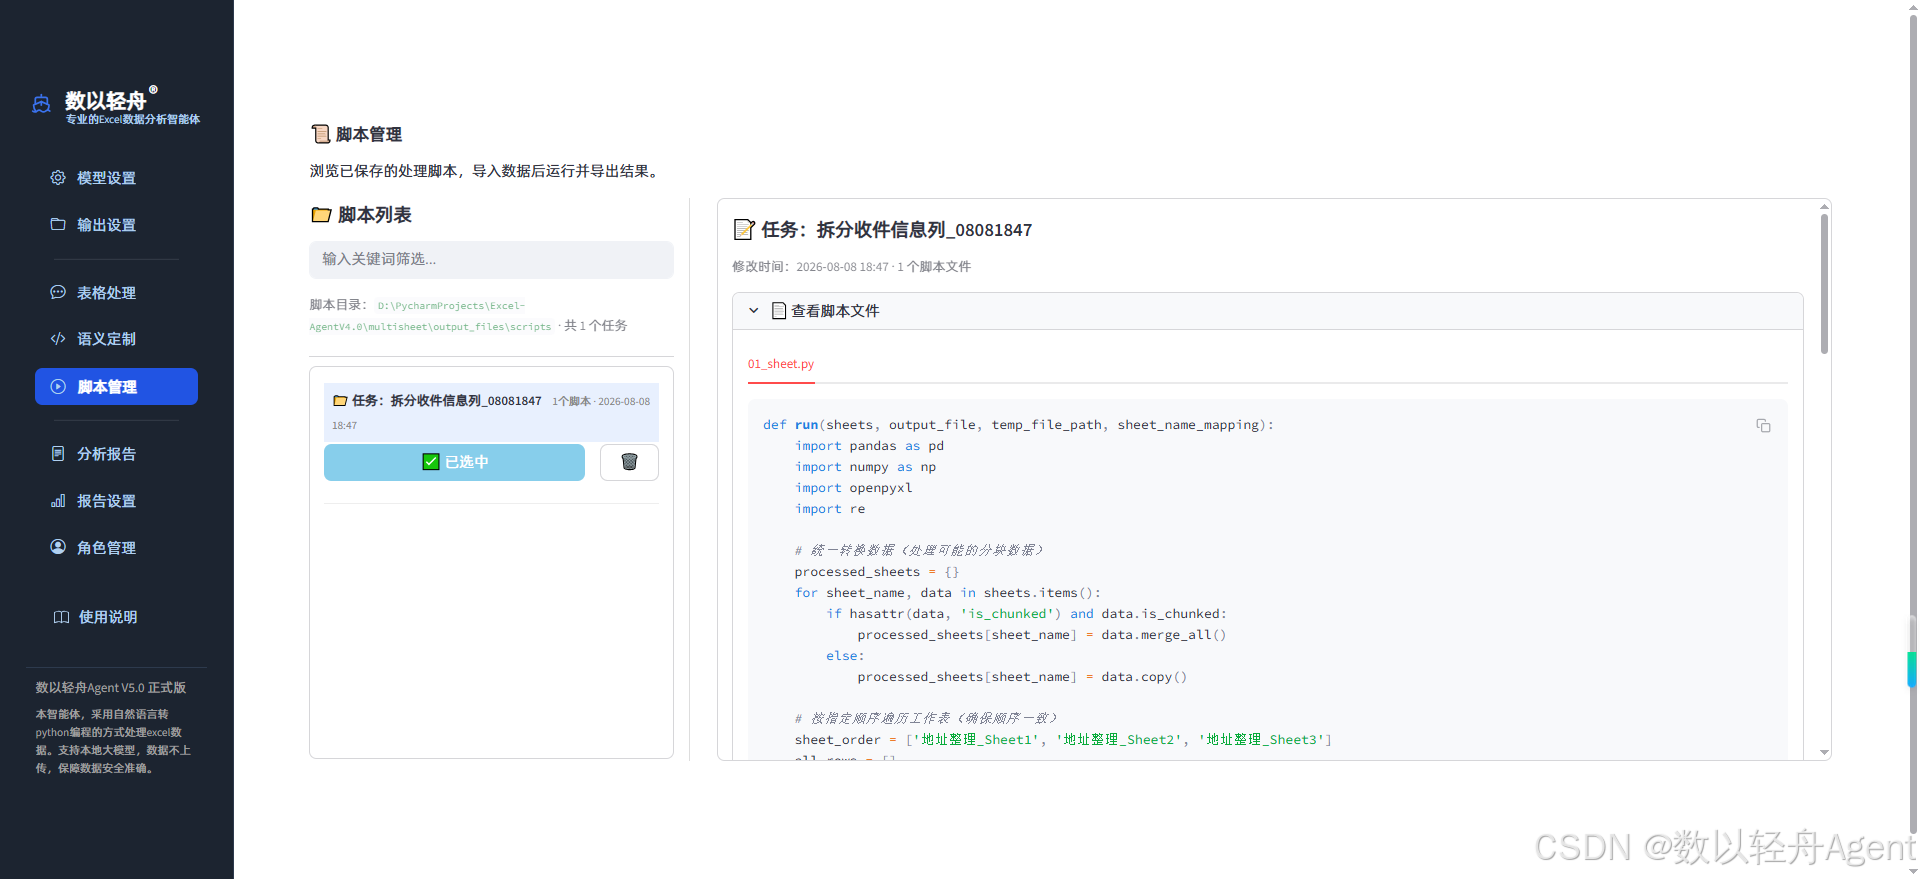
到这里可以看出,真正让脚本复用成立的前提,是整套动作都发生在本地:数据文件在本地处理、不进聊天框、不传第三方 SaaS,处理脚本也落在自己电脑上。能做到"指令→生成脚本→保存复用"闭环在本地、并把它当成产品一大卖点来做的,正是数以轻舟Agent 这类本地部署工具的定位------它把"复用"从一句营销话术,变成了实实在在留在你电脑上的脚本库。
五、能力边界(先看清楚再决定)
把话说在前面:目前只处理 Excel(.xlsx)和 CSV(.csv)表格,PDF、图片、Word 这类非表格文件不在支持范围内,旧版 .xls 需先在 Excel 里另存为 .xlsx。
商业模式上,软件是一次买断的------买断的是软件本体;模型算力(token)需要你自己接自己的 API 额度、按实际用量自购,产品内置 token 优化帮你把消耗压到最低,但不做积分充值中间商。
适合人群:手上有 Excel/CSV 数据、被重复报表与合表消耗、愿意接受本地脚本驱动处理方式的用户。不适合人群:只接受纯网页操作、不愿在自己电脑上装任何软件的;没有接入模型算力(API)意愿、期望装完就能用且完全不用任何配置的------这两类人会觉得本地工具门槛高,这是产品定位使然,不是缺陷。
六、FAQ / 选型建议
- 问:需要会写代码才能用脚本复用吗? 答:不用。用自然语言下指令,脚本由产品自动生成并运行,你不碰代码;但脚本会留在本地,想改可以自己改。
- 问:脚本复用和普通 AI 记住偏好,到底哪个更省事? 答:短期都省事;但长期看,脚本是"沉淀下来的成果",普通 AI 只是"对话里的临时记忆",跨会话、换文件后差距会越拉越大。
- 问:是不是存了一堆脚本就够用了? 答:不是。脚本要服务于真实、稳定的重复任务才有价值;一次性任务不必都沉淀,脚本库留着给高频、固定口径的活更划算。
说到底,工具"记住你"不难,难的是把你跑通的那套处理逻辑留下来、随时能再跑一遍。脚本复用和普通 AI 的逻辑复用,差的不是记忆,是沉淀------一个把重复劳动留在对话里,一个把它变成自己电脑上随时可用的资产。谁先学会沉淀,谁就少熬一个月的班。像数以轻舟Agent 这类本地安装的 Excel 数据处理工具,正是把"沉淀脚本"这件事直接做进了产品里。