一、前置内容
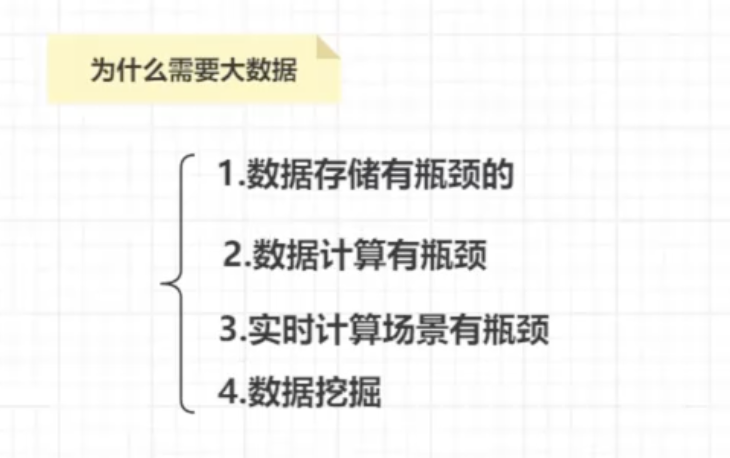
1.1 为什么需要大数据
1.2 各类分析模型
数据库设计三范式
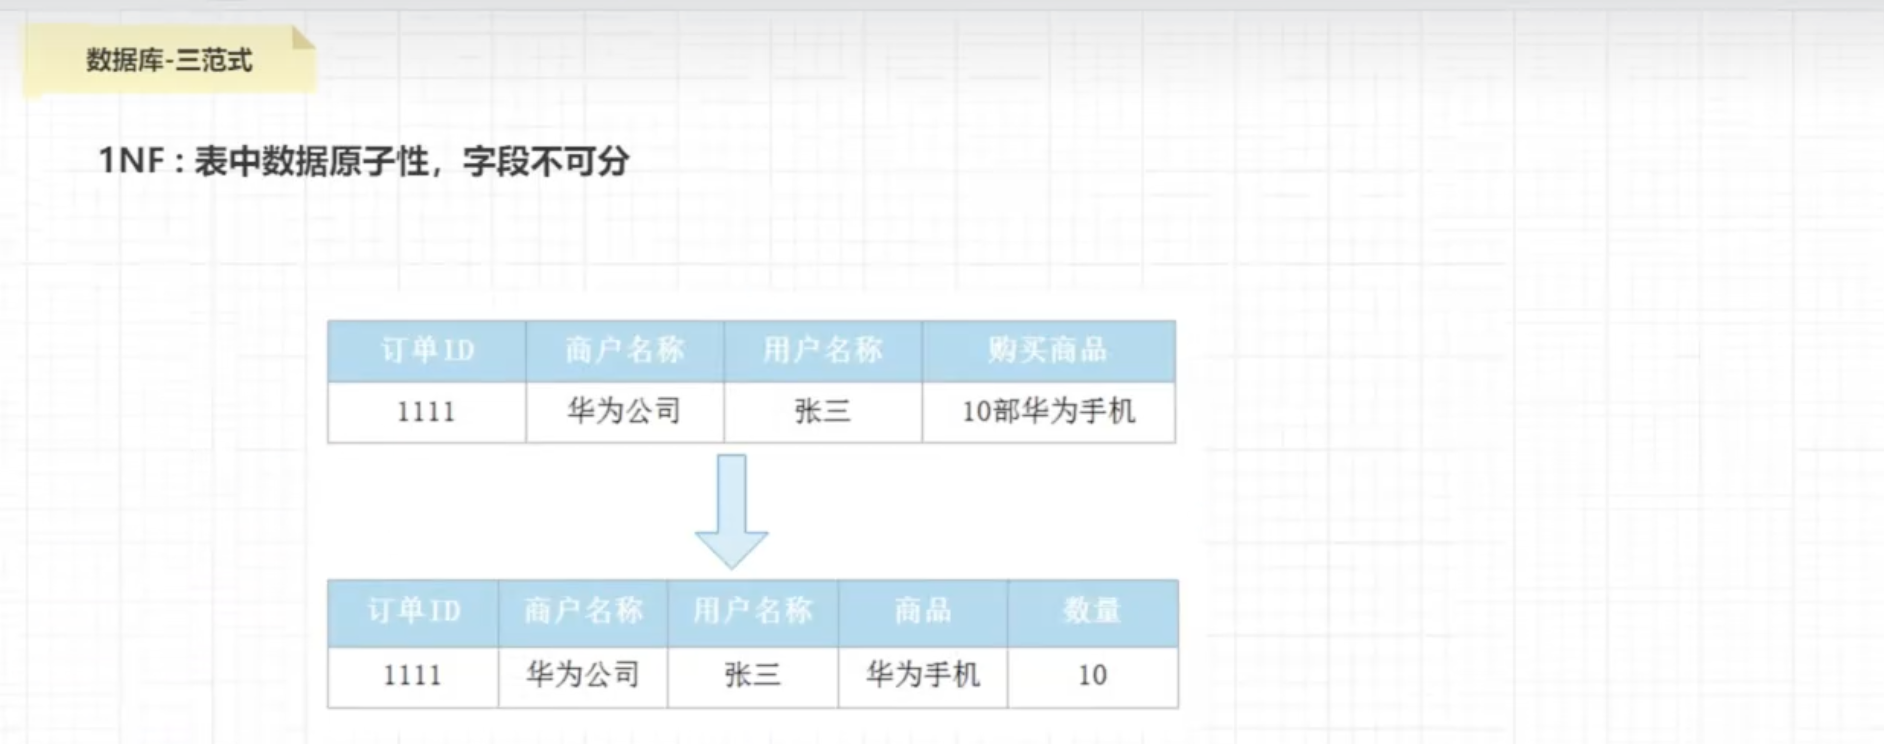
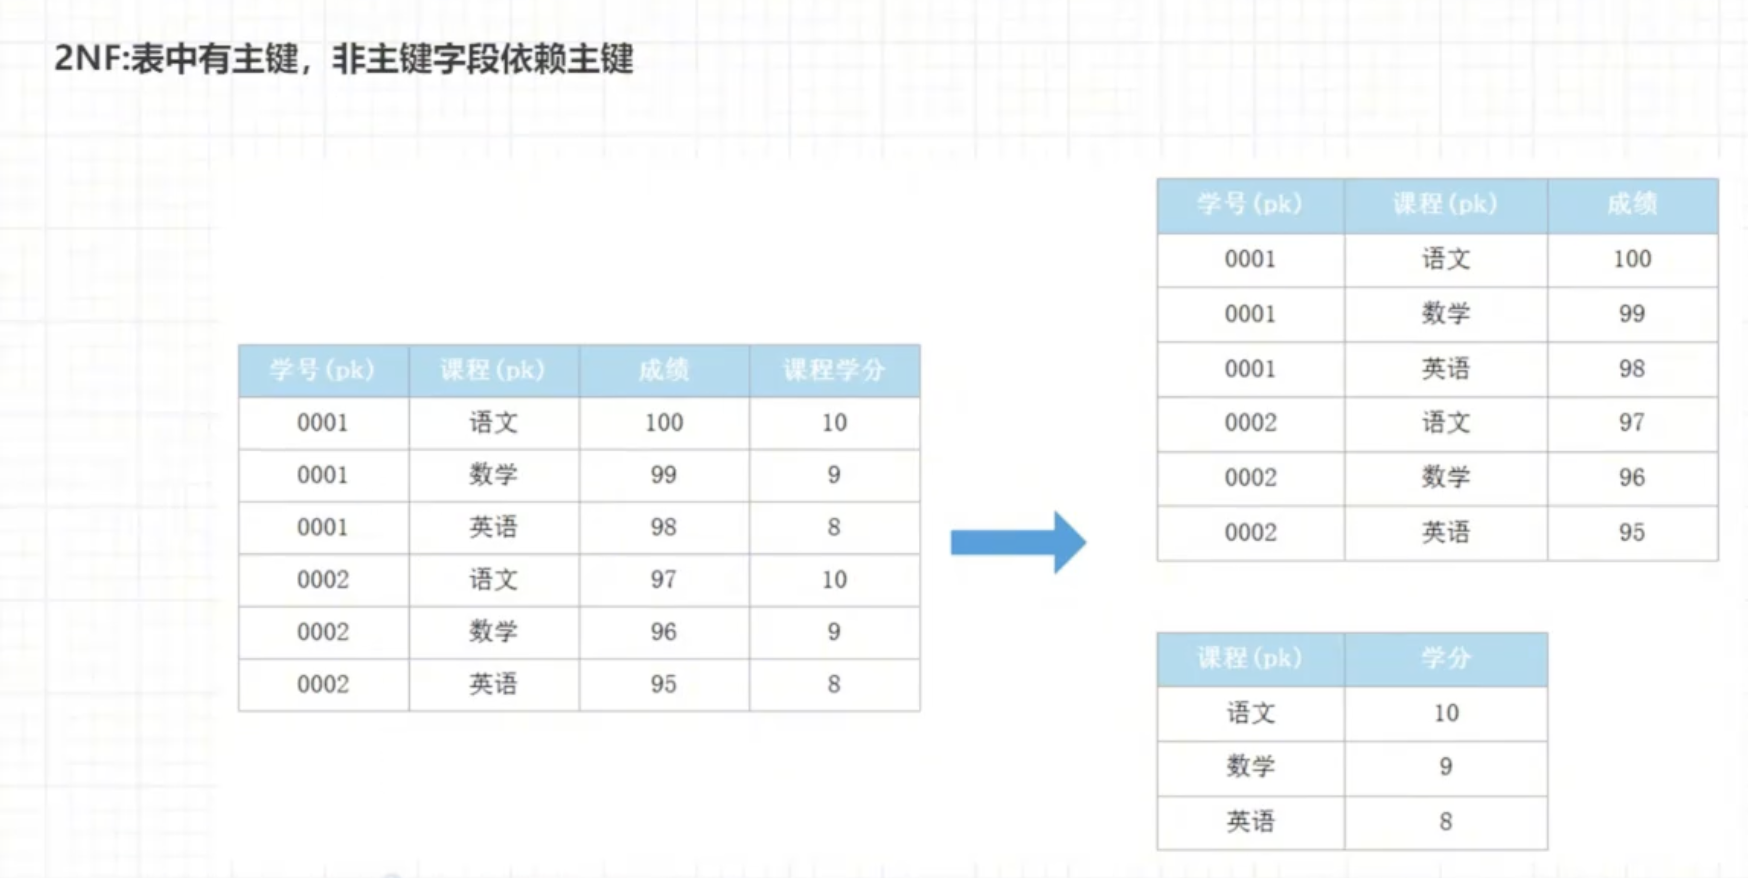
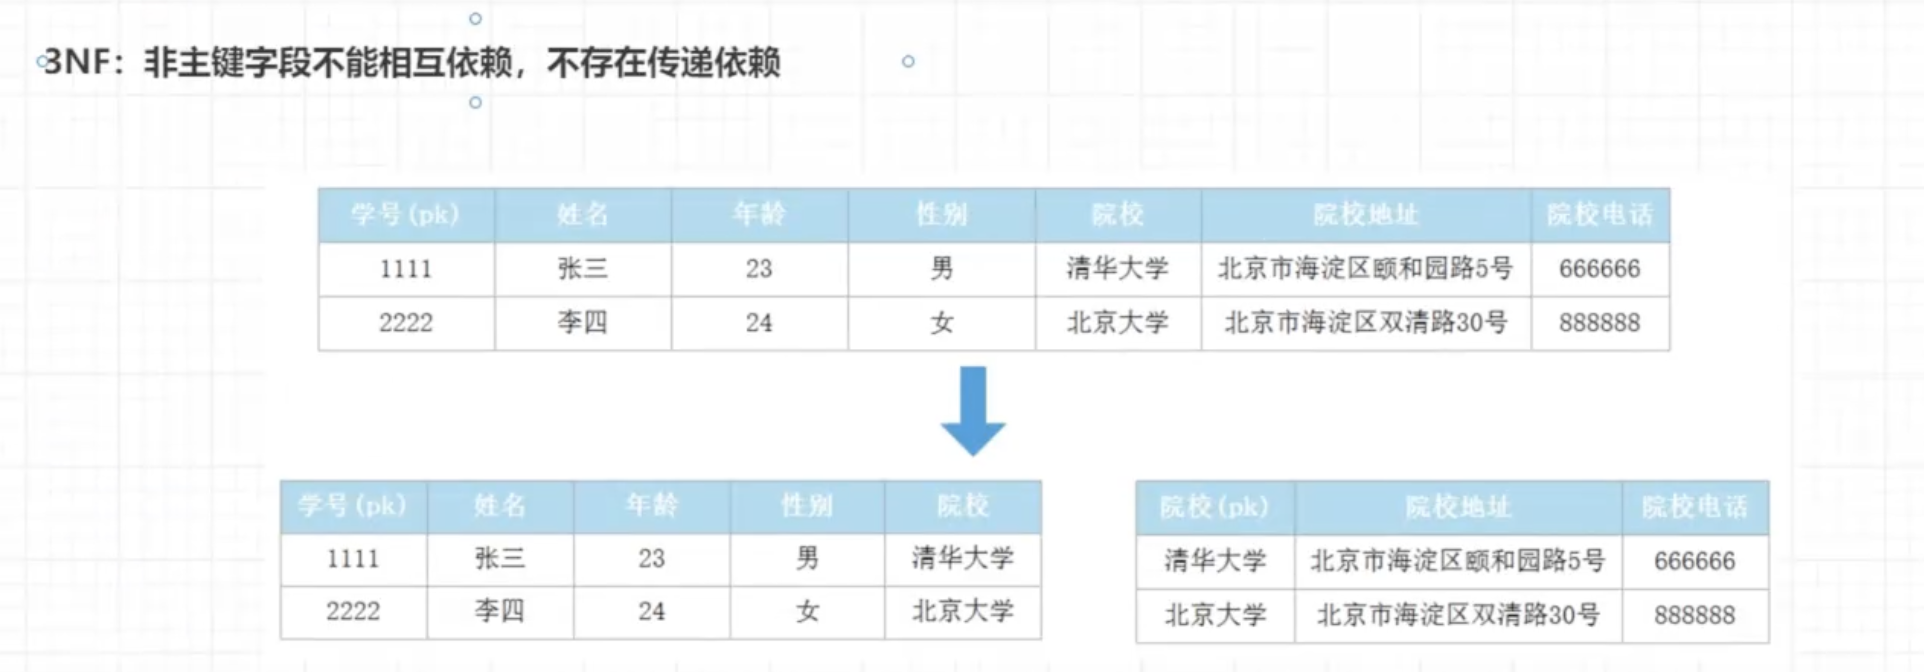
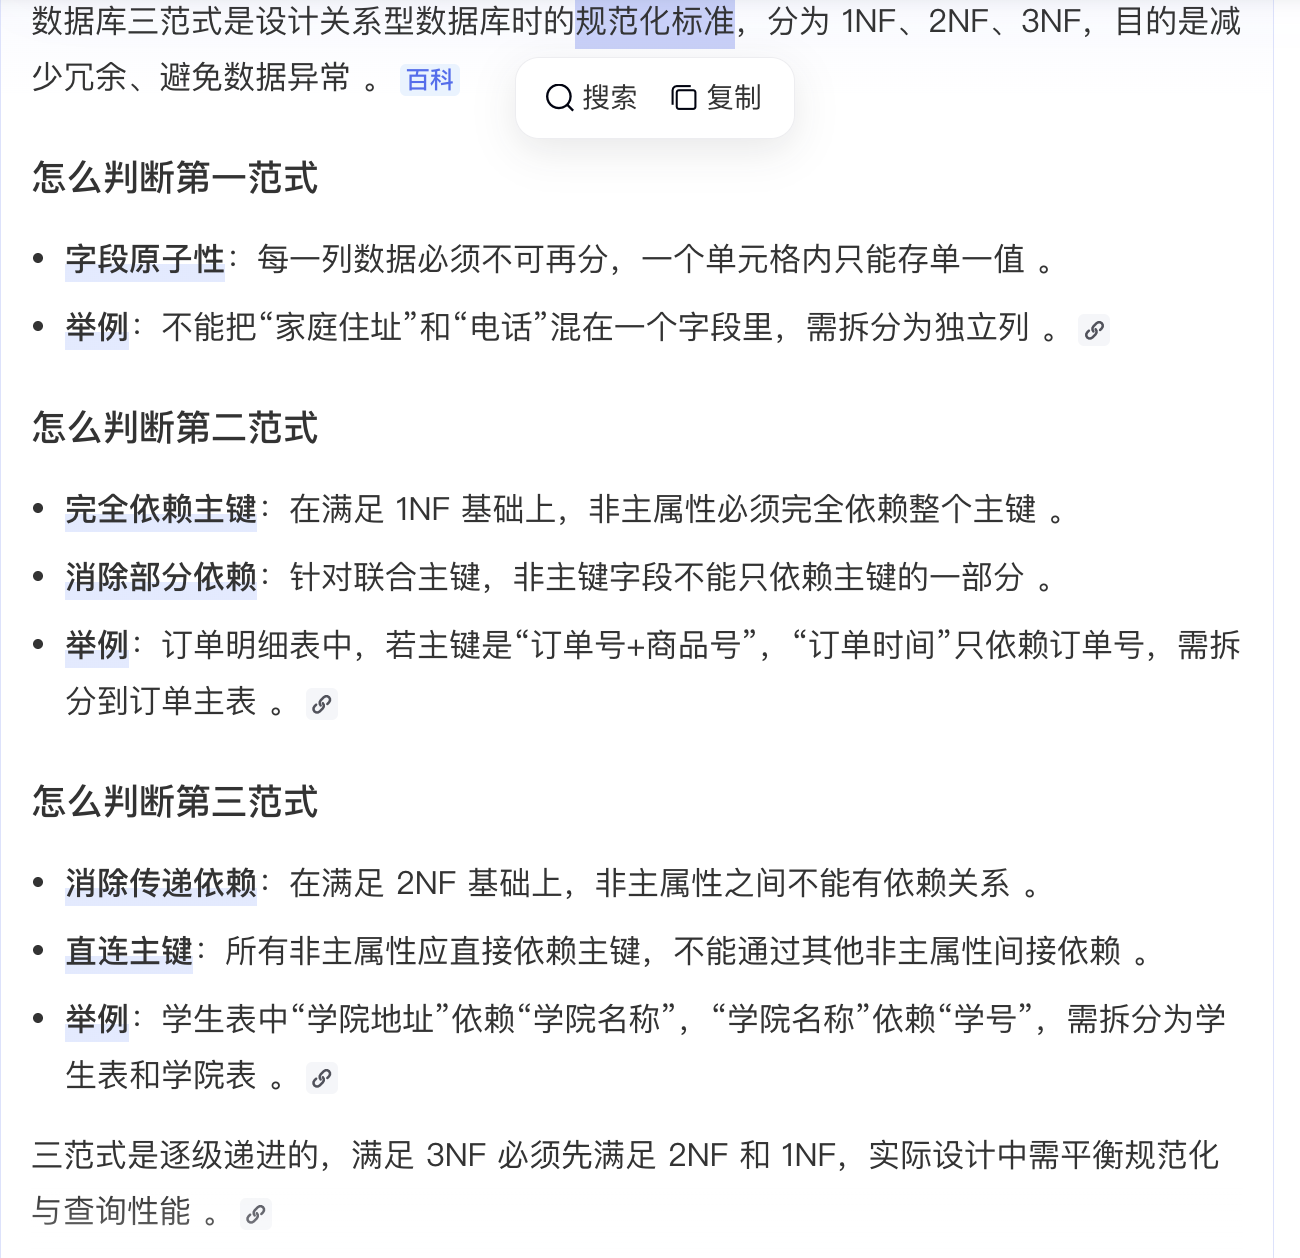
三范式目的:数据唯一+减少数据冗余
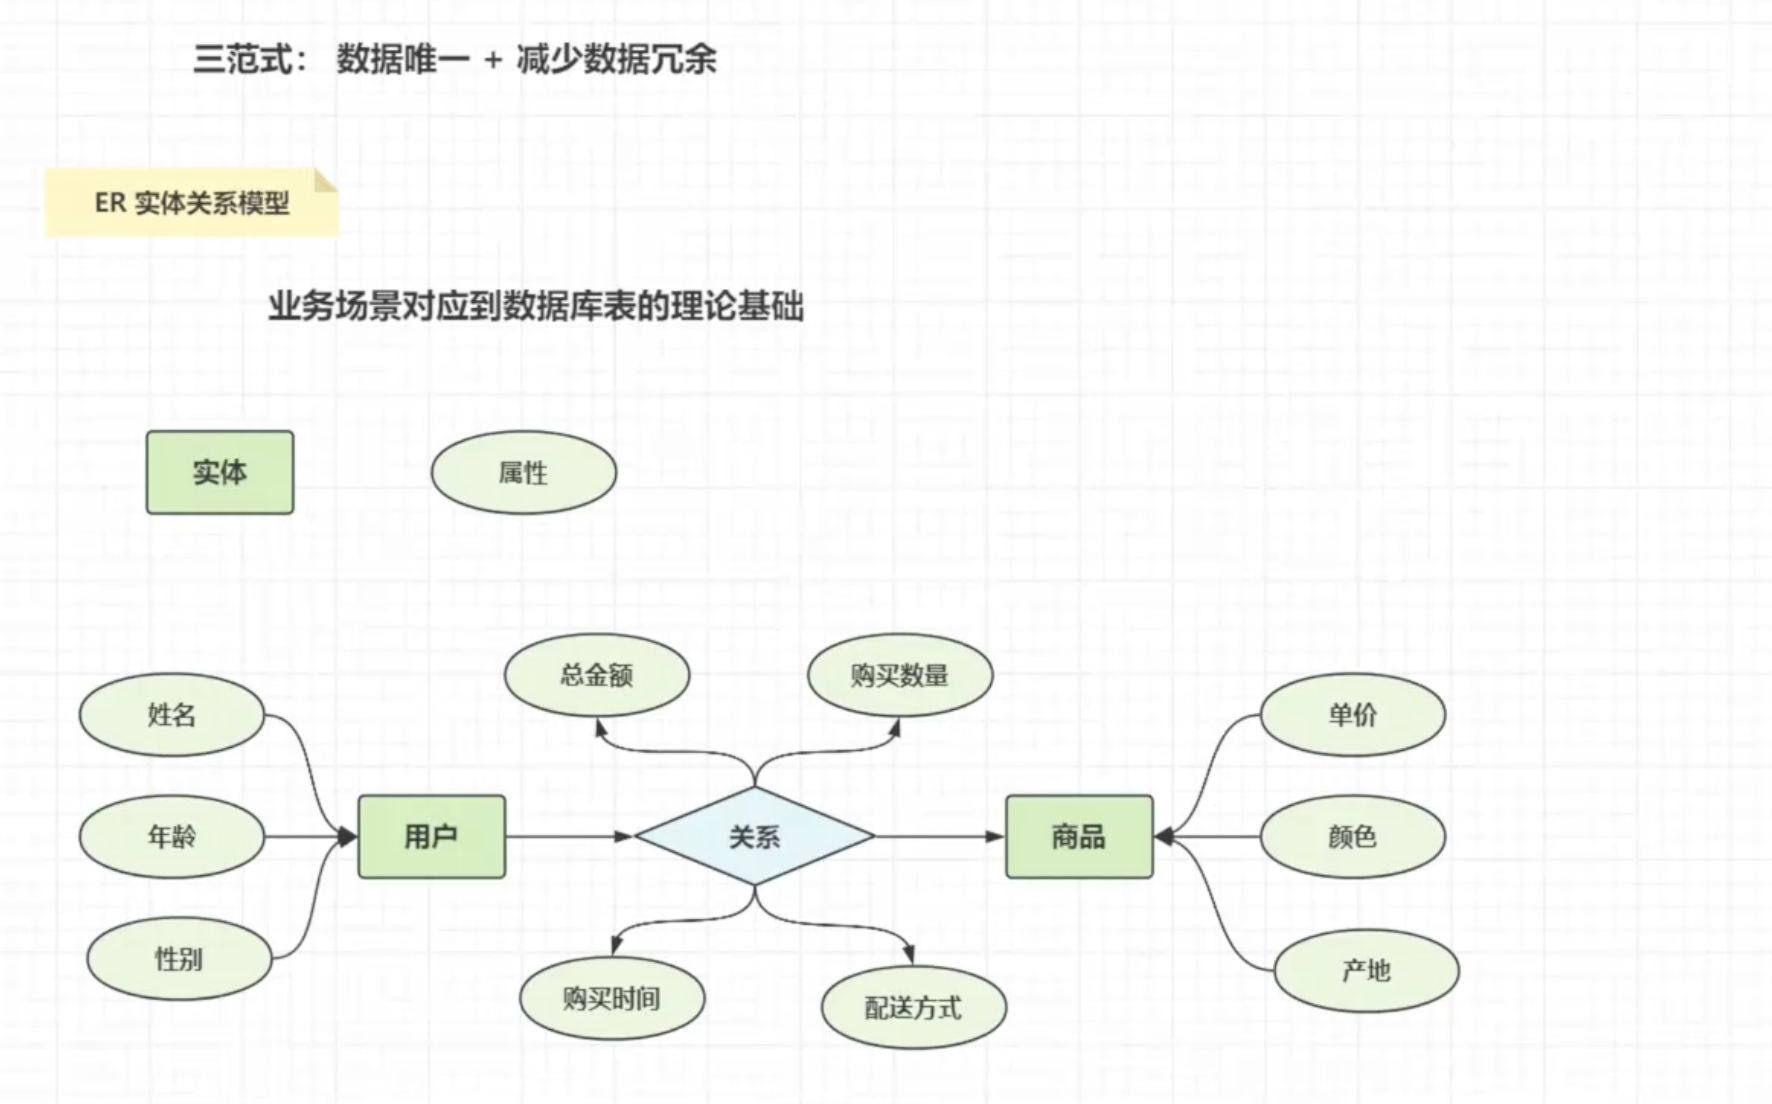
ER实体关系模型
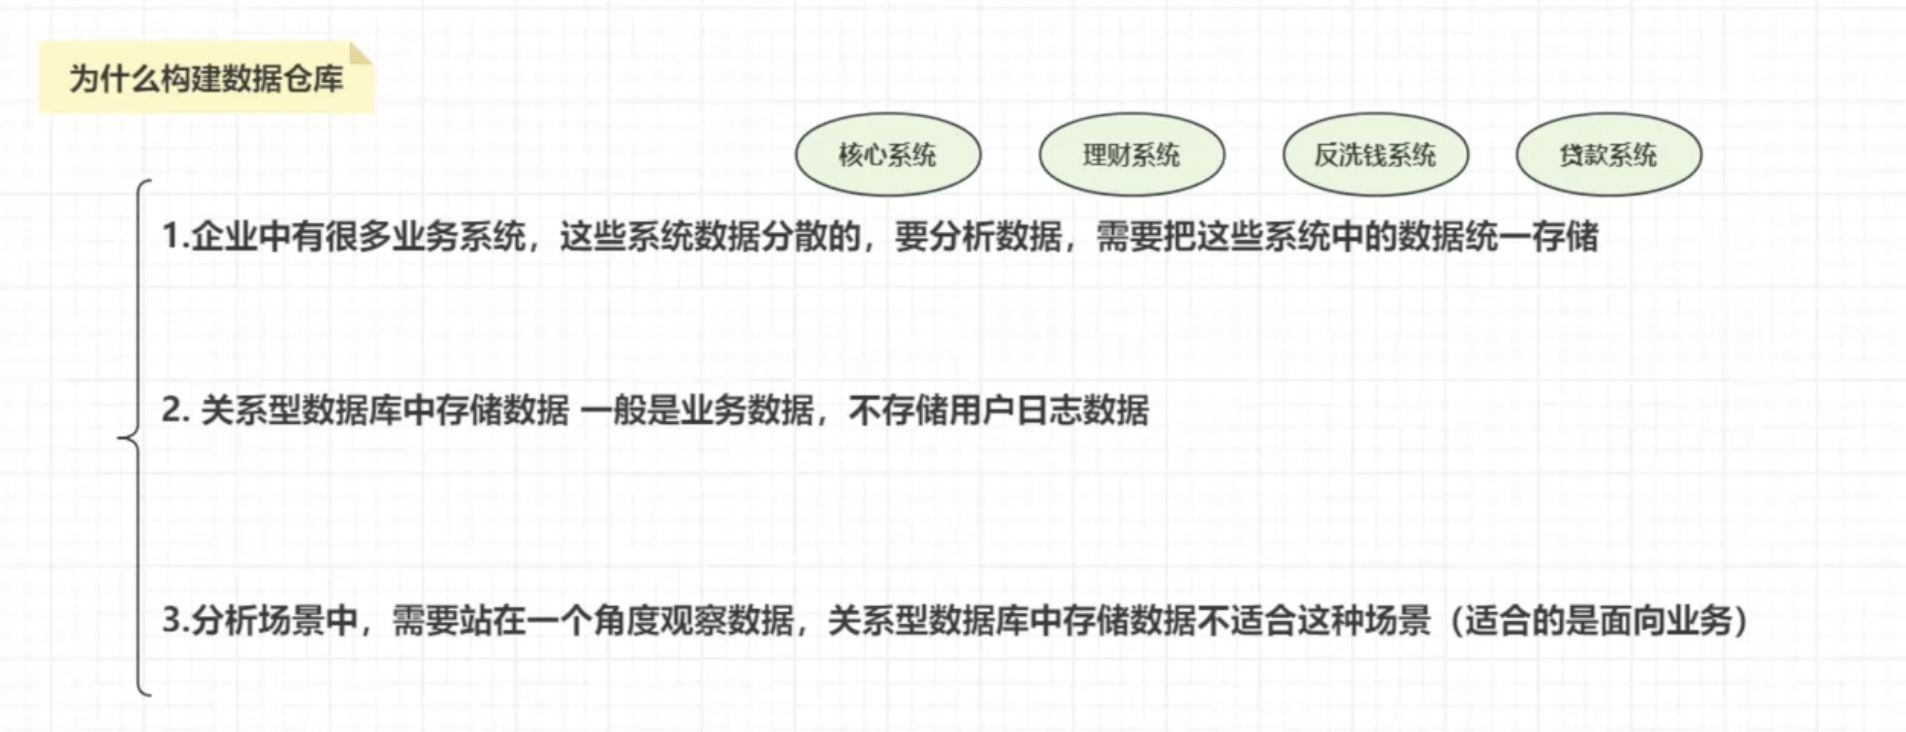
1.3 为什么构建数仓
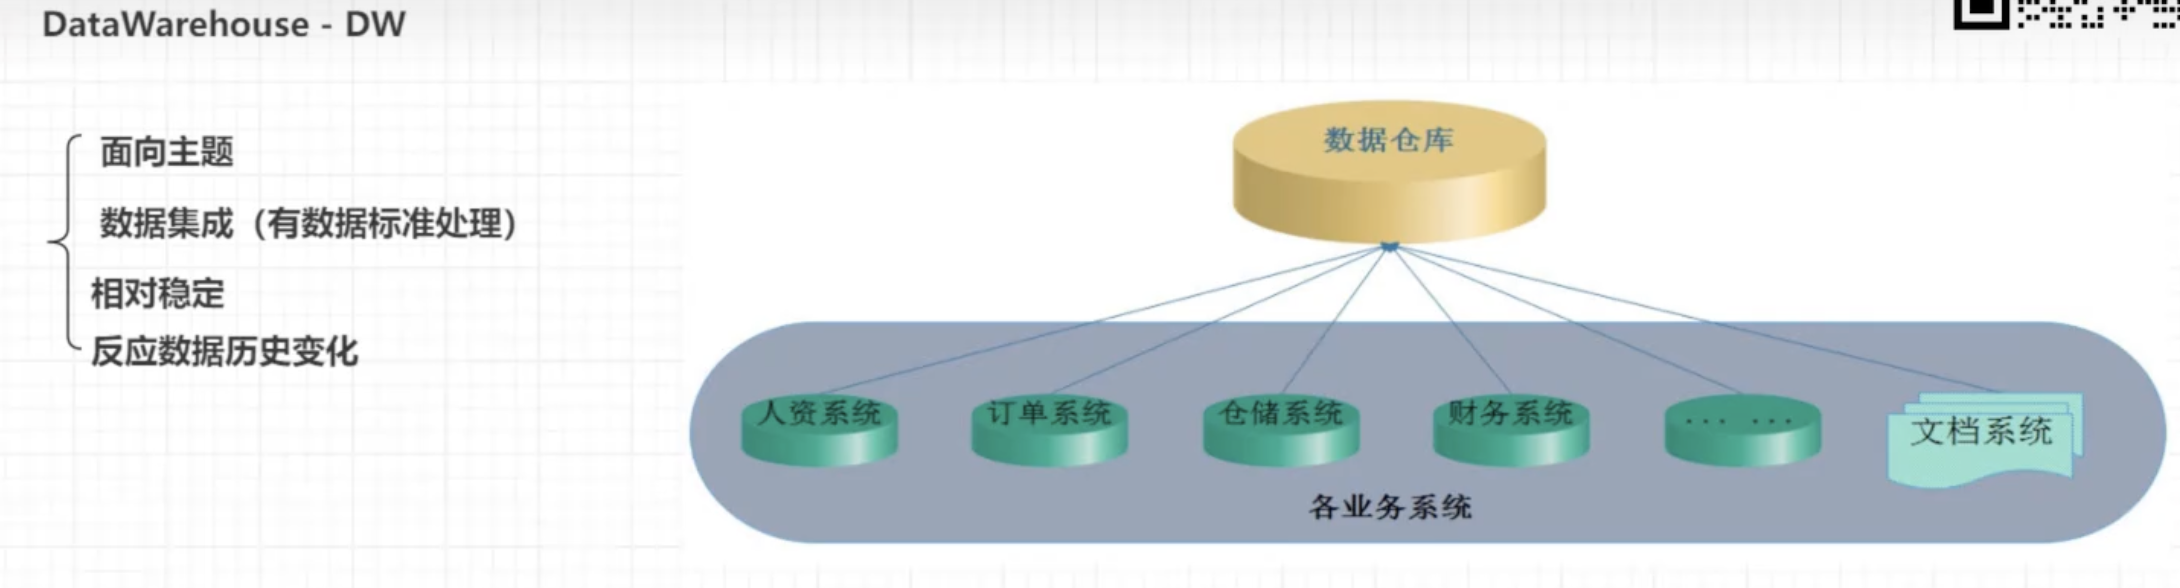
1.4 如何构建数仓
1.4.1 数仓两阶段
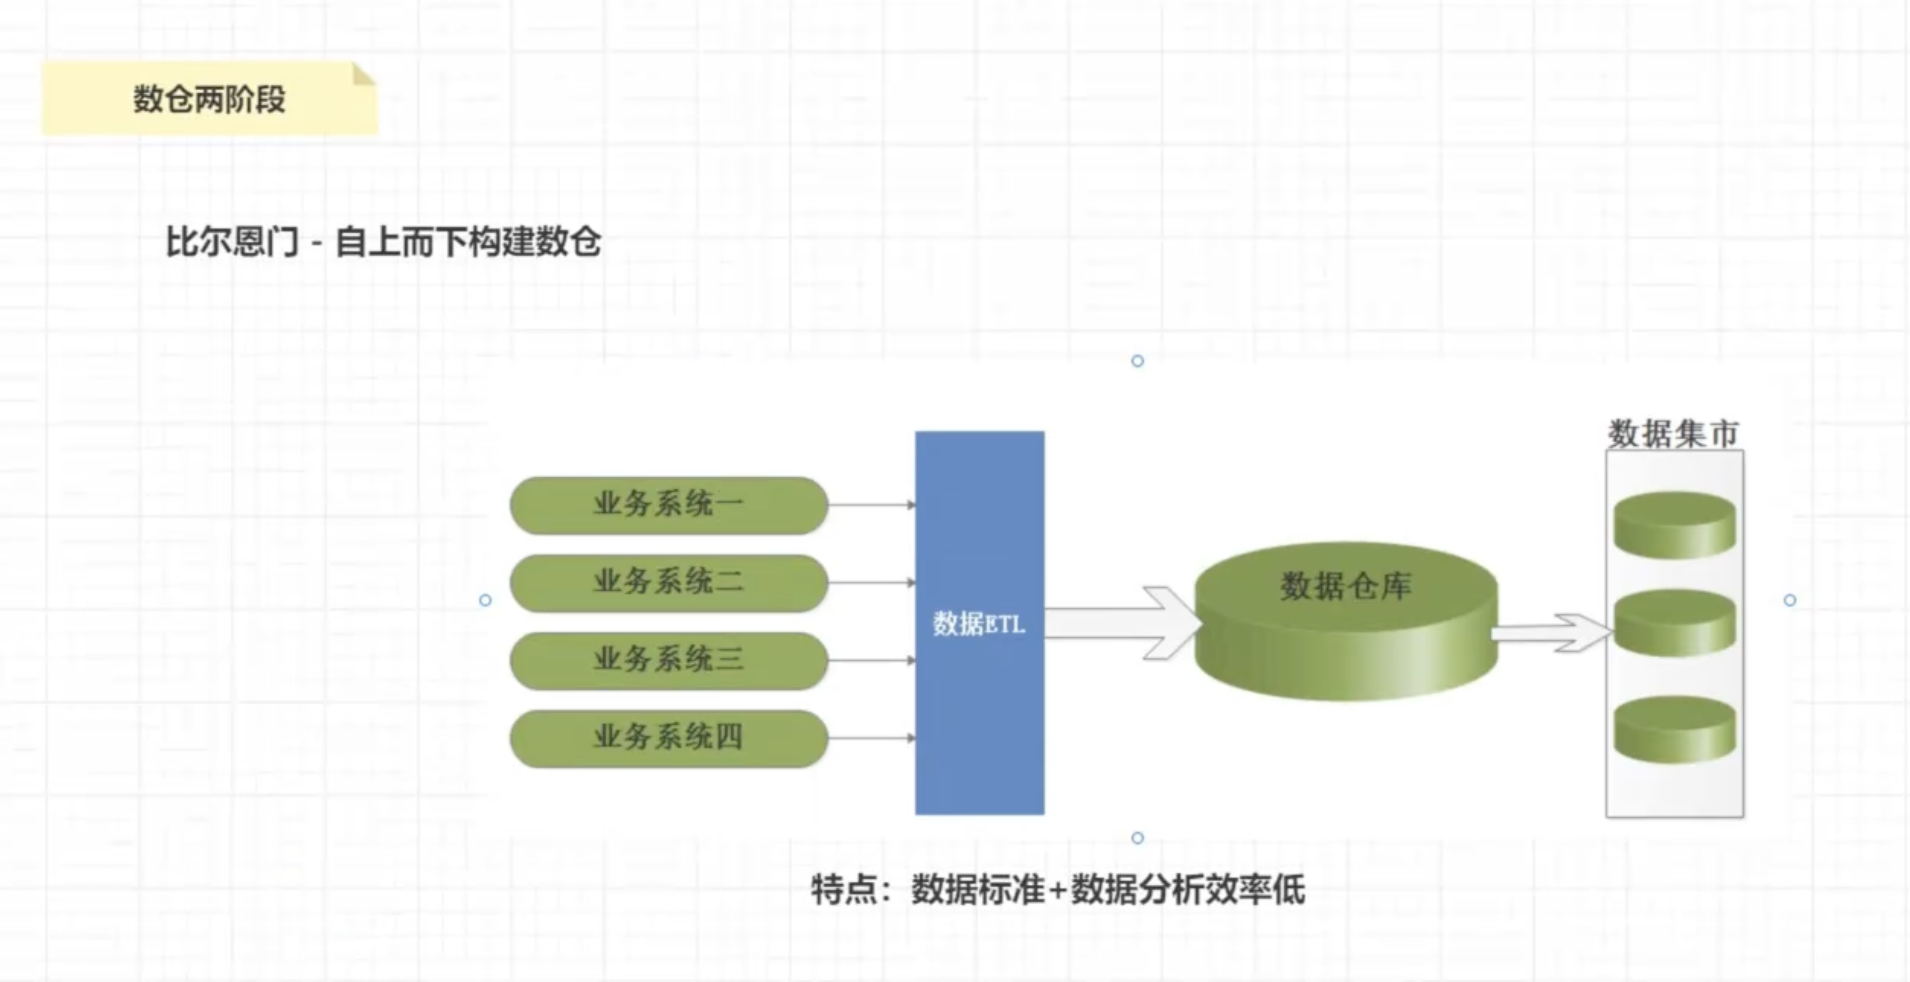
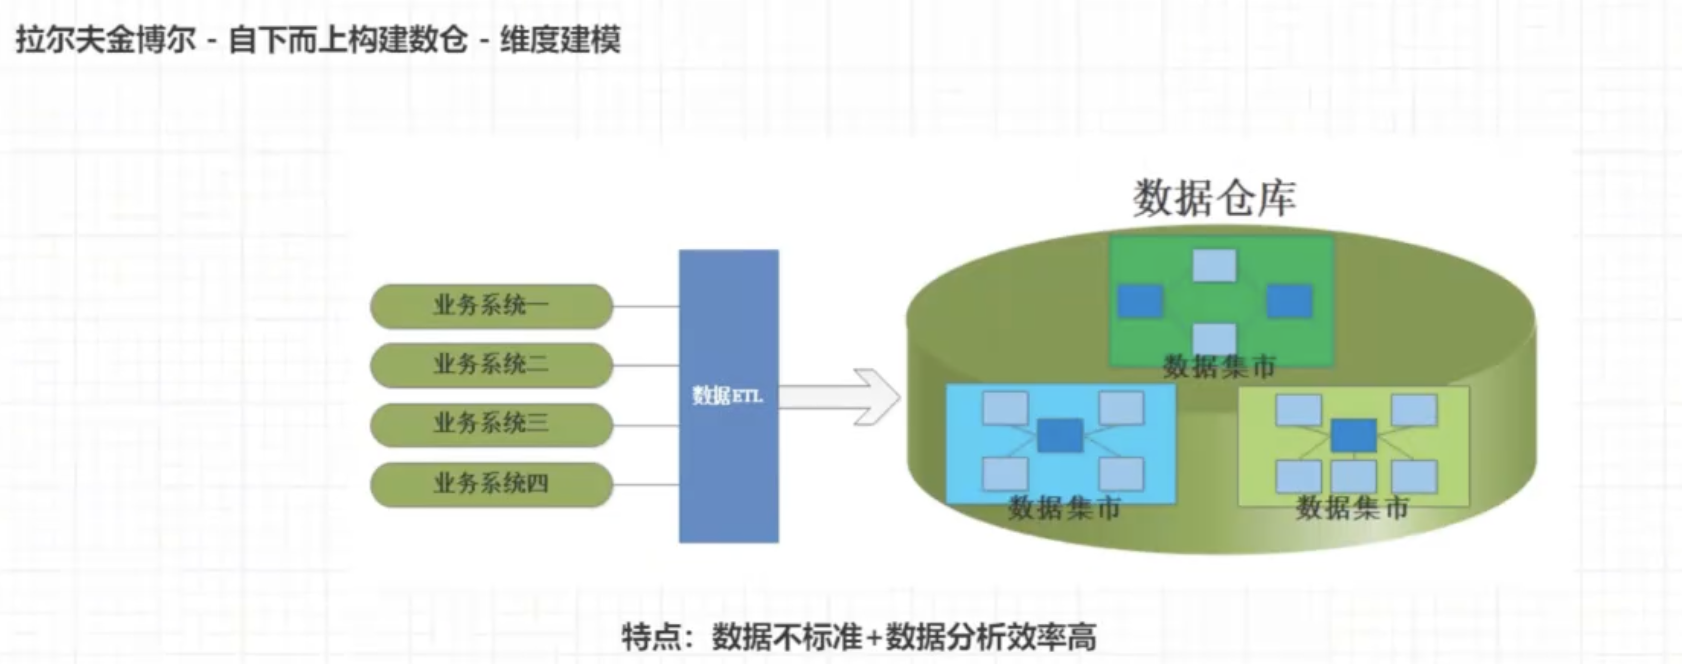
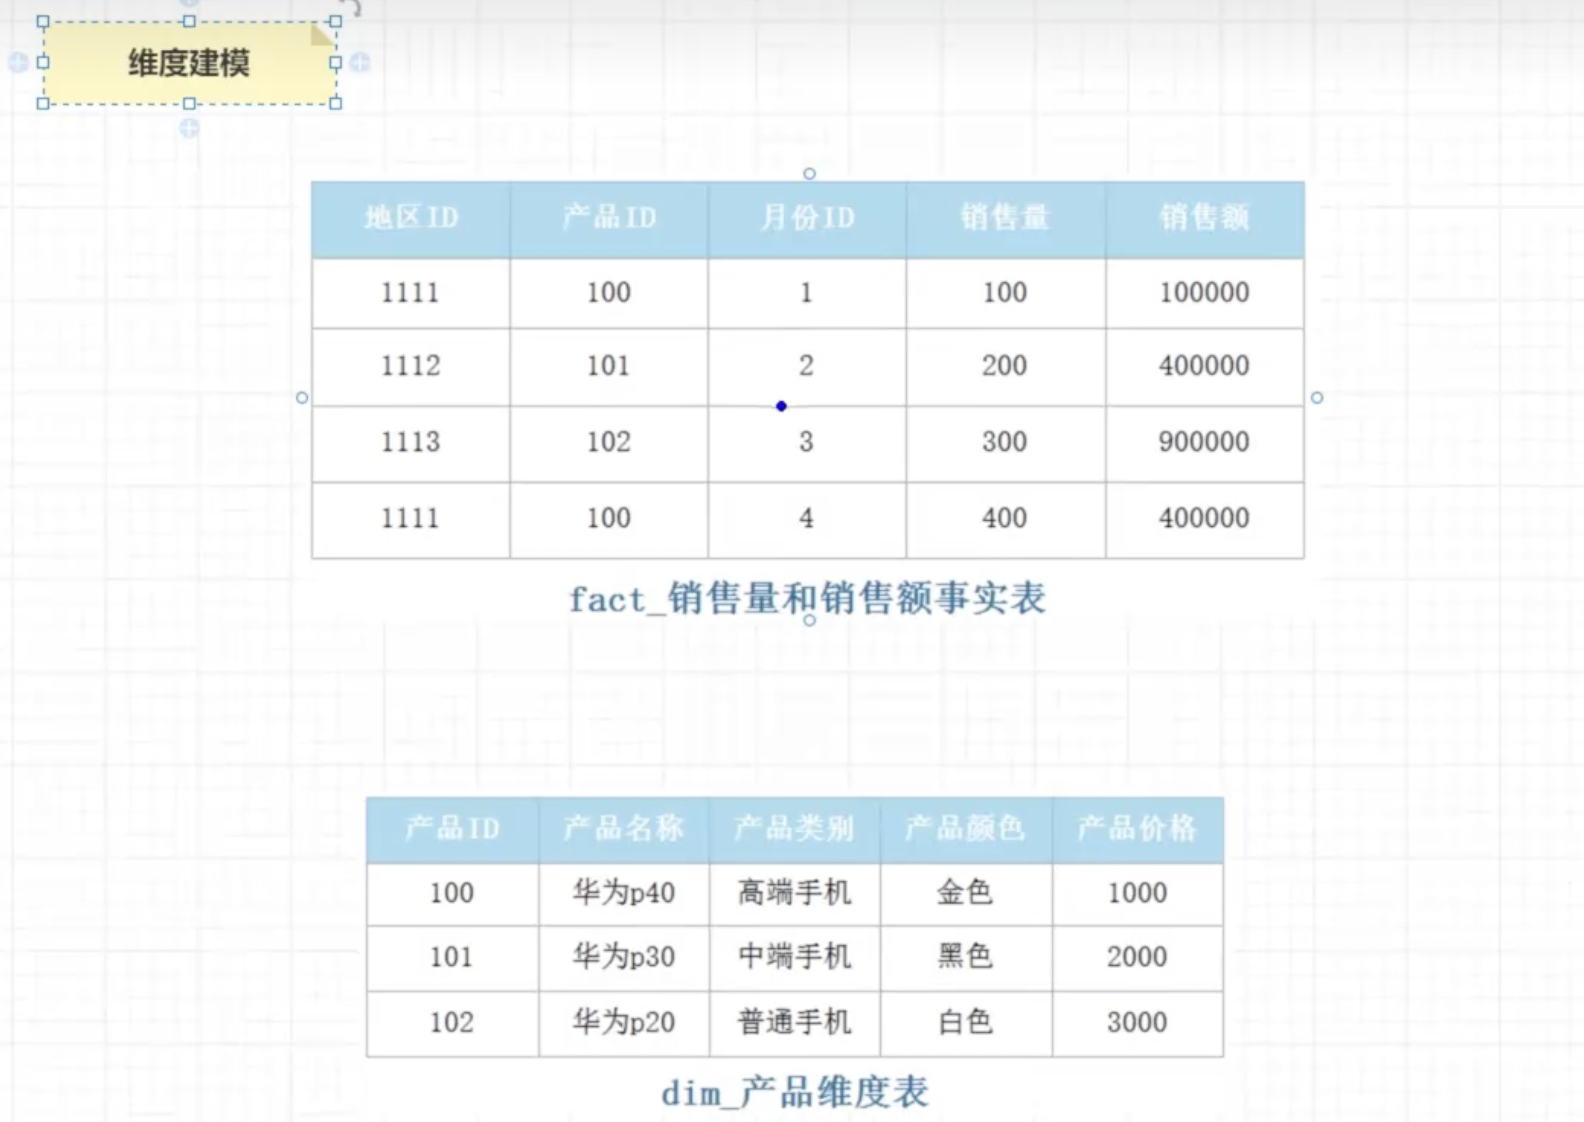
1.4.2 维度建模
事实表:包含维度+指标 (是一个高表、宽表)
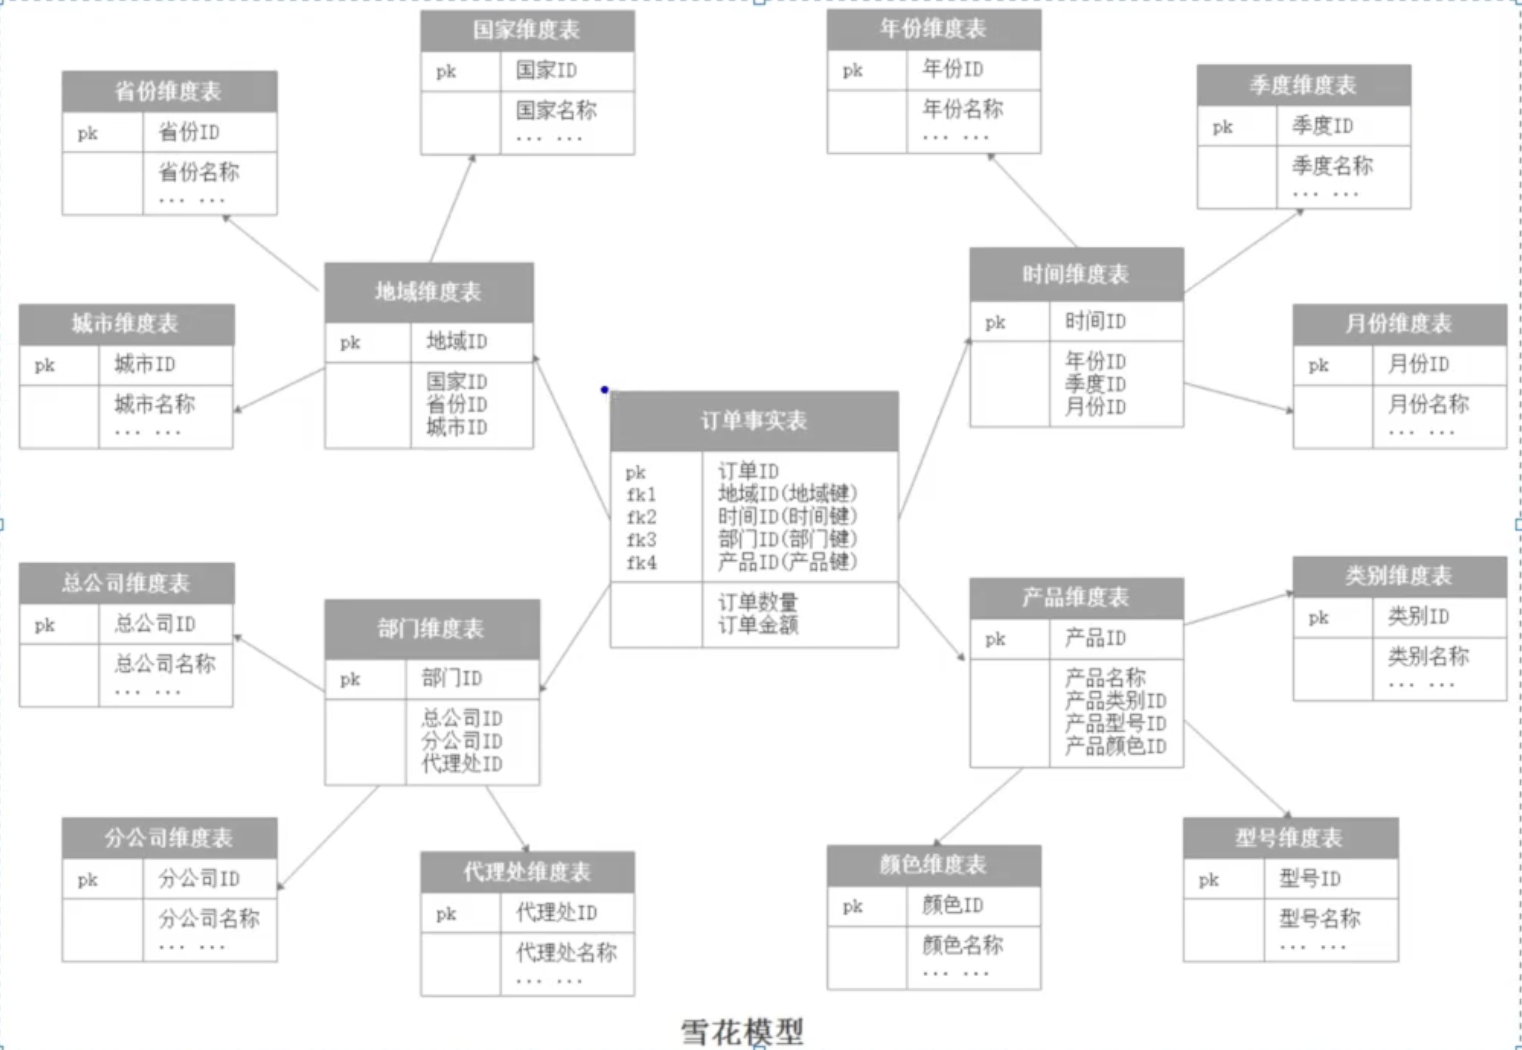
1.4.3 星型模型和雪花模型
星型模型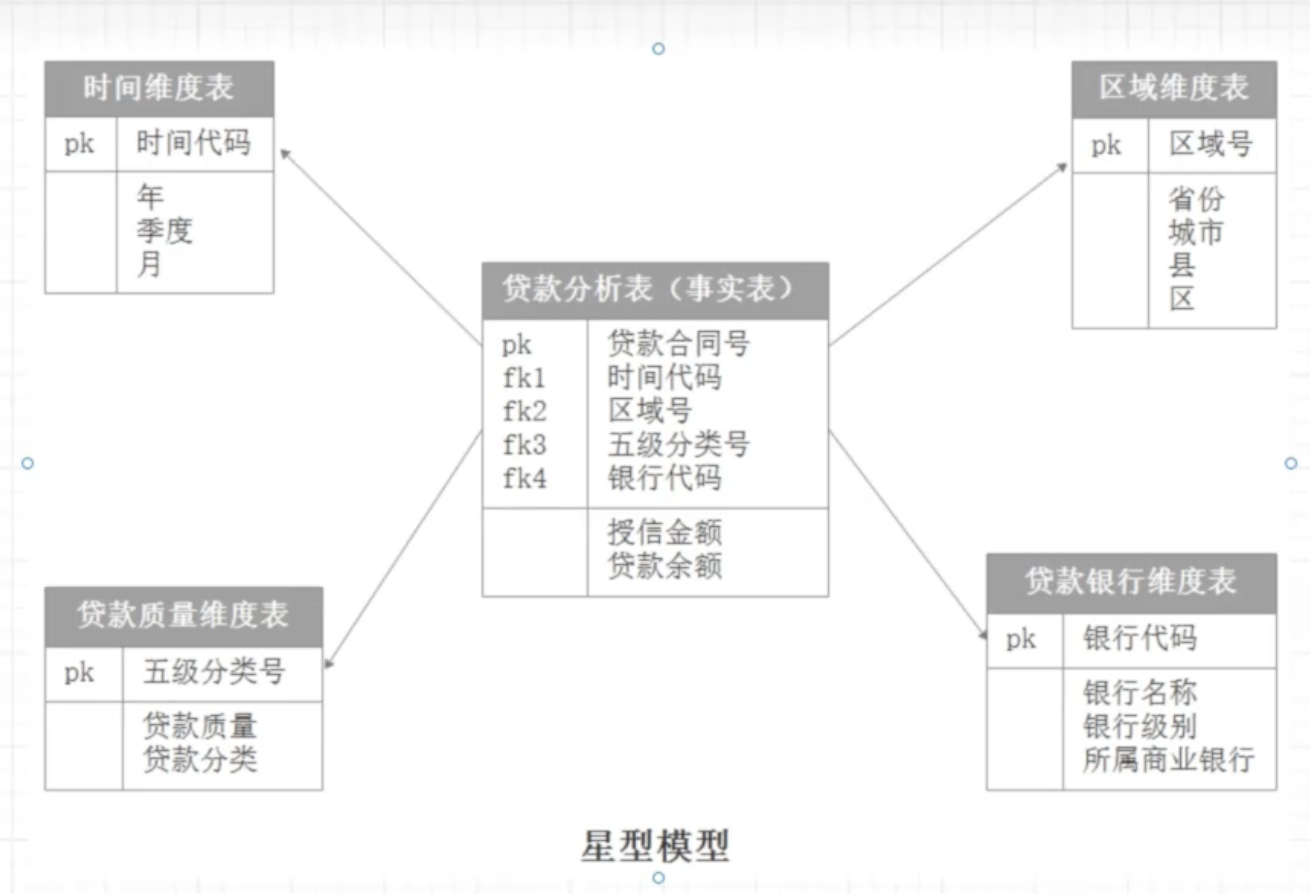
雪花模型
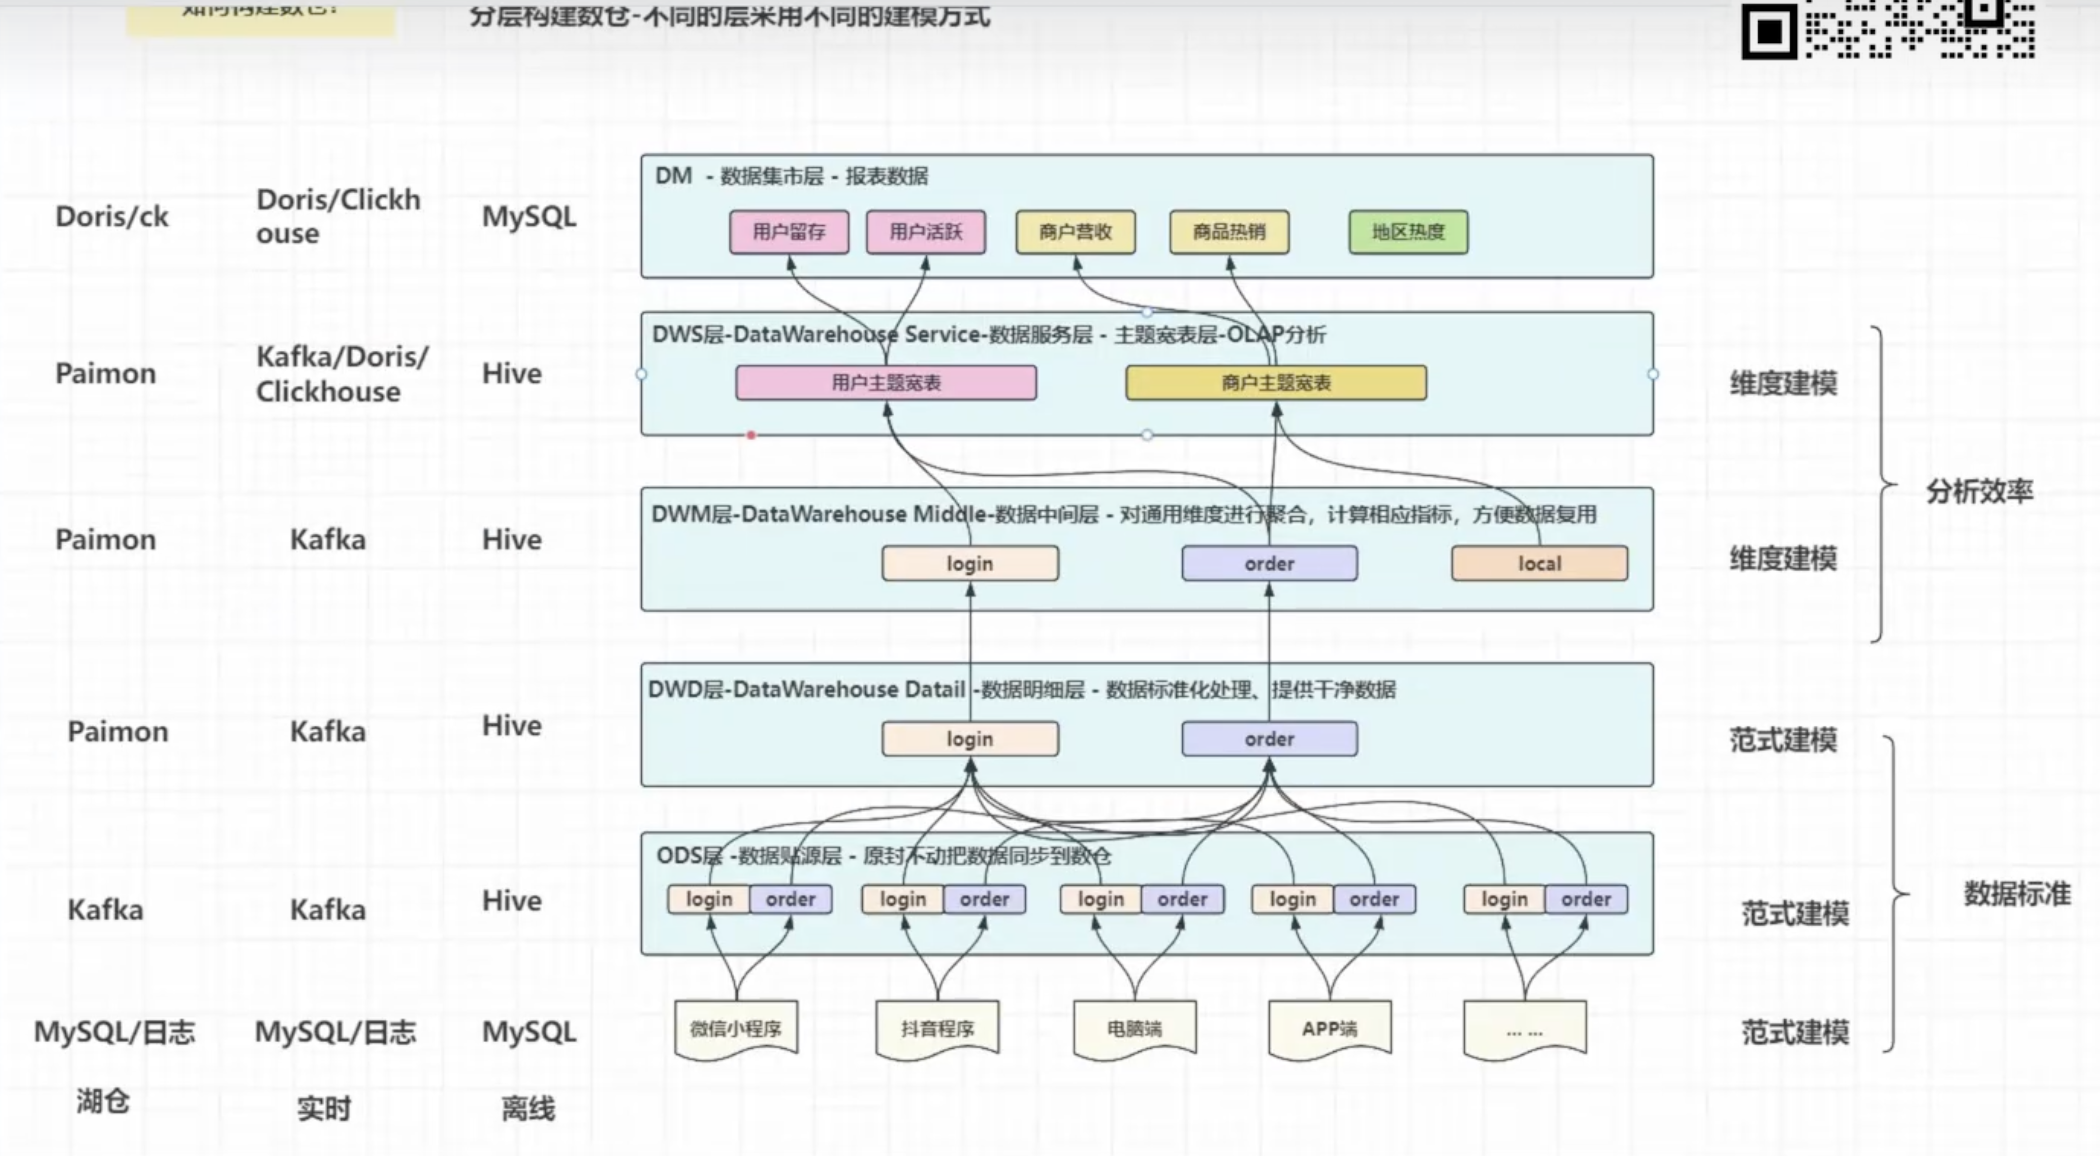
1.4.4 数仓分层实战
如何构建数仓?
分层构建数仓-不同的层采用不同的构建方式
1.4.5 大数据工作方向
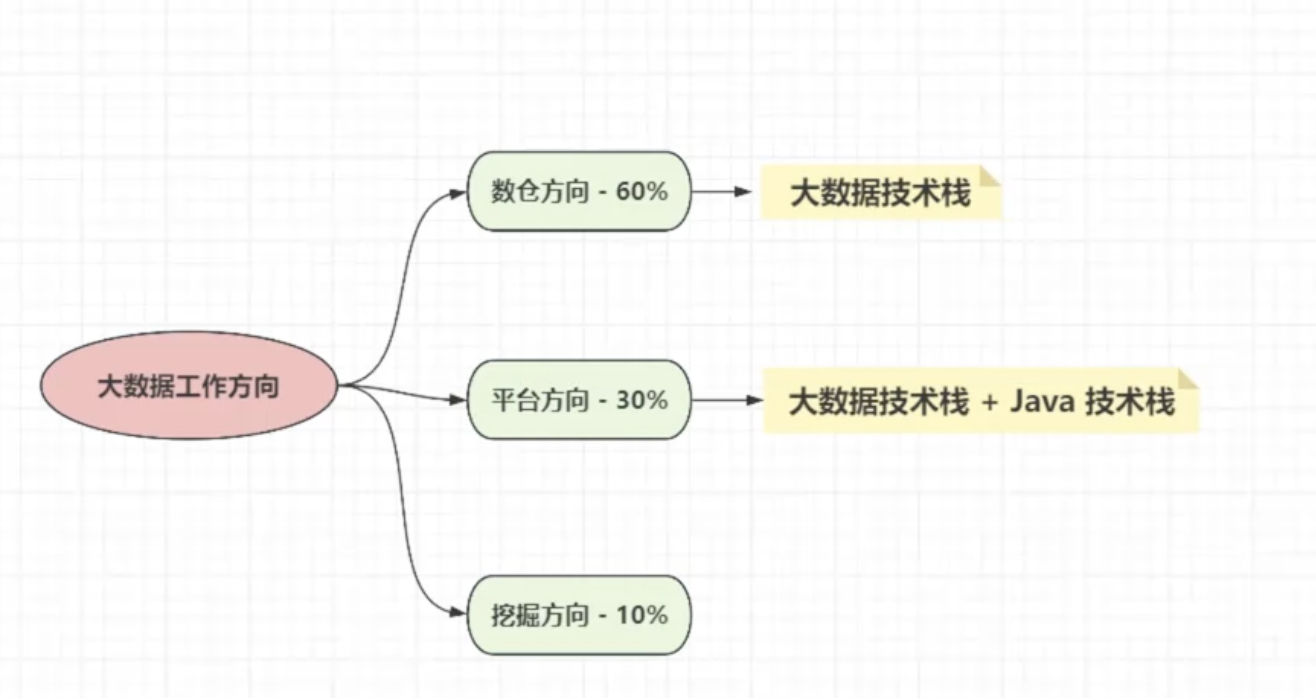
二、数据湖Iceberg
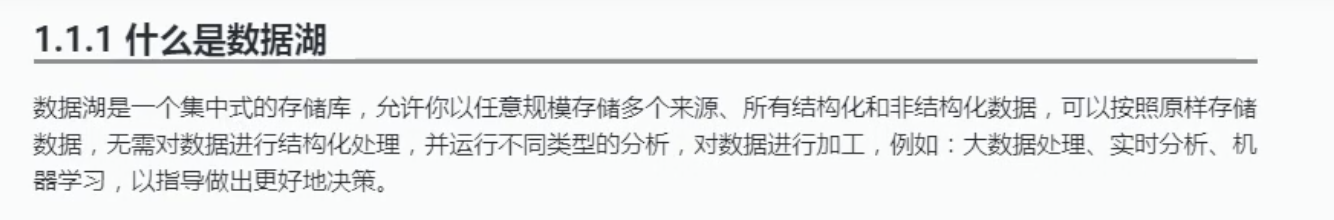
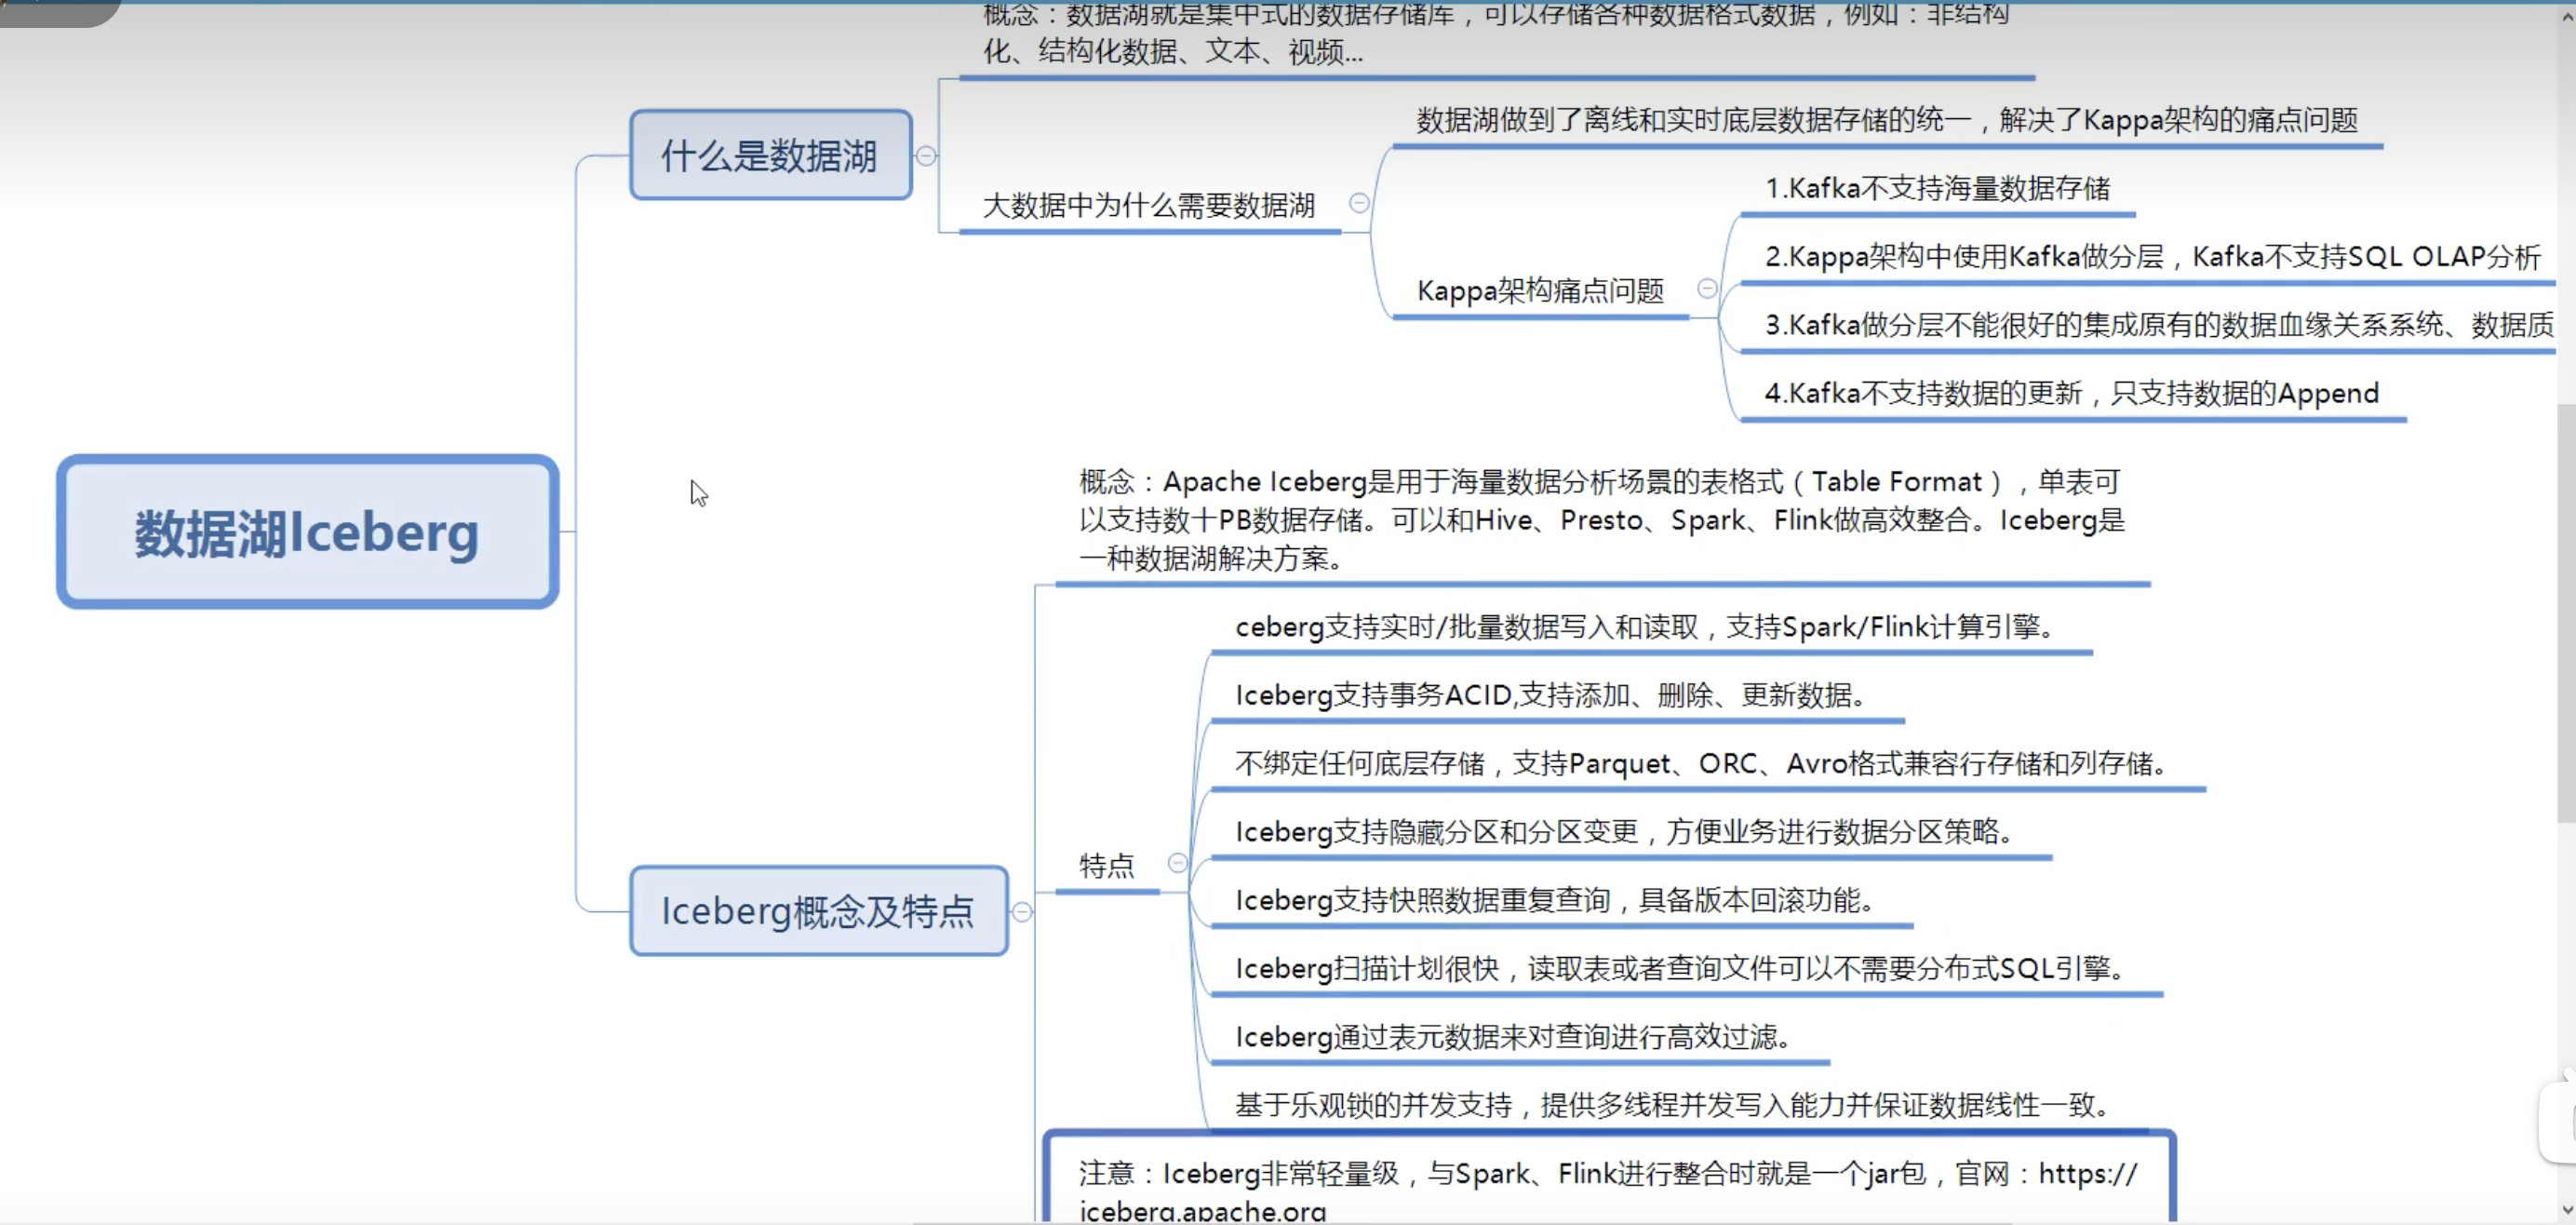
1. 什么是数据湖
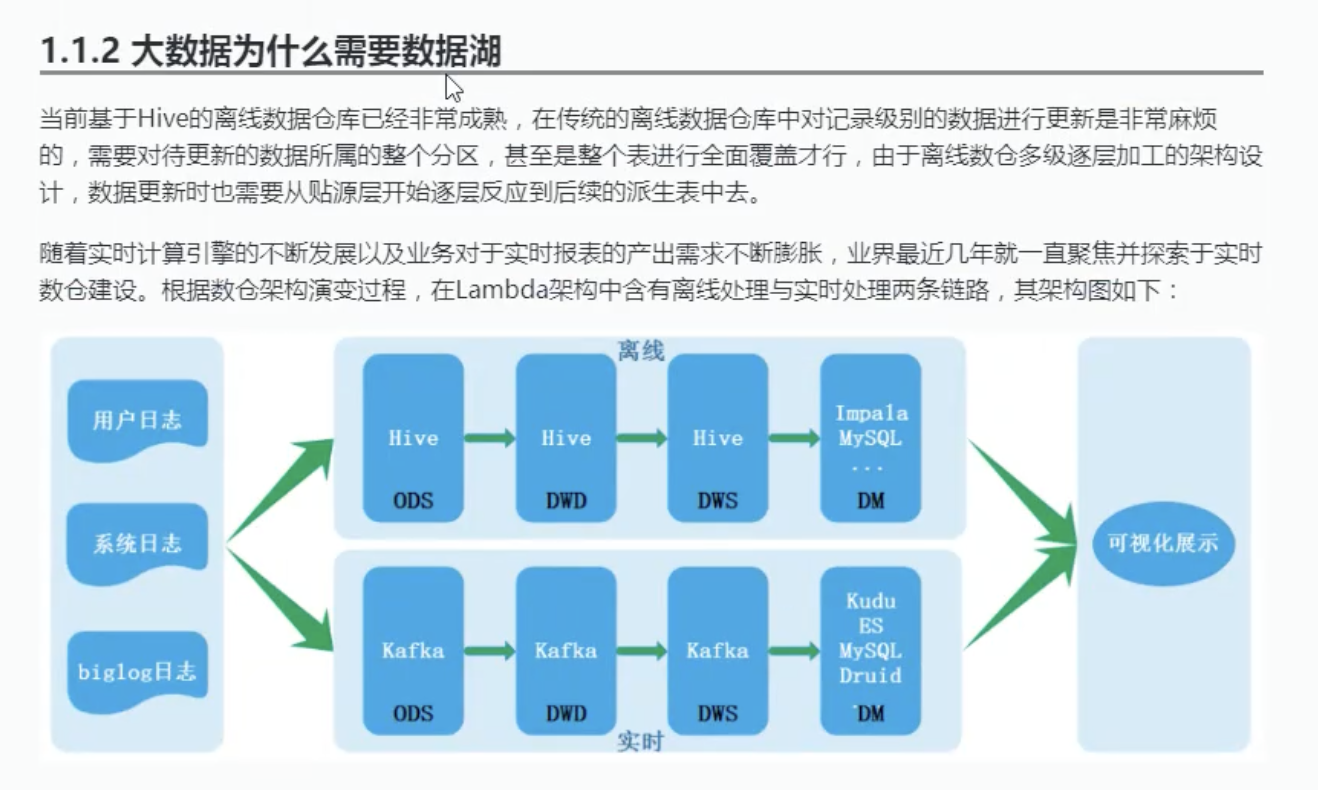
2. 为什么需要数据湖
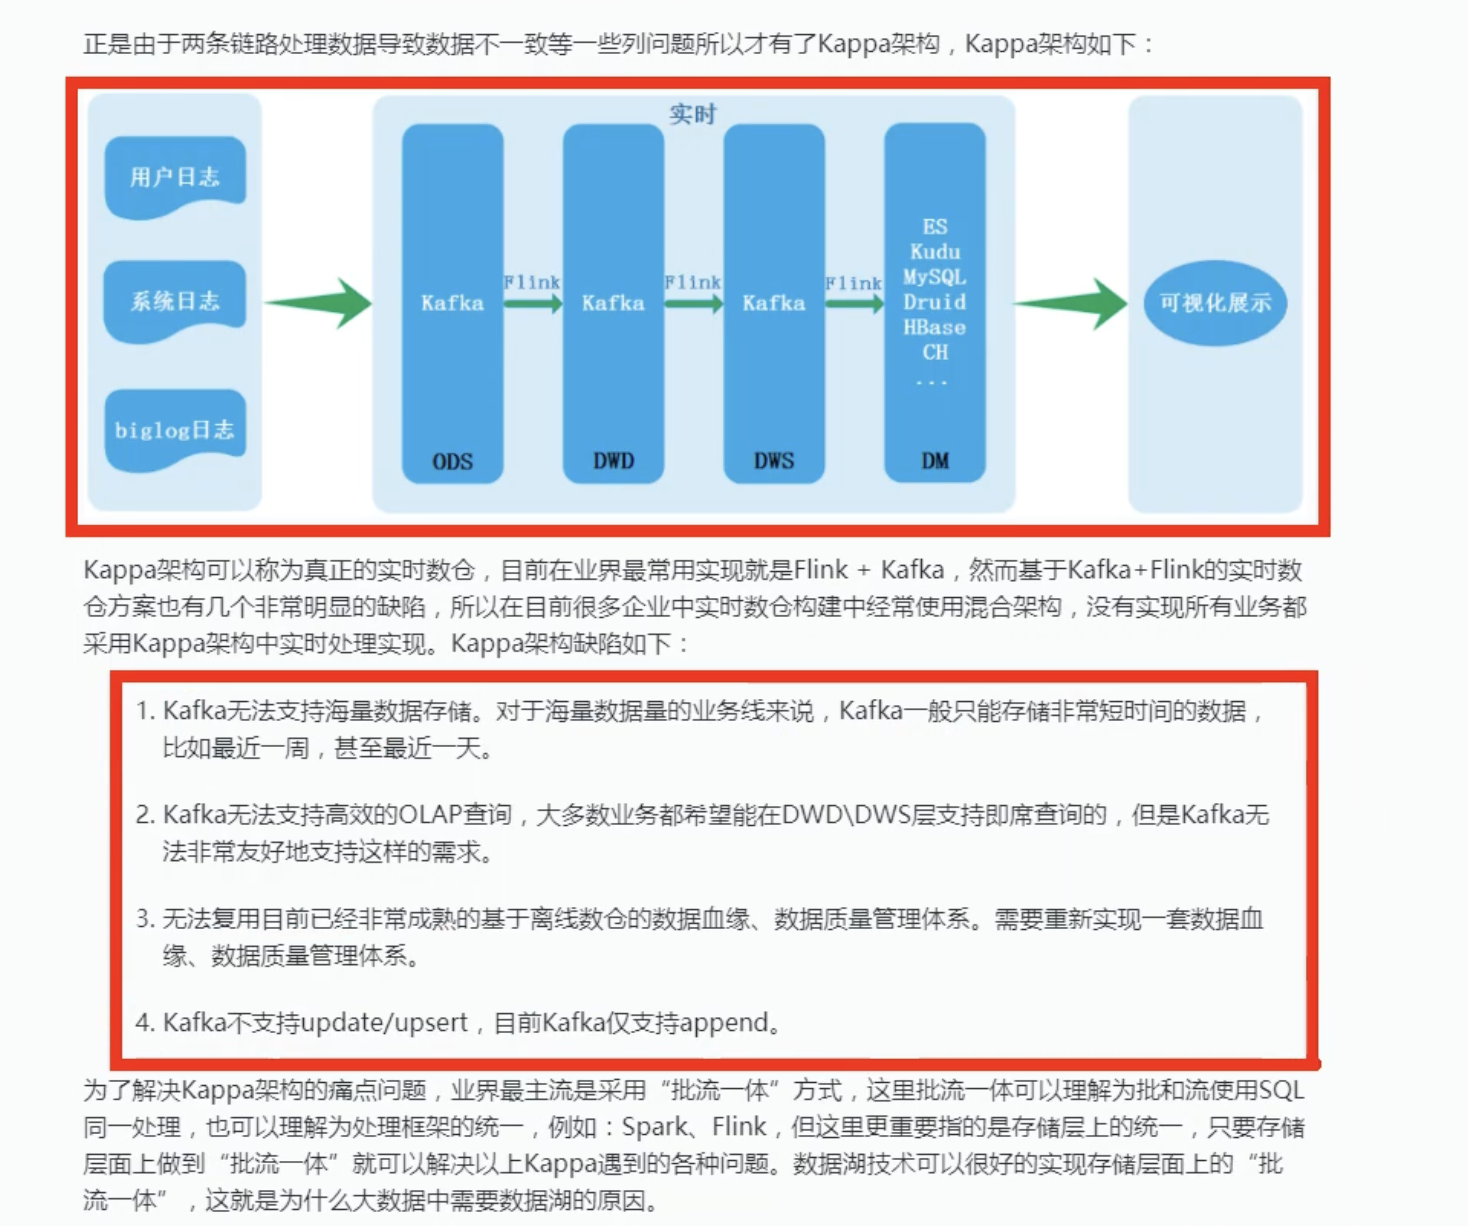
三、Iceberg
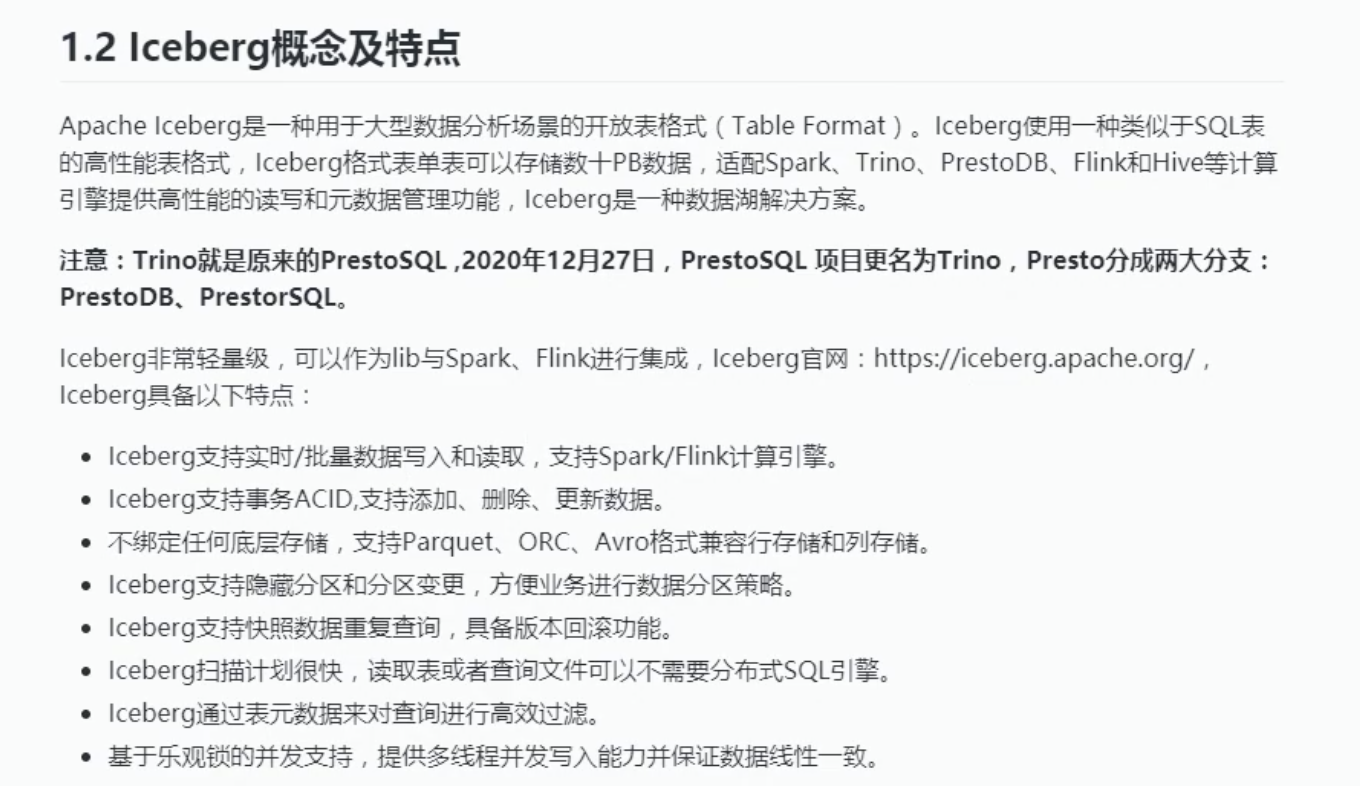
3.1 概念及特点
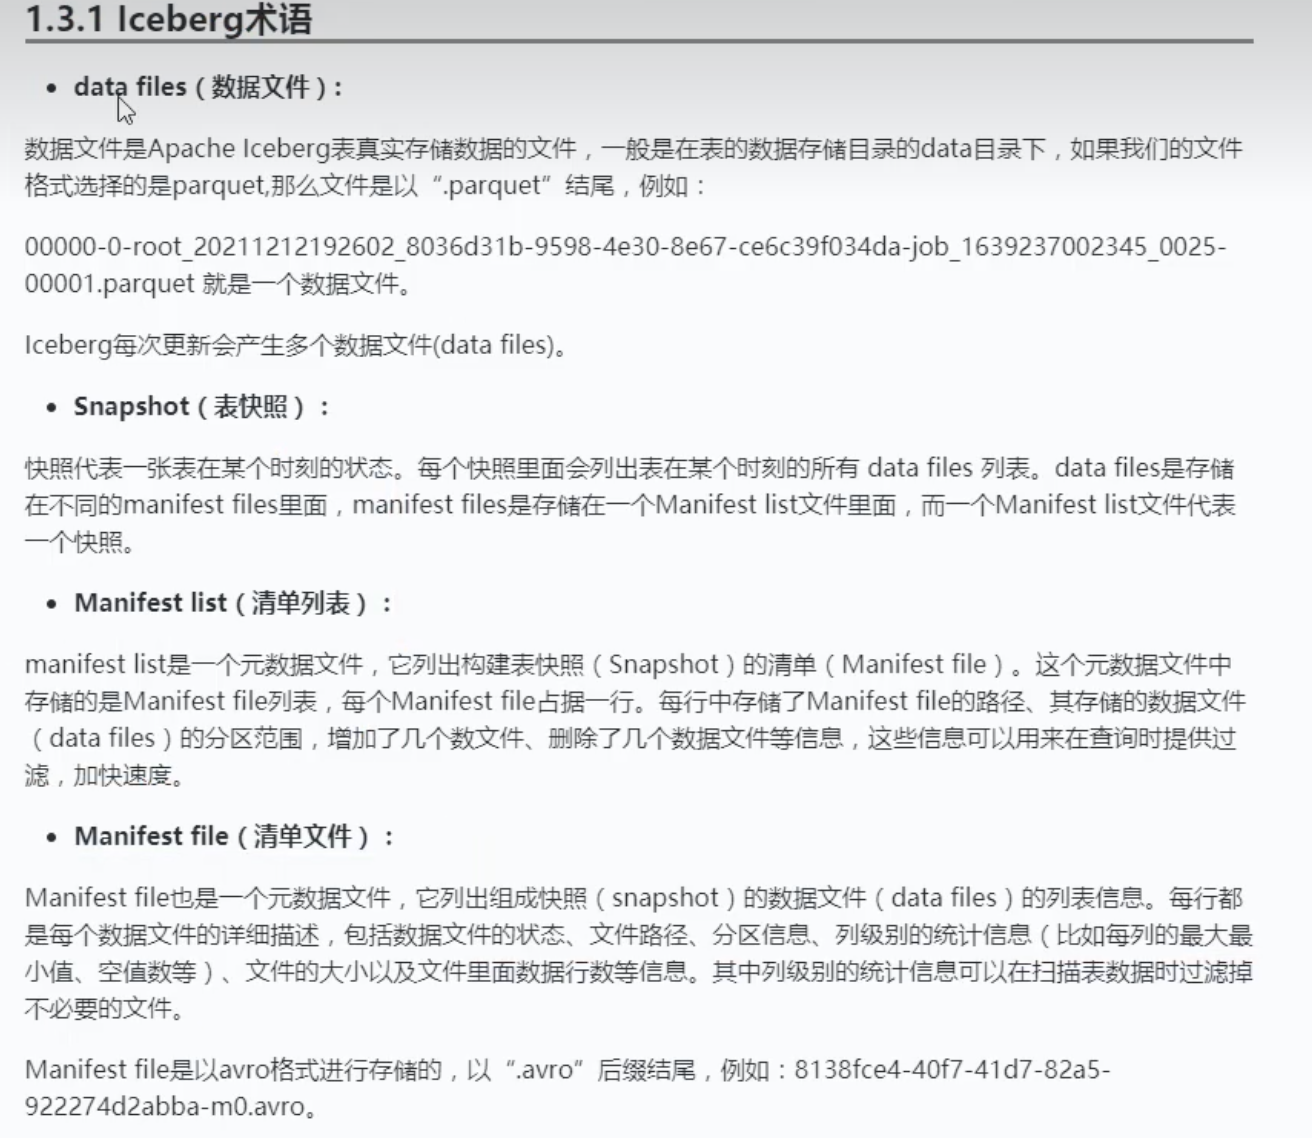
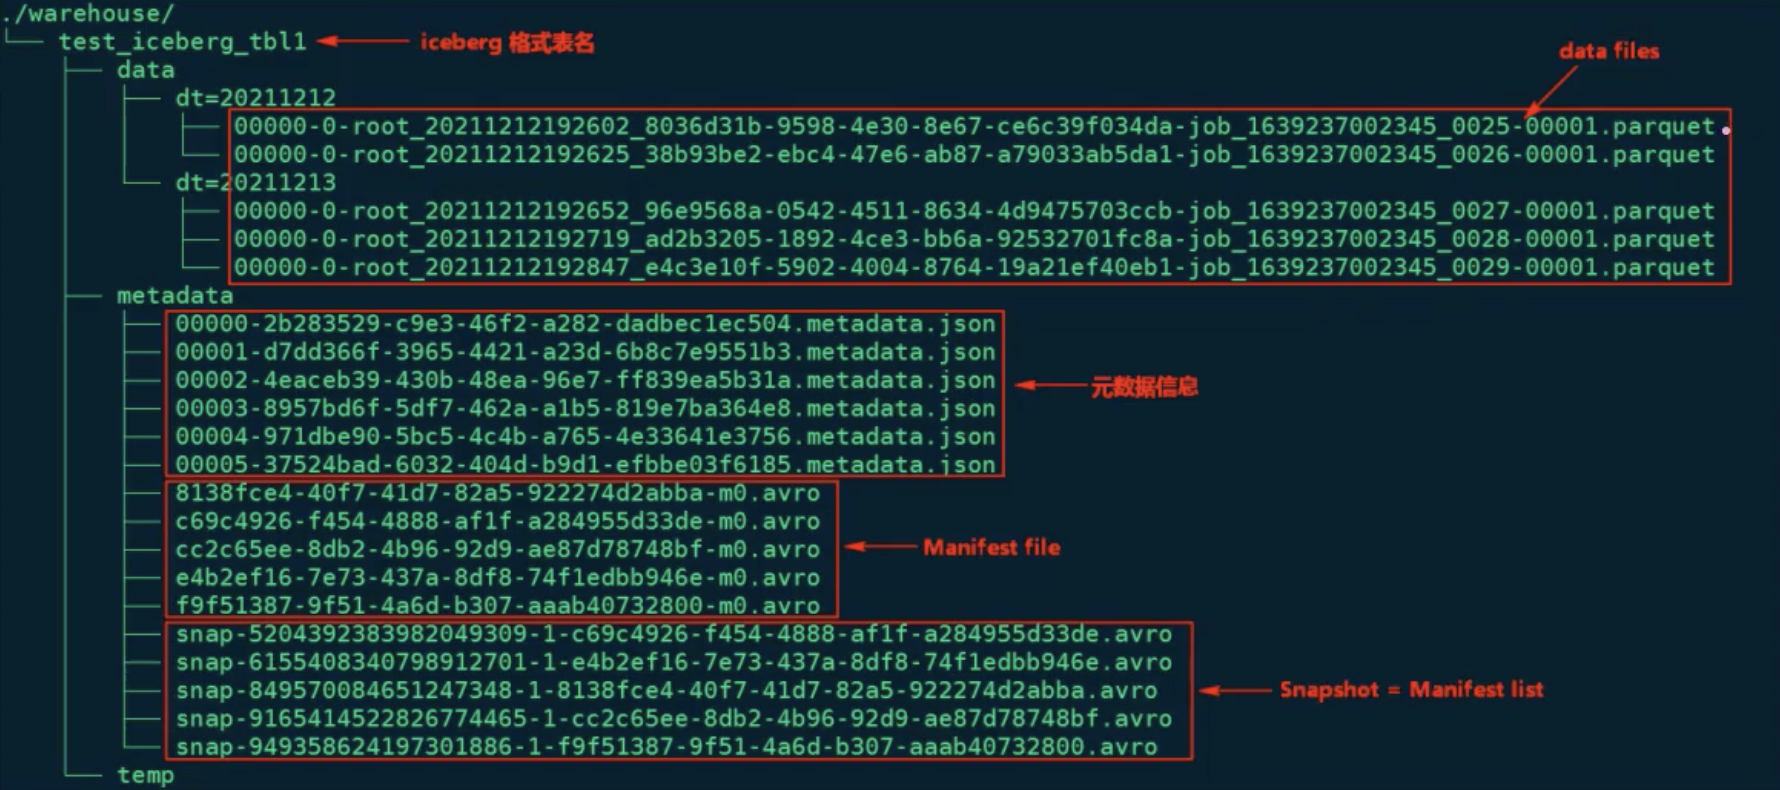
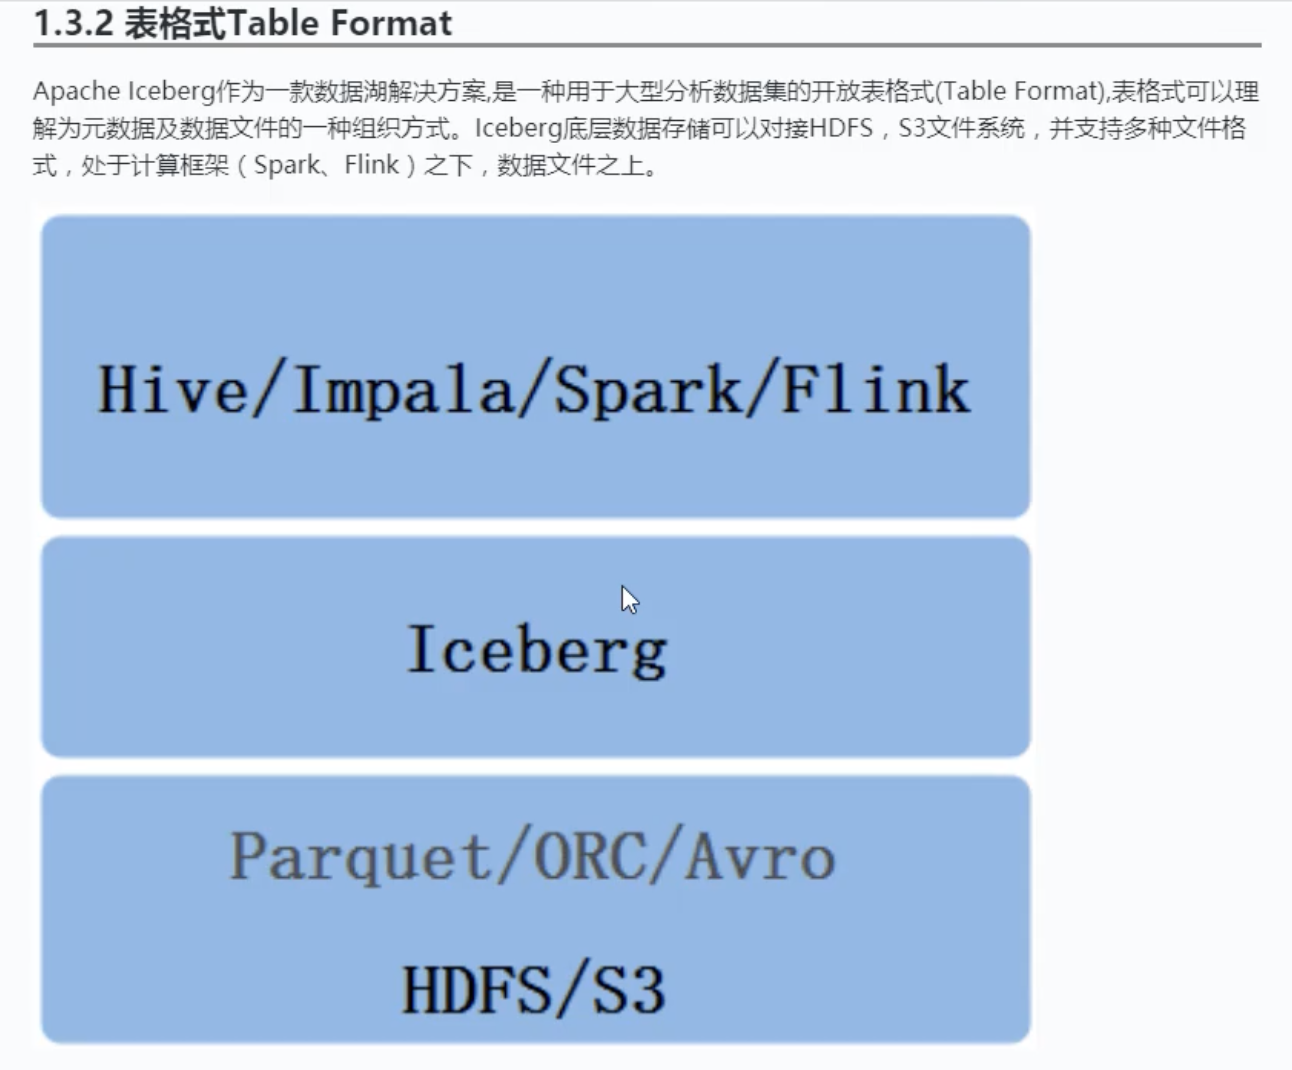
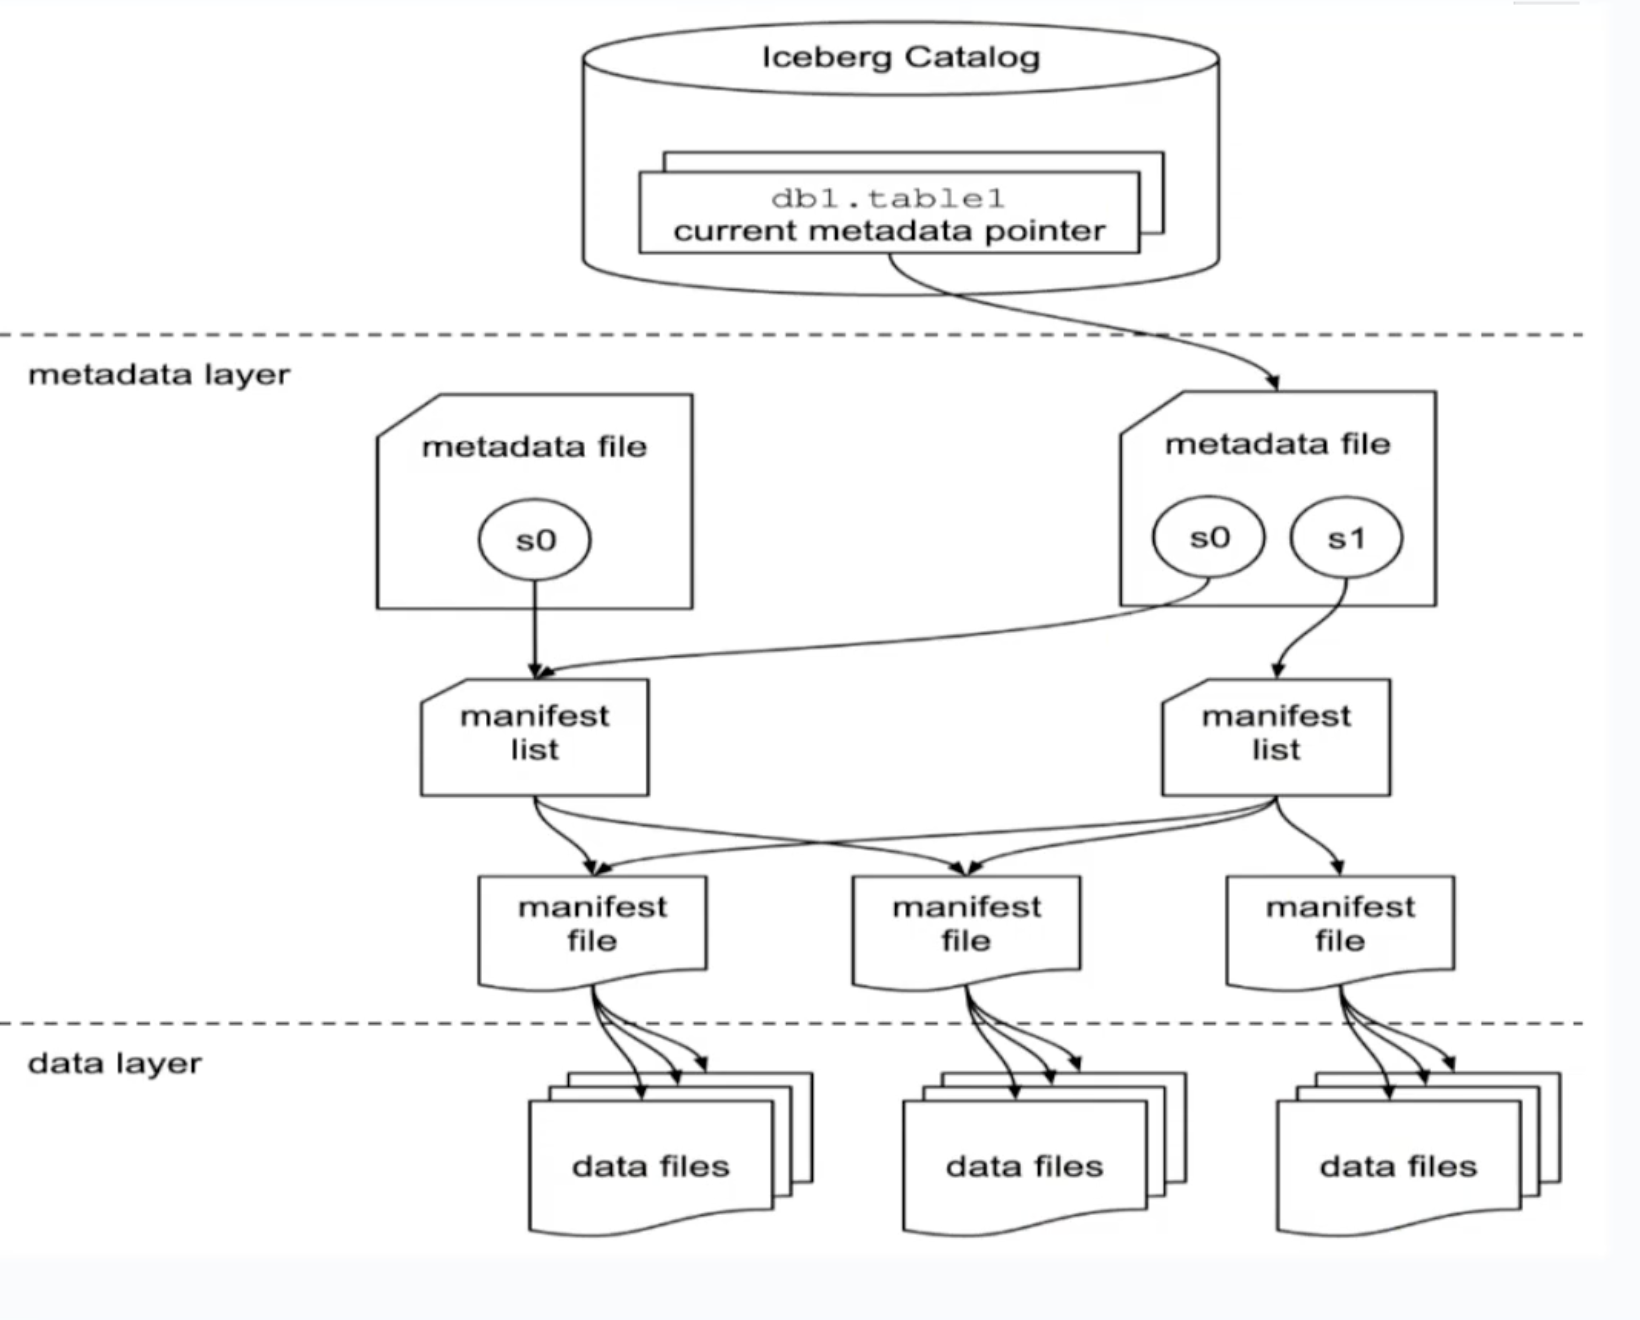
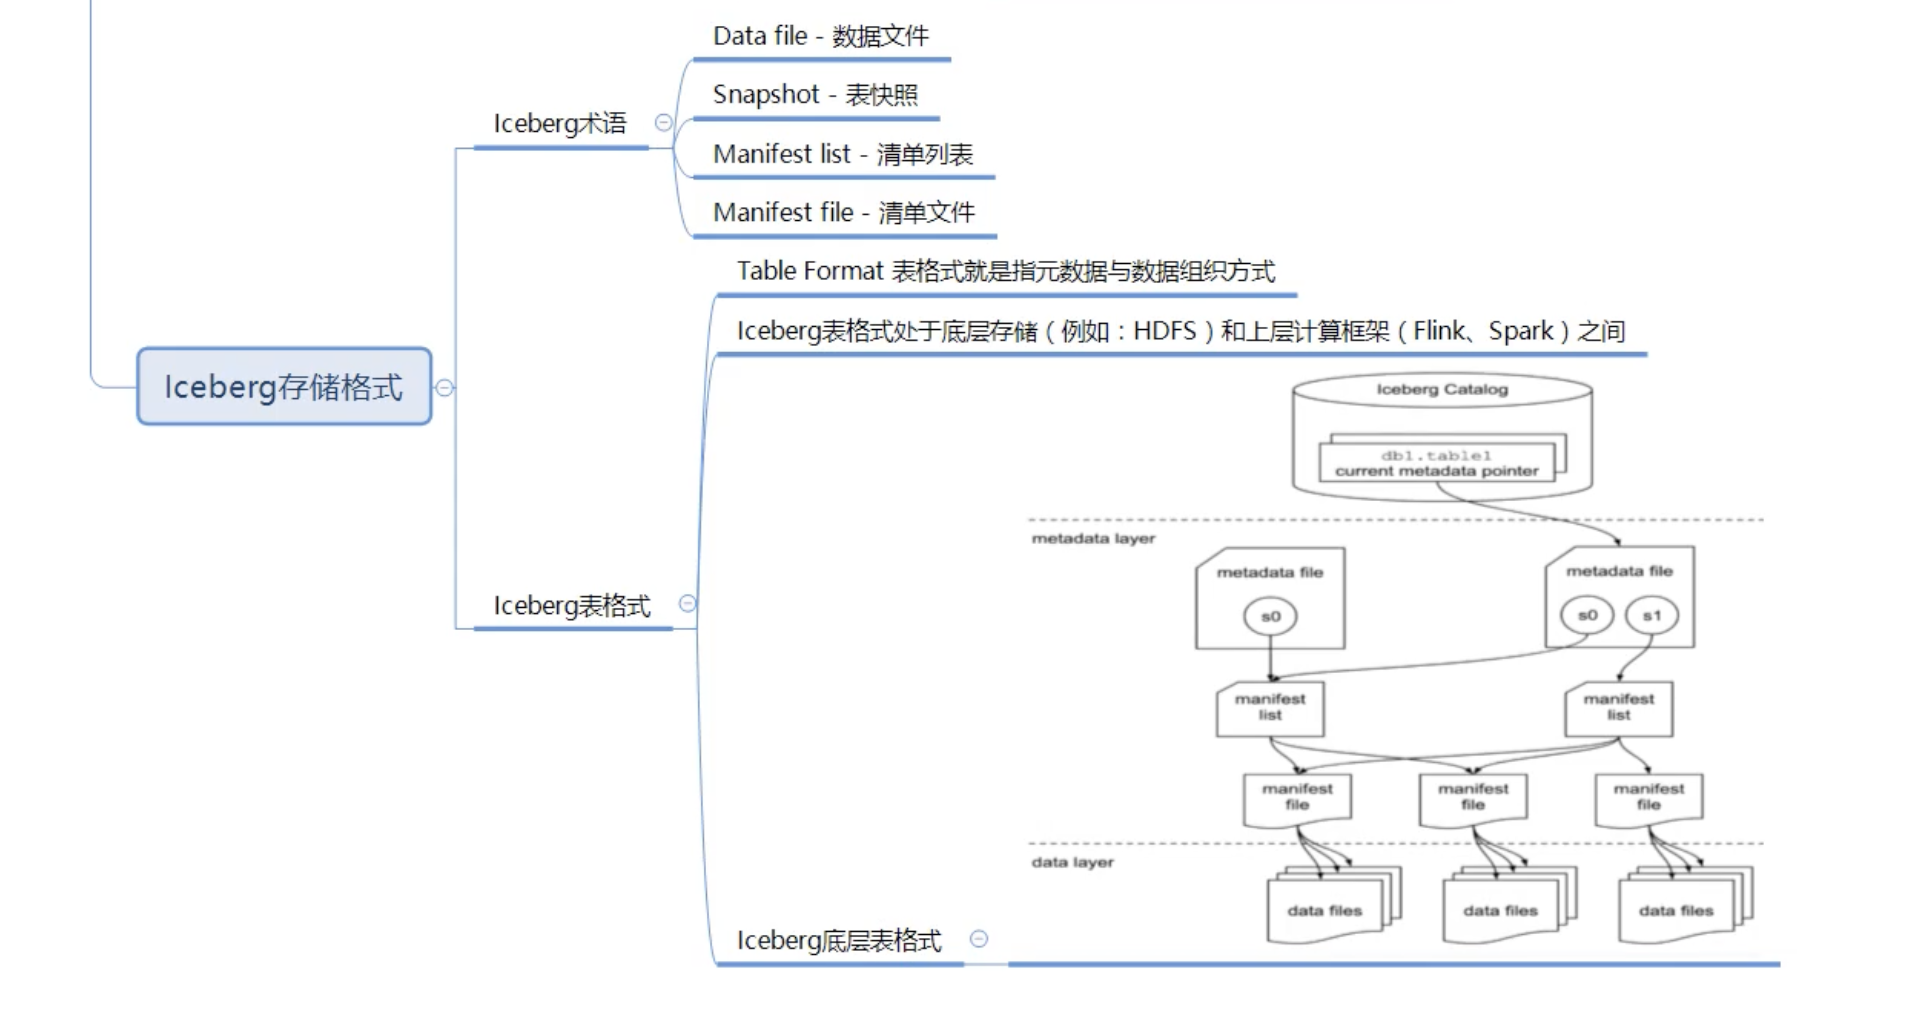
3.2 Iceberg术语及表格式
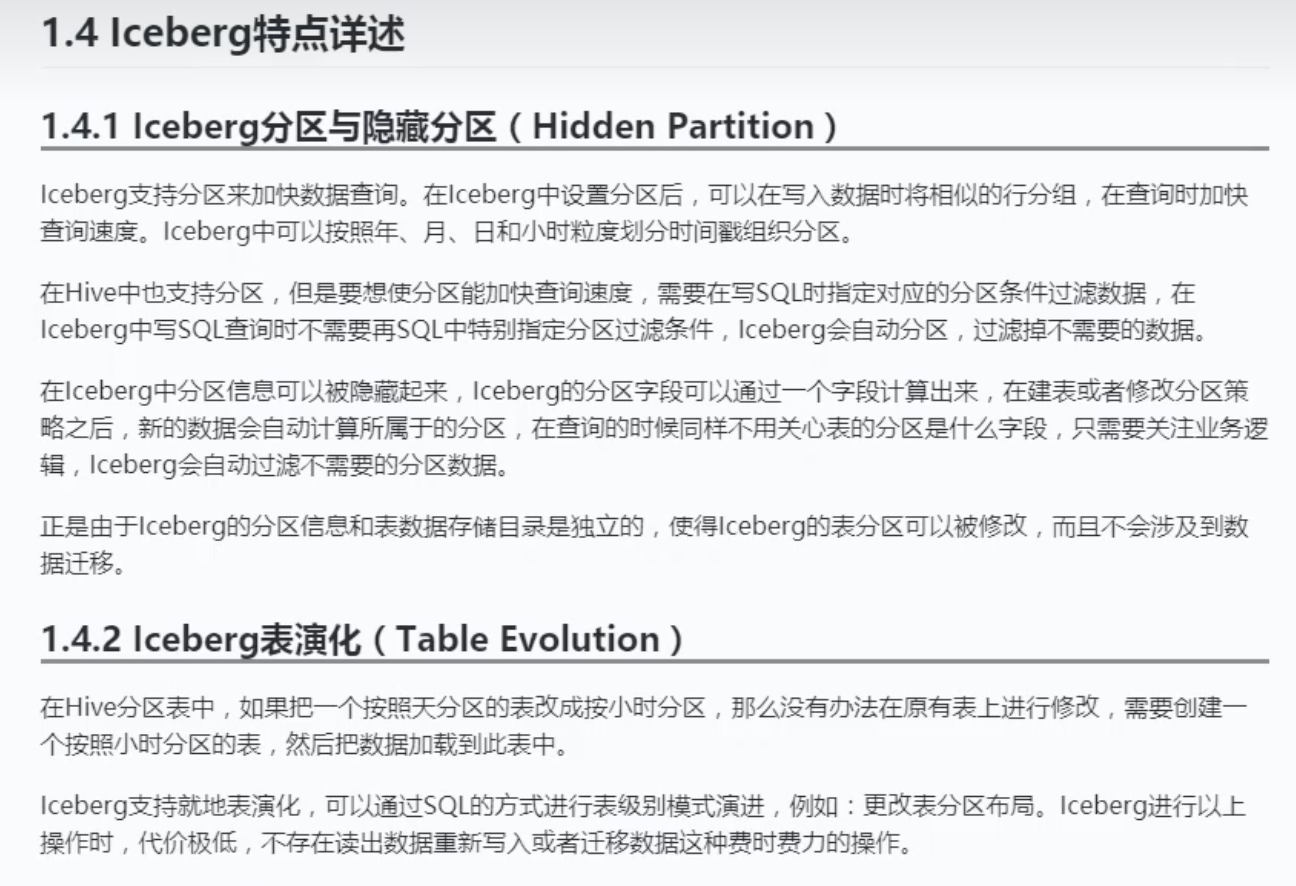
3.3 Iceberg特点
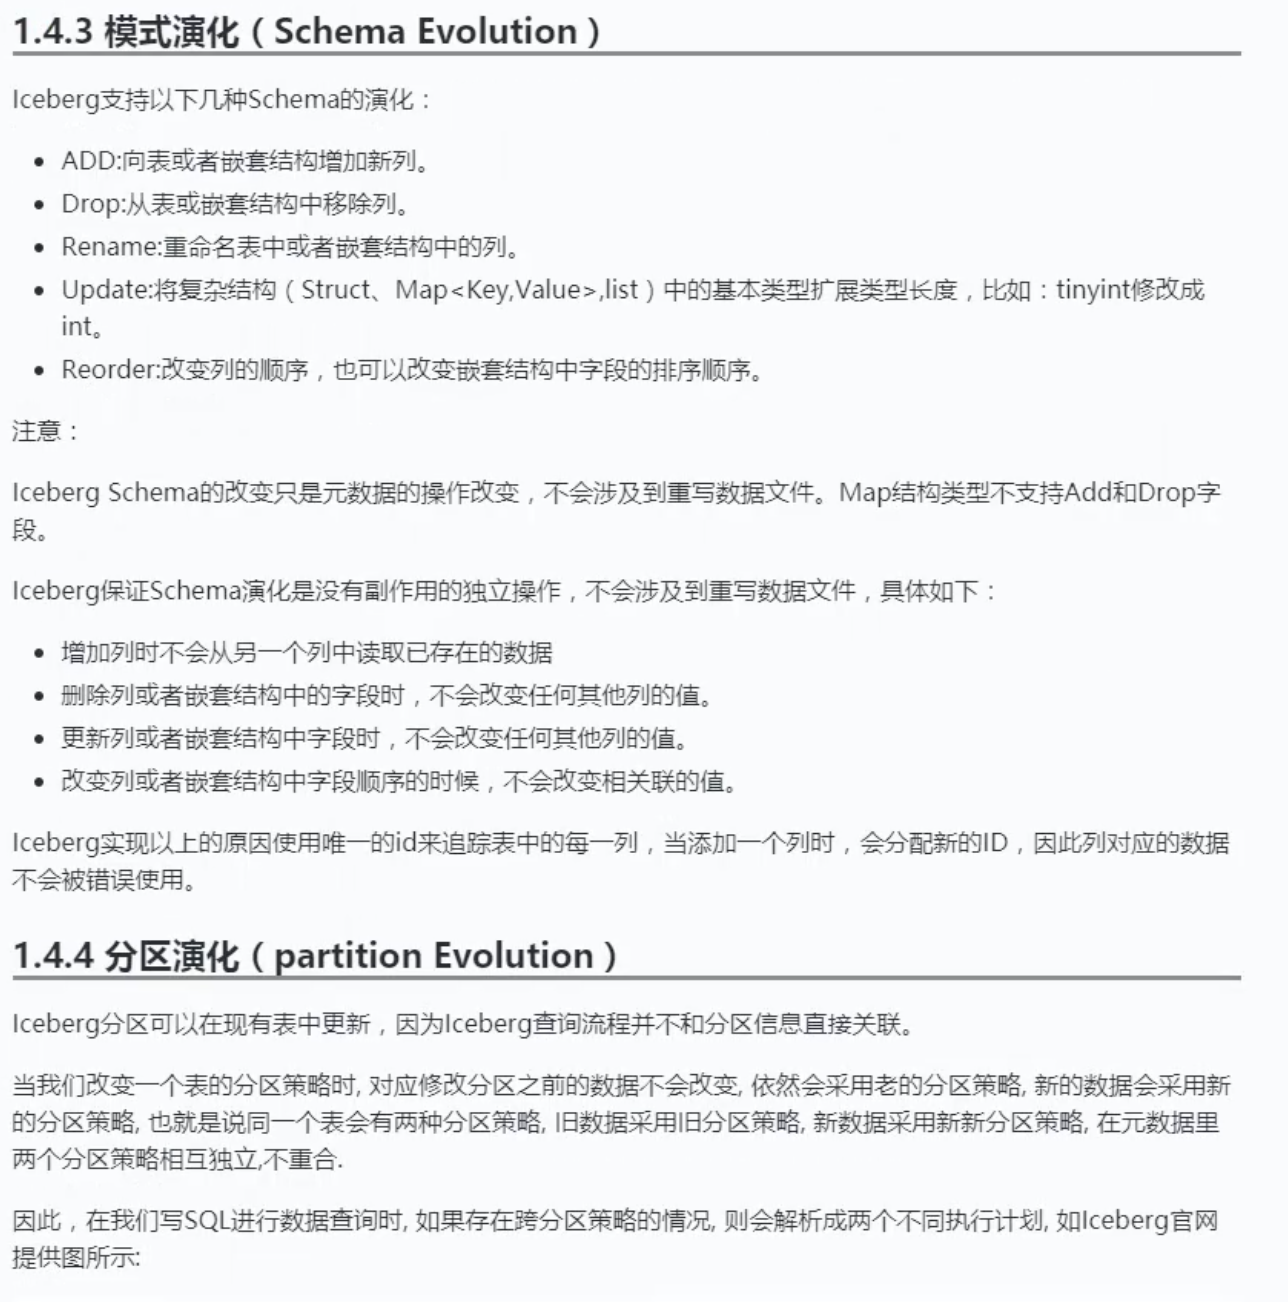
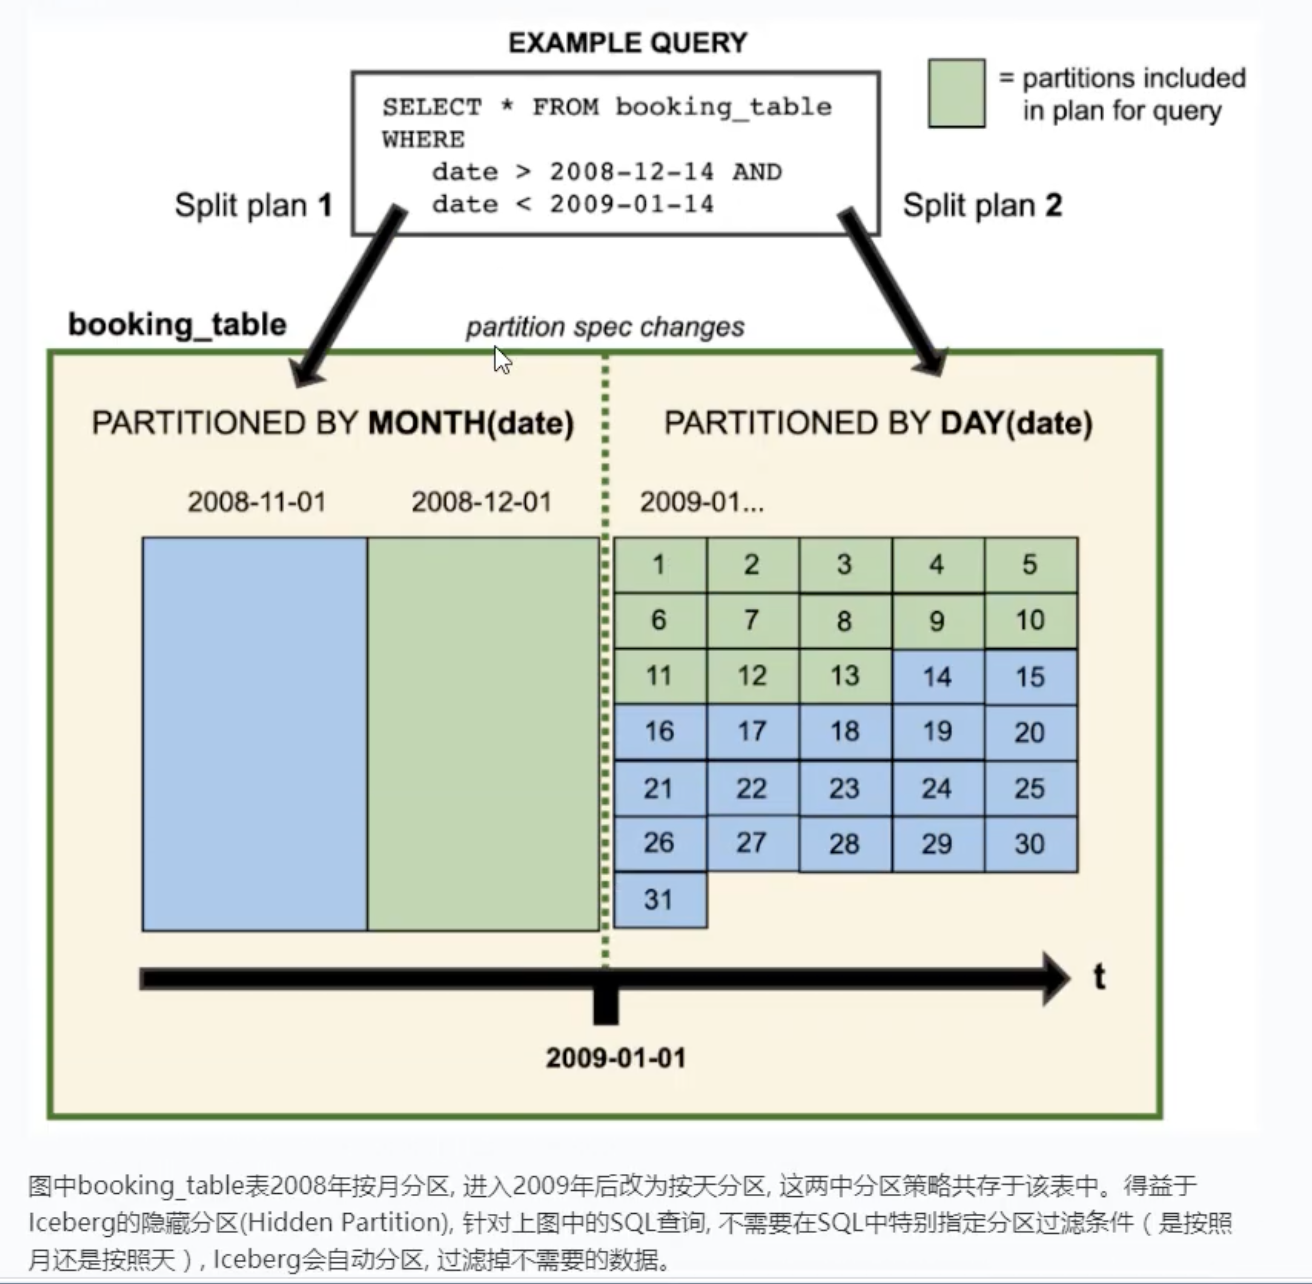
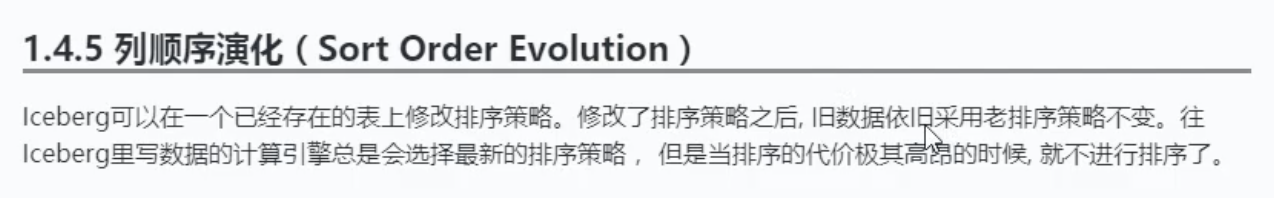
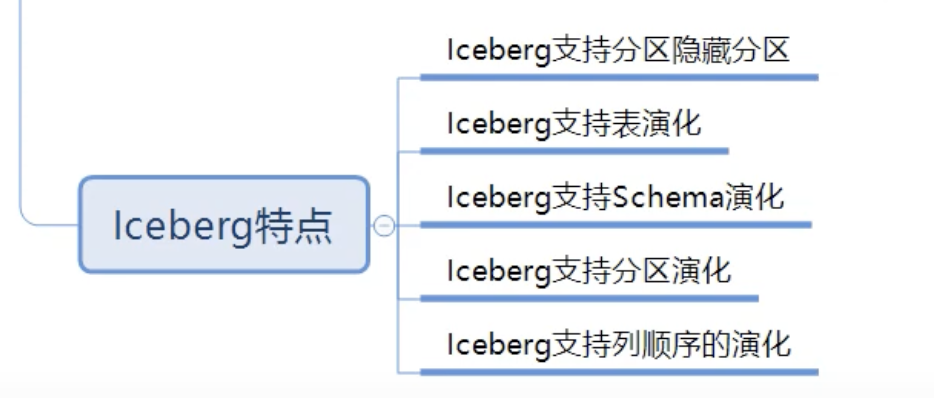
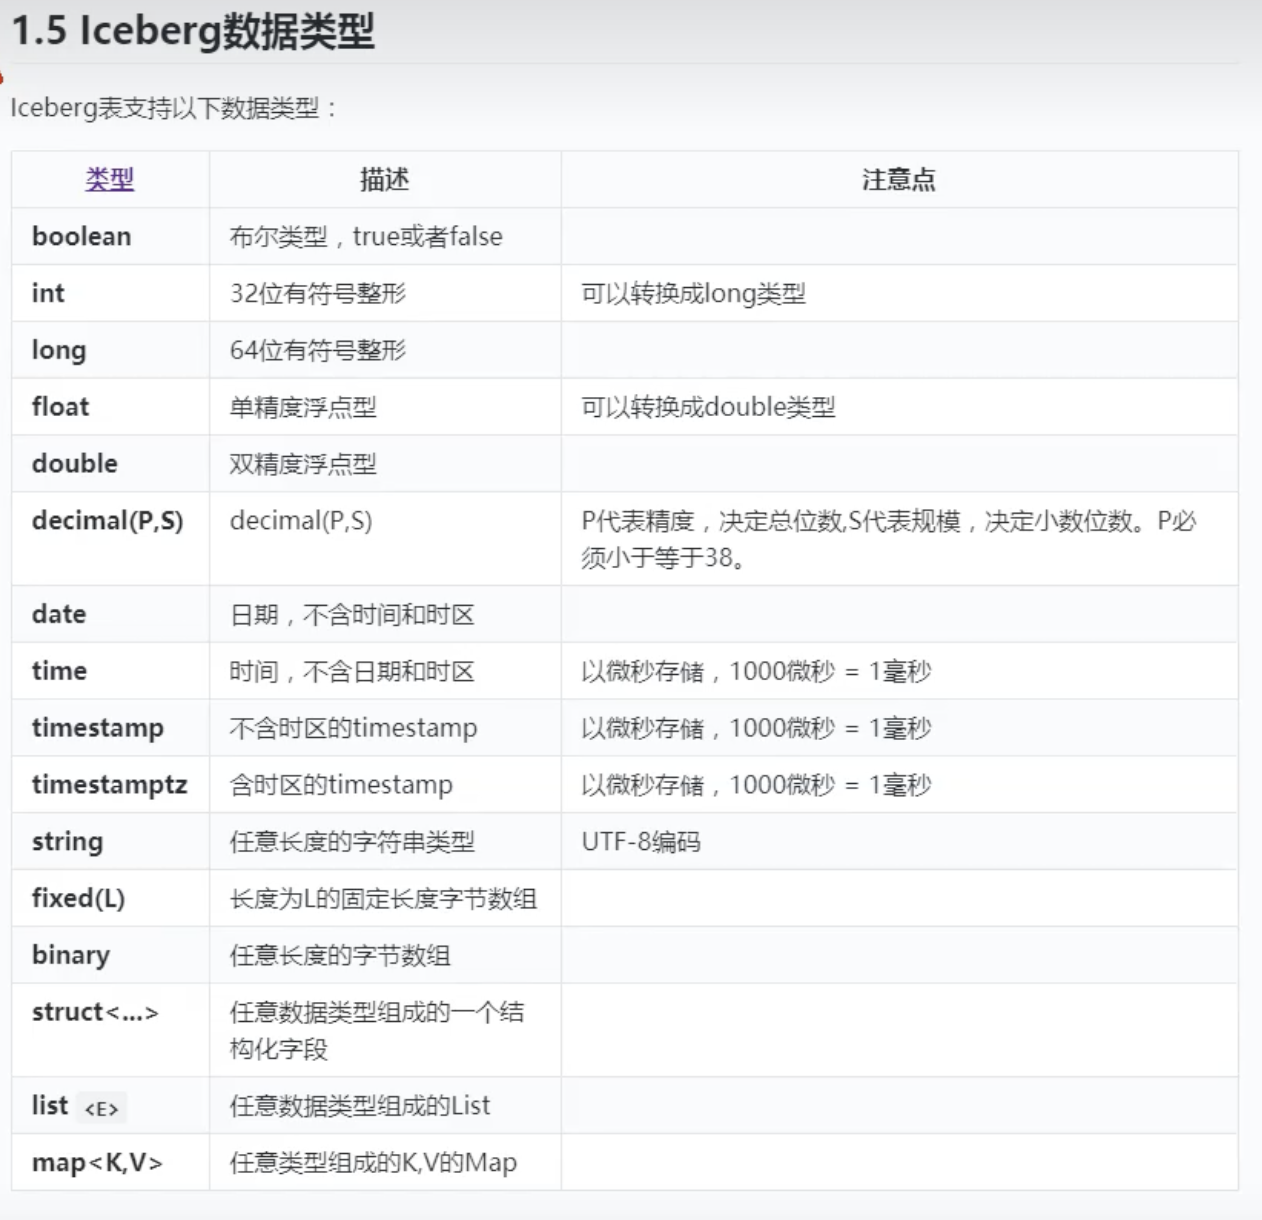
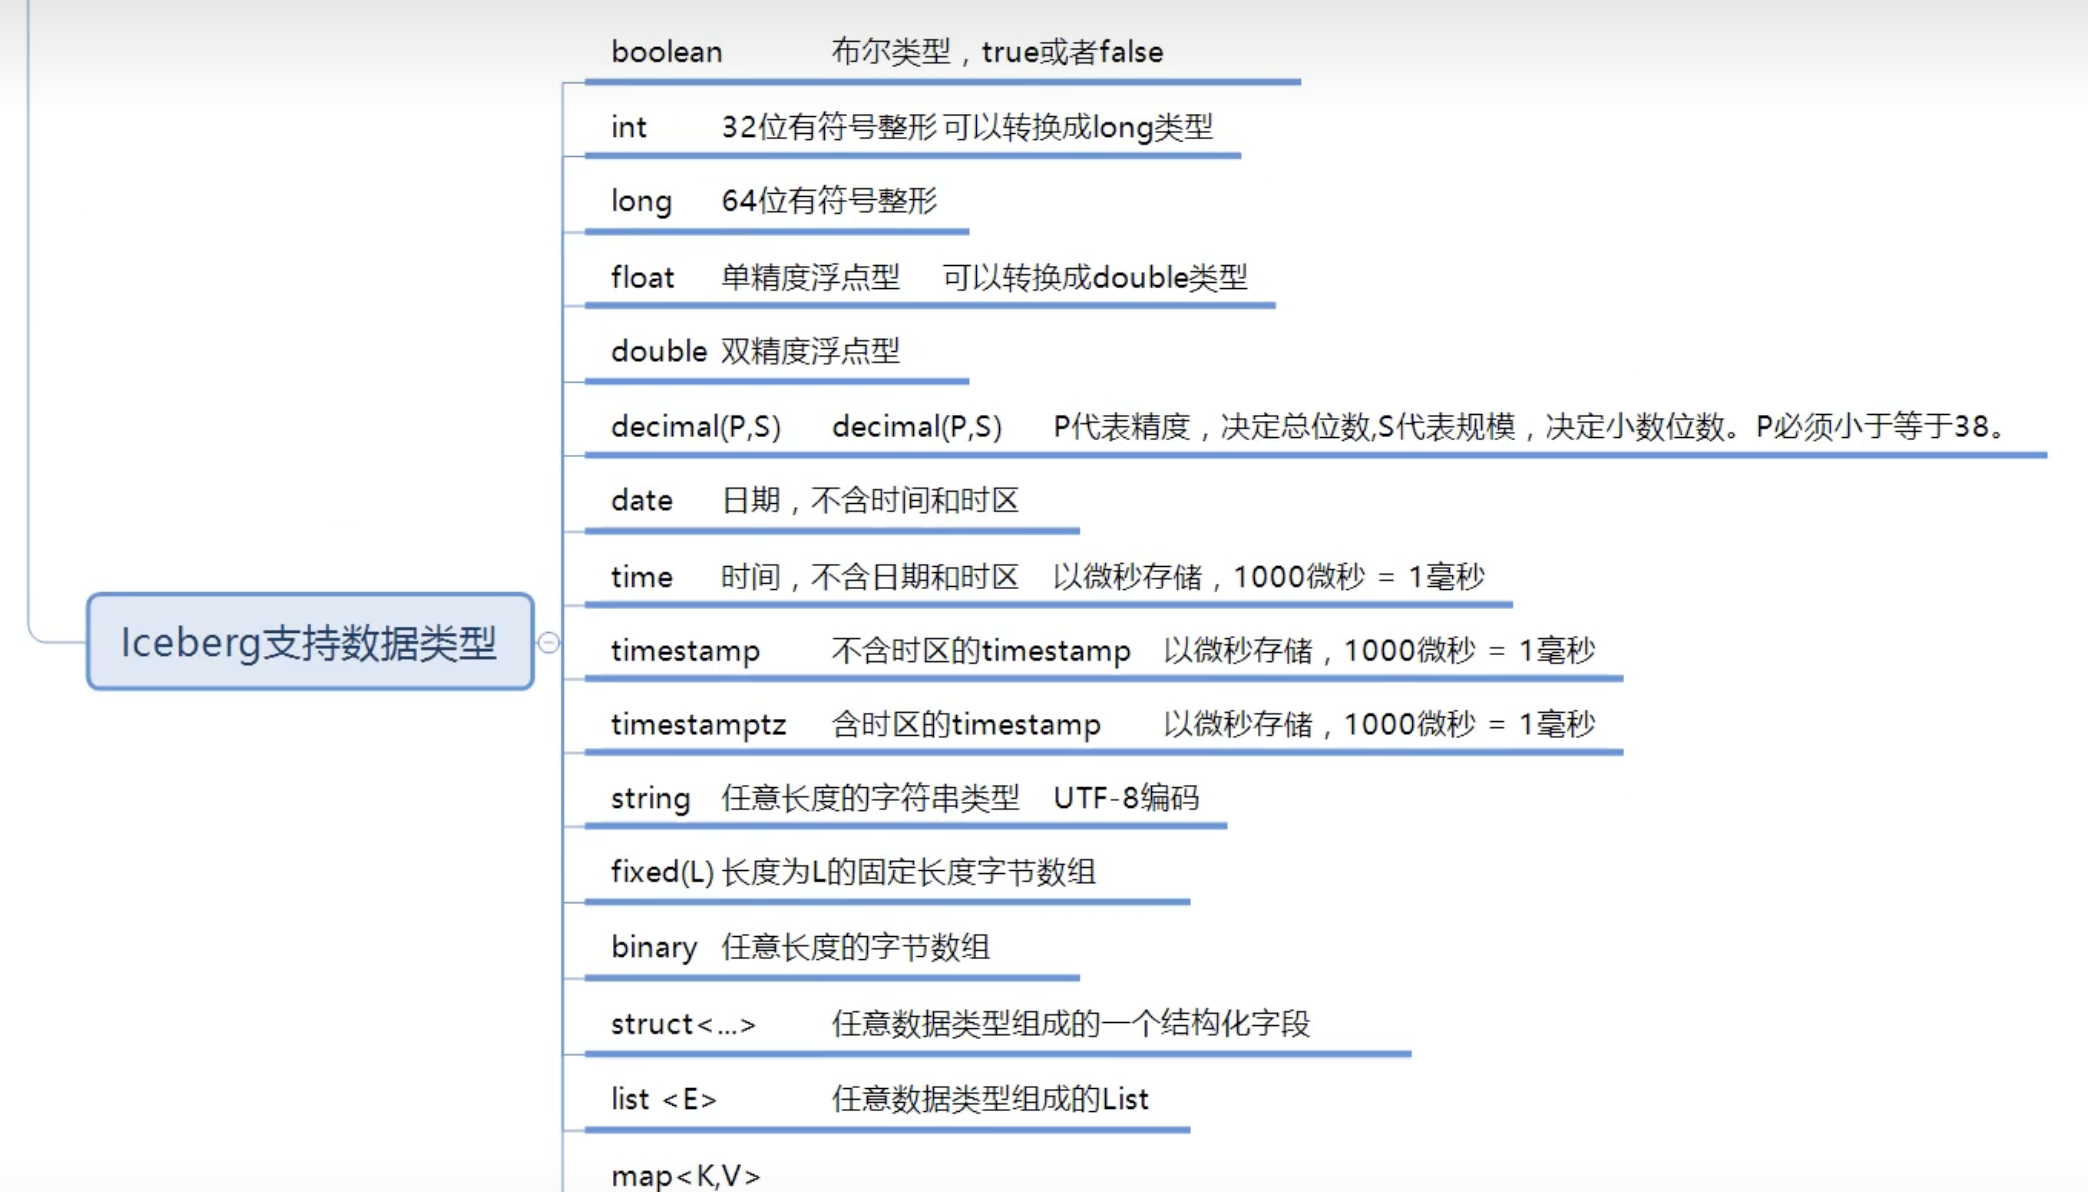
3.4 数据类型
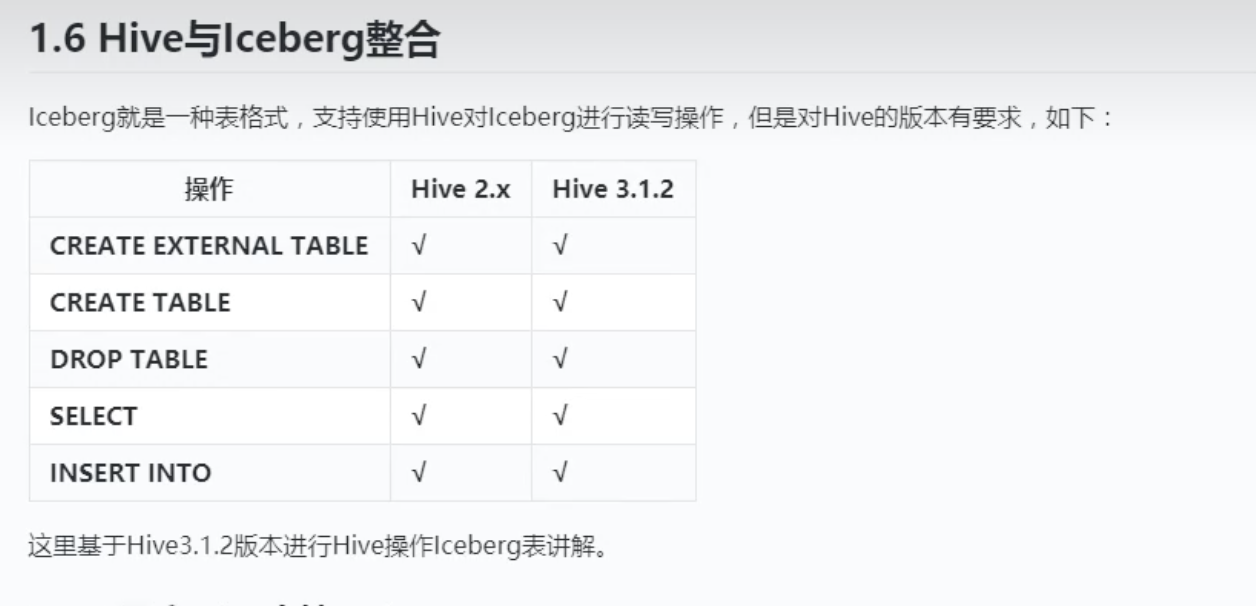
3.5 Hive与Iceberg整合
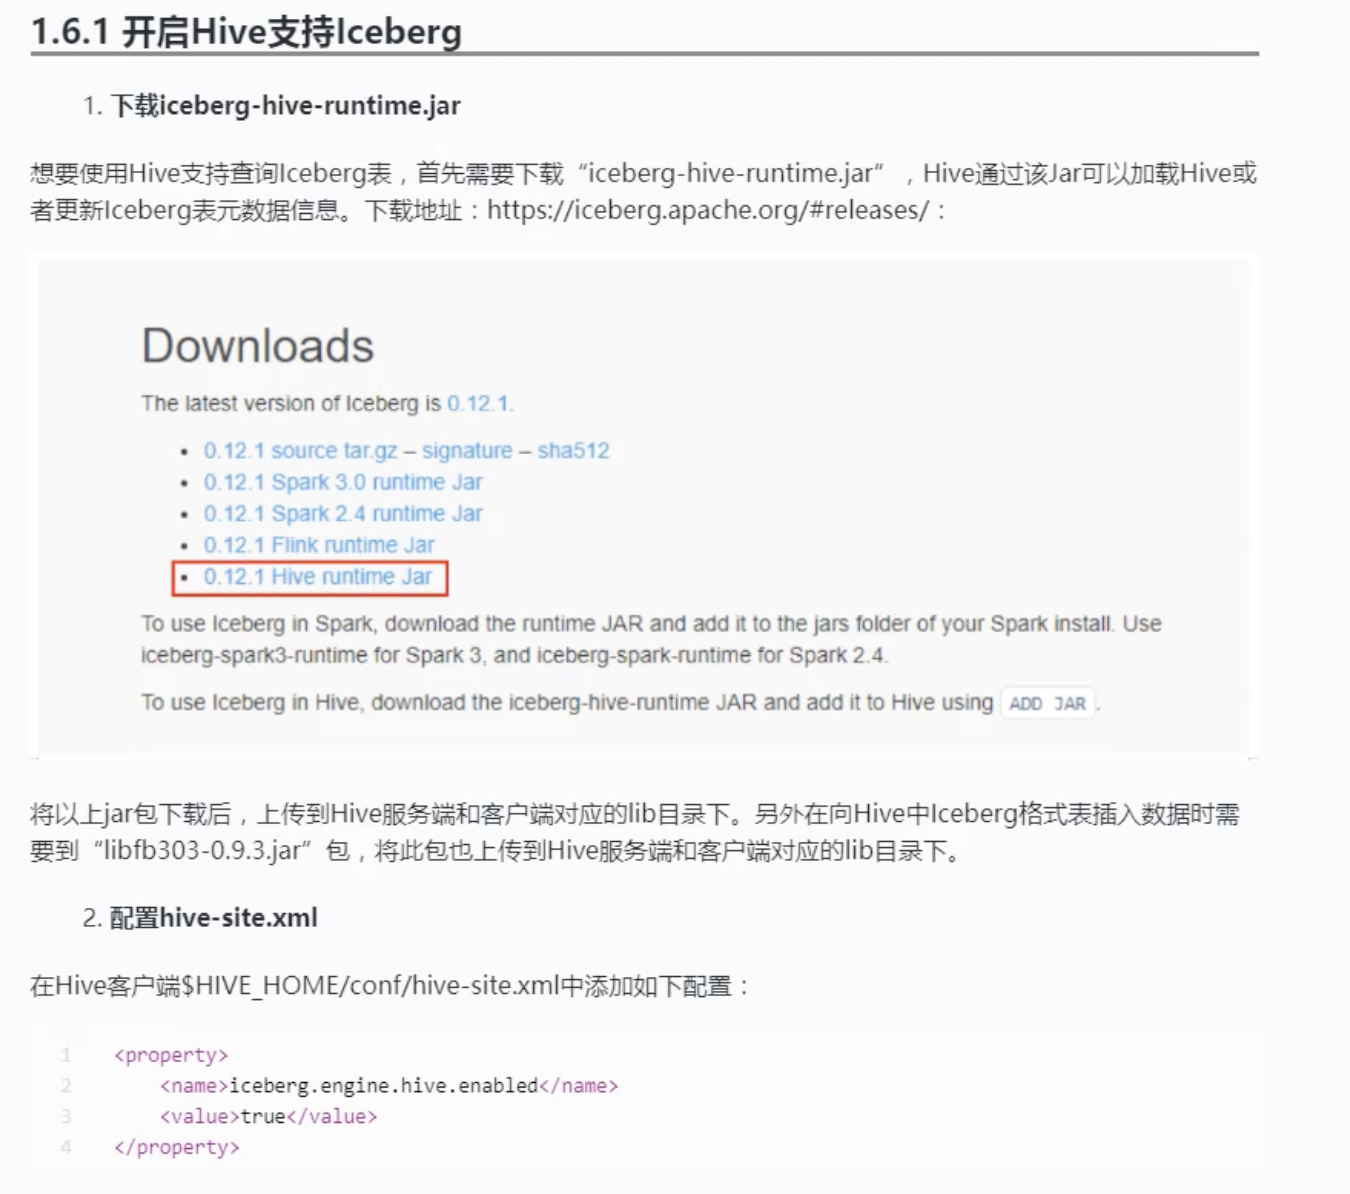
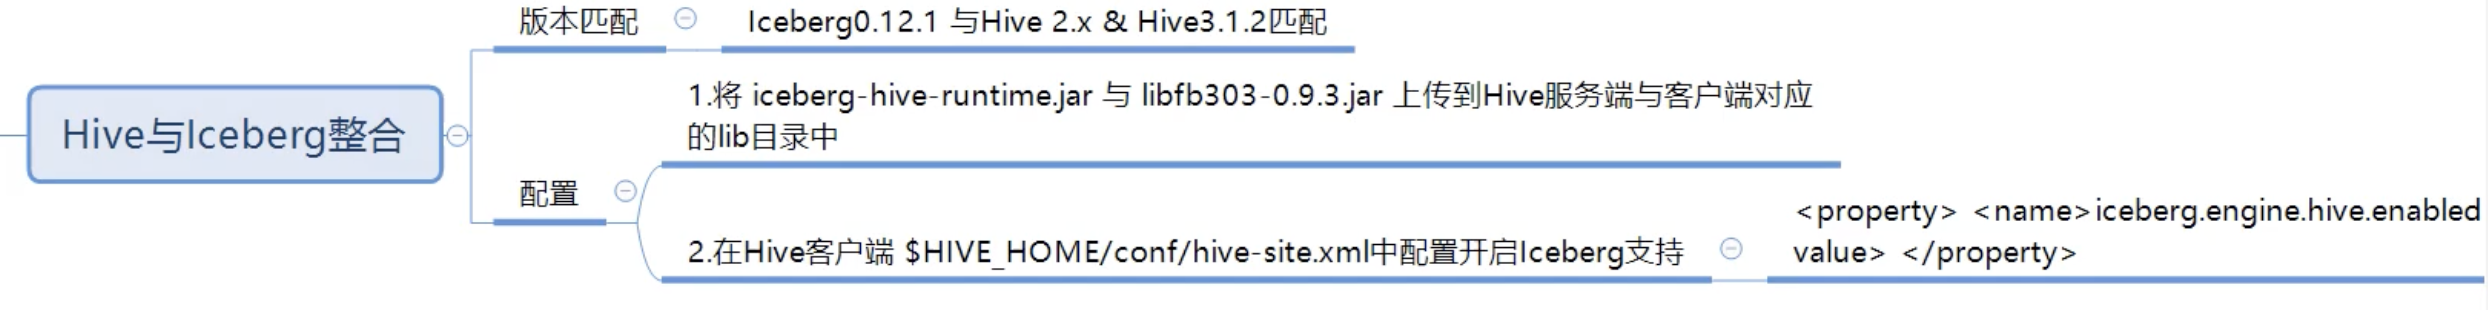
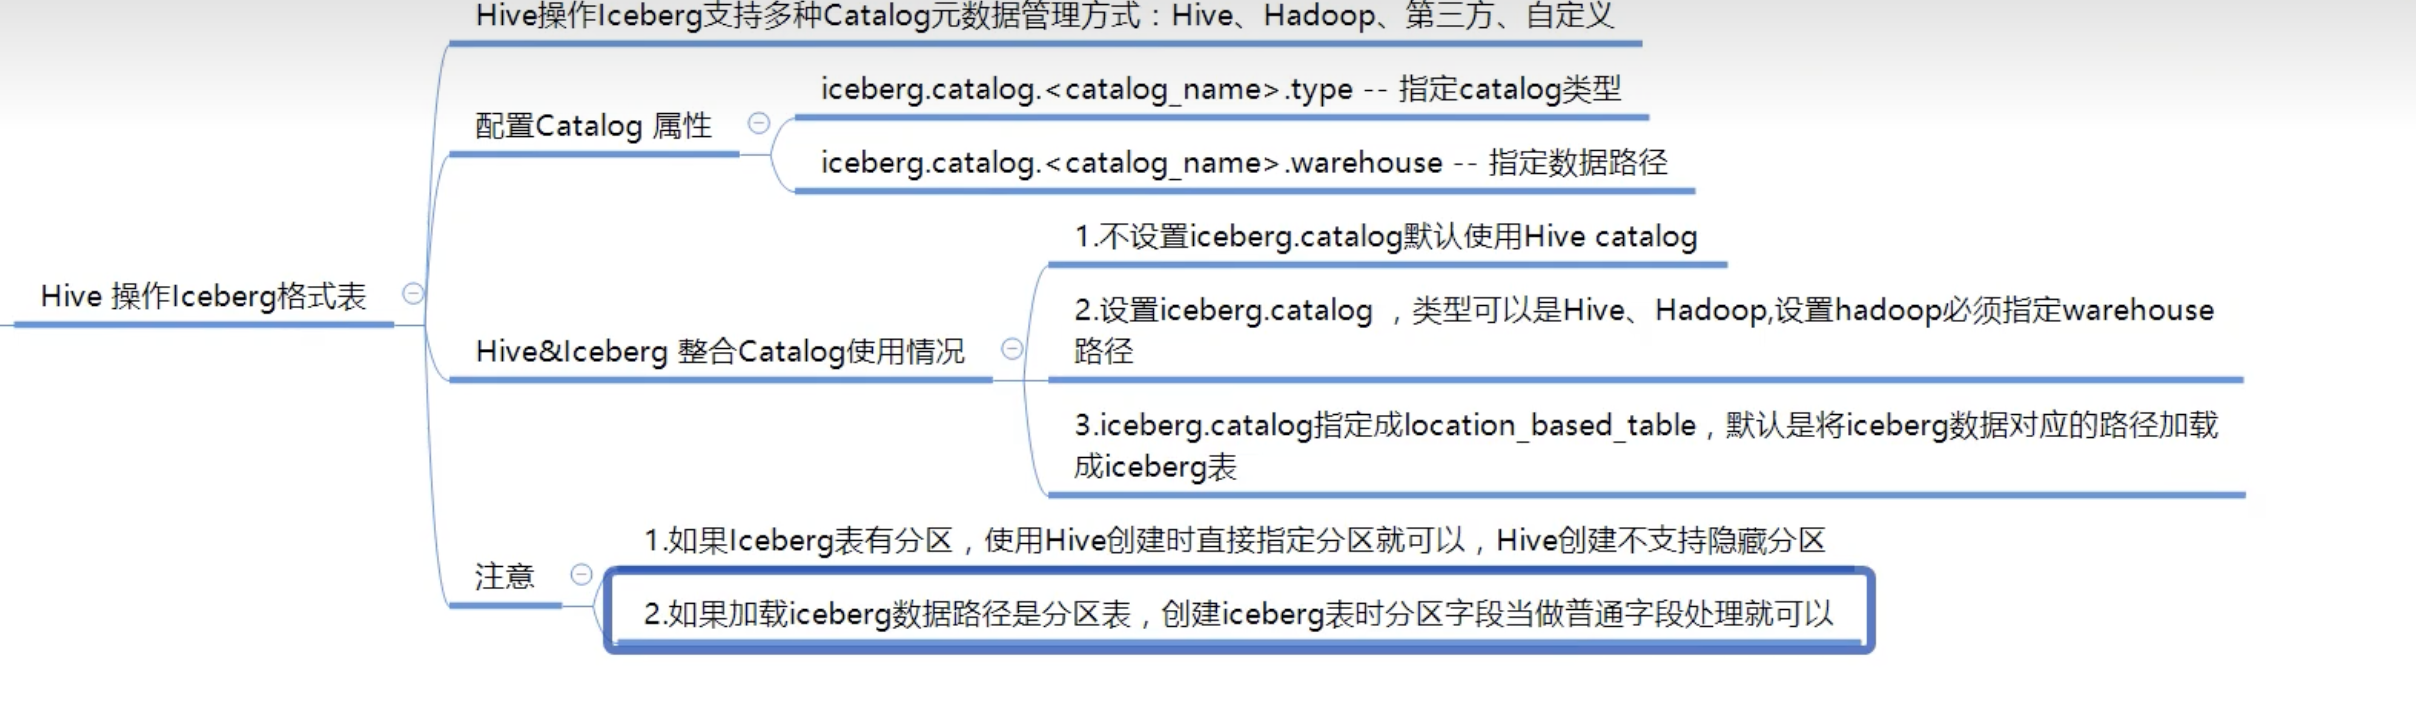
3.6 Hive中操作Iceberg格式表
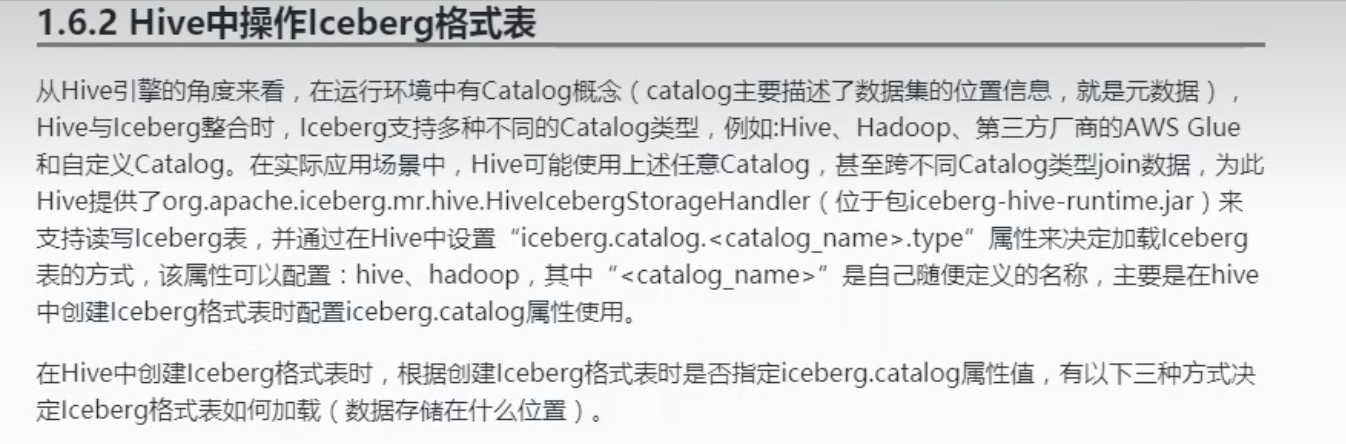
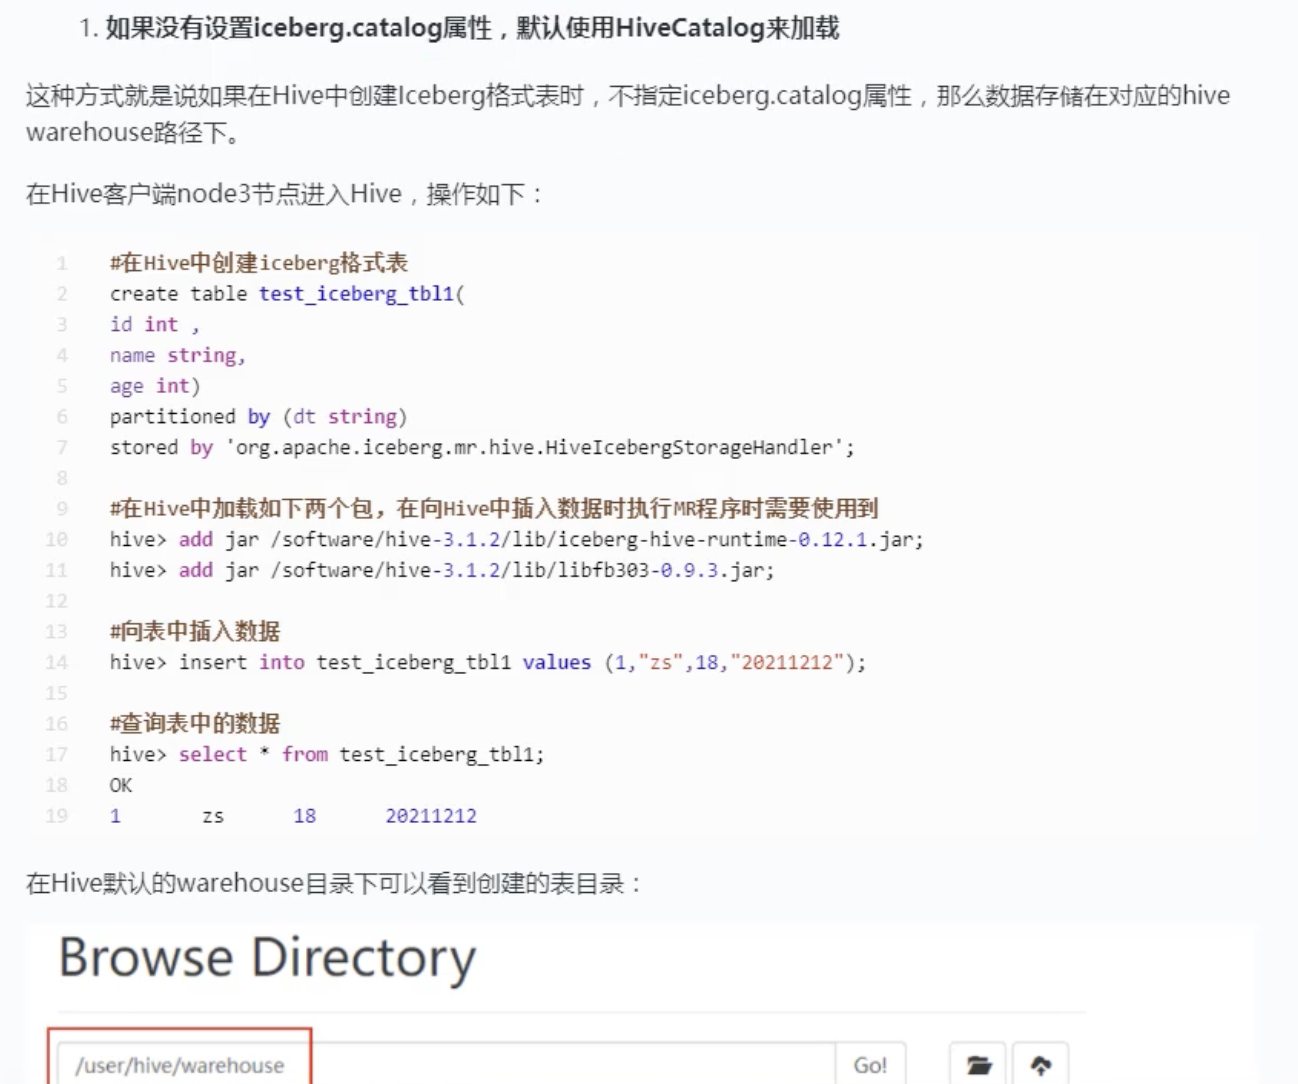
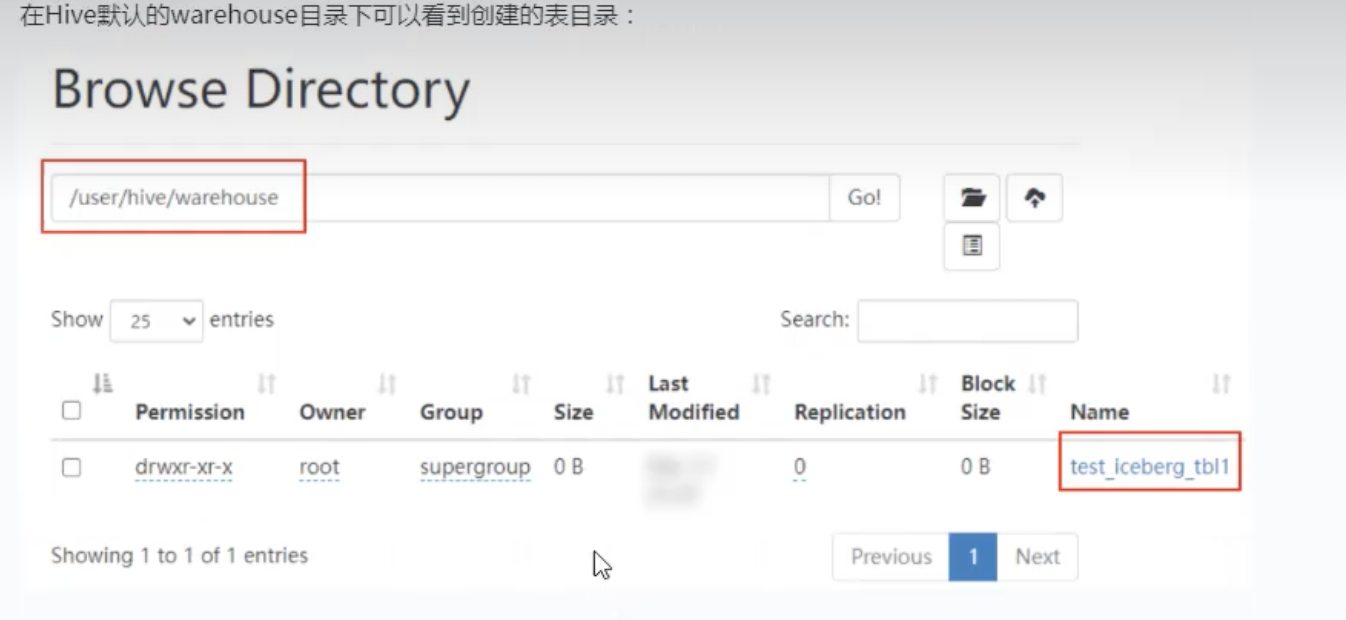
3.6.1 不设置iceberg.catalog属性
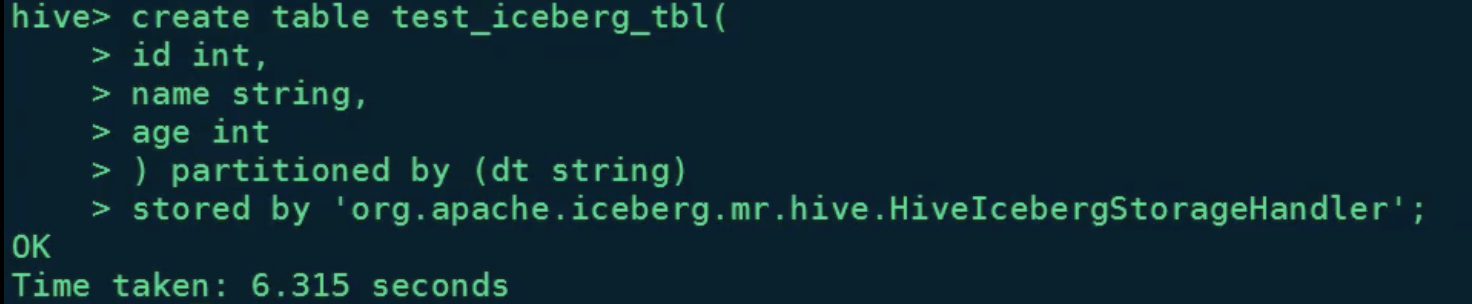
3.6.2 设置iceberg.catalog对应的catalog名字
3.6.2.1 设置成hive
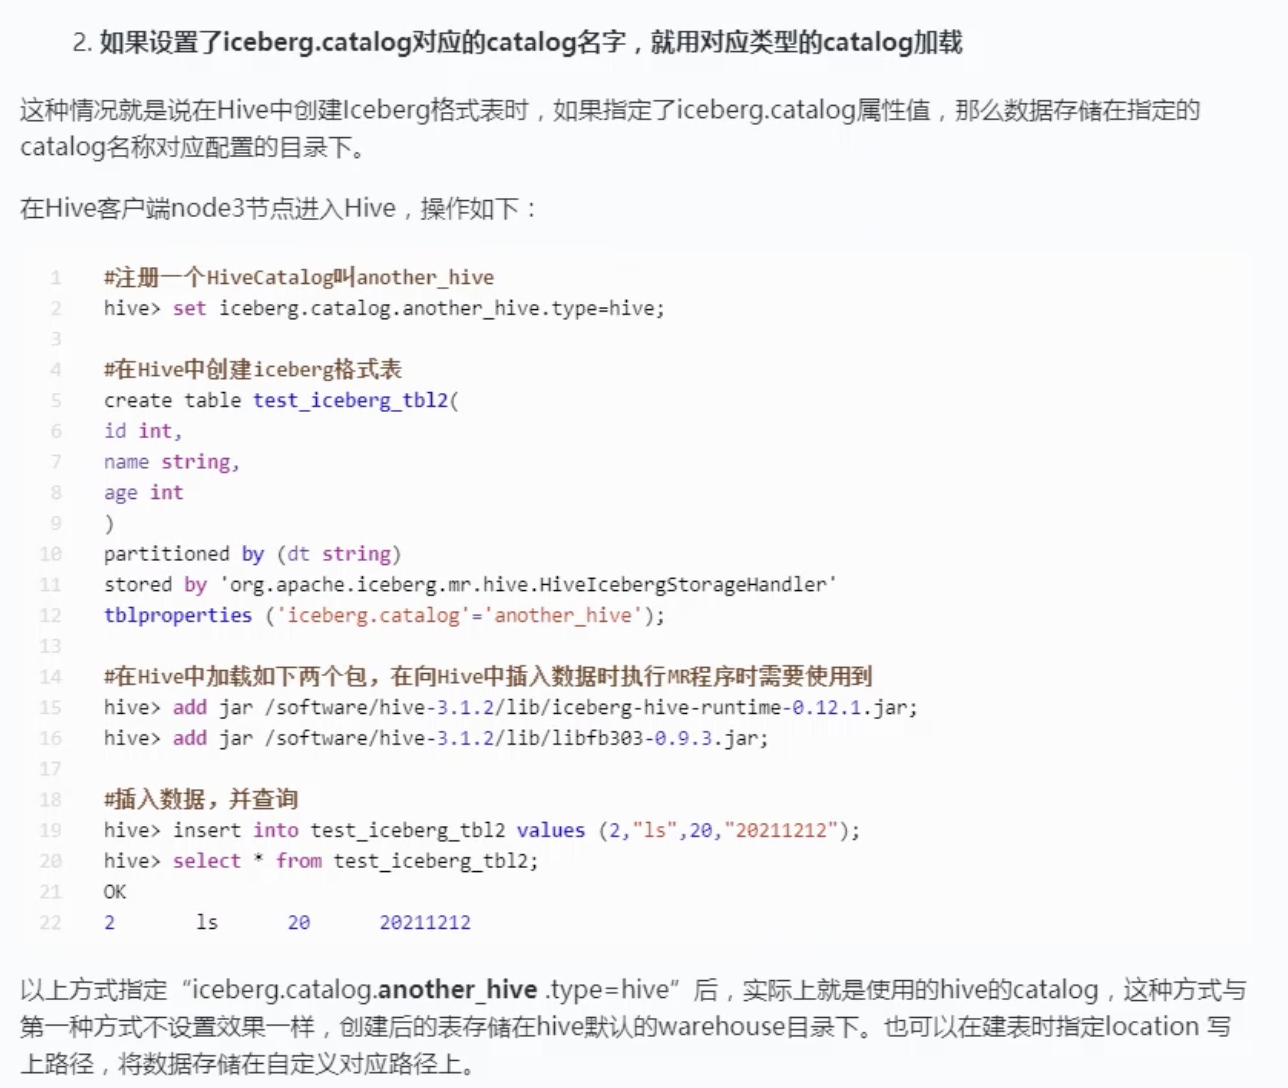
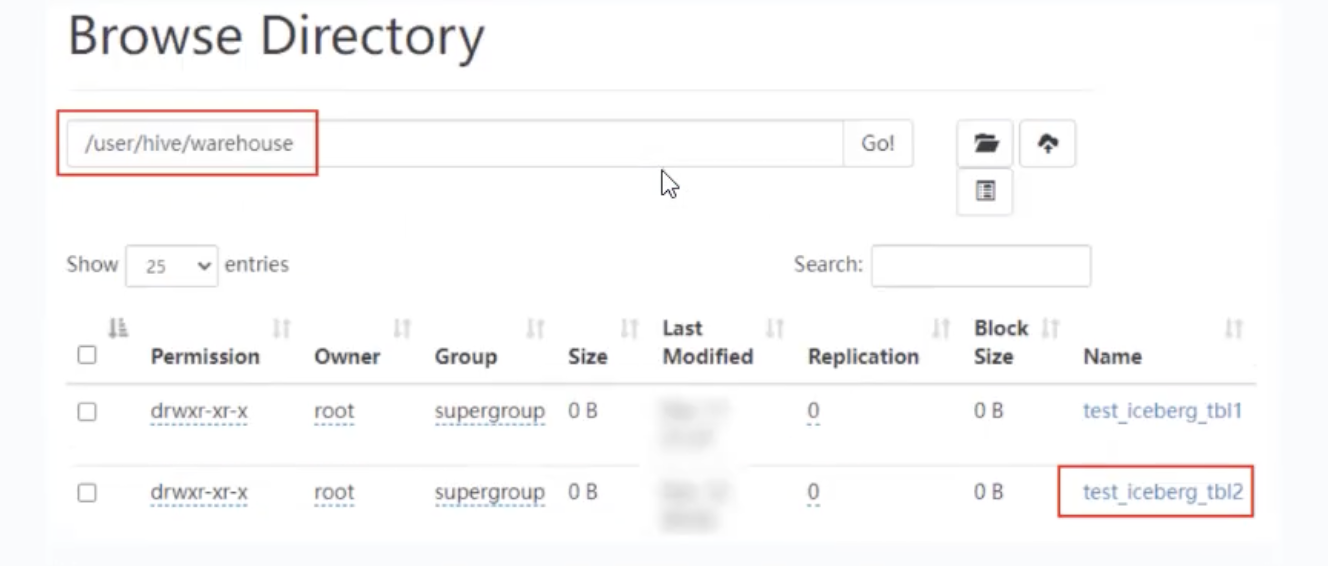
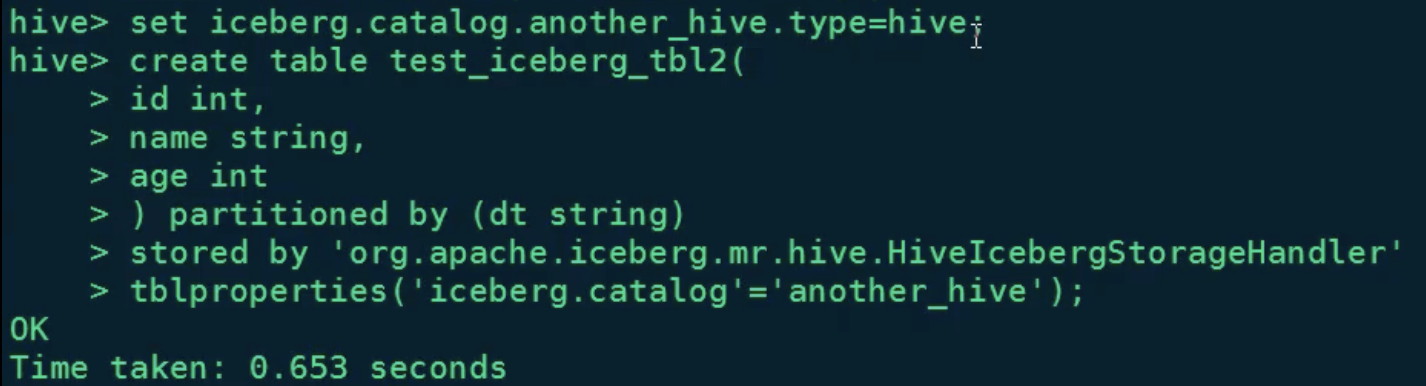
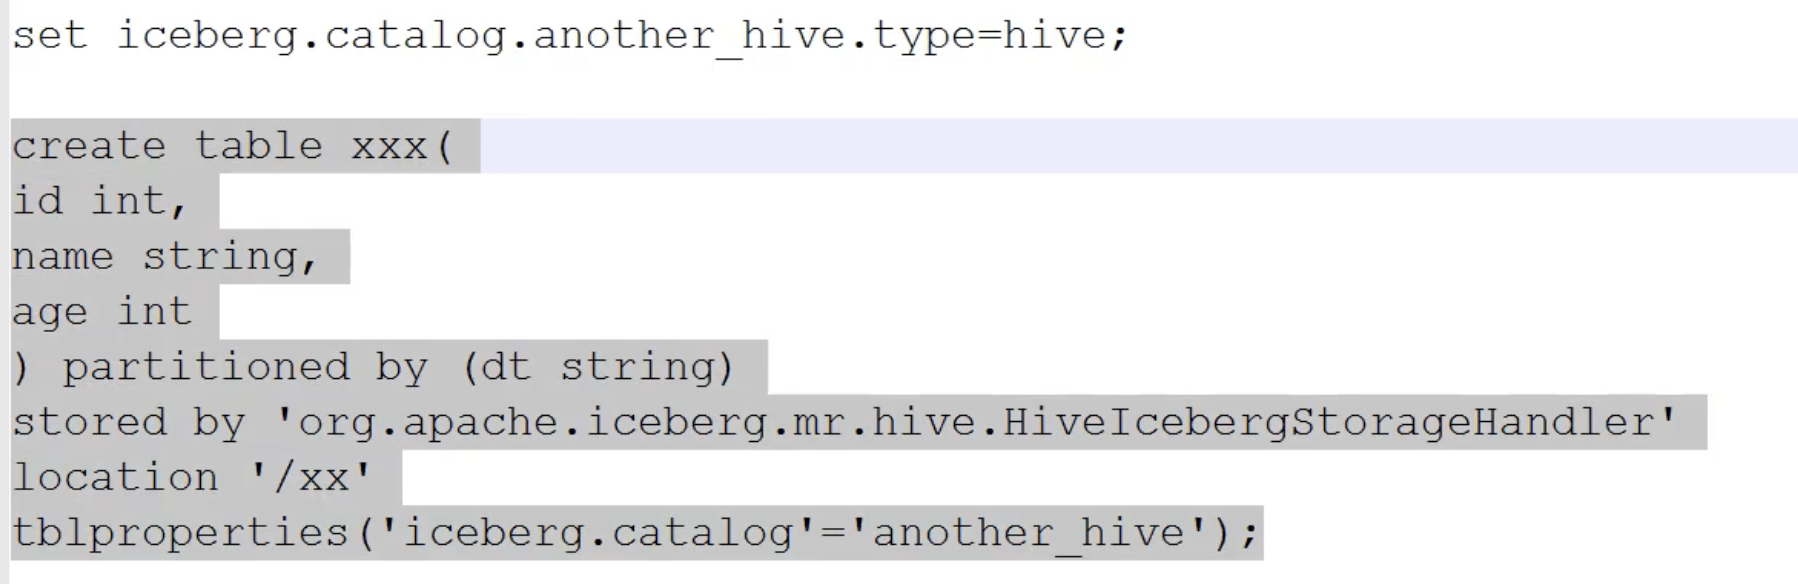
默认存储路径还是hive的warehouse,跟不设置的时候存储位置一样,如果想把数据存储到其他位置,可以使用location关键字指定
3.6.2.2 设置成hadoop
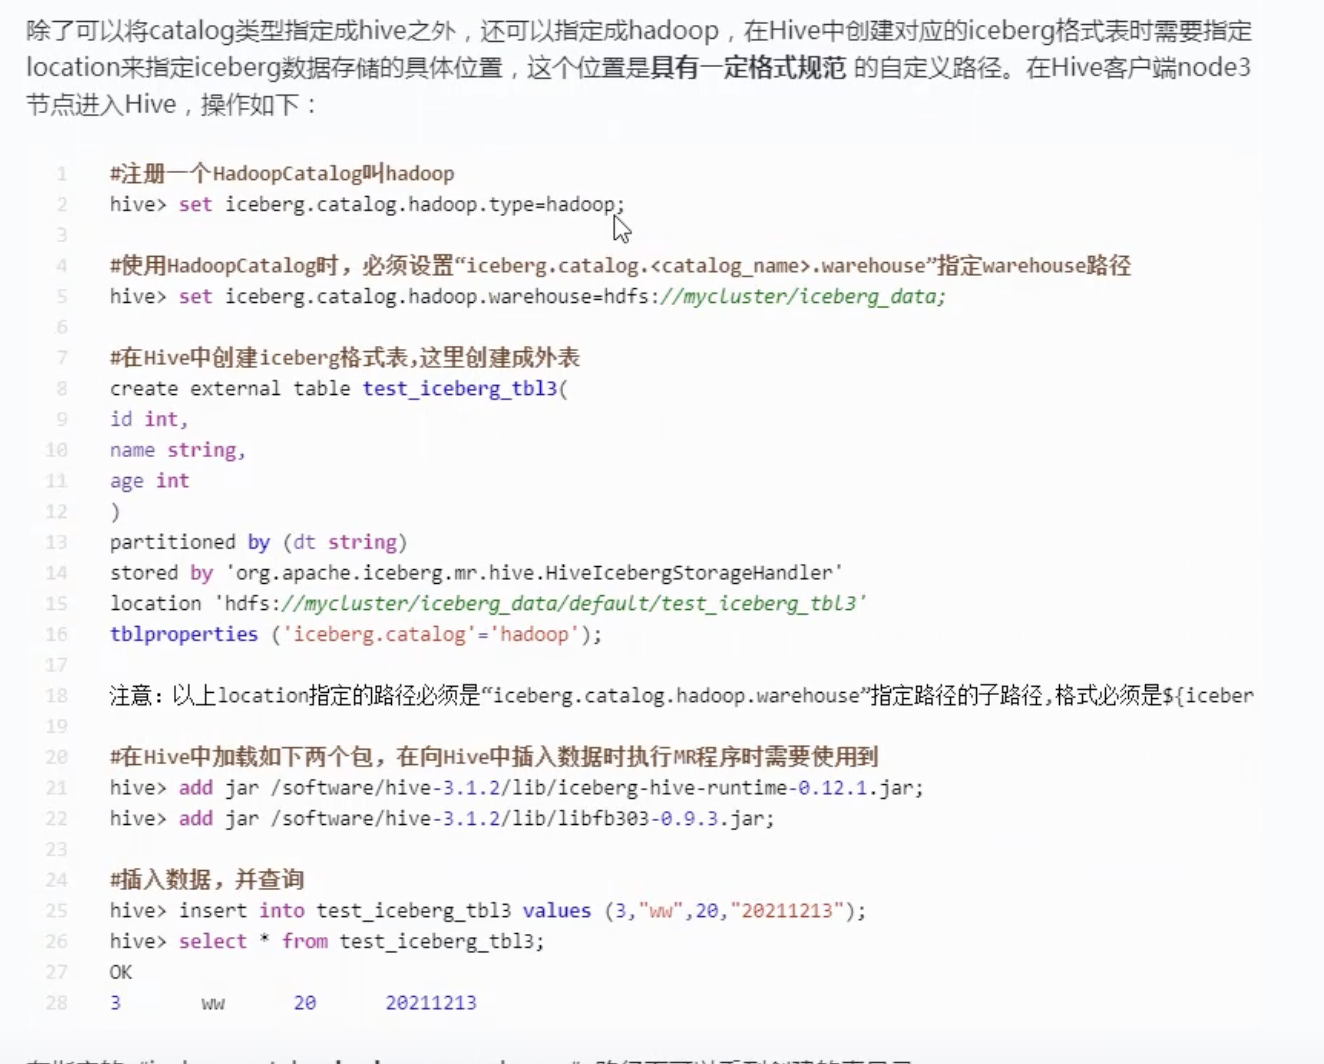

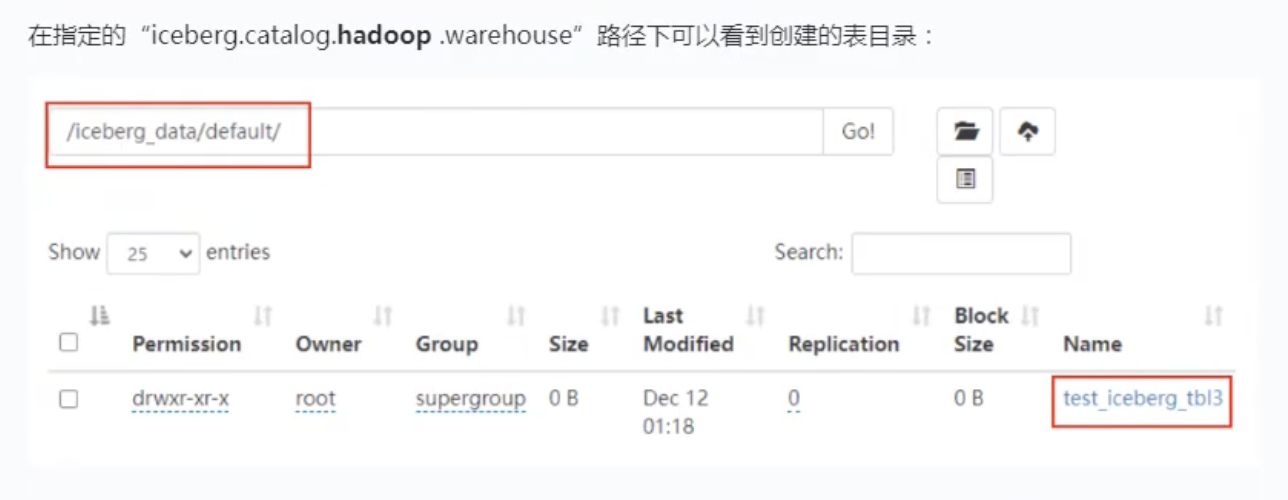
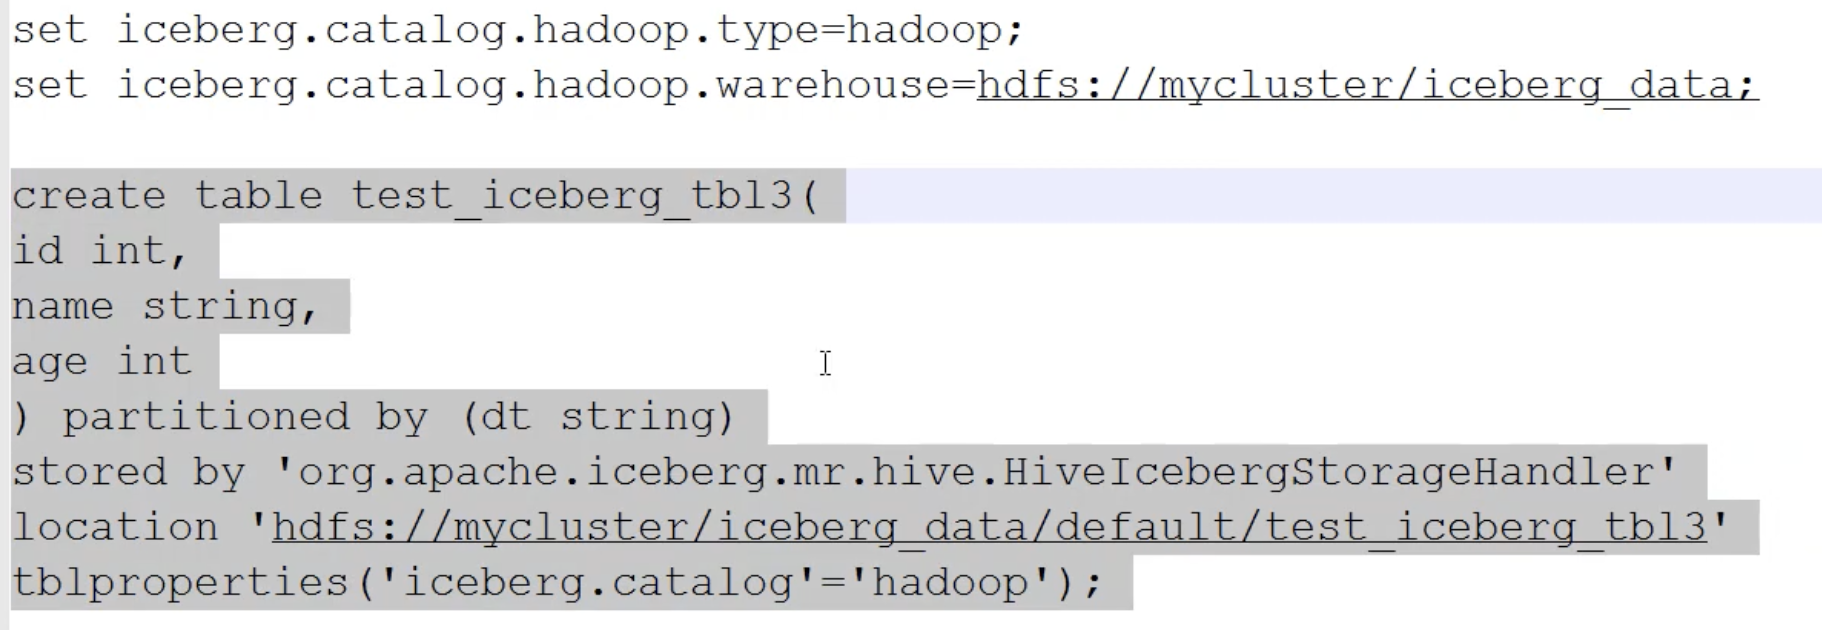
注意:hadoop管理catalog建表,必须指定location,而且对location的格式有严格管理,必须是前面指定的hadoop.warehouse/数据库名(如果没有,可以使用default)/表名
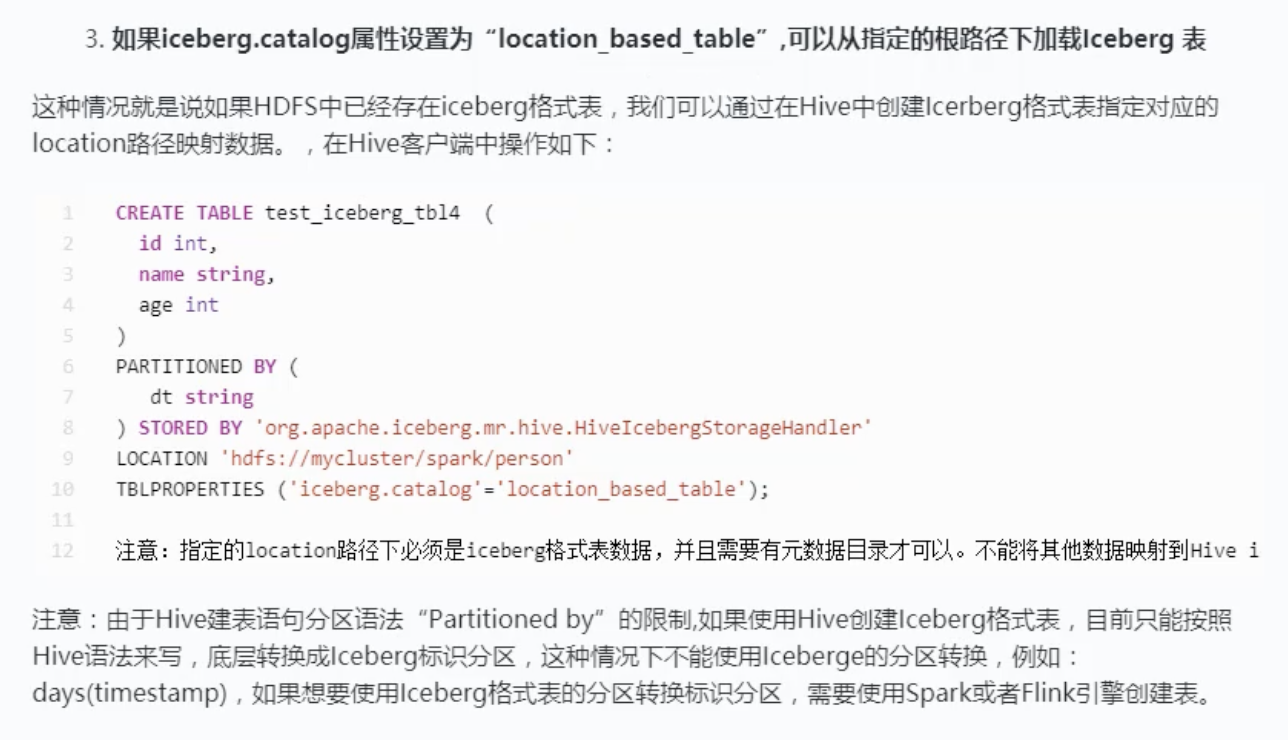
3.6.3 iceberg.catalog设置为location_based_table
加载已存在的表
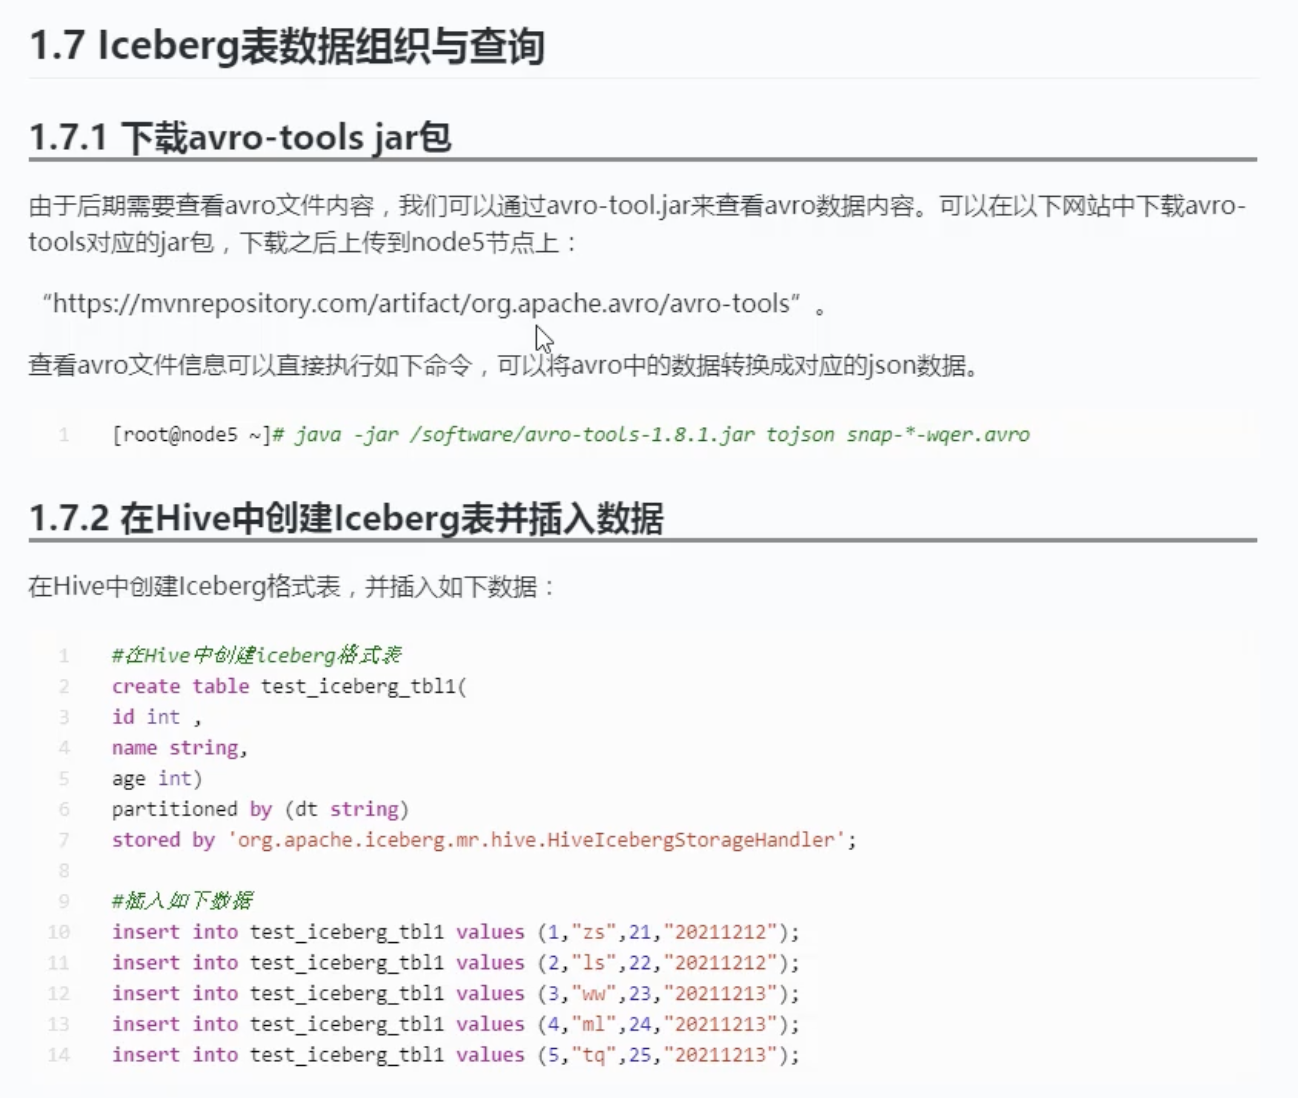
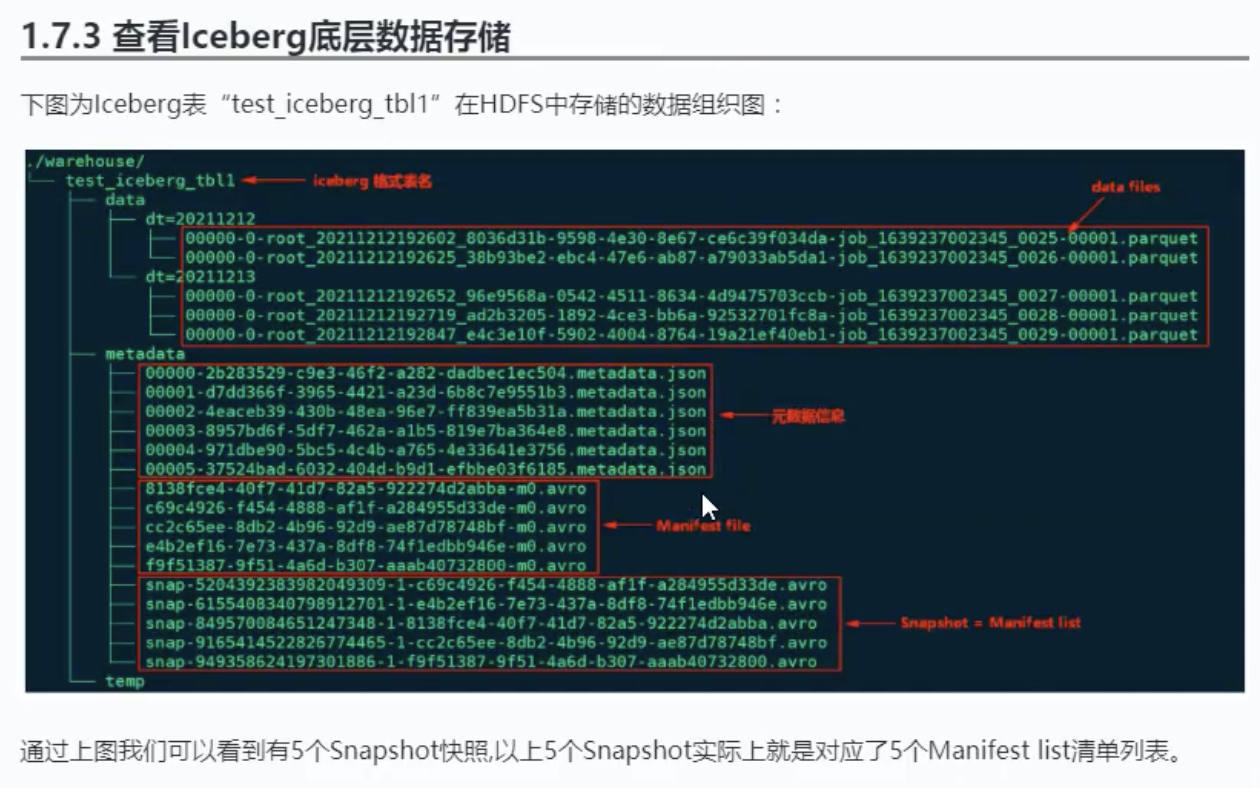
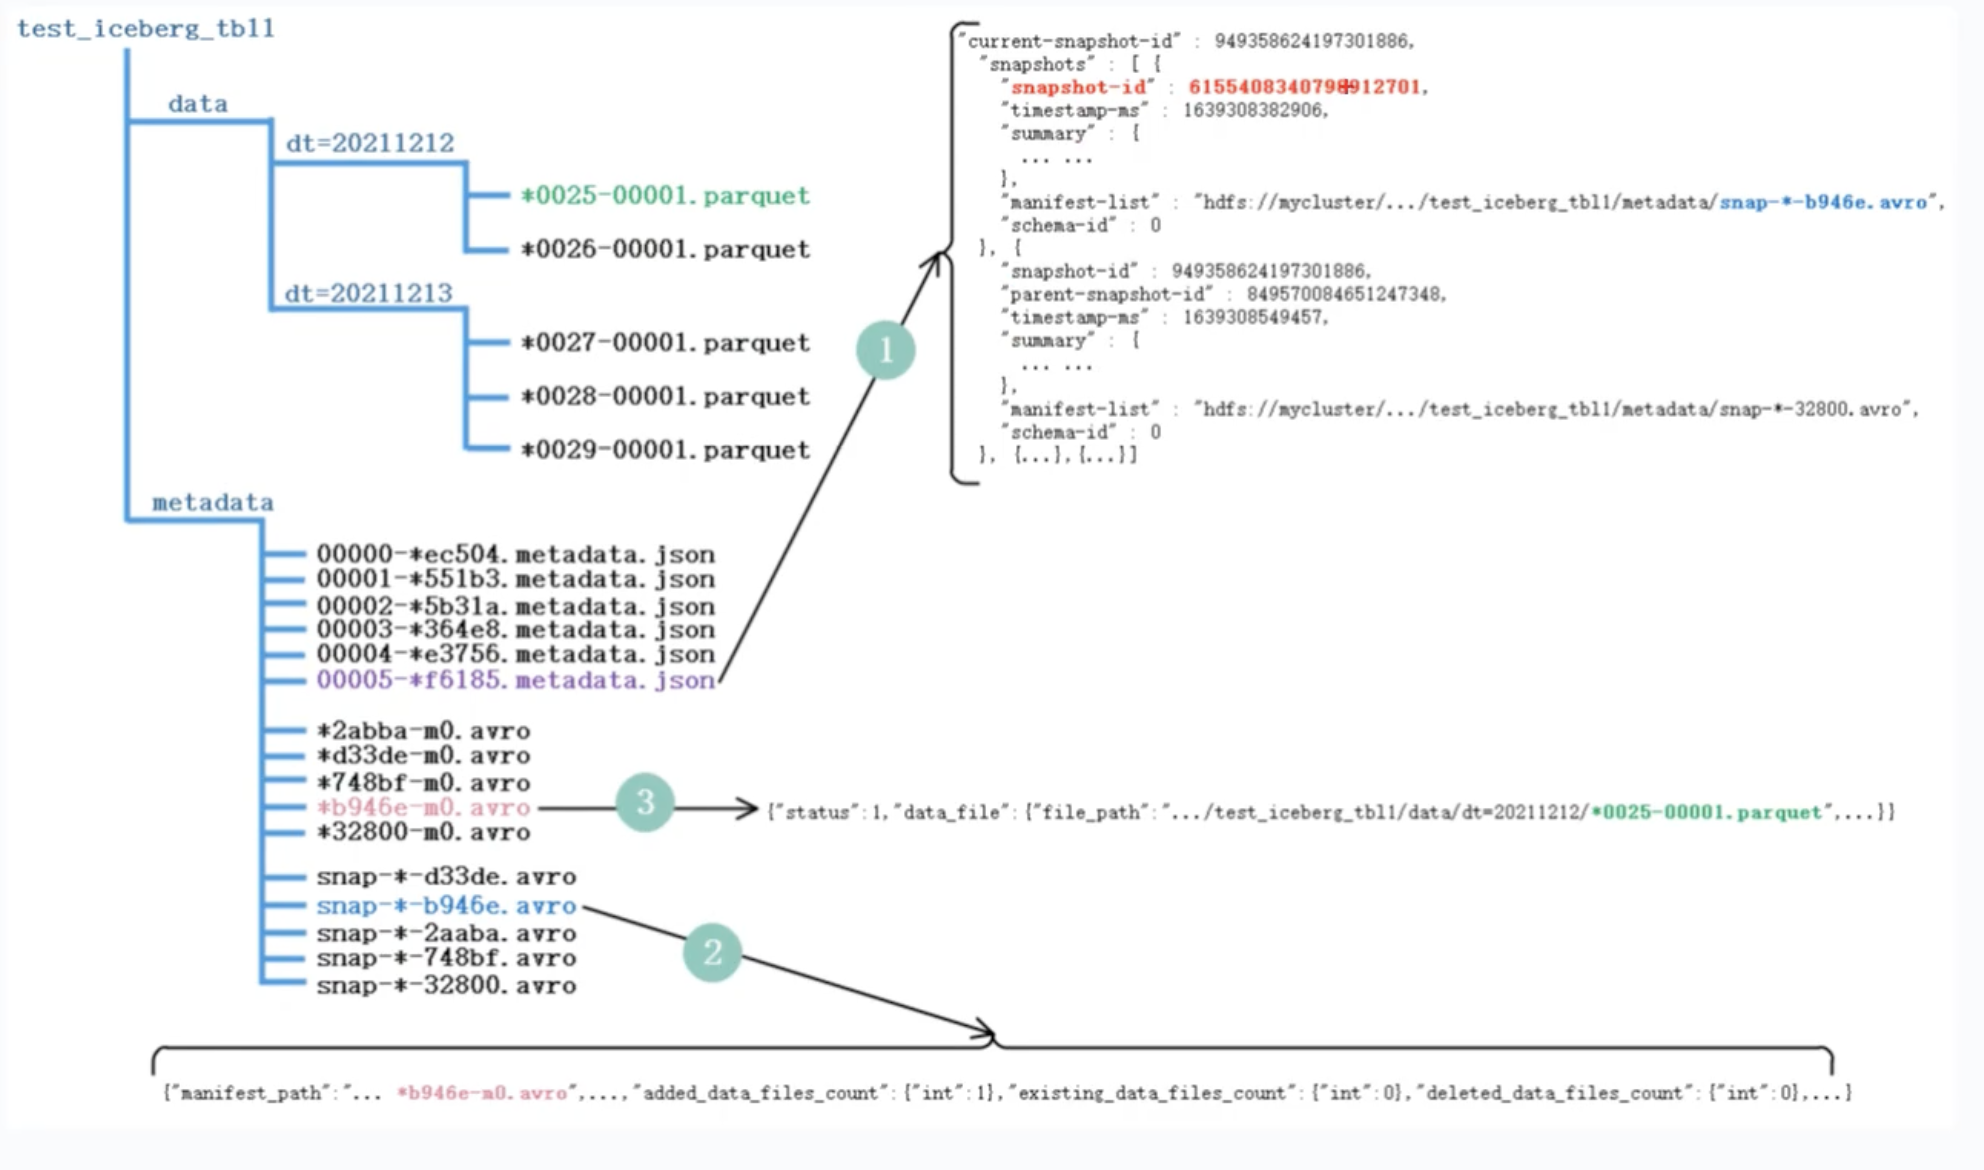
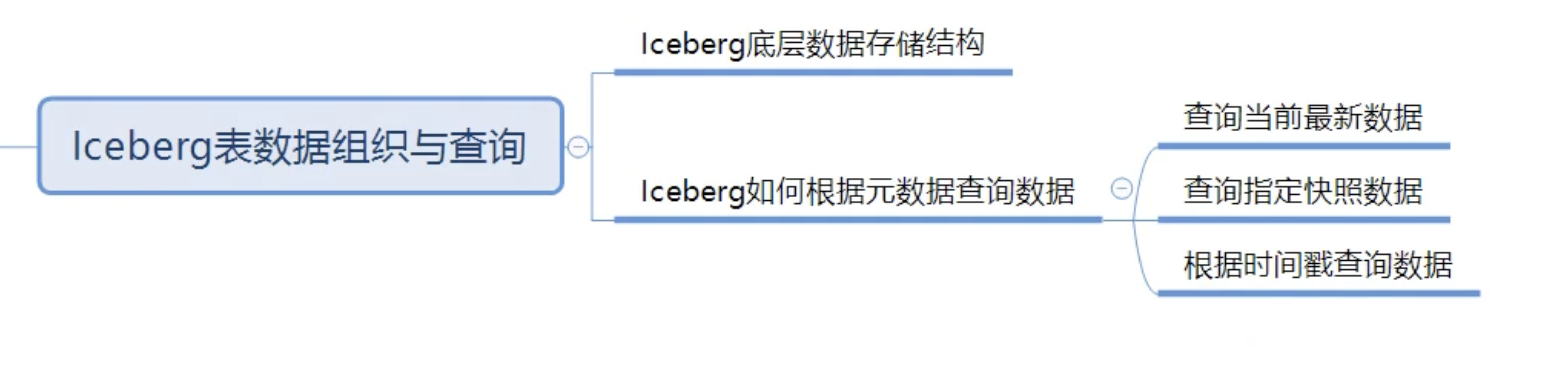
3.7 表数据组织和查询
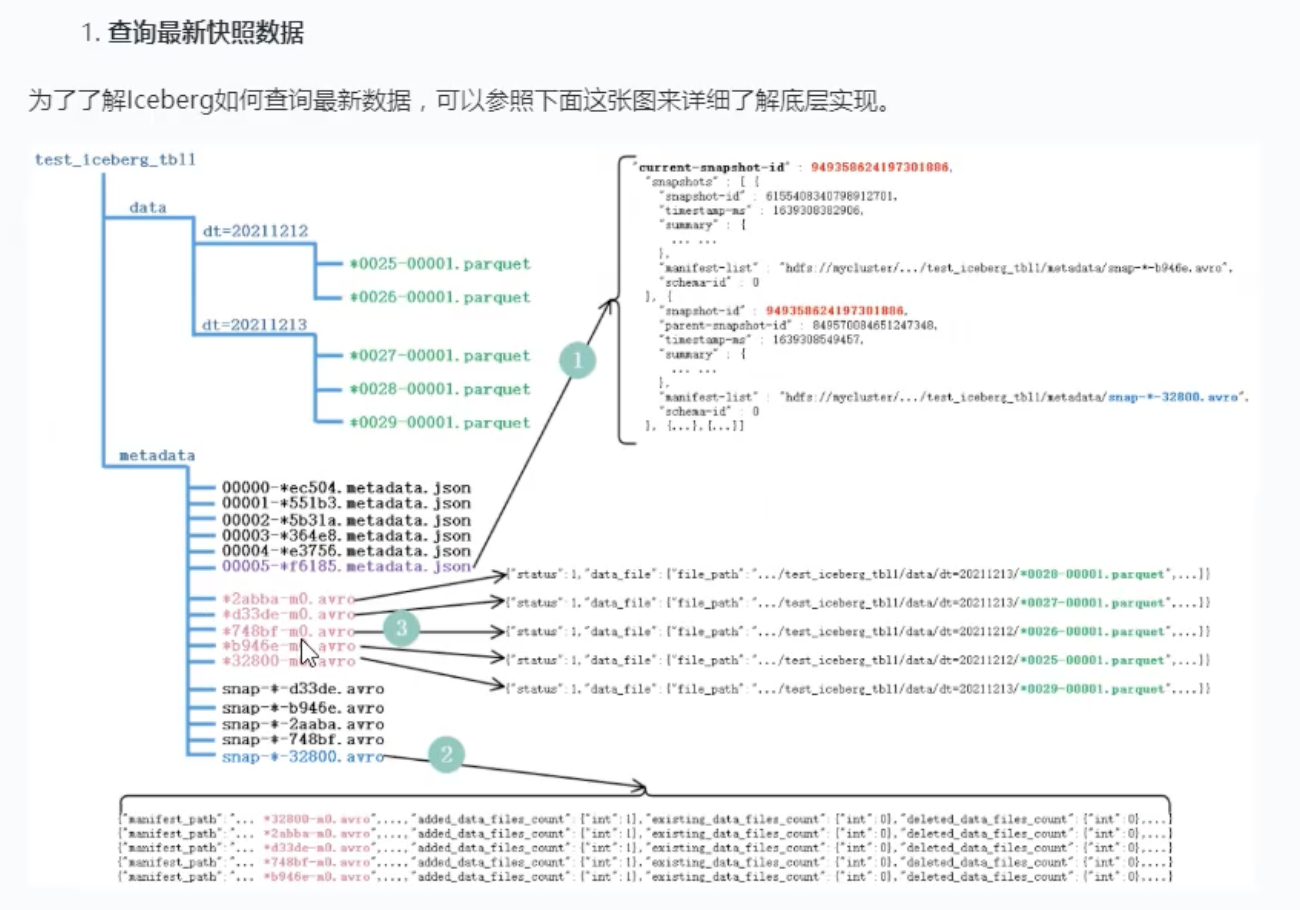
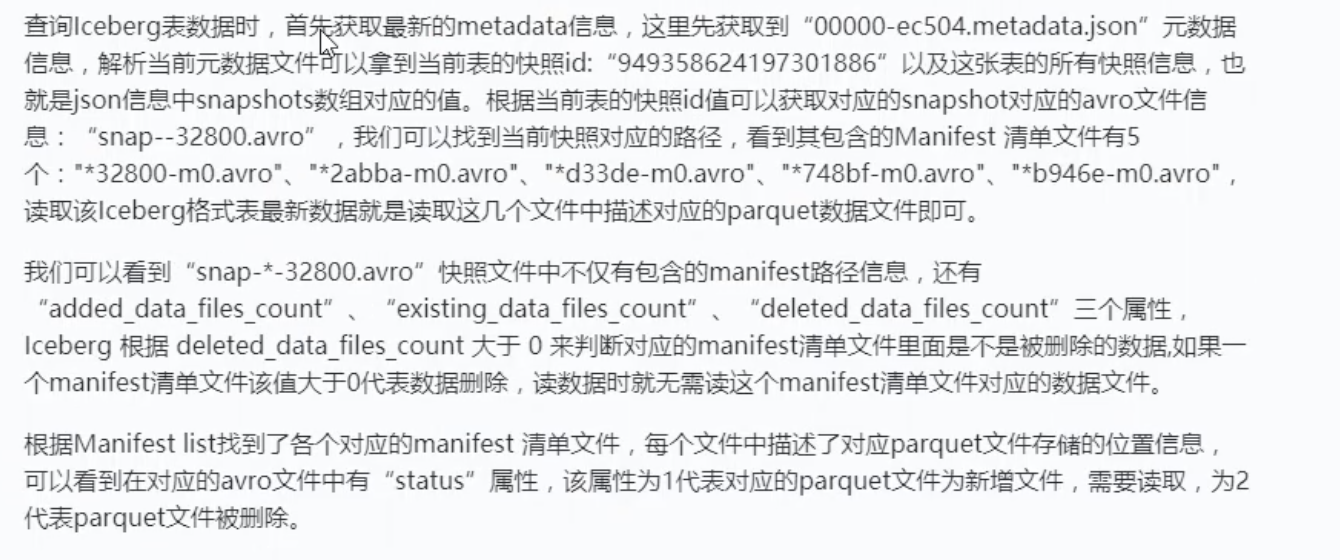
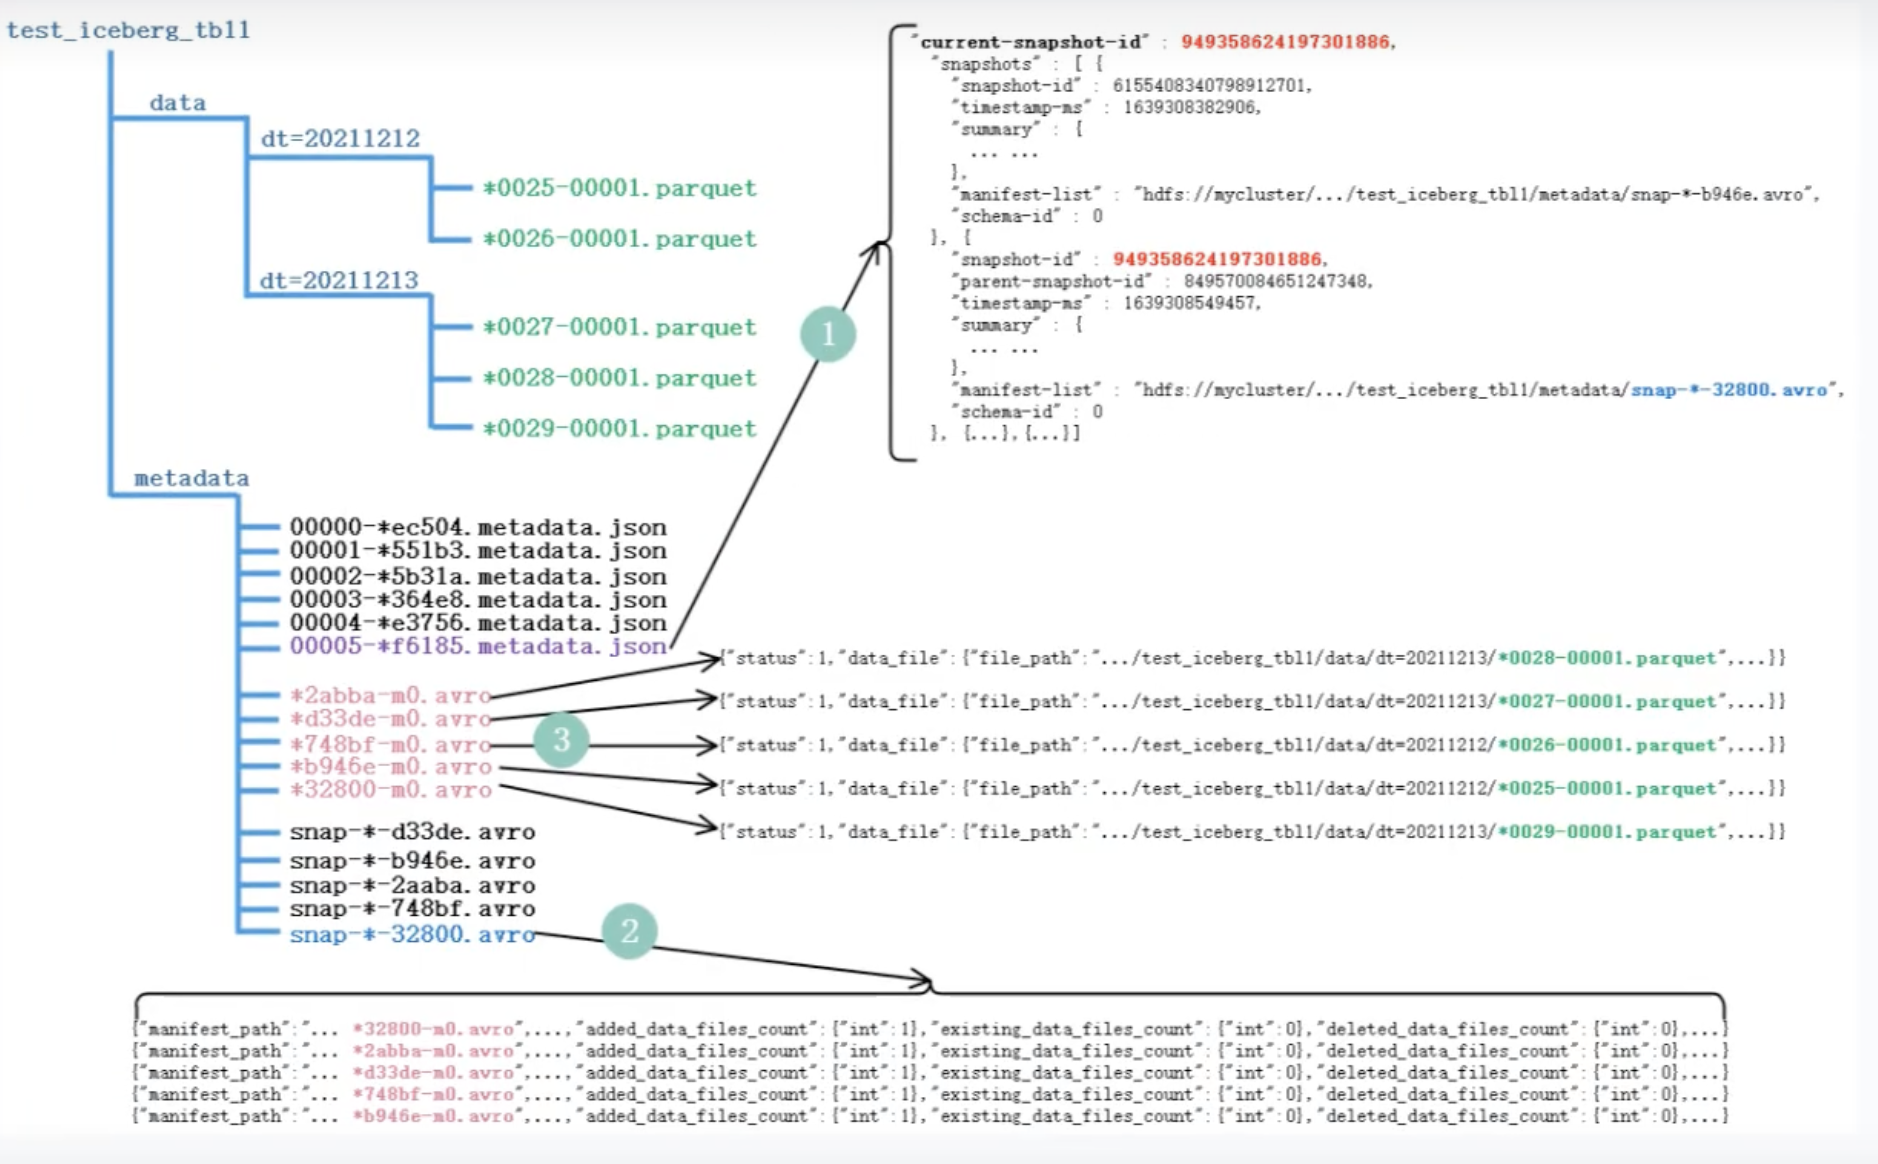
3.7.1 查询最新快照数据
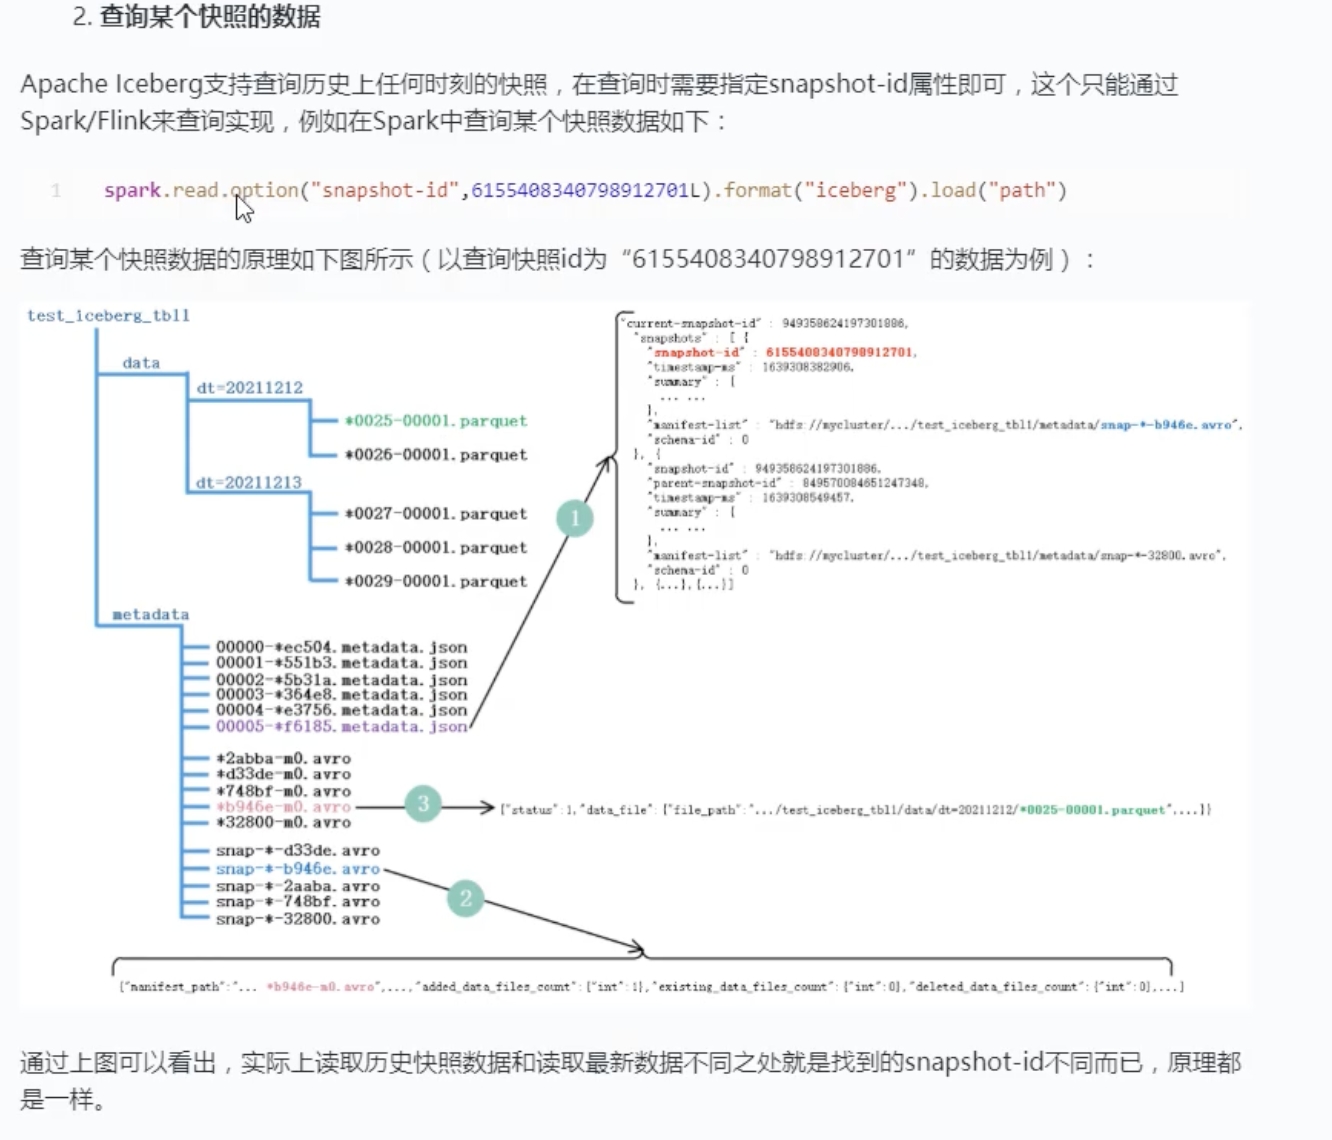
3.7.2.查询某个快照的数据
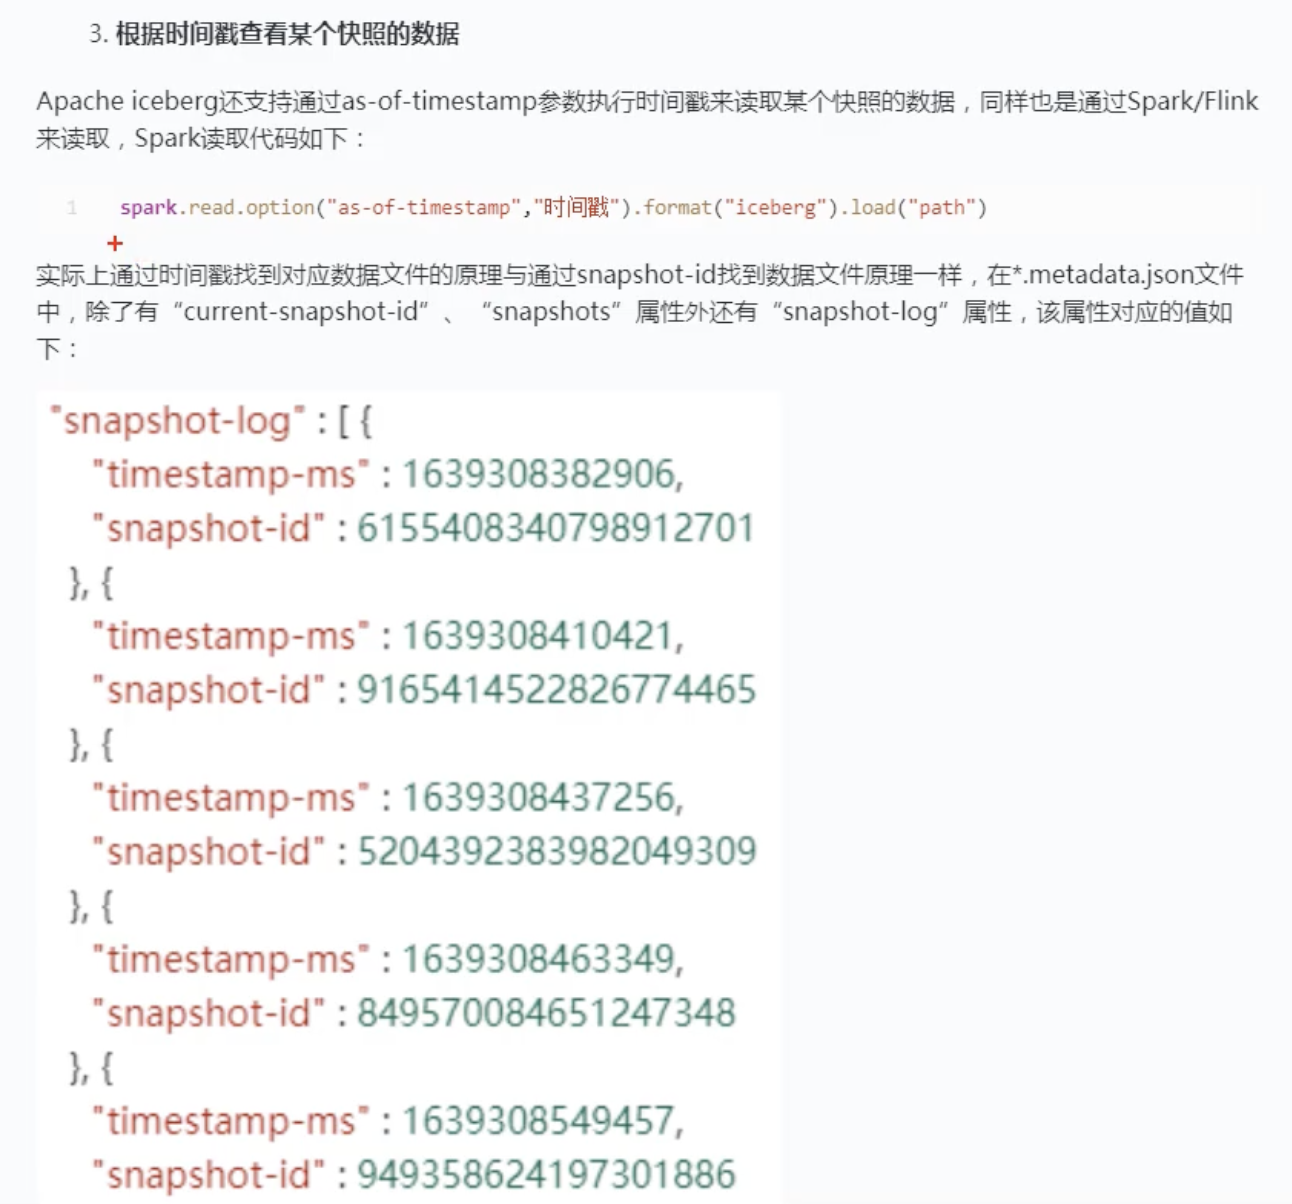
3.7.3 根据时间戳查询
三、spark与Iceberg整合操作
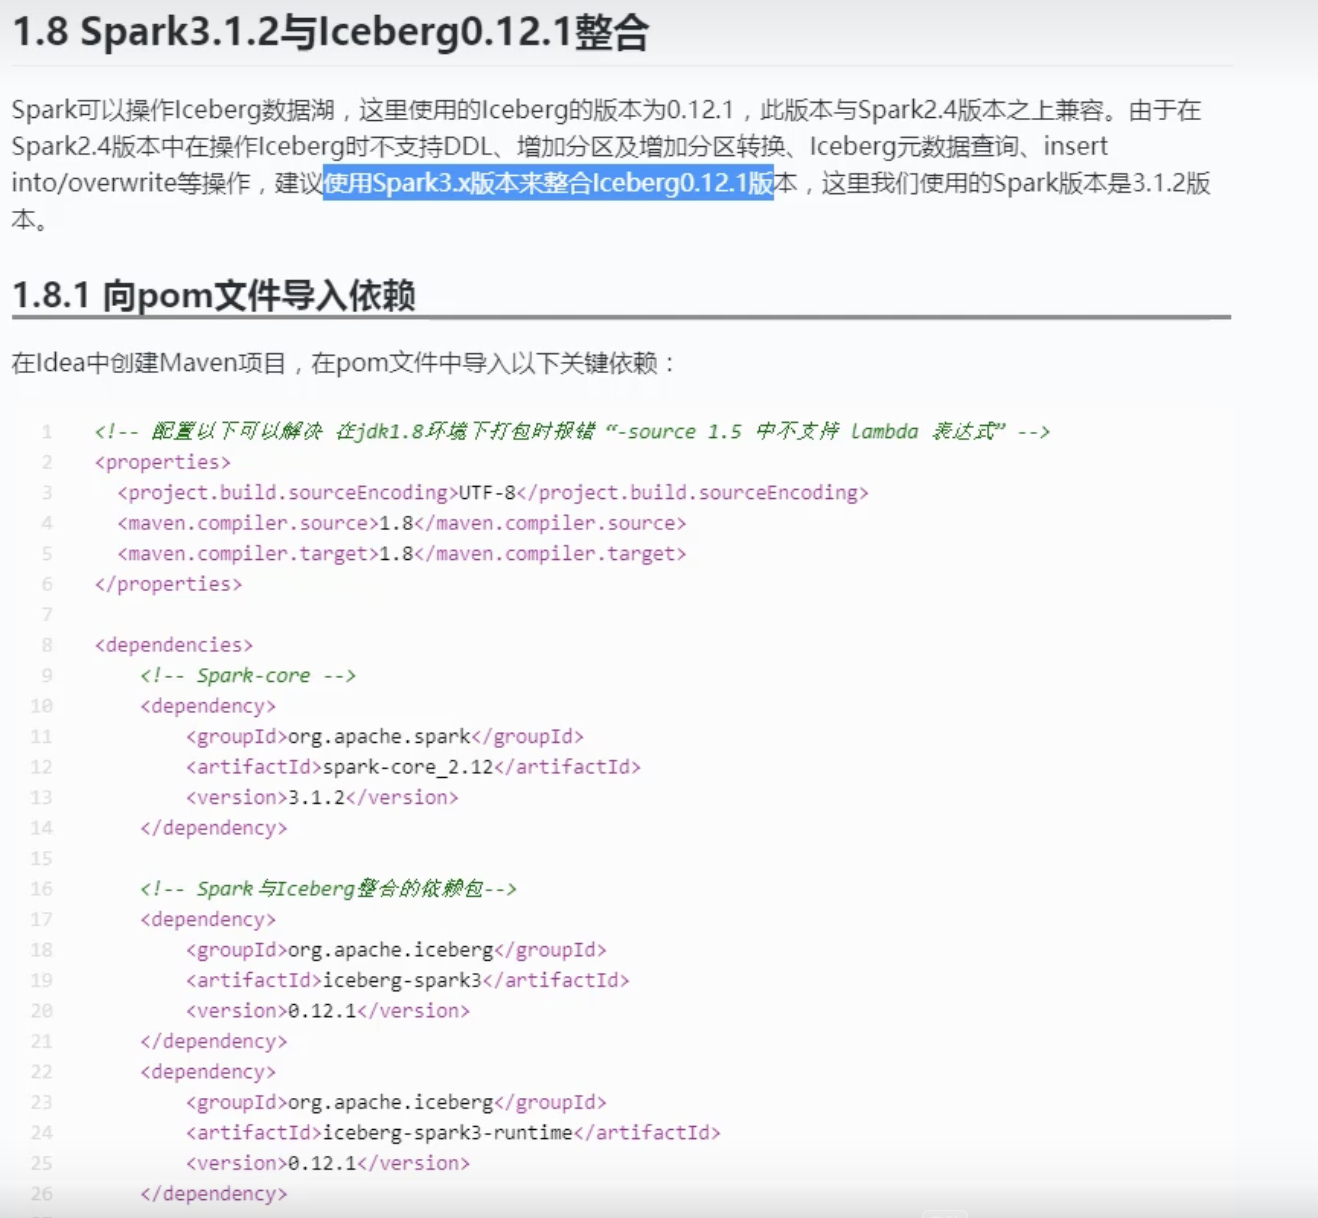
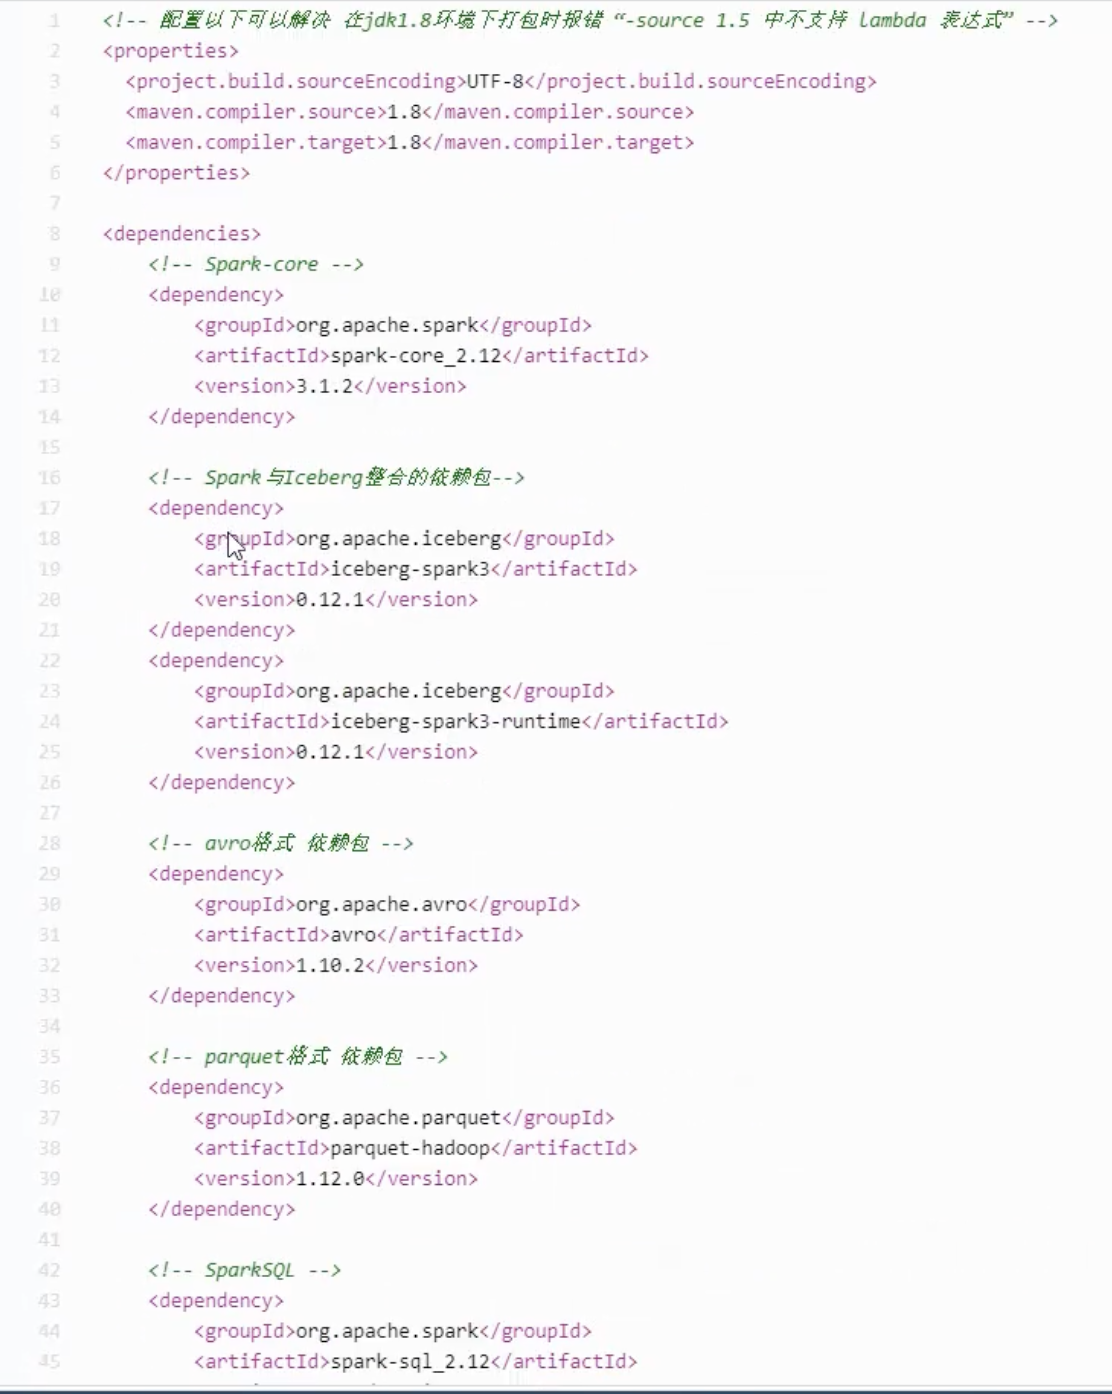
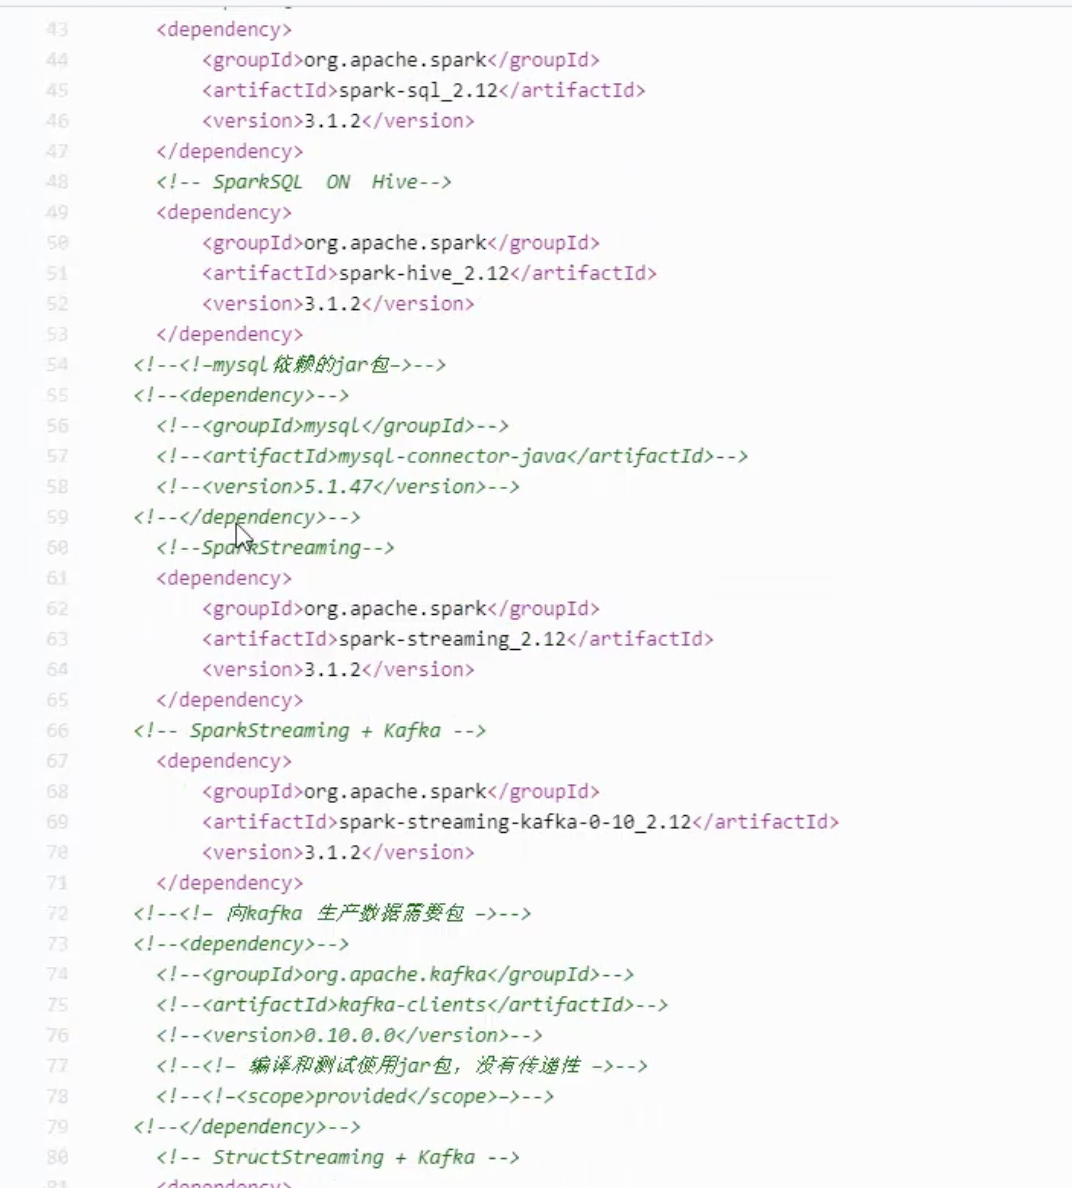
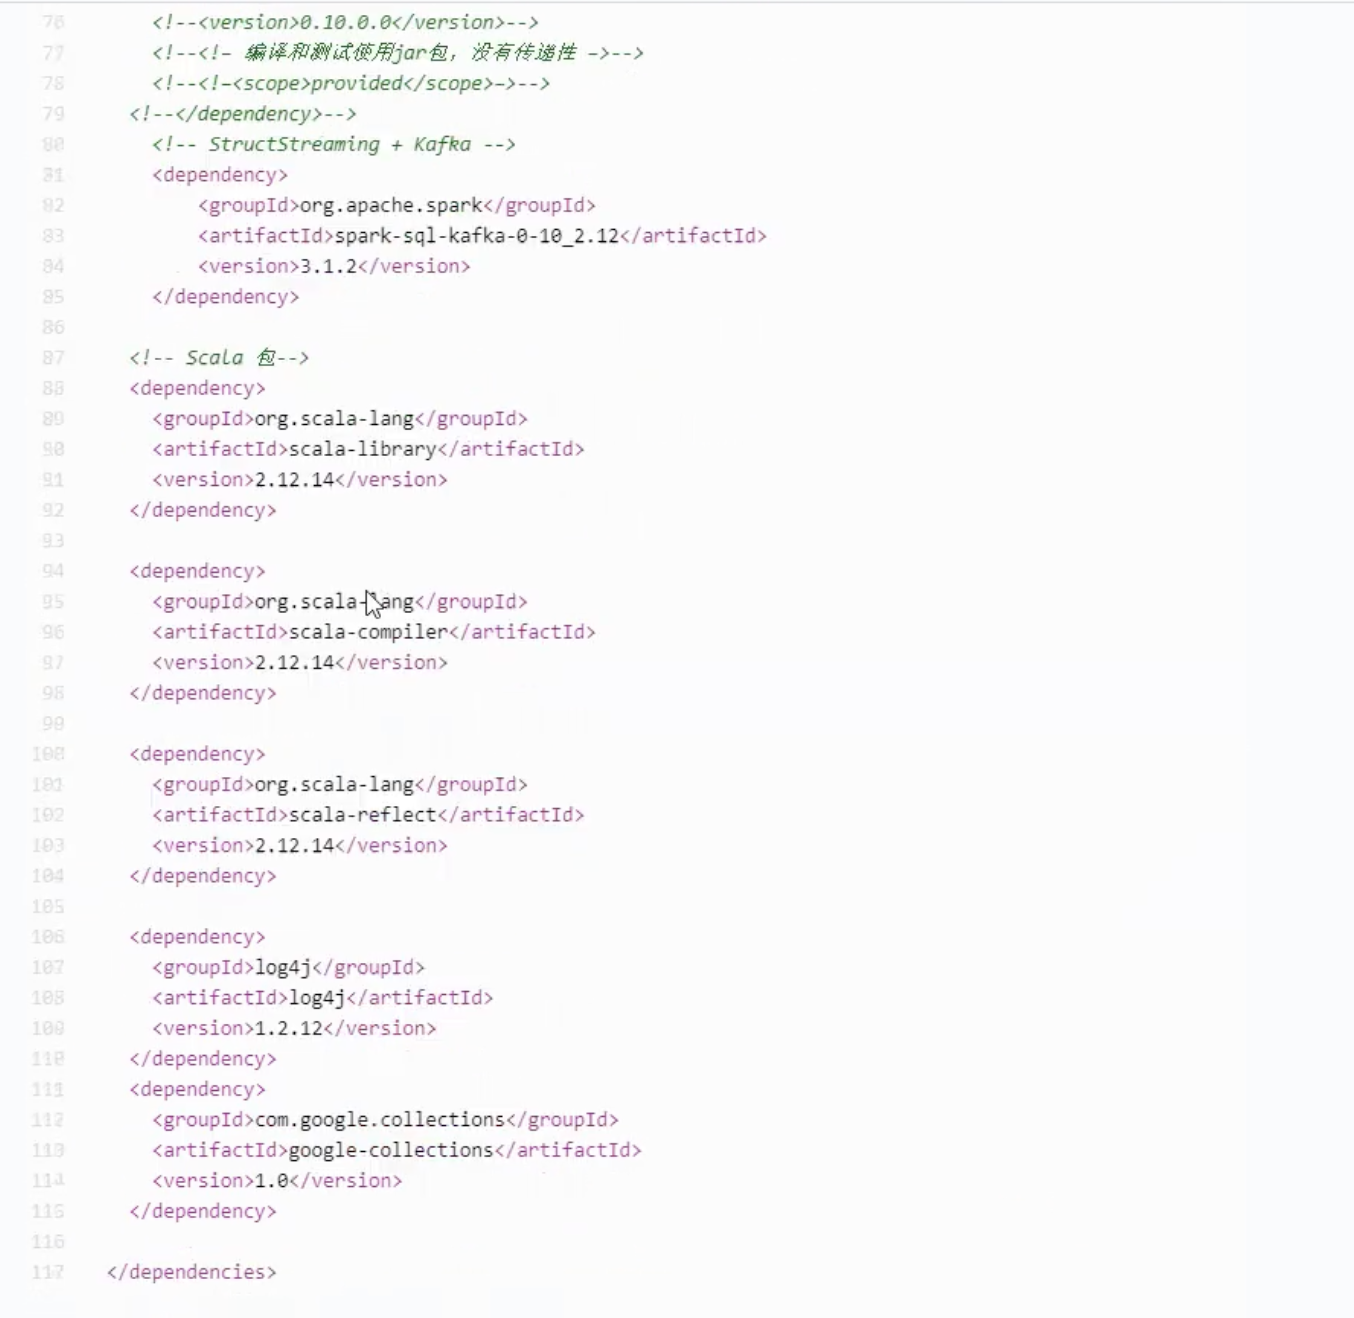
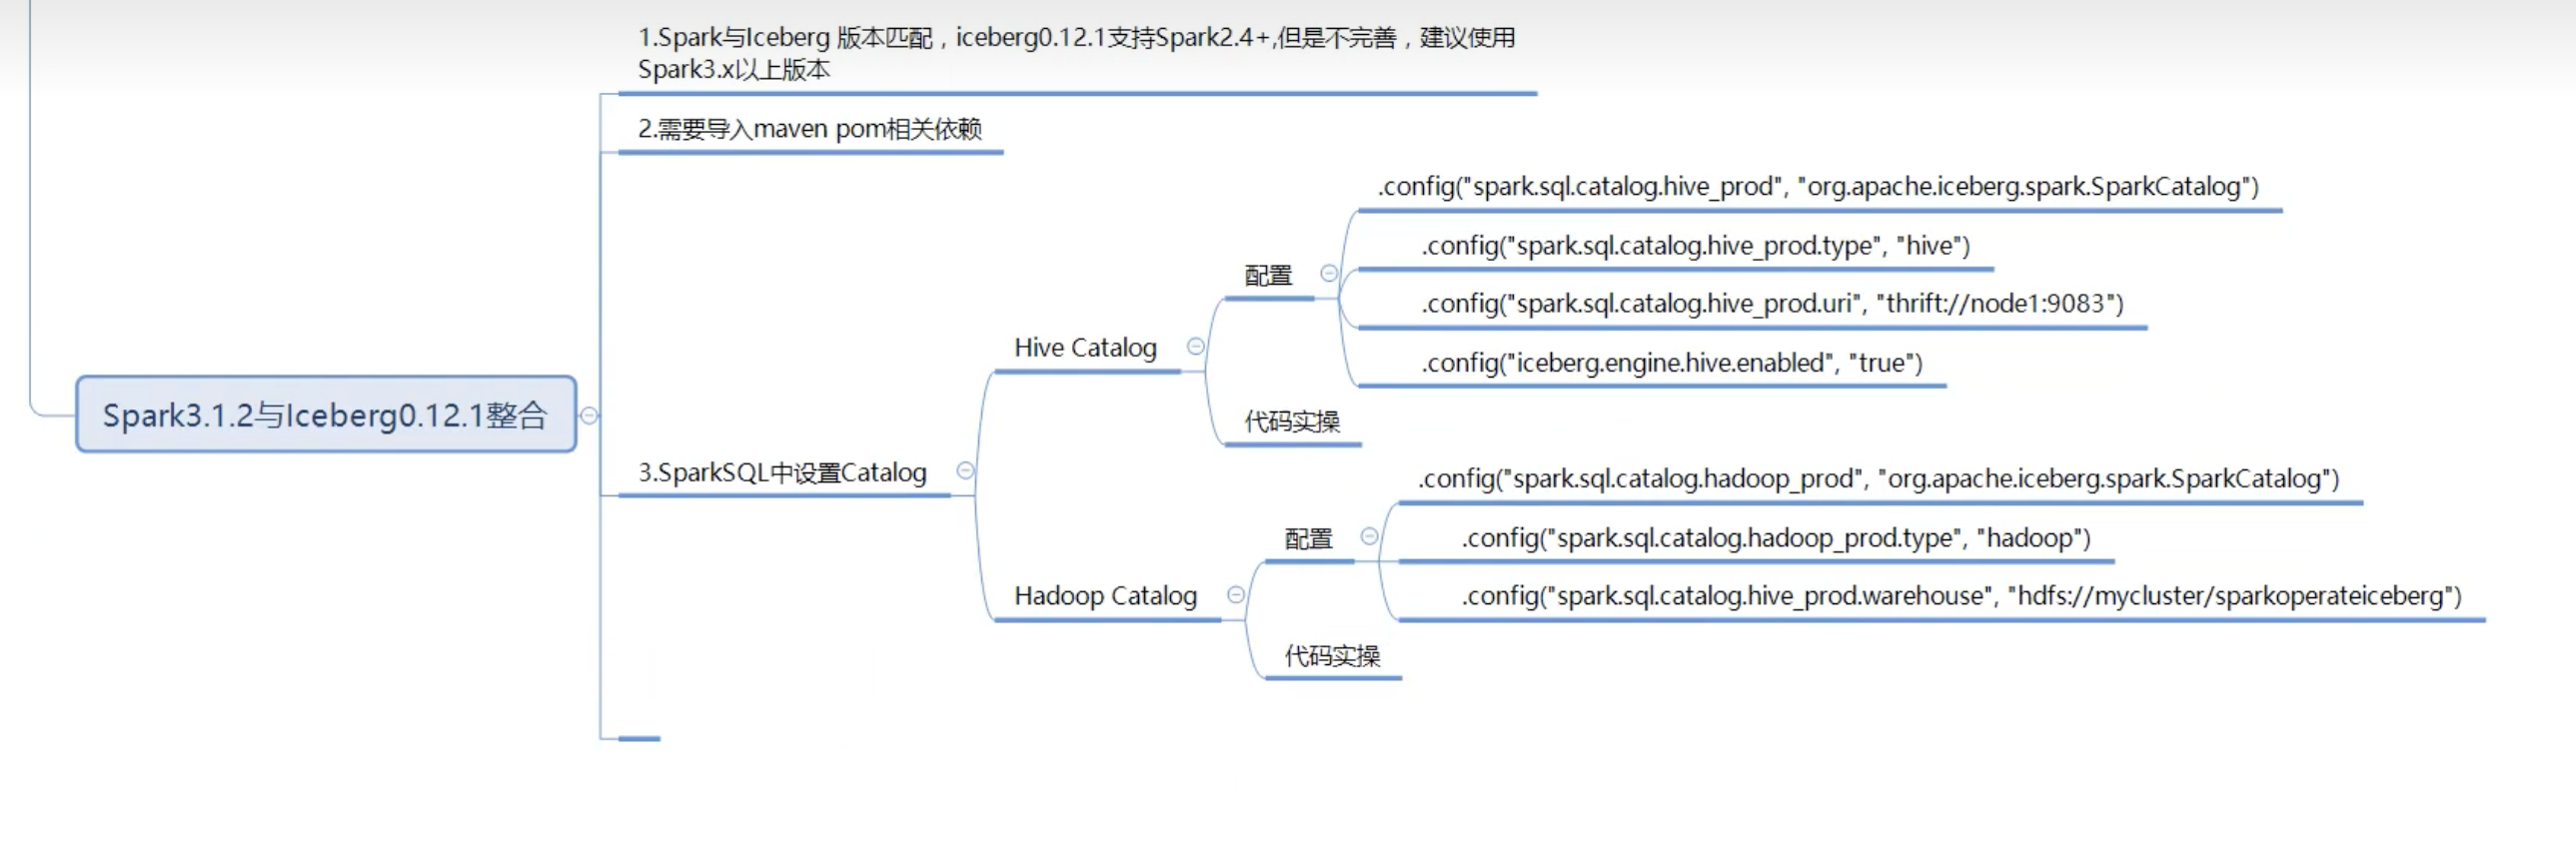
3.1 版本说明及依赖
3.2 SparkSQL设置catalog
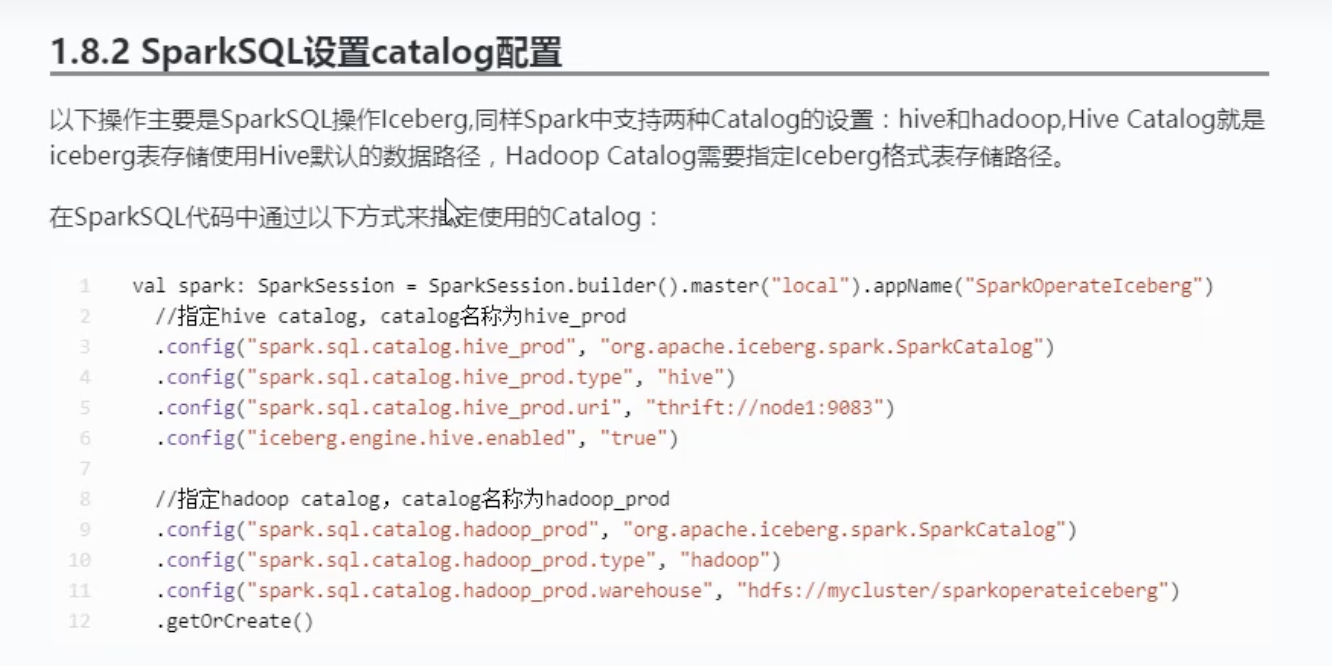
3.3 Spark 管理表
3.3.1 Spark使用Hive Catalog管理表
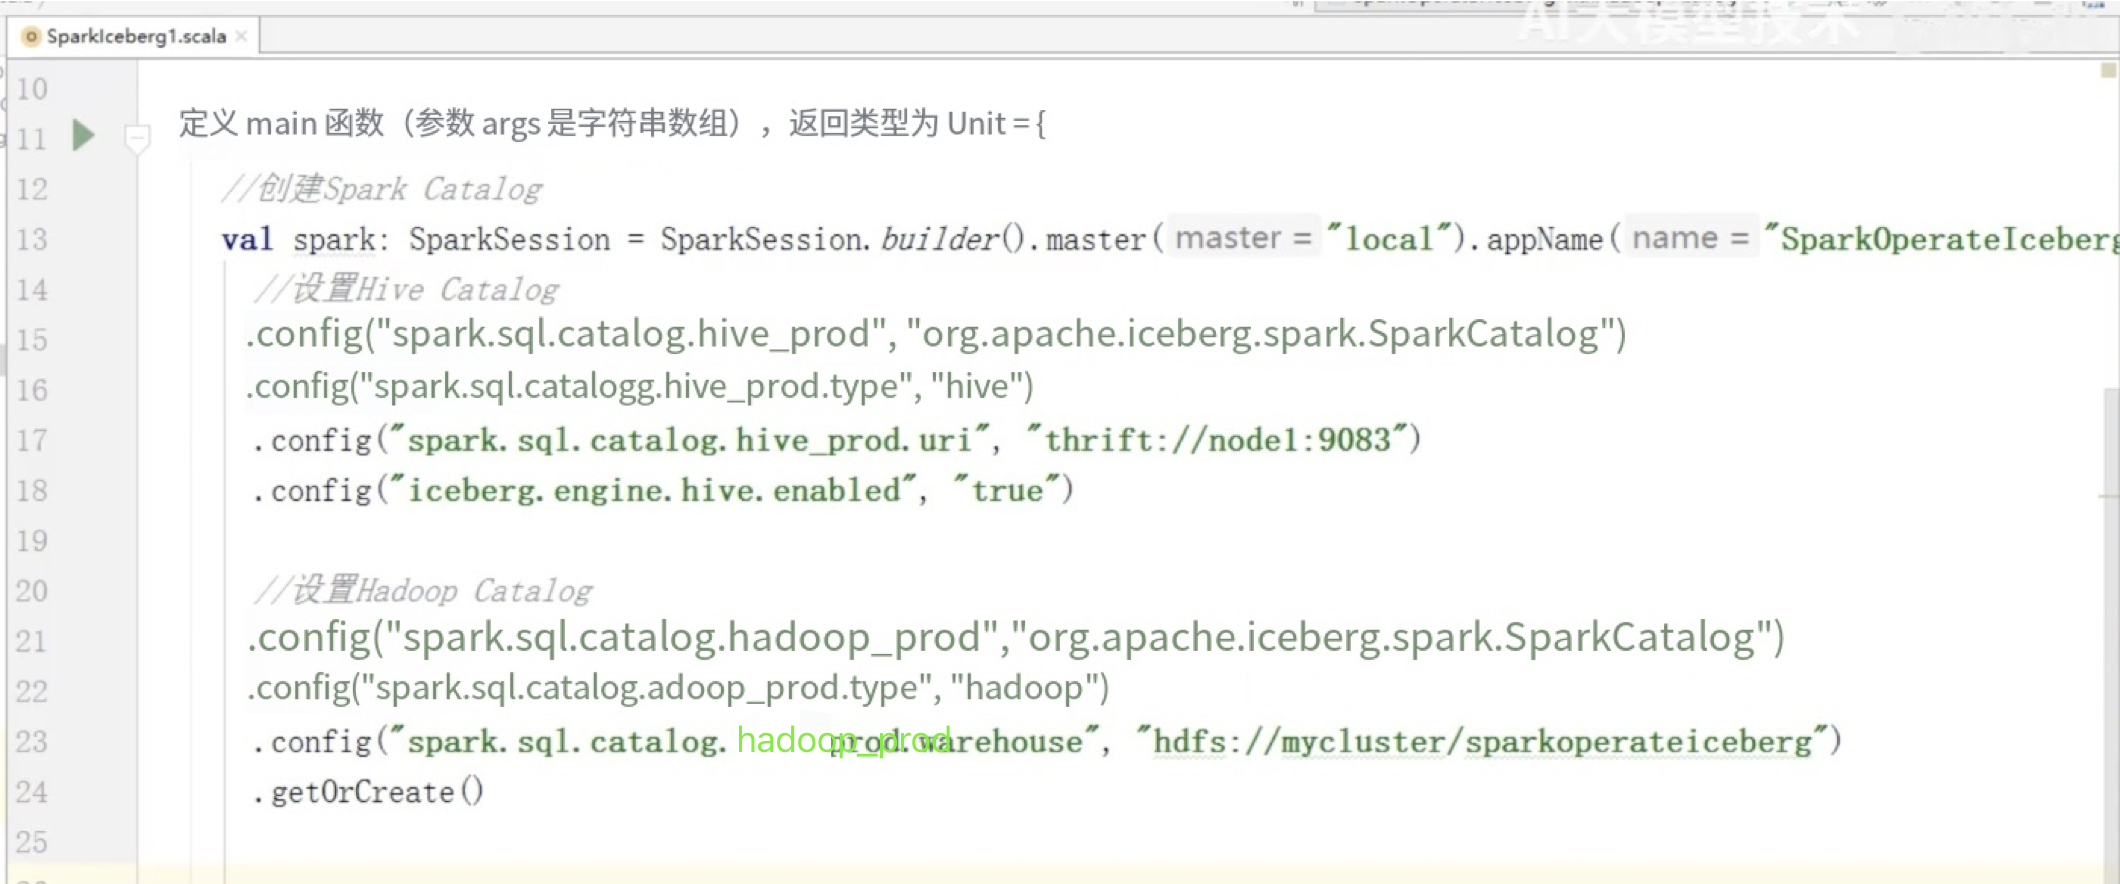
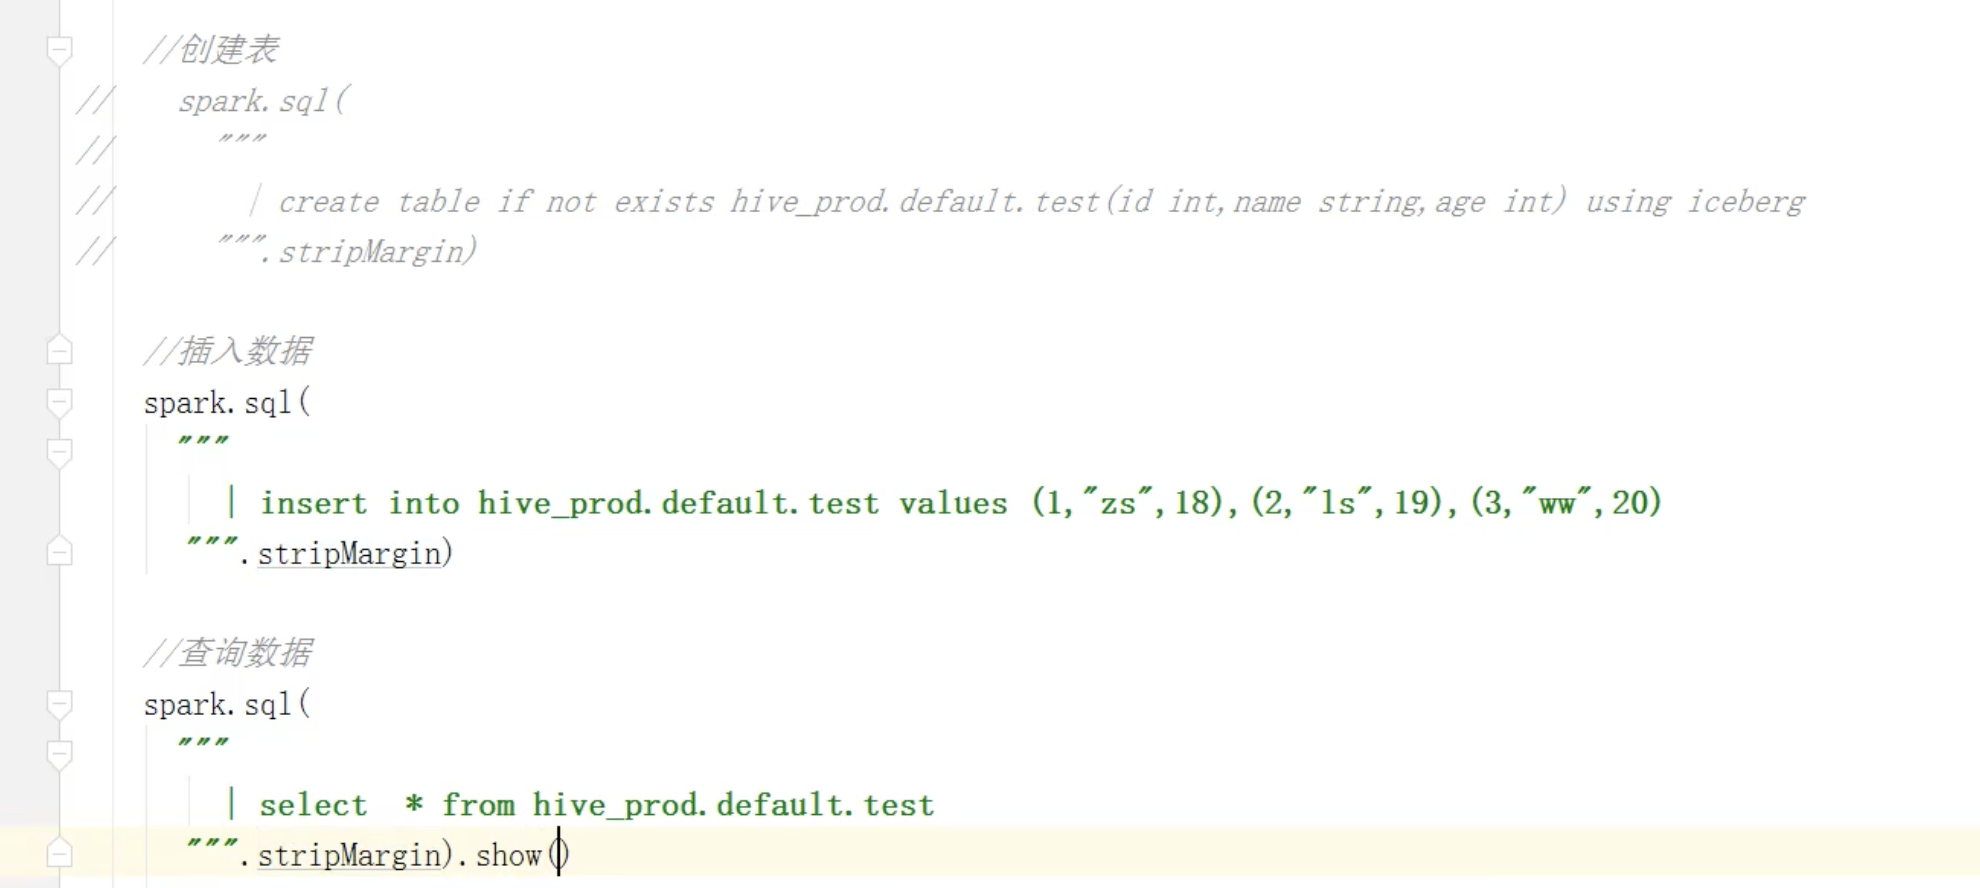
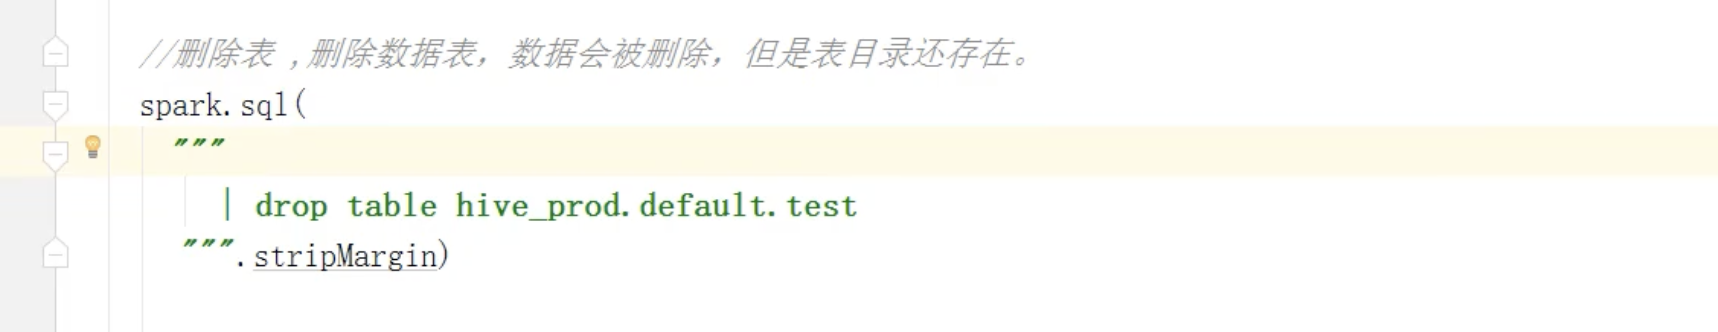
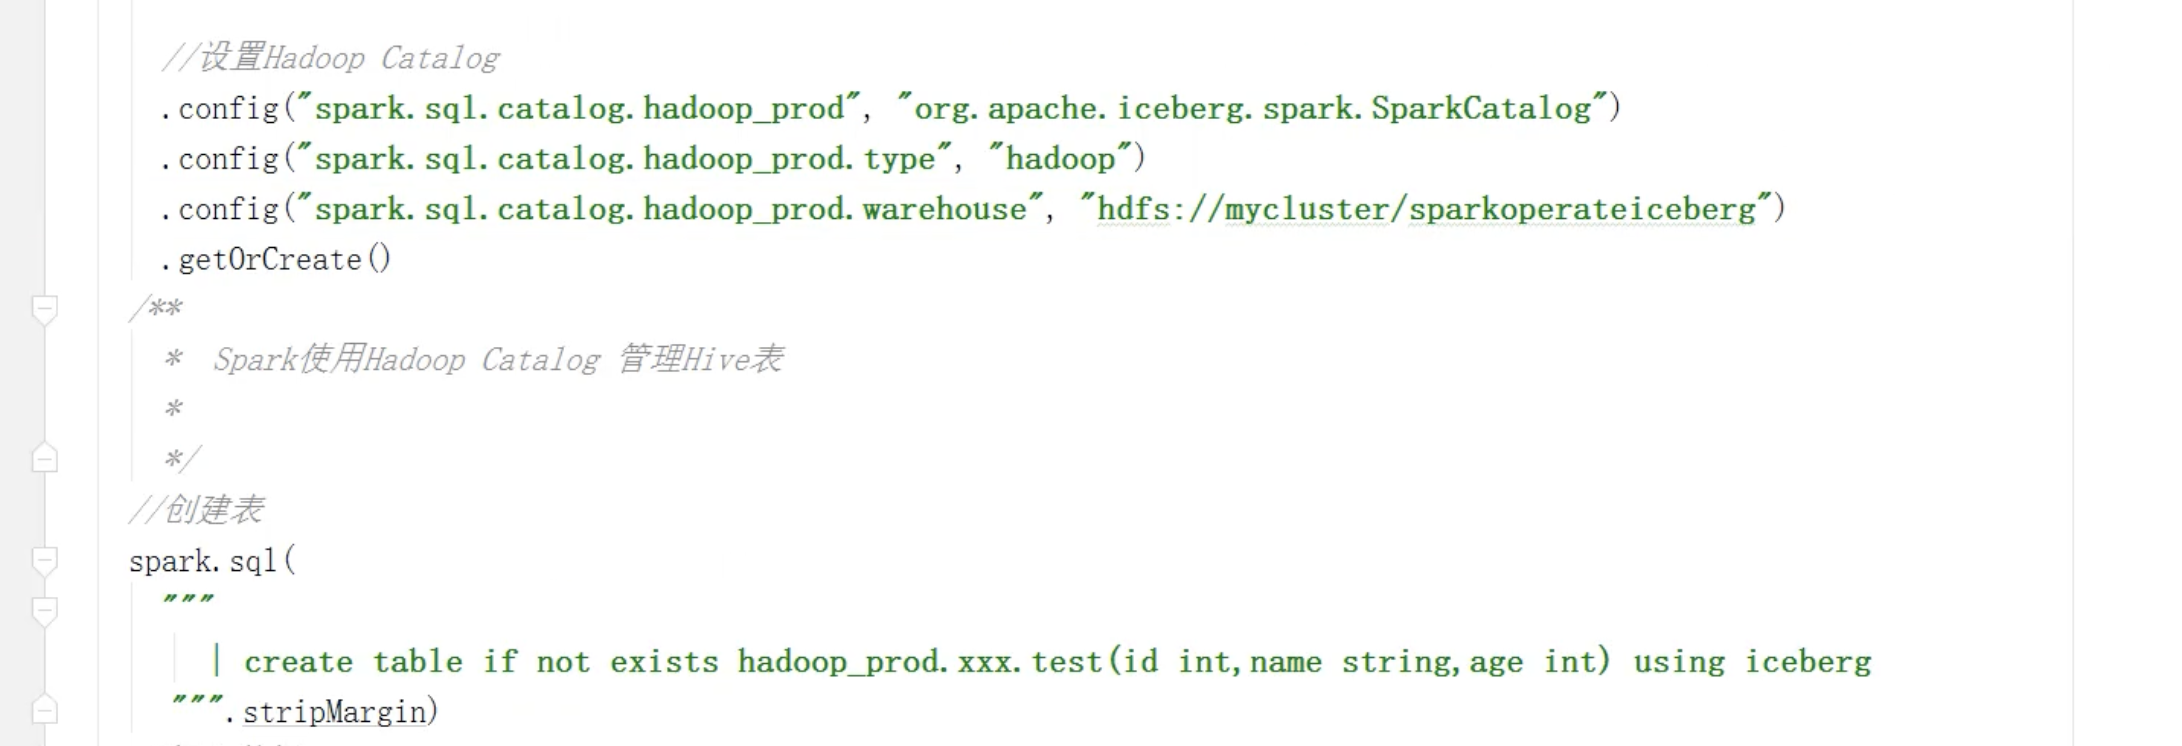
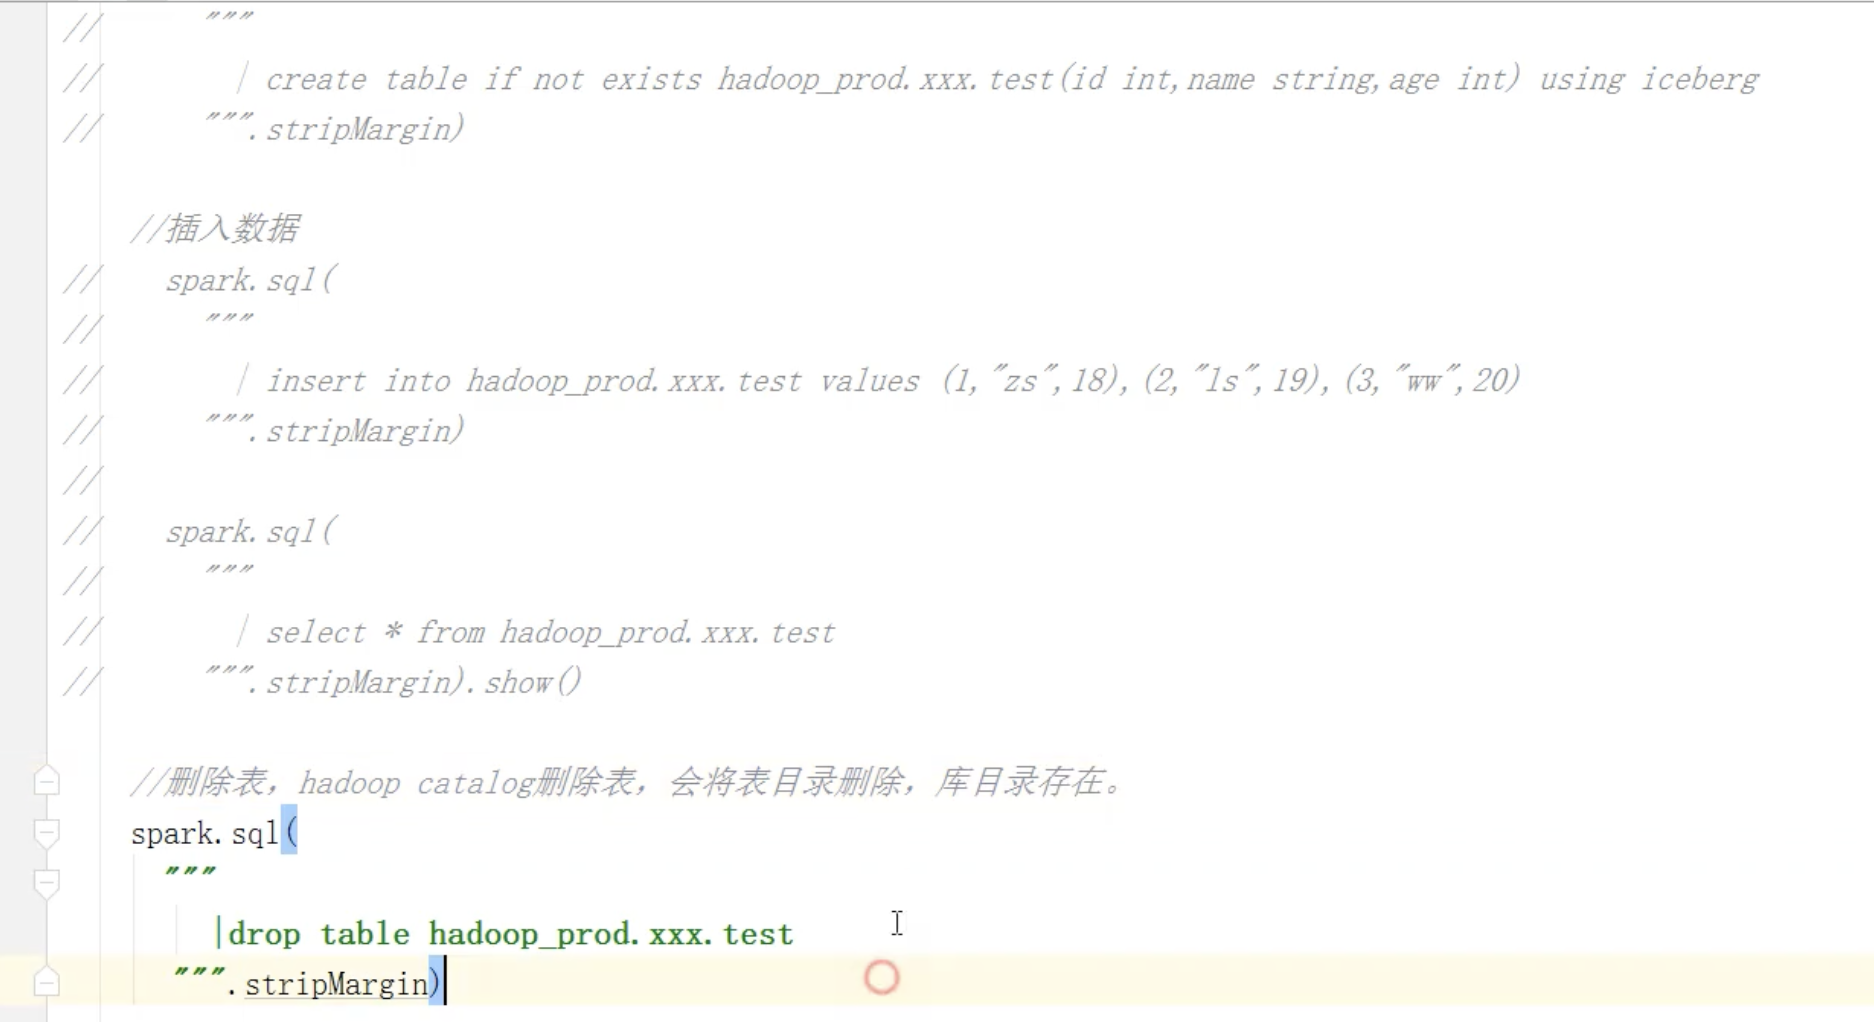
3.3.2 Spark使用Hadoop Catalog管理表
3.4 spark与Iceberg整合DDL操作
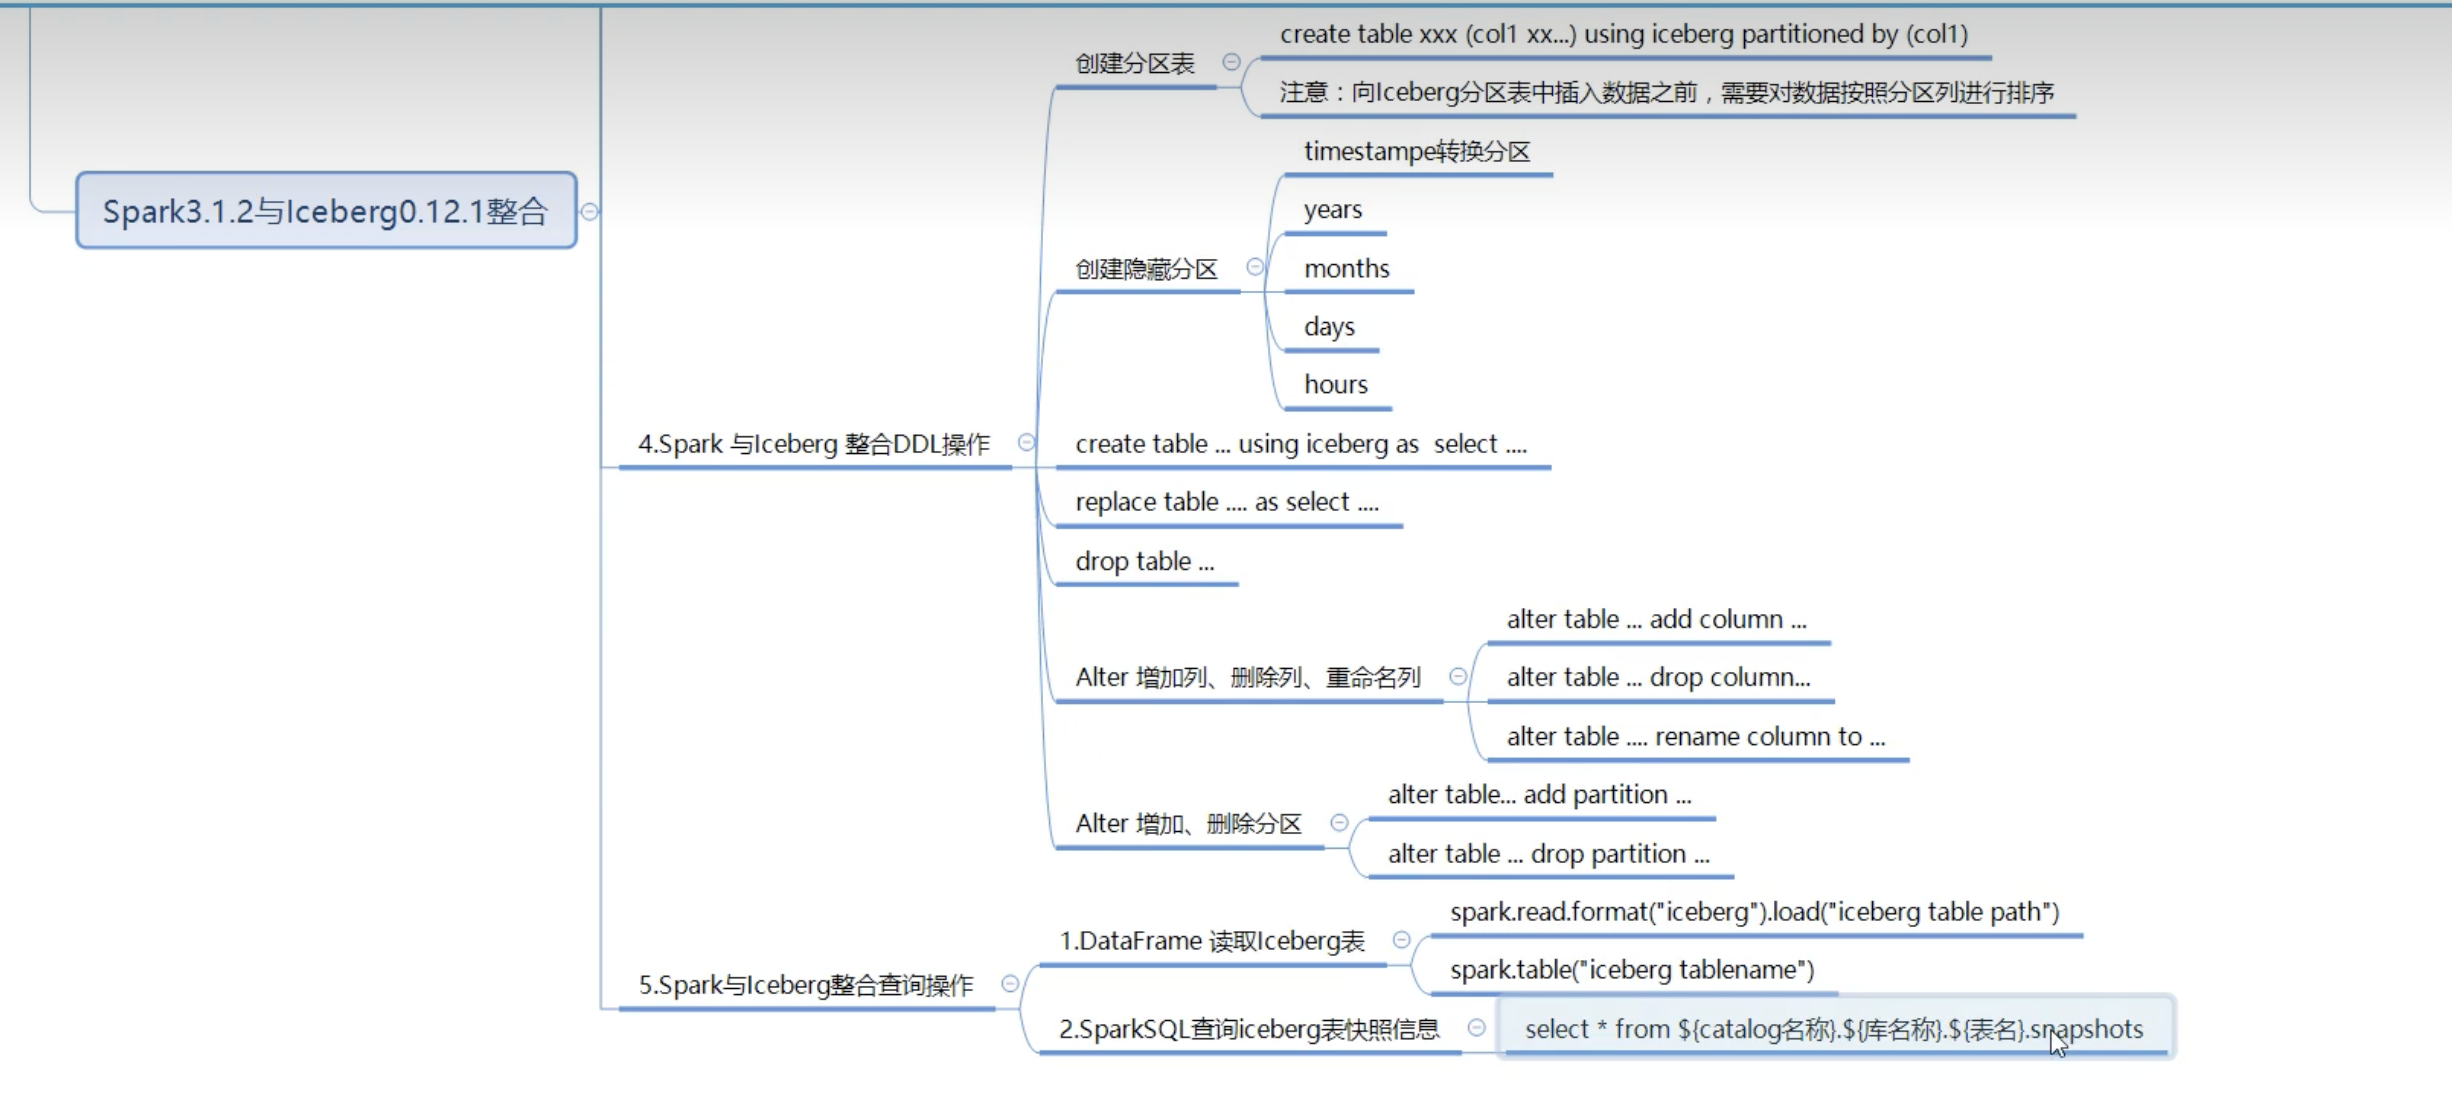
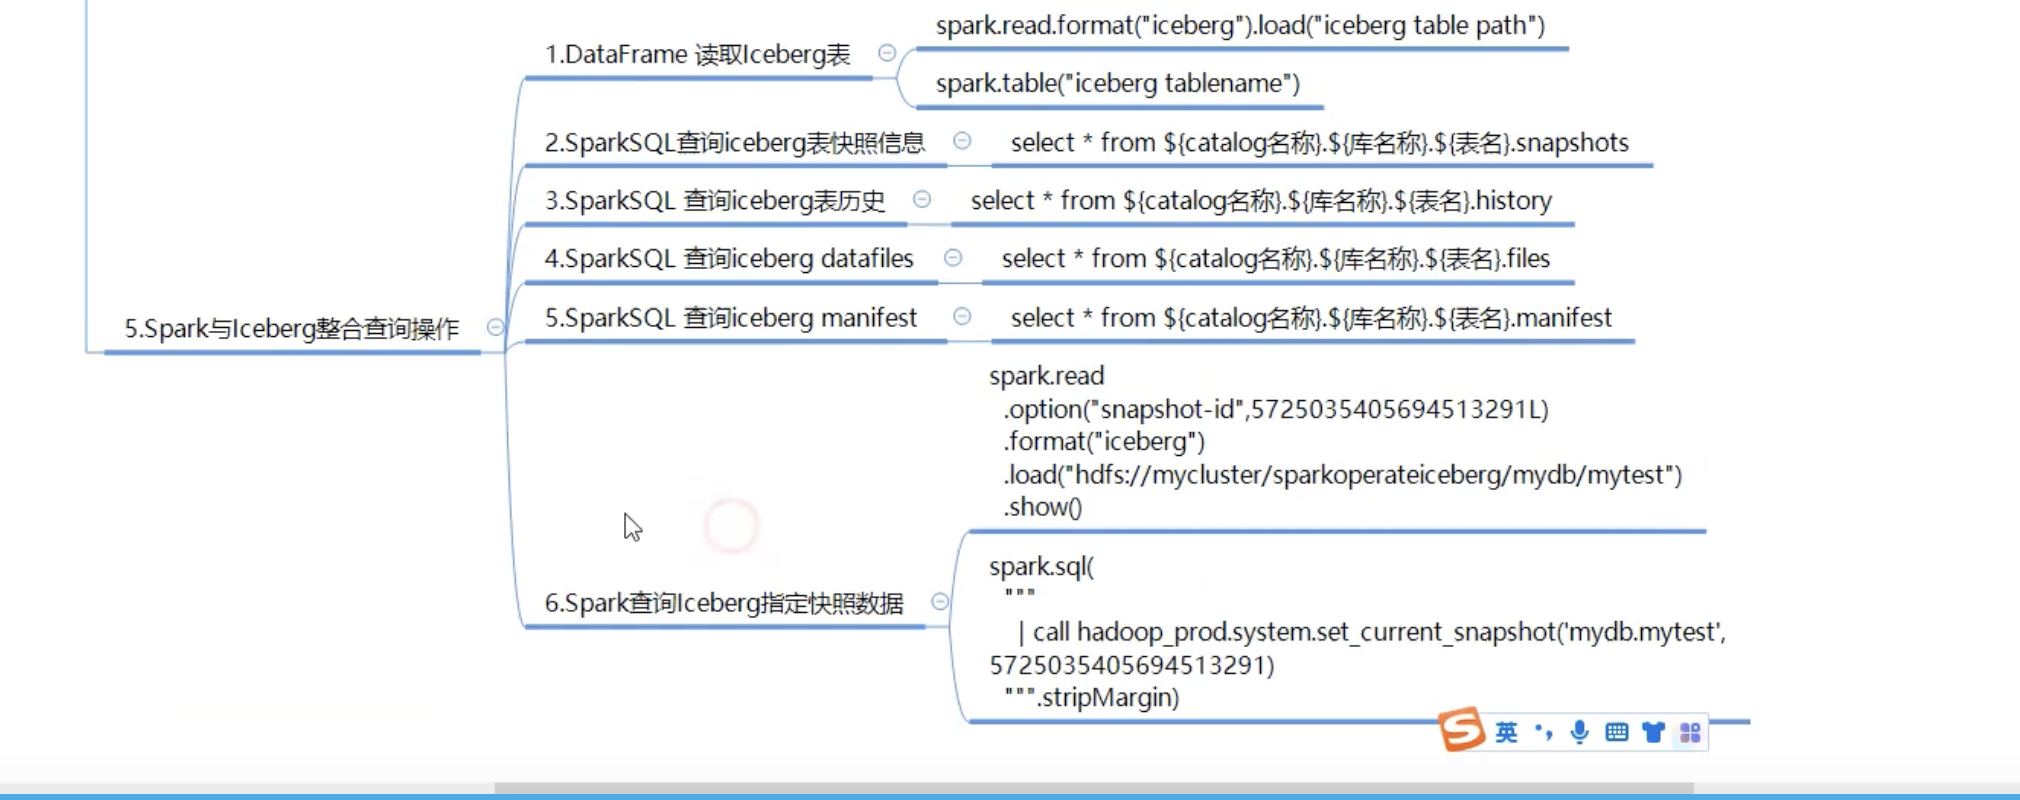
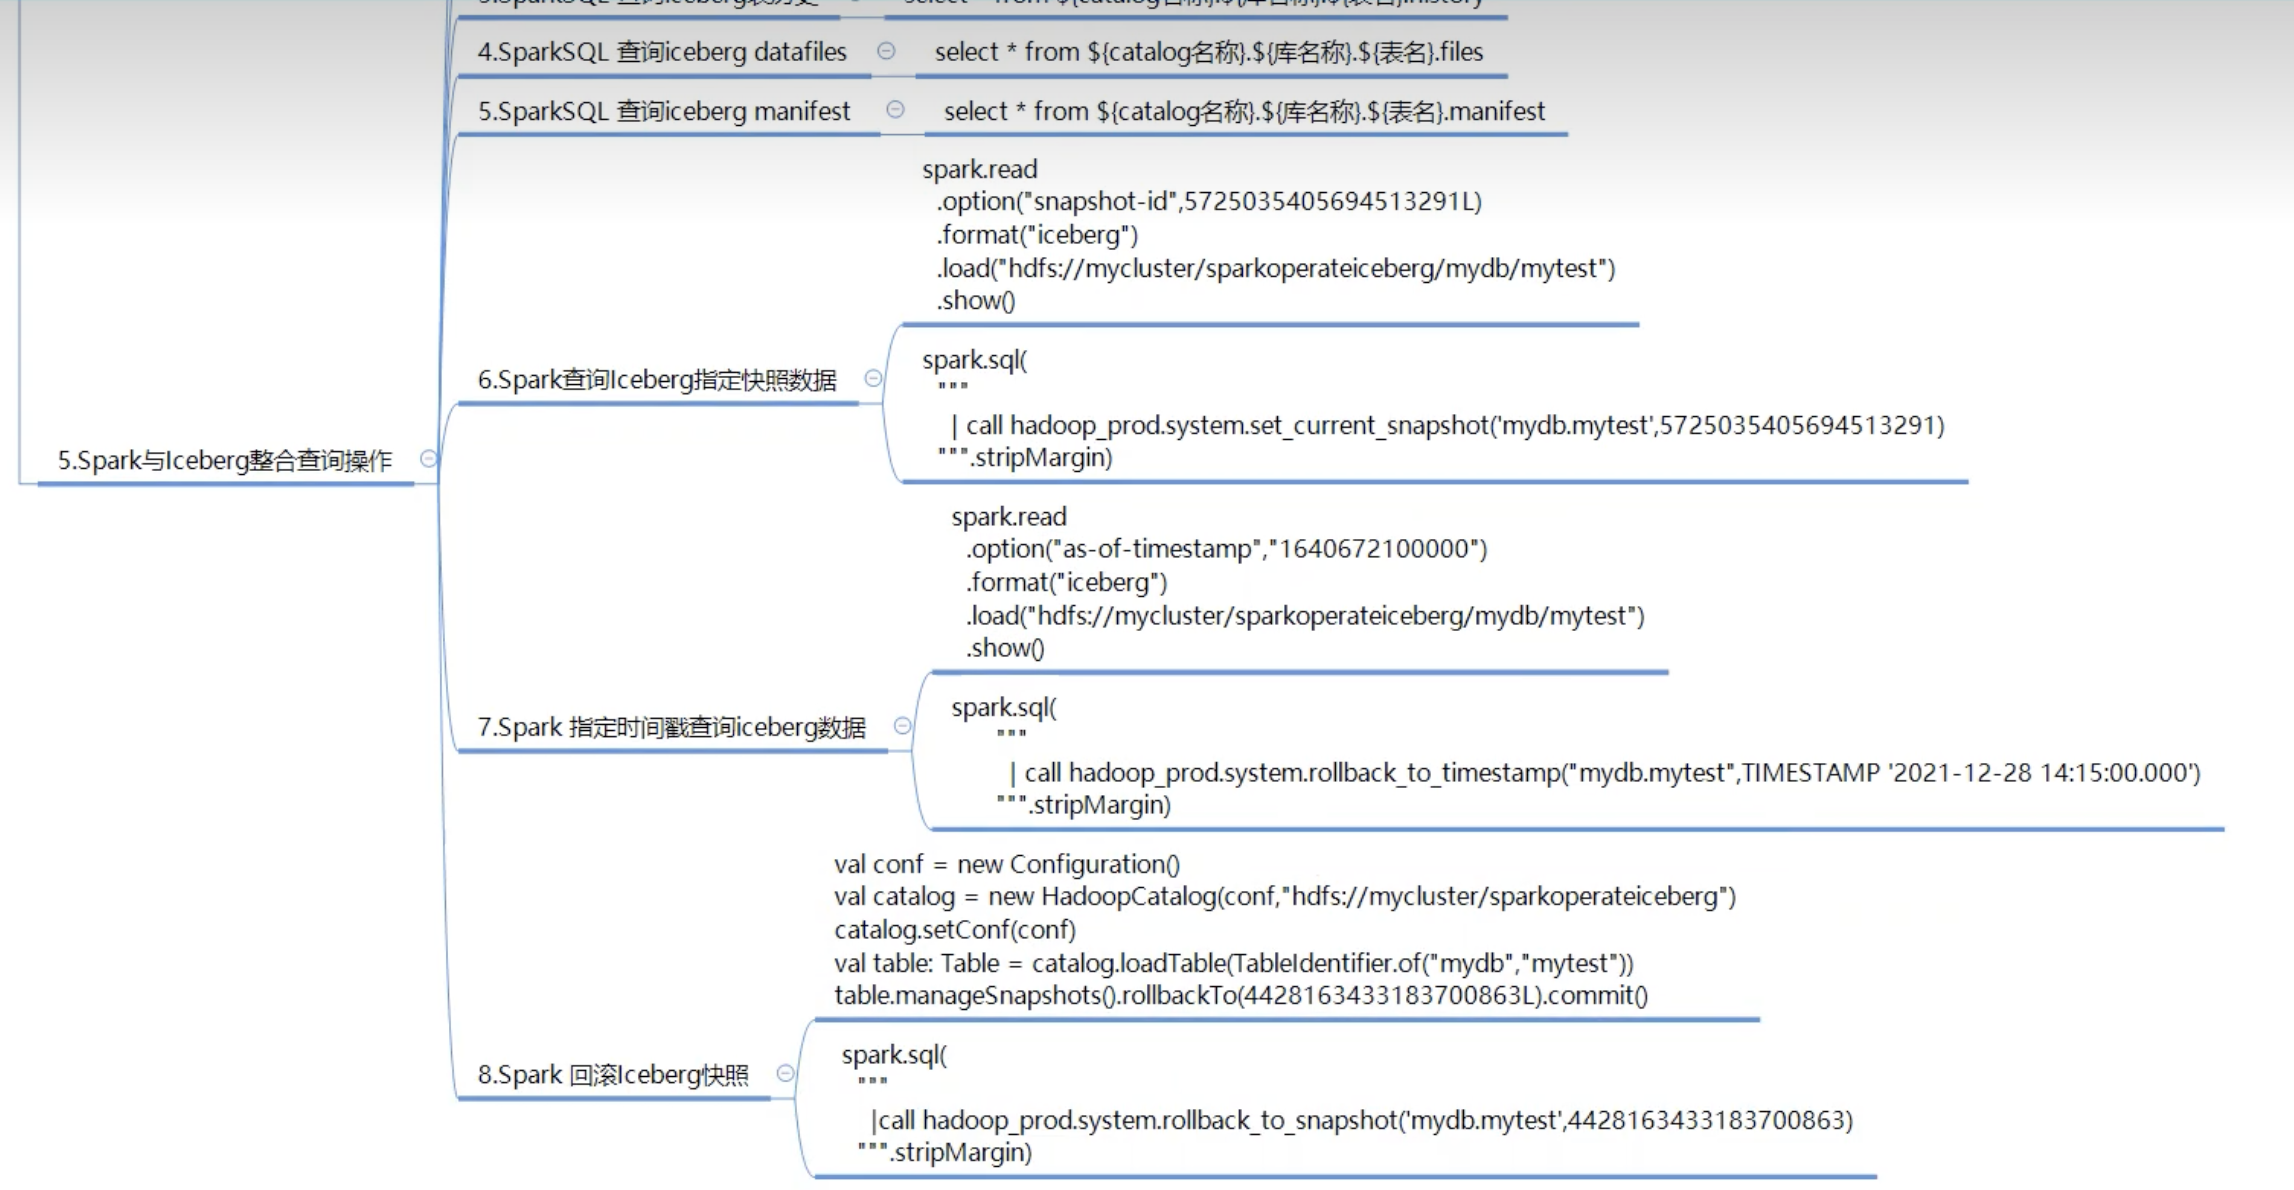
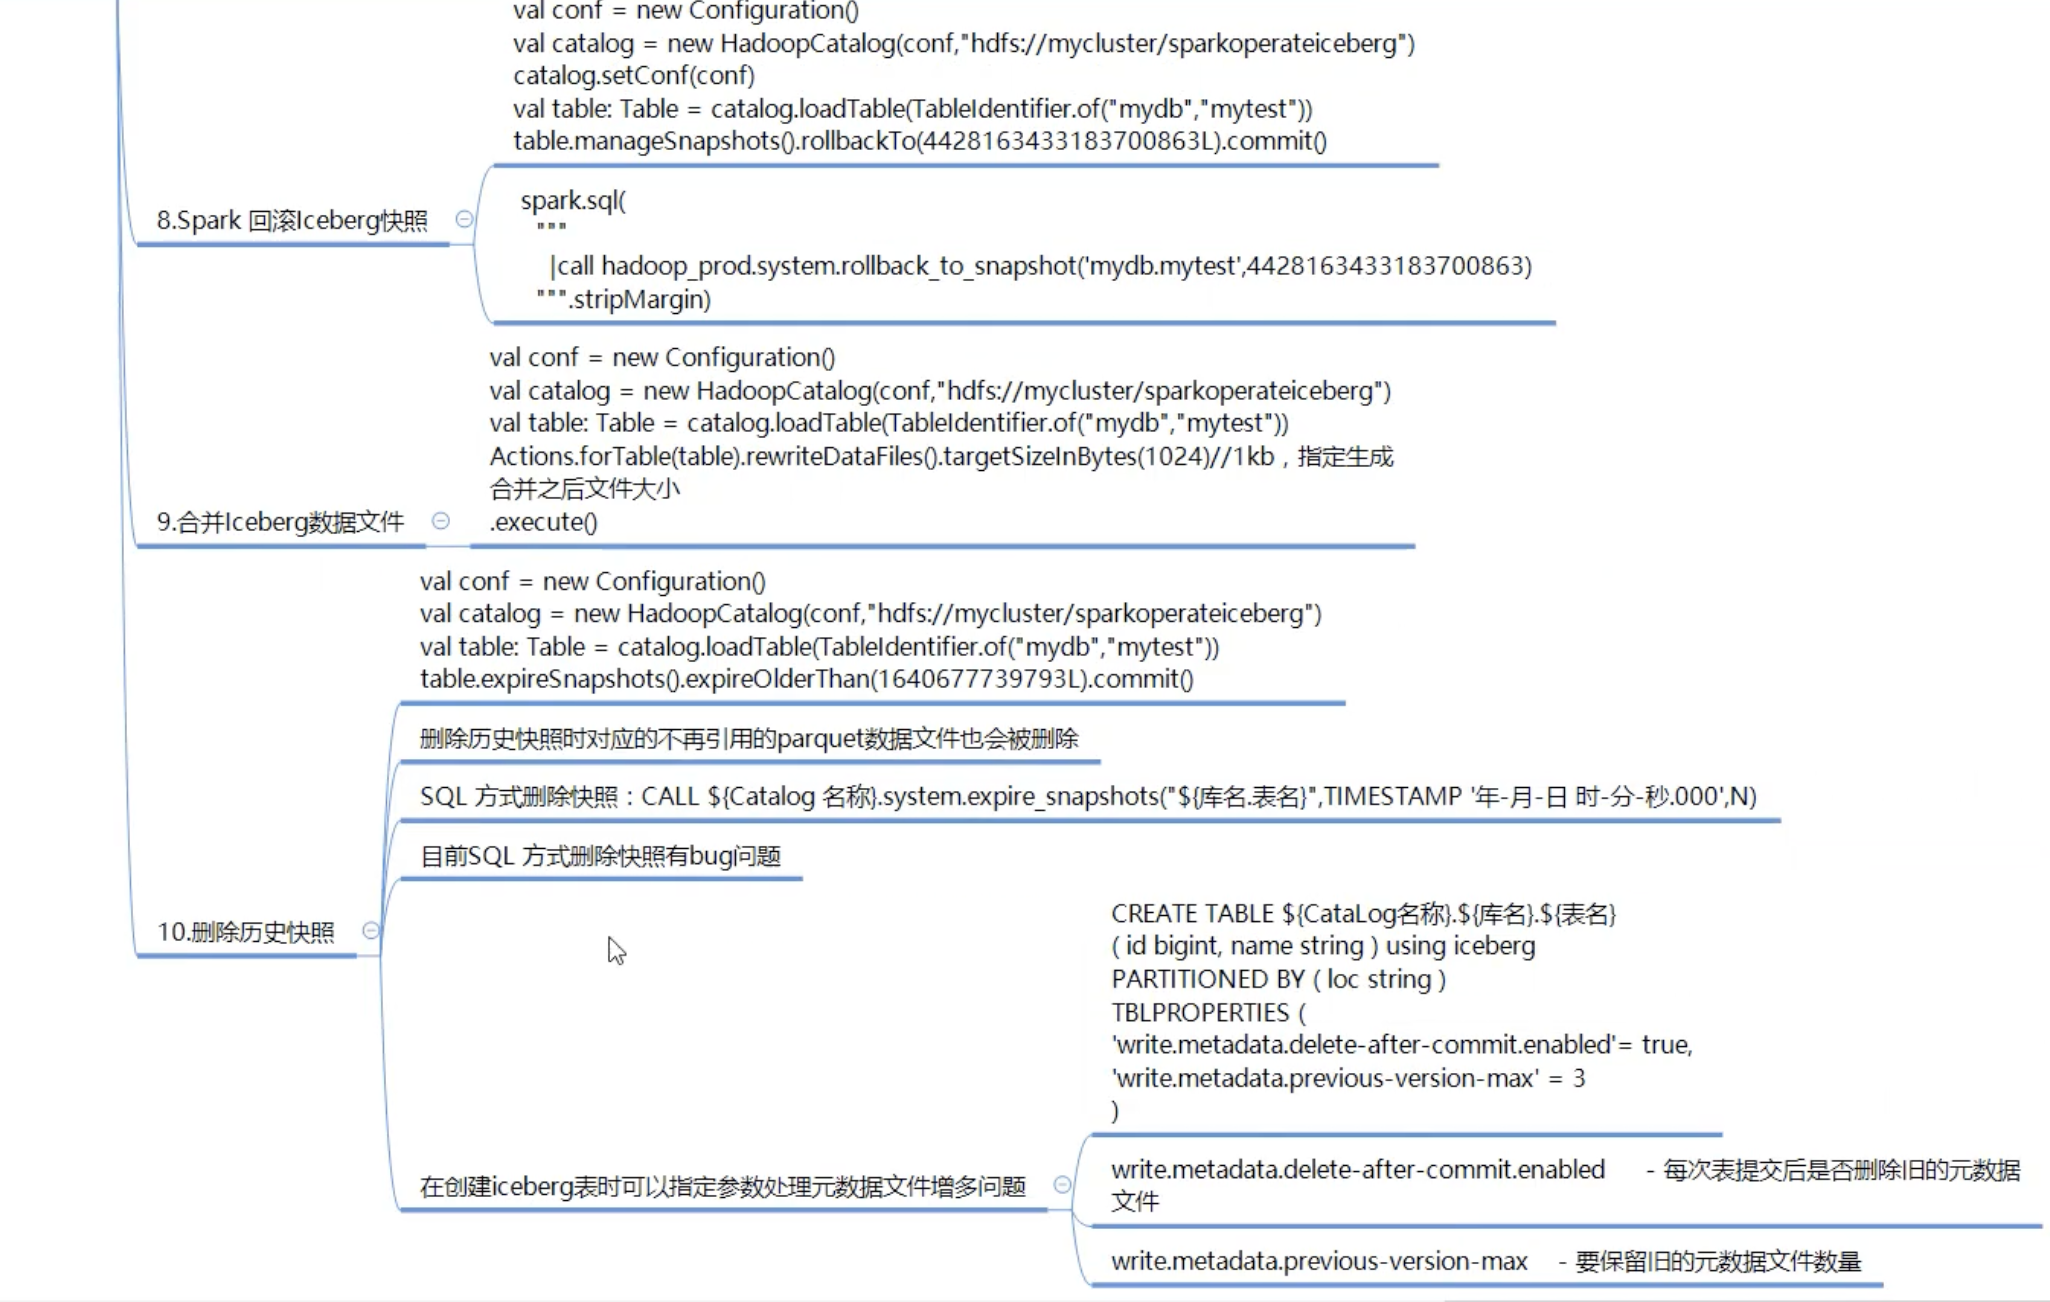
3.5 spark与Iceberg整合查询操作
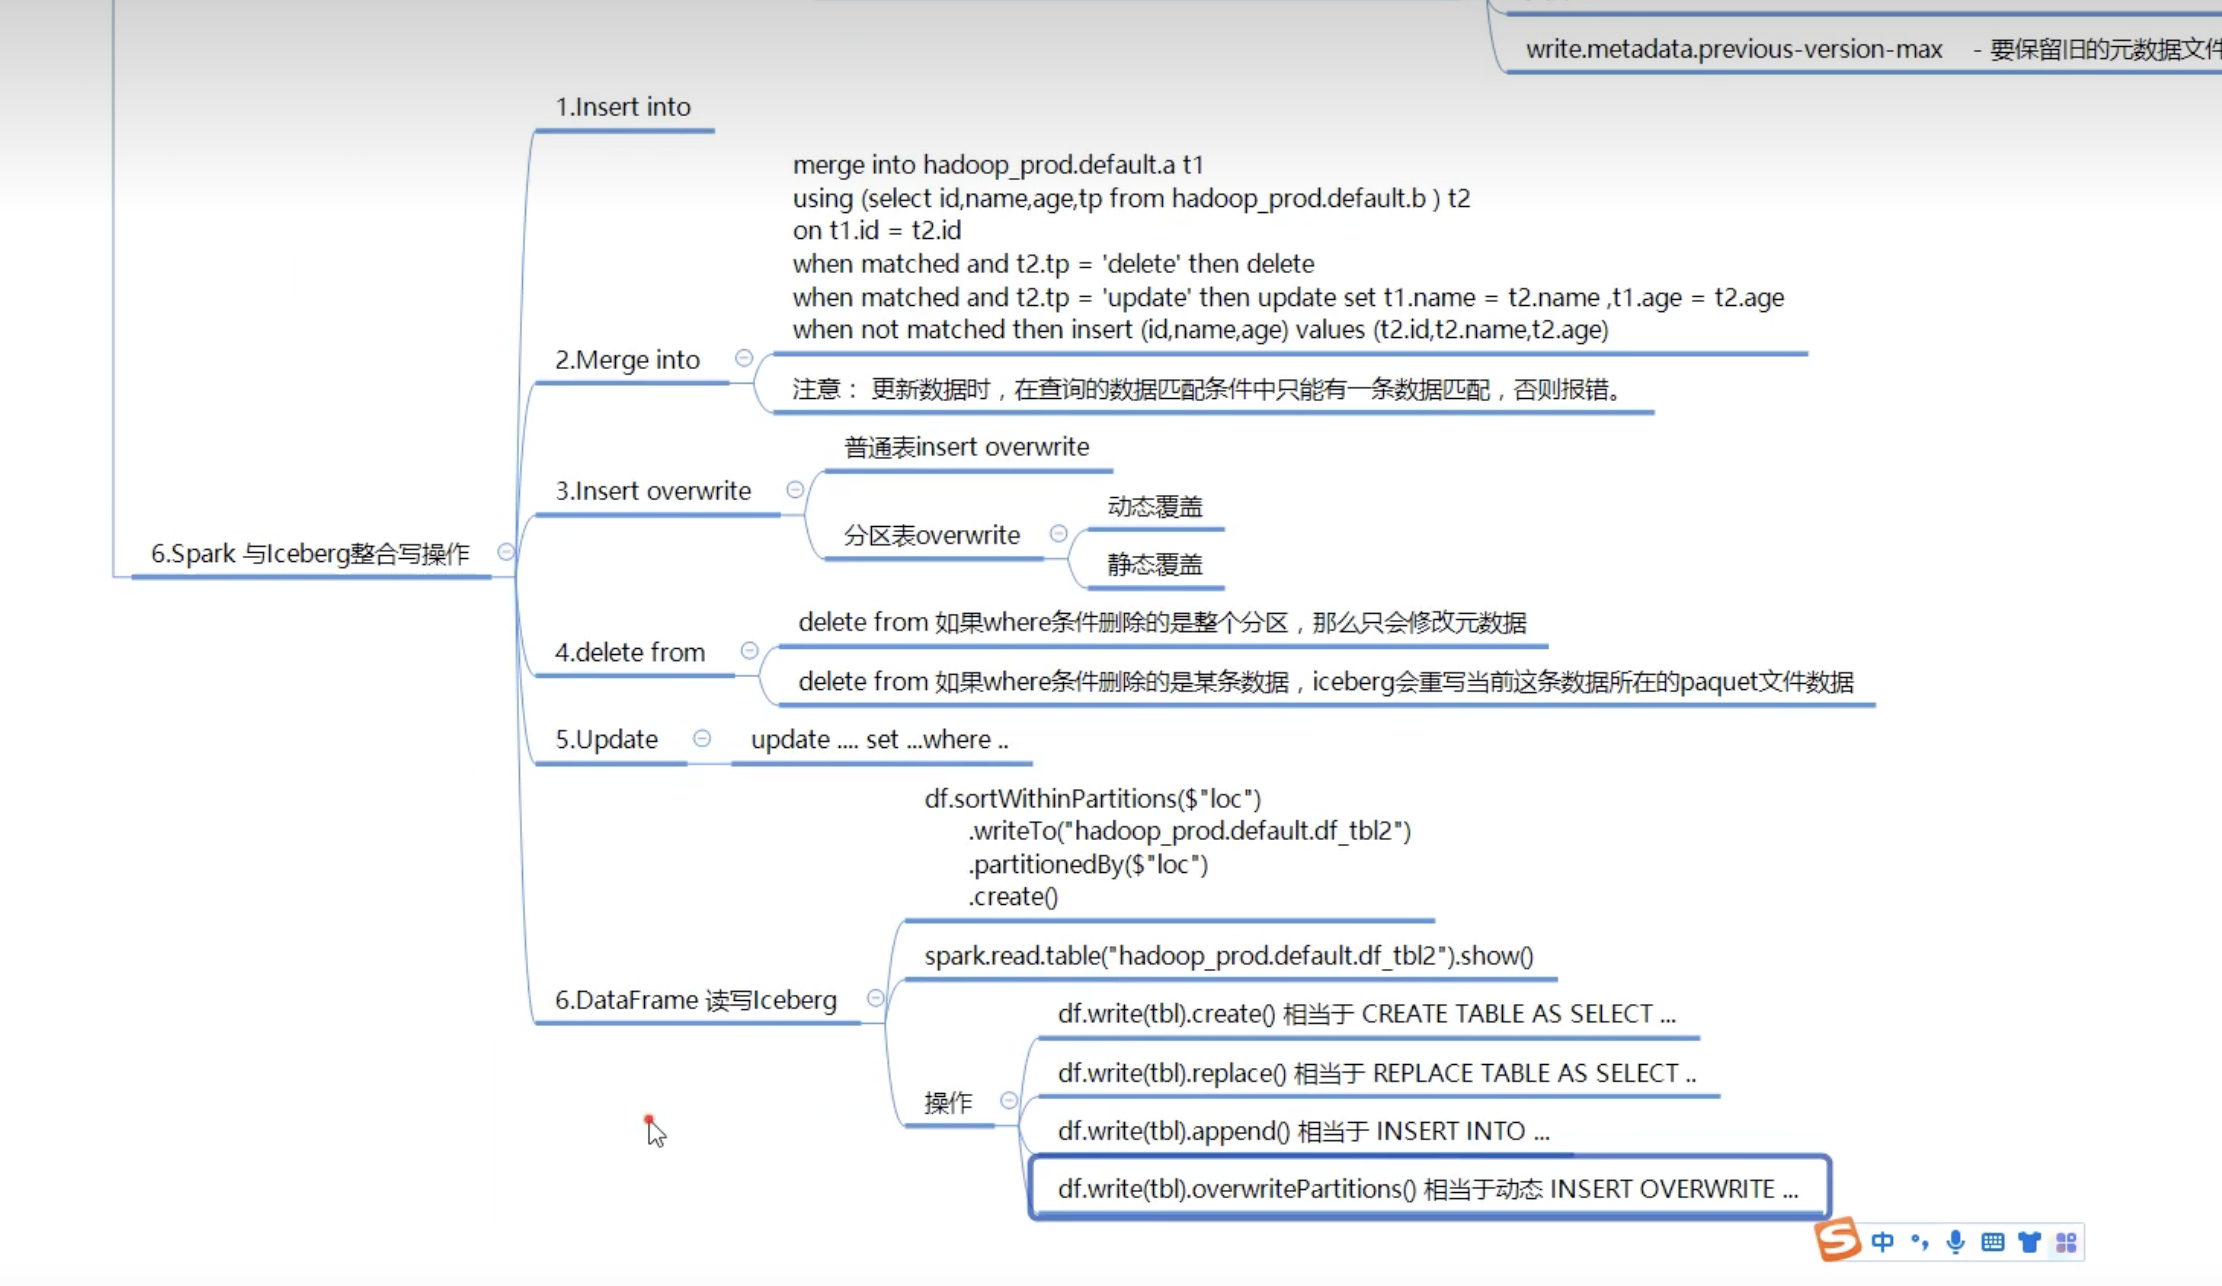
3.6 spark与Iceberg整合写操作
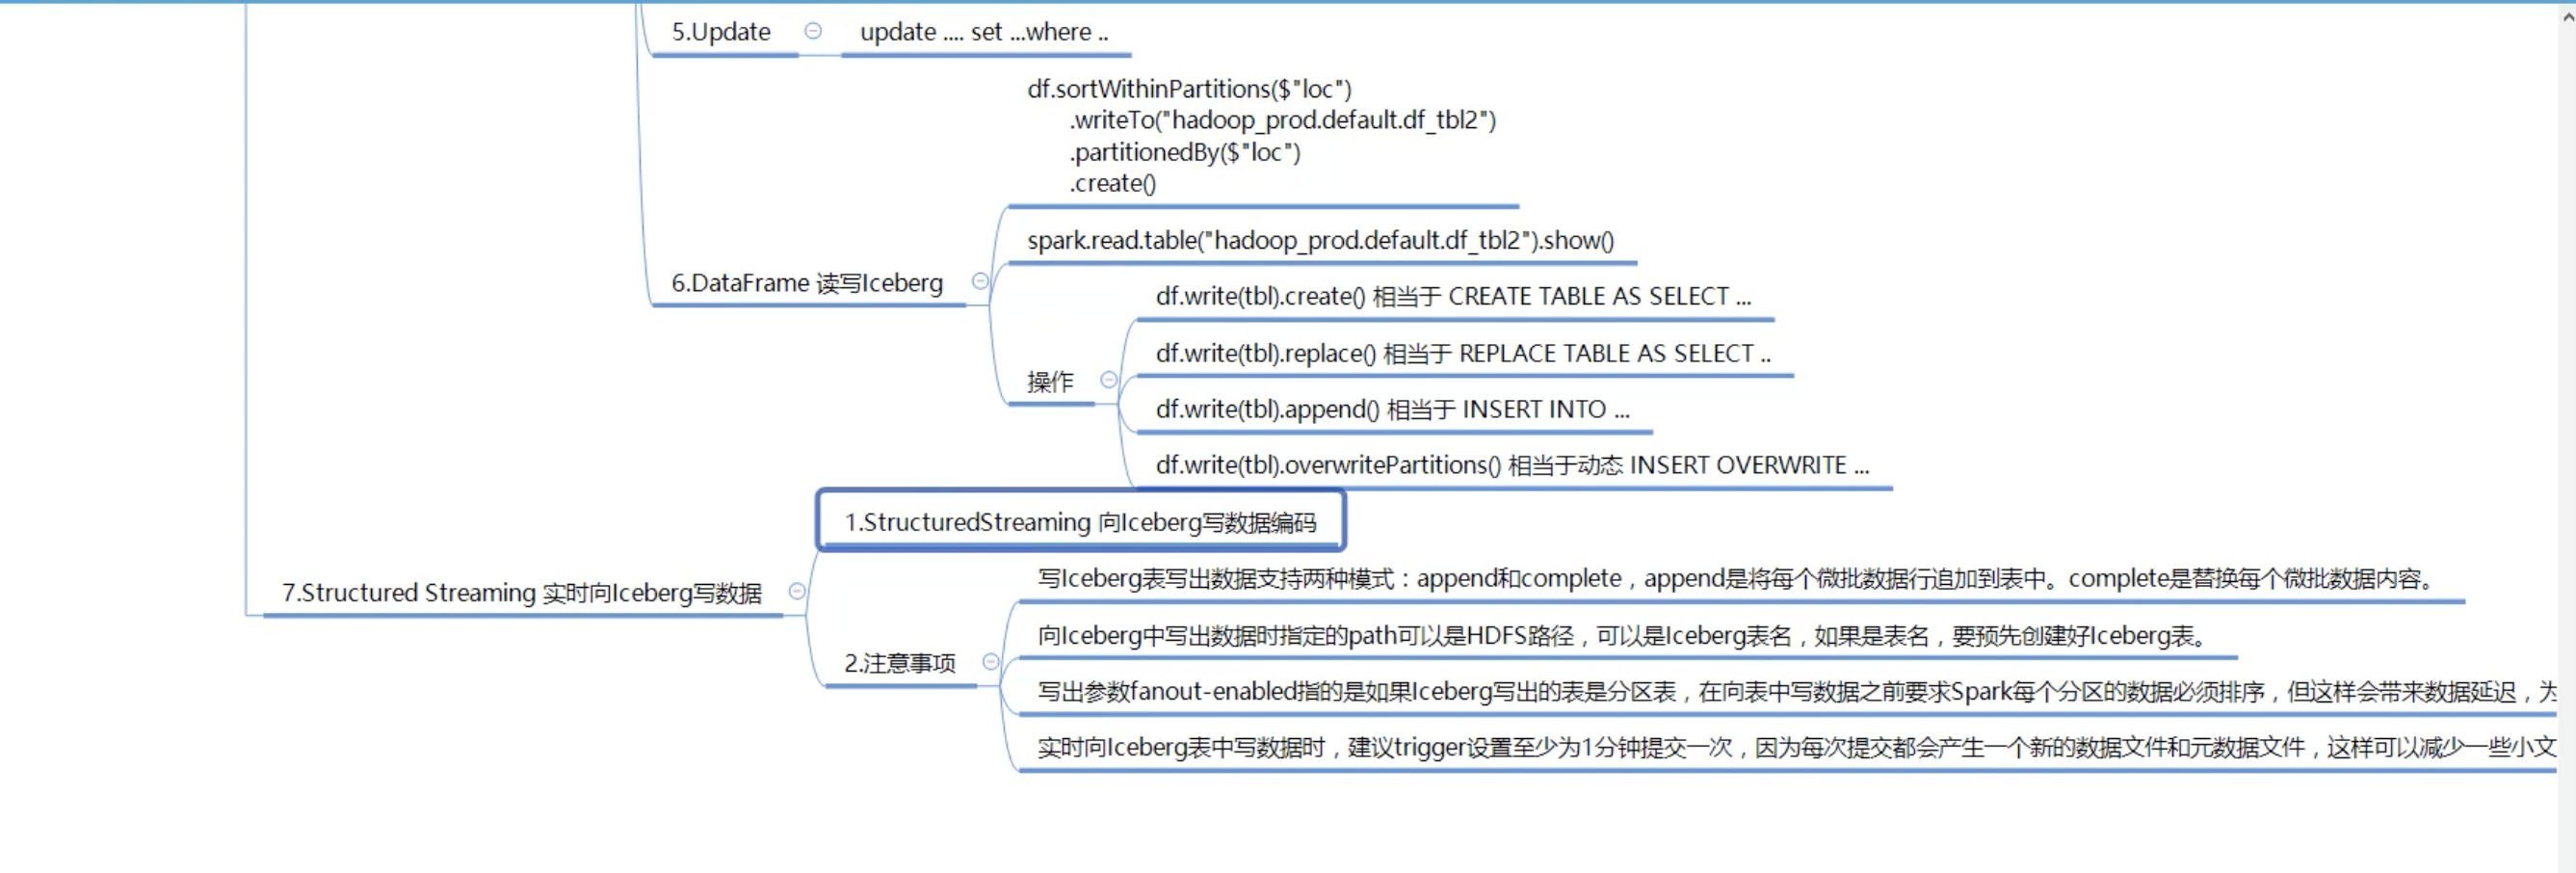
3.7 SparkStreaming向Iceberg写数据
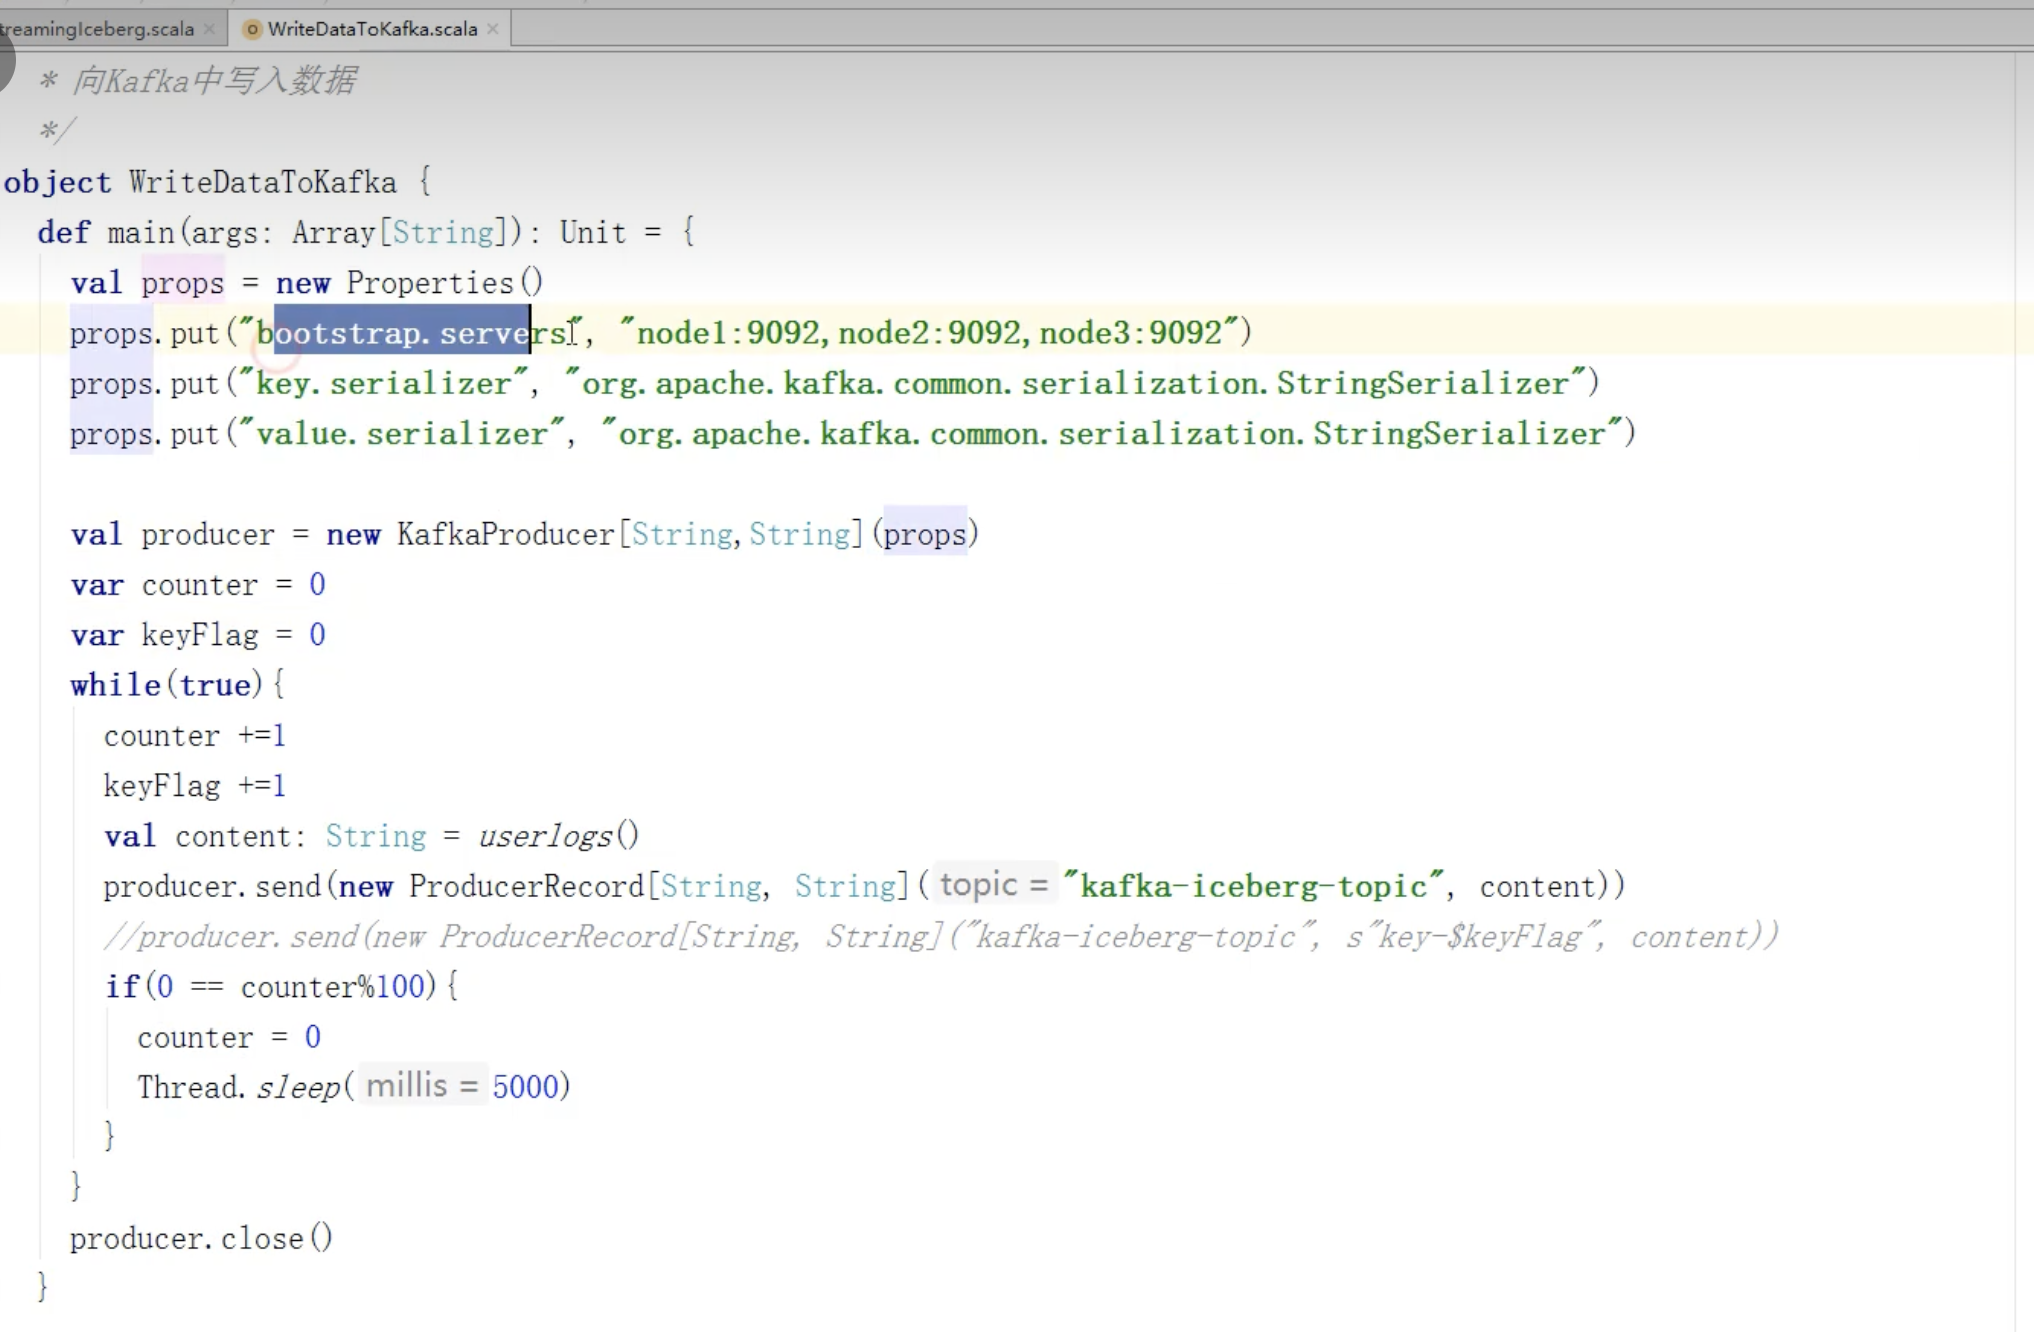
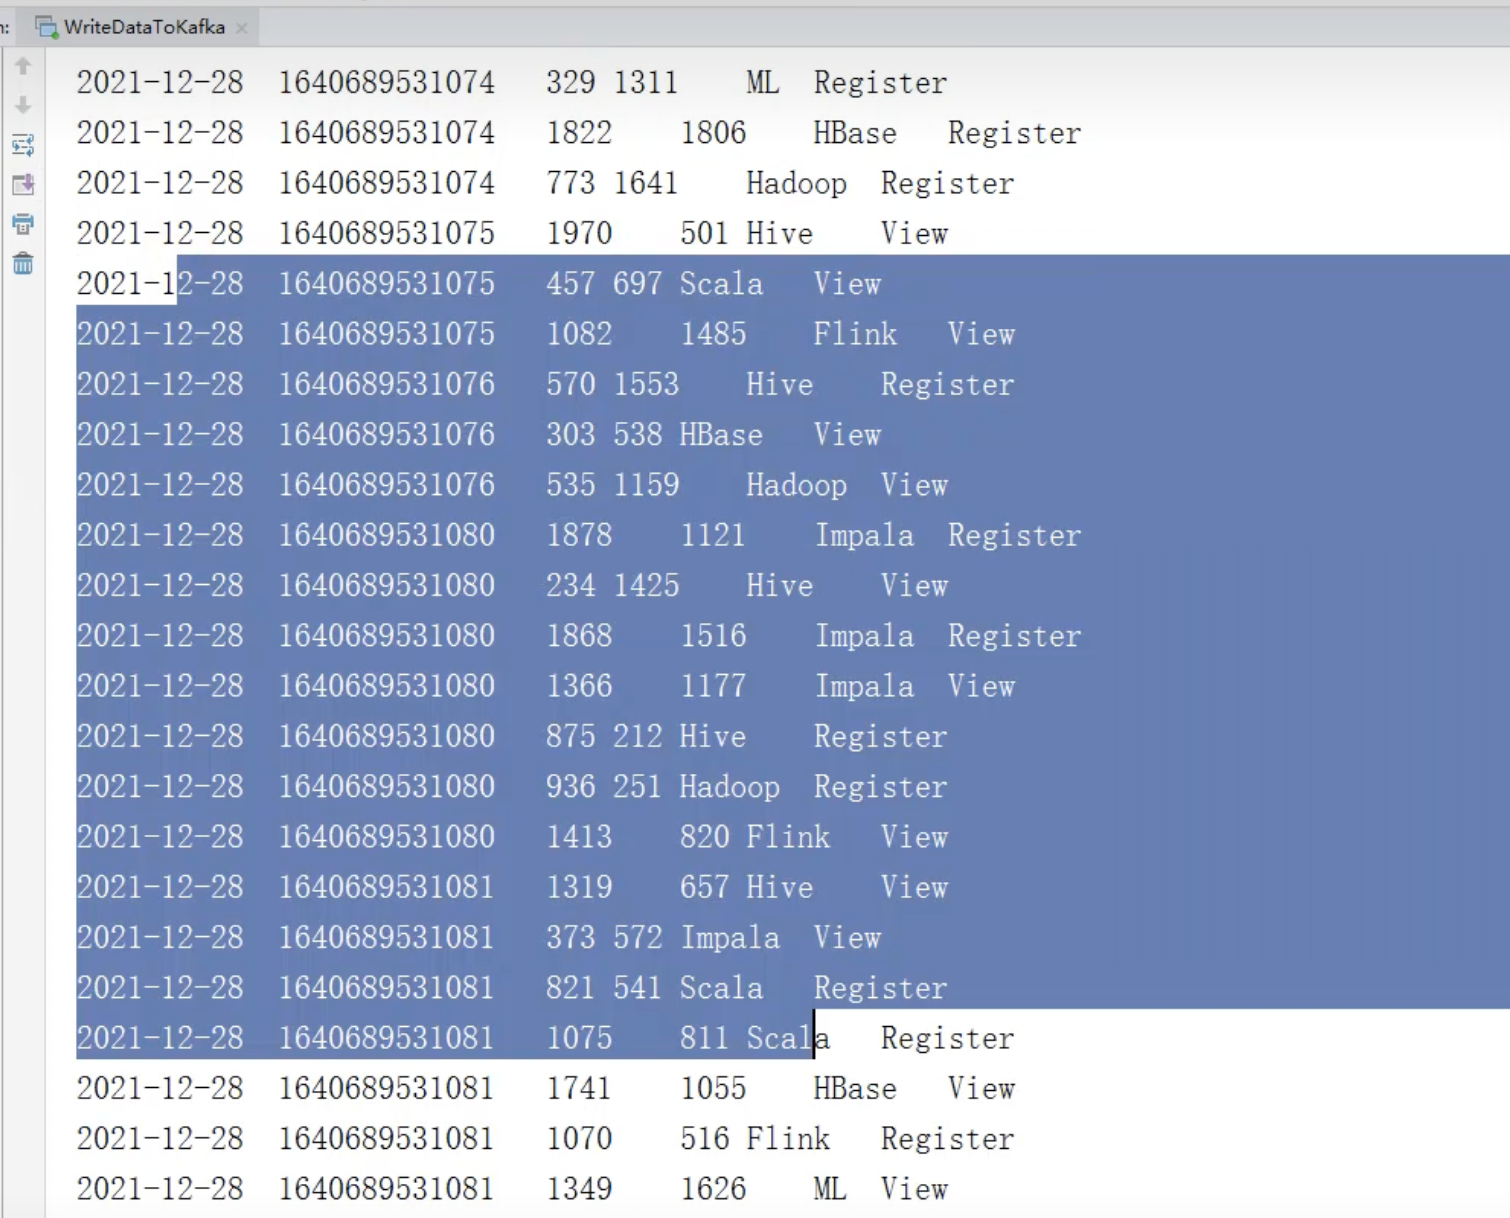
3.7.1 数据写入kafka代码
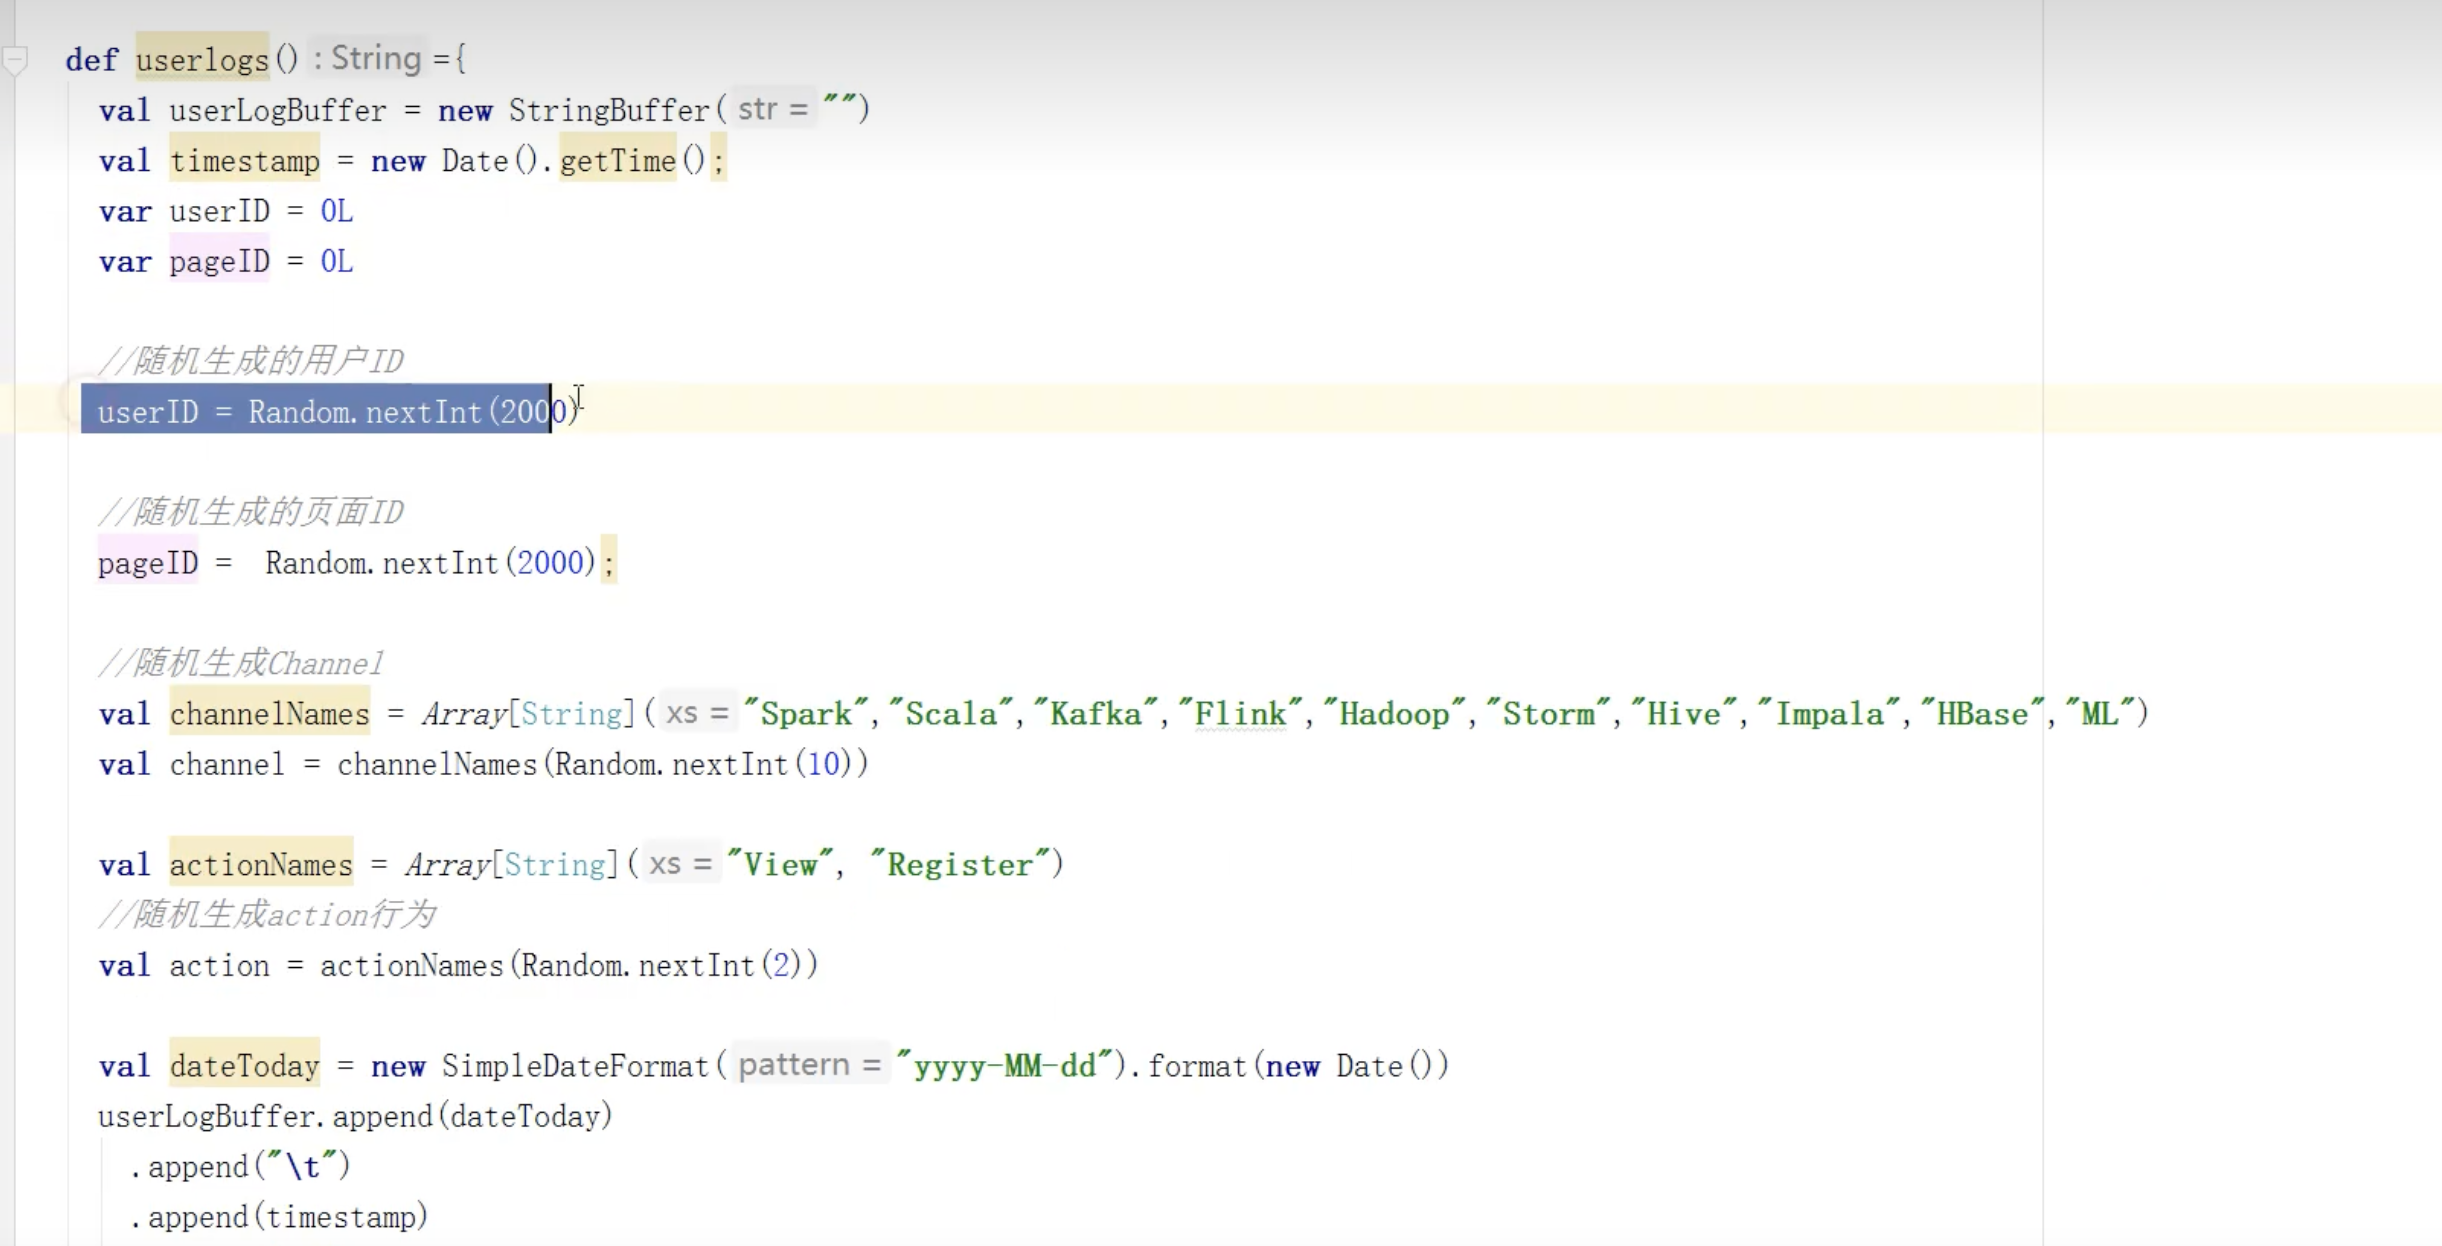
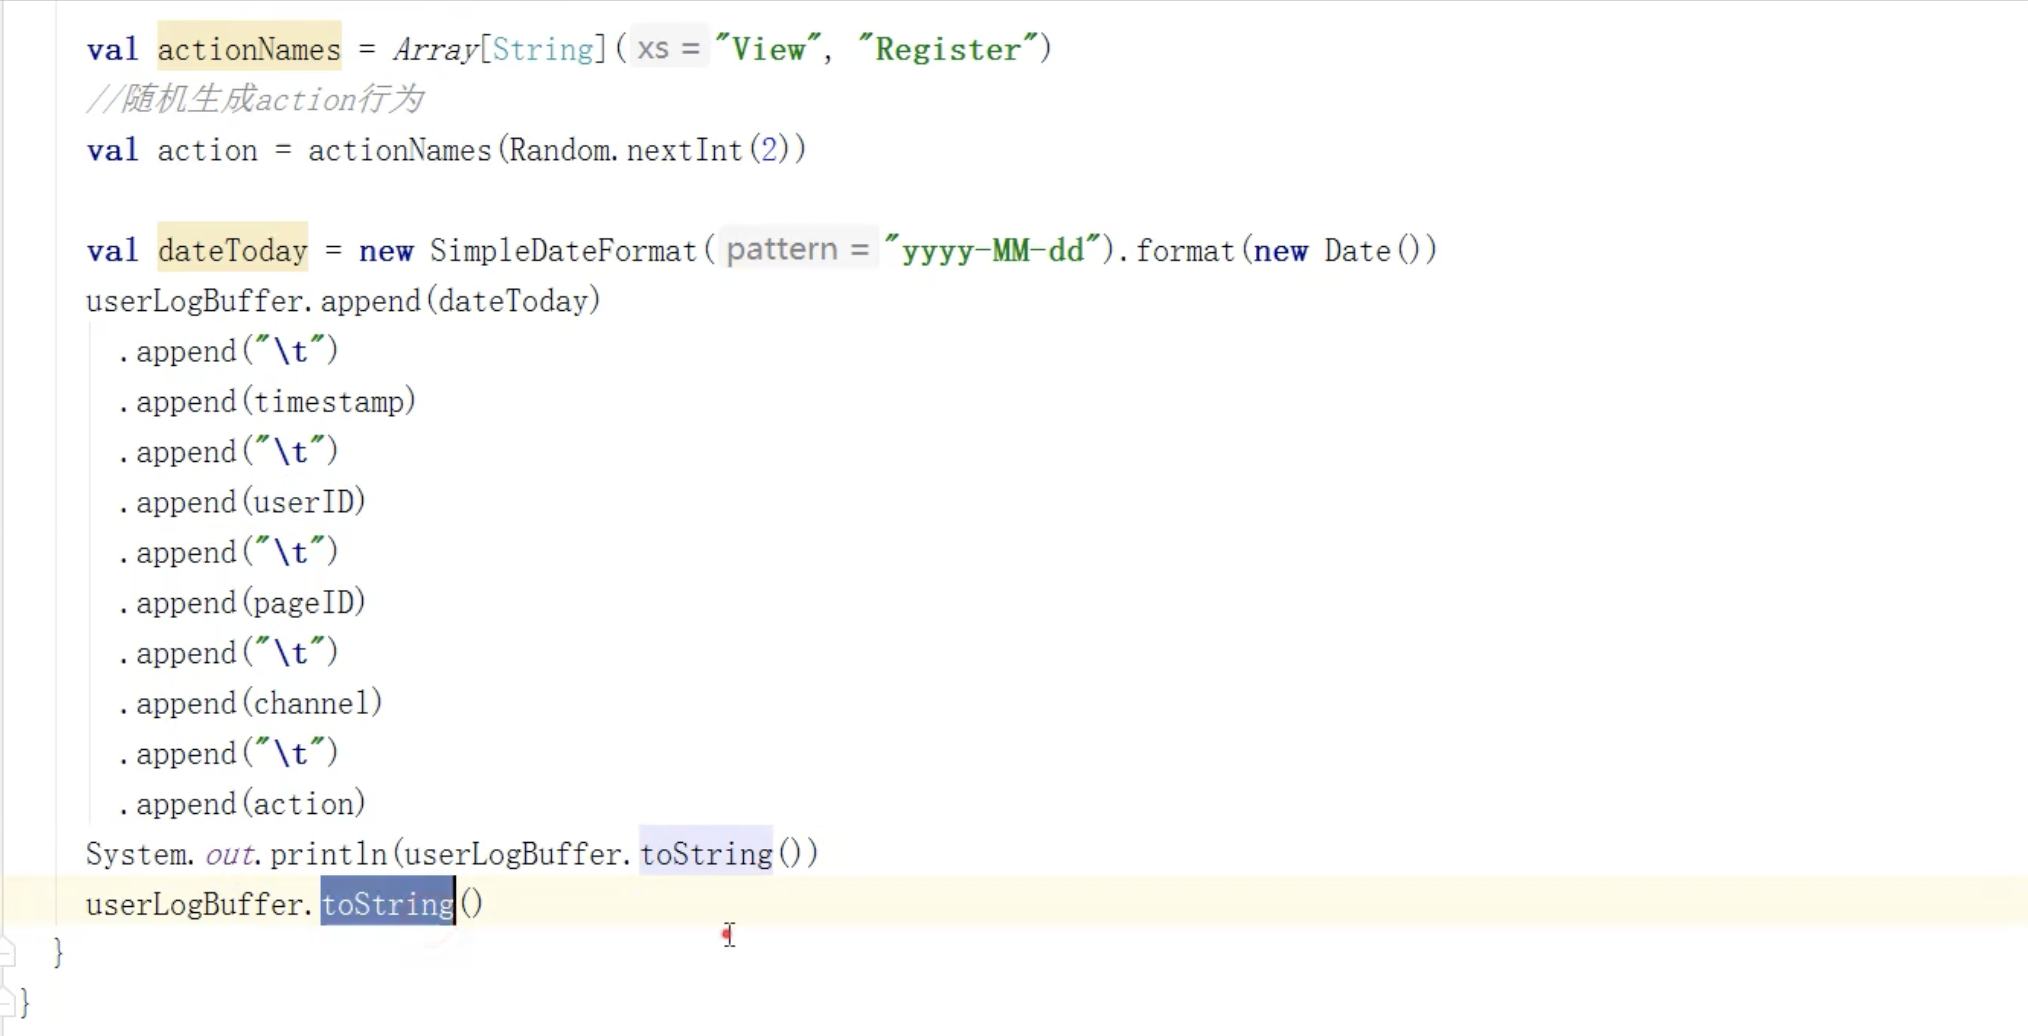
生成的数据如下:
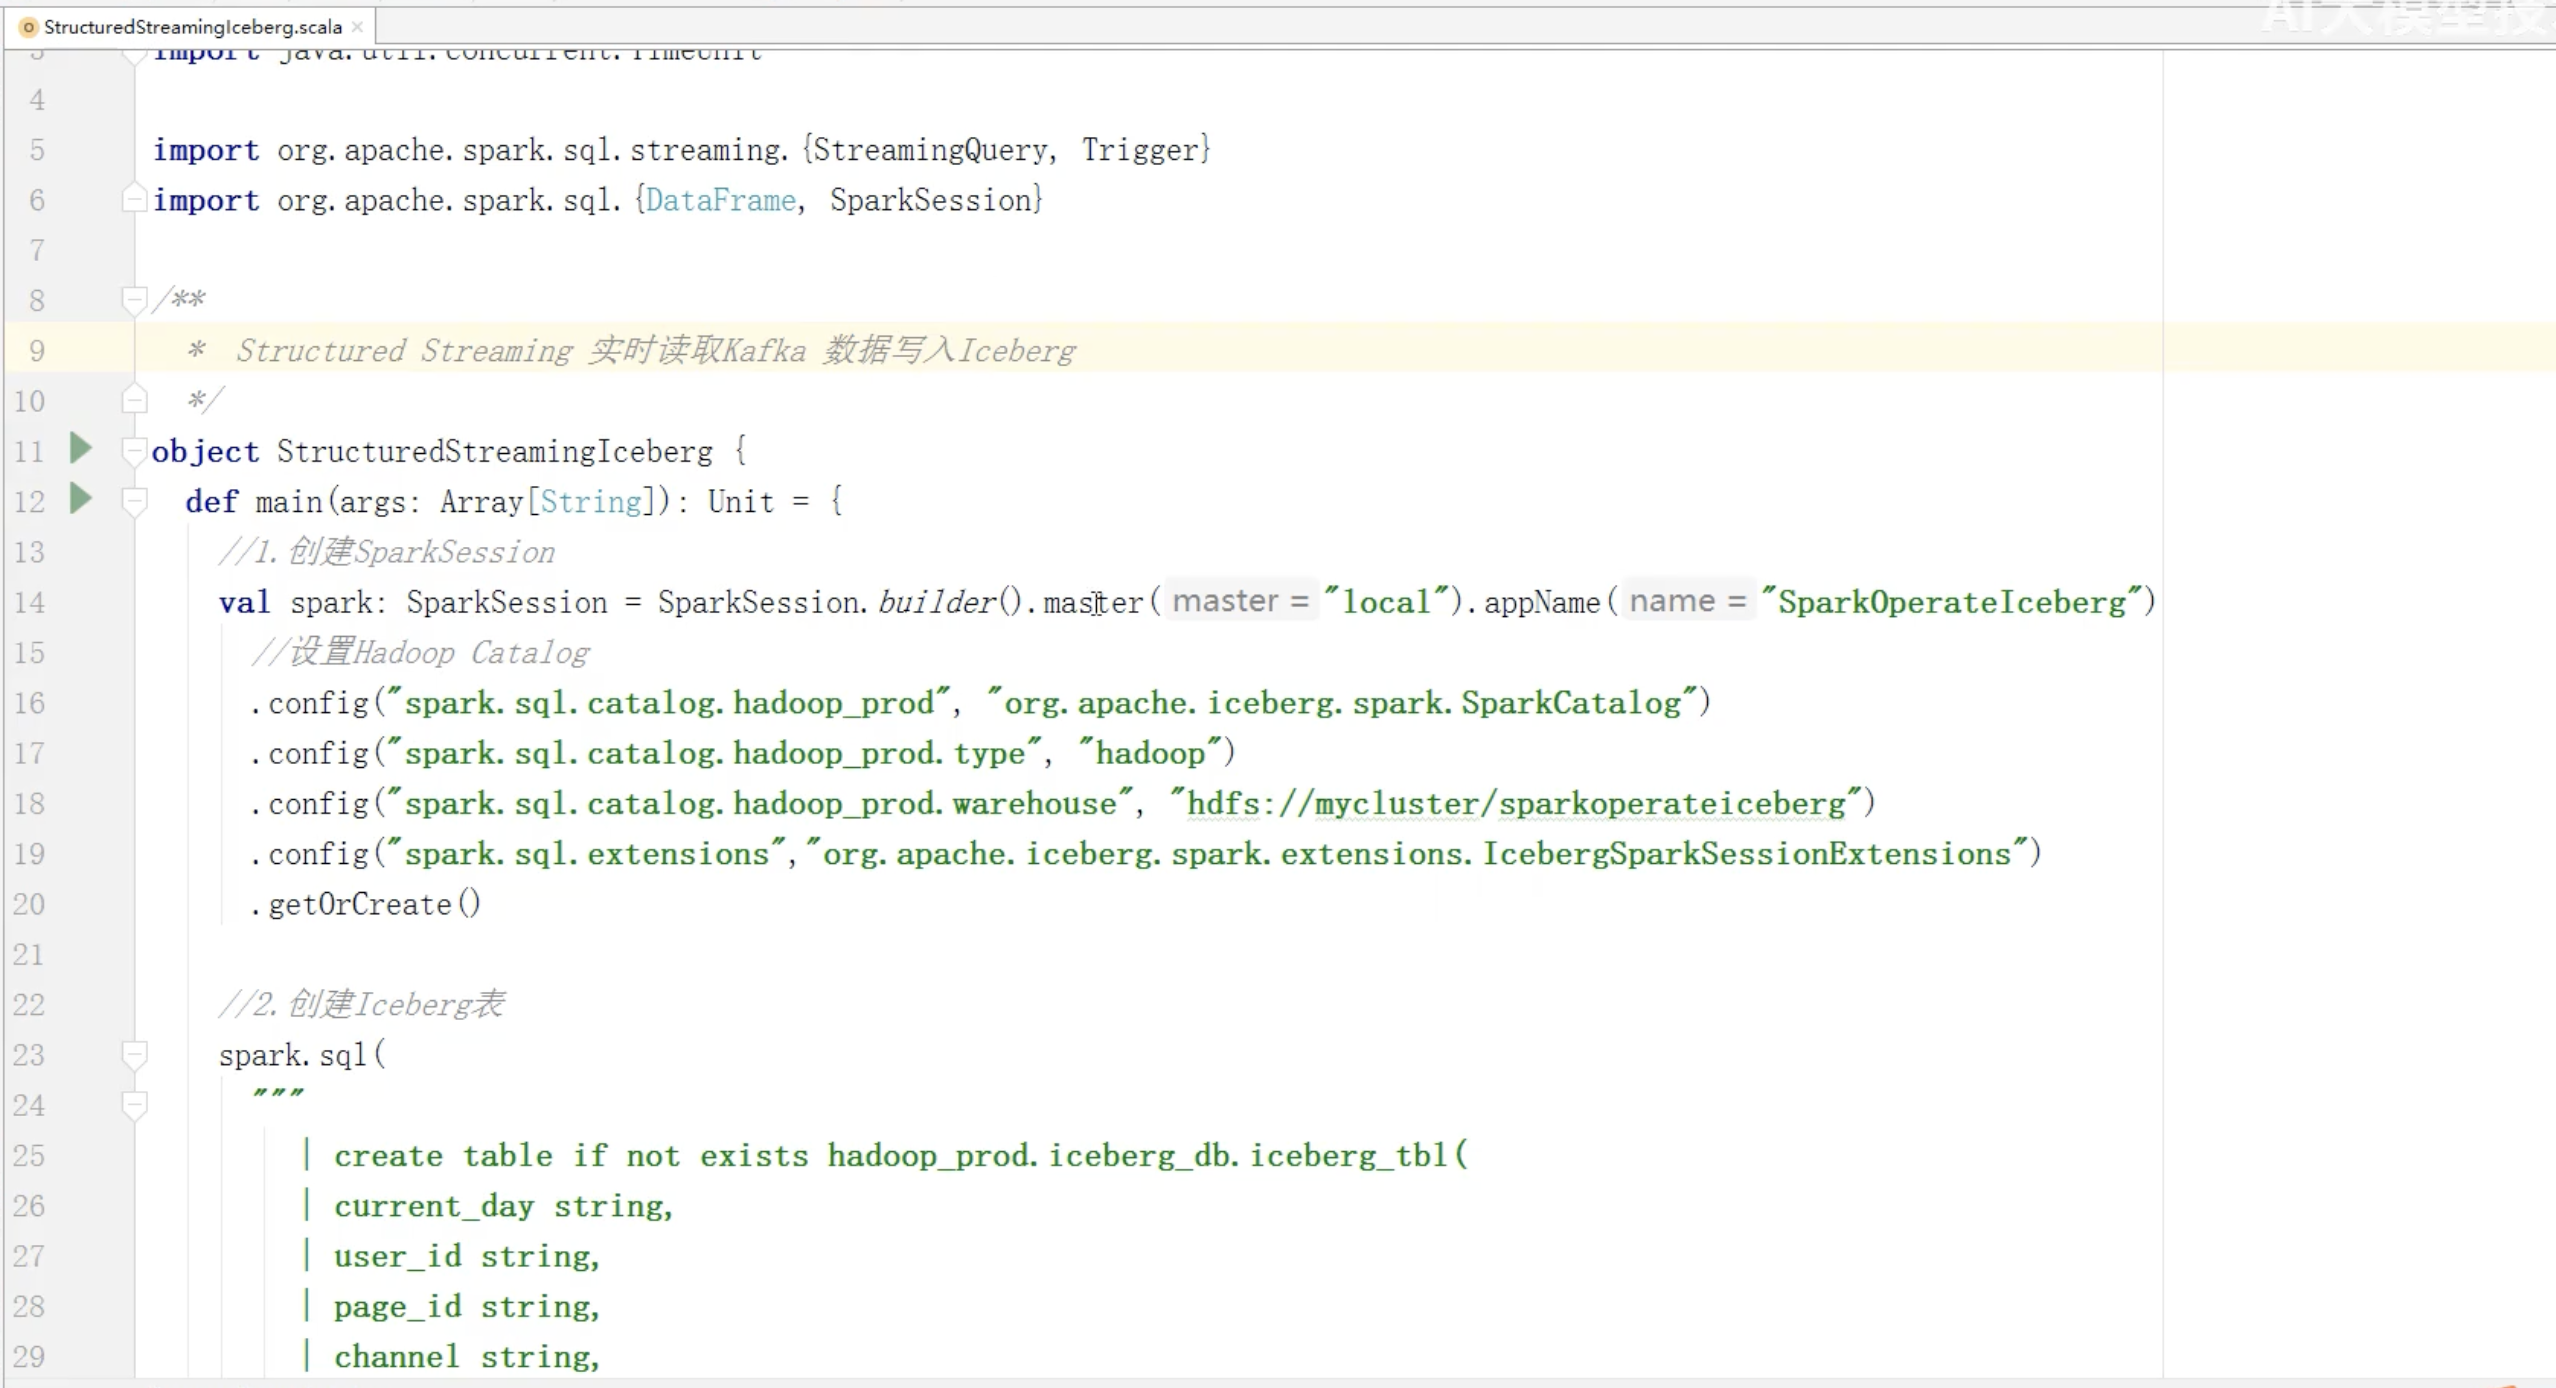
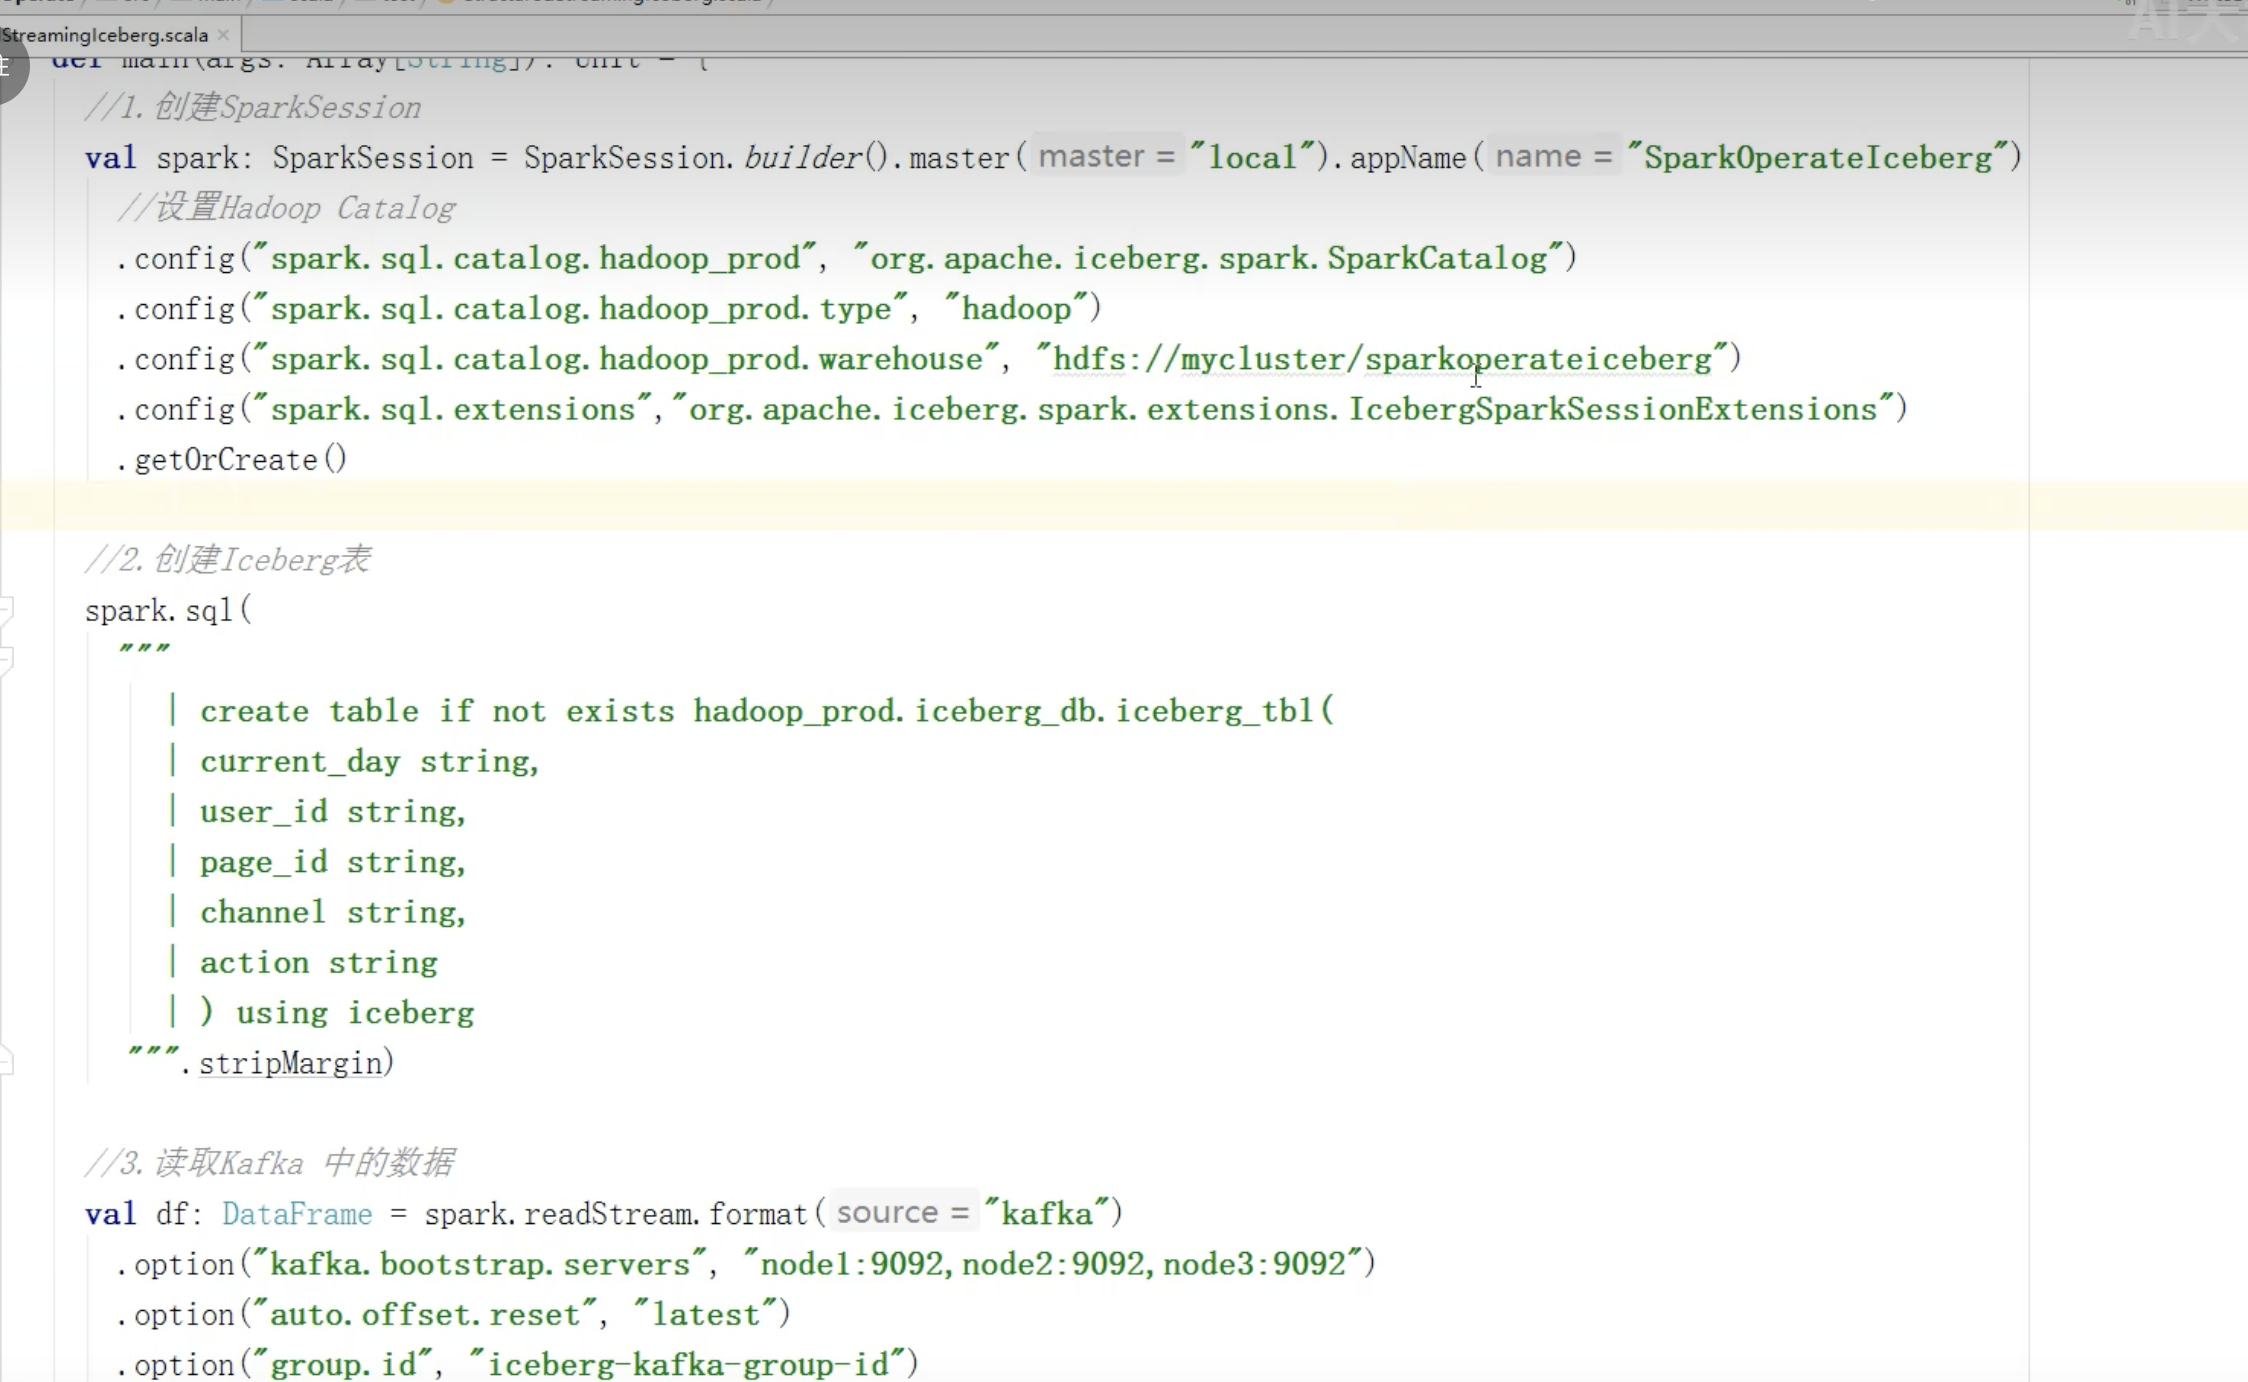
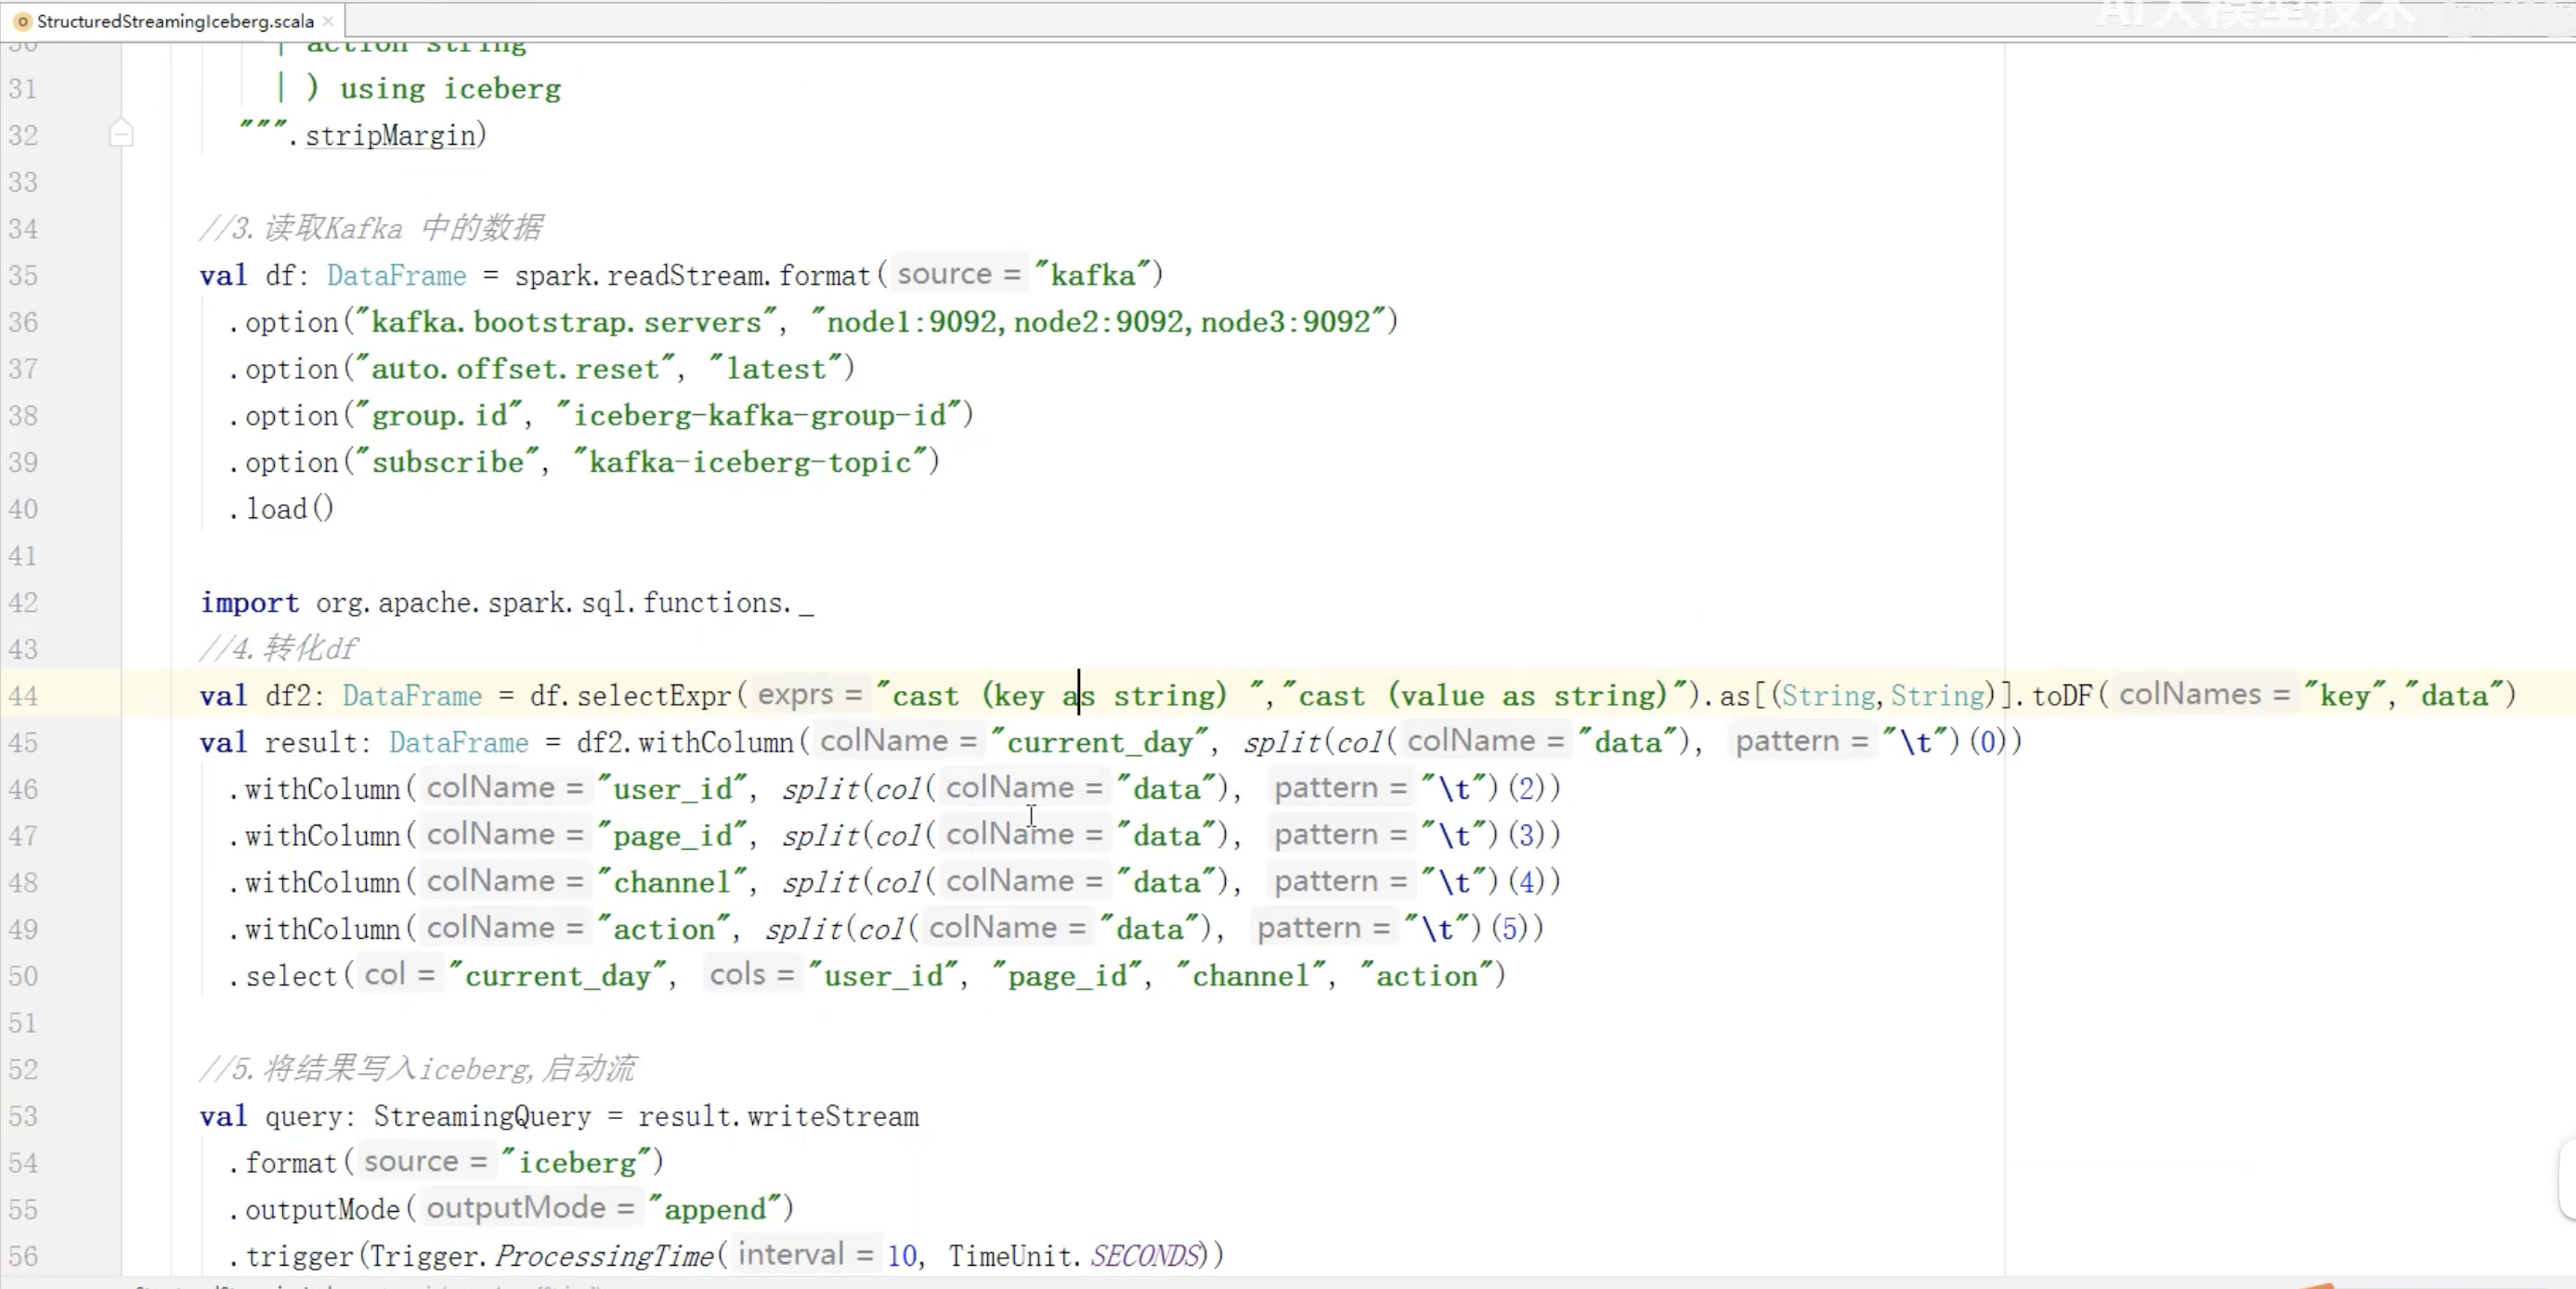
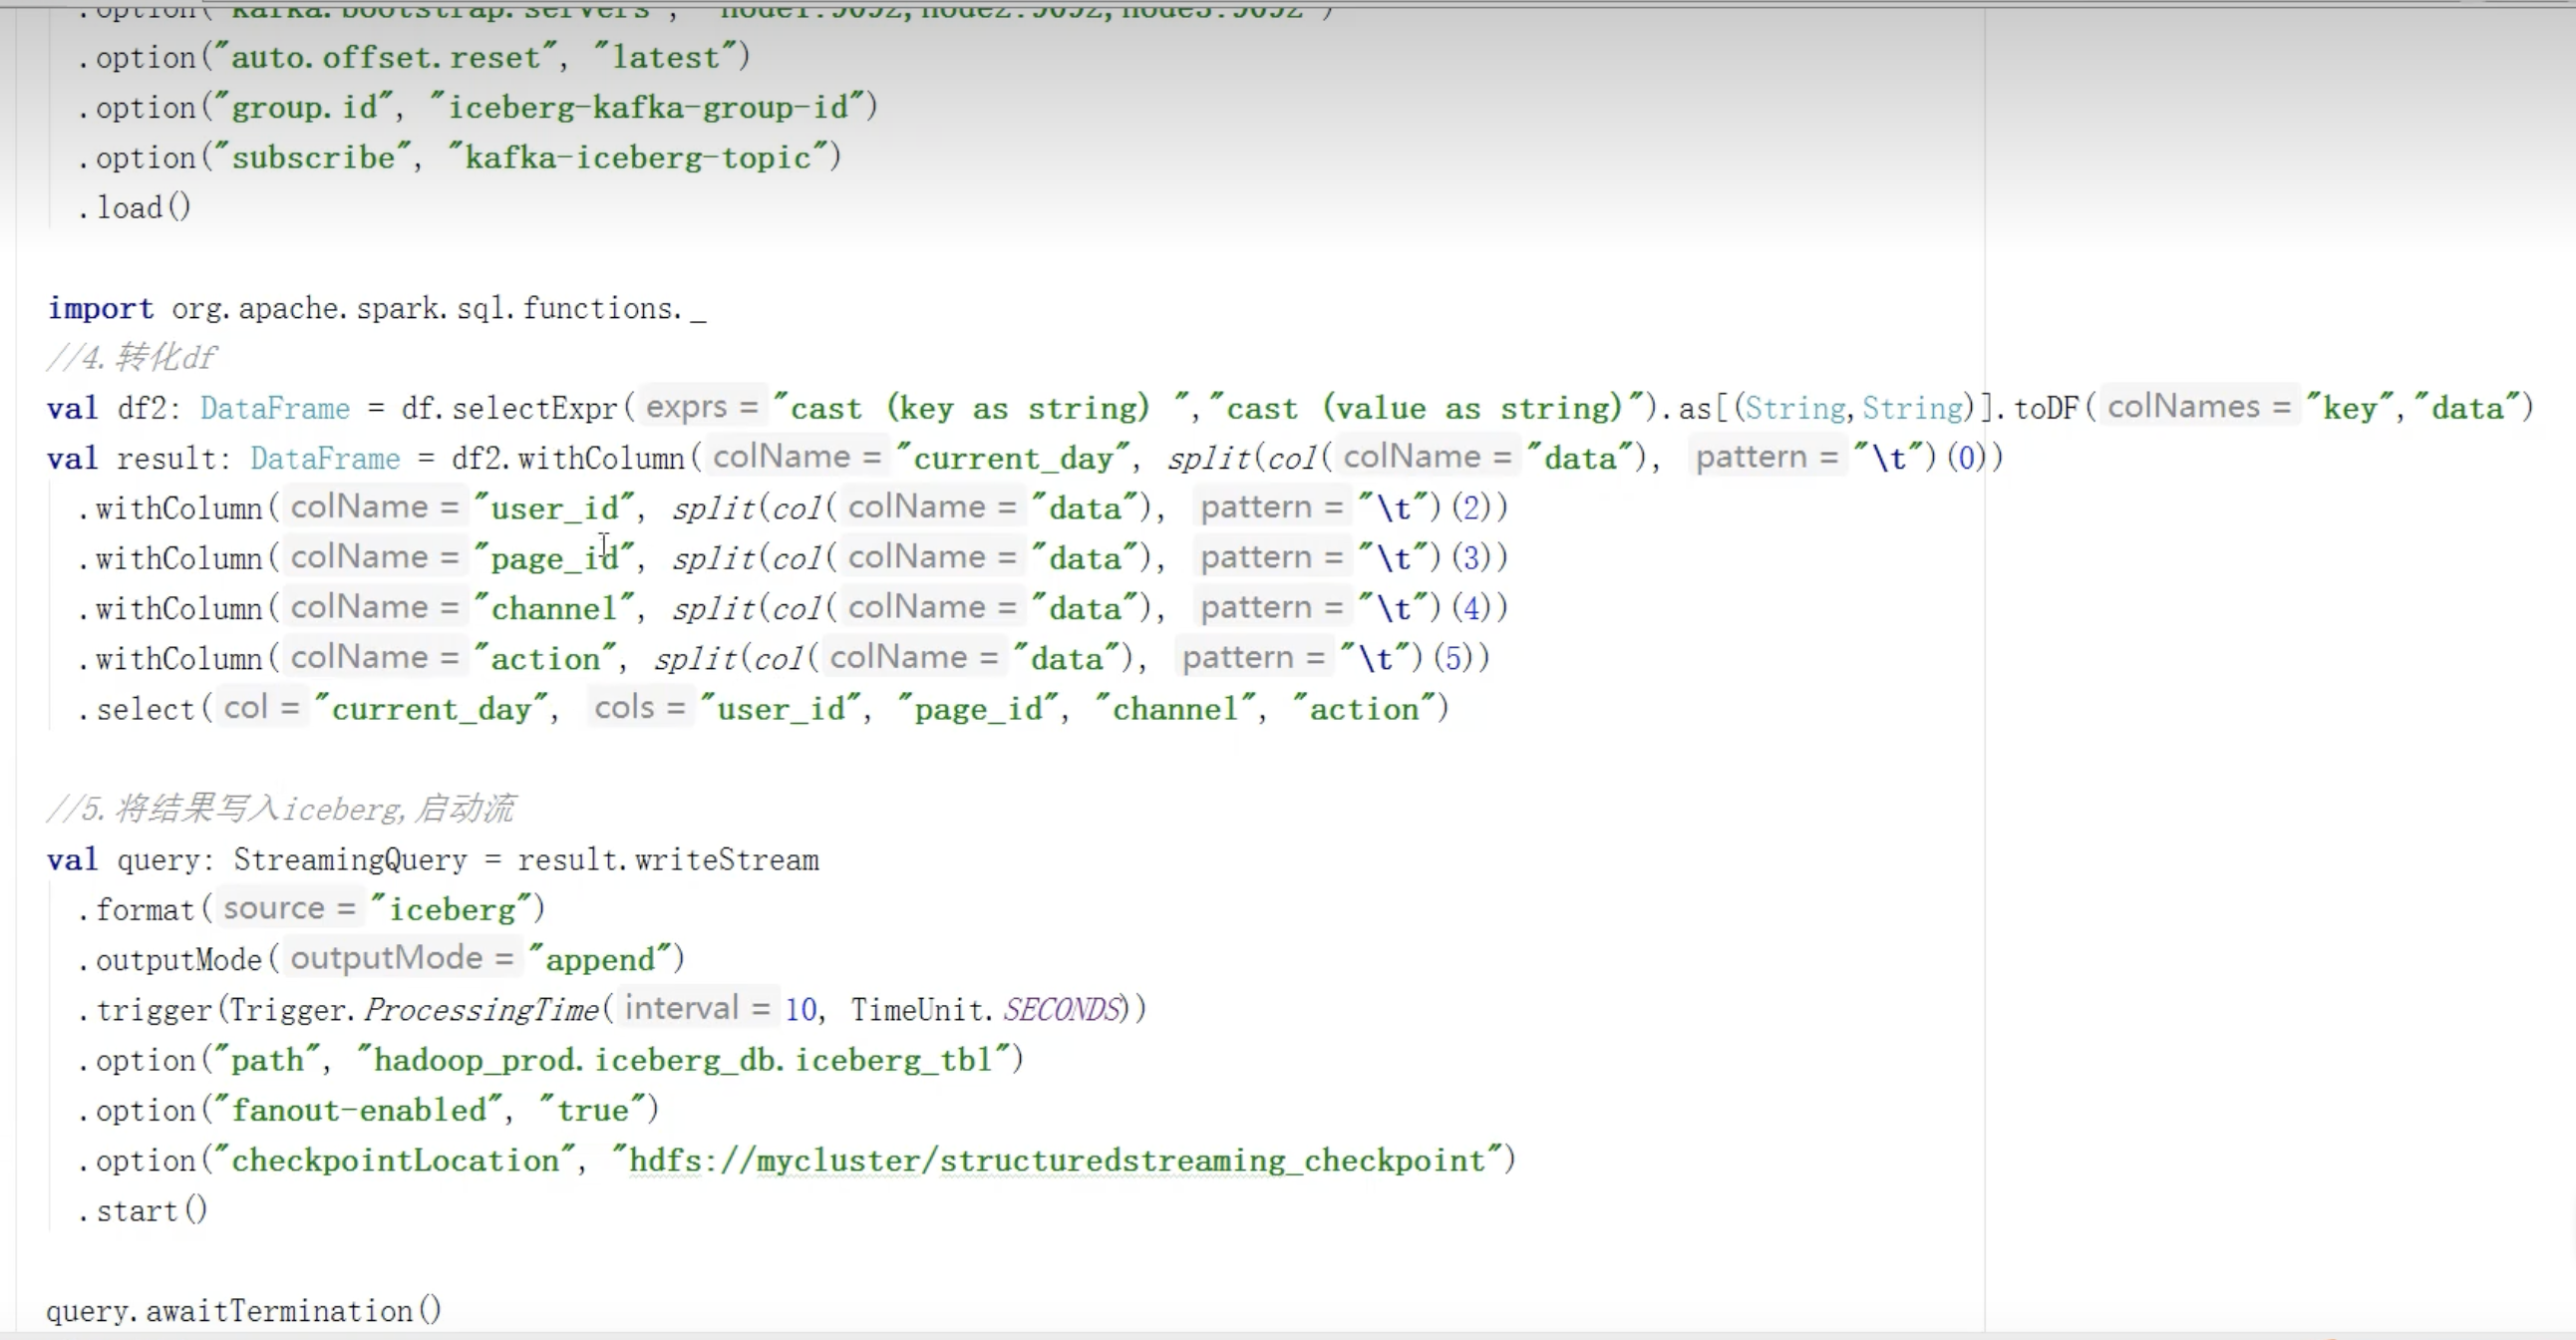
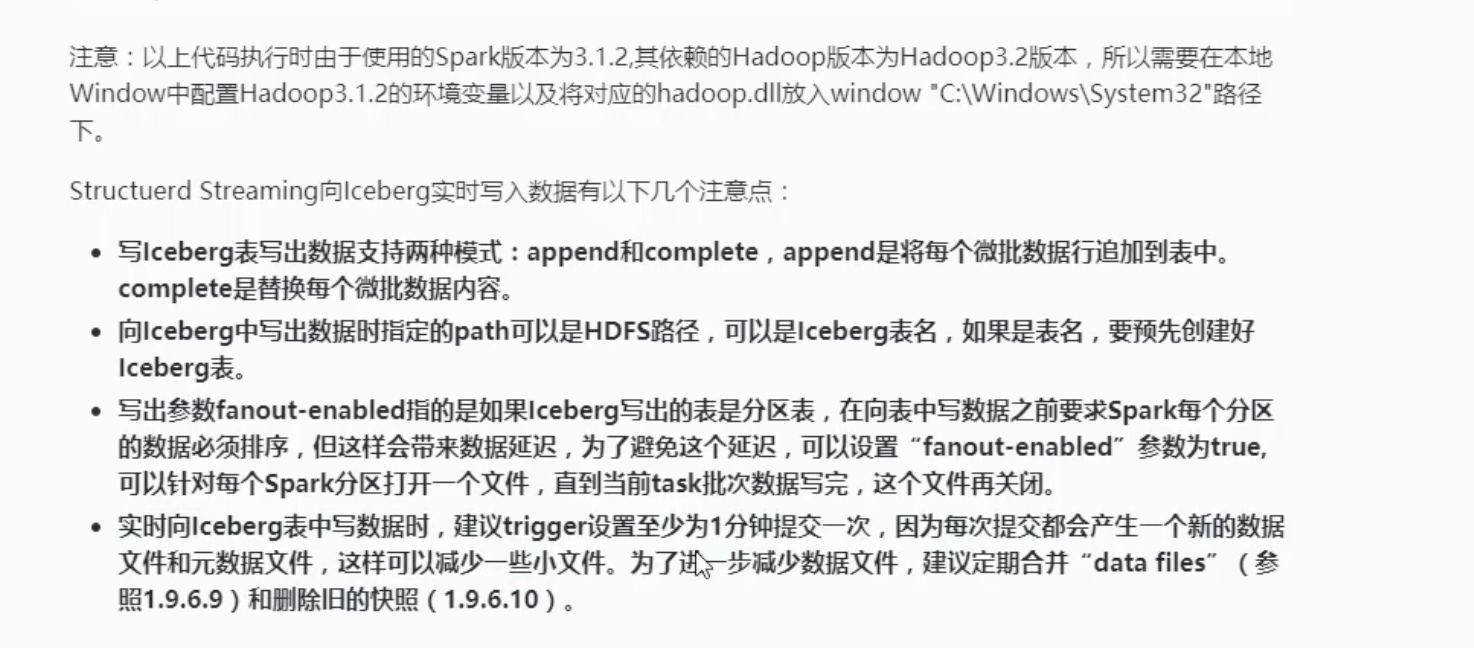
3.7.2 消费kafka数据并写入Iceberg表中
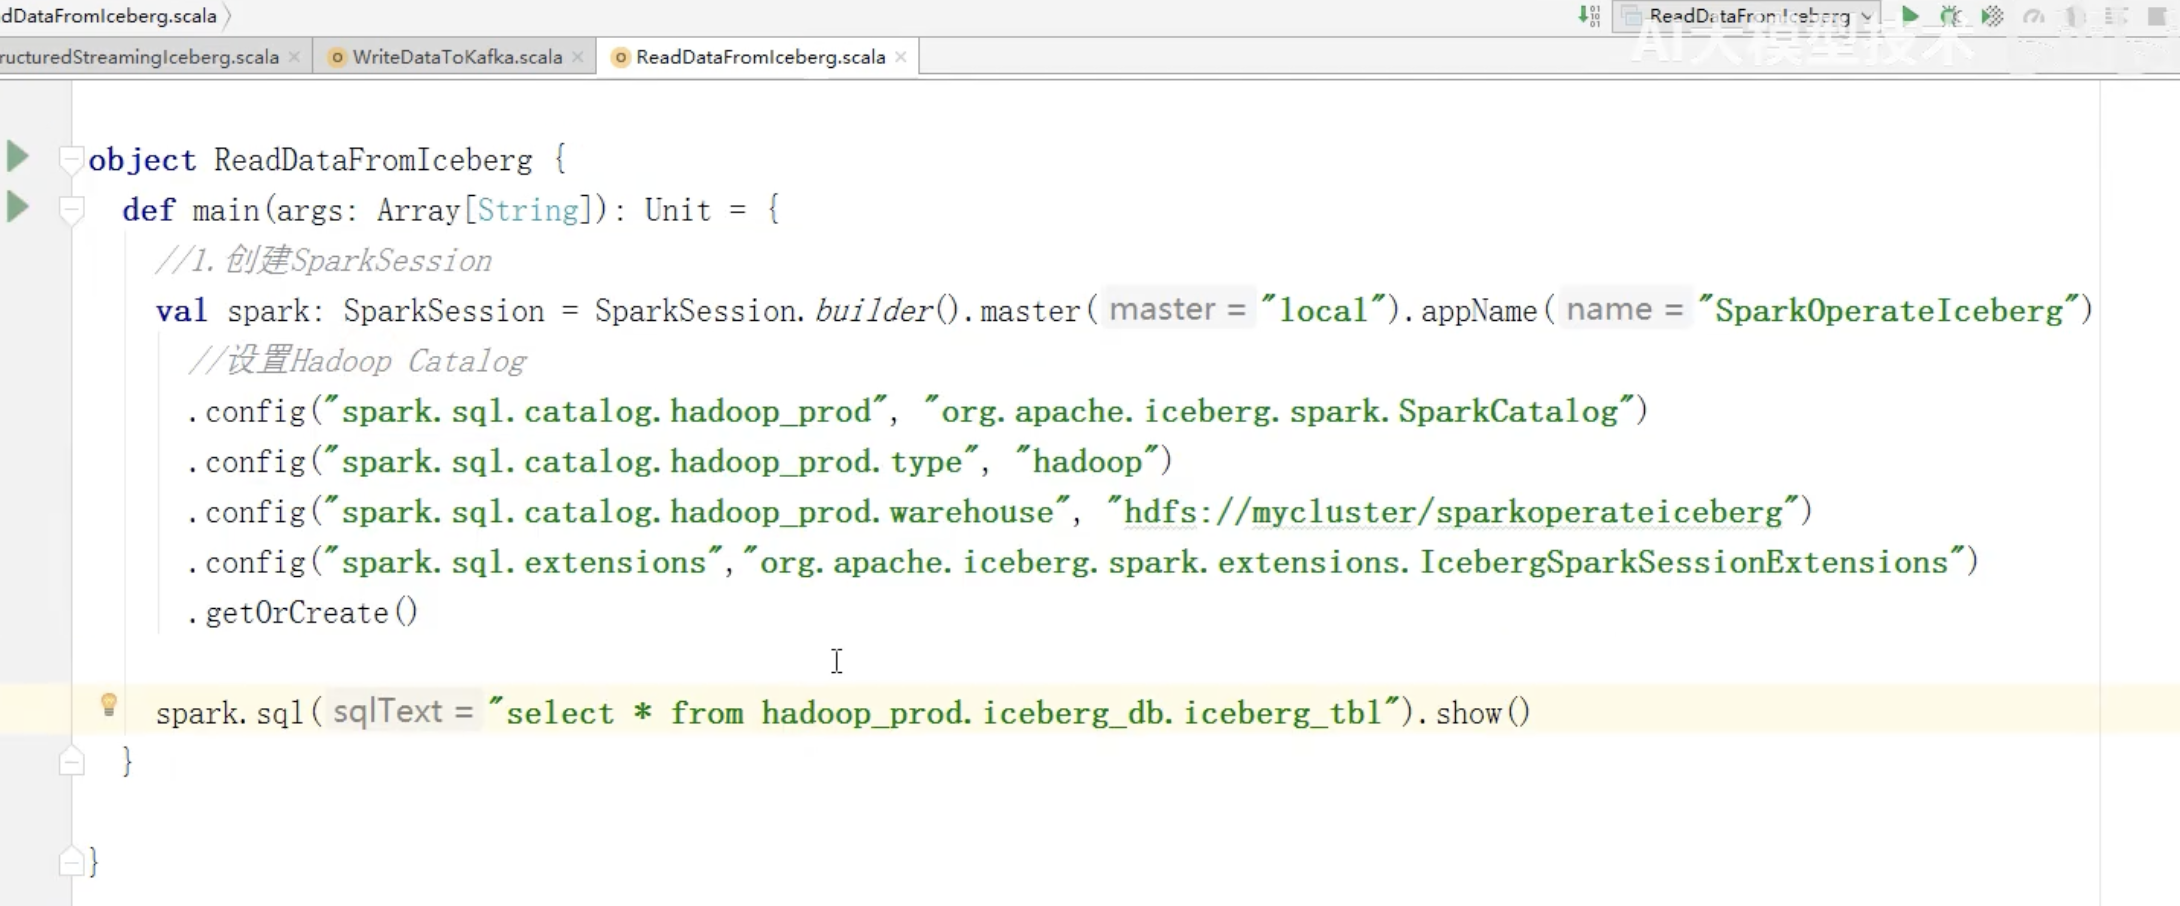
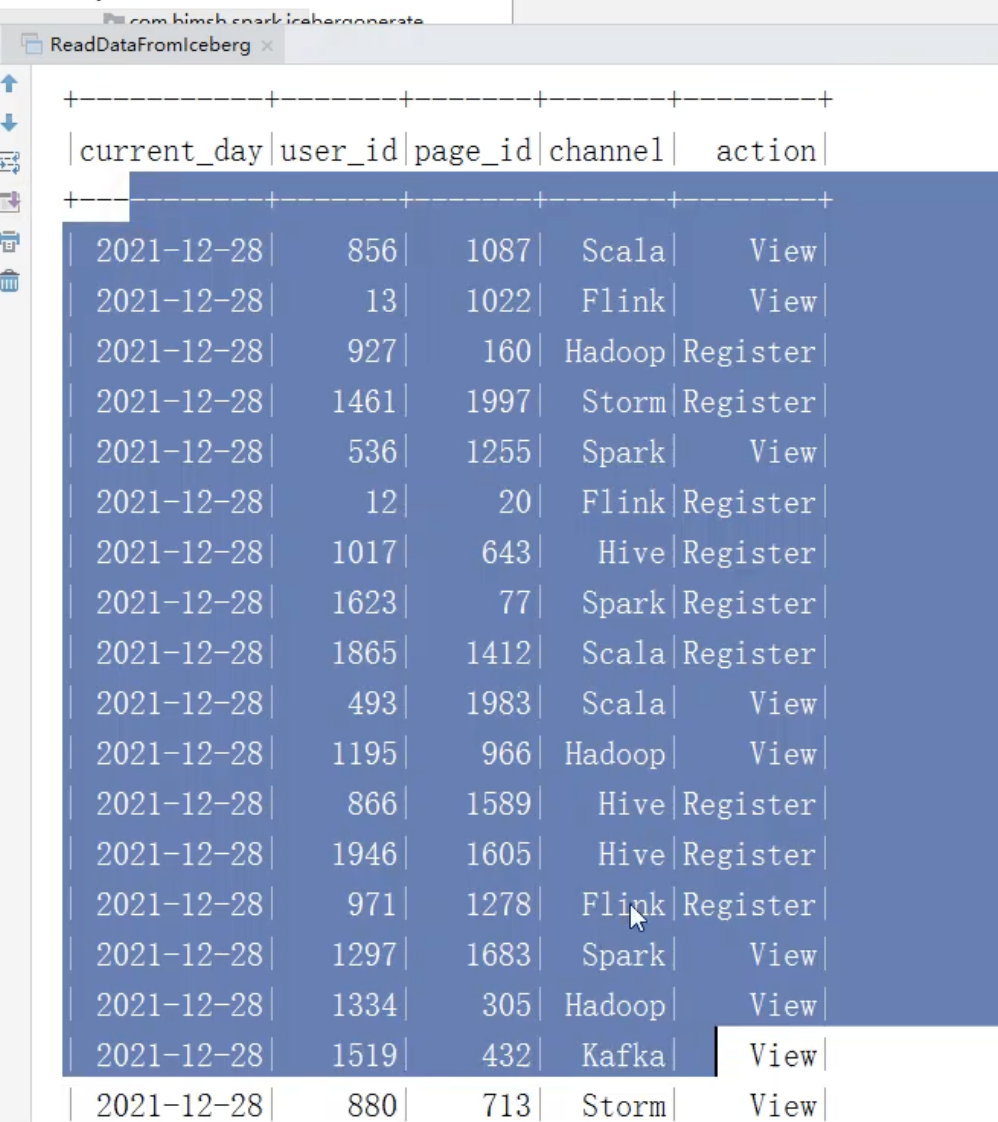
3.7.3 从Iceberg读取数据
四、Flink与Iceberg整合
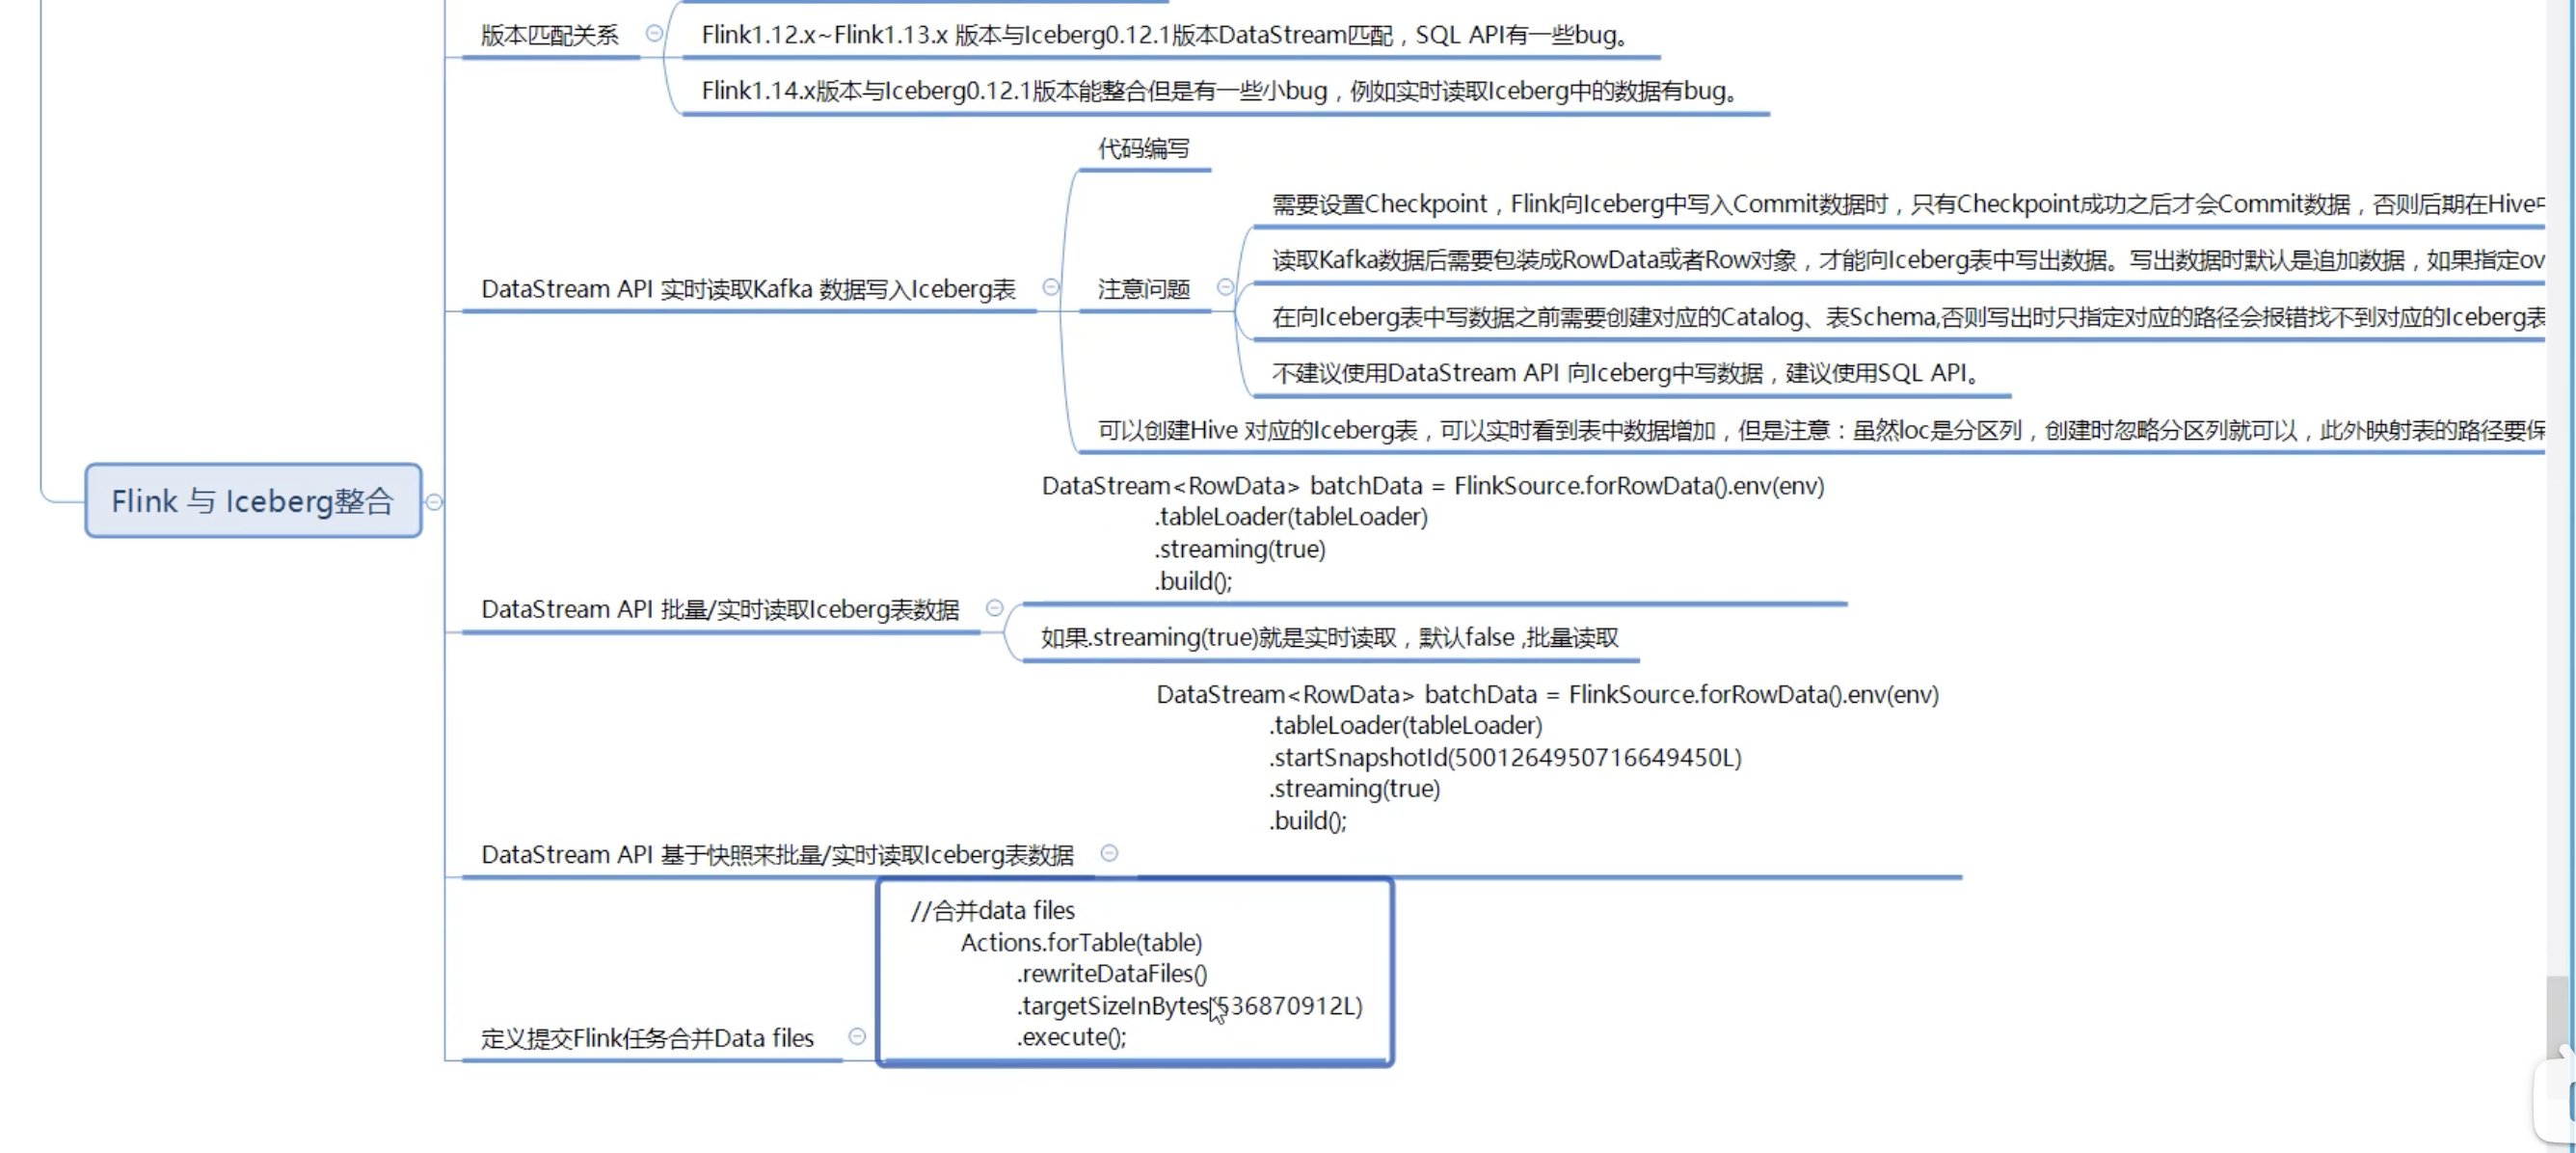
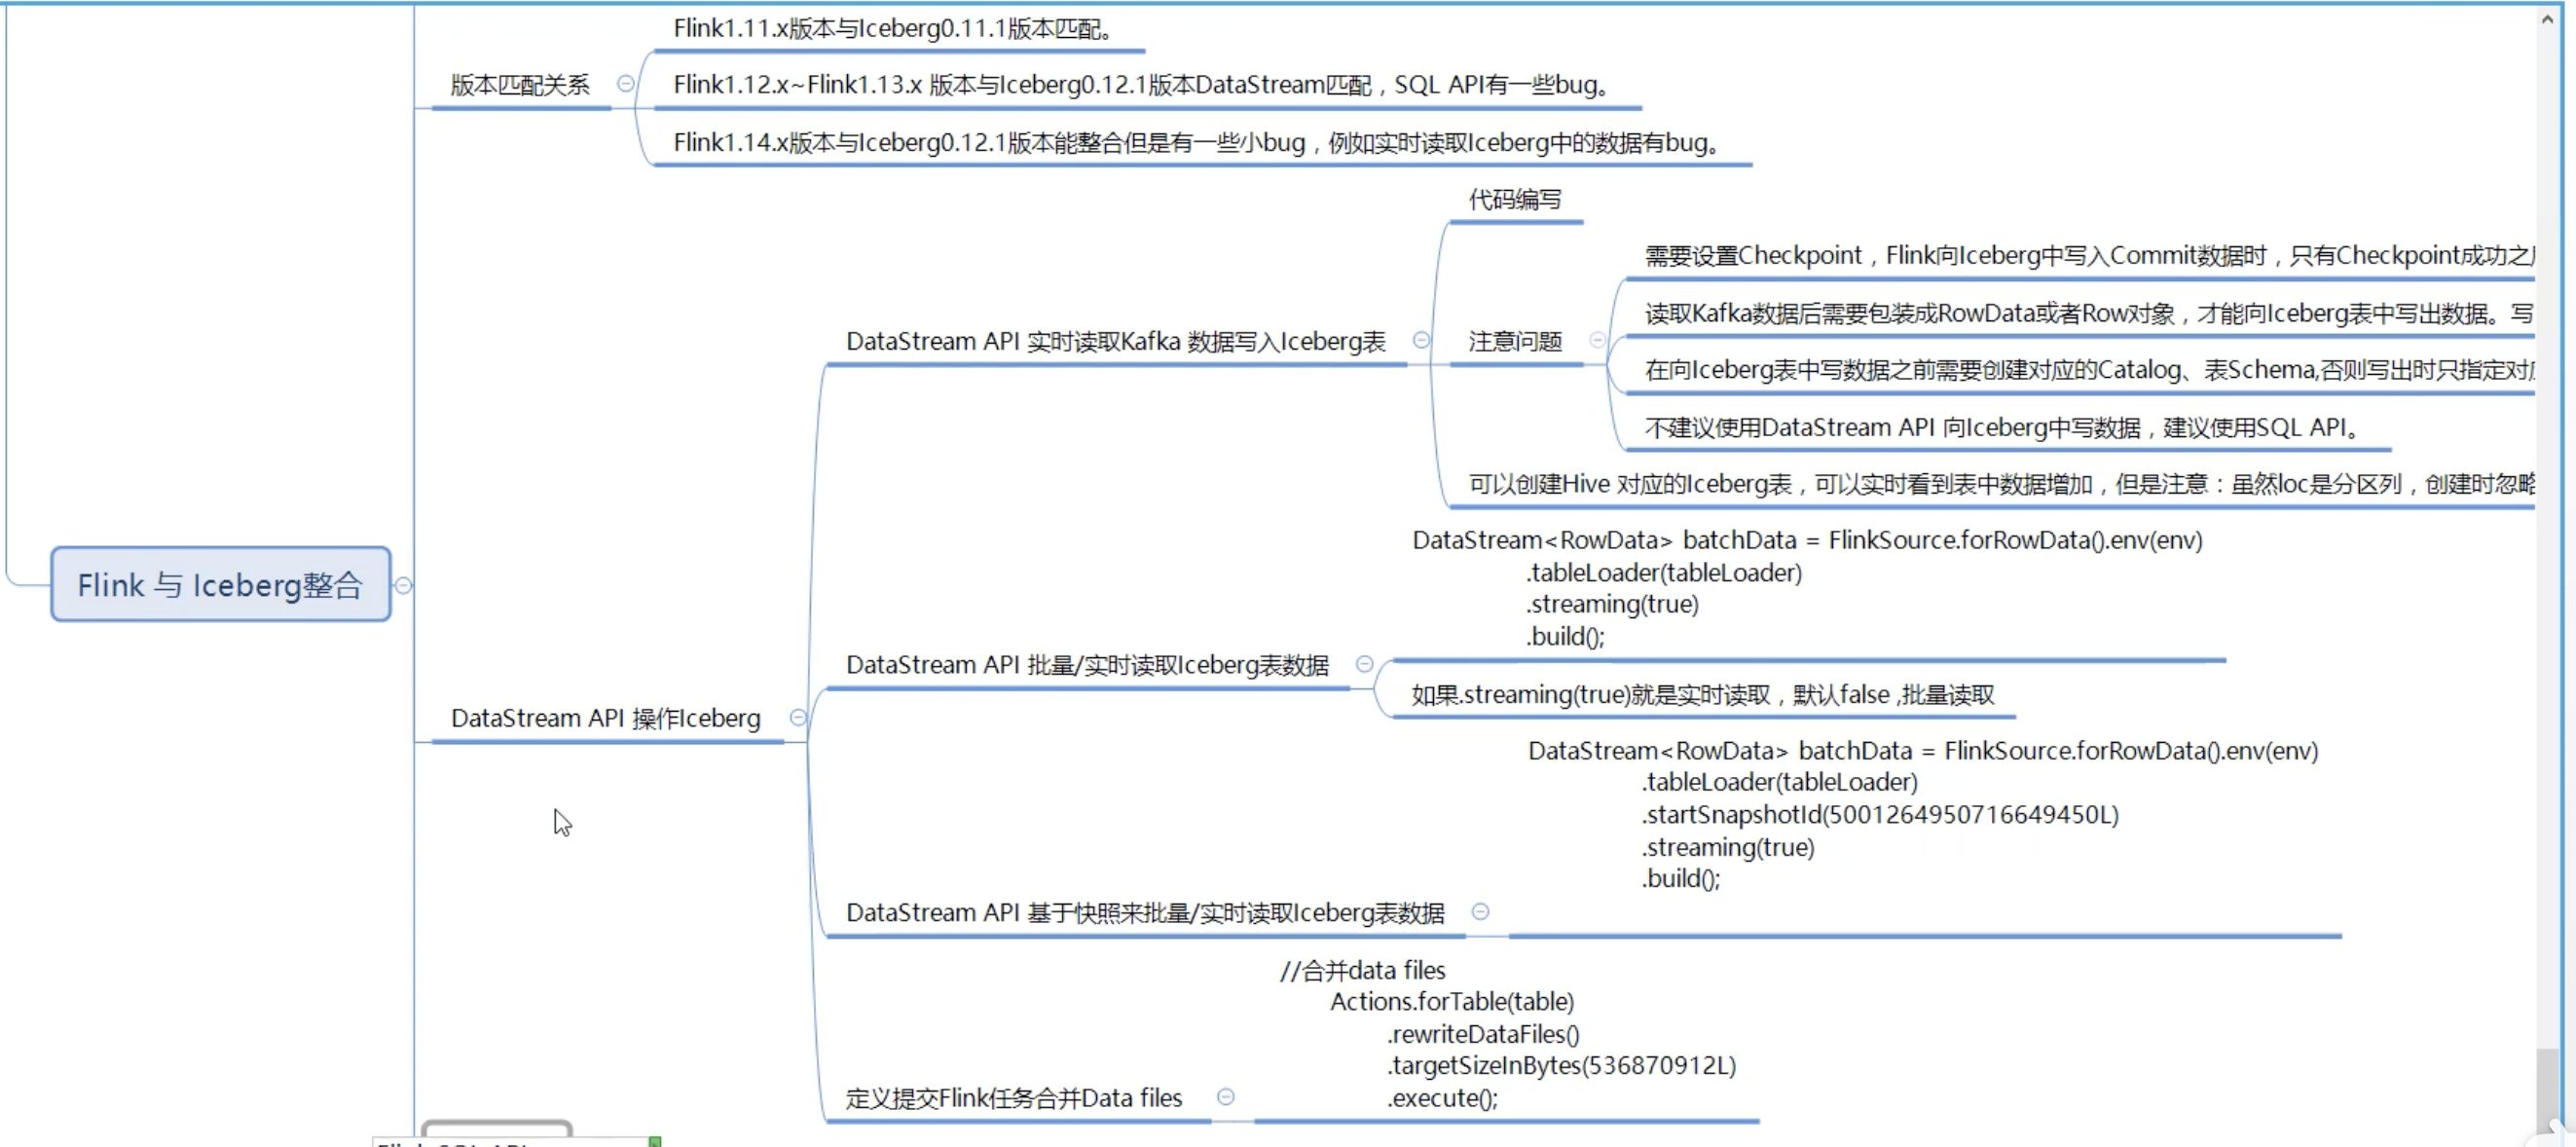
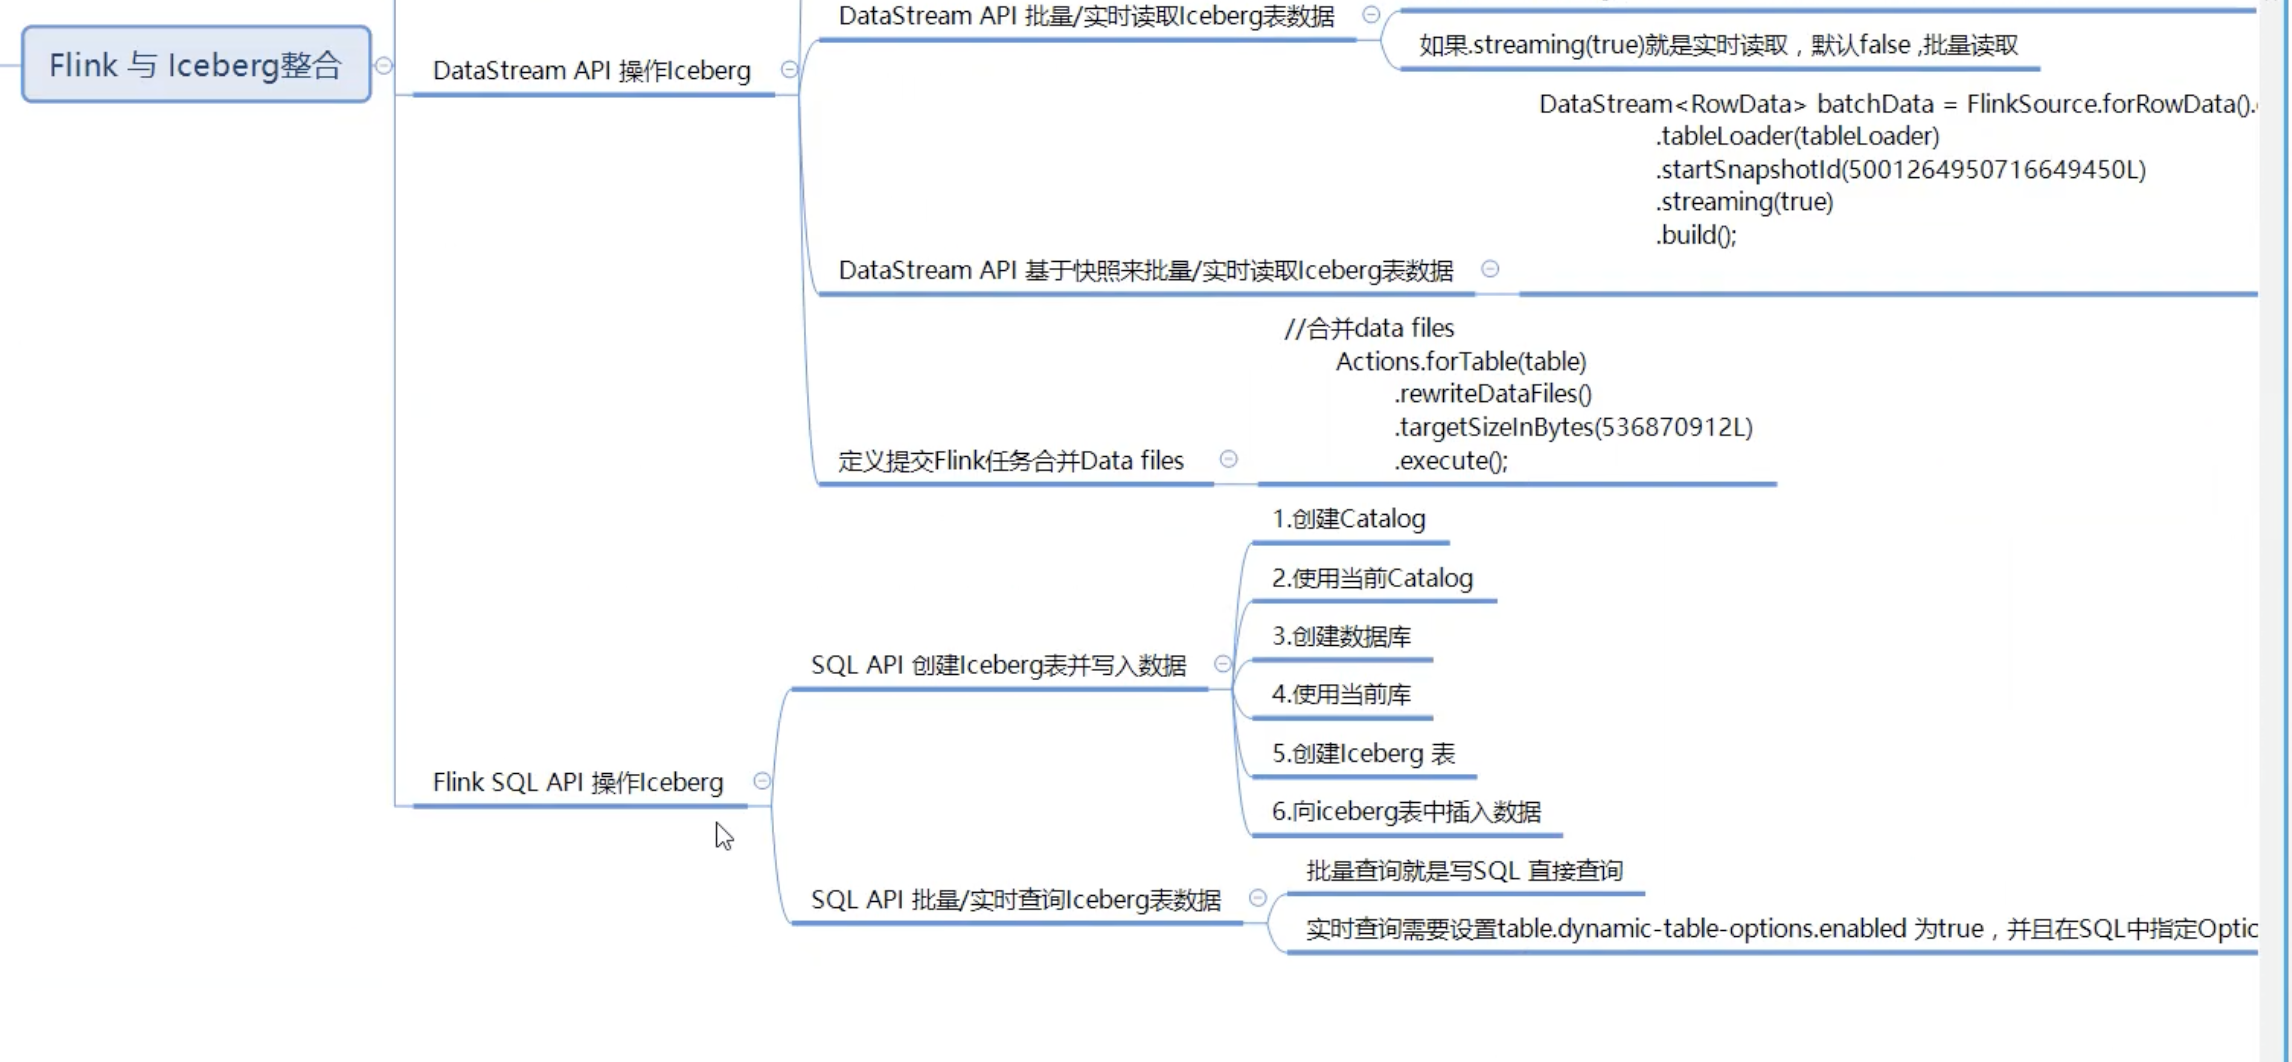
4.1 DataStreamAPI操作Iceberg
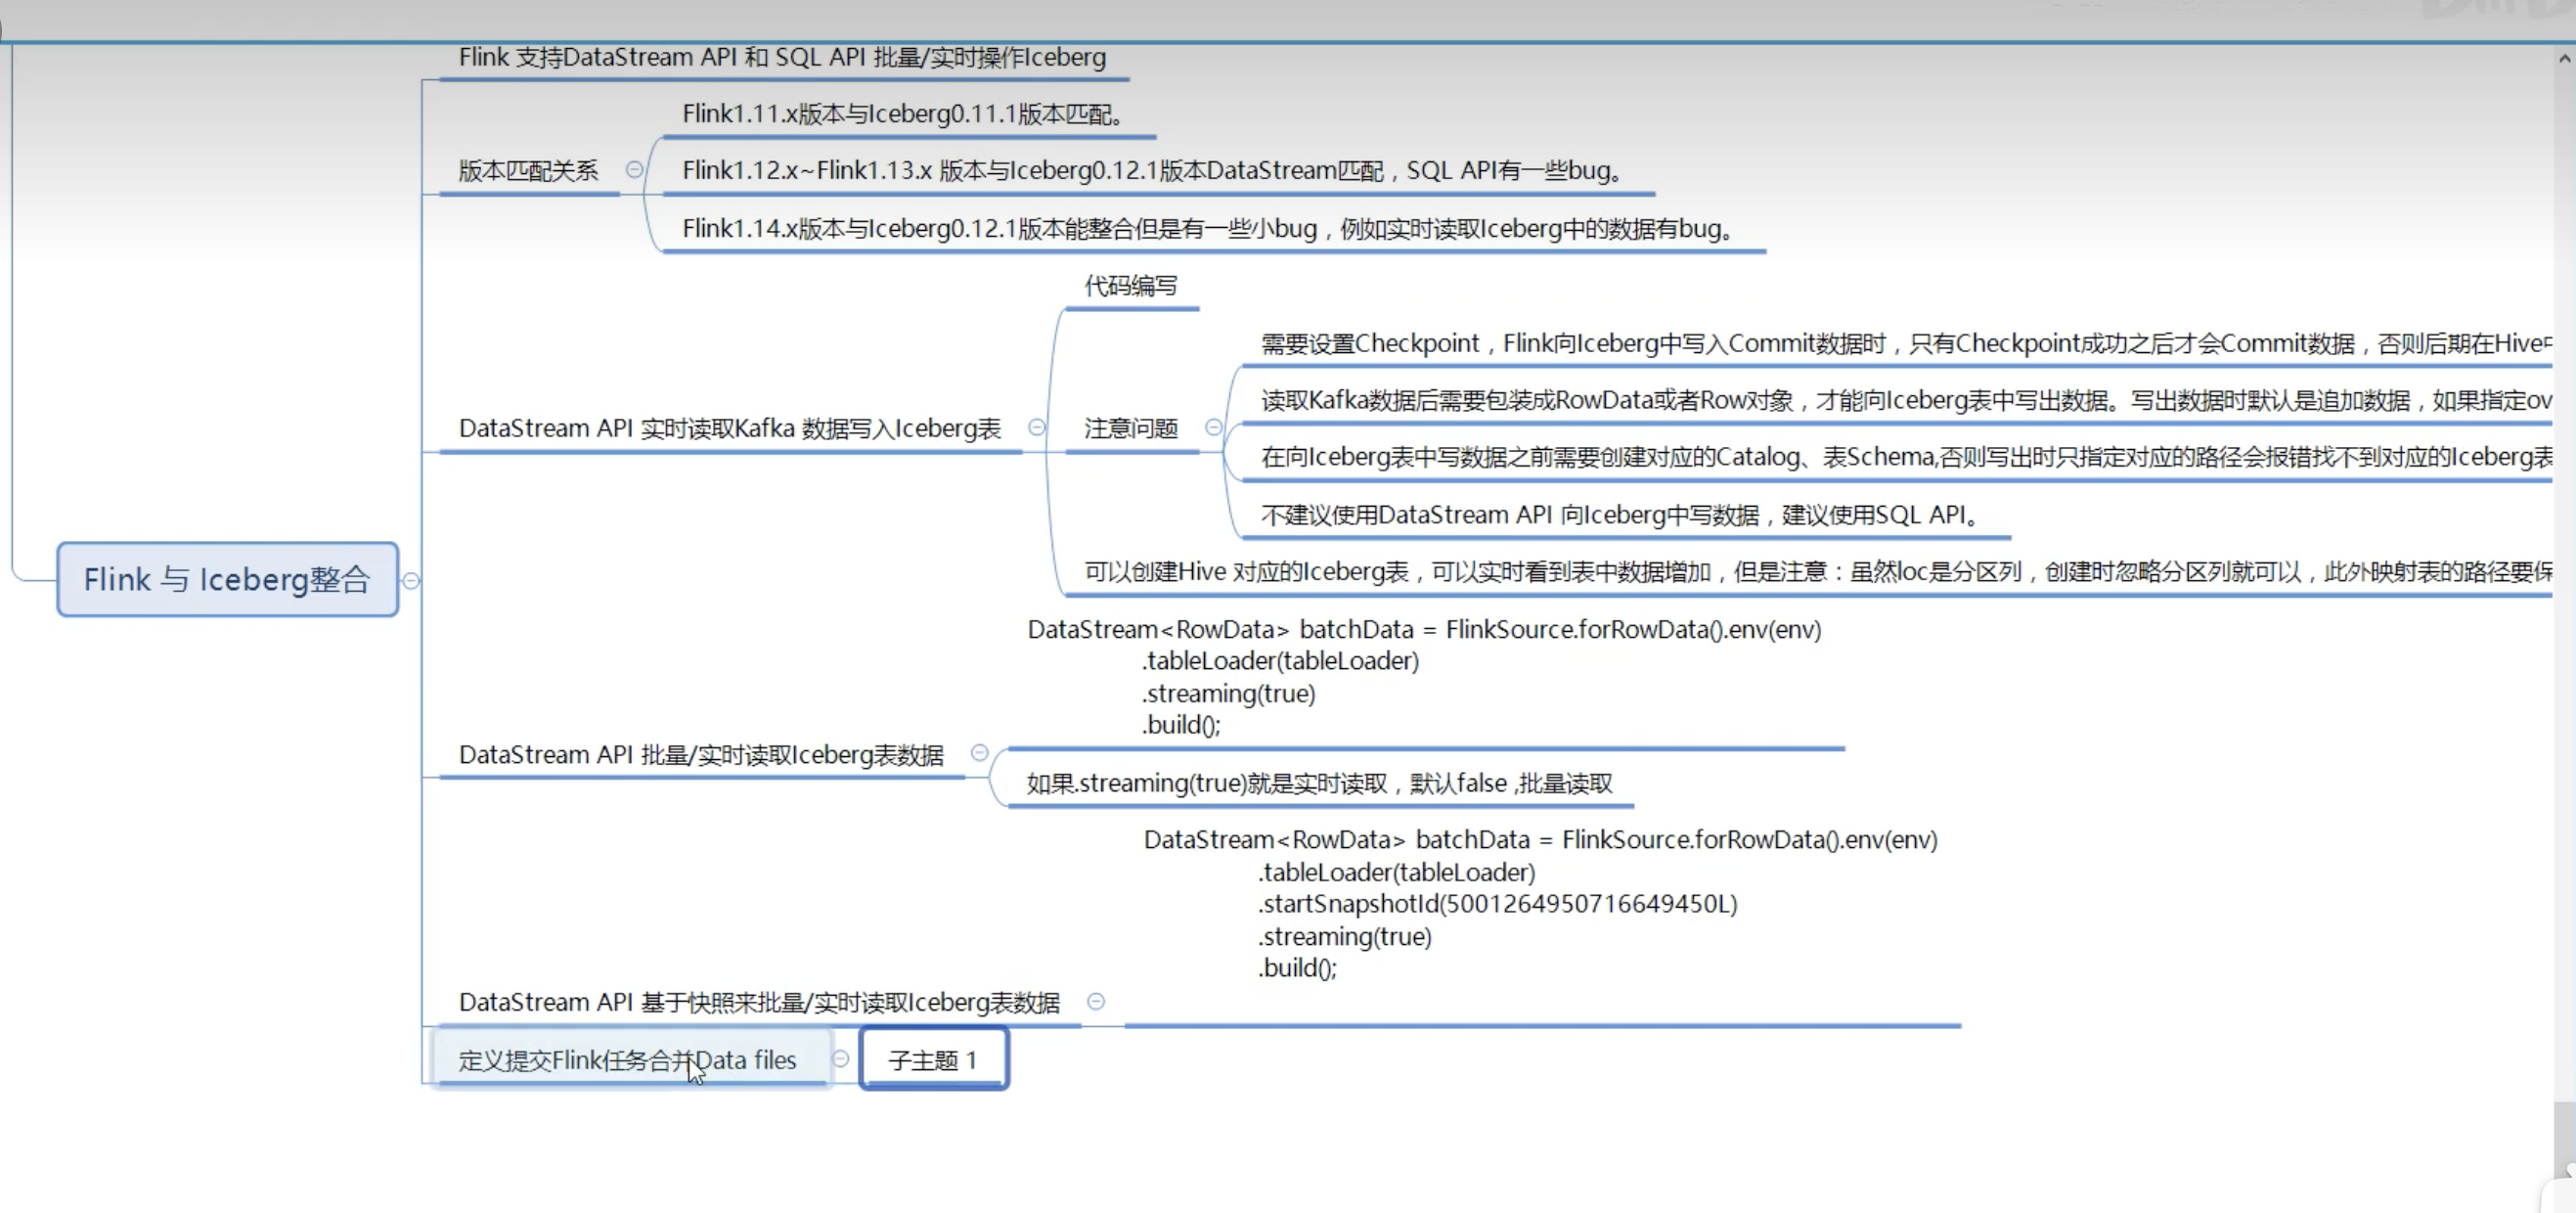
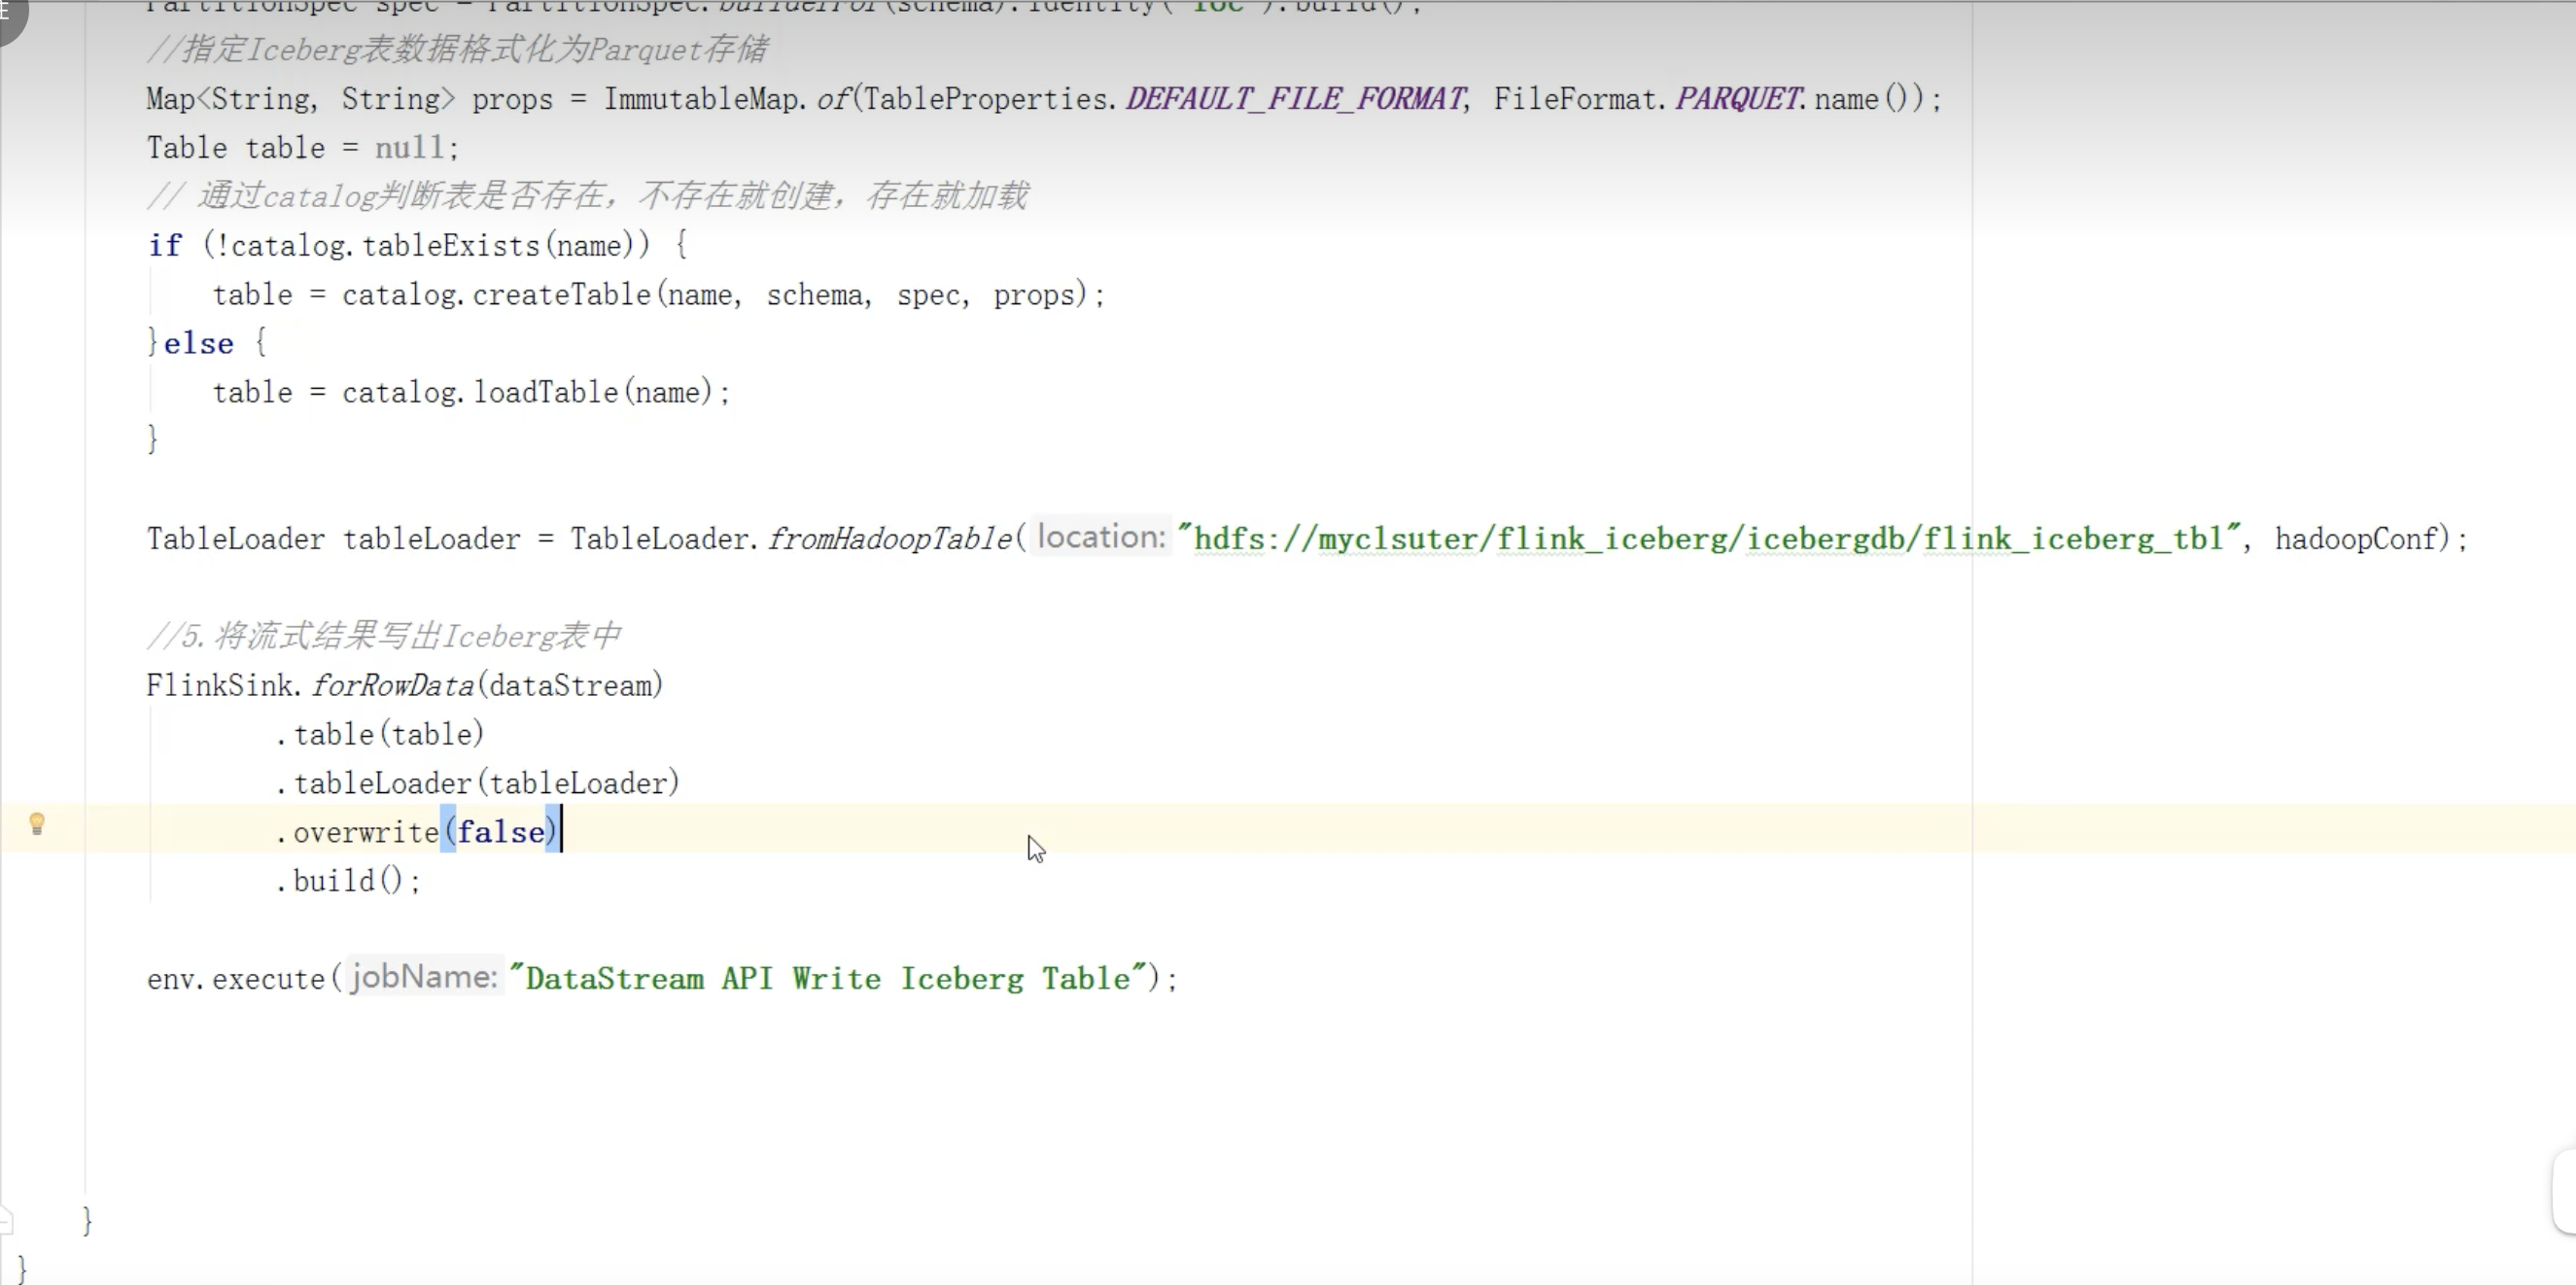
4.1.1 读取Kafka数据,单表写入Iceberg
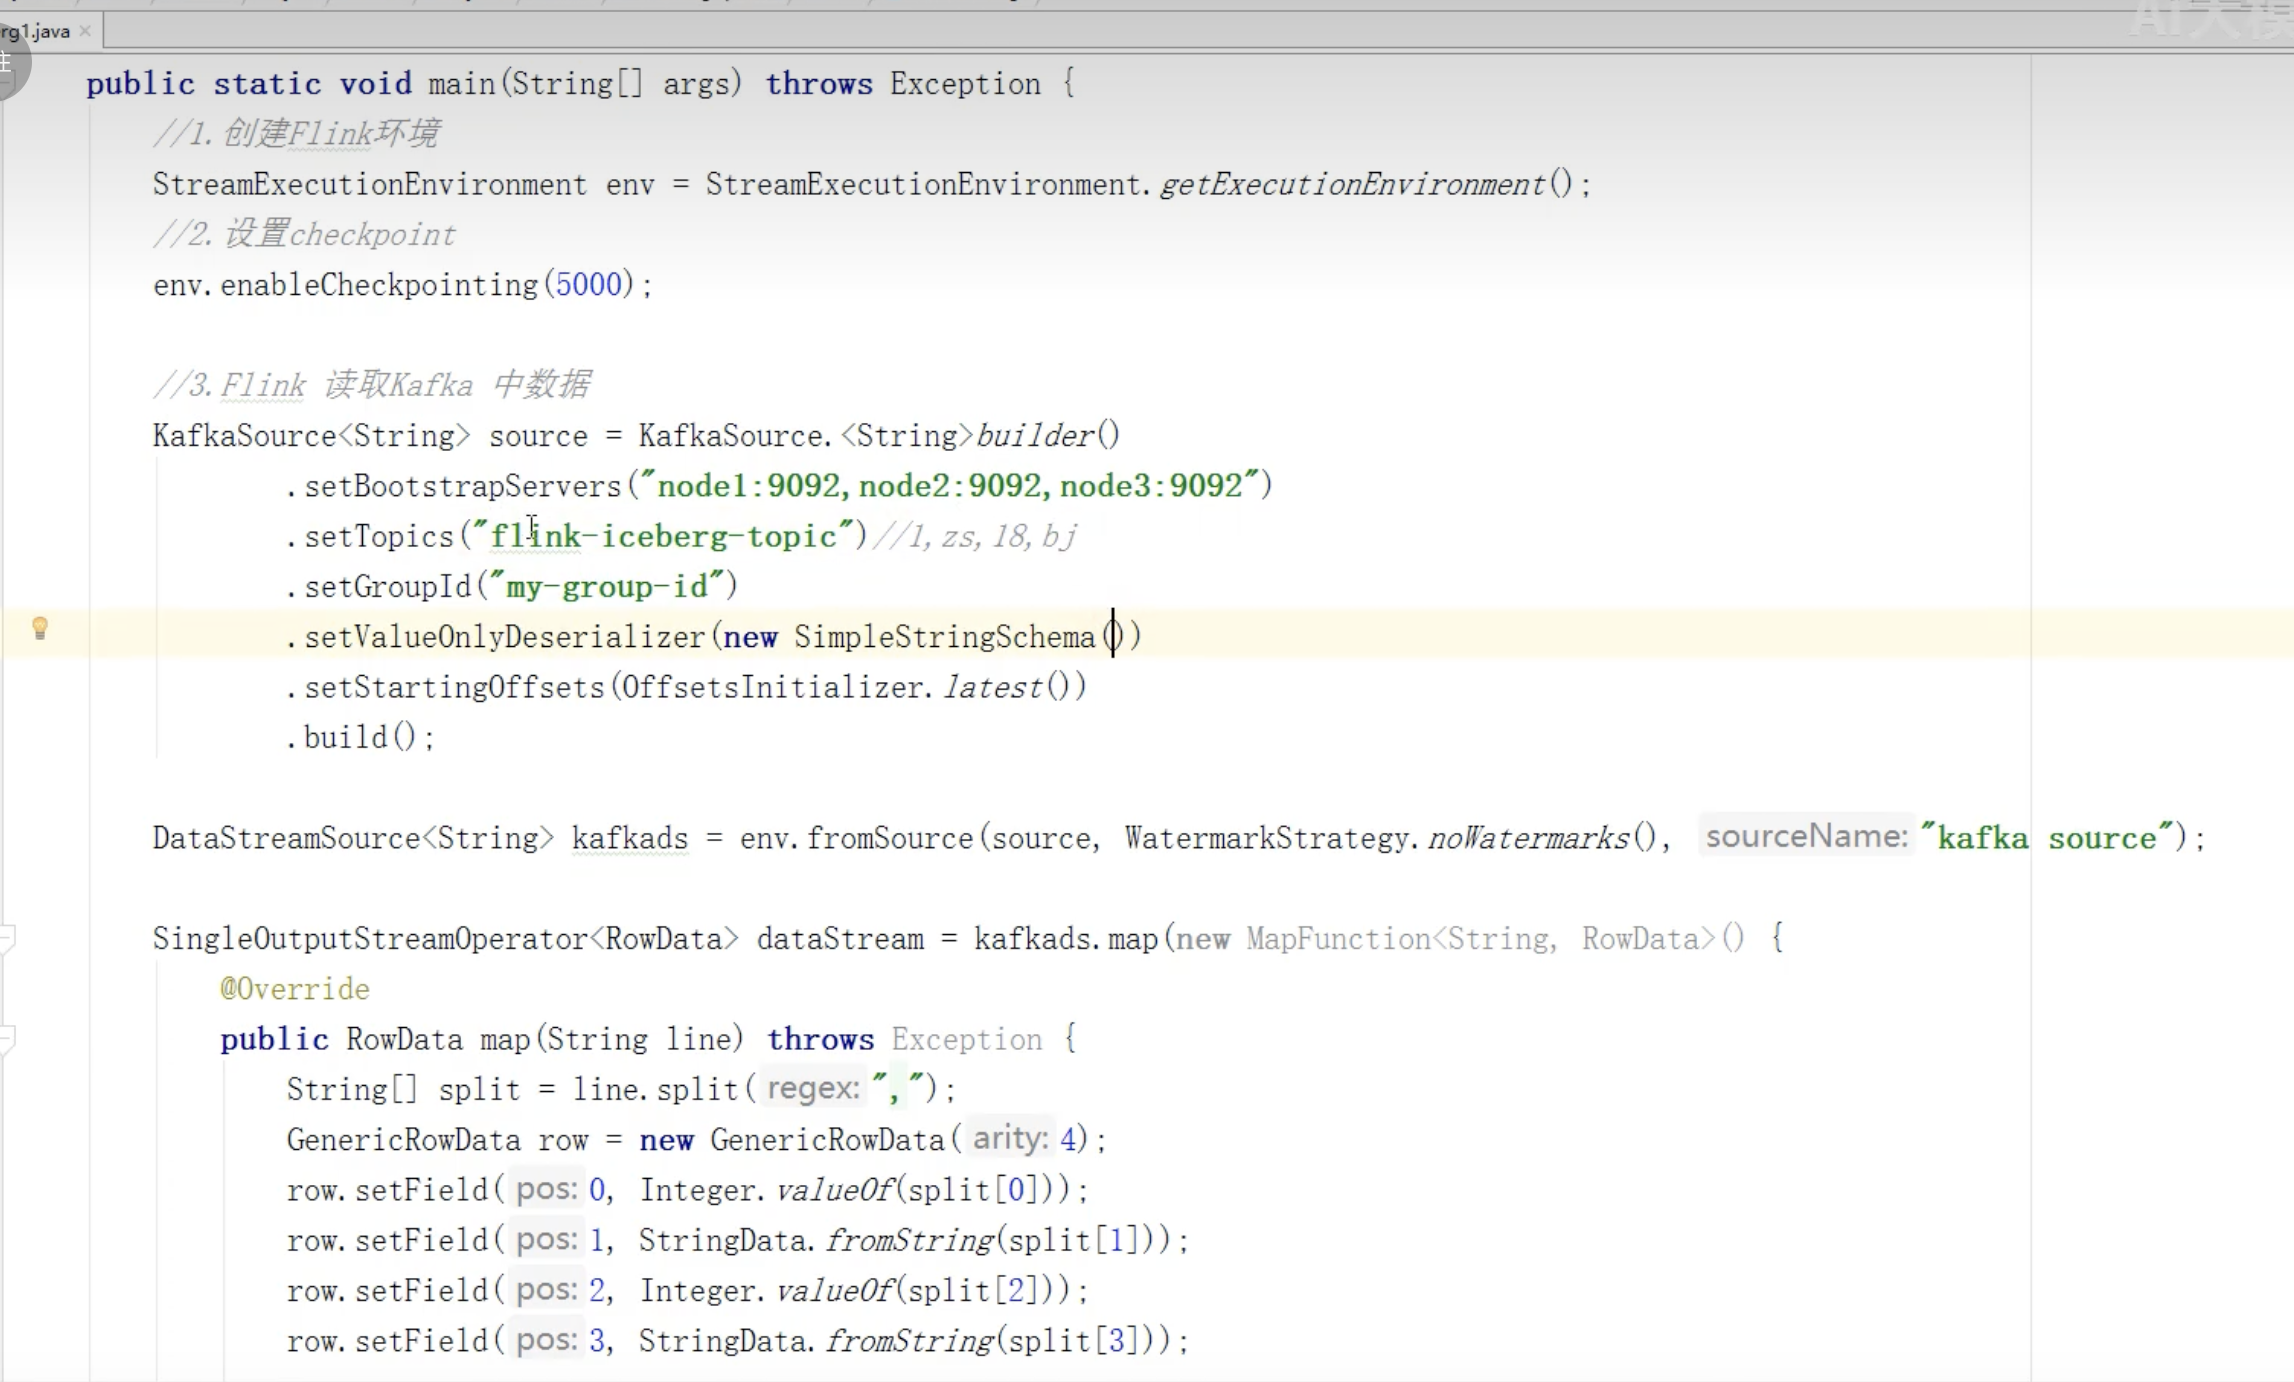
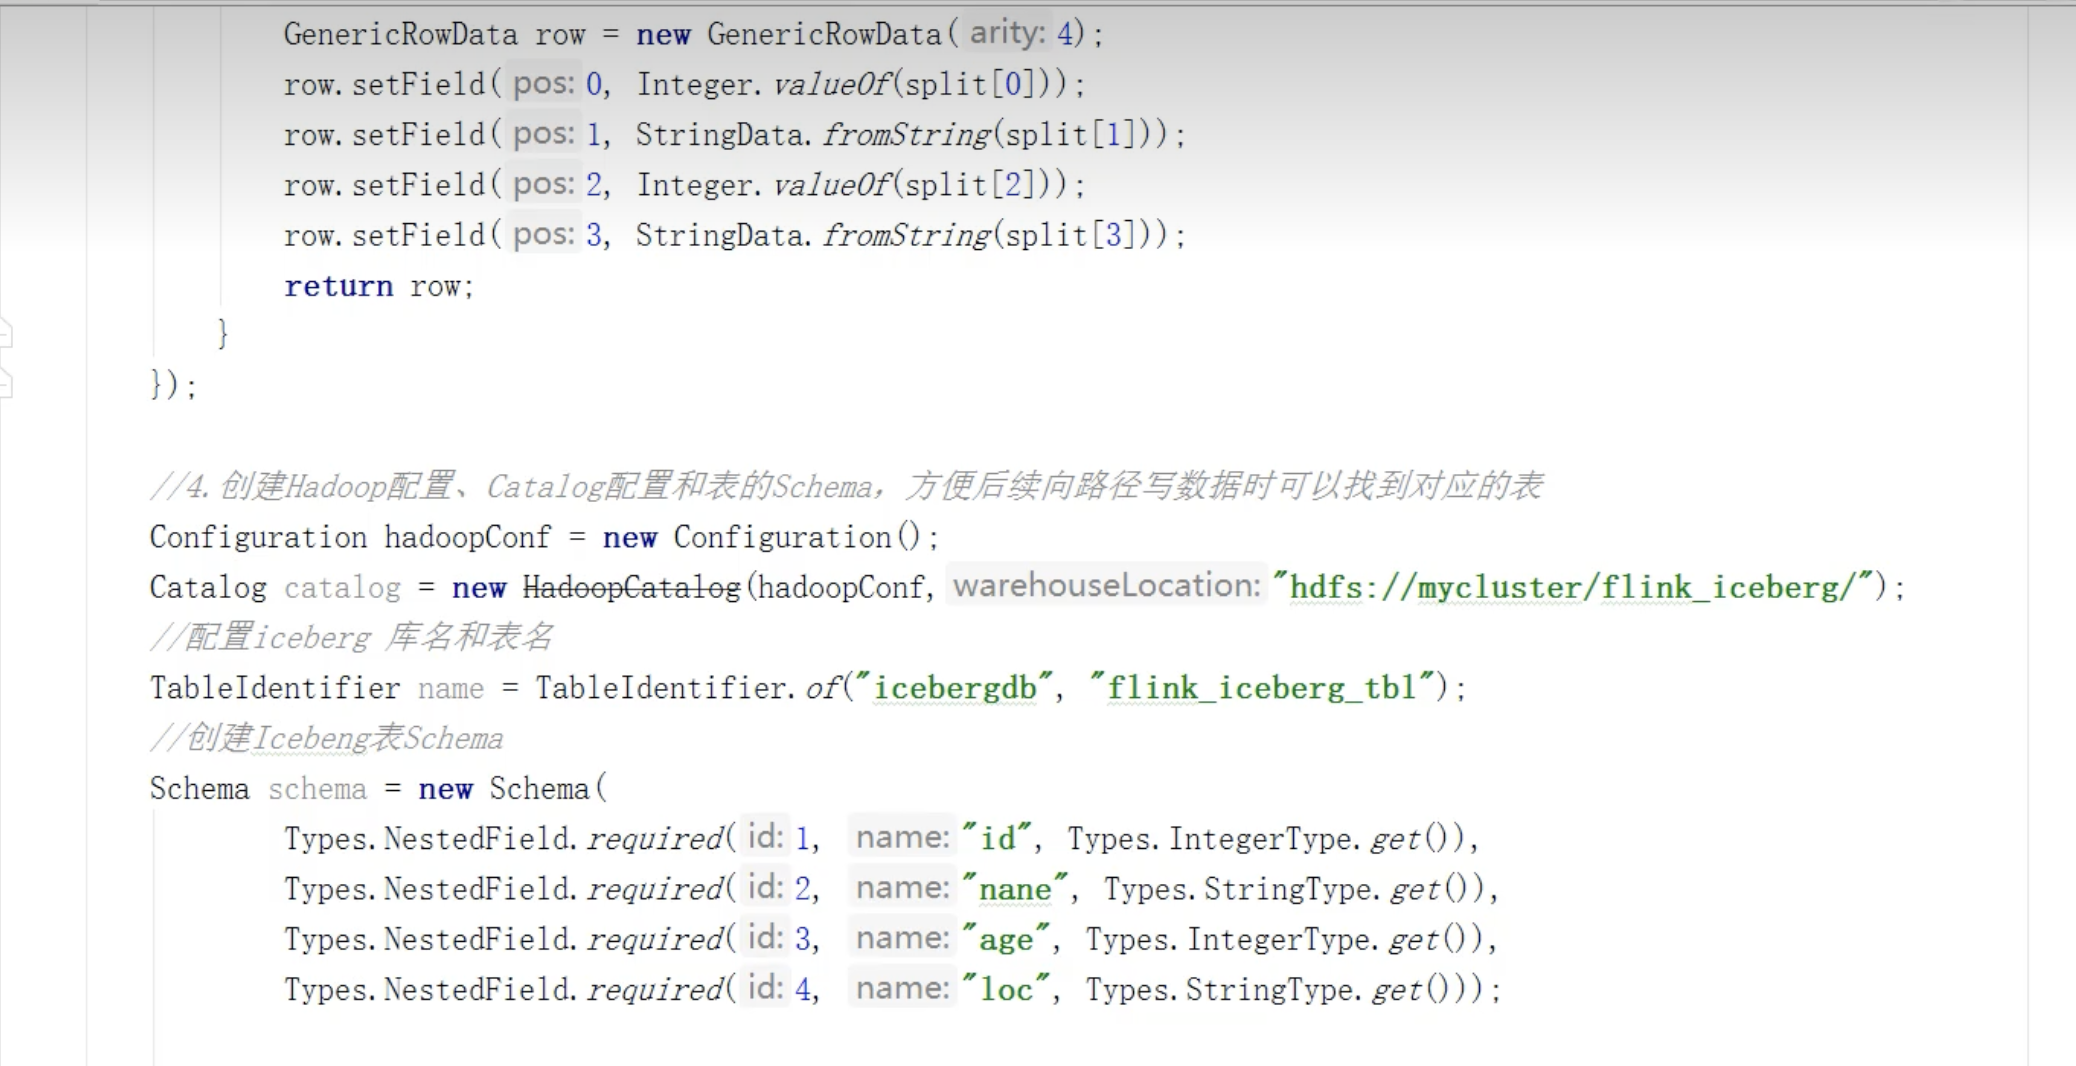
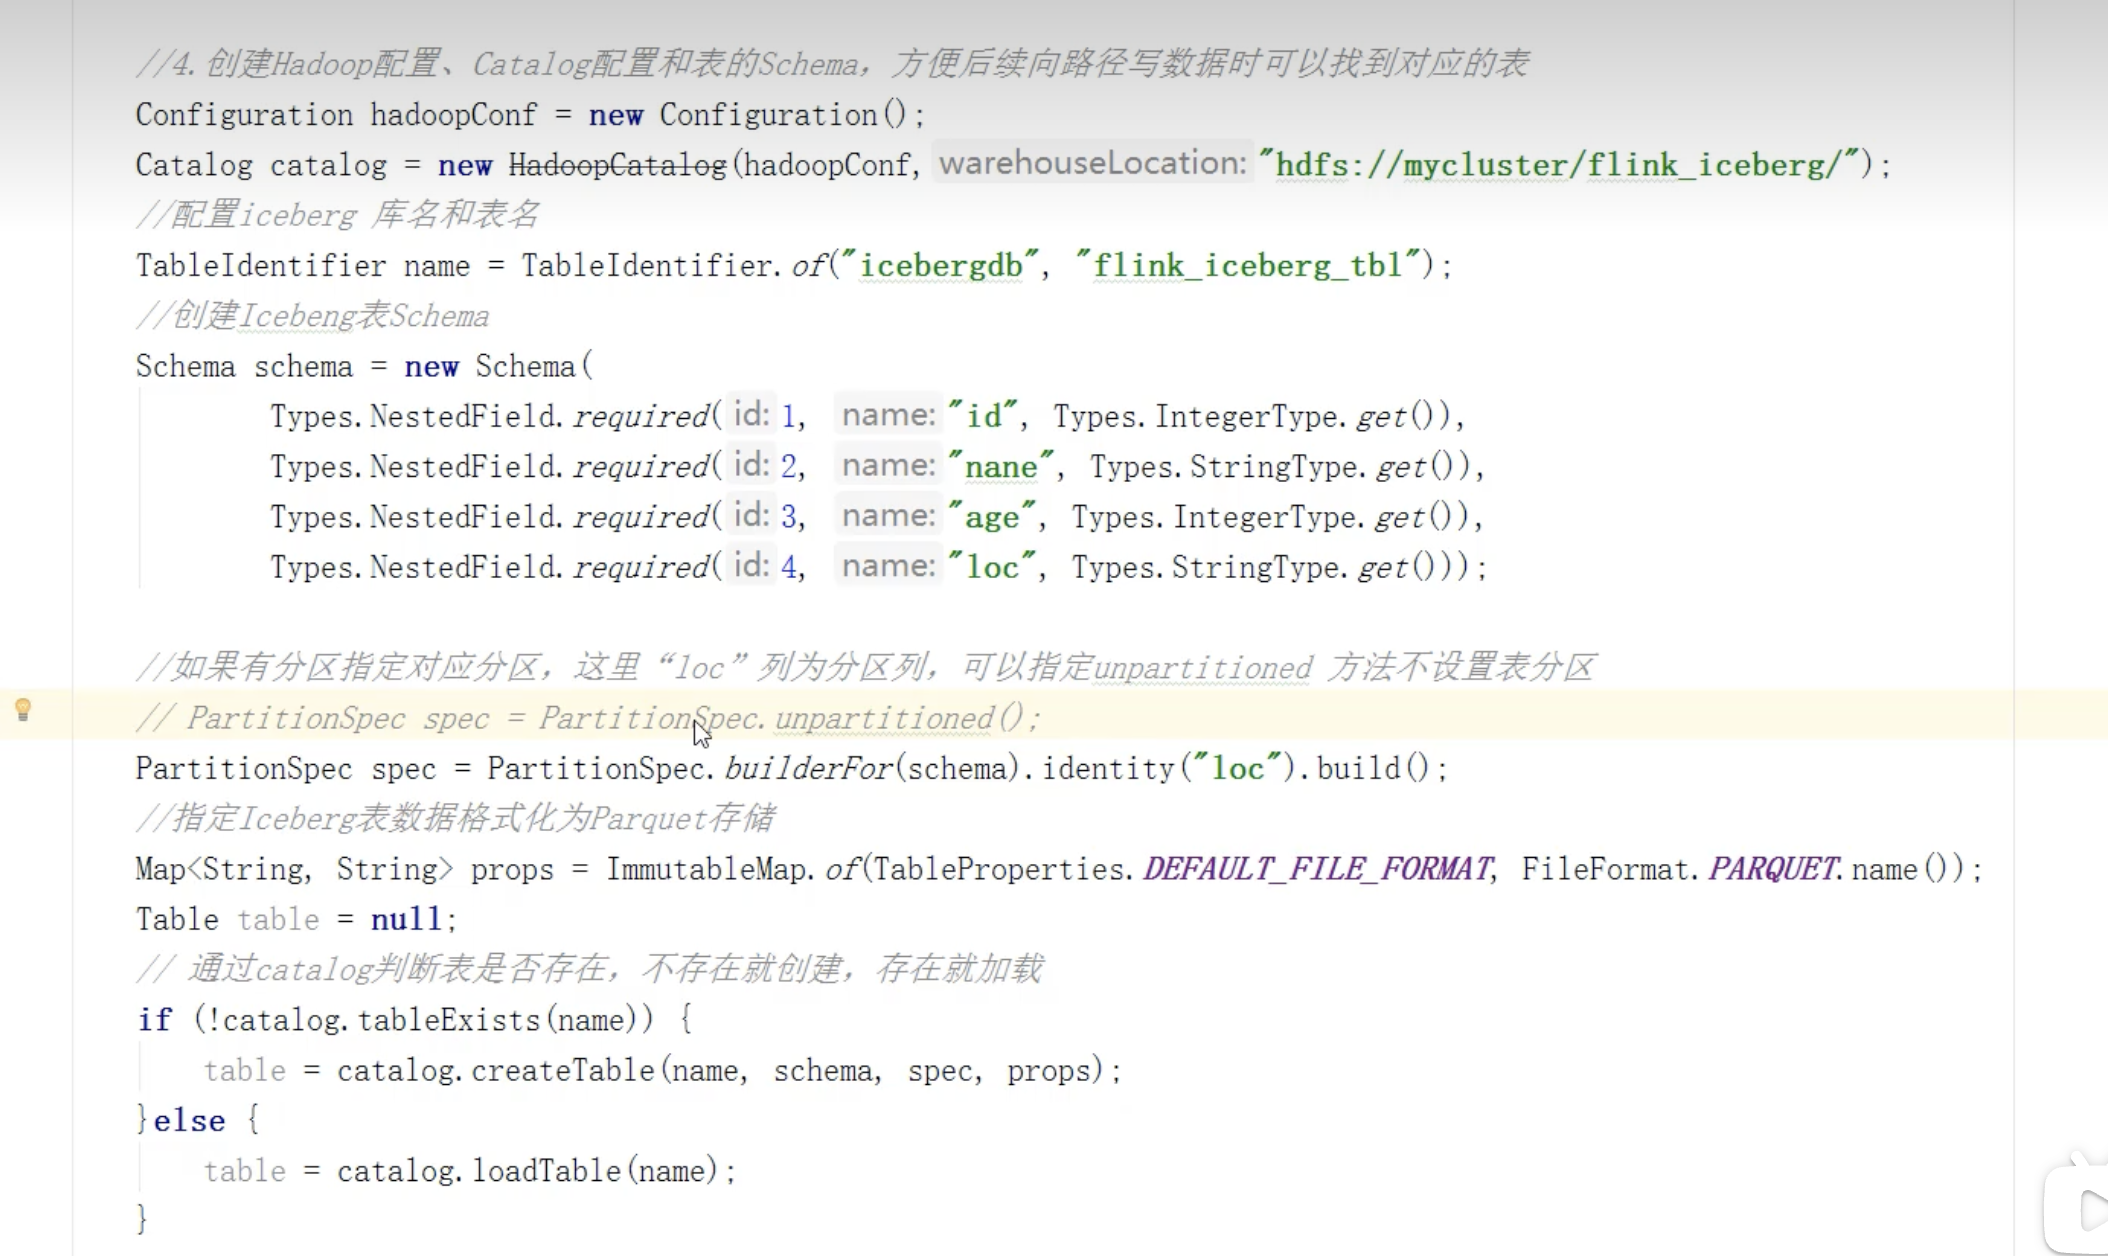
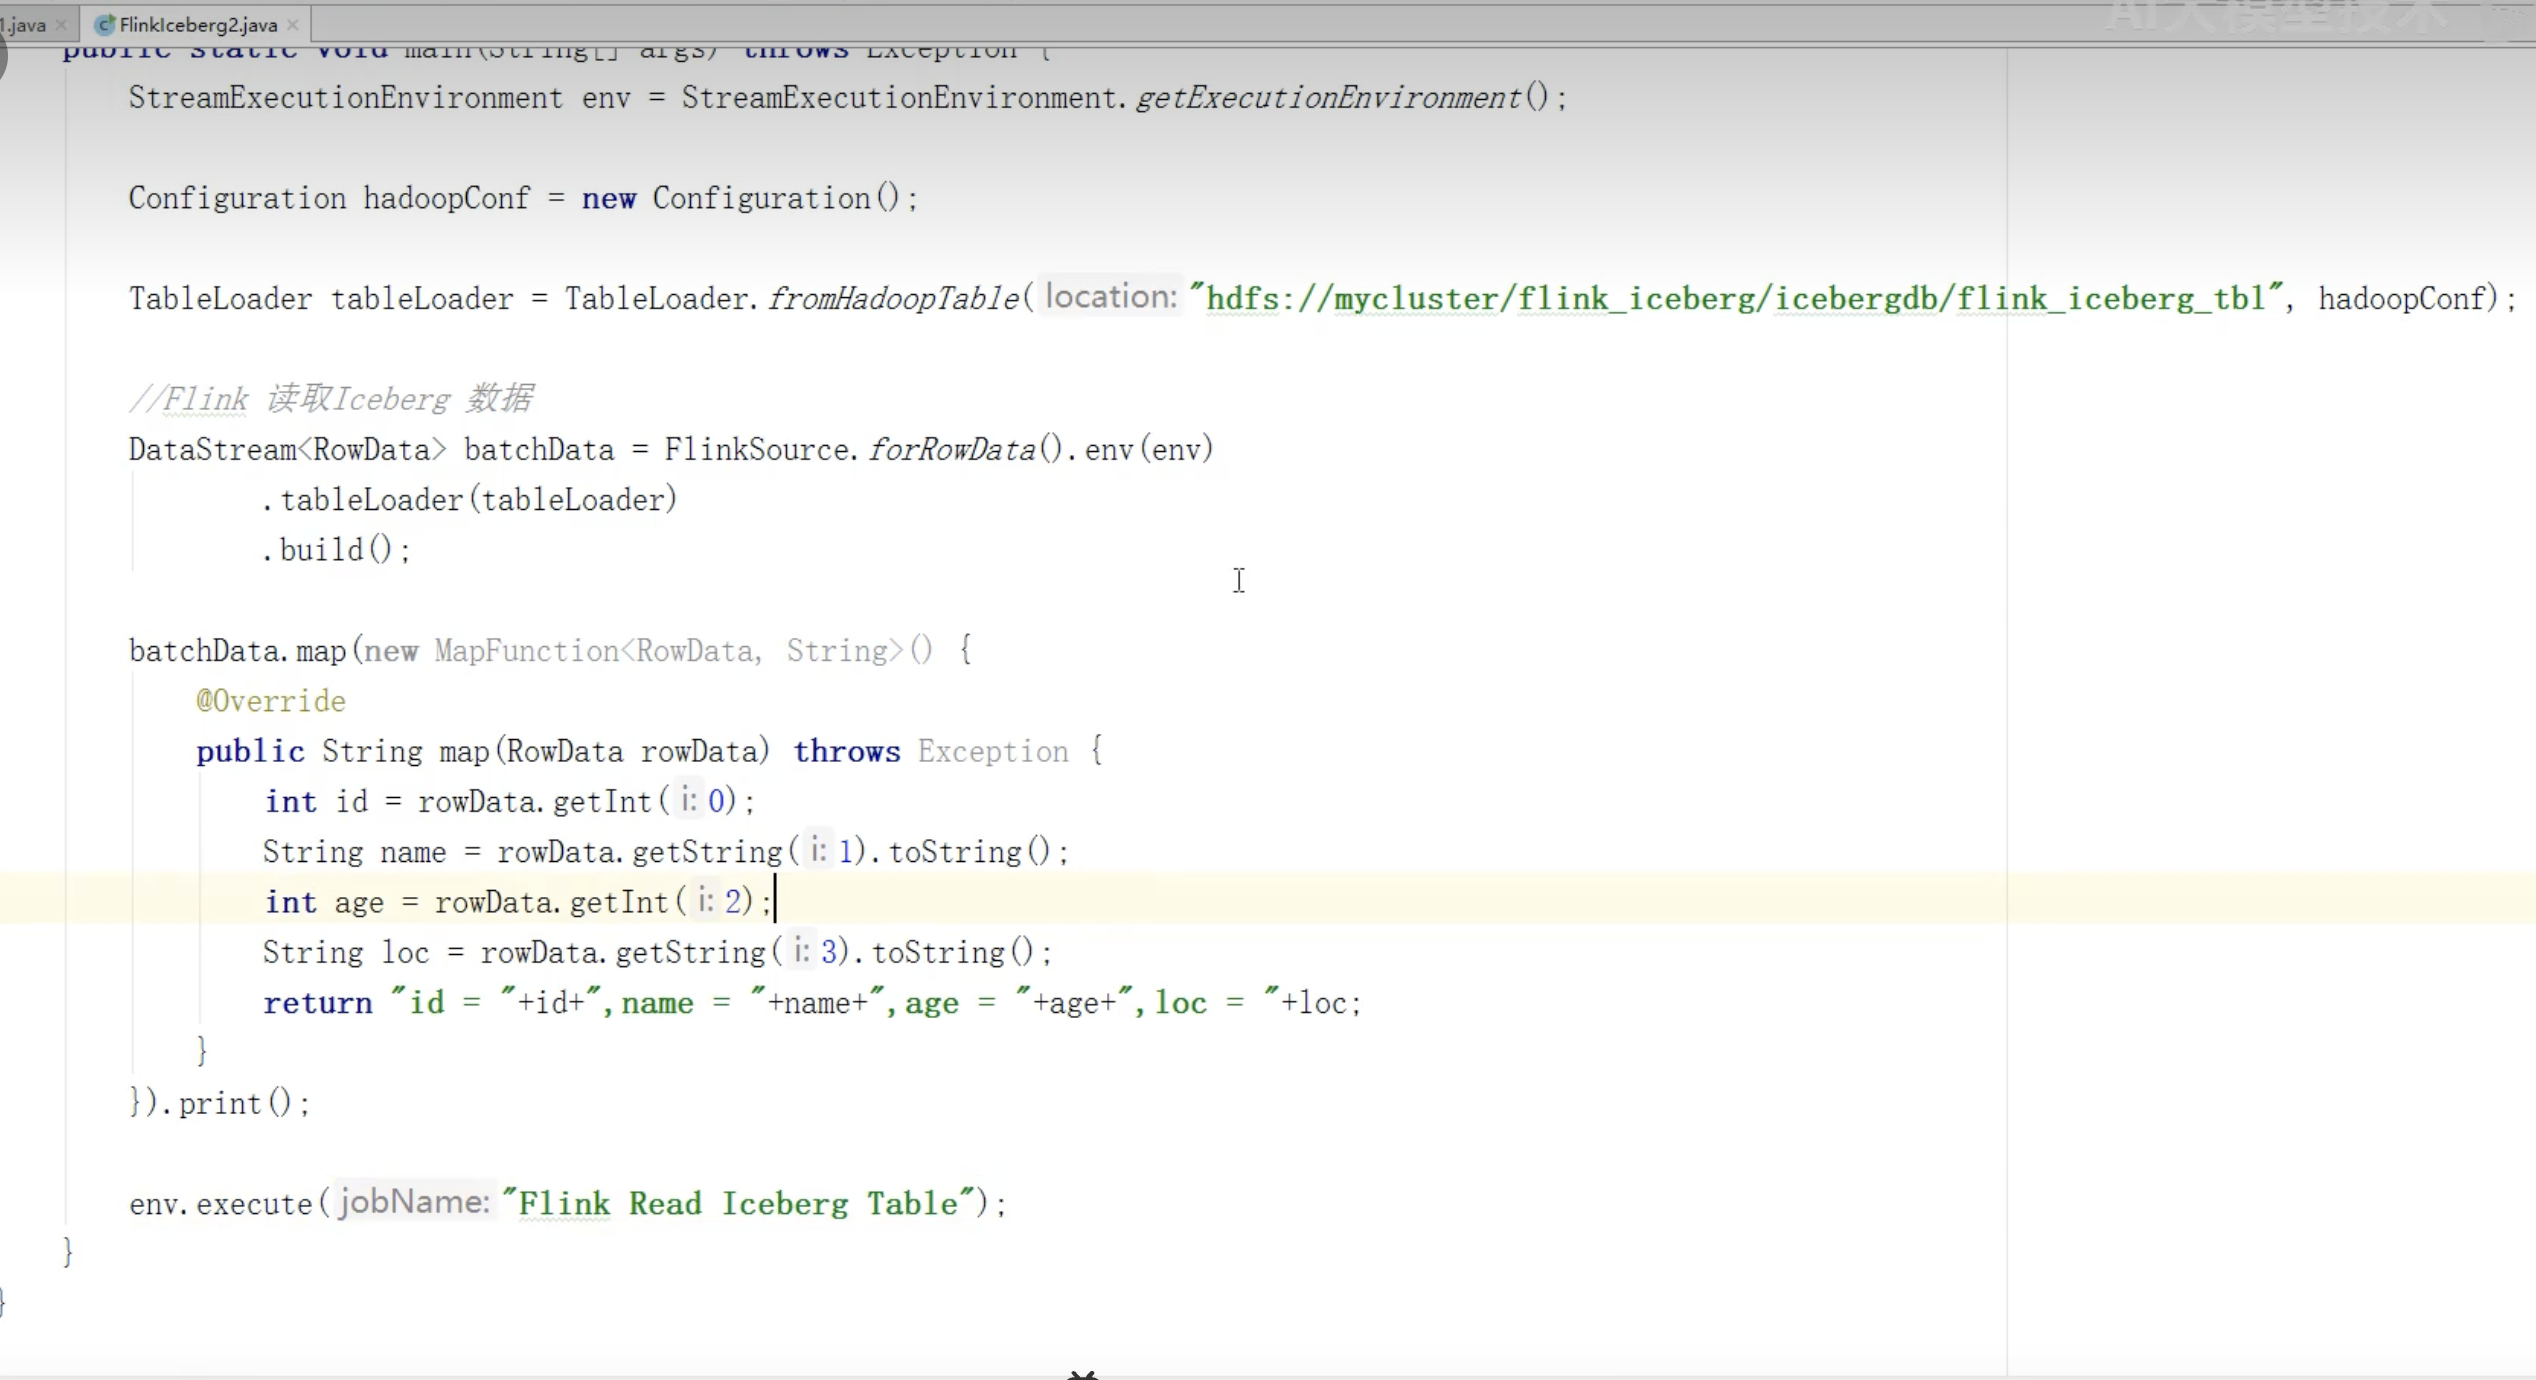
4.1.2 DataStream API 批量读取Iceberg数据
上面是批量读取,读取完数据,程序终止,如果想要流式读取,需要将streaming设置成true,如下图:
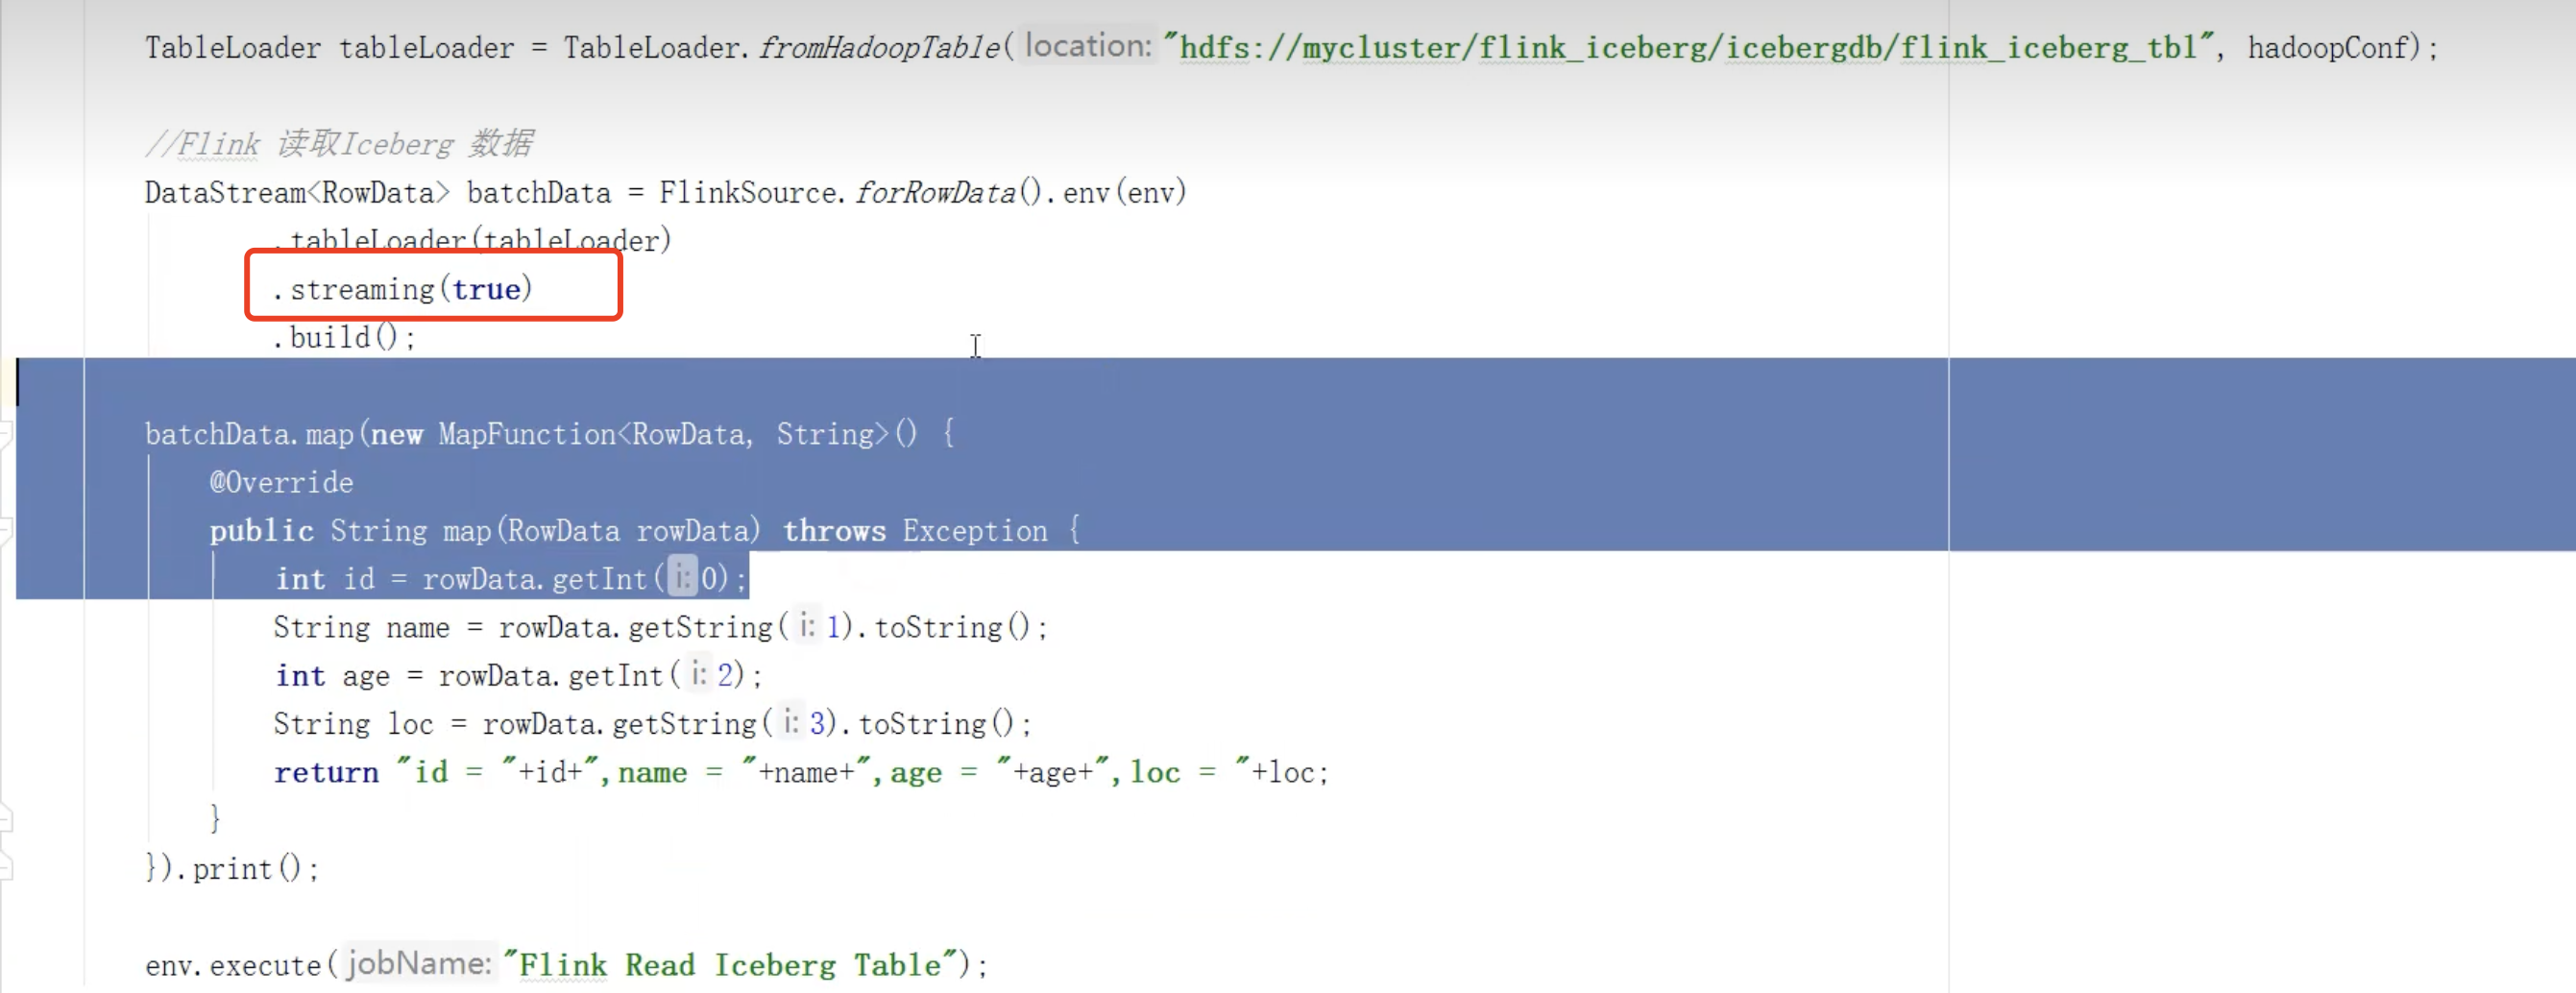
这样,程序不会终止,如果有新的数据写入表中,程序能实时读取到数据。
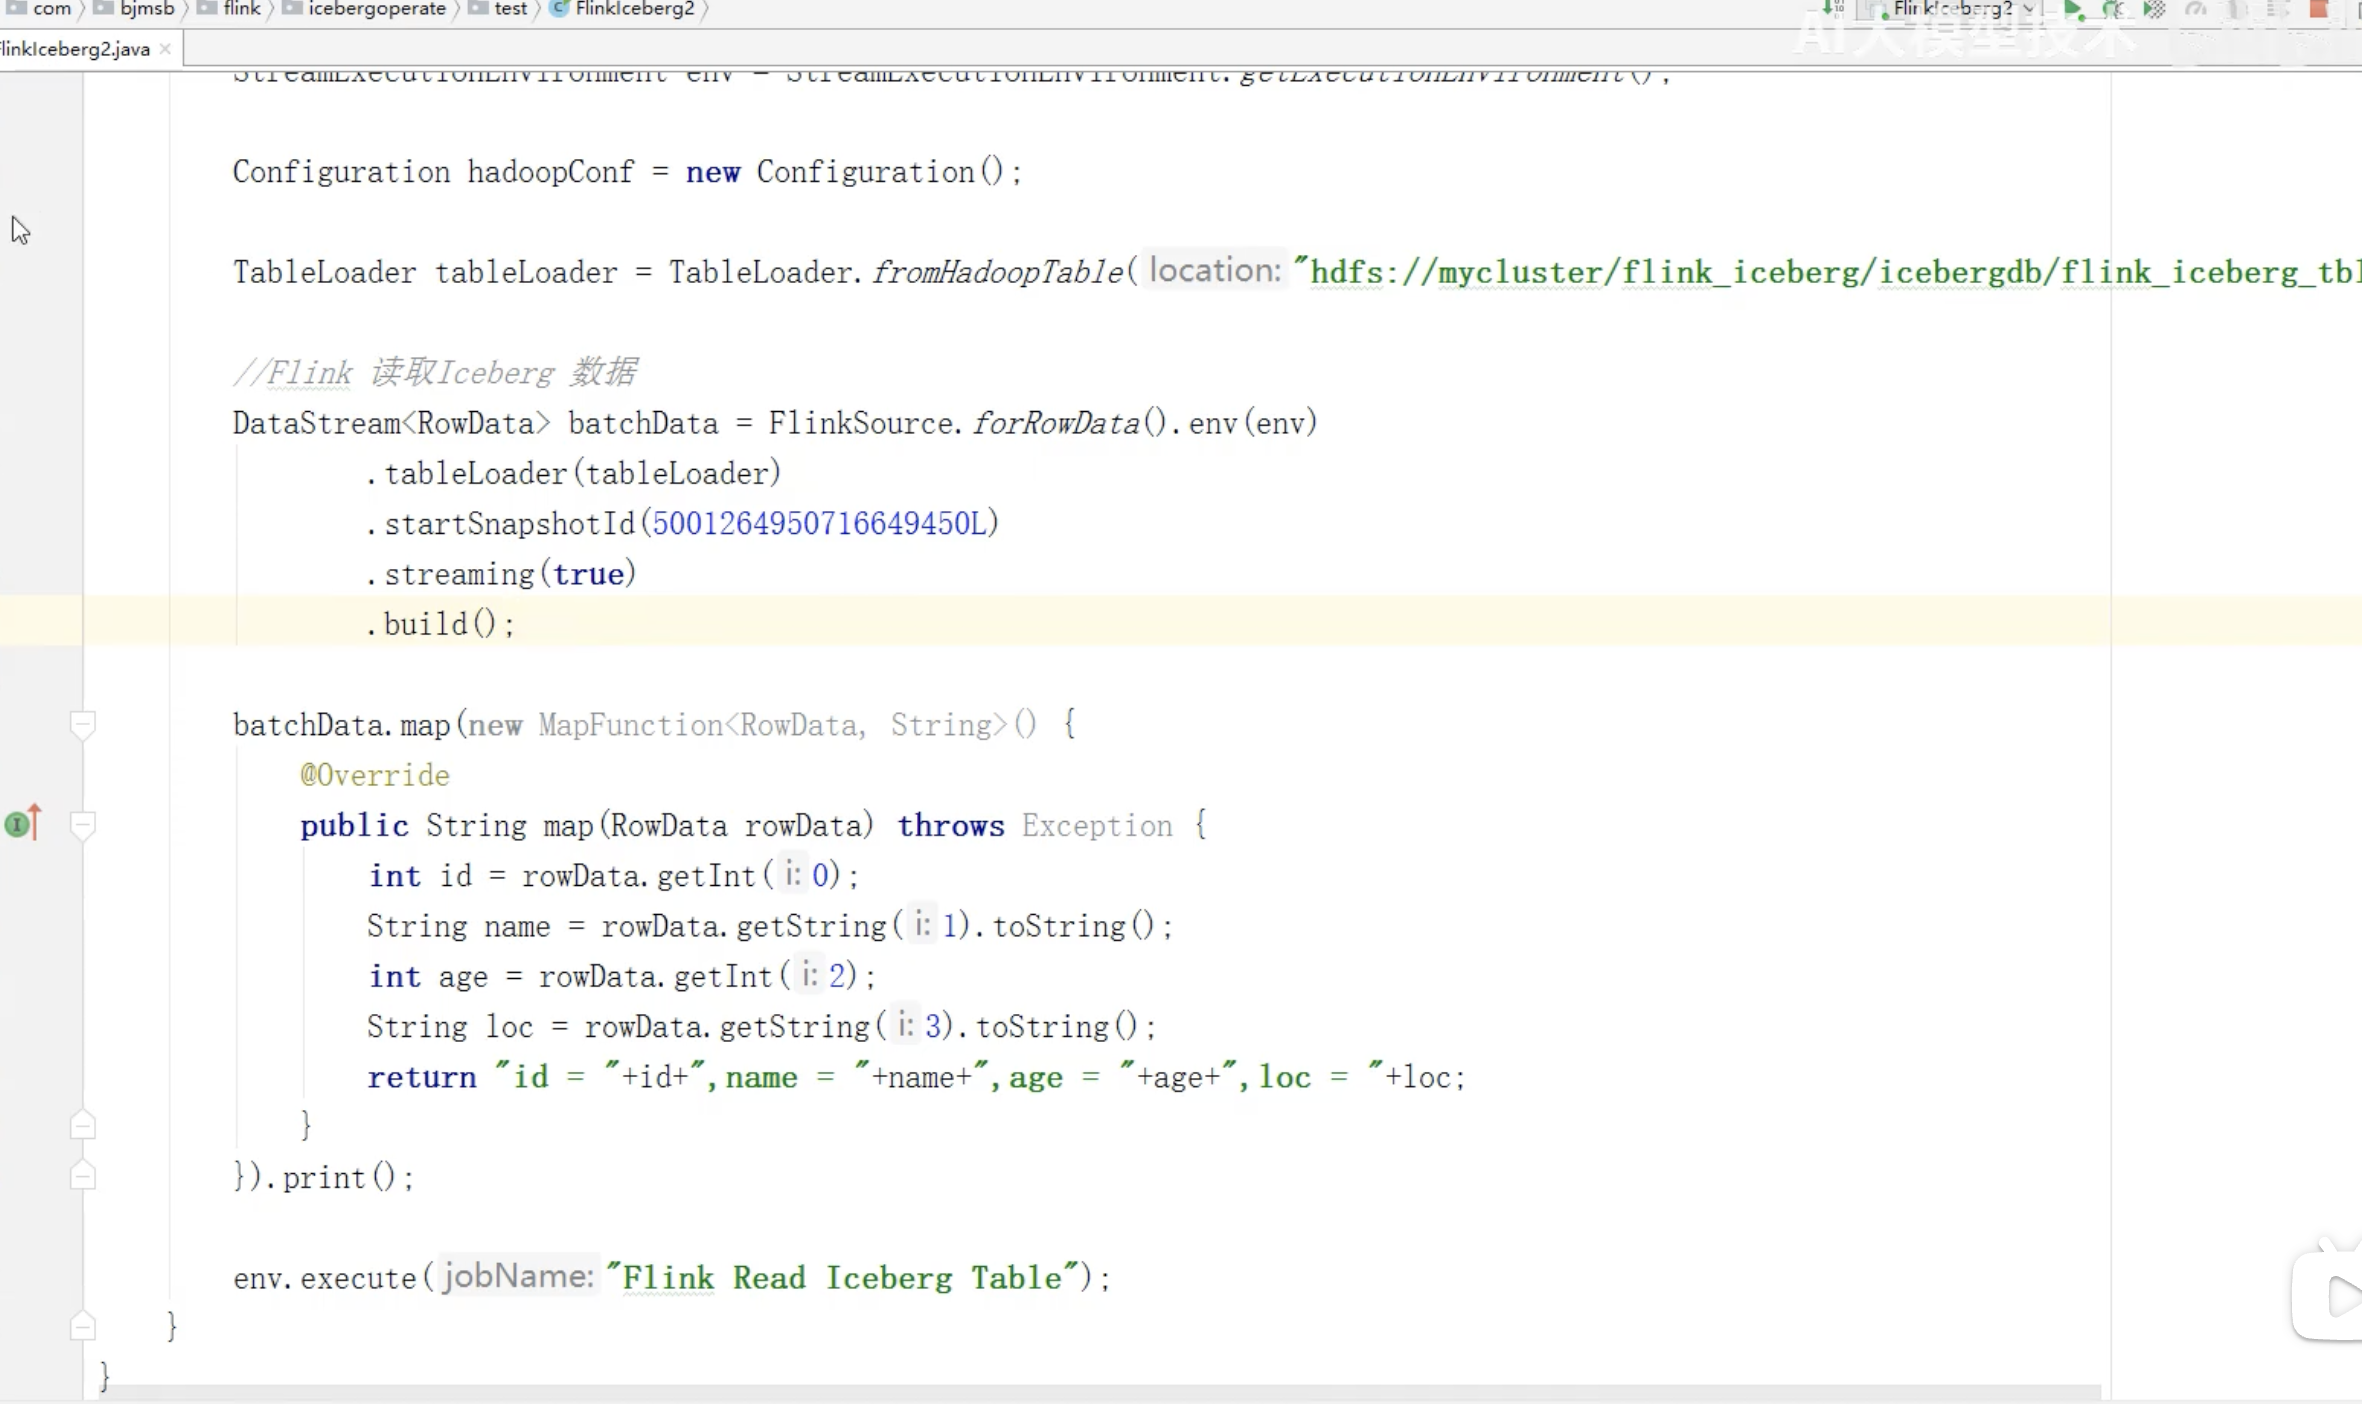
4.1.3 读取快照
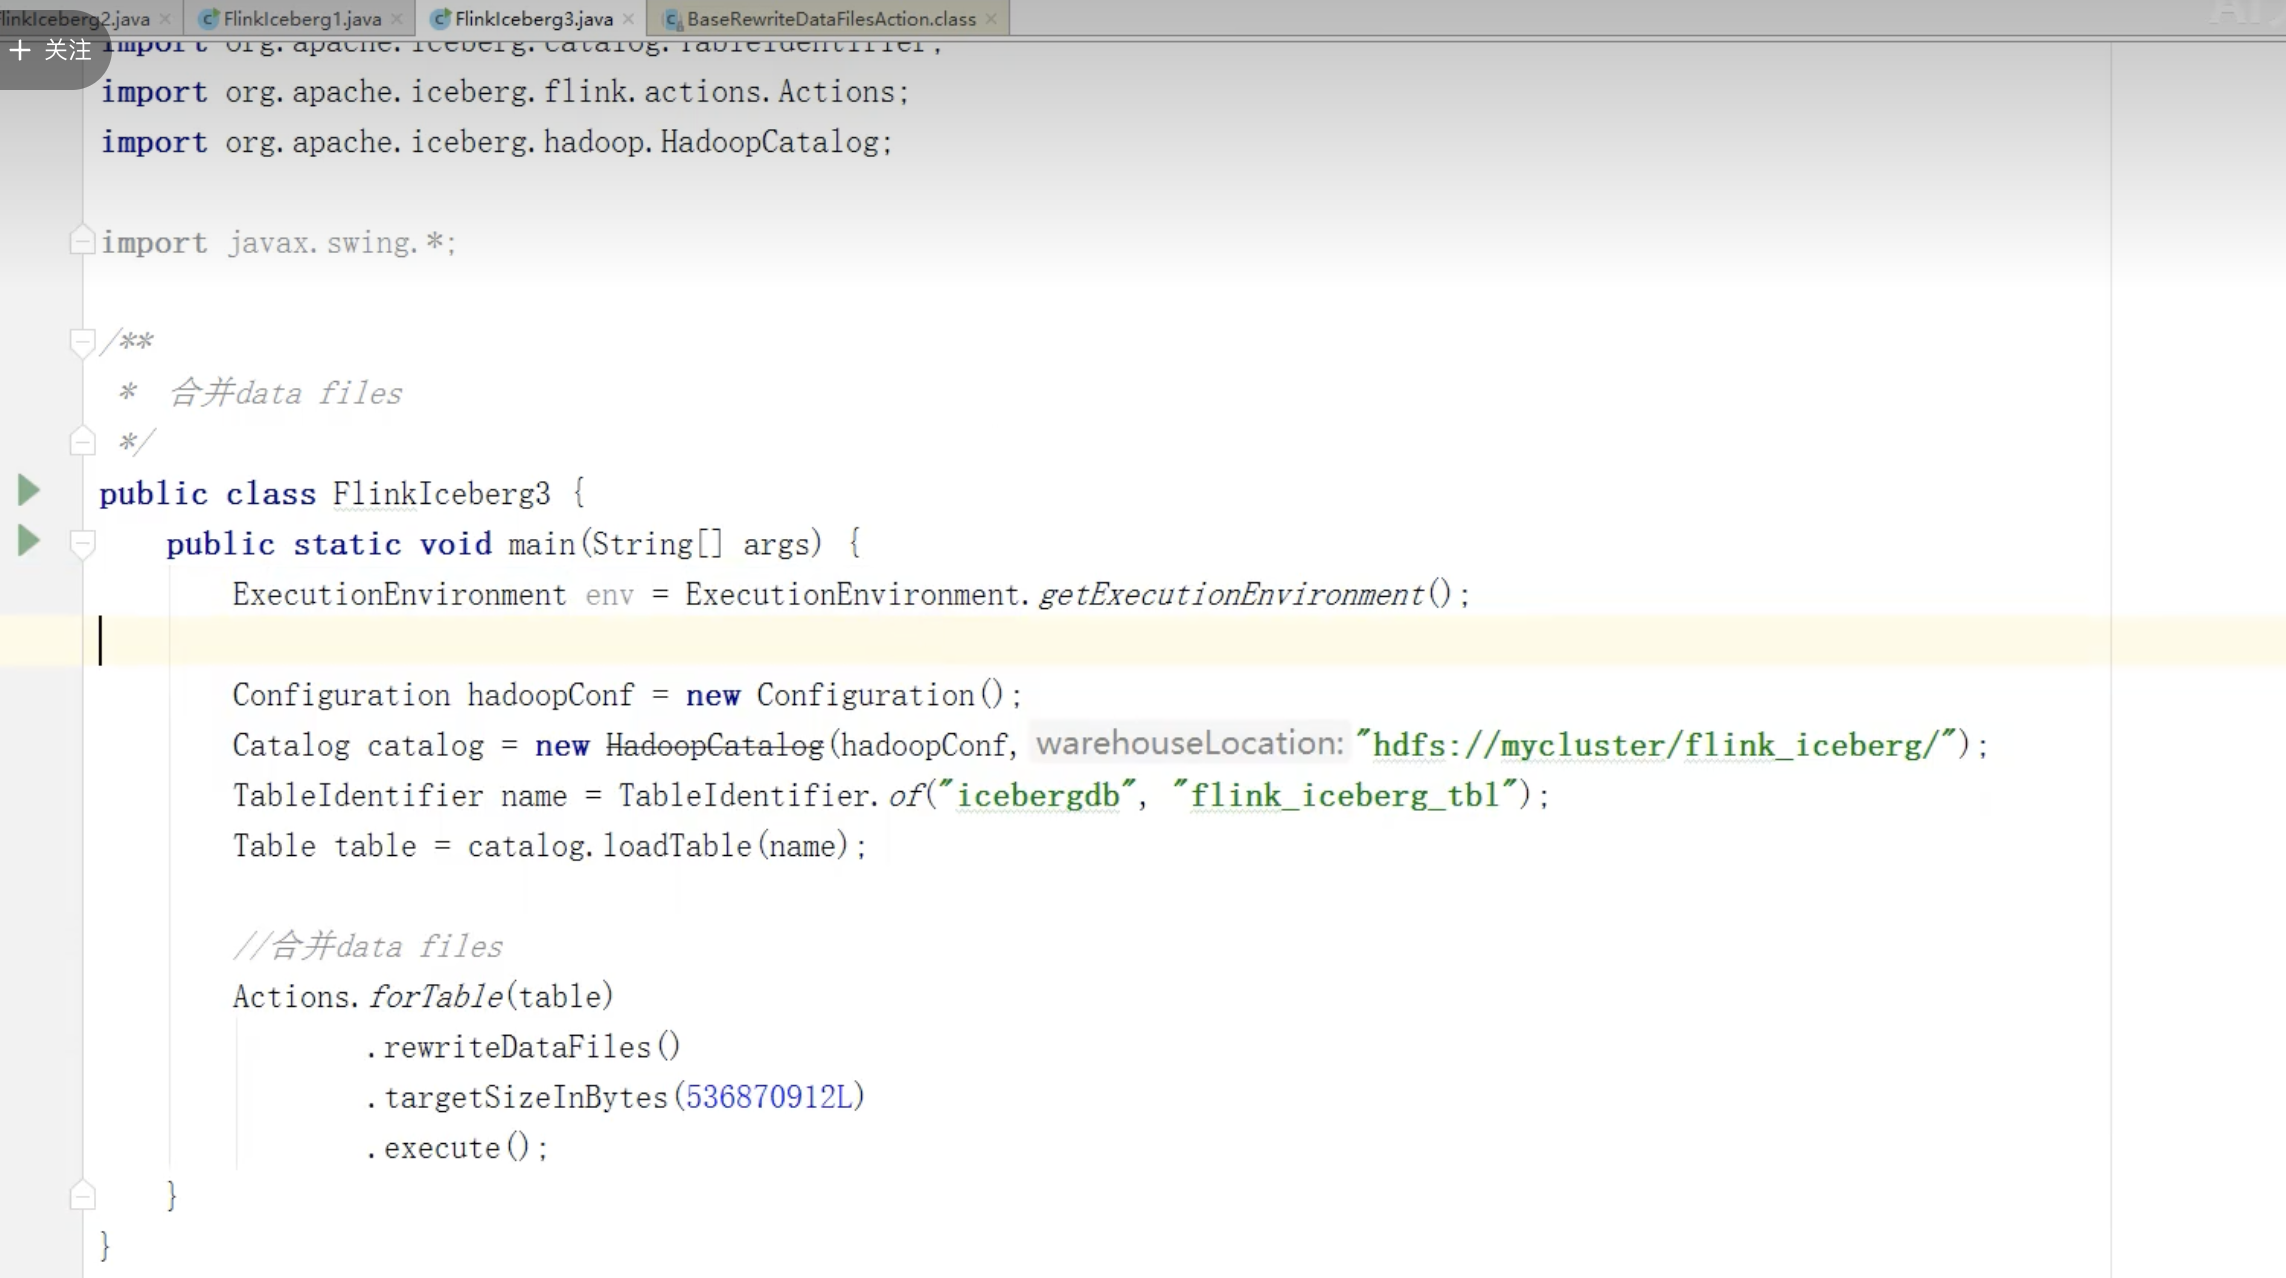
4.1.4 合并Data Files
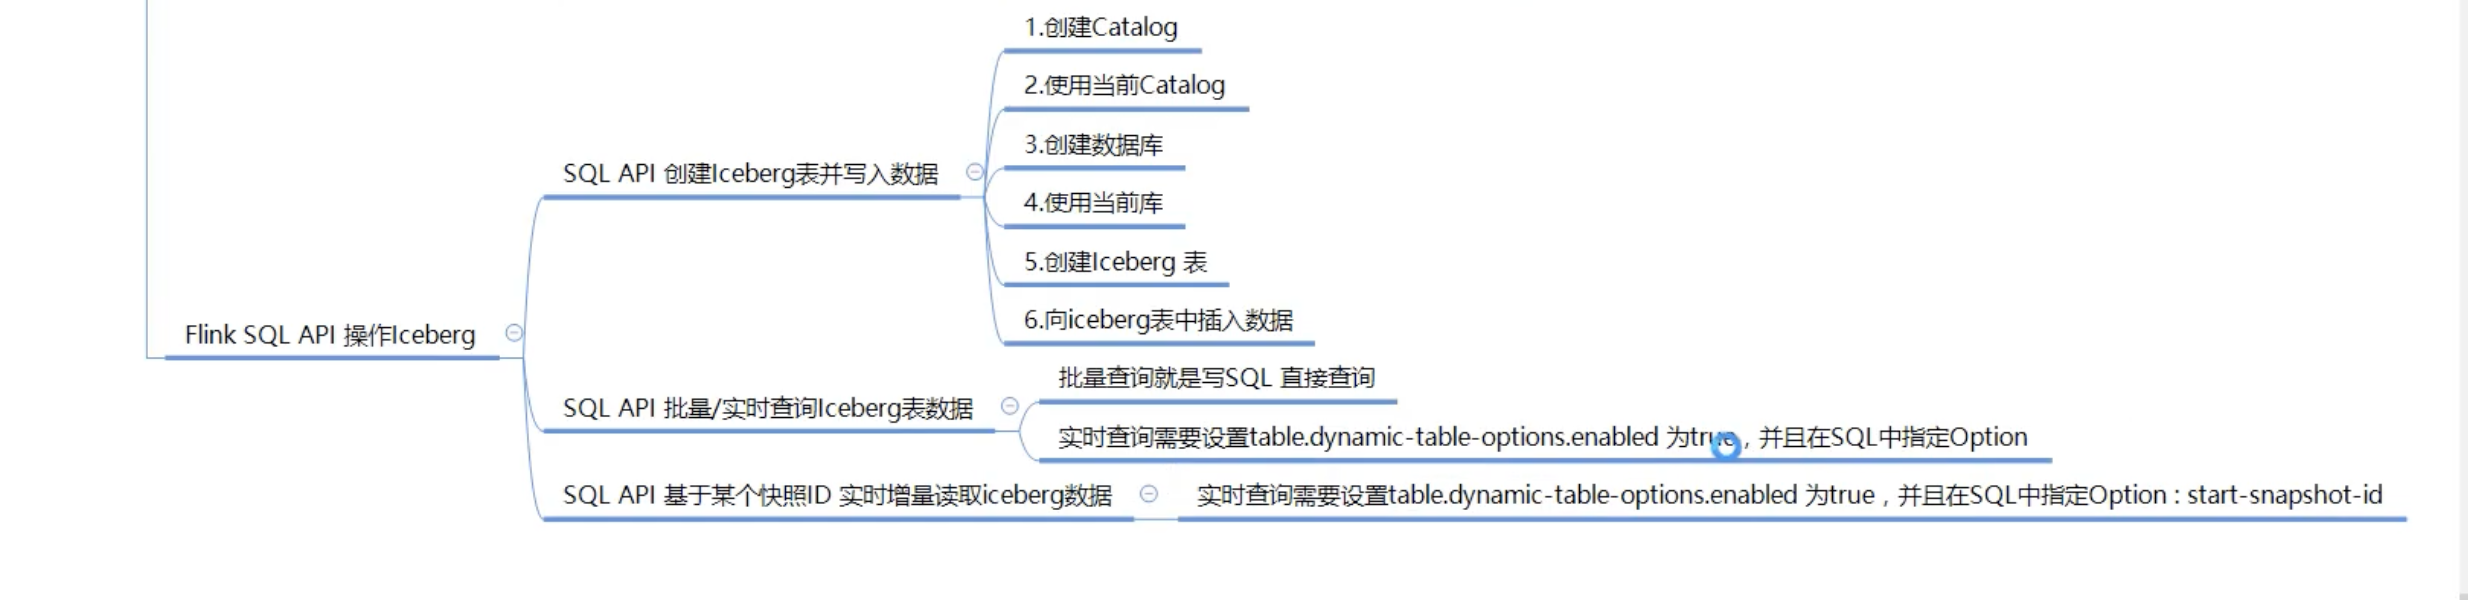
4.2、Sql API 操作Iceberg
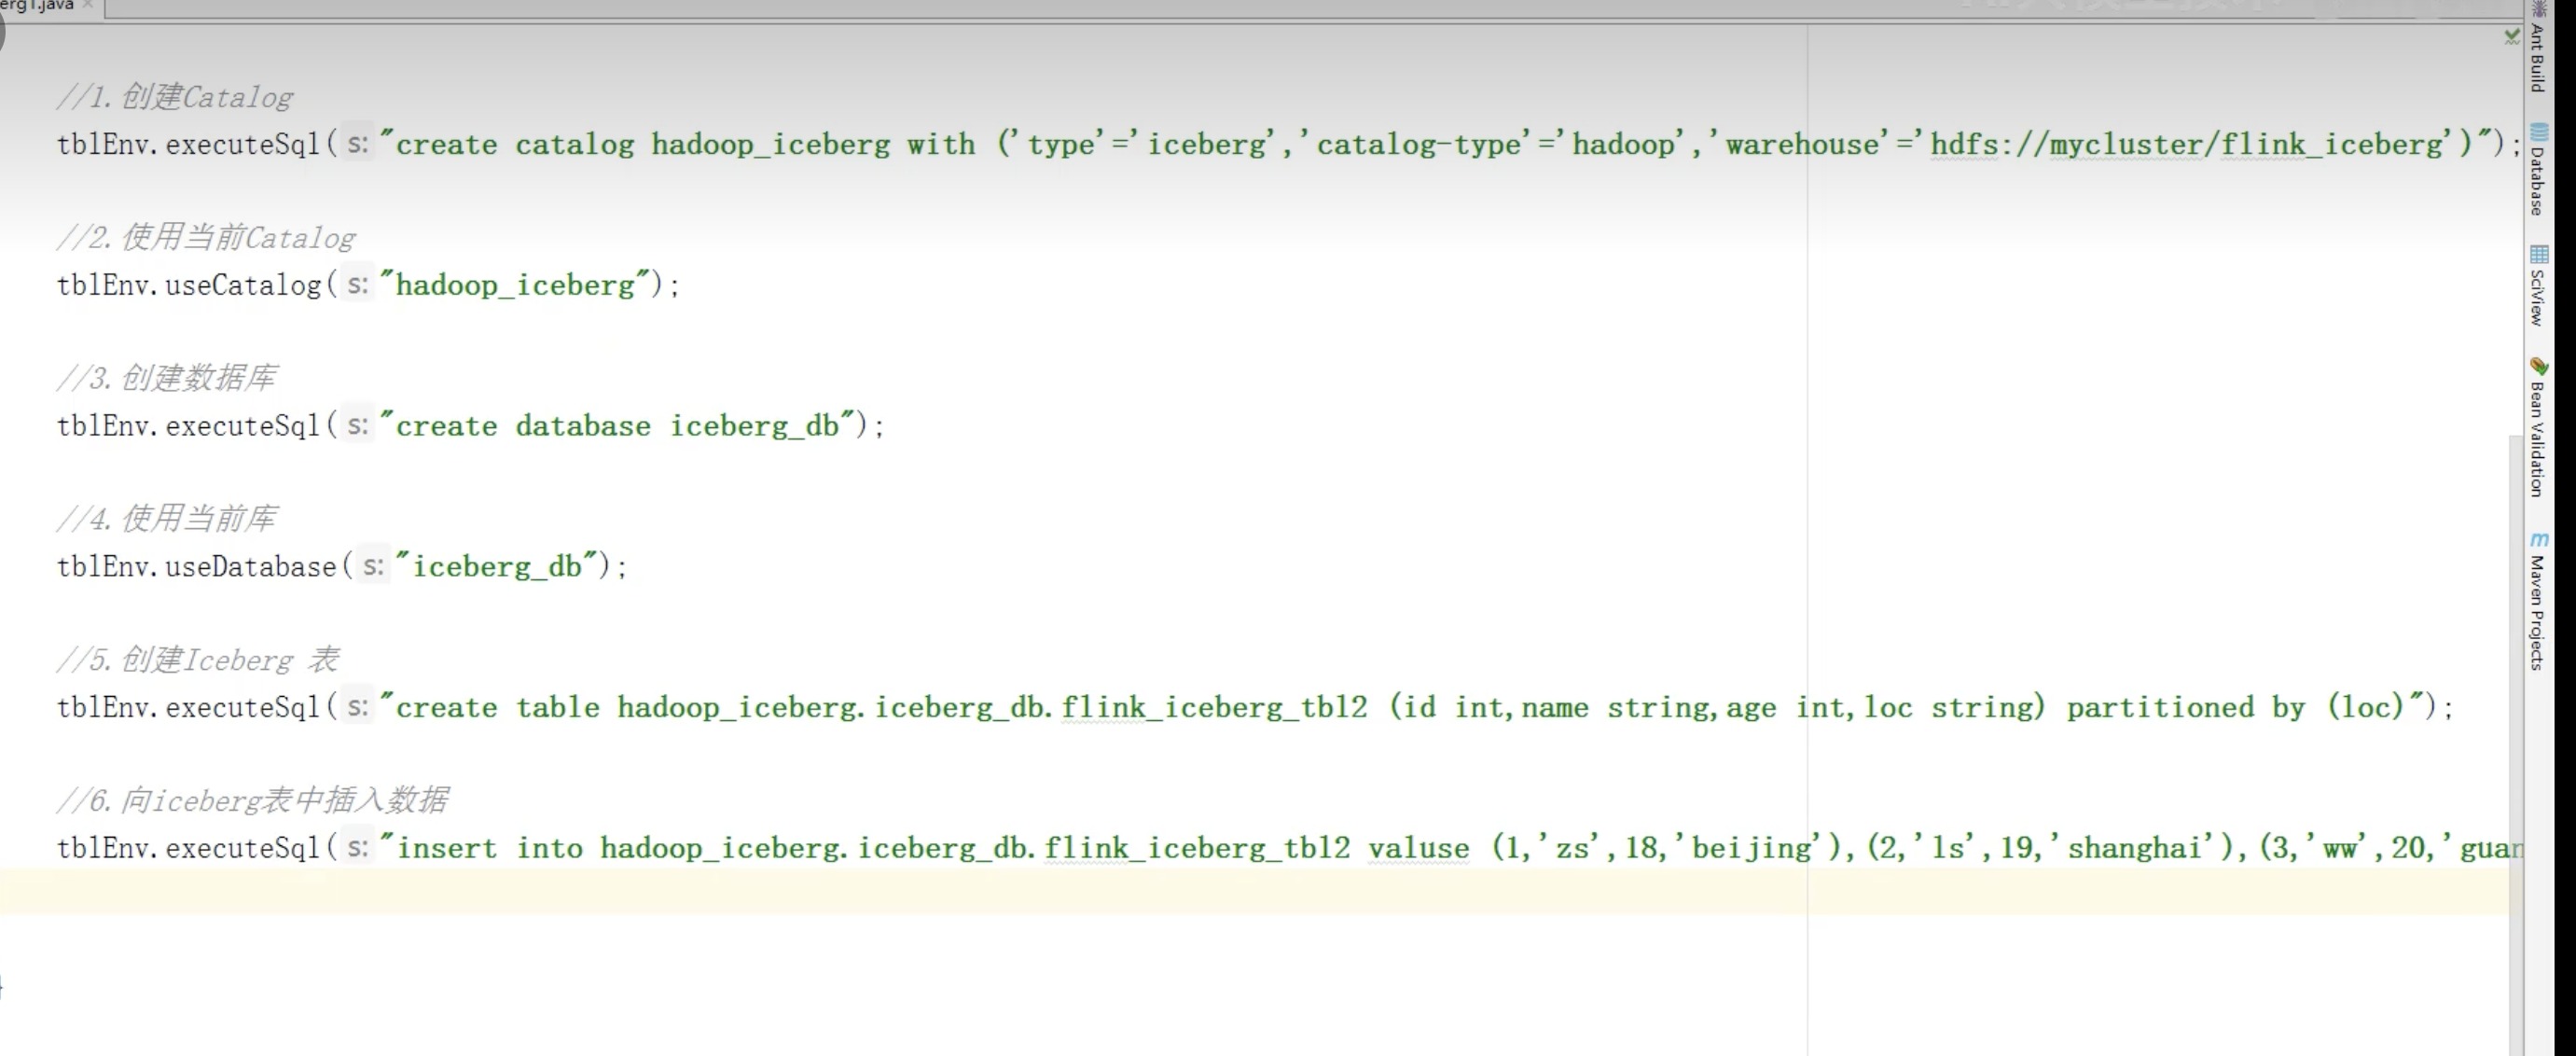
4.2.1 创建表并写入数据
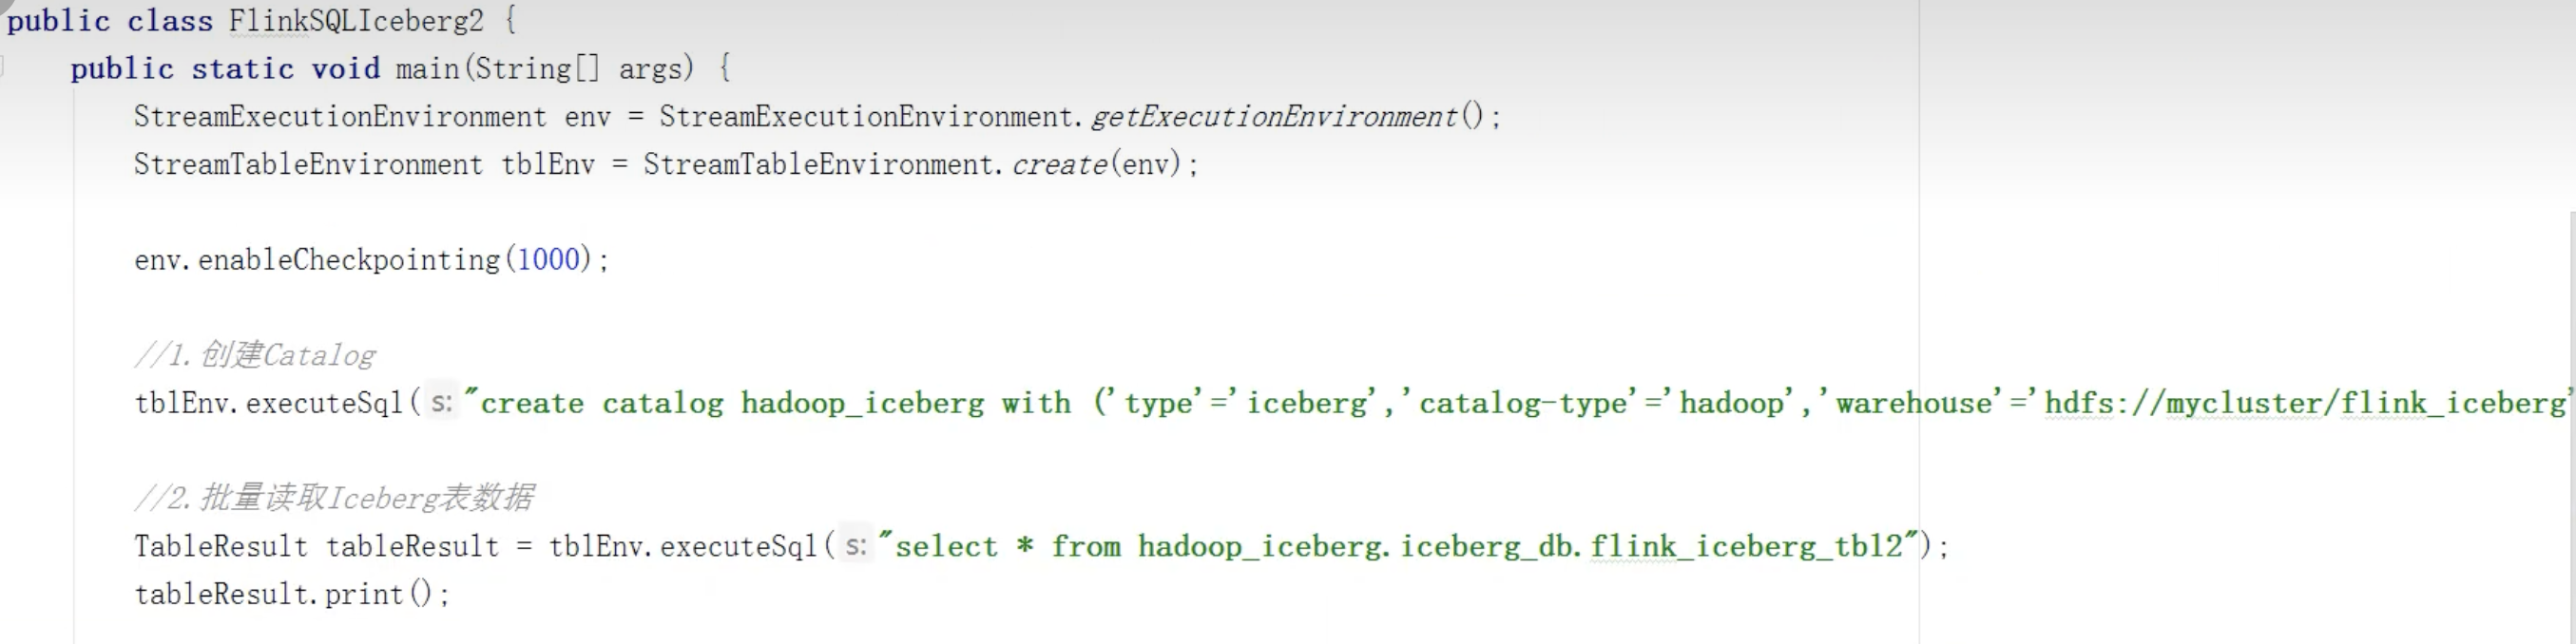
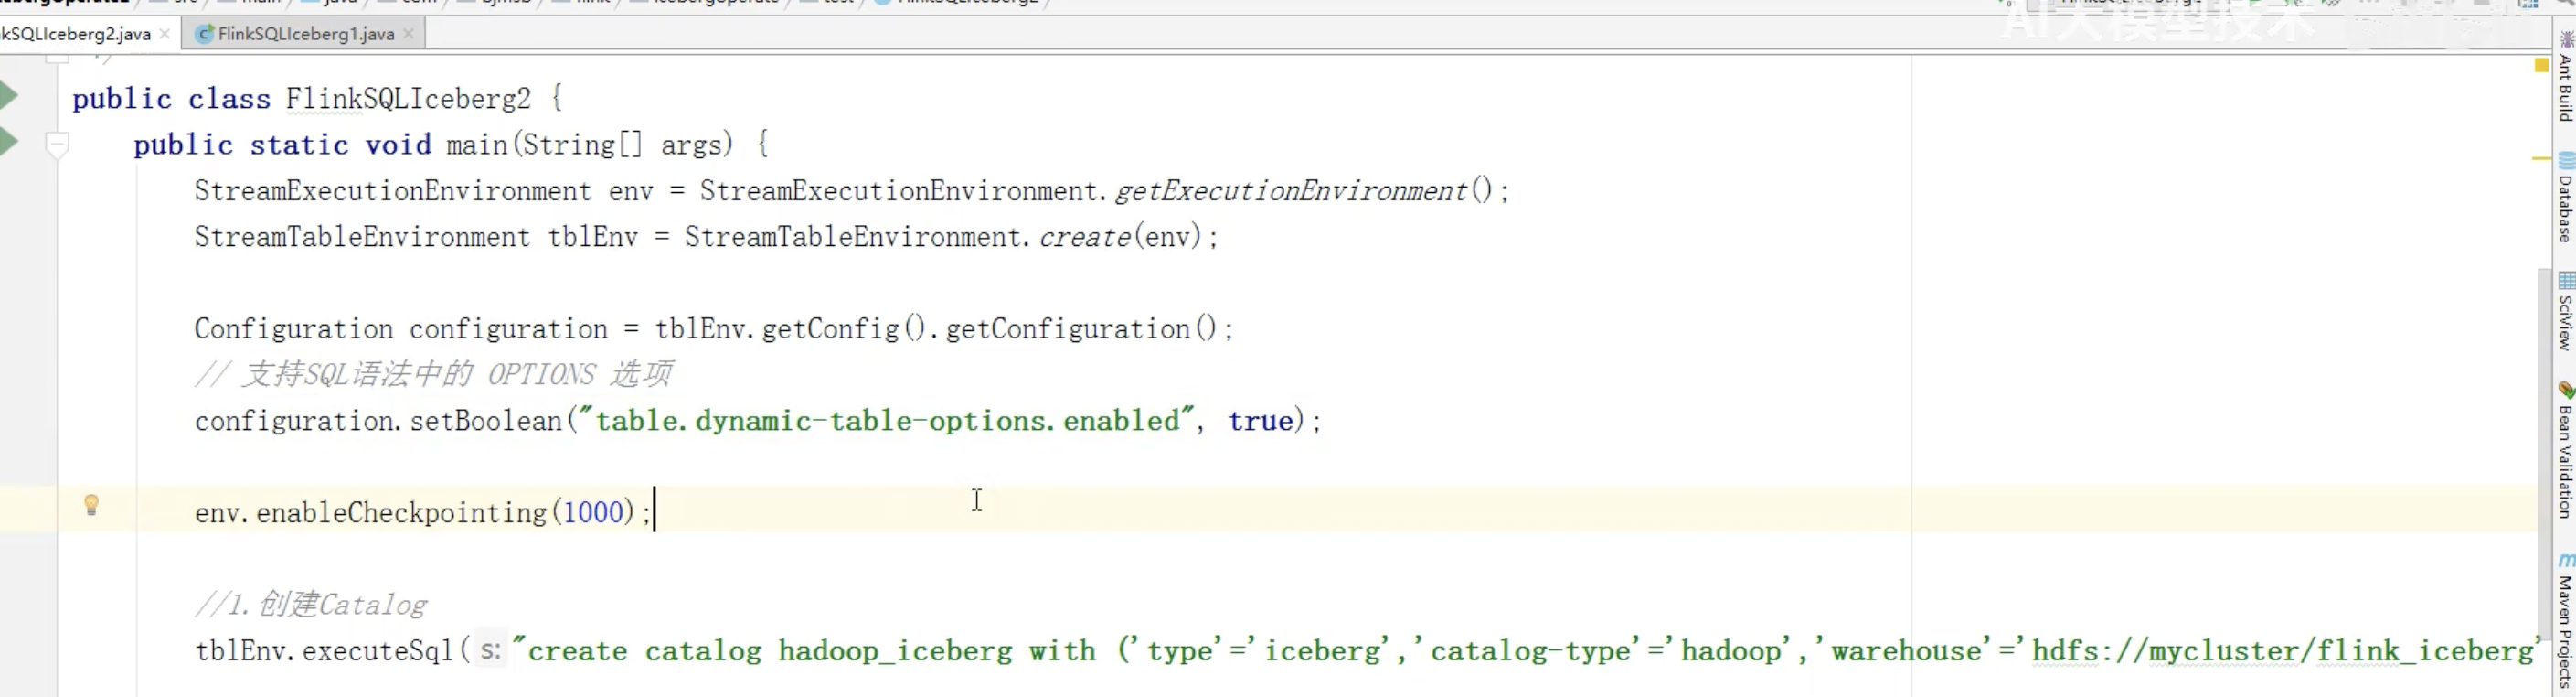
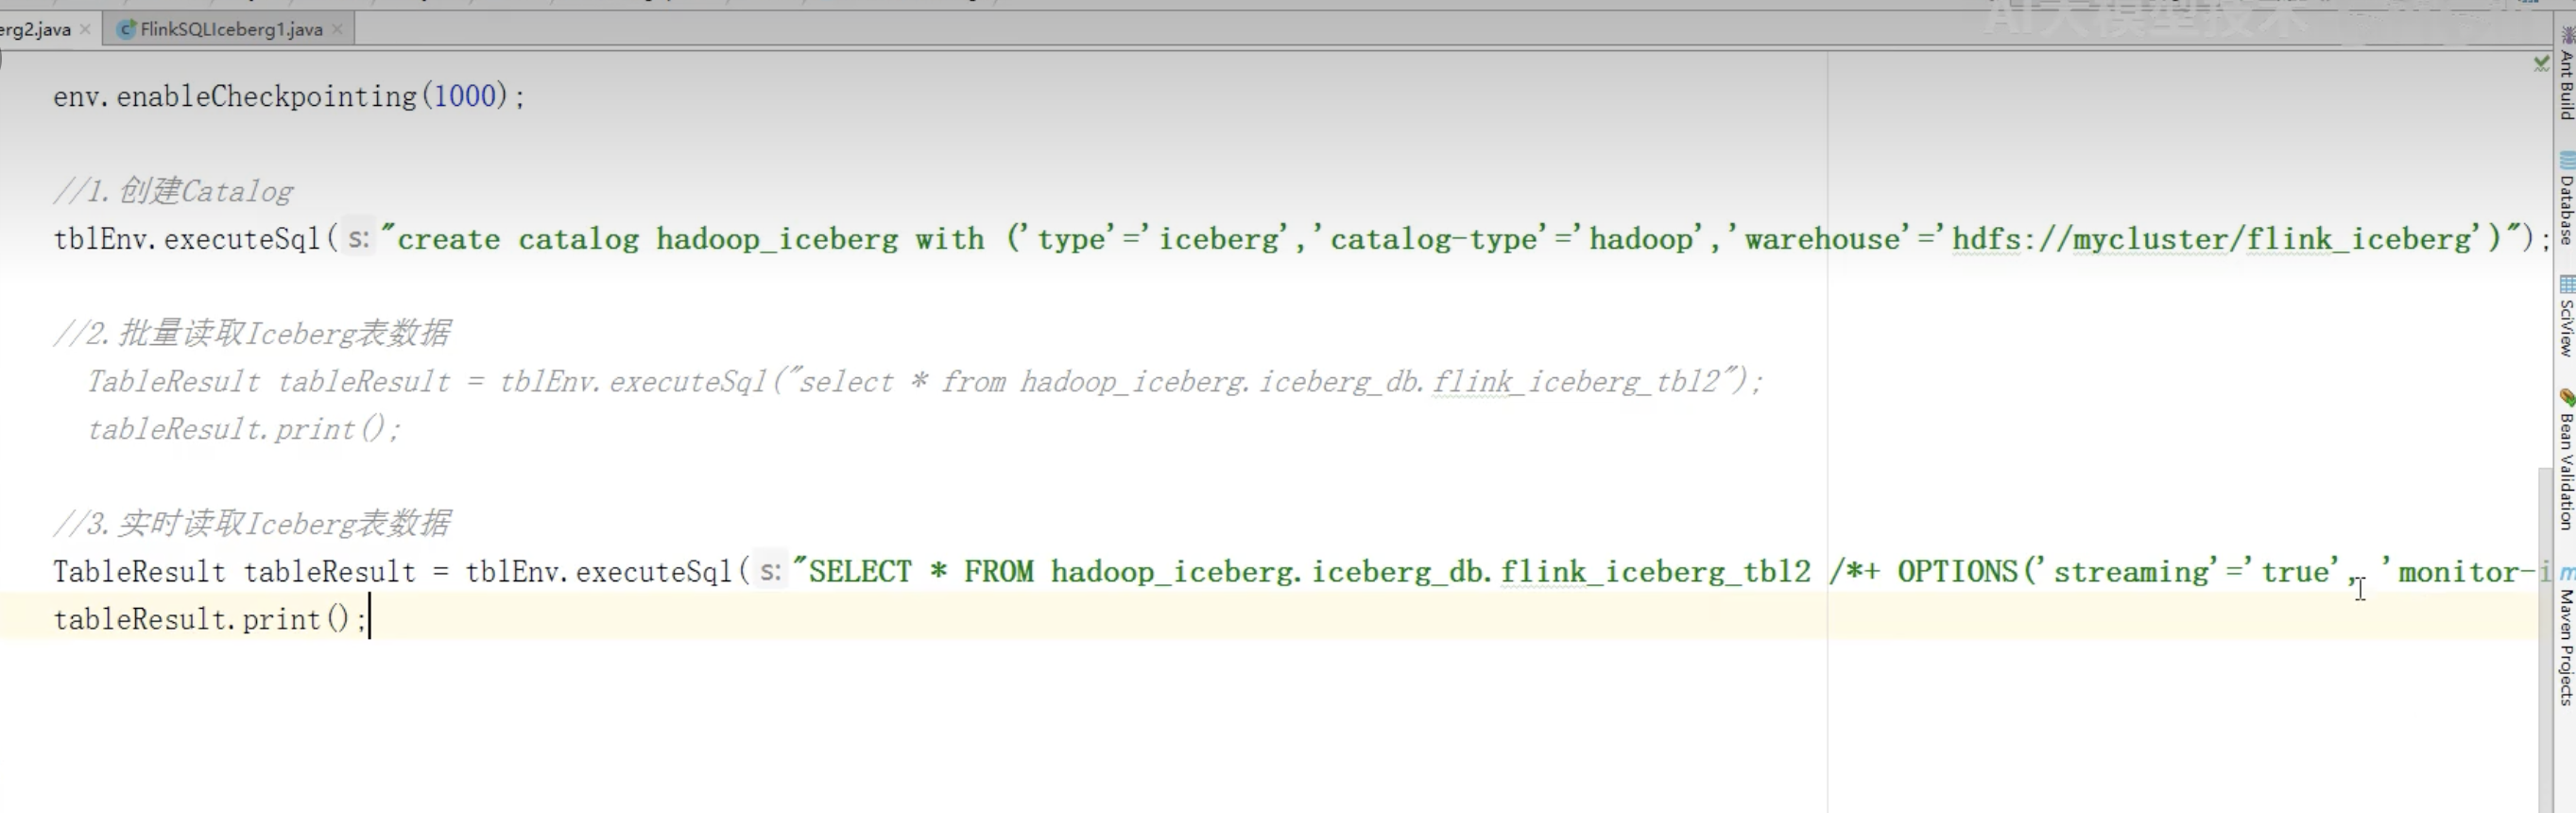
4.2.2、SqlAPI 批量/实时查询Iceberg数据
批量读取
实时读取

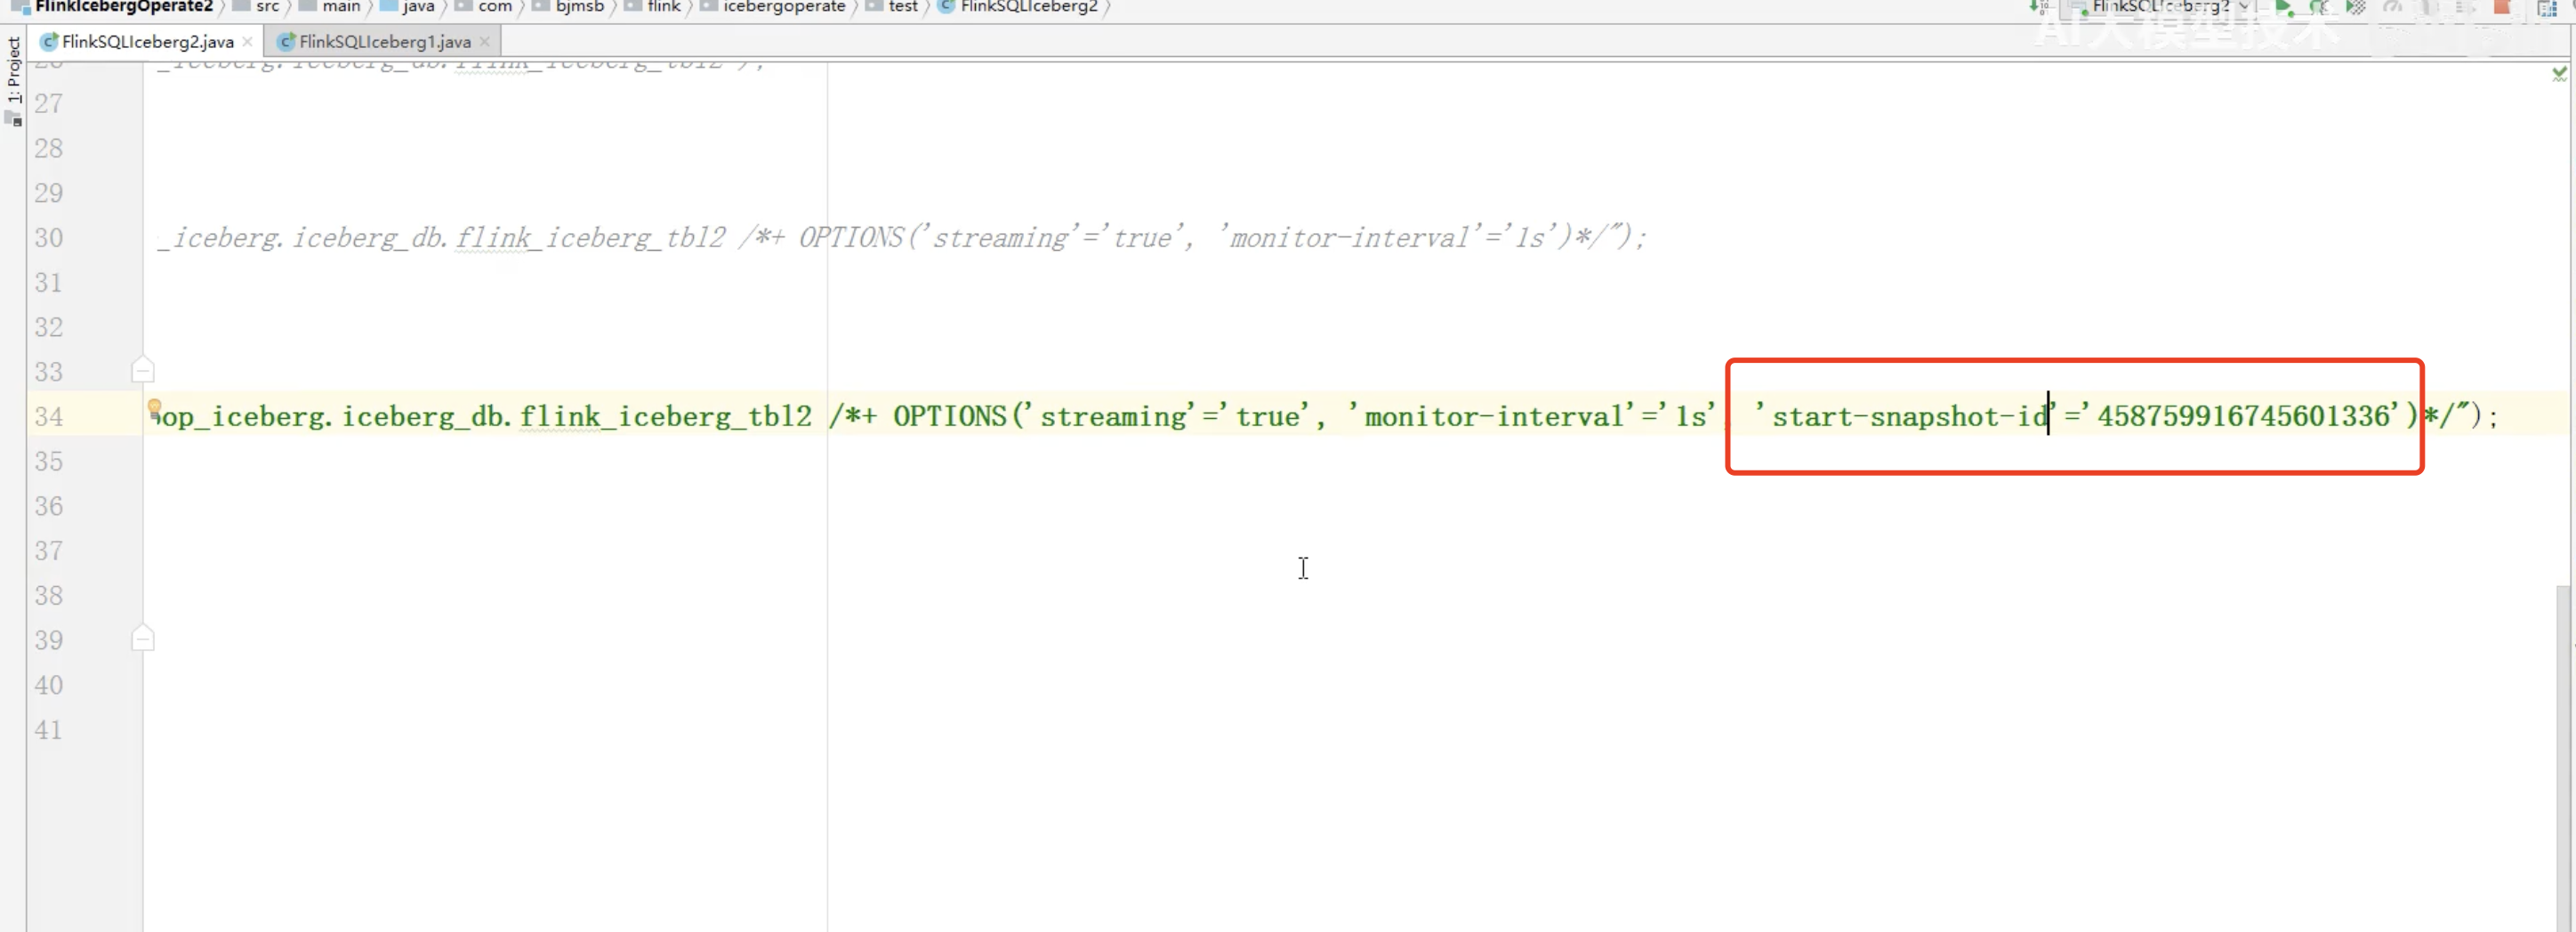
4.2.3 基于快照实时读取
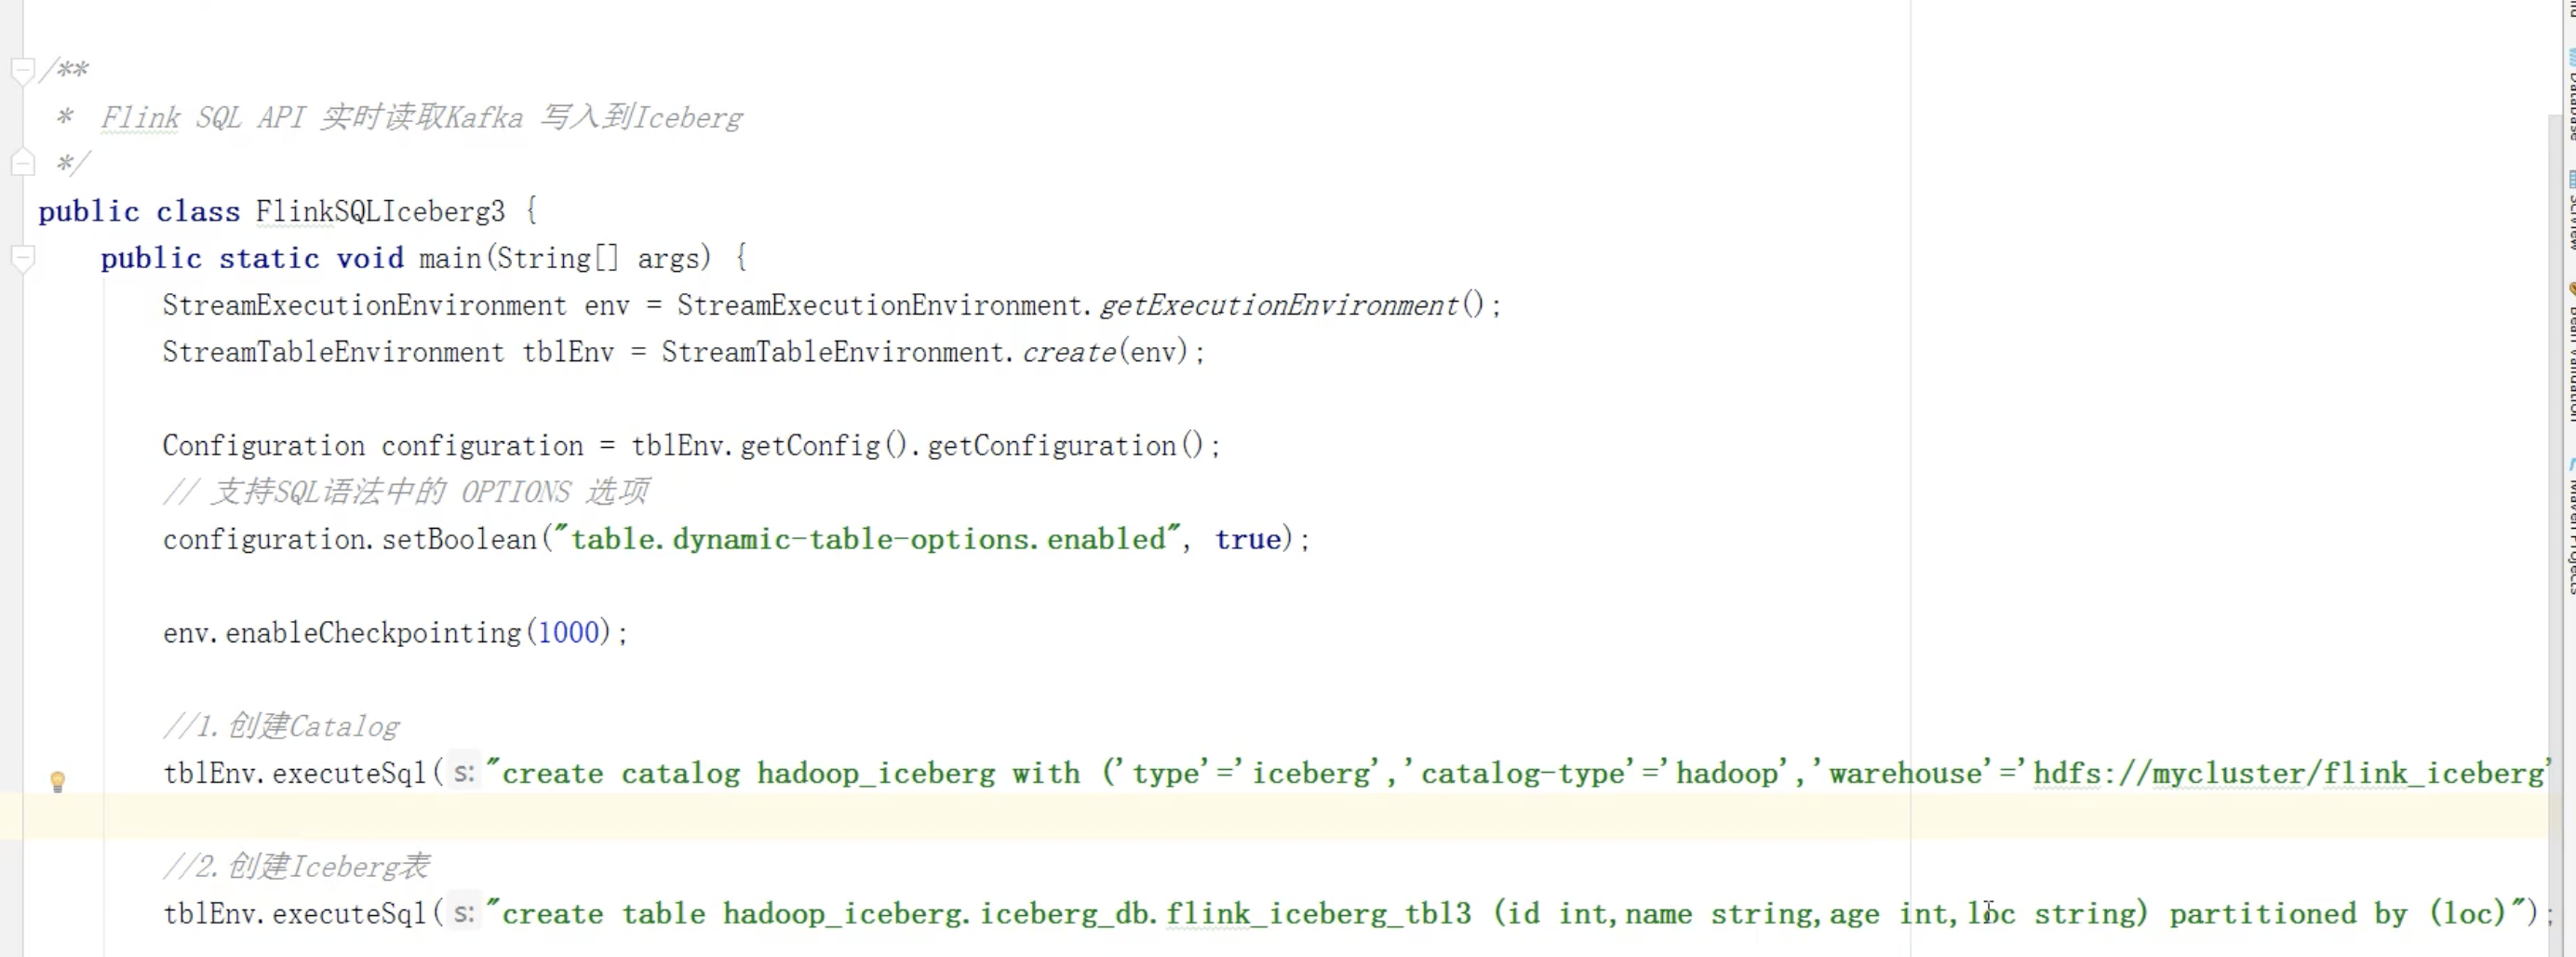
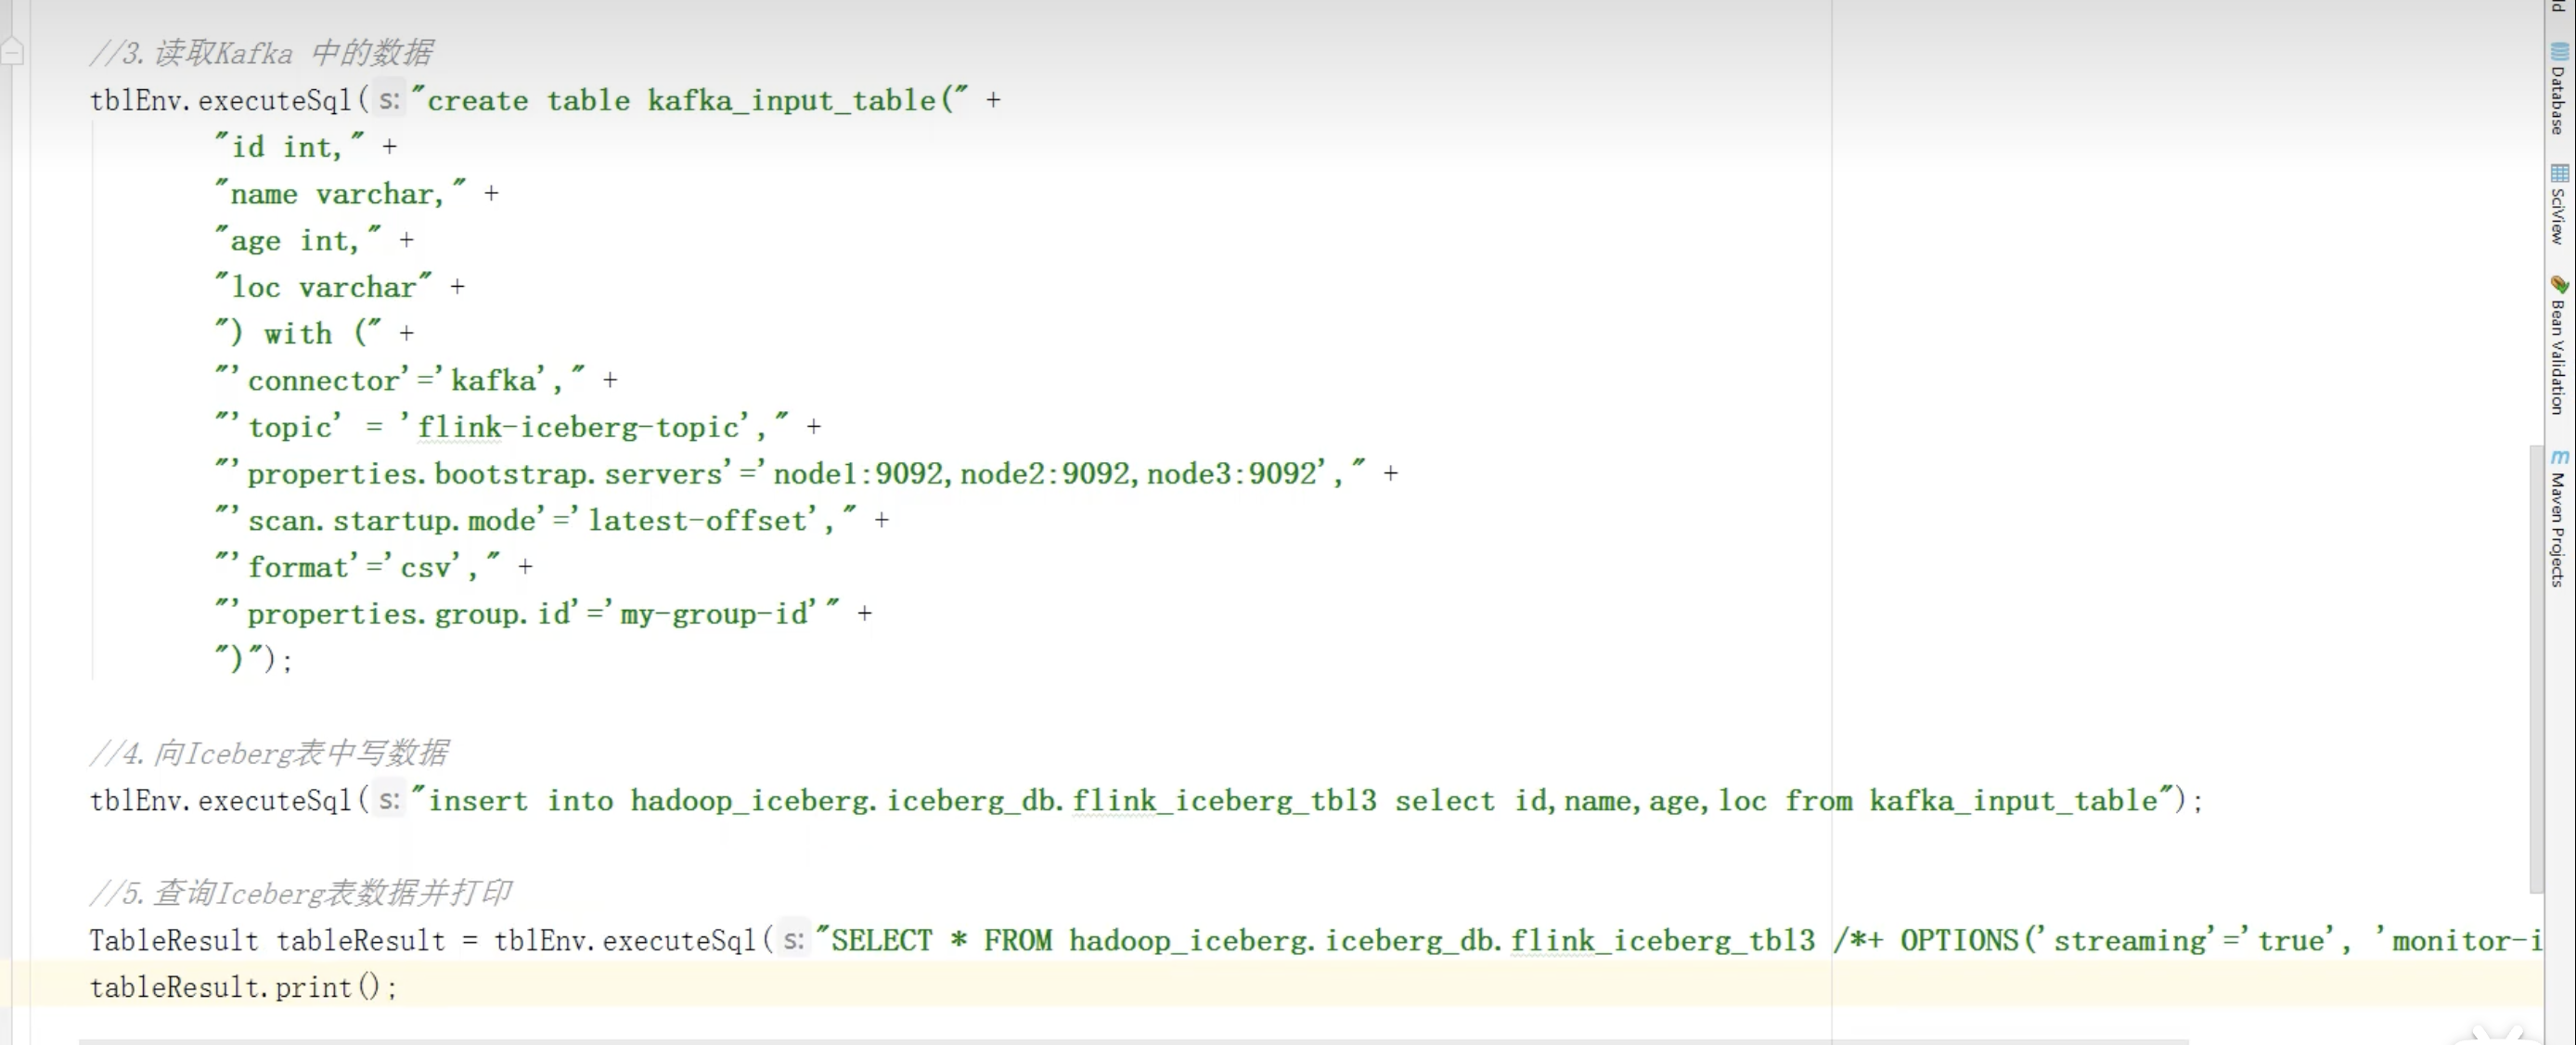
4.2.4 Sql API 实时读取kafka数据,写入Iceberg
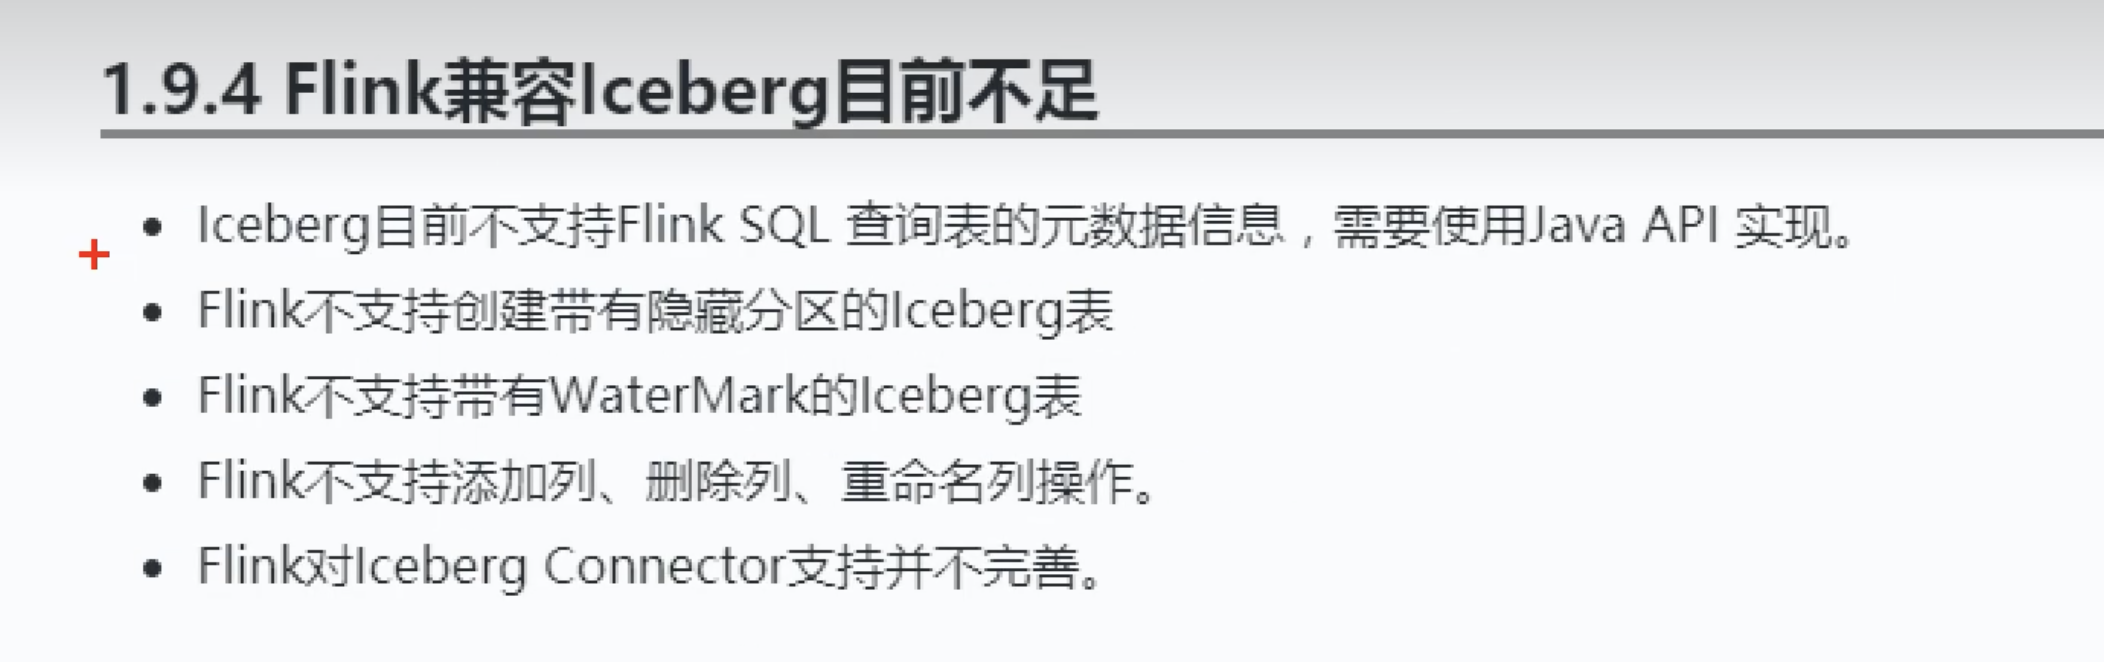
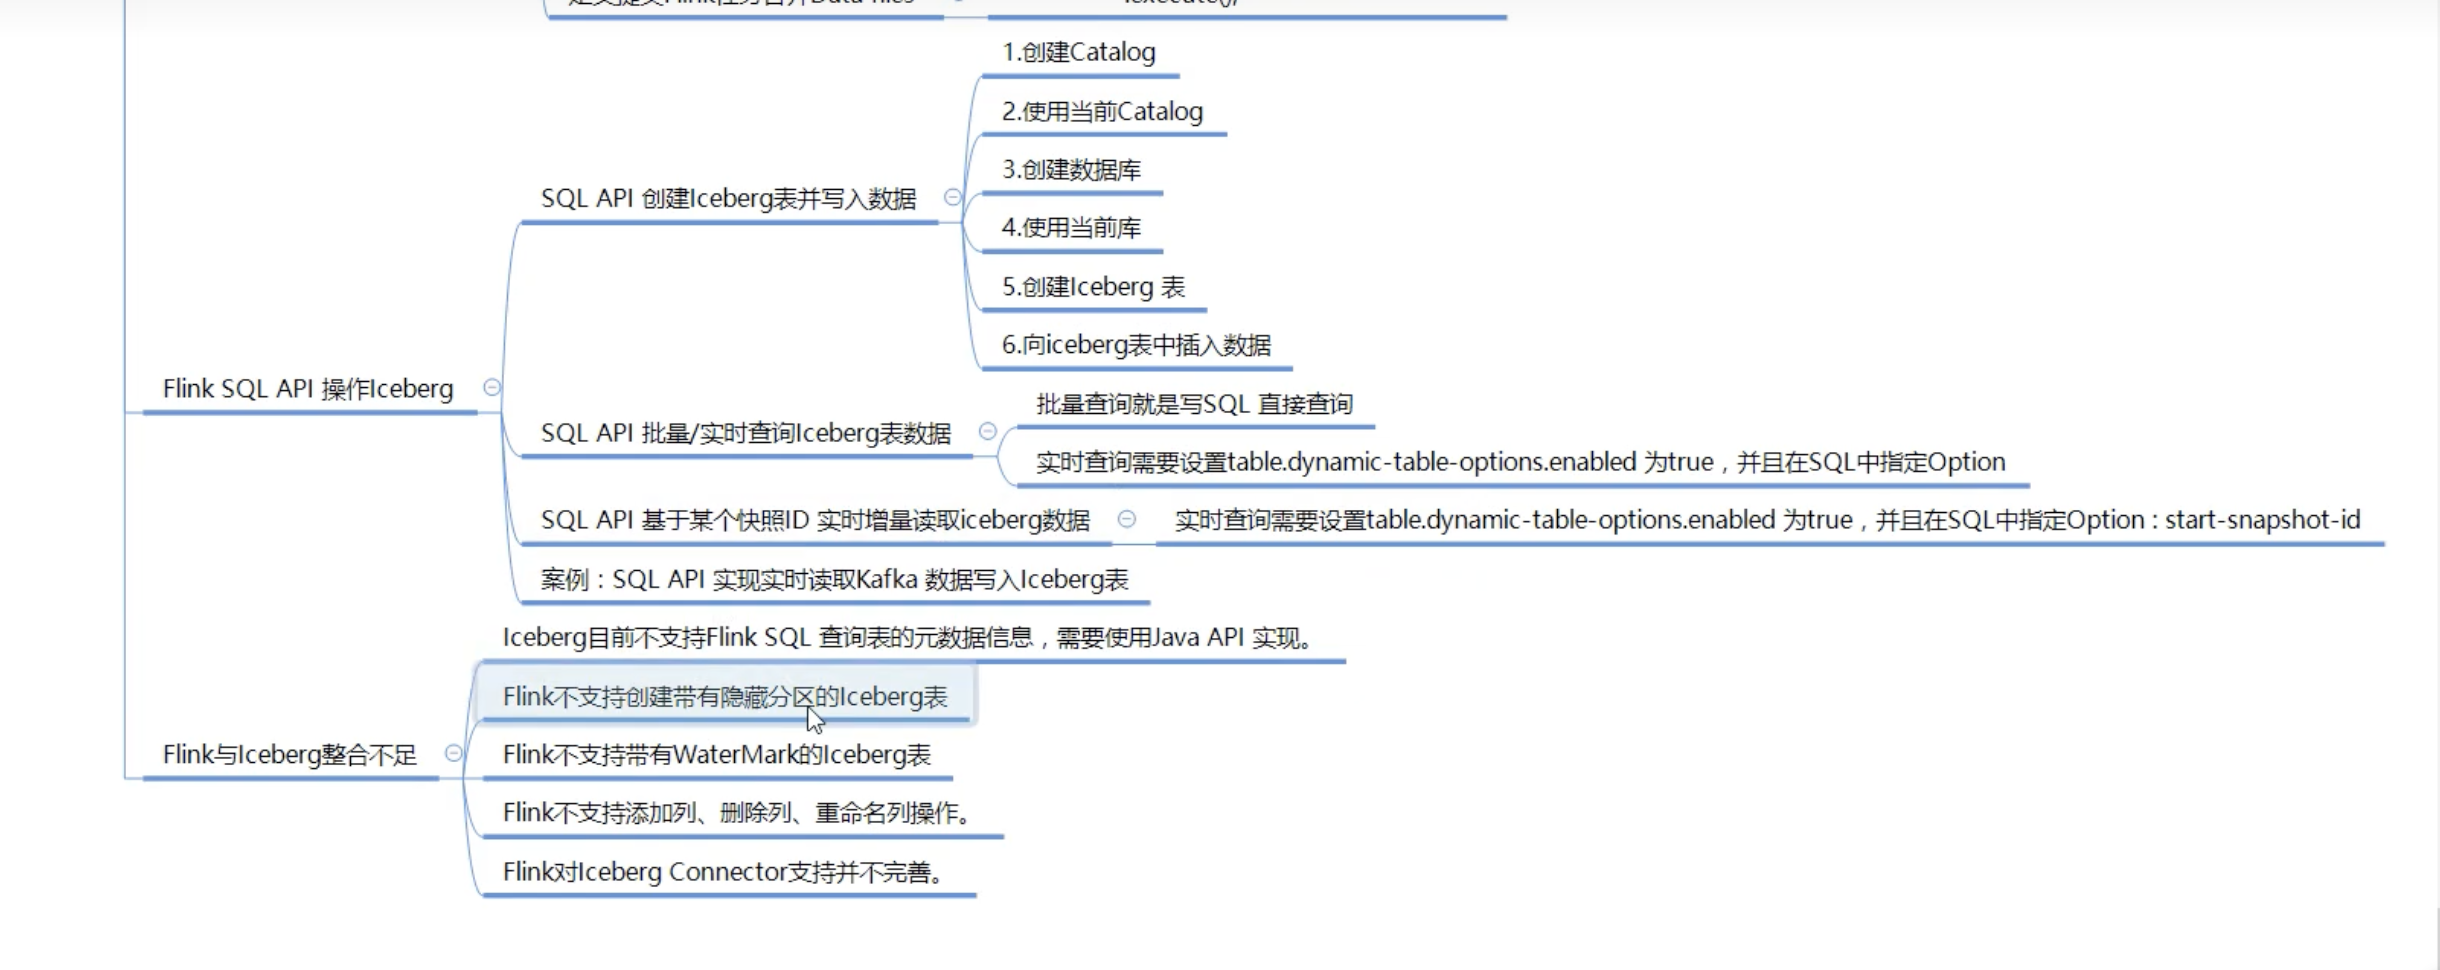
4.3 Flink与Iceberg整合的不足
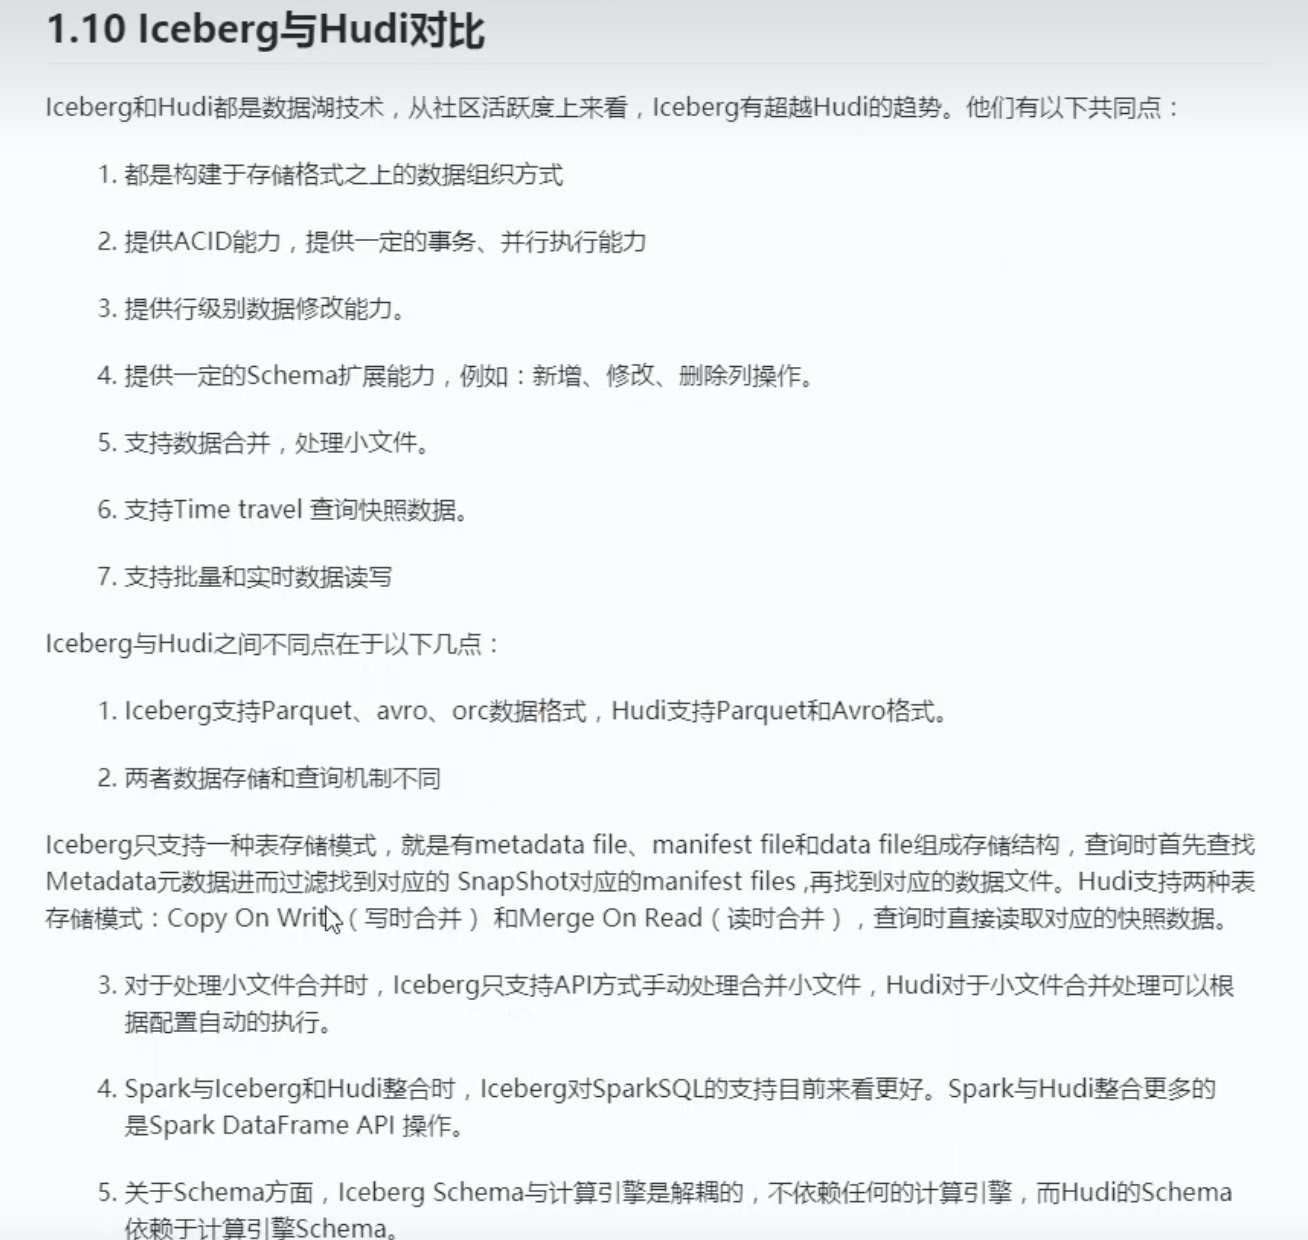
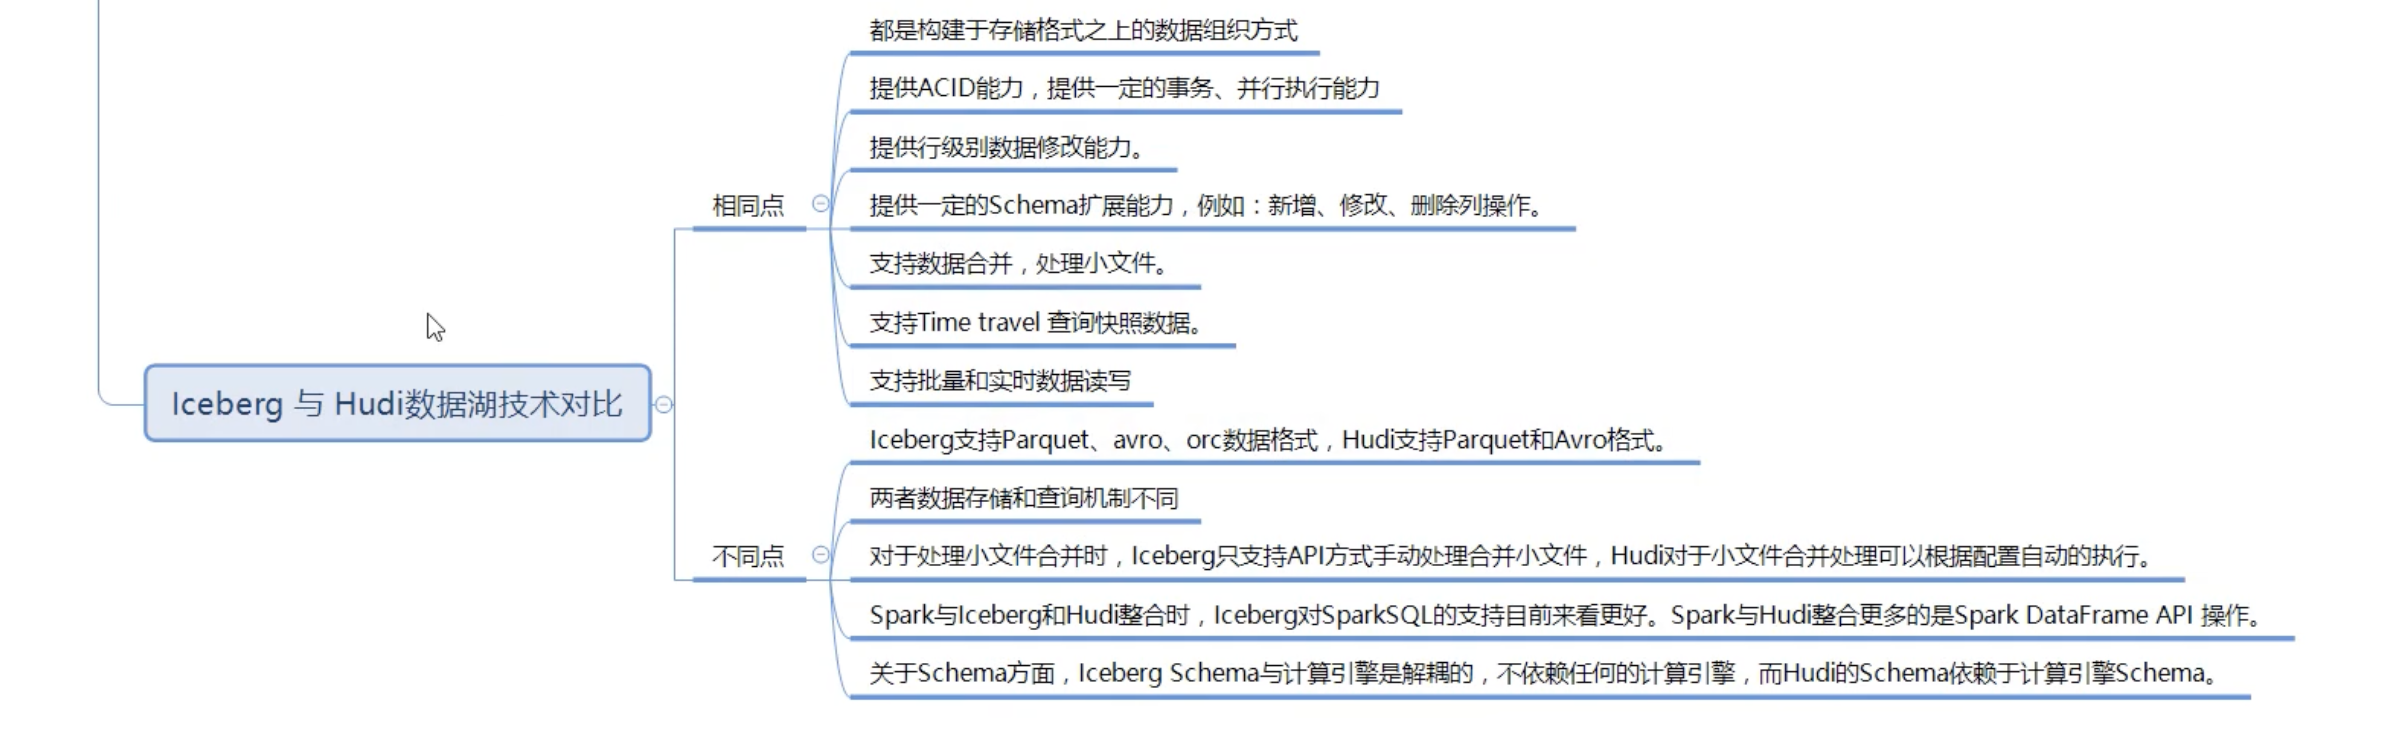
五、Iceberg与Hudi对比