本文面向具有一定 VLM(Vision-Language Model,视觉语言模型)、vLLM(大模型推理与服务框架)和文档解析系统开发经验的工程师,重点介绍百度飞桨 PaddleOCR 最新发布的 HPD-Parsing,包括模型架构、层级并行解码原理、性能指标、部署方式、API 调用、输入输出格式,以及工程落地时需要关注的问题。
一、前言
近年来,基于 VLM(Vision-Language Model,视觉语言模型)的统一式文档解析逐渐成为复杂文档处理的重要技术路线。
传统文档解析系统通常采用多个专用模型组成流水线:
javascript
PDF / 图片
    │
    ▼
文档图像预处理
    │
    ▼
版面分析(Layout Analysis)
    │
    ├── OCR(文字识别)
    ├── 表格识别
    ├── 公式识别
    ├── 图片检测
    └── 阅读顺序恢复
    │
    ▼
后处理
    │
    ▼
Markdown / JSON
这种架构具有很好的模块化特性,但系统也比较复杂。不同模块之间存在数据转换、坐标映射、任务调度以及异常处理等问题。
统一式 VLM 文档解析则尝试将这些任务统一到一个模型中:
文档图像
   │
   ▼
视觉语言模型
   │
   ▼
结构化文档结果
从系统架构角度看,这种方式明显更加简洁。
但是,它也带来了一个新的问题:
生成速度。
传统统一式 VLM 通常采用自回归生成(Autoregressive Generation):模型每次生成一个 Token(模型处理文本的基本单位),然后根据已经生成的结果继续生成下一个 Token。
其过程可以简单表示为:
erlang
Token 1
   ↓
Token 2
   ↓
Token 3
   ↓
Token 4
   ↓
...
   ↓
Token N
对于普通问答任务,这种方式通常可以接受。
但文档解析具有一个非常明显的特点:
输出通常很长。
一个复杂页面可能同时包含:
- 标题
- 正文
- 多栏文本
- 图片
- 图片标题
- 表格
- 公式
- 页眉
- 页脚
- 页码
最终生成的结构化结果可能包含数千甚至更多 Token。
因此,随着输出长度增加,自回归生成的串行依赖会越来越明显。
HPD-Parsing 正是在这个背景下提出的。
二、HPD-Parsing 是什么?
HPD-Parsing 的全称是:
Hierarchical Parallel Document Parsing(层级并行文档解析)
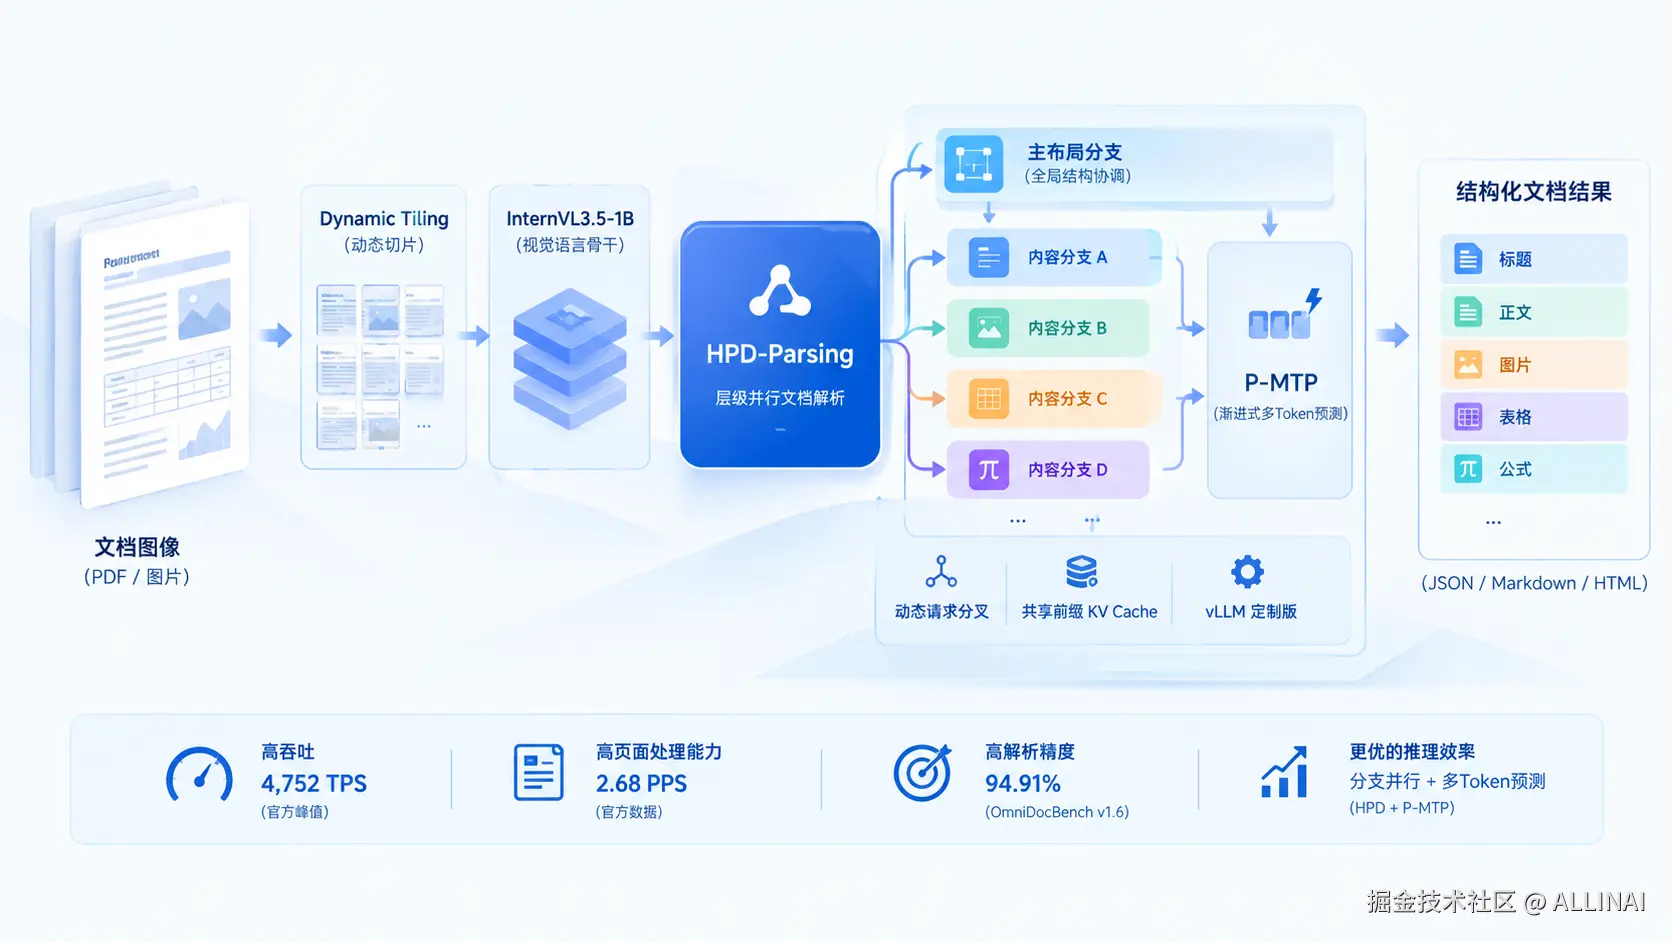
它是百度飞桨 PaddleOCR 推出的轻量级、高吞吐文档解析模型,模型规模约为 1B(10 亿)参数。
官方公布的核心指标包括:
- OmniDocBench v1.6 Overall:94.91%
- 峰值吞吐:4,752 TPS(Tokens Per Second,每秒 Token 数)
- 在官方测试条件下,相比其自回归基线吞吐提升约 3.06×
- 页面吞吐达到 2.68 PPS(Pages Per Second,每秒页面数)
官方 Model Card 将 HPD-Parsing 定位为一种新的统一式文档解析范式:不再让整张页面沿着单一的自回归轨迹生成,而是由一个主布局分支协调全局结构,再将局部内容分配给多个并发分支进行解析,同时结合 P-MTP(Progressive Multi-Token Prediction,渐进式多 Token 预测)进一步减少解码步骤。
因此,HPD-Parsing 最值得关注的并不是"又一个 1B 文档解析模型",而是:
它从推理架构层面重新设计了文档解析的生成过程。
三、传统 VLM 文档解析的性能瓶颈
3.1 单轨迹自回归生成
假设一个页面最终需要生成 6000 个 Token。
传统模型大致需要:
vbnet
Step 1 → Token 1
Step 2 → Token 2
Step 3 → Token 3
Step 4 → Token 4
...
Step 6000 → Token 6000
其核心特点是:
当前 Token 的生成依赖前面的 Token。
因此,即使 GPU 具有很强的并行计算能力,Decode(解码生成)阶段仍然存在天然的串行依赖。
3.2 文档解析其实不需要完全串行
考虑下面这样一张页面:
┌───────────────────────────────────┐
│               标题                │
├────────────────┬──────────────────┤
│                │                  │
│    正文区域    │      图片        │
│                │                  │
├────────────────┴──────────────────┤
│               表格                │
├───────────────────────────────────┤
│               正文                │
└───────────────────────────────────┘
这里实际上存在明显的局部性。
例如:
css
正文区域 A和:
css
图片区域 B之间并不存在强烈的内容生成依赖。
因此没有必要强制要求:
css
正文 A 解析完成
       ↓
图片 B 解析
       ↓
表格 C 解析
       ↓
正文 D 解析
完全串行执行。
这就是 HPD-Parsing 的核心观察:
文档布局需要全局协调,而具体内容往往具有明显的区域局部性。
论文也正是基于这一观察提出 HPD(Hierarchical Parallel Decoding,层级并行解码)范式。
四、HPD-Parsing 的整体架构
HPD-Parsing 使用 InternVL3.5-1B 作为 Backbone(骨干模型),并通过动态 Tile(切片)机制处理高分辨率文档图像。
官方 Model Card 描述其最多可以使用 24 个 448×448 Tile。
整体架构可以抽象为:
css
                    文档图像
                       │
                       ▼
              Dynamic Tiling
              (动态图像切片)
                       │
                       ▼
                InternVL3.5-1B
                  视觉语言骨干
                       │
                       ▼
              Main Layout Branch
                (主布局分支)
                       │
             全局文档结构协调
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
   Content Branch  Content Branch  Content Branch
     局部区域 A       局部区域 B       局部区域 C
        │              │              │
        ▼              ▼              ▼
      P-MTP          P-MTP          P-MTP
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                  结构化结果
整个架构可以概括为三个关键组成部分:
- 视觉编码与高分辨率图像处理
- Hierarchical Parallel Decoding(层级并行解码)
- P-MTP(渐进式多 Token 预测)
五、视觉输入:InternVL3.5-1B 与 Dynamic Tiling
HPD-Parsing 使用 InternVL3.5-1B 作为基础视觉语言模型。
文档解析与普通图片理解最大的不同之一,是:
文档图片中的文字通常非常小。
例如一张 A4 页面可能包含:
标题
正文
表格
脚注
公式
图片说明
如果简单把整张 A4 页面缩放成固定尺寸:
A4 页面
   ↓
448 × 448
小字号文本很容易丢失。
因此,HPD-Parsing 使用 Dynamic Tiling(动态切片)方式处理高分辨率文档。
可以简单理解为:
原始页面

┌────────┬────────┬────────┐
│ Tile 1 │ Tile 2 │ Tile 3 │
├────────┼────────┼────────┤
│ Tile 4 │ Tile 5 │ Tile 6 │
├────────┼────────┼────────┤
│ Tile 7 │ Tile 8 │ Tile 9 │
└────────┴────────┴────────┘
官方架构说明中最多支持 24 个 448×448 Tile。
这样可以在有限视觉 Token 预算下,更好地保留文档中的细粒度文字和版面信息。
六、核心技术:Hierarchical Parallel Decoding
6.1 什么是层级并行解码?
HPD(Hierarchical Parallel Decoding,层级并行解码)的核心思想可以概括为:
先解决全局布局,再并行处理局部内容。
传统统一式文档解析:
markdown
整张页面
    │
    ▼
单一生成轨迹
    │
    ▼
Token 1 → Token 2 → Token 3 → ... → Token N
HPD:
css
整张页面
    │
    ▼
主布局分支
    │
    ├──────────────┬──────────────┐
    ▼              ▼              ▼
局部内容 A       局部内容 B       局部内容 C
    │              │              │
    ▼              ▼              ▼
并行 Decode      并行 Decode      并行 Decode
因此,HPD 同时利用了:
- 文档的全局结构信息;
- 文档区域之间的局部独立性;
- GPU 并行计算能力。
七、Main Layout Branch:主布局分支
HPD-Parsing 并不是简单地把页面切成几个区域,然后独立调用模型。
它首先需要建立:
全局 Layout(布局)结构。
因此存在一个 Main Layout Branch(主布局分支)。
它主要负责回答:
页面有哪些区域?

这些区域是什么类型?

它们之间是什么关系?

这些区域的阅读顺序是什么?

哪些区域需要进一步生成局部内容?
例如:
css
                页面
                 │
                 ▼
          Main Layout Branch
                 │
       ┌─────────┼─────────┐
       ▼         ▼         ▼
     Title     Image      Table
       │         │         │
       ▼         ▼         ▼
    Branch A  Branch B  Branch C
这就是 HPD 中的"Hierarchical(层级)"。
八、Content Branch:局部内容分支
确定页面结构之后,模型会为不同区域创建局部内容分支。
例如:
css
页面
 │
 ├── 标题
 │     └── Content Branch A
 │
 ├── 正文
 │     └── Content Branch B
 │
 ├── 表格
 │     └── Content Branch C
 │
 └── 图片
       └── Content Branch D
每一个 Content Branch(内容分支)负责一个局部区域。
因此:
css
Branch A ─────┐
Branch B ─────┤
Branch C ─────┼──→ 并行执行
Branch D ─────┘
传统方式:
css
A → B → C → DHPD:
css
A ─┐
B ─┤
C ─┼──→ 并行
D ─┘
这就是第一层加速。
九、Dynamic Request Forking:动态请求分叉
要真正实现上面的架构,仅仅修改模型结构还不够。
推理框架也必须支持:
一个父请求动态产生多个子请求。
这就是 Dynamic Request Forking(动态请求分叉)。
可以理解为:
vbscript
Parent Request
      │
      ├──── Child Request A
      │
      ├──── Child Request B
      │
      ├──── Child Request C
      │
      └──── Child Request D
传统 vLLM 请求调度模型并不是专门为这种层级分叉设计的,因此 HPD-Parsing 使用了定制版 vLLM。
官方文档明确指出:
HPD-Parsing 使用基于 vLLM 0.17.1 的定制版本,加入了层级并行解码所需的动态请求分叉机制,并支持 P-MTP 投机解码。
这也是为什么不能简单地:
pip install vllm然后直接加载 HPD-Parsing。
十、Shared Prefix KV Cache:共享前缀键值缓存
多个 Content Branch 往往共享同一个前缀。
例如:
css
System / Image / Layout Prefix
             │
       ┌─────┼─────┐
       ▼     ▼     ▼
      A      B      C
如果每一个分支都重新计算 Prefix(前缀),计算成本会非常高。
因此 HPD-Parsing 使用 Shared Prefix KV Cache(共享前缀键值缓存)。
可以理解为:
css
                 Shared Prefix
                   KV Cache
                      │
          ┌───────────┼───────────┐
          ▼           ▼           ▼
       Branch A    Branch B    Branch C
这样不同分支可以共享前面已经计算好的 Key / Value。
官方 Model Card 特别强调了共享前缀 KV Cache,并指出 vLLM 的 Paged KV Cache(分页键值缓存)可以支持并发分支以及前缀共享。
十一、P-MTP:渐进式多 Token 预测
即使不同区域已经能够并行处理,每一个 Branch 内部仍然存在:
erlang
Token 1
 ↓
Token 2
 ↓
Token 3
 ↓
Token 4
 ↓
...
因此 HPD-Parsing 又引入了:
Progressive Multi-Token Prediction(渐进式多 Token 预测,P-MTP)
它属于 Speculative Decoding(投机解码)技术的一种应用。
11.1 普通自回归 Decode
例如需要生成 12 个 Token:
vbnet
Step 1 → Token 1
Step 2 → Token 2
Step 3 → Token 3
...
Step 12 → Token 12
需要大约 12 个 Decode Step(解码步骤)。
11.2 P-MTP
P-MTP 尝试在一次迭代中预测多个未来 Token:
vbnet
Step 1 → Token 1  Token 2  Token 3  Token 4  ...
Step 2 → Token 5  Token 6  Token 7  Token 8  ...
实际过程并不是简单地"一次无条件生成多个 Token",而是结合投机预测与验证机制减少有效 Decode Step。
官方服务启动参数中:
css
--speculative-config \
'{"method":"medusa",
  "model":".../P-MTP",
  "num_speculative_tokens":6}'
其中:
ini
num_speculative_tokens=6表示每一步最多使用 6 个投机 Token。
十二、HPD + P-MTP 为什么能够明显加速?
HPD 实际上是在两个方向上减少串行依赖。
第一层:Branch Parallelism(分支并行)
css
Layout
  │
  ├── Branch A
  ├── Branch B
  ├── Branch C
  └── Branch D
解决:
不同文档区域之间的串行依赖。
第二层:Multi-Token Prediction(多 Token 预测)
vbnet
Branch A

Step 1 → Token 1~6
Step 2 → Token 7~12
Step 3 → Token 13~18
解决:
单个区域内部 Token-by-Token 的串行问题。
因此:
css
                 HPD-Parsing
                      │
          ┌───────────┴───────────┐
          ▼                       ▼
   Branch Parallelism          P-MTP
      分支并行             多 Token 预测
          │                       │
          ▼                       ▼
减少区域之间串行           减少 Token Decode Step
          │                       │
          └───────────┬───────────┘
                      ▼
                更高推理吞吐
官方实验也显示,随着文档输出长度增加,HPD 的加速优势进一步扩大。在最长输出长度区间,官方报告最多可以减少 18.04× Decode Steps ,提高 3.67× Request Throughput(请求吞吐) ,并降低 5.80× Single-Request Latency(单请求延迟) 。
十三、HPD-Parsing 的性能指标
HPD-Parsing 官方主要在 OmniDocBench v1.6 上进行评测。
其核心指标如下:
| 指标 | HPD-Parsing |
|---|---|
| 模型规模 | 约 1B |
| OmniDocBench v1.6 Overall | 94.91% |
| 峰值 TPS | 4,752.1 |
| PPS | 2.68 |
| Benchmark GPU | NVIDIA A800 80GB |
| Batch Size | 512 |
官方测试显示,在 Batch Size 512、NVIDIA A800 80GB、vLLM 环境下:
PPS:
1.02 → 2.68

TPS:
1,554.8 → 4,752.1
对应:
PPS 提升:2.62×
TPS 提升:3.06×
十四、与其他文档解析模型比较时应该怎么看?
这里需要特别强调:
TPS 不能直接等价于页面解析速度。
TPS:
Tokens Per Second(每秒 Token 数)
PPS:
Pages Per Second(每秒页面数)
两者衡量的对象不同。
假设:
ini
模型 A:
每页输出 1000 Token
TPS = 3000
理论上:
PPS ≈ 3而:
ini
模型 B:
每页输出 3000 Token
TPS = 5000
理论上:
PPS ≈ 1.67因此,如果做文档解析模型选型,不能只看:
TPS还应该关注:
PPS
P50 Latency
P95 Latency
P99 Latency
GPU Memory
Accuracy
十五、HPD-Parsing 与 DeepSeek-OCR-2 的吞吐对比
官方给出的一个非常有价值的比较是:
HPD-Parsing 每页大约处理 4,800 个输入 Token,超过 DeepSeek-OCR-2 的 4 倍,但仍然取得了更高的 PPS 和 TPS。
官方数据显示:
ini
HPD-Parsing
输入 Token ≈ 4,800 / page

但仍然达到:
PPS = 2.68
TPS = 4,752.1
这说明 HPD 的优势并不是来自简单地减少输入 Token,而主要来自:
markdown
层级并行解码
        +
共享前缀 KV Cache
        +
P-MTP
换句话说:
HPD-Parsing 的核心竞争力在于推理效率,而不仅仅是模型规模。
十六、准确率表现
HPD-Parsing 在 OmniDocBench v1.6 上的 Overall 达到:
94.91%
官方将其描述为当前端到端统一式文档解析模型中的领先结果。
这意味着 HPD-Parsing 的目标并不是:
降低准确率
换取速度
而是:
markdown
保持较高解析能力
        +
重新设计 Decode
        ↓
提高吞吐
不过需要注意:
Benchmark 结果不等价于企业真实业务数据上的最终效果。
实际项目中的:
- 扫描 PDF
- 财报
- 合同
- 技术文档
- 论文
- 中文复杂表格
- 多栏排版
- 印章
- 手写内容
可能与公开 Benchmark 存在明显分布差异。
因此生产环境仍然需要使用自己的业务数据进行评测。
十七、部署环境要求
根据百度飞桨官方文档,HPD-Parsing 当前要求:
GPU
已经验证:
yaml
NVIDIA H100
NVIDIA H800
NVIDIA H20
NVIDIA A100
NVIDIA A800
NVIDIA A30
NVIDIA L20
RTX Pro 6000
NVIDIA 驱动需要支持:
CUDA 12.8+操作系统
Linux x86-64其他操作系统需要通过能够运行 Linux NVIDIA GPU 容器的 Docker 环境使用。
Python
如果采用预编译包:
Python 3.10 ~ 3.13Docker
Docker:
shell
>= 19.03同时需要:
NVIDIA Container Toolkit这些要求均来自官方当前使用教程。
十八、一个容易忽略的问题:不需要安装 PaddleOCR
虽然 HPD-Parsing 属于 PaddleOCR 体系,但官方特别说明:
HPD-Parsing 不依赖
paddleocrPython 包。
它使用的是:
markdown
HPD-Parsing
      │
      ▼
定制版 vLLM
      │
      ▼
GPU
而不是传统的:
Python
 ↓
paddleocr
 ↓
Paddle Inference
因此不要按照普通 PaddleOCR 模型的方式安装和调用。
十九、部署方式一:Docker
官方推荐优先使用 Docker,因为它已经包含:
- 定制版 vLLM
- HPD-Parsing 所需依赖
- 推理环境
官方镜像:
bash
ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/hpd-parsing-vllm:latest-nvidia-gpu启动:
css
docker run \
    -it \
    --rm \
    --gpus all \
    --network host \
    ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/hpd-parsing-vllm:latest-nvidia-gpu
默认监听:
yaml
8118官方当前文档显示:
在线镜像:约 20.2 GB
离线镜像:约 24.5 GB
离线镜像:
bash
ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/hpd-parsing-vllm:latest-nvidia-gpu-offline离线镜像已经包含模型权重,因此适合无法访问互联网的环境。
二十、Docker 模型缓存
在线镜像启动时会自动下载模型。
如果直接使用:
arduino
docker run --rm ...容器删除以后,容器内部缓存也可能随之消失。
因此生产环境建议挂载缓存:
css
docker run \
    -it \
    --rm \
    --gpus all \
    --network host \
    -v hpd_parsing_hf_cache:/home/hpd/.cache/huggingface \
    ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/hpd-parsing-vllm:latest-nvidia-gpu
官方文档也给出了这种缓存复用方式。
二十一、部署方式二:安装预编译 vLLM
如果不能使用 Docker,可以直接安装官方提供的定制版 vLLM 预编译包。
创建虚拟环境:
bash
python -m venv .venv_hpd_parsing

source .venv_hpd_parsing/bin/activate
安装:
ruby
python -m pip install \
https://paddle-model-ecology.bj.bcebos.com/paddlex/PaddleX3.0/deploy/hpd_parsing/vllm-0.17.1+hpdparsing-cp38-abi3-manylinux_2_31_x86_64.whl
然后下载模型:
css
hf download PaddlePaddle/HPD-Parsing \
    --local-dir ./HPD-Parsing
下载后必须确认:
arduino
HPD-Parsing/
├── config.json
└── P-MTP/
    └── config.json
这里的:
css
P-MTP/不能遗漏。
因为它包含 P-MTP 投机解码所需的模型权重。
二十二、启动 HPD-Parsing 服务
官方推荐的服务启动命令:
sql
MODEL_PATH="$(realpath ./HPD-Parsing)"

MAX_PATCHES_WITH_RESIZE=true \
vllm serve "${MODEL_PATH}" \
    --trust-remote-code \
    --port 8118 \
    --served-model-name HPD-Parsing \
    --max-model-len 16384 \
    --limit-mm-per-prompt '{"image": 1}' \
    --gpu-memory-utilization 0.9 \
    --attention-backend FLASHINFER \
    --attention-config '{"use_prefill_query_quantization":true}' \
    --enable-chunked-prefill \
    --enable-prefix-caching \
    --speculative-config \
    "{"method":"medusa","model":"${MODEL_PATH}/P-MTP","num_speculative_tokens":6}"
官方文档给出的这些参数是 HPD-Parsing 正常发挥性能的重要组成部分。
二十三、启动参数详解
| 参数 | 含义 | 作用 |
|---|---|---|
MAX_PATCHES_WITH_RESIZE=true |
最大切片与 Resize 行为 | 官方要求设置 |
--trust-remote-code |
信任模型远程代码 | 加载模型自定义实现 |
--port 8118 |
服务端口 | API 监听端口 |
--served-model-name |
服务模型名称 | API 调用时使用 |
--max-model-len |
最大上下文长度 | 控制最大上下文 |
--limit-mm-per-prompt |
每个请求最多图片数 | 当前配置为 1 |
--gpu-memory-utilization |
GPU 显存利用率 | 控制 vLLM 显存使用 |
--attention-backend FLASHINFER |
Attention(注意力机制)后端 | 官方推荐 |
--enable-chunked-prefill |
Chunked Prefill(分块预填充) | 优化长输入 |
--enable-prefix-caching |
Prefix Caching(前缀缓存) | 支持前缀复用 |
--speculative-config |
投机解码配置 | 启用 P-MTP |
二十四、为什么 enable-prefix-caching 非常重要?
HPD 的架构天然存在:
css
Parent
  │
  ├── Branch A
  ├── Branch B
  ├── Branch C
  └── Branch D
如果没有 Prefix Caching:
css
Prefix
 ├── A → 重新计算
 ├── B → 重新计算
 ├── C → 重新计算
 └── D → 重新计算
会造成大量重复计算。
启用 Prefix Caching:
css
              Prefix KV Cache
                     │
          ┌──────────┼──────────┐
          ▼          ▼          ▼
          A          B          C
可以让多个分支复用公共前缀。
因此:
对 HPD 来说,Prefix Caching 并不是普通的"小优化",而是并行分支高效运行的重要基础设施。
二十五、OpenAI 兼容 API
HPD-Parsing 服务启动后,可以通过 OpenAI Compatible API(OpenAI 兼容接口)调用。
安装:
python -m pip install openai客户端:
ini
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8118/v1",
    api_key="EMPTY",
)
这里的:
base_url指向的是你自己部署的 HPD-Parsing 服务。
二十六、输入数据格式
HPD-Parsing 使用 OpenAI Chat Completions 风格的多模态输入。
基本结构:
json
{
  "model": "HPD-Parsing",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "data:image/png;base64,..."
          }
        },
        {
          "type": "text",
          "text": "document parsing with fork."
        }
      ]
    }
  ],
  "max_tokens": 8000,
  "temperature": 0
}
其中最重要的是:
image_url可以直接使用:
bash
data:image/png;base64,...形式传入图片。
官方客户端示例也是采用 Base64 图片 + 固定 Prompt 的方式。
二十七、Prompt 为什么必须固定?
HPD-Parsing 官方要求使用:
javascript
document parsing with fork.这个 Prompt。
注意:
它不是普通意义上的"请解析这张图片"。
HPD-Parsing 的服务端会根据这个请求进入对应的层级并行解析模式。
因此不建议修改为:
javascript
Please parse this document.或者:
请解析这张文档。官方文档明确要求解析文档图像时使用:
javascript
document parsing with fork.二十八、完整 Python 调用示例
ini
import base64

from openai import OpenAI


client = OpenAI(
    base_url="http://127.0.0.1:8118/v1",
    api_key="EMPTY",
)


def encode_image(image_path: str) -> str:
    with open(image_path, "rb") as f:
        return base64.b64encode(f.read()).decode("utf-8")


image_base64 = encode_image("demo.png")


response = client.chat.completions.create(
    model="HPD-Parsing",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{image_base64}"
                    },
                },
                {
                    "type": "text",
                    "text": "document parsing with fork.",
                },
            ],
        }
    ],
    max_tokens=8000,
    temperature=0,
)


result = response.choices[0].message.content

print(result)
这套调用方式对应官方当前服务化调用示例。
二十九、输入图片需要注意什么?
由于当前服务配置:
css
--limit-mm-per-prompt '{"image": 1}'意味着:
一个请求当前限制为一张图片。
因此,如果原始 PDF 有 100 页,不建议:
100 页图片
   ↓
一次 API 请求
而应该:
vbscript
PDF
 │
 ▼
Page 1 ──→ Request 1
Page 2 ──→ Request 2
Page 3 ──→ Request 3
...
Page 100 → Request 100
再由上层文档任务调度系统负责:
diff
任务拆分
+
并发调度
+
结果合并
+
异常重试
+
顺序恢复
三十、输出数据格式
HPD-Parsing 返回的并不是传统 OCR 的 JSON:
json
{
  "text": "...",
  "boxes": [...]
}
而是一种结构化文档文本表示。
核心结构为:
scss
<BLOCK>block_type [x1, y1, x2, y2]<CHILD>content例如:
scss
<BLOCK>title [100, 80, 900, 150]<CHILD>文档标题
<BLOCK>text [100, 180, 900, 400]<CHILD>这里是正文内容
<BLOCK>image [100, 450, 900, 800]
官方文档明确指出,每个版面块以 <BLOCK> 开头,随后依次包含:
- Block 类型
- 边界框坐标
- 可选的
<CHILD> - 文本内容
而 image 等没有文本内容的块不会包含 <CHILD>。
三十一、BLOCK 数据结构
可以把:
scss
<BLOCK>text [100,200,800,400]<CHILD>Hello World理解为:
json
{
  "type": "text",
  "bbox": [100, 200, 800, 400],
  "text": "Hello World"
}
其中:
bash
type表示版面块类型。
例如官方示例中出现:
arduino
text
title
image
image_caption
header
page_number
等类型。
三十二、建议在业务系统中转换成自己的 JSON Schema
虽然 HPD-Parsing 原始输出格式非常紧凑,但在正式文档解析系统中,不建议直接将这段字符串作为下游统一数据结构。
更合理的架构是:
css
HPD-Parsing
     │
     ▼
Raw Result
     │
     ▼
HPD Output Parser
     │
     ▼
Block Validator
     │
     ▼
Unified Document Schema
     │
 ┌───┼────┬──────┐
 ▼   ▼    ▼      ▼
JSON Markdown HTML RAG
例如:
json
{
  "blocks": [
    {
      "type": "title",
      "bbox": [100, 80, 900, 150],
      "text": "标题"
    },
    {
      "type": "text",
      "bbox": [100, 180, 900, 400],
      "text": "正文内容..."
    },
    {
      "type": "image",
      "bbox": [100, 450, 900, 800],
      "text": ""
    }
  ]
}
这样更方便后续:
- Markdown 导出
- HTML 重建
- RAG(Retrieval-Augmented Generation,检索增强生成)
- Chunk(文本分块)
- Embedding(向量嵌入)
- 向量数据库入库
- 数据库存储
- 文档结构分析
三十三、官方 BLOCK 解析代码
官方提供了一个简单的正则表达式(Regular Expression,正则表达式)解析方式:
python
import re


def parse_blocks(input_text: str) -> list[dict]:
    """解析输出中的所有版面块"""

    pattern = re.compile(
        r"<BLOCK>(\w+)\s*[([^]]*)]"
        r"(?:<CHILD>)?(.*?)(?=<BLOCK>|\Z)",
        re.DOTALL,
    )

    blocks = []

    for block_type, coords_str, content in pattern.findall(input_text):
        blocks.append(
            {
                "type": block_type,
                "bbox": [
                    int(x.strip())
                    for x in coords_str.split(",")
                ],
                "text": content.strip(),
            }
        )

    return blocks
三十四、生产环境中不要简单照搬正则解析
上面的代码非常适合作为:
Demo
测试
快速验证
但如果进入生产环境,建议进一步设计专门的 Parser(解析器):
scss
Raw HPD Result
      │
      ▼
Syntax Parser
      │
      ▼
Block Validator
      │
      ▼
Coordinate Validator
      │
      ▼
Content Normalizer
      │
      ▼
Unified Document Schema
至少应该检查:
markdown
1. BLOCK 是否完整
2. bbox 是否包含 4 个坐标
3. 坐标是否越界
4. type 是否属于允许的 Block 类型
5. CHILD 内容是否正确关联
6. Block 顺序是否符合阅读顺序
7. 输出是否发生截断
这样才能真正把模型输出转换成可靠的业务数据。
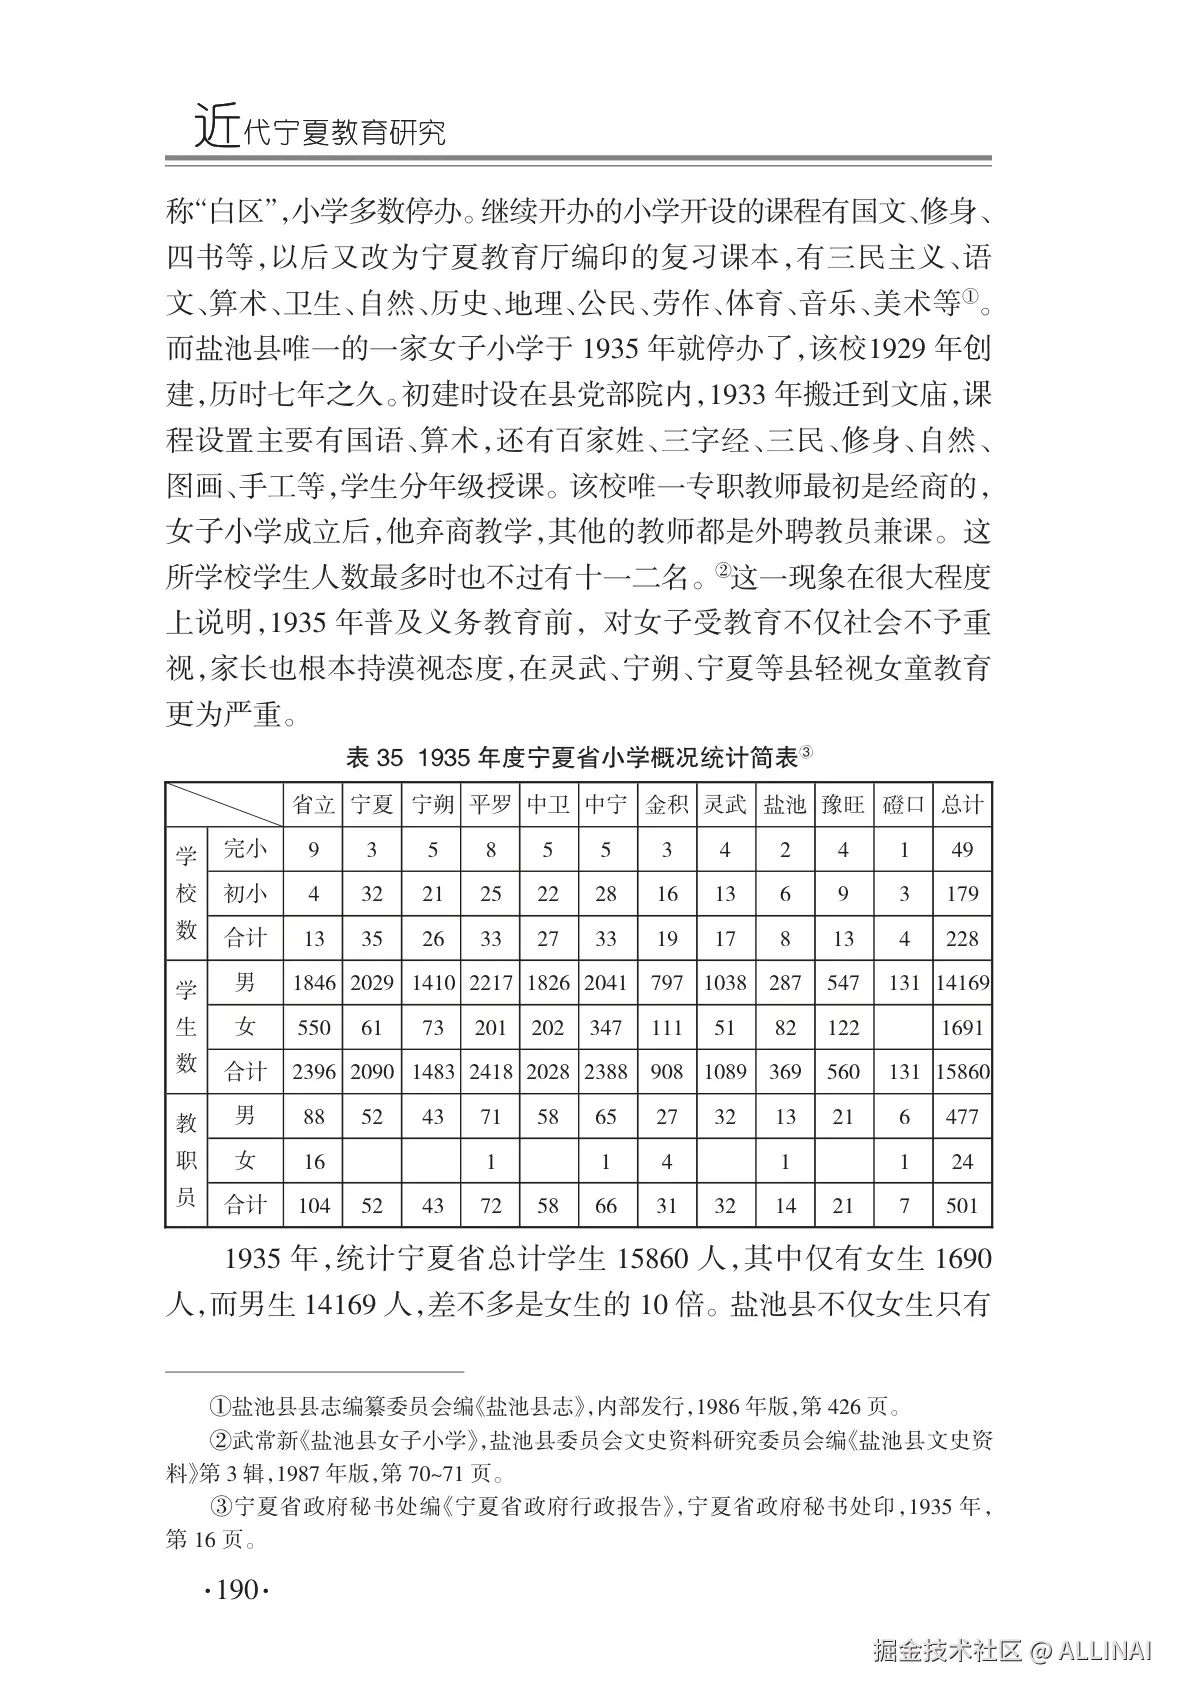
三十五、真实输入示例
三十六、真实输出示例
txt
<BLOCK>header [159, 57, 378, 88]<CHILD>近代宁夏教育研究
<BLOCK>text [132, 113, 840, 430]<CHILD>称"白区",小学多数停办。继续开办的小学开设的课程有国文、修身、四书等,以后又改为宁夏教育厅编印的复习课本,有三民主义、语文、算术、卫生、自然、历史、地理、公民、劳作、体育、音乐、美术等①。而盐池县唯一的一家女子小学于1935年就停办了,该校1929年创建,历时七年之久。初建时设在县党部院内,1933年搬迁到文庙,课程设置主要有国语、算术,还有百家姓、三字经、三民、修身、自然、图画、手工等,学生分年级授课。该校唯一专职教师最初是经商的,女子小学成立后,他弃商教学,其他的教师都是外聘教员兼课。这所学校学生人数最多时也不过有十一二名。②这一现象在很大程度上说明,1935年普及义务教育前,对女子受教育不仅社会不予重视,家长也根本持漠视态度,在灵武、宁朔、宁夏等县轻视女童教育更为严重。
<BLOCK>table_caption [285, 436, 684, 453]<CHILD>表 35 1935 年度宁夏省小学概况统计简表 \( ^{③} \)
<BLOCK>table [136, 457, 839, 723]<CHILD><table><tr><td colspan="2"></td><td>省立</td><td>宁夏</td><td>宁朔</td><td>平罗</td><td>中卫</td><td>中宁</td><td>金积</td><td>灵武</td><td>盐池</td><td>豫旺</td><td>磴口</td><td>总计</td></tr><tr><td rowspan="3">学校数</td><td>完小</td><td>9</td><td>3</td><td>5</td><td>8</td><td>5</td><td>5</td><td>3</td><td>4</td><td>2</td><td>4</td><td>1</td><td>49</td></tr><tr><td>初小</td><td>4</td><td>32</td><td>21</td><td>25</td><td>22</td><td>28</td><td>16</td><td>13</td><td>6</td><td>9</td><td>3</td><td>179</td></tr><tr><td>合计</td><td>13</td><td>35</td><td>26</td><td>33</td><td>27</td><td>33</td><td>19</td><td>17</td><td>8</td><td>13</td><td>4</td><td>228</td></tr><tr><td rowspan="3">学生数</td><td>男</td><td>1846</td><td>2029</td><td>1410</td><td>2217</td><td>1826</td><td>2041</td><td>797</td><td>1038</td><td>287</td><td>547</td><td>131</td><td>14169</td></tr><tr><td>女</td><td>550</td><td>61</td><td>73</td><td>201</td><td>202</td><td>347</td><td>111</td><td>51</td><td>82</td><td>122</td><td></td><td>1691</td></tr><tr><td>合计</td><td>2396</td><td>2090</td><td>1483</td><td>2418</td><td>2028</td><td>2388</td><td>908</td><td>1089</td><td>369</td><td>560</td><td>131</td><td>15860</td></tr><tr><td rowspan="3">教职员</td><td>男</td><td>88</td><td>52</td><td>43</td><td>71</td><td>58</td><td>65</td><td>27</td><td>32</td><td>13</td><td>21</td><td>6</td><td>477</td></tr><tr><td>女</td><td>16</td><td></td><td></td><td>1</td><td></td><td>1</td><td>4</td><td></td><td>1</td><td></td><td>1</td><td>24</td></tr><tr><td>合计</td><td>104</td><td>52</td><td>43</td><td>72</td><td>58</td><td>66</td><td>31</td><td>32</td><td>14</td><td>21</td><td>7</td><td>501</td></tr></table>
<BLOCK>text [134, 729, 838, 777]<CHILD>1935年,统计宁夏省总计学生15860人,其中仅有女生1690人,而男生14169人,差不多是女生的10倍。盐池县不仅女生只有
<BLOCK>list [131, 813, 840, 914]
<BLOCK>page_footnote [169, 818, 757, 835]<CHILD>①盐池县县志编纂委员会编《盐池县志》,内部发行,1986年版,第426页。
<BLOCK>page_footnote [133, 838, 837, 873]<CHILD>②武常新《盐池县女子小学》,盐池县委员会文史资料研究委员会编《盐池县文史资料》第3辑,1987年版,第70~71页。
<BLOCK>page_footnote [133, 876, 835, 912]<CHILD>③宁夏省政府秘书处编《宁夏省政府行政报告》,宁夏省政府秘书处印,1935年,第16页。
<BLOCK>page_number [169, 926, 227, 942]<CHILD>·190·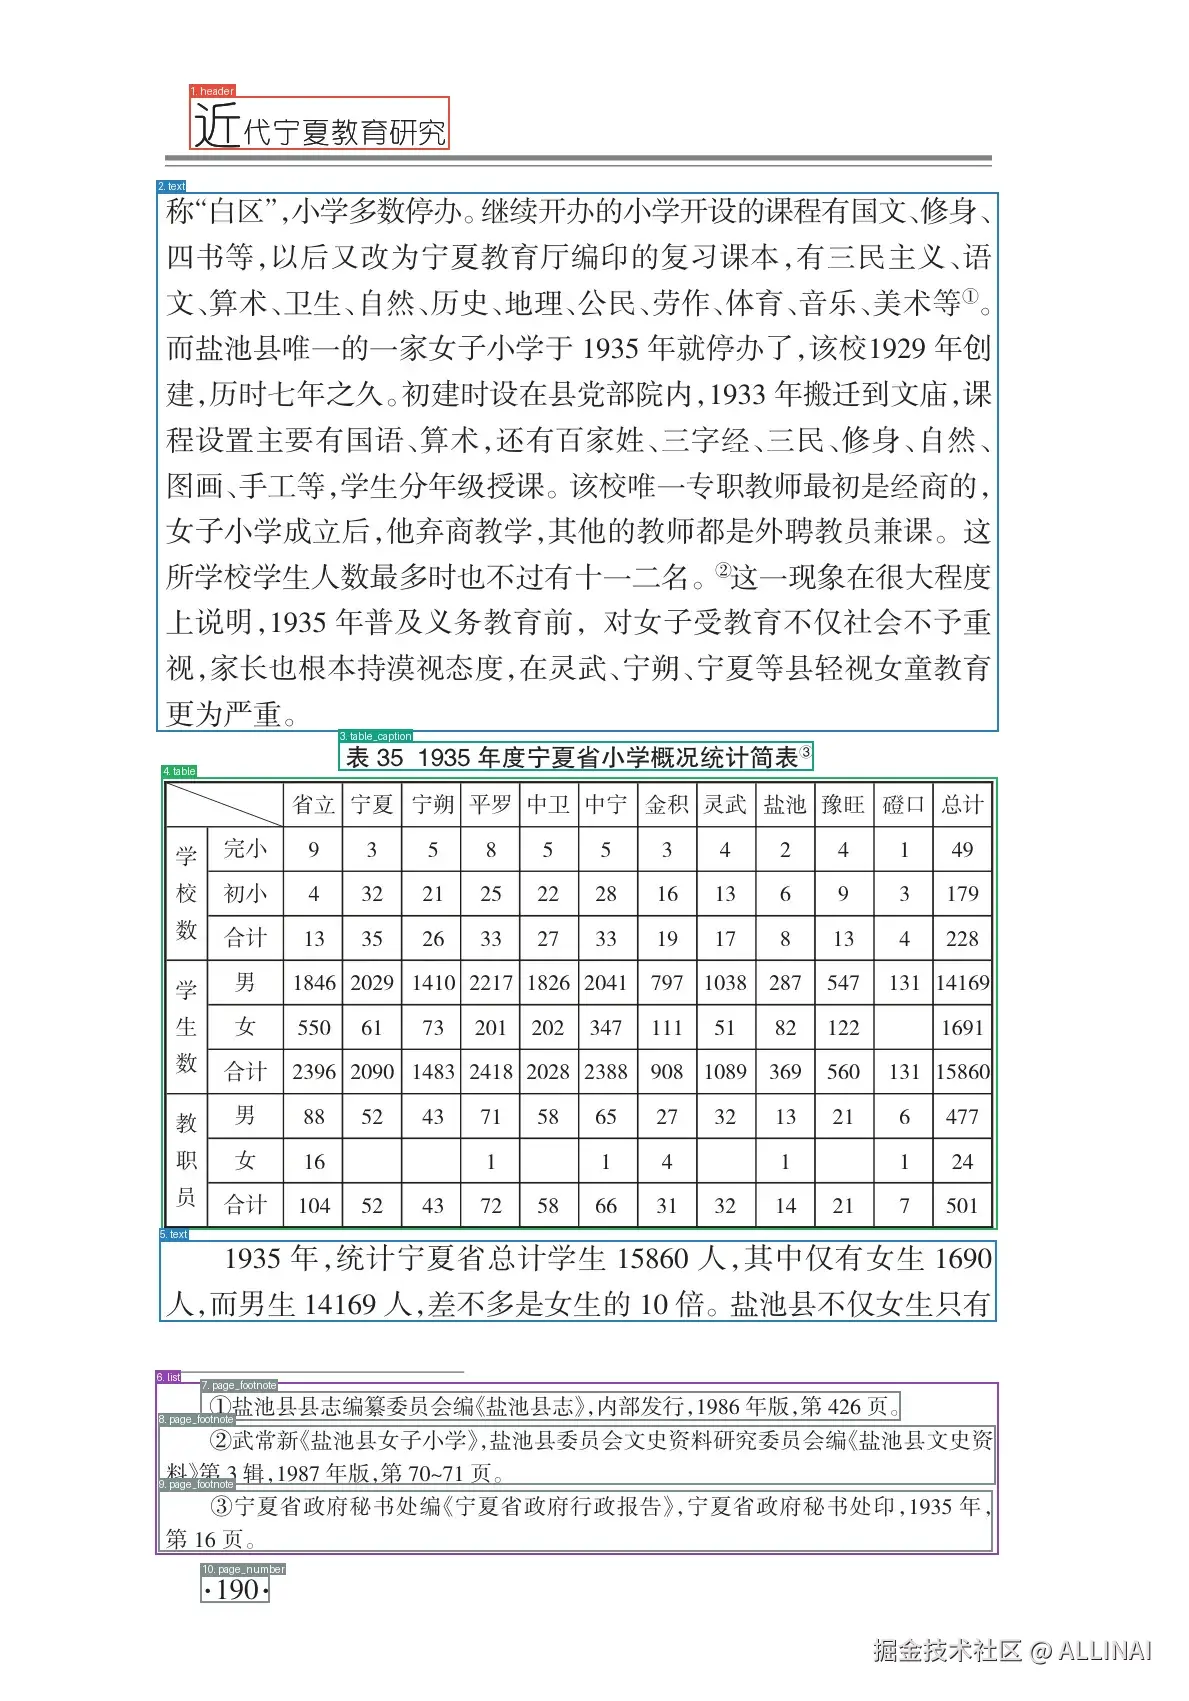
三十七、批量调用
文档解析系统通常需要处理:
javascript
document.pdf
    │
    ├── page_001.png
    ├── page_002.png
    ├── page_003.png
    ├── ...
    └── page_100.png
官方建议批量处理时使用多线程或异步方式并发提交请求。
例如:
python
from concurrent.futures import ThreadPoolExecutor


with ThreadPoolExecutor(max_workers=16) as executor:
    results = list(
        executor.map(
            parse_one,
            image_paths,
        )
    )
但需要注意:
max_workers=16只是官方示例,并不是所有 GPU 都应该设置成 16。
实际并发度应该根据:
diff
GPU 显存
+
输入图像大小
+
输入 Token
+
输出 Token
+
max_model_len
+
KV Cache
+
实际吞吐
进行压测。
三十八、生产环境更推荐服务化部署
对于真正的文档解析平台,不建议每个任务自己加载模型。
不推荐:
arduino
Task 1
 ↓
加载模型
 ↓
GPU

Task 2
 ↓
加载模型
 ↓
GPU
而应该:
arduino
                    Document API
                         │
                         ▼
                    Task Queue
                         │
             ┌───────────┴───────────┐
             ▼                       ▼
         Worker / Client         Worker / Client
             │                       │
             └───────────┬───────────┘
                         ▼
                  HPD-Parsing Server
                         │
                       vLLM
                         │
                         ▼
                        GPU
模型长期驻留 GPU。
多个业务请求进入同一个推理服务,由 vLLM 统一完成请求调度。
这才更符合 HPD-Parsing 的高吞吐设计目标。
三十九、max_tokens 应该怎么设置?
官方客户端示例:
ini
max_tokens=8000它表示:
当前请求允许生成的最大输出 Token 数。
如果设置太小:
ini
max_tokens=2000复杂页面可能发生输出截断。
如果设置得过大:
ini
max_tokens=20000又会增加:
- KV Cache 压力
- 显存占用
- 请求调度压力
因此生产环境建议根据实际业务数据统计:
P50 Output Length
P95 Output Length
P99 Output Length
然后再设置合理的安全余量。
四十、max-model-len 和 max_tokens 的区别
这两个参数很容易混淆。
max-model-len
表示:
模型允许处理的最大上下文长度。
max_tokens
表示:
当前请求最多生成多少 Token。
可以简单理解为:
lua
max-model-len
│
├── Input Tokens
│
└── Output Tokens
        ↑
    max_tokens
因此:
css
Input Tokens + Output Tokens不能超过模型上下文限制。
官方服务示例默认:
python
--max-model-len 16384并说明该值可以根据显存情况调整。
四十一、GPU 显存配置
官方默认:
css
--gpu-memory-utilization 0.9也就是允许 vLLM 使用大约 90% 的 GPU 显存。
但实际显存并不只有模型权重。
还包括:
markdown
Model Weights
      +
Vision Encoder
      +
KV Cache
      +
Activation
      +
vLLM Runtime
      +
CUDA Runtime
因此:
不能简单根据"模型只有 1B 参数"判断 HPD-Parsing 需要多少显存。
尤其是高分辨率图片、多并发、长输出场景,KV Cache 可能成为显存的重要消耗来源。
四十二、为什么 HPD-Parsing 对高并发更加友好?
传统 VLM:
css
Request A
   ↓
Decode 1 → 2 → 3 → 4 → ...
多个请求虽然可以 Batch,但每个请求自身仍然具有串行 Decode。
HPD:
css
Request A
 ├── Branch A
 ├── Branch B
 └── Branch C

Request B
 ├── Branch A
 ├── Branch B
 └── Branch C
vLLM 可以在更大的请求池中进行统一调度。
因此:
HPD-Parsing 的优势尤其适合多请求、高吞吐场景。
这也是官方性能测试采用 Batch Size 512 的重要原因之一。
四十三、重复输出问题
对于极其复杂的 Layout(版面),模型可能出现重复生成。
官方文档给出的一个处理方式是:
ini
extra_body={
    "repetition_penalty": 1.05
}
例如:
ini
response = client.chat.completions.create(
    ...
    extra_body={
        "repetition_penalty": 1.05
    }
)
但不建议一开始就默认使用。
更合理的流程是:
markdown
正常配置
   │
   ▼
业务数据压测
   │
   ├── 正常 → 保持默认
   │
   └── 出现重复
          │
          ▼
  调整 repetition_penalty
四十四、本地 Python API
除了服务化 API,官方还提供直接通过 vLLM Python API(Python 接口)加载模型的方式。
核心代码:
ini
from pathlib import Path
import os

from vllm import LLM, SamplingParams


model_path = Path(os.environ["MODEL_PATH"])


llm = LLM(
    model=str(model_path),
    trust_remote_code=True,
    max_model_len=16384,
    limit_mm_per_prompt={"image": 1},
    gpu_memory_utilization=0.9,
    attention_backend="FLASHINFER",
    enable_prefix_caching=True,
    speculative_config={
        "method": "medusa",
        "model": str(model_path / "P-MTP"),
        "num_speculative_tokens": 6,
    },
)


sampling_params = SamplingParams(
    temperature=0,
    max_tokens=8000,
)
然后:
ini
outputs = llm.chat(
    messages=messages,
    sampling_params=sampling_params,
)

result = outputs[0].outputs[0].text
官方明确将这种方式定位为:
单机批量处理场景。
四十五、服务化 API 与本地 API 如何选择?
可以简单按照下面的方式选择:
| 场景 | 推荐方式 |
|---|---|
| 生产环境 | 服务化部署 |
| 多业务系统共享 | 服务化部署 |
| 高并发 | 服务化部署 |
| API 服务 | 服务化部署 |
| 单机实验 | Python API |
| 离线批处理 | Python API |
| Benchmark | 两者均可 |
| 快速验证 | Python API |
如果你的目标是构建一个完整的:
文档解析服务
那么优先推荐:
diff
HPD-Parsing
+
定制版 vLLM
+
OpenAI Compatible API
四十六、HPD-Parsing 与传统 OCR Pipeline 的区别
传统 Pipeline(流水线):
css
PDF
 ↓
Page Render
 ↓
Layout Detection
 ↓
OCR
 ↓
Table Recognition
 ↓
Formula Recognition
 ↓
Reading Order
 ↓
Post Processing
 ↓
Markdown
HPD:
PDF Page
   ↓
HPD-Parsing
   ↓
Structured Document
从架构复杂度来看:
传统 Pipeline
模块多
接口多
数据转换多
后处理多

HPD
模型统一
接口简单
系统链路短
但是,这种统一也意味着一个问题:
模型内部成为更大的黑盒。
传统 Pipeline 中:
css
OCR 错误
Layout 错误
Table 错误
比较容易定位。
而 VLM:
diff
视觉理解
+
Layout
+
OCR
+
结构理解
+
生成
共同影响最终结果。
因此工程上不能简单认为:
VLM 一定全面取代传统 OCR Pipeline。
两者仍然存在明显的应用场景差异。
四十七、HPD-Parsing 更适合什么场景?
从模型架构和性能指标来看,我认为以下场景非常适合 HPD-Parsing。
1. 大规模文档解析
例如:
每天 10 万页
每天 100 万页
这时候:
GPU 利用率
PPS
TPS
并发能力
比单请求延迟更加重要。
2. 企业知识库
例如:
合同
财报
技术文档
产品手册
研究报告
标准规范
会议材料
这类文档通常:
diff
版面复杂
+
输出较长
恰好适合 HPD 的设计。
3. RAG 数据入库
典型流程:
PDF
 ↓
Page Render
 ↓
HPD-Parsing
 ↓
Document Schema
 ↓
Chunk
 ↓
Embedding
 ↓
Vector Database
4. 高吞吐文档解析服务
例如:
markdown
用户上传 PDF
       ↓
Document API
       ↓
任务队列
       ↓
HPD Cluster
       ↓
结构化文档
此时 HPD 的并行 Decode 能够更充分地利用 GPU。
四十八、哪些场景不一定适合?
1. 没有 NVIDIA GPU
当前官方验证环境均为 NVIDIA GPU,并要求 CUDA 12.8+。
因此:
纯 CPU并不是它的目标运行环境。
2. 极低调用量
如果:
每天只有几十页专门部署:
diff
A800 / H800
+
vLLM
+
HPD
可能并不经济。
3. 强依赖精确规则控制的场景
例如某些强监管业务,需要严格保证:
字段位置
字段类型
坐标规则
版面规则
数据格式
这时候:
diff
VLM
+
传统 OCR / Layout
+
规则校验
可能比纯端到端方案更加可靠。
四十九、生产环境真正应该关注哪些指标?
如果你准备把 HPD-Parsing 集成到自己的文档解析服务中,我不建议只关注:
yaml
4752 TPS至少应该测试下面五个指标。
1. Accuracy
解析准确率2. PPS
sql
Pages Per Second
每秒页面数
回答:
一张 GPU 一秒能够解析多少页面?
3. P95 Latency
P50
P95
P99
回答:
一个页面从请求到返回需要多长时间?
4. GPU Utilization
例如:
GPU Utilization
Memory Utilization
KV Cache Usage
5. Error Rate
例如:
请求失败率
输出截断率
模型异常率
重复输出率
解析失败率
最终真正应该形成这样的 Benchmark(基准测试):
| 指标 | HPD-Parsing |
|---|---|
| Accuracy | 待测试 |
| P50 Latency | 待测试 |
| P95 Latency | 待测试 |
| P99 Latency | 待测试 |
| PPS | 待测试 |
| TPS | 待测试 |
| GPU Memory | 待测试 |
| GPU Utilization | 待测试 |
| Error Rate | 待测试 |
五十、HPD-Parsing 的真正价值
如果只把 HPD-Parsing 理解成:
"百度又发布了一个新的文档解析模型。"
其实并没有抓住它最重要的价值。
它真正值得关注的是:
重新设计了 VLM 文档解析的推理方式。
传统思路更多是:
更大模型
   ↓
更强能力
   ↓
更高精度
HPD 增加了另一个维度:
css
如何重新设计 Decode Architecture?
             │
             ▼
减少串行依赖
             │
             ▼
增加局部并行
             │
             ▼
共享 Prefix KV Cache
             │
             ▼
P-MTP
             │
             ▼
减少有效 Decode Steps
             │
             ▼
提高 GPU 利用率
             │
             ▼
提高整体吞吐
因此 HPD-Parsing 的创新重点并不只是:
Model Scaling而更接近:
Inference Architecture
(推理架构)
五十一、从文档解析服务架构角度理解 HPD
如果将 HPD-Parsing 放进一个完整的文档解析系统,可以设计成:
arduino
                        Document
                           │
                           ▼
                    File Preprocess
                    (文件预处理)
                           │
                           ▼
                     Page Rendering
                    (页面渲染)
                           │
                           ▼
                    Image Processing
                    (图像处理)
                           │
                           ▼
                     HPD-Parsing
                           │
              ┌────────────┴────────────┐
              ▼                         ▼
         Layout/Text                 Images
              │
              ▼
        Post Processing
         (后处理)
              │
              ▼
     Unified Document Schema
       (统一文档数据结构)
              │
       ┌──────┼──────┐
       ▼      ▼      ▼
   Markdown  JSON    RAG
也就是说:
HPD-Parsing 更适合作为文档解析系统中的核心理解引擎,而不是整个文档解析系统本身。
外围仍然需要:
文件处理
PDF 渲染
任务调度
GPU 服务
结果存储
异常重试
后处理
输出
监控
五十二、如果用于企业级文档解析服务,推荐的整体架构
结合 HPD-Parsing 的特点,一个比较合理的生产架构可以设计成:
arduino
                         Client
                           │
                           ▼
                     API Gateway
                           │
                           ▼
                    Document Service
                           │
                 ┌─────────┴─────────┐
                 ▼                   ▼
             File Store          Task Queue
                                     │
                                     ▼
                              Page Processing
                                     │
                                     ▼
                            HPD-Parsing Cluster
                                     │
                          ┌──────────┼──────────┐
                          ▼          ▼          ▼
                       GPU-1      GPU-2      GPU-3
                          │          │          │
                          └──────────┼──────────┘
                                     ▼
                              Post Processing
                                     │
                                     ▼
                           Unified Document JSON
                                     │
                   ┌─────────────────┼─────────────────┐
                   ▼                 ▼                 ▼
                Markdown           RAG             Database
这里最重要的设计原则是:
模型服务与业务任务调度解耦。
这样以后即使把:
HPD-Parsing替换成:
PaddleOCR-VL
MinerU
其他 VLM
也不会影响上层任务系统。
五十三、HPD-Parsing 的技术链路总结
整个模型可以概括成:
css
                  Document Image
                        │
                        ▼
               Dynamic Tiling
                 动态图像切片
                        │
                        ▼
                InternVL3.5-1B
                  视觉语言骨干
                        │
                        ▼
              Main Layout Branch
                 主布局分支
                        │
                 全局结构协调
                        │
        ┌───────────────┼───────────────┐
        ▼               ▼               ▼
    Content A        Content B       Content C
    内容分支 A       内容分支 B      内容分支 C
        │               │               │
        ▼               ▼               ▼
      P-MTP           P-MTP           P-MTP
        │               │               │
        └───────────────┼───────────────┘
                        ▼
                Structured Output
                  结构化文档结果
其性能优化链路则是:
css
单轨迹自回归
       │
       ▼
Hierarchical Parallel Decoding
       │
       ▼
动态请求分叉
       │
       ▼
局部 Branch 并行
       │
       ▼
Prefix KV Cache 共享
       │
       ▼
P-MTP 投机解码
       │
       ▼
减少 Decode Steps
       │
       ▼
提高 TPS / PPS
五十四、总结
HPD-Parsing 的核心思想可以浓缩成一句话:
利用文档布局的全局性与内容的局部性,将传统 VLM 的单轨迹自回归生成重构为"全局布局协调 + 局部内容并行解码",再通过 P-MTP 减少每个分支内部的解码步骤,从而提升长输出文档解析任务的推理吞吐。
它的技术链路可以总结为:
css
InternVL3.5-1B
       │
       ▼
Dynamic Tiling
       │
       ▼
Main Layout Branch
       │
       ▼
Hierarchical Parallel Decoding
       │
       ├── Content Branch A
       ├── Content Branch B
       ├── Content Branch C
       └── Content Branch N
              │
              ▼
        Shared Prefix KV Cache
              │
              ▼
             P-MTP
              │
              ▼
       High-Throughput Parsing
从目前官方公开数据来看,HPD-Parsing 约 1B 参数 ,在 OmniDocBench v1.6 上达到 94.91% Overall ,并在 A800 80GB、Batch Size 512 的测试条件下达到约 4,752 TPS / 2.68 PPS。官方同时报告,随着输出长度增加,HPD 的并行解码优势进一步扩大。
因此,如果你的关注点是:
diff
复杂文档
+
长输出
+
高并发
+
GPU 推理
+
大规模文档处理
那么 HPD-Parsing 值得重点关注。
但从工程落地角度来看,也需要注意它目前并不是一个普通的 PaddleOCR Python 模型,而是一套:
diff
HPD-Parsing
+
定制版 vLLM
+
P-MTP
+
GPU
组成的专用推理方案。官方当前要求 Linux x86-64、NVIDIA GPU 和 CUDA 12.8+,并推荐使用官方 Docker 镜像部署。
最终,如果把 HPD-Parsing 放进一个企业级文档解析系统,我认为最合理的定位是:
将 HPD-Parsing 作为核心文档理解引擎,由外围的任务调度、文件处理、页面渲染、结果后处理、统一 Schema(数据结构)、存储和监控系统组成完整的文档解析服务。
官方资料
- PaddleOCR HPD-Parsing 官方使用教程
HPD-Parsing 官方使用教程 - HPD-Parsing Model Card
HPD-Parsing 官方 Model Card - HPD-Parsing 论文
HPD-Parsing 论文