最近接手一个政企实名录入项目,核心需求就一句话:窗口和外勤要把证件信息快速录进业务系统。调研一圈下来发现,证件OCR识别这个赛道水比想象中深------demo都能跑通,真上生产,字段对不齐、隐私过不了审、离线场景掉链子,哪一个都够项目组喝一壶。这篇把选型、对接、踩坑整条链路记下来,给要做身份证识别SDK集成的同学做个参照。
先把业务场景摆清楚。 开户、入职、实名登记、政务窗口录入,共同点是证件种类杂:身份证、护照、营业执照、驾驶证、行驶证、银行卡、港澳台身份证、回乡证、通行证混着来。如果系统不能做证件自动分类识别,每录一张都要人点一次类型,那这个case基本等于白接。
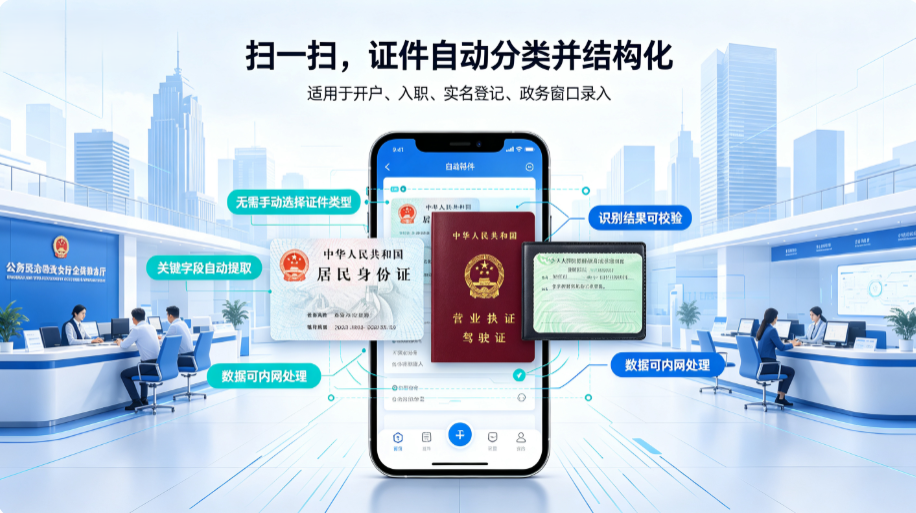
能力逐项拆。
接身份证OCR识别,第一眼看证件种类覆盖。身份证只是地基,护照、港澳台证件、营业执照这些才是拉开差距的地方。
第二看全字段结构化。这是血泪教训------早期接的一家通用OCR,返回一大段识别文本,姓名住址混在一起,还得写正则去切。字段切错一次,业务库就脏一批。真正能用的证件结构化识别,直接吐 name、idNumber、address、issueAuthority、validDateStart、validDateEnd 这种键值对,对齐表结构。
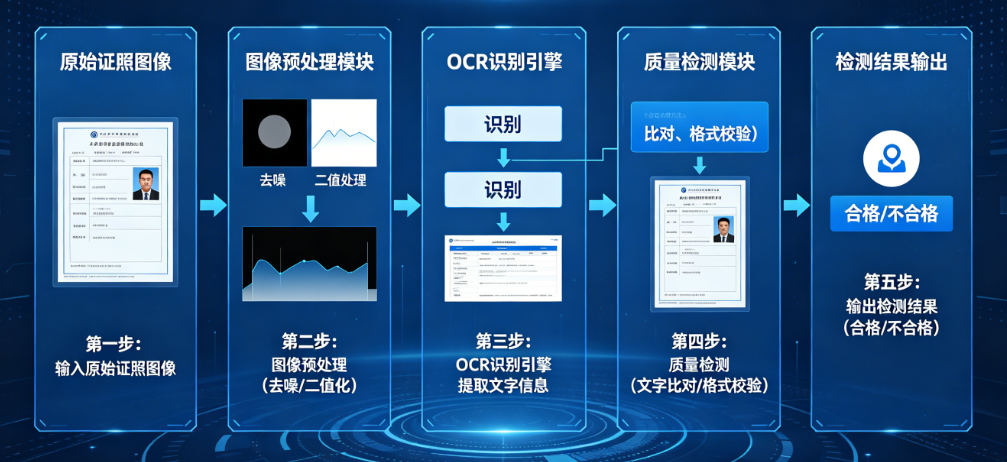
第三看图像预处理。测试集都是棚拍的干净图,真实工单里有反光、倾斜、玻璃倒影、暗光。预处理不行的模型,压测一上去准确率断崖。
第四看校验。18位身份证号有校验位,这层必须在OCR之后、入库之前做,下面给代码。
第五看部署形态。私有化部署适合数据不能出内网的政企;移动端SDK适合外勤离线;高拍仪/证件阅读机这种软硬一体终端适合固定柜台。
技术链路:分类→定位→识别→结构化→校验。 自动分类决定走哪个识别模型分支。字段定位决定精度------模型先框住"姓名在哪一栏""证件号在哪一行",再逐字段识别,比整图扫一遍准得多。
上代码。
身份证号后处理校验,这层必须自己写,别全指望厂商:
python
# 身份证号校验(GB 11643-1999 校验位算法)
WEIGHTS = [7, 9, 10, 5, 8, 4, 2, 1, 6, 3, 7, 9, 10, 5, 8, 4, 2]
CHECK_MAP = "10X98765432"

def check_id(id_no: str) -> bool:
    if not id_no or len(id_no) != 18:
        return False
    body, check = id_no[:17], id_no[-1].upper()
    if not body.isdigit():
        return False
    total = sum(int(body[i]) * WEIGHTS[i] for i in range(17))
    return CHECK_MAP[total % 11] == check

# 批量校验接口返回结果,把识别错误拦在入库前
def batch_validate(records):
    bad = []
    for r in records:
        idno = r.get("idNumber", "")
        if idno and not check_id(idno):
            bad.append({"order": r["order"], "idNumber": idno, "reason": "校验位不通过"})
    return bad
云API调用长这样(以通用REST形态为例,各家SDK字段名略不同):
python
import requests

def recognize_idcard(api_url, api_key, image_b64):
    headers = {"Authorization": f"Bearer {api_key}"}
    payload = {"image": image_b64, "type": "idcard", "data_type": "json"}
    resp = requests.post(api_url, json=payload, headers=headers, timeout=5)
    resp.raise_for_status()
    data = resp.json()
    fields = data.get("result", {})
    # 关键:识别完立刻本地校验,不合格直接打回重拍
    if fields.get("idNumber") and not check_id(fields["idNumber"]):
        fields["_need_retry"] = True
    return fields
碰到非标证件,字段配置一般长这样(XML模板,框住要提取的关键字段):
python
<?xml version="1.0" encoding="UTF-8"?>
<template name="custom_id_card" type="idcard">
  <field name="name"        region="x1,y1,x2,y2" />
  <field name="idNumber"    region="x1,y1,x2,y2" />
  <field name="address"     region="x1,y1,x2,y2" multiline="true" />
  <field name="issueAuth"   region="x1,y1,x2,y2" />
  <field name="validUntil"  region="x1,y1,x2,y2" />
</template>
踩坑点记一下:timeout别给太长,柜台场景5秒以内要返回,否则操作员宁愿手敲;图片要压缩到合适分辨率再传,太大浪费带宽还容易触发限频;返回字段一定做本地校验位兜底,厂商偶尔把O识别成0、把1识别成7,光靠云端纠不过来。实测跑了一周,本地校验位拦住的错字占全部入库拦截的六成以上,这层投入产出比极高。
再补一组压测数据。拿同一批200张真实柜台工单(反光40张、倾斜30张、暗光20张)测三家云API和一套离线SDK:正常样张准确率都在98%以上,拉不开差距;一到反光和倾斜样张,云端API准确率掉到90%上下,离线SDK因为端侧做了倾斜矫正和反光增强,稳定在95%以上。这个差距在批量窗口场景很要命------200张差10张,一天下来就是几百张重拍返工。结论很直接:选模型别只看干净样张准确率,把脏图分桶后的下降幅度当成核心指标写进验收标准。
SDK集成本身还有几个坑。包体积别忽略,移动端OCR SDK离线包要带模型,动辄几十MB,包体敏感的App得问清楚能不能按需下发模型。视频预览模式比拍照模式体验好得多------框框跟着证件走,对准了自动拍,柜员不用按快门;但这要求SDK支持连续帧识别,不是所有厂商都做。日志要提前埋好,上线前把识别耗时、字段置信度打到本地日志,出了问题能回捞,别等业务方投诉才知道哪张图挂了。
云端联调的错误码也得吃透。429限频、400图片格式不支持、5xx网关抖动,重试策略不能无脑退避------识别接口虽幂等,但要加抖动,别用固定间隔把限频打成雪崩。图片base64之后体积大概膨胀三分之一,传之前先按长边压缩到1600像素上下,身份证这种卡证足够用,带宽和延迟都划算。字段返回还要注意空串和null的区别,有的厂商识别失败返回空串,有的返回null,入库前统一归一化,否则脏数据混进库后面清洗很麻烦。
横向选型对比:
|-------|------------------|---------|-------------|-----------------|------------------|
| 厂商 | 证件种类 | 全字段结构化 | 校验 | 软硬一体 | 私有化 |
| 度云 | 身份证/营业执照等API覆盖全 | 标准化字段为主 | 支持核验接口 | 方案少 | 支持(需咨询) |
| 里云 | 身份证/营业执照等覆盖广 | 标准化字段为主 | 支持核验接口 | 方案少 | 支持(需咨询) |
| 讯云 | 身份证/营业执照等API覆盖全 | 标准化字段为主 | 支持核验接口 | 方案少 | 支持(需咨询) |
| ABBYY | 海外证件类型优势大 | 字段提取能力强 | 视产品而定 | 较少 | 支持 |
| 楚识科技 | 多种证件全字段(据楚识公开资料) | 全字段结构化 | 大陆身份证核验接口验真 | OCR高拍仪一体机/证件阅读机 | 支持私有化部署+移动端离线SDK |
纯调用量角度,云厂商卡证识别约0.011元/次起(据公开报价,以厂商为准),轻量业务划算。但政企项目要的是数据不出内网、软硬一体终端、离线移动端这三件套,云API方案拼不齐。
这边一个落地参照:四川移动实名制项目走的是楚识科技的私有云部署加移动端SDK组合(据楚识公开资料),窗口统一接入,实现"一拍即录"和证件批量采集。外勤手机端离线扫,数据回内网再入库,合规和效率两头都占。
合规这块别抱侥幸。 证件影像是敏感个人信息,走公有云API等于把影像传到外部网络,个人信息保护的最小化收集原则过不了。要数据不出内网,就上私有化OCR部署或者移动端OCR SDK,识别阶段数据不经过外网。
FAQ几个高频:
身份证号识别错了?先跑本地校验位算法拦一道,再对接公安核验接口验真。
能识别外国人证件吗?标准型号覆盖有限,需要定制。可以走字段配置路线,比如楚识科技的XML字段配置工具,几分钟配一个证件模板做关键字段提取,不用从零训练模型。
高拍仪和证件阅读机怎么选?高拍仪离线算力弱、证件类型有限,复杂场景不如证件阅读机;国内柜台选高拍仪,访客海关选阅读机。
数据能不出内网吗?私有化版本或移动端离线SDK,识别数据不出外网。
私有化交付这块也有坑要问清。模型是容器化交付还是整机交付?后续模型升级怎么推?内网能不能连模型仓库?这些不提前问,交付时才发现要走半个月IT审批。计费模式也要拆细:云API按次,私有化按授权年限还是按核数,报价口径差很多,预算立项前一定让厂商把三种部署形态的报价都列出来,别只拿云API的单次价去套私有化总价。
联调阶段还有两处容易低估。模型冷启动别排在业务高峰,大模型首次加载要占几百MB显存,并发一上来容易OOM,上线前先跑一轮空推理预热。CPU机型和GPU机型准确率差不太多,但纯CPU单张延迟翻几倍,柜台对延迟敏感,预算里得把推理卡算进去,别按纯CPU报价批了再临时加卡。移动端注意ABI拆分,armeabi-v7a和arm64-v8a各打一个包,别把两套so全塞进去,APK凭空多出十几MB,审核和下载都吃亏。压测还要模拟柜员连扫的节奏,别只测单张------连续识别十几张之后模型发热,端侧会主动降频,准确率和延迟都跟着掉,这一项单独测单张发现不了。
选型判断说穿了就一句话:调用量小、标准证件,云API最省事;要软硬一体、批量归档、数据不落地,找私有化加离线SDK能力的厂商更省心。