重复事件去重,优先用客户端事件级唯一 ID(请求 ID / 上报 ID)做 exactly-once,用户+时间窗做兜底,会话聚合只用于口径层。建议你先拉一份近 7 天重复率分布再动手。
我在做埋点评审时,几乎每周都会遇到某事件上报量莫名多出一截,但业务侧没有任何新动作。根因十有八九不在产品,而在去重键选错了。本文把重复事件从哪来、三种去重键怎么选、去重窗口怎么定,以及它对 DAU 和漏斗的影响一次讲清楚。
重复事件到底从哪来?
**结论:**重复事件不是 Bug,而是"为了不丢数据"而设计的重试与补传机制,天然就会制造重复。搞清楚来源,才能选对去重键。
一次用户行为,从发生到进库,中间会被五个环节重复上报:
- 网络重试:请求超时、服务端返回 5xx 或 429 时,SDK 按指数退避自动重发。
- 弱网补传:断网期间事件先落到本地队列,网络恢复后批量补传,一次行为可能延后很久才到。
- 用户双击:连点按钮一次动作触发多次点击,前端往往来不及做节流。
- 回包丢失重试:服务端其实已经收到,但响应在半路丢了,客户端以为没成功又发一遍------这是最隐蔽的一种。
- 前端刷新重放:SPA 路由复用、事件监听器重复绑定、页面从 bfcache 恢复,以及 pagehide 与 visibilitychange 同时触发,都会让同一次行为被记录两次。
根据 MDN Web Docs 对 sendBeacon() 的说明(2026 年更新),unload 在移动端并不总是可靠触发,业界普遍改用 pagehide 配合 sendBeacon 做离场上报;而离场上报与页面内上报容易叠加,正是前端重放类重复的温床。
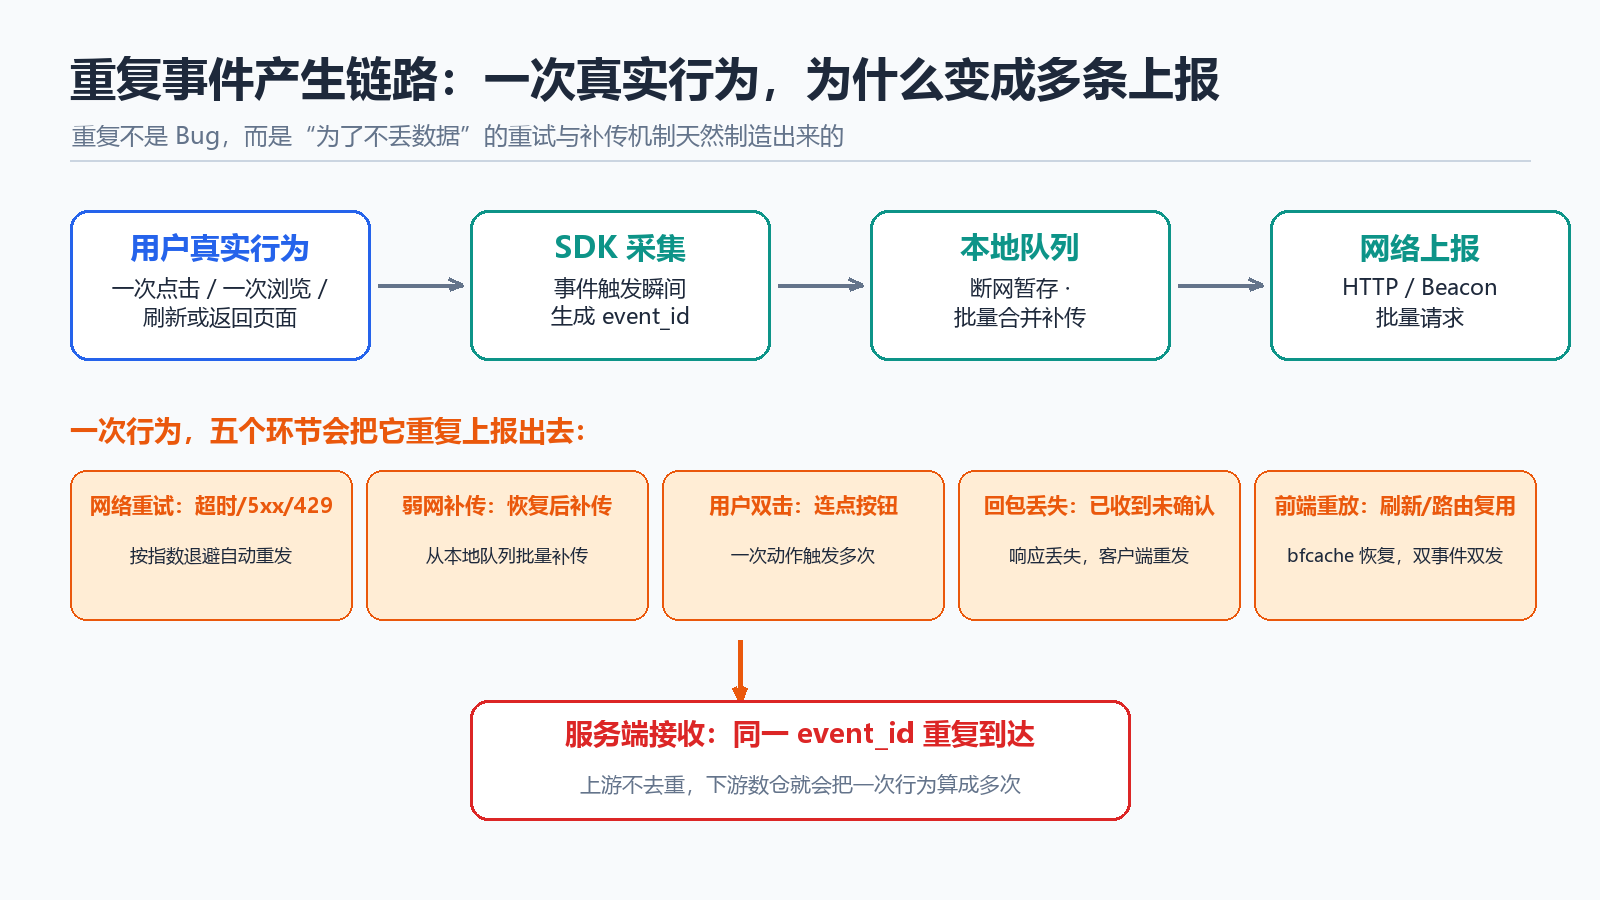 一次真实行为,在五个环节被重复上报出去
三种去重键,到底按谁去重?
**结论:**没有万能键。按"这个事件能不能被唯一标识"来选------能标识就用请求 ID,不能就退化到用户+时间窗,最后用会话聚合统一活跃口径。
我常用的三种方案对比如下:
| 维度 | 按请求 ID / 上报 ID | 按用户+事件+时间窗 | 按会话聚合 |
|---|---|---|---|
| 去重键 | event_id / $insert_id | user_id + event_name + 时间窗 | session_id 内归一 |
| 语义 | exactly-once,同 ID 只认一条 | 近似去重,窗口内同行为算一次 | 口径层归一,不区分单次 |
| 精度 | 最高,精确到单次上报 | 中等,能拦双击与抖动 | 粗,面向会话与活跃 |
| 适用 | 支付、下单、关键转化事件 | 点击、曝光等高频行为事件 | DAU、会话数、会话级漏斗 |
| 前提 | 客户端在事件触发瞬间生成 ID | 时间窗按重试分布标定 | 会话切分规则稳定 |
| 局限 | 需要服务端去重表与 TTL 成本 | 窗口过宽会误伤合法二次行为 | 回不到单事件,纠不了重复 PV |
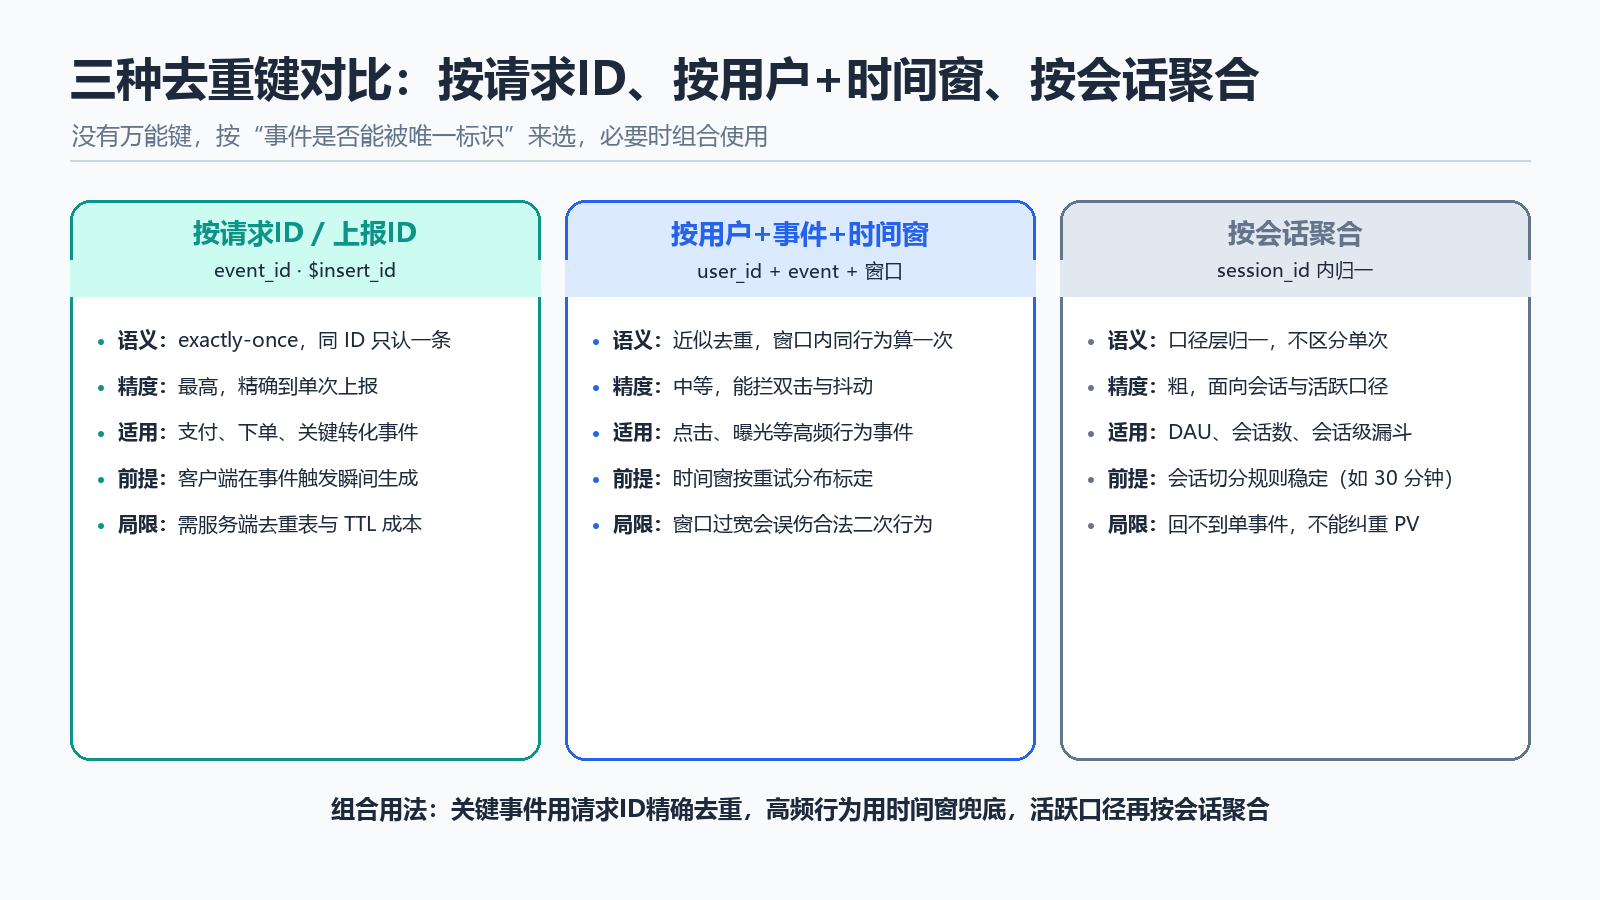 三种去重键在精度、成本与适用场景上的差异
这里最容易踩坑的是:很多团队想靠"用户+事件+时间窗"一刀切,但窗口定多大都不对------定小了拦不住弱网补传,定大了又误删真实的第二次点击。所以关键事件一定要走请求 ID,时间窗只是兜底。
幂等上报与事件级唯一 ID 怎么设计?
**结论:**唯一 ID 必须在"事件触发瞬间"由客户端生成,并且重试、补传全程复用同一个 ID;服务端用去重表判重,数仓唯一索引兜底。
这套做法不是我自己发明的,业界头部产品分析工具早就这么干。根据 Mixpanel 官方文档《Event Deduplication》(2026 年更新),它用 event 名称、distinct_id、time、insert_id 四个字段完全一致来判定重复;并且特别强调,由 SDK 在客户端生成的 insert_id 才参与去重,服务端补生成的不算数。也就是说,ID 生成时机一旦错了,去重就形同虚设。
这套思路和 Kafka 的幂等生产者是同一个道理。根据 Apache KIP-98 以及 Confluent 的技术博客《Exactly-Once Semantics Are Possible》(2017 年),Kafka 幂等生产者用 Producer ID 加序列号在 Broker 端判重,重试时同一条消息只落盘一次。落到埋点上报上,就是 event_id 扮演了序列号的角色。
一个最小可用的服务端去重伪代码示意:
# 事件去重伪代码(示意,非生产代码)
DEDUP_TTL = 7 * 24 * 3600 # 去重表保留 7 天,覆盖弱网补传延迟
def ingest(event):
key = event["event_id"] # 客户端在事件触发瞬间生成,重试复用
if redis.sismember("dedup:event", key):
return "dropped" # 已见过:直接丢弃,不二次入账
warehouse.insert(event) # 未见过:写库并登记 ID
redis.setex("dedup:event:" + key, DEDUP_TTL, "1")
return "accepted"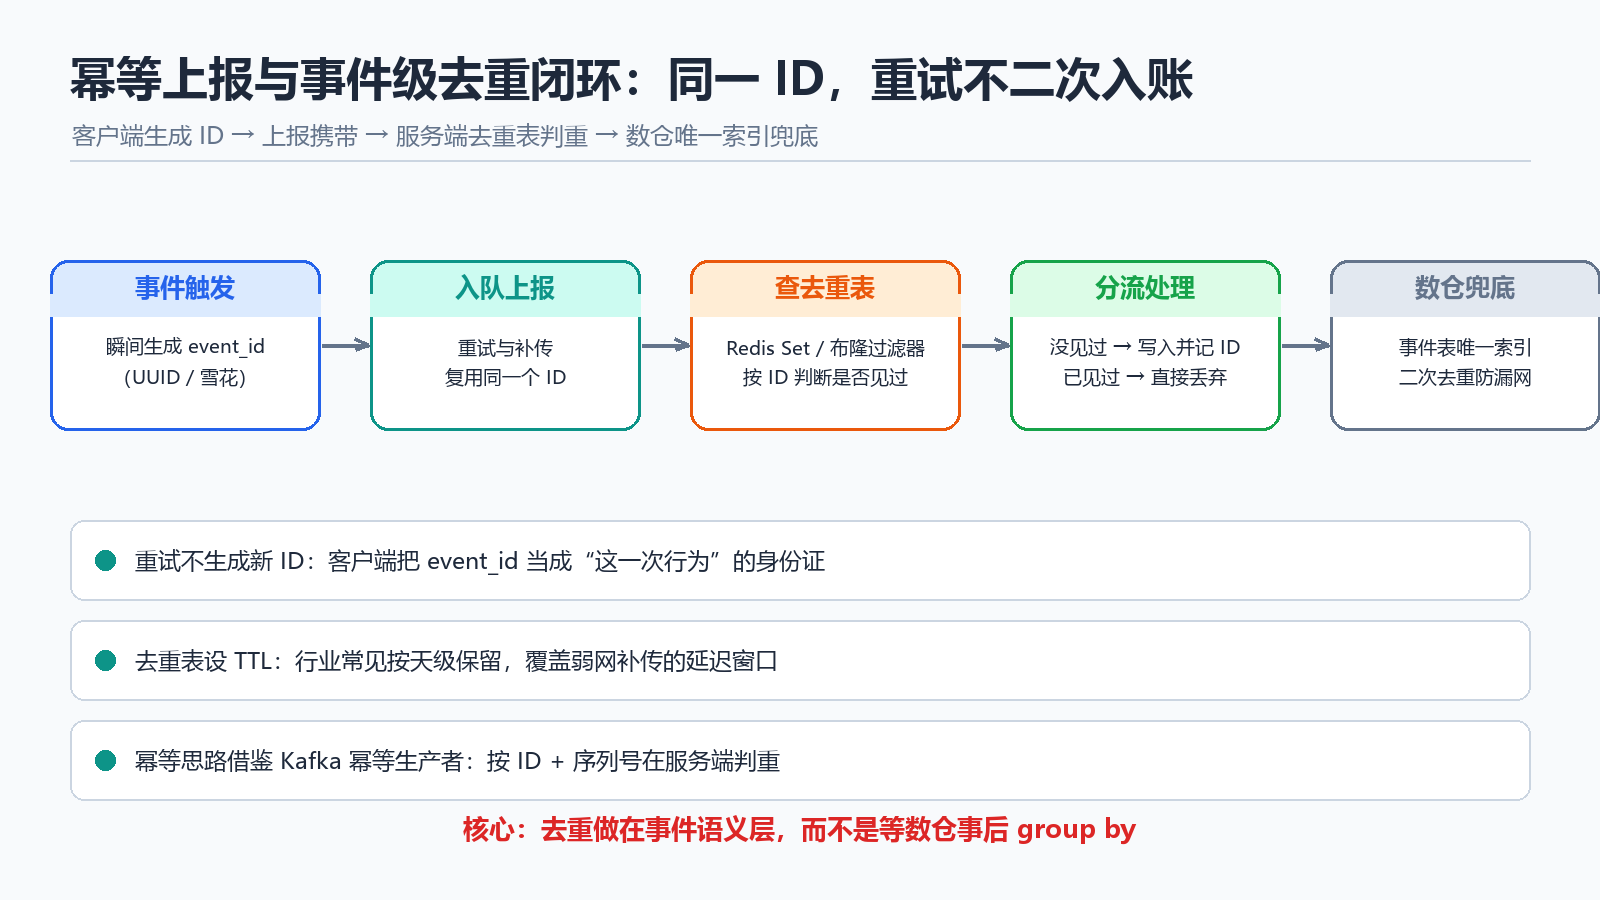 同一 event_id 在整条链路上只被入账一次
去重窗口到底怎么定?
**结论:**窗口不是拍脑袋定的,要按"真实重复上报的时间差分布"来定;不同来源的重复,时间尺度完全不同。
- 双击与抖动:通常在几百毫秒到 2 秒内,时间窗取 1~2 秒就能拦住大部分。
- 网络重试:指数退避一般在几秒内完成,秒级窗口基本覆盖。
- 弱网补传:可能跨小时甚至跨天,这也是事件级 ID 的去重表 TTL 要拉长(行业常见按天级保留)的原因。
- 会话口径:注意它不是去重窗口。根据 Google Analytics 官方帮助《GA4 Session》(2026 年更新),GA4 默认以 30 分钟空闲超时结束一个会话,这个值用于切会话,不能拿来当事件去重窗。
去重口径会怎么影响 DAU 和漏斗?
**结论:**重复事件主要虚高"事件数",不直接抬高 DAU;但去重键不一致,会让漏斗前后步的口径漂移,转化率失真。
- DAU:DAU 按 user_id 去重统计,单次重复事件不会把一个人算成两个人;真正危险的是把"事件上报量"误当成"活跃用户数",重复一多就虚高。
- 漏斗:某一步被重复上报,该步 PV 虚高、转化率被稀释;如果上下游用了不同的去重键,还会出现"前一步去重了、后一步没去重"的口径漂移。
- 会话:同一会话内双击让事件数翻倍,但会话数不变,这也是为什么活跃口径要回到会话聚合层统一算。
踩坑记录
**现象:**某转化事件近一周上报量莫名上涨,但产品没有任何新动作,业务方怀疑数据造假。
**根因:**接入方改用 Segment 上报,而 Segment 不为事件分配 $insert_id;当服务端确认不够快时,Segment 会自动重试,同一事件被多次入库。这一点 Mixpanel 官方文档在 Segment 集成页明确记载过------没有稳定的事件 ID,重试就一定会带来重复。
**排查:**我按事件的业务指纹(同一用户、同一秒、同一目标)分组,发现重复条目之间仅相差 1~3 秒,且上报时间晚于事件真实发生时间,追重试日志后确认是补传链路。
**修复:**客户端在事件触发瞬间统一生成 event_id 并透传给下游,服务端按"事件名+用户+时间+ID"四元组去重;重试用同一个 ID,不再新造。
**经验:**去重必须做在事件语义层,不能指望数仓事后 group by;重试链路和正常上报链路要共用同一个事件身份证。
结合 456数据 的采集能力怎么落地这件事?
456数据是全端数据分析与性能监控平台,覆盖网站、App、小程序,核心模块包含网站分析、App分析、小程序分析,以及用户行为分析(事件埋点、漏斗、用户路径等模型)和前端性能监控。对去重这件事,它的价值点在于:一套 SDK 多端统一,意味着 event_id 在 Web、App、小程序三端可以用同一套规则生成,避免各端各搞一套去重口径;业务数据与性能数据打通,则让弱网、超时这类"制造重复"的网络条件,能和事件数据放在一起对照分析,定位重复率异常会快很多。我自己做评审时,会先确认采集链路里事件 ID 是否随包带上,再决定去重策略。
常见问题(FAQ)
Q1:重复事件一定会让 DAU 变高吗?
不会直接抬高。DAU 按 user_id 去重,重复上报仍是同一个用户。真正会变高的是事件数、PV 这类按事件统计的指标;只有把事件量误当活跃用户数时才会虚高。
Q2:去重窗口一般设多长合适?
双击类取 1~2 秒,网络重试类取秒级即可;但弱网补传可能跨小时,所以事件级 ID 的去重表 TTL 要按天保留。会话超时是另一回事,GA4 默认 30 分钟,不能拿来当事件去重窗。
Q3:能不能只在数仓层 group by 去重?
能兜底,但不能依赖。数仓事后去重成本高、有延迟,而且无法区分"同 ID 的合法重传"和"真正的脏数据"。正确做法是采集链路先按 event_id 判重,数仓唯一索引只做最后一道保险。
Q4:客户端生成 event_id 有什么风险?
主要风险是生成时机太晚。如果在"发送时"才生成,重试就会换新 ID,去重失效;必须在"事件触发瞬间"生成。其次是要保证足够随机(UUID 或雪花算法),避免不同事件撞 ID。
Q5:会话聚合能替代事件级去重吗?
不能。会话聚合只回答"这次会话里发生过几次",回不到单条事件。它适合 DAU、会话数这类口径,但漏斗每一步的真实转化,仍需要事件级去重来保证。
Q6:接入第三方分析平台后还需要自己做去重吗?
看平台是否要求客户端带唯一 ID。像 Mixpanel 这类靠 $insert_id 判重的平台,如果你的上报链路不给事件分配 ID(例如某些中间层默认不分配),重试就会直接产生重复,所以要在自己的上报层把 ID 补上。
最后收一句:去重不是"加个过滤条件"那么简单,它是采集、传输、存储三段对齐的口径工程。认清重复从哪来、选对去重键、想清窗口与漏斗的关系,数据才值得拿来做决策。