随着业务系统大规模迁移到 Kubernetes,应用的部署与资源调度方式发生了根本性变化。数据库作为典型的有状态负载,一旦进入 K8s 环境,就不再只是"把实例跑起来"那么简单------它要和计算、存储、网络等多类资源协同,运维的复杂度随集群规模线性上升。过去依赖人工逐台部署、配置、巡检的模式,在这种动态环境里很快会触及天花板。
正是看准了用户在 K8s 环境中管理金仓 KES 集群的真实痛点,金仓正式推出了面向 Kubernetes 的运维工具 KES-Operator。它基于 Operator 模式与声明式管理理念,把 KES 集群纳管进 Kubernetes 原生的管理体系,提供从集群部署、状态保持、弹性扩缩容到物理备份的一整套能力。换句话说,用户从此可以"用 K8s 的方式"来运维 KES,而不是把数据库当成 K8s 之外的孤岛。
一、为什么需要 KES-Operator
Kubernetes 的精髓在于"声明期望状态,系统自动维持"。但数据库天然是有状态、长生命周期、对数据一致性极度敏感的负载,原生 K8s 的 Deployment / StatefulSet 并不能直接回答这几个问题:
- 集群节点挂了,谁来按既定拓扑拉起并保持主从关系?
- 业务流量涨了,谁来平滑扩节点而不丢数据?
- 磁盘、网络、配置漂移了,谁来把实际状态拉回期望状态?
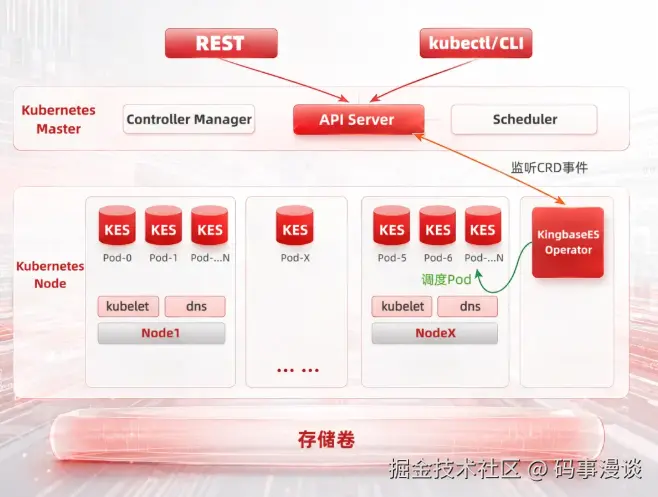
KES-Operator 的出现,就是把这些问题收口到 K8s 控制平面里。它通过自定义资源(CRD)扩展 K8s 的管理边界,把"一个 KES 集群"抽象成一个可以被声明、被观测、被自愈的 K8s 对象。
二、核心机制:声明式 + 控制器闭环
KES-Operator 的设计遵循标准 Operator 模式:
- 用户通过 CRD 配置定义 KES 集群的期望状态(节点数、版本、存储、备份策略等)。
- Operator 内部的控制器持续 watch 集群的实际状态。
- 一旦发现"实际 ≠ 期望",自动协调底层 K8s 资源(Pod、PVC、Service、ConfigMap 等),把偏差消除。
这个"定义即所得"的闭环,带来的直接收益是:运维人员不再需要反复手动执行部署脚本和巡检命令,集群始终朝着配置目标收敛。即便发生节点故障、 Pod 被驱逐等扰动,Operator 也会依据声明把集群重新拉回正轨。
三、覆盖哪些运维场景
围绕 KES 集群在 K8s 中的全生命周期,KES-Operator 提供了以下关键能力:
1. 自动化部署,分钟级拉起集群
在 K8s 里部署一套数据库集群,往往要配置十几个相互关联的资源对象。KES-Operator 把这些复杂性封装掉:用户只需维护一份集群配置文件,Operator 便会自动创建并编排相关资源,省去人工逐项拼装的环节。
2. 持续状态管理,集群永远"在线且正确"
集群建好只是第一步,运行期的稳定性更关键。Operator 通过 K8s 控制器机制,持续比对实际运行状态与用户声明的期望状态。一旦出现偏离------无论是配置被误改、还是节点意外下线------Operator 会按配置自动校正,把人工巡检和兜底处理的工作量降到最低。
3. 弹性扩缩容,跟着业务节奏走
业务有峰谷,数据库资源也该随之伸缩。KES-Operator 支持集群的扩容与缩容:用户修改配置中的节点规模后,Operator 负责按新规格调度资源,既能顶住流量高峰,也能在低谷期释放资源。
4. 物理备份与监控,统一纳管
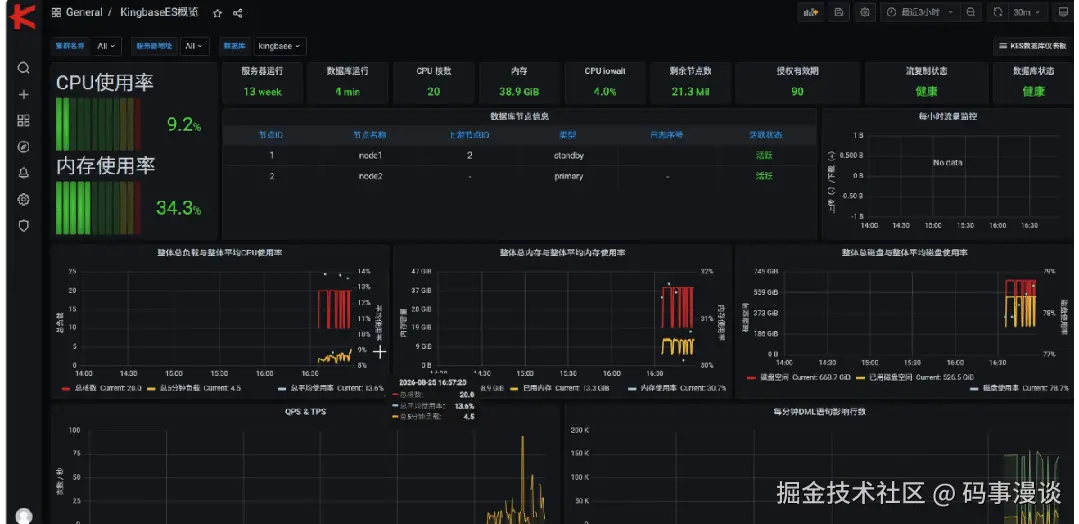
长期稳定运行离不开数据保护和可观测性。KES-Operator 支持 KES 物理备份任务的创建与调度,同时可纳管 KMonitor 监控组件,用于实时查看集群运行状态。备份计划与监控视图都在 K8s 环境内统一管理,日常维护的入口更集中、更清晰。
四、价值小结
KES-Operator 发布后,KES 集群真正融入了 Kubernetes 的管理范式:部署、状态保持、扩缩容、备份、监控,第一次有了统一的操作入口和一致的运维语言。对于已经全面拥抱云原生的团队来说,这意味着数据库运维终于能和上层应用一样,享受声明式、自动化、自愈化的红利。
未来,金仓将持续打磨 KES-Operator 的能力边界,覆盖 KES 在 K8s 环境中更多样的部署与运维需求。目前 KES-Operator 已正式发布,可下载体验。