任务 3:大模型提示词设计(网络评论情感分类)
模型:Qwen3.5-0.8B 环境:
rag_env虚拟环境 题目要求:加载本地模型,自己设计提示词模板,输入评论,只输出正面 / 中立 / 负面单个词语 目标人群:学生,代码增加大量注释,步骤讲细
整体原理(给学生理解)
- 提示词模板 = 我们提前写好的任务规则(本题得分核心,由学生自己设计)
- 用户输入 = 待分析的评论内容
- 程序做字符串拼接:【规则模板】+【用户输入的评论】,拼成完整一段话送给大模型
- 大模型按照我们写的规则,只输出分类词,不能额外写解释
完整操作步骤
步骤 1:登录服务器,进入工作目录,激活 rag_env 虚拟环境
# 进入workspace文件夹,模型、代码都放在这里
cd ~/workspace

# 激活我们之前装好依赖的虚拟环境rag_env
source rag_env/bin/activate
✅ 激活成功标志:命令行前面出现 (rag_env)
重要:所有代码运行必须在这个环境里面,否则找不到 numpy、transformers、torch 等库
步骤 2:确认模型已经解压(提前操作)
# 查看目录,确认Qwen3_5‑0_8B文件夹存在
ls
如果还没解压,执行解压命令
tar -zxvf Qwen3_5‑0_8B.tar.gz步骤 3:新建 Python 代码文件 classify_comment.py
# nano是Linux简易记事本,文件不存在就新建并打开编辑
nano classify_comment.py
粘贴下面带详细注释的完整代码
# 导入需要的工具包
# AutoTokenizer:分词器,把文字转成模型看得懂的数字
# AutoModelForCausalLM:加载Qwen大语言模型
from transformers import AutoTokenizer, AutoModelForCausalLM
# torch:GPU运算框架,用来在显卡上跑模型推理
import torch

# ===================== 【1】设置模型路径 =====================
# 指向解压后的Qwen3.5模型文件夹,这里根据你的文件夹名字修改
model_path = "./Qwen3_5‑0_8B"

# ===================== 【2】加载分词器和大模型 =====================
# 加载分词器,模型文件夹内自带分词器文件
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)

# 加载Qwen大模型,自动使用GPU显卡运行
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    torch_dtype=torch.float16,  # 使用半精度,节省显存
    device_map="auto",          # 自动检测cuda显卡,把模型放到GPU
    trust_remote_code=True
)

# ===================== 【3】学生自己设计的提示词模板(本题核心考点!) =====================
# 这一段是固定任务规则,写死在代码里面,属于考生设计的prompt模板
# {comment_text} 是占位符,后面会把用户输入的评论填到这个位置
def build_prompt_template(comment_text):
    prompt = f"""
任务:对网络评论进行情感分类,只输出【正面、中立、负面】其中一个词,禁止输出多余解释。
待分类评论:{comment_text}
输出结果:
"""
    # 返回拼接完成的完整提示词
    return prompt


# ===================== 【4】接收用户输入的评论 =====================
# input()函数:在终端等待学生输入文字,就是待分类的评论
user_comment = input("请输入待分类的网络评论:")

# 调用函数,把用户输入的评论填充进提示词模板,完成字符串拼接
full_prompt = build_prompt_template(user_comment)

# 打印完整拼接后的全部文本,方便学生观察,理解模板+输入如何合并
print("\n======== 送入大模型的完整提示文本 ========")
print(full_prompt)
print("==========================================")


# ===================== 【5】文字编码,送入GPU推理 =====================
# tokenizer:把完整文本转成模型能识别的数字token,放到cuda显卡
input_tokens = tokenizer(full_prompt, return_tensors="pt").to("cuda")

# torch.no_grad():关闭梯度计算,推理阶段节省显存,加快速度
with torch.no_grad():
    # 调用模型生成结果
    output_tokens = model.generate(
        **input_tokens,
        max_new_tokens=10,    # 限制最多输出10个token,只需要输出一个词,防止长篇回答
        temperature=0.1       # 降低随机性,让分类结果稳定,不会乱变
    )

# ===================== 【6】把模型输出的数字转回中文文字 =====================
# skip_special_tokens=True:去掉模型自带特殊标记,只保留可读文字
result_text = tokenizer.decode(output_tokens[0], skip_special_tokens=True)

# 打印最终分类结果
print("\n模型分类结果:")
print(result_text)
粘贴完成后: Ctrl+O → 回车保存文件 → Ctrl+X 退出 nano 编辑器
步骤 4:运行代码
python3 classify_comment.py- 程序加载模型,等待一段时间(模型载入 GPU 显存)
- 终端提示:
请输入待分类的网络评论: - 输入样例文字:
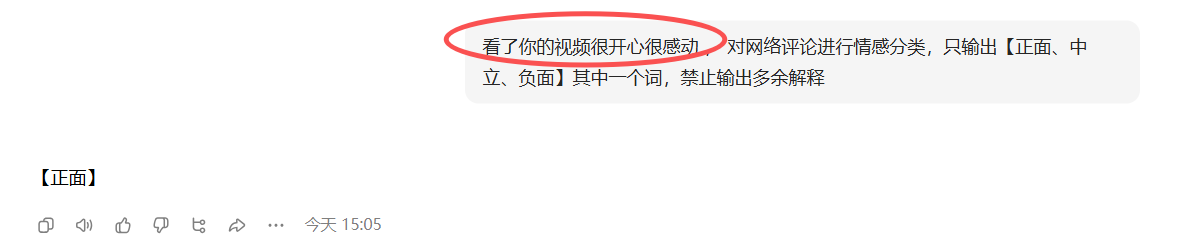
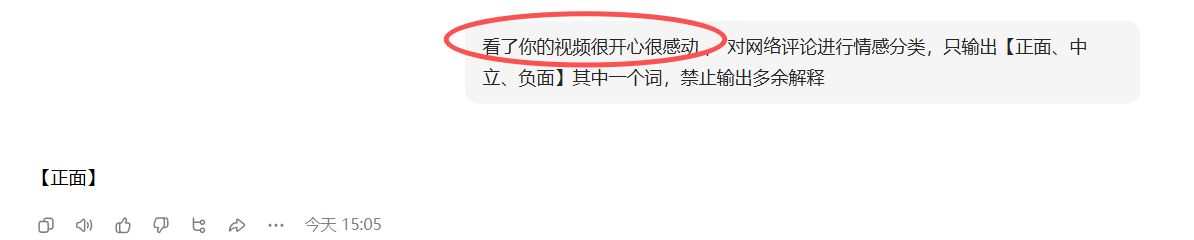
看了你的视频很开心很感动 - 程序会先打印完整拼接好的提示文本,再输出分类结果
正面
步骤 5:保存成果(竞赛提交)
- 把代码复制,粘贴到答题卡对应位置
- 终端运行截图,放入
3_答题卡/result/Q2文件夹
测试样例(给学生练习)
表格
| 用户输入评论 | 预期输出 |
|---|---|
| 看了你的视频很开心很感动 | 正面 |
| 这个视频太差了,完全浪费时间 | 负面 |
| 视频时长 5 分钟。 | 中立 |