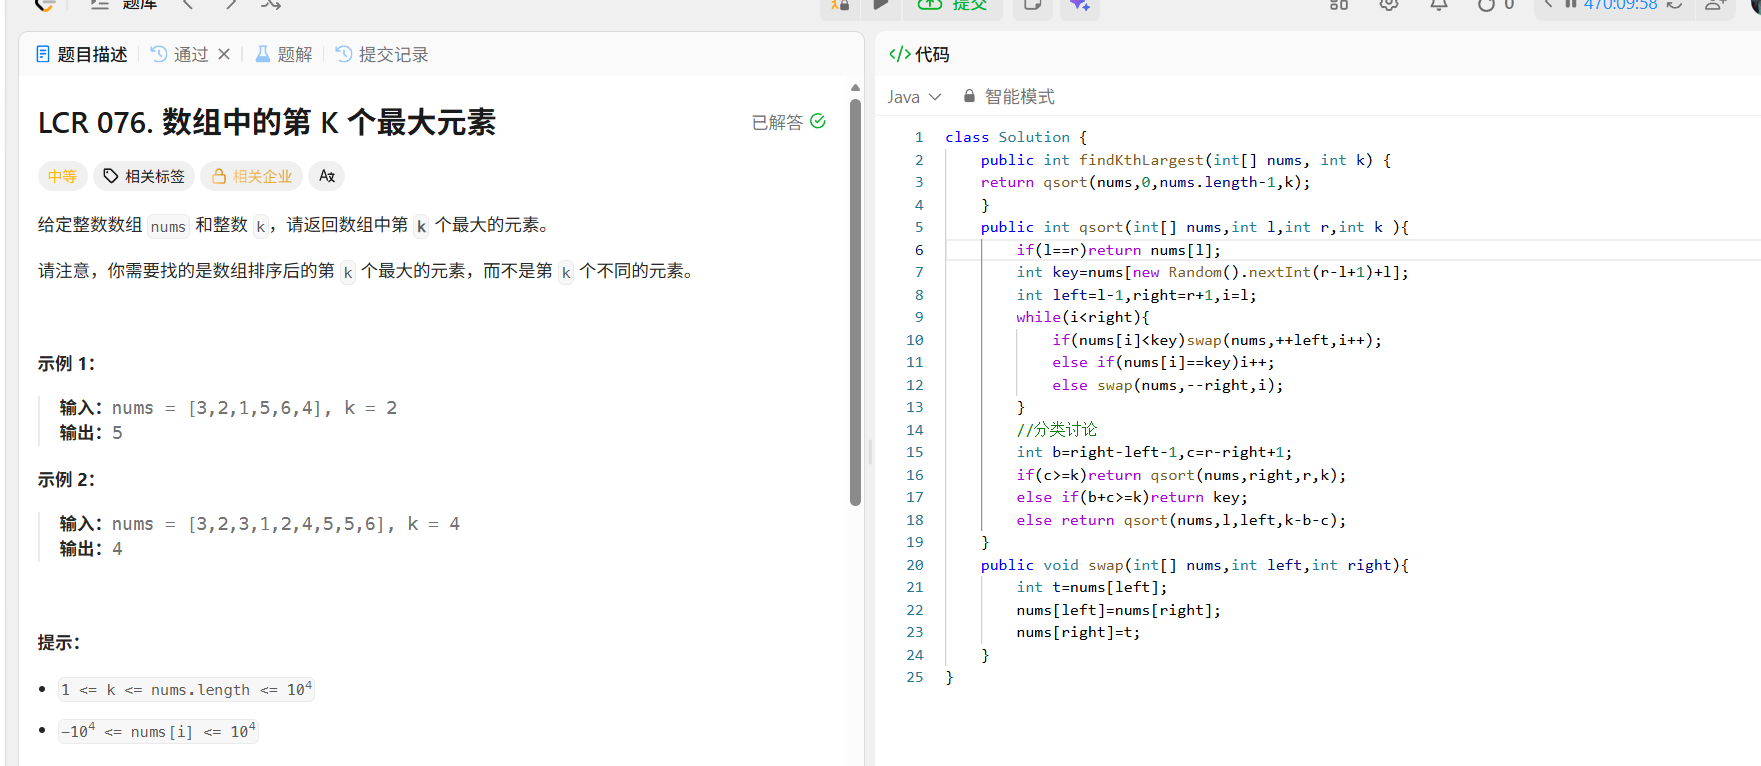
1. 代码逻辑解析
- 随机选基准值 :
nums[new Random().nextInt(r-l+1)+l]随机选取基准值key,避免有序数组下的最坏情况。 - 三路分区 :将当前区间
[l, r]划分为三部分:小于key、等于key、大于key。left指向大于key区域的末尾,right指向小于key区域的开头。- 遍历数组,将元素交换到对应区域。
- 分类讨论 :
b为大于key的元素个数,c为等于key的元素个数。- 若
c >= k(第 k 大元素在等于key的区域),直接返回key。 - 若
b >= k(第 k 大元素在大于key的区域),递归左半部分(大于key的区域)。 - 否则(第 k 大元素在小于
key的区域),递归右半部分,并更新k = k - b - c。
2. 复杂度分析
- 时间复杂度 :平均 O(n),最坏情况(每次分区极不均匀)为 O(n²)。随机化基准值可有效避免最坏情况。
- 空间复杂度 :O(log n)(递归栈深度,随机化下平均对数级)。
3. 优缺点评价
- 优点:利用了三路快排处理重复元素的优势,逻辑严谨,效率较高。
- 缺点 :
- 每次递归都
new Random(),有一定性能开销。 - 分区逻辑变量较多(如
left-1、right+1),容易在边界条件上出错。
- 每次递归都
4. 优化与替代方案
- 优化建议 :
- 将
Random实例提取为全局静态变量,避免频繁创建。 - 当区间较小时(如长度
< 10),可切换为插入排序以提升缓存命中率。
- 将
- 替代方案 :
- 最小堆 :维护一个大小为
k的最小堆,时间复杂度 O(n log k),空间复杂度 O(k),适合处理海量数据。 - 快速选择(双路分区):常规的双指针分区同样可以实现 O(n) 的平均时间复杂度。
- 最小堆 :维护一个大小为
5. 注意事项
- 题目明确"第 k 个最大元素"允许重复(如示例 2),三路快排恰好适合此场景。
- 递归终止条件
if(l==r) return nums[l];确保了区间缩小到单个元素时正确返回。