一、介绍
本次的实践代码实现了一个基于PyTorch的CBOW词向量模型。
CBOW是Word2Vec的一种形式,核心思想是:**用中心词周围的上下文词来预测中心词。**训练完成后,模型中的Embedding层权重就可以作为词向量使用。
二、核心代码讲解
2.1导入库与超参数
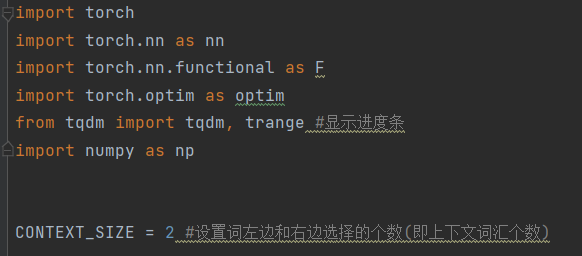
在PyTorch中,所有神经网络模型都继承自torch.nn.Module。它提供了:
参数管理:自动记录nn.Parameter,可以通过model.parameters()获取。
子模块管理:nn.Linear、nn.Embedding等都是Module,会自动注册。
前向传播接口:必须实现forward方法。
训练/评估模式切换:model.train()、model.eval()。
设备迁移:model.to(device)
tqdm:显示训练进度条。
**numpy:**最后把词向量转成Numpy数组。
CONTEXT_SIZE = 2:表示中心词左边取2个词,右边取2个词,共4个上下文词。
2.2语料与词表构建
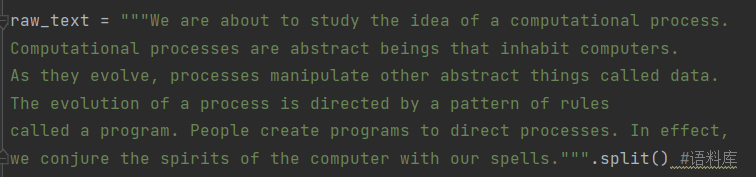
把整段文本用split()按空格切分成单词列表。
注意:标点没有去掉,所以process.、program.、computers.等会作为独立词存在。
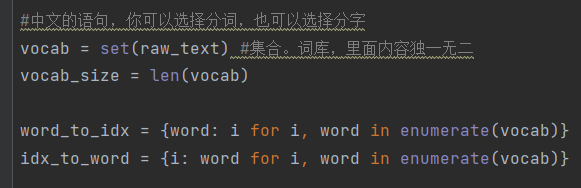
vocab是词表集合 ,保证每个词唯一。
word_to_idx:词------>索引。
idx_to_word:索引------>词。
2.3构建训练数据
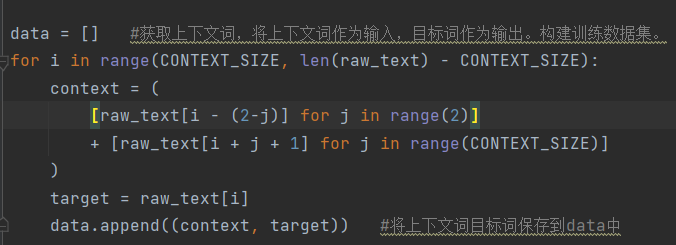
这段是构建CBOW的训练样本。
i是中心词的位置。
target = raw_texti:中心词。
context由左右两边词组成:
左边:raw_text\[i-2,raw_texti-1]
右边:raw_text\[i+1,raw_texti+2]
所以每个样本是:(上下文列表,中心词)。
例如第一个样本:
i = 2,target = raw_text2 = 'about'
上下文是'We','are','to','study'
2.4上下文转索引向量
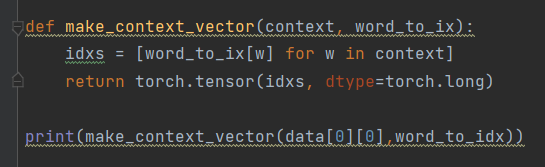
把上下文中的每个词转成词表索引。
返回一个torch.long类型的张量,形状为4。
打印第一个样本的上下文索引,方便检查。
2.5设备选择
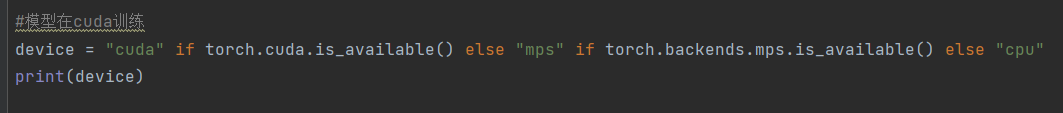
优先使用NVIDIA GPU (CUDA)
其次使用Apple Silicon 的MPS
否则使用CPU
后面模型和数据都会.to(device)。
2.6CBOW模型定义
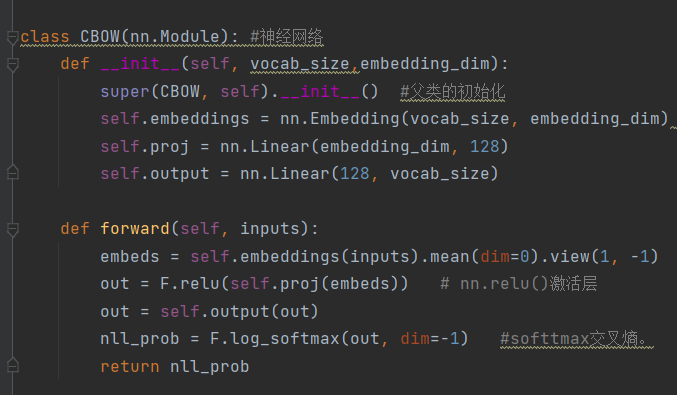
这是模型的核心。
6.1__init__
self.embeddings = nn.Embedding(vocab_size,embedding_dim)
词嵌入层,本质是一个查找表**。**
行数 = vocab_size(每个词一行);
列数=embedding_dim(每行有10个数)。
输入词索引,输出对应的词向量。
形状:vocab_size,embedding_dim。
这里的embedding_dim = 10:每个词用一个长度为 10 的向量(10 个浮点数)来表示。
例如表里有个词"process",它对应的词向量可能是:
0.12, -0.45, 0.78, 0.03, -0.91, 0.22, 0.67, -0.14, 0.55, 0.09
**self.proj = nn.Linear(embedding_dim,128):**把10维上下文向量投影到128维。
self.output = nn.Linear(128,vocab_size):输出每个词作为预测词的得分大小。
6.2 forward
输入inputs是上下文词的索引,形状为4。
embeds = self.embeddings(inputs)
得到形状4, 10,即4个上下文词的词向量。
**.mean(dim=0)对4个词向量按维度求平均,**得到形状10。这就是CBOW的核心:把上下文词向量平均后作为上下文表示。
.view(1,-1) 变成1,10,方便送入全连接**。**
out = F.relu(self.proj(embeds))
out = self.output(out)经过两层全连接,输出形状1,vocab_size。
**nll_prob = F.log_softmax(out, dim=-1)**对最后一维做log_softmax,得到对数概率。后面配合NLLLoss使用。
2.7 模型、优化器与损失函数
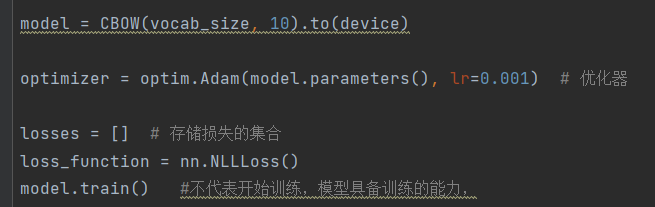
创建CBOW模型,词向量维度为10,移动到设备。
使用Adam优化器,学习率0.001。
损失函数是负对数,而且越小越好,与前面的log_softmax搭配
model.train()切换到训练模式。
2.8训练过程
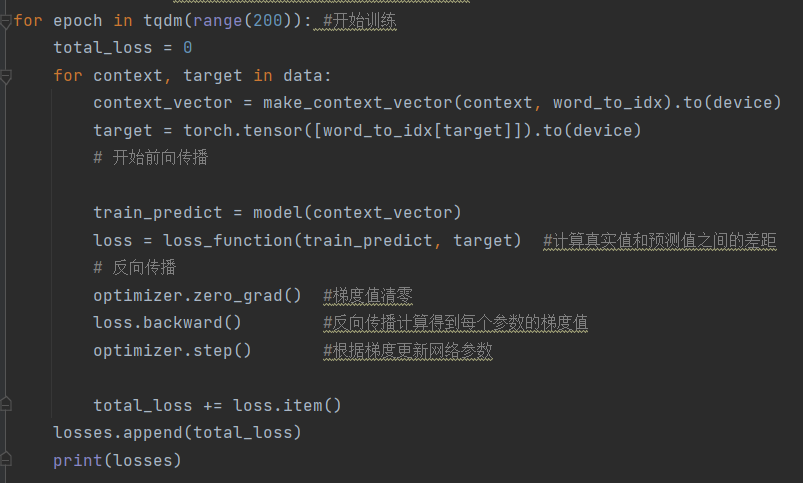
for epoch in tqdm(range(200)):训练200轮。
for context, target in data:遍历每个训练样本。
context_vector:把上下文词转成索引张量,并放到设备上。
target:中心词的索引,形状1。
train_predict = model(context_vector):前向传播,得到对数概率。
loss = loss_function(train_predict,target):计算损失。
optimizer.zero_grad():清空梯度。
loss.backward():反向传播,计算梯度。
optimizer.step():更新参数。
total_loss += loss.item():累加损失。
losses.append(total_loss):保存每轮损失。
2.9测试与预测
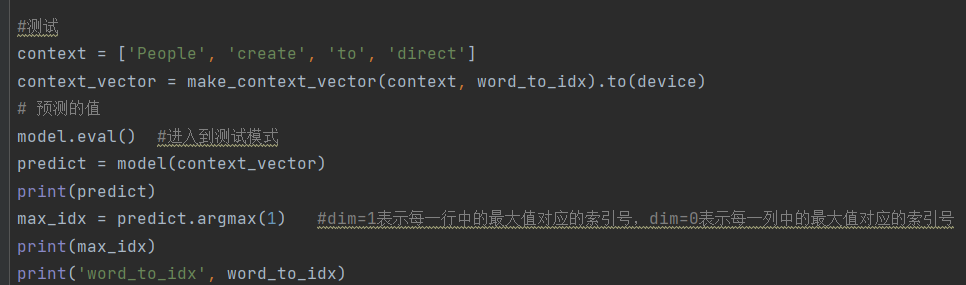
测试上下文是'People','create','to','direct'。所以目标词应该是programs。
model.eval()切换到测试模式。
predict = model(context_vector)输出的是log概率,不是普通概率。
predict.argmax(1)在词表维度找最大值的索引,即预测词索引。
2.10获取词向量
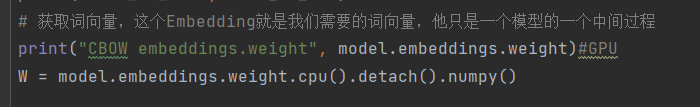
model.embeddings.weight就是训练好的词向量矩阵。
.cpu()移到CPU
.detach()从计算图中分离。
.numpy()转成Numpy数组。
W的每一行对应一个词的词向量。
三、网络层总结
1. nn.Embedding:词嵌入层
2.nn.Linear:全连接层。
3.F,relu:激活函数