写在前面
最近在把一套跨境电商 ERP(AEERP)从 V2 迁到 V3,技术栈从 .NET Framework 4.x 升到 .NET 8。框架层的迁移有单元测试兜底,71 个用例全绿,心里还算有底。
真正让我睡不着的是两张大表:
| 表名 | 行数 | 说明 |
|---|---|---|
| Product_Freight_Detail | 520 万 | 商品运费明细 |
| Product_AreaPrice_Detail | 1538 万 | 商品分区域报价明细 |
合计两千多万行,要从 SQL Server 一列不差地搬到 MySQL。这不是写个循环就能了事的事------它要连续跑几个小时,中间可能断线、可能爆内存、可能被业务实时写入的数据搅乱。
于是有了这个约 500 行的控制台程序 BigDBMigrator。这篇文章记录我在设计和落地过程中的取舍、踩过的坑,以及一些事后的思考。
一、为什么最后决定自己写
第一反应肯定是找现成的轮子。试过一圈之后放弃了:
- 图形化工具的数据传输功能:两千万行的量级,中途不能续传。一旦第 1400 万行断掉,你只能从头再来一次。
- 数据库自带的导入导出向导 / SSIS:本质是逐行 Insert,两千万行跑到天亮也跑不完;而且对 GUID、时间边界值的类型映射处理不够透明。
- 导出文件再导入:先 dump 成中间文件再灌库,中间文件几十 GB,磁盘和 IO 都不划算;格式转换最后还是要自己写。
先算一笔时间账
在动手写这个工具之前,我试过的几种办法,当时都把耗时记了下来。这笔账后来成了这个工具最直接的立项理由:
| # | 步骤 | 做什么 | 实测耗时 |
|---|---|---|---|
| 1 | 压缩备份 | 压缩数据库备份文件 AEERP.bak |
10 分钟以上 |
| 2 | 跨公网下载 | 把压缩包 AEERP.bak.rar 下载到本机 |
1 小时以上 |
| 3 | 跨服务器批量插入 | SELECT * INTO ##TMP_Product_AreaPrice_Detail FROM [远程服务器].[AEERP].[dbo].[Product_AreaPrice_Detail] |
30 分钟 |
| 4 | 执行 SSIS 包 | 跑 Product_AreaPrice_Head.dtsx(39.5 万行数据) |
20 分钟以上 |
单看每一步好像都还能忍,但把它们串起来,问题的形状就很清楚了。
第 1、2 步是纯粹的"搬运成本"。 压缩 10 分钟,下载 1 个多小时------这两个小时里你什么都干不了,只能盯着进度条。而这只把一个整库备份"拿到手上"而已,还原、建表、再往 MySQL 推的活儿一根手指都还没动。公网带宽是这里的硬瓶颈,压缩率再高、工具再好也绕不过去。
第 3 步的 30 分钟其实不算慢 (折算下来约 50 万行/分钟)。但它解决的是"SQL Server 复制到 SQL Server"的问题,而且 ## 前缀的全局临时表会随会话断开而消失,拿到的只是一份临时副本------离"数据落进 MySQL"还差着十万八千里。
第 4 步最能说明问题。 一个 SSIS 包搬 39.5 万行要 20 多分钟,折算约 2 万行/分钟。如果拿它去啃 1538 万行的 Product_AreaPrice_Detail,按同速率线性外推(粗糙估算,仅供参考),大概需要 13 个小时------而且中途断了不能续传,得从头再来。
把这些数字摊开之后,结论就变了:我要解决的不是"哪个工具更快",而是"把不可控的长步骤换成可控的短步骤"。
同样是"一个多小时",备份包下载的那一个多小时是不可中断、不可续传的,你只能守着;而批处理迁移是 2 万行一批、每批 1~2 秒,任何一刻中断都能从断点接上。前者的一个多小时是"我不敢眨眼",后者的一个多小时是"我可以去干别的"。
这才是 BigDBMigrator 真正的设计动机。
另一半原因:不可观测
现成工具跑起来就是个黑盒:你不知道它跑到哪了、还有多久、断了能不能接上。
两千万行的迁移,最怕的不是慢,是"你不知道它死在哪"。
所以决定自己写。核心诉求只有三条:
- 能续传------任何时刻中断,重跑都能从断点接上;
- 可观测------每批都打印进度、速率、耗时;
- 幂等安全------重复跑不会把数据搞乱。
二、六个关键设计决策
技术栈很朴素:.NET 8 控制台 + Microsoft.Data.SqlClient(读源)+ MySqlConnector 的 MySqlBulkCopy(写目标)。
难的不是技术栈选型,是那几个必须想清楚的决策点。
决策 1:分页坚决不用 OFFSET
这是整个迁移的性能命门。
千万行表分批读,直觉写法是 ORDER BY ID OFFSET n ROWS FETCH NEXT b ROWS ONLY。但 OFFSET 的代价是 O(n):读第 1 批扫 2 万行,读第 700 批就要先把前面 1400 万行数一遍。700 批跑下来,总扫描量接近行数的平方级------越跑越慢,最后几批能慢到让你怀疑人生。
我用了键集分页(Keyset Pagination):
sql
SELECT TOP (@batch) [col1], [col2], ...
FROM [Table] WITH (NOLOCK)
WHERE [Key] > @last
ORDER BY [Key]
@last 是上一批最后一行的主键值。这是一个索引 seek,第 1 批和第 700 批的代价几乎一样------每批耗时恒定,这是能预估总时长的前提。
分页键不是拍脑袋定的,直接从系统视图取主键的第一列:
sql
SELECT TOP 1 c.name FROM sys.indexes i
JOIN sys.index_columns ic ON ic.object_id = i.object_id AND ic.index_id = i.index_id
JOIN sys.columns c ON c.object_id = ic.object_id AND c.column_id = ic.column_id
WHERE i.object_id = OBJECT_ID(@t) AND i.is_primary_key = 1 AND ic.key_ordinal = 1
这两张表的主键恰好都是 GUID。GUID 做主键在 SQL Server 上因为页分裂一直被诟病,但作为键集分页的游标反而好用:单调可比、全局唯一,还能直接序列化进 JSON 当断点。
还有一个细节:WITH (NOLOCK)。生产库还在跑业务,迁移读不能长时间持共享锁把线上拖死。代价是可能读到未提交的行------对"明细数据一次性搬运"这个场景可以接受。
决策 2:批次大小从 20 万降到 2 万
代码里留着一层"考古痕迹":
csharp
//const int BATCH = 200_000;
const int BATCH = 20_000;
20 万行一批听起来很爽,实际跑起来有两个问题:
- 内存:DataTable 一次性读 20 万行全量加载到内存,宽表加上 DataTable 的装箱开销,单批能吃到几百 MB。GC 压力大,一旦 OOM 整个进程直接没了。
- 进度粒度:20 万行一批,一轮就是好几分钟。断点最坏情况下要白跑好几分钟。
改成 2 万行后,单批耗时稳定在 1~2 秒,进度几乎是每秒都在动,心理体验完全不同------你能看着数字涨,知道它活着。
这是我觉得最值得分享的一条:批大小的选择不是在优化吞吐,而是在优化"可观测性"和"失败成本"。批越小,进度越平滑,断点越细;只要分页方式是键集,批小并不会显著增加总 IO。
决策 3:检查点文件,就放在程序目录下
断点续传的核心是一个普通 JSON 文件:
csharp
class MigrateCheckpoint
{
    public string Table { get; set; }      // 表名
    public int BatchNo { get; set; }       // 已成功完成的批次数
    public string LastKey { get; set; }    // 最后一批的分页键值
    public long Total { get; set; }        // 已迁移的累计行数
    public long SrcRows { get; set; }      // 检查点创建时的源表行数
    public string UpdatedAt { get; set; }  // 最后更新时间
}
每批成功后立刻落盘成 checkpoint_<表名>.json,迁移 PASS 后自动删除:
json
{
  "Table": "Product_AreaPrice_Detail",
  "BatchNo": 74,
  "LastKey": "85cd4b6c-47f7-45af-b9eb-1801fc92b474",
  "Total": 1480000,
  "SrcRows": 15381070,
  "UpdatedAt": "2026-09-16 17:42:00"
}
没上数据库,也没上 Redis------一个 JSON 文件就够了。理由:这是单人操作的运维任务,不需要并发;文件天然可见,出问题能直接肉眼看、手工改;部署零依赖。
决策 4:检查点"不算数"怎么办------四重校验
这是最容易埋雷的地方。断点文件存在 ≠ 可以续传。
如果有人在迁移期间往源表插了几万行,或者上一次跑到一半目标表被清过,你拿着旧检查点续传,结果就是数据错位加重复。
所以续传前必须过四道校验:
csharp
bool resume = ckpt != null
              && ckpt.SrcRows == srcRows            // 1. 源表规模没变
              && ckpt.Total > 0                     // 2. 检查点有意义
              && !string.IsNullOrEmpty(ckpt.LastKey) // 3. 游标有效
              && dstRows == ckpt.Total;             // 4. 目标行数与检查点完全吻合
关键是第 1 条和第 4 条。
源表行数从 1538 万变成 1542 万,说明迁移期间业务写入了新数据,已迁的部分和未迁的部分不再是同一份快照------这时候正确做法是放弃续传、重来。第 4 条则是自证:目标表现有行数必须精确等于检查点记录的已迁行数,差一行都不认。
这套校验看起来很保守,但它的价值在于把"可能错"变成"一定重来"。数据迁移里,宁可多花两小时重跑,也不能带着错位的数据上线。
决策 5:四种启动状态,让程序自己判断该干什么
程序启动后不是无脑开搬,而是先做一次状态判定:
| 条件 | 动作 |
|---|---|
| 目标行数 ≥ 源行数 | SKIP,视为已完成 |
| 存在有效检查点 | 断点续传,从 batchNo + 1 继续 |
| 目标表有残留、无有效检查点 | TRUNCATE 后完整重迁 |
| 目标表不存在 | 报错退出(schema 由另一个工具负责建) |
这套状态机带来的直接好处是:运维时只需要反复运行同一条命令。跑失败了?直接再跑一次,它会自己判断是从头、续传还是跳过。不用记"现在该执行第几步"。
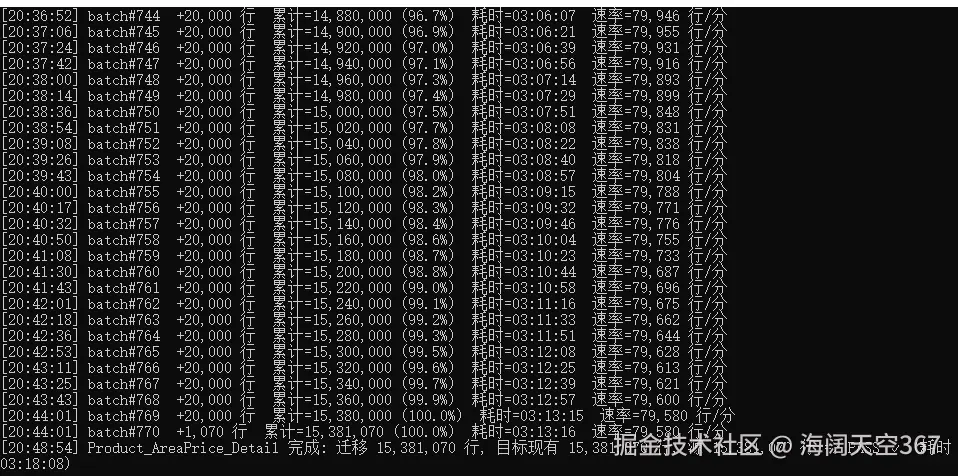
对应的进度打印也很直白:
csharp
[17:42:00] batch#074 +20,000 行 累计=1,480,000 (9.6%) 耗时=00:11:17 速率=131,166 行/分决策 6:类型映射,用一个装饰器搞定
SQL Server 和 MySQL 之间有些类型是"长得像但语义不同"的,直接搬会炸。我没有去改每一列的类型定义,而是写了一个 TransformReader,用装饰器模式包住 DataReader,在读取的瞬间做转换:
csharp
internal static object? Transform(object v)
{
    if (v is DateTime dt && dt.Year < 1000) return DBNull.Value;
    if (v is DateTimeOffset dto) return dto.ToString("yyyy-MM-dd HH:mm:ss.fff zzz");
    if (v is Guid g) return g.ToString();
    return v;
}
三行代码,解决了三类真实问题:
- 时间的最小值 :.NET 里
DateTime.MinValue是0001-01-01,但 MySQL 的DATETIME合法范围从1000-01-01起。老系统里那些拿默认值当 NULL 用的"空时间"字段,直接搬过去会被拒绝。判Year < 1000转成DBNull。 - GUID :MySQL 没有原生 GUID 类型,
uniqueidentifier需要转成字符串(36 位)才能落库。 - 带时区的时间 :MySQL 的
DATETIME不保存时区偏移,直接写会丢信息,转成带偏移量的字符串把语义保住。
装饰器的好处是零侵入 :MySqlBulkCopy 拿到的还是一个标准 DbDataReader,不用改 BulkCopy 的任何逻辑,也不用给每个字段写映射规则。
三、容错:为"连续跑十个小时"而设计
迁移要跑将近 2 小时,期间什么都可能发生。程序里所有关键动作都包了容错。
单批读写失败重试 3 次:
csharp
catch (Exception ex)
{
    attempt++;
    Log($"!! 读取批次出错(第 {attempt}/{MAX_RETRY} 次): {ex.Message}");
    if (attempt >= MAX_RETRY) { /* 安全退出,保留检查点 */ return false; }
    await EnsureOpenAsync(src);       // 断线重连
    await EnsureOpenAsync(dst);
    await Task.Delay(RETRY_DELAY_MS); // 5 秒退避
}重试前先确保连接还活着:
csharp
static async Task EnsureOpenAsync(DbConnection c)
{
    if (c.State != ConnectionState.Open)
    {
        Log($"连接已断开({c.GetType().Name}),尝试重连 ...");
        await c.CloseAsync();
        await c.OpenAsync();
    }
}
核心原则:失败要"退得干净" 。重试超过上限后不是抛异常崩掉,而是 return false 安全退出------此时检查点已经保存,下次运行自动续上。
同时顺手关掉目标库的约束检查:
sql
SET FOREIGN_KEY_CHECKS = 0;
SET UNIQUE_CHECKS = 0;
批量导入时这两项关掉能明显提速。因为数据本来就是从一套完整约束的库里搬过来的,完整性由源端保证。
最后做一次行数对账,PASS 才删检查点:
csharp
long finalRows = GetDstRowCount(dst, tblName);
bool pass = finalRows >= srcRows;
if (pass) DeleteCheckpoint(tblName);顺带一个小技巧:源表行数别用 COUNT(*) 。1538 万行的 COUNT(*) 要扫全表,好几秒才出结果。用系统分区视图可以秒出:
sql
SELECT SUM(p.rows) FROM sys.tables t
JOIN sys.partitions p ON p.object_id = t.object_id AND p.index_id IN (0, 1)
WHERE t.name = @t
四、实测数据
写这篇文章的时候,迁移正在线上跑。真实数据如下:
- 表:
Product_AreaPrice_Detail,1538 万行 - 批次:20,000 行/批
- 运行 17 分钟完成 196 万行(12.7%),平均速率约 11.6 万行/分钟,单批稳定在 1~2 秒
- 按此推算,整表迁移约需 2 小时出头
这里有个小细节值得提一句:随着批次推进,整体速率其实是在缓慢下滑 的(前期约 13 万行/分钟,跑到 17 分钟时降到 11.6 万)。这可能来自目标库索引的持续增长,也可能来自磁盘 IO 的波动。但因为键集分页让"单批耗时"保持恒定,这种下滑是平滑、可观测的,我随时能根据当前速率重算剩余时间,而不是突然撞上一堵墙。
速率基本恒定,是键集分页带来的最大好处------第 1 批和第 700 批的代价接近,所以"还剩多久"是一个能算出来的确定值,而不是一个越等越绝望的黑盒。
这一点在长任务运维里的价值,怎么强调都不过分。
五、已知的不足
老实交代几个我想改但还没改的地方,也算给自己留的作业。
1. 重试可能导致重复行。 这是当前设计里最需要警惕的一点。批量写入不是事务性的------如果一批 2 万行写到第 1.2 万行时连接断了,这批是"部分成功"的。此时程序重试会把这 2 万行再写一遍,前面那 1.2 万行就变成了重复数据。而最后的对账用的是 finalRows >= srcRows,有重复照样 PASS。
改进方向有两个:
- 目标表建唯一索引,让批量写入遇到冲突时忽略(但这又和
SET UNIQUE_CHECKS = 0的提速相冲突,需要权衡); - 或者更彻底:按主键做
INSERT ... ON DUPLICATE KEY UPDATE,牺牲一些速度换幂等。
2. 没有并行。 目前是单线程串行,源库读和目标库写交替进行。理论上读写可以流水线化(读下一批的同时写上一批),把吞吐再提一截。但考虑到生产库资源有限,暂时保持单线程的确定性。
3. 断点粒度受限于批大小。 2 万行一批,最坏情况重跑 2 万行。想更细就要把分页键区间再细分,但那会牺牲吞吐。当前这个平衡点我觉得可以接受。
4. 目标行数核对用 COUNT(*)。 在千万行 MySQL 上是全表扫描。虽然只调用两次(开始和结束),但如果要做更频繁的进度核对,应该改成读 information_schema.TABLES.TABLE_ROWS 这类估算值。
六、几点心得
① 大任务的第一优先级不是快,是可观测。 两千多万行的迁移,"跑多快"是第二位的,"我知道它跑到哪了、断了能不能接上"才是第一位的。所以我花了相当多精力在检查点、进度打印、状态判定上,而不是在调批次大小和优化 SQL 上。事实也是如此:可观测性做好了,剩下的问题会自己暴露出来。
② 保守的校验不亏。 检查点那四重校验,一开始还担心是不是太严了。但它们真正的价值不是"防止错误发生",而是"把不确定性收敛成确定性"------要么我确定能安全续传,要么我确定应该重来。中间态才是事故的温床。
③ 把"运维友好"当成功能来设计。 不用记执行步骤、重复运行同一条命令、失败了自己判断怎么接------这些不是顺手做的,是设计出来的。工具的成熟度往往体现在它出错时的表现,而不是它顺利时的表现。
④ 类型映射这种"脏活",用装饰器比用配置划算。 如果去写一张字段映射表,那每换一张表都得维护一份;用一个 TransformReader 按"类型语义"去转换,三行代码对所有表通用,而且读代码的人一看就懂。
⑤ 数据迁移里,慢可以被容忍,错不能被容忍。 整个设计里我做了很多"看起来很怂"的选择:放弃 OFFSET、严格校验检查点、失败就退出不硬扛。这些选择都在拿性能换确定性。事后看,这个交换非常划算。
⑥ 要盯的不是总耗时,是"单次失败的成本"。 压缩 10 分钟、下载 1 个多小时、SSIS 跑 20 分钟------这些数字单看都不算离谱,甚至比批处理迁移的总耗时还短。但它们有个共同点:失败了就得从头再来。一次网络抖动,一个多小时的下载白干;SSIS 包跑到 90% 报错,那 20 分钟也不还给你。
所以真正要优化的指标是"单次失败的成本",而不是"平均速度"。检查点、分批、幂等------这三个东西就是在把"失败成本"从"几小时"压到"几秒"。一个任务能不能放手跑过夜,取决于它失败时有多便宜,而不取决于它跑起来有多快。
以上代码来自 AEERP 项目中的 BigDBMigrator 工具(.NET 8 控制台程序)。如果你也在做大表跨库迁移,希望这些踩坑记录能帮你少走一点弯路。