摘要:让 AI 修 Bug,经常越修越多,改到无关模块,测试漏一块就是线上事故。三组实测把账算清楚了:缺的不是模型聪明,是修复循环里没有撤销点,改动集又大到没人读得完。
一、代码看不懂,只能让 AI 改
某天下班后,生产库连接数冲到上限,一串服务跟着超时。DBA 翻遍慢 SQL 日志,干干净净。最后顺着连接数一层层往下捋,落在这个每五分钟跑一次的定时任务上------它同时开着大量连接,而且不还(此处为模拟线上事故场景🐶)。
这是 AI 修改的新版本,它把流程包了四层:一个任务调度类,一个"任务上下文管理器",一个"通用执行器",一个"结果集处理框架"。连接在"通用执行器"里建,释放逻辑散在各层------某个分支释放了,另一个分支交给"结果集处理框架"之后就没有下文。
更麻烦的是它还自带一套"优雅关闭":任务抛错时,把连接塞进"待重试队列",等下次复用。这个队列在某条异常路径上会被无限填充,直到把连接池吃干净。
写这段代码的模型不是在偷懒。让这次调用成功,和让这个系统长期活着,是两件事,它优化的是前者。
下面这个场景你大概更熟。一家公司用 AI 工具做客服 Agent,团队原班是 Java 和前端,边学边做。上线之后频繁异常,而且定位不了------核心代码由 AI 生成,能跑,但没人说得清为什么这么设计,更判断不出"改这里会波及哪些功能"。
然后就进了那个循环:代码看不懂,只能继续让 AI 改;AI 修好一个问题,又带出新的;今天解决了 A,明天 B 又异常。
他们复盘时给出的结论很干脆:真正失控的不是 AI,是工程过程。
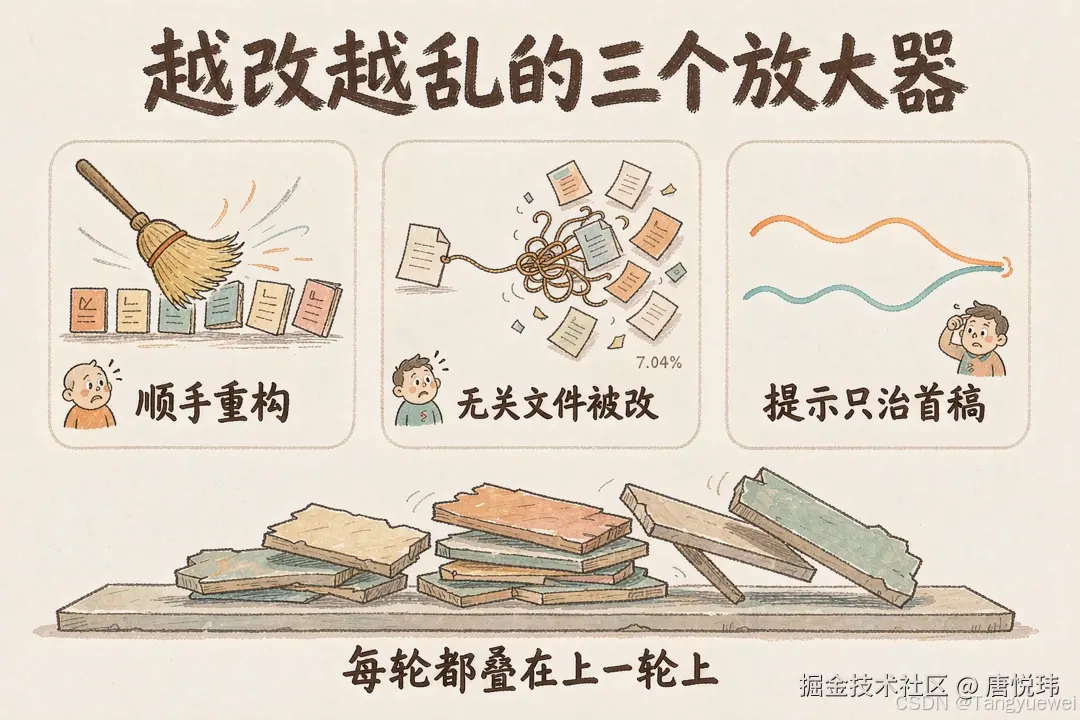
几行样式的小改动上,同一件事看得更清楚。让 AI 调一个按钮颜色,它先改对了颜色,顺手把相邻组件也"统一"了;第二轮修布局,动了公共样式;第三轮你已经不认识这个文件,也说不清自己本来要改哪几行。
二、越改越多的账,有人算过
ACM 上有一篇专门研究 AI 代码回滚的论文,样本是三万三千多个 agent 提交的 PR。作者从里面挑出所有由 AI 写作者发出的回滚提交,逐个人工归类,最后得到八类原因。
排第一的那一类,占了 22.33%,名字叫"过度工程的副作用"。拆开看:意外改变了原有行为占 12.47%,改动了无关文件占 7.04%,过度重构占 2.82%。
"改动了无关文件"------这就是你感觉到的"越改范围越大"。
论文里有个反直觉的数字,得一并说:整体算下来,AI 提交的回滚率是 2.66%,人类是 4.68%,AI 反而更低。但分工具看,差距拉到十倍以上------Copilot 是 7.57%,高于人类 62%;Claude Code 是 7.21%;Cursor 是 2.34%;Codex 只有 0.72%。
平均更低,个体差十倍。这说明结论不在"用不用 AI",在"怎么用、用哪个"。
第二个数据更扎心。一篇名为 TDAD 的研究在 SWE-bench Verified 上跑了 100 个实例,基线回归率 6.08%------换算下来,平均每个生成的补丁,会打破 6.5 个"原本是通过的"测试。
你交给它的测试过了,产品不一定还完整。
还有一个基准测试叫 SlopCodeBench,出自威斯康星大学麦迪逊分校、MIT 和华盛顿州立大学的研究者。他们让十一个最强编程 Agent 反复迭代同一个程序、不断追加需求。结果是没有一个 Agent 端到端完成,最好的解决率也只有 17.2%。
失败方式比失败率更有意思:它们不崩溃,不写错代码,每一步测试都过------但代码每迭代一次就糟一点。生成代码的冗长度是等价人类代码的 2.2 倍,结构性侵蚀出现在 80% 的迭代轨迹里。
而且研究者试过用更好的提示词去救。有用,首稿明显更干净。但救不了迭代:跑到后期,有提示和无提示的 Agent 收敛到了同样的结构问题。
三、缺的不是聪明,是一个撤销动作
把上面这些串起来看,根因很朴素。
人修 Bug 的循环里天生带一个动作:改坏了,git checkout . 退回去,重想。方向错了就换方向,成本是几分钟。
AI 修 Bug 的循环里没有这个动作。你贴一个报错,它改;你贴下一个报错,它接着改。每一轮都叠在上一轮的废墟上。
于是每轮都往系统里存两样东西:上下文里留着已经证明是错的推理,代码里留着没派上用场的补丁。存到第五轮,代码长什么样已经没人能预测------"改到全局功能"是这个过程的水到渠成,不是意外。
有篇讲"所有权债"的文章把这个反应说得很准:AI 写的代码出问题,人的第一反应不该是让它再试一次。那不是调试,那是赌博------你在掷骰子,指望这次它给个更好的答案。
真正的调试是读代码、建心智模型、定位失败原因。而"再试一次"跳过了全部三步。
所以修复循环里最该补齐的,是一个能把你从废墟里拽出来的动作。Fireship 有句话流传很广:当 AI 接管了你的代码,它同时也拿到了删掉你能跑的部分的能力,而一旦发生,你几乎不可能靠提示词把它指挥回来。
他的结论是,提交是那颗 AI 没法用话术绕过的撤销键。
四、把改动缩小到一个人读得完
撤销的前提,是你要知道自己该退到哪。而退到哪取决于一次改动有多大。
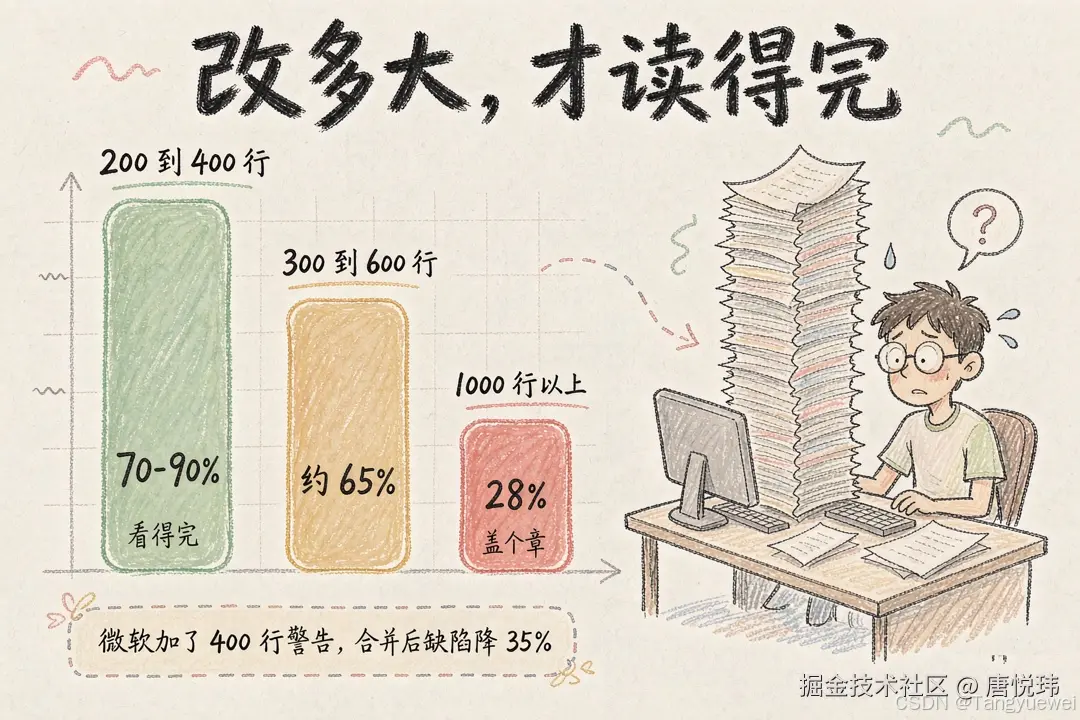
代码评审有个被反复验证的老结论:SmartBear 早年统计过 Cisco 约两千五百次评审,200 到 400 行是缺陷检出率最高的区间,落在 70% 到 90%;超过一千行,检出率掉到三成以下,基本等于盖章。
这条规律在 AI 时代被放大了。一份覆盖多家工程组织的分析发现:改动超过一千行的超大 PR,引入缺陷的比率是极小改动的 5.9 倍,而且按行数归一化之后这个差距依然成立------大 PR 不是"缺陷多",是"每行都更容易出问题"。
有个对照实验更直接:微软对超过 400 行的 PR 加了一条警告,什么都没禁,就是提醒一下。合并之后的缺陷下降了 35%。
原因不神秘。评审者的注意力是有额度的,改动越大,分摊到每行的注意力越少。有一句话值得抄在团队规范第一行:
一个做两件事的 diff,两件事都无法被验证。
这条对 AI 尤其致命。你说"修一下这个空指针",它顺手把同名变量重构了、把日志级别调了、给相邻模块补了两层防御。这个 diff 里既有对的部分也有错的部分,你要么全收,要么全退。你想只留对的那部分------那就得自己动手改,等于回到了起点。
落到操作上就三条:
- 一次只解决一件事,一个提交只对应一个原因
- 改动超过三个文件,先出计划再动手,不要直接给代码
- 明确"允许改哪些文件,其余只读"
第三条最省事也最有效。你只要把白名单写在它能读到的地方,越界的改动就少一大截。
五、两次修不好,就退回去
判据有了,动作还得有。
有人在实操里总结出一条很硬的规则,叫重置规则,五步:
- 提交:每次端到端能跑通,就存一个提交,写一句大白话,比如"登录和首页能用了"
- 让它试第一次:贴一个像样的 Bug 描述,允许它改
- 再试第二次 :如果第一次引入了新问题,明确告诉它破坏了什么,并且把范围限定在它刚碰过的文件里
- 退回去:第二次还不行,停下,重置到上一个提交。不要发第三条指令
- 拆得更小:把这件事拆到你能用一句话说清的最小改动,先验证再往下
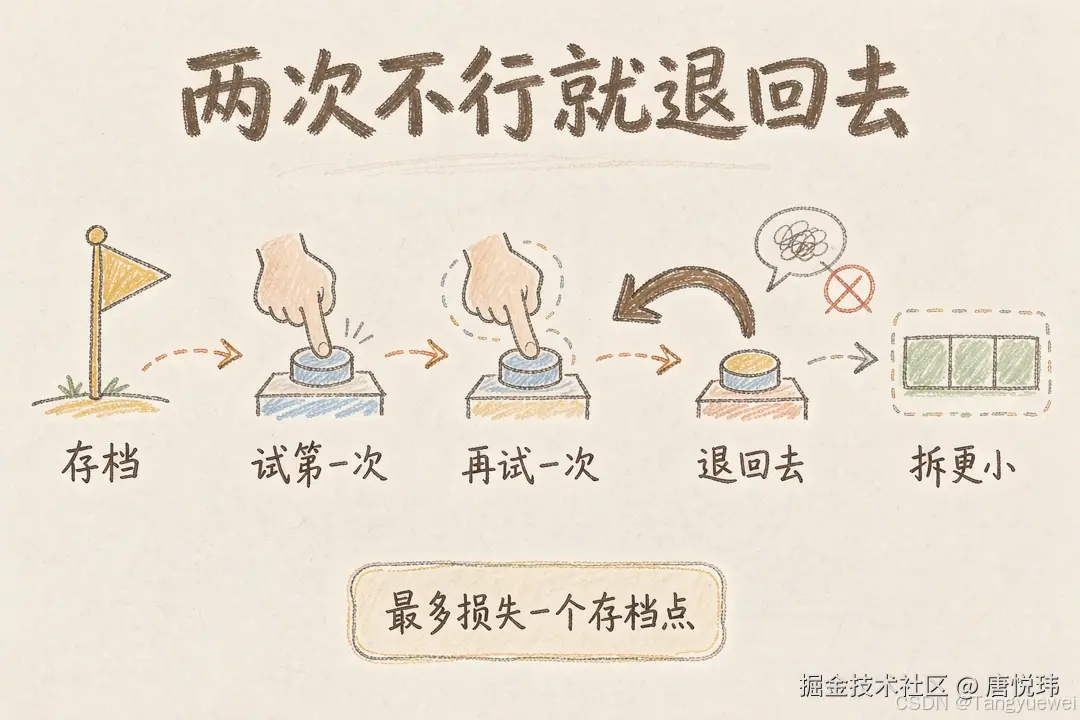
这笔账很好算。两次失败加一次重置,最多损失一个检查点的活儿,通常十五到三十分钟。而那个螺旋没有上限------有团队记过一笔账:一个功能,十分钟生成,接着 90 分钟调试、1 小时重构、3 小时线上救火,比一开始手写还慢。
工具侧现在也给了支持。Claude Code 里每发一次指令都会自动生成一个检查点,走偏了连按两次 Esc 就能回到之前的某个点,可以选择只恢复代码、只恢复对话,或者两者都恢复。
但机制有边界,官方讲得很清楚:它不追踪通过命令行做的文件操作,也就是 rm、mv 这类不记录;也不追踪你在编辑器里、在终端里做的改动;更不能替代版本控制。
所以它适合当"顺手回一下",不该当"我以为存过了"。真正的存档点仍然是 git 提交------而且提交要密,密到"每次它能跑通"这个粒度。
六、先把"改完是什么样"写出来
退回去之后,还得解决问题。而"越改越多"的另一半原因,是你从来没告诉它什么叫改完了。
Anthropic 官方的 Claude Code 最佳实践里,被标为最高杠杆的一条是这个:给 Claude 一个它能自己跑起来的检查 (官方指南)。
原话是这么说的:没有一个它能运行的检查时,"看起来完成了"就是唯一可用的信号,而你就成了那个验证回路------每一个错误都在等着你去发现。
反过来,只要你给的检查能产生一个通过或不通过,回路就自己闭上了:它干完活,跑检查,读结果,不过就继续改,直到过为止。你从回路里被摘了出来。
检查的强度可以分三档,按你的容忍度选:
- 写进提示词:顺手让它跑一遍(最轻,任何任务都能用)
- 设成结束条件:单独一个评估器每轮复核,不满足就不许停
- 做成硬门禁:用钩子拦住回合结束,检查不过就继续
软件故障的场景下,最便宜的检查就是一个"不修就会挂"的测试。先要测试,看它红,再让它改,看它变绿。 这个红到绿的过程,是确认"它改的是我问的那个问题"最直接的证据。
要让这个检查有效,Bug 报告得写全四个部分:
- 你做了什么(触发动作,一句话)
- 现在什么现象(你眼睛看到的)
- 你期望什么(一句话)
- 完整的错误文本(原样复制,含文件名行号,不要转述)
最后一条最容易被忽略。错误文本是你和模型共享的确定性事实,通常直接点出问题在哪个文件的哪一行。写"它坏了,修一下",等于让它在一百个文件里猜,每次猜都是一次弄坏好功能的机会。
这里还有个反直觉的实测结论,来自前面那篇 TDAD 论文(arXiv:2603.17973):
- 什么都不给,回归率 6.08%
- 给一堆流程性指令------"你要先写测试、你要跑测试、改完要验证"------回归率涨到 9.94%
- 给一张"哪些测试会受这次改动影响"的依赖图,配二十行短指引,回归率压到 1.82%
流程性指令反而让结果更差的解释有两条:一是长指令吃掉上下文,把真正需要的仓库知识挤了出去;二是它不知道哪些测试重要,于是碰更多文件。
论文自己的总结是:"跑测试"这句话没有意义,除非你知道跑哪几个。
七、为什么技能装了一堆,还是不行
回到你那个疑问。
技能、规则文件、提示模板,解决的是同一类问题:让模型更了解你的项目。它们没法解决另一类问题:修复循环本身的形状。
SlopCodeBench 那组数据已经把这条界线画出来了------更好的提示能让首稿更干净,但阻止不了迭代退化。到后期,有无提示收敛到同样的结构问题。因为"这一刀下去六个月内要多花三倍时间"这种判断,不是提示词能装进去的,它是踩过坑之后长出来的直觉。
另一个实验从反面印证了同一个判断。TDDev 那篇论文测了四种开发协议,结论是 TDD 基础设施能稳定提升质量 34 到 48 个百分点;但协议和模型的生成风格不匹配时,收益会被完全抵消,token 成本还能涨到 25 倍。
同一套方法论,配错了就归零。所以"市面上有那么多技能,效果不理想"这件事,多半不是技能写得不认真,是它给的是流程,缺的是上下文------这也正是 TDAD 那张依赖图干的事。
最后得说清楚边界,这套做法不是万能的。
收窄范围、两次就退、不保留向后兼容------这些在低风险、能一键撤回的场景里最划算。换到碰钱的链路、数据迁移、认证授权、不可逆操作上,同样的配置就是自杀。这些地方你反而需要它把调用方翻一遍、把回滚路径想清楚、多跑几轮验证。
判据不是"让 AI 少做点",是这个改动最坏情况能不能撤回。能撤回,就给它上限制、上节奏;不能撤回,就给足谨慎。
开头那个五十行的定时任务,如果中途有过一次回滚,它不会长成五百行。它会长成五十行------加一个判空。
这就是区别。不是模型更聪明了,是有人在中途喊过一次停。
参考资料
- When AI Code Doesn't Stick: An Empirical Study on Reverted Changes Introduced by AI Coding Agents --- ACM,2026(DOI: 10.1145/3793302.3793587)
- TDAD: Test-Driven Agentic Development --- Reducing Code Regressions in AI Coding Agents via Graph-Based Impact Analysis --- Alonso, Yovine, Braberman,arXiv:2603.17973v2,2026
- From Runnable to Shippable: Multi-Agent Test-Driven Development for Generating Full-Stack Web Applications from Requirements --- Wan 等,arXiv:2605.17242,2026
- Best practices for Claude Code --- Anthropic 工程博客
- AI编程时代代码复杂性失控:五个信号与四道防线 --- CSDN(定时任务连接池事故复盘)
- AI写得很快,团队却维护不动:一个客服Agent项目的失控现场 --- 今日头条,2026-09-07
- Ownership Debt: The Hidden Risk of AI-Generated Code --- Technodrone,2026
- A great software development workflow in 2026 --- Startup Notes
- Vibe Debugging: When to Stop Asking the AI to Fix It (and Revert Instead) --- 13Labs(含 DevForge 的成本记录,以及 Fireship 关于"提交是唯一无法绕过的那颗撤销键"的引述)
- Autonomous Teams Ship Cleaner AI Code --- Span
- AI can write code. It just can't maintain it. --- ArtificialStudio,2026(引述 SlopCodeBench:威斯康星大学麦迪逊分校 / MIT / 华盛顿州立大学)
- Best Kept Secrets of Peer Code Review --- SmartBear(对 Cisco 约 2,500 次评审的规模统计,业界常引用的经典研究)
作者:唐悦玮 | 从后端出发,用 AI 拓展到全栈的工程师。