Seata------把分布式事务理论落到 Java 微服务实践
- [为什么需要 Seata](#为什么需要 Seata)
- [Seata 最重要的三个角色](#Seata 最重要的三个角色)
- [先看一个 Seata 事务流程](#先看一个 Seata 事务流程)
-
- [Seata 有哪些主要事务模式](#Seata 有哪些主要事务模式)
- [XA 模式](#XA 模式)
- [Seata AT 模式是什么](#Seata AT 模式是什么)
-
- [AT 第一阶段做什么](#AT 第一阶段做什么)
-
- [undo_log 是什么](#undo_log 是什么)
- [AT 第一阶段和 XA 最大的不同](#AT 第一阶段和 XA 最大的不同)
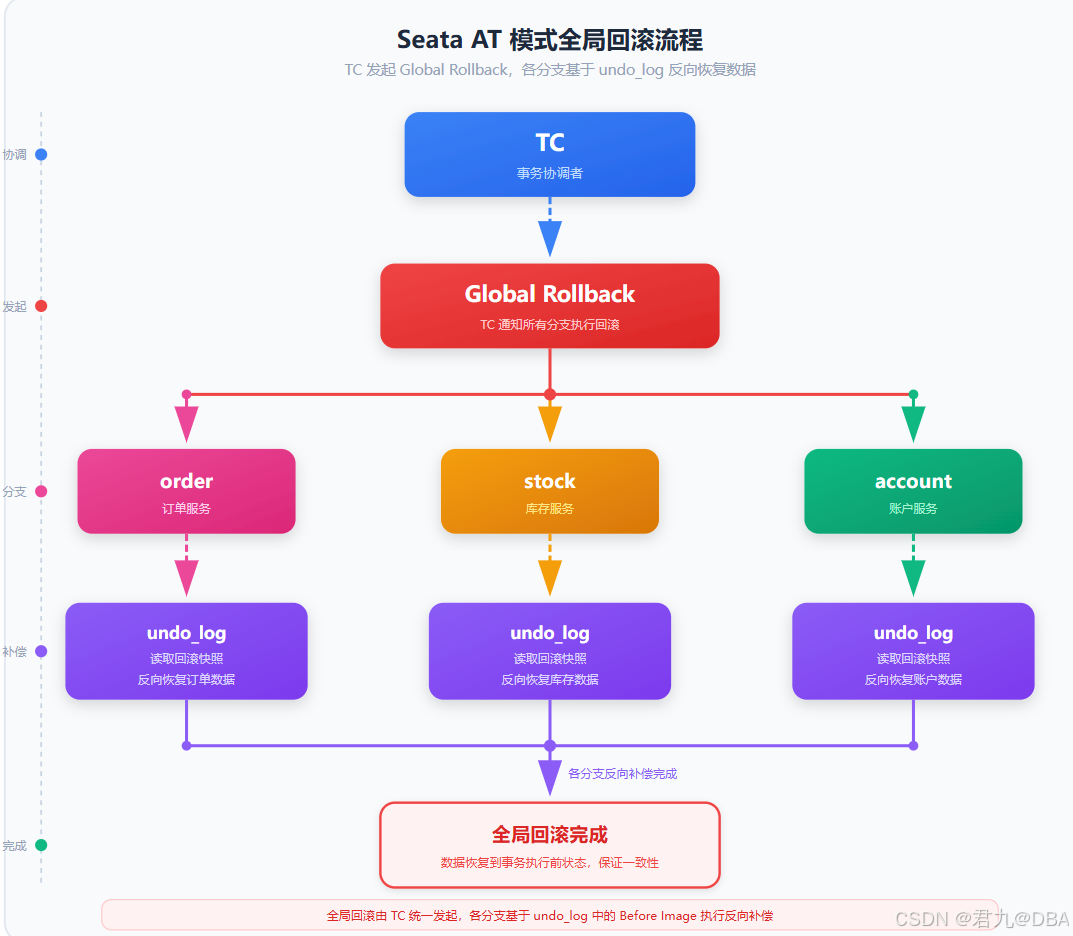
- [那 AT 怎么回滚?](#那 AT 怎么回滚?)
- [这和 Saga 很像吗?](#这和 Saga 很像吗?)
- [AT 为什么需要全局锁](#AT 为什么需要全局锁)
- 什么是全局锁
- [为什么 AT 既释放 DB 锁,又还能保证隔离](#为什么 AT 既释放 DB 锁,又还能保证隔离)
- [AT 的二阶段提交](#AT 的二阶段提交)
-
- [AT 的二阶段回滚](#AT 的二阶段回滚)
- [为什么需要校验 After Image](#为什么需要校验 After Image)
- [这说明 AT 有一个重要前提](#这说明 AT 有一个重要前提)
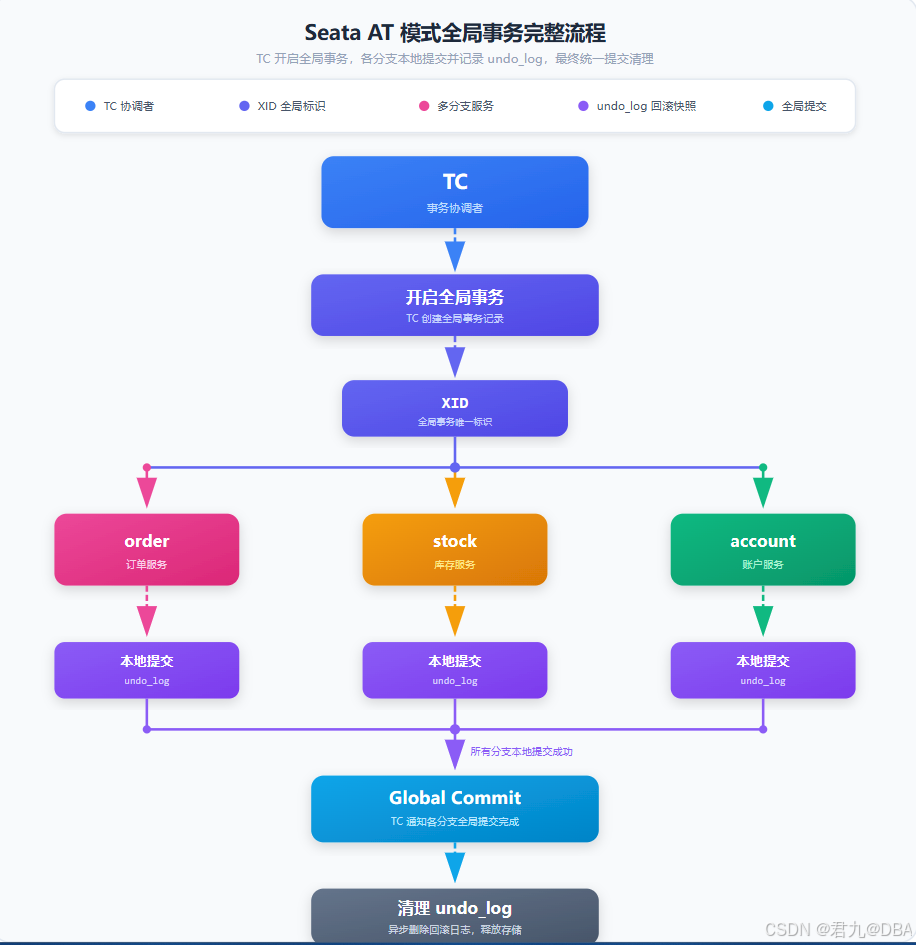
- [AT 的整体流程](#AT 的整体流程)
- [AT 和 XA 怎么比较](#AT 和 XA 怎么比较)
-
- [AT 适合什么场景](#AT 适合什么场景)
- [AT 不太适合什么场景](#AT 不太适合什么场景)
- [Seata TCC 是什么](#Seata TCC 是什么)
-
- [Seata TCC 的价值是什么](#Seata TCC 的价值是什么)
- [Seata Saga 是什么](#Seata Saga 是什么)
- [Seata 四种模式怎么选](#Seata 四种模式怎么选)
- 实际项目可以混用
- [为什么支付通常不要简单用 AT](#为什么支付通常不要简单用 AT)
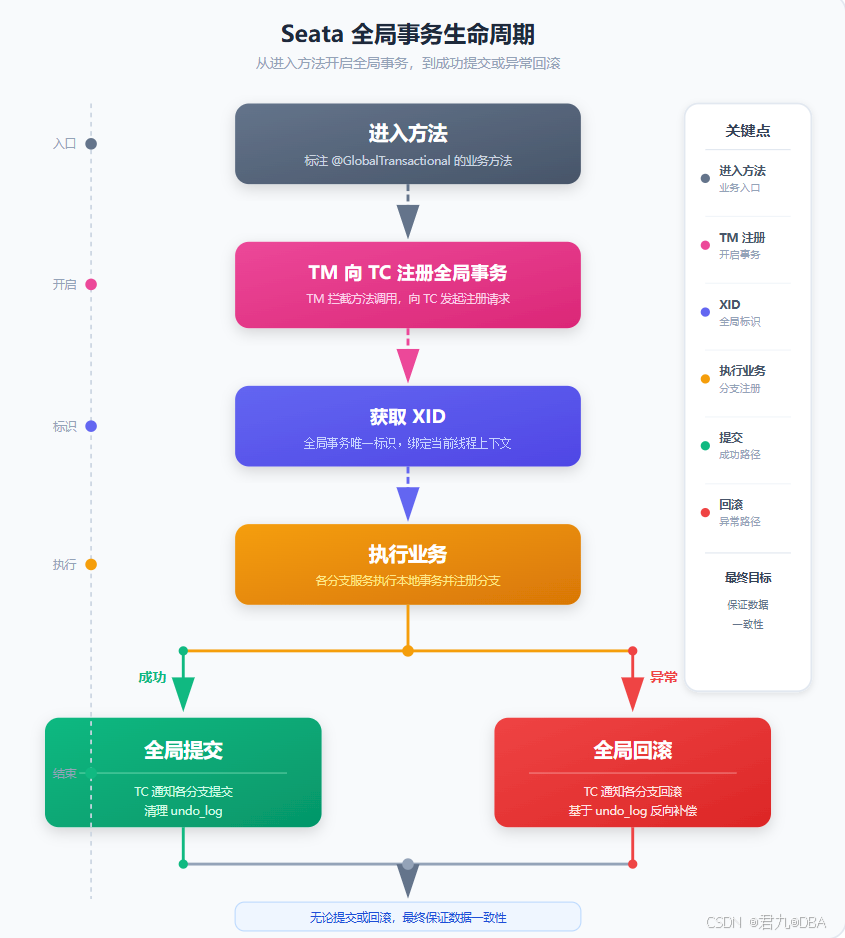
- [@GlobalTransactional 是什么](#@GlobalTransactional 是什么)
- [@Transactional 和 @GlobalTransactional 的区别](#@Transactional 和 @GlobalTransactional 的区别)
- [一个典型 Spring Cloud 场景](#一个典型 Spring Cloud 场景)
- [如果 account-service 抛异常](#如果 account-service 抛异常)
- [Seata 不是魔法](#Seata 不是魔法)
- 全局事务应该尽可能短
- [Seata AT 最容易被问的面试题](#Seata AT 最容易被问的面试题)
-
- [问:Seata AT 模式怎么实现回滚?](#问:Seata AT 模式怎么实现回滚?)
- [问:AT 和 XA 最大区别是什么?](#问:AT 和 XA 最大区别是什么?)
- [问:undo_log 有什么作用?](#问:undo_log 有什么作用?)
- [问:TC、TM、RM 分别是什么?](#问:TC、TM、RM 分别是什么?)
- 把现在所有知识串起来
- [本篇须记住的 10 个结论](#本篇须记住的 10 个结论)
上一篇:《幂等、重试、去重与状态机》
下一篇:《》
进入 Seata------把分布式事务理论落到 Java 微服务实践。
本篇的目标,是把前面学过的:
text
2PC / XA
TCC
Saga
幂等
补偿
状态机
真正映射到 Seata 体系里。
先记一句话:
Seata 不是一种新的分布式事务理论,而是把多种分布式事务模式工程化实现出来的框架。
为什么需要 Seata
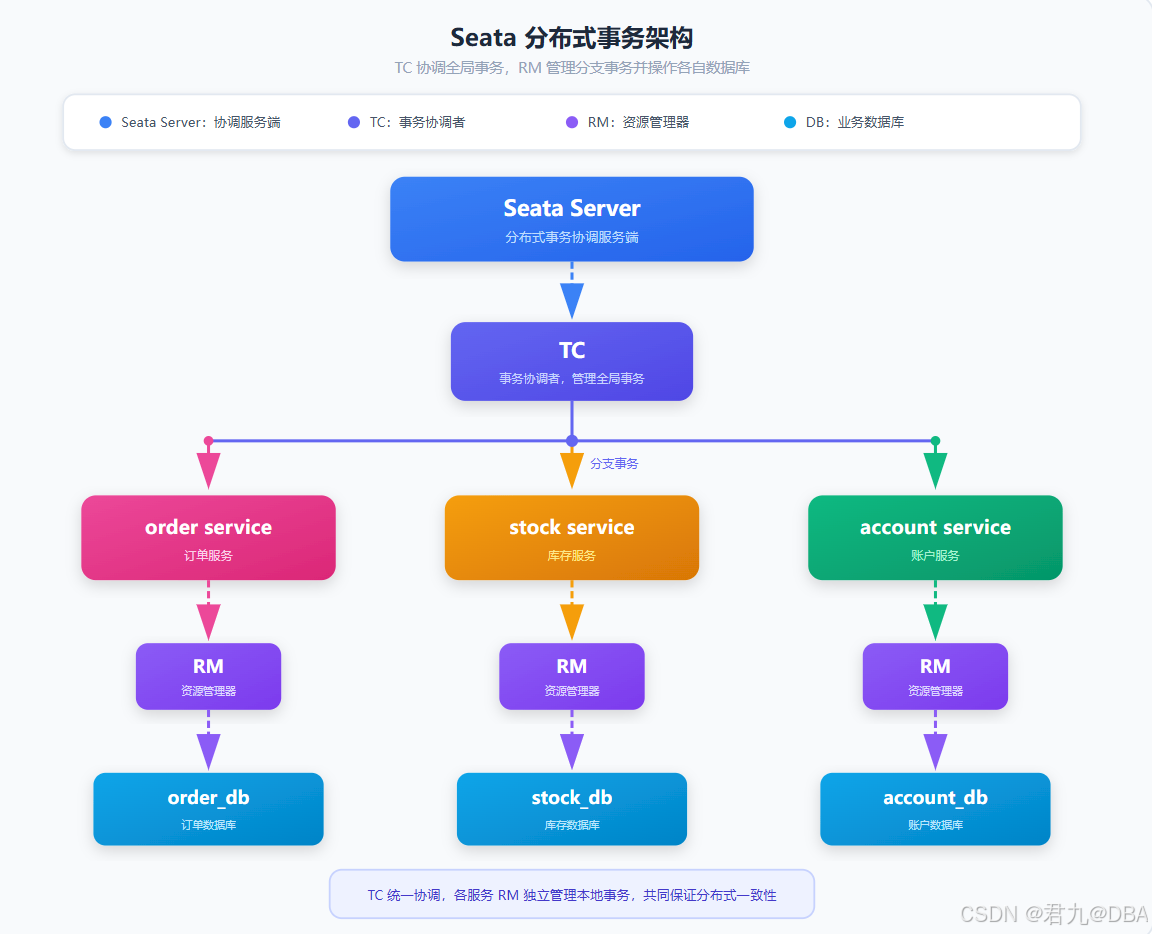
假设现在有三个微服务:
text
order-service
stock-service
account-service
下单流程:
text
创建订单
   ↓
扣库存
   ↓
扣余额
每个服务都有自己的 MySQL:
text
order-service   → order_db
stock-service   → stock_db
account-service → account_db
如果没有分布式事务框架,你需要自己处理:
text
事务协调
全局事务 ID
分支事务注册
失败回滚
重试
异常恢复
事务状态
这些东西非常复杂。
Seata 做的事情,就是:
提供一个统一的分布式事务协调框架。
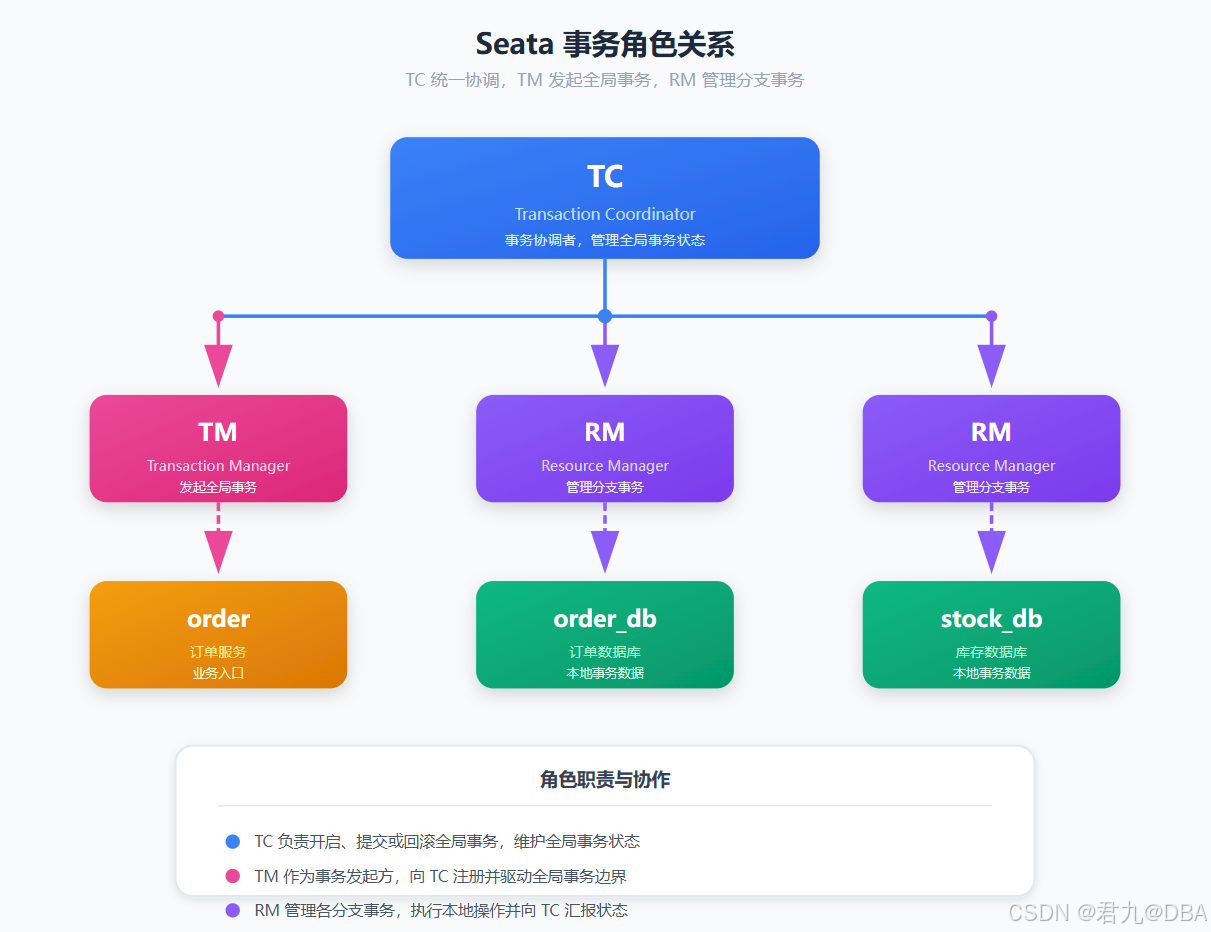
Seata 最重要的三个角色
学 Seata,第一件事就是记住:
text
TC
TM
RM
分别是:
text
TC = Transaction Coordinator
TM = Transaction Manager
RM = Resource Manager
中文:
text
TC:事务协调器
TM:事务管理器
RM:资源管理器
先看整体架构
更完整一些:
TC 是什么
TC:
text
Transaction Coordinator负责:
协调整个全局事务。
它会维护:
text
这个全局事务有哪些分支
哪些分支成功
哪些分支失败
最终应该 Commit 还是 Rollback
你可以把它理解成:
text
分布式事务总指挥通常 Seata Server 承担 TC 角色。
TM 是什么
TM:
text
Transaction Manager负责:
text
开启全局事务
提交全局事务
回滚全局事务
例如:
java
@GlobalTransactional
public void createOrder() {

    orderService.create();

    stockService.deduct();

    accountService.deduct();
}
这里:
text
@GlobalTransactional所在的应用,可以理解成承担 TM 的职责。
TM 会告诉 TC:
text
我要开始一个全局事务最终再告诉 TC:
text
提交或者:
text
回滚RM 是什么
RM:
text
Resource Manager负责管理具体的事务资源。
例如:
text
MySQL对于订单服务:
text
order_db就是一个事务资源。
库存服务:
text
stock_db也是一个事务资源。
RM 会做:
text
向 TC 注册分支事务
报告分支事务状态
执行分支提交
执行分支回滚
所以:
text
TM
↓
控制全局事务

RM
↓
控制具体资源事务

TC
↓
负责统一协调
什么是全局事务
假设一次下单:
text
createOrder()会调用:
text
订单服务
库存服务
账户服务
整个业务流程:
text
Global Transaction也就是:
全局事务。
可以表示为:
text
Global Transaction
│
├── Branch Transaction 1
│   └── order_db
│
├── Branch Transaction 2
│   └── stock_db
│
└── Branch Transaction 3
    └── account_db
这里每个数据库事务:
text
Branch Transaction叫:
分支事务。
什么是 XID
当 TM 开启全局事务以后:
TC 会生成一个:
text
XID可以把它理解成:
全局事务唯一 ID。
例如:
text
XID = 192.168.1.10:8091:123456789于是:
text
订单
库存
账户
虽然属于不同微服务,但只要它们拿到相同:
text
XID就知道:
我们属于同一个全局事务。
XID 为什么重要
假设:
text
order-service
↓
HTTP / RPC
↓
stock-service
调用时需要把:
text
XID传过去。
继续:
text
stock-service
↓
account-service
也要继续传播 XID。
所以本质上:
text
XID是一种:
事务上下文传播。
很像我们熟悉的:
text
traceId只不过:
text
traceId是链路追踪 ID。
text
XID是全局事务 ID。
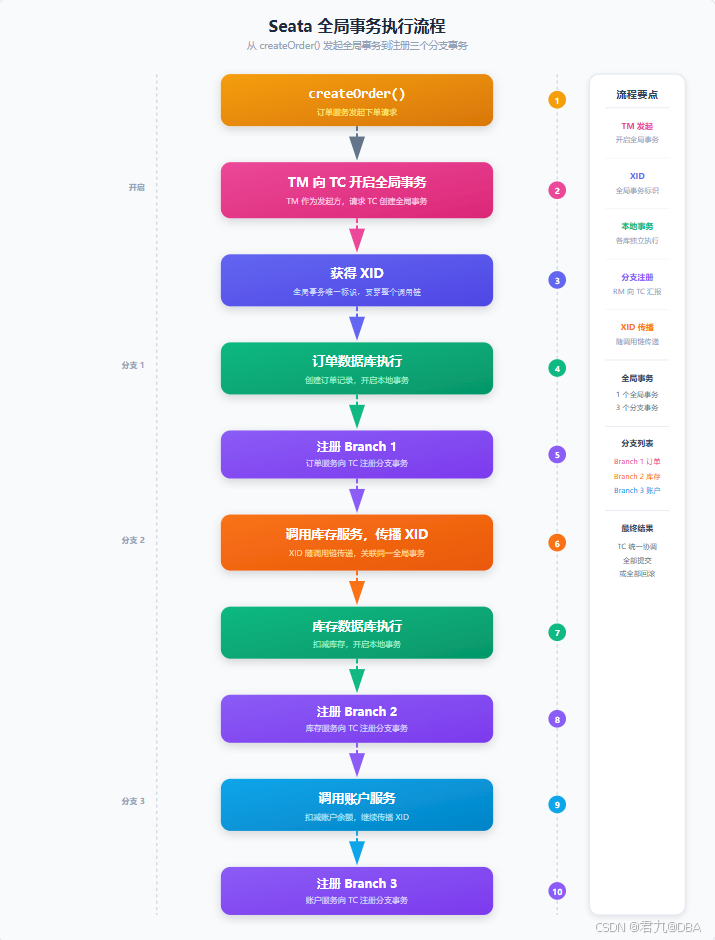
先看一个 Seata 事务流程
假设:
java
@GlobalTransactional
public void createOrder() {

    createOrderRecord();

    stockClient.deduct();

    accountClient.deduct();
}
执行流程大概是:
如果全部成功:
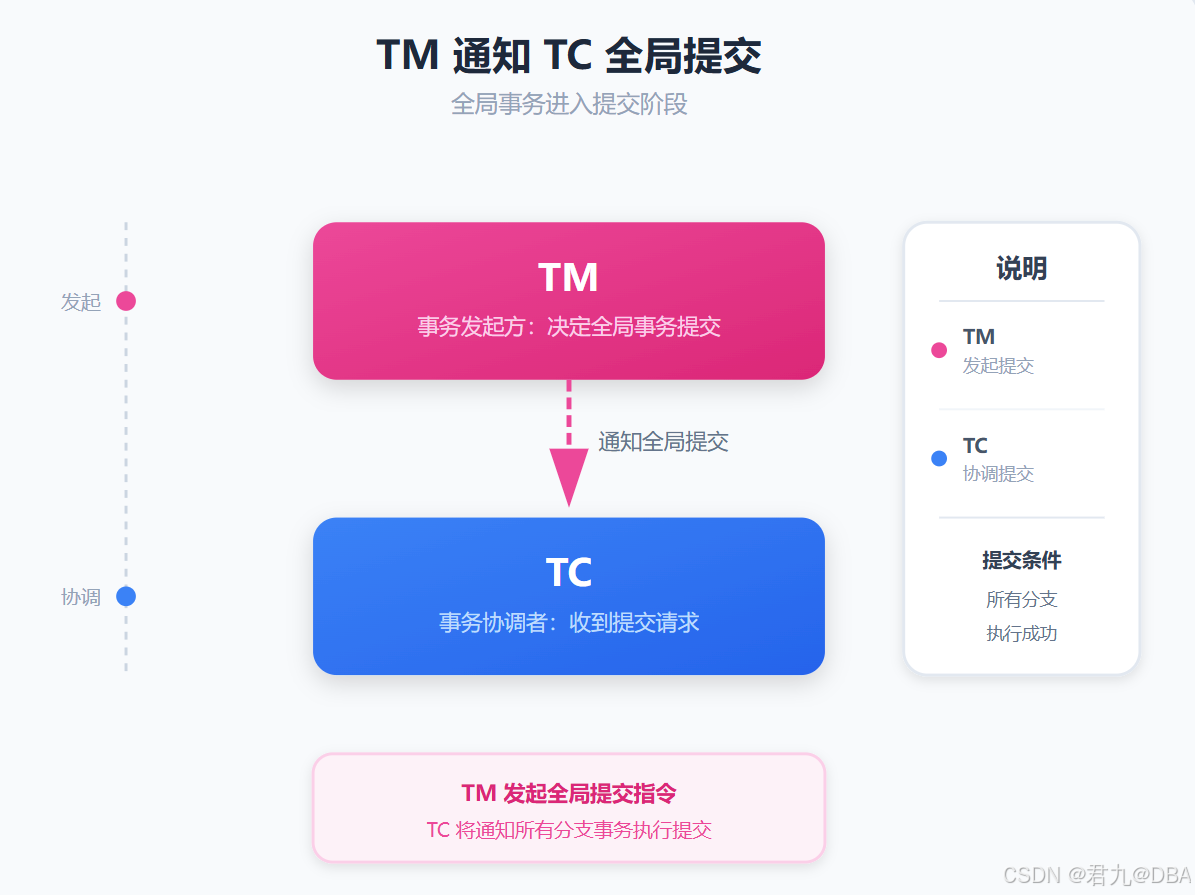
失败:
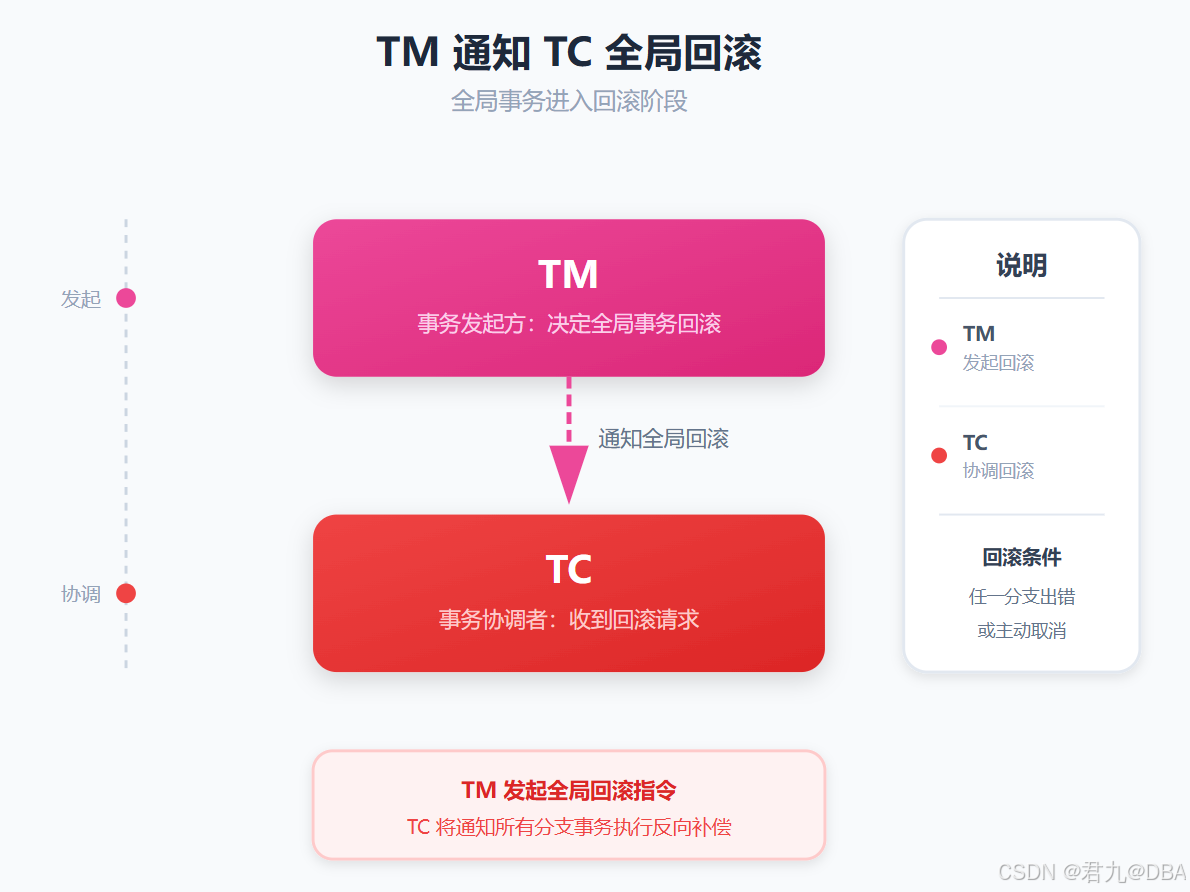
然后 TC 负责协调各个 RM。
Seata 有哪些主要事务模式
你目前重点记四种:
text
AT
TCC
Saga
XA
这正好对应我们前面已经学过的知识。
XA 模式
这个最容易理解。
因为上一课之前已经讲过:
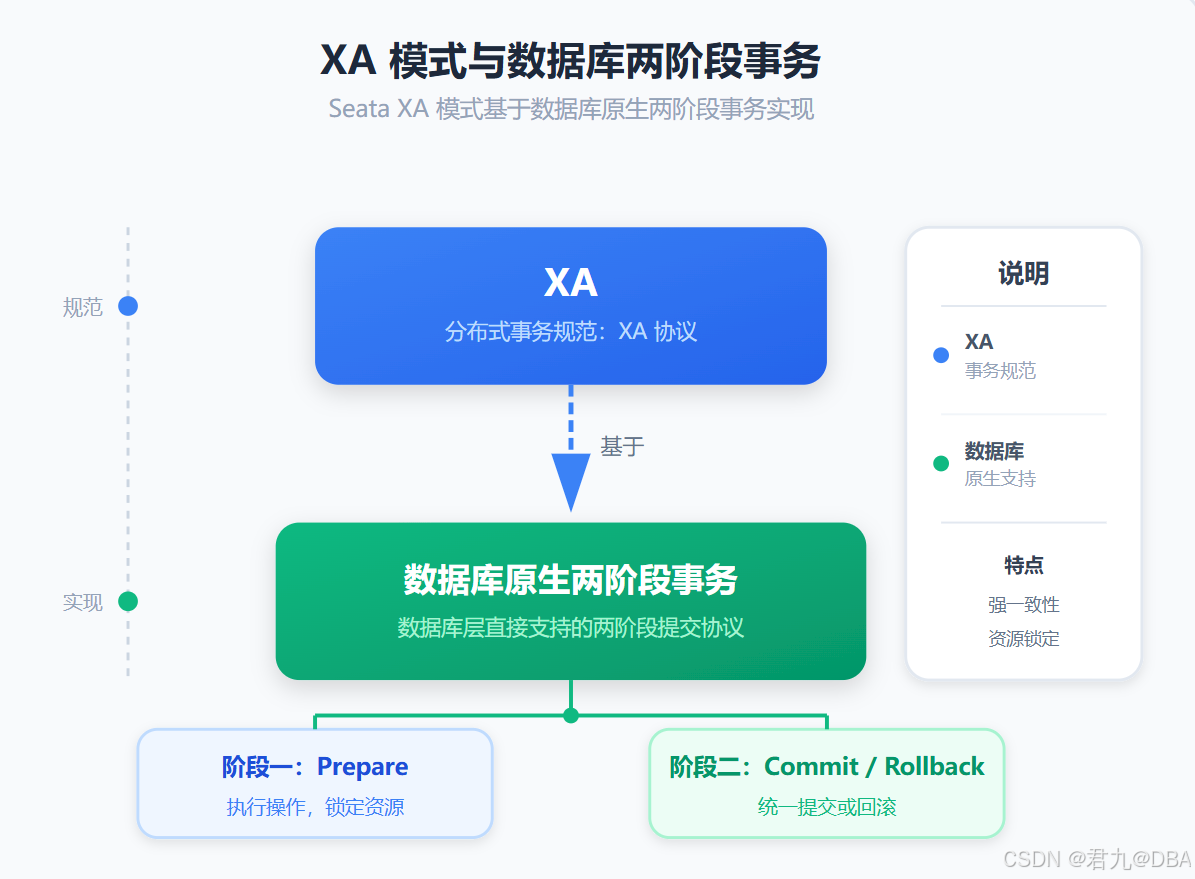
Seata XA:
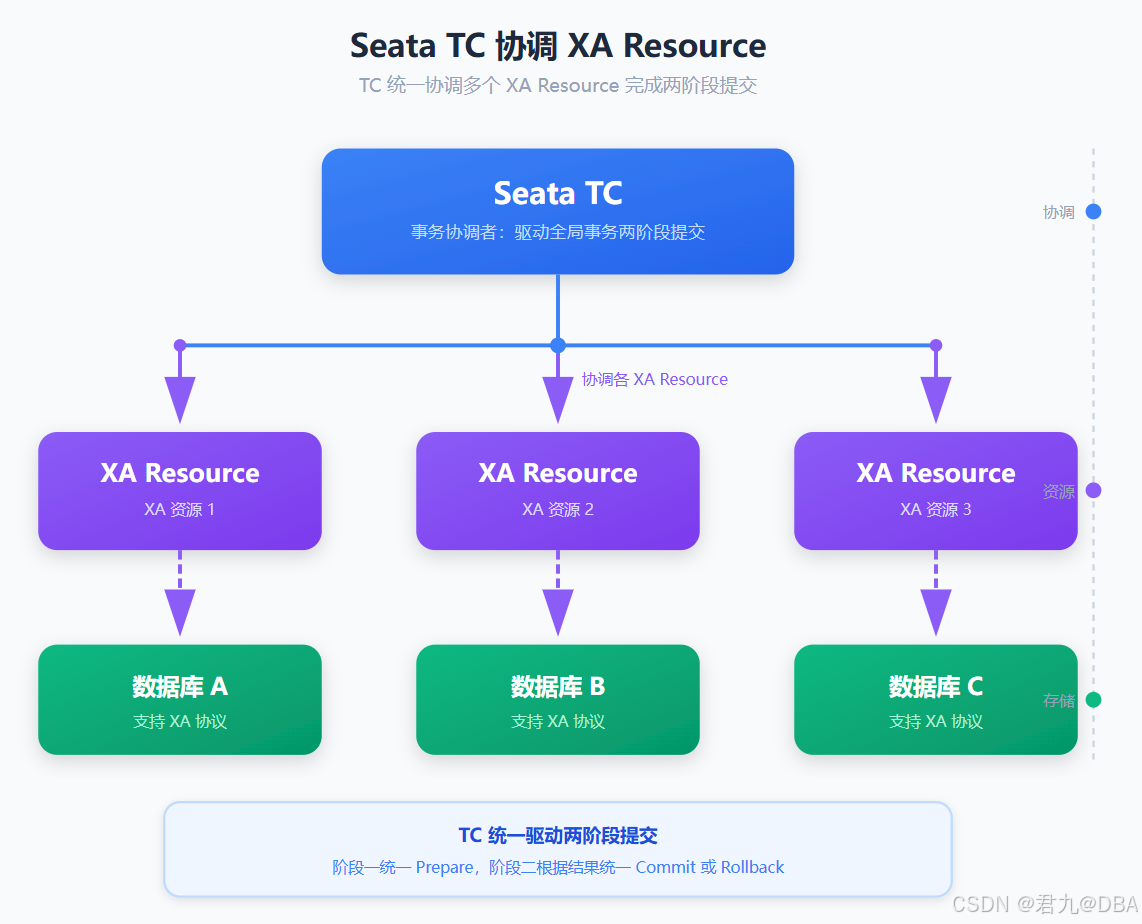
特点:
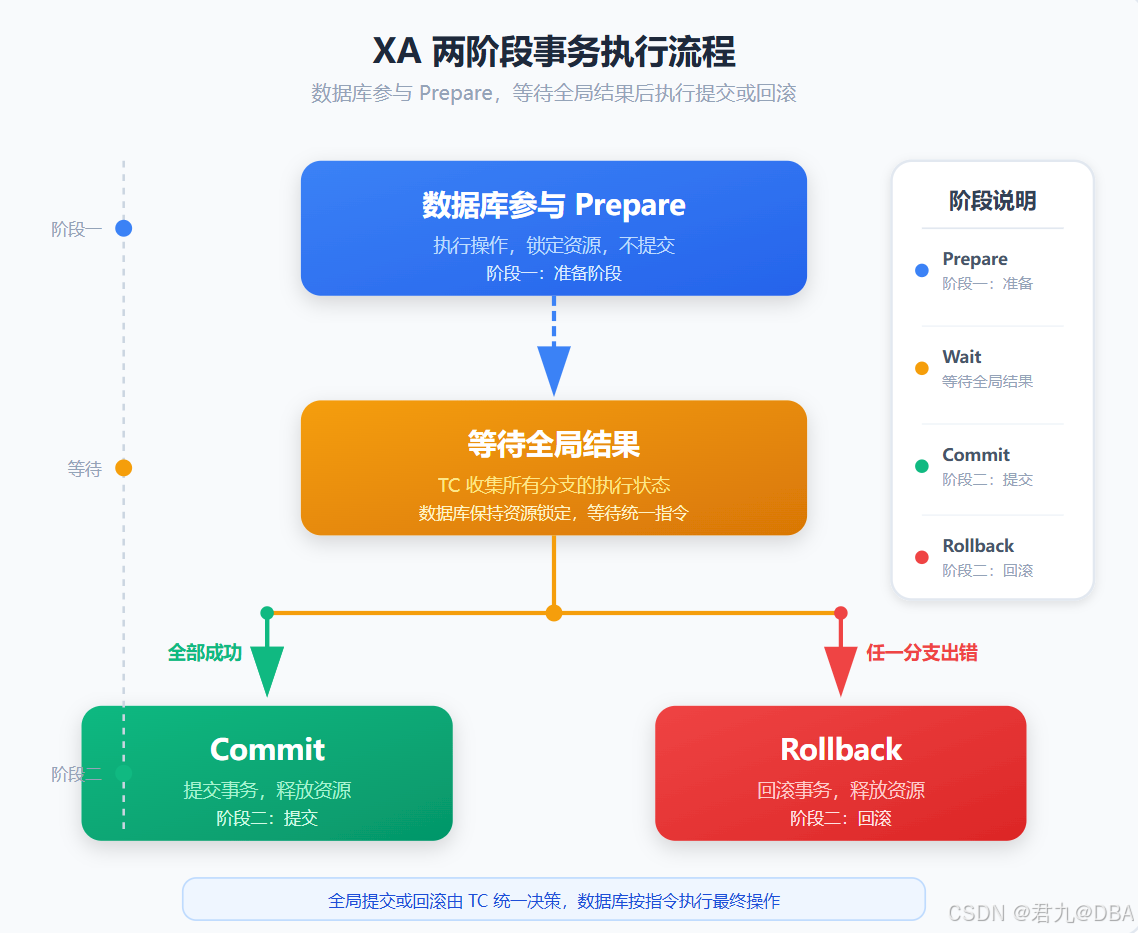
优点:
text
强一致
业务侵入低
数据库原生支持
缺点:
text
锁资源时间长
性能相对差
所以:
Seata XA 本质上还是数据库级的两阶段提交。
Seata AT 模式是什么
AT 是 Seata 很有代表性的一种模式。
AT:
text
Automatic Transaction可以把它理解成:
尽量少修改业务代码,由 Seata 自动帮助完成提交和回滚。
你可以把它想象成:
text
类似 2PC
但不是传统 XA 那种数据库长事务
这是理解 AT 的关键。
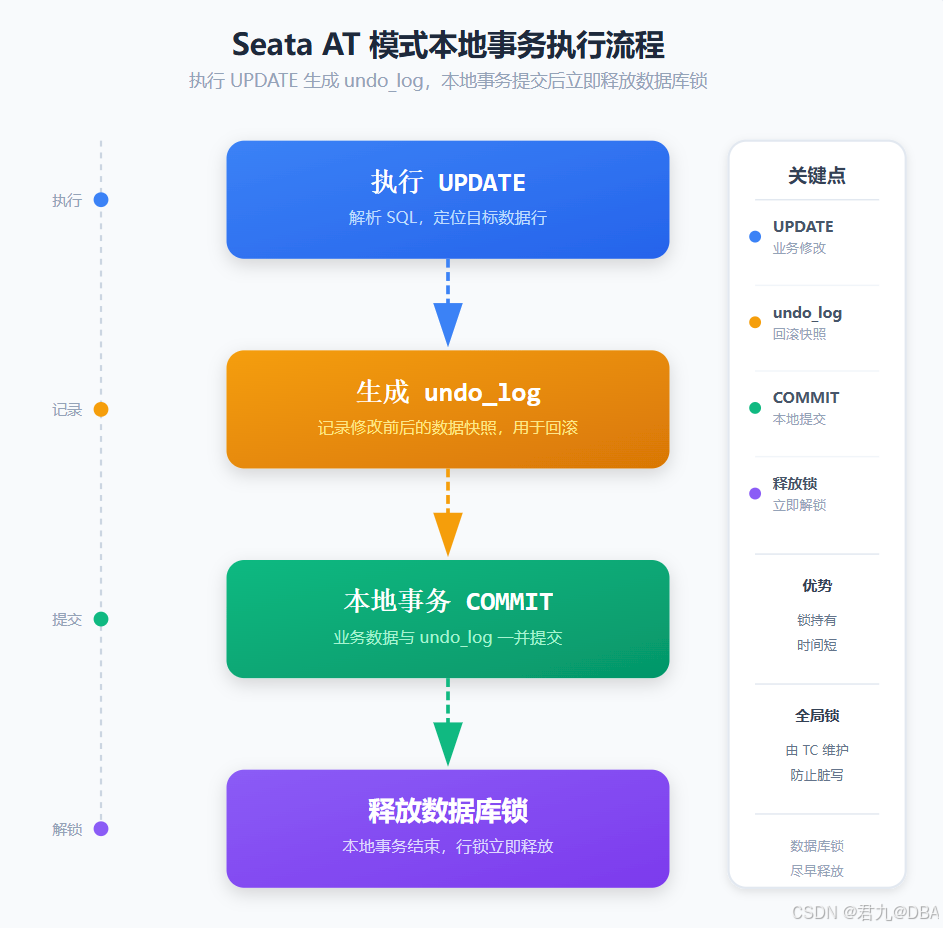
AT 第一阶段做什么
假设库存服务:
sql
UPDATE stock
SET count = count - 1
WHERE product_id = 100;
执行前:
text
count = 10执行后:
text
count = 9Seata AT 会在执行 SQL 前后记录数据快照。
也就是:
text
Before Image
After Image
例如:
text
Before Image:
count = 10

After Image:
count = 9
然后把这些信息保存到:
text
undo_logundo_log 是什么
这是 AT 模式最重要的表之一。
你可以把它理解成:
Seata 自己维护的一份业务回滚日志。
例如:
text
undo_log
---------------------------------
branch_id
xid
context
rollback_info
log_status
其中:
text
rollback_info会记录:
text
修改前是什么
修改后是什么
这样如果后面全局事务失败:
Seata 就可以知道:
text
应该把 9 恢复成 10AT 第一阶段和 XA 最大的不同
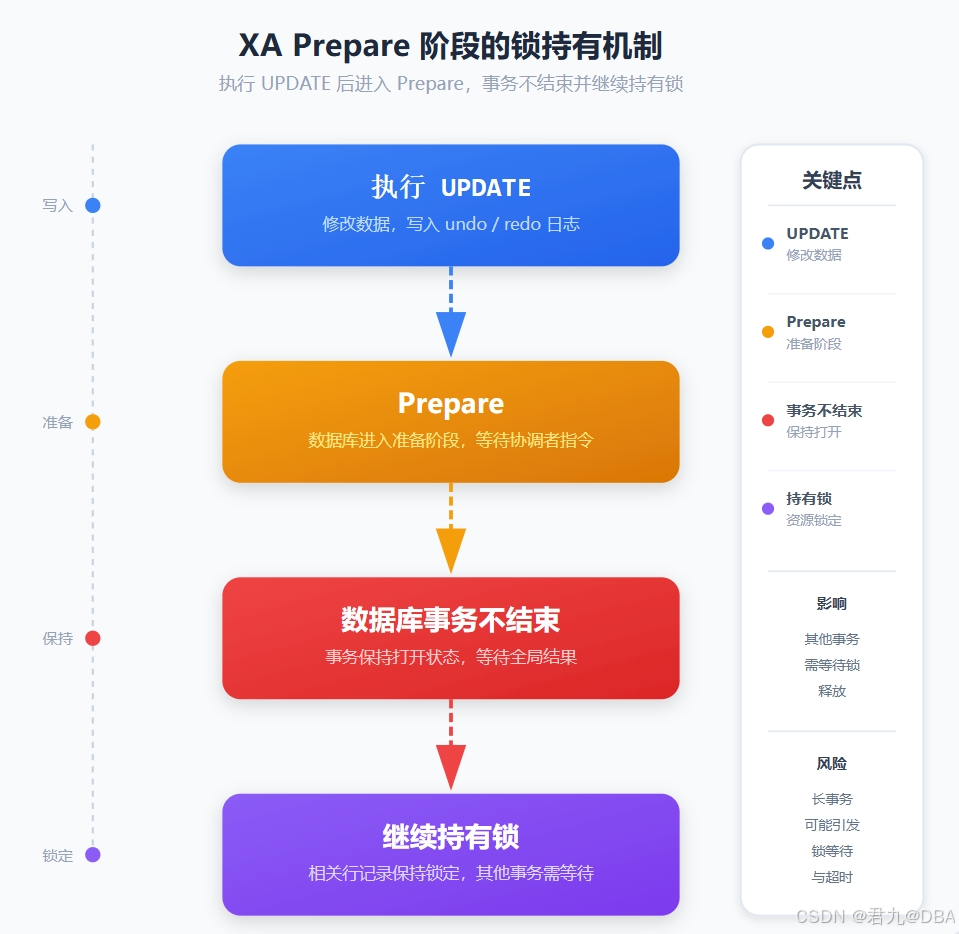
XA:
AT:
注意:
AT 第一阶段的本地数据库事务已经提交了。
所以:
text
数据库锁很快释放这也是 AT 性能通常比 XA 更灵活的重要原因。
那 AT 怎么回滚?
例如:
text
原库存 = 10AT 第一阶段执行:
text
10 → 9本地事务已经提交。
后来支付失败。
全局事务要回滚。
Seata 查看:
text
undo_log发现:
text
Before Image = 10
After Image = 9
于是执行:
text
9 → 10也就是:
通过反向 SQL 恢复数据。
这和 Saga 很像吗?
看起来确实有点像:
text
先提交
失败再恢复
但两者区别很大。
AT:
text
数据库数据级别自动回滚Saga:
text
业务语义级补偿例如:
AT 可以恢复:
text
stock 9 → 10Saga 可能执行:
text
releaseStock(orderId)后者是业务补偿方法。
所以:
AT 更偏数据库层自动补偿,Saga 更偏业务层语义补偿。
AT 为什么需要全局锁
这里开始进入 AT 的关键机制。
假设全局事务 A:
text
stock = 10执行:
text
10 → 9第一阶段提交后:
数据库本地锁已经释放。
如果这时候另一个全局事务 B 直接修改:
text
9 → 8然后 A 又要回滚:
text
9 → 10问题来了:
现在数据库已经是:
text
8A 不能随便恢复成:
text
10否则 B 的修改也被覆盖了。
所以 Seata AT 需要:
text
Global Lock全局锁。
什么是全局锁
虽然数据库本地事务已经提交:
text
DB 行锁释放但是 Seata TC 还会记录:
这条数据目前属于某个全局事务。
其他全局事务如果想修改相同数据:
text
必须竞争全局锁所以:
text
数据库锁和:
text
Seata 全局锁不是一回事。
为什么 AT 既释放 DB 锁,又还能保证隔离
可以这样理解:
text
阶段一:
短时间持有数据库行锁
↓
提交
↓
释放数据库行锁

但是:
继续持有 Seata 全局锁
这样:
text
其他 Seata 全局事务不能随意修改这条数据。
因此降低了数据库长事务带来的压力。
AT 的二阶段提交
如果整个全局事务成功:
text
TC → CommitAT 第一阶段业务数据本来就已经提交了。
所以第二阶段提交其实很轻:
text
主要清理 undo_log
释放全局锁
这就是为什么 AT:
提交通常很快。
AT 的二阶段回滚
如果:
text
account-service失败。
TC 决定:
text
Global Rollback库存 RM:
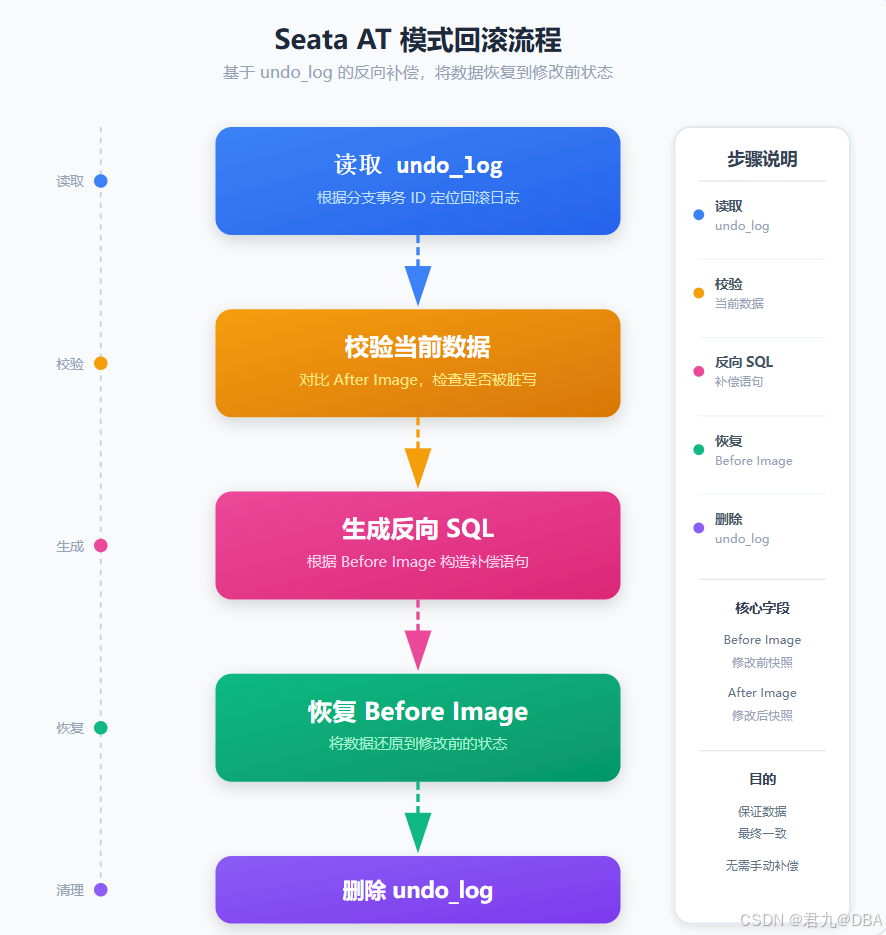
订单服务也类似。
为什么需要校验 After Image
这个细节非常重要。
假设:
text
Before = 10
After = 9
准备回滚时:
数据库当前值:
text
9说明:
text
数据还符合自己提交后的状态于是可以恢复:
text
9 → 10但如果数据库当前已经是:
text
7就说明:
text
有人在外部修改过数据这个时候 Seata 不能直接:
text
7 → 10否则可能覆盖其他合法修改。
所以 AT 需要做:
text
Data Validation数据校验。
这说明 AT 有一个重要前提
如果所有服务都:
text
经过 Seata事务控制比较容易。
但如果:
text
有些程序直接修改数据库
不走 Seata
就可能出现:
text
脏写
回滚冲突
所以 AT 对数据访问路径有一定要求。
AT 的整体流程
成功:
失败:
AT 和 XA 怎么比较
这是非常重要的一张表:
| 对比 | XA | AT |
|---|---|---|
| 第一阶段 | Prepare | 本地直接 Commit |
| 数据库事务 | 长事务 | 短事务 |
| DB 锁 | 持有到二阶段 | 一阶段结束释放 |
| 回滚方式 | DB 原生 rollback | undo_log 反向恢复 |
| 全局锁 | 依赖 DB 锁/XA | Seata 全局锁 |
| 性能 | 相对较低 | 通常更好 |
| 业务侵入 | 低 | 低 |
| 依赖 | XA 支持 | SQL 解析与 undo_log |
AT 适合什么场景
一般更适合:
text
关系型数据库
普通 CRUD
事务时间较短
希望业务改造较少
例如:
text
订单
库存
账户
这种标准数据库更新。
AT 不太适合什么场景
如果业务操作不是简单数据库更新:
text
发送邮件
第三方支付
调用外部 SaaS
发送短信
操作文件
undo_log 根本没办法:
text
把短信收回来所以:
AT 主要解决数据库资源的一致性,不是万能补偿框架。
这类业务还是需要:
text
TCC
Saga
MQ
等。
Seata TCC 是什么
Seata 也支持 TCC。
基本模式:
text
Try
Confirm
Cancel
例如:
java
boolean prepare(...);

boolean commit(...);

boolean rollback(...);
Seata 负责:
text
全局事务协调
调用 Confirm
调用 Cancel
传播 XID
记录事务状态
但是:
text
业务资源如何预留仍然需要你自己实现。
所以 Seata TCC 并不会消除:
text
幂等
空回滚
悬挂
这些问题。
Seata TCC 的价值是什么
你可以理解成:
Seata 帮你做"协调",但业务语义仍然由你设计。
例如余额:
text
Try
↓
冻结余额

Confirm
↓
扣除冻结余额

Cancel
↓
解冻余额
Seata TC 会决定:
text
所有 Try 成功
→ Confirm

任一 Try 失败
→ Cancel
Seata Saga 是什么
Seata Saga 基于:
text
状态机描述长事务流程。
例如:
text
CreateOrder
↓
ReserveStock
↓
Pay
对应补偿:
text
CancelOrder
ReleaseStock
Refund
状态机负责:
text
流程推进
异常处理
补偿
状态持久化
所以非常适合:
text
长流程
业务补偿
最终一致性
Seata 四种模式怎么选
建立这个直觉:
XA
text
需要较强一致性
事务短
数据库支持 XA
并发压力不是极高
考虑:
text
XAAT
text
主要是关系型数据库 CRUD
希望改造少
希望数据库事务短
考虑:
text
ATTCC
text
业务天然支持:
预留
确认
释放
例如:
text
余额
额度
库存
优惠券
考虑:
text
TCCSaga
text
流程长
参与服务多
允许最终一致
能设计补偿
考虑:
text
Saga实际项目可以混用
这点特别重要。
不要认为:
text
一个系统只能选一种模式完全不是。
例如电商:
text
核心订单 + 库存
↓
Seata AT

支付账户冻结
↓
TCC

订单履约流程
↓
Saga

积分 / 短信 / 通知
↓
MQ + Outbox
这其实比:
text
整个系统全部 AT更合理。
为什么支付通常不要简单用 AT
假设:
text
account balance = 1000AT 可以:
text
1000 → 900失败再:
text
900 → 1000技术上可能能做。
但支付领域通常会需要:
text
冻结金额
支付流水
退款流水
账务审计
对账
这时候:
text
TCC / 账务模型通常更符合业务语义。
所以:
技术上能回滚,不代表业务上应该这么设计。
@GlobalTransactional 是什么
在 Spring Boot 项目里,你可能看到:
java
@GlobalTransactional
public void createOrder() {
    orderService.create();
    stockService.deduct();
    accountService.deduct();
}
它表示:
text
这个方法是全局事务入口大致流程:
@Transactional 和 @GlobalTransactional 的区别
Spring:
java
@Transactional主要管理:
text
当前数据源
当前数据库连接
属于:
本地事务。
Seata:
java
@GlobalTransactional管理:
text
多个服务
多个分支事务
属于:
全局事务。
但是通常每一个 RM 内部:
text
仍然依赖本地事务所以两者不是:
text
二选一而是不同层级。
一个典型 Spring Cloud 场景
例如:
java
@GlobalTransactional
public void placeOrder(OrderRequest request) {

    orderService.create(request);

    stockClient.deduct(
        request.getProductId(),
        request.getCount()
    );

    accountClient.deduct(
        request.getUserId(),
        request.getAmount()
    );
}
流程:
text
order-service
     │
     │ XID
     ↓
stock-service
     │
     │ XID
     ↓
account-service
只要:
text
XID传播正常,三个 RM 就能加入同一个全局事务。
如果 account-service 抛异常
例如:
text
余额不足执行状态:
text
订单:成功
库存:成功
账户:失败
TM 捕获异常:
text
↓
通知 TC
↓
Global Rollback
如果使用 AT:
text
订单根据 undo_log 恢复
库存根据 undo_log 恢复
最终:
text
订单撤销
库存恢复
账户没扣
Seata 不是魔法
这一点一定要记住。
使用:
java
@GlobalTransactional并不代表:
text
所有分布式问题全部消失你仍然要考虑:
text
超时
重试
幂等
服务宕机
锁冲突
热点数据
事务边界
慢 SQL
消息一致性
外部系统
特别是:
全局事务范围越大,出问题的概率和性能成本通常越高。
所以不要把:
text
发短信
发邮件
积分
推荐
统计
全部放进一个:
text
@GlobalTransactional里面。
全局事务应该尽可能短
例如:
java
@GlobalTransactional
public void createOrder() {

    createOrder();

    deductStock();

    Thread.sleep(30000);

    callThirdParty();

    sendEmail();

    uploadFile();

    deductAccount();
}
这种设计非常危险。
因为全局事务:
text
30 秒甚至更久会导致:
text
全局锁占用
事务冲突
资源占用
故障恢复困难
所以应该:
核心必须一致的数据库操作放进去,其余异步解耦。
Seata AT 最容易被问的面试题
问:Seata AT 模式怎么实现回滚?
可以回答:
AT 模式在一阶段执行业务 SQL 时,通过数据源代理记录修改前后的数据镜像,并将回滚信息保存到 undo_log。一阶段本地事务直接提交并释放数据库锁。如果全局事务失败,二阶段根据 undo_log 生成反向操作,将数据恢复到修改前状态。
问:AT 和 XA 最大区别是什么?
答:
XA 在一阶段 Prepare 后数据库事务仍未结束,需要持有数据库事务资源直到二阶段;AT 在一阶段记录 undo_log 后就提交本地事务并释放数据库锁,二阶段失败时通过 undo_log 进行数据恢复,因此 AT 的数据库事务更短,但需要 Seata 自己维护全局锁和回滚日志。
问:undo_log 有什么作用?
答:
undo_log 保存 AT 分支事务执行前后的数据快照及回滚信息,用于全局事务失败时执行反向恢复,同时也用于判断数据是否被其他事务修改,避免错误覆盖。
问:TC、TM、RM 分别是什么?
可以直接这么说:
TM 负责开启、提交和回滚全局事务;RM 负责管理具体事务资源并注册分支事务;TC 负责维护全局事务状态并协调所有分支事务最终提交或回滚。
这句话非常值得记住。
把现在所有知识串起来
到这里,我们已经形成:
text
第 1 课
分布式事务为什么存在
        ↓
第 2 课
ACID / CAP / BASE
        ↓
第 3 课
XA / 2PC
        ↓
第 4 课
TCC
        ↓
第 5 课
Saga
        ↓
第 6 课
MQ / Outbox
        ↓
第 7 课
幂等 / 重试 / 状态机
        ↓
第 8 课
Seata
而 Seata 把前面的理论映射成:
text
XA
→ 数据库原生两阶段事务

AT
→ undo_log + 全局锁 + 自动补偿

TCC
→ Try / Confirm / Cancel

Saga
→ 状态机 + 业务补偿
本篇须记住的 10 个结论
- Seata 是分布式事务框架,不是一种新的事务理论。
TC= 事务协调器,TM= 全局事务管理者,RM= 资源管理者。XID是全局事务唯一标识,并且要在服务调用链中传播。- 一个全局事务由多个分支事务组成。
- Seata XA 本质仍然是数据库原生两阶段事务。
- Seata AT 一阶段会记录 undo_log,然后提交本地事务。
- AT 二阶段失败时,通过
undo_log自动恢复数据。 - AT 使用全局锁解决多个全局事务之间的数据冲突。
- TCC、Saga 在 Seata 中仍然分别对应业务资源预留 和业务补偿。
- 实际项目中可以同时使用 AT + TCC + Saga + MQ,而不是全系统只选一种方案。
下一篇非常适合做一件更重要的事情:
《分布式事务方案选型》
我会直接给你一个完整电商案例:
text
下单
↓
扣库存
↓
用优惠券
↓
支付
↓
增加积分
↓
发短信
↓
同步搜索 / 推荐
然后逐个分析:
text
哪个应该用 AT?
哪个应该用 TCC?
哪个应该 Saga?
哪个应该 MQ?
哪些根本不应该加入分布式事务?上一篇:《幂等、重试、去重与状态机》
下一篇:《分布式事务方案选型》
若有转载,请标明出处: