Spring AI 2.0.1 本身已经把 RAG 拆成 Query Transformation、Query Expansion、Retrieval、Post-Retrieval 和 Generation 等模块,并提供
VectorStoreDocumentRetriever、RewriteQueryTransformer、MultiQueryExpander、DocumentPostProcessor等接口,因此可以直接用这套结构建立完整心智模型。(Home)
RAG 的核心目标可以概括成一句话:在模型回答之前,把当前问题真正需要的证据找出来,并以尽量少的噪声送入 Context。
因此,一个真正的 RAG 系统远比"连接一个向量数据库"复杂。完整过程通常经历:
bash
原始资料
   ↓
解析 / 清洗
   ↓
Chunking
   ↓
Embedding
   ↓
建立索引
================
用户问题
   ↓
Query Rewrite / Multi-Query
   ↓
Metadata Filter
   ↓
Vector Search + Keyword Search
   ↓
Hybrid Search
   ↓
Top-K 候选
   ↓
Rerank / 去重 / 压缩
   ↓
最终证据
   ↓
Context
   ↓
LLM
   ↓
回答 + 引用
理解这张图以后,绝大多数 RAG 术语都可以确定自己处在哪个位置。
一、Chunking:先决定"拿什么东西去检索"
Chunking 就是把原始长文档切成较小的文本块。Spring AI 的 ETL Pipeline 中,DocumentReader 负责读取资料,DocumentTransformer 负责转换,其中 TokenTextSplitter 就是常用的切块工具。Spring AI 2.0.1 默认按照 token 数量切分 ,并支持自定义中文句号、问号等边界。(Home)
为什么不能直接把一本 100 页 PDF 当成一个 Document?因为用户问:
"项目申请需要哪些材料?"
真正有用的可能只有其中一段。如果整个 PDF 作为一个向量,Embedding 会把大量主题压进一个向量中,检索精度很差。
于是可以:
java
// 创建 TokenTextSplitter,按 token 数量切分文本
TokenTextSplitter splitter = TokenTextSplitter.builder()
        .withChunkSize(800)          // 每个 Chunk 的最大 token 数
        .withMinChunkSizeChars(350)  // 最小字符数,避免切出过短的碎片
        .withPunctuationMarks(       // 指定中文标点作为切分边界
                List.of('。', '?', '!', '\n')
        )
        .build();
// 对原始文档执行切块,得到多个 Document
List<Document> chunks =
splitter.apply(documents);
这里没有一个适合所有项目的最佳 chunkSize。真正要理解的是两个方向。
bash
Chunk 太大
→ 一个块里包含多个主题
→ 检索到了相关内容,同时带进大量噪声
Chunk 太小
→ 单独一句话缺乏前后文
→ 检索虽然命中,但模型无法正确理解
例如原文是:
bash
申请对象为注册满两年的科技企业。
申请截止日期为9月30日。
企业还需提交上一年度审计报告。
如果切成三个完全独立的小块,用户问"谁需要提交审计报告"时,第三句话本身可能已经失去了"科技企业"的主体。
因此实际项目还经常出现 Overlap、Structure-aware Chunking、Semantic Chunking、Parent-Child Retrieval 等术语。
Overlap指相邻 Chunk 保留少量重复上下文;Structure-aware Chunking 指按照标题、段落、表格、代码方法等自然结构切分;Semantic Chunking 则尽量在语义主题变化的位置切开;Parent-Child Retrieval 是检索较小的 Child Chunk,提高命中精度,最终把它所属的较大 Parent 内容交给模型,从而同时兼顾"找得准"和"上下文完整"。
面试时如果被问 Chunking,可以回答:切块首先影响检索单元的粒度。过大会增加噪声,过小会破坏语义,因此通常根据文档结构、模型 Context 和真实查询进行实验,而不是机械固定一个长度。
二、Embedding:把"语义相似"变成可以计算的距离
Embedding 是把文本转换成一个高维数字向量。例如:
bash
"如何办理退款"
        ↓
Embedding Model
        ↓
[0.18, -0.42, 0.73, ...]
"退款申请步骤"虽然没有完全相同的关键词,但生成的向量通常会在语义空间中比较接近。向量数据库随后通过 cosine similarity、dot product(点积) 等方式寻找相似向量。Spring AI 的 VectorStore 对不同向量数据库提供统一接口。(Home)
因此,当出现:
bash
用户问:
"离职以后还能报销吗?"
知识库写:
"劳动关系终止后不再享受费用报销资格"
纯关键词搜索可能匹配得很差,Embedding 检索则有机会通过语义关系找到它。
【重点】****Embedding 出问题时通常表现为"明明知识库里有,语义检索却总找不到" 。这时需要检查 Embedding 模型是否适合当前语言和领域、文档与查询是否使用同一套兼容模型、Chunk 是否包含足够语义,以及专业缩写、编号等信息是否更适合关键词检索 。当前有研究证明,Embedding对代码标识符的语义理解几乎失效。****【尤其是在代码搜索的关键词里,95%都是标识符。所以如果大篇幅都是代码,Embedding语义检索可能不及grep精确查询效果好】
PS:可观测性首先发现"绿色问题"------知识库明明有内容,但检索结果里长期找不到。如果记录得足够细,它还能继续往下定位"红色原因" :查看 Query 和 Chunk 的 Embedding、相似度分数、Top-K 排名、切块结果、模型版本等,从而判断更可能是模型不适配、Chunk 语义不足,还是查询表达问题。所以它的定位精度取决于"观测了多少中间过程" 。基础可观测性只能告诉你"检索失败了";完善的 Trace + Metrics + Eval 可以把问题缩小到 Embedding、Chunk、Query 等具体环节,但通常不会自动告诉你"就是某一个参数错了"。
Embedding 后通常还会听到一个词:ANN,Approximate Nearest Neighbor,近似最近邻搜索 。它解决的是向量规模非常大以后,如何快速找到最相似向量。HNSW【图索引、跳表算法,从顶层开始,沿着长距离边快速靠近目标区域】、IVF【先K-Means聚类,找到最近的簇,只在该簇内搜索,避免全量比对】 等属于底层索引算法。应用开发初期知道它们属于"向量检索性能层"即可,没有必要把它们与 RAG 业务逻辑混在一起。
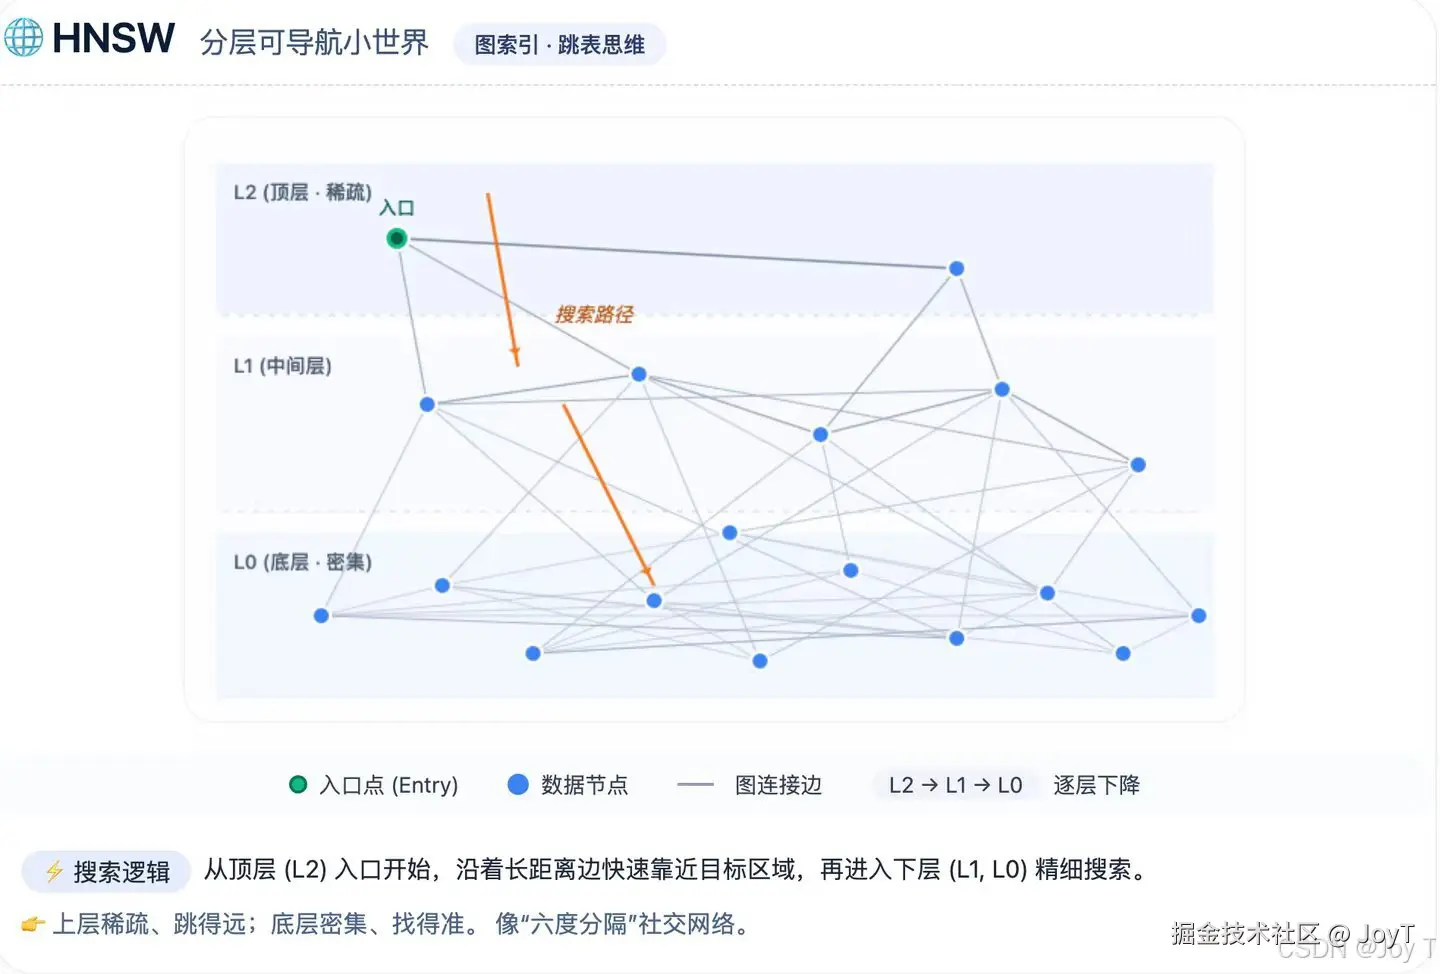
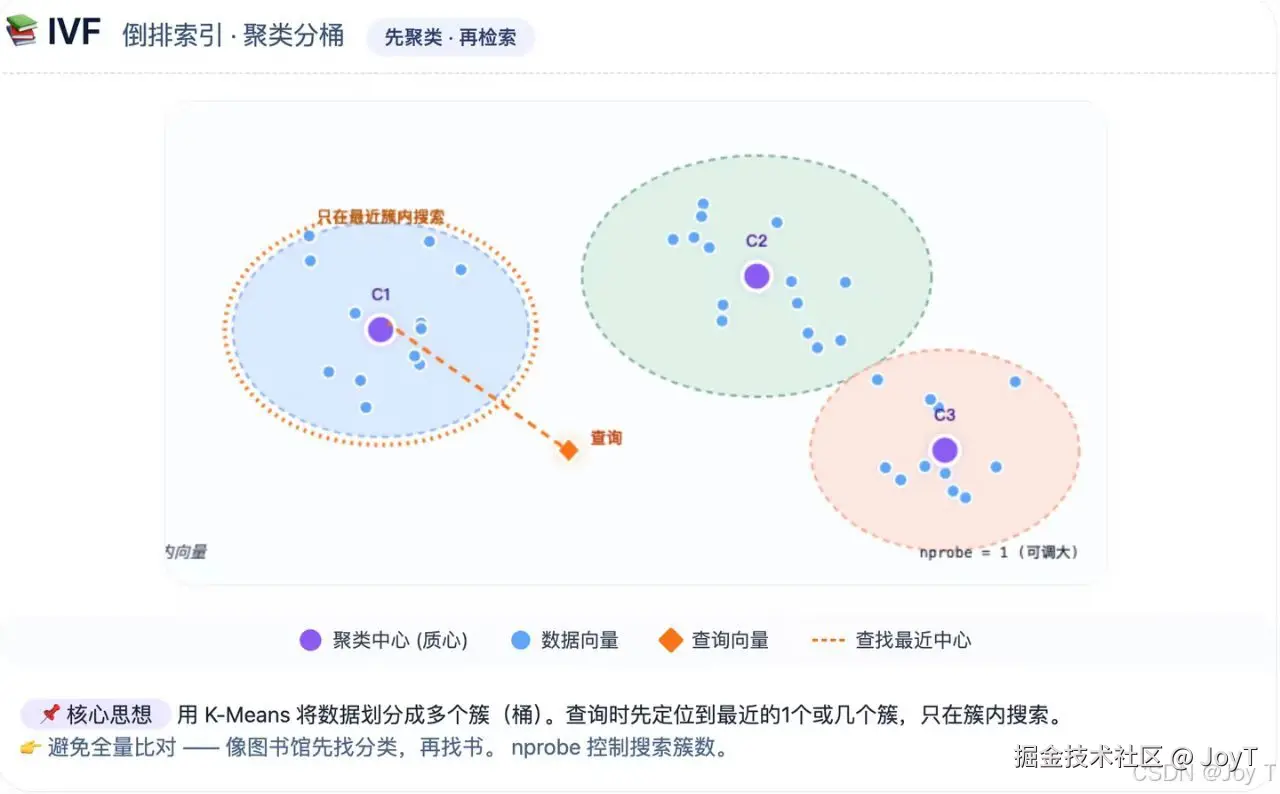
图片来自于小红书博主:近似最近邻搜索(ANN)算法:HNSW 和 IVF ✅ HNSW 分... xhslink.cn/o/9rsMHWtQI... 存下链接,去【小红书】阅读全文~
三、Top-K 与 Similarity Threshold:取多少结果
向量检索通常不会只返回一个结果,而是返回最相近的前 K 个:
java
// 构建向量检索器,配置 Top-K 和相似度阈值
VectorStoreDocumentRetriever retriever =
        VectorStoreDocumentRetriever.builder()
                .vectorStore(vectorStore)          // 指定向量存储
                .topK(5)                           // 最多返回 5 个候选 Chunk
                .similarityThreshold(0.70)         // 过滤相似度低于 0.70 的结果
                .build();
Spring AI 的 VectorStoreDocumentRetriever 原生支持 topK、相似度阈值以及 Metadata Filter。(Home)
Top-K = 5 表示最多返回五个候选 Chunk;similarityThreshold 则用于过滤相似度过低的内容。
这里同样存在取舍:
bash
Top-K 太小
→ 正确证据可能排在第6名
→ 漏召回
Top-K 太大
→ 无关材料大量进入 Context
→ 成本增加,模型受到干扰因此常见工程策略是:检索阶段适当扩大召回,再通过 Rerank 缩小最终进入 Context 的数量【广撒网,收大鱼】。
例如:
bash
第一阶段召回 Top 20
        ↓
Rerank
        ↓
最终保留 Top 5
这也是 Recall(召回率)和 Precision(精确率)之间的典型平衡。
四、Metadata Filter:先限定"在哪些资料里找"
这是企业 RAG 中非常重要、同时经常被初学者忽略的一层。【辅助检索:在检索阶段给request加入结构化Metadata约束(即限定场景),便于和文档的Metadata进行快速、准确匹配。】
假设知识库里同时有:
bash
2024年退款政策
2025年退款政策
2026年退款政策
广东政策
海南政策
北京政策
普通用户制度
VIP制度
内部员工制度
用户问:
"2026年海南地区企业用户申请条件是什么?"
单纯做向量相似度搜索,很可能检索到语义非常相似的 2025 年文件。
Metadata Filter 会在检索时加入明确的结构化约束:
bash
year == 2026
AND region == "海南"
AND userType == "enterprise"
Spring AI 提供可移植的 SQL-like Metadata Filter【过滤器表达式,过滤出新的空间】:
java
// 构建检索请求,加入 Metadata 过滤条件
SearchRequest request = SearchRequest.builder()
        .query(question)                          // 用户查询
        .topK(10)                                 // 召回 10 个候选
        .filterExpression("""                     // SQL-like 过滤表达式
            region == '海南'
            && year == 2026
            && documentType == 'policy'
        """)
        .build();
这些表达式可以由支持过滤能力的 VectorStore 转换为底层数据库自己的查询格式。(Home)
因此,在入库阶段就应该认真设计文档的 Metadata:
java
// 创建 Document,并附带结构化 Metadata 元数据
Document document = new Document(
        text,                                     // 文档正文内容
        Map.of(                                   // 元数据键值对
            "source", "海南省政府网站",            // 来源
            "region", "海南",                      // 地区
            "year", 2026,                         // 年份
            "documentType", "policy",             // 文档类型
            "authorityLevel", "government",       // 权威等级
            "publishDate", "2026-05-12"           // 发布日期
        )
);
这也是为什么高质量 RAG 的 Document 不能只有正文。
Metadata 可以承担:
bash
来源
发布日期
地区
部门
文档类型
权限范围
项目 ID
租户 ID
版本
权威等级
因此面试时可以把 Metadata Filter 概括为:向量检索回答"语义上像不像",Metadata Filter 回答"这个文档有没有资格参与这次检索"。
五、Hybrid Search:为什么只做向量检索还不够
Hybrid Search,即混合检索,是实际 RAG 中非常重要的一项技术。
向量检索擅长理解:
bash
"怎么办理费用报销"
≈
"费用 reimbursement 的申请流程"
但如果用户查询:
bash
琼府〔2026〕18号
MGC-2026-001
Spring AI 2.0.1
GB/T 7714-2015
这些编号、专有名词、产品型号和缩写通常更需要精确关键词匹配。
传统全文检索常使用 BM25,它非常擅长:
bash
关键词
编号
人名
机构名
专业术语
因此 Hybrid Search 会同时执行:
bash
用户 Query
   ↓
┌──────────────┐
│              │
Vector Search  BM25 Search
语义检索        关键词检索
│              │
└──────┬───────┘
       ↓
结果融合
       ↓
候选文档
例如用户问:
"琼府〔2026〕18号里关于红树林项目申报的要求是什么?"
Vector Search 负责找到"红树林项目申报要求"这一语义主题,BM25 则可以精确抓住"琼府〔2026〕18号"。
两路结果还需要进行融合 ,常见方法包括 Weighted Score 和 RRF(Reciprocal Rank Fusion,倒数排名融合)。RRF 不强依赖两套检索分数处于相同量纲,而是根据各自排名进行融合,因此在混合检索中非常常见。
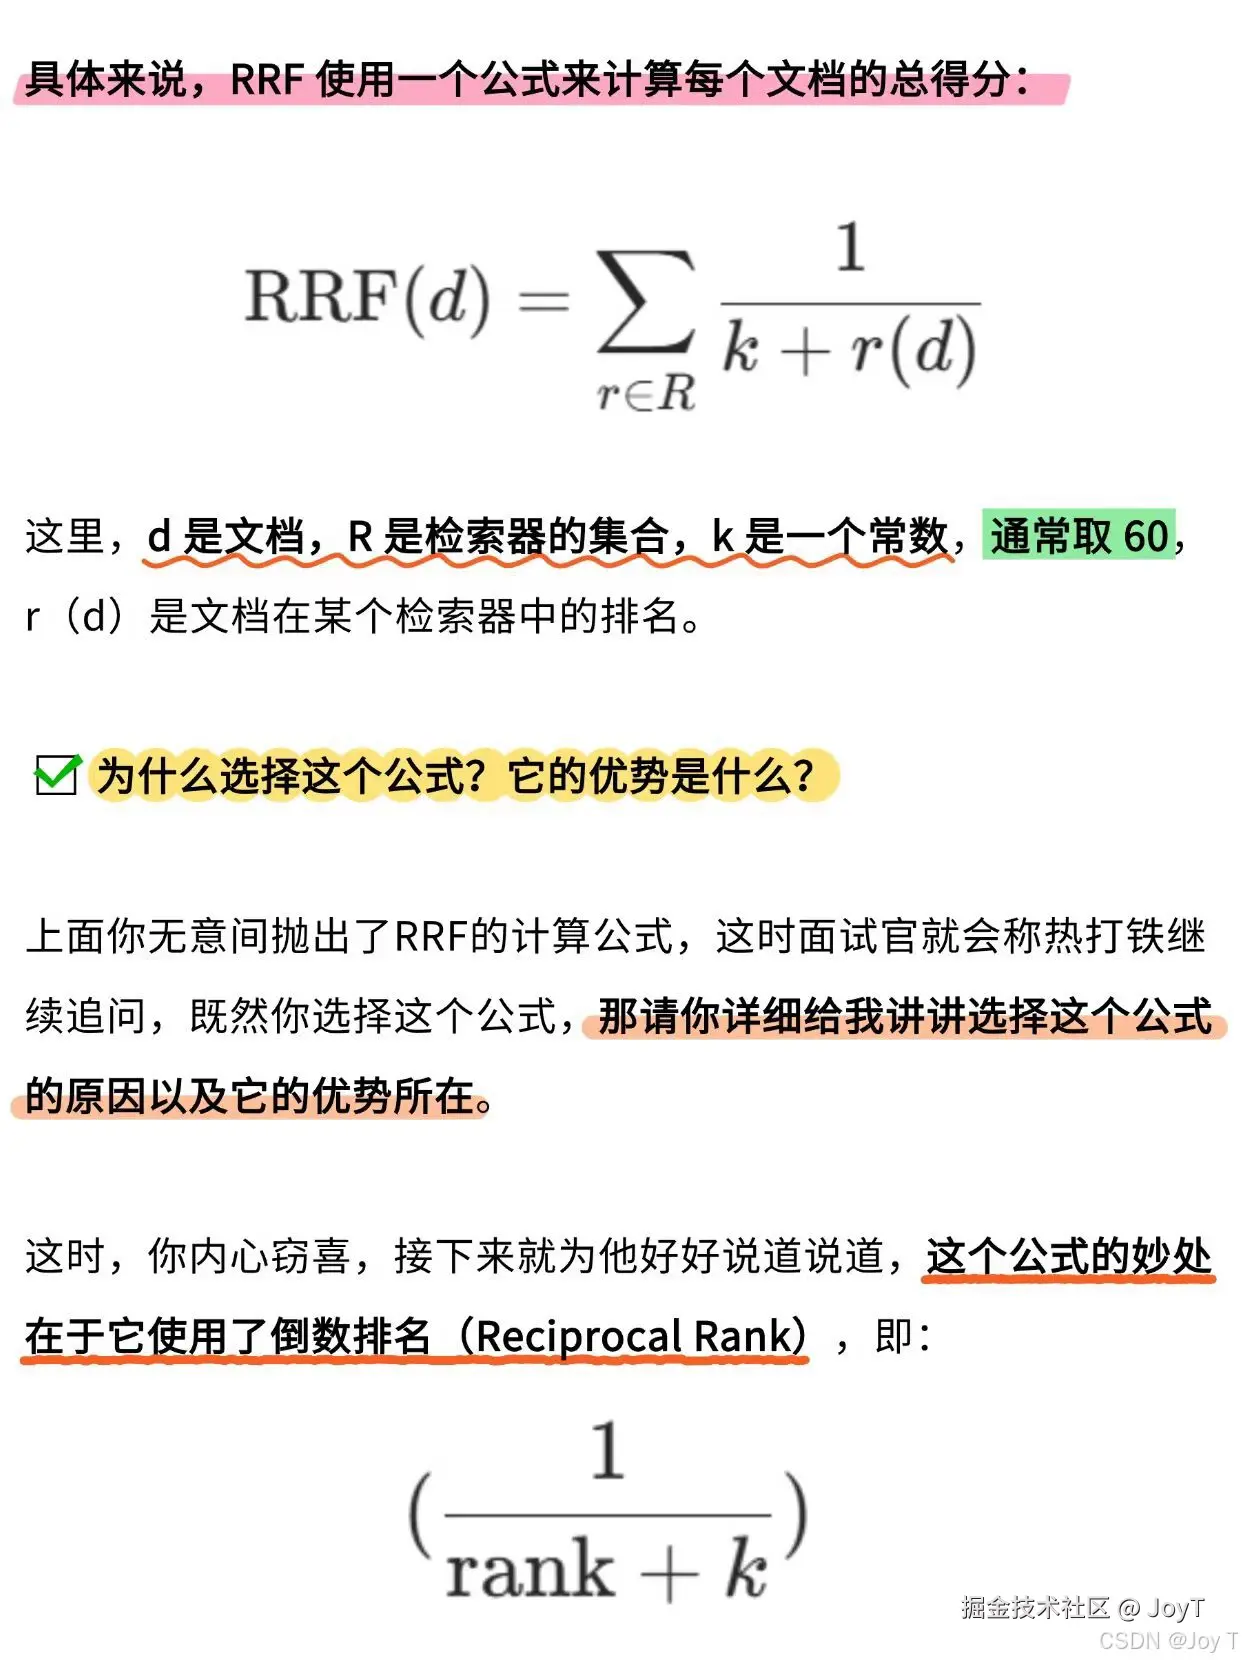
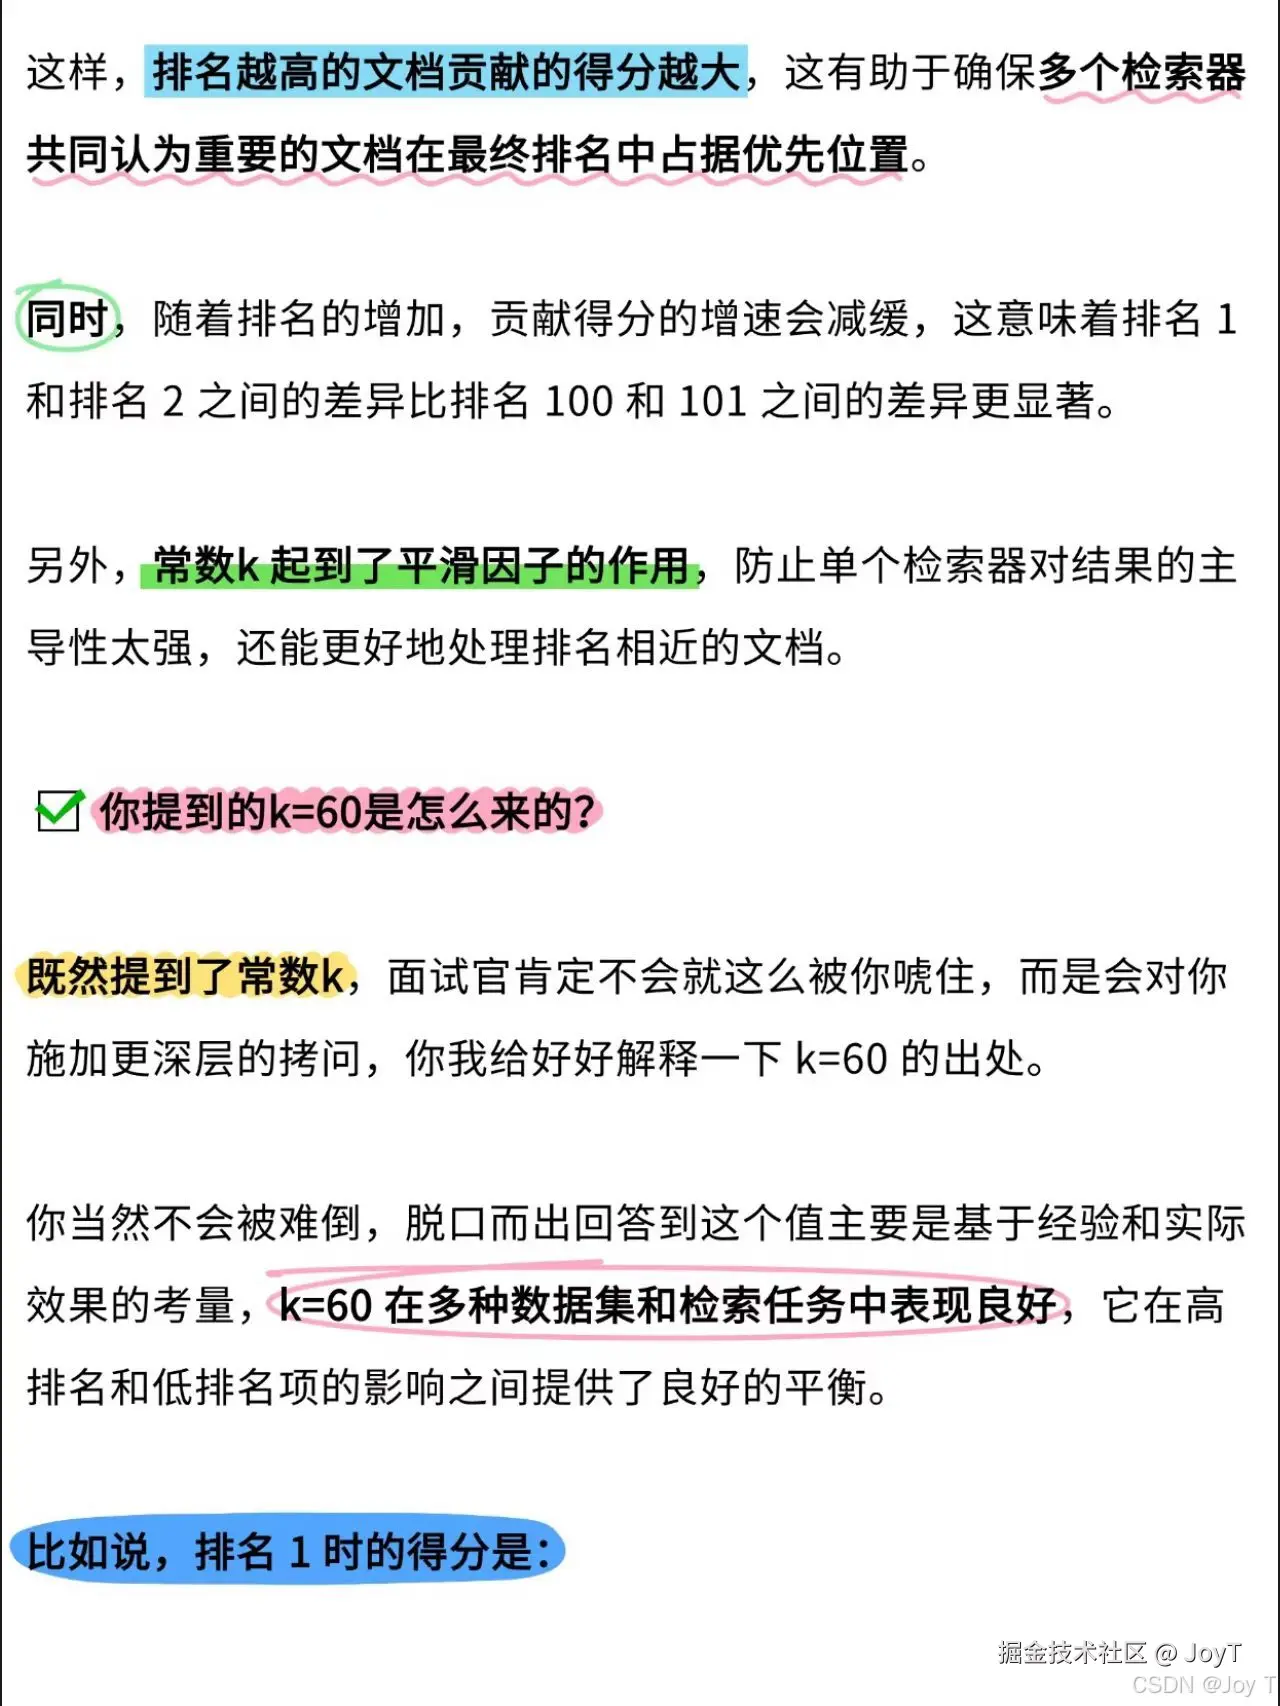
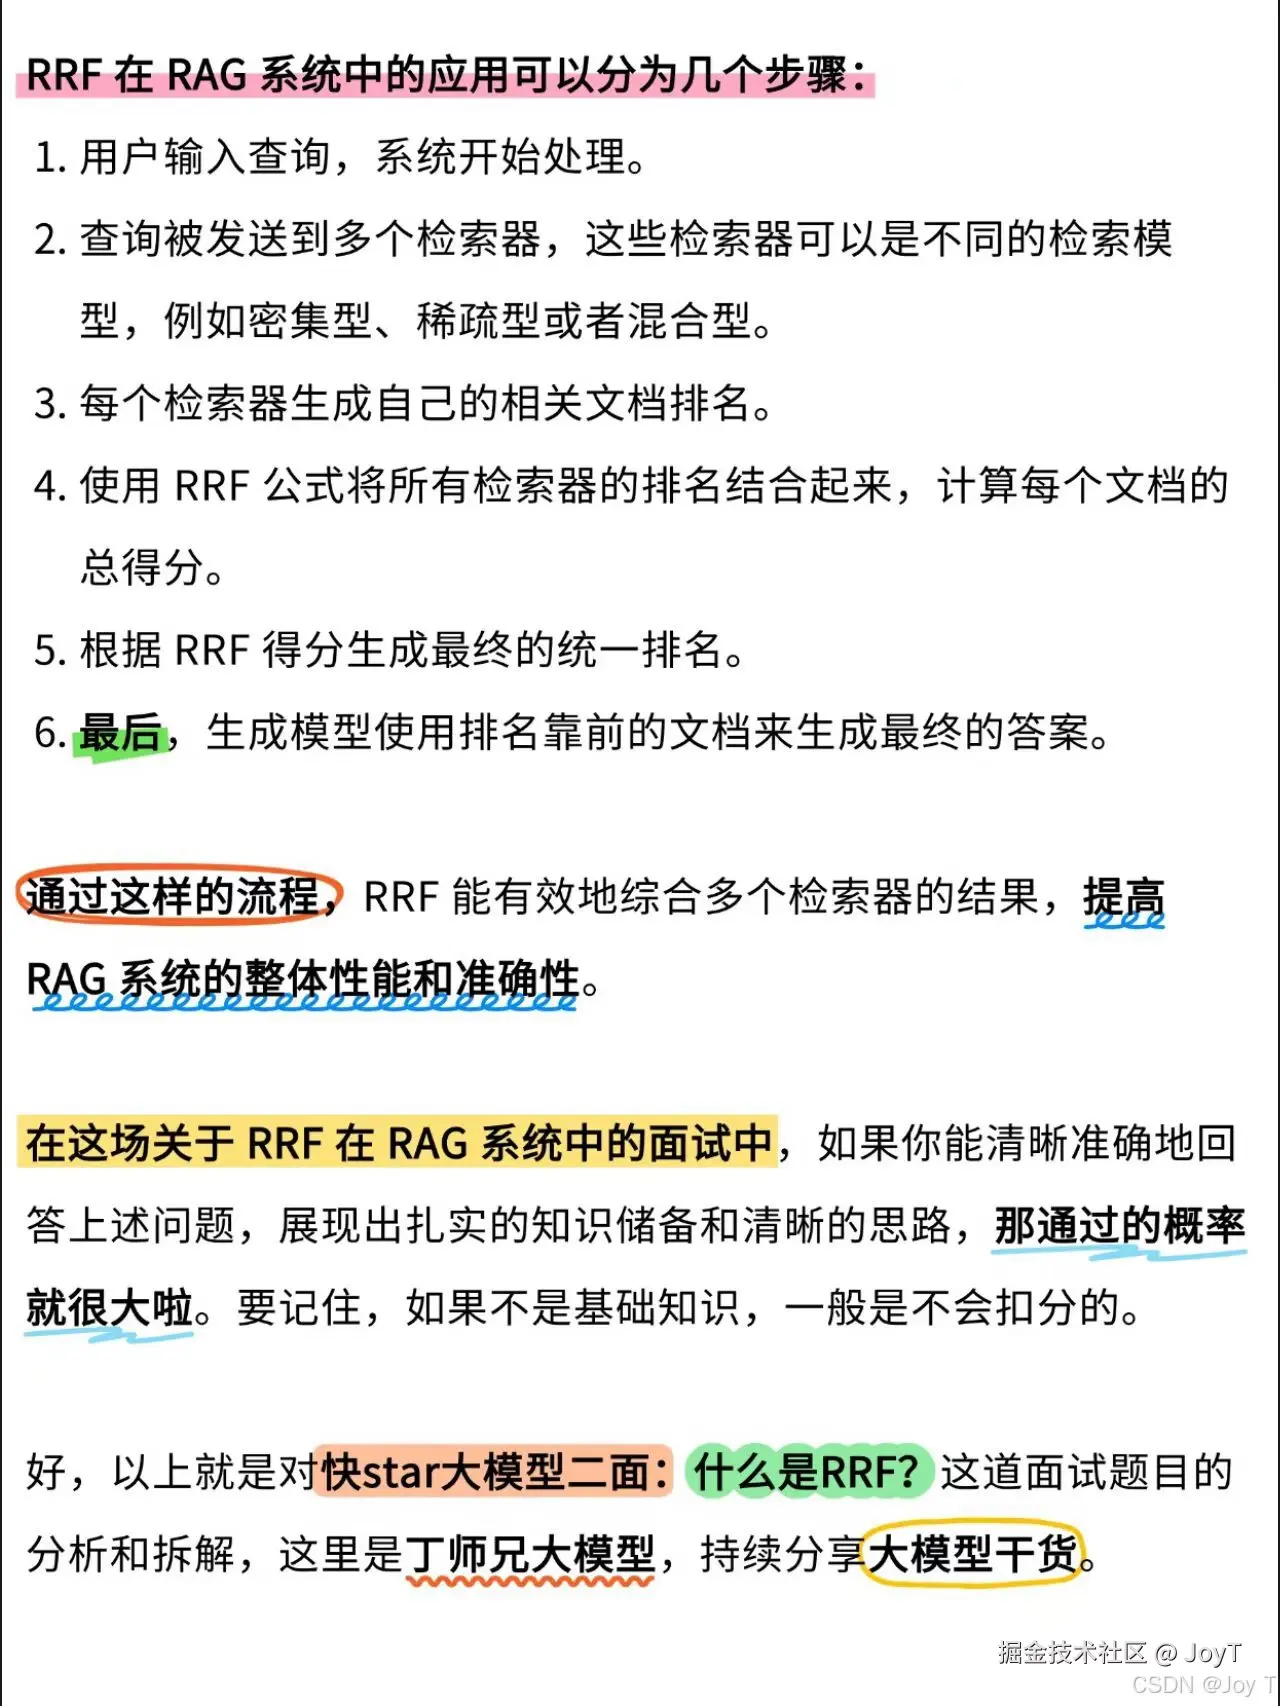
图片来自小红书博主:快star大模型二面:什么是RRF? ... xhslink.cn/o/3awxgPTiD... 存下口令,跳转【小红书】阅读~
Spring AI 的统一 VectorStore API 主要抽象向量相似度检索;真正的 Hybrid Search 能力往往与底层搜索引擎相关,例如 Spring AI 官方文档明确指出 OpenSearch 同时支持 lexical、vector 和 hybrid search。(Home)
面试时可以这样回答:
向量检索解决语义匹配,BM25 解决关键词和精确实体匹配。业务资料中经常同时存在自然语言描述与政策编号、产品型号、专有名词,因此生产 RAG 常采用 Hybrid Search,再对两路结果进行融合。
六、Query Rewrite 与 Multi-Query:用户的问题本身可能就不好搜
RAG 检索失败还有一种常见原因:问题本身写得不好。
例如多轮对话:
bash
用户:海南企业补贴最高多少?
AI:......
用户:那深圳呢?
第二个 Query 如果直接拿:
bash
"那深圳呢?"去向量库搜索,语义严重不足。
Query Rewrite 会把它改写成:
bash
"深圳企业补贴最高金额是多少?"Spring AI 已经提供 RewriteQueryTransformer,专门用于把冗长、模糊或者带有无关信息的 Query 重写成更适合检索的查询 。(Home)
还有一种方法叫 Multi-Query。例如:
bash
原问题:
企业申请蓝碳项目需要什么条件?
扩展:
蓝碳项目企业申报资格
企业申请蓝碳项目准入条件
蓝碳项目申请主体要求然后分别检索,再合并结果。这样可以增加召回率,降低用户某一种表达方式恰好与文档表达差异过大的影响 。Spring AI 提供 MultiQueryExpander,可以用 LLM 生成多个语义不同的查询版本。(Home)
继续深入还会看到 Query Decomposition 和 HyDE 。前者把复杂问题拆成多个子问题(问题解压);HyDE 会先让模型生成一个假想答案,再使用假想答案去进行语义检索。初级项目不需要一开始全部使用,它们主要解决"原始 Query 难以直接召回正确证据"的问题。
七、Rerank:召回以后重新认真排一次
检索阶段通常追求"别漏掉正确答案",因此可能先召回:
bash
20 个 Chunk但最终给模型 20 个 Chunk 很可能噪声太大。
Rerank 的作用就是:
bash
20个候选
   ↓
更加精细地比较
Query 与每个 Document 的相关性
   ↓
重新排序
   ↓
只留下最好的5个
第一阶段的向量搜索需要在几十万甚至几百万文档中快速搜索,因此强调速度。Reranker 只需要处理已经召回的几十个候选,可以使用计算量更大的 Cross-Encoder 或专门的 Rerank Model,更细致地判断 Query 与 Document 的真实相关性。【速度和精度的平衡:Rerank】
例如第一次检索得到:
简单向量相似度可能把第 3 项排在第三。
Reranker结合整个 Query 和候选内容重新判断后,可以得到:
Spring AI 的高级 RAG API 提供 DocumentPostProcessor 接口,官方明确将 reranking、去除无关或重复文档以及内容压缩列为 Post-Retrieval 阶段的典型用途。具体 Rerank 模型通常需要结合实际供应商或搜索后端实现。(Home)
因此可以记住:
bash
Retrieval
→ 先把正确答案捞进候选集
Rerank
→ 再把真正最相关的排到前面
八、还有哪些常见 RAG 词需要认识
到了这里,再看到很多术语就容易定位了。
| 术语 | 解决的问题 |
|---|---|
Chunk Overlap |
切块边界导致上下文断裂 |
Semantic Chunking |
固定长度切分破坏完整语义 |
Parent-Child Retrieval |
小块好检索,大块更适合阅读 |
Similarity Threshold |
过滤明显不相关的召回结果 |
Top-K |
控制候选数量 |
Metadata Filter |
限定地区、时间、权限、来源等检索范围 |
BM25 |
精确关键词和实体检索 |
Hybrid Search |
融合语义检索与关键词检索 |
RRF |
融合多种检索结果排名 |
Query Rewrite |
原始问题模糊、不完整 |
Multi-Query |
单一表达可能漏召回 |
Query Decomposition |
一个问题包含多个子问题 |
Rerank |
初次召回排序不够准确 |
Deduplication(去重) |
多个 Chunk 内容高度重复 |
Context Compression(内容压缩) |
Chunk 有效信息少、噪声多 |
Citation / Provenance |
回答需要返回原始证据来源 |
Freshness |
避免过期资料覆盖新资料 |
这些技术没有必要全部默认开启。工程上应该根据 Badcase 判断真正的问题发生在哪里。
九、RAG 最后一定要做 Retrieval Eval
RAG 最容易出现一种错觉:模型最终回答看起来不错,于是认为检索系统也很好。
真正评价 RAG 时,应当单独检查检索阶段。
例如准备一个问题:
bash
Q:
2026年海南某项目申报截止日期是什么?
标准证据:
policy_2026_hainan.pdf 第18页
然后检查:
bash
Top 5 检索结果中
是否出现标准证据?
这就是最基础的 Recall@K 思想。更正式一点,如果一个问题对应若干条真正相关的证据,那么:
bash
Recall@K = Top K 中找回的相关结果数/所有应该找回的相关结果数例如标准答案一共有 2 个相关 Chunk,Top 5 找到了其中 1 个,那么 Recall@5 = 1/2 = 50%。
为什么 RAG 特别重视 Recall?因为前面的检索阶段如果漏掉正确证据,后面的 Rerank 和大模型基本没有机会补救 。相反,如果 Top 5 里面多混进两三个无关 Chunk,后面的重排序和模型还有机会把它们过滤掉。因此第一阶段检索通常优先保证"别漏"。
这也能帮助我们理解 Precision@K。假设 Top 5 返回了 5 条,其中只有 2 条相关:
bash
Precision@5=\frac{2}{5}=40%Precision 更关注"你拿回来的东西干不干净",Recall 更关注"该拿回来的东西有没有漏掉"。
还可以继续关注:
bash
Precision@K
→ 返回的 K 个结果里有多少是真的相关
MRR
→ 第一个正确结果排得有多靠前
nDCG
→ 整体排序质量怎么样对于企业知识库,还应该增加业务指标,例如:
bash
权威来源是否优先?
最新版本是否优先?
引用能否返回原文?
跨租户资料是否被严格隔离?
没有证据时是否明确回答"无法确认"?
这一步非常重要。一个高质量 RAG 系统的目标不是"无论什么问题都生成一段像答案的话",而是尽可能找到正确证据,并且在缺少可靠证据时保持可控。
十、用问题驱动的方法选择 RAG 技术
最后把整篇压缩成一套面试时真正有用的判断路径:
bash
知识库里根本没有答案
→ 补充数据源
资料有,但总搜不到
→ 检查 Chunking / Embedding / Query Rewrite
同义表达搜不到
→ Embedding / Multi-Query
政策编号、型号、专有名词搜不到
→ BM25 + Hybrid Search
总搜到旧政策或错误地区
→ Metadata Filter + Freshness
正确文档在候选里,但排名很靠后
→ Rerank
召回结果太多、噪声很大
→ Threshold / Top-K / Rerank / Compression
Chunk 命中了,但上下文残缺
→ Overlap / Parent-Child / 更合理 Chunking
单问题过于复杂
→ Query Decomposition
最终答案无法核查
→ Citation / Provenance
不知道优化以后有没有变好
→ Retrieval Eval + Badcase + 回归测试
因此,RAG 工程真正需要掌握的核心思路可以概括为:
bash
先把资料组织好
        ↓
尽可能召回正确证据
        ↓
通过过滤缩小搜索空间
        ↓
结合关键词与语义检索
        ↓
重新排序候选证据
        ↓
只把高质量证据交给 LLM
        ↓
保留来源并进行 Eval
Spring AI 在这里提供的是一套模块化接口。DocumentReader → TokenTextSplitter → VectorStore → QueryTransformer / QueryExpander → DocumentRetriever → DocumentPostProcessor → RetrievalAugmentationAdvisor 基本已经对应了完整 RAG 工程的主要阶段。(Home)
真正到了项目和面试场景,你需要表达的重点也不再是"我接了一个向量数据库",而应该能够说明:遇到了什么检索问题,问题发生在 RAG 的哪一层,为什么选择 Chunking、Metadata Filter、Hybrid Search 或 Rerank,以及最终用什么 Eval 指标证明检索确实变好了。