基于linux系统运行 此文档开始前 请先准备好linux系统 (虚拟机,服务器配置均可)以三台为例
此文档基于linux三台虚拟机完成 使用finallshell ssh隧道连接
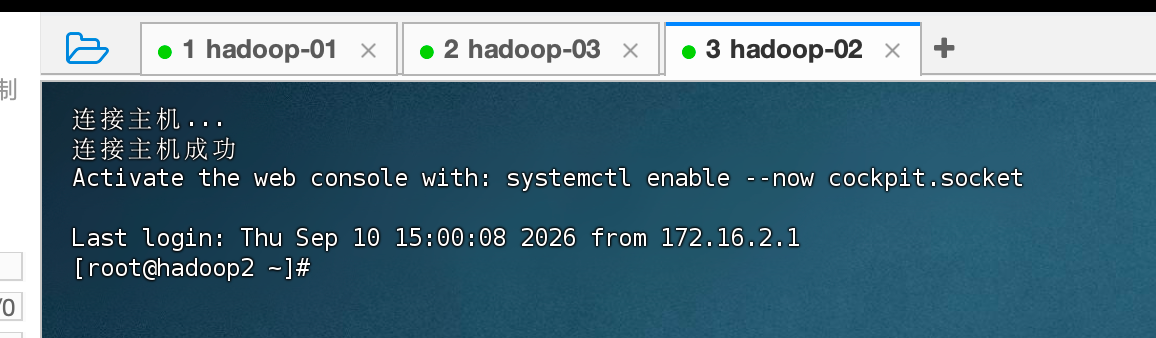
三台分别为
- hadoop1:172.16.2.133
- hadoop2:172.16.2.134
- hadoop3:172.16.2.135
系统:CentOS Stream9 aarch64(ARM)
步骤一 配置三台主机名
linux指令如下
zsh
# hadoop1执行
hostnamectl set-hostname hadoop1
# node02执行
hostnamectl set-hostname hadoop2
# node03执行
hostnamectl set-hostname hadoop3
hosts解析
三台修改 /etc/hosts 文件
追加以下三行
zsh
172.16.2.133 hadoop1
172.16.2.134 hadoop2
172.16.2.135 hadoop3
步骤二 hadoop1 配置ssh登录
仅在hadoop1置行
zsh
# 生成密钥,一路回车
ssh-keygen -t rsa
# 把公钥分发到3台机器(包含自己)
ssh-copy-id hadoop1
ssh-copy-id hadoop2
ssh-copy-id hadoop3
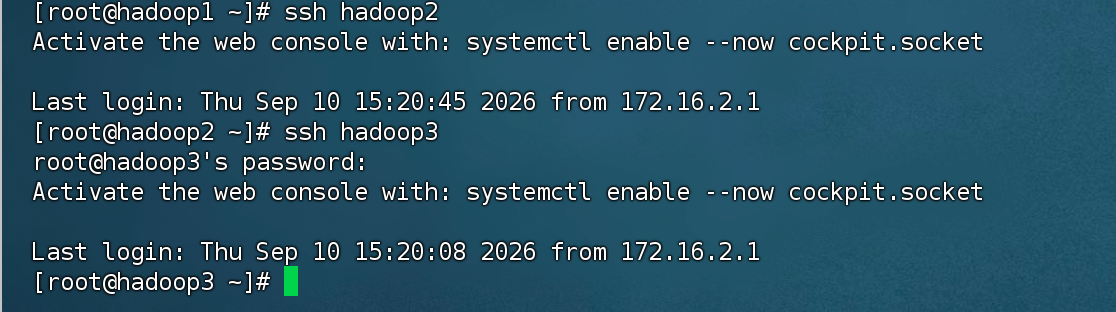
测试 :ssh hadoop2 ,可正常切换
步骤三 安装jdk
第一 分别在三台机器下 安装 一下文件夹作为约定
创建存放数据的目录
mkdir -p /export/data/创建存放安装程序的目录
mkdir -p /export/servers/创建存放安装包的目录
mkdir -p /export/software/第二 下载jdk安装包 这里以jdk 21 为例
下载链接
https://www.oracle.com/java/technologies/downloads/#java21
将下载的压缩包存放到 /export/servers 下
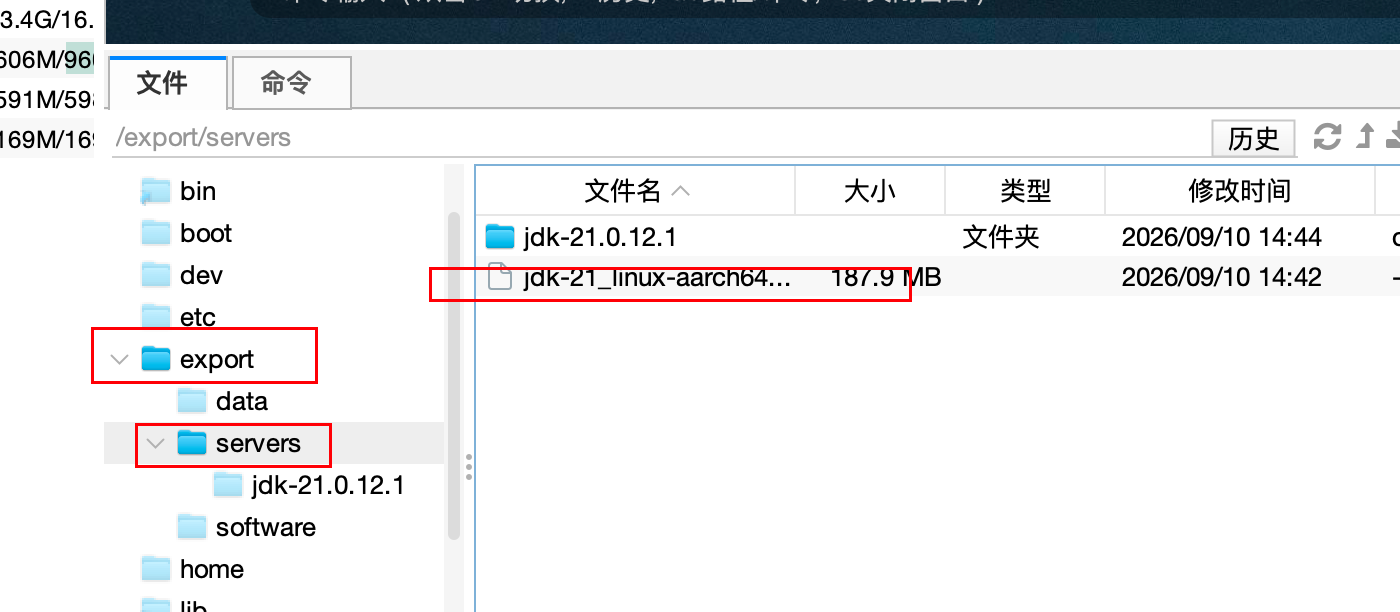
通过命令 进行解压 (要注意替换命令中文件位置 压缩包名称 以及压缩位置)
tar -zxvf /opt/software/jdk-8uXXX-linux-aarch64.tar.gz -C /opt/module/第三 进行环境变量配置
创建此文件
/etc/profile.d/my_env.sh
打开写入 配置文件 (注意解压后安装包路径及文件名称 如上图为jdk-21.0.12.1)
export JAVA_HOME=/opt/module/jdk1.8.0_xxx
export PATH=$PATH:$JAVA_HOME/bin
第四 刷新配置文件 让配置生效
source /etc/profile.d/my_env.sh 验证
java -version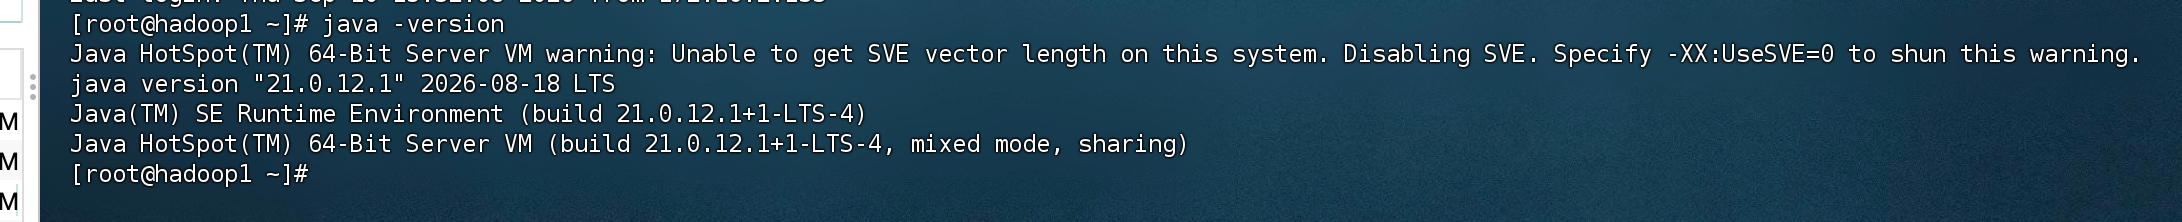
如图即为生效
第五 使用scp 进行 分发
三台主机名:hadoop1 hadoop2 hadoop3
JDK 目录示例:/export/servers/jdk-21.0.12.1,换成自己真实的文件夹名
把 hadoop1 的 jdk 目录传到 hadoop2
scp -r /export/servers/jdk-21.0.12.1 root@hadoop2:/export/servers/传到 hadoop3
scp -r /export/servers/jdk-21.0.12.1 root@hadoop3:/export/servers/-r:递归,用来拷贝文件夹(拷贝文件夹必须加 - r)
分发环境变量文件 my_env.sh
scp /etc/profile.d/my_env.sh root@hadoop2:/etc/profile.d/
scp /etc/profile.d/my_env.sh root@hadoop3:/etc/profile.d/
scp 简单说明
scp 源文件 目标用户@目标主机:目标路径- 拷贝文件 :不用
-r - 拷贝文件夹 :必须
-r