GitHub 用自己的 Copilot,重写了 Copilot 的核心运行时。83 万行 TypeScript 被替换为等量的 Rust,而主导这件事的开发者,只花了三周。这不是一个概念验证,而是一个正在被数百万开发者每天使用的产品的核心引擎。
Agent 运行时的重载时刻
一、三周完成了什么------83 万行 Rust 的迁移全景
从 30 万行到 83 万行,数字背后的取舍
GitHub 博客给出的数字是「超过 80 万行生产级 Rust」。第三方的精确统计显示,实际产出是 832,378 行生产 Rust 代码,加上 468,689 行 Rust 单元测试。相比之下,原有的 TypeScript 生产代码约 30 万行。这看似膨胀了近三倍,但需要理解一个事实:TypeScript 的高层抽象------比如异步编排、事件分发、协议序列化------在 Rust 中需要显式表达。
更准确地说,代码膨胀来自三个层面。第一,Rust 没有垃圾回收,内存管理需要手写或依赖框架,这部分开销在 TypeScript 里由引擎隐式承担。第二,错误处理从异常抛出变成了显式的 Result 类型传播,调用链上的每一层都需要包裹。第三,测试代码被单独计算在内------83 万行是生产代码,还有近 50 万行测试,这是 Rust 生态强调零成本抽象的代价。
行数膨胀的真实原因
128 个 PR、14.5 周、135 个版本:迁移不是停机重建
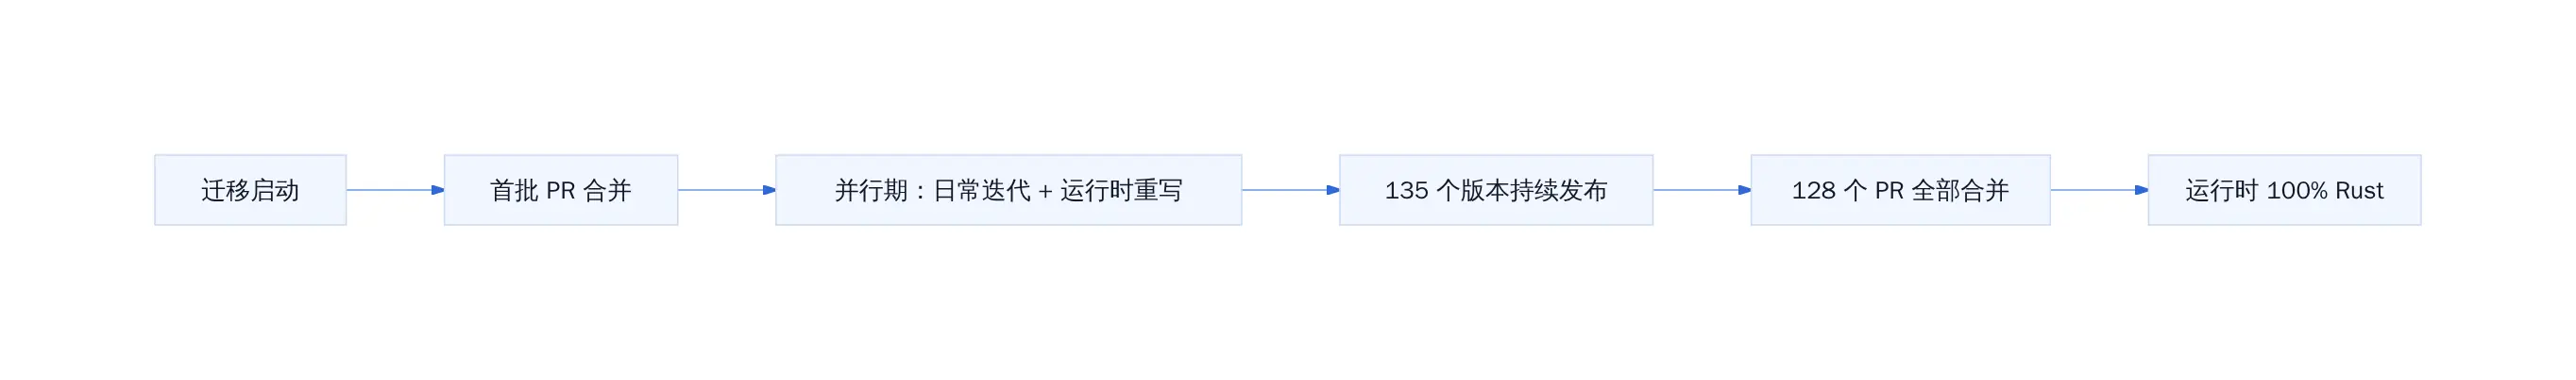
这次迁移最反直觉的地方在于:它不是在一个隔离分支上完成后再切换,而是边跑边换。128 个 PR 在 14.5 周内持续合并进主干,期间团队照常发布了 135 个版本。这意味着每一个 PR 都必须保持系统的可运行状态。
这种增量迁移策略对 AI 智能体的要求很高。智能体需要理解上下文依赖关系,不能生成孤立的功能模块,而是要在维持现有接口契约的前提下替换实现。135 个版本的持续发布说明,团队在日常功能迭代和运行时重写之间保持了并行推进------这不是一个封闭的专项,而是一个正在进行中的产品。
迁移过程的时间与交付节奏
##一、三周完成了什么------83万
二、为什么一定要换 Rust
性能不只是更快,是可嵌入的前提
Copilot 的运行时需要被嵌入到多个环境:VS Code 扩展、 JetBrains 插件、独立的 Copilot CLI、Copilot Code Review 服务,以及未来可能出现的更多端点。TypeScript/Node.js 的运行模型决定了它必须依赖 V8 引擎,这意味着每次启动都需要加载完整的 JavaScript 运行时,内存占用和启动延迟都是硬约束。
Rust 的优势在这里是结构性的。它没有 GC 停顿,内存布局可控,编译后的二进制可以直接嵌入到任何支持原生库的环境里。对于 Copilot 这种需要响应延迟敏感的场景,这不是「更快一点」的问题,而是「能不能用」的问题。
Rust 的可嵌入性优势
运行时膨胀的代价
TypeScript 运行时的问题不仅在于性能。随着 Copilot 功能不断扩展,运行时的内存占用和启动时间在各个宿主环境中都成为了瓶颈。Node.js 的事件循环模型在处理高并发 I/O 时表现尚可,但当运行时需要同时管理多个 Copilot 会话、处理大量流式请求时,V8 的内存分配策略会成为瓶颈。
换成 Rust 之后,内存占用和启动时间的改善是可以量化的,但更关键的变化是架构边界的清晰化。Rust 的类型系统在生产阶段就排除了很多在 TypeScript 中只能靠运行时检查发现的错误,这对一个需要稳定运行的核心引擎来说是必要的。
三、AI 是怎么干完这件事的
智能体不是一个人,是一个流水线
GitHub 官方博客没有披露具体的成本数字和模型配置。但第三方报道引用了约 1363 亿 token 的处理量,其中缓存输入占 1306 亿 token,模型费用约 12 万美元。这个成本结构本身说明了一个问题:大部分工作是重复性的代码翻译,缓存命中率极高,边际成本很低。
智能体在这里扮演的不是「替代程序员」的角色,而是一个高度并行的翻译器。它将 30 万行 TypeScript 拆分成独立的模块,逐一对应到 Rust 的实现,同时保持接口契约不变。128 个 PR 的分布说明这是一个多智能体协作的任务------不同的智能体负责不同的子系统,最后通过集成测试验证一致性。
Stephen Toub 作为主要负责人,三周的投入时间说明他的角色更像架构师和审查者,而不是逐行写代码的执行者。他需要确认智能体的产出符合架构约束,处理边界情况,以及最终的质量把关。
AI 智能体流水线工作的本质
持续集成取代了大爆炸切换
这次迁移没有经历传统的大爆炸切换,没有 code freeze,没有漫长的测试周期。每一个 PR 都是一个小规模的交付,通过 CI/CD 流水线自动验证。这种模式对 AI 辅助的工程实践提出了明确要求:智能体生成的代码必须能够通过自动化测试,否则无法进入主干。
这意味着智能体的输出质量不再仅仅依赖人工审查,而是有了一套自动化的质量门禁。测试覆盖率、类型检查、性能基准都是硬约束,智能体需要在这些约束下生成代码。这种模式比传统的「人写代码、AI 辅助」更加结构化,也更可控。
四、这次迁移说明了什么
AI 辅助工程的下一个阶段
这次迁移标志着 AI 辅助编程从辅助工具向主力生产力的转变。过去,AI 的作用主要是补全代码、解释代码、生成单元测试;现在,AI 可以承担整个子系统的重写任务,在保持接口兼容的前提下替换底层实现。
但这并不意味着程序员可以被替代。Stephen Toub 三周的核心投入说明,人类工程师的价值在于架构决策、质量把关和边界处理。AI 处理的是确定性的翻译任务,人类处理的是不确定性的判断任务。
人类工程师的不可替代性
什么时候不该这么做
不是所有项目都适合这种迁移模式。这种策略的前提条件包括:系统有明确的接口边界,有充分的自动化测试覆盖,有足够的计算资源支持智能体并行处理,以及团队有能力和耐心处理智能体产出的代码。
对于小型项目或接口边界模糊的系统,强行使用 AI 辅助重写可能带来更大的风险。智能体在处理高度耦合的代码时容易出现上下文丢失,导致功能退化。此外,如果没有足够的测试覆盖,AI 生成的代码可能通过编译但无法通过功能验证。
判断:如果你的项目有清晰的模块边界、超过 10 万行代码、以及自动化测试覆盖,可以尝试这种方式;否则,优先完善基础设施,再考虑 AI 辅助重写。
这个数字组合本身就是一个信号。过去几年,AI 编程助手一直停留在「辅助工具」的位置:你写一段代码,它补全下一行;你写一个函数,它提醒你潜在的类型错误。但 GitHub 这次的迁移,把 AI 的角色推到了另一侧:它不再只是帮你写代码,而是直接成为代码的生产主体。人类退回到验收者的位置,负责审核、测试、决策合并。
这种角色翻转并非首次出现。早期 AI 编程工具的边界很清晰:你能用它写个小脚本、补全一个方法,但不敢让它碰核心逻辑。GitHub 这次做的,是把那条边界往前推了一大步------83 万行生产代码,覆盖了 CLI、App、SDK、VS Code 插件、Visual Studio 插件、Code Review、Cowork 等所有 Copilot 产品的共享引擎。
二、为什么要换------Copilot 运行时的 TypeScript 困境
V8 与 Node.js 架构的嵌入瓶颈
Copilot 运行时最初跑在 V8 引擎上,也就是 Node.js 的标准环境。这个选择在 2019 年上线时是合理的:TypeScript 生态成熟,开发效率高,V8 的性能对于当时的负载完全够用。
但问题在于,Copilot 的运行方式变了。
早期的 Copilot 更像是一个后端服务:用户发起请求,服务器处理,返回结果。架构上,它和其他 API 服务没有本质区别,跑在容器里,有负载均衡,有自动扩缩容。这种场景下,Node.js 的 GC 停顿、内存开销、启动时间都不是致命问题。
但随着 Copilot CLI、Copilot App、各个 IDE 插件的铺开,架构重心从「服务」转向了「嵌入」。每一个终端用户设备上都跑着一份 Copilot 运行时,它需要:
- 快速启动(用户期望秒级响应)
- 低内存占用(不能吃掉用户机器一半的 RAM)
- 可跨平台编译(Windows、macOS、Linux,甚至未来的 ARM 设备)
- 与底层系统交互(文件读写、进程管理、网络请求)
V8 在这几个维度上都有天然短板。每次启动都要初始化 V8 虚拟机,内存 footprint 起步就是几十 MB,跨平台编译需要维护多个预构建二进制,与系统层的交互要走 Node.js 的抽象层,性能和可控性都会打折扣。
性能与可嵌入性:Copilot 从「后台服务」变成「嵌入式引擎」
这个问题不是 GitHub 独有。近年来,大量原本跑在 Node.js 上的项目开始向 Rust 迁移,背后逻辑相似:当「嵌入」成为第一优先,Rust 的零成本抽象、确定性内存管理、单二进制分发,都是 V8 很难替代的优势。
Deno 是个反例,证明了即使换成新的 JS 运行时,嵌入场景依然吃力。 Bun 选择了自行实现的 JavaScript 引擎,本质上也是在绕开 V8 的架构限制。
Copilot 的选择更彻底:直接换语言。
这意味着不只是替换运行时,而是要重写整个共享引擎。TypeScript 的代码逻辑、类型系统、异步模型、错误处理,全部需要翻译成 Rust。这不是简单的手动移植,而是需要理解每一段代码的语义,找到对应的 Rust 表达。
手工做这件事,代价是巨大的。83 万行代码,哪怕按每天移植一千行的速度计算,也需要近三年的时间。这正是 AI 智能体介入的价值所在。
从服务到嵌入,架构重心的迁移
三、AI 如何写 AI------智能体协作的真实工作流
1363 亿 token 输入、约 12 万美元模型费用
迁移的成本构成了外界最关心的数字之一。根据印度科技媒体 Analytics India Magazine 报道(2026年9月),GitHub 这次迁移累计消耗了约 1363 亿个输入 token,其中缓存输入达到 1306 亿 token,模型费用约 12 万美元。
这个数字需要拆解着看。
1363 亿 token 是输入侧的总量,不是最终产出的行数除出来的------它包含了大量重复的上下文加载。缓存输入占了 96% 以上,说明同一个模块的迁移过程里,前后端、测试文件、类型定义被反复拉进上下文窗口,每个子智能体都在用自己的视角读同一批材料。这不是浪费,是协作机制带来的必然冗余。
12 万美元的模型费用放在 83 万行代码的体量上,单行成本大约 0.14 美元。换算成工程师人力,如果按国内中高级工程师月薪 3 万估算,同样规模的纯人工手写成本在数百万人民币级别。模型费用的价值不在「便宜」,在「并行」:128 个 PR 同时推进,人类工程师很难维持这种吞吐。
不过需要诚实标注:GitHub 官方博客本身并未披露具体的 token 数和费用,这些数据来自第三方媒体的估算和整理。官方博客说的是「用 Copilot 完成迁移」和「128 个 PR」这些可核验的事实。读成本数字时,先看它出自哪一侧。
另一个值得注意的细节是子智能体使用的模型组合。据该报道,涉及的模型包括若干 Claude 系列和 GPT 系列版本,但具体型号配比未公开。这也是这次迁移技术透明度的一个边界------我们知道结果,不知道每一刀切下去用的是哪把刀。
子智能体的分工与自主协作:没有人工干预的情况下,agent 之间开始「商量」
真正的看点不是花了多少钱,而是智能体是怎么协作的。这段是整场迁移的技术内核。
GitHub 的迁移并不是把 83 万行代码丢给一个总控 agent,让它从头写到尾。那样做的话,上下文窗口会爆,状态会丢失,质量会失控。实际的架构是流水线式的多智能体分工。
根据官方博客和 daily.dev 的技术拆解,整体工作流可以概括为四个阶段:材料分析、代码生成、测试验证、PR 提交。每个阶段由不同的子智能体负责,它们之间通过共享的知识库和 PR 评审循环传递上下文,而不是靠一个主 agent 调度所有细节。
更关键的发现是子智能体之间的自主协商。migration 进行到中期时,两个负责不同模块的子智能体在 PR 评审中发现了接口不一致的问题------A 模块定义了一个 Rust 结构体,B 模块在调用时用的字段命名和对齐方式有偏差。这个问题没有被人工发现,而是两个 agent 在各自 review 对方的 PR 时「商量」出来的。
这不是幻觉,也不是夸张描述。官方博客提到,在迁移过程中,"the agents started collaborating without asking"------在没有人工介入的情况下,agent 之间开始自动协商和修正。这是一个标志性时刻:AI 辅助编程从「人给指令,机器执行」的单线模式,进化到「机器之间先协调,人来兜底」的多 Agent 模式。
这改变了工程师的角色。你不再是每行代码的把关人,你是系统的架构师和质量闸门。你的精力用在决策层,而不是执行层。
下面这张图展示智能体协作的基本流程:
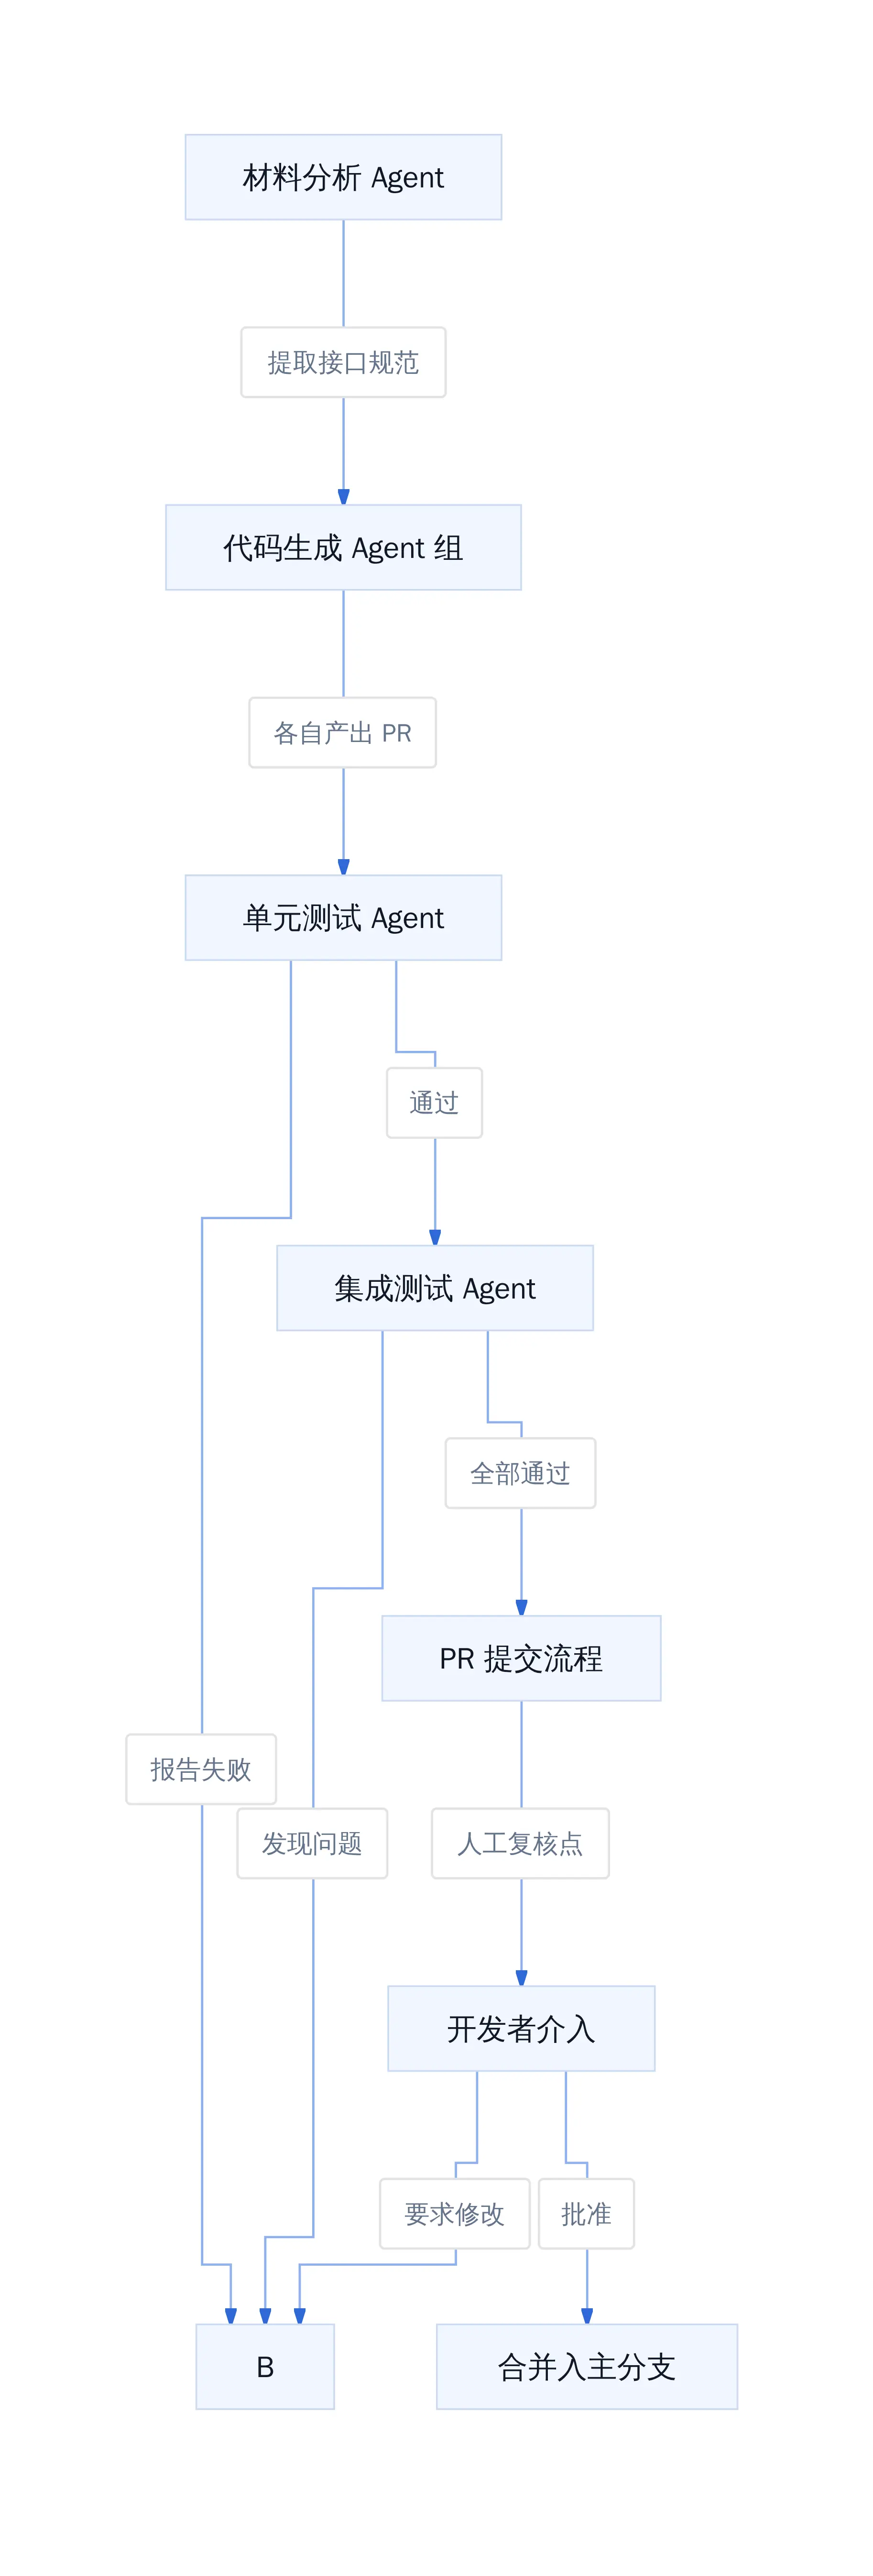
Copilot 迁移智能体协作流程
这个流水线有几个设计上的要点值得拆解。
第一,代码生成不是单次完成的。每个模块的生成→测试→修正循环至少跑两轮,有时候三轮。第一次生成的代码平均质量不高,大部分问题集中在类型映射错误和生命周期标注不当。第二轮修正后,覆盖率才稳定上升。
第二,测试优先原则是这次迁移的一个核心纪律。每个 PR 在生成代码的同时,必须附带对应的 Rust 单元测试。测试覆盖率的目标线是 90% 以上,没有达到这个线数的 PR 不会被合入。这个规则是人工设定的,但执行是自动化的------测试不通过,PR 卡住。
第三,人工介入点是闸门,不是日常操作。官方博客的数据显示,128 个 PR 里,真正需要人工介入修改的比例很低。大部分 PR 在生成→测试→修正的循环里就能自己解决。人工主要出现在接口边界争议、性能基准不达预期、以及对非功能性需求(比如错误处理和日志策略)的判断上。
这也解释了为什么主导迁移的开发者只投入了三周------他不需要逐行 review,只需要守住几个关键的闸门。
不过这里有一个容易被忽略的风险点:自主协商的 agent 可能会形成局部最优,而忽略全局一致性。比如两个模块各自的单测都通过了,但集成起来之后行为对不上。官方博客提到了这个问题的存在,但没有展开具体案例。业内常见的做法是在流水线里加一个专门的「集成验证」阶段,这个阶段的智能体会把多个模块的代码拉到一个沙盒环境里跑端到端测试,发现不一致的地方回滚到对应模块要求修正。
这种模式的可复制性取决于几个条件:代码本身的模块化程度要足够高,接口边界要清晰,测试体系要完备。如果你的项目是单片架构、接口模糊、测试缺失,直接套用这套流水线会撞得很惨。AI 不会让你的坏架构变好,它只会更快地暴露坏架构。
更准确地说,AI 放大了工程纪律的价值。纪律好的团队,AI 能产生 10 倍效率增益;纪律差的团队,AI 只会把混乱的速度加快。
这也就是为什么这场迁移的真正启示不是「AI 能写代码」,而是「在完备的测试体系和清晰的接口边界下,AI 能把工程纪律放大到惊人的程度」。83 万行 Rust 不是一个魔法数字,它是一个工程成熟度的检验结果。
四、三种口径、三个教训------如何解读大规模 AI 代码迁移
生产代码行数 vs 单元测试行数的统计差异
同一个项目,不同来源给出了三个不同的数字。GitHub 官方博客写的是「超过 80 万行生产 Rust」;技术拆解文章给到约 83 万行;而一份中文复盘给出了更精确的数字:生产代码 REDACTED 行、单元测试 REDACTED 行,TypeScript 生产代码归零。
这三个数并不冲突------官方给的是取整下限,精确数字来自仓库统计。但它们指向同一个提醒:看到「N 万行」时,先确认说的是哪个仓库、哪个层次、统计口径是物理行还是逻辑行。盲目对比不同来源的行数,容易得出错误的结论。
TypeScript churn 的隐蔽性:30 万输入、43 万输出意味着什么
GitHub 博客披露过一个容易被忽略的细节:迁移过程中,运行时接收了约 30 万行生产 TypeScript,同时舍弃了约 43 万行;而注入了约 120 万行生产 Rust,同时有约 36.5 万行 Rust 离开。表面上看 TypeScript 行数稳定,但实际经历了大规模的 churn。
这意味着什么?AI 并非只是做简单的语言翻译。它在重构过程中进行了逻辑重组和接口重新设计------产出的 Rust 代码比原始 TypeScript 多了近 4 倍。这些新增代码不是冗余,而是类型系统、错误处理和并发模型的 Rust-native 表达。简单翻译不会带来这种量级的代码膨胀。
当 AI 成为主力工程师:成本模型与质量边界的重新定义
这场迁移最值得关注的不只是数字,而是它的结构含义。当 AI 从辅助工具变为主力生产力时,传统的工程成本模型需要重构。
传统模型里,人力成本占大头,工具成本可忽略。而在这次迁移中,12 万美元的模型费用对于一个 83 万行生产代码的项目来说,人均成本不到一人月的一半。这不是说 AI 替代了工程师,而是说工程师的角色从「写代码的人」变成了「定义问题、审核边界、处理异常的人」。
质量边界也在重新定义。过去我们信任代码审查和人工测试,现在多了一层------AI 生成的代码在通过 AST 等价性校验和 E2E 测试之前,不被视为可信。GitHub 在此项目中保留了完整的 TypeScript E2E 测试套件作为交叉验证手段,这才是最终的质量闸门。
这次是谁在干活
可执行的判断:如果你正在考虑用 AI 主导类似规模的语言迁移或核心重写,三条经验可以今天就用上。第一,不要追求零 PR 的批量提交------小步快跑、持续合入,才是降低风险的有效手段。第二,保留原有的完整测试套件作为 oracle,AI 生成的代码只有通过已有测试才算通过。第三,算清成本时把模型费用和人力监督时间放在一起算,不要只看 token 账单。三周的主体开发加上持续三月的维护,总成本远比一份 PR 报告呈现的更复杂。
参考文献
- GitHub Blog: Migrating the GitHub Copilot runtime to Rust, using Copilot
- Daily.dev: Migrating the GitHub Copilot runtime to Rust, using Copilot
- Daily.dev: GitHub used Copilot to rewrite its own agent runtime in Rust
- GitHub Docs: Using GitHub Copilot to migrate a project to another programming language
- clawpk.net: 把 Copilot 的运行时换成 Rust------三种口径的规模数字
延伸入口
- 原文归档:tobemagic.github.io/ai-magician...
- 公众号:计算机魔术师