网络基础概念
1. 计算机网络背景
1.1 网络发展历史
计算机最初是独立模式 :每台计算机相互独立,各自完成计算任务。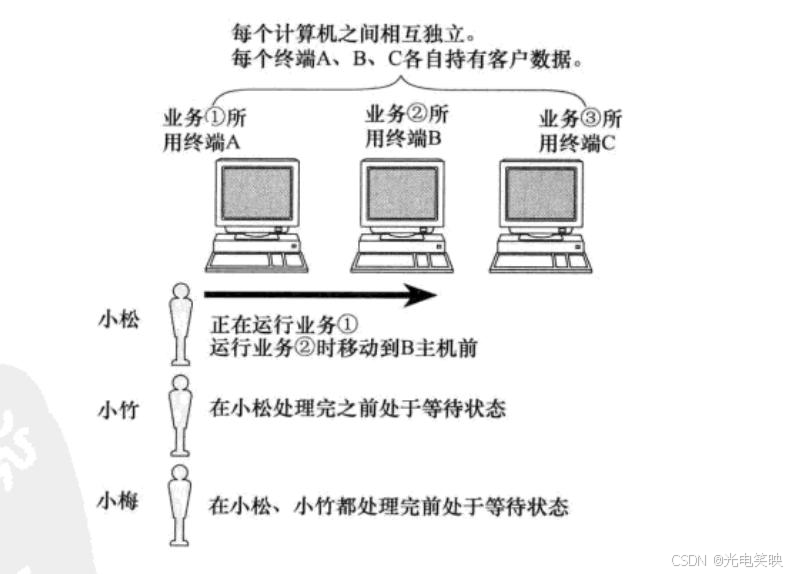
但计算机是人类的工具,人类需要协作,计算机之间也必然需要协作。因此,网络的产生是必然的。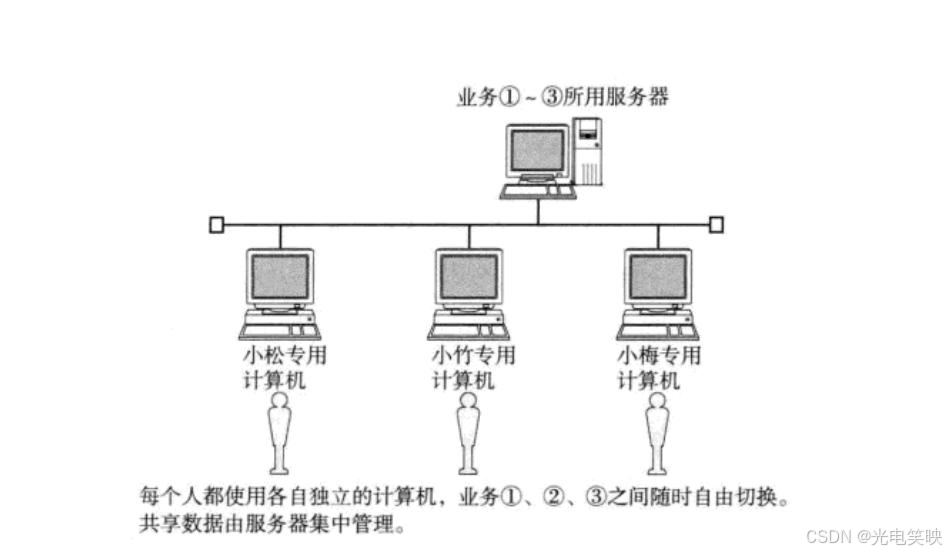
| 阶段 | 说明 |
|---|---|
| 独立模式 | 计算机之间相互独立 |
| 网络互联 | 多台计算机连接在一起,完成数据共享 |
| 局域网 LAN | 计算机数量更多,通过交换机和路由器连接在一起 |
| 广域网 WAN | 将远隔千里的计算机都连在一起 |
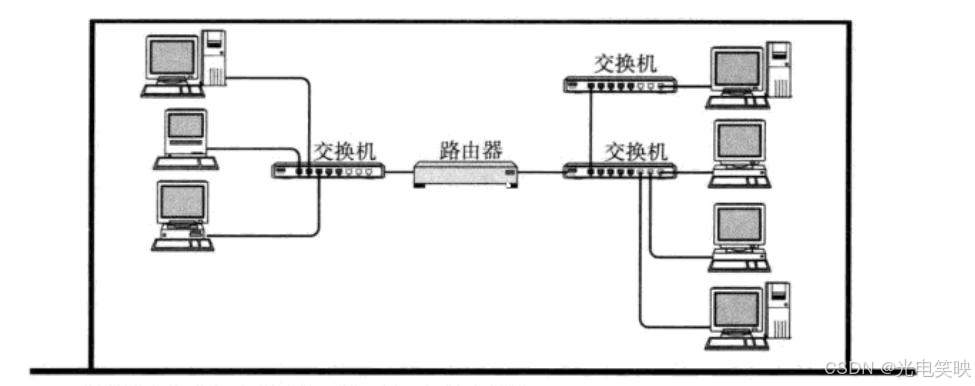
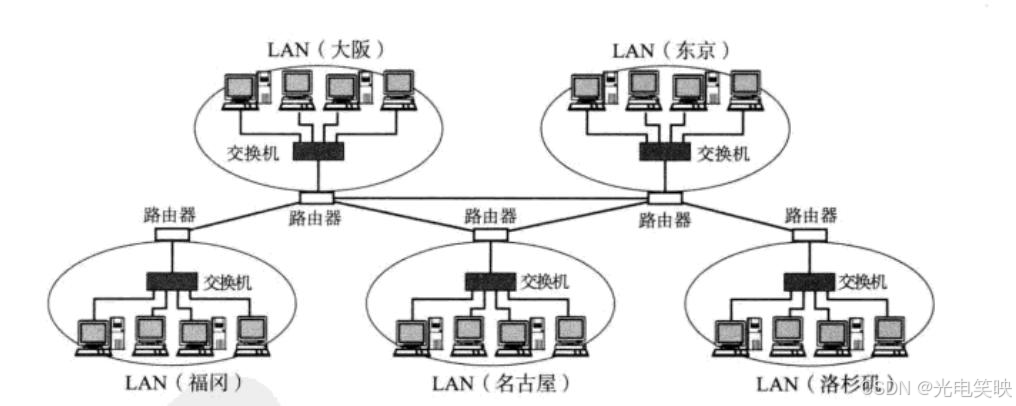
计算机网络的发展,本质上映射着人类协作边界不断突破物理空间限制的过程。
注意:局域网和广域网只是相对概念。比如我们常说的"广域网",在某些视角下也可以看做一个比较大的局域网。
1.2 协议与标准化
为什么需要协议?
协议是一种约定,用来减少通信成本,快速形成共识。
生活例子:
-
当年电话费较贵,打电话没打通不收费。
-
为了省电话费,可以约定:响一声代表"我没生活费了",响两声代表"报平安",一直响代表"有事情谈"。
-
这就是一种协议,双方快速形成共识,降低成本。
计算机之间的传输媒介是光信号和电信号,通过频率 和强弱 表示 0 和 1。
要想传递各种不同信息,就需要约定好双方的数据格式。
只约定协议就够了吗?
不够。
-
你用频率表示 01,我用强弱表示 01;
-
就像你用中文,我用葡萄牙语;
-
虽然大家都遵守"通信规则",但语言不同,仍然无法正常通信。
所以,完善的协议需要更多更细致的规定,并让参与的人都遵守。
为什么需要网络协议标准?
计算机生产厂商很多,操作系统很多,网络硬件设备也很多。
如何让不同厂商生产的计算机相互顺畅通信?
需要有人站出来,约定一个共同标准,大家都来遵守,这就是网络协议。
标准化组织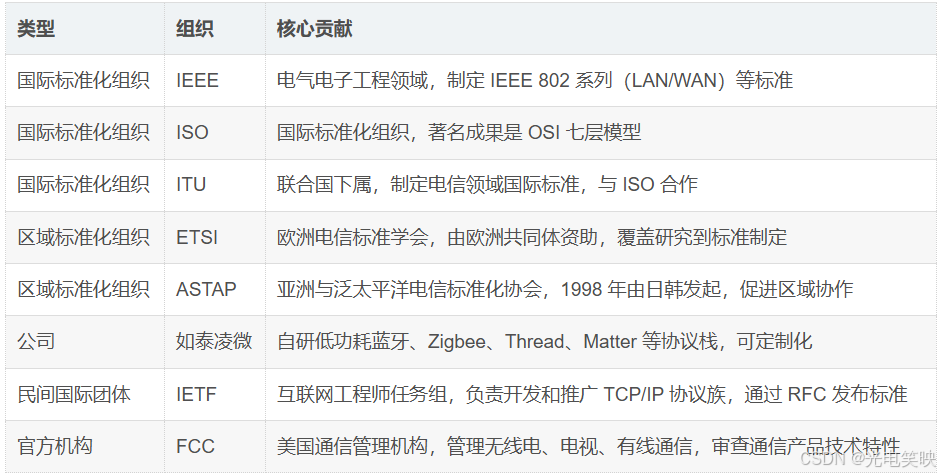
这些标准只提供标准本身,并不提供代码实现。
2. 协议分层
2.1 分层思想
协议本质也是软件。为了更好的模块化、解耦合,协议被设计成层状结构。
用打电话类比网络分层: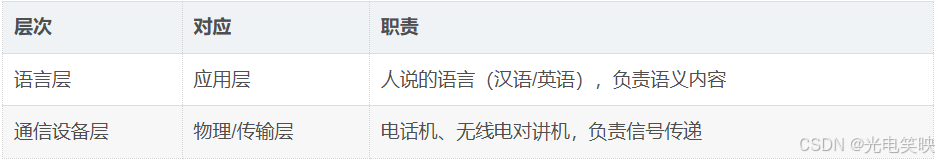
两层之间有接口:人对着设备说话,设备把人声转为电信号。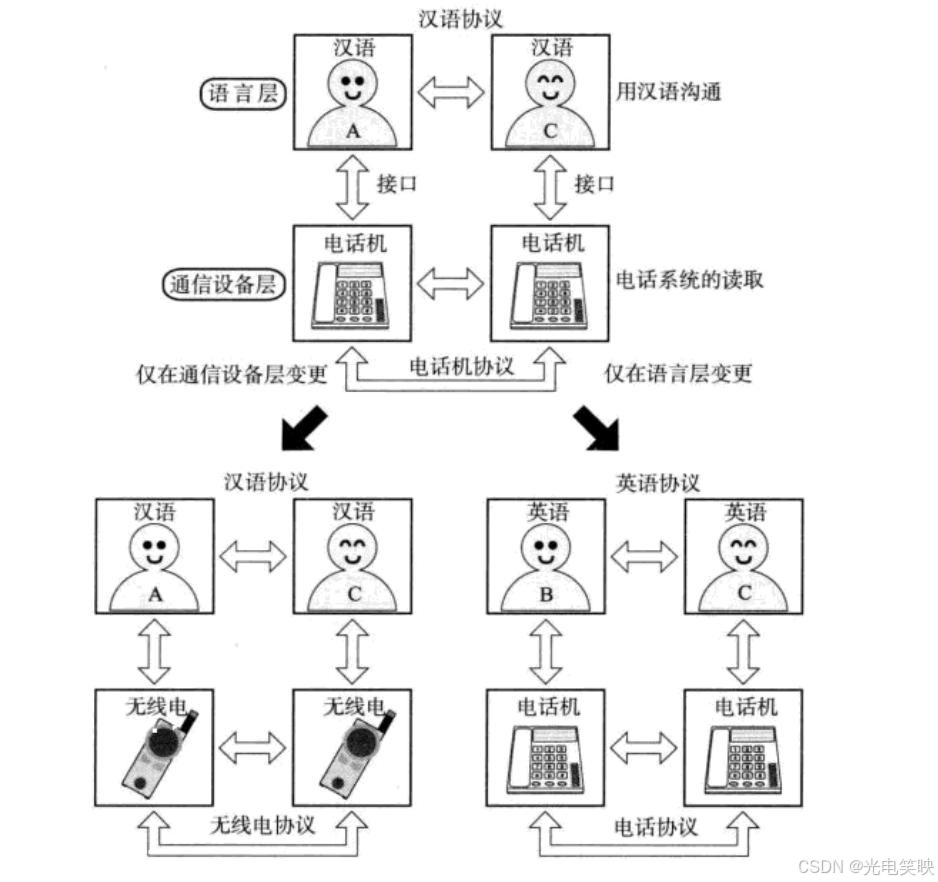
-
仅更换通信设备层:A 和 C 语言不变,仍然汉语,电话机换成无线电对讲机。
-
仅更换语言层:B 和 C 设备不变,还是电话机,但两个人从汉语换成英语。
核心知识点
-
层之间相互独立:某一层内部实现改变,只要层间接口不变,其他层不受影响。
-
对等层通信:A 和 C 的语言层互相对话;两台电话机的设备层互相通信。只有同一层才有对应的协议。
-
分层的好处:把"信息内容"和"信号传输"拆开,改传输工具不影响内容,改内容不影响传输工具。解耦,可维护性强。
2.2 OSI 七层模型
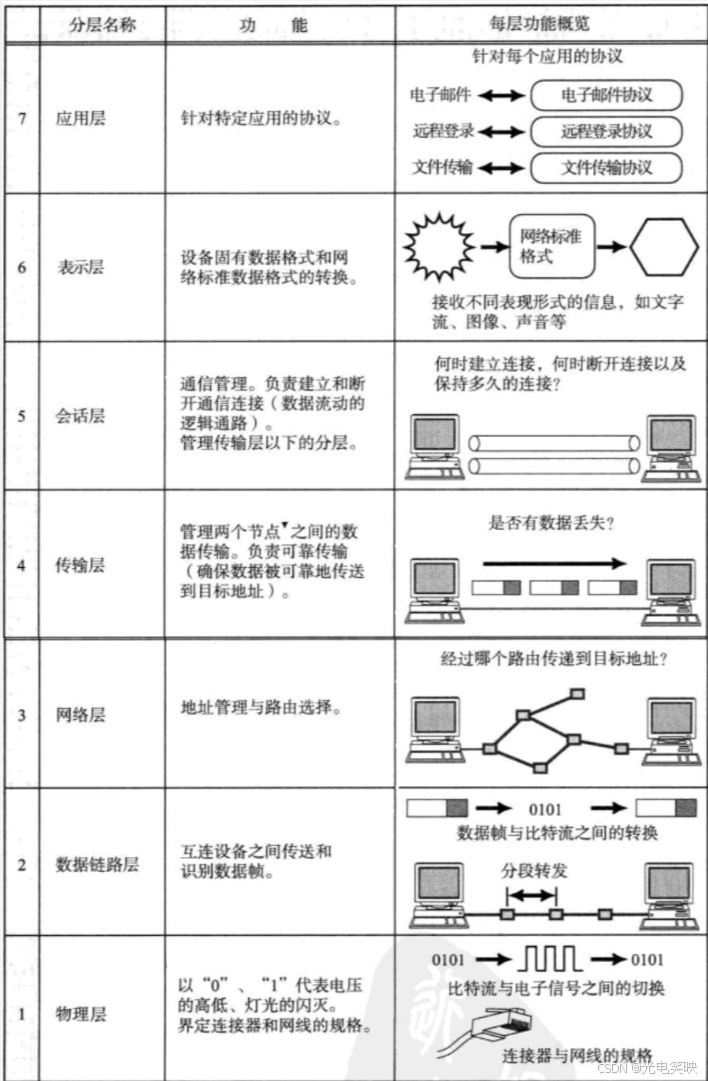
OSI(Open System Interconnection,开放系统互连)七层网络模型,是一个逻辑上的定义和规范。
| 特点 | 说明 |
|---|---|
| 分层 | 把网络从逻辑上分为 7 层,每层有对应物理设备 |
| 作用 | 帮助不同类型的主机实现数据传输 |
| 优点 | 将服务、接口和协议三个概念明确区分,理论完整 |
| 缺点 | 复杂又不实用 |
在实际工程中,会话层、表示层很难接入操作系统,最终落地的是 5 层协议。
2.3 TCP/IP 五层(或四层)模型
TCP/IP 是一组协议的代名词,还包括许多协议,组成了 TCP/IP 协议簇。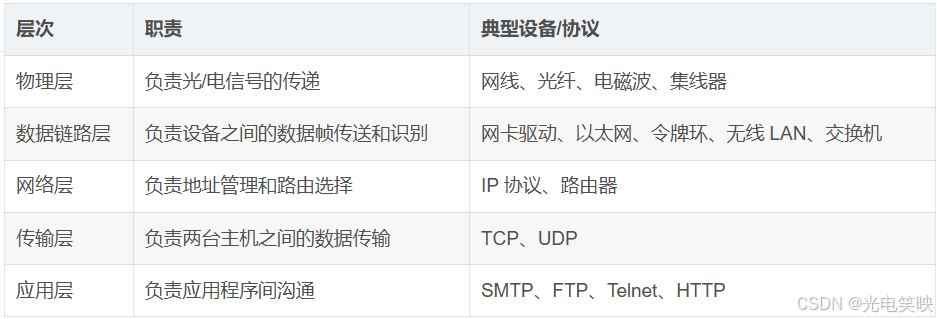
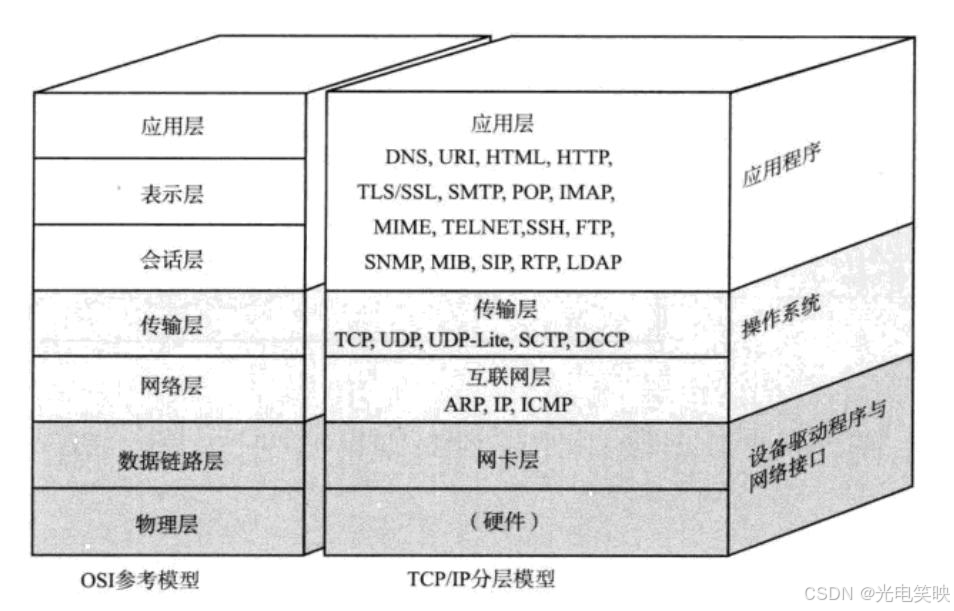 物理层考虑较少,很多时候直接称为 TCP/IP 四层模型。
不同设备实现的层次
| 设备 | 实现的层次 |
|---|---|
| 主机 | 传输层到物理层(操作系统内核实现) |
| 路由器 | 网络层到物理层 |
| 交换机 | 数据链路层到物理层 |
| 集线器 | 只实现物理层 |
并不绝对。很多交换机也实现了网络层转发;很多路由器也实现了部分传输层内容(如端口转发)。
3. 再识协议
3.1 为什么需要 TCP/IP?
本地通信 vs 网络通信
计算机内部设备与设备之间也需要交互,同样需要协议。
把你的计算机硬件拆成各个小零件:内存在东北,CPU 在西藏,磁盘在台湾,它们之间用长长的线连接组成了你的计算机。
-
内存与外设之间:I/O 总线
-
CPU 与内存之间:系统总线
计算机内部的硬件本身就构成了一个网络结构,冯·诺依曼结构也可以理解为一种网络。
网络通信本质也是设备到设备,唯一区别是距离变长了 。而距离变长,一定会带来新问题。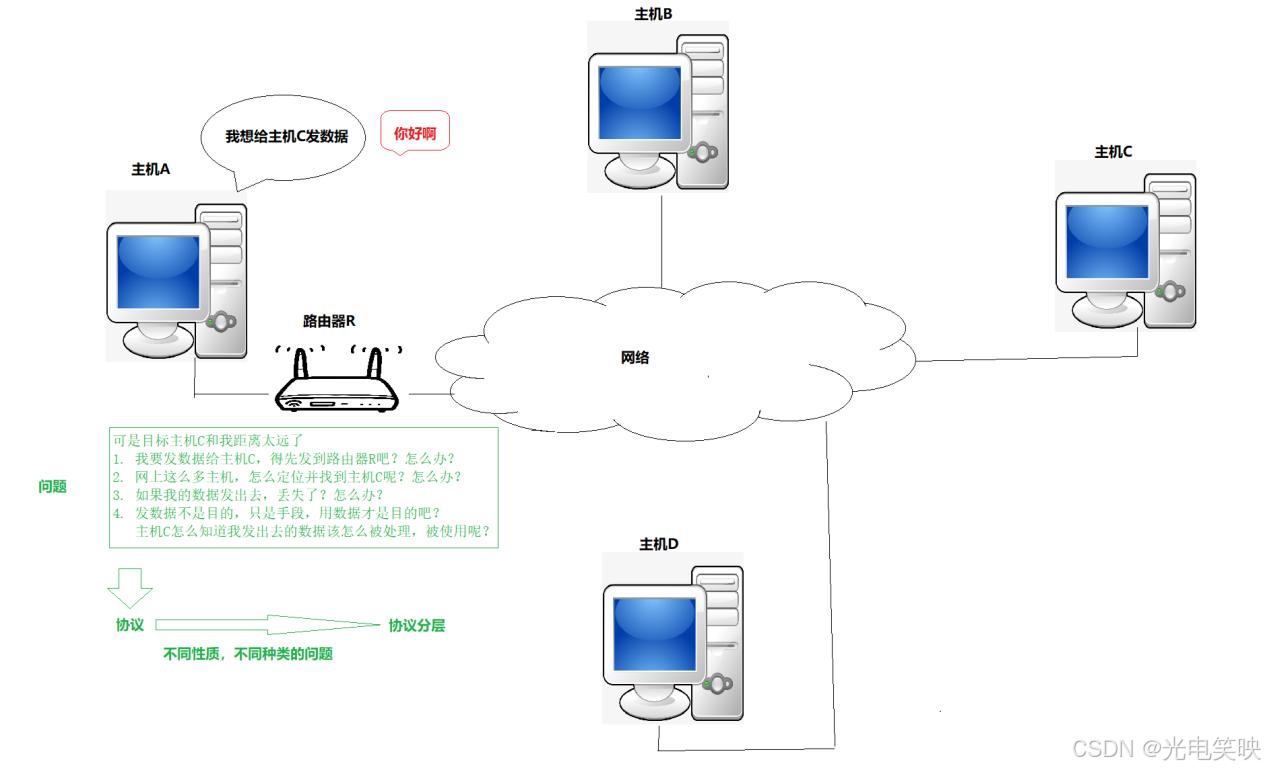
| 问题 | 对应层次 |
|---|---|
| 如何处理数据? | 应用层 |
| 数据丢了怎么办? | 传输层 |
| 怎么定位目标主机? | 网络层 |
| 怎么解决当下要去哪里? | 数据链路层 |
所以 TCP/IP 协议本质就是一种网络长距离通信的解决方案。
TCP/IP 能分层,前提是因为问题本身能分层。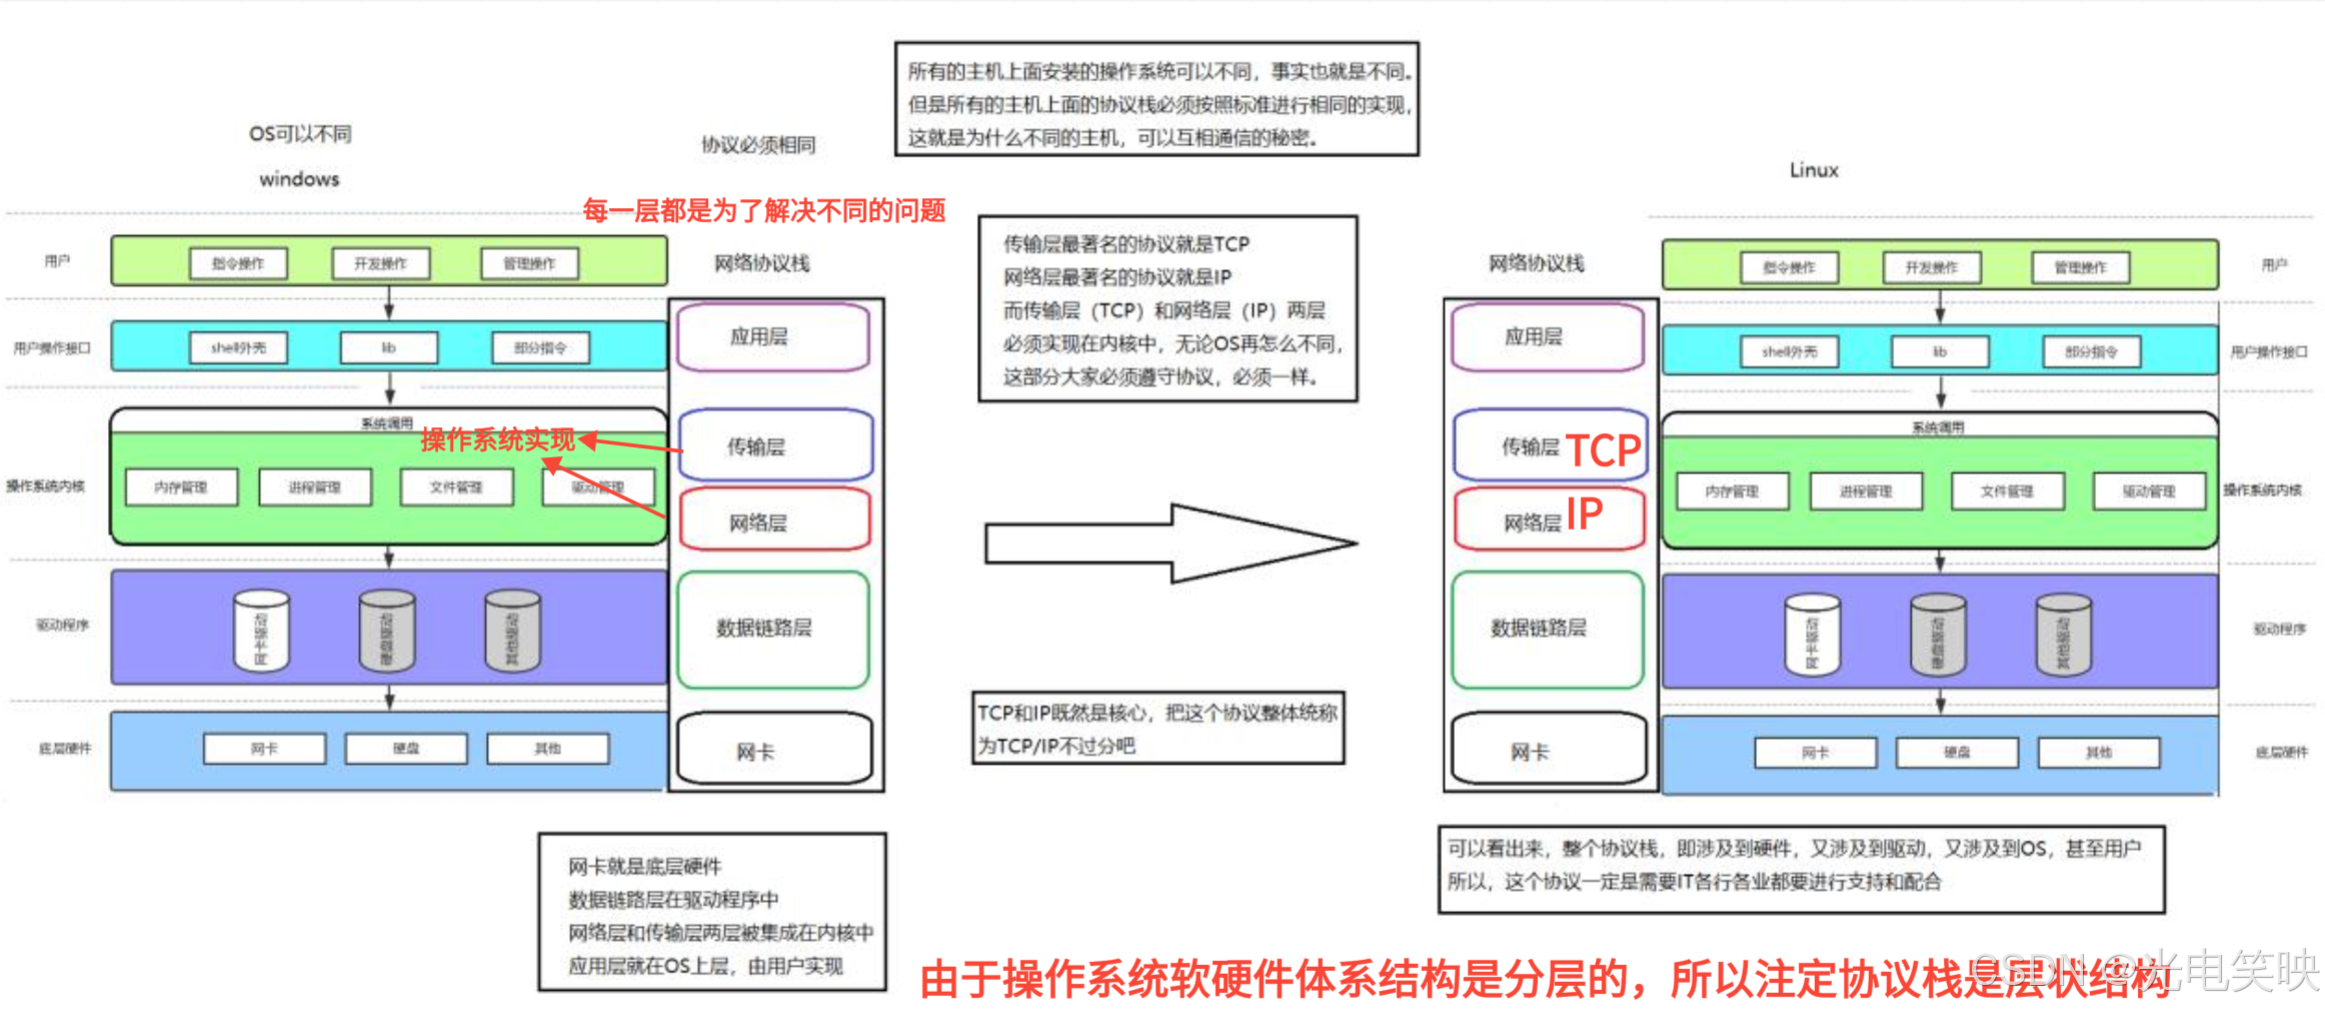
3.2 什么是协议?
到目前为止,我们还没接触过任何具体协议,但可以朴素理解协议了。
操作系统源代码一般都是用 C/C++ 写的。
主机 B 能识别 data,并且准确提取 a=10,b=20,c=30 吗?
答案是肯定的。因为双方都有同样的结构体类型 struct protocol。也就是说:
用同样的代码实现协议,用同样的自定义数据类型,天然就具有"共识",能够识别对方发来的数据,这不就是约定吗?
关于协议的朴素理解:所谓协议,就是通信双方都认识的结构化的数据类型,即约定好的结构体。
因为协议栈是分层的,所以每层都有双方都有的协议,同层之间互相可以认识对方的协议。
这也就解释了为什么 Linux 可以与 Windows 通信。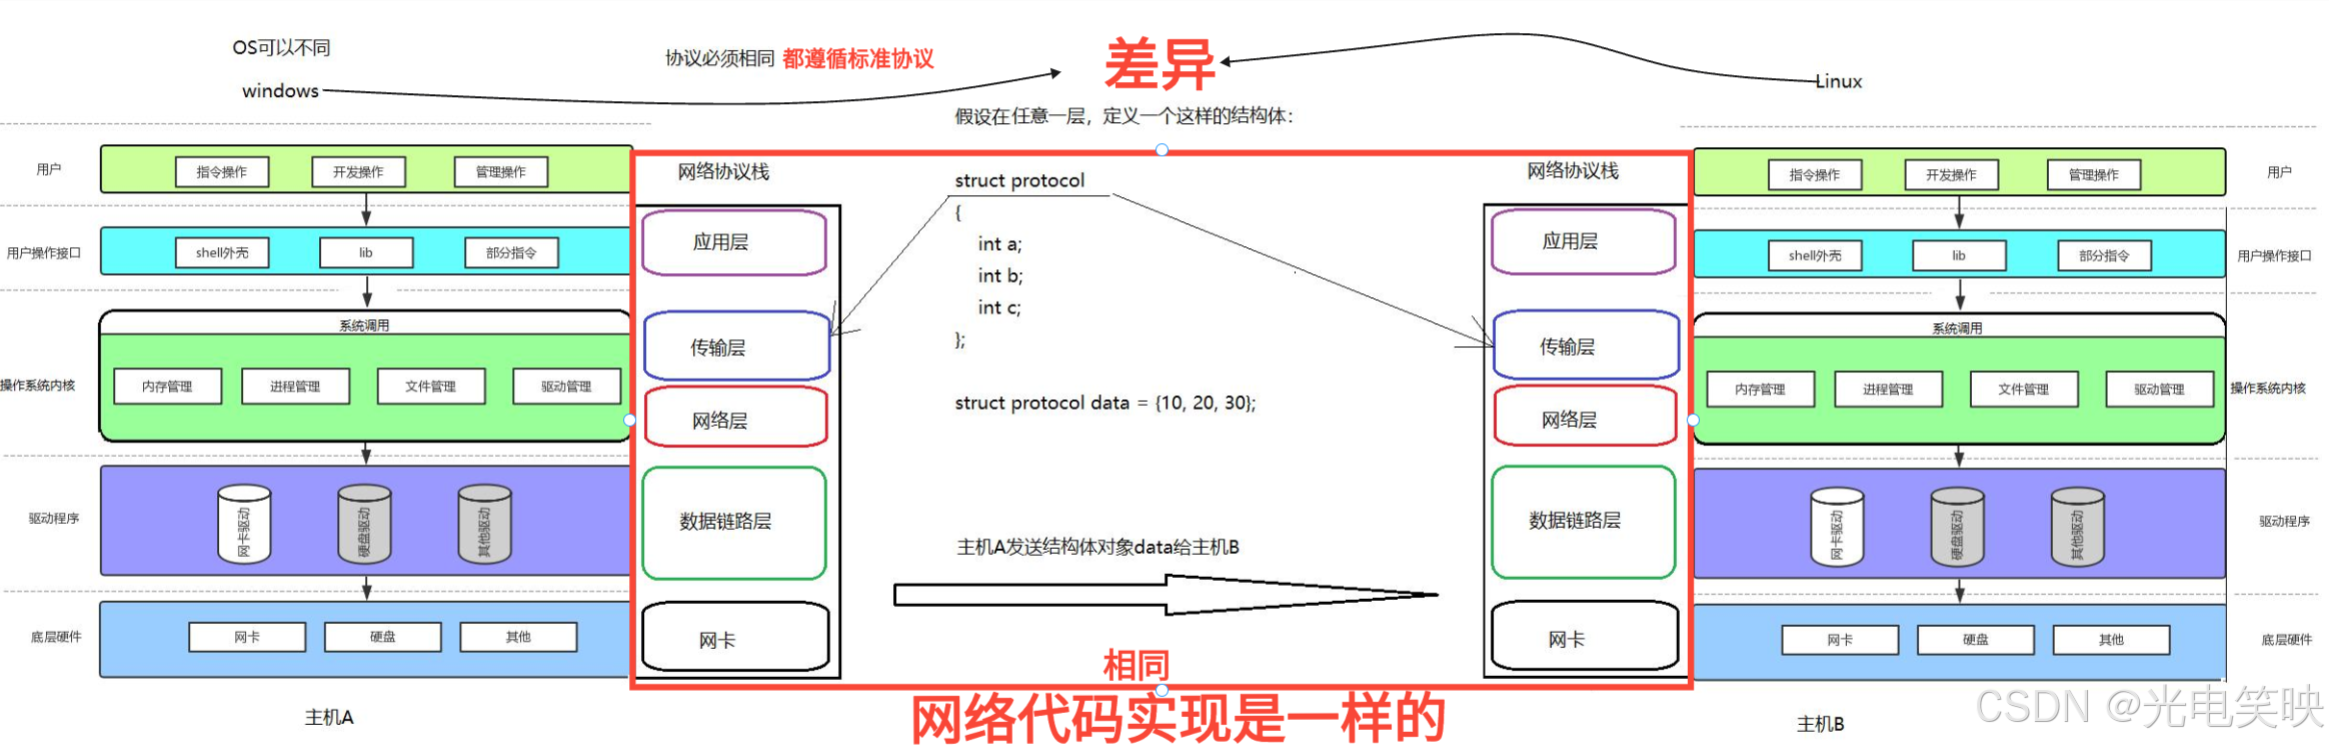
4. 网络传输基本流程
4.1 局域网通信原理
局域网(LAN)是指覆盖范围较小(如家庭、办公室、校园等)的网络,核心特点是高带宽、低延迟和私有管理。
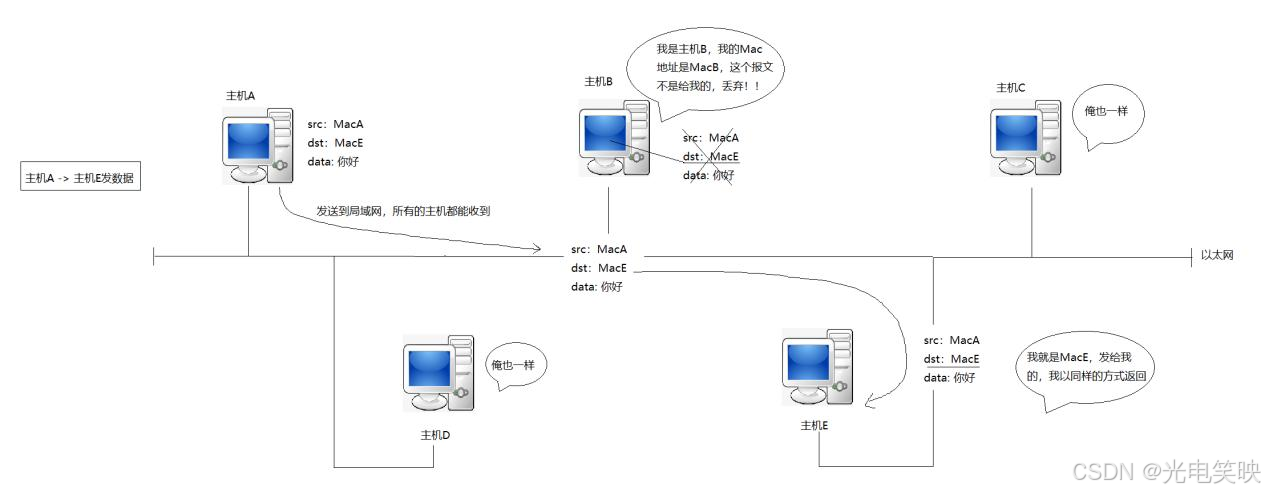
两台主机在同一个局域网,是否能够直接通信?
是的。
原理类似上课:
-
在一间教室里,多台主机可以直接通信。
-
老师叫张三站起来问:"你的作业为什么没写?"
-
李四、王五、赵六都听到了。
-
为什么他们不站起来?因为他们获取信息时发现叫的是张三,自己不是张三,于是把消息扔掉了。
所以,局域网通信的本质就是:
不断向局域网发消息,所有人都收到了,但会对消息进行判定,不是我的就丢弃。
发消息所有人都会收到,这个现象叫做泛洪。
更准确地说:在共享介质或交换机未知单播/广播时,会泛洪;主机网卡根据目的 MAC 过滤。
局域网协议
局域网发展是从计算机之间在小区域上的合作开始的。最初几乎每个区都有自己的协议,随着网络发展,很多区域之间也需要合作,于是需要统一协议。
很多协议被淘汰,只有少部分被保留下来,如:
-
以太网
-
令牌环网
-
无线 LAN
这些协议都在数据链路层。
以太网名字由来
以太网的"以太"借用了 19 世纪物理学中"光以太"的概念------一种看不见、无处不在的传播介质。
Metcalfe 用它来比喻数据在共享电缆中传播。虽然"以太"后来被物理学否定,但这个名字一直沿用至今。
令牌环网(简单了解)
令牌环网是一种局域网技术,核心思想是:用一张"令牌"控制谁有权发送数据,避免多台主机同时发数据造成冲突。
令牌环网里的"令牌",本质上就是一把网络层面的互斥锁。
MAC 地址
每台主机在局域网上,要有唯一的标识来保证主机的唯一性。
| 特性 | 说明 |
|---|---|
| 长度 | 48 位,即 6 个字节 |
| 表示 | 16 进制数字加冒号,如 08:00:27:03:fb:19 |
| 出厂 | 通常出厂时烧录在网卡 ROM 中 |
| 唯一性 | 通常唯一,但虚拟化或软件修改可能导致冲突 |
| 可变性 | 一般不变,但软件可以覆盖当前使用的 MAC |
注意:MAC 地址通常写死在网卡 ROM,但操作系统可以修改网卡当前使用的地址,不是物理改写 ROM。
数据碰撞与共享介质
如果很多台主机一起发数据会发生什么?
教室里不允许一对以上的通信。老师正在对张三说,此时李四又对王五说,那就乱成一锅粥了。
所以:
以太网中,任何时刻,只允许一台机器向网络发送数据。
如果多台同时发送,会发生数据干扰,称之为数据碰撞。
这也是一个网用的人越多就越卡的原因。以太网本质就是共享资源,具有互斥属性。
-
在一个子网中,入网主机增多,碰撞概率增加,丢包概率增加,单位时间内能发出去的报文减少,网速变慢。
-
没有交换机的情况下,一个以太网就是一个碰撞域。
-
所有发送数据的主机要进行碰撞检测 和碰撞避免。
抓包与混杂模式
主机对收到的报文确认是否是发给自己的,是通过目标 MAC 地址判定。
混杂模式是网卡的一种工作模式:
-
正常模式:网卡只接收目的 MAC 地址是自己的帧。
-
混杂模式:网卡会接收经过它的所有帧,不管目的 MAC 是谁。
简单说:"来者不拒,全都收下。"它是抓包、网络分析的基础。
4.2 同网段传输流程
局域网通信过程中,主机对收到的报文确认是否是发给自己的,是通过目标 MAC 地址判定。
从系统角度理解:
-
每台主机看成一个协议栈。
-
消息几乎都是用户发起的。
-
数据由用户层发起,贯穿协议栈,交给网卡。
-
对端主机网卡硬件先接收到报文,然后自底向上返回用户层,从而实现同层之间直接通信。
本质就是两个协议栈在通信。
传输过程中,每层都有协议,所以要进行封装 和解包。
类比线上购物:
-
下单后,实际送过来的并不是物品本身,而是有包装,比如快递盒/袋。
-
我们真正要的是物品本身,多出来的快递单就类似于协议报头。
为什么要自顶向下封装?
因为消息来源是用户,而实际发送数据是网卡,所以必须贯穿操作系统。
报头与有效载荷
-
报头:对应协议层的结构体字段。
-
有效载荷:该层报头除外的部分。该层并不关心前面几层加了什么报头,都看做一块数据。
-
报文 = 报头 + 有效载荷。
不同协议层对数据包有不同称谓:
| 层次 | 称谓 |
|---|---|
| 应用层 | 请求与应答 |
| 传输层 | 段(segment) |
| 网络层 | 数据报(datagram) |
| 链路层 | 帧(frame) |
封装与解包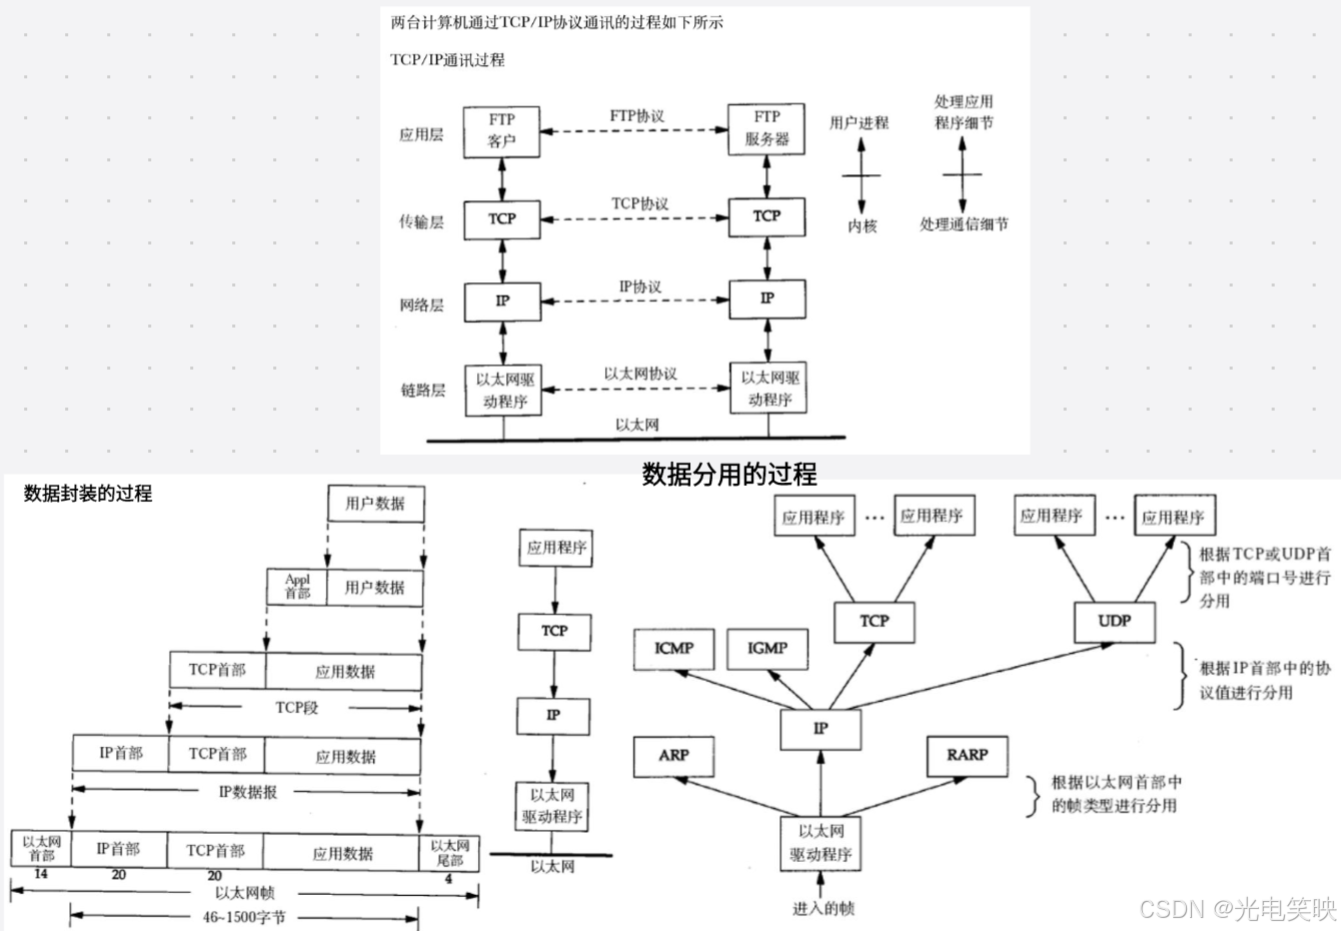
-
应用层数据通过协议栈发到网络上时,每层协议都要加上一个数据首部,称为封装。
-
首部信息中包含:首部有多长、载荷有多长、上层协议是什么等。
-
数据封装成帧后发到传输介质上,到达目的主机后,每层协议再剥掉相应的首部,根据首部中的"上层协议字段"将数据交给对应的上层协议处理,称为解包 与分用。
任何协议报头必须具备的两种能力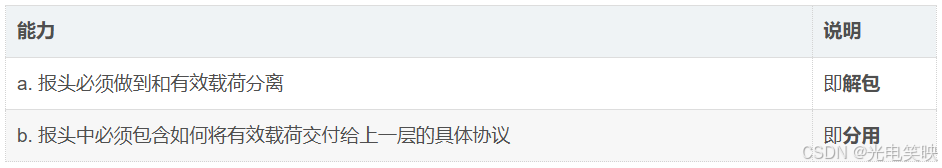
细节
-
链路层帧头包含源 MAC 和目的 MAC,主机根据目的 MAC 判断是否接收,不是自己的就丢弃。
-
整个数据的封装与解包过程,相当于入栈与出栈 。这也解释了为什么叫协议栈。
总流程:
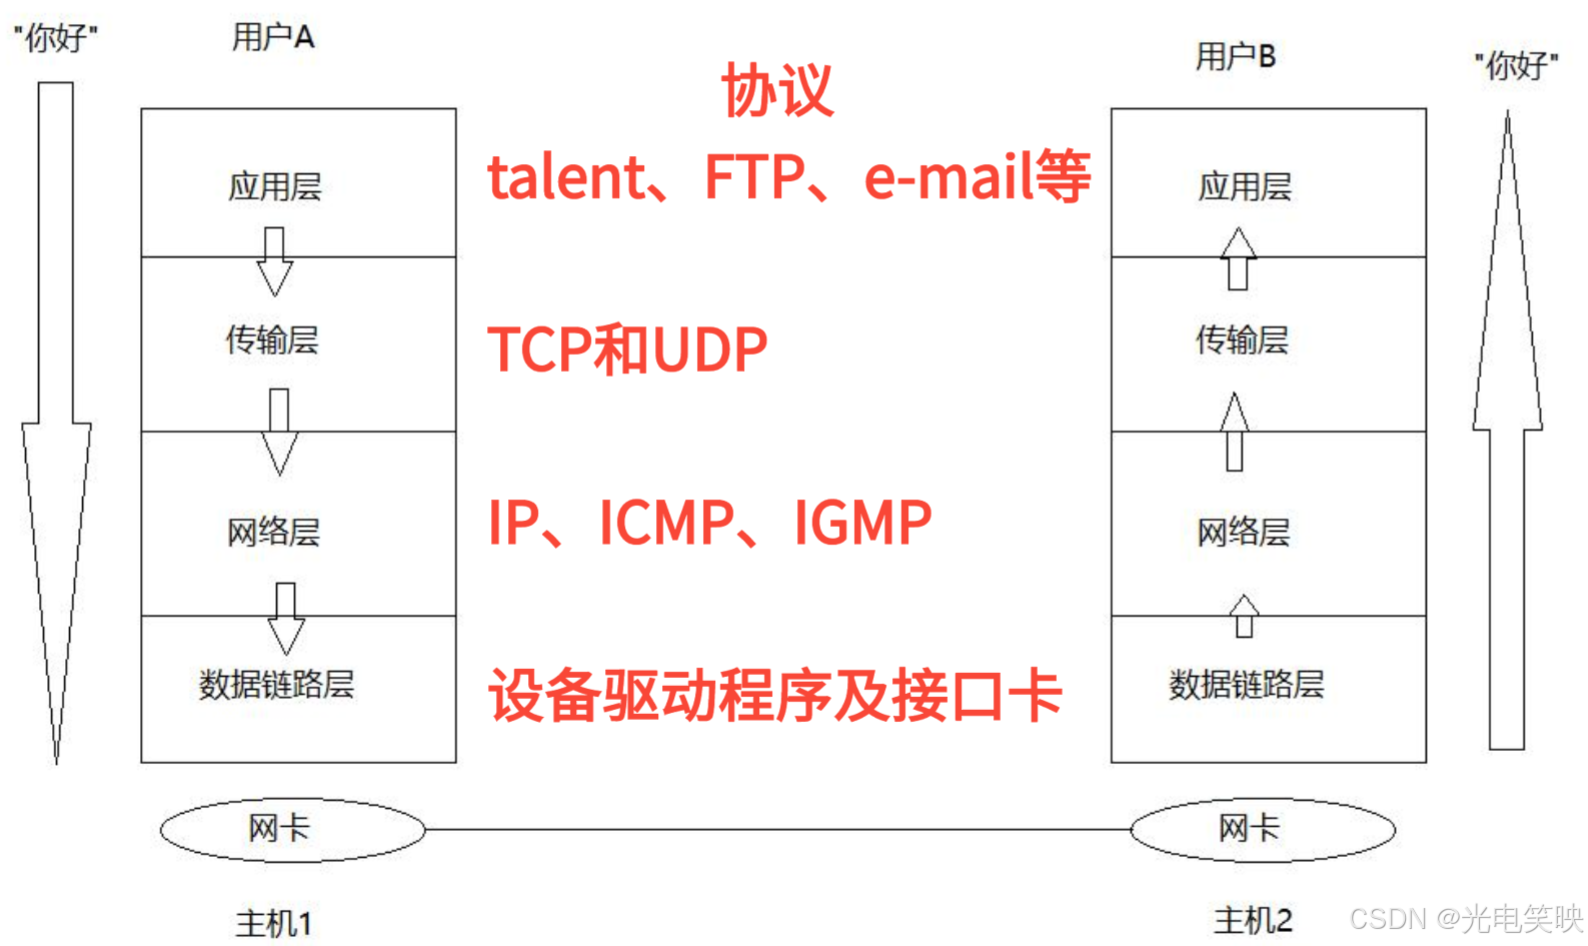
详细流程: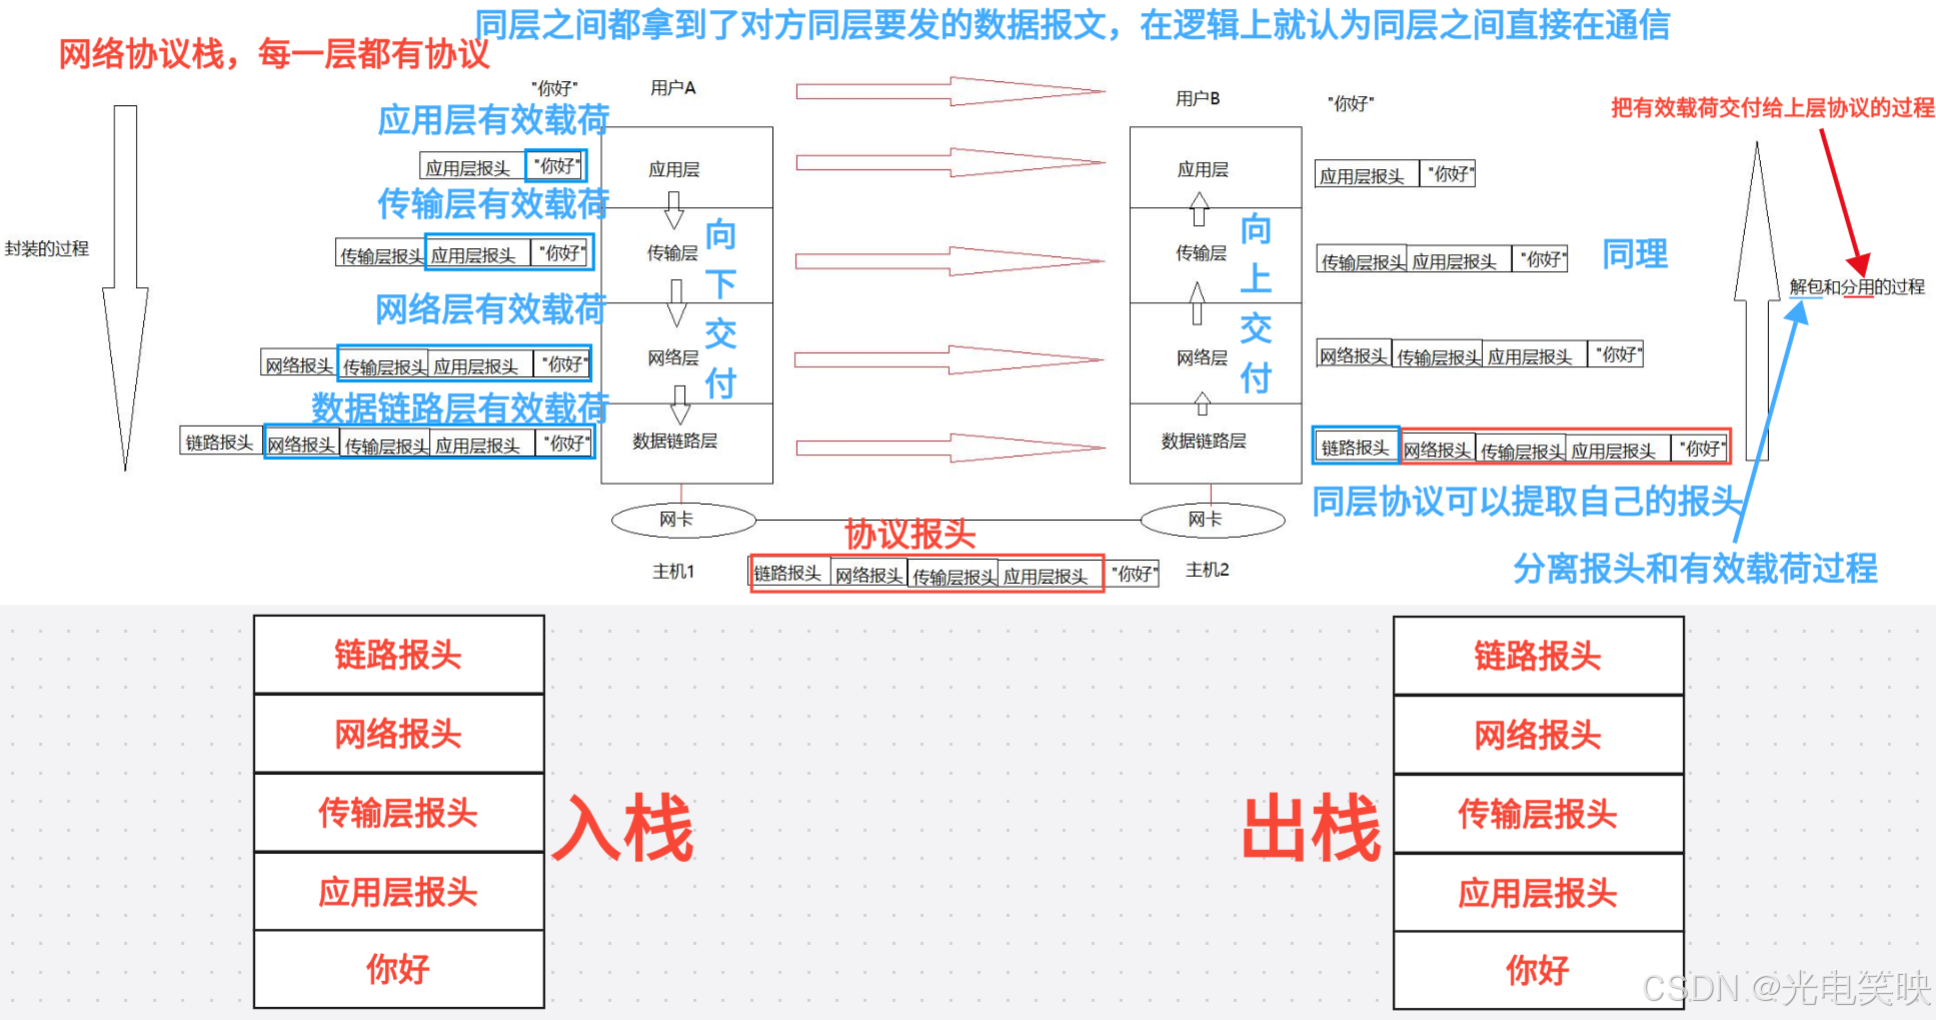
5. 跨网段传输流程
5.1 IP 地址 vs MAC 地址
刚才讲了 MAC 地址标识计算机的唯一性,现在怎么又来一个 IP 地址标识计算机的唯一性?
| MAC 地址 | IP 地址 |
|---|---|
| 物理地址,固化在硬件中 | 逻辑地址,可动态分配 |
| 用于同一局域网内的直接通信 | 用于跨网络的路由通信 |
| 数据链路层(OSI 第二层) | 网络层(OSI 第三层) |
生活类比:寄快递/旅行中转
IP 地址:负责全局寻址,标识通信的起点(源)和终点(目标),类似"出发地"和"最终目的地"。
例子:你要从北京寄一个包裹到纽约。包裹上的收件地址始终是"北京 → 纽约",这个最终目的地全程不变。
MAC 地址:负责局部寻址,标识每一段路程的直接上一站和下一站,类似"当前中转站"和"下一个中转站"。
例子:包裹不能瞬间飞到纽约,需要经过多个中转站:北京分拣中心 → 东京中转站 → 洛杉矶中转站 → 纽约配送站。每到一个中转站,工作人员会换上一张新的运输标签,上面写着"当前站"和"下一站"。每一段的起点和终点 MAC 地址都会变化。
具体通信过程类比
假设包裹路线:北京 → 东京 → 洛杉矶 → 纽约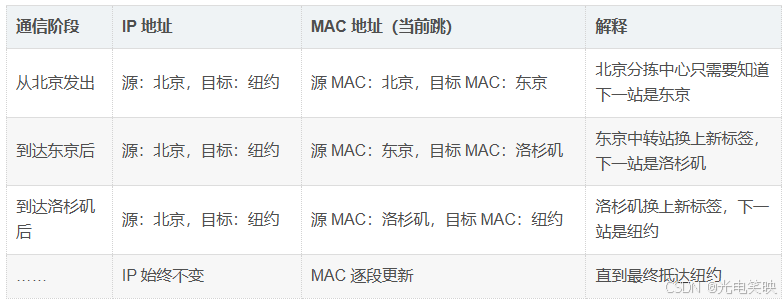
为什么需要两者?
IP 地址是逻辑上的全局定位,但实际网络中数据包需要经过多个设备(路由器、交换机),这些设备之间需要通过 MAC 地址在本地网络中准确传递数据。
就像包裹不能直接"瞬移"到纽约,必须依赖每一站的指引(MAC 地址),而 IP 地址保证它最终不会送错城市。
5.2 跨网段数据传输流程
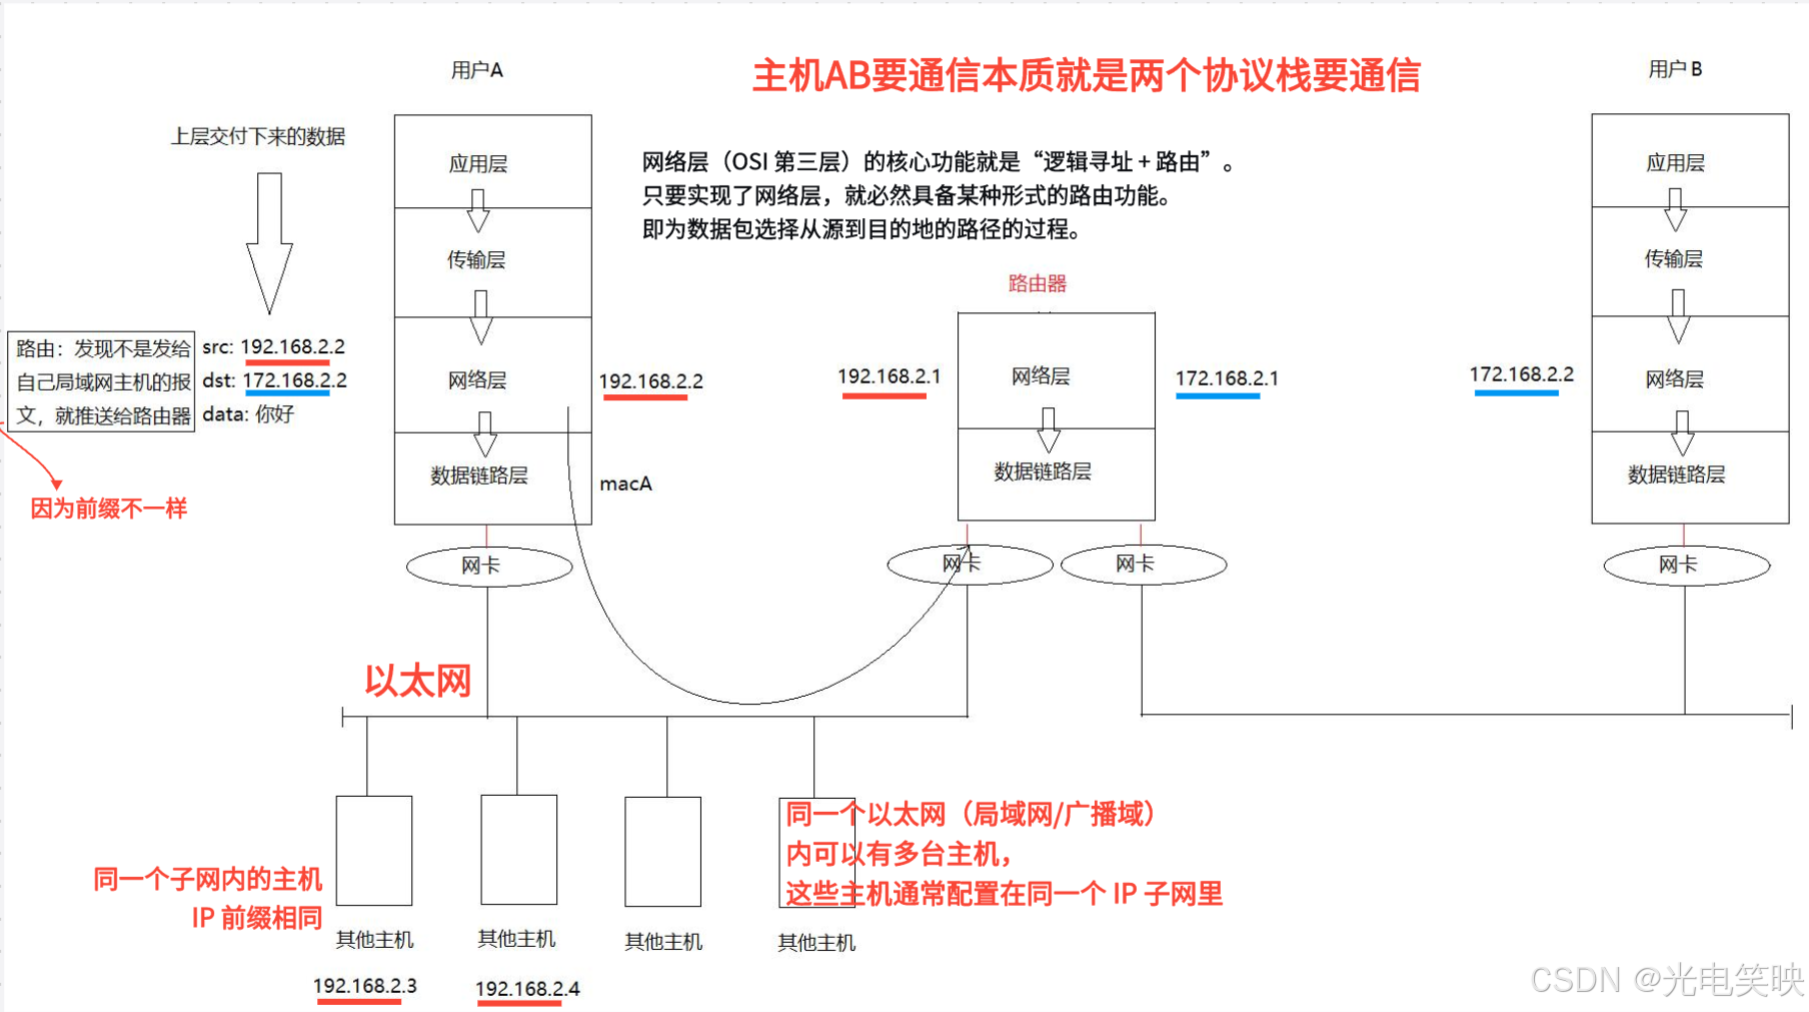
跨网段主机的数据传输,数据从一台计算机到另一台计算机传输过程中要经过一个或多个路由器。
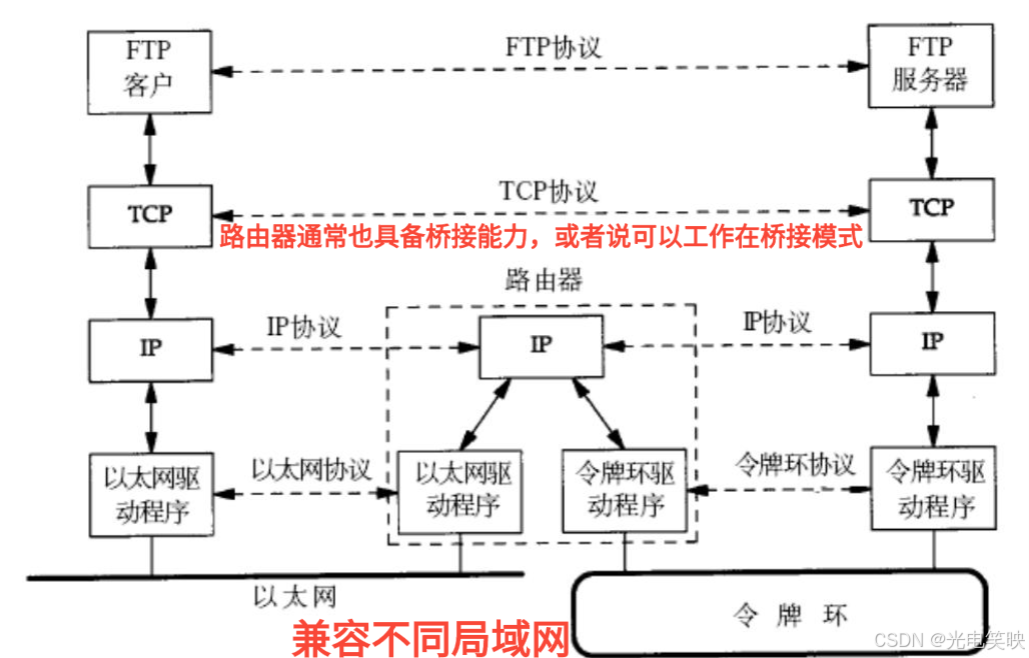
跨网段通信的本质就是:
IP 管全程,MAC 管每一段。
当主机发现目的 IP 不在自己子网时:
-
它不会直接发往目标,而是查路由表找到默认网关。
-
把数据包封装成帧------此时源 MAC 是自己,目的 MAC 是网关。
-
路由器收到后拆掉旧帧,取出 IP 数据包。
-
查路由表决定下一跳。
-
再用新的源 MAC 和下一跳的目的 MAC 重新封装发出去。
整个过程中:
-
源 IP 和目的 IP 从头到尾一个字都不变,它们标识的是最终通信的双方。
-
源 MAC 和目的 MAC 每经过一个路由器就换一次,它们只负责当前这一段链路把包交给谁。
就像寄快递:
-
收件地址(IP)始终不变。
-
每到一个中转站,运输标签(MAC)都会换成"从当前站到下一站"。
-
直到包裹抵达终点。
5.3 IP 与 MAC 在传输中的角色
注意到三个主机的网络层当中,三个主机收到的报文是一样的,而封装的 MAC 帧的源 MAC、目的 MAC 是被路由器重新替换转发的。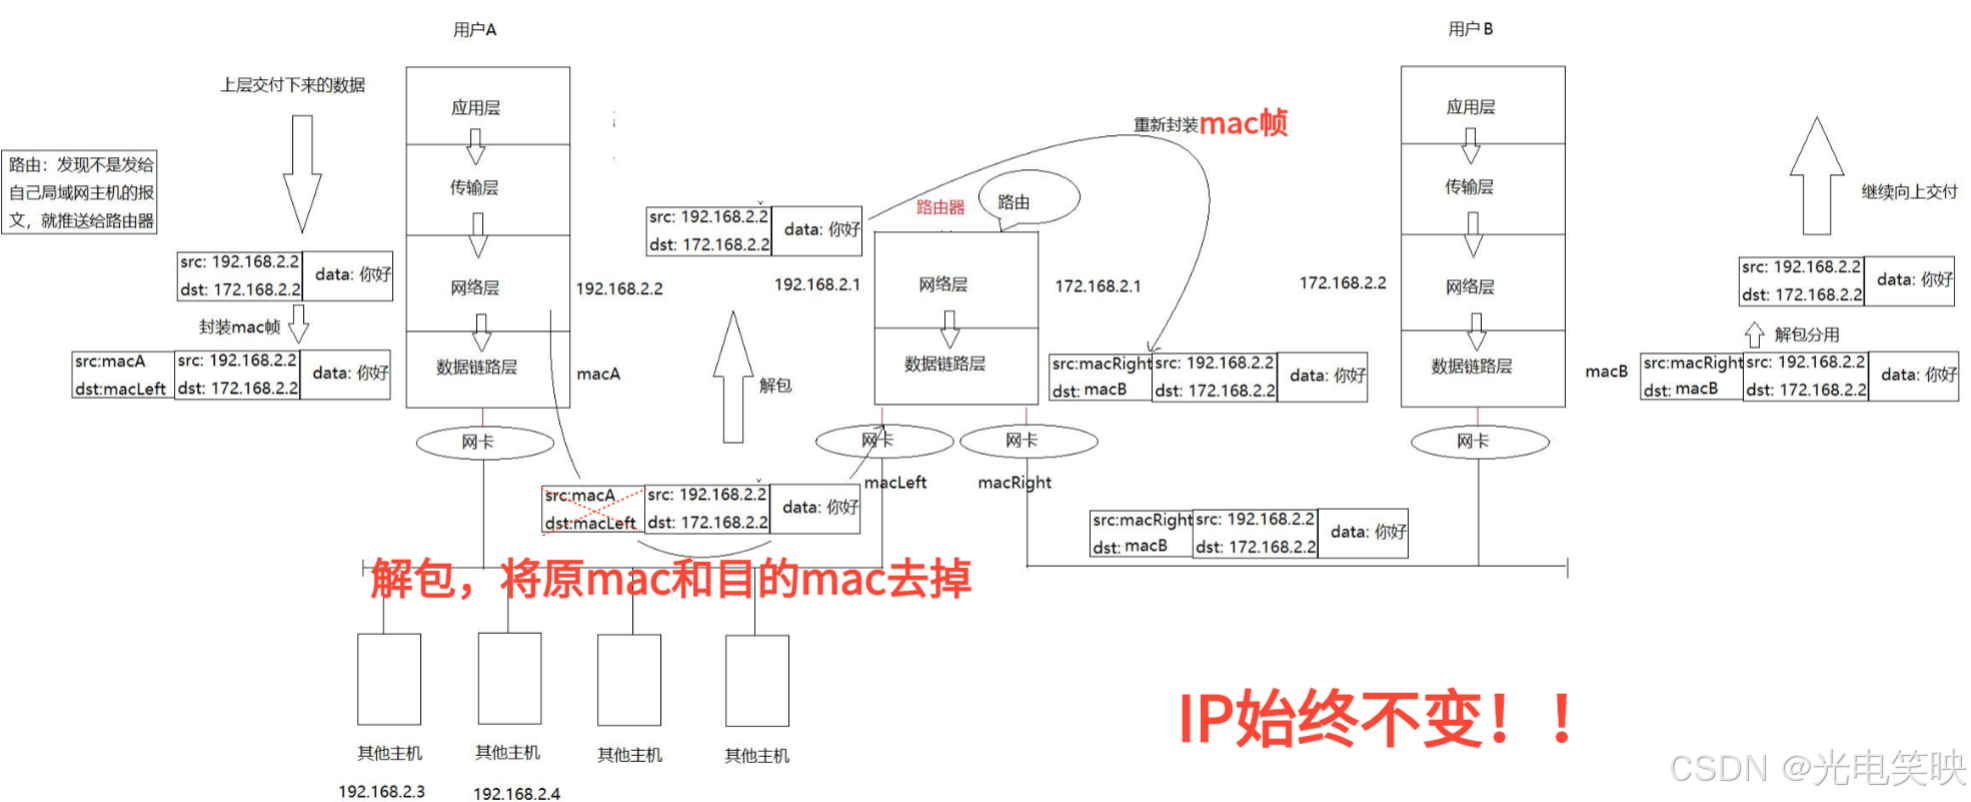
总结:
-
IP 地址不变,MAC 一直在变。
-
所以 MAC 地址只会在本局域网有效。
注意
-
改 MAC 改的是网卡当前使用的地址,不是物理改写 ROM。
-
"IP 一直不变"不是指"永远不变",而是指在一次跨网段通信的过程中,源 IP 和目的 IP 始终保持不变。
6. 网络层的意义:IP 虚拟化
6.1 底层差异被驱动屏蔽
不管是以太网、无线 LAN、令牌网,还是自定义通信,原理其实都不重要。只要把驱动搞好就行。
驱动的作用,就是把底层硬件差异屏蔽掉,向上提供统一的接口。
6.2 IP 层提供"虚拟化层"
提取出网络层 + IP 地址,就自然可以找到要去哪里了。
所以,网络层 + IP 提供了一层虚拟化层。
-
IP 协议规定了一套全球统一的逻辑地址(IP 地址)和统一的数据包格式(IP 数据报)。
-
不管底层是以太网、Wi-Fi 还是 5G,到了 IP 层,全都变成了统一的"IP 网络"。
-
IP 层就像在一个杂乱无章的物理世界之上,建立了一个逻辑上的、统一的虚拟网络。
-
路由器只认 IP 地址,不认底层硬件。
6.3 最终结果:"IP 网络"一统天下
因为 IP 层的这个虚拟化能力,它把全球各种不同的底层网络(局域网、广域网、城域网)粘合在了一起。
-
不管你是在用光纤、Wi-Fi 还是卫星通信,只要它们都支持 IP 协议,它们就能互联互通。
-
这就是为什么我们常说"IP over everything"和"everything over IP"。
-
最终,全世界最大的网络被命名为 Internet(互联网),本质上就是全球最大的 IP 网络。
6.4 补充:驱动搞好的前提
驱动搞好的前提,是硬件厂商和协议标准必须达成共识。
驱动可以屏蔽差异,但驱动自己得知道怎么和操作系统、怎么和 IP 层对接。
所以,网卡驱动必须遵循操作系统提供的网络接口规范,比如 Linux 的 net_device 结构体,这样 IP 层才能把数据包丢给驱动,驱动才能把硬件收到的数据交给 IP 层。
6.5 哲学与提炼
哲学:任何一个软件问题,都可以通过加一个软件层解决。
这也就解释了为什么要把网络层写到内核,因为网络层与驱动程序没关系。
提炼:IP 网络的意义和网络通信的宏观流程
主机 A 跨网传送到 B 主机的数据流动:
每经过一个路由器,就是不断的:
封装 → 解包 → 分用 → 封装 → 解包 → 分用 → ...... 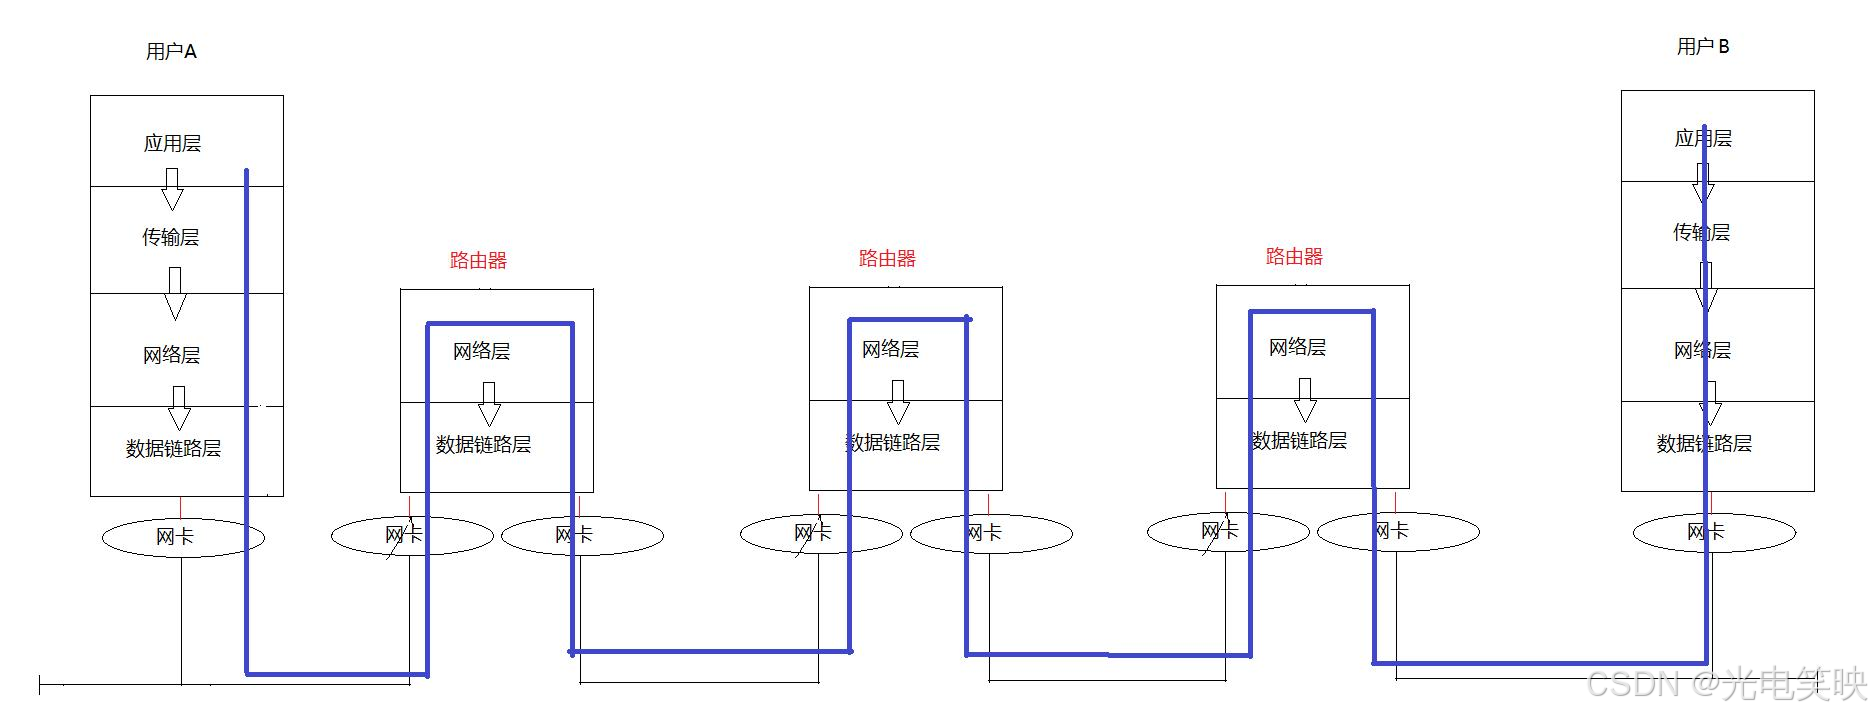
IP 网络层存在的意义
提供网络虚拟层,让世界的所有网络都是 IP 网络,屏蔽最底层网络的差异。
Socket 编程预备
1. 理解源 IP 地址和目的 IP 地址
IP 在网络中,用来标识主机的唯一性。
但这里要思考一个问题:数据传输到主机是目的吗?
不是。
因为数据是给人用的。聊天是人在聊天,下载是人在下载,浏览网页是人在浏览。但人是怎么看到聊天信息的?怎么执行下载任务的?通过启动的 QQ、迅雷、浏览器。
而这些程序都是进程。换句话说:
进程是人在系统中的代表,只要把数据给进程,人就相当于拿到了数据。
人与操作系统的交互唯一方式就是启动进程。所以我们使用计算机就是给计算机派发任务,而任务就是进程。
数据传输到主机不是目的,而是手段。到达主机内部,再交给主机内的进程,才是目的。
上网只有两种行为
| 行为 | 说明 |
|---|---|
| input | 从远端服务器获取数据 |
| output | 本地数据上传到远端服务器 |
网络通信的本质是 IO
对进程来说,网络通信本质上就是一种 IO 操作------和读写文件没有本质区别,只是设备从磁盘换成了网卡。
| 方向 | 对应 IO |
|---|---|
| 发送 | 输出 |
| 接收 | 输入 |
| 网卡 | IO 设备 |
| socket | 文件描述符 |
网络通信就是一次典型的 IO 过程。
为什么是进程间通信?
数据是由进程来处理的,进程在内存里,而数据要通过网卡收发。网络通信本质就是两个不同主机的进程在进行数据交互。
所以本质就是进程间通信。要进程间通信,就要让进程看到同一份资源:
| 通信方式 | 共享资源 |
|---|---|
| 管道 | 内核缓冲区 |
| 共享内存 | 物理内存段 |
| 消息队列 | 内核链表 |
| 网络 | socket |
网络中,这份"共享资源"就是 socket。
但是系统中同时存在非常多进程。数据到达目标主机后,怎么转发给目标进程?
2. 认识端口号
端口号(port)是传输层协议的内容。
| 特性 | 说明 |
|---|---|
| 长度 | 2 字节,16 位整数 |
| 作用 | 标识一个进程,告诉操作系统数据要交给哪个进程处理 |
| 范围 | 0 ~ 65535 |
端口号范围划分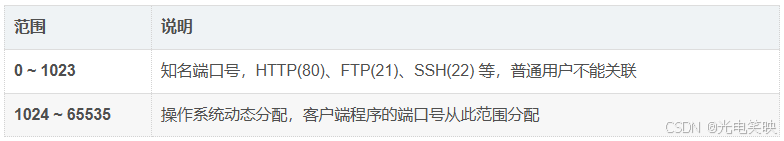
大致原理:数据怎么交给对应进程?
操作系统下层有网络协议栈,多个进程在 OS 上层。每个进程通过 socket 与端口关联,内核维护一张以端口为键的哈希表,用来快速定位 socket。
收到报文时,从链路层向上解包:
-
网络层:确认目的 IP 是本机
-
传输层:提取目的端口
-
根据端口查哈希表,找到对应的 socket
-
数据放入 socket 的接收缓冲区
进程调用 recv/read 时,数据从内核 socket 缓冲区 拷贝到进程用户态缓冲区。
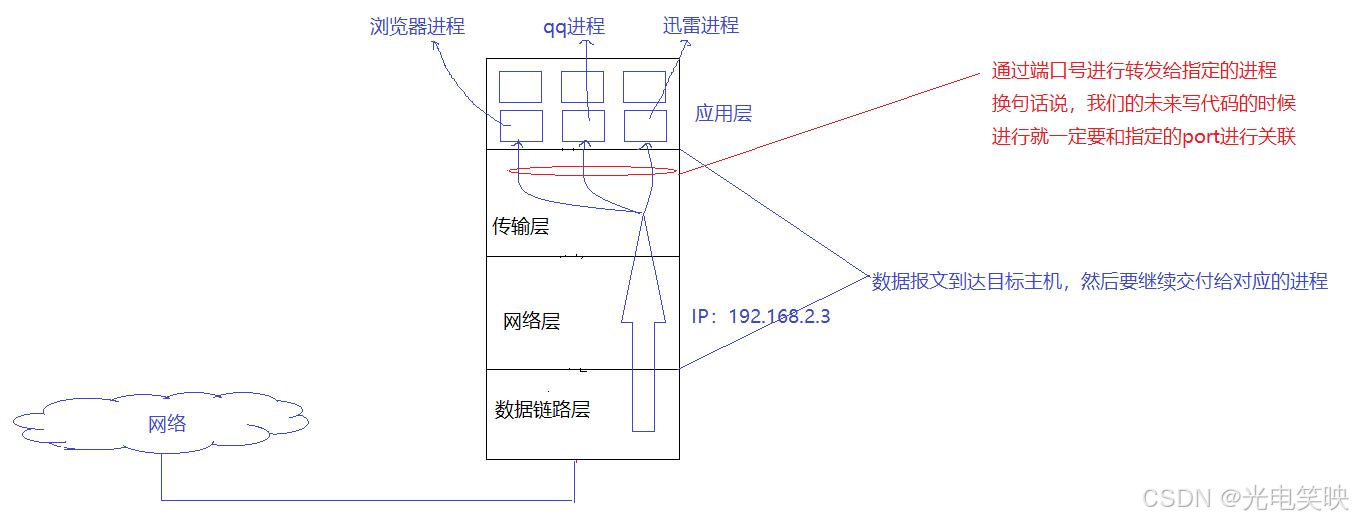
Linux 一切皆文件,socket 也是文件,有 fd,进程通过 fd 操作它。数据不是直接送到进程,而是先送到 socket 缓冲区,进程再主动读取。
两个细节
细节 1 :一个进程可以绑定多个端口号;但一个端口号不能被多个进程绑定。
细节 2 :虽然进程有 PID 标识唯一性,但不用 PID 做端口号,原因有二: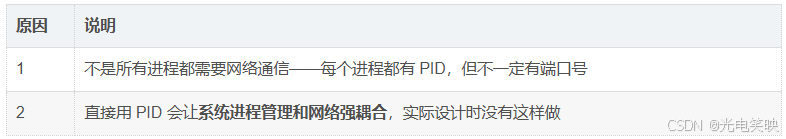
3. 理解 socket
IP 地址 + 端口号,能够标识网络上的某一台主机的某一个进程。
一个端口号只能被一个进程占用。
与 MAC 的原理类似,就有了:
{源 IP,源端口} 和 {目标 IP,目标端口}这样就建立了跨主机的网络通信。
网络通信的本质,就是全网唯一一对进程在进行进程间通信。 用对方的 IP + 端口表示对方的唯一性。
我们把 IP + 端口 叫做 socket(套接字)。
{srcIp, srcPort, dstIp, dstPort}这样的四元组,就能标识互联网中唯一的两个进程。
4. 传输层的典型代表
传输层属于内核。要通过网络协议栈通信,必定调用传输层提供的系统调用。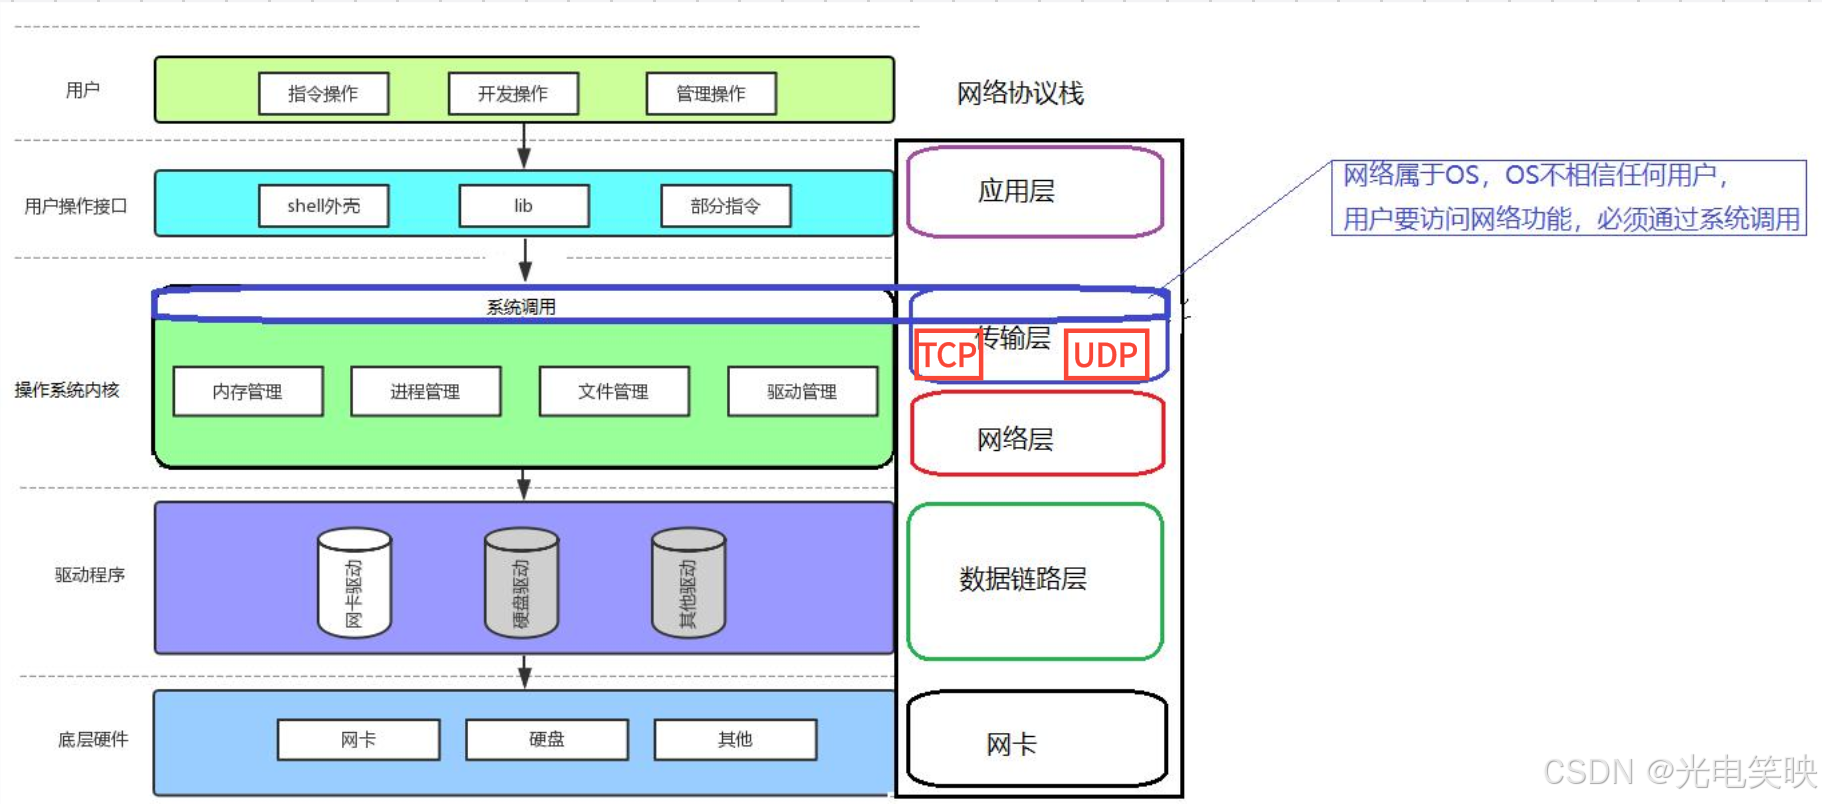
TCP 协议
| 特性 | 说明 |
|---|---|
| 传输层协议 | 是(其中一种) |
| 有连接 | 要先建立连接,类似打电话 |
| 可靠传输 | 丢数据或丢包会重传,有各种检测机制 |
| 面向字节流 | 像水龙头,要多少接多少,没有边界 |
UDP 协议
| 特性 | 说明 |
|---|---|
| 传输层协议 | 是(其中一种) |
| 无连接 | 不用建立连接,类似对讲机 |
| 不可靠传输 | 丢数据丢包就丢了不管 |
| 面向数据报 | 发快递,发 10 个就必须收 10 个,快递之间独立 |
可靠和不可靠是特点,不是缺陷和优势。 各有各的好处:
TCP 要保证可靠性,就要做更多工作
特别需要可靠性就用 TCP;允许少量丢包就用 UDP,简单、开发周期短、可维护性好
5. 网络字节序
大端与小端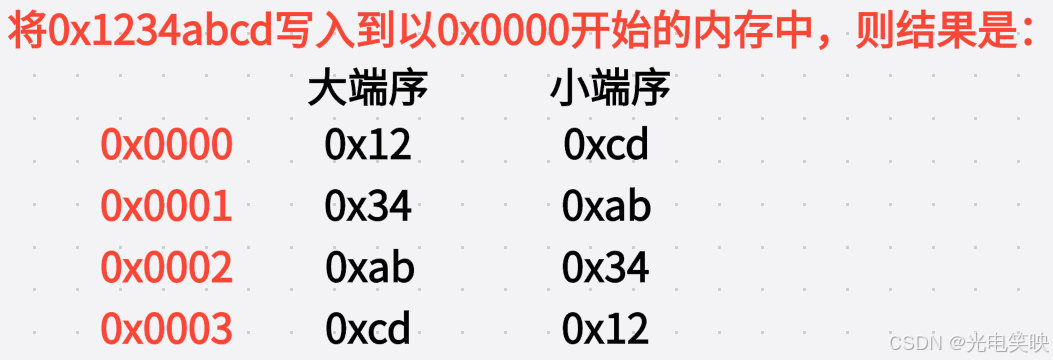
| 模式 | 说明 |
|---|---|
| 大端 | 低位字节存高地址,高位字节存低地址 |
| 小端 | 低位字节存低地址,高位字节存高地址 |
内存中的多字节数据有大端小端之分,磁盘文件中的多字节数据相对于文件偏移地址也有大端小端之分,网络数据流同样有大端小端之分。
网络数据流的地址规定
-
发送主机通常将发送缓冲区中的数据按内存地址从低到高的顺序发出。
-
接收主机把从网络上接到的字节依次保存在接收缓冲区中,也是按内存地址从低到高的顺序保存。
-
因此,网络数据流的地址规定:先发出的数据是低地址,后发出的数据是高地址。
-
TCP/IP 协议规定:网络数据流应采用大端字节序,即低地址高字节。
-
不管这台主机是大端机还是小端机,都会按照 TCP/IP 规定的网络字节序来发送/接收数据。
-
如果当前发送主机是小端,就需要先将数据转成大端;否则就忽略,直接发送即可。
字节序转换函数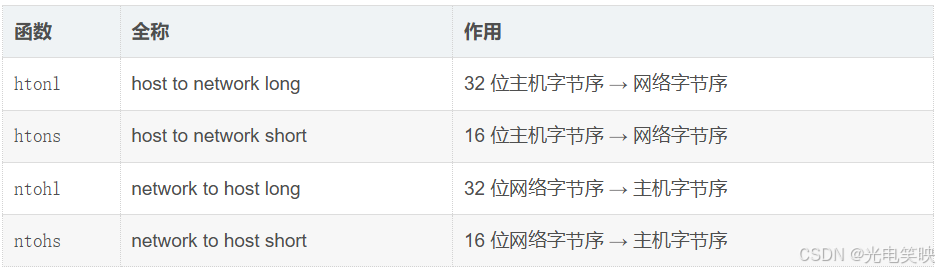
记忆:
h= host,n= network,l= long(32 位),s= short(16 位)。
-
如果主机是小端,这些函数做转换后返回。
-
如果主机是大端,这些函数不做转换,原封不动返回。
6. Socket 编程核心接口
1. socket --- 创建套接字
cpp
#include <sys/socket.h>

int socket(int domain, int type, int protocol);| 参数 | 说明 |
|---|---|
domain |
协议族:AF_INET(IPv4)、AF_INET6(IPv6)、AF_UNIX(本地) |
type |
类型:SOCK_STREAM(TCP)、SOCK_DGRAM(UDP) |
protocol |
通常填 0(自动选择) |
返回值 :成功返回 fd,失败返回 -1。
作用:创建一个套接字,返回 fd,后续用它操作网络通信。
2. bind --- 绑定地址和端口
cpp
int bind(int socket, const struct sockaddr *address, socklen_t address_len);| 参数 | 说明 |
|---|---|
socket |
socket 返回的 fd |
address |
地址结构体(IP + 端口) |
address_len |
地址结构体长度 |
返回值 :成功返回 0,失败返回 -1。
作用 :把套接字绑定到指定的 IP 和端口。服务器必须调用,客户端一般不用。
本质:把用户态的地址结构体传给内核,写入内核的 socket 数据结构中。
3. listen --- 开始监听
cpp
int listen(int socket, int backlog);| 参数 | 说明 |
|---|---|
socket |
已绑定的 fd |
backlog |
连接队列最大长度 |
返回值 :成功返回 0,失败返回 -1。
作用 :把套接字设为被动监听模式,等待客户端连接。仅 TCP 服务器使用。
4. accept --- 接收连接
cpp
int accept(int socket, struct sockaddr *address, socklen_t *address_len);| 参数 | 说明 |
|---|---|
socket |
监听套接字 fd |
address |
输出参数,返回客户端地址 |
address_len |
输入输出参数,地址长度 |
返回值 :成功返回新的 fd (与客户端通信),失败返回 -1。
作用 :从连接队列取出一个已完成连接的客户端,返回新套接字用于通信。仅 TCP 服务器使用。
监听 fd 继续监听,新 fd 用于和该客户端通信。
5. connect --- 建立连接
cpp
int connect(int sockfd, const struct sockaddr *addr, socklen_t addrlen);| 参数 | 说明 |
|---|---|
sockfd |
socket 返回的 fd |
addr |
服务器地址 |
addrlen |
地址长度 |
返回值 :成功返回 0,失败返回 -1。
作用 :向服务器发起连接(TCP 三次握手)。仅 TCP 客户端使用。
6. send / recv --- TCP 收发数据
cpp
ssize_t send(int sockfd, const void *buf, size_t len, int flags);
ssize_t recv(int sockfd, void *buf, size_t len, int flags);| 参数 | 说明 |
|---|---|
sockfd |
通信 fd |
buf |
数据缓冲区 |
len |
数据长度 |
flags |
通常填 0 |
返回值 :成功返回实际收发字节数,失败返回 -1。
7. sendto / recvfrom --- UDP 收发数据
sendto
cpp
ssize_t sendto(int sockfd, const void *buf, size_t len, int flags,
               const struct sockaddr *dest_addr, socklen_t addrlen);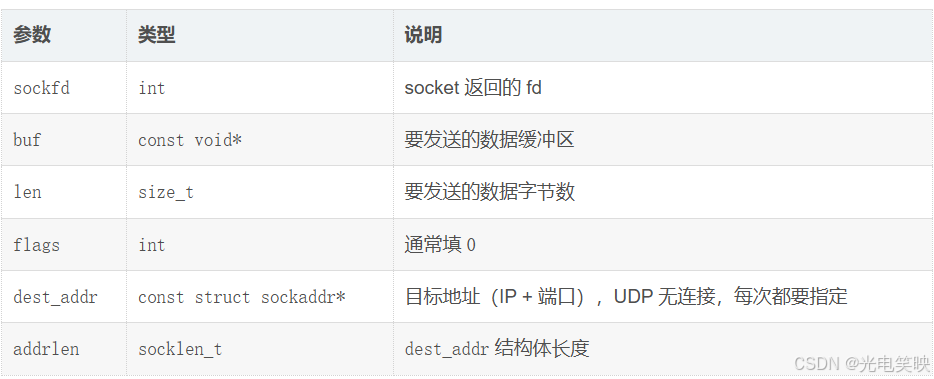
返回值 :成功返回实际发送字节数,失败返回 -1。
recvfrom
cpp
ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags,
                 struct sockaddr *src_addr, socklen_t *addrlen);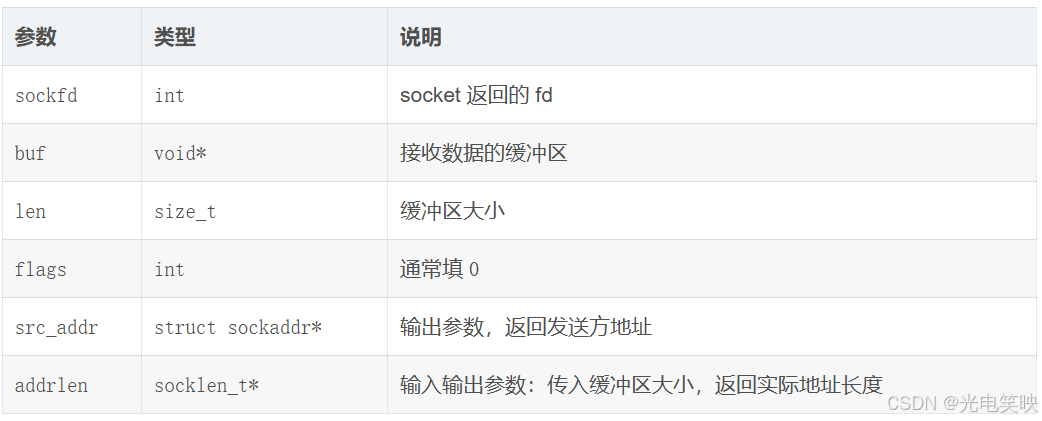
返回值 :成功返回实际接收字节数,失败返回 -1。
addrlen在recvfrom里是指针,因为内核要回填实际长度。
8. close --- 关闭套接字
cpp
int close(int fd);返回值 :成功返回 0,失败返回 -1。
本质:关闭 fd,释放 socket 资源。
7. TCP / UDP 通信流程
TCP 服务器
cpp
socket()   → 创建套接字
   ↓
bind()     → 绑定 IP + 端口
   ↓
listen()   → 开始监听
   ↓
accept()   → 接收连接(阻塞等待)
   ↓
recv/send  → 通信
   ↓
close()    → 关闭
TCP 客户端
cpp
socket()   → 创建套接字
   ↓
connect()  → 连接服务器
   ↓
send/recv  → 通信
   ↓
close()    → 关闭
UDP 服务器
cpp
socket()          → 创建套接字
   ↓
bind()            → 绑定 IP + 端口
   ↓
recvfrom/sendto   → 通信
   ↓
close()           → 关闭
UDP客户端
cpp
socket()          → 创建套接字
   ↓
sendto/recvfrom   → 通信
   ↓
close()           → 关闭
UDP &TCB对比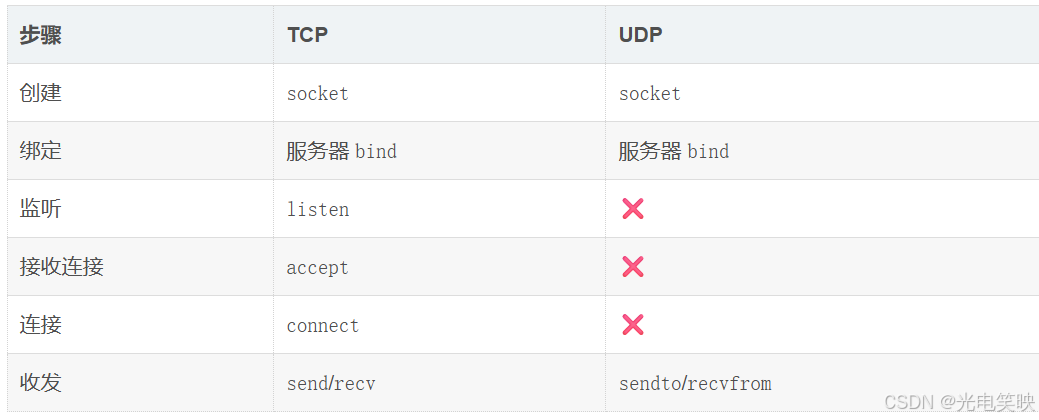
8. 对 IP 的处理
IP 地址转换函数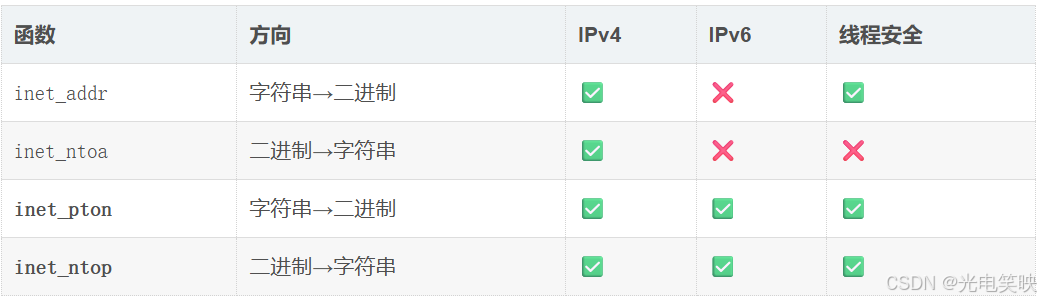
推荐用 inet_pton / inet_ntop。
正向:字符串 → 4 字节(inet_pton)
cpp
"192.168.1.1"
    ↓ 按 '.' 分割
["192", "168", "1", "1"]
    ↓ 每段转十进制整数(0~255)
[192, 168, 1, 1]
    ↓ 每个整数存为 1 字节
[0xC0, 0xA8, 0x01, 0x01]
    ↓ 拼成 4 字节(网络字节序,大端)
内存:C0 A8 01 01
逆向:4 字节 → 字符串(inet_ntop)
cpp
内存:C0 A8 01 01
    ↓ 取出 4 个字节
[0xC0, 0xA8, 0x01, 0x01]
    ↓ 每字节转十进制
[192, 168, 1, 1]
    ↓ 用 '.' 连接
"192.168.1.1"
核心要点
| 步骤 | 正向 | 逆向 |
|---|---|---|
| 1 | 按 . 分割 |
取出 4 字节 |
| 2 | 每段转整数 | 每字节转十进制 |
| 3 | 存为 1 字节 | 用 . 拼接 |
| 4 | 拼成 4 字节(网络序) | 得到字符串 |
inet_pton输出的已经是网络字节序,不需要再htonl。
9. socket 的三大类型
网络 socket
| 项 | 说明 |
|---|---|
| 通信域 | AF_INET / AF_INET6 |
| 用途 | 跨主机通信 |
| 标识 | IP + 端口 |
| 跨主机 | ✅ |
本地 socket
| 项 | 说明 |
|---|---|
| 通信域 | AF_UNIX / AF_LOCAL |
| 用途 | 同主机进程间通信 |
| 标识 | 文件路径 |
| 跨主机 | ❌ |
| 速度 | 更快(不走网络协议栈) |
原始 socket
| 项 | 说明 |
|---|---|
| 通信域 | AF_INET + SOCK_RAW / AF_PACKET |
| 用途 | 底层协议、抓包 |
| 权限 | 需要 root |
| 跨主机 | ✅ |
三种 socket 对应三种不同的通信层次和场景。
关于 System V 与 POSIX
| 标准 | 用途 |
|---|---|
| System V | 主要用来本地进程间通信 |
| POSIX | 主要用于网络通信,也能本地通信 |
这也是 System V 有点被淘汰的原因。
10. sockaddr 结构
为什么需要 sockaddr?
socket API 是一层抽象的网络编程接口,适用于各种底层网络协议,如 IPv4、IPv6、UNIX Domain Socket。
然而,各种网络协议的地址格式并不相同。socket 设计者只想提供一种通信接口 ,为了达到这个目的,就先定义了 sockaddr 结构。
通用结构体:sockaddr
cpp
#include <sys/socket.h>

struct sockaddr {
    sa_family_t sa_family;    // 地址族
    char        sa_data[14];  // 地址数据
};| 字段 | 说明 |
|---|---|
sa_family |
地址族,决定如何解析后面的数据 |
sa_data |
地址数据,不同协议族格式不同 |
sa_data只有 14 字节,格式不明确,实际编程中几乎不用它,而是用具体的地址结构。
具体结构体:sockaddr_in(IPv4)
cpp
#include <netinet/in.h>

typedef unsigned short int sa_family_t;

#define __SOCKADDR_COMMON(sa_prefix) \
    sa_family_t sa_prefix##family

struct sockaddr_in
{
    __SOCKADDR_COMMON (sin_);   // sa_family_t sin_family;
    in_port_t      sin_port;    // 端口,16 位,网络字节序
    struct in_addr sin_addr;    // IP,32 位,网络字节序
    unsigned char  sin_zero[8]; // 填充
};

typedef uint32_t in_addr_t;

struct in_addr
{
    in_addr_t s_addr;           // 32 位 IPv4 地址,网络字节序
};| 字段 | 说明 |
|---|---|
sin_family |
固定 AF_INET,位于偏移 0 |
sin_port |
必须用 htons 转网络字节序 |
sin_addr |
必须用 htonl/inet_pton 转网络字节序 |
sin_zero |
填充 8 字节,使结构体大小为 16,和 sockaddr 一致 |
__SOCKADDR_COMMON 宏
## 是 C 预处理器的 token 拼接运算符:
| 传入前缀 | 拼接结果 |
|---|---|
sin_ |
sin_family |
sun_ |
sun_family |
sin6_ |
sin6_family |
sa_ |
sa_family |
作用:为每种 sockaddr 结构体生成**统一类型、统一位置(偏移 0)**的地址族字段,保证可以安全强转。
sin_zero 的计算
cpp
16(sockaddr 大小)
 - 2(sa_family_t)
 - 2(in_port_t)
 - 4(in_addr)
= 8 字节
所以 sin_zero[8],正好把结构体填满到 16 字节。
内存布局对比
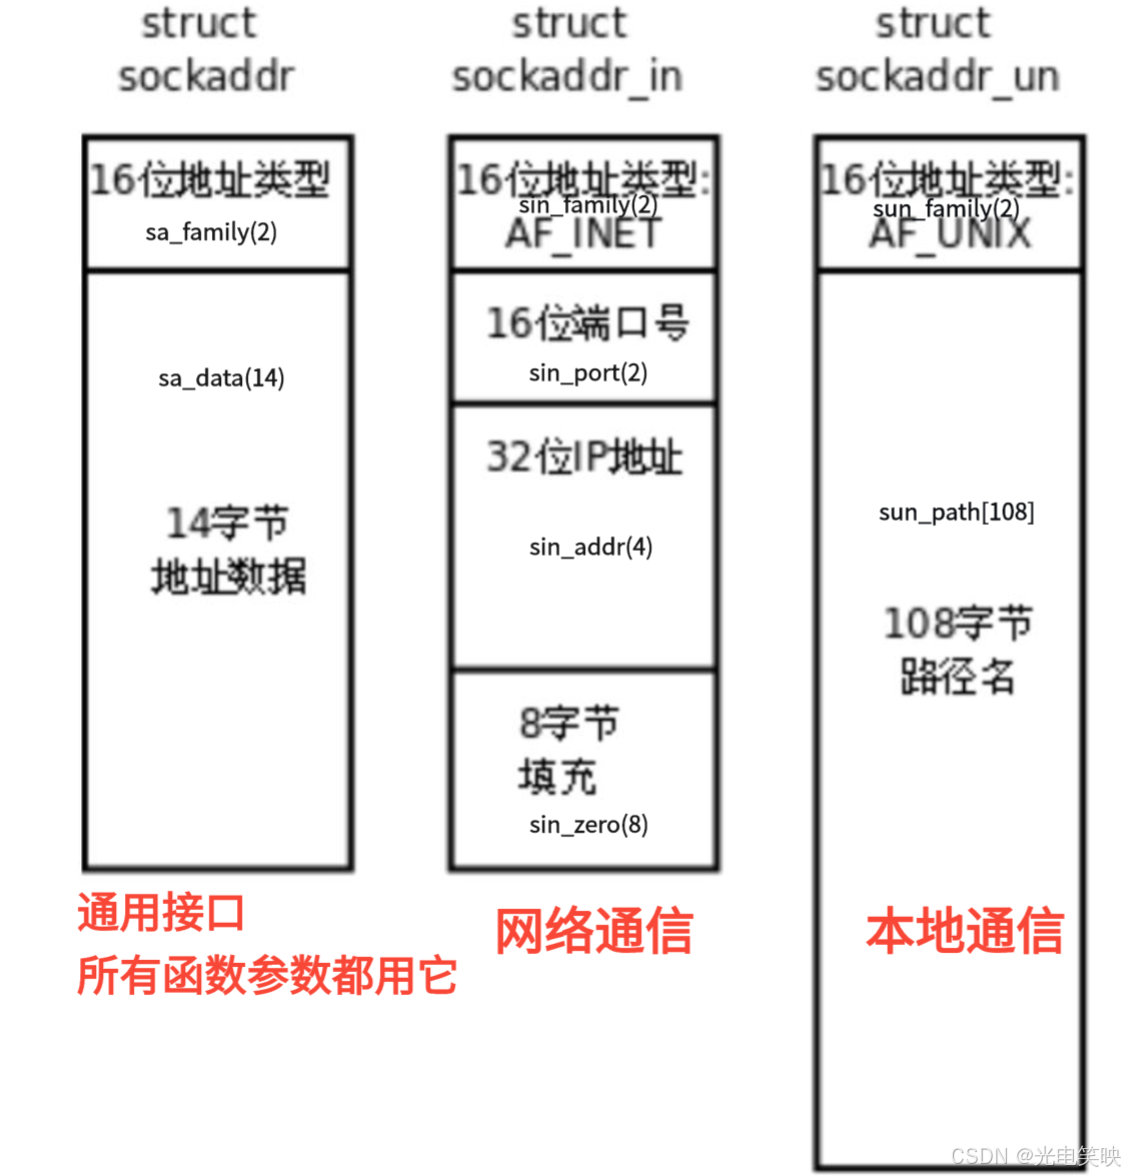
其他具体结构
| 结构体 | 协议族 | 用途 |
|---|---|---|
sockaddr_in |
AF_INET |
IPv4 |
sockaddr_in6 |
AF_INET6 |
IPv6 |
sockaddr_un |
AF_UNIX |
Unix 域套接字 |
sockaddr_ll |
AF_PACKET |
链路层原始套接字 |
使用示例
cpp
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
#include <string.h>

int main()
{
    int fd = socket(AF_INET, SOCK_STREAM, 0);

    struct sockaddr_in addr;
    memset(&addr, 0, sizeof(addr));
    addr.sin_family = AF_INET;
    addr.sin_port = htons(8080);
    addr.sin_addr.s_addr = htonl(INADDR_ANY);

    bind(fd, (struct sockaddr*)&addr, sizeof(addr));
    //       ↑ 强制转换
    return 0;
}
本质:继承多态的体现
从设计思想 看,sockaddr 就是继承多态 的体现;从语言机制 看,它是 C 语言在用内存布局手动模拟面向对象。
-
基类 :
struct sockaddr(通用接口,定义地址族sa_family)。 -
派生类 :
struct sockaddr_in(IPv4)、struct sockaddr_un(Unix 域)。 -
多态调用 :系统调用接口(如
bind、connect、accept)的参数全是struct sockaddr *,传入的可以是sockaddr_in也可以是sockaddr_un,系统在底层根据sa_family来决定怎么解析这块内存。
模拟"继承":首地址对齐 + 大小对齐
-
首地址字段对齐 :
sockaddr_in的第一个字段必须是sa_family_t sin_family,正好对应sockaddr的第一个字段sa_family。所以强转指针后,读取sa_family是完全安全的。 -
大小对齐 :
sockaddr设计成 16 字节,sockaddr_in正好也是 16 字节(用sin_zero[8]填充对齐)。这就保证了两者内存占位一样,可以安全互相拷贝。
模拟"多态":标签判断 + 手动转换
C++ 的多态是"运行时自动查虚函数表"。C 语言的多态是:内核源码里根据 sa_family 写 if/else 或者 switch,手动转成具体的结构体。
cpp
int bind(int fd, struct sockaddr *addr, socklen_t len) {
    switch (addr->sa_family) {
        case AF_INET:
            struct sockaddr_in *in = (struct sockaddr_in *)addr;
            break;
        case AF_UNIX:
            struct sockaddr_un *un = (struct sockaddr_un *)addr;
            break;
    }
}
对比 C++ 继承多态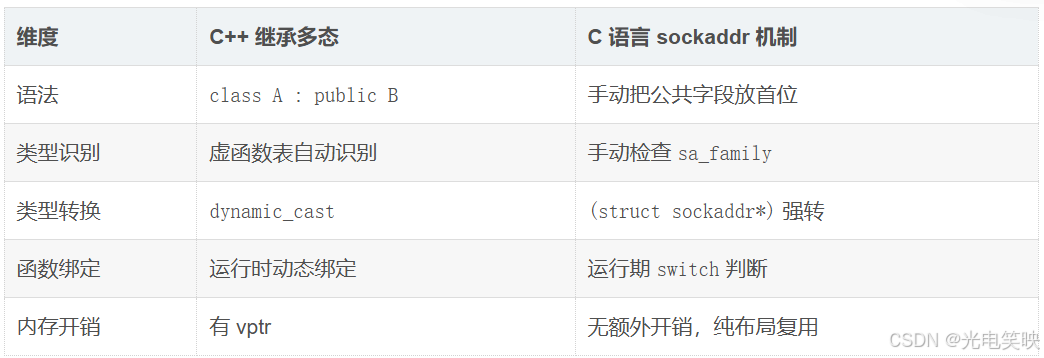
11. 总结
核心概念
| 概念 | 说明 |
|---|---|
| IP | 标识主机 |
| 端口 | 标识进程 |
| socket | IP + 端口,标识网络上的通信端点 |
| 四元组 | {srcIp, srcPort, dstIp, dstPort},全网唯一一对进程 |
核心接口
| 接口 | 作用 |
|---|---|
socket |
创建套接字 |
bind |
绑定 IP + 端口 |
listen |
开始监听 |
accept |
接收连接 |
connect |
发起连接 |
send/recv |
TCP 收发 |
sendto/recvfrom |
UDP 收发 |
close |
关闭 |
网络通信的本质,是全网唯一一对进程在进行进程间通信 。IP + 端口标识这对进程,socket 是它们的通信端点。TCP 有连接可靠,面向字节流;UDP 无连接不可靠,面向数据报。字节序统一用大端,IP 用
inet_pton/inet_ntop转换,地址用sockaddr系列结构体表示------C 语言用内存布局手动模拟了继承多态。