把 KES 集群交给 Kubernetes 的九十天:一个 DBA 的试用实录
第 0 天:一个押上睡眠质量的决定
先交代背景。我在团队里负责十多套金仓 KES(KingbaseES)数据库集群的运维,主备流复制架构,跑在虚拟机上。这套体系我们维持了几年,谈不上优雅,但胜在熟悉------每台机器的脾气、每个实例的参数、每份应急预案的位置,都在心里有一本账。
变化来自两个方向。一是公司基础架构全面转向 Kubernetes,业务应用一批批迁入,平台组开始追问"数据库什么时候跟上";二是我们自己的痛感在累积:凌晨的告警、扩容时的跨部门协调、永远背在身上的备份检查清单。这两股力量推着同一个问题浮出水面:数据库集群,敢不敢交给 Kubernetes 管?
坦白说,我一开始是抗拒的。数据库跟普通应用不一样,这话我对平台组说过不止一次。但你抗拒一样东西的时候,最好先搞清楚它到底行不行------于是我们决定,拿出测试环境,认真试用九十天,用电科金仓新发布的 KES K8s 运维工具 KES-Operator,看看"声明式管理数据库集群"到底是营销话术,还是真的能落地。
为了让这次试用有说服力而不是走过场,我们在开始前先立了规矩,把九十天拆成四个验证目标:第一,能不能部署 ------一个没碰过 KES 的平台组同事,仅凭配置文件能否独立拉起一套集群;第二,能不能自愈 ------制造实例级故障,看系统在没有人工介入的情况下能否恢复;第三,能不能弹性 ------在业务高峰前完成扩容、高峰后完成缩容,且不影响存量业务;第四,能不能兜底------备份任务的创建、执行、核查是否形成闭环。四个目标,分别对应数据库运维的四个命门。事后来看,这个拆解方式也建议你照抄:验证一个新运维体系,最忌讳的就是"用着看",没有明确的验收标准,试用就会沦为走过场。
这九十天的记录,就是这篇文章。
第 1 天:先看图纸,再谈施工
我的习惯是,动任何新东西之前,先把架构图看明白。KES-Operator 的整体架构是这样的:
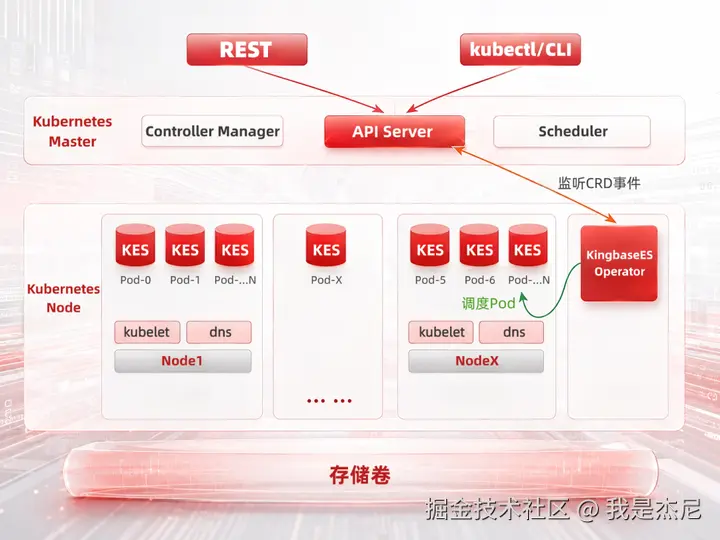
看懂这张图之前,得先回答一个前置问题:Kubernetes 自己不是有 StatefulSet 吗?为什么还需要一个专门的 Operator?
答案是分工不同。StatefulSet 解决的是"身份"问题 ------给每个 Pod 一个稳定的编号、一块专属的盘、一个可预期的网络名,这是数据库在 K8s 上存活的前提。但 StatefulSet 不懂数据库:它不知道主备复制怎么搭、不知道新节点入伙前要先追平数据、不知道故障后谁是主谁接替。Operator 补的正是这块认知------它把数据库领域的运维知识写成了代码,以控制器的身份常驻集群。两者的关系,一个管"身体",一个管"大脑"。理解了这一层,再看这张架构图就非常顺了:
从上往下看四层,我当时的理解过程是这样的:
最上面是入口:REST API 和 kubectl/CLI。看到这两个入口我第一反应是松了口气------意味着操作数据库集群和操作普通 K8s 资使用的是同一套 API Server,我们现有的自动化工具链不用另开炉灶。
中间是 Kubernetes 原生控制平面 :Controller Manager、API Server、Scheduler,一个不少。这张图传递的关键信息是:KES-Operator 没有"魔改"Kubernetes,它自己就是集群里的一个普通工作负载,靠监听 CRD 事件来感知用户的配置变更,通过"调度 Pod"来落实这些变更。它是融入者,不是颠覆者。 这一点很重要------意味着所有 K8s 原生的能力(调度、自愈、RBAC 权限、审计)对 KES 集群照样生效。
往下是数据平面 :KES 的各个数据库实例以 Pod 形态分布在多个 Node 上,每个 Node 由 kubelet 管容器生命周期、dns 管服务发现。图里 Pod 的编号是有序的------Pod-0、Pod-1、Pod-2 这样排下去。这个细节值得多说一句:数据库节点要的是"身份",Pod 原生给的是"匿名",每次重启 IP 和主机名都可能变,而流复制拓扑要求备节点永远找得到主节点。StatefulSet 的稳定编号标识,正是解这个死结的钥匙。
最底下是存储:数据落在独立的存储卷上,Pod 销毁重建不影响数据,重建后重新挂回原卷,一切照旧。
看懂这张图,我给团队总结了三句话:用户声明期望状态,Operator 负责对齐,K8s 原生机制负责执行。 声明式管理不是我告诉系统每一步怎么走,而是我只说终点,路径它自己找------哪怕中途出了岔子,它也会把系统重新拽回我声明的样子。
这有点像开车:过去我们是全程手握方向盘的老司机,现在副驾坐了一个不知疲倦的自动驾驶系统,而我们要做的,只是把目的地说清楚。
第一周:三份 YAML,一条命令
第一周的实操从部署开始,上面这组动图是当时的完整记录。
登录 K8s 管理节点(终端里能看到这是 k8s-204,对应 KingbaseES V009R001C010PS009 x86_64 的部署目录),ls 一下目录,三个文件整整齐齐:
all_crd.yaml------注册自定义资源定义,让 Kubernetes 认识"KES 集群"这个新概念;kingbase_deploy.yaml------集群部署清单:几节点、什么版本、多大存储,全写在这里;kingbase_backup.yaml------备份配置,一并声明。
然后 kubectl apply,回车,结束。
之后发生的事,我们全程围观:API Server 登记集群声明,Operator 监听到事件开始调谐,StatefulSet 和存储卷被自动创建,Scheduler 把各个数据库 Pod 分配到合适的节点,kubelet 拉起容器,KES 实例初始化,主备复制关系自动建立,服务就绪。
说一个数字对比。同样的集群,在虚拟机时代我们的部署手册有十七页:申请机器、装系统、装数据库软件、初始化、配流复制、注册服务地址、加监控,顺利的话一个下午。而现在,整个部署被压缩成三份 YAML 和一条命令。 第一周结束时,我们成功部署了测试集群,部署过程没有翻开过一页手册。
这里还有一个值得所有运维团队借鉴的细节:部署清单进 Git 之后,"集群"在团队的知识体系里第一次变成了一个可追溯的对象 。以前的集群知识是散落的------配置在 /etc 下、参数在实例里、变更记录在某个人的聊天记录里;现在集群的全部期望形态收敛在一个文件里,谁在什么时候改了什么、为什么改,git blame 一下全都有。新人入职第一天 clone 仓库,就能看到所有集群的完整画像。这份 YAML 同时是部署脚本、是配置文档、也是变更审计日志------一份文件干三份活,这是声明式管理意料之外的红利。
更微妙的变化在心理层面:以前部署完,心里是没底的------总有一两个环节(比如复制参数)要靠人再检查一遍才踏实;现在部署完,心里反而很稳------因为集群的实际状态不是人一步步堆出来的,而是控制器对着声明对齐出来的,偏差会被自动修复,这是机制保证,不是手艺保证。
第三十天:一次"没有发生"的故障
真正的考验在第三天来到------我们策划了一次"谋杀":手动干掉一个 KES 数据库 Pod。
上面这组动图记录的是期间进入数据库 Pod 内部做状态核查的场景,注意终端提示符:kingbase-cluster-kingbase-0。这个 "-0" 后缀就是 StatefulSet 给的稳定标识------无论它被杀死重建多少次,名字永远是它,身份永远是它,挂载的存储卷也永远是它那块。"杀死一个数据库实例"在虚拟机时代是事故,在这里只是一次可再生资源的销毁与重建。
Pod 被干掉后发生了什么?监控短暂闪了一下,然后 Pod 重建、卷重挂、实例重新加入集群拓扑。全程没有告警电话,没有值班同学半夜爬起来,没有第二天早上的故障复盘会。
支撑这一切的是 KES-Operator 的持续状态管理机制:它通过 Kubernetes 控制器机制,持续监测数据库集群的实际运行状态,并与用户定义的期望状态进行比对;当实际状态与期望状态出现偏差时,根据配置协调相关 Kubernetes 资源,把集群拉回稳定运行。 期望状态里写着"要有 N 个节点、谁是主、谁是备",实际状态一偏航,控制循环立刻纠正。
这套机制管的不只是"Pod 死没死"这么粗的问题,而是三个层次的健康:实例级 ------某个 KES Pod 意外退出,实际副本数低于期望,自动重建并重新接入集群拓扑;角色级 ------主备角色分配与声明出现偏差时,按配置协调资源,恢复正确的复制拓扑;配置级------用户修改了资源额度或参数,Operator 感知到声明变更,逐步把实际状态调整到新目标。三个层次都在"观察→比对→纠正"的循环里被持续看护。
当然,我必须说清楚边界:这套机制管的是实例级故障------进程挂了、Pod 没了、节点失联了。物理磁盘损坏、机房级灾难,还是得靠备份兜底。自愈不等于永生,但日常运维里最高频的那类故障,确实从"事故"降级成了"日志里的一条记录"。
那天晚上我睡得很好。这是三十天来第一次,"数据库告警"这四个字没有出现在我的梦境里。
第六十天:大促扩容,两分钟改完配置
第二个月,赶上业务大促演练,读流量预估翻倍,需要加两个只读备节点。
放在以前,这是一个标准的"小立项":向平台组申请两台虚拟机、等待资源到位、安装数据库软件、配置流复制、等待全量数据同步、验证复制延迟、接入负载均衡、更新监控清单。涉及两三个团队的协调,周期以天计,大促结束后再反向走一遍缩容流程,机器资源闲置又心疼。
这一次,我们的全部操作是:打开 kingbase_deploy.yaml,修改节点数量,重新 apply。
KES-Operator 根据新的配置自动编排新节点的整个"入职流程":申请独立存储卷、拉起 KES 实例、从主节点建立复制通道、追平数据、纳入集群。等它跑完,我们登录节点做了一次人工核验------上面这组动图里的命令就是当时的现场:执行 /opt/kingbase/bin/repmgr cluster show,集群当前的复制拓扑、每个节点的角色与状态一屏尽显。新节点是否真的"转正"、复制关系是否健康,不用猜,看输出。
这里多说一句扩缩容背后的门道,因为它最能体现 Operator 的价值。扩容一个数据库节点,不是"多开一个容器"这么简单 :新节点要按顺序经历存储就绪、实例启动、复制建立、数据追平、对外服务这五个阶段,跳一步就是生产事故;缩容更要命,必须先确认摘的不是主节点(或者先做主备切换),否则就是把整个集群的大脑摘了。这些判断过去装在 DBA 的脑子里,是"经验";现在被 KES-Operator 编排成了固定流程,是"机制"。KES-Operator 支持KES 集群的扩容与缩容管理,用户修改集群配置后,它根据新的配置完成相应资源调整------弹性伸缩,从此不再是无状态应用的专属特权。
大促演练结束,流量回落,我们再改一次配置把节点缩了回去。整个过程,平台组的同事只在周报里看到一行字:"数据库扩缩容演练完成。"
顺便说一个演练中的小插曲。扩容时我盯着监控看新节点追数据的进度,中途产生过一个疑虑:如果追平数据的过程被打断------比如节点又被调度走------会不会出现半吊子节点挂在集群上?后来的观察给出了答案:控制循环对"中间态"天然免疫。追平一半的节点在控制器眼里就是"未达期望状态"的一部分,下一轮调谐会继续把它推向终点,而不是把烂摊子丢给人。这跟人工操作是本质区别------人会累、会忘、会下班,控制循环不会。
第七十五天:把最后一件心事交出去
做数据库运维的都懂一个道理:你可以九十九天不碰备份,但第一百天出事的时候,备份就是全部。 备份这件事的诡异之处在于,它的价值只在灾难降临的那一刻兑现------而在那一刻之前,它永远只是"应该有人管着"的悬心事。
我们的老备份体系:备份机上的定时脚本、每月一次的人工检查清单、一份贴在 wiki 上但没人确定是否最新的恢复手册。每次审计前翻出来核对一遍,是团队雷打不动的"例行动作"。
KES-Operator 对备份的管理方式,延续的还是那套声明式哲学:物理备份以配置形式声明,用户通过配置创建和管理备份任务,任务的创建、调度、执行由工具统一管理。上面这组动图展示的就是备份任务的管理界面。
这里值得展开说一下"物理备份"的分量。数据库备份分两路:逻辑备份导出的是 SQL 语句,恢复等于把建库过程重放一遍,小库可行,大库就是灾难片;物理备份直接对数据库物理存储做一致性拷贝,恢复时把数据"原样放回去",速度和完整性完全不在一个量级。对生产级 KES 集群来说,物理备份就是数据安全的最后防线。 KES-Operator 把这条防线管起来的意义在于:备份策略变成了配置文件的一部分,进 Git、走评审、有版本------"备份脚本在哪台机器上"这个问题,从此有了标准答案:在仓库里。
第七十五天,我们把最后一台老备份机下了线。那台机器上的 crontab,跑完了它的最后一个凌晨。
第九十天:现在的日常长什么样
九十天下来,现在每天早上打开的第一个页面,是 KES-Operator 配套的 KMonitor 监控组件大盘。上面这张图就是日常视图,信息密度很高,我带大家逐块看一遍:
资源水位区:CPU 使用率 9.2%、内存使用率 34.3%------日常健康线;旁边的家底数据同样重要:CPU 核数 20、物理内存 38.9 GiB,水位要结合家底看才有意义;还有一个容易被忽略但 DBA 都懂的指标------CPU iowait 4.0%,它一抬升往往就是磁盘瓶颈的第一信号,对数据库来说,这个数比 CPU 总使用率更值得盯着。
运行状态区:服务器运行时长 13 周、数据库运行时长、授权有效期 90 天。授权临期这种事,以前要靠"翻出合同看日期",现在大盘上直接可见,提前续期不慌不忙。
拓扑健康区 :数据库节点信息表列得清清楚楚------node61,角色 standby(活备),状态"活跃";node62,角色 primary(主节点)。配合醒目的流复制状态:健康标识,主备拓扑正常与否一眼可判。放在以前,这个判断要挨个节点登进去跑命令,现在是一眼的功夫。
容量与吞吐区:整体总容量与平均 CPU/内存/磁盘使用率的历史曲线,加上 QPS & TPS 实时曲线和每秒各类 DML 语句影响行数。容量规划从"拍脑袋"变成"看曲线",数据库忙不忙、忙在哪种操作上,全部量化。第六十天那次大促演练,我们判断"新加的只读节点够不够用",靠的就是这组数据。
更重要的是,这些备份和监控信息都收敛在 Kubernetes 环境中统一管理------部署、状态、扩缩容、备份、监控,五类运维动作,一个体系,一个入口。我们的浏览器书签栏里,那些为数据库专门收藏的十几个地址,可以清掉了。
九十天复盘:什么变了,什么没变
九十天结束,测试集群转为正式使用。复盘会上我们列了两张清单。
变了的:
- 部署从十七页手册变成三份 YAML,从一下午变成几分钟;
- 实例故障从"半夜的电话"变成"早会上的一句话";
- 扩缩容从跨部门立项变成改一行配置;
- 备份从"贴在 wiki 上的流程"变成进 Git 的声明;
- 监控从"多套工具拼图"变成一个统一大盘。
没变的(也是我要提醒后来者的):
- 存储依然是地基。Operator 管的是数据库,数据库脚下的存储卷性能不达标、不支持动态供给,再聪明的控制器也巧妇难为无米之炊。上生产之前,先把存储选型做扎实。
- 声明要当代码管。kingbase_deploy.yaml 这类文件必须进版本库、走评审,每一次变更留痕。声明式管理的红利,一半来自工具,一半来自纪律。
- 自动化有边界。自愈覆盖实例级故障,不覆盖物理灾难;监控数据再漂亮,定期的恢复演练也不能省。信任建立在验证之上,而不是信仰之上。
- 人不会失业,但会转型 。确定性操作被接管之后,人的价值向容量规划、性能调优、架构演进上移。工具接管的是重复,不是思考。 团队里最资深的 DBA 现在花时间最多的,是研究监控曲线里的趋势,而不是执行那些曾经写满手册的操作步骤。
写在最后
九十天前,我对平台组说"数据库跟你们那些应用不一样"。
九十天后,我的结论变成了:确实不一样------不一样的东西,需要专门为它设计的工具。 KES-Operator 基于 Kubernetes Operator 技术和声明式管理方式,把 KES 集群纳入 Kubernetes 管理体系:部署自动化、状态持续调谐、扩缩容随需而动、物理备份与监控统一收敛。它没有让数据库"变得简单",它做的是把复杂性从人的肩上,转移到了机制内部。
KES-Operator 现已正式发布。如果你也在考虑把金仓 KES 集群迁入 Kubernetes 环境,我的建议只有一个:别只看架构图和功能列表,像我们一样,拿出九十天,押上一小套测试环境,亲手杀一次 Pod、改一次配置、跑一次备份。机制值不值得信任,让手上的体验说话。
未来,电科金仓还将继续完善 KES-Operator 的相关能力,覆盖 KES 在 Kubernetes 环境中更多的使用和运维需求。而对我们团队来说,下一个九十天已经开始------这次要迁的,是生产环境的正式集群。