note
文章目录
一、Qwen3.8-Omni-Flash
1、向 Qwen3.8-Omni-Flash 提出了一项任务:在 12 小时内提升 Qwen2.5-Omni-3B 的四川话识别能力,并交付可用模型。它自主选定 WenetSpeech-Chuan 评测集、固定评测标准并完成基线测试,随后直接听取语音样本,结合识别结果诊断问题,构建针对性的训练数据。在连续 4 轮实验中,Agent 累计构建了 3,413 条训练数据,并根据评测反馈调整方案、保留有效改进、回退无效尝试。最终,Qwen2.5-Omni-3B 在同一评测集上的字符错误率从 25.79% 降至 15.30%,相对下降约 40.7%。
2、扩展了 Qwen-MM-Plugins,为长音视频的按需感知、工具调用与工作流执行提供支持;同时开源 Qwen-Live Harness,为实时、持续的全模态交互提供原生运行环境。两者分别面向长程工作流与实时交互,并在与模型的共同迭代中持续拓展全模态 Agent 的能力边界
Qwen-MM-Plugins: https://github.com/QwenLM/Qwen-MM-Plugins
Qwen-Live Harness(Coming Soon): https://github.com/QwenLM/Qwen-Live-Harness
(1)通用类
core:读本地图片/视频帧,把文档、代码、3D 模型、NIfTI 医学体数据可视化给模型看。默认原生模式不用 API key。(最推荐装)
api:调云端模型服务做图/视频/音频理解------VL 视觉问答/OCR/定位、Omni 转写/说话人分离/字幕、ASR、SAM3 分割。走 DashScope 或自建兼容服务。
search:联网搜索 + 网页抽取 + 反向图搜(Serper/Exa/Tavily 等)。
(2)Qwen VL 系列专用
video-memory(长视频分层记忆,问答不用重看)、video-edit(图/视频/音频生成与剪辑)、blender(驱动 Blender 建模渲染)、freecad(参数化 CAD)、edu-agent(生成中文数理讲解视频)。
(3)Qwen Omni 系列专用
omni-chatcut(音乐 MV / 影视解说 / 保留音色的视频翻译)、omni-video2note(教程视频转带插图 PDF 笔记)、omni-skill-creator(把演示视频变成可复用的 Agent Skill)、omni-memory(长视频的"音+画"记忆:谁在场、谁说了什么、怎么说的)。
3、Qwen3.8-Omni-Flash 原生 Agent 则从问题出发,自主决定该看什么、听什么,并通过由粗到细的多轮取证定位关键信息
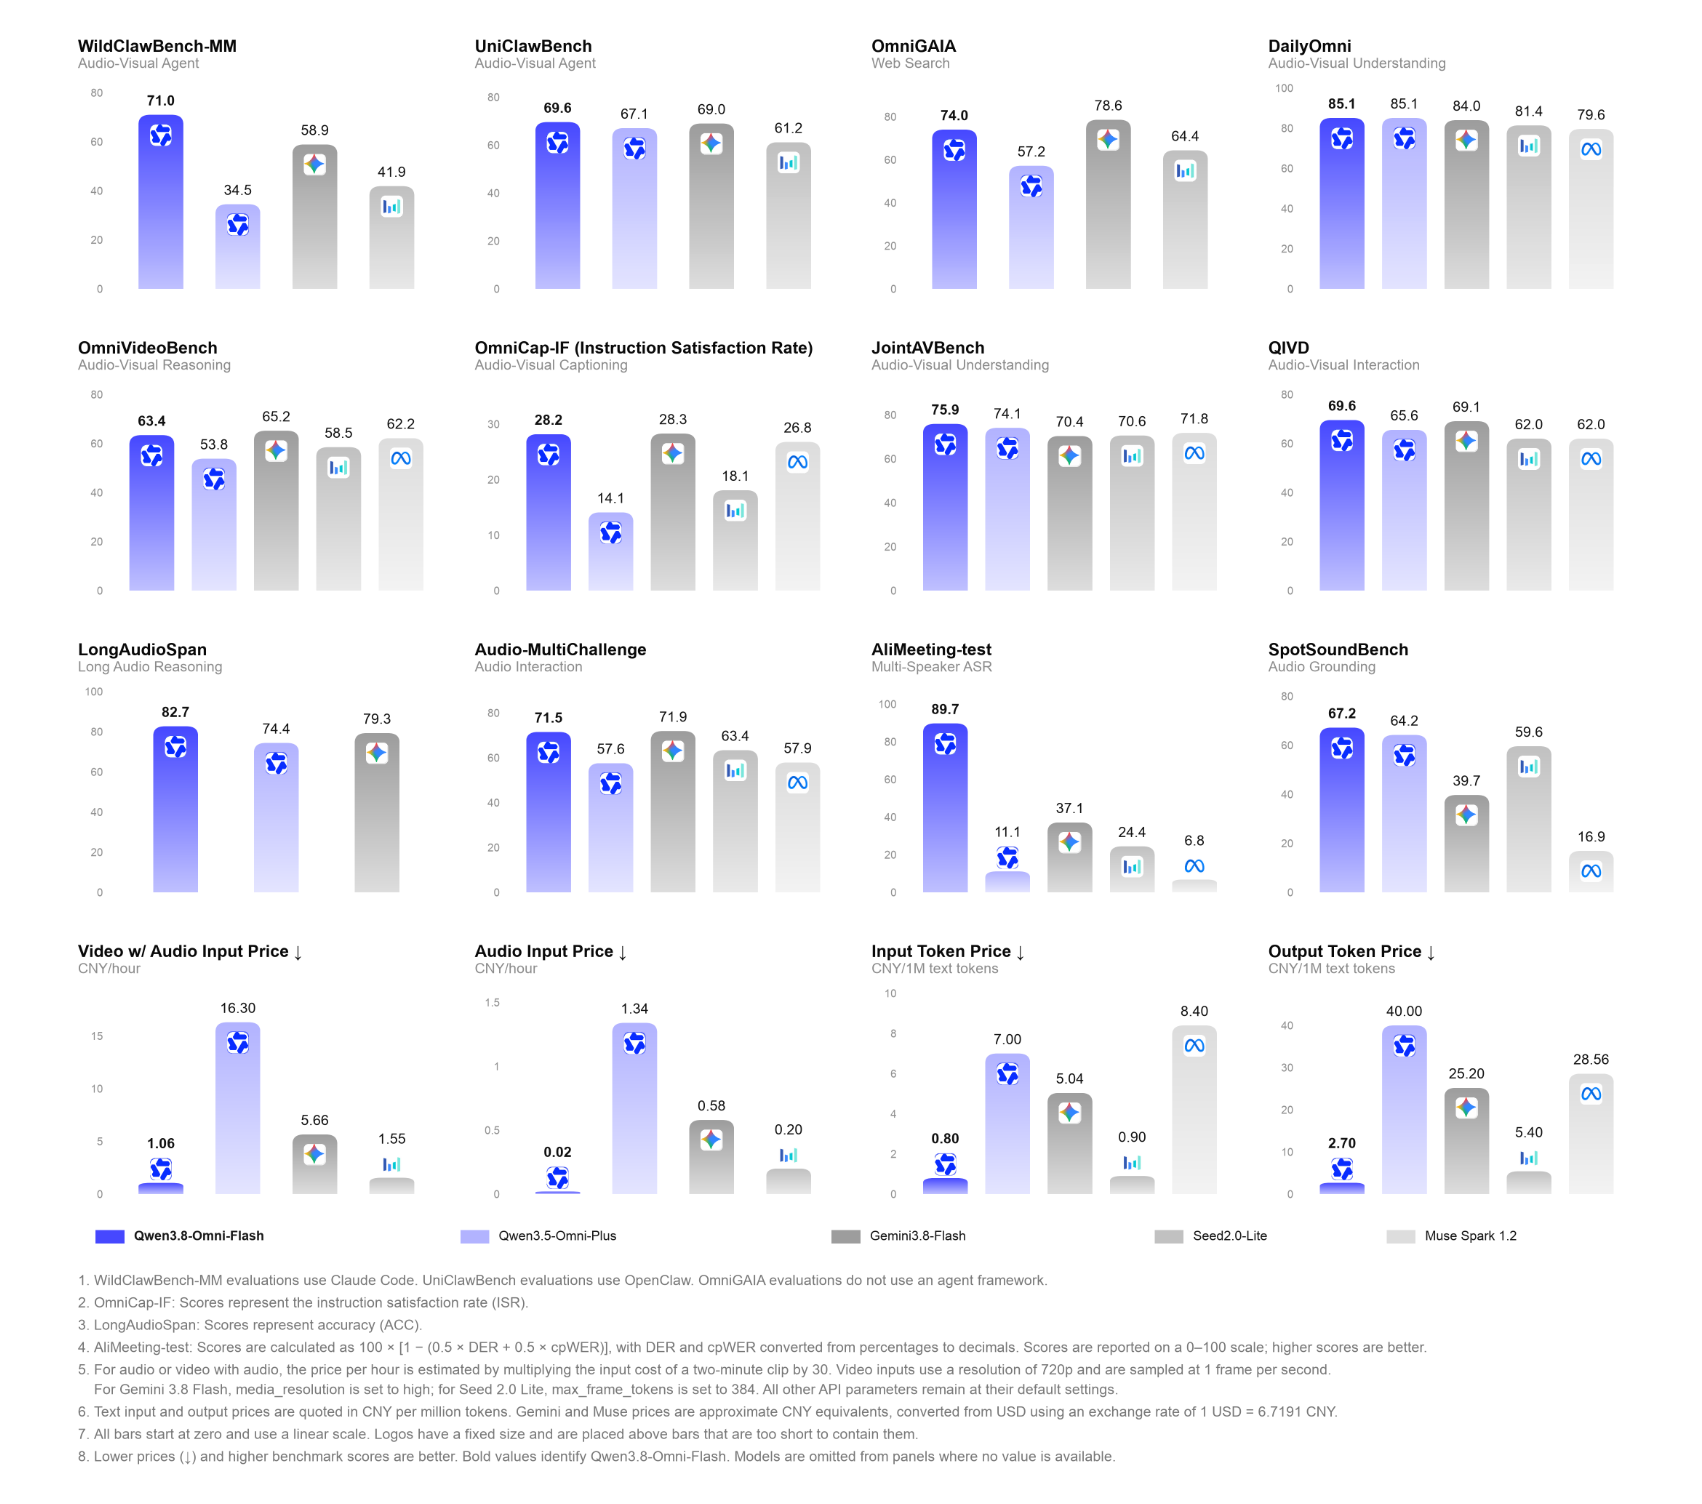
4、通过扩展数据、上下文与 Agentic Environment,Qwen3.8-Omni-Flash 的音视频能力接近 Gemini 3.8 Flash,音频能力整体超过 Gemini 3.8 Flash。