在开篇先分享一张图给大家:
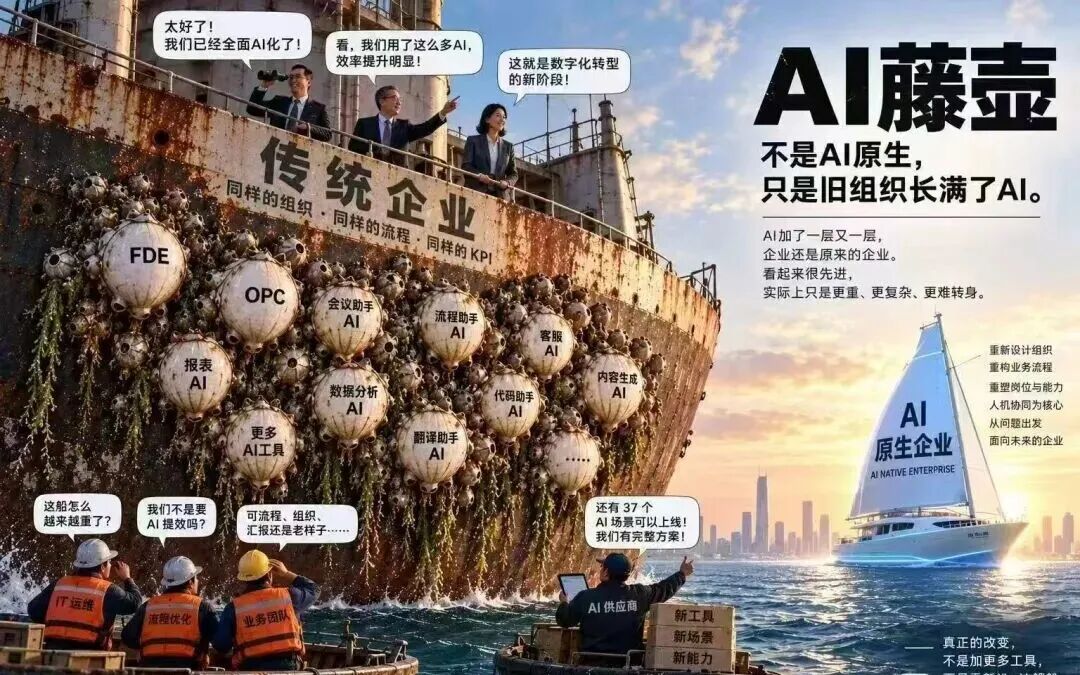
希望看到这张图的朋友们避坑,做AI应用落地,切忌只叠加AI,而不改变原始流程!
今天这篇文章也就着这个AI原生的话题,聊一下如何做一个AI原生的AIOps平台。
说到AI原生,我认为至少要满足一个核心判断:如果把 AI 拿掉,平台的核心工作流就无法正常成立。
比如传统运维平台:
告警 ↓规则聚合 ↓人工查看Dashboard ↓人工查日志 ↓人工判断 ↓人工选Runbook ↓执行然后旁边加一个 AI,这叫AI叠加,不是AI原生:
AI助手 ↑告警 → 事件 → 人工处理而 AI 原生应该是这样:
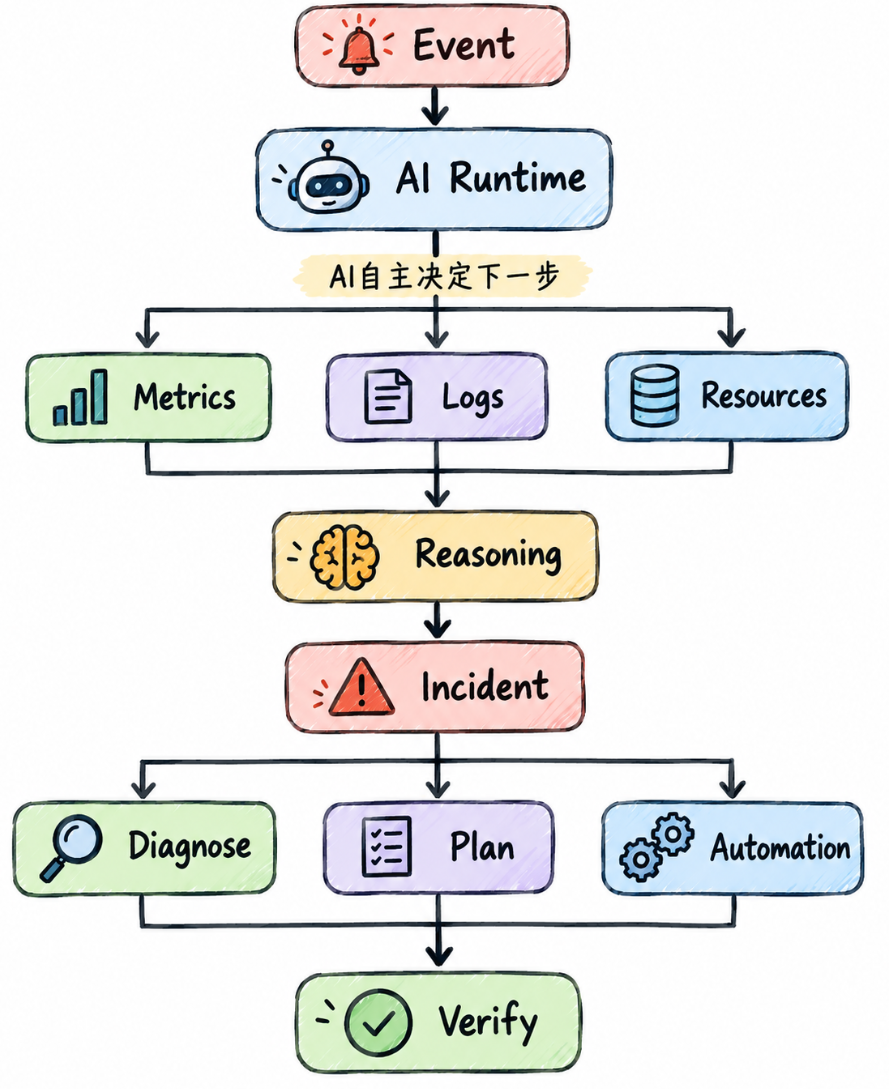
这里的 AI Runtime已经不是一个"AI 功能模块"。而是:整个 AIOps 平台的智能控制平面。
01 | 平台架构
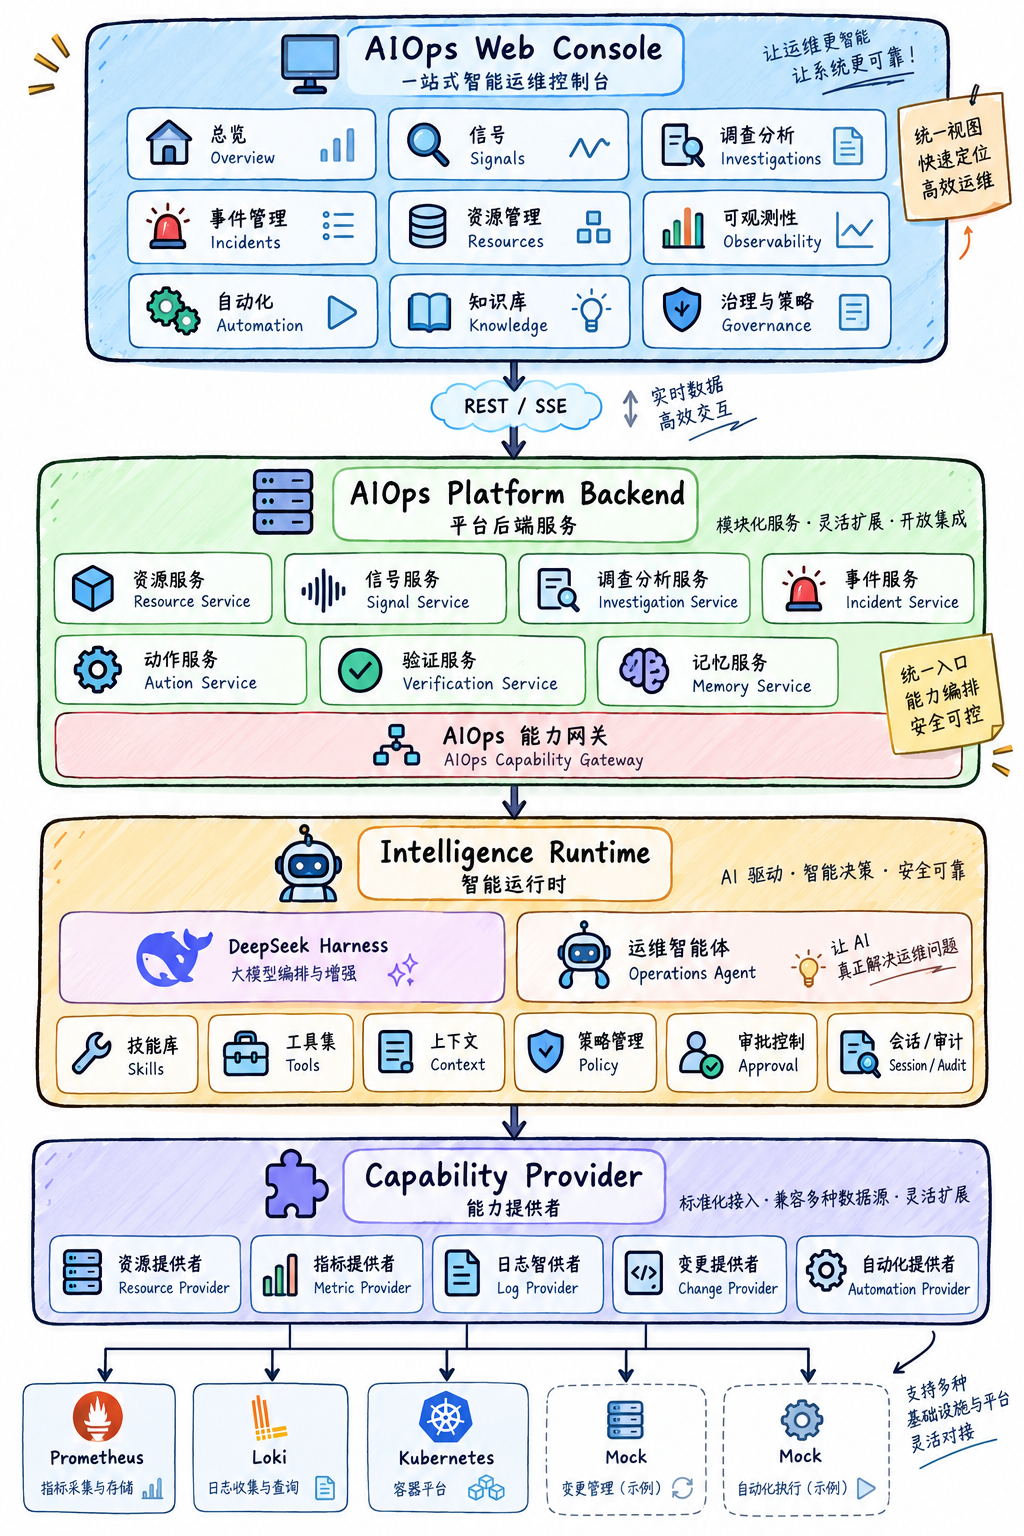
其中,平台后端负责领域数据、业务状态、权限、审批和能力封装,DSH 负责运行智能体、组织调查流程、选择工具、形成判断和生成处置计划。
02 | 架构说明
- AIOps Web Console
AIOps Web Console 是整个平台面向运维人员、开发人员和管理人员的统一操作入口,负责把平台内部复杂的资源状态、异常信号、问题调查过程、处置方案和执行结果,以可理解、可操作的方式呈现出来。
用户不需要直接面对底层 Prometheus、Loki、Kubernetes 或智能体运行时,而是通过 Web Console 完成日常运维工作。
该组件主要承担三个作用。
第一,展示系统当前运行状态,例如当前有多少异常信号、哪些服务正在被调查、有哪些未关闭事件、是否存在需要人工审批的操作。
第二,展示智能调查过程。用户可以看到系统针对某个问题已经查询了哪些指标、检查了哪些日志、发现了哪些变更、形成了哪些证据,以及当前更倾向于哪一种原因判断。
第三,提供人工参与入口。用户可以查看调查结果、调整事件状态、批准或拒绝高风险操作,也可以通过自然语言直接询问平台当前运行情况。
Web Console 本身不承担运维分析逻辑,而是通过 REST API 获取业务数据,通过 SSE 接收调查、执行和验证过程中的实时状态更新。
- AIOps Platform Backend
AIOps Platform Backend 是整个平台的核心业务后台。可以把它理解为:
AIOps 平台的"业务中枢"。
Web Console 展示的 Signal、Investigation、Incident、Plan、Action 等对象,都由 Platform Backend 创建、管理和持久化。
Intelligence Runtime 可以负责分析和决策,但最终平台的业务状态仍然由 Platform Backend 统一管理。
它负责管理整个运维生命周期。例如:
Signal ↓Investigation ↓Evidence ↓Hypothesis ↓Incident ↓Plan ↓Action ↓Verification ↓Memory这些都属于 Platform Backend 管理的业务对象。
3. Intelligence Runtime
Intelligence Runtime 是整个平台的智能运行环境。这一层由:DeepSeek Harness 作为主要运行底座。
可以把它理解为:AIOps 平台的"智能大脑"。
它的任务不是简单回答聊天问题,而是在运维任务中持续进行:
理解↓调查↓判断↓规划↓调用工具↓重新获取信息↓调整判断↓验证举个实际的例子,Intelligence Runtime 首先会接收到 Signal(类似告警):
checkout-serviceP99 latency abnormal同时获得上下文:
Resource:checkout-serviceEnvironment:prodRelated Signals:CPU ↑Memory ↑Current Investigation:INV-0028它需要判断:下一步应该做什么?
可能首先调用:metric.query ,发现:
CPU ↑Memory ↑P99 ↑随后决定调用:log.search,又发现:
GC Pause明显增加于是继续:change.list,发现:
15分钟前部署 v1.8.3再查询:memory.search,发现以前出现过类似事件。
这整个动态调查过程,就是 Intelligence Runtime 的核心工作。
Intelligence Runtime 内部主要有这些能力:
1)Operations Agent
负责整个任务的统筹。它决定:
现在应该查什么已经掌握了什么还缺少什么什么时候可以形成结论什么时候需要生成Plan2)Skills
提供不同运维任务的方法。例如:
Investigation SkillRCA SkillPlanning SkillVerification SkillMemory Skill3)Tools
Tools 是 Agent 可以调用的平台能力。例如:
metric.querylog.searchresource.dependencieschange.listmemory.searchaction.rollbackAgent 不能想做什么就直接访问底层系统,只能使用被允许的 Tool。
4)Context
Context 保存当前任务所需要的信息。例如:
当前Signal当前Resource已有Evidence已有Hypothesis当前Incident历史Memory权限信息这样 Agent 能够持续推进同一个任务。
5)Session
Session 保存一次智能任务的运行轨迹。例如:
收到Signal↓调用metric.query↓获得结果↓调用log.search↓获得结果↓更新Hypothesis这样以后可以回放和审计智能过程。
4. Capability Provider
Capability Provider 是平台与各种真实运维系统之间的适配层。可以把它理解为:AIOps 平台的"手和眼睛"。
举个具体的例子,你就知道它的作用了。
① telligence Runtime 想知道:checkout最近30分钟CPU是多少?
真正的数据可能存储在 Prometheus。
② Intelligence Runtime 想查询:checkout最近有什么ERROR日志?
真正的数据可能存在 Loki。
③ Intelligence Runtime 想执行:checkout副本从3扩到5
真正需要操作 Kubernetes。
这些具体技术差异全部由 Capability Provider 负责处理。
那为什么需要搞这些 Provider?
因为平台上层应该使用统一能力,比如:
查监控数据,应用用 metric.query,而不是 PromQL查日志,应该使用 log.search, 而不是 Loki Query
做任务,应该使用 action.scale,而不是执行命令 kubectl scale deployment...
这样上层系统不需要绑定具体基础设施产品。
- Data & Execution Systems
这一层是真正的数据来源和执行目标。包括:
Prometheus
Loki
Kubernetes
CMDB
CI/CD
Database
Middleware
Mock Environment

等等
它可以理解为:平台实际观察和操作的运行世界。
03 | 五层之间的关系
可以把整个系统平台简单理解为:
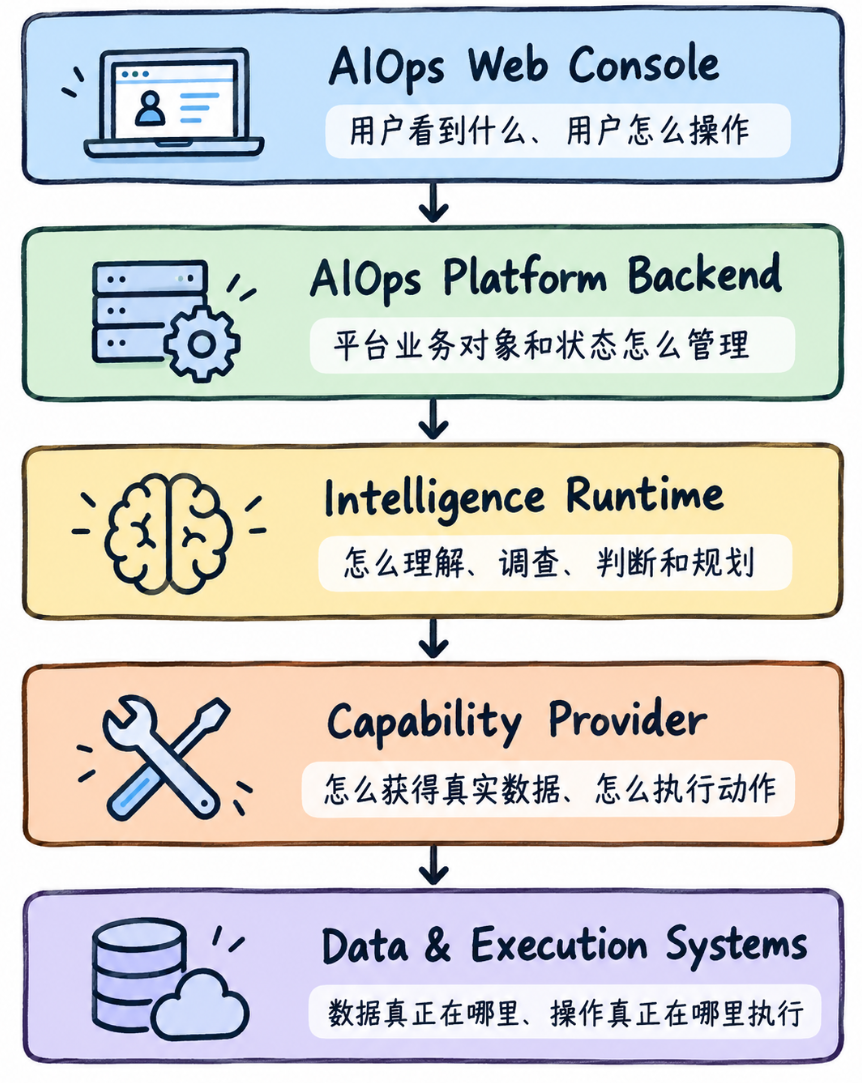
再来个整体总结:
Web Console 是"界面",Platform Backend 是"业务中枢",Intelligence Runtime 是"大脑",Capability Provider 是"手和眼睛",底层 Data & Execution Systems 是平台实际观察和操作的运行环境。
大家觉得这个设计咋样,聊聊你的看法!