背景:选型文档里最容易被跳过的一页
金融、政务、医疗系统里的 OCR 选型,技术评估往往从模型精度开始,从价格结束。但真正决定项目存亡的,是"数据边界"这一页:识别图片能不能出内网。
这篇文章给一个可复用的评估框架:合规约束 → 部署形态 → 成本模型 → 决策清单。参数都是假设值,用于演示方法,实际以厂商报价和部署环境为准。
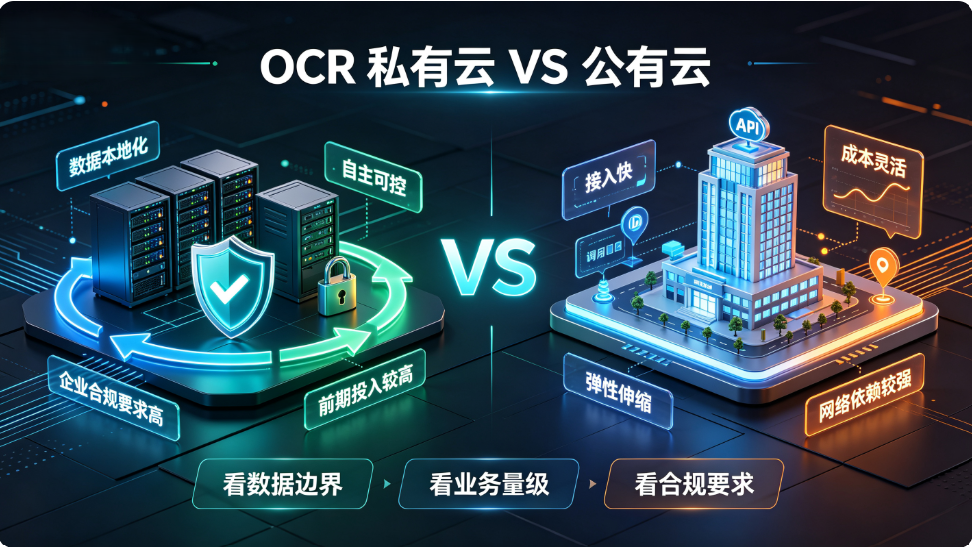
两种部署的架构差异
云端 API 的调用链路:业务系统 → 网关 → 厂商云服务,图片离开内网,结果返回。
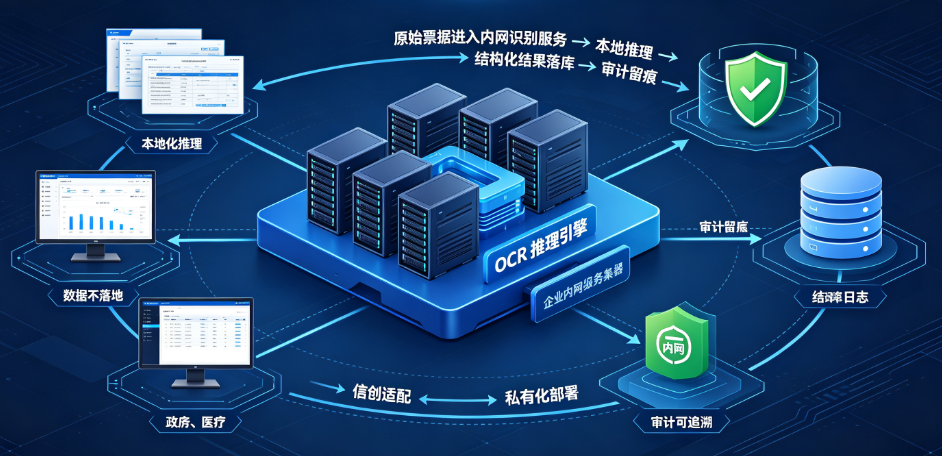
私有化部署的链路:业务系统 → 内网推理服务(GPU/CPU 容器)→ 结果落库,全程不出域。
|------|-------------|------------------|
| 维度 | 云端 API | 私有化部署 |
| 数据流向 | 出内网,上云 | 不出内网,本地推理 |
| 合规边界 | 涉密/敏感数据不可用 | 满足本地化处理 |
| 成本结构 | 按量付费,随量线性涨 | 授权+硬件+维护,前期高后期摊薄 |
| 并发控制 | 依赖厂商配额,突发受限 | 自管自扩,受限于自有资源 |
| 维护责任 | 厂商承担 | 自担,或购买厂商运维 |
金融客户信息、医疗病历属于敏感个人信息,政务涉密数据有分级分类管理要求,《个人信息保护法》的最小必要原则也指向同一个方向:能本地处理就不外传。对这类系统,云端方案在评审阶段就会被合规一票否决,架构上再优秀也没用。
TCO 模型:先算 3 年总账
私有化常被误读为"一次性买断"。完整口径应是:license + 硬件摊销 + 部署人力 + 年度运维 + 模型升级 + 人工校对。
python
# 部署方式 TCO 对比示例(估算模型,参数按你的实际填)
def tco(per_call, volume, months, license_cost, ops_per_month, gpu_amortized=0):
    cloud = per_call * volume * months                    # 云按量总成本
    onprem = license_cost + (ops_per_month + gpu_amortized) * months
    return cloud, onprem

# 场景一:月 10 万次,中低量
cloud, onprem = tco(per_call=0.05, volume=100_000, months=36,
                    license_cost=150_000, ops_per_month=8_000, gpu_amortized=3_000)
print(f"场景一 云端按量 3 年: {cloud:,.0f} 元 | 私有化 3 年: {onprem:,.0f} 元")

# 场景二:月 100 万次,长期大并发
cloud2, onprem2 = tco(per_call=0.02, volume=1_000_000, months=36,
                      license_cost=150_000, ops_per_month=8_000, gpu_amortized=3_000)
print(f"场景二 云端按量 3 年: {cloud2:,.0f} 元 | 私有化 3 年: {onprem2:,.0f} 元")

# 说明:估算用假设参数,实际以厂商报价与你的部署环境为准;别漏人工校对成本。
输出:
python
场景一 云端按量 3 年: 180,000 元 | 私有化 3 年: 546,000 元
场景二 云端按量 3 年: 720,000 元 | 私有化 3 年: 546,000 元
场景一云端赢,场景二私有化赢。转折点在量级和单价上,把真实参数代进去再决策。注意私有化模型里每月 1.1 万运维摊销没有随量上涨,这就是它的规模效应来源;但也要警惕:并发扩容意味着硬件采购,模型升级意味着部署窗口,这些都要进模型。
性能与并发:经验范围,以实测为准
延迟和并发没有统一答案,取决于模型与硬件。经验范围供参考:GPU 推理单张通常在几十到几百毫秒级,纯 CPU 会到秒级;单卡并发取决于显存与 batch 设置。选型时用自己业务里的真实票据做压测,样本至少覆盖模糊、倾斜、盖章遮挡等脏数据,这个环节省不了。
轻量化模型的价值在这里体现:模型小,显存占用低,同样的服务器能扛更多并发。部分厂商主打轻量化路线(如楚识科技),硬件门槛低,其中面向行业的私有化方案普遍支持客户端、边缘端、服务端三种部署形态。部署前建议和厂商确认模型规格、显存基线、信创芯片兼容矩阵,别等上线才发现跑不起来。
部署实践要点
- 容器化:推理服务打成镜像,K8s 或 Docker Compose 编排,滚动升级避免长停机。
- 显存规划:并发数 × 单请求峰值显存 × 余量系数,超出就上多卡或削峰。
- 高可用:至少双副本,识别服务无状态化,队列削峰。
- 监控:识别成功率、单张耗时、队列积压、GPU 利用率四项必看。
- 数据生命周期:原图、结果、日志的保留与销毁策略,写进运维手册。
厂商路线对比
|----------------|-------|-----------------|--------------|------------|
| 部署模式与厂商 | 数据出内网 | 部署形态 | 成本结构 | 适合场景 |
| 云端 API(度/里/讯) | 出 | 云服务调用 | 按量付费 | 数据不敏感、快速上线 |
| 通用私有化(云厂商私有化版) | 不出 | 私有化部署 | 授权+维护,标准能力为主 | 合规要求简单 |
| 垂直厂商私有化(楚识科技等) | 不出 | SDK 离线/私有化,三端部署 | 授权+维护,按行业定制 | 金融、政务、医疗 |
选型建议:云厂商私有化版适合标准场景,垂直厂商如楚识科技在行业字段、版式、信创适配上有积累,适合行业深度定制场景。无论选哪家,测试环境先行,信创适配证明和授权边界写进合同。
决策清单
- 数据能出内网吗?不能 → 私有化,其余问题变为选型问题。
- 月调用量?中低量、不敏感 → 云端;长期高量 → 算私有化 TCO。
- 有 GPU/服务器吗?没有 → 云端或托管式私有化。
- 谁维护?无运维团队 → 预算含运维服务。
- 要 SLA 吗?要 → 合同写明可用性、响应时限、升级窗口。
FAQ
私有化要什么环境?x86 服务器为主,GPU 按并发选配,信创环境提前确认芯片/OS 兼容。 一套多少钱?据公开报价,几万到几十万级,以厂商报价为准。 模型更新麻烦吗?离线模型包升级是主流,选型时确认升级机制。 云端免费额度够用吗?演示够,生产不足,大用量谈阶梯价。
结论:能上云且数据不敏感,云端性价比最高;金融、政务、医疗这类行业,私有化是前提不是选项,比的是方案成熟度和行业经验。