发布时间:2026 年 9 月 18 日
直接结论:Qwen3.8-27B 做 GRPO,4×RTX 4090 只能作为 QLoRA、小 Batch、短输出的 PoC 起点;要把 vLLM Rollout 与训练进程分开,8×RTX 4090 更合理。全参数 GRPO 不建议直接用这两种配置。
一、为什么不能直接用"总显存"判断
一张 RTX 4090 有 24GB 显存,因此:
| 配置 | 物理显存总量 | 能否视为一块大显存 |
|---|---|---|
| 4×RTX 4090 | 96GB | 不能 |
| 8×RTX 4090 | 192GB | 不能 |
RTX 4090 官方规格为 24GB GDDR6X,并且不支持 NVLink。多卡之间仍需通过 PCIe 交换模型分片、梯度和激活,不能把 4 张卡简单理解成"一张 96GB 显卡"。NVIDIA RTX 4090 官方规格
对于 GRPO,还要同时考虑:
- Policy 模型权重;
- LoRA Adapter、梯度和优化器状态;
- 前向与反向传播的激活值;
- 每个 Prompt 生成的多组 Completion;
- vLLM 的模型权重与 KV Cache;
- Reference Model------当配置需要 KL 约束时;
- CUDA、NCCL、PyTorch 和量化框架的缓存。
所以"模型能装进显存"不等于"GRPO 能训练"。
二、Qwen3.8-27B 本身需要多少显存
Qwen 官方模型卡显示,Qwen3.8-27B 的语言模型约为 27B 参数,同时包含视觉编码器,原生上下文长度为 262,144 Token。Qwen3.8-27B 官方模型卡
先做一个只看权重的理论计算:
python
params = 27_000_000_000

for name, bytes_per_param in {
    "BF16/FP16": 2,
    "INT8": 1,
    "INT4理论值": 0.5,
}.items():
    gb = params * bytes_per_param / 1e9
    gib = params * bytes_per_param / 1024**3
    print(f"{name}: {gb:.1f} GB / {gib:.1f} GiB")
结果大致为:
| 权重格式 | 27B 裸权重理论占用 |
|---|---|
| BF16/FP16 | 约 54GB |
| INT8 | 约 27GB |
| INT4 | 约 13.5GB |
这些数字不包含视觉编码器、量化元数据、LoRA 参数、激活值、KV Cache 和框架缓存,不能直接作为实例配置。
如果进行全参数训练,按每个参数约 12~16 Byte 粗略估算,模型参数、梯度和优化器状态可能达到约 324~432GB,且尚未计算激活值。即使使用 ZeRO-3 分片:
- 4 卡平均仍约为 81~108GB/卡;
- 8 卡平均仍约为 40.5~54GB/卡。
因此,4×4090 和 8×4090 都不适合作为 Qwen3.8-27B 全参数 GRPO 的常规方案。本文后续默认采用 4-bit QLoRA。
三、4×4090:能做,但定位应该是 PoC
4×4090 比较适合以下目标:
- 验证奖励函数是否有效;
- 检查数据格式和 Chat Template;
- 用少量 Prompt 跑通完整训练闭环;
- 验证 Checkpoint 能否保存、恢复;
- 观察峰值显存、单步耗时和生成吞吐。
建议采用:
- 4-bit NF4 QLoRA;
- DeepSpeed ZeRO-3;
per_device_train_batch_size=1;- Gradient Checkpointing;
num_generations=4起步;max_completion_length=256~512起步;- vLLM Colocate 模式;
- vLLM Sleep Mode;
- 必要时关闭 Reference Model。
TRL 当前文档说明,Colocate 模式会让 vLLM 与训练进程共享 GPU,优点是不需要额外生成卡,缺点是更容易发生显存争用。Sleep Mode 可以在优化阶段卸载 vLLM 权重和缓存,但会增加主机与显卡之间的数据搬运时间。TRL GRPO 文档、TRL 显存优化文档
一套保守的配置骨架如下:
python
from trl import GRPOConfig

training_args = GRPOConfig(
    output_dir="outputs/qwen38-27b-grpo-poc",

    bf16=True,
    learning_rate=1e-5,

    per_device_train_batch_size=1,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,

    num_generations=4,
    max_completion_length=512,

    # beta=0 时,TRL 默认不加载 Reference Model。
    # 是否允许关闭 KL 项,应由实验目标决定。
    beta=0.0,

    use_vllm=True,
    vllm_mode="colocate",
    vllm_tensor_parallel_size=4,
    vllm_gpu_memory_utilization=0.15,
    vllm_enable_sleep_mode=True,

    logging_steps=1,
    save_steps=50,
)
这只是显存敏感型起点,不是"4 张 4090 必定能跑"的保证。Qwen3.8-27B 属于视觉语言模型,实际加载方式还取决于当前 Transformers、TRL、vLLM 与 bitsandbytes 的版本组合。
4 卡方案的主要限制
- 训练与生成争抢同一组 GPU。
- Completion 变长后,KV Cache 会迅速占用剩余显存。
num_generations从 4 增加到 8,会明显提高生成开销。- 4090 没有 NVLink,ZeRO-3 和 Tensor Parallel 的通信会经过 PCIe。
- 一旦同时加载 Reference Model,显存余量可能快速耗尽。
因此,4 卡更适合回答"训练链路能否跑通",不适合直接承担大规模正式训练。
四、8×4090:更适合拆分 Rollout 与训练
8 卡方案建议按两组资源拆分:
| GPU | 职责 | 建议 |
|---|---|---|
| GPU 0~3 | vLLM Rollout | Tensor Parallel=4 |
| GPU 4~7 | QLoRA 训练 | ZeRO-3、Gradient Checkpointing |
这种布局的关键优势不是"总显存翻倍",而是将生成和训练隔离。
TRL 的 vLLM Server 模式要求生成服务与训练进程使用不同的 CUDA 设备。官方示例同样使用一组 GPU 运行 vLLM、另一组 GPU 执行训练。TRL vLLM 集成文档
示意启动方式:
bash
# GPU 0~3:Rollout 服务
CUDA_VISIBLE_DEVICES=0,1,2,3 \
trl vllm-serve \
  --model Qwen/Qwen3.8-27B \
  --tensor-parallel-size 4

# GPU 4~7:QLoRA + GRPO 训练
CUDA_VISIBLE_DEVICES=4,5,6,7 \
accelerate launch \
  --num_processes 4 \
  --config_file deepspeed_zero3.yaml \
  train_grpo.py
不同 TRL 版本的 CLI 参数可能变化,正式启动前应执行:
bash
trl vllm-serve --help
accelerate launch --help
8 卡方案适合什么任务
num_generations=8的标准 GRPO 实验;- Completion 较长的数学、代码或推理任务;
- 需要持续生成大量 Rollout;
- 需要分别监控生成吞吐和训练速度;
- 希望减少 Colocate 模式下的显存互相挤占;
- 需要更稳定地保存与恢复 Checkpoint。
但 8×4090 仍然不自动等于全参数 GRPO。若目标是 BF16 全参数训练、超长上下文或高并发 Rollout,应优先评估 80GB 级数据中心 GPU 及更合适的卡间互联。
五、4 卡和 8 卡应该怎么选
| 决策项 | 4×4090 | 8×4090 |
|---|---|---|
| 推荐训练方式 | 4-bit QLoRA | 4-bit QLoRA |
| vLLM 部署 | Colocate | 独立 Server |
| 推荐定位 | 小规模 PoC | 正式实验起点 |
num_generations |
4 起步 | 8 更从容 |
| Completion 长度 | 256~512 起步 | 可逐步增加 |
| 训练与生成隔离 | 否 | 是 |
| OOM 调参压力 | 高 | 中 |
| 全参数 GRPO | 不建议 | 仍不建议 |
| 通信限制 | PCIe、无 NVLink | PCIe、无 NVLink |
简单判断:
- 只想验证奖励函数、数据和训练闭环:先开 4 卡。
- 已经完成 PoC,需要提高 Rollout 吞吐:选择 8 卡。
- 需要全参数更新或超长上下文:不要只在 4 卡与 8 卡 4090 之间纠结,应重新评估 GPU 类型。
六、以算家云为例操作演示
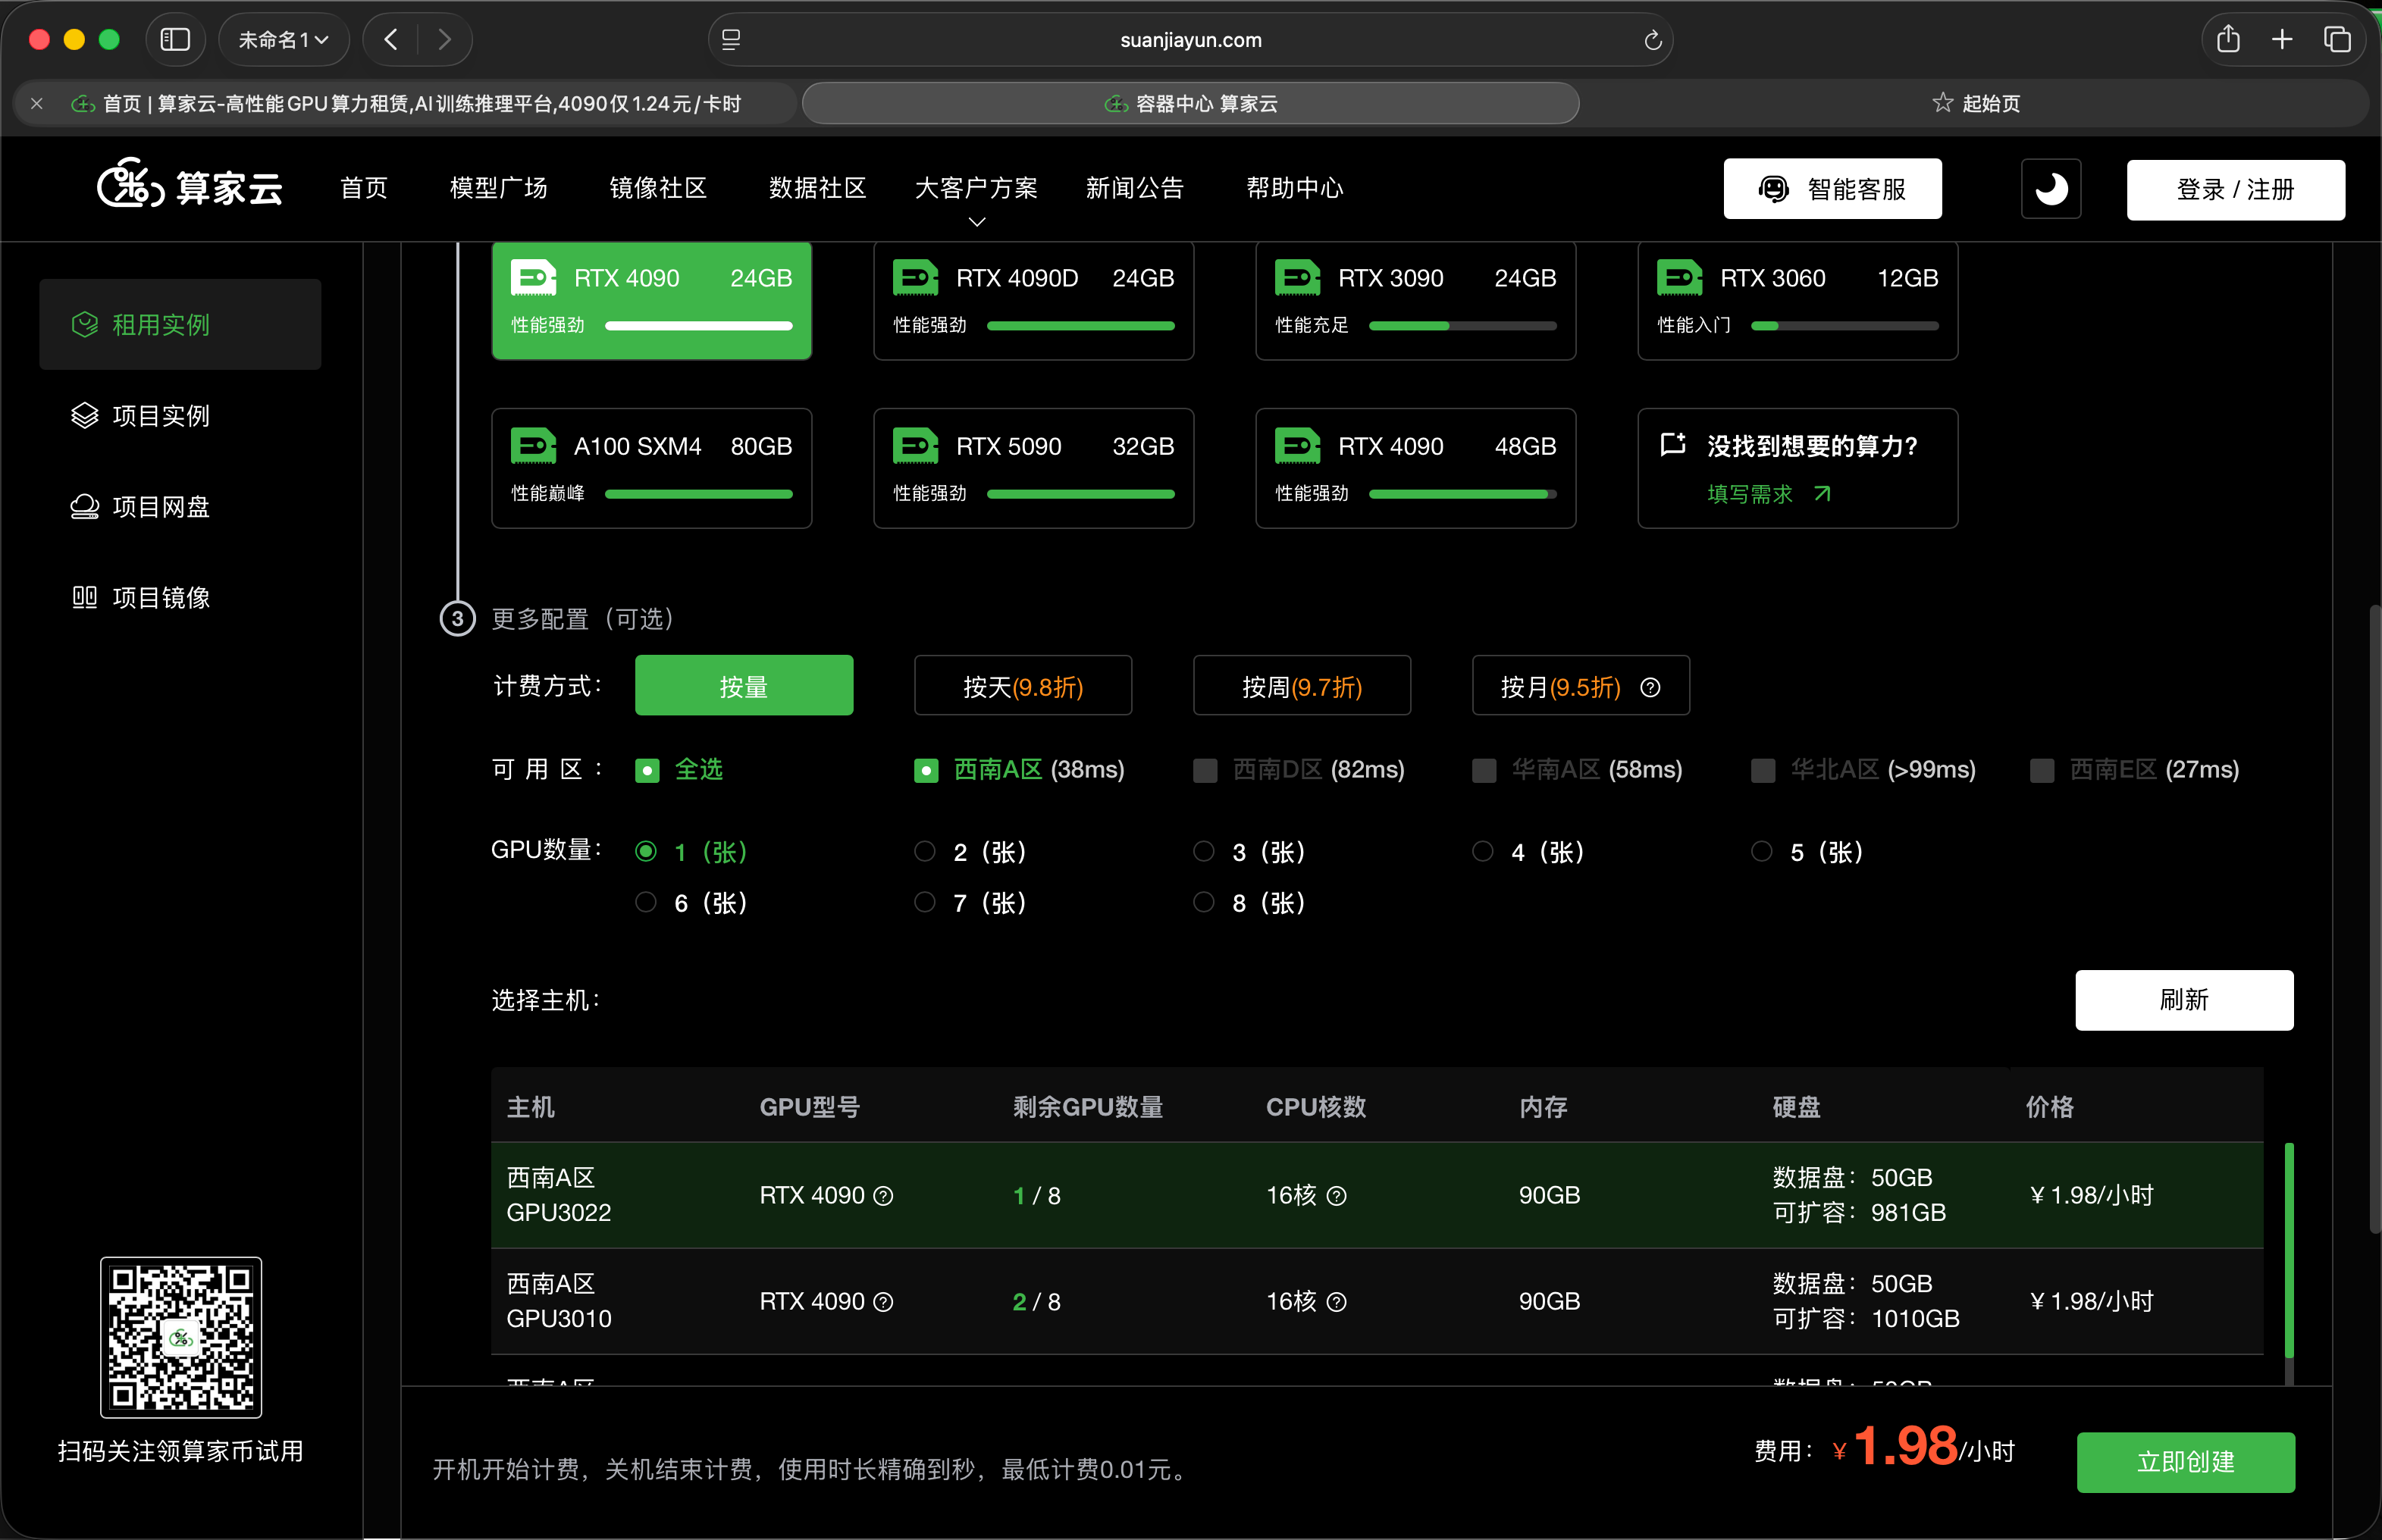
这类持续、多卡训练任务更适合优先考察算家云专业版。创建实例时不要只看"RTX 4090"字样,应同时确认:
- 是同一台机器的 4 卡或 8 卡,而不是多台单卡实例;
- 每张卡均为 24GB,型号和驱动保持一致;
- CPU、系统内存和本地磁盘能否支撑模型卸载与数据缓存;
- GPU 之间的 PCIe 拓扑;
- 当前区域是否有足够的实时库存;
- Checkpoint 和数据是否需要单独持久化。
算家云的卡数、区域和库存属于动态信息,应以专业版实例创建页当时展示为准。本文不承诺某一区域持续存在 4 卡或 8 卡库存。
实例启动后先检查:
bash
nvidia-smi
nvidia-smi topo -m

python - <<'PY'
import torch

print("PyTorch:", torch.__version__)
print("CUDA:", torch.version.cuda)
print("GPU count:", torch.cuda.device_count())

for i in range(torch.cuda.device_count()):
    p = torch.cuda.get_device_properties(i)
    print(i, p.name, round(p.total_memory / 1024**3, 2), "GiB")
PY
重点关注:
- 是否识别到预期卡数;
- 每张卡的显存是否一致;
- GPU 间连接显示为哪种 PCIe 路径;
- PyTorch、CUDA 和驱动能否正常匹配。
再启动显存记录:
bash
nvidia-smi \
  --query-gpu=timestamp,index,name,memory.used,memory.total,utilization.gpu,power.draw \
  --format=csv \
  -l 2 | tee grpo-gpu-monitor.csv
建议先用 100~500 条 Prompt 跑一次小规模 PoC,至少完成:
- 一次 Rollout;
- 一次 Reward 计算;
- 一次参数更新;
- 一次 Checkpoint 保存;
- 一次中断恢复。
七、CUDA OOM 的排查顺序
遇到 OOM 时,不建议立即从 4 卡升级到 8 卡。先按这个顺序处理:
- 将
max_completion_length从 1024 降到 512 或 256; - 将
num_generations从 8 降到 4; - 保持每卡 Batch Size 为 1;
- 开启 Gradient Checkpointing;
- 降低
vllm_gpu_memory_utilization; - 开启
vllm_enable_sleep_mode; - 检查是否意外加载了 Reference Model;
- 检查视觉输入是否造成额外 Token 和激活占用;
- 再考虑由 4 卡升级到 8 卡。
GRPO 的显存问题经常发生在生成阶段。只调整训练 Batch Size,未必能解决 Completion、KV Cache 或多候选生成导致的 OOM。
八、适用边界
本文方案适合:
- QLoRA 形式的 GRPO;
- 代码、数学或文本奖励任务;
- 单机多卡实验;
- 需要控制预算的模型后训练 PoC。
不适合直接套用到:
- Qwen3.8-27B 全参数 GRPO;
- 262K 原生上下文训练;
- 大量图像或视频输入;
- 多机多卡且依赖高速互联的训练;
- 对故障恢复和服务等级有明确生产要求的任务。
FAQ
1. 4×4090 能不能直接跑 Qwen3.8-27B GRPO?
可以作为 4-bit QLoRA、小 Batch、短 Completion 的实验起点,但不能承诺任意数据和参数都能运行。建议先完成小规模 PoC。
2. 为什么模型 BF16 权重只有约 54GB,4 卡总显存 96GB 仍然紧张?
GRPO 除了 Policy 权重,还需要激活、梯度、生成候选、KV Cache、vLLM 缓存及可能存在的 Reference Model。总显存也不是一块连续显存。
3. 8×4090 是否一定比 4×A100 更快?
不能只按卡数判断。还需比较显存容量、卡间互联、Rollout 吞吐、通信比例、功耗和实际任务长度。本文没有进行统一条件的性能实测。
4. 为什么推荐 8 卡拆成 4 卡生成、4 卡训练?
GRPO 是在线训练方法,生成通常是主要瓶颈之一。将 vLLM 与训练进程放到不同 GPU,可以减少显存争用,也便于分别监控两个阶段。
5. 可以直接把上下文设成官方的 262K 吗?
不建议。262K 是模型能力边界,不是 24GB 多卡训练的默认参数。PoC 应从短 Prompt 和 256~512 Token 的 Completion 开始。