编码 OFDM 通信链路详解:从比特发送到数据恢复
前言
OFDM(正交频分复用)被广泛应用于 Wi-Fi、4G/5G、数字电视以及宽带无线通信系统中。
很多 OFDM 教程只介绍 IFFT、循环前缀和 FFT,却忽略了一个实际通信系统还必须解决的三个问题:
- 如何检测传输错误?
- 如何对抗噪声和多径衰落?
- 接收机如何完成同步、频偏校正和信道均衡?
本文结合下图中的编码 OFDM 链路,完整分析数据从发射机进入信道,再由接收机恢复的全过程。
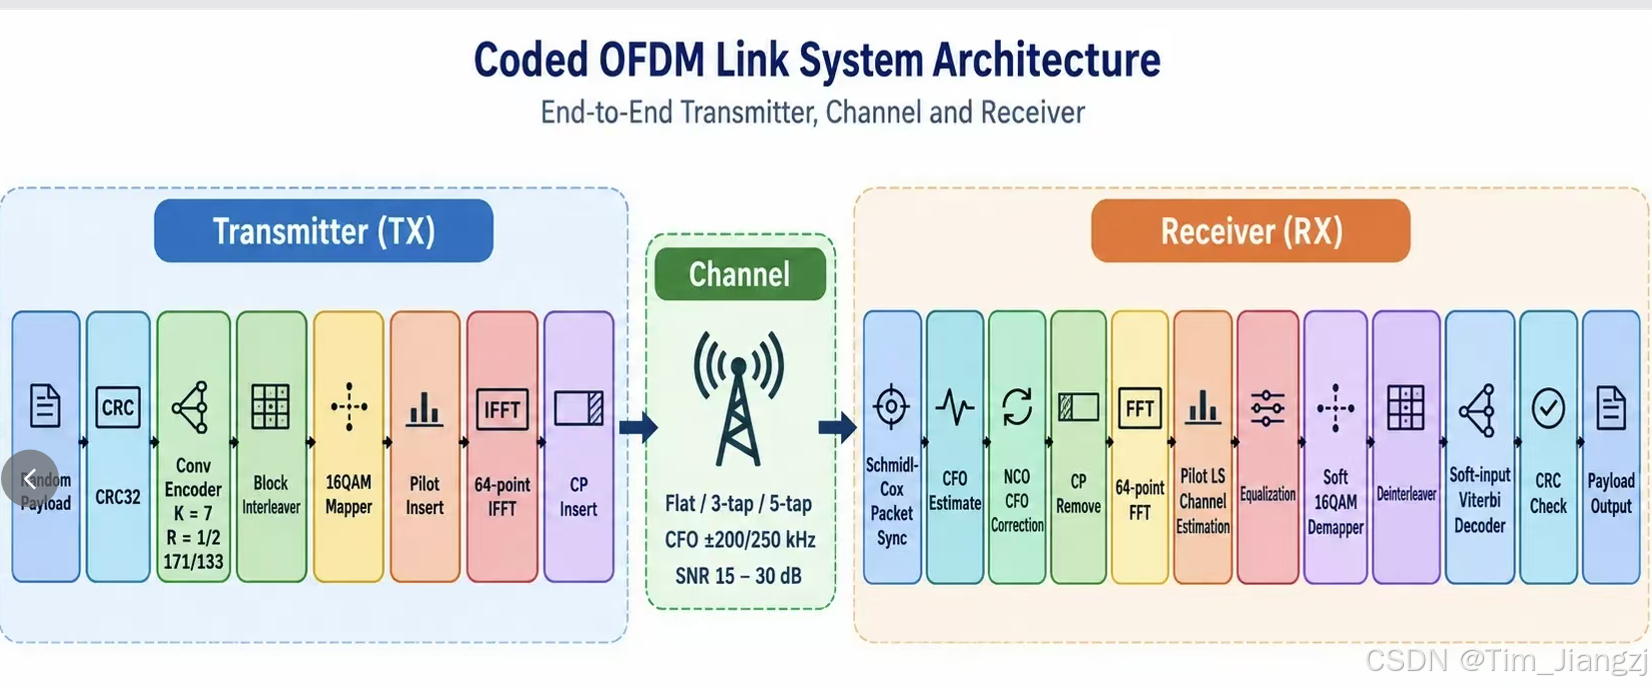
系统主要参数如下:
- FFT 点数:64
- 循环前缀长度:16
- 有效子载波:52
- 数据子载波:48
- 导频子载波:4
- 调制方式:16QAM
- 信道编码:码率 R=1/2R=1/2R=1/2、约束长度 K=7K=7K=7 的卷积码
- 生成多项式:171/133171/133171/133(八进制)
- 信道模型:平坦、3 径或 5 径多径信道
- 载波频偏:约 ±200∼250 kHz\pm200\sim250\text{ kHz}±200∼250 kHz
- 信噪比:15~30 dB
一、系统总体结构
整个编码 OFDM 系统可以分为三个部分:
text
原始数据
   ↓
发射机:CRC → 信道编码 → 交织 → 16QAM → 导频 → IFFT → CP
   ↓
无线信道:多径衰落 + 载波频偏 + 噪声
   ↓
接收机:同步 → 频偏校正 → 去CP → FFT → 信道估计
        → 均衡 → 软解调 → 解交织 → Viterbi译码 → CRC
   ↓
恢复数据
发射机负责给数据增加保护并生成 OFDM 波形;信道负责模拟真实无线环境;接收机则需要估计并补偿信道带来的各种失真。
二、OFDM 发射机处理流程
1. 生成原始数据
发射端首先生成一段随机二进制数据,作为待传输的有效载荷:
bn∈{0,1} bn\in\{0,1\} bn∈{0,1}
在仿真中使用随机数据有两个好处:
- 可以比较发送数据与接收数据,计算误码率;
- 可以通过多次随机试验评估系统性能。
在真实系统中,这些数据可能来自语音、视频、传感器或者网络数据包。
2. 添加 CRC32
CRC32 用于检测接收数据是否发生错误。
发送端根据有效载荷计算 32 位 CRC,并将其附加到数据尾部:
Packet=Payload∥CRC32 \text{Packet}=\text{Payload}\parallel\text{CRC32} Packet=Payload∥CRC32
其中,符号 ∥\parallel∥ 表示数据拼接。
需要注意的是,CRC 只能检错,不能纠错。真正负责纠错的是后面的卷积编码和 Viterbi 译码。
接收端重新计算 CRC:
- CRC 一致:数据包大概率正确;
- CRC 不一致:数据包存在错误,需要丢弃或重传。
因此,CRC 通常用于统计误包率 PER,而不仅仅是误码率 BER。
3. 卷积编码
图中的卷积编码器参数为:
K=7,R=12 K=7,\qquad R=\frac{1}{2} K=7,R=21
生成多项式为:
G0=1718,G1=1338 G_0=171_8,\qquad G_1=133_8 G0=1718,G1=1338
码率 R=1/2R=1/2R=1/2 表示每输入 1 bit,编码器输出 2 bit。
例如:
text
输入:1 0 1 1
输出:xx xx xx xx
输出数据量约为输入数据量的两倍,因此降低了有效传输速率,但提高了抗噪声能力。
约束长度 K=7K=7K=7 表明当前编码结果不仅取决于当前输入,还与之前若干输入有关。接收端可以利用这种关联,通过 Viterbi 算法恢复最可能的原始比特序列。
4. 块交织
卷积码比较擅长纠正分散的随机错误,但无线信道经常产生连续错误。
例如,某个频率区域发生深衰落时,相邻子载波上的多个比特可能同时出错。块交织器通过重新排列编码比特,将相邻比特分散到不同位置。
假设编码数据按行写入矩阵:
b0b1b2b3b4b5b6b7b8 \begin{bmatrix} b_0 & b_1 & b_2 \\ b_3 & b_4 & b_5 \\ b_6 & b_7 & b_8 \end{bmatrix} b0b3b6b1b4b7b2b5b8
然后按列读出:
b0,b3,b6,b1,b4,b7,b2,b5,b8 b_0,b_3,b_6,b_1,b_4,b_7,b_2,b_5,b_8 b0,b3,b6,b1,b4,b7,b2,b5,b8
经过无线信道后,即使出现一段连续错误,接收端解交织后,这些错误也会被分散,从而提高 Viterbi 译码的成功率。
5. 16QAM 调制
经过编码和交织的比特被送入 16QAM 调制器。
16QAM 一共有 16 个星座点,因此每个复数符号可以携带:
log216=4 bit \log_2 16=4\text{ bit} log216=4 bit
例如,一组比特可能按照 Gray 编码映射为:
text
0000 → -3-3j
0001 → -3-1j
0011 → -3+1j
0010 → -3+3j
实际使用时通常还需要进行功率归一化。若星座点取值为 ±1\pm1±1 和 ±3\pm3±3,平均符号能量为 10,因此可除以 10\sqrt{10}10 :
Xnorm=X10 X_{\text{norm}}=\frac{X}{\sqrt{10}} Xnorm=10 X
Gray 映射可以保证相邻星座点通常只相差 1 bit,从而降低误符号造成的比特错误数量。
16QAM 的频谱效率高于 BPSK 和 QPSK,但星座点之间距离更近,因此对噪声、频偏和信道估计误差更加敏感。
6. 插入导频
系统共有 52 个占用子载波,其中:
- 48 个用于传输数据;
- 4 个用于发送导频。
导频是收发双方都已知的符号。接收机通过比较导频的发送值和接收值,估计无线信道对信号造成的幅度衰减与相位旋转。
可以将频域 OFDM 符号表示为:
Xk={Xdk,k∈DXpk,k∈P0,其他位置 Xk= \begin{cases} X_dk, & k\in\mathcal{D}\\ X_pk, & k\in\mathcal{P}\\ 0, & \text{其他位置} \end{cases} Xk=⎩ ⎨ ⎧Xdk,Xpk,0,k∈Dk∈P其他位置
其中:
- D\mathcal{D}D 为数据子载波集合;
- P\mathcal{P}P 为导频子载波集合;
- 未使用的子载波被置零。
64 个子载波中没有全部投入使用,是为了保留直流子载波和频带两侧的保护子载波。
7. 64 点 IFFT
完成子载波映射后,通过 64 点 IFFT 将频域符号转换成时域波形:
xn=164∑k=063Xkej2πkn/64 xn=\frac{1}{64} \sum_{k=0}^{63}Xke^{j2\pi kn/64} xn=641k=0∑63Xkej2πkn/64
IFFT 将多个彼此正交的子载波合成为一个时域 OFDM 符号。
这些子载波在频域上存在重叠,但由于它们相互正交,接收端仍然可以使用 FFT 将其分离。这也是 OFDM 具有较高频谱利用率的重要原因。
8. 添加循环前缀
系统的循环前缀长度为 16。发送端将时域 OFDM 符号最后 16 个采样点复制到符号前面:
xCP=x\[48,...,x63,x0,...,x63] x_{\mathrm{CP}}= x\[48,\ldots,x63,x0,\ldots,x63] xCP=x\[48,...,x63,x0,...,x63]
添加循环前缀后的符号总长度为:
64+16=80 64+16=80 64+16=80
循环前缀主要有两个作用:
- 减少多径造成的符号间干扰;
- 将信道线性卷积转化为有效区间内的循环卷积。
只要信道最大时延扩展不超过循环前缀长度,接收机就可以在频域使用单抽头均衡器补偿信道。
其代价是增加了传输开销。本系统的循环前缀开销为:
1664=25% \frac{16}{64}=25\% 6416=25%
三、无线信道模型
图中的信道同时考虑了多径、载波频偏和噪声。
1. 多径信道
多径信道可以表示为:
hn=∑l=0L−1hlδn−τl hn=\sum_{l=0}^{L-1}h_l\deltan-\\tau_l hn=l=0∑L−1hlδn−τl
其中:
- hlh_lhl 为第 lll 条路径的复数增益;
- τl\tau_lτl 为对应路径时延;
- LLL 为路径数量。
图中支持三种情况:
- 平坦信道;
- 3-tap 多径信道;
- 5-tap 多径信道。
平坦信道主要改变整体幅度和相位;多径信道则会使不同子载波经历不同的衰减,从而形成频率选择性衰落。
2. 载波频偏
发射机与接收机的本振频率不可能完全一致,同时用户移动也可能带来多普勒频移,这些因素都会产生载波频偏 CFO。
带有频偏的接收信号可以表示为:
rn=snej2πΔfn/Fs rn=sne^{j2\pi\Delta f n/F_s} rn=snej2πΔfn/Fs
其中:
- Δf\Delta fΔf 为载波频偏;
- FsF_sFs 为采样率。
CFO 会造成:
- 星座图持续旋转;
- 子载波之间的正交性被破坏;
- 产生载波间干扰 ICI;
- 接收误码率明显升高。
因此,接收机必须在 FFT 前进行频偏估计与校正。
3. 高斯白噪声
信道还会加入复高斯白噪声:
yn=(x∗h)nej2πΔfn/Fs+wn yn=(x*h)ne^{j2\pi\Delta f n/F_s}+wn yn=(x∗h)nej2πΔfn/Fs+wn
其中:
wn∼CN(0,σ2) wn\sim\mathcal{CN}(0,\sigma^2) wn∼CN(0,σ2)
图中的仿真信噪比范围为 15~30 dB,可以用于观察系统误码率和误包率随信噪比的变化。
四、OFDM 接收机处理流程
1. Schmidl-Cox 包检测与同步
接收机首先需要确定数据包从哪里开始。
Schmidl-Cox 算法使用具有重复结构的训练序列完成包检测和粗定时同步。假设训练符号由两个相同的长度为 LLL 的序列构成,其延迟相关值为:
P(d)=∑m=0L−1r∗d+mrd+m+L P(d)=\sum_{m=0}^{L-1} r^*d+mrd+m+L P(d)=m=0∑L−1r∗d+mrd+m+L
接收信号能量为:
R(d)=∑m=0L−1∣rd+m+L∣2 R(d)=\sum_{m=0}^{L-1}|rd+m+L|^2 R(d)=m=0∑L−1∣rd+m+L∣2
同步度量可写为:
M(d)=∣P(d)∣2R2(d) M(d)=\frac{|P(d)|^2}{R^2(d)} M(d)=R2(d)∣P(d)∣2
当滑动窗口进入重复训练序列时,相关度量会明显增大。接收机根据该特征检测数据包,并估计 OFDM 符号的起始位置。
如果定时位置错误,FFT 窗口会发生偏移,严重时将破坏子载波正交性。
2. CFO 估计
Schmidl-Cox 的相关结果不仅可以用于定时,还可以估计粗载波频偏。
由于训练序列前后两部分相同,它们之间的相位差主要来自 CFO:
ϕ^=arg(P(d)) \hat{\phi}=\arg(P(d)) ϕ^=arg(P(d))
进而可估计频偏:
Δf^=ϕ^Fs2πL \widehat{\Delta f} =\frac{\hat{\phi}F_s}{2\pi L} Δf =2πLϕ^Fs
该方法存在一定估计范围限制,因此工程系统有时还会增加短训练序列和长训练序列,分别完成粗频偏与细频偏估计。
3. NCO 频偏校正
获得频偏估计值后,接收机使用数控振荡器 NCO 产生反向旋转信号:
rcn=rne−j2πΔf^n/Fs r_cn=rn e^{-j2\pi\widehat{\Delta f}n/F_s} rcn=rne−j2πΔf n/Fs
理想情况下,校正后的残余频偏接近零。
这一处理应当在 FFT 之前完成。因为严重 CFO 会产生 ICI,仅在 FFT 后修正公共相位并不能完全消除其影响。
4. 去除循环前缀
完成同步和频偏校正后,接收机删除每个 OFDM 符号前面的 16 个循环前缀采样,只保留后面的 64 个有效采样点。
如果符号起始位置正确,并且信道最大时延小于 CP 长度,去除 CP 后便可对有效数据执行 FFT。
5. 64 点 FFT
接收机使用 64 点 FFT,将时域信号转换回频域:
Yk=∑n=063yne−j2πkn/64 Yk=\sum_{n=0}^{63} yne^{-j2\pi kn/64} Yk=n=0∑63yne−j2πkn/64
在循环前缀足够长且同步准确的情况下,每个子载波近似满足:
Yk=HkXk+Wk Yk=HkXk+Wk Yk=HkXk+Wk
这意味着复杂的时域多径卷积被转换成了频域上的逐子载波乘法,大幅降低了均衡复杂度。
6. 基于导频的 LS 信道估计
在导频位置,发送符号 XpkX_pkXpk 是已知的,因此可以采用最小二乘法估计信道:
H^kp=YkpXpkp \hat{H}k_p =\frac{Yk_p}{X_pk_p} H^kp=XpkpYkp
由于只有 4 个导频,而数据子载波有 48 个,因此还需要通过线性插值、样条插值或其他方法获得所有数据子载波上的信道估计值。
LS 算法优点是结构简单、计算量低;缺点是没有充分利用噪声统计信息,在低信噪比下估计误差较大。
若需要进一步提高性能,可以考虑:
- MMSE 信道估计;
- DFT 降噪;
- 时频二维插值;
- 判决反馈信道跟踪。
7. 软均衡
最简单的迫零均衡形式为:
X^k=YkH^k \hat{X}k=\frac{Yk}{\hat{H}k} X^k=H^kYk
但当 ∣H^k∣|\hat{H}k|∣H^k∣ 很小时,迫零均衡会放大噪声。因此实际系统可以使用 MMSE 均衡:
X^k=H^∗k∣H^k∣2+σn2/EsYk \hat{X}k =\frac{\hat{H}^*k} {|\hat{H}k|^2+\sigma_n^2/E_s} Yk X^k=∣H^k∣2+σn2/EsH^∗kYk
软均衡不仅需要输出估计符号,还应保留该子载波的可靠度信息,使后续软解调器知道哪些符号更可信。
8. 16QAM 软解调
硬判决解调直接将接收符号映射为 0 或 1,会丢失置信度信息。
软解调则为每一个比特计算对数似然比 LLR:
L(bi)=lnP(bi=0∣Y)P(bi=1∣Y) L(b_i) =\ln \frac{P(b_i=0\mid Y)} {P(b_i=1\mid Y)} L(bi)=lnP(bi=1∣Y)P(bi=0∣Y)
其绝对值表示判决置信度:
- LLR 绝对值越大,判决越可靠;
- LLR 接近 0,表示该比特难以确定;
- LLR 的正负表示更倾向于 0 还是 1,具体符号约定由实现决定。
使用 max-log 近似后:
L(bi)≈1σ2mins∈Si1∣Y−s∣2−mins∈Si0∣Y−s∣2 L(b_i)\approx \frac{1}{\sigma^2} \left\\min_{s\\in S_i\^1}\|Y-s\|\^2 -\\min_{s\\in S_i\^0}\|Y-s\|\^2 \\right L(bi)≈σ21s∈Si1min∣Y−s∣2−s∈Si0min∣Y−s∣2
软信息可以显著提高 Viterbi 译码性能,尤其是在中低信噪比条件下。
9. 解交织
接收机按照与发送端相反的排列规则重新组织 LLR。
需要特别注意:软接收机解交织的是一组 LLR,而不是已经完成硬判决的 0、1 序列。LLR 的顺序改变,但数值和符号应完整保留。
如果发送端和接收端的交织尺寸或索引规则不一致,即使信道完全没有噪声,也无法正确译码。
10. 软输入 Viterbi 译码
Viterbi 算法根据卷积码的状态转移关系,寻找累计路径度量最小或概率最大的路径。
对于约束长度 K=7K=7K=7 的卷积码,编码器状态数为:
2K−1=64 2^{K-1}=64 2K−1=64
相比硬输入 Viterbi,软输入译码器使用 LLR 或量化软值计算分支度量,能够利用接收信号的可靠度,因此通常具有更好的译码性能。
实现时还应注意:
- 编码器是否使用尾比特归零;
- Viterbi 回溯长度;
- 生成多项式的位序;
- LLR 正负号定义;
- 编码器与译码器的初始、终止状态。
这些参数只要有一项不一致,就可能出现无法译码的问题。
11. CRC 校验与有效载荷输出
Viterbi 输出译码比特后,接收机分离有效载荷和 CRC,并重新计算 CRC32。
text
CRC 正确 → 输出 Payload
CRC 错误 → 丢弃该数据包
至此,接收机完成了从 IQ 采样到原始数据的全部恢复过程。
五、系统吞吐率分析
每个 OFDM 符号包含 48 个数据子载波。采用 16QAM 时,每个子载波携带 4 bit,因此调制后每个 OFDM 符号携带:
48×4=192 bit 48\times4=192\text{ bit} 48×4=192 bit
卷积码码率为 1/21/21/2,所以对应的信息比特约为:
192×12=96 bit 192\times\frac{1}{2}=96\text{ bit} 192×21=96 bit
考虑 16 点循环前缀后,OFDM 的时间利用率为:
ηCP=6464+16=0.8 \eta_{\mathrm{CP}} =\frac{64}{64+16} =0.8 ηCP=64+1664=0.8
如果只考虑卷积编码和 CP,不考虑 CRC、前导、导频占用等额外开销,则相对于全部 64 个子载波的理论比特利用率为:
η=4864×4×12×6480=1.2 \eta =\frac{48}{64} \times4 \times\frac{1}{2} \times\frac{64}{80} =1.2 η=6448×4×21×8064=1.2
即平均每个时域采样约承载 1.2 个有效信息比特。实际净吞吐率还需要扣除前导、CRC、包间隔和可能的填充比特。
六、建议的仿真调试顺序
完整链路模块较多,如果一开始就同时加入多径、频偏和噪声,很难快速定位故障。建议按照以下顺序调试。
第一阶段:验证基础收发链路
关闭噪声、多径和频偏,只测试:
text
16QAM → IFFT → CP → 去CP → FFT → 16QAM解调此时误码率应当为零。
第二阶段:验证编码链路
加入:
text
卷积编码 → 交织 → 解交织 → Viterbi译码无噪声情况下,译码结果仍应完全正确。
第三阶段:加入 AWGN
扫描不同 SNR,观察 BER 曲线是否随 SNR 增大而下降,同时比较:
- 未编码与卷积编码;
- 硬判决与软判决。
第四阶段:加入多径
加入 3-tap 或 5-tap 信道,验证:
- CP 长度是否足够;
- 导频索引是否一致;
- 信道估计是否正确;
- 均衡后星座是否恢复。
第五阶段:加入频偏和同步
最后加入 CFO、前导和 Schmidl-Cox 同步,观察:
- 包检测成功率;
- 定时位置误差;
- CFO 估计误差;
- 校正前后的星座图;
- 最终误包率。
七、常见问题
1. 无噪声时仍然出现误码
优先检查:
- FFT 与 IFFT 是否使用相同的移位规则;
- 子载波索引是否一致;
- 16QAM 映射和解映射是否匹配;
- 交织和解交织是否严格互逆;
- 卷积码生成多项式的位序是否一致。
2. 频偏校正后星座图仍在旋转
可能原因包括:
- CFO 估计符号方向写反;
- NCO 校正指数正负号错误;
- 采样率或训练序列长度代入错误;
- 仍存在残余频偏或公共相位误差。
3. 均衡后部分子载波噪声很大
这通常意味着对应子载波位于信道深衰落区域。迫零均衡在除以很小的 ∣Hk∣|Hk|∣Hk∣ 时会严重放大噪声,可以改用 MMSE 均衡。
4. Viterbi 输出完全错误
重点检查:
- 171/133171/133171/133 是否按八进制处理;
- LLR 的正负定义是否正确;
- 编码器是否添加尾比特;
- 译码器初始状态是否匹配;
- 回溯长度是否足够。
5. BER 不高,但 CRC 经常失败
BER 统计的是比特错误比例,而 CRC 判断的是整个数据包是否存在错误。即使一包只错了 1 bit,CRC 也会将其判为错误包。因此长数据包的 PER 通常明显高于 BER。
八、总结
本文分析的编码 OFDM 系统并不只是一个 IFFT/FFT 模型,而是一条较完整的数字通信链路:
- CRC32 负责检错;
- 卷积码与 Viterbi 负责纠错;
- 交织负责分散突发错误;
- 16QAM 提高频谱效率;
- 导频用于估计信道;
- IFFT/FFT 实现多载波调制;
- 循环前缀对抗多径;
- Schmidl-Cox 完成包检测和粗同步;
- CFO 估计与 NCO 校正恢复子载波正交性;
- 软均衡与软解调为译码器保留可靠度信息。
这套架构覆盖了 OFDM 物理层中最核心的处理模块,也非常适合作为 MATLAB、Python、GNU Radio、DSP 或 FPGA 链路实现的基础框架。