note
- 文档解析三个特征:
- 视觉token极压缩:"光学压缩"成了新卖点
- 推理加速成为显学:多token预测+投机解码被卷到这个领域
- 训练全面转向"可验证奖励的强化学习"(RLVR)
- LightOnOCR和olmOCR用unit-test式评估+GRPO;
- Infinity-Parser2一次co-train八个任务;
- Jina-OCR-v1用五维乘积奖励(内容、结构、单元测试、重复、格式)给部分分,并特意合成公式/表格密集页喂奖励。
- 三个判断:
- 下一个瓶颈不在"看",在"结构推理"
- 从"全局压token"转向"按内容动态分配token"
- 会有一次"可验证奖励范式"的事故或反噬
文章目录
一、文档解析
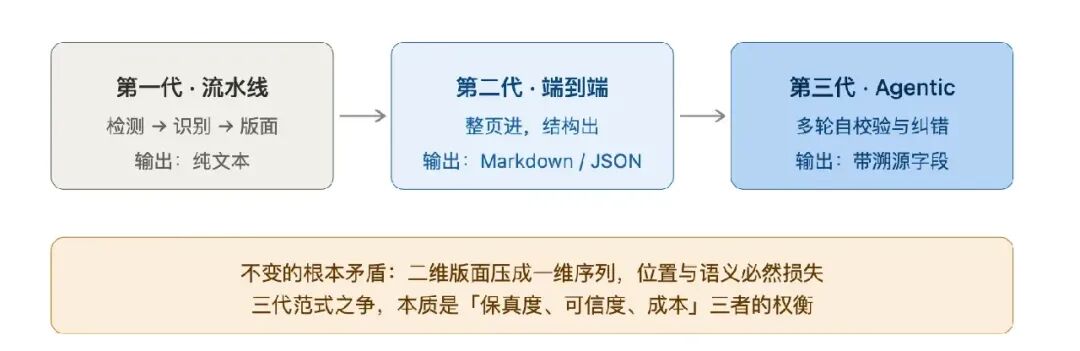
1、三个突出特征
其一,视觉token极压缩:"光学压缩"成了新卖点。
- 2018的ViT一路到Qwen2.5-VL家族,每页要几千个视觉token,贵。2026年大家集体转向把整页视觉信息压成极少量token。例如:DeepSeek-OCR首创"上下文光学压缩":用1024×1024的视图只产出256个视觉token,解码端却能据此输出比视觉token多10倍以上的文本tokenarxiv.org。
- 它的迭代DeepSeek-OCR2换了第二代编码器DeepEncoderV2:把CLIP组件替换成一个小型语言模型,并引入"因果流查询"(causalflowtokens),可学习的查询token像人眼一样按语义动态重组视觉信息blog.csdn.net。代价是公式解析+6.17%、表格+2.5~3%、文本编辑距离降0.025,同时保持16倍视觉token压缩率hub.baai.ac.cn。
- 又如Jina-OCR-v1直接复用DeepSeek-OCR的编码器,把每token像素做到约4096。
其二,推理加速成为显学:多token预测+投机解码被卷到这个领域。
OCR输出长、又高度可预测,成了投机解码的"肥肉"。2026年几乎每家都在解「生成长、解码慢」的问题。代表的:
- FastMTP(共享单块递归草拟)、DFlash(HunyuanOCR-1.5用)、GLM-OCR的共享参数MTP,
- 都在走"一个草稿块猜多个token、主模型批量验证"的路线;
其三,后训练全面转向"可验证奖励的强化学习"(RLVR)。这是2026年最实质的质量来源。不再是纯SFT让模型背答案,而是用确定性可验证奖励+GRPO/DAPO让模型自己摸索更高分,看下代表工作:
- 一个是奖励信号用确定性代码打分:表格用TEDS、公式用CDM、再加结构完整性(括号是否闭合、标签是否闭合、表格是否完整),不需要奖励模型或judge;
- 具体的,又LightOnOCR和olmOCR用unit-test式评估+GRPO;Infinity-Parser2一次co-train八个任务;Jina-OCR-v1用五维乘积奖励(内容、结构、单元测试、重复、格式)给部分分,并特意合成公式/表格密集页喂奖励。
2、三个判断
2、三个判断同样的,有三个判断,也可以做个思考:
判断一:下一个瓶颈不在"看",在"结构推理" 。阅读顺序、多栏、跨行表格,这些"看不见但要想"的结构问题,正是今年分数的洼地(所有模型在reading-order、OldScans上都难看),而且结构恰恰是规则奖励最难表达的(什么叫"阅读顺序对",你很难写成确定性检查)。2027会需要新的监督信号,很可能是强标注的"结构对比合成对"+判别性结构判官。
判断二:从"全局压token"转向"按内容动态分配token" 。全局256token把细节全丢光了。往下走会是全局粗看+局部按需高分辨率:先低精度分栏定结构,再对公式、数字区、小字区动态放大并加token。这是视频编码"人眼敏感区给高码率"的行星级分配逻辑,搬到视觉token上。Deep Encoder V2的causal flowtokens已经是这个方向的苗头。
判断三:会有一次"可验证奖励范式"的事故或反噬 。RLVR太容易被榜单绑架。当几家都靠合成数据喂专项奖励刷分时,模型在真实世界的样张上会集体露馅(奖项能打分的和真实需求开始背离)。其实关于"OCRbenchmark与真实文档错位"的公开争论一直有,就像当年ROUGE被诟病那样。真正确立地位的,会是"保真度追踪+失真优先级预算"这类评估,而不是一个总分。