审批一键催办业务功能的设计与实现
业务需求背景
很简单,就是一个按钮,按下去之后就可以给所有审批人发送催促代办的消息:
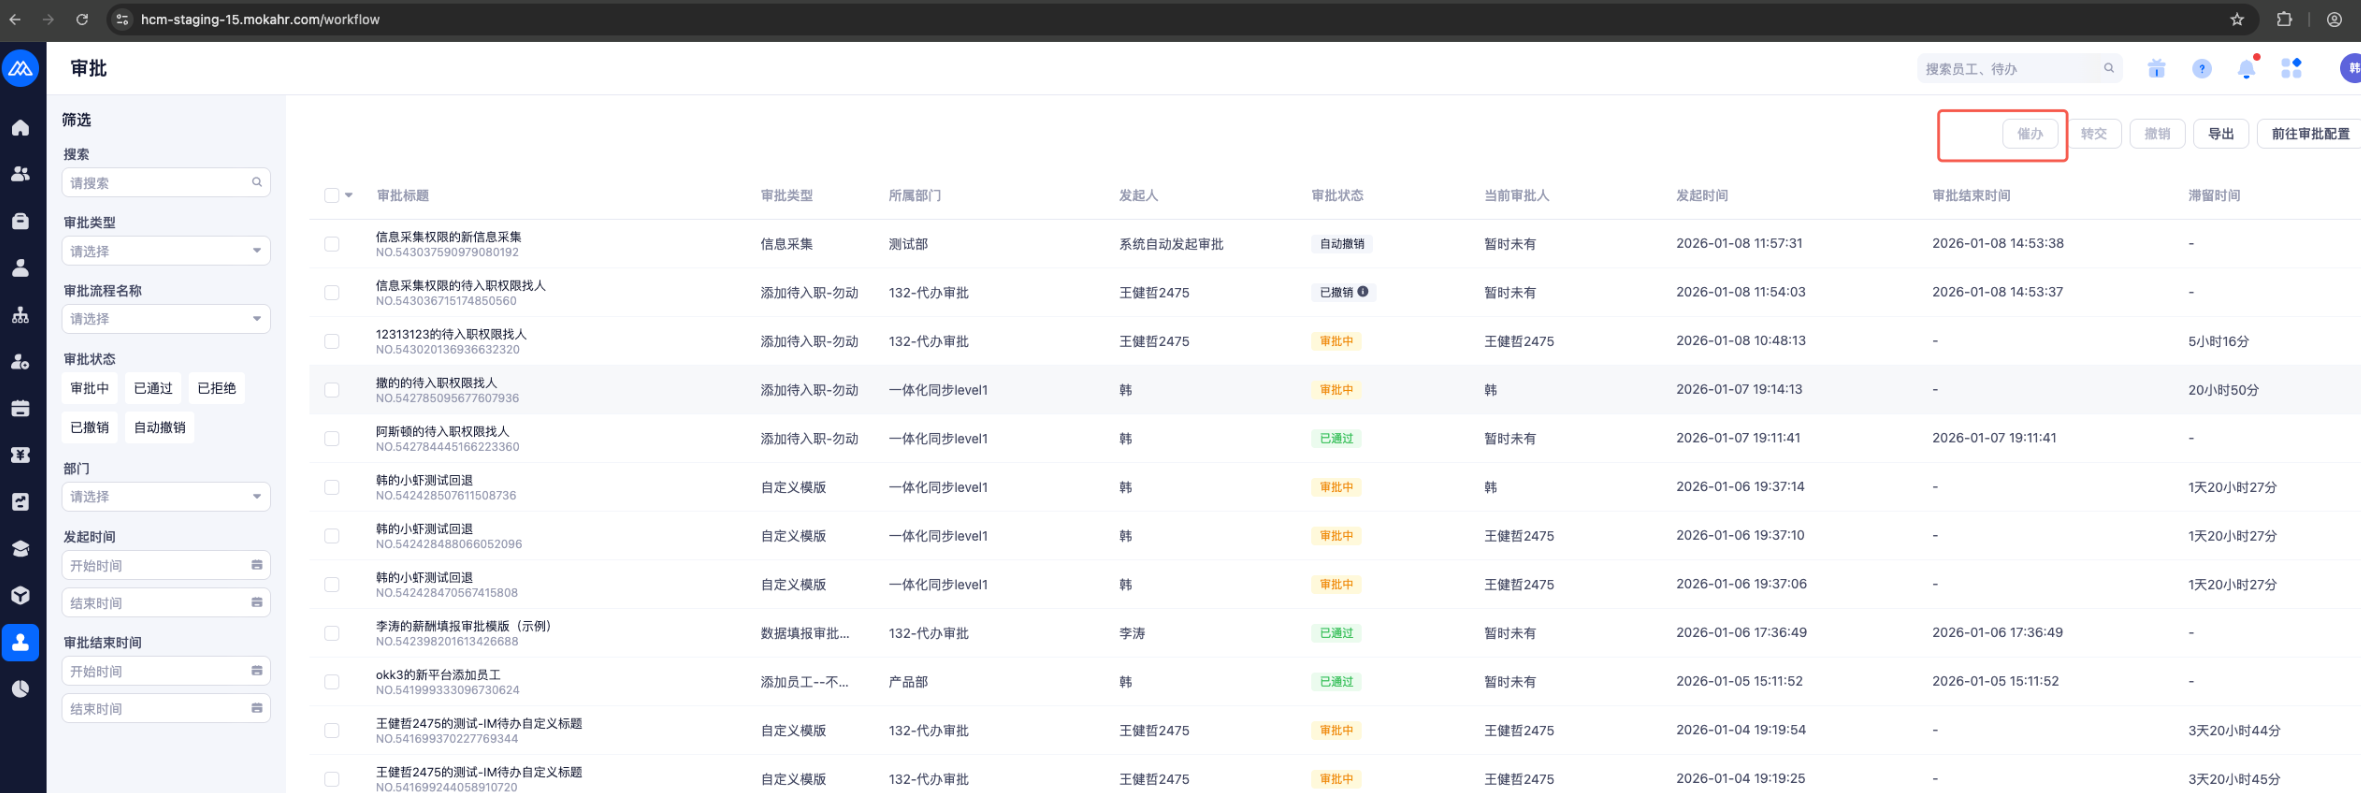
如上图所示,默认是置灰的,现在是只有当勾选了左侧的 审批标题 时,才可以催办当前这一页的内容:
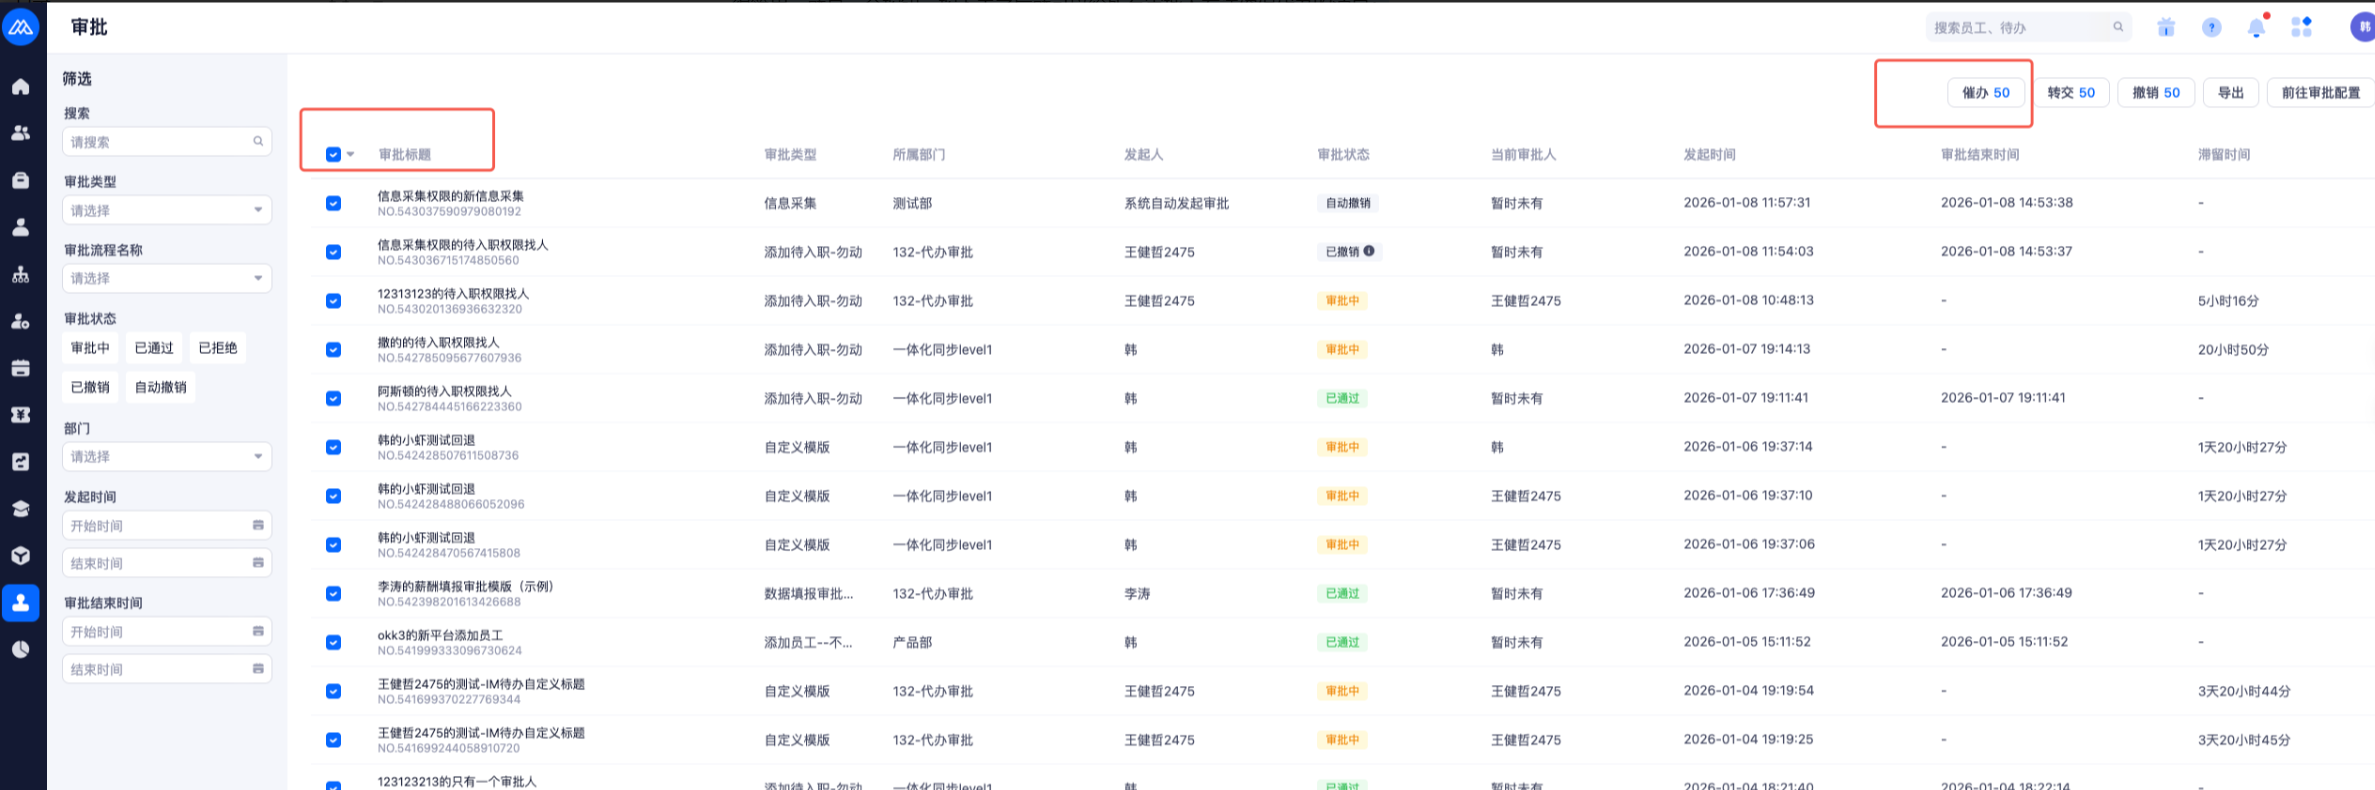
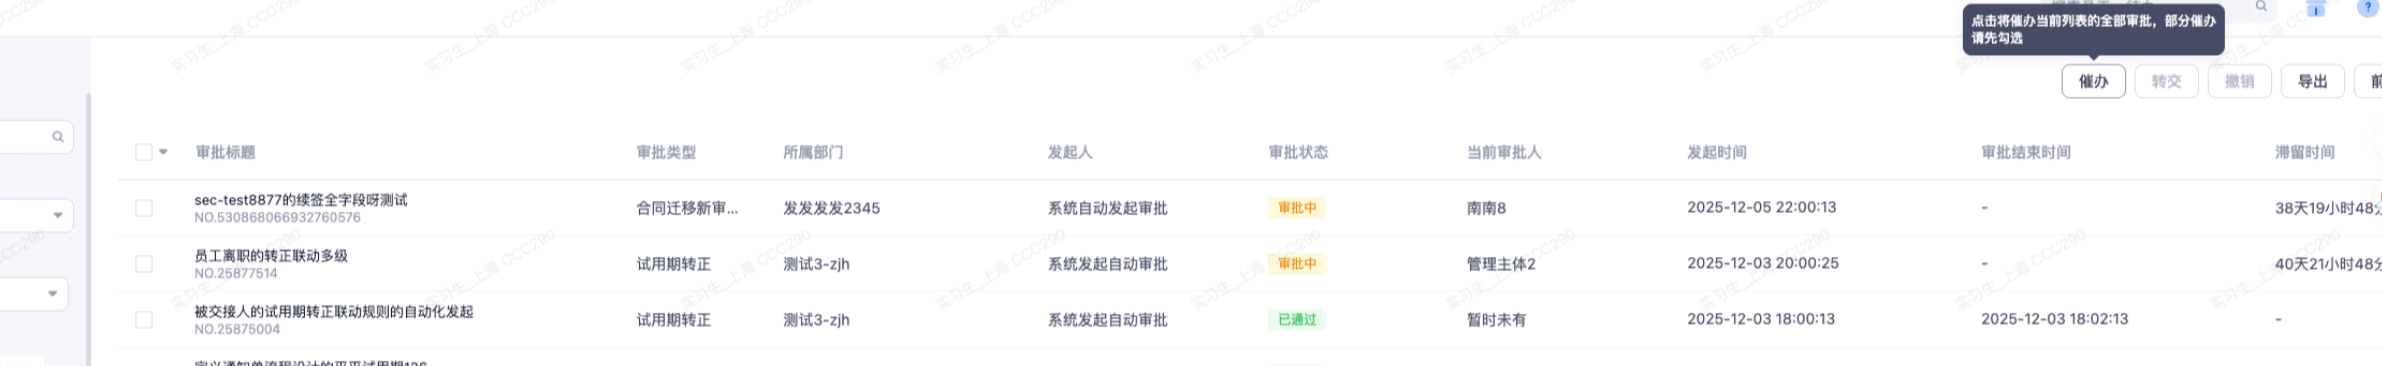
现在要改成,默认没有勾选左侧 审批标题 时,点击催办的效果就变成 一键催办 ,也就是把这个人下面的所有分页记录中的审批都发送催办一下。
设计与实现
一键催办这个功能本质上是一个"入口防重复 + 后台异步执行"的场景,因为它是批量操作且执行时间不可控,如果不做控制,用户频繁点击会导致多个任务并发执行,从而对下游服务造成冲击,同时也会产生重复催办的问题。
因此我在设计时,将防重复逻辑放在 web 请求线程,在分布式锁保护下先检查并写入 Redis 冷却窗口(比如 1 小时 TTL),保证"检查 + 写入 + 投递任务"这一过程的原子性,然后再提交线程池异步执行具体的催办逻辑并立即释放锁,这样既避免了长时间持锁,又能保证前端返回成功就代表请求已经被系统受理。
同时锁的选择上我使用 tryLock 而不是 lock,因为这个场景需要的是拒绝重复提交而不是让请求排队执行,并且我会显式设置一个较短的 leaseTime,而不是依赖看门狗机制,让锁的生命周期更加可控。
整体来说,这个方案通过短锁保证入口原子性,用 Redis TTL 实现业务防重,用异步线程处理耗时任务,从而在高并发和长任务场景下保证系统的稳定性和一致性。
为什么要用分布式锁呢?
在一键催办这个场景中,引入分布式锁的核心目的不是单纯为了加锁,而是为了保证"检查冷却窗口 + 写入窗口 + 提交异步任务"这一整套流程的原子性,避免在并发情况下被重复执行。
理论上最简单的方案其实可以只用 Redis 的 setnx 加 TTL 来实现防重复,因为它本身就是原子操作,已经能解决大部分问题;但是在多实例部署和高并发点击的情况下,如果检查和写入、任务投递这些步骤分散执行,仍然可能出现竞态问题,比如多个请求几乎同时通过校验并各自提交任务。
引入分布式锁之后,可以把这几个步骤收敛在一个短临界区内,保证同一时间只有一个请求能够完成受理,从而让"前端返回成功"严格等价于"后台已成功受理任务"。所以分布式锁并不是必须的,而是在高并发和多实例场景下,为了提升一致性和稳定性所做的一种工程化增强。
如果是单实例或者并发不高的场景,其实可以不加分布式锁,只用 Redis 的 setnx 就够了;我这里加锁主要是为了让受理逻辑更严谨,避免极端并发下的重复提交。
执行顺序如下:
bash
先拿锁
→ 检查窗口标识
→ 提交异步任务
→ 任务提交成功后再写入窗口标识
→ 释放锁
更详细的流程:
bash
用户点击催办
    ↓
web线程获取分布式锁
    ↓
检查 remind:window:{tenantId}:{userId} 是否存在
    ↓
不存在:说明可触发
    ↓
写入 remind:window key,并设置TTL
    ↓
提交异步催办任务到线程池
    ↓
立即释放分布式锁
    ↓
返回前端"催办已提交"
    ↓
异步线程执行实际催办逻辑
为了方便理解,提供了当时的部分代码:
controller 层:
java
@PostMapping("/task/listPageRemind/batch")
public ResponseDto<BatchOperateResp> remindBatch(@RequestBody @Validated RemindBatchReq req) {

    // 普通批量催办逻辑
    if (CollectionUtils.isNotEmpty(req.getRemindBatchItems())) {
        return doNormalBatchRemind(req);
    }

    // 一键催办逻辑:在这里同步完成"是否受理"的判定
    BatchOperateResp resp = allHastenService.oneClickReminderAll(req);

    return ResponseDto.ok(resp);
}
service 接口:
java
public interface AllHastenService {

    /**
     * 返回值不是 void,而是明确告诉前端:
     * 这次请求是"成功受理"还是"被拦截"
     */
    BatchOperateResp oneClickReminderAll(RemindBatchReq req);
}
service 实现:入口防重 + 异步投递:
java
@Slf4j
@Service
public class AllHastenServiceImpl implements AllHastenService {

    @Resource
    private RedissonClient redissonClient;

    @Resource
    private StringRedisTemplate stringRedisTemplate;

    @Resource
    private ThreadPoolManager threadPoolManager;

    @Resource
    private FlowInstSearchService flowInstSearchService;

    @Resource
    private FlowInstOperateService flowInstOperateService;

    private static final String SUBMIT_LOCK_KEY = "one_click_remind:submit_lock:%s:%s";
    private static final String COOL_DOWN_KEY   = "one_click_remind:cool_down:%s:%s";

    // 冷却窗口:1小时
    private static final long COOL_DOWN_SECONDS = 3600L;

    // 短临界区锁的最大持有时间:几秒足够
    private static final long SUBMIT_LOCK_LEASE_SECONDS = 5L;

    // 批次大小
    private static final int BATCH_SIZE = 500;

    @Override
    public BatchOperateResp oneClickReminderAll(RemindBatchReq req) {
        String tenantId = req.getTenantId();
        String userId = req.getUserId();

        String submitLockKey = String.format(SUBMIT_LOCK_KEY, tenantId, userId);
        String coolDownKey = String.format(COOL_DOWN_KEY, tenantId, userId);

        RLock lock = redissonClient.getLock(submitLockKey);

        boolean locked = false;
        try {
            // 这里只保护短临界区,所以可以显式给一个较短 leaseTime
            locked = lock.tryLock(0, SUBMIT_LOCK_LEASE_SECONDS, TimeUnit.SECONDS);

            if (!locked) {
                log.info("一键催办提交过于频繁,正在并发提交中: tenantId={}, userId={}", tenantId, userId);
                throw new CommonCustomException(ErrorCode.SYS_OPERATION_TOO_FREQUENT.getCode(), "请求处理中,请勿重复点击");
            }

            // 1. 检查冷却窗口
            Boolean exists = stringRedisTemplate.hasKey(coolDownKey);
            if (Boolean.TRUE.equals(exists)) {
                log.info("一键催办命中冷却窗口: tenantId={}, userId={}", tenantId, userId);
                throw new CommonCustomException(ErrorCode.SYS_OPERATION_TOO_FREQUENT.getCode(), "1小时内已执行过一键催办,请稍后再试");
            }

            // 2. 先写冷却窗口,再投递异步任务
            // 这样可保证"防重复触发"在入口原子完成
            stringRedisTemplate.opsForValue().set(coolDownKey, "1", COOL_DOWN_SECONDS, TimeUnit.SECONDS);

            // 3. 生成任务ID,方便日志追踪/监控
            long taskId = SnowflakeSequence.nextId();

            // 4. 提交异步任务
            threadPoolManager.getDefaultExecutor().execute(() -> {
                doOneClickReminderAsync(req, taskId, coolDownKey);
            });

            log.info("一键催办受理成功: tenantId={}, userId={}, taskId={}", tenantId, userId, taskId);

            return BatchOperateResp.builder()
                    .progressId(taskId)
                    .build();

        } catch (CommonCustomException e) {
            throw e;
        } catch (Exception e) {
            log.error("一键催办受理失败: tenantId={}, userId={}", tenantId, userId, e);
            throw new CommonCustomException(ErrorCode.SYSTEM_ERROR.getCode(), "一键催办提交失败");
        } finally {
            if (locked && lock.isHeldByCurrentThread()) {
                lock.unlock();
            }
        }
    }
异步执行真正的一键催办:
java
    /**
     * 真正耗时的催办逻辑只放在异步线程里
     */
    private void doOneClickReminderAsync(RemindBatchReq req, long taskId, String coolDownKey) {
        int totalCount = 0;
        int totalSuccess = 0;
        int totalFail = 0;

        try {
            FlowInstListSearchReq searchReq = buildSearchRequest(req);

            long cursor = 0L;
            boolean hasNext = true;
            int batchIndex = 0;

            while (hasNext) {
                batchIndex++;
                searchReq.setCursor(cursor);
                searchReq.setPageSize(BATCH_SIZE);

                FlowInstListSearchRespBO searchResp = flowInstSearchService.cursorBasedSearch(searchReq);

                if (searchResp == null || CollectionUtils.isEmpty(searchResp.getFlowInstEsDocList())) {
                    break;
                }

                List<FlowInstListSearchRespBO.FlowInstSearchBO> flowInstList = searchResp.getFlowInstEsDocList();
                totalCount += flowInstList.size();

                List<TaskInstRemindParamBO> params = convertToRemindParams(flowInstList, req);

                int successCount = executeBatchRemind(params, batchIndex);
                totalSuccess += successCount;
                totalFail += (flowInstList.size() - successCount);

                cursor = searchResp.getCursor();
                hasNext = searchResp.isHasNext();

                log.info("一键催办批次完成: taskId={}, batchIndex={}, batchSize={}, nextCursor={}, hasNext={}",
                        taskId, batchIndex, flowInstList.size(), cursor, hasNext);
            }

            log.info("一键催办执行完成: taskId={}, totalCount={}, success={}, fail={}",
                    taskId, totalCount, totalSuccess, totalFail);

        } catch (Exception e) {
            log.error("一键催办异步执行失败: taskId={}, tenantId={}, userId={}, totalCount={}, success={}, fail={}",
                    taskId, req.getTenantId(), req.getUserId(), totalCount, totalSuccess, totalFail, e);

            // 这里有两种策略,面试时你要讲清楚你选哪一种
            // 策略A:不删除 coolDownKey
            //   含义:只要入口成功受理,就进入1小时冷却,防止频繁重试把系统打爆
            //
            // 策略B:删除 coolDownKey
            //   含义:如果异步执行失败,允许用户立刻重试
            //
            // 对于审批催办这种高频入口、防抖更重要的场景,我更推荐策略A:不删
        }
    }
一些辅助方法:
java
    private FlowInstListSearchReq buildSearchRequest(RemindBatchReq req) {
        FlowInstListSearchReq searchReq = new FlowInstListSearchReq();
        OperatorInfoUtils.copy(req, searchReq);
        searchReq.setFlowInstStatusList(Collections.singletonList(InstanceStatusEnum.APPROVING.getVal()));
        searchReq.setFilterAuthority(true);
        searchReq.setCursor(0L);
        return searchReq;
    }

    private List<TaskInstRemindParamBO> convertToRemindParams(
            List<FlowInstListSearchRespBO.FlowInstSearchBO> flowInstList,
            RemindBatchReq req) {

        return flowInstList.stream().map(flowInst -> {
            TaskInstRemindParamBO param = new TaskInstRemindParamBO();
            OperatorInfoUtils.copy(req, param);
            param.setFlowInstId(flowInst.getFlowInstId());
            param.setAll(true);
            param.setContent(getRemindContent(req));
            param.setMessageAggregate(true);
            return param;
        }).collect(Collectors.toList());
    }

    private String getRemindContent(RemindBatchReq req) {
        if (CollectionUtils.isNotEmpty(req.getRemindBatchItems())) {
            return req.getRemindBatchItems().get(0).getContent();
        }
        return "催办";
    }

    private int executeBatchRemind(List<TaskInstRemindParamBO> params, int batchIndex) {
        if (CollectionUtils.isEmpty(params)) {
            return 0;
        }

        int successCount = 0;
        for (TaskInstRemindParamBO param : params) {
            try {
                flowInstOperateService.remind(param);
                successCount++;
            } catch (Exception e) {
                log.error("批次催办失败: batchIndex={}, flowInstId={}", batchIndex, param.getFlowInstId(), e);
            }
        }
        return successCount;
    }
}
采用 ES 游标分页 + 批次处理 解释
因为催办的数据是存储在 ES 里的,ES 做关键字检索非常快,因此从 ES(elastic search)里拉取数据。
但是因为数据量太大,为了防止一次性拉入导致内存爆炸,我们通过游标查询的方式来拉取数据,也就是通过一个标记一批一批的拉。
线程池 + CountDownLatch
用线程池来实现分批拉取,CountDownLatch 用来等待所有批次拉完。具体的话可以看上面的代码。
Redisson 分布式锁 + 成功后时间窗口限制
这个在最前面的设计里说过了。
针对并发穿透场景,引入 双重判定机制
这个有点不太记得了,可以删除掉这部分内容,当时做方案设计的时候这个好像最后没用,逻辑说不通。
实现简易 动态线程池调参能力
代码:
java
package com.moka.workflow.platform.base.common.util;

import cn.hutool.core.thread.NamedThreadFactory;
import com.google.common.collect.Lists;
import com.google.common.collect.Maps;
import com.moka.prometheus.util.MokaPrometheusUtil;
import com.moka.workflow.platform.base.common.apollo.ApolloConfReaderFactory;
import com.moka.workflow.platform.base.common.config.ThreadPoolConfig;
import com.moka.workflow.platform.base.common.metrics.BasicMetricConstants;
import io.micrometer.core.instrument.Tag;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.BeanUtils;
import org.springframework.stereotype.Service;

import javax.annotation.PostConstruct;
import java.util.Map;
import java.util.concurrent.*;
import java.util.concurrent.atomic.AtomicInteger;

/**
 * User: yuxiang.sun
 * Date: 3/30/22
 * Time: 12:05 PM
 */
@Slf4j
@Service
public class ThreadPoolManager {

    /**
     * 管理的所有线程池
     */
    private ConcurrentHashMap<String, SWThreadPoolExecutor> threadPoolMap
            = new ConcurrentHashMap<>();

    /**
     * 记录线程池的数量
     */
    public final AtomicInteger threadPoolCount = new AtomicInteger(0);

    public Map<String, SWThreadPoolExecutor> getAllPool() {
        Map<String, SWThreadPoolExecutor> ret = Maps.newHashMap();
        ret.putAll(threadPoolMap);
        return ret;
    }

    /**
     * 默认线程池配置
     */
    private static final ThreadPoolConfig DEFAULT_THREAD_POOL_CONFIG = ThreadPoolConfig
            .builder()
            .threadPoolName("default")
            .coreSize(50)
            .maxSize(50)
            .keepAliveSecond(60)
            .queueSize(10000)
            .fullHandler(new ThreadPoolExecutor.CallerRunsPolicy())
            .build();

    /**
     * 默认允许创建的线程池个数上限
     */
    private static final int DEFAULT_THREAD_POOL_COUNT_THRESHOLD = 10;

    /**
     * apollo配置前缀
     */
    private static final String CORE_SIZE_KEY_PREFIX = "tp.core.size.";
    private static final String MAX_SIZE_KEY_PREFIX = "tp.max.size.";
    private static final String THREAD_POOL_COUNT_THRESHOLD_KEY = "tp.count.threshold";

    @PostConstruct
    private void init() {
        threadPoolMap.put(DEFAULT_THREAD_POOL_CONFIG.getThreadPoolName(), buildThreadPool(DEFAULT_THREAD_POOL_CONFIG));
    }

    /**
     * 获取默认的公用线程池
     */
    public ThreadPoolExecutor getDefaultExecutor() {
        return getExecutor(DEFAULT_THREAD_POOL_CONFIG);
    }

    /**
     * 获取指定名字的线程池,优先从缓存中获取,没有则使用配置创建
     *
     * @param threadPoolName 线程池名称
     * @return 线程池
     */
    public ThreadPoolExecutor getExecutor(String threadPoolName) {
        ThreadPoolConfig threadPoolConfig = new ThreadPoolConfig();
        BeanUtils.copyProperties(DEFAULT_THREAD_POOL_CONFIG, threadPoolConfig);
        threadPoolConfig.setThreadPoolName(threadPoolName);
        return getExecutor(threadPoolConfig);
    }

    public ThreadPoolExecutor getExecutor(ThreadPoolConfig threadPoolConfig) {
        String threadPoolName = threadPoolConfig.getThreadPoolName();
        SWThreadPoolExecutor threadPoolExecutor = threadPoolMap.get(threadPoolName);
        if (threadPoolExecutor != null) {
            return refresh(threadPoolName, threadPoolExecutor);
        }

        int threshold = ApolloConfReaderFactory.ofInteger(THREAD_POOL_COUNT_THRESHOLD_KEY,
                DEFAULT_THREAD_POOL_COUNT_THRESHOLD).read();
        //限制Apollo只能增加数量
        threshold = Math.max(threshold, DEFAULT_THREAD_POOL_COUNT_THRESHOLD);

        if (threadPoolCount.get() < threshold && threadPoolCount.getAndIncrement() < threshold) {
            SWThreadPoolExecutor executor = threadPoolMap
                    .computeIfAbsent(threadPoolName, (key) -> buildThreadPool(threadPoolConfig));
            return refresh(threadPoolName, executor);
        }
        log.error("线程池创建个数超过上限 {},使用默认线程池", DEFAULT_THREAD_POOL_COUNT_THRESHOLD);
        return getDefaultExecutor();
    }

    /**
     * 构造一个skywalking包装的线程池
     *
     * @param threadPoolConfig 线程池配置
     * @return 线程池
     */
    private static SWThreadPoolExecutor buildThreadPool(ThreadPoolConfig threadPoolConfig) {

        RejectedExecutionHandler rejectedExecutionHandler = threadPoolConfig.getFullHandler();
        if (rejectedExecutionHandler == null) {
            // 默认不处理任务,直接丢弃,外头future.get()时永久阻塞,future.get(timeout)抛出超时异常
            rejectedExecutionHandler = (r, executor) -> {
                log.error("线程池满了 {} 被拒绝的任务为 {}", threadPoolConfig.getThreadPoolName(), r);
                Iterable<Tag> tags = Lists.newArrayList(Tag.of(BasicMetricConstants.POOL_NAME_TAG, threadPoolConfig.getThreadPoolName()));
                MokaPrometheusUtil.counter(BasicMetricConstants.REJECT_COUNT, tags);
            };
        }
        ThreadFactory threadFactory = threadPoolConfig.getThreadFactory();
        if (threadFactory == null) {
            threadFactory = new NamedThreadFactory(threadPoolConfig.getThreadPoolName() + "-", false);
        }
        return new SWThreadPoolExecutor(threadPoolConfig.getCoreSize(), threadPoolConfig.getMaxSize(),
                threadPoolConfig.getKeepAliveSecond(), TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(threadPoolConfig.getQueueSize()),
                threadFactory,
                rejectedExecutionHandler);
    }

    /**
     * 刷新配置
     */
    private ThreadPoolExecutor refresh(String threadPoolName, ThreadPoolExecutor executor) {

        int oldCorePoolSize = executor.getCorePoolSize();
        int oldMaxPoolSize = executor.getMaximumPoolSize();

        int coreSize = ApolloConfReaderFactory.ofInteger(buildCoreSizeKey(threadPoolName), oldCorePoolSize).read();
        int maxSize = ApolloConfReaderFactory.ofInteger(buildMaxSizeKey(threadPoolName), oldMaxPoolSize).read();

        if (coreSize <= 0 || maxSize <= 0 || coreSize > maxSize) {
            log.warn("线程池 {} 配置错误,core {}, max {}", threadPoolName, coreSize, maxSize);
            return executor;
        }

        if (coreSize != oldCorePoolSize) {
            log.info("线程池 {} 配置调整 core {}", threadPoolName, coreSize);
            executor.setCorePoolSize(coreSize);
        }

        if (maxSize != oldMaxPoolSize) {
            log.info("线程池 {} 配置调整 max {}", threadPoolName, maxSize);
            executor.setMaximumPoolSize(maxSize);
        }

        return executor;
    }

    private static String buildMaxSizeKey(String threadPoolName) {
        return MAX_SIZE_KEY_PREFIX + threadPoolName;
    }

    private static String buildCoreSizeKey(String threadPoolName) {
        return CORE_SIZE_KEY_PREFIX + threadPoolName;
    }

}
这是一个基于「命名线程池 + 懒加载缓存 + Apollo 拉取式配置刷新」实现的轻量级动态线程池管理器。
它通过在获取线程池时对 core/max 参数进行实时校验与更新,实现了线程池参数的运行期动态调整,同时通过线程池数量上限与默认线程池兜底,避免了线程池滥用导致的系统资源失控。
具体不懂可以问一下 AI。
基于 Apollo 引入 AB 开关 实现新旧业务逻辑切换
这个就简单了,要先理解什么是 AB 开关。
实际上就是通过 Apollo 配置中心进行开关控制,比如开关叫 一件催办,那么当我在 Apollo 上配置 一件催办 功能开关打开的时候,那么线上的应用程序就会拥有这个 一件催办 的代码逻辑,用户就可以用这个功能,如果我配置关闭,那么用户就不可以用这个功能。
这样可以在服务器不停机的情况下,动态的进行调整。
具体对应的名词,比如 结合 黑白名单机制 支持功能 灰度上线 与快速回切 ,这些比较简单都可以自己 AI 一下。
基于 访问者设计模式 重构审批流程遍历逻辑
业务需求
业务需求是当用户要打印审批模板的时候,如果是 或签 的类型,那么只需要打印出实际的审批人是哪个即可。
也就是假如一个流程节点上有张三和李四还有王五三个人进行或签审批,也就是只要这三个人中有一个审批通过那么另外两个人就不用再进行审批了,比如张三审批通过那么李四还有王五就不需要再审批了,那么在最终用户打印对应的审批实例单子的 pdf 文件时,在该流程节点就只需要打印出张三的信息,比如审批人、审批时间、审批原因等,李四还有王五则不需要展示出来,不过这个可以通过 Apollo 进行动态配置,通过一个 boolean 值来判断是不是需要只打印实际审批人。
文件模板打印的代码:
java
package com.moka.workflow.platform.core.composite.print;

import com.google.common.collect.Sets;
import com.itextpdf.text.BaseColor;
import com.itextpdf.text.Element;
import com.itextpdf.text.Phrase;
import com.itextpdf.text.pdf.PdfDiv;
import com.moka.workflow.form.platform.sdk.client.dto.form.data.FieldValue;
import com.moka.workflow.form.platform.sdk.client.dto.form.data.FormDefDataDTO.GroupDataDTO;
import com.moka.workflow.form.platform.sdk.client.dto.form.data.FormDefDataDTO.GroupDataDTO.FieldDataDTO;
import com.moka.workflow.form.platform.sdk.client.dto.form.data.FormDefDataDTO.GroupDataDTO.FieldDataDTO.PropertiesDTO;
import com.moka.workflow.form.platform.sdk.enums.CombineTypeEnum;
import com.moka.workflow.form.platform.sdk.util.MultiDetailGroupUtil;
import com.moka.workflow.platform.base.common.converter.dto.workflow.SubFieldValueDTO;
import com.moka.workflow.platform.base.common.converter.service.CombineFieldConvertService;
import com.moka.workflow.platform.base.sdk.enums.HcmFieldTypeEnum;
import com.moka.workflow.platform.base.sdk.enums.ValueFormat;
import com.moka.workflow.platform.base.sdk.enums.value.format.PlatformTextFormat;
import com.moka.workflow.platform.core.composite.config.csm.service.CsmConfigReaderService;
import com.moka.workflow.platform.core.composite.constants.ApolloConstant;
import com.moka.workflow.platform.core.composite.instance.bo.OperatorInfoBO;
import com.moka.workflow.platform.core.composite.instance.bo.comment.CommentContentBO;
import com.moka.workflow.platform.core.composite.instance.bo.detail.AbstractProcessExecutePathBO;
import com.moka.workflow.platform.core.composite.instance.bo.detail.AbstractProcessExecutePathBO.TaskInstanceBO;
import com.moka.workflow.platform.core.composite.instance.bo.detail.AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO;
import com.moka.workflow.platform.core.composite.instance.bo.detail.FlowInstanceDetailBO;
import com.moka.workflow.platform.core.composite.instance.service.detail.form.service.locale.LocaleService;
import com.moka.workflow.platform.core.composite.instance.service.detail.traversal.ProcessExecPathBONodeTraversal;
import com.moka.workflow.platform.core.composite.instance.service.detail.traversal.ProcessExecPathBONodeVisitor;
import com.moka.workflow.platform.core.composite.instance.utils.ApolloConfReaderUtils;
import com.moka.workflow.platform.core.composite.invoke.EmployeeQueryRespInvokeServiceImpl;
import com.moka.workflow.platform.core.composite.print.bo.PrintTextBO;
import com.moka.workflow.platform.core.composite.print.document.*;
import com.moka.workflow.platform.core.composite.print.document.table.Cell;
import com.moka.workflow.platform.core.composite.print.document.table.Row;
import com.moka.workflow.platform.core.composite.print.document.table.Table;
import com.moka.workflow.platform.core.composite.print.handler.FieldValueHandlerAdapter;
import com.moka.workflow.platform.core.composite.utils.AccessUtil;
import com.moka.workflow.platform.core.composite.utils.ApolloSwitchUtil;
import com.moka.workflow.platform.core.composite.utils.DateUtils;
import com.moka.workflow.platform.core.sdk.client.instance.dto.EmployeeInfoResp;
import com.moka.workflow.process.platform.sdk.constants.enums.ApprovalModeEnum;
import com.moka.workflow.process.platform.sdk.constants.enums.InstanceStatusEnum;
import com.moka.workflow.process.platform.sdk.constants.enums.NodeTypeEnum;
import com.moka.workflow.process.platform.sdk.constants.enums.TaskInstStatusEnum;
import com.starter.hcm.common.util.JacksonUtil;
import lombok.extern.slf4j.Slf4j;
import org.apache.commons.collections4.CollectionUtils;
import org.apache.commons.collections4.ListUtils;
import org.apache.commons.collections4.MapUtils;
import org.apache.commons.lang3.StringUtils;
import org.apache.logging.log4j.util.Strings;
import org.springframework.stereotype.Service;

import javax.annotation.Resource;
import java.io.OutputStream;
import java.util.*;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.stream.Collectors;

import static com.itextpdf.text.Element.*;
import static com.itextpdf.text.Font.FontStyle.BOLD;
import static com.itextpdf.text.pdf.PdfDiv.FloatType.LEFT;
import static com.itextpdf.text.pdf.PdfDiv.FloatType.RIGHT;
import static com.moka.workflow.platform.base.common.util.MoreFunctions.runFallback;
import static com.moka.workflow.platform.core.composite.constants.CoreConstant.FIELD_LABEL_WITH_UNITS_TEMP;
import static com.moka.workflow.platform.core.composite.constants.CsmConfigKeyConstant.*;
import static com.moka.workflow.platform.core.composite.print.document.CellFactory.newCell;
import static com.moka.workflow.platform.core.composite.print.document.ParagraphFactory.newParagraph;
import static com.moka.workflow.platform.core.composite.utils.DateUtils.DATE_FORMAT;
import static java.util.Arrays.asList;
import static java.util.Collections.singletonList;
import static java.util.Collections.unmodifiableList;
import static java.util.Objects.isNull;
import static java.util.Optional.of;
import static java.util.Optional.ofNullable;
import static org.apache.commons.collections4.CollectionUtils.isEmpty;

@Slf4j
@Service
public class PrintExecutor {

    @Resource
    private EmployeeQueryRespInvokeServiceImpl employeeQueryRespInvokeService;

    @Resource
    private PrintHelper printHelper;

    @Resource
    private ProcessExecPathBONodeTraversal processExecPathBONodeTraversal;

    @Resource
    private LocaleService localeService;

    @Resource
    private FieldValueHandlerAdapter fieldValueHandlerAdapter;

    @Resource
    private CsmConfigReaderService csmConfigReaderService;

    @Resource
    private CombineFieldConvertService combineFieldConvertService;

    public void execute(FlowInstanceDetailBO flowInstDetail, OperatorInfoBO operatorInfoBO, OutputStream outputStream) {

        PrintTextBO printTextBO = localeService.buildPrintText(operatorInfoBO.getLocale());
        String timeZone = localeService.getUserTimeZone(operatorInfoBO, operatorInfoBO.getUserId());
        printTextBO.setTimeZone(timeZone);

        WorkflowDocument workflowDocument = new WorkflowDocument();
        PhraseBuilder phraseBuilder = PhraseBuilder.builder()
                .fontStyle(BOLD)
                .build();
        addFlowInstInfo(flowInstDetail, printTextBO, workflowDocument, phraseBuilder, operatorInfoBO);
        addFormDataTable(flowInstDetail, workflowDocument, phraseBuilder, operatorInfoBO);
        addTaskDataListTable(flowInstDetail, printTextBO, workflowDocument, phraseBuilder, operatorInfoBO);
        addCommentTable(flowInstDetail, printTextBO, workflowDocument, phraseBuilder);
        addExtraInfo(flowInstDetail, printTextBO, operatorInfoBO, workflowDocument);
        workflowDocument.getDocument(outputStream);
    }

    private void addFlowInstInfo(FlowInstanceDetailBO instDetailBO, PrintTextBO printTextBO,
                                 WorkflowDocument workflowDocument, PhraseBuilder phraseBuilder,
                                 OperatorInfoBO operatorInfoBO) {

        String flowName = instDetailBO.getFlowName();
        InstanceStatusEnum instanceStatusEnum = InstanceStatusEnum.codeOf(instDetailBO.getFlowStatus());
        String flowStatus = MapUtils.emptyIfNull(printTextBO.getFlowInstanceStatusMapping())
                .getOrDefault(instanceStatusEnum, instanceStatusEnum.getMsg());
        boolean noUseChineseFont = ApolloSwitchUtil.isOpen(operatorInfoBO.getTenantId(), ApolloConstant.DEFAULT_PRINT_FLOW_INST_TITLE_DONT_USE_CHINESE_FONT);
        workflowDocument
                .addElement(newParagraph(phraseBuilder.toPhraseSelectUseChinsesFont(flowName, noUseChineseFont), ALIGN_CENTER))
                .addElement(newParagraph(phraseBuilder.toPhrase(flowStatus), ALIGN_RIGHT, 0F, 15F, 0F, 10F));
        String actInstanceId = String.valueOf(instDetailBO.getFlowInstanceId());
        String createTimeStr = DateUtils.formatWithFormatAtZone(new Date(instDetailBO.getCreateTime()), DATE_FORMAT, printTextBO.getTimeZone());

        Boolean noApplicant = ApolloConfReaderUtils.notApplicatInfoSpecialTemplate(instDetailBO.getTemplateId());
        Table table = Table.builder().build();
        table.addRow(Row.newRow()
                .addCell(newCell(2, printTextBO.getFlowInstanceNo()))
                .addCell(newCell(2, actInstanceId))
                .addCell(newCell(2, printTextBO.getCreateTime()))
                .addCell(newCell(2, createTimeStr)));
        table.addRow(Row.newRow()
                //如果是无申请人模板,改为展示发起人
                .addCell(newCell(2, noApplicant ? printTextBO.getInitiator() : printTextBO.getApplicant()))
                .addCell(newCell(6, noApplicant ? instDetailBO.getInitiator().getName() : instDetailBO.getApplicant().getName())));
        workflowDocument.addElement(table);
    }

    /**
     * 附加信息格式
     * 打印人:
     * 打印时间:            申请人法人公司
     */
    private void addExtraInfo(FlowInstanceDetailBO flowInstDetail, PrintTextBO printTextBO,
                              OperatorInfoBO operatorInfoBO, WorkflowDocument workflowDocument) {

        EmployeeInfoResp employee = runFallback(() -> employeeQueryRespInvokeService.getEmployee(operatorInfoBO.getUserId(), operatorInfoBO),
                () -> null);
        String printEmployeeName = isNull(employee) ? "" : employee.getName();

        // 打印人
        Phrase operatorPhrase = PhraseFactory.newPhrase(printTextBO.getPrintEmployee() + printEmployeeName, 10F);
        String printTime = DateUtils.formatWithFormatAtZone(new Date(), DATE_FORMAT, printTextBO.getTimeZone());

        // 打印时间
        Phrase printTimePhrase = PhraseFactory.newPhrase(printTextBO.getPrintTime() + printTime, 10F);
        Div div = Div.builder()
                .paddingLeft(13F)
                .floatType(LEFT)
                .elements(unmodifiableList(asList(operatorPhrase, printTimePhrase)))
                .build();
        workflowDocument.addElement(div);

        boolean closePrintOpinion = csmConfigReaderService.ofBoolean(CLOSE_PRINT_CORPORATION, operatorInfoBO, false);

        if (!closePrintOpinion && !AccessUtil.isAts(operatorInfoBO.getAccess())) {

            // 申请人法人公司
            String corporationName = printHelper.getCorporationName(operatorInfoBO, flowInstDetail);
            Phrase corporationNamePhrase = PhraseFactory.newPhrase(corporationName, 10F);
            div = Div.builder()
                    .floatType(RIGHT)
                    .elements(singletonList(corporationNamePhrase))
                    .paddingTop(14F)
                    .paddingRight(13F)
                    .build();
            workflowDocument.addElement(div);

        }
    }

    private void addCommentTable(FlowInstanceDetailBO instDetailBO, PrintTextBO printTextBO,
                                 WorkflowDocument workflowDocument, PhraseBuilder phraseBuilder) {

        List<CommentContentBO> commentList = instDetailBO.getCommentList();
        Table table = Table.builder()
                .colspan(8)
                .build();
        if (isEmpty(commentList)) {
            return;
        }
        Paragraph paragraph = newParagraph(phraseBuilder.toPhrase(printTextBO.getComment()),
                ALIGN_LEFT, 15F, 0F, 0F, 10F);
        workflowDocument.addElement(paragraph);
        for (CommentContentBO comment : commentList) {
            Row row = Row.newRow();
            String employeeName = comment.getEmployeeName();
            String content = comment.getContent();
            String timeComment = DateUtils.format(comment.getCreateTime());
            Phrase phrase = new PhraseBuilder()
                    .toPhrase(employeeName + ":" + content);
            PdfDiv leftDiv = new PdfDiv();
            leftDiv.addElement(phrase);
            leftDiv.setFloatType(LEFT);
            leftDiv.setWidth(280F);

            PdfDiv rightDiv = new PdfDiv();
            rightDiv.addElement(PhraseBuilder.builder()
                    .color(BaseColor.LIGHT_GRAY)
                    .build()
                    .toPhrase(timeComment));
            rightDiv.setFloatType(RIGHT);
            rightDiv.setPaddingRight(5);

            row.addCell(Cell.builder()
                    .colspan(8)
                    .rowspan(1)
                    .verticalAlignment(ALIGN_MIDDLE)
                    .elements(asList(leftDiv, rightDiv))
                    .build());
            table.addRow(row);
        }
        workflowDocument.addElement(table);
    }

    private void addTaskDataListTable(FlowInstanceDetailBO instDetailBO, PrintTextBO printTextBO,
                                      WorkflowDocument workflowDocument, PhraseBuilder phraseBuilder, OperatorInfoBO operatorInfoBO) {

        List<AbstractProcessExecutePathBO> processExecPathRespList = instDetailBO.getProcessExecPathList();
        workflowDocument.addElement(newParagraph(phraseBuilder.toPhrase(printTextBO.getApprovalProcess()),
                ALIGN_LEFT, 15F, 0F, 0F, 10F));
        Table table = Table.builder()
                .colspan(8)
                .build();
        if (isEmpty(processExecPathRespList)) {
            return;
        }

        boolean needPrintOpinion = csmConfigReaderService.ofBoolean(PRINT_APPROVAL_OPINION_SWITCH, operatorInfoBO, false);

        boolean needPrintOnlyRealApprover = csmConfigReaderService.ofBoolean(
                PRINT_ONLY_REAL_APPROVER_SWITCH,
                operatorInfoBO,
                false
        );
        if (needPrintOnlyRealApprover) {
            log.info("审批打印或签时,只打印实际审批人,过滤前结果:{}", JacksonUtil.toJson(processExecPathRespList));
            filterOnlyRealApprovers(processExecPathRespList);
            log.info("审批打印或签时,只打印实际审批人,过滤后结果:{}", JacksonUtil.toJson(processExecPathRespList));
        }

        processExecPathBONodeTraversal.recursiveTraversalNode(processExecPathRespList, new ProcessExecPathBONodeVisitor() {
            @Override
            public void onUserNodeVisit(UserTaskProcessExecutePathBO node) {
                addUserTask(table, node, Row.newRow(), printTextBO, needPrintOpinion);
            }
        });

        workflowDocument.addElement(table);
    }

    /**
     * 过滤审批路径中的实际审批人数据。
     * 对于 OR_SIGN(或签)节点,移除状态为 NO_NEED_PROCESS 的任务实例,
     * 以确保最终打印结果仅展示真实参与审批的人员。
     */
    private void filterOnlyRealApprovers(List<AbstractProcessExecutePathBO> nodeList) {

        try {

            processExecPathBONodeTraversal.recursiveTraversalNode(nodeList, new ProcessExecPathBONodeVisitor() {
                @Override
                public void onUserNodeVisit(UserTaskProcessExecutePathBO node) {
                    if (ApprovalModeEnum.OR_SIGN.equals(node.getApprovalMode()) && node.getAssigneeList() != null) {
                        // 过滤掉 NO_NEED_PROCESS 状态的审批人
                        List<TaskInstanceBO> filteredAssignees = node.getAssigneeList().stream()
                                .filter(task -> task.getStatus() != TaskInstStatusEnum.NO_NEED_PROCESS)
                                .collect(Collectors.toList());

                        node.setAssigneeList(filteredAssignees);
                    }
                }
            });

        } catch (Exception e) {
            log.error("filterOnlyRealApprovers error", e);
        }
    }


    /**
     * 一行(colspan:8)分为两部分: 审批节点名(colspan:2) 和 节点信息(colspan:6,大概350F)
     */
    private void addUserTask(Table table, UserTaskProcessExecutePathBO processPath, Row row, PrintTextBO printTextBO, boolean needPrintOpinion) {
        String value = getNodeName(processPath.getNodeName(), processPath.getNodeType(), printTextBO);
        List<TaskInstanceBO> assigneeList = processPath.getAssigneeList();
        if (Objects.nonNull(assigneeList)) {
            row.addCell(newCell(2, assigneeList.size(), ALIGN_MIDDLE, new PhraseBuilder().toPhrase(value)));
        }
        if (isEmpty(assigneeList)) {
            return;
        }
        // TODO 打印回退信息
        // TODO 打印转交信息
        // TODO 根据节点类型打印节点信息
        assigneeList.forEach(assignee -> {
            String employeeName = assignee.getAssigneeName();
            TaskInstStatusEnum taskInstanceStatus = assignee.getStatus();
            Date approveTime = assignee.getEndTime();
            String reason = assignee.getReason();
            List<Element> pdfDivs = new ArrayList<>();
            Float defaultWidth = 100F;

            // TODO 待封装
            //构建assigneeName
            PdfDiv assigneeNameDiv = buildPdfDiv(employeeName, defaultWidth, LEFT);
            pdfDivs.add(assigneeNameDiv);

            if (needPrintOpinion) {
                //构建TaskInstStatus
                PdfDiv taskInstStatusDiv = buildPdfDiv(taskInstanceStatus.getMsg(), defaultWidth, LEFT);
                pdfDivs.add(taskInstStatusDiv);
            }

            //构建approveTime
            if (!taskInstanceStatus.equals(TaskInstStatusEnum.SUSPEND)) {
                PdfDiv pdfDivRight = new PdfDiv();

                pdfDivRight.addElement(PhraseBuilder.builder()
                        .color(BaseColor.LIGHT_GRAY)
                        .build()
                        .toPhrase(ofNullable(approveTime).map(DateUtils::format).orElse("")));
                pdfDivRight.setFloatType(RIGHT);
                pdfDivRight.setPaddingRight(6);
                pdfDivs.add(pdfDivRight);
            }

            if (needPrintOpinion) {
                //构建reason
                PdfDiv reasonDiv = buildPdfDiv(reason, 350F, LEFT);
                pdfDivs.add(reasonDiv);
            }

            row.addCell(Cell.builder().colspan(6).rowspan(1).paddingTop(0.5F).paddingBottom(7F).verticalAlignment(ALIGN_MIDDLE).elements(pdfDivs).build());
        });
        table.addRow(row);
    }

    private static PdfDiv buildPdfDiv(String value, Float width, PdfDiv.FloatType floatType) {
        Phrase phrase = new PhraseBuilder().toPhrase(value);
        PdfDiv pdfDiv = new PdfDiv();
        pdfDiv.addElement(phrase);
        pdfDiv.setFloatType(floatType);
        pdfDiv.setWidth(width);
        return pdfDiv;
    }

    private String getNodeName(String nodeName, NodeTypeEnum nodeType, PrintTextBO printTextBO) {

        return MapUtils.emptyIfNull(printTextBO.getNodeNameMapping())
                .getOrDefault(nodeType, nodeName);

    }

    private void addFormDataTable(FlowInstanceDetailBO instDetailBO, WorkflowDocument workflowDocument,
                                  PhraseBuilder phraseBuilder, OperatorInfoBO operatorInfoBO) {

        for (GroupDataDTO g : instDetailBO.getFormDataList()) {
            if (g.isApplicantGroup()) {
                continue;
            }

            if (g.isPermitCopy()) {
                addFormGroupData(workflowDocument, phraseBuilder, g.getFieldList(), g.getName(), operatorInfoBO);
            } else {
                addFormData(workflowDocument, phraseBuilder, g.getFieldList(), g.getName(), operatorInfoBO);
            }
        }
    }

    /**
     * 添加表单非明细组数据
     *
     * @param fieldDataList 非明细组字段数据
     * @param groupName     群组名称
     */
    private void addFormData(WorkflowDocument workflowDocument, PhraseBuilder phraseBuilder,
                             List<FieldDataDTO> fieldDataList, String groupName,
                             OperatorInfoBO operatorInfoBO) {

        Table table = Table.builder().build();
        if (isEmpty(fieldDataList)) {
            return;
        }
        workflowDocument.addElement(newParagraph(phraseBuilder.toPhrase(groupName), ALIGN_LEFT, 15F, 0F, 0F, 10F));
        for (FieldDataDTO fieldDataDTO : fieldDataList) {
            addTableRowFromFieldData(table, fieldDataDTO, operatorInfoBO);
        }
        workflowDocument.addElement(table);
    }

    /**
     * 添加表单明细组数据
     *
     * @param fieldDataList 明细组字段数据
     * @param groupName     群组名称
     */
    private void addFormGroupData(WorkflowDocument workflowDocument, PhraseBuilder phraseBuilder,
                                  List<FieldDataDTO> fieldDataList, String groupName,
                                  OperatorInfoBO operatorInfoBO) {

        Table table = Table.builder().build();
        if (isEmpty(fieldDataList)) {
            return;
        }
        Map<Integer, List<FieldDataDTO>> index2FieldDataMapping = fieldDataList.stream()
                .filter(o -> MultiDetailGroupUtil.isDetailGroupField((o.getUniqKey())))
                .collect(Collectors.groupingBy(o -> MultiDetailGroupUtil.getDetailGroupFieldIndex(o.getUniqKey())));
        Set<Integer> totalIndex = Sets.newTreeSet();
        totalIndex.addAll(index2FieldDataMapping.keySet());

        workflowDocument.addElement(newParagraph(phraseBuilder.toPhrase(groupName), ALIGN_LEFT, 15F, 0F, 0F, 10F));
        AtomicInteger titleIndex = new AtomicInteger(1);

        // 这里index对于修改流程可能不连续
        for (int index : totalIndex) {
            Row row = Row.newRow();
            String cellName = getCellName(groupName, totalIndex, titleIndex);
            row.addCell(newCell(8, cellName));
            table.addRow(row);
            // 当前明细段落
            List<FieldDataDTO> currentGroup = index2FieldDataMapping.get(index);
            for (FieldDataDTO fieldDataDTO : currentGroup) {
                addTableRowFromFieldData(table, fieldDataDTO, operatorInfoBO);
            }
        }
        workflowDocument.addElement(table);
    }

    /**
     * 要求打印的时候,只有一个分组,则不显示1
     */
    private static String getCellName(String groupName, Set<Integer> totalIndex, AtomicInteger titleIndex) {
        String cellName;
        if (totalIndex.size() == 1) {
            cellName = groupName;
        } else {
            cellName = groupName + titleIndex.getAndIncrement();
        }
        return cellName;
    }

    private void addTableRowFromFieldData(Table table, FieldDataDTO fieldDataDTO, OperatorInfoBO operatorInfoBO) {
        Row row;
        int type = fieldDataDTO.getFieldType().getValue();
        if (type == 0) {
            return;
        }

        String label = buildPrintFieldLabel(fieldDataDTO);
        if (CombineTypeEnum.isHrCombineType(type, fieldDataDTO.getFrontendComponent())) {
            //人事组合字段
            row = buildRowForCombineField(fieldDataDTO, label);
            if (row != null) {
                table.addRow(row);
            }
        } else {

            String value = getFieldShowValue(fieldDataDTO, operatorInfoBO);
            if (isNull(value)) {
                return;
            }
            row = Row.newRow();
            row.addCell(newCell(2, label));
            row.addCell(newCell(6, value));
            table.addRow(row);

        }
    }

    private Row buildRowForCombineField(FieldDataDTO fieldDataDTO, String label) {

        try {

            Row row;
            List<SubFieldValueDTO> subFieldValueDTOs = ListUtils.emptyIfNull(fieldDataDTO.getValue())
                    .stream()
                    .filter(valueFormat -> valueFormat instanceof PlatformTextFormat)
                    .map(valueFormat -> (PlatformTextFormat) valueFormat)
                    .flatMap(valueFormat -> combineFieldConvertService.extractSubFieldValues(valueFormat, true).stream())
                    .collect(Collectors.toList());

            if (CollectionUtils.isEmpty(subFieldValueDTOs)) {
                //空值
                row = Row.newRow();
                row.setCombined(true);
                row.addCell(newCell(2, label));
                row.addCell(newCell(6, StringUtils.EMPTY));
            } else {

                int rowSpan = subFieldValueDTOs.size();
                row = Row.newRow();
                row.setCombined(true);

                //主字段列
                row.addCell(newCell(2, rowSpan, ALIGN_MIDDLE, new PhraseBuilder().toPhrase(label)));

                //子字段列
                subFieldValueDTOs.forEach(subFieldValueDTO -> {

                    row.addCell(newCell(2, subFieldValueDTO.getFieldName()));

                    List<ValueFormat> valueFormats = subFieldValueDTO.getValueFormats();
                    String subFieldValue = ofNullable(valueFormats)
                            .map(v -> {
                                FieldValue fieldValue = new FieldValue();
                                fieldValue.setValue(v);
                                fieldValue.setType(HcmFieldTypeEnum.ofValue(subFieldValueDTO.getFieldType()));
                                return fieldValue.getFieldValue();
                            })
                            .orElse(Strings.EMPTY);
                    row.addCell(newCell(4, subFieldValue));

                });

            }

            return row;

        } catch (Exception e) {
            log.error("buildRowForCombineField error", e);
            return null;
        }
    }

    /**
     * 构造打印字段的名称(包含单位)
     *
     * @param fieldDataDTO 字段值
     * @return 打印字段的名称
     */
    private String buildPrintFieldLabel(FieldDataDTO fieldDataDTO) {

        if (fieldDataDTO == null) {
            return StringUtils.EMPTY;
        }

        String units = of(fieldDataDTO)
                .map(FieldDataDTO::getProperties)
                .map(PropertiesDTO::getUnits)
                .orElse(null);

        if (StringUtils.isBlank(units)) {
            return fieldDataDTO.getFieldName();
        }

        return String.format(FIELD_LABEL_WITH_UNITS_TEMP, fieldDataDTO.getFieldName(), units);

    }

    /**
     * 获取字段展示的内容
     */
    private String getFieldShowValue(FieldDataDTO fieldDataDTO, OperatorInfoBO operatorInfoBO) {
        return fieldValueHandlerAdapter.getFieldShowValue(fieldDataDTO, operatorInfoBO);
    }

}
其中我新增的仅按照实际审批人打印的代码:
java
/**
     * 过滤审批路径中的实际审批人数据。
     * 对于 OR_SIGN(或签)节点,移除状态为 NO_NEED_PROCESS 的任务实例,
     * 以确保最终打印结果仅展示真实参与审批的人员。
     */
    private void filterOnlyRealApprovers(List<AbstractProcessExecutePathBO> nodeList) {

        try {

            processExecPathBONodeTraversal.recursiveTraversalNode(nodeList, new ProcessExecPathBONodeVisitor() {
                @Override
                public void onUserNodeVisit(UserTaskProcessExecutePathBO node) {
                    if (ApprovalModeEnum.OR_SIGN.equals(node.getApprovalMode()) && node.getAssigneeList() != null) {
                        // 过滤掉 NO_NEED_PROCESS 状态的审批人
                        List<TaskInstanceBO> filteredAssignees = node.getAssigneeList().stream()
                                .filter(task -> task.getStatus() != TaskInstStatusEnum.NO_NEED_PROCESS)
                                .collect(Collectors.toList());

                        node.setAssigneeList(filteredAssignees);
                    }
                }
            });

        } catch (Exception e) {
            log.error("filterOnlyRealApprovers error", e);
        }
    }
可以看到我们有一个遍历所有节点、包括并行分支节点的工具,这是个以递归方式实现的遍历所有流程节点的框架:
java
/**
 * User: yuxiang.sun
 * Date: 6/27/22
 * Time: 4:39 PM
 */
@Service
public class ProcessExecPathBONodeTraversal {

    /**
     * 遍历节点定义的入口
     *
     * @param nodeList    节点定义列表
     * @param nodeVisitor 节点处理器
     */
    public void recursiveTraversalNode(List<AbstractProcessExecutePathBO> nodeList,
                                       ProcessExecPathBONodeVisitor nodeVisitor) {

        ListUtils.emptyIfNull(nodeList).forEach(processExecPathListResp -> {

            if (processExecPathListResp instanceof AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO) {
                recursiveTraversalUserTaskNode((AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO) processExecPathListResp, nodeVisitor);
            } else if (processExecPathListResp instanceof AbstractProcessExecutePathBO.ParallelBranchProcessExecutePathBO) {
                recursiveTraversalParallelNode((AbstractProcessExecutePathBO.ParallelBranchProcessExecutePathBO) processExecPathListResp, nodeVisitor);
            }
        });
    }

    private void recursiveTraversalParallelNode(AbstractProcessExecutePathBO.ParallelBranchProcessExecutePathBO parallelNodeBO,
                                                ProcessExecPathBONodeVisitor nodeVisitor) {

        nodeVisitor.onParallelNodeVisit(parallelNodeBO);
        parallelNodeBO.getBranchNodeList().forEach(processExecPathListNodes -> recursiveTraversalNode(processExecPathListNodes, nodeVisitor));
    }

    private void recursiveTraversalUserTaskNode(AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO userTaskBONode,
                                                ProcessExecPathBONodeVisitor nodeVisitor) {

        nodeVisitor.onUserNodeVisit(userTaskBONode);
    }
}
然后封装了一个访问者的访问方法的接口:
java
/**
 * User: yuxiang.sun
 * Date: 5/1/22
 * Time: 3:00 PM
 */
public interface ProcessExecPathBONodeVisitor {

    /**
     * 节点遍历
     *
     * @param node 非并行网关开始节点
     */
    default void onUserNodeVisit(AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO node) {
    }

    /**
     * 节点遍历
     *
     * @param node 并行网关开始节点
     */
    default void onParallelNodeVisit(AbstractProcessExecutePathBO.ParallelBranchProcessExecutePathBO node) {
    }

}
这个参数中的类虽然不需要明白,但万一后面要看的话还是可以完整展现一下:
java
@Data
@JsonTypeInfo(use = JsonTypeInfo.Id.NAME)
@JsonSubTypes(value = {
        @JsonSubTypes.Type(AbstractProcessExecutePathBO.ParallelBranchProcessExecutePathBO.class),
        @JsonSubTypes.Type(AbstractProcessExecutePathBO.UserTaskProcessExecutePathBO.class)
})
public abstract class AbstractProcessExecutePathBO {

    private String nodeId;
    private String nodeKey;
    private String nodeName;
    private NodeTypeEnum nodeType;
    private AdvancedSetupDTO advancedSetup;

    @EqualsAndHashCode(callSuper = true)
    @Data
    public static class UserTaskProcessExecutePathBO extends AbstractProcessExecutePathBO {

        private ESignSetupDTO eSignSetupDTO;
        private ESignNodeStartStateEnum eSignNodeStartStateEnum;
        private String eSignStartMarkTaskInstId;
        private String frontendComponent;
        private List<TaskInstanceBO> assigneeList;
        private ApprovalModeEnum approvalMode;
        private String desc;
        private PathNodeStatusEnum nodeStatus;
        /**
         * 标记该节点的撤销来源
         */
        private OperationalSourceEnum nodeRevokeSource;
        /**
         * 审批人名字是否可见
         */
        private Boolean isNameVisible;
        /**
         * 节点对前端是否可见
         */
        private Boolean hiddenNode;
    }

    @EqualsAndHashCode(callSuper = true)
    @Data
    public static class ParallelBranchProcessExecutePathBO extends AbstractProcessExecutePathBO {

        private List<List<AbstractProcessExecutePathBO>> branchNodeList;

    }

    @AllArgsConstructor
    @NoArgsConstructor
    @Data
    @Builder
    public static class TaskInstanceBO {

        private String assignee;
        private String assigneeName;
        private String assigneeAvatar;

        private String taskInstanceId;
        private TaskInstStatusEnum status;
        /**
         * 是否隐藏任务实例状态
         */
        private Boolean hideApproveStatus;
        /**
         * 标记该任务的撤销来源
         */
        private OperationalSourceEnum taskRevokeSource;
        private String reason;
        private List<HandoverHistoryItemBO> handoverHistory;
        private RollbackDetailBO rollbackDetail;
        private Boolean autoPass;
        private Boolean autoSKip;
        private Boolean beforeCountersignedOp;
        private Boolean produceByCountersigned;
        private ApprovalModeEnum approveType;
        private Date createTime;
        private Date endTime;
        private RemindButtonStateEnum reminderButtonState;
        private HandoverButtonStateEnum handoverButtonState;
        /**
         * 所有字段
         */
        private List<FormDiffGroup.FormDiffItem> formDiffItems;
        /**
         * 虚拟分组所有字段
         */
        private List<FormDiffGroup.FormDiffItem> virtualDiffItemList;
        /**
         * 非明细字段,不包含虚拟分组
         */
        private List<FormDiffGroup.NotDetailGroupDataDiff> notDetailGroupDataDiffList;

        /**
         * 明细字段,不包含虚拟分组
         */
        private List<FormDiffGroup.DetailGroupDataDiff> detailGroupDataDiffList;
        private List<CountersignedBO> countersignedList;


        /**
         * 代理信息
         */
        private AgentDetailBO agentDetailBO;
    }


    @Data
    @NoArgsConstructor
    @AllArgsConstructor
    @Builder
    public static class AgentDetailBO {
        /**
         * 原审批人姓名
         */
        private String originAssigneeName;

        /**
         * 原审批人id
         */
        private String originAssigneeId;

        /**
         * 代理人姓名
         */
        private String agentAssigneeName;

        /**
         * 代理人id
         */
        private String agentAssigneeId;


        private Boolean canOriginalReceiveAndDeal;

        /**
         *  详情展示描述
         */
        private String desc;


    }

    @Data
    @Builder
    @AllArgsConstructor
    @NoArgsConstructor
    public static class CountersignedBO {
        private List<IdValueFormat> assigneeList;
        private String reasonId;
        private CommentContentBO reason;
        private SignedWayEnum signedWayEnum;
    }


    @Data
    @Builder
    @AllArgsConstructor
    @NoArgsConstructor
    public static class HandoverHistoryItemBO {

        //转交前人员
        private long fromUser;
        private String fromUserName;

        //转交后人员
        private long toUser;
        private String toUserName;

        private String reason;

        private long createTime;
    }

    @Data
    @Builder
    @AllArgsConstructor
    @NoArgsConstructor
    public static class RollbackDetailBO {

        /**
         * 回退人员工id
         */
        private Long operatorId;

        /**
         * 回退人员工姓名
         */
        private String operatorName;

        /**
         * 回退目标节点名称
         */
        private String targetNodeName;

        /**
         * 回退目标节点id
         */
        private String targetNodeId;

        /**
         * 回退目标分配人id
         */
        private Long targetAssigneeId;

        /**
         * 回退目标分配人姓名
         */
        private String targetAssigneeName;

        /**
         * 回退原因
         */
        private String reason;

        /**
         * 跳转前节点名称
         */
        private String rollbackNodeName;

        /**
         * 跳转前节点id
         */
        private String rollbackNodeId;

        /**
         * 回退操作时间
         */
        private Date rollbackTime;

    }


}
这段代码运用了访问者模式(Visitor Pattern),是一个非常优雅的设计。让我为你详细分析。
🏗️ 设计模式分析
- 核心架构(访问者模式)
这是一个经典的访问者模式实现,包含三个核心组件:
① 元素类(Element) - 数据结构
- AbstractProcessExecutePathBO - 审批流程节点的抽象类
- UserTaskProcessExecutePathBO - 用户审批任务节点(包含审批人列表)
- ParallelBranchProcessExecutePathBO - 并行分支节点(包含多个子分支)
② 访问者接口(Visitor) - 行为定义
- ProcessExecPathBONodeVisitor - 定义了访问不同节点类型的钩子方法
- onUserNodeVisit() - 访问用户任务节点时触发
- onParallelNodeVisit() - 访问并行分支节点时触发
③ 遍历器(Traversal) - 框架基础设施
- ProcessExecPathBONodeTraversal - 封装了复杂的递归遍历逻辑
代码执行流转:
以 filterOnlyRealApprovers 为例:
java
1. 调用入口
filterOnlyRealApprovers(nodeList)
↓
2. 创建匿名 Visitor 实现
new ProcessExecPathBONodeVisitor() {
	onUserNodeVisit() { 过滤或签节点的 NO_NEED_PROCESS 任务 }
}
↓
3. 调用遍历框架
processExecPathBONodeTraversal.recursiveTraversalNode(nodeList, visitor)
↓
4. 框架递归遍历(自动处理复杂的树形结构)
  ○ 遍历每个节点
  ○ 判断节点类型(instanceof)
  ○ 如果是 UserTaskNode → 调用 visitor.onUserNodeVisit()
  ○ 如果是 ParallelBranchNode → 调用 visitor.onParallelNodeVisit()
然后递归遍历每个分支(处理嵌套的并行网关)
↓
5. 业务逻辑执行
在 visitor 回调中过滤掉不需要的审批人
✨ 关键优化点
- 分离关注点(Separation of Concerns)
● 遍历逻辑(如何遍历树形结构)→ 封装在 ProcessExecPathBONodeTraversal
● 业务逻辑(过滤审批人、生成PDF等)→ 实现在各个 Visitor 中
● 数据结构(节点定义)→ 定义在 AbstractProcessExecutePathBO - 高度复用,避免重复代码
审批流程的树形结构可能很复杂(嵌套的并行网关、多层用户任务),传统做法需要在每个功能中都写一遍递归遍历逻辑。使用访问者模式后:
● 遍历框架写一次,所有场景复用
● 新增功能只需实现一个 Visitor - 扩展性强
● 新增节点类型:只需在 Visitor 接口添加一个方法
● 新增业务场景:只需实现一个新的 Visitor
● 符合开闭原则(对扩展开放,对修改关闭) - 类型安全
通过 instanceof 判断和强类型转换,确保在编译期就能发现类型错误。
面试话术回答:
"在工作流引擎项目中,我遇到一个典型的代码复用问题。审批流程是一个复杂的树形结构,包含用户任务节点和并行分支节点,可能有多层嵌套。我们有多个业务场景需要遍历这个结构,比如生成PDF、过滤审批人、统计数据等。最初每个场景都要写一遍递归遍历逻辑,代码重复严重。
我通过访问者模式解决了这个问题。我抽象出一个遍历框架 ProcessExecPathBONodeTraversal,封装了所有递归遍历的复杂性,包括类型判断、递归调用等。然后定义了一个 Visitor 接口,提供节点访问的回调方法。各个业务场景只需要实现这个接口,关注自己的业务逻辑就行。
举个具体例子,在 PDF 打印功能中,我需要过滤掉或签节点中状态为 NO_NEED_PROCESS 的审批人,只展示真实参与审批的人。使用访问者模式后,我只需要实现 onUserNodeVisit 方法,在里面做一个简单的 stream 过滤,10 行代码就搞定了。如果不用这个模式,我需要写 50+ 行的递归代码。
这个重构带来的效果是:新增一个遍历场景的代码量从 100 多行降到 10-20 行,而且遍历逻辑的 bug 只需要在框架中修一次,所有场景都能受益。"
基于 CompletableFuture 并行加载多维度数据
主要是下面这个接口:
web服务:/api/workflowplatform/flowInst/detail/form-data
core服务:ResponseDto<FlowInstanceDetailResp> getFlowInstanceFormDataDetail
下面是我后来用G老师补充的:
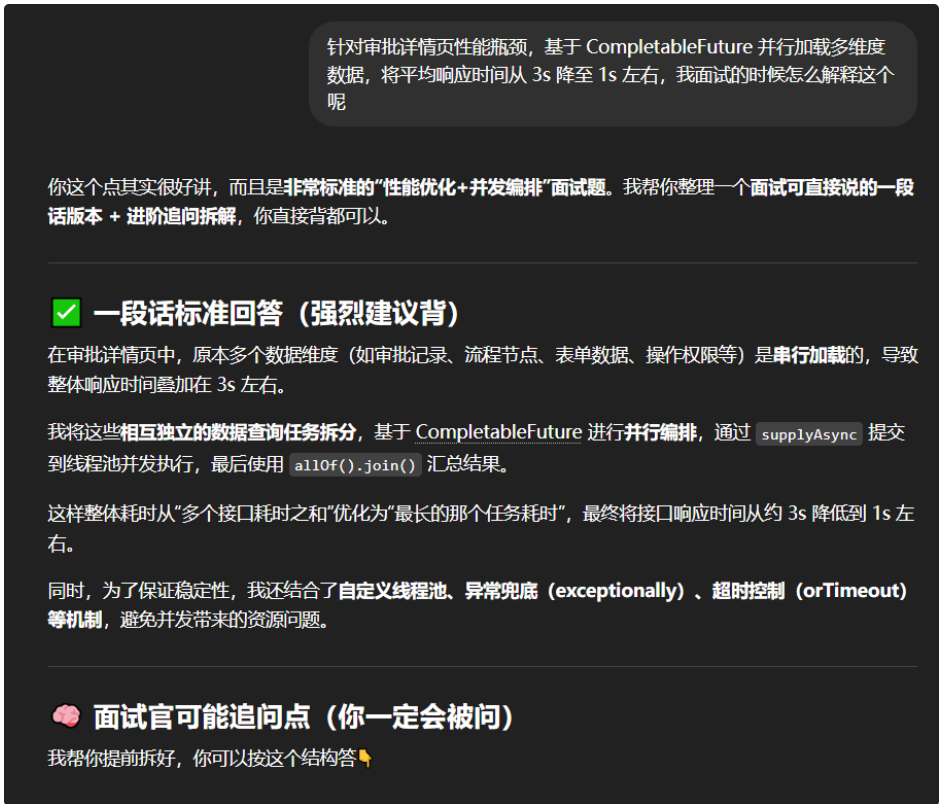
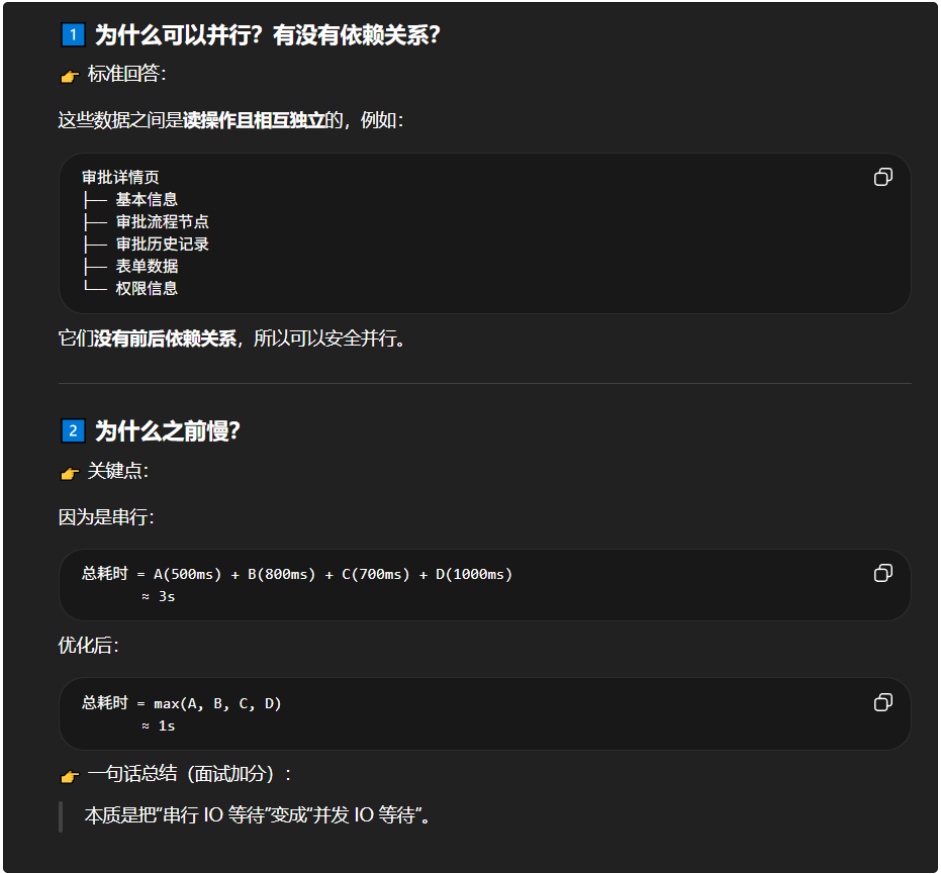
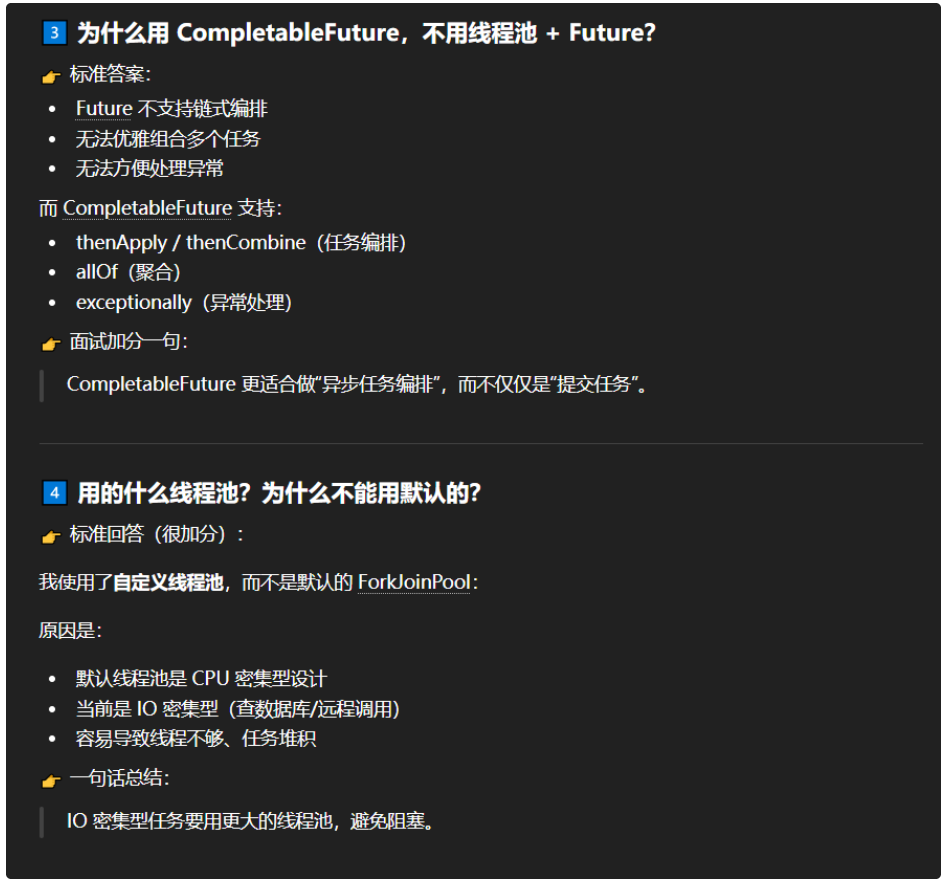
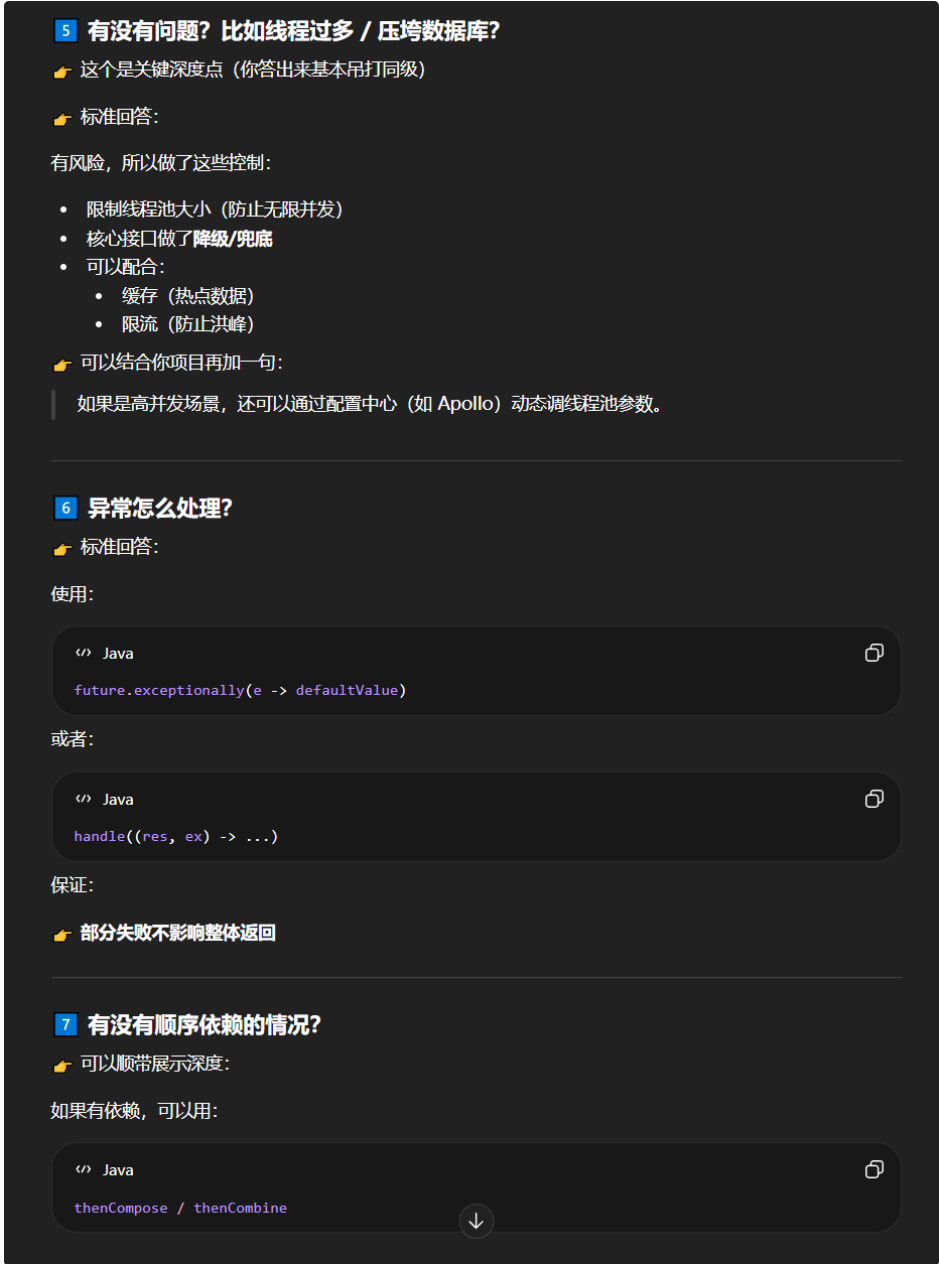
这个优化本质上是将原本的串行 IO 模式改造成并发 IO,通过 CompletableFuture 做任务编排,在保证线程池可控的前提下,将接口耗时从"累加模型"优化为"取最大值模型",显著提升了接口性能。
定位并解决 2 次线上慢 SQL 问题
CASE1:activity 框架的问题
可以先补一下 activity 的内容:
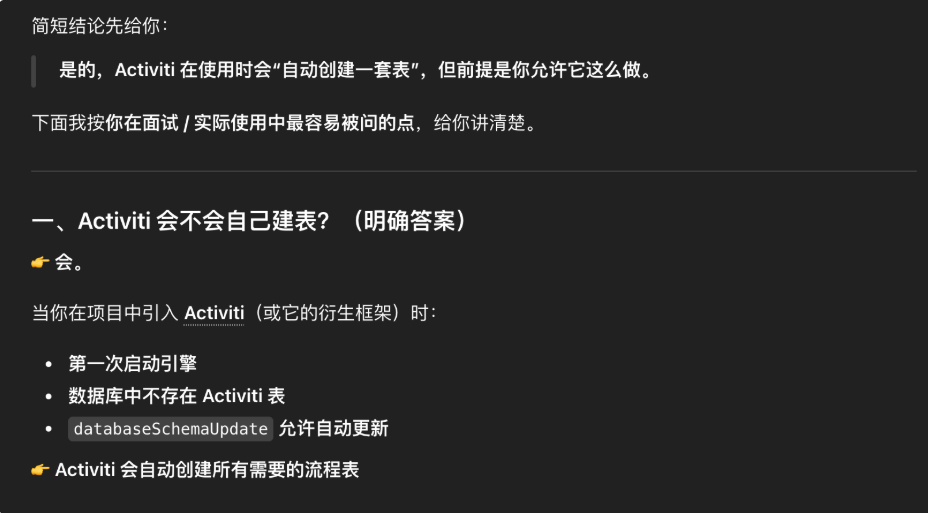
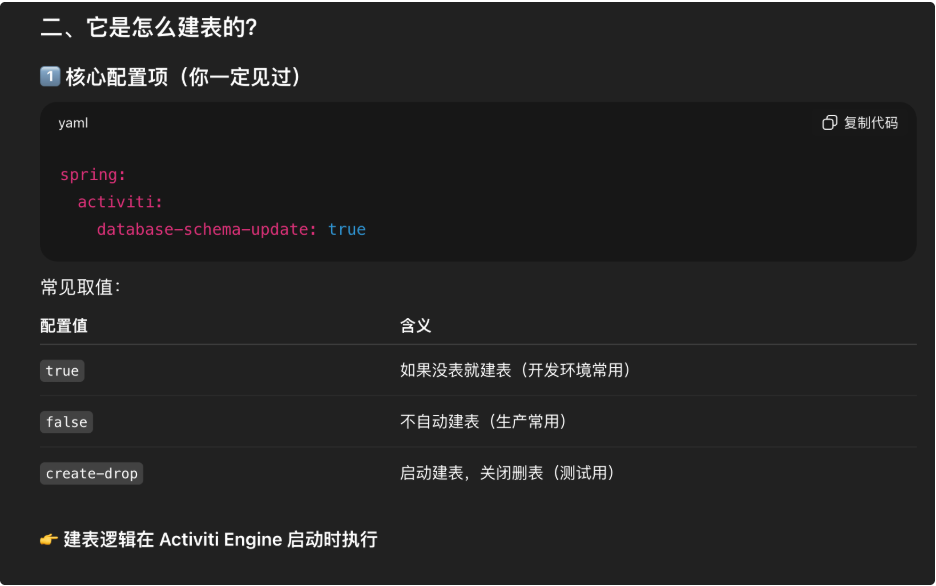
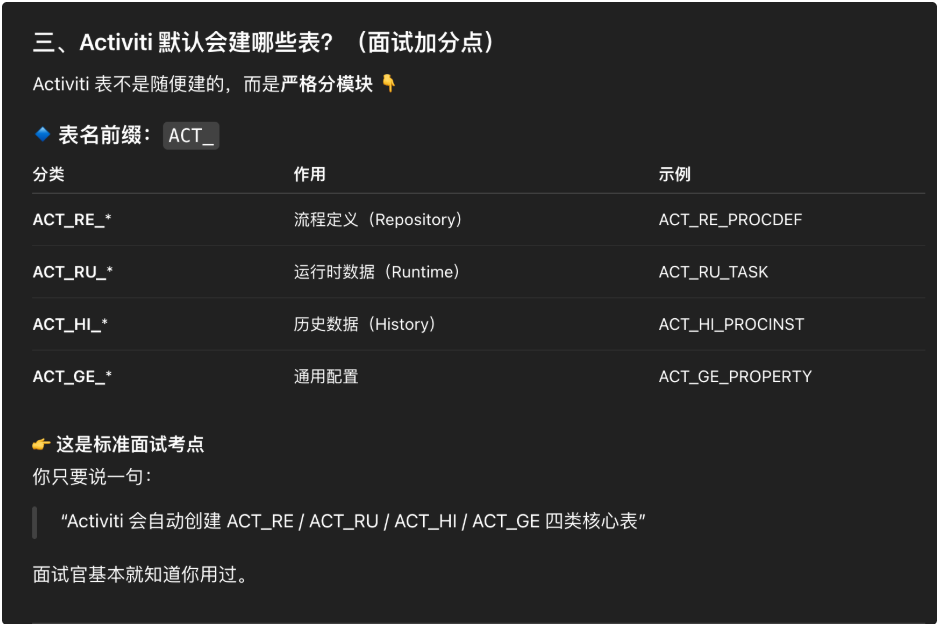
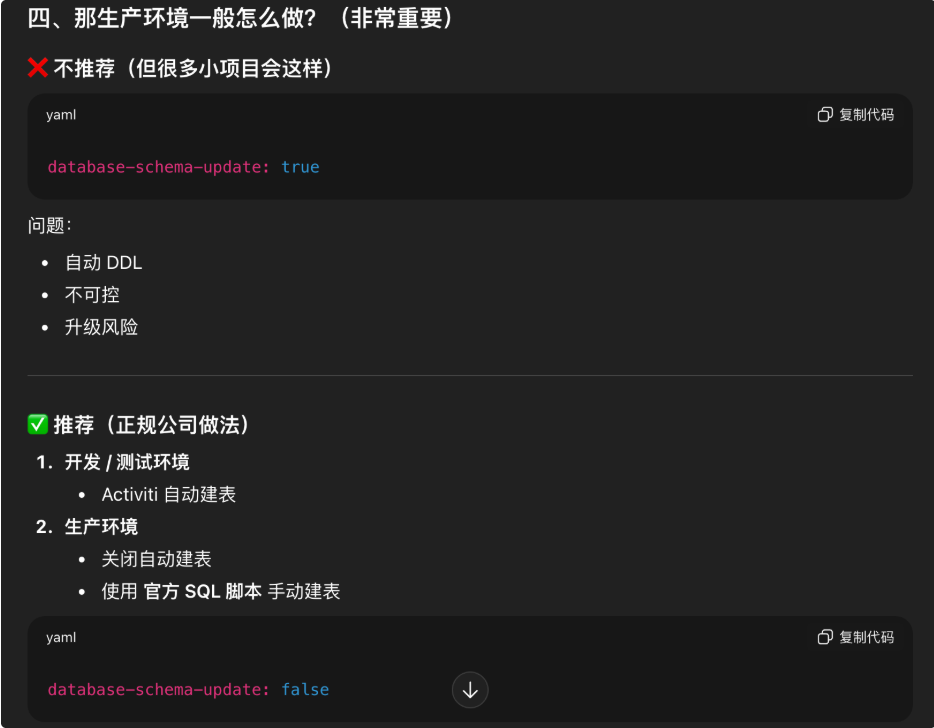
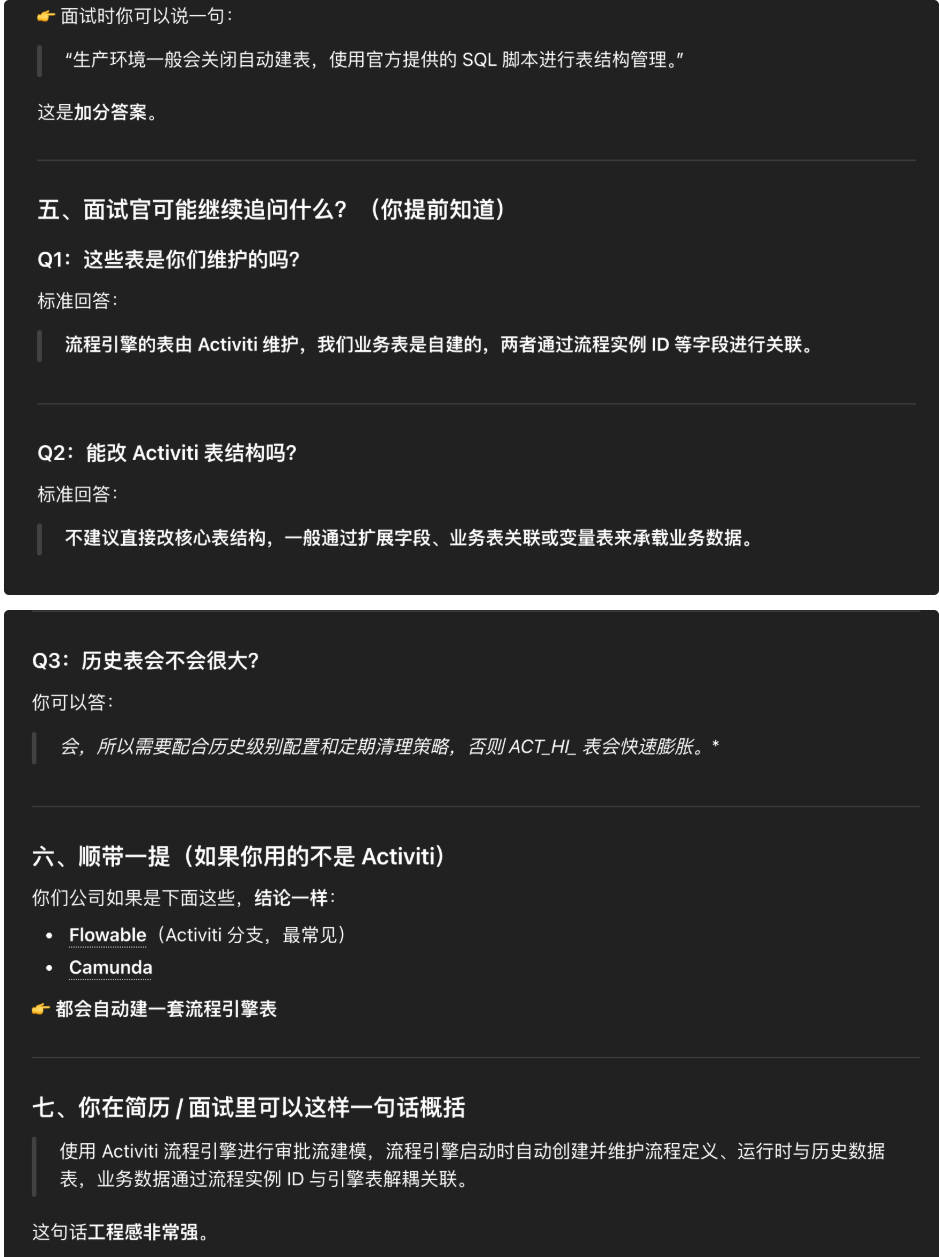
我们公司的配置也是这么配的:
java
spring:
  application:
    name: hcm-workflow-process-platform
  activiti:
    db-history-used: true
    history-level: audit
    async-executor-activate: false
    database-schema-update: false
    use-strong-uuids: false
    # 避免启动时自动部署
    deployment-mode: single-resource

  resources:
    static-locations: classpath:/META-INF/resources/,classpath:/static/,classpath:/public/,classpath:/resources/,file:/project/profiles/
那么问题是什么呢?
首先审批的流程引擎使用的是 activity 框架,然后在一次运维平台的线上告警的提示中,发现流程引擎的一个 sql 查询需要一秒钟(我们公司的标准就是执行时间有 1 秒钟及以上就属于慢 SQL),然后我登陆上我们公司的运维后台系统就看到了记录的有一条慢sql。
然后将这条慢 sql 给放到了阿里云的 dms 环境上,使用 explain 执行计划看了一下,发现 activity 自带的一张表 act_hi_taskinst 里只有一个索引。
又结合了这条 sql 的业务场景分析出实际上是少建了一条索引。
什么是 act_hi_taskinst 表:
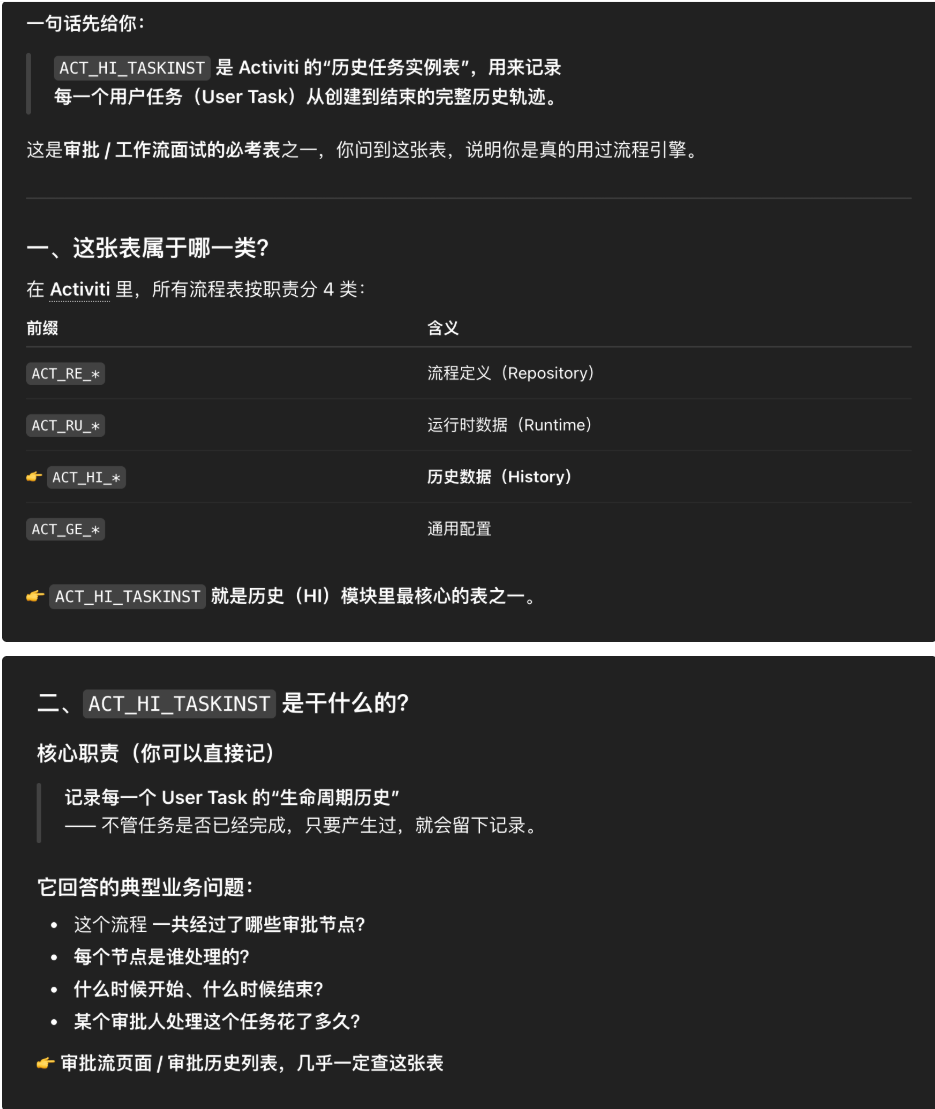
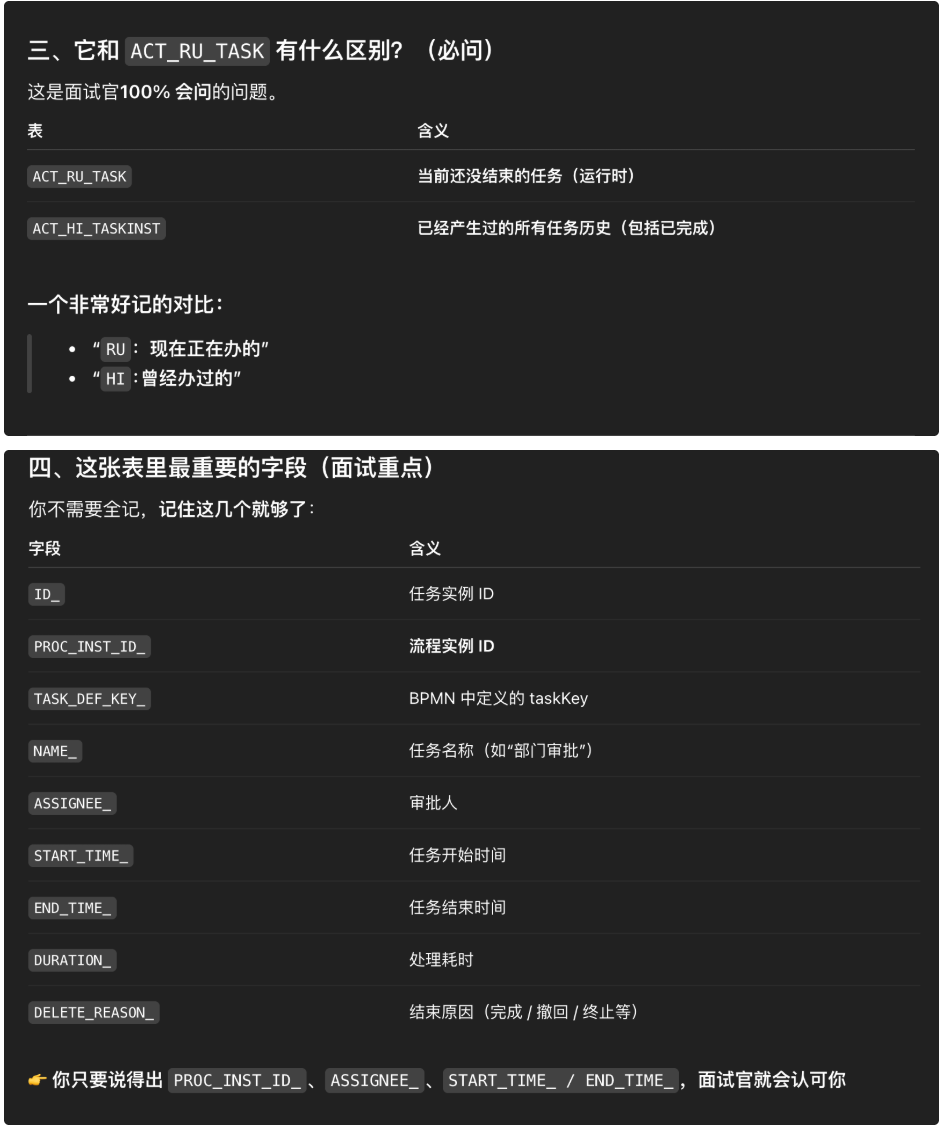
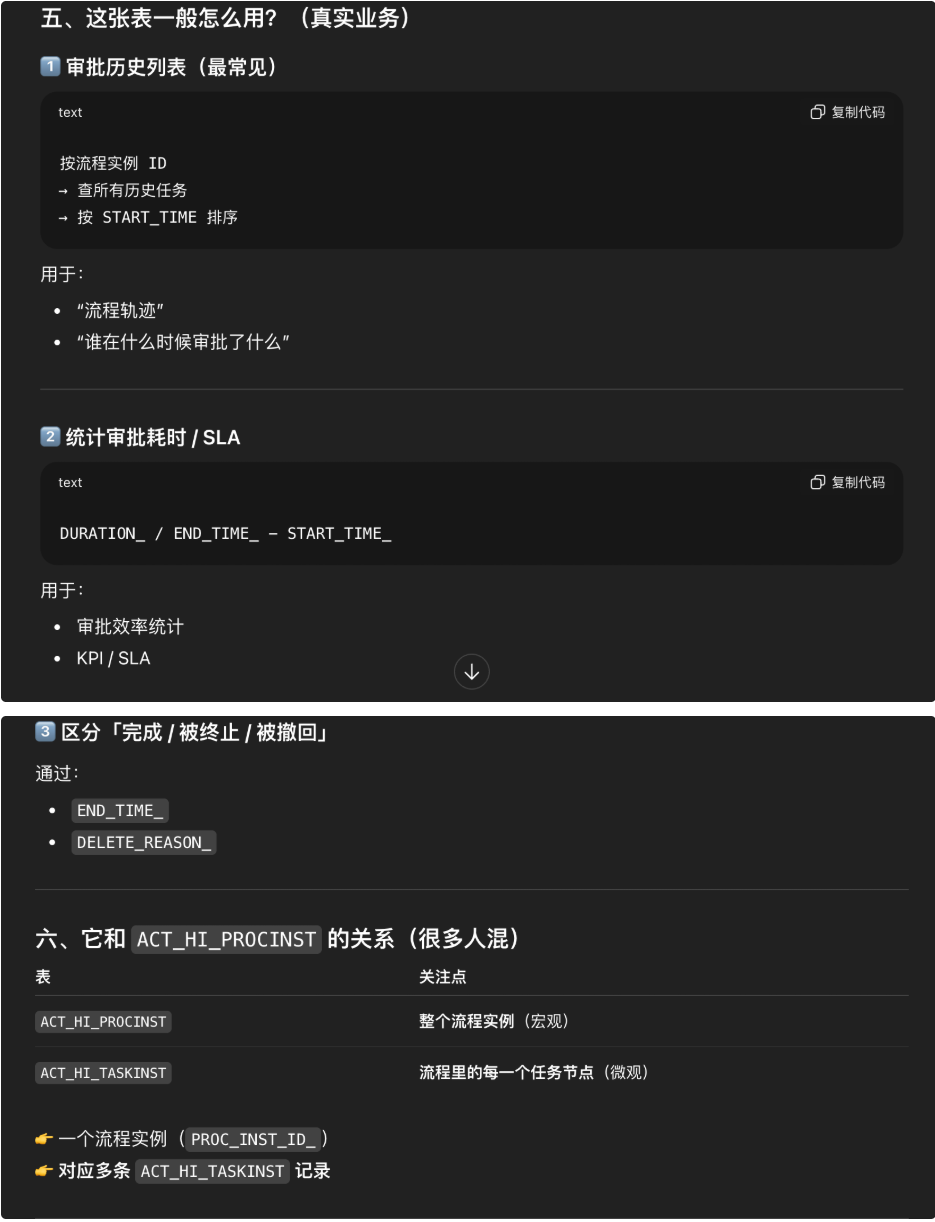
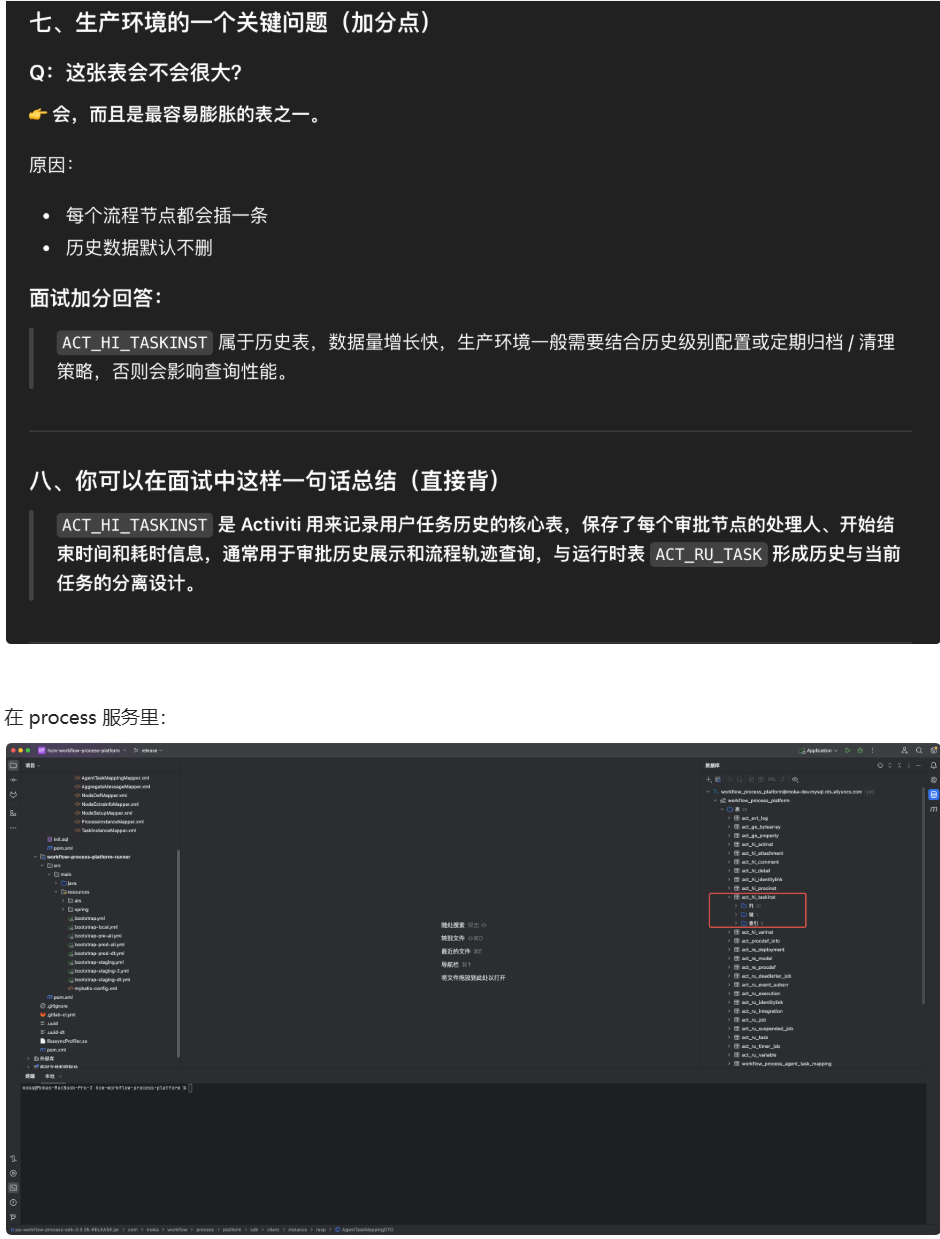
然后可以看一下该表的 DDL:
java
-- auto-generated definition
create table act_hi_taskinst
(
  ID_             varchar(64)             not null
  primary key,
  PROC_DEF_ID_    varchar(64)             null,
  TASK_DEF_KEY_   varchar(255)            null,
  PROC_INST_ID_   varchar(64)             null,
  EXECUTION_ID_   varchar(64)             null,
  NAME_           varchar(255)            null,
  PARENT_TASK_ID_ varchar(64)             null,
  DESCRIPTION_    varchar(4000)           null,
  OWNER_          varchar(255)            null,
  ASSIGNEE_       varchar(255)            null,
  START_TIME_     datetime(3)             not null,
  CLAIM_TIME_     datetime(3)             null,
  END_TIME_       datetime(3)             null,
  DURATION_       bigint                  null,
  DELETE_REASON_  varchar(4000)           null,
  PRIORITY_       int                     null,
  DUE_DATE_       datetime(3)             null,
  FORM_KEY_       varchar(255)            null,
  CATEGORY_       varchar(255)            null,
  TENANT_ID_      varchar(255) default '' null
)
    collate = utf8_bin;

create index ACT_IDX_HI_TASK_INST_PROCINST
    on act_hi_taskinst (PROC_INST_ID_);

create index idx_parent_task_id
    on act_hi_taskinst (PARENT_TASK_ID_);
上面的第二个索引是后面加的,当 activity 创建表时,默认只会创建第一个索引,也就是 PROC_INST_ID_,对流程实例 ID 建立索引:
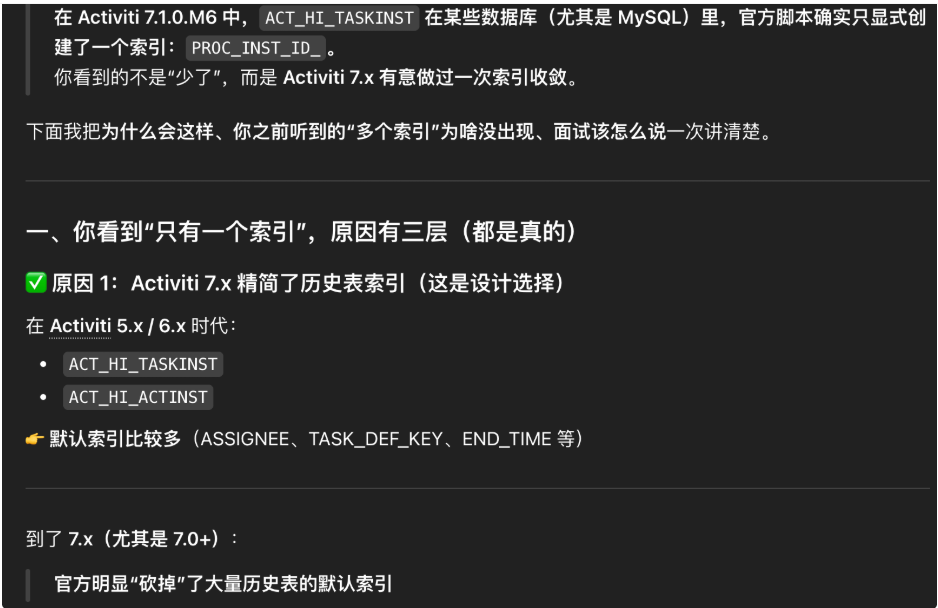
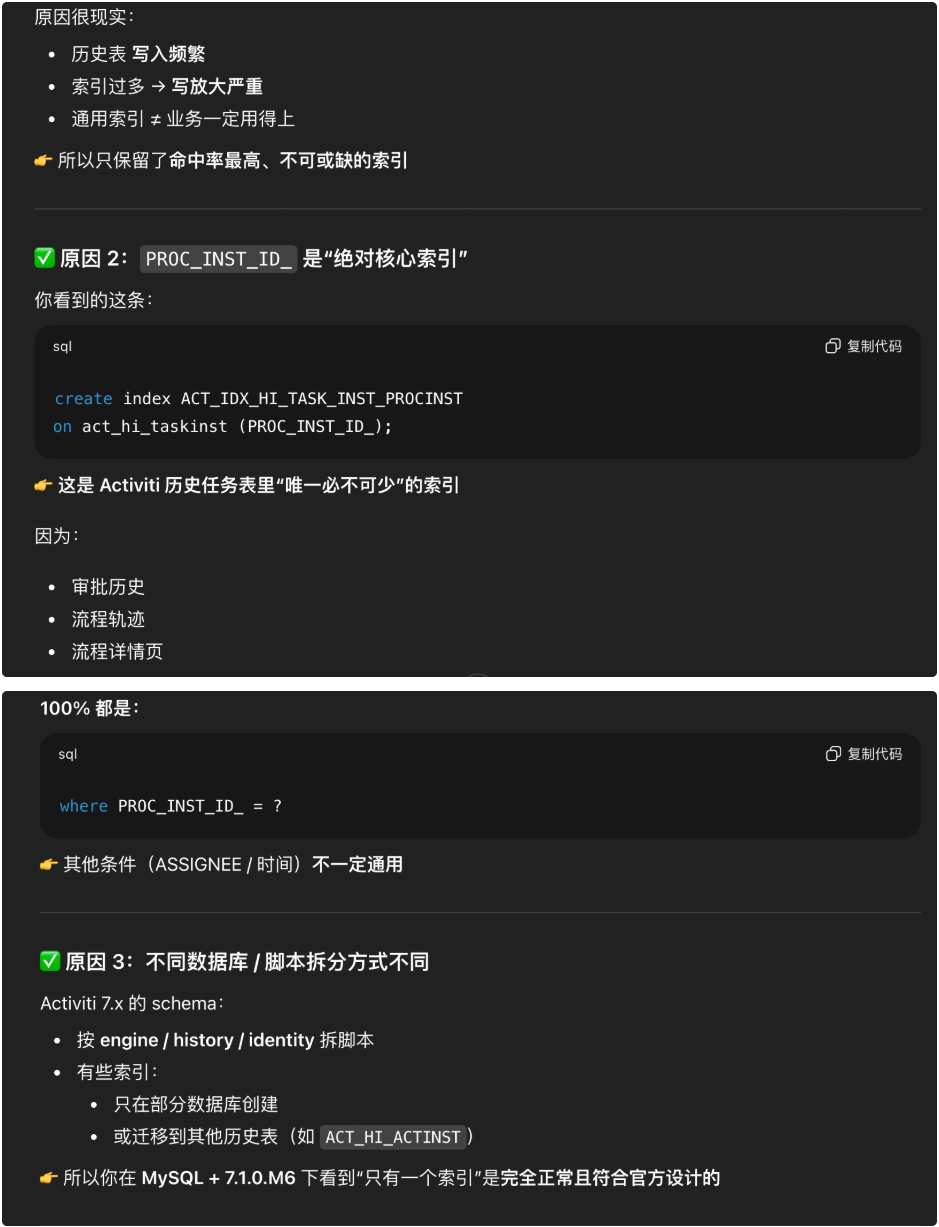
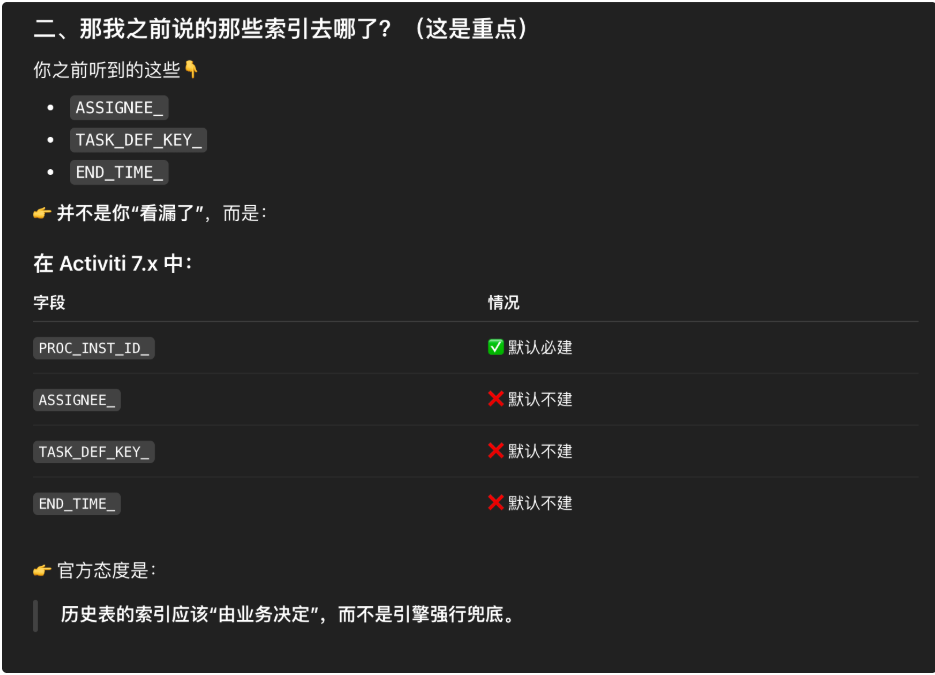
Activiti 7.x 默认只在 ACT_HI_TASKINST 上保留了 PROC_INST_ID_ 索引,更多索引需要根据业务查询模式补充。如果直接在历史表上按 ASSIGNEE 或时间范围做列表查询,很容易出现慢 SQL。
而这个慢 sql 的 case 实则就是我们有个需求是要查父节点的,也就是这个PARENT_TASK_ID_ 这个字段,因此最终的优化手段也很直接,直接加上索引就可以了:
java
create index idx_parent_task_id
    on act_hi_taskinst (PARENT_TASK_ID_);
sql 查询慢 sentry 是否会告警?
不是 sentry 告警,而是公司有专门的 DBA 运维平台工具,会自动发消息到钉钉群里通知开发进行处理。然后有那么两条简单的就是安排到了我的头上。
这个查父节点的业务是什么?
不重要,总之就是有这么一条sql,是根据 act_hi_taskinst 表中的 parent_task_id 去查询任务实例的,然后这个表只有一条索引,所以就慢了。因此加上就可以了。
但是在表的使用过程中加上的话 MySQL 底层会对历史数据重新建立新增的索引树,如果数据量很大,那么实际建树的过程会非常慢的,因此需要在使用低峰期内进行更新,而且如果实在是数据量太大,DBA 可能都不会让加。
然后我们一般是提供一个 sql 操作的工单,会让 DBA 批一下工单,DBA 批工单的时候会评估我们的 sql 对业务影响大不大,是不是能够执行,然后如果可以的话,就会审批通过,然后告诉你晚上几点的时候执行这条 sql。
一般就是八点半到九点左右就发版了,所以应该也是这个点就操作了。
CASE2:in 关键字返回的数量太多
如下:
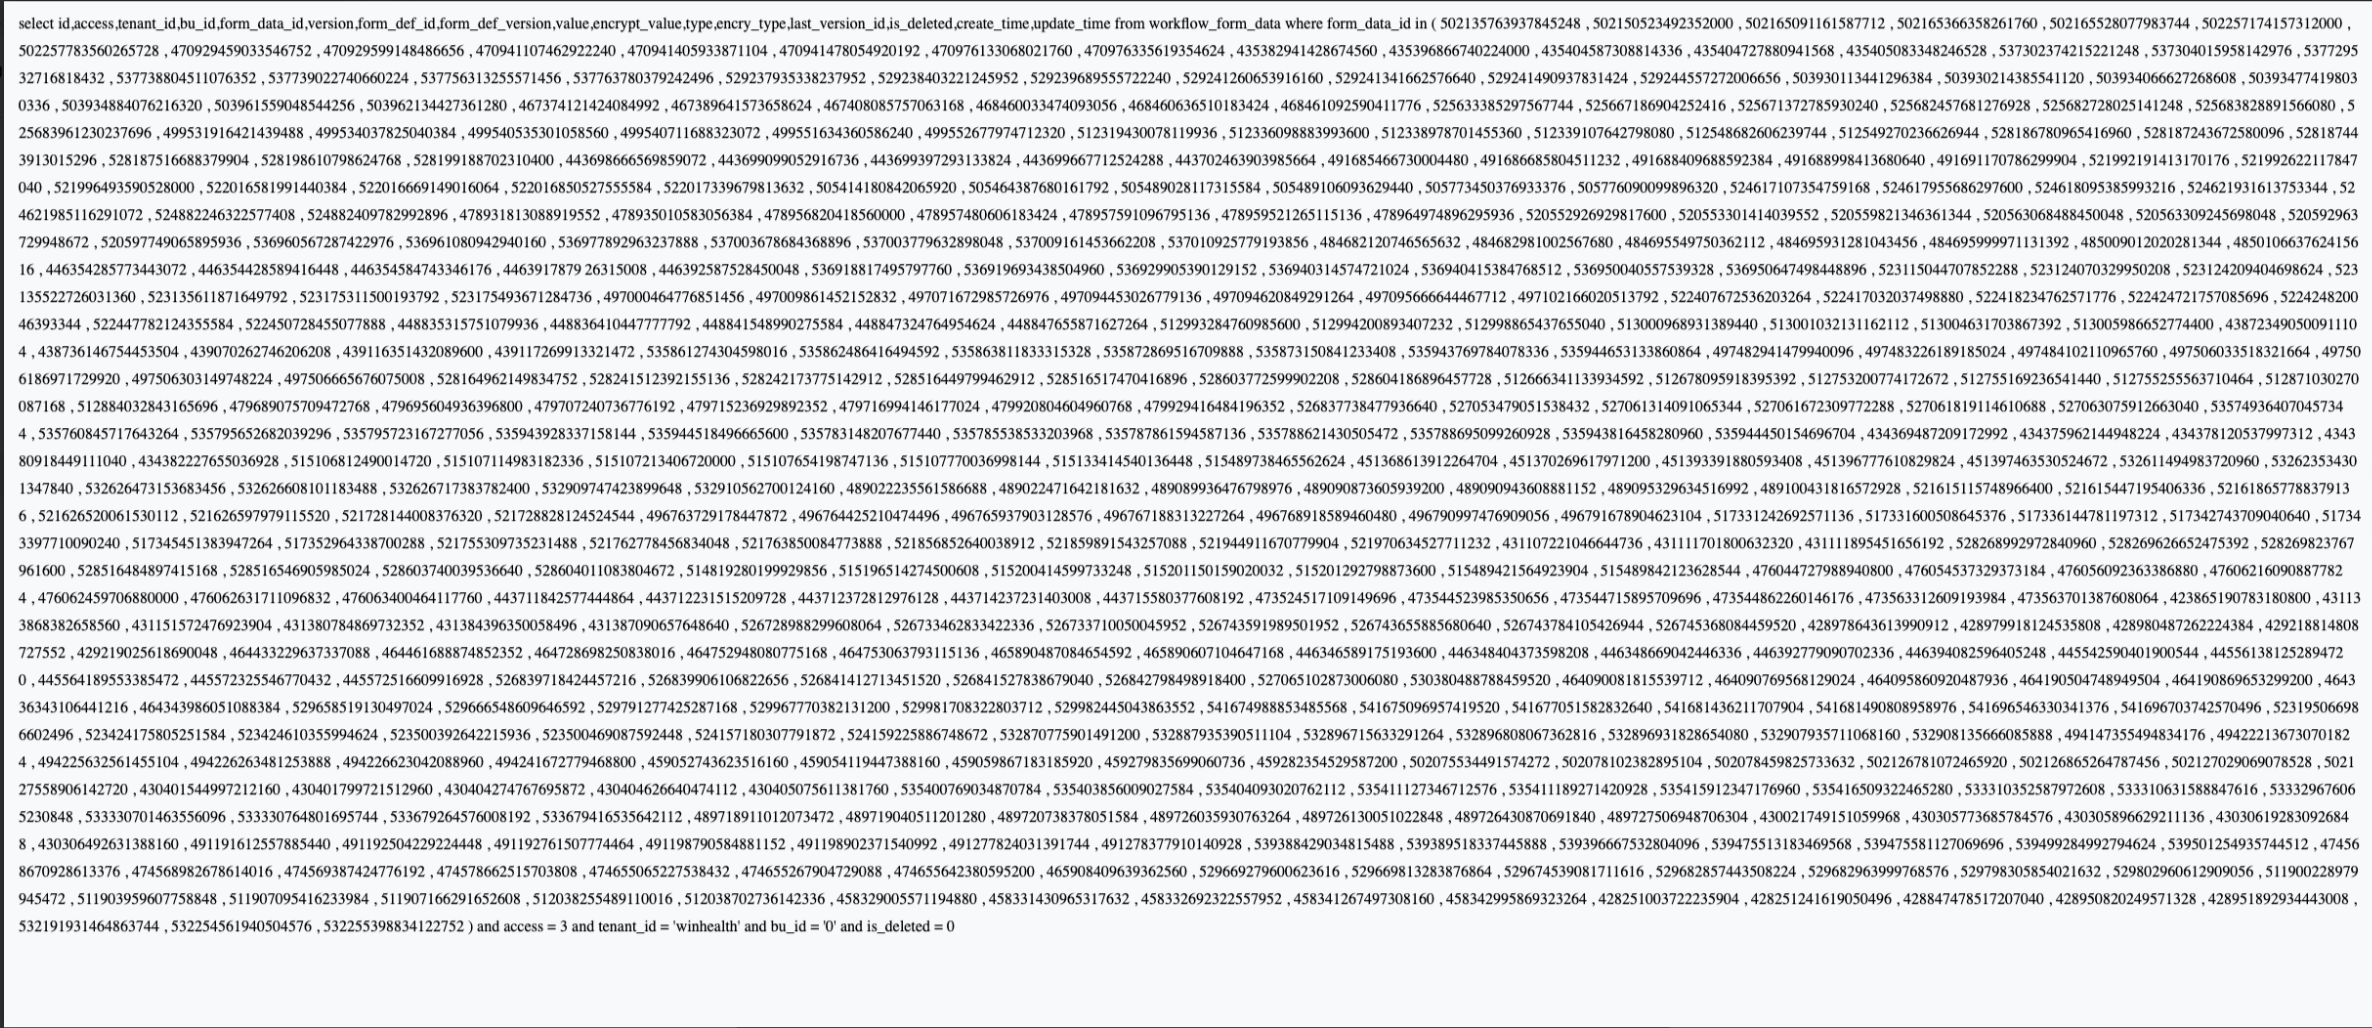
存在该问题的地方,批量查询表单数据的位置:
java
    /**
     * 批量查询表单数据
     */
    List<FormDataBO> getFormDataList(List<Long> formDataIdList, OperatorInfoBO operatorInfoBO);
java
@Override
    public List<FormDataBO> getFormDataList(List<Long> formDataIdList, OperatorInfoBO operatorInfoBO) {
        OperatorInfoReq operatorInfoReq = new OperatorInfoReq();
        OperatorInfoUtils.copy(operatorInfoBO, operatorInfoReq);
        ChunkQueryWithOperatorInfoReqParam<Long> chunkQueryParam = (ChunkQueryWithOperatorInfoReqParam<Long>)
                ChunkQueryWithOperatorInfoReqParam.<Long>builder()
                        .operatorInfoReq(operatorInfoReq)
                        .build()
                        .setParamList(new LinkedHashSet<>(formDataIdList));
        ChunkQueryUtil<ChunkQueryWithOperatorInfoReqParam<Long>, Long, FormDataDO> chunkQueryUtil = new ChunkQueryUtil<>
                (FORM_DATA_SERVICE_IMPL_GET_FORM_DATA_LIST, taskExecutorService, threadPoolManager);
        List<FormDataDO> formDataDOList = chunkQueryUtil.chunkQuery(chunkQueryParam, (param, paramList) -> {
            OperatorInfoReq operatorInfo = param.getOperatorInfoReq();
            return formDataMetaDataService.getByFormDataIdList(paramList, operatorInfo.getAccess().getVal(), operatorInfo.getTenantId(), operatorInfo.getBuId());
        });

        return formDataDOList.stream()
                .peek(
                        formDataDO -> {
                            if (StringUtils.isNotEmpty(formDataDO.getEncryptValue())) {
                                checkAndDoFormDataDeCrypt(true, formDataDO, operatorInfoBO);
                            }
                        }
                )
                .map(FormDataBOConverter::convert2FormDataBO)
                .collect(toList());
    }
这个查询的 sql 如下:
java
@Override
    public List<FormDataDO> getByFormDataIdList(List<Long> formDataIdList, long access, String tenantId, String buId) {
        if (CollectionUtils.isEmpty(formDataIdList)) {
            return Collections.emptyList();
        }
        return formDataMetaDataDAO.getByFormDataIdList(formDataIdList, access, tenantId, buId);
    }
java
    /**
     * 批量查询表单数据
     */
    @Select({"<script>",
            " select ", ALL_FIELD,
            " from workflow_form_data ",
            " where form_data_id in ",
            "<foreach collection='ids' item='i' index='index' separator=',' open='(' close=')'>",
            " #{i} ",
            "</foreach>",
            " and access = #{a} ",
            " and tenant_id = #{t} ",
            " and bu_id = #{b} ",
            " and is_deleted = 0 ",
            "</script>"
    })
    List<FormDataDO> getByFormDataIdList(@Param("ids") List<Long> formDataIdList,
                                         @Param("a") long access,
                                         @Param("t") String tenantId,
                                         @Param("b") String buId);
这是一个 MyBatis 动态 SQL 查询方法,用于批量查询表单数据。详细解释:
SQL 逻辑分析
生成的 SQL 语句
java
SELECT [所有字段]
  FROM workflow_form_data
  WHERE form_data_id IN (100, 101, 102)  -- 批量ID查询
    AND access = 1                        -- 产品线隔离
    AND tenant_id = 'tenant_123'          -- 租户隔离
    AND bu_id = 'bu_456'                  -- 业务单元隔离
    AND is_deleted = 0                    -- 排除软删除数据
参数说明
java
  ┌──────────────┬────────────┬─────────────────┬─────────────────┐
  │     参数     │    类型    │      说明       │     示例值      │
  ├──────────────┼────────────┼─────────────────┼─────────────────┤
  │ ids          │ List<Long> │ 表单数据ID列表  │ [100, 101, 102] │
  ├──────────────┼────────────┼─────────────────┼─────────────────┤
  │ a (access)   │ long       │ 产品线/访问权限 │ 1=HCM, 2=ATS等  │
  ├──────────────┼────────────┼─────────────────┼─────────────────┤
  │ t (tenantId) │ String     │ 租户ID          │ "tenant_123"    │
  ├──────────────┼────────────┼─────────────────┼─────────────────┤
  │ b (buId)     │ String     │ 业务单元ID      │ "bu_456"        │
  └──────────────┴────────────┴─────────────────┴─────────────────┘
核心要点
- 批量 IN 查询
java
<foreach collection='ids' item='i' index='index' separator=',' open='(' close=')'>
    #{i}
  </foreach>
  - 将 List<Long> formDataIdList 转换为 IN (100, 101, 102) 语句
  - separator=',':用逗号分隔
- open='(' 和 close=')':添加括号- 多租户数据隔离
这是典型的 SaaS 多租户架构,通过三层隔离保证数据安全:
access(产品线) → tenantId(租户) → buId(业务单元)
示例:
- access=1:HCM人力资源系统
- tenantId='alibaba':阿里巴巴租户
- buId='taobao':淘宝事业部
这样可以确保:
- 阿里巴巴的数据不会被腾讯看到(tenantId隔离)
- 淘宝的数据不会被天猫看到(buId隔离)
- HCM的数据不会被ATS招聘系统看到(access隔离)
- 软删除机制
AND is_deleted = 0
- 删除数据时不是真正从数据库删除(硬删除)
- 而是标记 is_deleted = 1(软删除)
- 查询时过滤掉已删除数据
- 好处:数据可恢复、可追溯、保证数据完整性
实际使用场景
java
// 查询多条表单数据
  List<Long> formDataIds = Arrays.asList(100L, 101L, 102L);
  List<FormDataDO> dataList = dao.getByFormDataIdList(
      formDataIds,           // 要查询的ID列表
      1L,                    // access=1 (HCM系统)
      "alibaba",             // 阿里巴巴租户
      "taobao"               // 淘宝业务单元
  );
生成的SQL:
java
SELECT * FROM workflow_form_data
  WHERE form_data_id IN (100, 101, 102)
    AND access = 1
    AND tenant_id = 'alibaba'
    AND bu_id = 'taobao'
    AND is_deleted = 0
为什么需要这些条件?
安全性考虑
假设没有租户隔离,恶意用户可能:
java
// 危险!如果没有 tenantId 过滤
  List<FormDataDO> allData = dao.getByFormDataIdList(
      Arrays.asList(1L, 2L, 3L, ... 1000000L),  // 遍历所有ID
      access, "", ""  // 可能获取到其他租户的数据!
  );
数据一致性
- access + tenantId + buId 组合确保查询的数据属于同一个业务范围
- 防止跨租户数据泄露
- 支持数据归档和迁移(通过 is_deleted 标记)
总结
这是一个安全的批量查询接口,核心特点:
- 批量查询:支持一次查询多条数据(避免 N+1 问题)
- 多租户隔离:三层隔离机制保证数据安全
- 软删除:数据逻辑删除,保证可追溯
- 性能优化:IN 查询比循环单条查询效率高很多
对应的业务逻辑:
getFormDataList 方法业务逻辑详解
方法签名
List<FormDataBO> getFormDataList(List formDataIdList, OperatorInfoBO operatorInfoBO)
输入:
- formDataIdList:需要查询的表单数据ID列表(如 100, 101, 102)
- operatorInfoBO:操作人信息(包含租户、权限等上下文)
输出:
- List<FormDataBO>:表单数据业务对象列表
核心业务流程(5个步骤)
1️⃣ 分块查询(Chunk Query) - Line 488-501
java
  ChunkQueryUtil<...> chunkQueryUtil = new ChunkQueryUtil<>(...);
  List<FormDataDO> formDataDOList = chunkQueryUtil.chunkQuery(chunkQueryParam, (param, paramList) -> {
      return formDataMetaDataService.getByFormDataIdList(paramList, ...);
  });
为什么要分块?
假设你要查询 10,000 条数据:
-- 如果一次性查询,SQL 会很长,可能导致:
SELECT * FROM workflow_form_data
WHERE form_data_id IN (1,2,3,...,10000) -- SQL 太长!
分块策略:
java
  // 自动切分成多批查询
  批次1: IN (1, 2, ..., 1000)
  批次2: IN (1001, 1002, ..., 2000)
  ...
  批次10: IN (9001, 9002, ..., 10000)
好处:
- ✅ 避免 SQL 语句过长
- ✅ 避免数据库单次查询压力过大
- ✅ 支持并行查询(taskExecutorService)
- ✅ 防止内存溢出
2️⃣ 数据解密处理 - Line 503-510
java
  .peek(formDataDO -> {
      if (StringUtils.isNotEmpty(formDataDO.getEncryptValue())) {
          checkAndDoFormDataDeCrypt(true, formDataDO, operatorInfoBO);
      }
  })
业务背景:
表单数据可能包含敏感信息(工资、身份证号、银行卡等),需要加密存储:
java
  ┌──────────────┬──────────────────────────────┬────────────────────────────┐
  │     字段     │             说明             │            示例            │
  ├──────────────┼──────────────────────────────┼────────────────────────────┤
  │ value        │ 明文数据(老数据或不需加密) │ {"salary": "10000"}        │
  ├──────────────┼──────────────────────────────┼────────────────────────────┤
  │ encryptValue │ 密文数据(敏感数据加密后)   │ AES256_ENCRYPTED_STRING... │
  └──────────────┴──────────────────────────────┴────────────────────────────┘
解密逻辑:
java
  // 场景1:有密文 → 解密
  if (encryptValue != null) {
      // 1. 检查租户是否有解密密钥
      checkAndSetEncryptKeyIfNotExist(tenantId);
      // 2. 使用租户密钥解密
      return doDecryption(formDataDO);
  }

  // 场景2:明文为空但有密文 → 兜底解密
  if (value == "[]" && encryptValue != null) {
      return doDecryption(formDataDO);  // 防止配置变更导致的问题
  }
实际例子:
java
  // 数据库存储(加密)
  {
    "value": "[]",
    "encryptValue": "U2FsdGVkX1+abc..."  // AES加密
  }

  // 解密后返回
  {
    "salary": "10000",
    "idCard": "110101199001011234"
  }
3️⃣ 数据转换(DO → BO) - Line 511
.map(FormDataBOConverter::convert2FormDataBO)
为什么要转换?
java
  ┌──────────┬──────────────────────────────┬────────────────────────────┐
  │   层次   │           对象类型           │            说明            │
  ├──────────┼──────────────────────────────┼────────────────────────────┤
  │ 数据库层 │ FormDataDO (Data Object)     │ 数据库实体,包含数据库字段 │
  ├──────────┼──────────────────────────────┼────────────────────────────┤
  │ 业务层   │ FormDataBO (Business Object) │ 业务对象,包含业务逻辑字段 │
  └──────────┴──────────────────────────────┴────────────────────────────┘
转换示例:
java
  // FormDataDO(数据库对象)
  {
    "form_data_id": 100,           // 数据库字段命名
    "value": "{...}",              // JSON字符串
    "create_time": 1234567890,     // 时间戳
    "encrypt_value": "..."
  }

  // 转换为 FormDataBO(业务对象)
  {
    "formDataId": 100,             // 驼峰命名
    "formDataList": [...],         // JSON解析为对象列表
    "createTime": Date对象,         // 转换为Date类型
    // 过滤掉不需要暴露的字段(如密文)
  }
4️⃣ 收集结果 - Line 512
.collect(toList());
将 Stream 转换为 List 返回。
完整业务流程图
java
  输入: formDataIdList = [100, 101, ..., 10000]
           operatorInfoBO = {tenantId: "alibaba", access: HCM}
             ↓
  ┌─────────────────────────────────────────────────────┐
  │ 步骤1: 分块查询(Chunk Query)                        │
  ├─────────────────────────────────────────────────────┤
  │ • 将10000个ID分成10批,每批1000个                      │
  │ • 并行执行10次数据库查询                               │
  │ • 每次查询携带租户隔离条件 (tenantId, access, buId)    │
  └─────────────────────────────────────────────────────┘
             ↓
  ┌─────────────────────────────────────────────────────┐
  │ 步骤2: 数据库查询(底层调用MyBatis)                   │
  ├─────────────────────────────────────────────────────┤
  │ SELECT * FROM workflow_form_data                    │
  │ WHERE form_data_id IN (100, 101, ...)              │
  │   AND access = 1                                    │
  │   AND tenant_id = 'alibaba'                         │
  │   AND bu_id = 'taobao'                              │
  │   AND is_deleted = 0                                │
  └─────────────────────────────────────────────────────┘
             ↓
  ┌─────────────────────────────────────────────────────┐
  │ 步骤3: 数据解密(针对敏感数据)                        │
  ├─────────────────────────────────────────────────────┤
  │ • 检查是否有encryptValue字段                          │
  │ • 如果有,使用租户密钥进行AES解密                      │
  │ • 将解密后的数据填充到value字段                        │
  └─────────────────────────────────────────────────────┘
             ↓
  ┌─────────────────────────────────────────────────────┐
  │ 步骤4: 数据转换(DO → BO)                            │
  ├─────────────────────────────────────────────────────┤
  │ • 数据库字段名转驼峰命名                               │
  │ • JSON字符串解析为对象                                │
  │ • 过滤敏感字段(如密文)                               │
  │ • 添加业务计算字段                                    │
  └─────────────────────────────────────────────────────┘
             ↓
  输出: List<FormDataBO> (业务对象列表)
实际使用场景:
场景1:审批详情页查询
java
  // 用户查看审批详情时,需要加载该审批的所有历史表单数据
  List<Long> formDataIds = Arrays.asList(100L, 101L, 102L);  // 该审批的3个版本
  List<FormDataBO> historyData = formDataService.getFormDataList(
      formDataIds,
      operatorInfoBO  // 当前用户信息
  );
  // 显示:初始提交 → 驳回修改 → 最终通过
场景2:数据合并(本文开头的接口就用到了它)
java
  // batchUpdateFormDataById 内部调用
  List<FormDataDO> formDataList = formDataMetaDataService.getByFormDataIds(formDataIds);
  // 需要将多份表单数据的某个字段进行批量更新
场景3:审批流程数据聚合
java
  // 审批流转时,需要合并多个节点的表单数据
  FormDataBO mergedData = doMergeFormData(
      latestFormData,
      formDataIdList,  // 历史所有表单数据ID
      operatorInfoBO
  );
关键技术点总结:
java
  ┌────────────┬──────────────┬────────────────────────────┐
  │   技术点   │     目的     │          实现方式          │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 分块查询   │ 性能优化     │ ChunkQueryUtil 自动分批    │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 多租户隔离 │ 数据安全     │ access + tenantId + buId   │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 数据加密   │ 敏感信息保护 │ AES 加密 + 租户密钥管理    │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 软删除     │ 数据可追溯   │ is_deleted 标记            │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 分层架构   │ 职责分离     │ DO(数据层) → BO(业务层)    │
  ├────────────┼──────────────┼────────────────────────────┤
  │ 并行查询   │ 性能优化     │ taskExecutorService 线程池 │
  └────────────┴──────────────┴────────────────────────────┘
总结
这个方法的核心业务逻辑是:
- 安全地批量查询表单数据(租户隔离 + 软删除过滤)
- 自动处理敏感数据解密(工资、身份证等)
- 性能优化(分块查询 + 并行执行)
- 数据转换(数据库对象 → 业务对象)
它是一个基础设施方法,被上层很多业务方法调用,如数据合并、审批详情查询、历史版本对比等。