各位朋友大家好,我是一言,继续更新 Spring AI 2.0 系列。
前两篇文章分别讲了查询扩展和多轮改写。这次来看检索之后:结果已经按照相关性排好了,为什么还要调用另外一个模型再排一次?
Rerank(重排)就是给候选资料重新打分,再选出更符合当前问题的几份。
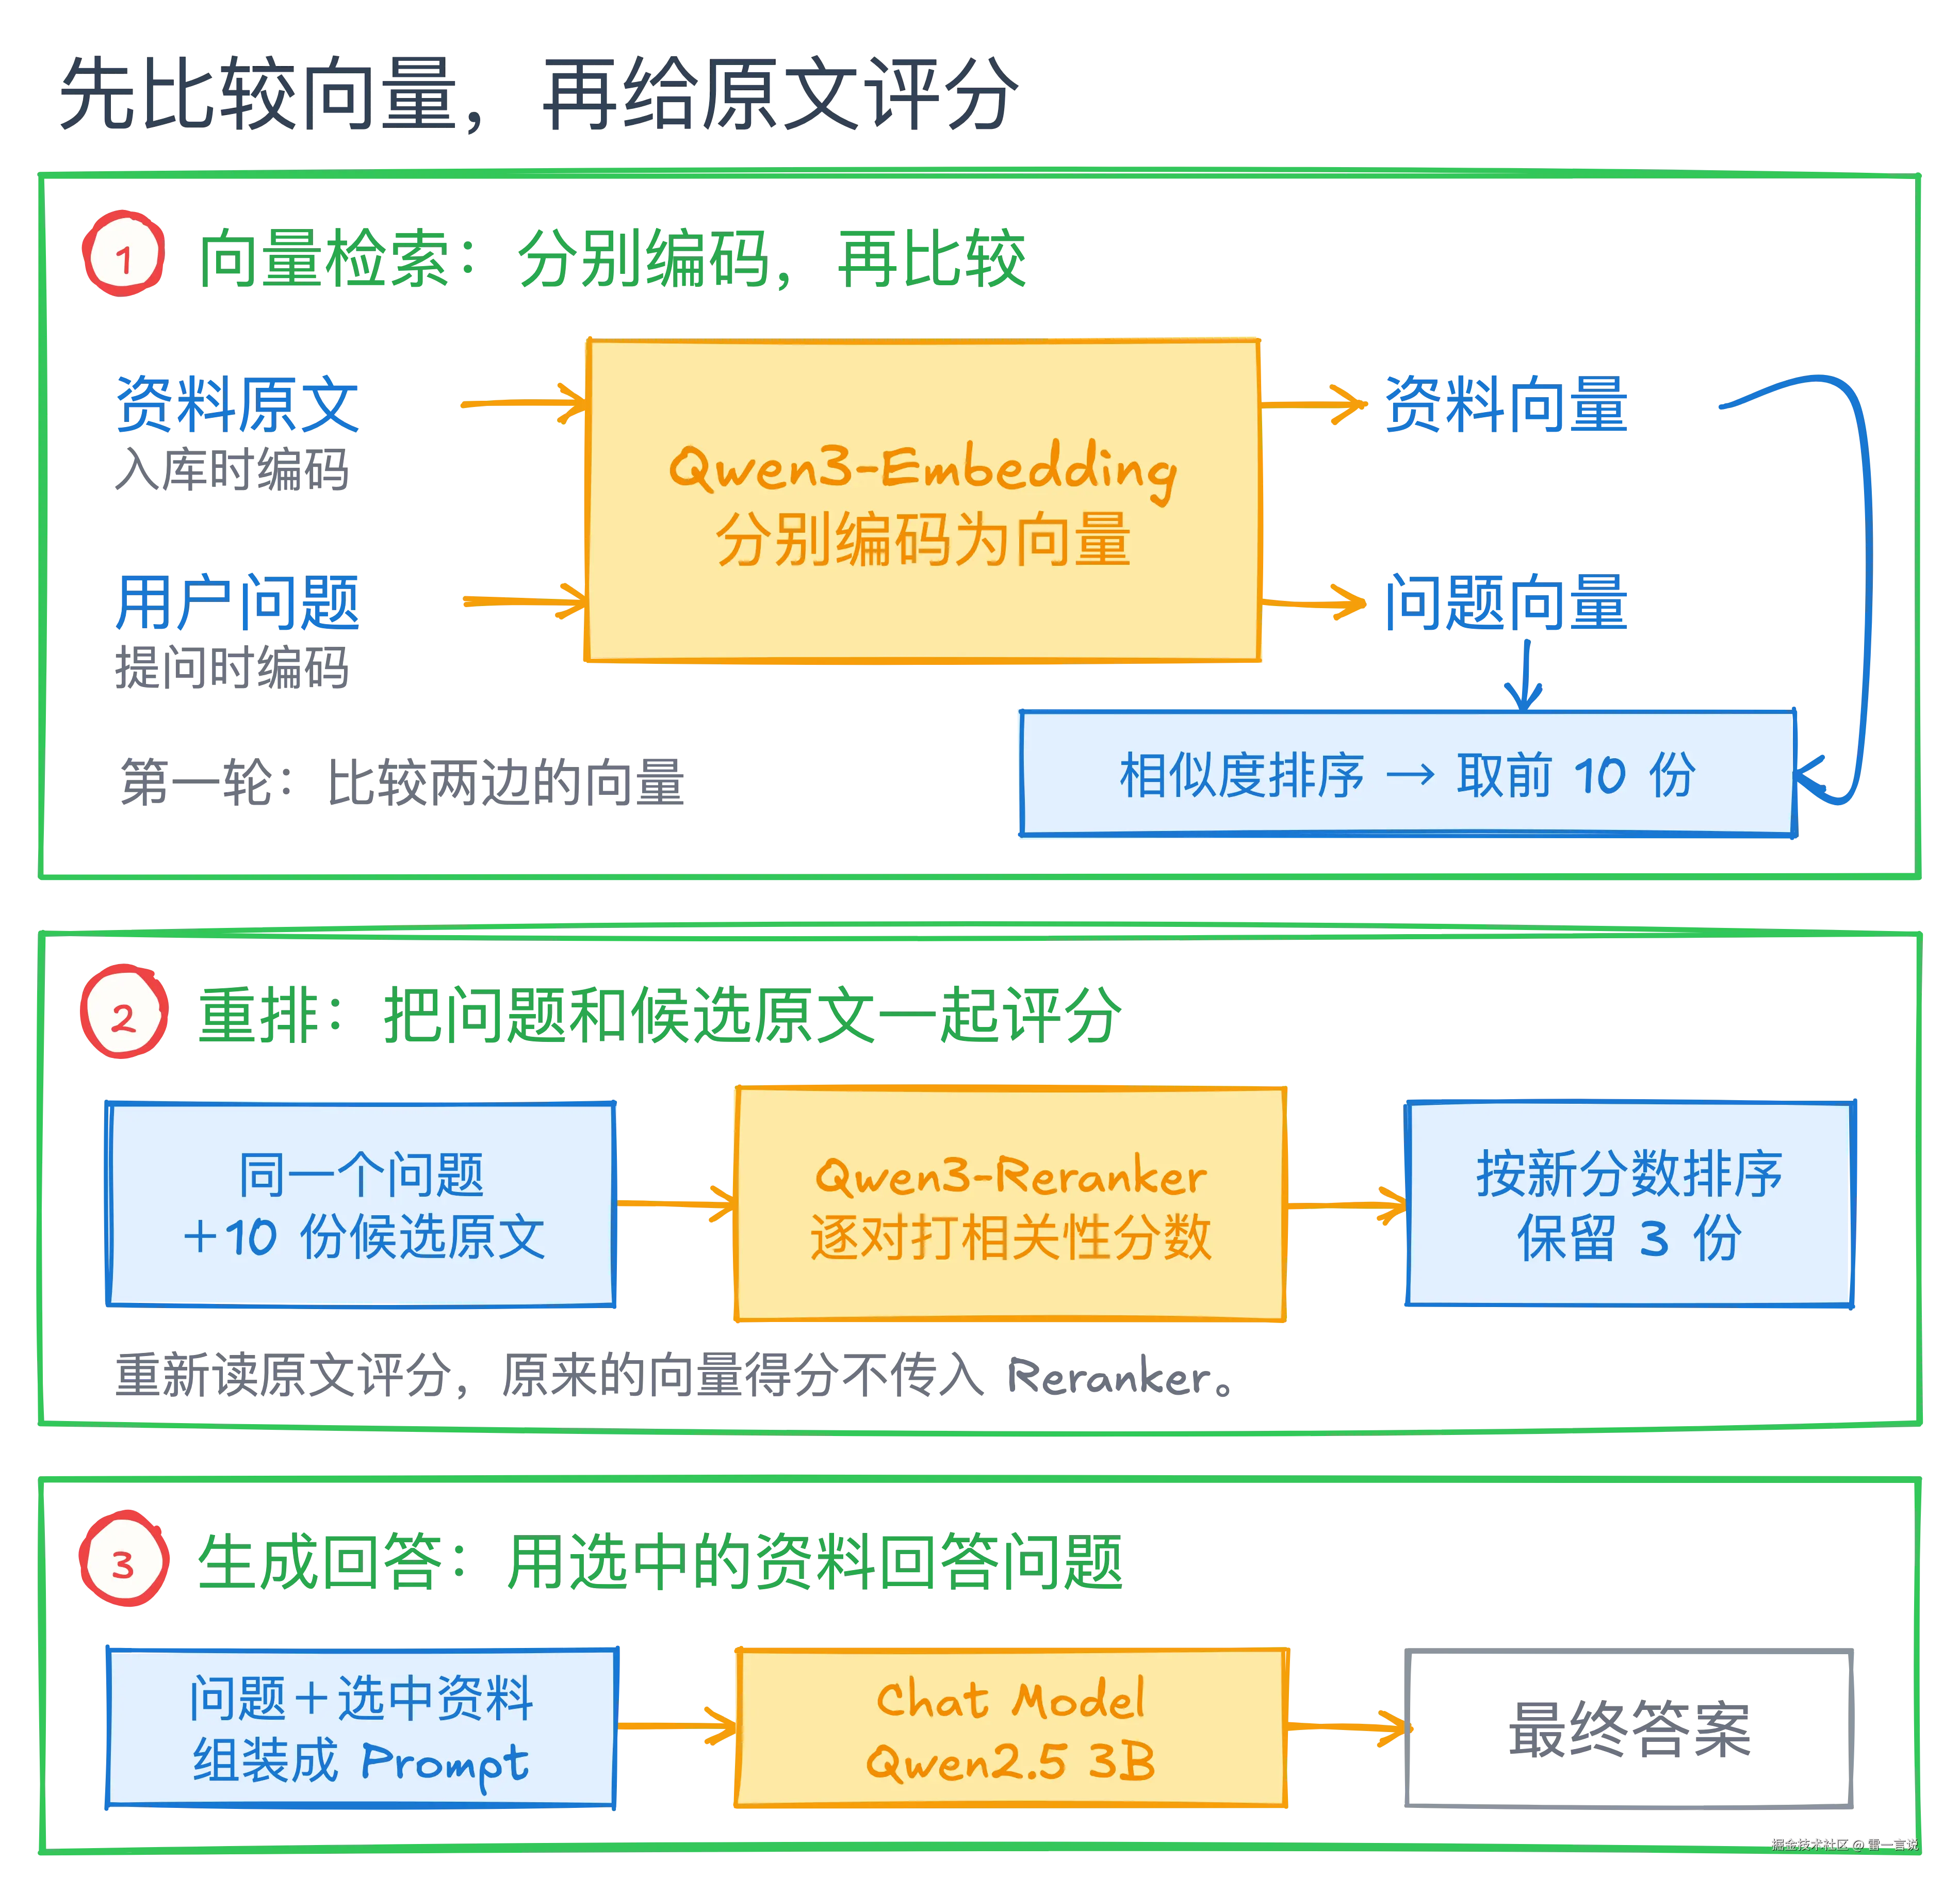
两次评分有什么不同
向量检索时,Embedding 模型把资料和问题分别编码成向量,再比较相似度。资料在入库时编码,问题在提问时编码。
Qwen3-Reranker 会把当前问题和每份候选原文一起输入模型,重新给这对文本打分。
比如两份资料都谈退款,一份讲正常到账,一份讲退款失败。用户问"退款失败后怎么办",就需要优先选出后一份规则。
实测用了三个模型:
| 模型类型 | 选用模型 | 输入 → 输出 |
|---|---|---|
| Embedding | Qwen3-Embedding 0.6B | 文本 → 向量 |
| Reranker | Qwen3-Reranker 0.6B | 问题+候选原文 → 相关性分数 |
| Chat Model | Qwen2.5 3B | 问题+选中资料 → 最终回答 |
选中的资料会和问题一起进入 Prompt,作为 Chat Model 回答的依据。
看知识库里面有什么
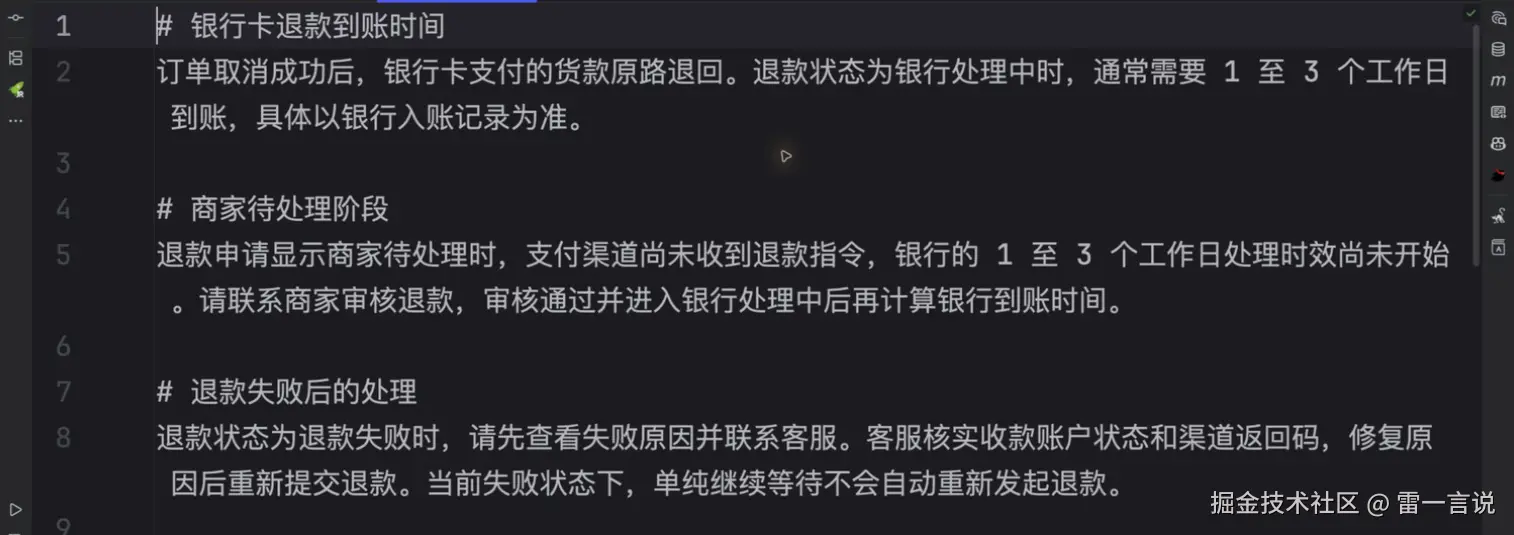
我准备了 20 份售后演示规则,作为 Document 存入 SimpleVectorStore。其中三份原文如下:
我固定了 6 个问题,跑两组对照:
- 直接检索:向量检索前 3 份,用来回答。
- 检索加重排:先检索 10 份,重排取前 3 份,用来回答。
两组共用知识库、回答模型和提示词。三个模型均在本地运行,6 组问答用例和 3 个后处理器测试通过。
一份关键规则,从第 6 位变成了第 1 位
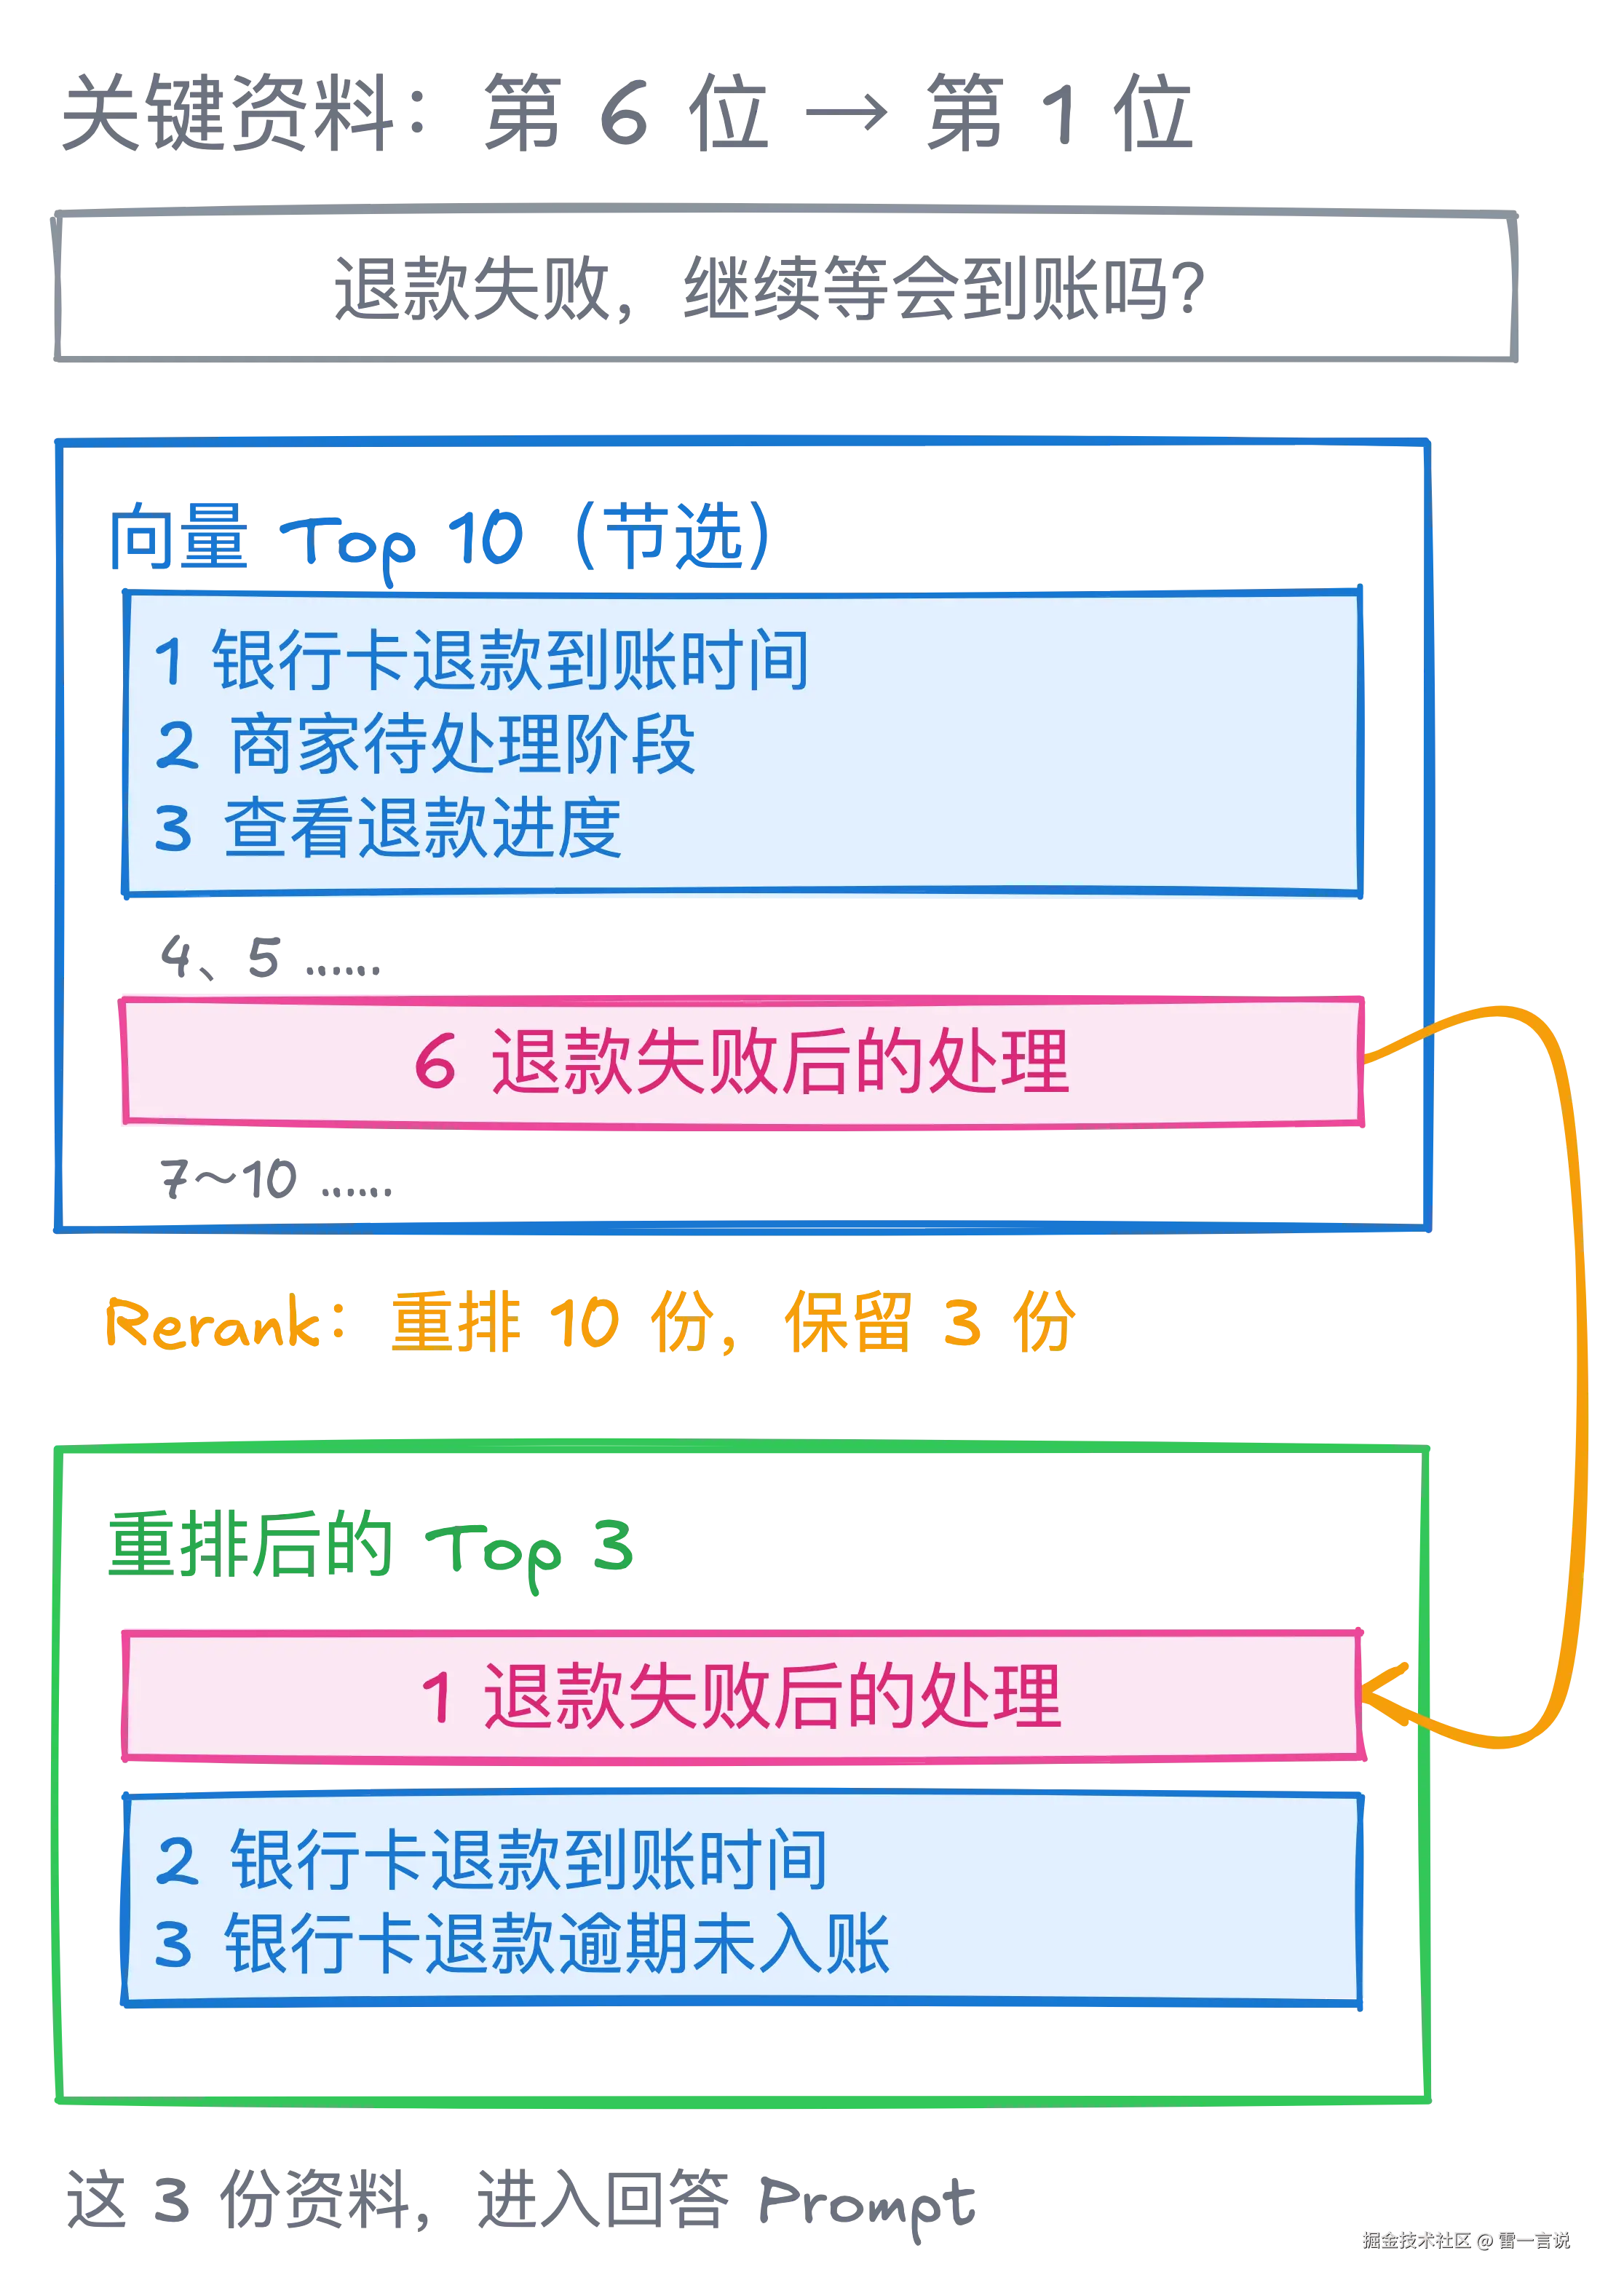
订单显示退款失败,我继续等几天就会到账吗?
《退款失败后的处理》原本排在第 6 位,不能进入前 3。重排之后,它到了第一位:
直接检索的时候,模型回答:
退款失败的状态下,需要联系商家审核退款,审核通过后才会进入银行处理中阶段。
它把"商家待处理"的办法用到了"退款失败"上面。
重排之后的完整回答是:
退款状态为退款失败时,请先查看失败原因并联系客服。客服核实收款账户状态和渠道返回码,修复原因后重新提交退款。当前失败状态下,单纯继续等待不会自动重新发起退款。
"退款失败"的规则进入回答上下文后,模型有了查原因、修复后重新提交的依据。
六道题,重排改变了什么
下表比较的是每道题需要的关键资料排在第几位:
| 问题 | 重排前 | 重排后 |
|---|---|---|
| 银行卡退款超过 3 个工作日未到账 | 第 1 位 | 第 1 位 |
| 周末算不算退款处理时间 | 第 1 位 | 第 1 位 |
| 原付款银行卡已经注销 | 第 1 位 | 第 1 位 |
| 退款仍显示商家待处理 | 第 1 位 | 第 1 位 |
| 余额付款,银行卡没收到退款 | 第 1 位 | 第 1 位 |
| 退款失败,继续等会到账吗 | 第 6 位 | 第 1 位 |
另外 5 题的关键资料一直排在第 1 位,重排后没有变化。"周末怎么算"和"银行卡注销"两题的答案也没有变化。
第一题重排后,还多了一句没必要的"缺少具体的退款流水号信息"。所以,重排也不保证每道题都答得更好。
直接把全部 10 份资料交给回答模型,也是另外一种做法,本次没有测试。
看一次 Reranker 的输入和输出
我用 Python 在本地加载 Qwen3-Reranker,封装成 HTTP 服务,Java 通过自定义的 HttpRerankClient 调用它。
再用 Postman 单独发一次请求:query 是问题,documents 是向量检索出的 10 份候选全文。
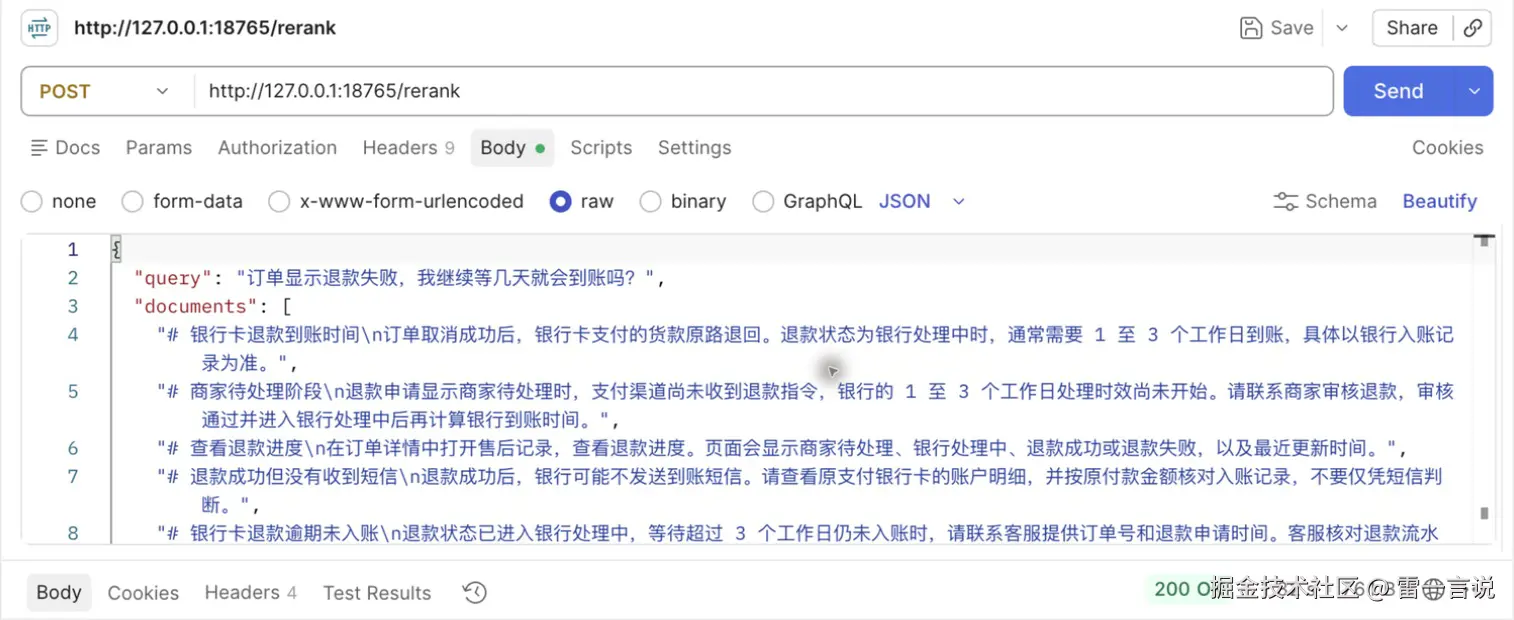
服务返回每份资料的索引和 relevance_score,按分数从高到低排列:
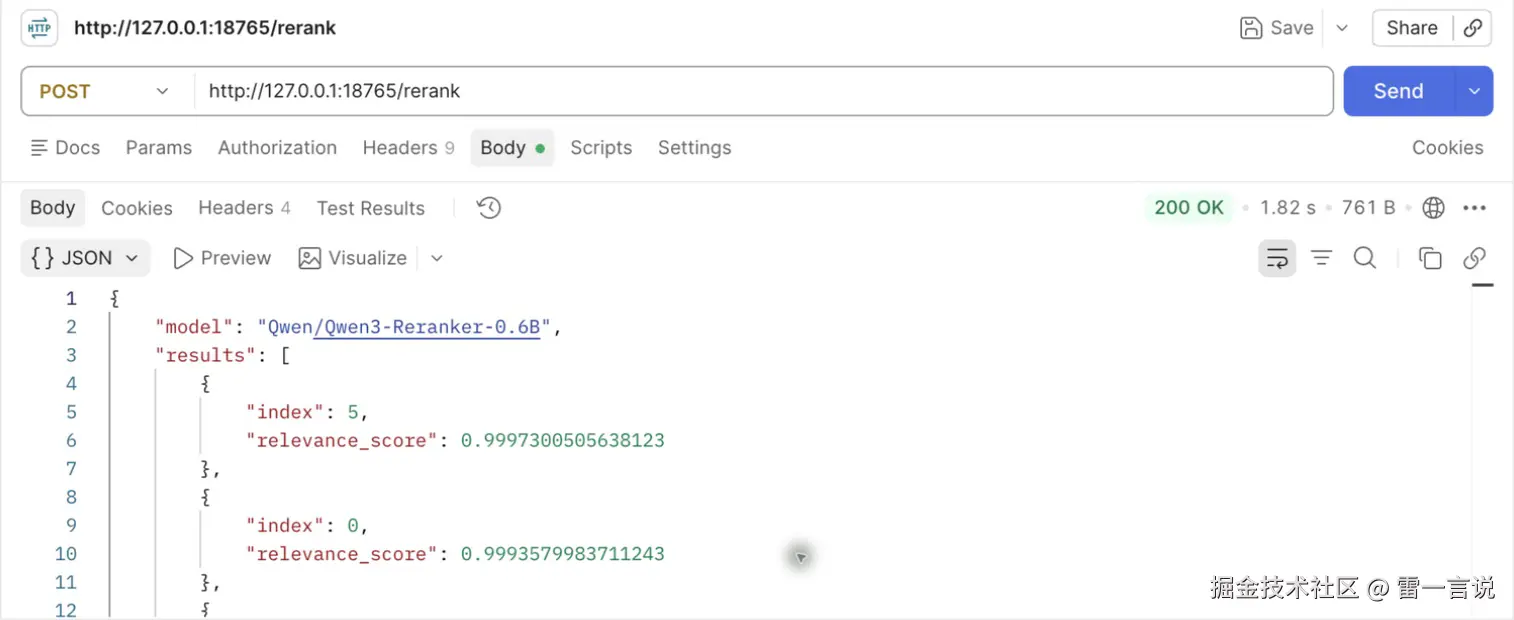
这一步输出分数,后面的 Chat Model 负责生成答案。
在 Spring AI 中接哪一层
Spring AI 提供了 DocumentPostProcessor 接口,在检索和合并之后、组装上下文之前对资料进行处理。
java
List<Document> process(Query query, List<Document> documents);运行环境为 Spring AI 2.0.1、Spring Boot 4.0.8、Java 21。这个接口从 1.0.0 开始就已经提供。
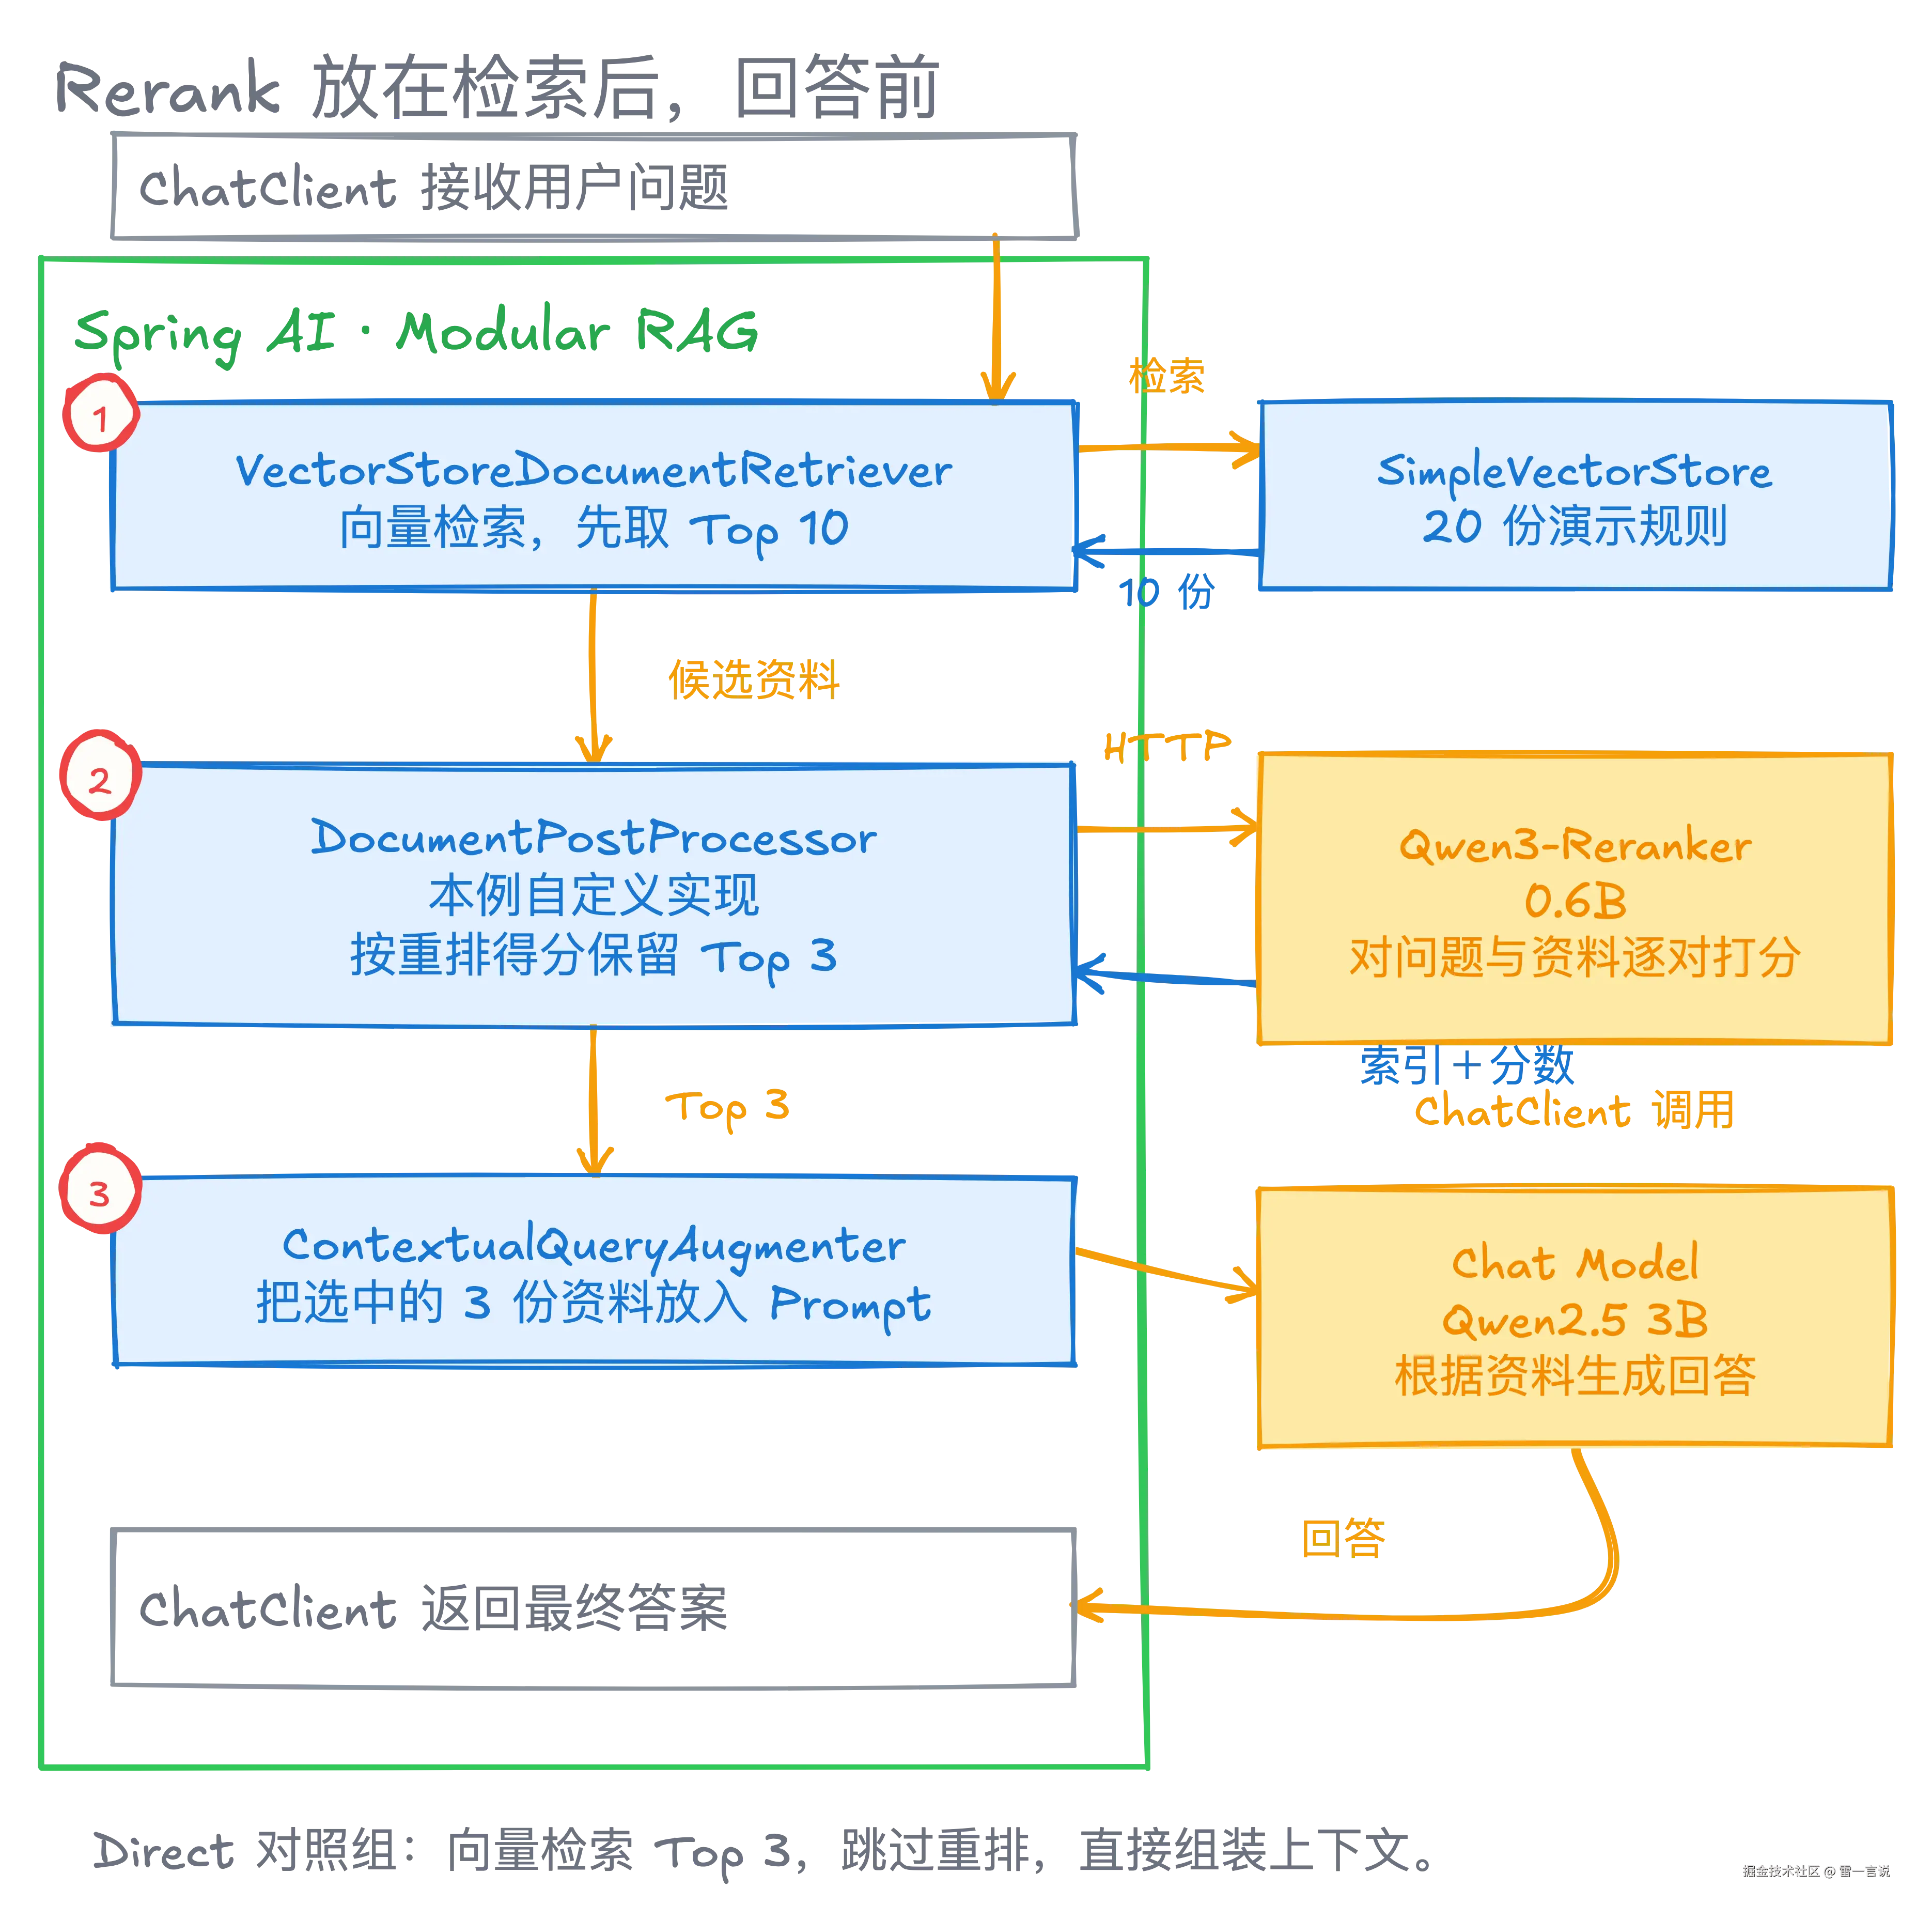
自定义 RerankDocumentPostProcessor 实现该接口。process() 核心如下,省略空列表及返回值校验:
java
// 1. 把问题和候选全文交给重排模型
var scores = client.rerank(query.text(),
        documents.stream().map(Document::getText).toList());

// 2. 按重排分数从高到低排列
var ranked = new ArrayList<>(scores);
ranked.sort(Comparator.comparingDouble(
        RerankClient.RankedIndex::relevance_score).reversed());

// 3. 按索引取回原文档,保留前 topN 份
return ranked.stream().limit(topN).map(item -> {
    Document original = documents.get(item.index());
    var metadata = new HashMap<>(original.getMetadata());
    metadata.put("rerank_score", item.relevance_score());
    return original.mutate().metadata(metadata).build();
}).toList();
重排分数存入 rerank_score,保留原文档信息。它不代表回答准确率,也不能与向量得分混排。
通过 documentPostProcessors(...) 接入 Advisor,下面省略模型、向量库和提示词组件的初始化:
java
var retriever = VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore)
        .similarityThreshold(0.0)
        .topK(10) // 先召回 10 份候选
        .build();

var reranker = new RerankDocumentPostProcessor(
        new HttpRerankClient(
                URI.create("http://127.0.0.1:18765/rerank")),
        3); // 重排后保留 3 份

var advisor = RetrievalAugmentationAdvisor.builder()
        .documentRetriever(retriever)
        .documentPostProcessors(reranker)
        .queryAugmenter(queryAugmenter)
        .build();

String answer = chatClient.prompt()
        .user(question)
        .advisors(advisor)
        .call()
.content();其中,ContextualQueryAugmenter 把资料填入 {context}、问题填入 {query},组装成回答模型的 Prompt。
多出这一步,得到的是什么
"退款失败"这题,总耗时从 4.71 秒增加到 6.63 秒 ,其中重排 HTTP 请求约 1.78 秒。
两组各调用一次 Chat Model,重排组多一次 Rerank 请求。耗时均为本机单次值。
要不要加,可以根据答错的记录来决定:
- 正确资料已经搜到,但是排名靠后:可以尝试重排。
- 候选中没有正确资料:先检查知识库、切分和检索。