成为全栈·React 管理后台篇·列表页范式:让分页、筛选和返回位置进入 URL
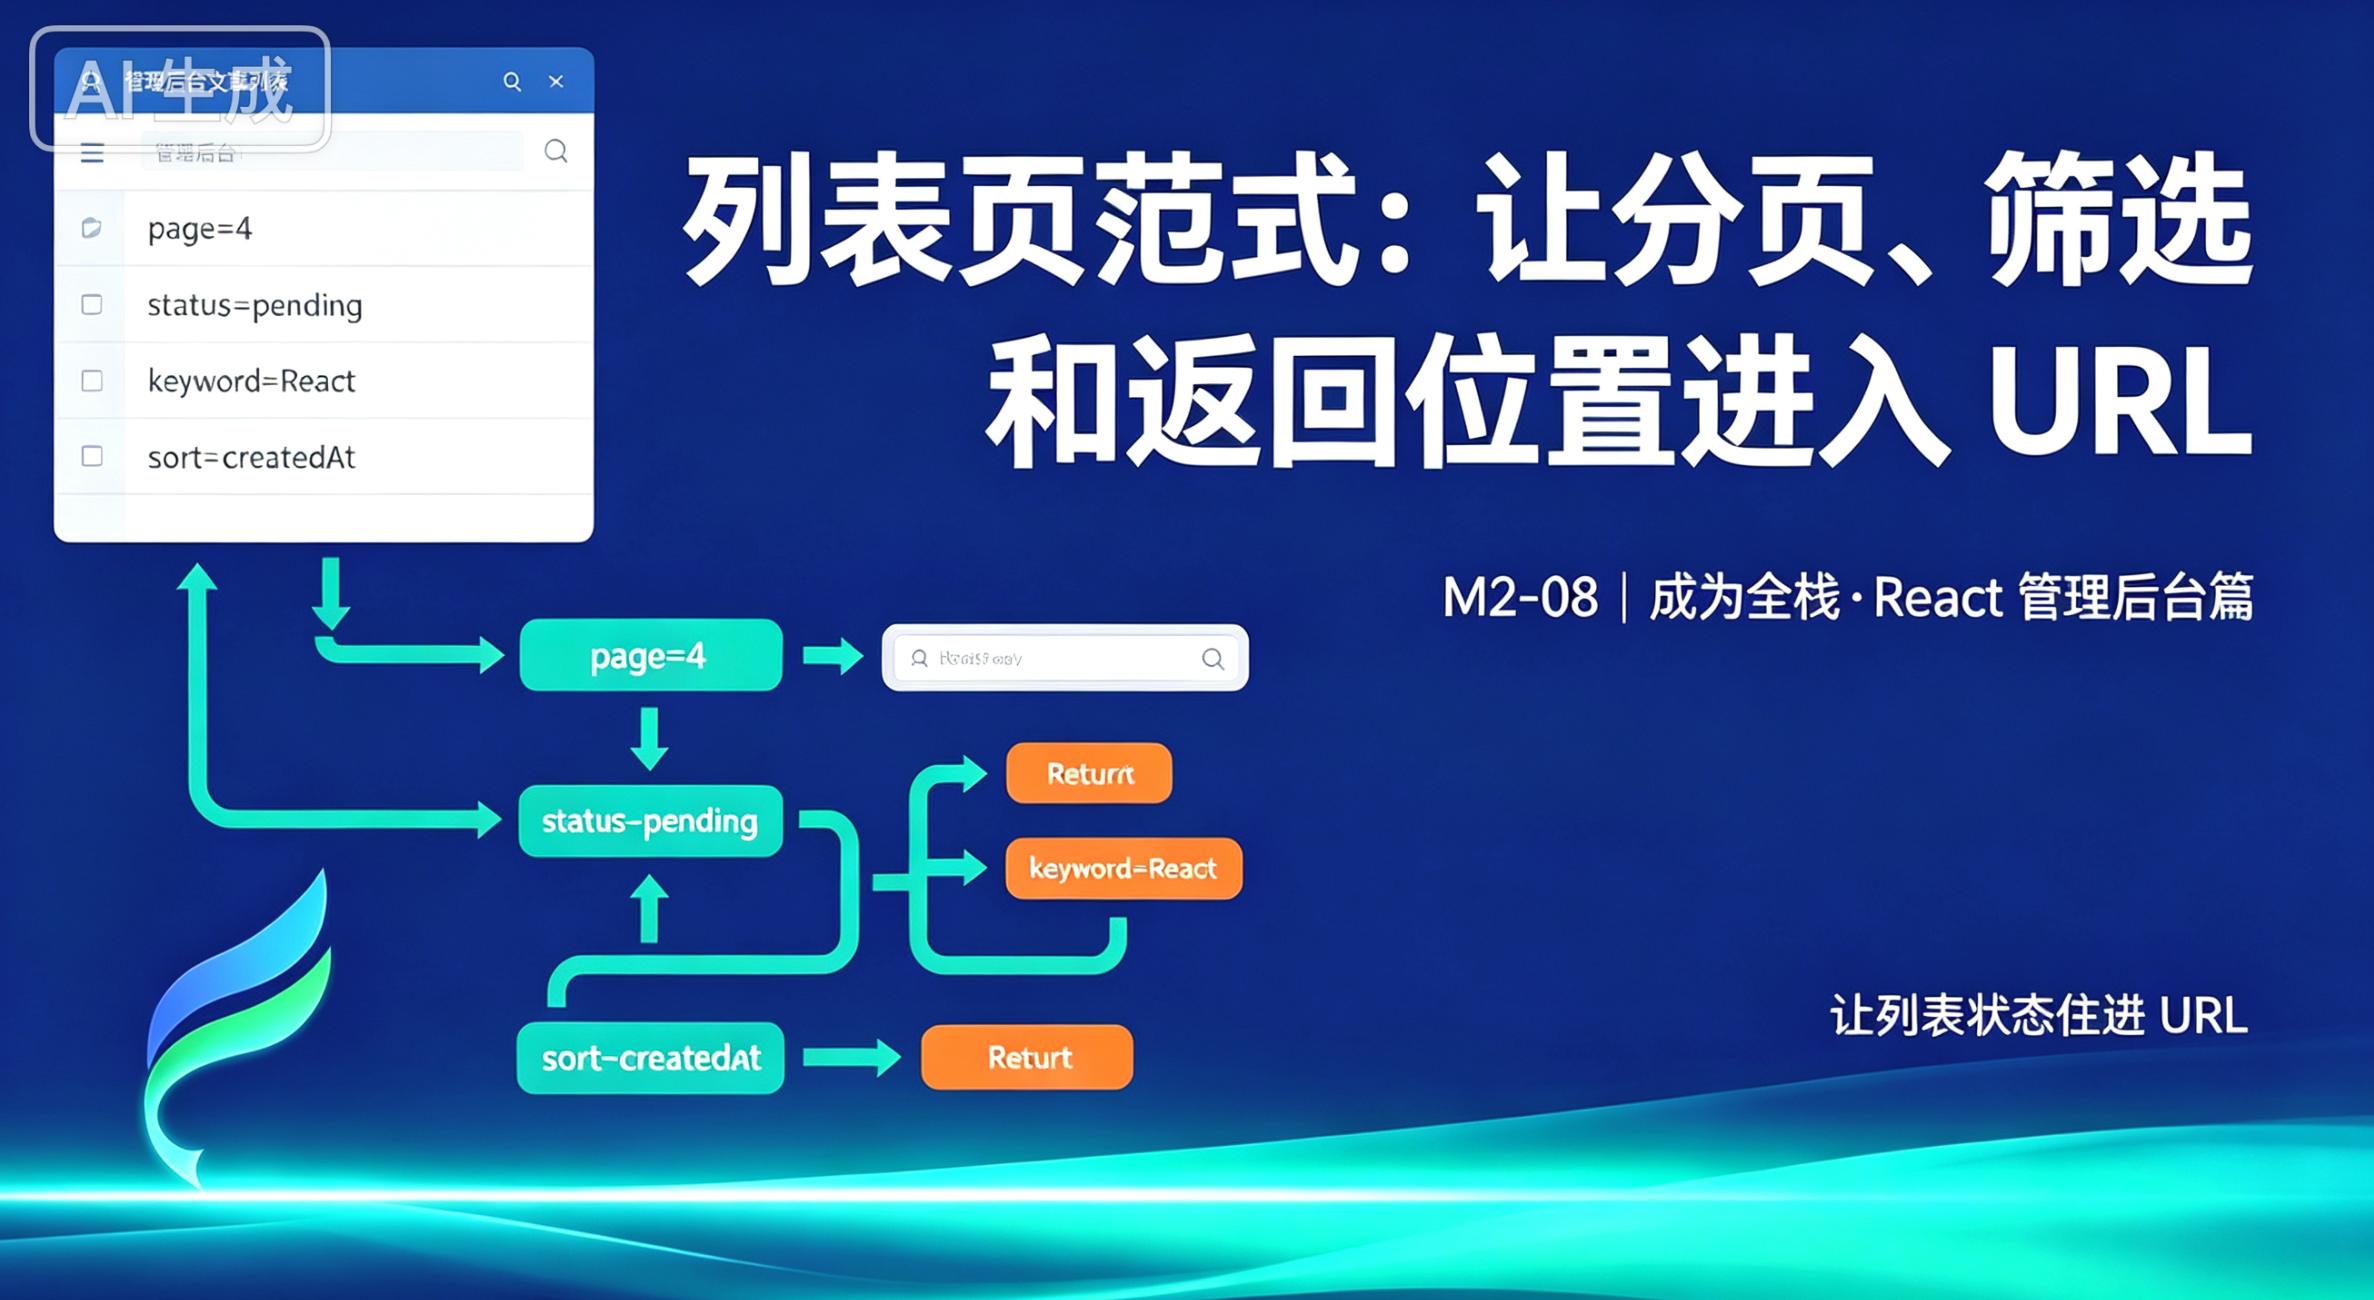
页码、筛选和排序不是表格组件的临时状态,而是"用户正在查看哪一组数据"的完整描述。只要这个描述值得刷新、返回或分享,就应该进入 URL。
前言
管理后台的列表页看起来都差不多:搜索框、几个筛选项、一张表格和分页器。真正容易出问题的,却不是表格怎么画,而是用户离开再回来以后还能不能回到原处。
我在这个项目里遇到过很典型的场景:编辑第 4 页的一篇待审文章,保存后点返回,页面却回到"全部状态"的第 1 页。审核人员要重新选择状态、重新翻页,再凭记忆寻找刚才那篇文章。刷新浏览器以后,筛选条件同样全部消失。
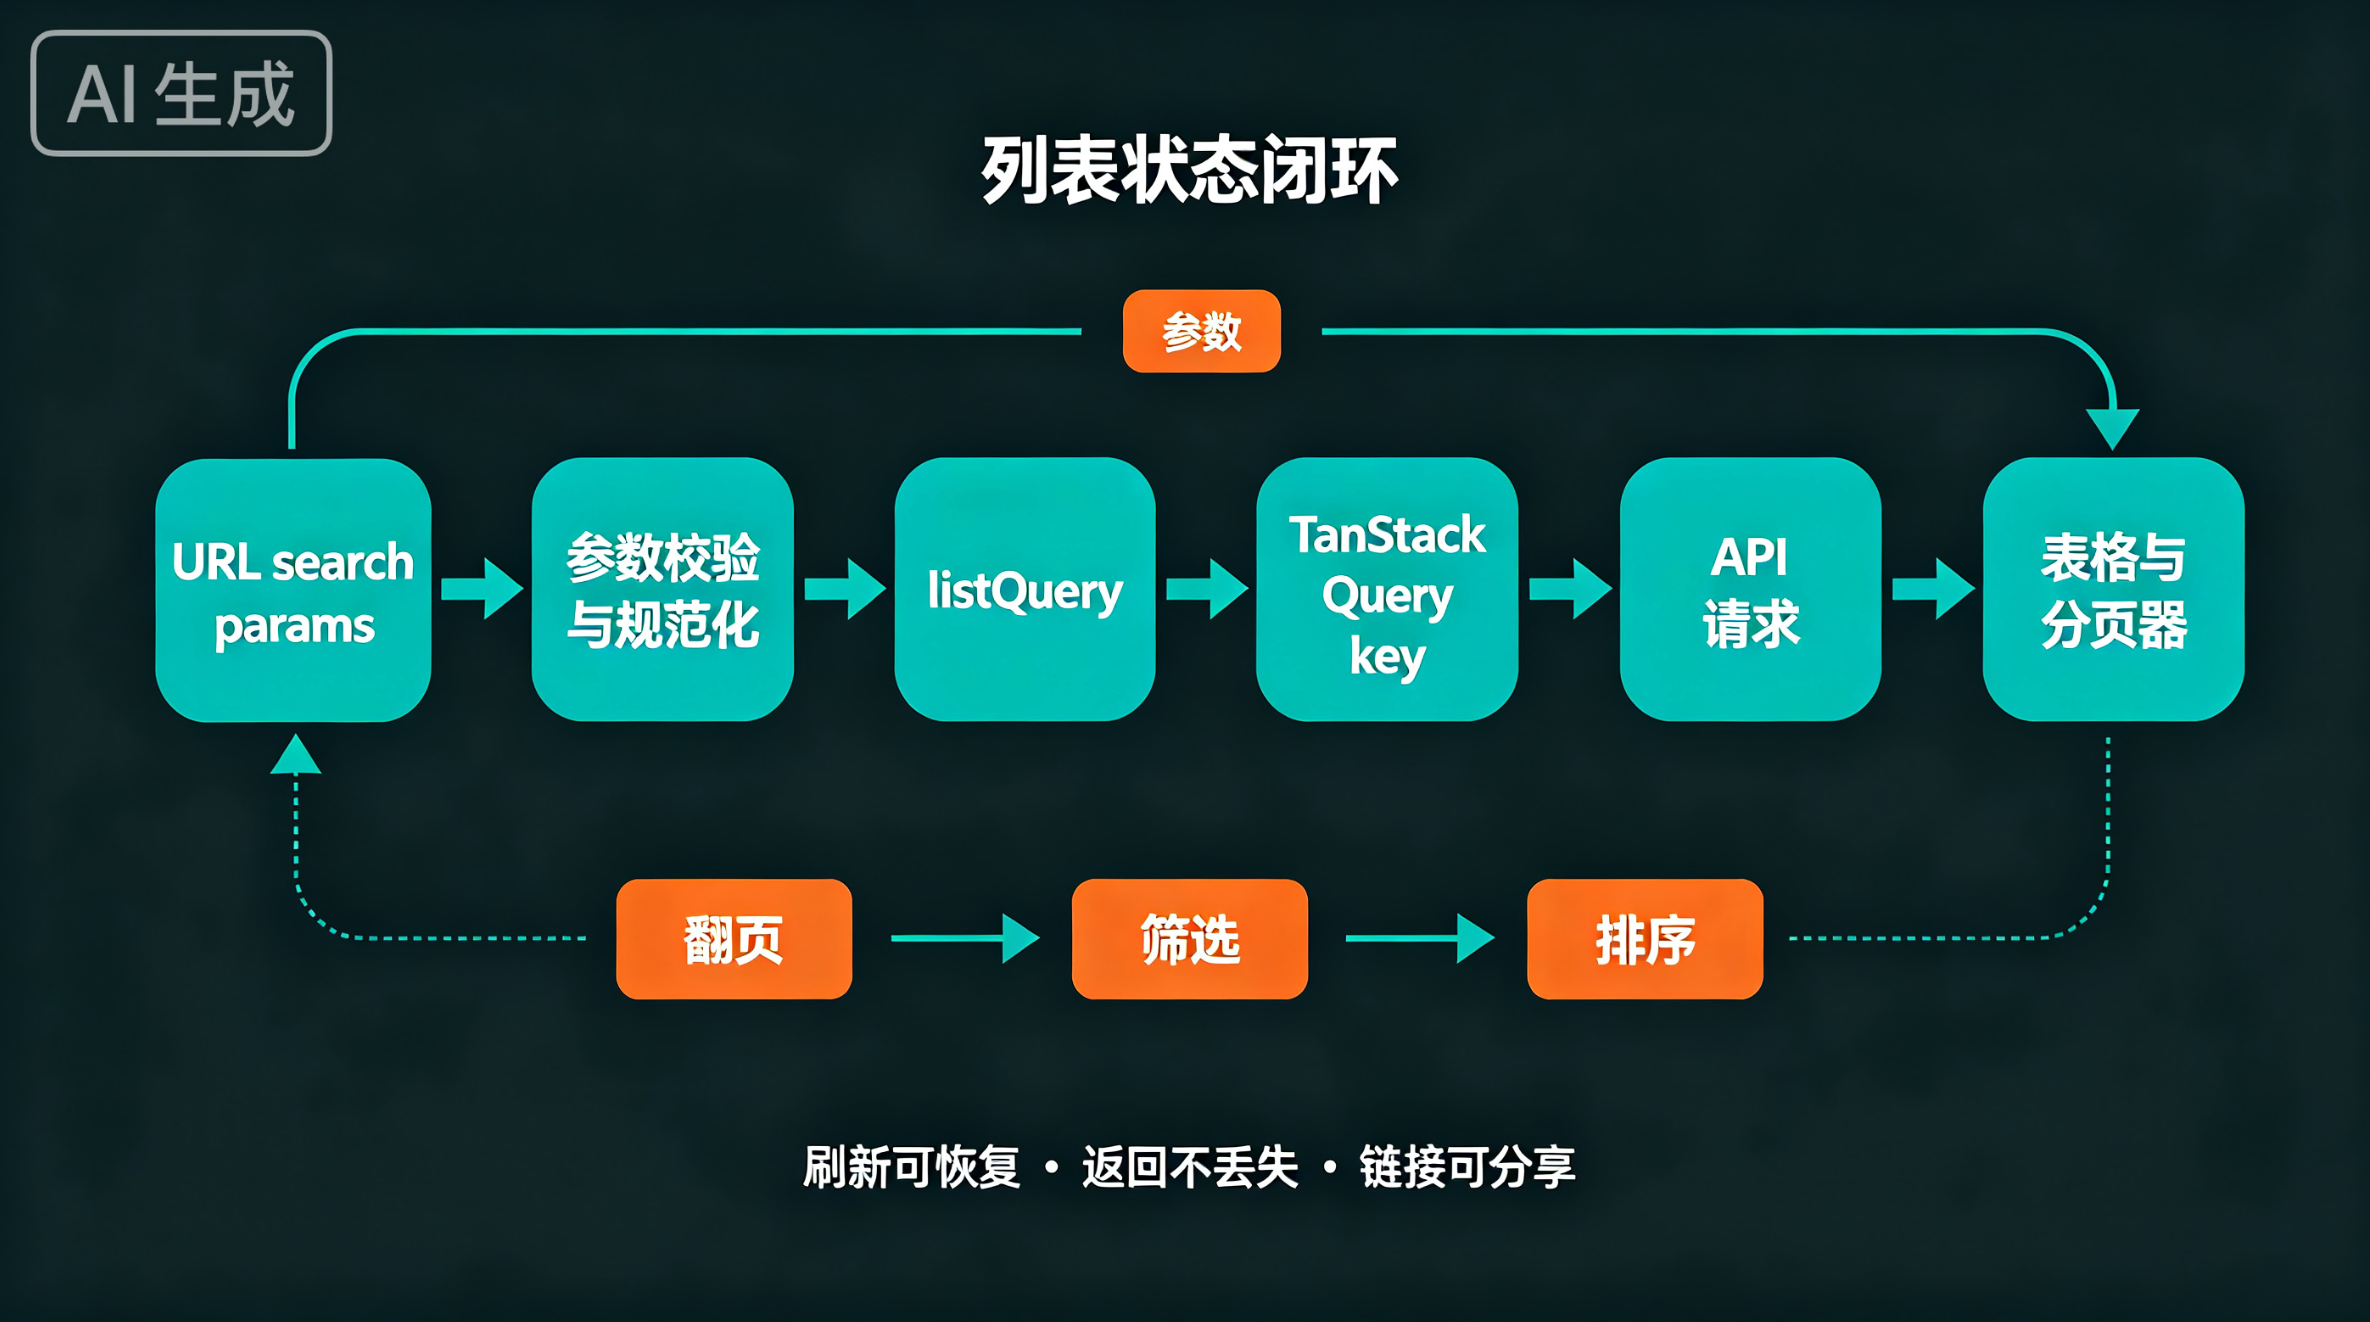
把这些状态塞进组件的 useState,单次渲染没有问题,却丢掉了浏览器原本就具备的导航能力。本项目最后让 URL 成为列表查询状态的载体,再由 Query key 和接口请求共同消费它。
本文要解决什么
- 为什么分页、筛选和排序应该写进 search params。
- 怎样读取非法参数并回落到安全默认值。
- 搜索防抖为什么可能在恢复页面时误把页码重置为 1。
- 编辑页怎样保存完整返回位置。
- 总页数缩小时,当前页如何夹正。
前置阅读:列表接口三件套:分页、筛选、排序、TanStack Query 不只是缓存:失效、派生与失败恢复
列表 URL 是一份可执行的视图描述
下面这个地址已经完整说明了用户在看什么:
text
/articles?page=4&pageSize=20&status=pending&sort=-createdAt&keyword=React它可以被刷新、收藏、复制,也会进入浏览器历史。只用 useState 保存同样的数据,则只有当前组件知道;组件卸载以后,上下文随之消失。
这并不意味着列表的一切都要进入 URL。删除确认框是否打开、当前鼠标悬停在哪一行、批量操作是否正在执行,都属于短暂交互。URL 保存的是会改变"数据集合身份"的条件。
| 状态 | 是否进入 URL | 原因 |
|---|---|---|
| page、pageSize | 是 | 决定查询区间 |
| status、category、keyword | 是 | 决定数据集合 |
| sort | 是 | 决定结果顺序 |
| 删除确认框 | 否 | 无法分享,也不应刷新恢复 |
| 请求 loading | 否 | 是一次请求过程,不是用户选择 |
| 当前页勾选项 | 通常否 | 依赖当前返回数据,跨页面恢复容易误操作 |
用一个 hook 收住解析和写入规则
若每个列表页都直接调用 useSearchParams,很快会出现不同规则:一个页面允许 page=0,另一个把空筛选写成 status=,还有一个换 pageSize 后忘了回第 1 页。
项目把这些规则集中在 useTableQuery:
ts
const rawPage = Number(params.get('page'))
const page = Number.isSafeInteger(rawPage) && rawPage > 0 ? rawPage : 1

const rawSize = Number(params.get('pageSize'))
const pageSize = [10, 20, 50].includes(rawSize)
  ? rawSize
  : defaultSize

const sort = params.get('sort') ?? undefined
URL 是外部输入,用户可以手改,也可能从旧链接进入,所以不能直接相信。非法页码回到 1,不支持的 pageSize 回到默认值;未知筛选仍可以保留在 query 中,由具体页面决定是否消费。
写入时采用合并策略,undefined 和空字符串表示删除参数:
ts
const patch = useCallback((next: Record<string, QueryValue>) => {
  writer.current((prev) => {
    const params = new URLSearchParams(prev)
    for (const [key, value] of Object.entries(next)) {
      if (value === undefined || value === '') params.delete(key)
      else params.set(key, String(value))
    }
    return params
  }, { replace: true })
}, [])
这里使用 replace: true,避免用户输入五个字符就制造五条浏览器历史。翻页究竟用 replace 还是 push 可以按产品习惯调整;当前后台更看重"返回上一业务页面",而不是逐页倒退。
改筛选时必须回到第一页
用户正在第 8 页,随后把状态改成"待审核"。新集合也许只有两页。如果继续请求第 8 页,页面会先显示空态,用户很容易误以为没有待审文章。
所以筛选、排序和 pageSize 变化都同时重置 page:
ts
const setPageSize = (size: number) =>
  patch({ pageSize: size, page: 1 })

const setSort = (sort?: string) =>
  patch({ sort, page: 1 })

const setFilters = (filters: Record<string, QueryValue>) =>
  patch({ ...filters, page: 1 })
清空筛选则保留 pageSize。每页条数更接近用户偏好,没有必要随着筛选一起丢掉:
ts
const next = new URLSearchParams()
if (prev.has('pageSize')) {
  next.set('pageSize', prev.get('pageSize') ?? '')
}
这些细节放进共享 hook 后,文章、评论、用户列表就不会各自发明一套分页行为。
防抖搜索有一个隐蔽的恢复陷阱
关键词搜索通常要防抖,否则每次键盘输入都发请求。最初的实现只有一个本地 value,300 毫秒后调用 setFilters。但页面从 URL 恢复时也会设置 value,effect 误以为这是用户新输入,再次提交筛选并把 page 重置为 1。
最终实现同时观察 URL keyword 与输入值:
ts
export const useKeywordFilter = (
  keyword: string,
  onChange: (filters: { keyword?: string }) => void,
) => {
  const [value, setValue] = useState(keyword)

  useEffect(() => {
    setValue(keyword)
  }, [keyword])

  useEffect(() => {
    if (value.trim() === keyword) return
    const timer = setTimeout(
      () => onChange({ keyword: value.trim() || undefined }),
      300,
    )
    return () => clearTimeout(timer)
  }, [value, keyword, onChange])

  return [value, setValue] as const
}
value.trim() === keyword 这一行区分了"URL 恢复"与"用户修改"。前者只同步输入框,不重新提交;后者才在防抖后更新 URL,并按照筛选规则回到第 1 页。
这个问题很难靠静态页面发现。必须从带 page 和 keyword 的地址直接进入,或者从编辑页返回,才能看到页码是否被悄悄重置。
返回位置不能只保存 pathname
进入编辑页时,列表把当前路径和查询串一起放进路由 state:
ts
const from = location.pathname + location.search

navigate(`/articles/${id}/edit`, {
  state: { from },
})
编辑页只接受符合预期的返回地址:
ts
const from = (location.state as { from?: string } | null)?.from
const returnTo = from?.startsWith('/articles?')
  ? from
  : '/articles'
保存成功或用户点返回时,重新导航到完整 URL,页码与筛选自然恢复。这里的校验不是安全边界,但能避免任意 state 把后台带到意外位置。
如果用户直接打开编辑页,没有 from,就回文章列表默认状态。这是合理降级;我们无法恢复一个从未进入过的列表上下文。
删除最后一条数据后,要夹正当前页
第 4 页只有一条记录,删除后总页数变成 3。URL 仍写着 page=4,接口可能返回空列表。分页器在收到真实 totalPages 后把页码夹回有效范围:
ts
useEffect(() => {
  const lastPage = Math.max(totalPages, 1)
  if (page > lastPage) onPageChange(lastPage)
}, [page, totalPages, onPageChange])
为什么不在解析 URL 时完成?因为 URL 解析阶段还不知道服务器会返回多少页。页码是否合法分成两层:小于 1、非整数属于语法非法,可以立即修正;超过 totalPages 属于数据非法,必须等查询结果。
当 total 为 0 时,界面仍显示第 1 / 1 页,避免出现"第 1 / 0 页"这种机械但难懂的结果。
Query key 必须消费规范化后的参数
页面最终显式组装接口 query:
ts
const listQuery = {
  page,
  pageSize,
  sort,
  status,
  category,
  tag,
  keyword: keyword || undefined,
}

const list = useAdminArticles(listQuery)
同一个对象同时进入 query key 和请求函数,于是 URL、缓存身份与服务端查询保持一致。若请求使用原始 params,query key 却使用规范化结果,缓存和实际请求就可能错位。
批量选择必须受当前查询范围约束
勾选状态虽然不进入 URL,却必须知道自己属于哪个 URL 查询范围。否则用户在"待审核第 2 页"选中三篇文章,再切到"已发布第 1 页",旧 id 仍留在 selection 中;点击批量删除时,界面上看不见的记录也可能被操作。
文章列表把规范化查询序列化成选择范围:
ts
const listQuery = { page, pageSize, sort, status, category, tag, keyword }
const batch = useBatchSelection(JSON.stringify(listQuery))
hook 将 scope 和 ids 一起保存。查询范围变化时,当前渲染立即返回空选择,并在 effect 中清理旧 id 与失败信息:
ts
const selected = selection.scope === scope ? selection.ids : []

useEffect(() => {
  if (scope !== selection.scope) {
    setFailures([])
    setSelection({ scope, ids: [] })
  }
}, [scope, selection.scope])
表格的"全选"也只遍历当前页 pageKeys,不会暗中选中缓存里的其他页。跨页全选当然可以实现,但需要服务端提供明确的查询批量操作语义,并在界面上告诉用户"选中当前筛选下的全部 N 条"。用前端 id 数组假装跨页全选,既不完整,也容易误操作。
适用边界
URL 很适合离散、可序列化的查询条件,却不适合大型草稿、敏感信息和短暂 UI 动画。高级筛选条件非常多时,可以把它们编码为稳定 JSON 或保存为服务端视图,但仍要给 URL 一个能够恢复的视图标识。
浏览器历史策略也要按场景选择。面向消费者的商品列表,用户可能希望后退时逐步撤销筛选;高频后台操作使用 replace 往往更顺畅。这不是技术上的唯一答案。
小结
列表状态进入 URL 后,刷新、分享、返回和浏览器导航自动拥有了共同语义。共享 hook 负责校验参数、合并写入、筛选回首页和清空规则;搜索 hook 区分 URL 恢复与用户输入;分页器再根据服务端结果夹正页码。
各位看官,一个可靠列表页的标准,不只是能显示数据。请在第 4 页加上筛选和关键词,进入编辑页再返回,然后刷新浏览器。所有条件仍在,用户才算真正回到了原来的工作现场。
延伸阅读
- 列表接口三件套:分页、筛选、排序
- TanStack Query 不只是缓存:失效、派生与失败恢复
- 表单页范式:校验、数据回填与未保存保护
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer