GPT-6 Astra API 上手指南:5 档推理强度怎么选,272K 计费门槛怎么算
GPT-6 Astra 是 OpenAI 9 月 3 日发布的旗舰模型。最近掘金上聊玩法、聊跑分的文章已经不少,这篇换个角度,只讲接进去之前必须搞明白的两件事:推理强度怎么选,以及单次请求的钱到底是怎么算出来的。
Astra 的定价结构比上一代多了一层,第一次接的人很容易在账单上被吓一跳。
一、先把规格和价格放进一张表
| 项目 | 官方信息 |
|---|---|
| API 模型 ID | gpt-6-astra |
| 上下文窗口 | 1,050,000 token |
| 最大输出 | 128,000 token |
| 知识截止日期 | 2026-04-30 |
| 输入 / 输出 | 文本与图片输入,文本输出 |
| 推理强度 | low / medium / high / xhigh / max |
| 标准输入 | $10 / 百万 token |
| 标准缓存输入 | $1 / 百万 token |
| 标准缓存写入 | $12.50 / 百万 token |
| 标准输出 | $50 / 百万 token |
| Batch / Flex | 标准费率的 50% |
| Fast mode | 费率 2 倍,最高约 2 倍速度 |
记住三个数字就行:10、50、272K。输入 10 美元、输出 50 美元,以及 272K 这个会改变整单价格的输入门槛。
开放范围上,截至 9 月上旬免费版 ChatGPT 还没有 Astra;Business / Enterprise 工作区默认关闭,需要管理员手动开启;API 的 Free 层不支持调用。判断自己有没有权限,别刷新闻,直接看模型选择器里有没有、API 项目能不能调到 gpt-6-astra 这个 ID。
二、最小可运行示例
官方对复杂推理和工具调用任务推荐 Responses API。Python 版:
python
from openai import OpenAI

client = OpenAI()  # Key 走环境变量或密钥管理服务,不要硬编码

resp = client.responses.create(
    model="gpt-6-astra",
    input="读一下这份接口文档,列出三个最容易引发线上事故的字段约束,并给出校验代码。",
    reasoning={"effort": "medium"},
)
print(resp.output_text)
curl 版:
bash
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "medium"},
    "input": "把这份需求文档拆成可执行的开发任务清单。"
  }'
Responses API 里可以挂的工具包括 Web Search、File Search、Image Generation、Code Interpreter、Hosted Shell、Apply Patch、Skills、Computer Use、MCP 和 Tool Search。
这里有个常见误解要提前说清:模型支持某个工具,不等于你的账号、地区和产品界面默认开着,而且部分工具调用会单独计费。做预算时要把这部分算进去。
三、5 档推理强度,别一律拉满
low / medium / high / xhigh / max 是这次开放出来的五档。名字很直白,但实际取舍没这么简单,因为强度越高,思考过程占掉的输出 token 越多,而输出是最贵的那一项。
我的建议是按任务类型分:
- low:抽取、分类、格式转换、改写这类确定性强的活儿。要的是稳定和快,不是聪明。
- medium:默认起点。日常问答、代码补全、文档摘要,先从这里开始试。
- high:跨文件重构、复杂 bug 定位、需要连续调用多个工具的任务。
- xhigh / max:数学证明、算法设计、链条很长的 Agent 任务。官方跑分就是在最大强度下取的,相应地也最贵最慢。
一个比较省钱的做法是:先用 medium 把流程跑通,把失败的样本收集起来,只对失败的那一类任务升一档,而不是一上来全量拉满。很多人调完效果提升不明显,账单却涨了一截,基本都是这个原因。
四、三个会改变账单的倍数
1. 272K:整单加价的开关
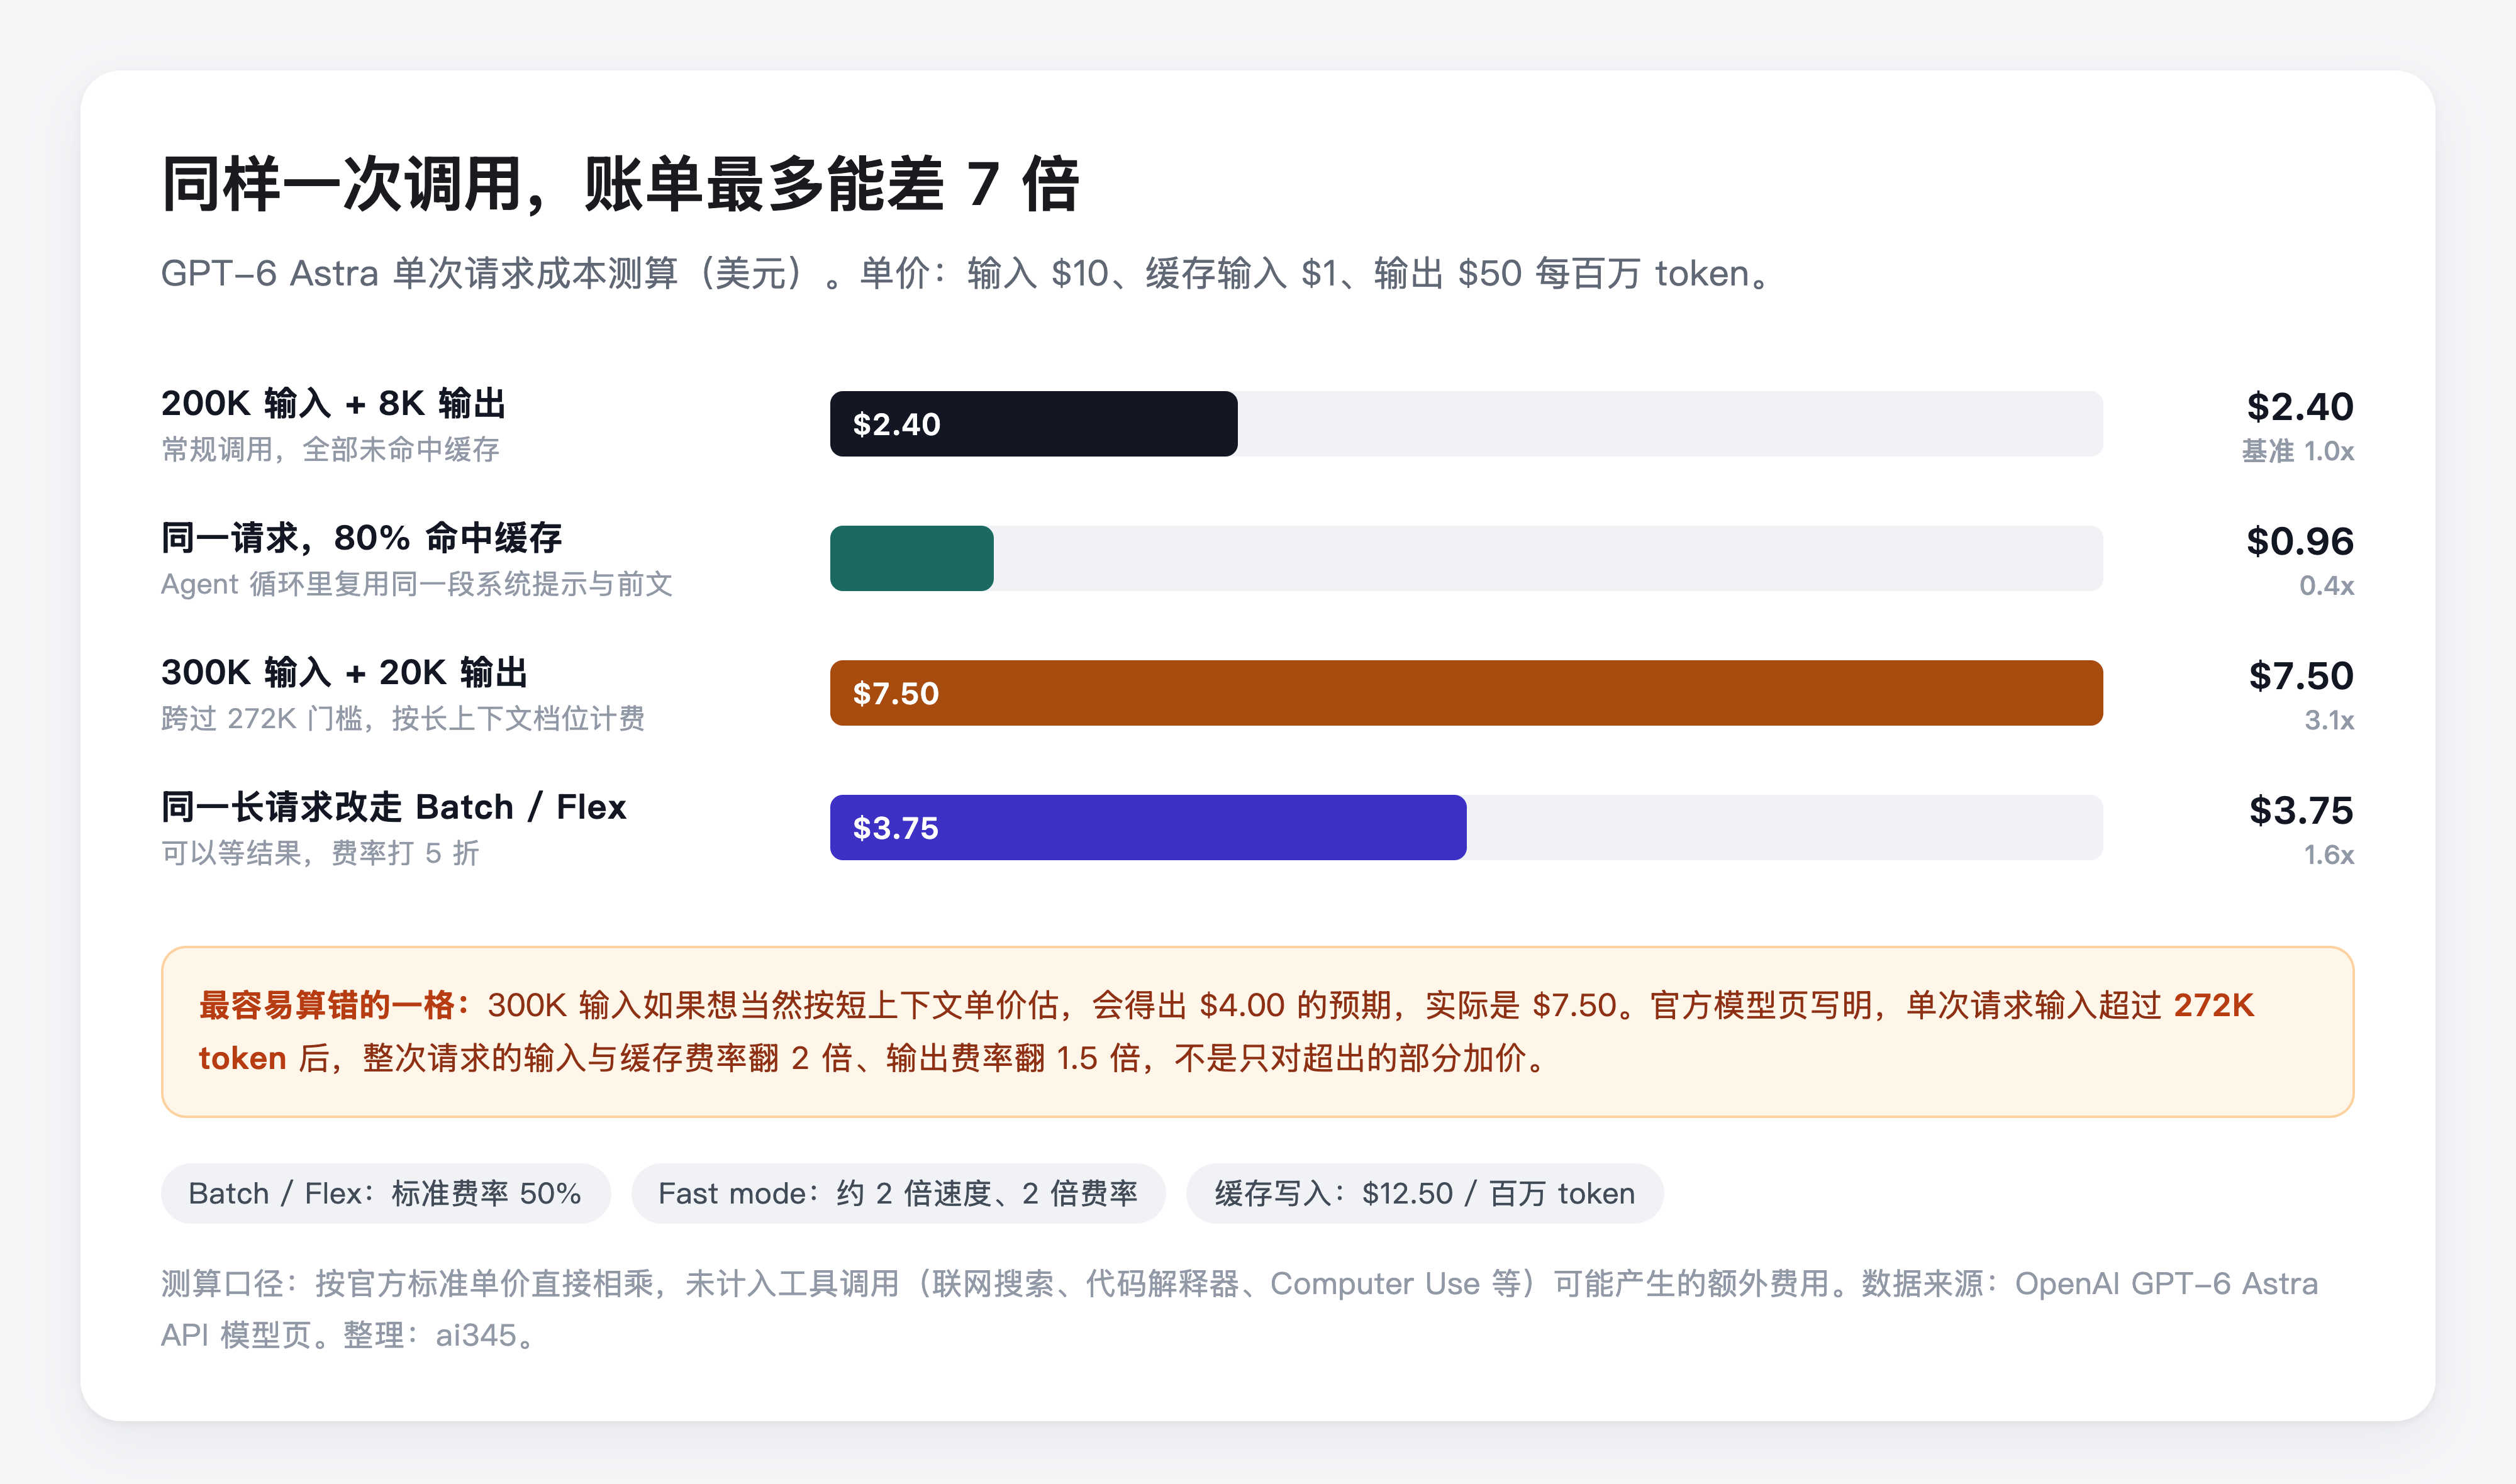
官方模型页写得很明确:单次请求输入超过 272K token 后,整次请求的输入和缓存费率按 2 倍 、输出按 1.5 倍计费。
注意,不是只对超出的那部分加价,是整单重新按倍率算。这一点特别容易踩,因为它跟你平时用其他长上下文模型的经验不一样。
2. 缓存:便宜 10 倍,但得把前缀设计好
缓存输入 1,正常输入 10,差 10 倍,这是长上下文任务里最大的一块钱。
缓存能生效的前提是请求前缀稳定,所以系统提示、工具定义、长文档这些固定内容要放在最前面,变量放到最后。反过来,如果你把时间戳、随机 ID 或者每次都不一样的内容塞进系统提示,缓存就白设计了。
另外缓存写入 $12.50 比普通输入还贵,值得先想一下这段内容到底会不会被复用第二次。
3. Batch / Flex 与 Fast mode:一个省钱,一个烧钱
能等的任务走 Batch / Flex,直接 5 折,离线跑批、批量生成报告这类场景没有理由不用。
Fast mode 是反过来的:2 倍速度对应 2 倍费率。它是用钱换时间,只在交互式场景下开,别当默认选项。
五、四种场景的单次成本
| 场景 | 输入 / 输出 | 计算过程 | 单次成本 |
|---|---|---|---|
| 常规代码评审 | 200K / 8K,无缓存 | 0.2×10 + 0.008×50 | $2.40 |
| 同一请求,80% 命中缓存 | 40K 新增 + 160K 缓存 / 8K | 0.04×10 + 0.16×1 + 0.4 | $0.96 |
| 长文档分析 | 300K / 20K,跨过 272K | 0.3×10×2 + 0.02×50×1.5 | $7.50 |
| 同上,改走 Batch / Flex | 300K / 20K | 7.50 × 50% | $3.75 |
第三行是重点。按短上下文单价估,会得出 4.00 的预期,实际是 7.50,差了将近一倍。做 Agent 预算的时候,先判断这次请求会不会跨过 272K,再决定是切分请求还是干脆换条路。
六、Codex 里为什么不容易丢上下文
官方这次同时改了 Codex 的运行框架。当任务跨过多个上下文窗口时,Astra 会把工作笔记保存下来,并且能主动搜索之前的消息和工具输出,而不是只依赖一次压缩摘要。
官方在 Mind2Web 上给出的数字是任务完成速度约为 GPT-5.6 Sol 的 1.9 倍。
1.9 倍是官方特定评测里的结果,不代表你的仓库也快 1.9 倍。依赖安装、跑测试、网络状况和项目复杂度全都算在真实耗时里。真正确定能改善的是另一件事:长任务不再换一次窗口就失忆。对动辄几小时的迁移和重构,这个变化比速度更有意义。
七、官方跑分怎么读
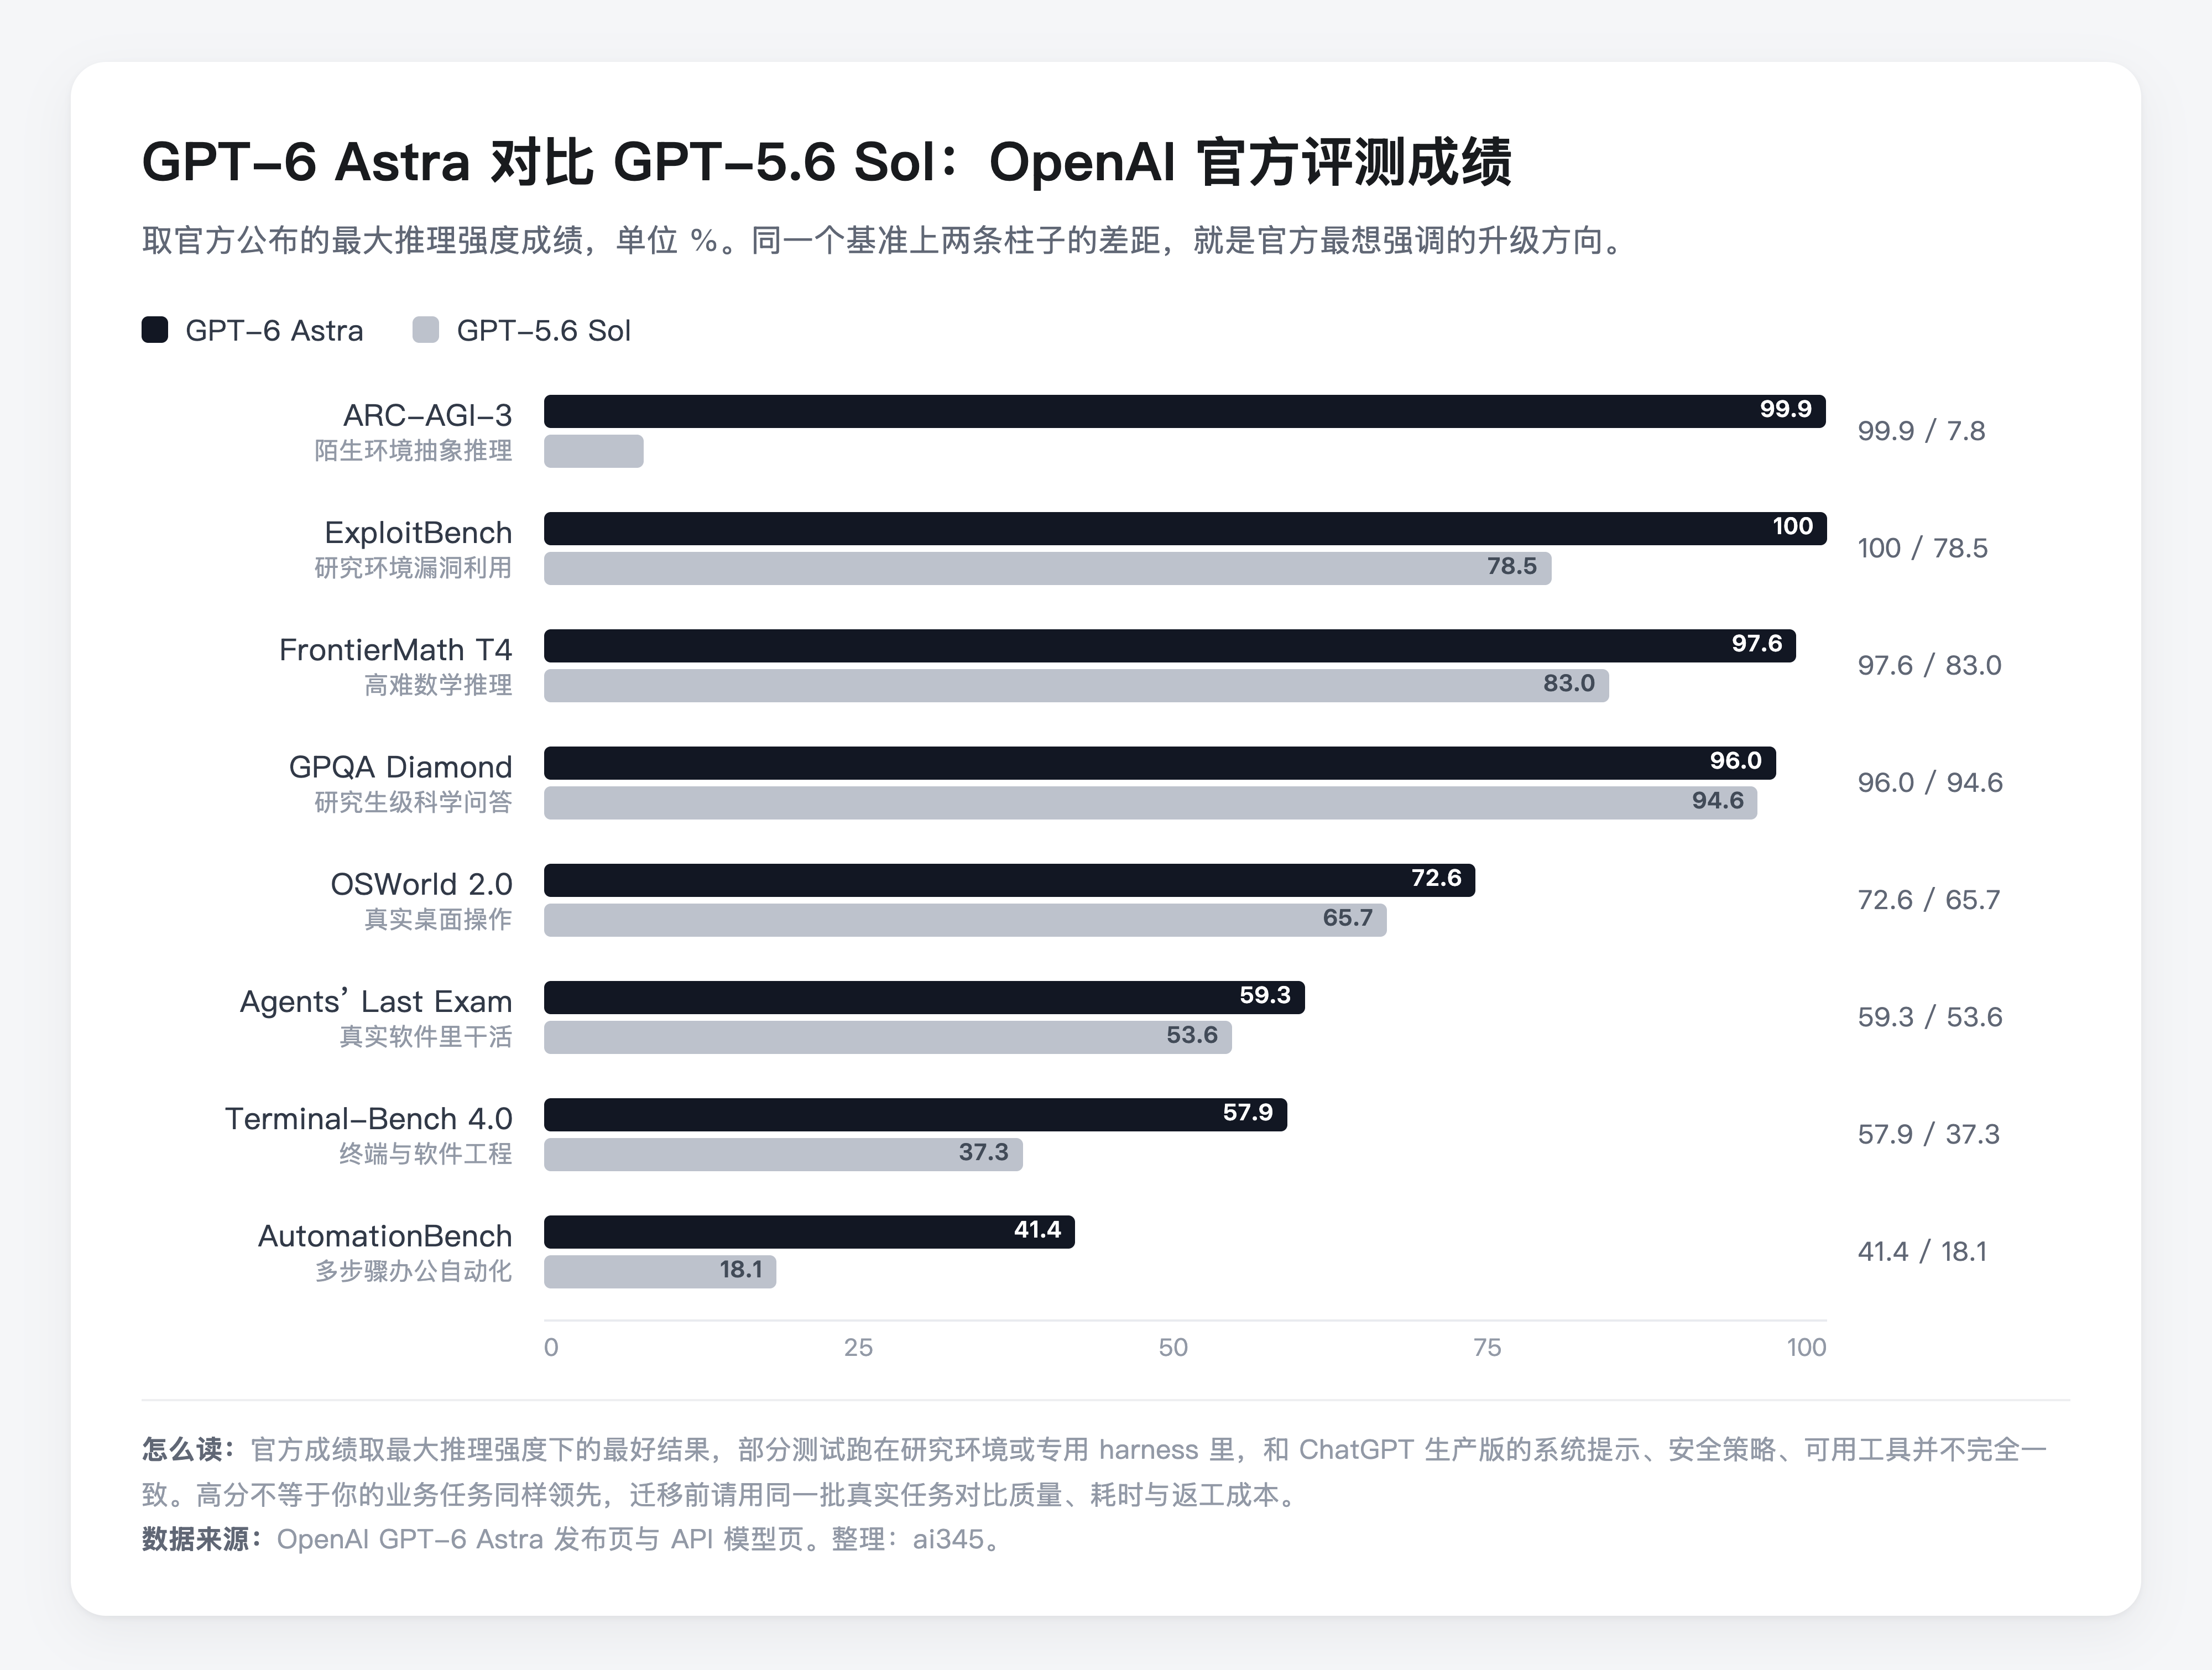
ARC-AGI-3 打出 99.9 对 7.8 这种差距确实抓眼球,但官方成绩有三个前提:取的是最大推理强度下的最好结果、部分测试跑在研究环境或专用 harness 里、ChatGPT 生产版的系统提示与安全策略跟评测并不一致。
所以这些分数用来看方向可以,用来判断你的业务能不能用是不行的。
还有一个信号值得留意:Astra 的网络安全能力已经达到 OpenAI Preparedness Framework 里的 Critical 阈值。官方版本会拒绝高风险的漏洞利用任务,某些合法的防御性测试也可能因为额外安全检查被中止。如果业务涉及安全方向,接之前先小范围探一下边界。
八、现在该不该迁
适合动手的:需要整仓长上下文分析的、Agent 要连续跑很多步工具的、要交付可继续编辑的文档和表格的。
建议再等等的:纯日常问答(差价不值)、对成本极敏感的批量任务、涉及高风险安全操作的。
迁不迁不用靠感觉,拿同一批真实任务,把质量、耗时、token 消耗、工具成功率、人工返工时间这五项一起记下来,用这张表做决定,比盯单个 benchmark 靠谱。
参考资料
- OpenAI GPT-6 Astra 发布页:https://openai.com/index/gpt-6-astra/
- 官方 API 模型页(规格与定价):https://developers.openai.com/api/docs/models/gpt-6-astra/
- 中文整理版(发布时间线、定价、Codex 接入进度、安全争议与 FAQ):https://www.ai345.info/ai-guide/gpt-astra-news
- Claude Fable 5.1 的横向整理:https://www.ai345.info/ai-guide/claude-fable-5-1-guide
- AI 工具与模型导航(按场景找工具):https://www.ai345.info/ai-nav