加速拉取与运行步骤(复制到 cmd 中执行)
第一步:通过国内镜像站拉取(免科学上网)
在 cmd 中执行以下命令(走国内 DaoCloud 的 NGC 加速通道):
docker pull nvcr.m.daocloud.io/nvidia/tensorrt-llm/release:0.20.0
或者直接(新版 llama.cpp 语法):
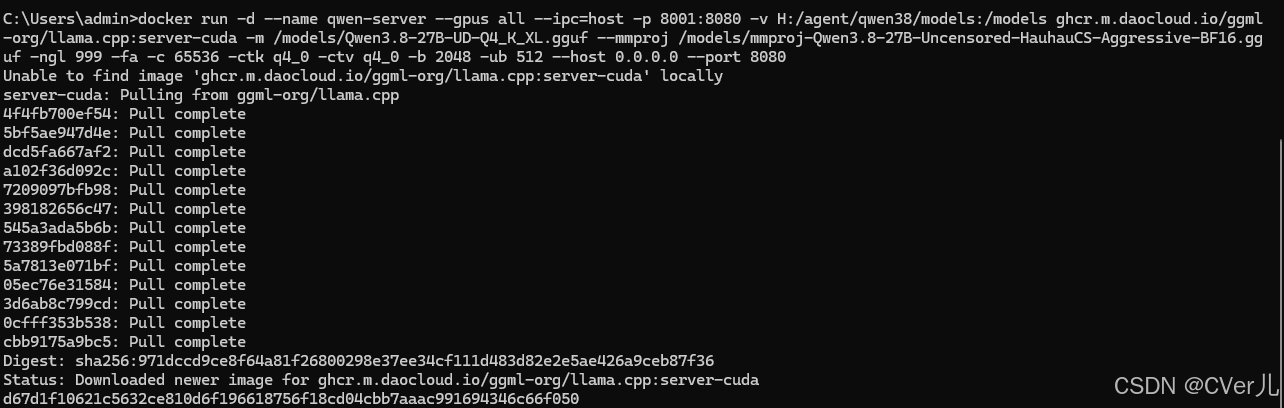
docker run -d --name qwen-server --gpus all --ipc=host -p 8001:8080 -v H:/agent/qwen38/models:/models ghcr.m.daocloud.io/ggml-org/llama.cpp:server-cuda -m /models/Qwen3.8-27B-UD-Q4_K_XL.gguf --mmproj /models/mmproj-Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-BF16.gguf -ngl 999 -fa on -c 65536 -ctk q4_0 -ctv q4_0 -b 2048 -ub 512 --host 0.0.0.0 --port 8080Docker 的机制里:docker run 如果在本地找不到镜像,会自动在后台触发 pull。
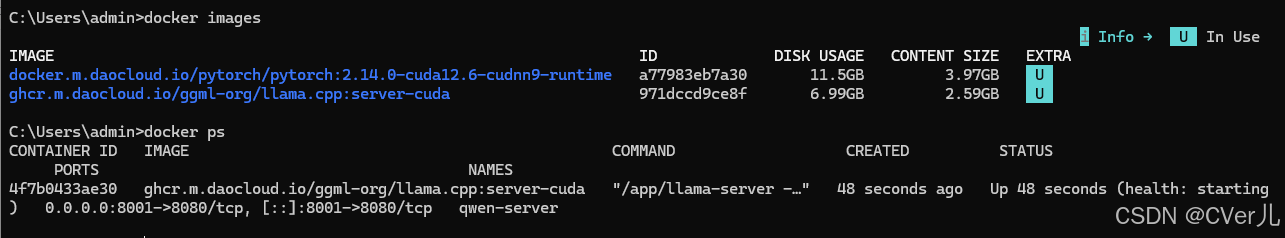
docker logs -f qwen-server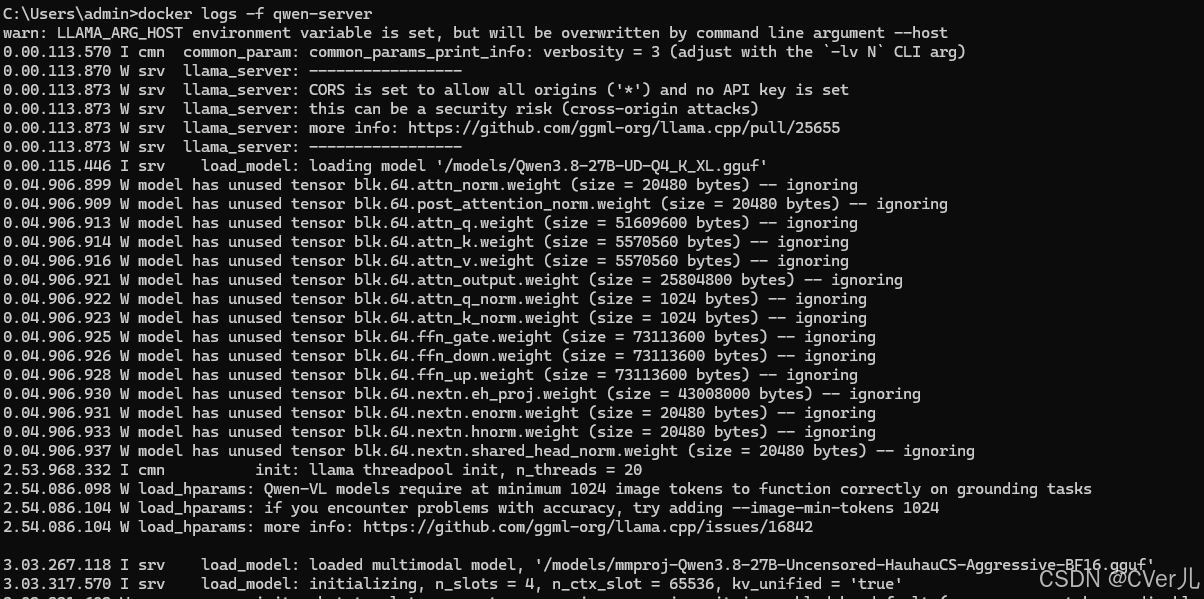
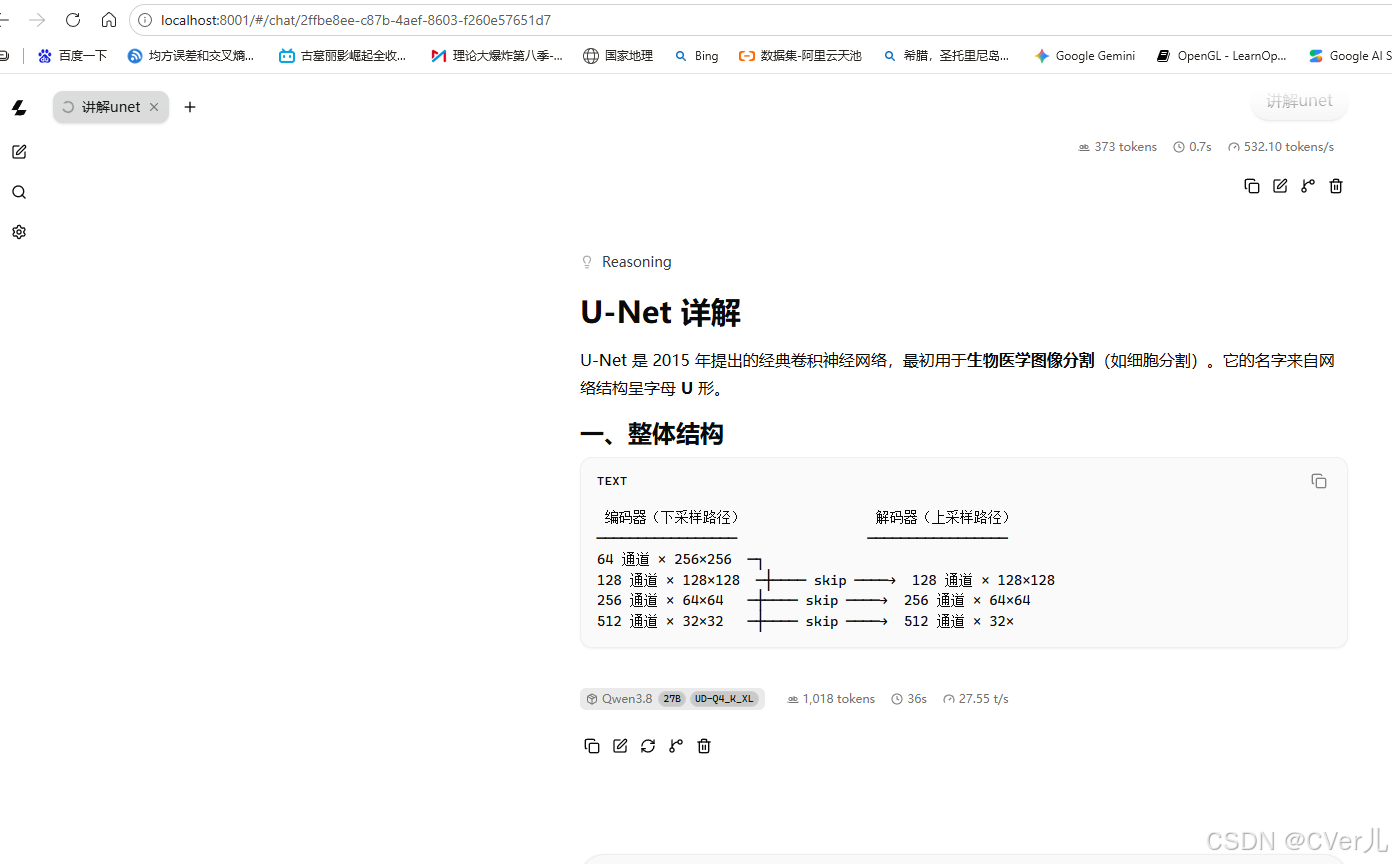
在你的 Windows 浏览器(Chrome / Edge)地址栏直接打开: 👉 http://localhost:8001
tensorrtllm:
win conda环境下载
modelscope download --model Qwen/Qwen3.8-27B --local_dir H:\agent\trt-llm\models\qwen3.8-27b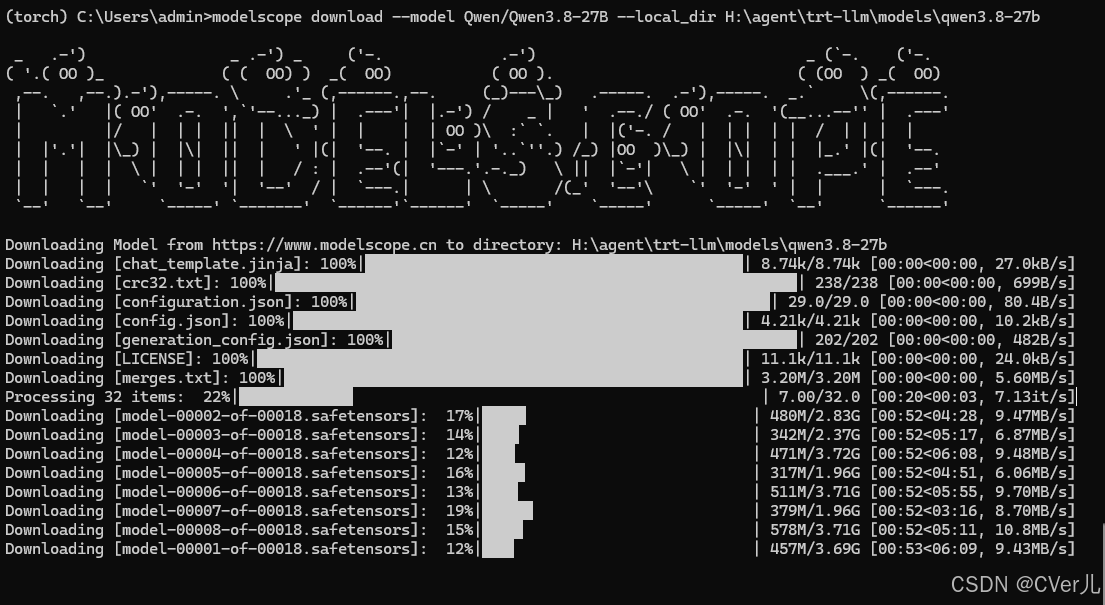
开始拉取最新镜像:
手动配置代理:
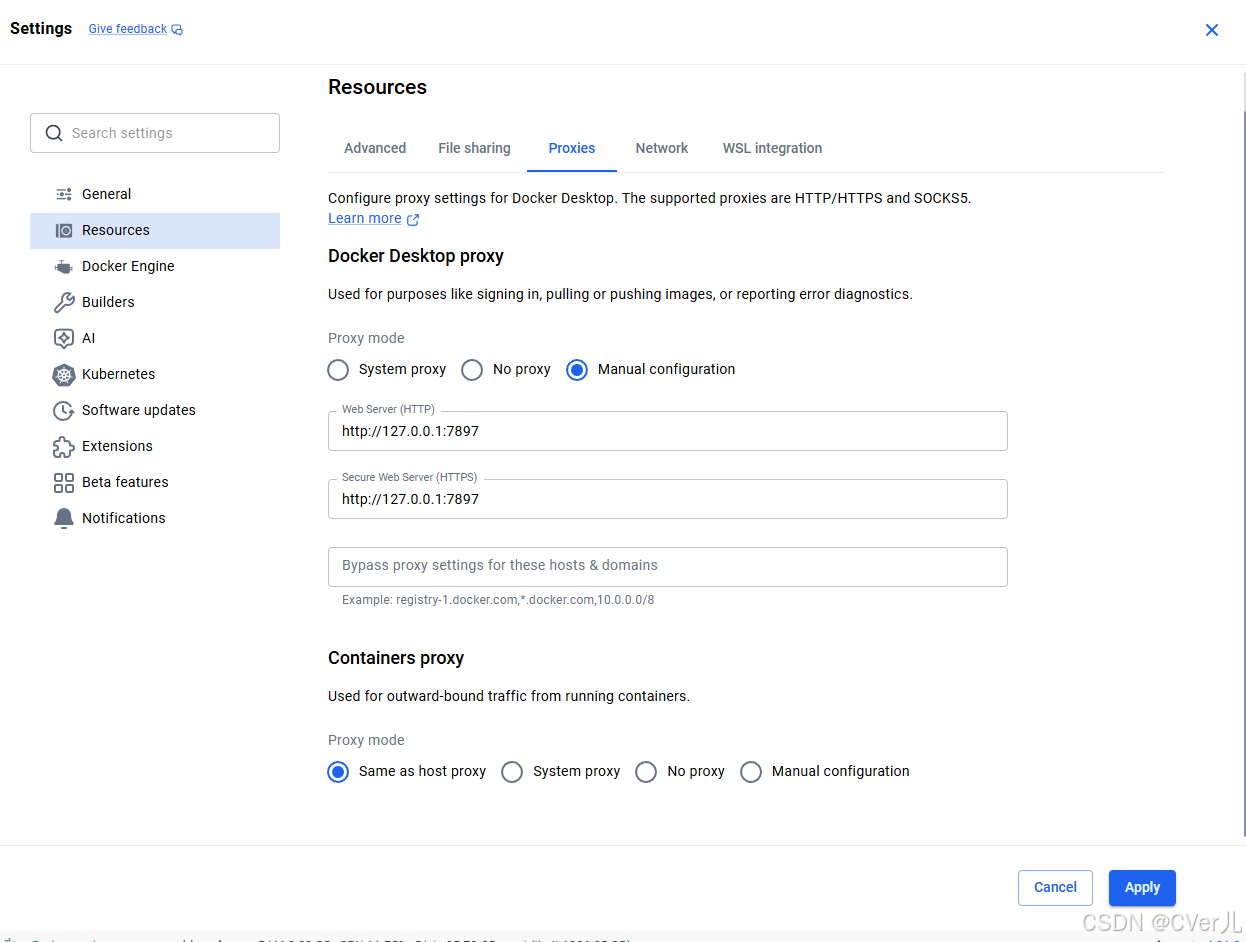
重启完成后,在 cmd 开始满速拉取!
Docker 重启大约需要 10~20 秒,看到左下角 Docker 图标变绿(Engine running)后,在你的 Windows cmd 中直接运行:
docker pull nvcr.io/nvidia/tensorrt-llm/release:1.2.0
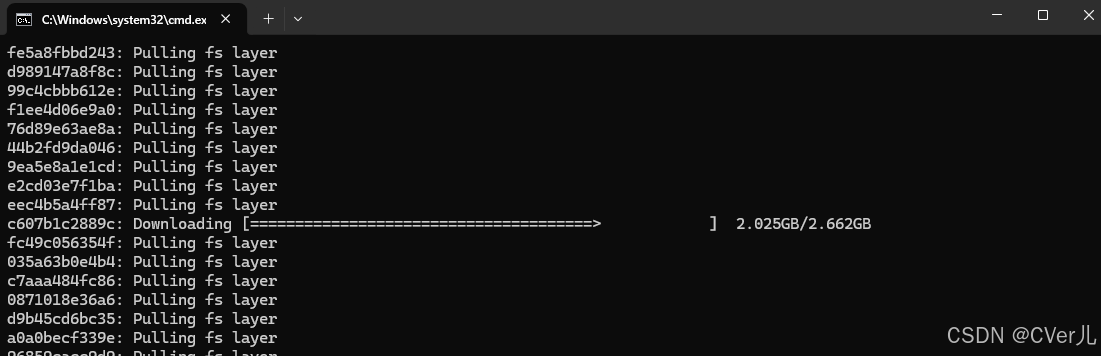
官方原版镜像 nvcr.io/nvidia/tensorrt-llm/release:1.2.0(20.9 GB)已经成功就绪!由于这是官方预构建镜像,里面已经预装了所有英伟达专属算子库、OpenMPI 和转换脚本,完全不需要再手动折腾任何依赖。
第一步:创建并进入全新的官方 TRT-LLM 容器
先清理可能残留的旧容器名称,然后直接启动进入容器:
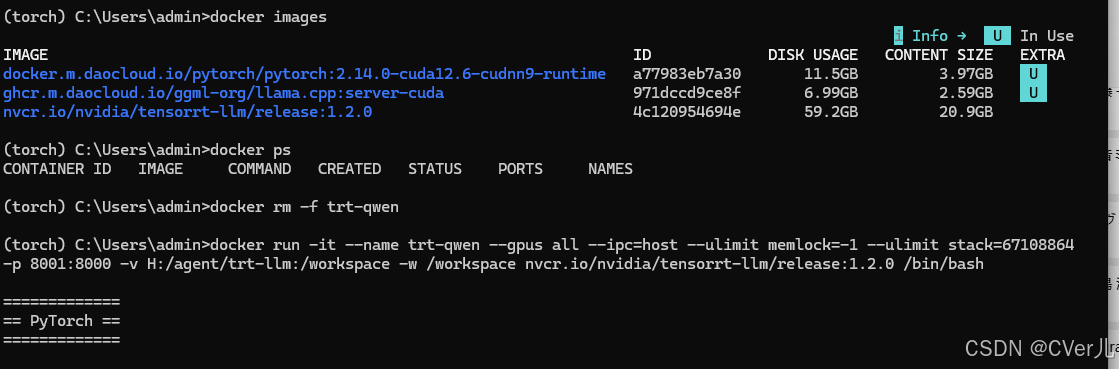
在docker内部:
在容器终端中,直接运行官方镜像内置的转换工具(将模型压缩量化到约 15GB,以便塞进RTX 3090):
pip install --upgrade transformers
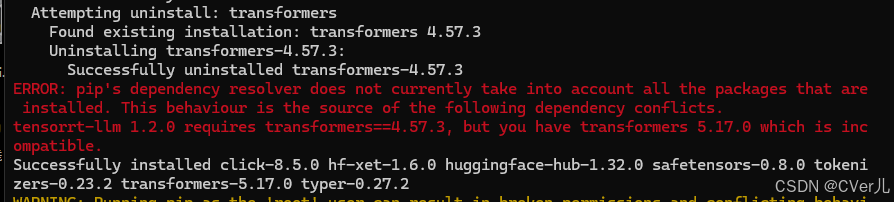
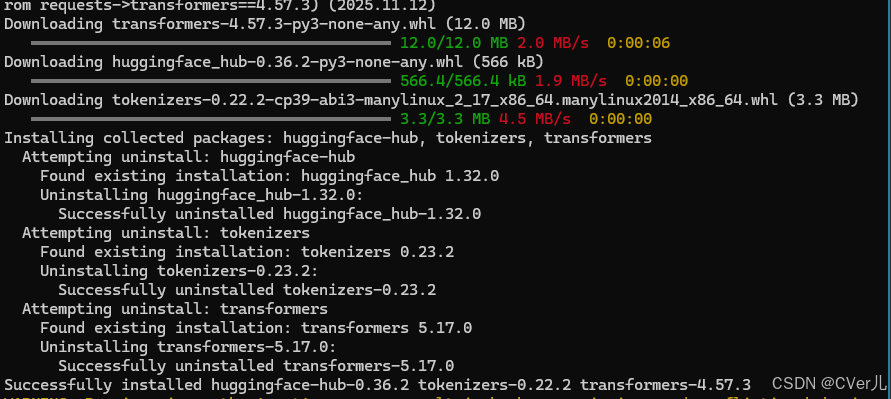
这是因为刚才的安装操作把 transformers 自动升级到了 5.x 新版本,而当前 TensorRT-LLM 1.2.0 官方锁定的适配版本是 4.57.3。
pip install transformers==4.57.3
python3 /app/tensorrt_llm/examples/models/core/qwen/convert_checkpoint.py \
    --model_dir /workspace/models/qwen3.8-27b \
    --output_dir /workspace/qwen3.8_ckpt_int4 \
    --dtype float16 \
    --use_weight_only \
    --weight_only_precision int4
转化失败了!!!
报错定位如下: ValueError: The checkpoint you are trying to load has model type qwen3_5 but Transformers does not recognize this architecture. KeyError: 'qwen3_5'
刚刚下载好的 qwen3.8-27b 模型配置文件(config.json)与权重字典(model.safetensors.index.json),发现了两个不可逾越的底层技术硬约束:
1. 架构冲突(致命原因):
- 打开权重文件可以看到,Qwen3.8-27B 并不是传统的 Transformer 架构!
- 它的内部网络是阿里最新的 Gated DeltaNet (线性注意力/线性卷积/SSM) + Gated Attention 混合架构 :
- 前 3 层是
linear_attn(权重包含conv1d.weight,A_log,dt_bias,in_proj_qkv等); - 第 4 层才是标准的
self_attn。
- 前 3 层是
- 而 TensorRT-LLM 镜像内置的
convert_checkpoint.py和trtllm-build编译器目前只为传统 Transformer 架构(Qwen1 / Qwen2 / Qwen2.5)设计 。它的 C++ 静态图内核中根本没有 DeltaNet 线性卷积的硬件融合算子,即使强行绕过名称校验,读取权重时也会因缺失算子而崩溃。
2. 显存物理限制(54GB vs 24GB):
- 你在 ModelScope 上下载的这套 Safetensors 是 BF16 原生浮点权重,体积整整 54 GB。
- 浮点权重直接加载需要至少 60 GB 显存 ,而你的 RTX 3090 只有 24 GB 显存,浮点权重无法在单卡 3090 上完成常规运行时加载。
坚持走 TensorRT-LLM 完整编译链路(换用支持的 Qwen2.5 系列)
本次的核心目标是完整体验 TensorRT-LLM 的构建、编译与极速推理 ,使用 TensorRT-LLM 1.2.0 官方原生深度支持的 Qwen2.5 系列(如 Qwen2.5-14B-Instruct 或 Qwen2.5-32B-Instruct-AWQ)。
以可以在 24G 显存上以 FP16 全速运行的 Qwen2.5-14B-Instruct 为例:
本次的核心目标是完整体验 TensorRT-LLM 的构建、编译与极速推理 ,建议使用 TensorRT-LLM 1.2.0 官方原生深度支持的 Qwen2.5 系列(如 Qwen2.5-14B-Instruct 或 Qwen2.5-32B-Instruct-AWQ)。
以可以在 24G 显存上以 FP16 全速运行的 Qwen2.5-14B-Instruct 为例:
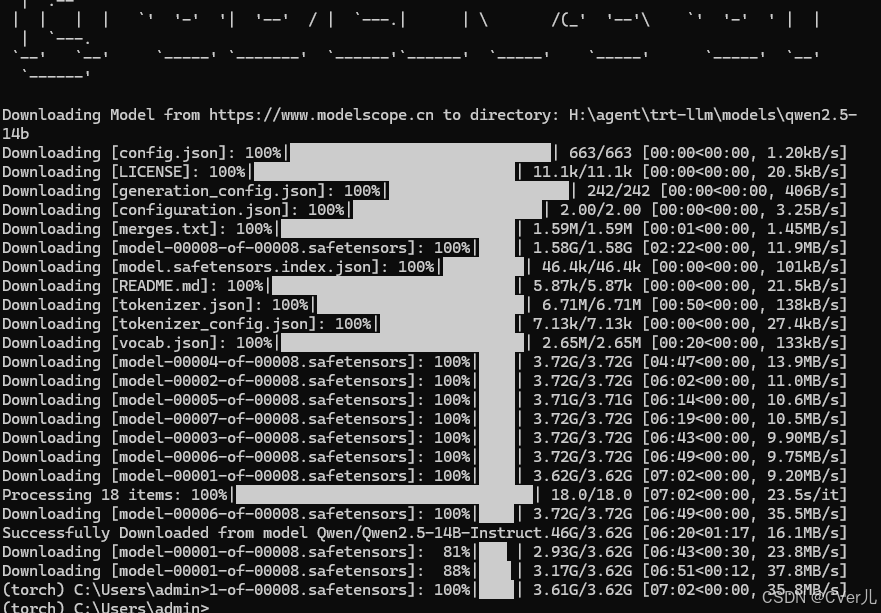
在 Windows cmd(激活 torch 环境)下载官方原生权重:
modelscope download --model Qwen/Qwen2.5-14B-Instruct --local_dir H:\agent\trt-llm\models\qwen2.5-14b
在 trt-qwen 容器内转换并编译:
本地 H:\agent\trt-llm\models\qwen2.5-14b 的权重(8 个分卷)已经全部就绪!它的架构是标准的 "model_type": "qwen2",当前容器原生完美支持。
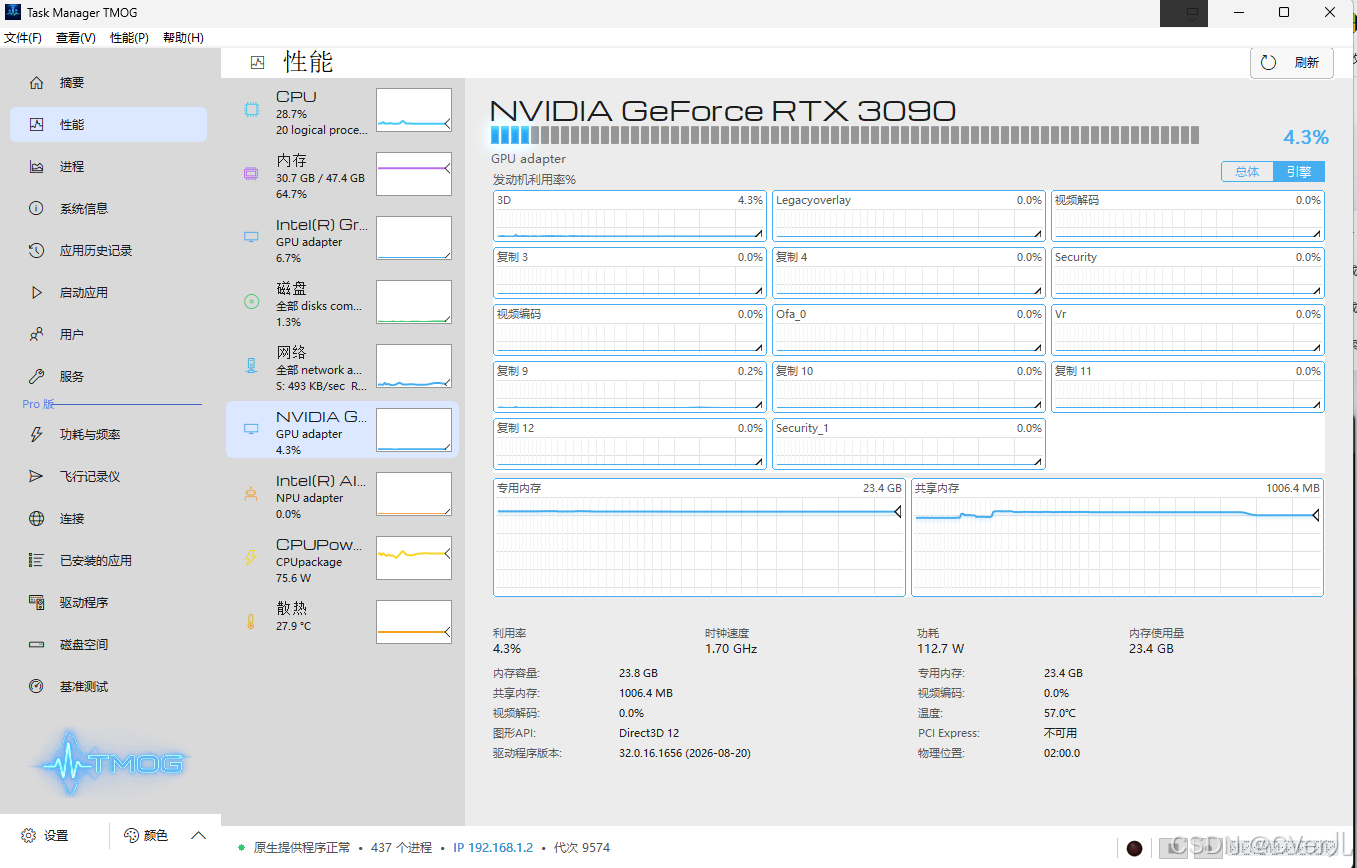
显存关键提示 : 14B 模型的原生 FP16 体积约为 29.5 GB ,如果直接以 FP16 运行会超出 RTX 3090(24GB)的显存上限而报 OOM。 因此强烈推荐使用 版本 A(INT4 单行版) ,转换后仅占 8 GB 显存,留出充裕空间给上下文与高吞吐;同时也为你准备了未量化的 版本 B(FP16 单行版)。
3. 启动服务
docker start trt-qwen && docker exec -it trt-qwen /bin/bash
版本 A:强烈推荐(INT4 量化单行命令,完美适配 24G 显存)
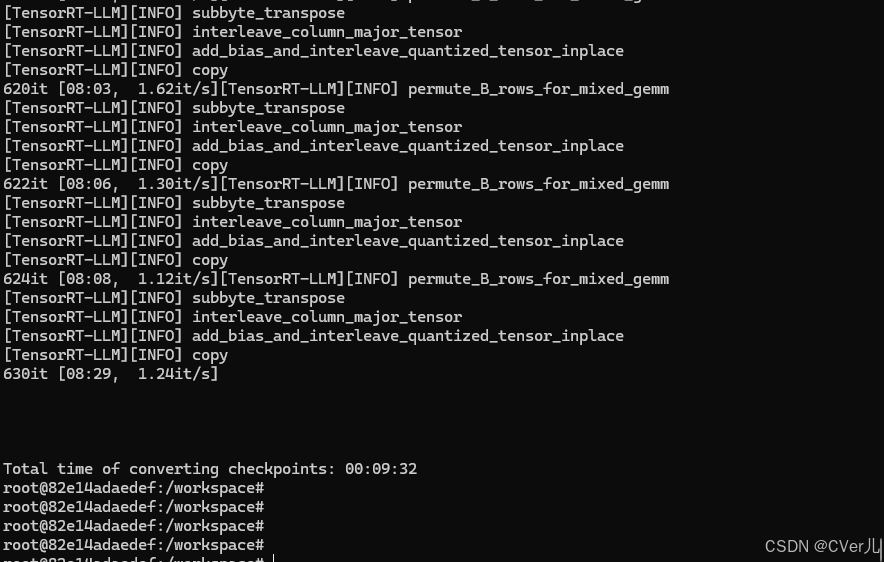
1. 转换为 INT4 Checkpoint(单行)
python3 /app/tensorrt_llm/examples/models/core/qwen/convert_checkpoint.py --model_dir /workspace/models/qwen2.5-14b --output_dir /workspace/qwen2.5_14b_ckpt_int4 --dtype float16 --use_weight_only --weight_only_precision int4
2. 编译为 RTX 3090 专属 Engine(单行)
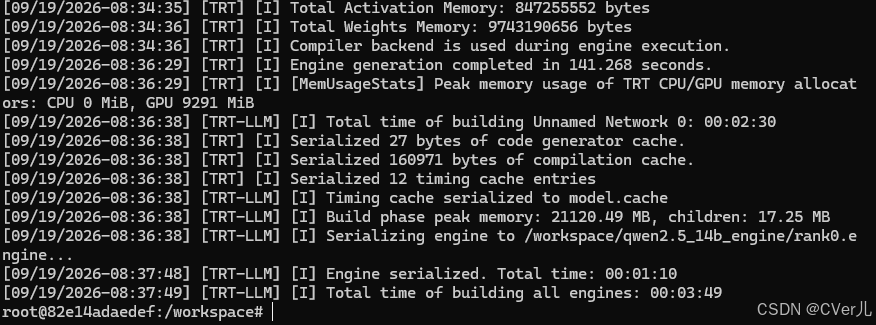
trtllm-build --checkpoint_dir /workspace/qwen2.5_14b_ckpt_int4 --output_dir /workspace/qwen2.5_14b_engine --gemm_plugin float16 --max_batch_size 3 --max_input_len 8000 --max_seq_len 18400 --paged_kv_cache enable --remove_input_padding enable
3. 启动推理服务(单行)
trtllm-serve /workspace/qwen2.5_14b_engine --host 0.0.0.0 --port 8000
版本 B:你要求的原版 FP16(完全不换行,单行命令)
1. 转换为 FP16 格式(单行)
python3 /app/tensorrt_llm/examples/models/core/qwen/convert_checkpoint.py --model_dir /workspace/models/qwen2.5-14b --output_dir /workspace/qwen2.5_14b_ckpt --dtype float162. 编译为 Engine(单行)
trtllm-build --checkpoint_dir /workspace/qwen2.5_14b_ckpt --output_dir /workspace/qwen2.5_14b_engine --gemm_plugin float16 --max_batch_size 2 --max_input_len 6096 --max_seq_len 101923. 启动服务(单行)
- 后端指定 :
trtllm-serve默认开启的是--backend pytorch,试图把它当成未编译的 HuggingFace 浮点模型加载。我们需要显式指定--backend tensorrt,告诉它加载编译好的硬件计划文件(.engine)。 - 分词器(Tokenizer)路径 :生成的
qwen2.5_14b_engine目录只存放编译后的二进制机器码,不包含分词文件;必须带上--tokenizer /workspace/models/qwen2.5-14b,告诉服务去哪里读取文字编码词表。
实际过程在编译 Engine 时设置了 --max_batch_size 3,而 trtllm-serve 启动时的默认运行时并发数是 2048,引擎的静态检查发现 2048 > 3,所以触发了断言:
Assertion failed: Runtime configured max batch size (2048) must not exceed engine max batch size (3)只需要在启动命令中加上 --max_batch_size 3,与你的引擎参数对齐即可!
trtllm-serve /workspace/qwen2.5_14b_engine --backend tensorrt --tokenizer /workspace/models/qwen2.5-14b --max_batch_size 3 --host 0.0.0.0 --port 8000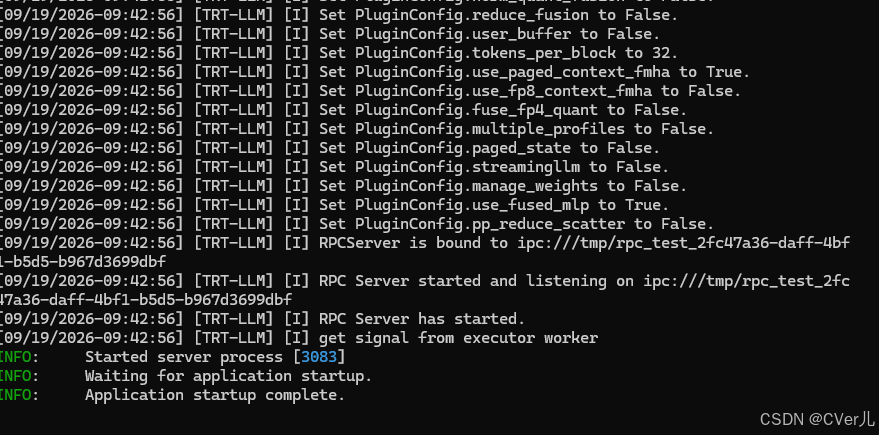
TensorRT-LLM 14B INT4 高性能推理服务已经完全启动成功并正式就绪!
当前这个终端窗口不要关闭(它正在前台提供推理服务,关闭会停止模型)。
接下来,请在 Windows 宿主机上另开一个全新的 cmd(命令提示符)窗口,进行调用与测试:
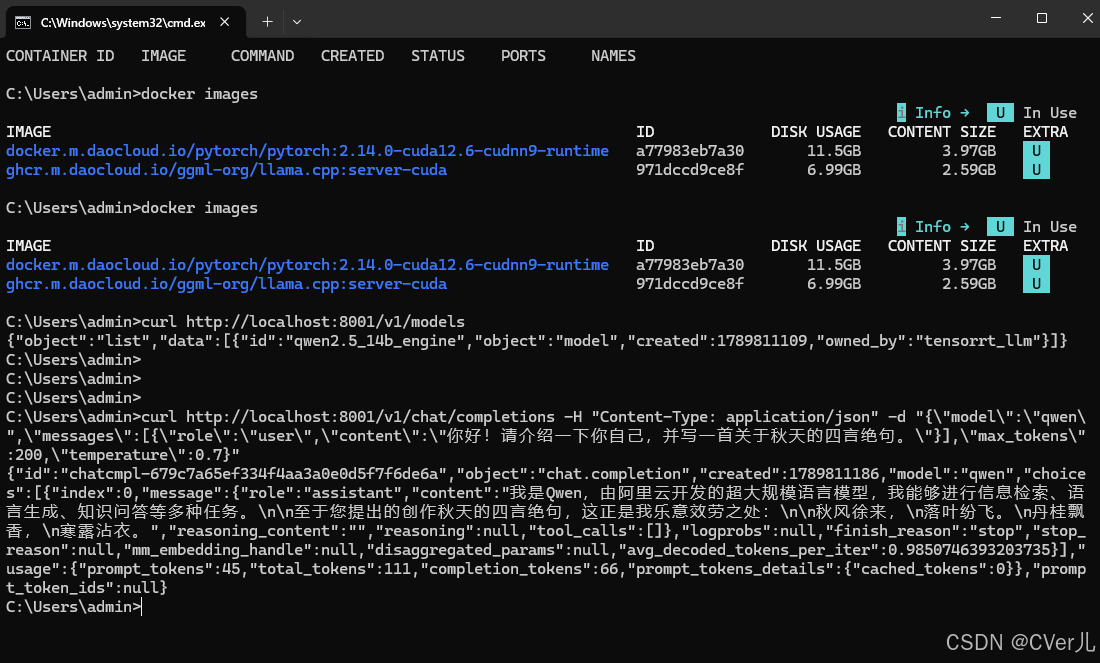
第一步:在新的 cmd 窗口中验证服务与模型
由于之前映射了端口 -p 8001:8000,直接在 Windows 新 cmd 中敲:
curl http://localhost:8001/v1/models
- 预期返回 :会返回 JSON 格式的模型信息(显示类似
{"data":[{"id":"qwen",...}]})。
第二步:发起第一次对话测试(OpenAI 兼容接口)
直接在新的 cmd 窗口中粘贴执行以下单行测试命令:
curl http://localhost:8001/v1/chat/completions -H "Content-Type: application/json" -d "{\"model\":\"qwen\",\"messages\":{\\"role\\":\\"user\\",\\"content\\":\\"你好!请介绍一下你自己,并写一首关于秋天的四言绝句。\\"},\"max_tokens\":200,\"temperature\":0.7}"
- 效果:你会看到毫秒级首字响应,并在几秒内流式返回通义千问 14B 的完整回复!
第三步:接入常用的 AI 客户端与 WebUI
专属 Engine 已经永久保存在了宿主机硬盘(H:\agent\trt-llm\qwen2.5_14b_engine),以后每次开机或重启,绝对不需要再进行转换与编译,直接秒级启动!
以下提供两种最常用的启动方式(推荐 方式一,开箱即用):
方式一:后台静默启动(最推荐,日常使用不占用 cmd 窗口)
在 Windows cmd 中复制执行这一行即可:
docker start trt-qwen && docker exec -d trt-qwen trtllm-serve /workspace/qwen2.5_14b_engine --backend tensorrt --tokenizer /workspace/models/qwen2.5-14b --max_batch_size 3 --host 0.0.0.0 --port 8000-
说明 :带有
-d参数,服务会在后台静默运行,cmd 窗口可以随时关闭。 -
随时查看运行状态与日志 :
docker logs trt-qwen --tail 50
-
不用时关闭 :
docker stop trt-qwen
方式二:前台交互启动(想实时看推理日志和请求情况)
在 Windows cmd 中执行:
docker start trt-qwen && docker exec -it trt-qwen trtllm-serve /workspace/qwen2.5_14b_engine --backend tensorrt --tokenizer /workspace/models/qwen2.5-14b --max_batch_size 3 --host 0.0.0.0 --port 8000- 说明 :当前 cmd 窗口会一直滚动打印请求日志,按
Ctrl + C即可停止服务。
制作桌面一键启动脚本
你可以在桌面新建一个文本文件,重命名为 启动TRT大模型.bat,内容填入:
@echo off
echo 正在唤醒 TensorRT-LLM 并挂载 Qwen2.5-14B 引擎...
docker start trt-qwen
docker exec -d trt-qwen trtllm-serve /workspace/qwen2.5_14b_engine --backend tensorrt --tokenizer /workspace/models/qwen2.5-14b --max_batch_size 3 --host 0.0.0.0 --port 8000
echo 启动完成!服务已在 http://localhost:8001/v1 就绪。
pause以后每次开机只需双击这个图标,几秒钟即可全自动拉起服务!
将当前配置好的环境迁移到其他 Ubuntu 服务器非常简单。
但在迁移前,必须注意一个 TensorRT 的核心底层规则:
显卡芯片架构绑定规则(非常重要) : TensorRT 编译出的 .engine(机器码计划文件)是与显卡底层微架构(Compute Capability)严格绑定的:
- 如果目标服务器也是 Ampere 架构(如 RTX 3090 / 3080 / A10 / A5000) :当前的
qwen2.5_14b_engine可以直接拷贝并秒级启动! - 如果目标服务器是不同架构(如 RTX 4090 / A100 / H100 等) :不需要重新下载模型,只需拷贝通用的
qwen2.5_14b_ckpt_int4,在目标机器上花 3 分钟执行一次trtllm-build即可生成适配新显卡的 Engine。
方案 :直接打包成"全封装一体化镜像"(适合纯离线、零目录依赖)
1. 在容器内部创建永久存储目录
mkdir -p /model_data/tokenizer
2. 将 7.4GB 通用 INT4 权重复制进容器内部系统
cp -r /workspace/qwen2.5_14b_ckpt_int4 /model_data/
3. 仅复制分词器文件(不复制 30GB 无用的原生大分卷,极大瘦身)
cp /workspace/models/qwen2.5-14b/tokenizer* /workspace/models/qwen2.5-14b/vocab* /workspace/models/qwen2.5-14b/merges* /workspace/models/qwen2.5-14b/config.json /model_data/tokenizer/执行完毕后输入 exit 退出容器。
第二阶段:在 Windows 宿主机导出镜像
在 Windows cmd 中执行:
1. 将容器提交为新镜像(已包含环境 + 权重 + 分词器)
docker commit trt-qwen qwen2.5-14b-portable:v1
2. 导出为 tar 压缩包
docker save -o H:\agent\qwen2.5-14b-portable.tar qwen2.5-14b-portable:v1
(会生成一个约 28GB 的安装包,传给 Ubuntu 目标服务器)
第三阶段:在目标 Ubuntu 服务器上一键构建并运行
把 qwen2.5-14b-portable.tar 传到 Ubuntu 后:
1. 导入镜像
docker load -i qwen2.5-14b-portable.tar
2. 启动并进入容器(完全无需外部目录挂载)
docker run -it --name trt-qwen --gpus all --ipc=host --ulimit memlock=-1 --ulimit stack=67108864 -p 8000:8000 qwen2.5-14b-portable:v1 /bin/bash3. 在 Ubuntu 容器内执行编译(仅需 3 分钟,针对目标显卡定制加速)
trtllm-build --checkpoint_dir /model_data/qwen2.5_14b_ckpt_int4 --output_dir /model_data/qwen2.5_14b_engine --gemm_plugin float16 --max_batch_size 3 --max_input_len 8000 --max_seq_len 18400 --paged_kv_cache enable --remove_input_padding enable4. 启动服务
trtllm-serve /model_data/qwen2.5_14b_engine --backend tensorrt --tokenizer /model_data/tokenizer --max_batch_size 3 --host 0.0.0.0 --port 8000终极技巧(在 Ubuntu 编译完成后)
在 Ubuntu 上编译成功后,可以在 Ubuntu 宿主机上敲一次:
docker commit trt-qwen qwen2.5-ready:latest
执行 docker commit 带来的三个核心价值
给当前容器拍一个"完整快照",把它保存成一个新镜像。
在容器里编译出的 Engine、拷贝的文件,都会被永久固化到这个新镜像里。以后无论容器被怎么删除折腾,随时拿这个新镜像启动,里面都是编译好的成品,开箱即跑!
执行这句命令后,Docker 会把"环境 + 权重 + 该机器专属的编译成果 "合为一体,固化为一个名为 qwen2.5-ready:latest 的新镜像:
1. 彻底防丢(容灾免疫)
- 哪怕别人把当前的容器
docker rm -f trt-qwen删得一干二净,你的编译成果依然完好无损地保存在本地镜像库中。
2. 实现"秒级拉起任意多实例"(方便横向扩容)
-
如果你后续想在这台服务器上开 2 个容器做负载均衡,或者被挂掉了想重新拉起,直接敲这一行就能在 1 秒钟内 启动,再也不需要进容器去敲编译命令:
docker run -d --name trt-qwen --restart always --gpus all -p 8000:8000 qwen2.5-ready:latest trtllm-serve /model_data/qwen2.5_14b_engine --backend tensorrt --tokenizer /model_data/tokenizer --max_batch_size 3 --host 0.0.0.0 --port 8000