⚡ 加急快讯:智谱推出 GLM-5.3-FlashX:最高 200 tokens/s,轻量模型竞争升维
🎬 视频版直达 :https://www.bilibili.com/video/av117291228402710/
📋 快讯详情
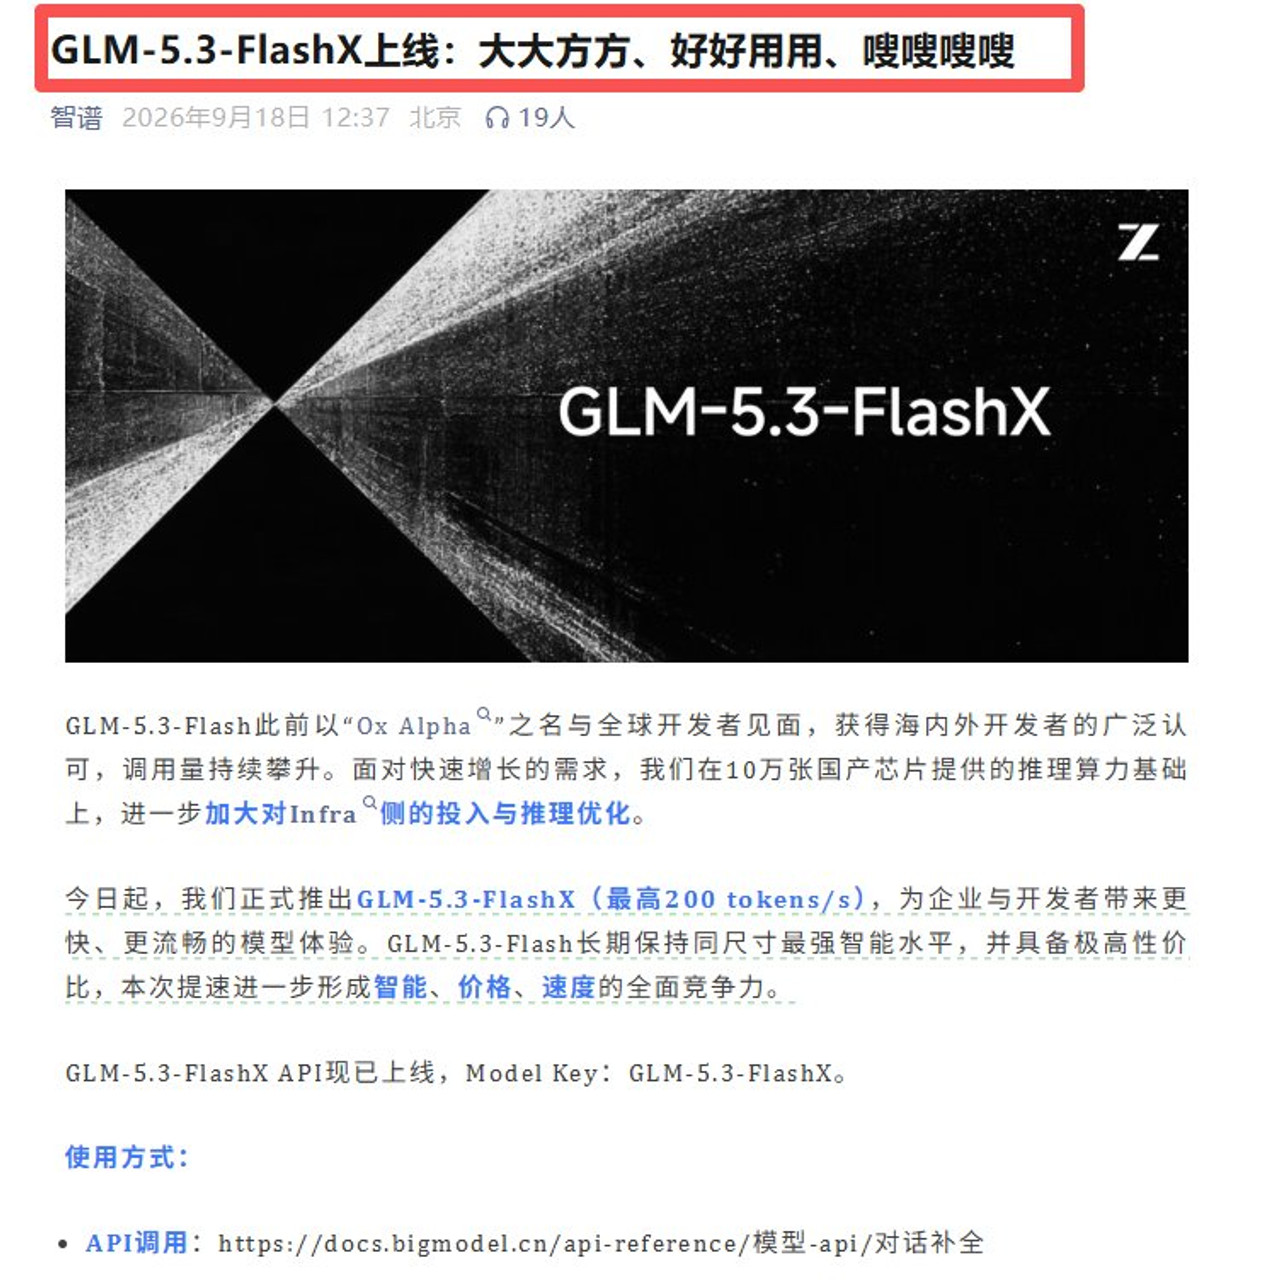
1. 今天,智谱正式推出 GLM-5.3-FlashX:官方口径最高推理速度 200 tokens 每秒,主打高性价比与低延迟体验。
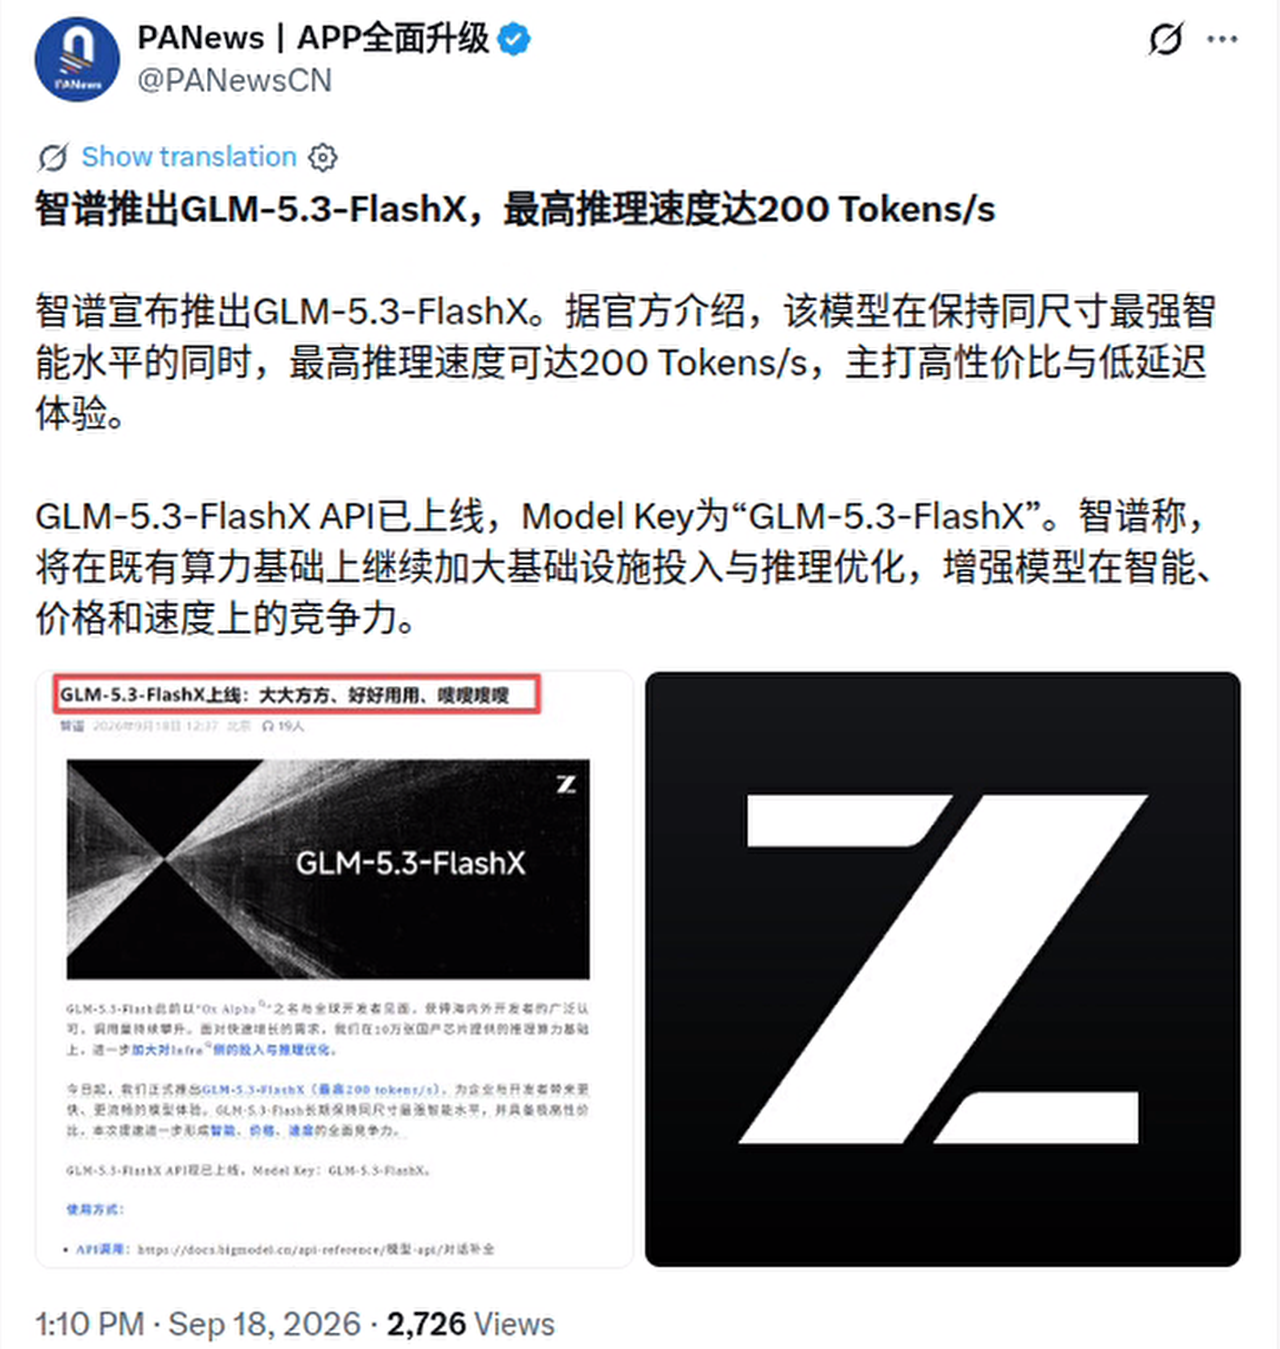
2. 官方介绍,GLM-5.3-Flash 长期保持同尺寸最强智能水平,具备极高性价比;这次推出 FlashX,就是要带来更快、更流畅的模型体验。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
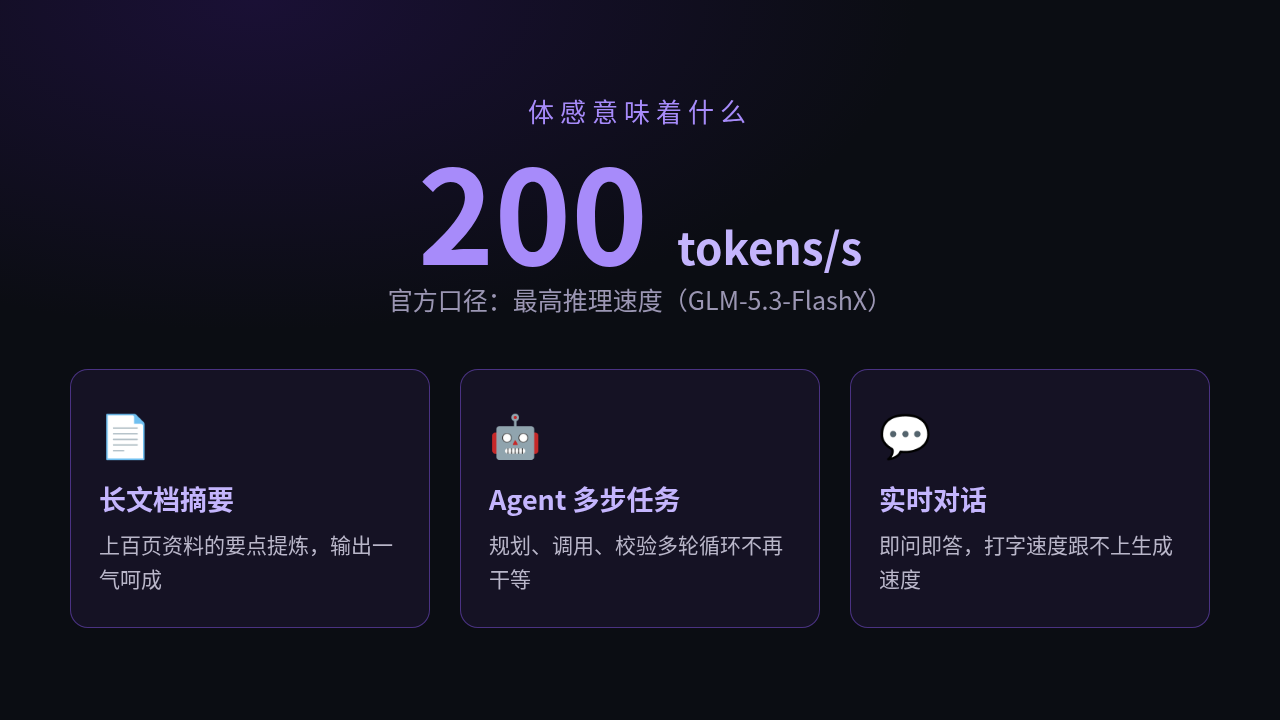
3. 200 tokens 每秒是什么概念?长文档摘要、Agent 多步任务、实时对话------最吃响应速度的场景,等待感都会明显缩短,这正是官方主打低延迟体验的原因。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
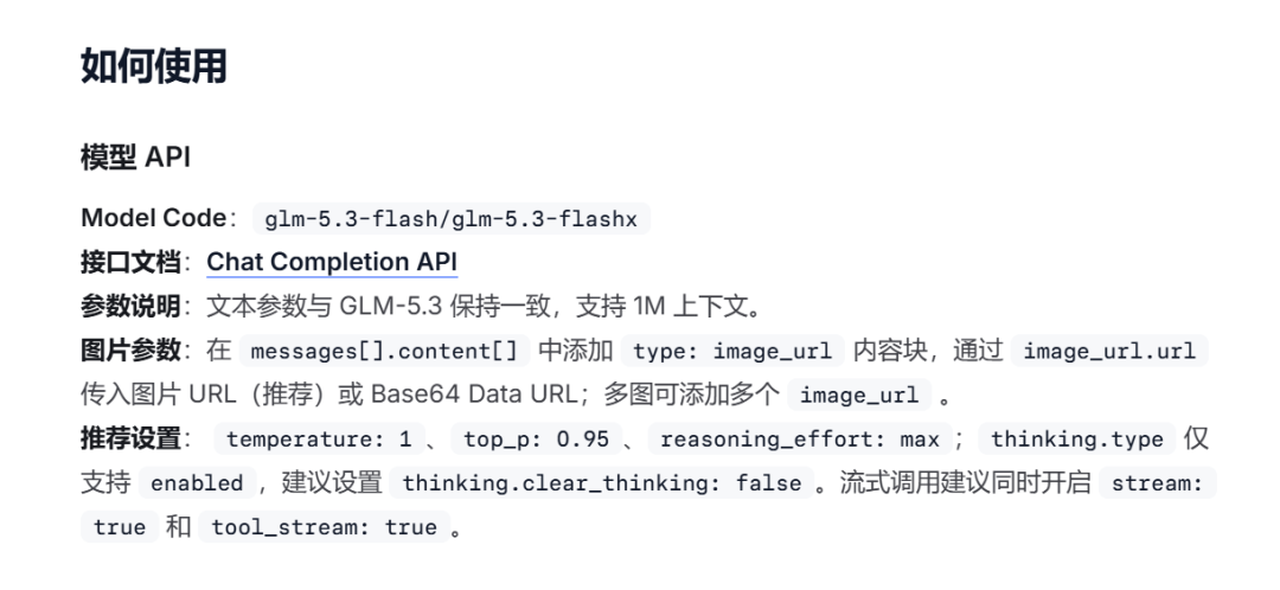
4. 上手零门槛:Model Code 直接填 glm-5.3-flashx,支持 1M 上下文和图片输入,官方文档连推荐参数都给好了。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
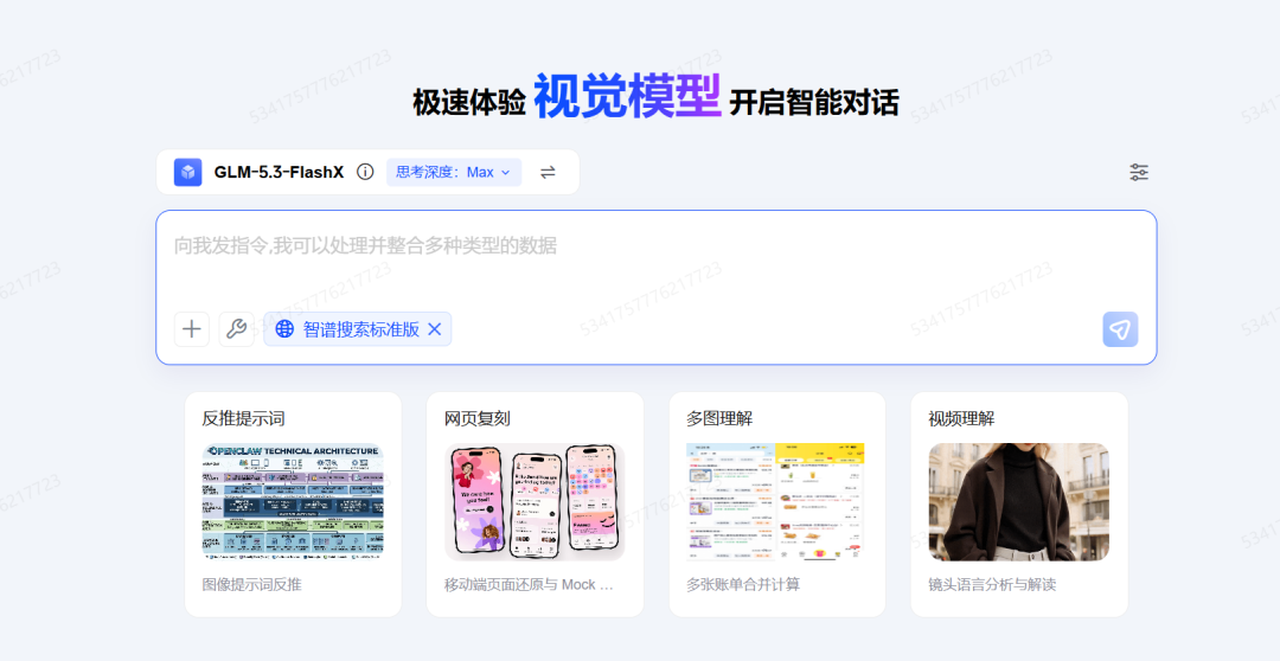
5. 体验中心也同步开放:视觉模型即点即用,反推提示词、网页复刻、多图理解、视频理解四大场景现在就能试。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
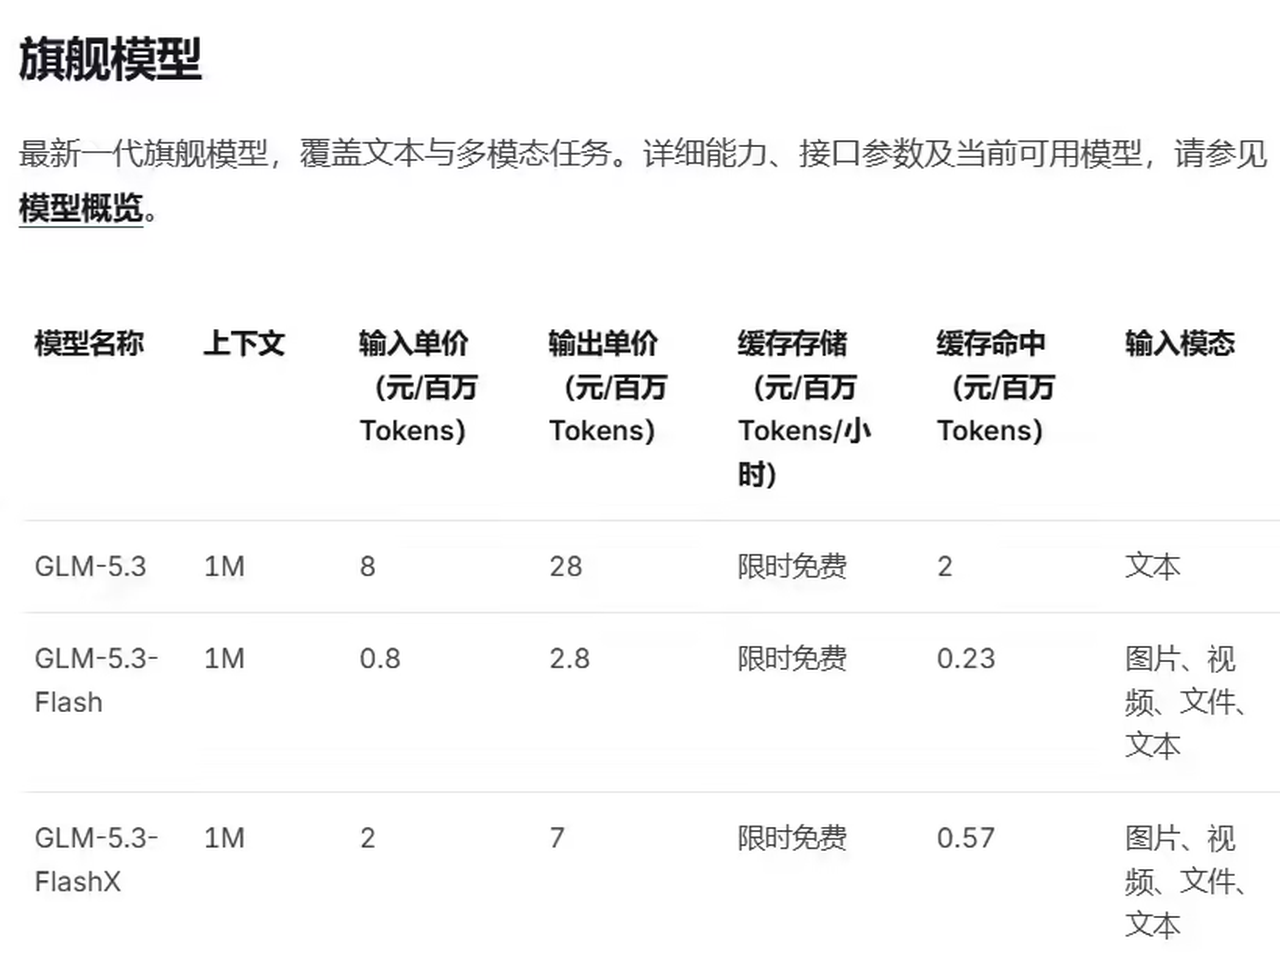
6. 定价方面,官方文档给出:每百万 token 输入 2 元、输出 7 元、缓存命中 5 毛 7,缓存存储限时免费------对比前代 Flash 的 8 毛和 2 块 8,恰好是 2.5 倍;有第三方测算,换来的是约 5 倍的速度提升。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
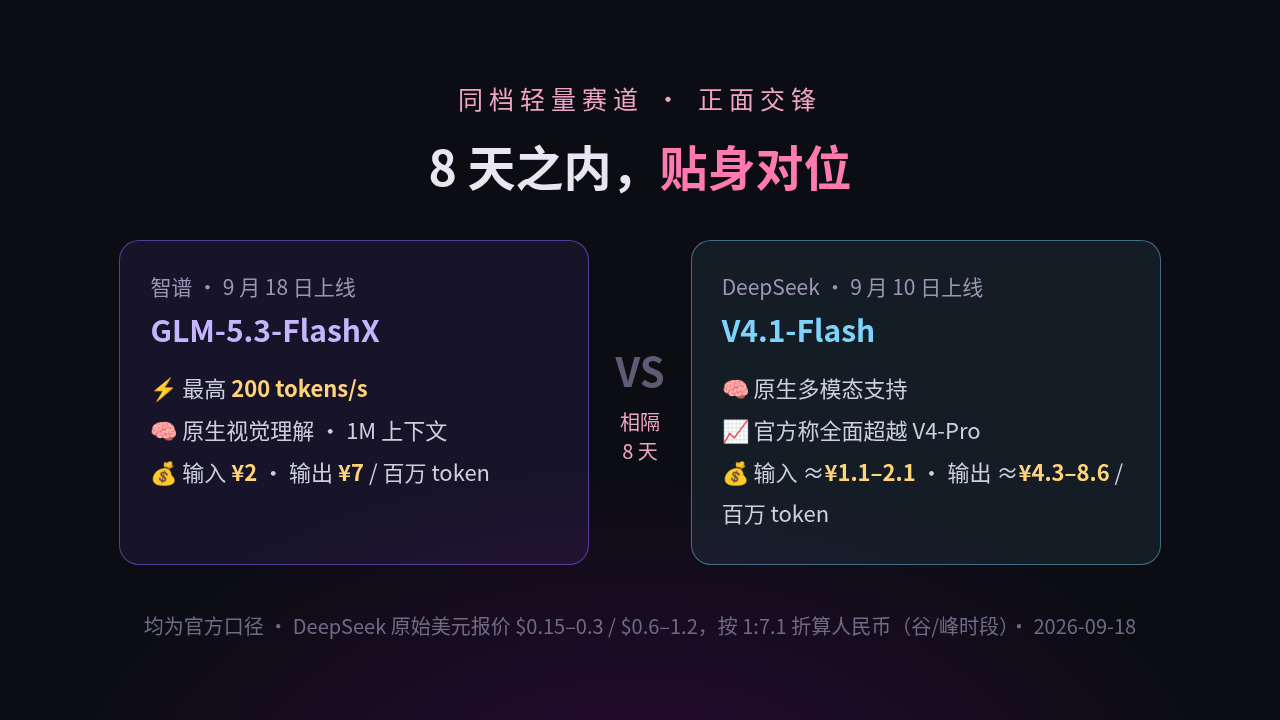
7. 值得玩味的是时机:DeepSeek V4.1 Flash 八天前刚发布、并完成了老用户的强制迁移,智谱今天就甩出同样主打速度与性价比的 FlashX------同样的 200 tokens 每秒口径,正面对位。智能不降、速度拉满、价格换挡,轻量模型的竞争正式进入卷速度的深水区。
 🔗 https://x.com/PANewsCN/status/2100814760753414508
📢 以上为本次加急快讯,关注更多深度分析,我们下期再见。