一句话总结:NanoJev 用 Qwen3-0.6B 的底座,接上几个轻量决策头,不生成任何文本 token,一次前向传播就吐出完整的概率分布。在 50×50 迷宫里 244 步找到出口,贪吃蛇吃到 27 个食物------和 TypeSafe 的 Jev 正面交锋,体量只有对方的零头。
跳出项目本身设计的迷宫和贪吃蛇游戏,让我来实施用nanojev实现玩扫雷游戏是什么效果
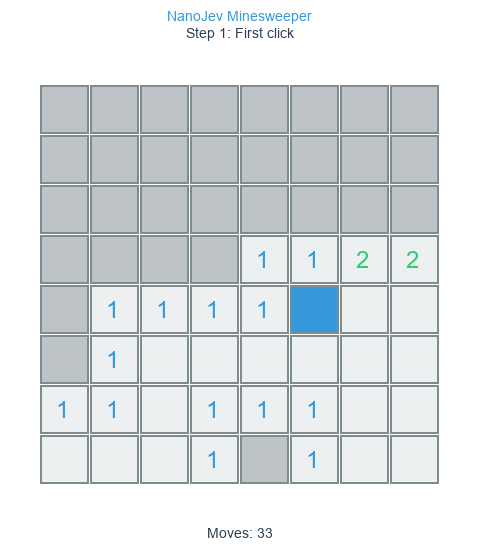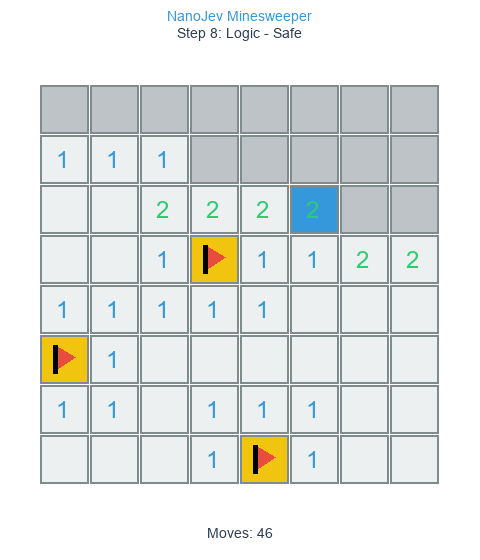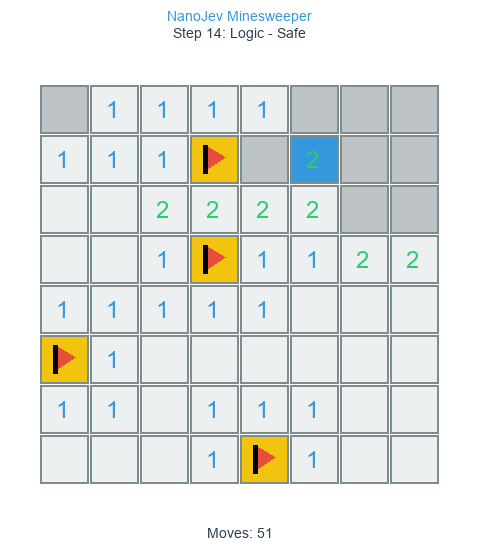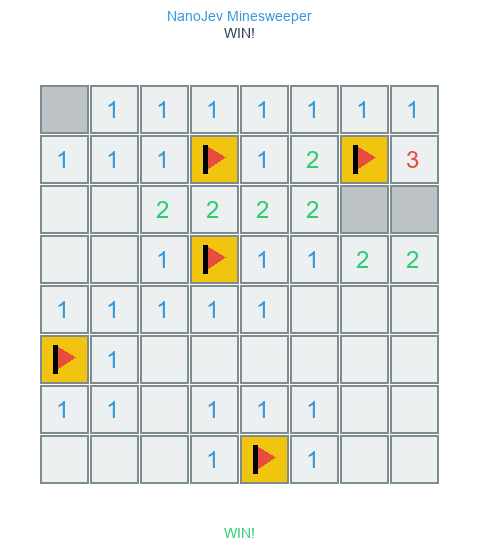
NanoJev 如何实现扫雷:建模与推理全解析
问题建模:把扫雷变成 NanoJev 能理解的"语言"
NanoJev 的核心能力是:给定一个状态(State)和一个问题(Question),直接输出概率分布,不生成任何文本 token。要用它玩扫雷,关键是把扫雷的棋盘状态编码成 NanoJev 能"读懂"的文本。
- 状态编码:3x3 局部视图
扫雷的核心决策是"这个格子有没有雷"。人类玩家做这个判断时,看的不是整个棋盘,而是目标格子周围的局部信息。我们模仿这个认知过程,把每个待决策格子编码为一个 3x3 的 ASCII 局部视图:
c
目标格子 (r, c) 的局部视图:

  # # #      # = 边界(棋盘外)
  1 . 2      . = 已翻开的空白格
  ? F ?      1-8 = 已翻开的数字格
             F = 已标记的地雷
             ? = 未翻开的未知格
这个设计的精妙之处在于:
与迷宫的 5x5 局部窗口同构:NanoJev 在迷宫任务中训练的就是"看局部、判安全"的能力,扫雷的 3x3 视图天然适配这个范式
保留了所有推理线索:数字格告诉你周围有几个雷,已标记的 F 提供了约束条件,? 是待决策的目标
位置不变性:无论格子在棋盘的哪个位置,模型看到的都是相同结构的 3x3 视图
题定义:Boolean 类型判断
每个决策被定义为一个 Boolean 类型的问题:
c
{
  "states": [{
    "id": "cell_3_5",
    "state": "# # #\n1 . 2\n? F ?",
    "questions": {
      "has_mine": {
        "type": "boolean",
        "instructions": "Is there a mine under this cell?"
      }
    }
  }]
NanoJev 收到这个请求后,会:
把 state 和 instructions 编码为 token 序列
为 true 和 false 两个候选各构建一条路径
通过共享的 Transformer 骨干做一次前向传播
在标量决策头上得到 z_true 和 z_false
计算 P(mine) = sigmoid(z_true - z_false)
一次前向传播,一个概率数字,没有逐字生成。
推理过程:逻辑推理 + 模型概率的混合策略
纯靠模型概率玩扫雷是不够的------NanoJev 是 0.6B 的小模型,它没有经过扫雷数据的专门训练,直接问它"有没有雷",得到的概率可能不太准。所以我们设计了一个三层决策架构:
c
┌─────────────────────────────────────┐
│         第一层:逻辑推理             │  ← 100% 准确
│  通过已翻开的数字做确定性推断        │
│  如果周围标记数 == 数字 → 剩余安全   │
│  如果周围未翻开数 == 数字-标记 → 全雷 │
└──────────────┬──────────────────────┘
               │ 无法推理时
               ▼
┌─────────────────────────────────────┐
│       第二层:NanoJev 概率判断        │  ← 模型直觉
│  把局部视图发给模型                   │
│  获取每个候选格子的 P(mine)          │
│  P < 0.2 → 翻开    P > 0.6 → 标记   │
└──────────────┬──────────────────────┘
               │ 模型也无法判断时
               ▼
┌─────────────────────────────────────┐
│         第三层:随机选择              │  ← 兜底
│  从未翻开的格子中随机选一个           │
└─────────────────────────────────────┘
每一步的完整推理流程如下:
c
1. 遍历棋盘,找到所有已翻开的数字格(1-8)
2. 对每个数字格,检查它的邻居:
   - 已标记的地雷数 == 数字?→ 剩余未翻开的都是安全的
   - 未翻开数 + 已标记数 == 数字?→ 所有未翻开的都是雷
3. 如果有确定性结论 → 执行翻开/标记,跳到下一步
4. 否则 → 收集所有未翻开的格子
5. 随机采样 10 个候选格子
6. 对每个候选格子:
   a. 构建 3x3 局部视图(ASCII 文本)
   b. 构造 Boolean 问题请求
   c. POST 到 NanoJev 的 /api/evaluate 端点
   d. 模型做一次前向传播(~200ms on CPU)
   e. 返回 P(mine)
7. 选择 P(mine) 最低的格子翻开
   或选择 P(mine) 最高的格子标记
8. 渲染当前棋盘状态为一帧图像
9. 重复直到游戏结束
NanoJev 的骨干是 Qwen3-0.6B-Base,一个经过大规模预训练的语言模型。虽然它没有专门学过扫雷,但它学到了模式识别的能力:
当它看到 1 . F 时,能理解"1 旁边有一个标记的雷,这个 1 已经被满足了"
当它看到 2 ? ? 时,能理解"2 旁边有两个未知格,可能都有雷"
当它看到 . . . 时,能理解"周围都是安全的空白"
这种基于语义的局部判断正是 NanoJev 的核心能力------它不生成答案文本,而是直接从隐藏状态读出概率。这就是 System 1 式决策:快速、并行、不经过语言中介的直觉判断。
它到底解决了什么问题?
想象你是一个机器人,站在一个从未见过的 50×50 迷宫里。你的眼睛只能看到周围 5×5 的局部墙壁,你需要判断"往北走会不会撞墙?往东呢?"。传统的大语言模型怎么做?它会一个字一个字地"说"出答案:"嗯,让我看看,北边好像有一堵墙......所以我觉得不能走北边......"------这个过程叫自回归解码,一个 token 接一个 token 地生成,慢得要命,而且它"说"出来的答案和它"内心"的真实判断之间,隔着一层厚厚的语言伪装。
NanoJev 彻底抛弃了这套把戏。
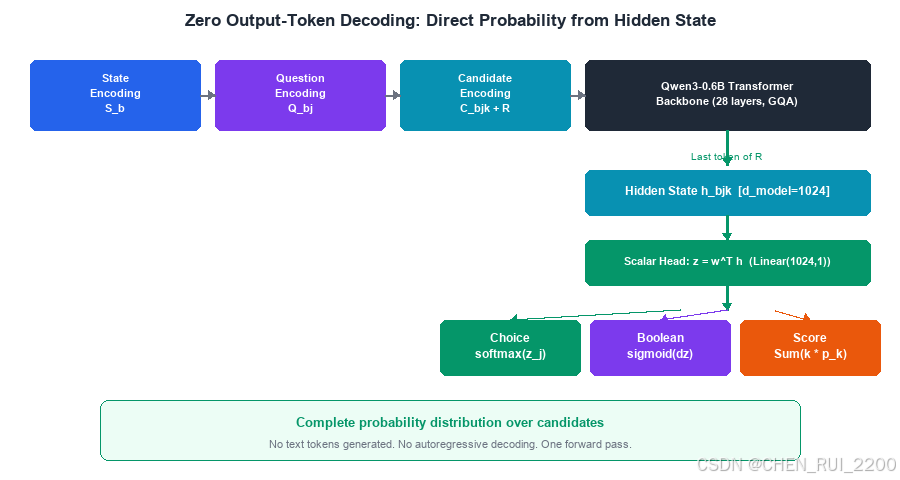
它的做法是:把状态(你看到的 5×5 局部景象)和问题("北边能走吗?")编码成 token 序列,送进 Qwen3-0.6B 的 Transformer 骨干网络,然后在最后一个特殊 token 的隐藏状态上接一个标量决策头 ------一个简简单单的线性层 wᵀh------直接输出一个数字。这个数字经过 sigmoid 变换,就是"北边能走"的概率。
没有"嗯",没有"让我想想",没有逐字生成的答案。一次前向传播,四个方向的概率同时出来。这就是论文里所说的 System 1 式决策------快思考,直觉判断,不经过语言中介。
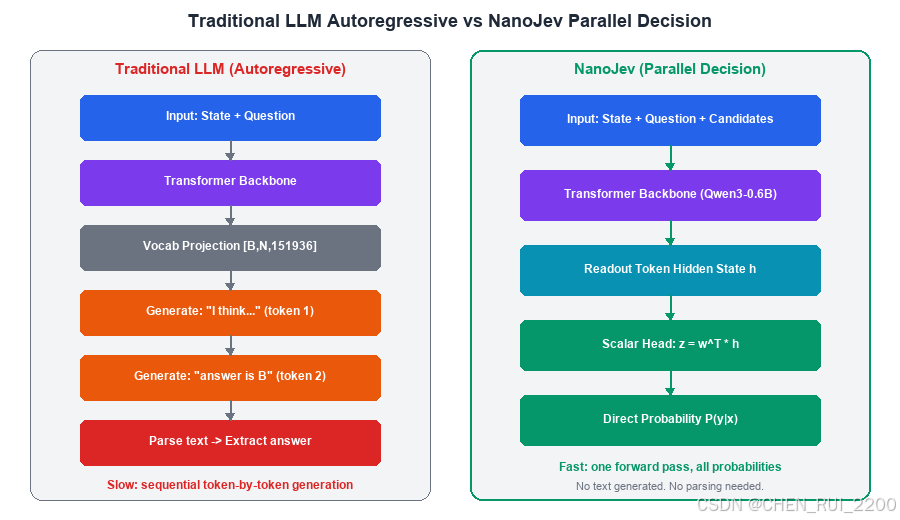
这个问题的核心矛盾在于:大语言模型拥有强大的语义理解能力,但它被训练成"说话"------一个字一个字地往外蹦。当你只需要一个"是/否"的判断时,它不得不先"说"出一段话来表达这个判断。这就像让一个数学家在回答"1+1等于几"之前,必须先写一篇论文。NanoJev 的解法是:保留数学家的大脑,但给他一个直接写答案的笔。
三大创新点:一刀一刀切掉多余的脂肪
创新一:零输出 Token 解码------决策不"说话"
这是 NanoJev 最核心的设计哲学。传统 LLM 做决策的流程是:
输入 → Transformer → 逐 token 生成 "我认为答案是B" → 解析出 BNanoJev 的流程是:
输入 → Transformer → 隐藏状态 → 标量头 → 直接得到概率 P(B)中间没有任何文本生成。决策头的输出就是最终答案,不需要后处理解析,不会因为模型"说了"一段废话而丢失关键信息。这意味着:
- 速度:不需要自回归地一个接一个生成 token,一次前向传播搞定所有决策
- 精度:概率直接从隐藏状态读出,不经过 softmax 词表的间接映射
- 并行:多个独立决策可以同时计算,互不干扰
创新二:共享前缀树注意力------一次前向,多个决策
如果你同时需要判断四个方向的安全性,朴素的做法是做四次前向传播。NanoJev 用了一个巧妙的共享前缀树结构:
- 树根是所有决策共享的"状态"(你看到的 5×5 局部景象)
- 第二层是每个问题的编码("北边能走吗?""东边能走吗?"......)
- 叶子层是每个候选路径的编码
关键在于 attention mask 的设计:每个叶子节点只能看到它到树根的路径上的 token,不能看到兄弟分支。这在数学上等价于独立的前向传播,但在计算上,共享的前缀只需要编码一次。
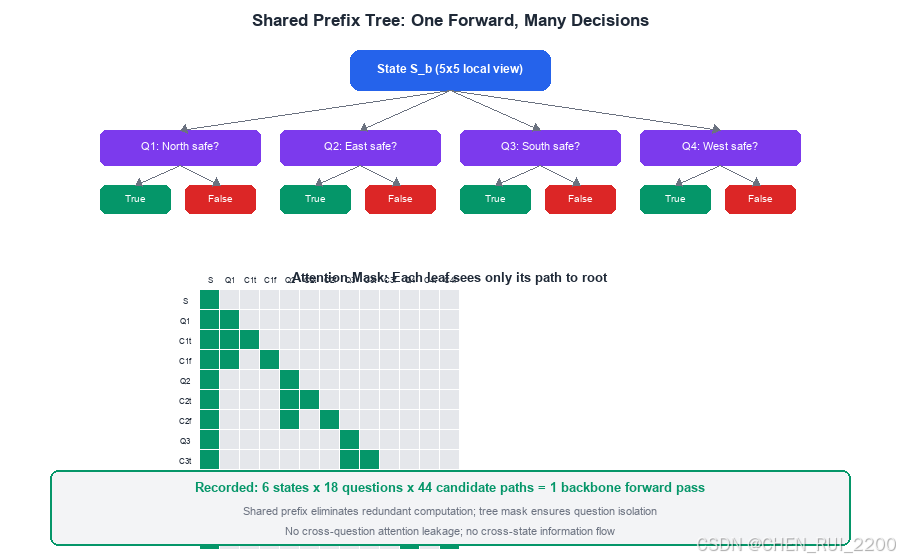
实际运行中的记录是:6 个状态 · 18 个问题 · 44 条候选路径 · 1 次 backbone 前向传播。这就像一棵大树,树干只长一次,但枝叶可以同时向不同方向伸展。
创新三:动态候选集------不锁死答案空间
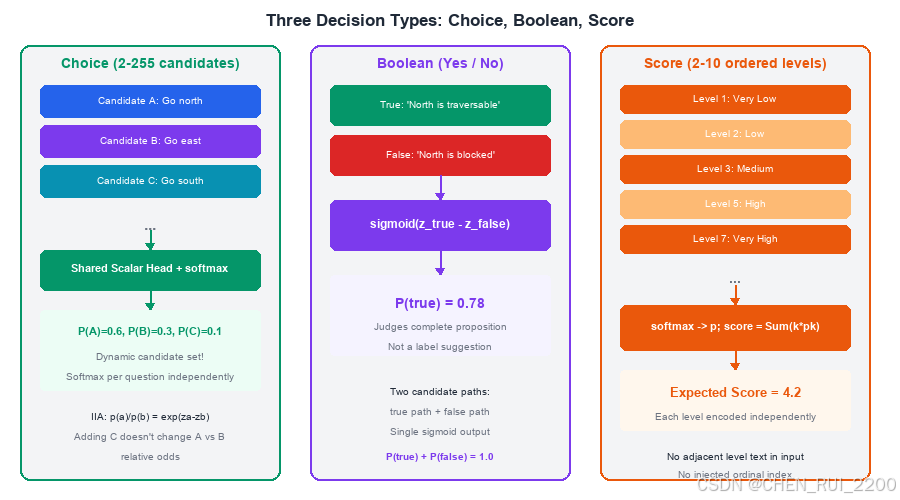
传统分类器的输出空间是固定的:训练时定义了 10 个类别,推理时就只能在这 10 个里面选。NanoJev 的 Choice 决策头支持 2--255 个动态候选------你可以每次给它不同的候选集合,它都能返回一个覆盖所有候选的概率分布。
这是怎么做到的?核心是集合注意力(Set Attention)机制:每个候选独立编码后,通过一个共享的标量头打分,然后在当前题目的候选集内做 softmax 归一化。候选集变了,归一化的分母就变了,概率分布自然跟着变。
模型的身世:从 Qwen3-0.6B 到 NanoJev 的蜕变
是的,NanoJev 就是从 Qwen3-0.6B 训练来的
这个问题值得开门见山地回答:NanoJev 的底座就是 Qwen3-0.6B。不是从零开始训练的新模型,不是某个神秘架构的黑箱产物,而是站在巨人肩膀上的一次精准改造。
项目文档中多处明确记录了这一点:
"0.6B LLM backbone. Qwen3-0.6B with decision heads for structured outputs." ------ README.md
"直接初始化
Qwen/Qwen3-0.6B,没有先训练 yes/no reranker。" ------ pipeline_runbook_zh.md
训练命令更是写得清清楚楚:--model Qwen/Qwen3-0.6B --revision c1899de289a04d12100db370d81485cdf75e47ca。
但"从 Qwen3-0.6B 训练来的"这句话背后,藏着一系列精心设计的改造步骤。
四步蜕变:从语言模型到决策机器
第一步:拆掉嘴巴(移除 LM head)
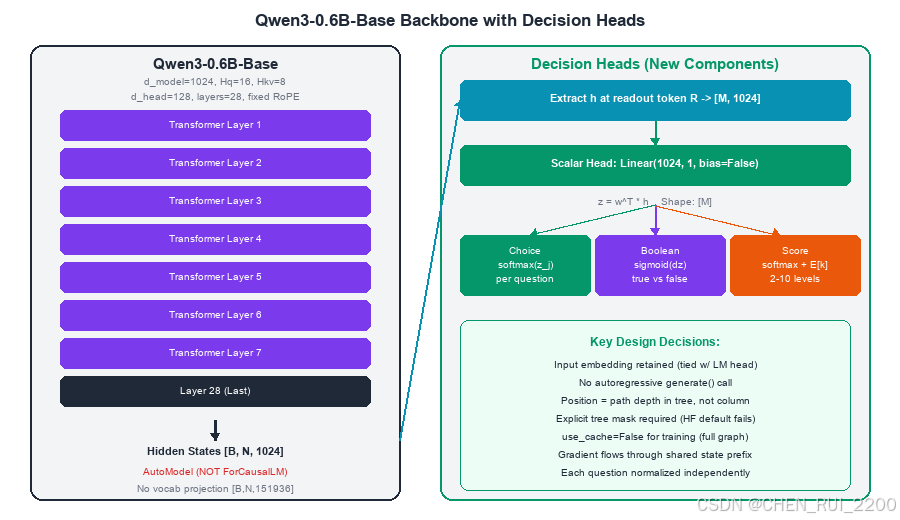
Qwen3-0.6B 原本是一个因果语言模型(Qwen3ForCausalLM),它的最后一层是一个 1024 → 151936 维的词表投影层------把每个位置的隐藏状态映射到整个词表上,预测"下一个 token 是什么"。NanoJev 把这个投影层整个扔掉 ,只保留 Transformer 骨干(Qwen3Model)。
这就像把一个能言善辩的数学家变成了只能写数字的哑巴------他不再"说话"了,但他对语义的理解能力完好无损。
第二步:装上决策之眼(添加读出头)
在骨干网络的顶部,NanoJev 注册了一个全新的组件:一个共享的 Linear(1024, 1, bias=False) 标量读出头。这个线性层接收每个候选路径最后一个 token 的隐藏状态 h,输出一个标量 wᵀh。对于 Choice 类型的决策,还额外添加了一个无位置编码的集合注意力头(Set Attention),让模型能够感知候选集的整体信息。
第三步:喂合成数据(概率分布监督训练)
训练数据不是人工标注的,而是由自写的游戏生成器合成的:
- 迷宫导航:8×8 到 50×50 的各种迷宫,每个状态问"四个方向哪个安全?"
- 贪吃蛇:12×12 的蛇游戏,每个状态问"往哪个方向走不会死?"
- 智能家居工作流:温度、灯光、窗户的控制决策
- 支持工单路由:退款、信息查询、投诉的分类
每个训练样本是一个四元组 (state, question, candidate_set, target_distribution)。监督信号有两种来源:
- 程序真值(gold):几何规则算出的精确标签("北边有墙 → 不可通行")
- Jev 教师标签(teacher):通过 TypeSafe API 采集的软概率分布
第四步:联合训练(骨干 + 决策头端到端优化)
训练时,整个 Qwen3-0.6B 骨干全参数更新(不是 LoRA 微调),决策头从头开始训练。先预热决策头 12 步,再联合训练。训练目标是完整候选集上的交叉熵分布损失------不是让模型"选对答案",而是让模型输出完整的概率分布去匹配目标分布。
NanoJev 和普通 Transformer 到底有什么区别?
下面这张表把两者的差异系统地列出来:
| 维度 | 普通 Transformer(如 GPT/Qwen) | NanoJev |
|---|---|---|
| 核心任务 | "下一个 token 是什么?" | "给定状态和问题,每个候选的概率是多少?" |
| 输出方式 | 逐 token 自回归解码,生成文本序列 | 零输出解码------一次前向传播,直接读出概率分布 |
| 输出头 | 共享词表投影(151,936 维) | 自定义共享标量头(1 维)+ 集合注意力,参数不随候选数增长 |
| 输入结构 | 单一文本序列 | 树形结构:state → question → candidate,每道题独立编码 |
| 注意力掩码 | 标准因果下三角 | 自定义树掩码:每个 token 只看祖先路径,不看兄弟 |
| 位置编码 | 全局递增 position IDs | 路径深度:从根到当前 token 的路径长度 |
| 并行能力 | 一次生成一个 token | 多 state × 多 question × 多 candidate 一次前向 |
| 概率输出 | 需要从 token logits 间接推算 | 直接从决策头读出,经过 sigmoid/softmax 归一化 |
| 推理速度 | O(序列长度 × 生成步数) | O(一次前向传播) |
| 动态候选 | 需要提示工程,候选固定在提示文本中 | 原生支持 2--255 个动态候选,每次推理可换候选集 |
一句话总结:骨干是同一个 Transformer,但 NanoJev 把它从"文本生成器"改造成了"并行概率判别器"。保留了预训练赋予的语义理解能力,但彻底改变了输出方式。
训练前 vs 训练后:因果证据
最有说服力的证据来自同一个 Qwen3-0.6B 在训练前后的对比。项目把未微调的原始 Qwen3-0.6B 作为一个对照基线("Untuned Qwen3-0.6B"),用原生 LM head 对 A--D 选项取条件概率,和训练后的 NanoJev 做完全相同的任务:
40 图导航基准测试(20 张 4×4 测试 + 20 张 6×6 OOD 地图):
| 系统 | 4×4 测试完成率 | 6×6 OOD 完成率 |
|---|---|---|
| NanoJev(训练后) | 95% | 90% |
| Jev(TypeSafe 商业版) | 100% | 95% |
| Untuned Qwen3-0.6B(未训练) | 35% | 15% |
50×50 迷宫测试:
| 系统 | 行动尝试 | 碰撞次数 | 结果 |
|---|---|---|---|
| NanoJev(训练后) | 244 | 36 | 到达目标 |
| Jev(原版) | 2,738 | 1,044 | 到达目标 |
| 原始 Qwen3-0.6B(未训练) | 4,726 | 2,044 | 到达目标 |
这组数据清楚地表明:NanoJev 的性能飞跃来自训练,而不是 Qwen 本身的预训练能力 。同一个 Qwen3-0.6B,用原生语言模型方式做导航只有 35% 成功率,经过决策头训练后达到了 95%------提升了近 3 倍。在 50×50 迷宫中更是如此:训练后 244 步到达,训练前需要 4,726 步------效率提升了 19 倍。
训练数据从哪来?
NanoJev 的训练数据不依赖昂贵的人工标注,而是由一套自写游戏生成器合成:
- 程序真值路径:几何规则、游戏引擎直接算出精确标签("北边有墙 → 不可通行")。这条路径完全不需要任何外部 API。
- Jev 教师路径:用相同的输入去调用 TypeSafe 的 Jev API,获取软概率分布作为额外的监督信号。
数据按地图来源、规则族和模板分组拆分,避免数据泄漏。训练集和测试集使用完全不同的地图,确保评测的是泛化能力而不是记忆能力。
这种"合成数据 + 程序真值"的方式,使得 NanoJev 的训练成本极低------不需要人工标注,不需要海量 GPU 时间,一张 A100 就能完成全参数训练。
架构深度解剖:从 Qwen3-0.6B 到概率输出
现在让我们一层一层地拆开 NanoJev 的内部结构,看看它是如何从一个通用的语言模型变成一个精准的决策机器的。
第一层:骨干网络------Qwen3-0.6B-Base
NanoJev 选择了 Qwen3-0.6B-Base 作为骨干网络。这个选择有几个关键考量:
- d_model = 1024:隐藏层维度适中,既能捕获丰富的语义信息,又不会让决策头的训练变得困难
- 28 层 Transformer:足够深的网络来理解复杂的局部观察(5×5 的 ASCII 迷宫墙壁模式)
- GQA(分组查询注意力):Hq=16 个查询头,Hkv=8 个键值头,在效率和表达能力之间取得平衡
- 固定 RoPE 位置编码:不使用动态 NTK 缩放,确保共享前缀树中不同分支的位置编码一致
重要细节:NanoJev 使用的是 Qwen3Model(AutoModel),而不是 Qwen3ForCausalLM。区别在于后者会额外做一个词表大小的投影([B,N,1024] → [B,N,151936]),而 NanoJev 根本不需要这个投影------它不预测下一个 token,它预测决策概率。
第二层:Token 路径设计------每个决策的"身份证"
每个决策由三段 token 拼接而成:
[S_b] + [Q_bj] + [C_bjk + R]- S_b(状态段):包含全局格式前缀和当前状态的文本描述。对于迷宫任务,这就是 5×5 的 ASCII 局部视图
- Q_bj(问题段):包含问题类型、指令和判断标准。例如"判断北方向一步是否可通行"
- C_bjk + R(候选段 + 读出头) :包含当前候选的语义描述,加上一个固定的读出后缀(如
\nScore:)
分词有一个关键陷阱:tokenize(S) + tokenize(Q) + tokenize(C) 不一定等于 tokenize(S+Q+C),因为 BPE 合并会在边界处产生不同的 token。NanoJev 的解决方案是先分别分词各段,关闭自动添加特殊 token,然后显式拼接 token IDs。
第三层:树形注意力掩码------隔离与共享的精妙平衡
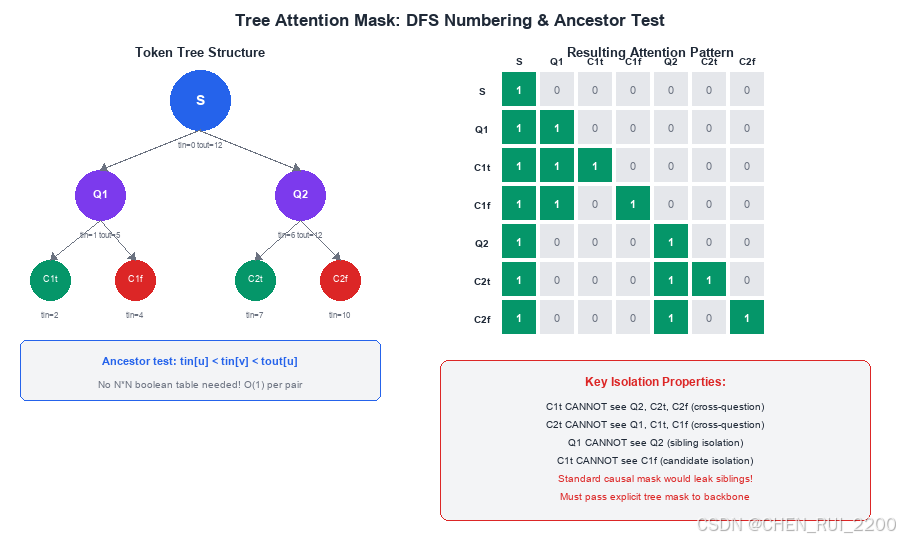
这是 NanoJev 架构中最精妙的部分。树形注意力掩码确保:
- 状态 token 只能看到状态前缀(因果关系)
- 问题 token 能看到完整状态 + 自己的问题前缀
- 候选 token 能看到完整状态 + 自己的问题 + 自己的候选前缀
- 不同问题的 token 之间互相看不到
- 不同状态的 token 之间互相看不到
实现方式是通过 DFS 编号的祖先测试:给每个树节点分配 tin 和 tout 编号,节点 u 是节点 v 的严格祖先当且仅当 tin[u] < tin[v] < tout[u]。这避免了存储 N×N 的布尔掩码矩阵。
第四层:三种决策头的后处理
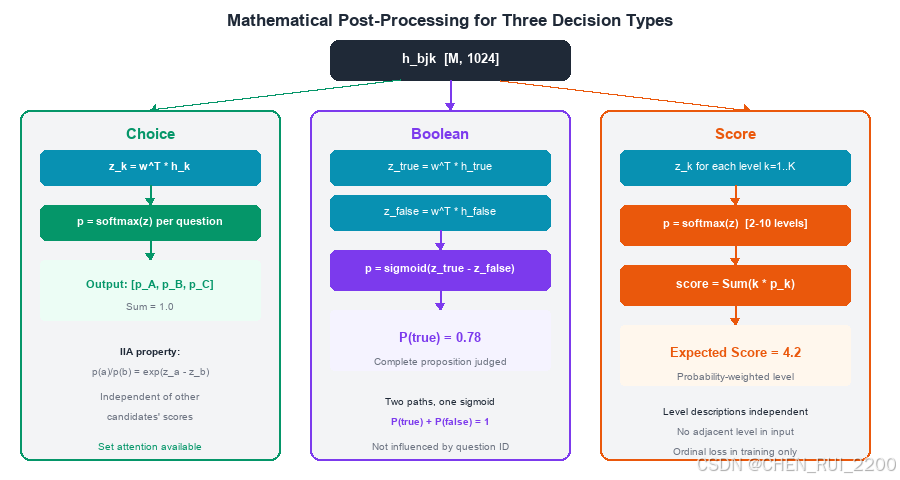
从骨干网络输出的隐藏状态 h_bjk 经过不同类型的后处理,产生三种决策:
Choice(多选一):
z_bjk = wᵀ · h_bjk    (共享标量头)
p_bj = softmax(z_bj) (按题独立归一化)Boolean(是/否判断):
p_true = sigmoid(z_true - z_false)用 true 和 false 两个候选的标量差值经过 sigmoid,直接得到命题为真的概率。
Score(有序评分):
p_j = softmax(z_j)           (等级分布)
score_j = Σ_k k × p_jk       (概率加权期望)
2-10 个有序等级,每个等级独立编码,最后返回概率加权的期望分数。
训练策略:从概率学习到校准决策
NanoJev 的训练不是简单地教模型"选对答案",而是教它诚实地报告概率。这里有一个深刻的洞察:如果你只奖励"选对",模型会倾向于把所有概率推向它认为最可能的选项,而不是如实反映不确定性。
概率学习的数学基础
假设事件的真实发生率为 70%,模型预测概率为 p。如果训练目标是最小化 Brier 分数(平方误差):
E[(p - Y)²] = 0.7(1-p)² + 0.3p² = (p - 0.7)² + 0.21最优值在 p = 0.7 处取得。这意味着 Brier 分数天然鼓励模型报告真实概率,而不是过度自信。
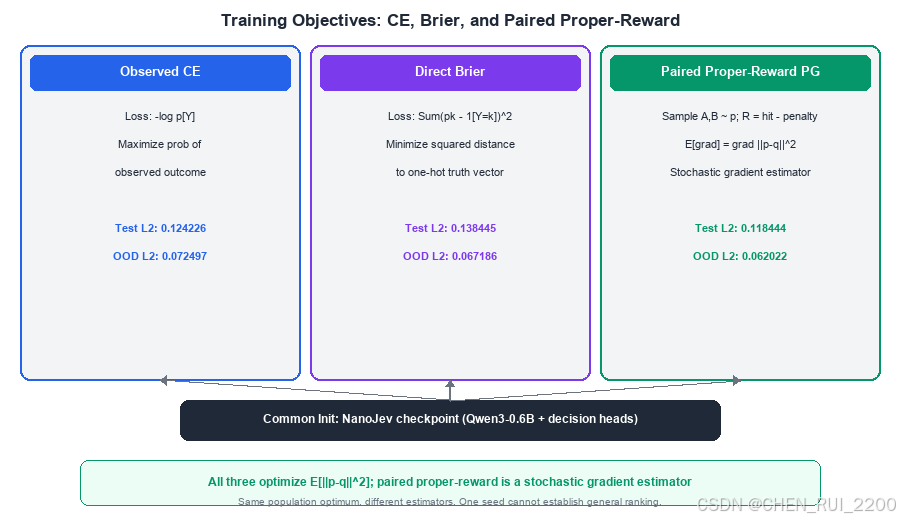
NanoJev 实现了三种训练目标的对照实验:
- 观测交叉熵(CE) :
-log p[Y],直接最大化观察到的结果的概率 - 直接 Brier :
Σ_k (p[k] - 1[Y=k])²,最小化预测分布与one-hot真值的平方距离 - 成对适当奖励(Paired Proper-Reward):一种基于采样的策略梯度方法
RLCD 思想:面向校准决策的强化学习
NanoJev 借鉴了 TypeSafe 提出的 RLCD(Reinforcement Learning for Calibrated Decisions) 思想。核心洞察是:一个"总是押对"的随机策略和一个"诚实报告概率"的模型,在正确的评分规则下有不同的最优行为。
如果只奖励正确性:
E[正确性奖励] = 0.7p + 0.3(1-p) = 0.3 + 0.4p这会把 p 推向 1------模型学会了"永远押 yes",但没有学到真实的 0.7。
成对适当奖励的巧妙之处在于:从预测分布中独立采样两个答案 A 和 B,然后定义奖励:
R = (2/M) Σᵢ 1[Aᵢ=Y] - Σₖ c[k](c[k]-1) / (M(M-1))第一项奖励"采样命中真值",第二项惩罚"重复采样同一候选"。期望值在 p=q(预测分布等于真实分布)时最优。
实验结果显示,在 Qwen3-0.6B 的事件概率学习任务上:
| 训练方法 | 测试集分布误差 | OOD分布误差 |
|---|---|---|
| 初始 NanoJev | 0.277078 | 0.319949 |
| 观测 CE | 0.124226 | 0.072497 |
| 直接 Brier | 0.138445 | 0.067186 |
| 成对适当奖励 | 0.118444 | 0.062022 |
成对适当奖励在两个指标上都取得了最低误差,证明了校准训练的有效性。
模型与代码的协奏曲:局部判断 + 全局规划
NanoJev 最聪明的设计决策之一是:不试图让模型做所有事情。它把任务清晰地分成两部分:
- 模型负责:局部感知判断("这个方向有没有墙?")------这是 System 1 式快思考
- 代码负责:全局路径规划、碰撞记忆、探索策略------这是 System 2 式慢思考
这种分工在 50×50 迷宫中体现得淋漓尽致:
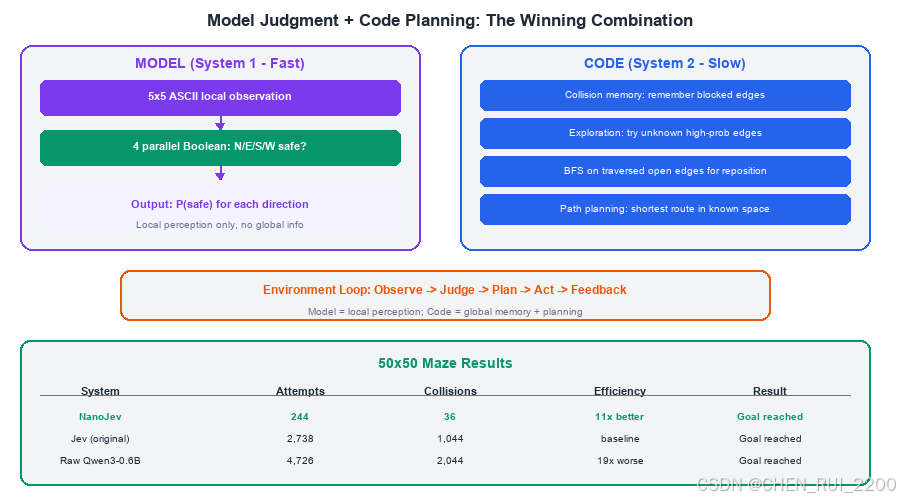
迷宫探索:244 步找到出口
在 50×50 的迷宫中,NanoJev 的表现:
| 系统 | 行动尝试 | 碰撞次数 | 结果 |
|---|---|---|---|
| NanoJev | 244 | 36 | 到达目标 |
| Jev(原版) | 2,738 | 1,044 | 到达目标 |
| 原始 Qwen3-0.6B | 4,726 | 2,044 | 到达目标 |
NanoJev 的效率是原版 Jev 的 11 倍 ,是原始 Qwen 的 19 倍。秘诀不在于模型更聪明,而在于代码帮它记住了哪些路走过、哪些墙撞过,避免了大量重复尝试。
贪吃蛇:27 个食物的生存之道
在 12×12 的贪吃蛇游戏中:
| 系统 | 吃到食物 | 步数 | 结果 |
|---|---|---|---|
| NanoJev | 27 | 256 | 存活到上限 |
| Jev | 30 | 256 | 存活到上限 |
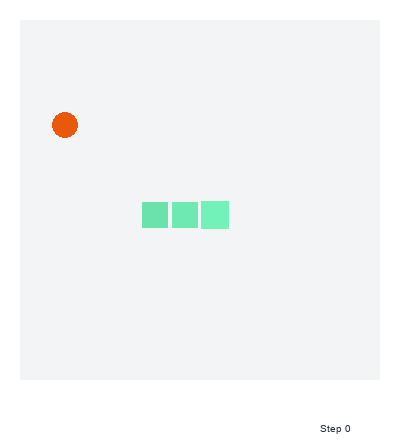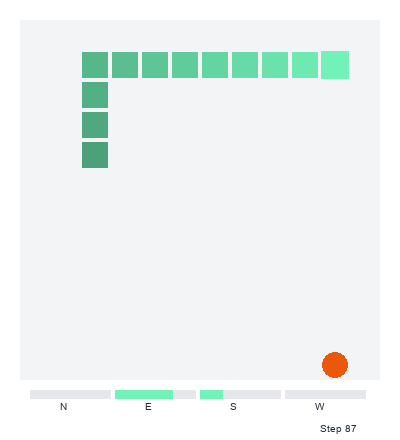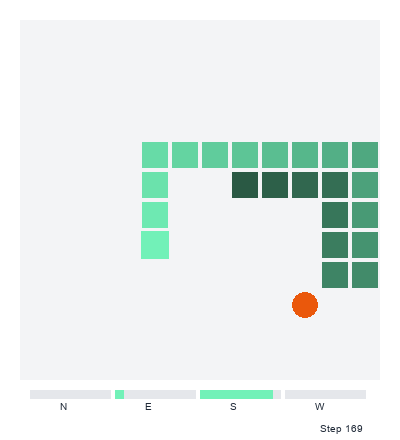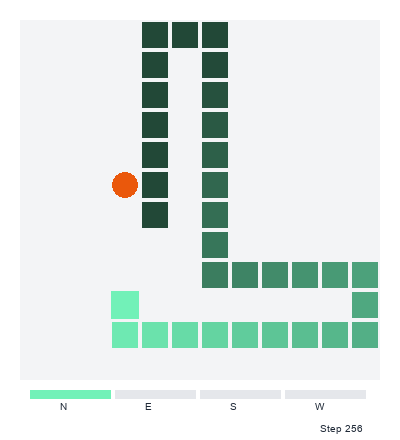
| 原始 Qwen3-0.6B | 25 | 211 | 陷入死局 |
共同规划器先排除立即碰撞的动作,再寻找通向食物的路径。模型在剩余候选之间做出选择。当只有一个候选时,代码直接执行,不浪费模型的计算资源。
40 图导航基准测试:小模型的大能量
在更早的 40 图导航基准测试中(20 张 4×4 测试地图 + 20 张 6×6 OOD 地图),NanoJev 的表现令人印象深刻:
| 模型 | 4×4 测试地图 | 6×6 OOD 地图 |
|---|---|---|
| NanoJev | 19/20 · 95% | 18/20 · 90% |
| Jev | 20/20 · 100% | 19/20 · 95% |
| 原始 Qwen3-0.6B | 7/20 · 35% | 3/20 · 15% |
一个 0.6B 的模型,在从未见过的 6×6 地图上达到了 90% 的成功率------而未经训练的原始 Qwen 只有 15%。这说明 NanoJev 学到的不是死记硬背的地图模式,而是可泛化的空间判断能力。
局部安全判断:77.84% 的准确率从何而来?
NanoJev 的局部安全模型在测试集上达到了 77.84% 的准确率 ,在 50×50 的 OOD 集上达到了 76.56%。这个数字是怎么来的?
训练数据来自 build_local_maze_data.py,它使用与推理完全相同的渲染器,从已有的迷宫快照中生成训练样本。每个样本包含:
- 一个 5×5 的 ASCII 局部视图
- 四个独立的 Boolean 问题(北/东/南/西各一步是否可通行)
- 来自几何规则的精确标签
关键设计决策:训练输入中不包含全局地图信息、最短路径、目标坐标。模型只学习"看局部、判安全"这一件事。全局规划完全交给代码。
数据集统计:300 个状态 / 1200 个问题(训练 576、开发 192、校准 192、测试 176、OOD 64)。
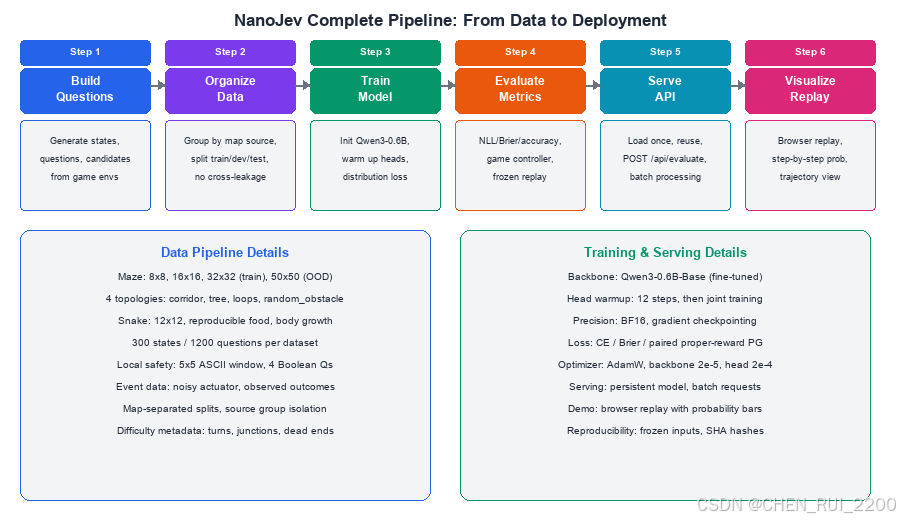
完整 Pipeline:从数据到部署的五步流程
第一步:构建问题
生成状态、问题、候选描述和目标分布。对于迷宫任务:
- 状态 = 5×5 ASCII 局部视图 + 坐标
- 问题 = "方向 X 一步是否可通行?"
- 候选 = {true, false}
- 目标 = 几何规则的精确计算结果
第二步:组织数据
相关地图、规则及其变体保留在同一分区。按地图来源分组,避免数据泄漏。支持 8×8、16×16、32×32 训练,50×50 作为 OOD 测试。
第三步:训练模型
初始化 Qwen3-0.6B,预热决策头(先只训练头部 12 步),再使用完整问题的分布损失联合训练。支持梯度检查点、BF16 精度、微批次 token 限制。
第四步:执行评测
测量概率质量(NLL、Brier、准确率)和任务性能(迷宫成功率、蛇食物数)。使用冻结的评测输入和独立轨迹回放核验。
第五步:服务与可视化
模型加载一次,通过 POST /api/evaluate 接受批量请求。浏览器端支持完整的轨迹回放,逐步展示每个决策的概率分布。
技术细节:那些决定成败的魔鬼
分词边界问题
BPE 分词器会在 token 边界处进行合并,这意味着 tokenize("hello") + tokenize("world") 可能不等于 tokenize("helloworld")。NanoJev 的解决方案是:先分别分词各段,关闭自动添加 BOS/EOS,然后显式拼接 token IDs。独立路径版和树版使用完全相同的段 token。
HF Transformers 的掩码陷阱
HuggingFace Transformers v5.17.0 在 attention_mask=None 时会根据 position ID 跳变推断 packed sequences 的掩码。树的兄弟分支会触发这种推断并切断应存在的祖先连接。因此必须显式传递树形掩码,不能依赖默认行为。
DynamicCache 的 fork 语义
推理时的 prefix KV 缓存不能简单地"共享"给多个分支。第一个子分支会追加 KV;如果把已追加的同一对象再给第二个兄弟,会发生污染。最保守的实现是克隆父缓存并按 batch 复制。
IIA 限制与集合头
独立的标量打分器满足 IIA(无关选项独立性):p(a)/p(b) = exp(z_a - z_b),新增候选不会改变原两项的相对 odds。这在某些任务上是限制------比如"选择最接近集合平均值的数字"------但可以通过添加集合注意力头来缓解。
实测展示
以下是从 NanoJev 的实际对局中截取的 GIF 动画,展示模型判断与代码规划的协同工作过程。每一帧都来自真实的模型推理记录和代码执行日志------不是模拟,不是动画预览,而是真实决策过程的逐帧回放。
在这些 GIF 中,你可以观察到几个关键现象:
- NanoJev 的概率条在变化:随着局部观察的变化,四个方向的概率实时调整。当模型看到墙壁时,对应方向的概率急剧下降;当看到开阔空间时,概率上升。
- 轨迹不是直线:模型引导的探索不是贪心的最短路径,而是带有探索性质的------它会尝试概率较高但尚未验证的方向,失败后再回头。
- 碰撞后快速修正:当发生碰撞时,代码记住这条边被阻塞,后续决策会避开它。模型的概率可能在碰撞后仍然偏高(因为它只看到局部),但代码的记忆会覆盖这个判断。
- 三个系统的行为差异:NanoJev 路径紧凑高效,Jev 路径冗长但最终到达,原始 Qwen 则频繁撞墙、反复尝试已知阻塞的方向。
GIF 1:50×50 迷宫探索------NanoJev 的 244 步征途

GIF 2:50×50 迷宫探索------Jev 的 2738 步对比

GIF 3:50×50 迷宫探索------原始 Qwen3-0.6B 的 4726 步挣扎

GIF 4:12×12 贪吃蛇------NanoJev 吃到 27 个食物
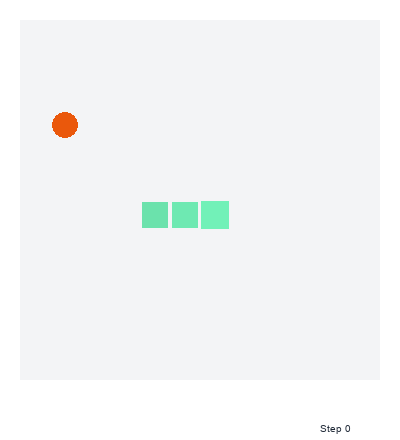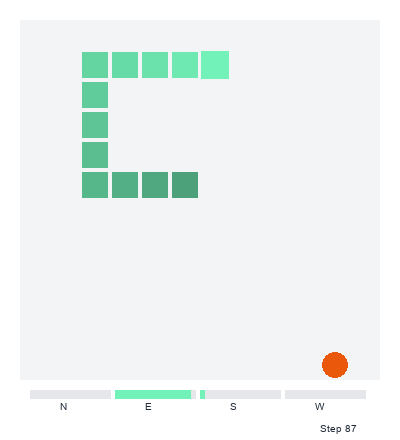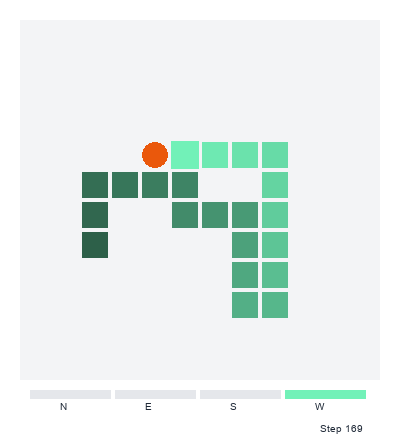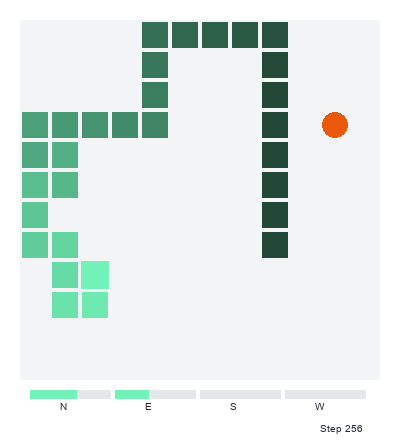
GIF 5:12×12 贪吃蛇------Jev 吃到 30 个食物
GIF 6:12×12 贪吃蛇------原始Qwen陷入死局
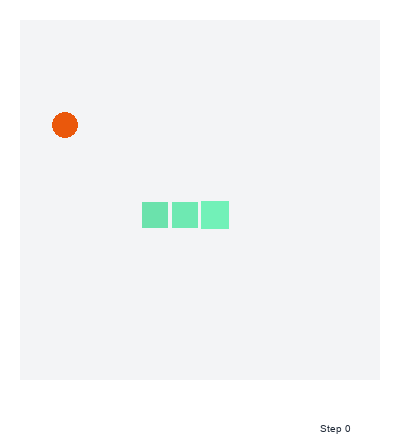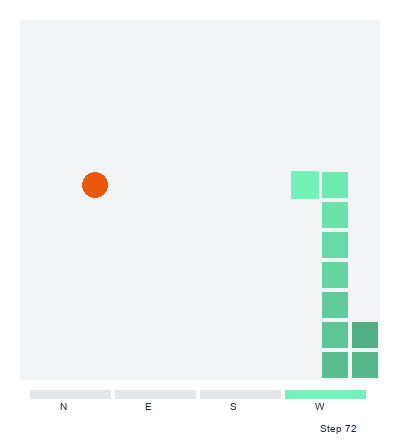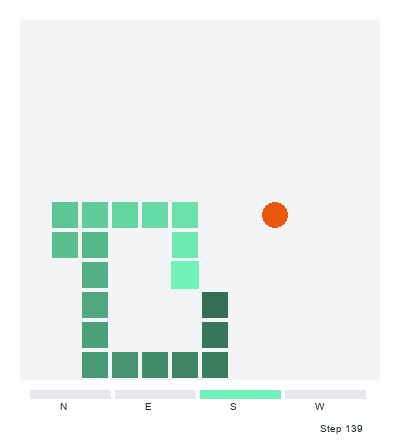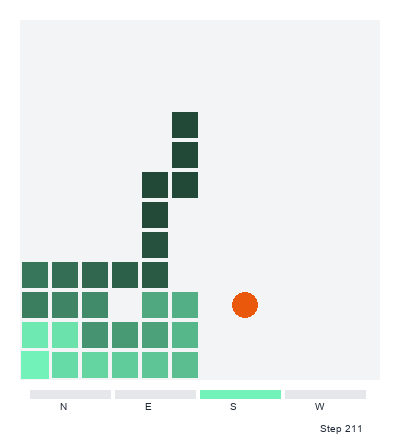
GIF 7:50×50 迷宫------Starting NanoJev(早期 checkpoint)

对比与思考:NanoJev 的位置
NanoJev 不是 Jev 的复刻品------它是一个独立开源设计,用可验证的方式探索了 Jev 论文中提出的核心理念:
- System 1 式决策:快速、并行、非自回归的概率判断
- 校准概率:80% 的概率意味着在大量类似情况下约 80% 会发生
- 代码规划:把精确计算、长链推理、全局记忆交给代码,模型只做它擅长的局部判断
NanoJev 的诚实之处在于它不声称自己做到了什么:
- 它不声称共享树必然比独立 batch 更快(在很多场景下确实更慢)
- 它不声称 0.6B 能达到 Jev 的语义判断质量
- 它不声称成对适当奖励一定优于 CE 或 Brier
- 它不声称小模型的校准概率可以替代大模型的推理能力
但它确实证明了:
- 一个 0.6B 的模型可以学会输出有意义的概率分布
- 局部判断 + 代码规划的组合可以解决 50×50 的复杂导航任务
- 零输出 token 解码的决策范式是可行的、高效的、可训练的
- 校准训练(Brier、proper-reward)确实能改善概率质量
深度解析:为什么共享前缀树不一定更快?
NanoJev 的文档中有一个非常诚实的讨论:共享前缀树在理论上减少了重复计算,但在实际中不一定比独立 batch 更快。这个洞察值得我们深入理解。
成本模型分析
设 s_b 为状态 token 数,q_bj 为问题 token 数,c_bjk 为候选 token 数。独立展开和树形处理的总 token 数分别是:
T_flat = Σ_bjk (s_b + q_bj + c_bjk)    # 每个候选都重复编码整个状态+问题
T_tree = Σ_b s_b + Σ_bj q_bj + Σ_bjk c_bjk   # 状态和问题只编码一次
看起来 T_tree 远小于 T_flat,但 attention 的计算成本不是简单地随 token 数线性增长。每层每个 query head 的有效注意力边数为:
E_flat = Σ_bjk L_bjk × (L_bjk + 1) / 2    # 每条路径独立的因果注意力
E_tree = Σ_b s_b(s_b+1)/2 + Σ_bj [s_b×q_bj + q_bj(q_bj+1)/2] + ...关键问题在于:当很多短前缀和长候选聚成一棵巨树时,兄弟分支之间被屏蔽的笛卡尔积甚至可能使密集树比独立 batch 更慢。因为虽然兄弟之间不能互相看到,但 attention 计算仍然需要遍历这些被屏蔽的位置------只是把结果乘以零而已。
真正的加速需要稀疏注意力 kernel(如 FlexAttention)跳过整个被屏蔽的块。但在 PyTorch 2.14.0 中,FlexAttention 仍然标记为 prototype,且 CPU/MPS 不支持反向传播。
实际测量建议
NanoJev 建议分别记录以下指标:
- Tokenization 时间
- Mask/BlockMask 创建时间
- 编译时间(FlexAttention 首次编译开销大)
- Prefill 时间
- 分支前向时间
- 归一化时间
- 端到端时延与峰值显存
而且吞吐必须按状态数、问题数、候选数三种单位分别报告,不能用"HTTP 并发数"来偷换概念。
IIA 限制:独立打分器的结构性盲区
NanoJev 的 Choice 决策头使用独立标量打分器加 softmax,这带来了一个有趣的结构性限制------无关选项独立性(IIA)。
什么是 IIA?
独立标量打分器满足:p(a)/p(b) = exp(z_a - z_b)。这意味着新增一个候选 c,不会改变 a 和 b 之间的相对几率。这在很多场景下是合理的------如果你认为"北边比东边好",那么加入"南边"作为选项不应该改变这个判断。
IIA 什么时候会失败?
考虑这样一个任务:选择候选集合中最接近其平均值的数字。
- 候选集
{0, 4, 5}:平均值 = 3,最接近的是 4 - 候选集
{0, 4, 5, 100}:平均值 = 27.25,最接近的是 5
如果 h_4 和 h_5 都不读取候选集的整体信息,那么 4 和 5 的相对排序就无法翻转。这是结构性的限制,与 softmax 温度或训练数据量无关。
可能的修复方案
NanoJev 提出了三种修复思路:
- 把完整候选集写进问题文本 Q:仍然共享 S/Q 前缀,可以学习集合关系;但 Q 长度变为包含所有候选,且文本顺序引入偏差
- 基于候选 hidden 的集合头 :
u = mean_k φ(h_k),z_k = ψ([h_k, u, log K]);保留主干共享和置换等变性------这是推荐的第二结构 - 代码处理精确集合规则:对排序、均值等可执行规则零歧义------与模型判断组合,避免强迫模型做精确计算
这种诚实的局限性讨论在开源项目中是难得的。NanoJev 没有声称自己解决了所有问题,而是清楚地标记了能力边界。
概率学习的深层直觉:为什么"只奖励正确"不够?
这是 NanoJev 训练策略中最深刻的洞察之一,值得用一个简单的数学例子来说明。
场景设定
假设你看到一个迷宫状态,事件("北边可通行")的真实概率是 70%。你的模型需要输出一个概率 p。
方案 A:只奖励"猜对"
如果训练目标是"猜对就给奖励":
E[正确性奖励] = 0.7 × p + 0.3 × (1-p) = 0.3 + 0.4p这个期望在 p=1 时最大。模型学会了永远说"是"------它在 70% 的情况下猜对了,获得了 0.7 的奖励。但它没有学到真实的 0.7。
这就是为什么纯 accuracy 训练不能产生校准概率。模型会变成一个过度自信的赌徒------永远押最可能的选项,而不是诚实地报告不确定性。
方案 B:Brier 分数(平方误差)
E[(p - Y)²] = 0.7 × (1-p)² + 0.3 × p²
            = (p - 0.7)² + 0.21
这个期望在 p=0.7 时最小。Brier 分数天然鼓励模型报告真实概率------不多不少。这就是**适当评分规则(proper scoring rule)**的魔力。
方案 C:成对适当奖励
NanoJev 的创新在于用采样来估计同一个目标:
- 从预测分布 p 中独立采样 M 个答案
- 计算"命中真值"的奖励
- 减去"重复采样同一候选"的惩罚
- 期望值在 p=q 时最优
这种方法的优雅之处在于:它不需要知道真实的 q,只需要观察到的结果 Y。这使得它可以用于在线学习------模型在与环境交互的过程中,仅凭观察到的结果就能逐步改善概率校准。
工程实践中的坑:那些论文不会告诉你的事
NanoJev 的文档记录了多个在实际实现中遇到的工程陷阱,这些经验对于任何想在 HuggingFace Transformers 上做非标准前向传播的人都极有价值。
坑 1:HF 的默认掩码推断会破坏树注意力
Transformers v5.17.0 在 attention_mask=None 时,会根据 position ID 的跳变来推断 packed sequences 的掩码。在树形结构中,兄弟分支的 position ID 可能产生跳变,导致 HF 自动切断本应存在的祖先连接。
解决方案:永远显式传递树形掩码,不要依赖默认行为。
坑 2:DynamicCache 不是为训练设计的
HF 的 DynamicCache 是一个可变容器,不提供自动的 fork/copy-on-write 语义。第一个子分支会追加 KV;如果你把已经追加过的同一个缓存对象再给第二个兄弟分支,就会发生 KV 污染。
解决方案 :训练时使用 use_cache=False,保留完整的计算图。推理时如果需要 prefix KV 共享,必须保守地克隆父缓存。
坑 3:分词边界会破坏共同前缀
BPE 分词器会在 token 边界处进行合并。tokenize("hello") + tokenize("world") 可能不等于 tokenize("helloworld"),因为后者可能在 "ow" 处产生一个新的合并 token。
解决方案:先分别分词各段,关闭自动添加 BOS/EOS,然后显式拼接 token IDs。独立路径版和树版必须使用完全相同的段 token 拼接方式。
坑 4:FlexAttention 的成熟度限制
PyTorch 2.14.0 的 FlexAttention 仍然标记为 prototype:
- CPU/MPS 不支持反向传播(训练只能在 CUDA 上)
- 对 attention dropout > 0 直接报错
- 大块遇到短候选时可能产生大量 partial block,吞掉理论加速
解决方案:先用 eager/SDPA 验证正确性,再尝试 FlexAttention 做效率优化。
对比实验的启示:小模型能走多远?
NanoJev 的实验设计有一个值得学习的地方:它不是简单地报告"我的模型最好",而是系统地比较了多个维度。
局部判断 vs 全局规划
实验清楚地表明:
- 纯模型直接行动(不做代码规划):无法在 128 步内解决任何迷宫
- 模型判断 + 代码规划:244 步解决 50×50 迷宫
- 纯代码(BFS 最短路径):16/24/96 步解决(但需要完整地图信息)
这说明模型的价值不在于替代算法,而在于为算法提供局部感知能力。当全局地图未知时,模型能告诉规划器"这个方向大概率是安全的",让规划器做出更明智的探索决策。
校准训练的实际收益
在事件概率学习任务上,经过校准训练的模型(无论是 CE、Brier 还是 proper-reward)都比初始 checkpoint 有显著改善:
- 初始 NanoJev 测试集分布误差:0.277
- 最佳训练后(proper-reward):0.118
这说明概率校准不是训练完成就自然获得的属性,它需要专门的目标函数和数据来培养。
OOD 泛化的边界
有趣的是,在某些指标上 OOD 表现甚至比测试集更好(分布误差更低),而在另一些指标上则更差。这提醒我们:OOD 泛化不是一个单一维度的概念,不同的能力维度可能有不同的泛化曲线。
从 NanoJev 看 System 1 模型的未来
NanoJev 的意义不仅在于它实现了一个 0.6B 的决策模型,更在于它验证了一种架构范式:保留预训练语言模型的语义理解能力,但用专门的决策头替代自回归生成输出。
这种范式的核心假设是:预训练已经赋予了模型足够的语义理解能力,问题在于如何把这些能力"导出"为结构化的决策。这就像一个人已经学会了阅读和理解地图,现在需要的是给他一支笔来标记路线,而不是让他把整个地图重新抄写一遍。
与其他方法的对比
| 方法 | 输出方式 | 速度 | 概率校准 | 动态候选 |
|---|---|---|---|---|
| 自回归 LLM | 逐 token 生成文本 | 慢 | 差 | 需要提示工程 |
| 传统分类器 | 固定类别 logits | 快 | 需专门训练 | 不支持 |
| GLiClass | 原型匹配 + 分类 | 快 | 中等 | 支持 |
| NanoJev | 共享骨干 + 标量头 | 快 | 好 | 支持 |
NanoJev 与 GLiClass 的关键区别在于:GLiClass 使用原型匹配(prototype matching),而 NanoJev 使用完整的 Transformer 前向传播来理解每个候选的语义。这意味着 NanoJev 可以处理更复杂的候选描述------不仅仅是类别名称,而是包含上下文和条件的完整命题。
局限性与未来方向
NanoJev 诚实地列出了自己的局限:
- 精确计算能力弱:模型不擅长数学运算、日期比较等需要精确推理的任务。这些应该交给代码。
- 长链推理不支持:模型做的是单步局部判断,多步推理需要代码来组合。
- 语义判断质量有上限:0.6B 的模型不可能达到 GPT-4 级别的语义理解。
- IIA 限制:独立打分器无法处理依赖候选集合的任务。
未来的方向包括:
- 扩展 RLCD 到更多语义任务
- 添加结构化输入支持(JSON、表格等)
- 探索更大的骨干网络
- 改进集合注意力机制
写在最后:决策智能的另一条路
NanoJev 给我们展示了一种可能性:不是所有智能都需要"说话"。当我们把大语言模型从"生成文本"的框架中解放出来,给它一个直接表达判断的出口,它可以用极小的体量完成令人惊讶的决策任务。
这并不意味着 LLM 的自回归生成没有价值------复杂的推理、创造性的写作、多步的规划仍然需要逐字生成的过程。但对于那些需要快速、并行、校准概率判断的场景------路由决策、风险评估、游戏策略、实时控制------NanoJev 式的"直觉判断"可能是一条更高效的路径。
0.6B 参数,一次前向传播,完整的概率分布。这就是 NanoJev 的答案:不说话,直接做判断。
项目地址:GitHub - NanoJev
模型下载:HuggingFace - C-Tianyu/NanoJev