看似普通的元素的背后
1、你不知道的<a>元素
只要是做过Web开发的,没有人不知道<a>元素,链接跳转嘛,太常用了,简单,想要跳转到某个页面,使用href属性;想要新窗口打开目标页面,再设置target="_blank"就可以了。就像下面这样:
html
<a href="/" target="_blank">首页</a>结束了,这就是<a>元素的全部,很多人都会有这样的想法。但真的如此吗?
1.1、rel属性知多少
<a>元素支持一个名为rel的属性,rel由简简单单三个字母构成,看起来其貌不扬,但它其实是个大家族,包含各种各样的功能和作用。
其支持的属性值参见下表,总共有30多个。
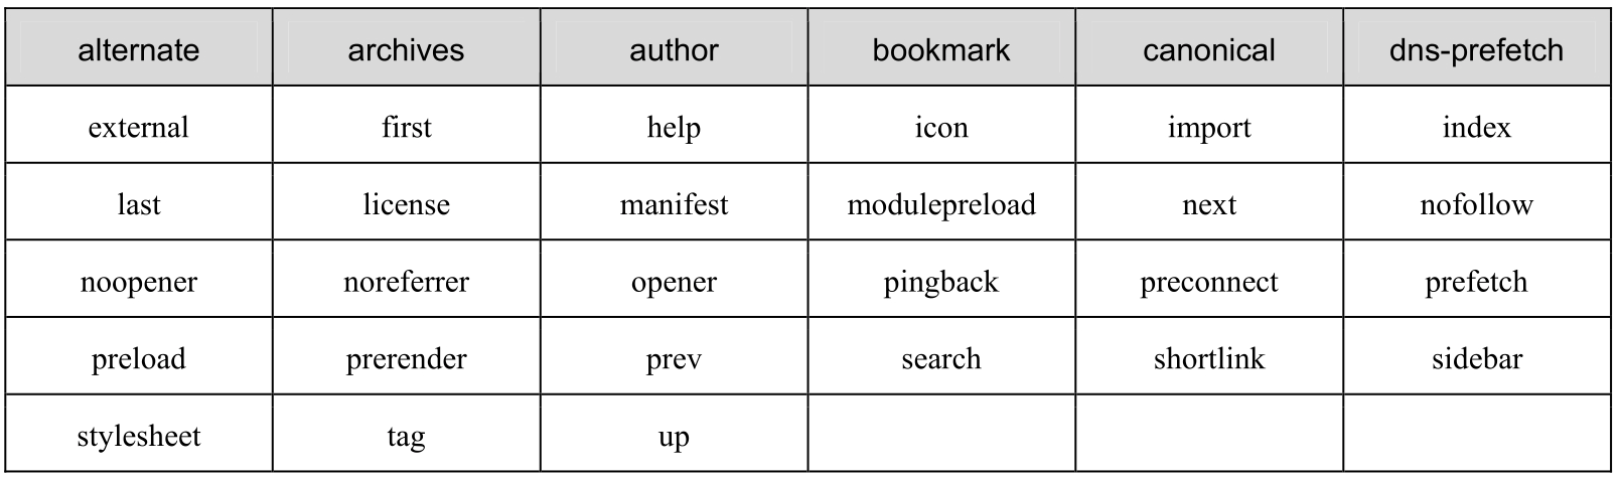
每一个rel属性值都对应一个Web应用场景,比如资源的预加载、网站图片和样式的显示等。
对于<a>元素,我们需要重点关注如下几个值。
- nofollow
- noopener和opener
- noreferrer
1.1.1、rel="nofollow"
给链接元素设置rel="nofollow"是SEO中的常用策略,用来告诉搜索引擎不要追踪这个链接。
在以下两种情况下需要设置rel="nofollow":
- 目标页面显示的均是无效信息,或者含有敏感信息;
- 目标页面属于外站,不希望共享权重。
前者好理解,那么后者是什么意思呢?
SEO中有个策略,如果一个权重很高的网站,直接外链一个权重不高的中小网站,同时没有设置rel="nofollow",那么这个中小网站的权重有一定的概率会被提高。
注意,是有一定的概率被提高,而并非一定,因为搜索引擎的权重策略是保密且动态调整的。以谷歌为例,在过去,页面的权重只会分配给允许跟踪的链接,但是现在谷歌使用了一种更为复杂的分配规则,即使某个链接设置了不允许跟踪,也有可能会有一定的权重分配。
因此,大型网站,尤其是新闻、问答或社区类的网站,通常会对外链设置rel="nofollow",以防止权重被外泄。
过去,这是前端开发中的常识,而如今却是冷知识,知者甚少。
一方面是因为前端知识图谱更广了,从业者学习的精力有限,无暇顾及这部分内容;另一方面是产品形态更加多样化,例如移动端产品、工具类产品是不需要SEO知识的;当然,还有一部分原因是,这些知识的匮乏对业务收益的影响是不可见的,或者可以通过其他策略规避因开发人员不懂rel="nofollow"给产品带来的损失。
比如,将所有的外链都换成本站地址并进行中转,A网站外链了B网站,则可以专门申请一个域名,例如link.aaa.com,然后将所有外链都换成这个域名。假设原来的链接是https://www.bbb.com/xxx,现在就可以换成https://link.aaa.com?target=https://www.bbb.com/xxx,这样就可以避免权重被外泄,同时也可以统计外链的点击量。
1.1.2、rel="noopener"与rel="opener"
例如,有这样一个需求场景,主页面有一个"登录"按钮,点击后会开启一个新窗口进行登录,现在希望用户登录成功后,主页面自动刷新,该如何实现?
有人会想到使用visibilitychange事件。
js
document.addEventListener('visibilitychange', function() {
    if (document.visibilityState === 'visible') {
        //检测是否登录成功
    }
})
也有人会使用postMessage实现跨页面通信。
但这两种方法,要么有运行冗余外加执行时机滞后的问题,要么学习成本高,上手不易。
那有没有执行时机精准,同时又能轻松实现的方法呢?
有,只需要给链接元素设置rel="opener"即可,例如:
bash
<a href="/login.html" target="_blank" rel="opener">登录</a>此时,只需要在登录成功后,执行下面的JavaScript代码就可以了:
js
window.opener.location.reload();这里的window.operer就是主页面的全局window对象。
是不是简单得超出想象?仅仅通过一个其貌不扬的HTML属性设置,就让原本两个独立的浏览器窗口有效通信。
然而,window对象的权限太高了,不仅挂载在window对象上的属性和方法可以被执行,任何document对象的属性和方法也可以被执行,因为document对象可以通过window.document访问。
这其实非常危险,有安全隐患,比如会被恶意修改主页面的内容,或者被人通过window.opener.document.cookie获取用户的敏感信息并进行身份伪造等。
1.1.3、rel="noreferrer"
要想了解rel="noreferrer"的作用,就必须先了解document.referrer这个API。
document.referrer可以返回当前页面的来源地址。如果用户直接在浏览器的地址栏输入URL地址进行访问,或者通过设置了rel="noreferrer"的链接元素访问,那么document.referrer就会是空字符串。
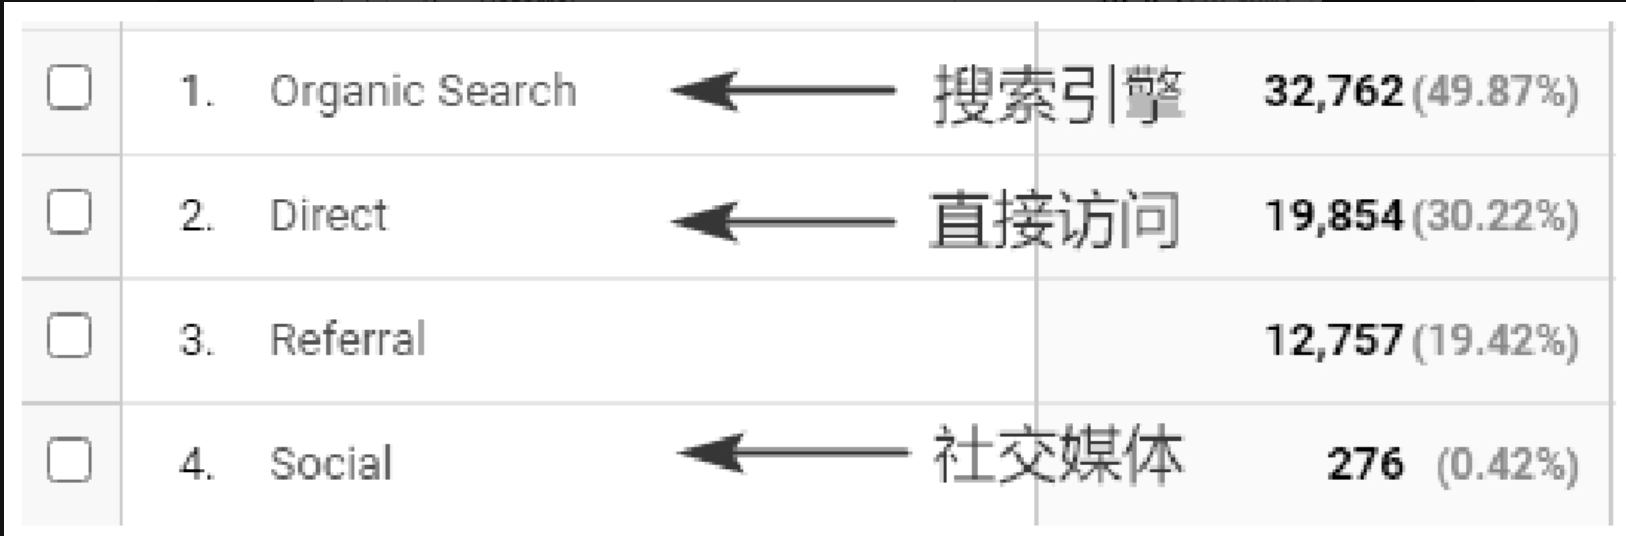
所有知名的网站分析工具,如百度统计和谷歌分析,都是通过document.referrer来判断多少PV(页面访问量)来自搜索引擎,多少PV来自社交媒体,以及多少PV来自直接访问的。下图所示的就是某流量分析工具中各种流量来源对应的名称。
当然,我们也可以借用document.referrer来完成一些日常开发任务,都是与细节体验相关的。
举两个例子。
- 例一,在移动端开发中,页面左上角往往会有一个"返回"按钮,但如果用户是通过点击某个分享链接进入的,那么这个返回的逻辑就不对,因为并没有上一页,此时这个"返回"按钮显示为"主页"按钮更合适。此时,我们就可以使用document.referrer来优化此细节,如果document.referrer是空字符串,则点击左上角的按钮会回到首页;如果不是,则会返回上一页。
- 例二,在某列表页面,点击任意列表会进入详情页,然后希望再次返回(通过页面内链接,而非浏览器的"后退"按钮)到列表页的时候,页面依然定位在之前的滚动位置,但如果是从其他页面进入的,则滚动置顶。
有经验的前端开发人员应该遇到过类似的需求,我想,肯定有人通过在href地址上做文章来实现此需求,例如加标志量:
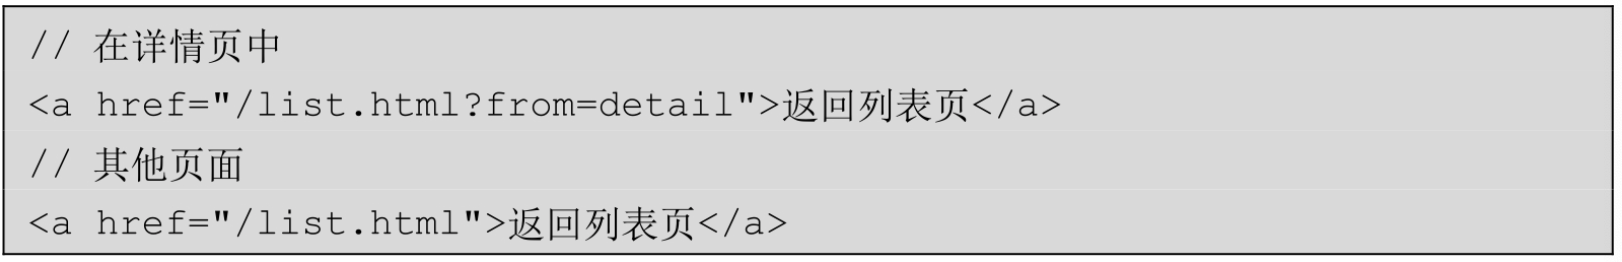
这也能满足需求,但不够优雅,何不直接使用浏览器自带的API呢?比如(假设详情页的地址是detail.html):
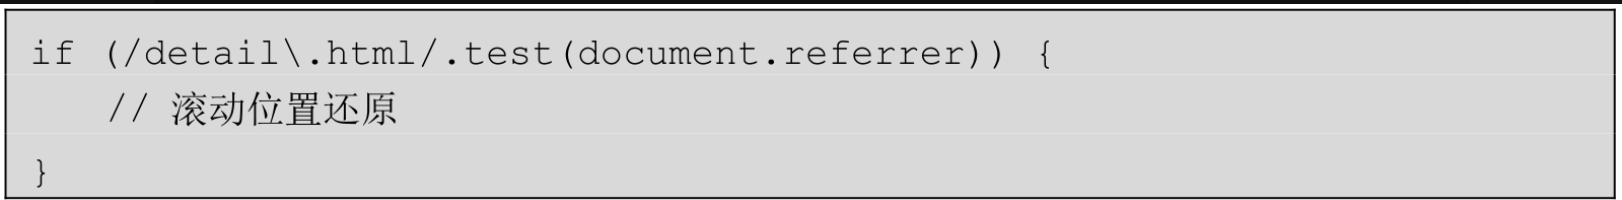
关于此需求,我专门做了个演示页面,可通过在浏览器中输入地址https://www.htmlapi.cn/2/1-2.html访问来体验。
可以看到,从详情页返回和从首页返回时的列表的滚动状态是不一样的,就是因为列表页使用document.referrer判断页面来源并做了不同的处理。
那么什么时候需要给链接设置rel="noreferrer"呢?
首先,可以肯定的是,对于所有的本站链接都不要设置rel="noreferrer",因为会影响用户访问路径的追踪,进而影响页面的流失率等数据的统计。
其次,对于外站链接,个人建议是,全部都设置rel="noreferrer",因为URL地址中也包含了大量的信息,甚至有隐私内容(如搜索结果落地页的URL会包含搜索关键词),泄露出去会增加不必要的风险。
由于对于外站链接必须设置rel="noopener",因此,我们会经常看到如下所示的HTML代码,也就是noopener和noreferrer值同时设置,彼此使用空格分隔:

再次,如果你的产品是社交媒体类的,例如微博、知乎等,那么可以不设置rel="noreferrer",因为这些产品本身是开放的,以社交为主,更看重信息的传播,暴露referrer信息反而有助于第三方网站溯源,可以间接增加访问量和热度。
上面两种说法好像有矛盾,难道社交网站就不担心隐私信息泄露了吗?隐私泄露对于用户也是不友好的,不是吗?
没错,你所忧虑的情况确实存在,rel="noreferrer"的确存在不足,其设置与否的效果就像是0和1,并没有折中的说法,也就是说,无法兼顾信息传播和隐私保护。
所以,各大浏览器开发商遵循规范指引,从2016年开始,陆续支持一个全新的关于referrer策略的HTML属性referrerpolicy,它可以让我们兼顾信息传播和隐私保护。
最后,虽然以下这个使用场景很少见,但确实存在,那就是链接地址直接是外部图片,而这个图片设置了防外链,此时,给链接元素设置rel="noreferrer"会有神奇的作用。
HTML代码示意:
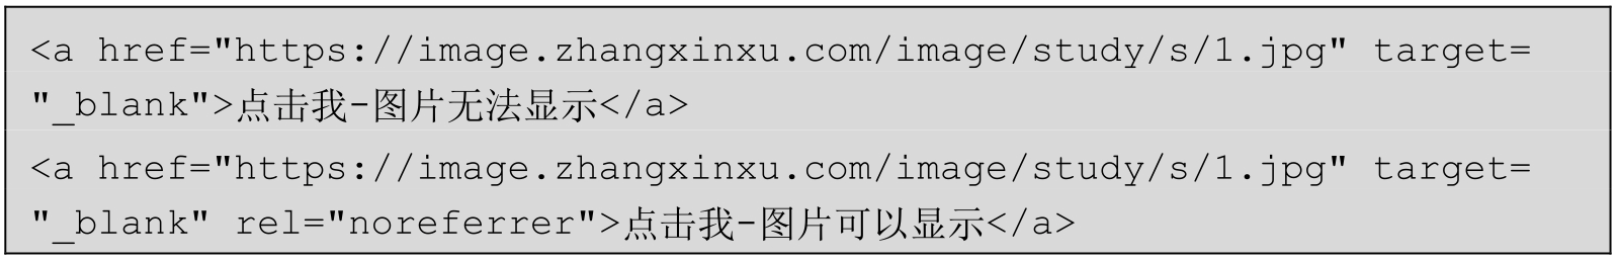
点击第一个链接,会发现图片无法显示,但是点击第二个链接,图片就可以显示了,如图所示。
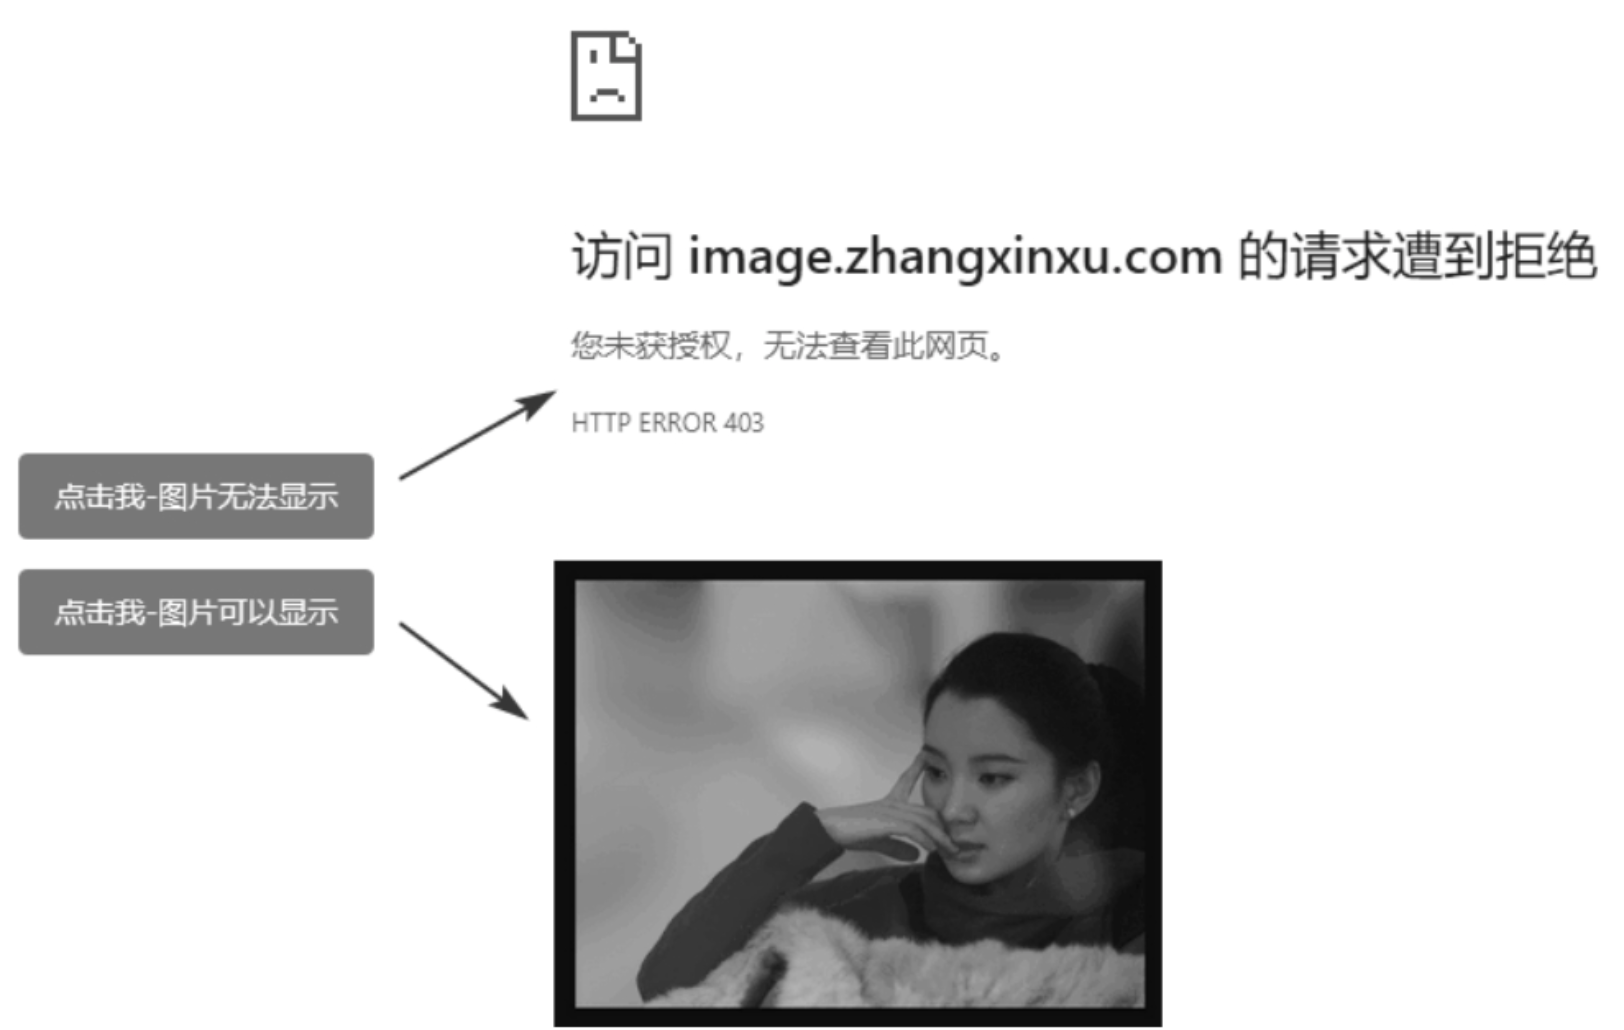
可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-3.html访问来体验对应的演示页面,需要注意的是,一旦图片被浏览器缓存,点击第一个链接依然可以显示,所以体验的时候,一定要先点击第一个链接,或者及时清空浏览器的缓存。
1.1.4、relList对象
前文出现过一段HTML属性设置,即rel="noopenernoreferrer",对于这种写法,不知道大家有没有觉得有些不自然或者有些特别。
如果你有这样的感觉,那就对了。
因为rel属性是所有HTML标准属性中为数不多的支持使用空格分隔多个值的HTML属性。另外一个常见的支持空格分隔的属性就是class属性,大家肯定都用过它,毕竟绝大多数的CSS样式都是使用类选择器进行匹配的。
rel属性和class属性不仅在HTML层面的语法上一致,在DOM API层面也是极其相似的。
比如,页面中有如下HTML元素:

我们可以使用名为classList的属性对类名进行增删操作,例如下面这行JavaScript代码就可以移除类名active。

同样,如果我们希望移除rel属性中的noreferrer,也使用类似的语法,只是属性名不再是classList,而是relList,示意如下。

无论是classList,还是relList,都有一个专门的接口,叫作DOMTokenList,支持如下属性和方法,上面演示的remove方法只是其中之一。
属性:
- DOMTokenList.length
- DOMTokenList.value
方法:
- DOMTokenList.item()
- DOMTokenList.contains()
- DOMTokenList.add()
- DOMTokenList.remove()
- DOMTokenList.replace()
- DOMTokenList.supports()
- DOMTokenList.toggle()
- DOMTokenList.entries()
- DOMTokenList.forEach()
- DOMTokenList.keys()
- DOMTokenList.values()
可见,rel属性要比很多人预想的要强大得多,具有其他HTML属性所没有的、独立的API。
1.2、你知道target的这个特性吗
在线写作工具经常会有预览功能,点击"预览"按钮后,可以在新窗口查看预览效果,例如知名的开源博客系统WordPress,对应的操作界面截图如图所示。
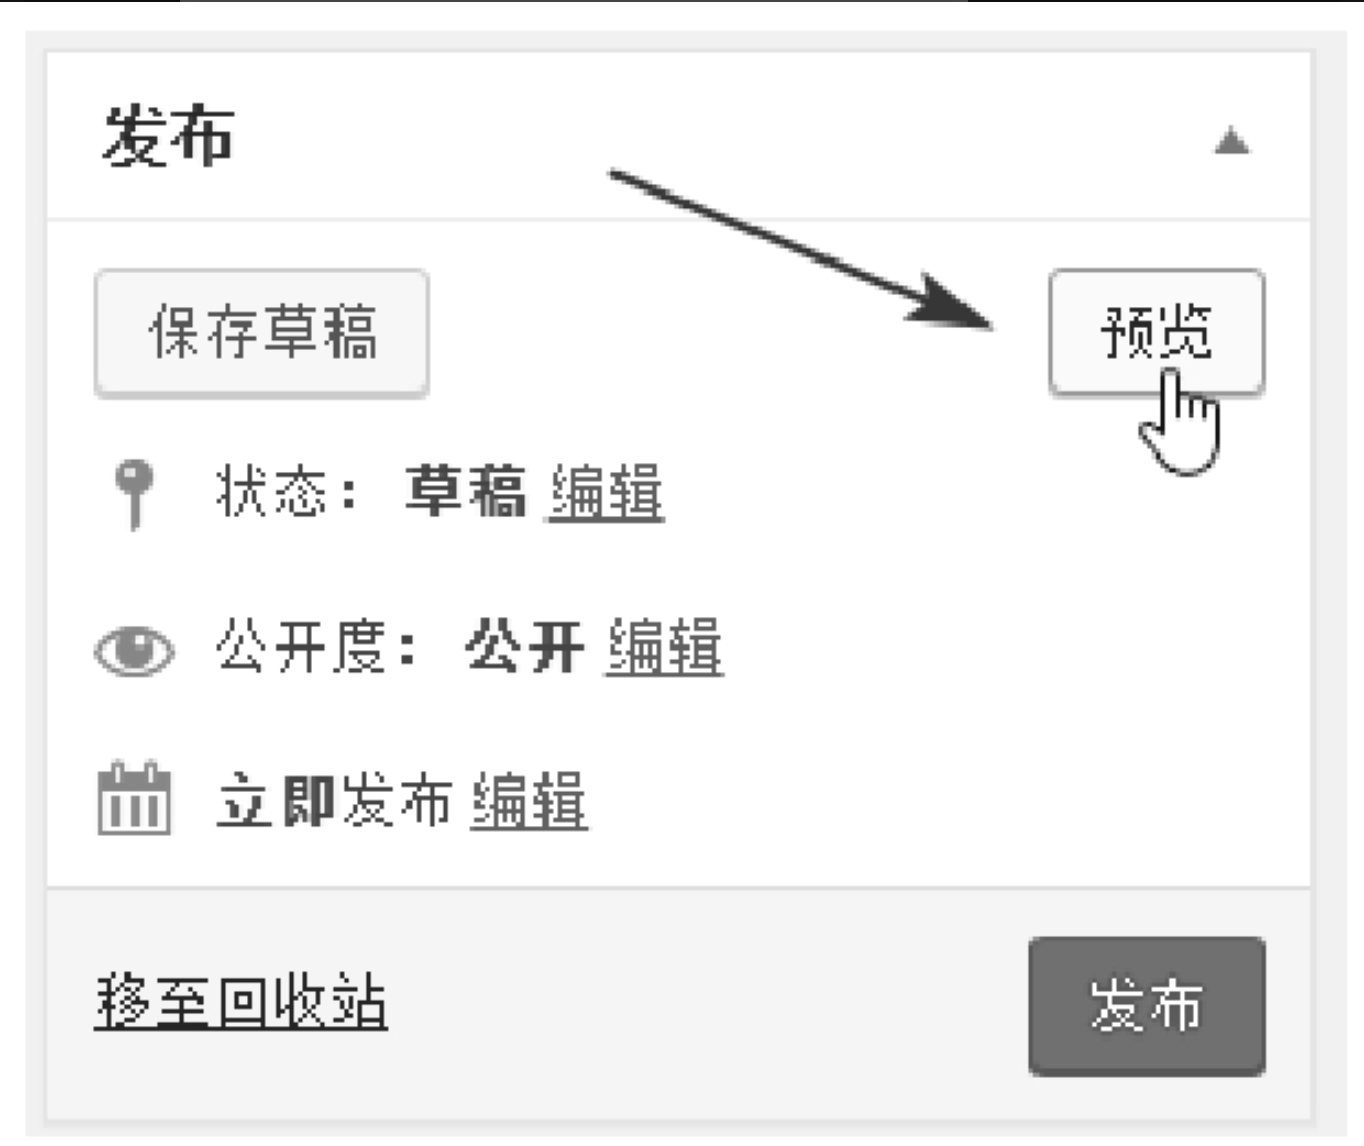
请问,你会如何实现这个预览效果?
很多人会通过以下方式实现:

这看似实现了新窗口打开的功能,但是有个问题,每次点击都会打开一个新窗口,而预览是会频繁操作的行为,那岂不是会打开多个网址重复的新窗口?
这显然会影响用户体验,试想一下,点击了5次"预览"按钮,结果浏览器出现了5个类似的预览页面,还能分清楚哪个预览页面是最新的吗?
所以,最好的效果应该是最多只打开一个新窗口,第二次点击"预览"按钮的时候,自动刷新这个新窗口。
那么,这种效果可以实现吗?可以,还是使用target属性即可。
在<a>元素中,只要target属性设为某个任意的固定值,则每次新窗口打开的时候,都只会在这个窗口创建,例如:

此时,预览只会在唯一的窗口中不断刷新,不会出现打开多个窗口的情况。
本书提供了演示页面给大家实际体验,在浏览器中输入地址https://www.htmlapi.cn/2/1-4.html访问即可。
可以看到,每次点击页面中的"预览"按钮(参见下图),都只会不断刷新之前已经打开的预览页面,而不会像target="_blank"那样每次都打开一个新窗口。
其他支持target属性的元素也有类似的特性,例如本书后面介绍的<form>元素。
1.3、实用的download属性
Web网页中有如下一段HTML代码,请问点击"案例图片"字样的链接后会有什么效果?

没错,会在新窗口打开一个图片并预览。
如果希望点击这个链接的行为不是预览图片,而是下载图片,该如何实现?
有人会想到使用FileSaver.js(业界知名客户端资源下载解决方案),此方法确实可以满足需求,却不是最佳实现方法。
其实,浏览器内置了对应的能力,那就是<a>元素专属的download属性,无须使用JavaScript即可实现图片资源的一键下载。
比如可以这样:

如果希望指定下载的图片名称,可以这样:
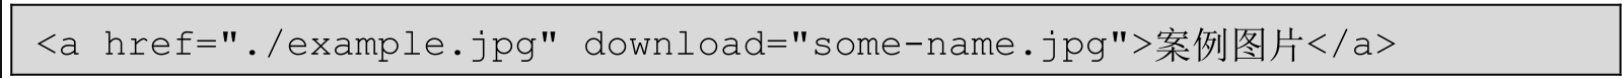
可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-5.html访问来体验上述效果。
需要注意的是,download属性并不是万能的,如果链接的资源跨域了,则无法触发下载,除非浏览器无法打开这个链接资源,在这种情况下,无论是否设置了download属性,都会触发下载行为。例如:
此时,点击"案例图片"字样的链接会直接下载example.zip文件,因为浏览器无法解析MIME Type是application/zip的文件。
于是就有人想利用此特性触发某些跨域文件的下载,例如:

在现代Web开发中,页面模板资源和静态资源都是分离的,属于不同的域名,也就是虽然资源跨域,但是配置的权限还在自己手中,所以就有人通过服务器配置,让PDF文件的header(头信息)中的Content-Type值是某个浏览器不认识的MIME Type类型的,而触发下载。
虽然也能达到效果,但感觉像在耍小聪明,其实更好的做法是配置Content-Disposition的值为attachment,Content-Type和原始文件保持一致即可。例如,在PHP语言中:

由于相关内容与本书关联不大,因此不做进一步展开。
1.4、看看ping属性的妙用
<a>元素还自带上报能力。只要设置了ping属性,当用户点击此链接元素的时候,浏览器就会自动发送一个POST请求给ping属性设置的地址。
例如,页面中有如下HTML代码:
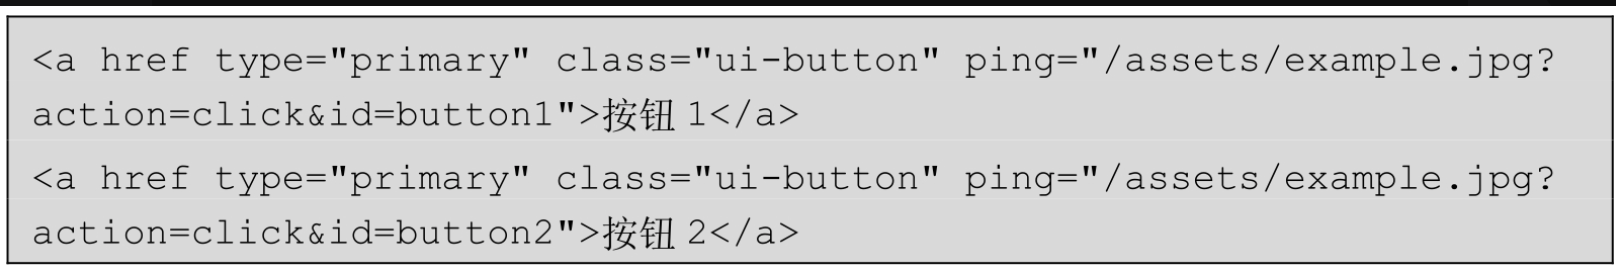
此时,点击"按钮1"和"按钮2",浏览器就会给'/assets/example.jpg?..'地址发送POST请求。
有专门的演示页面,可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-6.html访问来体验。
打开上述页面的控制台,切换到网络面板,然后点击页面中蓝色的按钮元素,如图所示。
此时就可以看到POST请求发出了,如图所示。
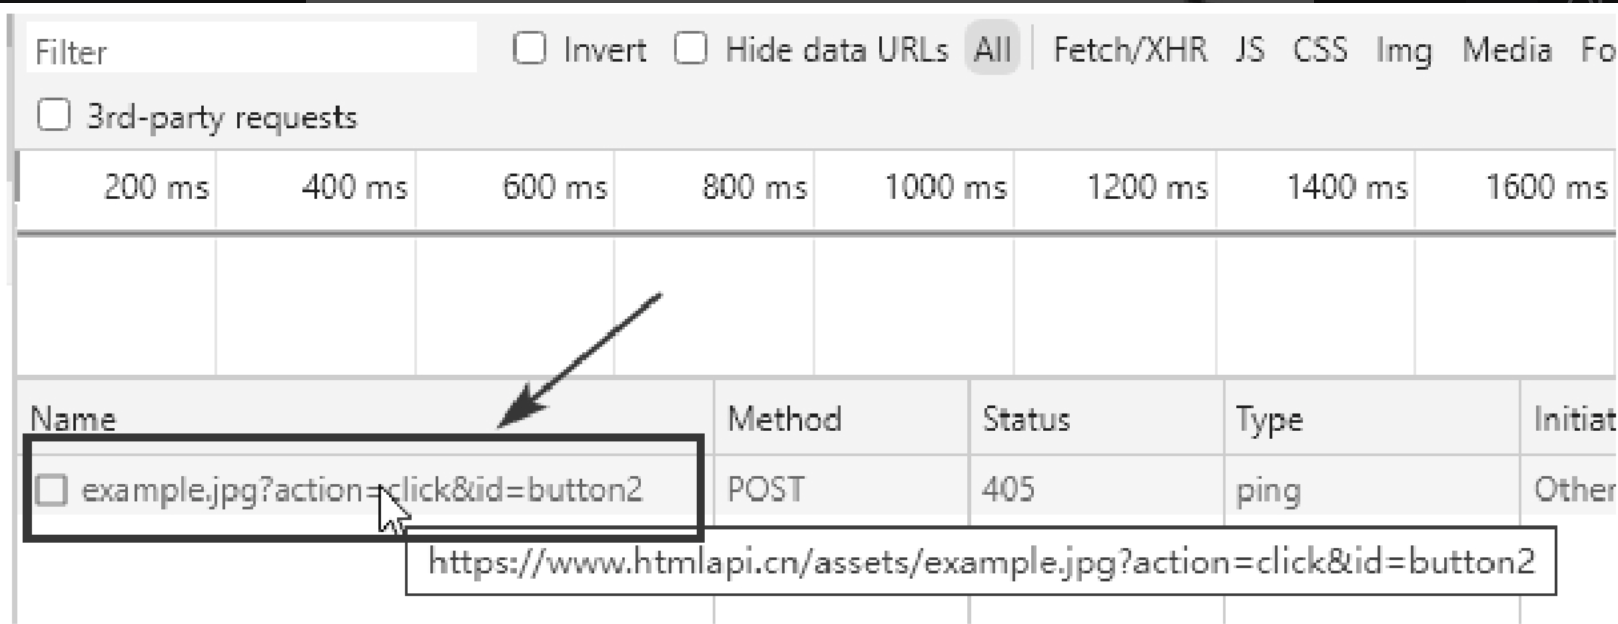
因为图片无法接收POST请求,所以被服务器阻止了,实际开发中肯定会使用一个专门接收POST数据的地址。
虽然请求被阻止,但是请求头信息依然可见,重点关注下图所示的高亮部分。
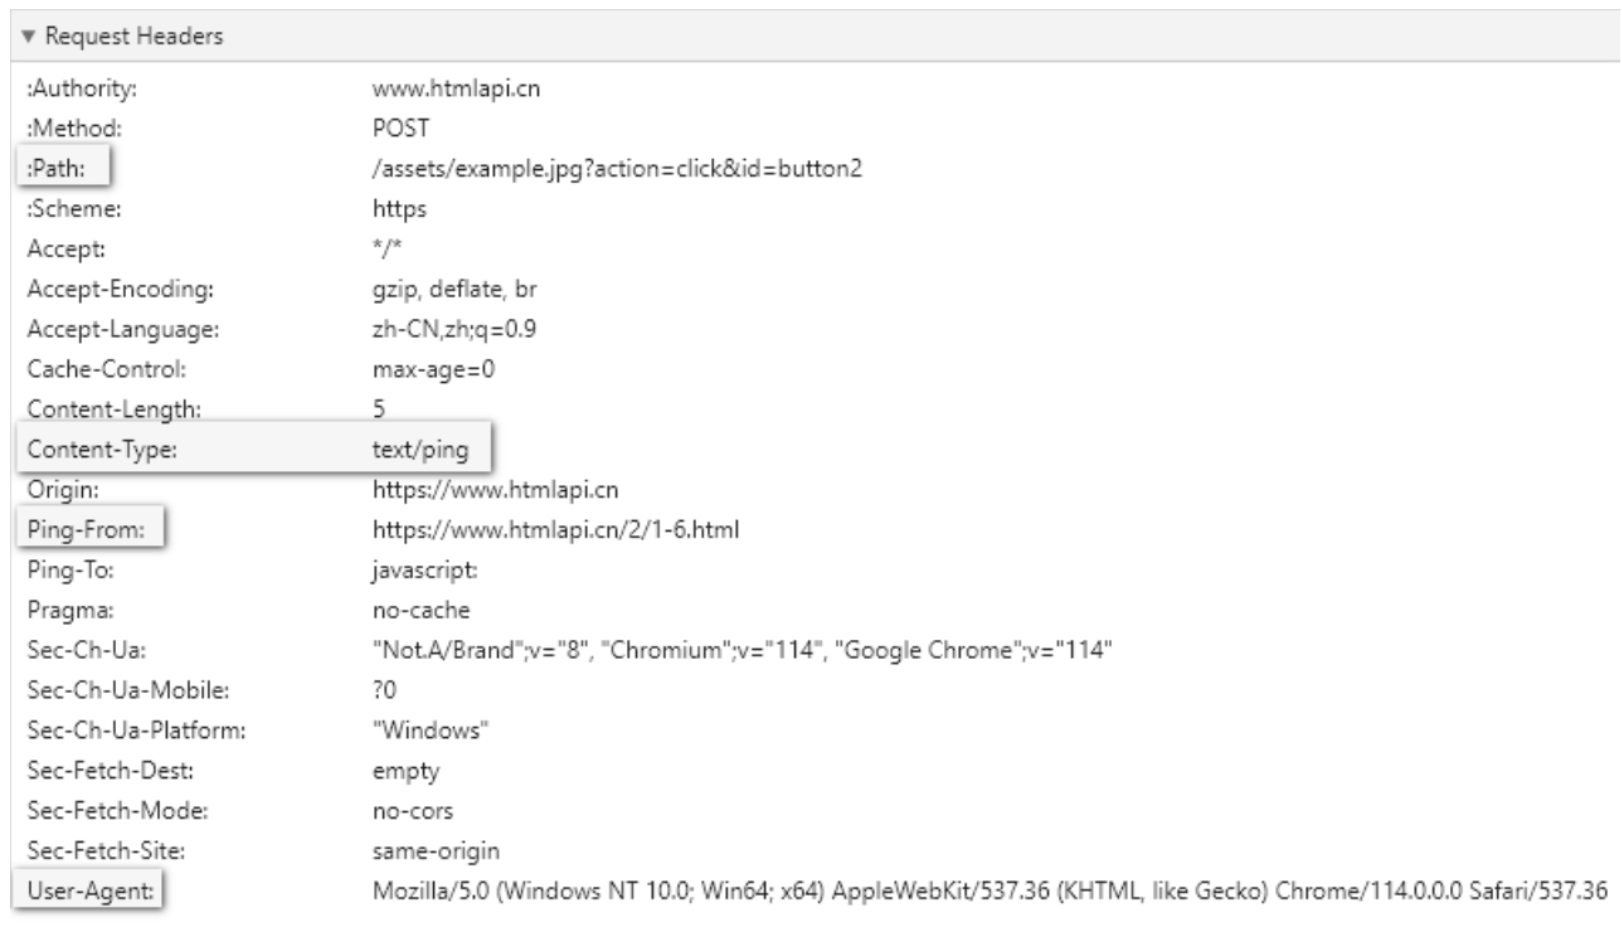
可以看到ping请求的content-type是text/ping,包含了用户的User-Agent、浏览器和操作系统信息、目标来源地址等信息,非常方便开发人员追踪收集的数据。
1.4.1、ping属性的优势
- 无须JavaScript代码参与,网页功能异常也能上报。
- 不受浏览器刷新、跳转或关闭的影响,也不会阻塞页面后续行为,这一点和navigator.sendBeacon()方法类似,可以保证数据上报的准确性。
- 支持跨域。

- 可上报大量数据,因为是POST请求。
- 语义明确,使用方便,灵活自主。
1.4.2、ping属性的劣势
- 只能支持点击行为的上报,如果是(重要元素)进入视区或者类似弹框显示的上报,则需要额外触发元素的click()行为。
- 只能支持<a>元素和<area>元素,在其他元素上设置ping属性没有作用,这就限制了其使用范围。
- 只能是POST请求,目前主流的数据统计还是基于日志中的GET请求,不能复用现有的数据采集与统计基建。
- "出身"不好,身为HTML属性,天然受某些开发者无视,难以得到有效传播。
- 属于新特性,IE浏览器并不支持。
1.4.3、适用的场景
ping属性上报有其独到之处,可以用在需要精确知道数据但不需要交互反馈的场景中。
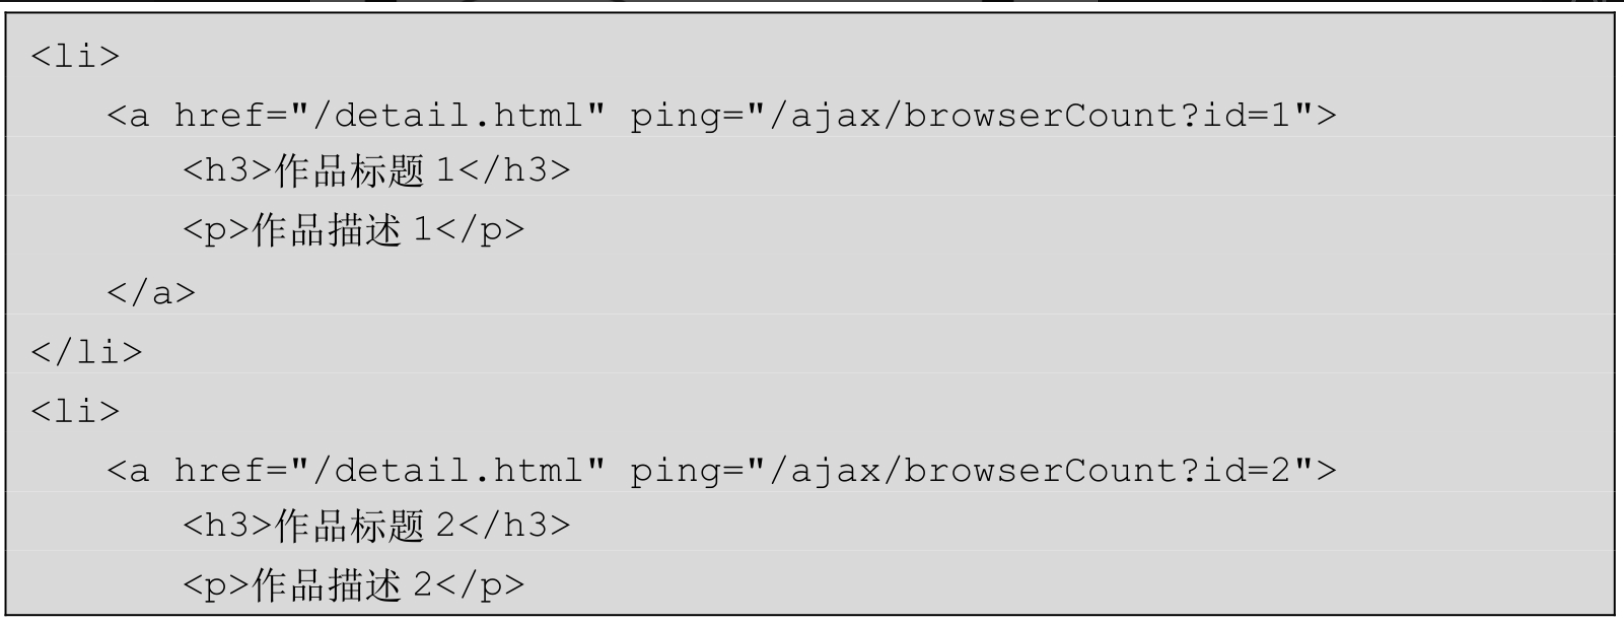
例如,如果某作品列表页面需要显示被观看的次数,如图所示,则特别适合使用ping属性,直接在列表的外面嵌套一层<a>元素,再将ping属性的值设为POST请求地址就可以。
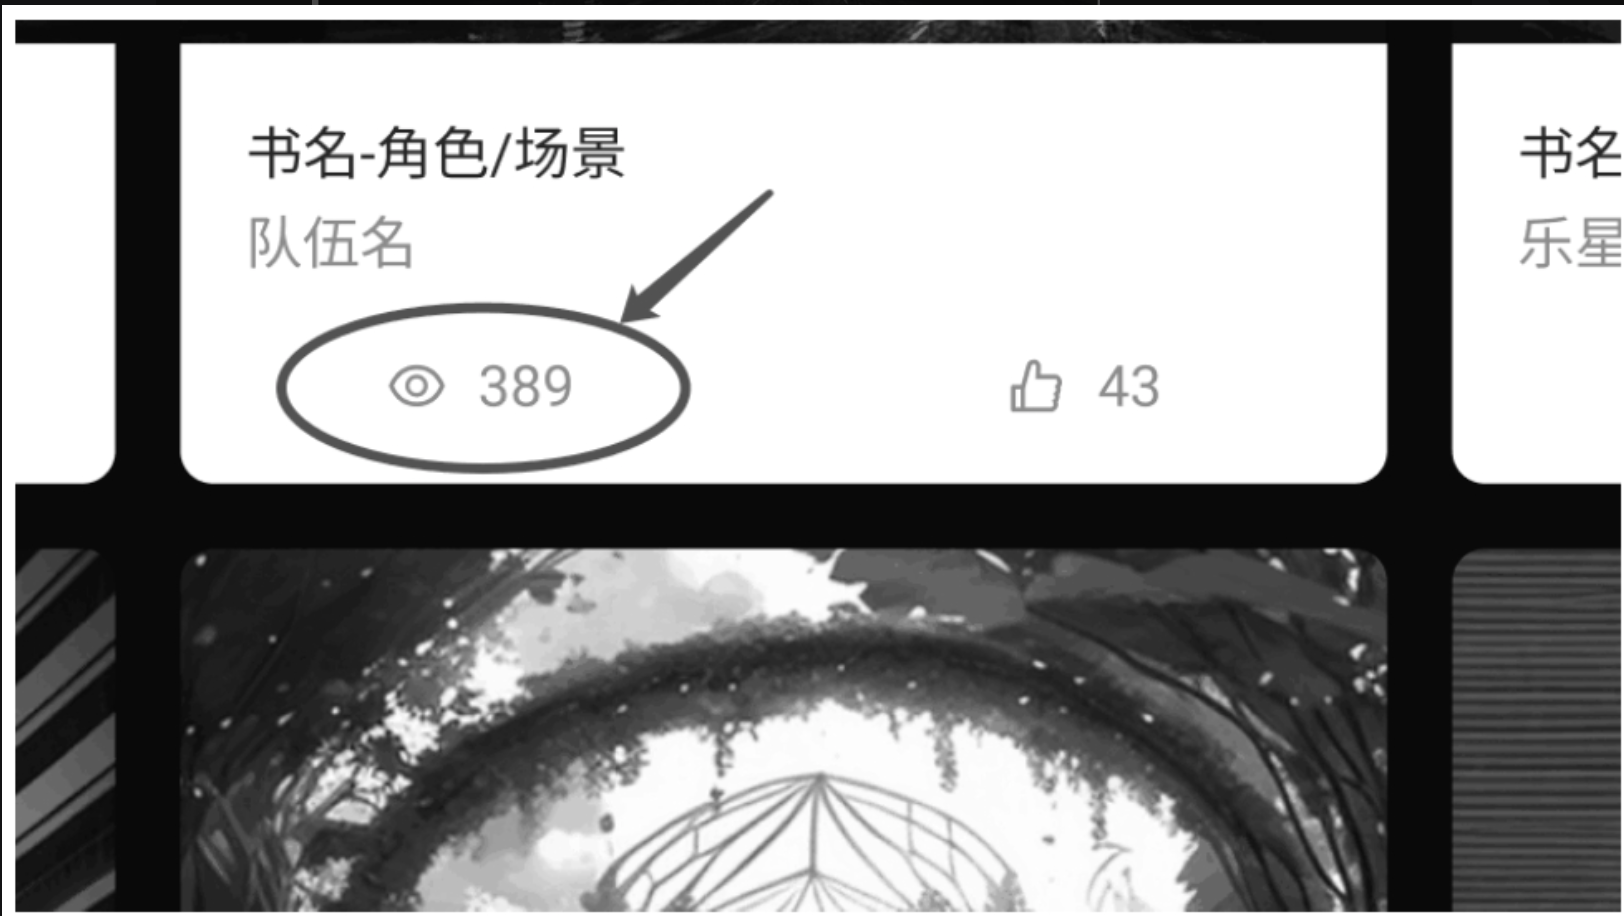
无须额外使用JavaScript绑定点击事件并使用Fetch API发送POST请求,使用一个HTML属性就搞定了,例如:

又如,需要快速进行AB测试的场景。
对于同样两张广告图,各自有50%的概率显示,分别预埋ping属性,然后处理POST请求,就能快速知道哪张广告图的点击效果好,无须专门负责大数据的同事帮忙,前端工程师自己就能搞定这件事情,比较容易出绩效。
这是低成本的杠杆技能之一,同时由于使用成本低,日后技术策略调整也会非常方便。
对于复杂的大规模的系统上报,ping属性方法并不合适,还是使用传统的JavaScript发送请求的方式吧。
总之,HTML提供了这样便捷的能力,能否活用相关技术并在项目中大放异彩,还要看个人的意识和技术嗅觉。
1.5、好好讲一下referrerpolicy属性
referrerpolicy属性支持如下这些属性值:
- Referrer-Policy:no-referrer
- Referrer-Policy:no-referrer-when-downgrade
- Referrer-Policy:origin
- Referrer-Policy:origin-when-cross-origin
- Referrer-Policy:same-origin
- Referrer-Policy:strict-origin
- Referrer-Policy:strict-origin-when-cross-origin
- Referrer-Policy:unsafe-url
1.5.1、no-referrer
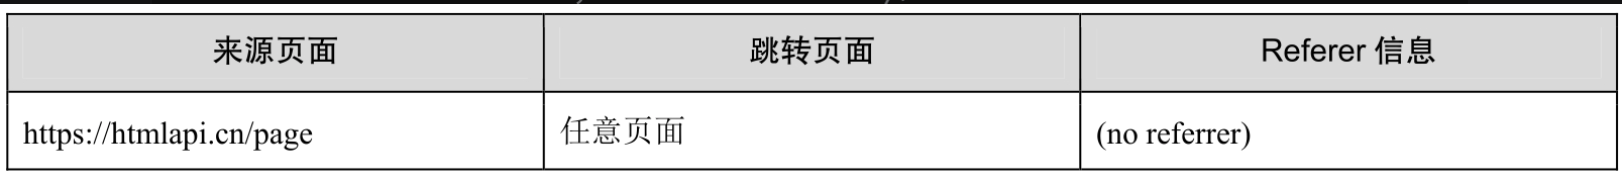
就最终的效果而言,referrerpolicy="no-referrer"等同于上文介绍过的rel="noreferrer",表示发送的请求或跳转的页面不包括任何Referer信息。
no-referrer与Referer信息示例参见下表。
1.5.2、no-referrer-when-downgrade
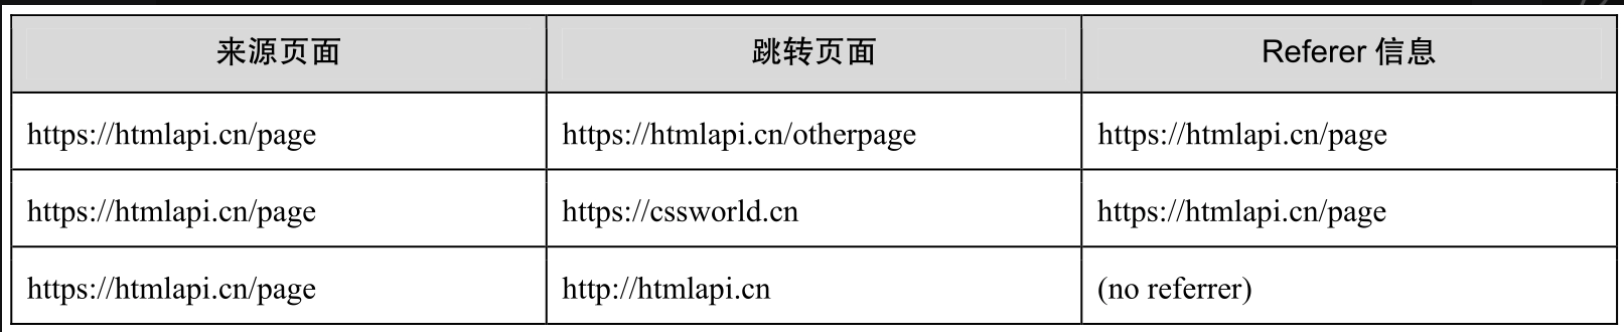
表示当协议安全级别保持不变或提高时(HTTP→HTTP,HTTP→HTTPS, HTTPS→HTTPS),在Referer中发送源、路径和查询字符串,当协议的安全级别下降的时候(HTTPS→HTTP, HTTPS→file)不发送Referer信息。
no-referrer-when-downgrade与Referer信息示例参见下表。
1.5.3、origin
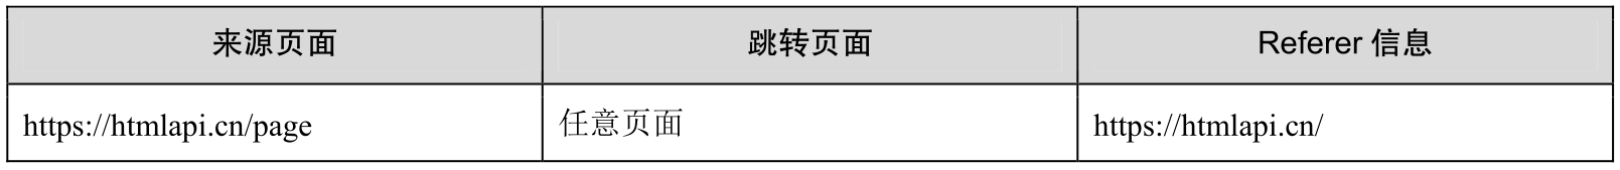
表示Referer信息是来源页面URL地址中的域信息(即location.origin的返回值)。
origin与Referer信息示例参见下表。
1.5.4、origin-when-cross-origin
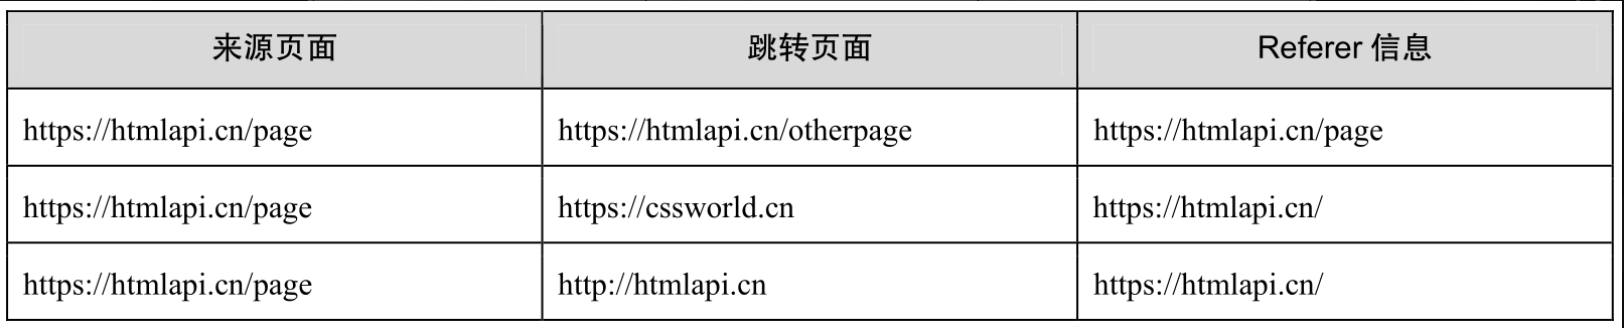
表示如果跳转页面和来源页面是跨域的,则Referer只显示原始的域信息,否则显示完整的地址。
origin-when-cross-origin与Referer信息示例参见下表。
1.5.5、same-origin
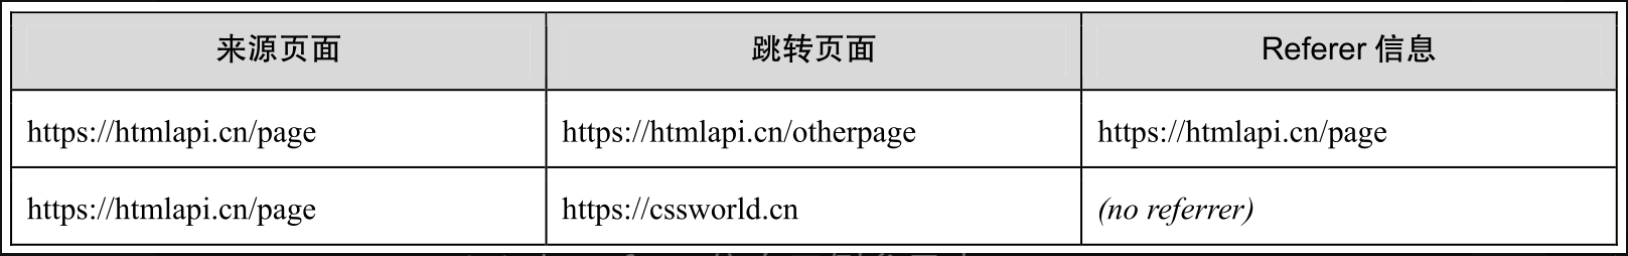
表示域名必须相同,否则Referer信息为空。
same-origin与Referer信息示例参见下表。
1.5.6、strict-origin
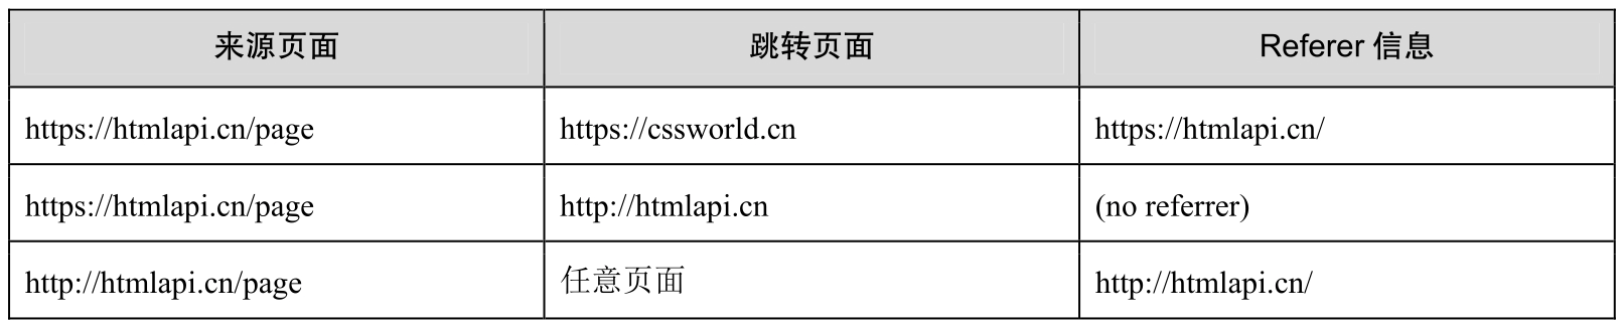
仅当协议安全级别保持不变或升高(HTTPS→HTTPS,HTTP→HTTPS)时,发送仅包含域信息的Referer信息,如果协议的安全级别降低(HTTPS→HTTP),则不发送Referer信息。
strict-origin与Referer信息示例参见下表。
1.5.7、strict-origin-when-cross-origin(默认值)
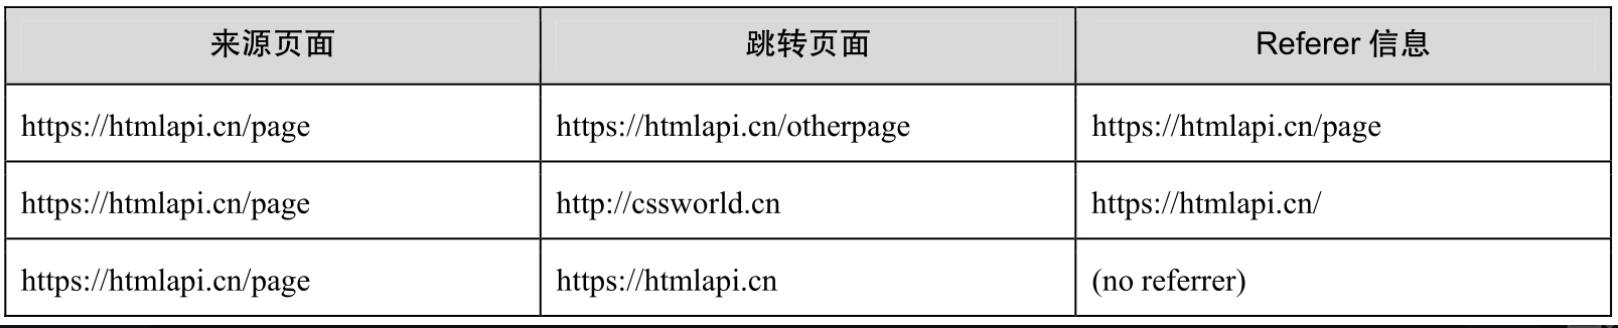
表示当域名和安全协议相同或更高的时候,Referer信息是完整地址,如果跨域,则Referer信息是原始的域信息;如果安全协议降低,则Referer信息为空。
此值是Referer策略新的默认值,在2020年之前的默认值是no-referrer-when-downgrade。
strict-origin-when-cross-origin与Referer信息示例参见下表。
1.5.8、unsafe-url
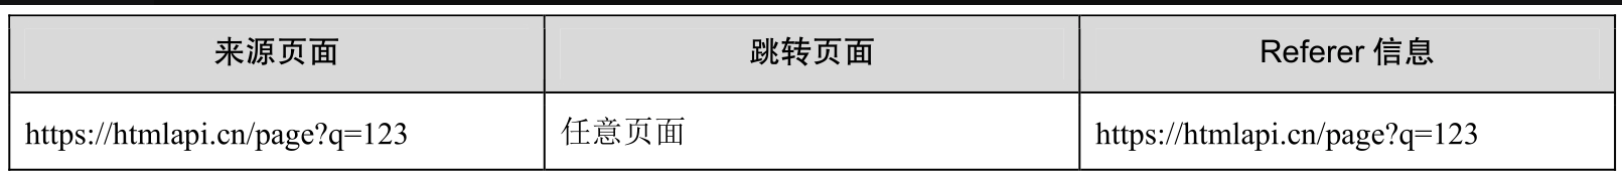
表示就算URL地址不安全,也发送完整的Referer信息。
unsafe-url与Referer信息示例参见下表。
以上就是对各个referrer策略的介绍。下面回到一开始的问题,面对外部链接,我们如何设置才能兼顾信息传播和隐私保护呢?
推荐使用origin-when-cross-origin,代码示意:

这样,外部网站可以知道自己的访问来源是哪个网站,从而增加曝光和流量,同时因为只有域名信息,所以,不会暴露关于网站和用户的任何其他隐私信息,足够安全。
与时俱进,试试在自己的网站中这样设置吧。
1.6、href属性的背后也有细节知识
1.6.1、自动绝对地址
如何使用JavaScript代码将一个相对地址转换为绝对地址?
方法一是使用new URL()方法,语法示意:

设置base参数为你希望的域名,此时就会自动返回绝对地址,例如:

不过此方法只能用在不需要考虑IE浏览器的产品中。
方法二是使用<a>元素的href属性(<form>元素的action属性亦可)。
代码示意:
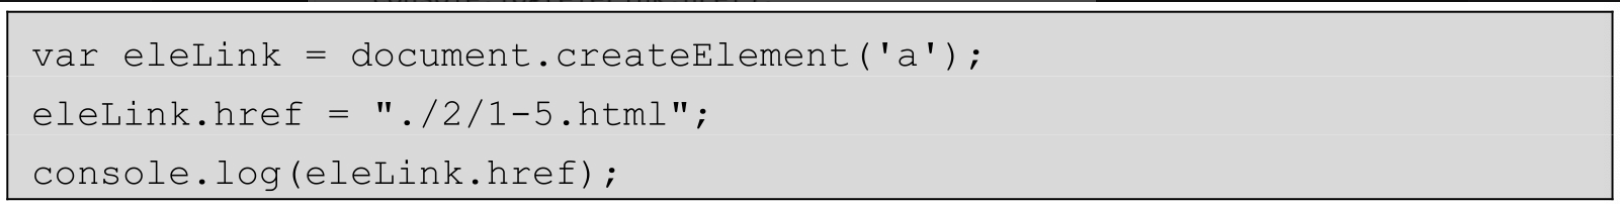
运行结果如图所示。
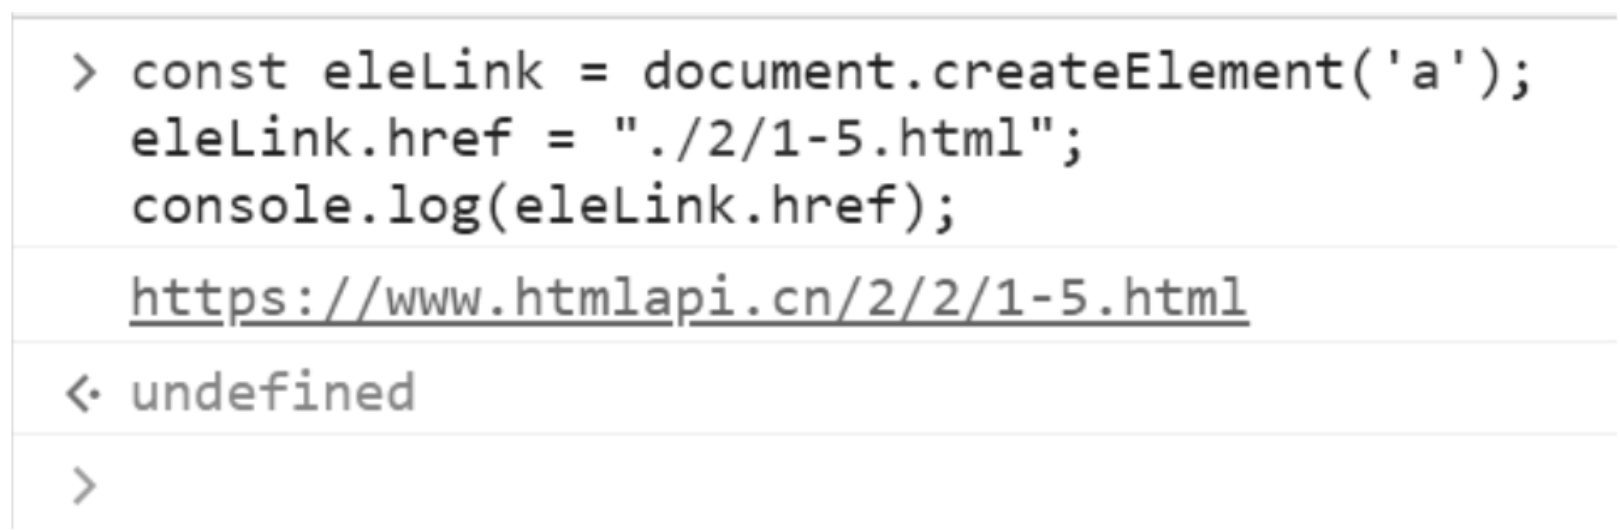
也就是说,当href属性值直接访问的时候,浏览器会自动将其转换为绝对地址。
但上面的实现有一个不足之处,就是补全的域名只能是当前页面所在的域名地址,如果希望指定域名,怎么办呢?
可以使用<base>元素临时指定,代码实现示意:
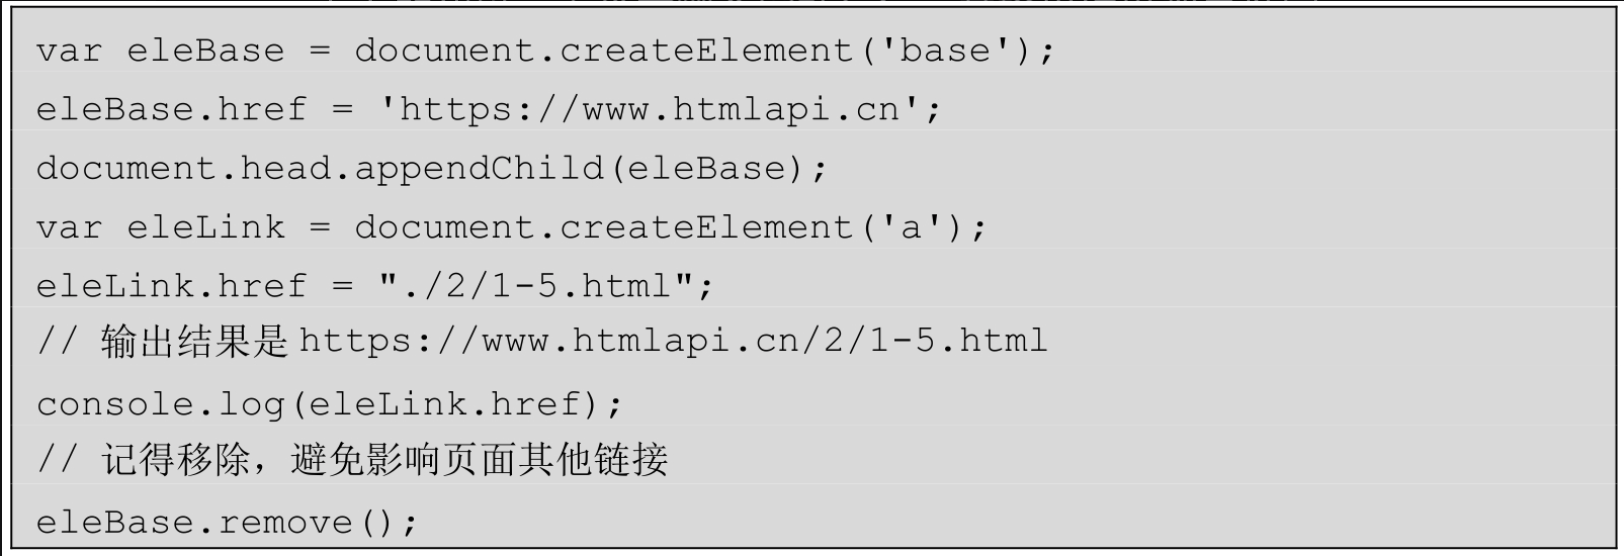
上面的代码,无论在哪个网站运行,其输出结果都是稳定的。
href方法的优点就是兼容性非常好,哪怕是IE8浏览器也是支持的,以及href方法不用担心解析报错(非法的url字符串使用newURL()方法解析的时候,会报UncaughtTypeError错误)。
1.6.2、锚点定位
锚点定位的本质是页面滚动,而与滚动相关的CSS特性非 常多,若要深究,篇幅定会冗长,所以这里不做展开,只讲和href属性相关的那点知识。
href的属性值如果以"#"开头,则点击此链接就会触发锚点定位。
例如:

点击"查看案例"字样的链接,浏览器会自动查询页面中有没有id属性值是'example'的元素(在过去,还会匹配name属性值是'example'的链接元素)。如果有,则会通过改变滚动距离的方式,让该元素定位到浏览器的上边缘(默认位置,可以通过CSS属性修改为下边缘或垂直居中);如果没有匹配,则不会有锚点定位,唯一的变化是浏览器的URL地址的hash值会变成#example。
但我想讲的内容不是上面这个前端开发人员都知道的知识,而是下面的内容:

当href属性值是#top的时候,点击该链接会让页面滚动到顶部,其效果等同于href="#",这是个很有趣的细节知识。
当然,如果页面中存在id="top"的元素,那么此时还是优先定位这个元素,而不是滚动到顶部。
1.6.3、无障碍访问
<a>元素自带多个无障碍访问特性,例如,能够使用Tab键聚焦,可以按回车键触发点击行为。
但很多人并不知道,这些无障碍访问行为的存在,全部都是因为有href属性。
一个链接元素,如果没有href属性,那么,这个元素是不能被键盘访问的,也不能匹配像:any-link这样的CSS选择器,此时,其行为表现本质上和<span>一样,就是个普通的内联元素。
因此,在日常开发中,当<a>元素被当作按钮使用的时候,会有如下所示的href属性值设置:

href="javascript:"看起来不参与任何行为,实际上保留了当前元素的可访问性,是不能删除的。
1.7、为何<base>元素无人问津
先了解一下HTML<base>元素的作用。
<base>元素可以设置当前网页上下文的根地址,页面中所有设置的相对地址都会受此元素影响,例如:

同时,页面中还有个如下所示的<a>元素:

点击"首页"字样的链接,浏览器会在新窗口打开https://www.htmlapi.cn/home.html地址。
注意,这里明明<a>元素并未设置任何target属性,却触发了打开新的浏览器窗口的行为,就是因为<base>元素设置了target="_blank"。
这么一看,似乎<base>还是很有用的,比如搜索结果列表页面,里面的链接就没必要一个一个地添加target="_blank"了,只要在页面顶部插入一个<base>元素就可以了。
话这么说没错,但是实际上并没有大家想得那么简单。
<base>元素的影响太广泛了,除<meta>元素无法受到影响之外,其余任何与链接地址相关的HTML属性都会受到影响,包括在JavaScript代码中运行的Ajax请求地址。
举个例子,在域名为htmlapi.cn的页面中有如下所示的<base>元素:
 然后运行了如下所示的fetch请求。

此时,浏览器会请求https://www.cssworld.cn/assets/example.jpg地址,而不是https://htmlapi.cn/assets/example.jpg地址。
于是就会报跨域的错误,如下图所示。
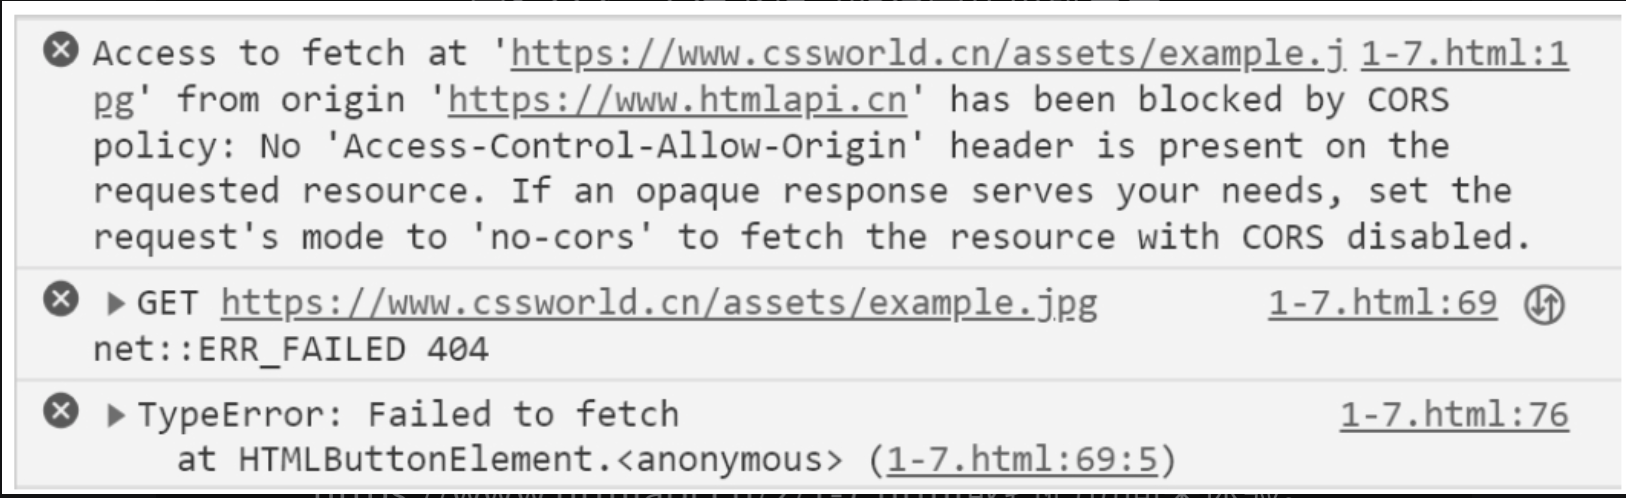
可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-7.html访问来体验。
正是由于<base>元素的影响过于深入与广泛,因此在日常开发中,不会使用<base>元素去定义页面的根路径,因为很容易出现意料之外的状况。
当然,存在即合理,大家可以理性对待<base>元素,不要将其当成"洪水猛兽",当场景合适时,它还是可以大放异彩的。
1.8、如何实现链接元素的嵌套
<a>元素是无法嵌套<a>元素的,例如:

浏览器会自动将上面的链接元素渲染成平行结构的,就像下面这样:

在实际的开发过程中,难免会遇到需要链接嵌套的情况,尤其在移动端的开发中。
移动端的点击都是使用手指完成的,属于不精确的点击,因此我们常常将整个列表都做成可点击的,但是有时候,列表中还会有其他外链的信息,此时链接嵌套的情况就出现了,比如图所示的这个例子,外部列表是个人详情链接,简介信息中的是书籍链接,瞧,这是典型的链接嵌套场景。
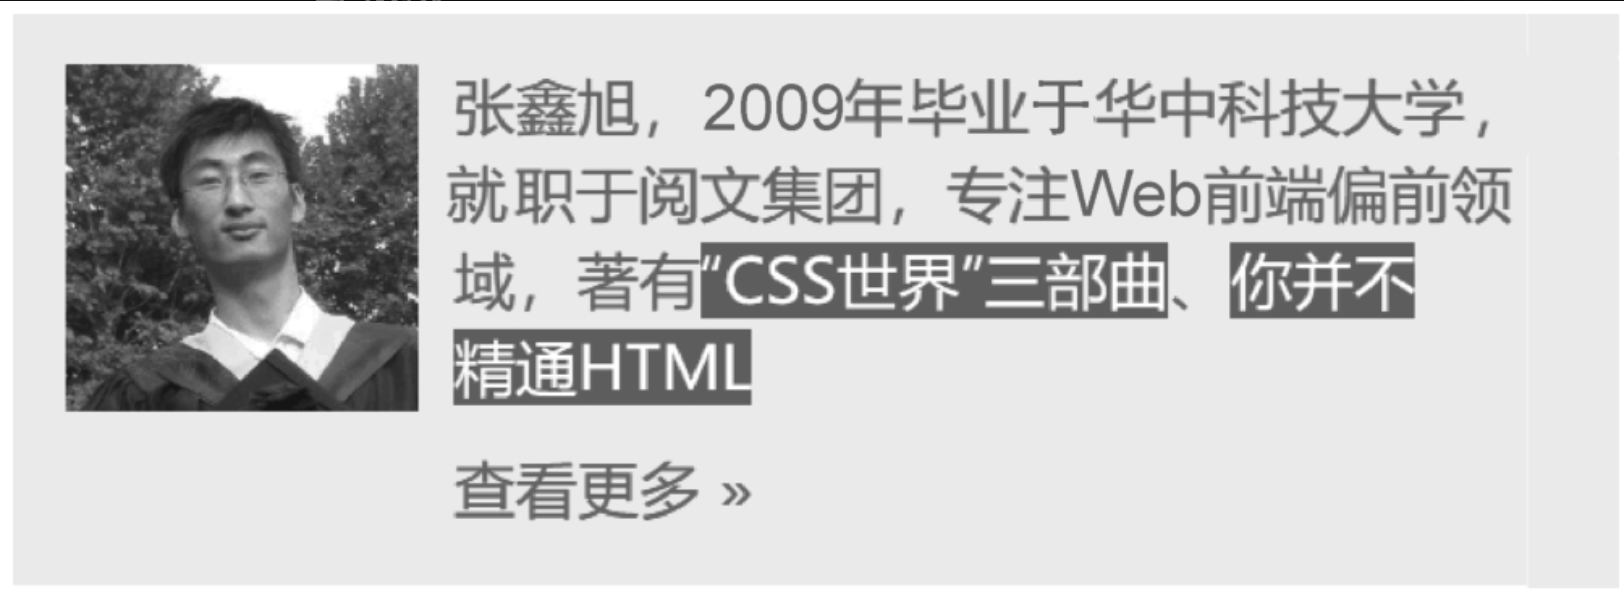
如果是你,你会如何实现此需求?
使用JavaScript的location.href方法触发跳转?可以,是个方法!除此之外呢?
嘿,不妨试试使用<area>元素。
<area>元素也是HTML标准元素,它的许多行为和<a>元素的都是一样的,不仅原生支持href属性的跳转行为,对于target、rel、ping、referrerpolicy等属性也都是支持的。
不过<area>元素并非嵌套元素,无法包裹文字或其他标签,所以作为链接出现的时候,只能覆盖在其他的元素上。
例如,上面链接嵌套的需求可以使用如下所示的代码实现(仅展示关键部分):
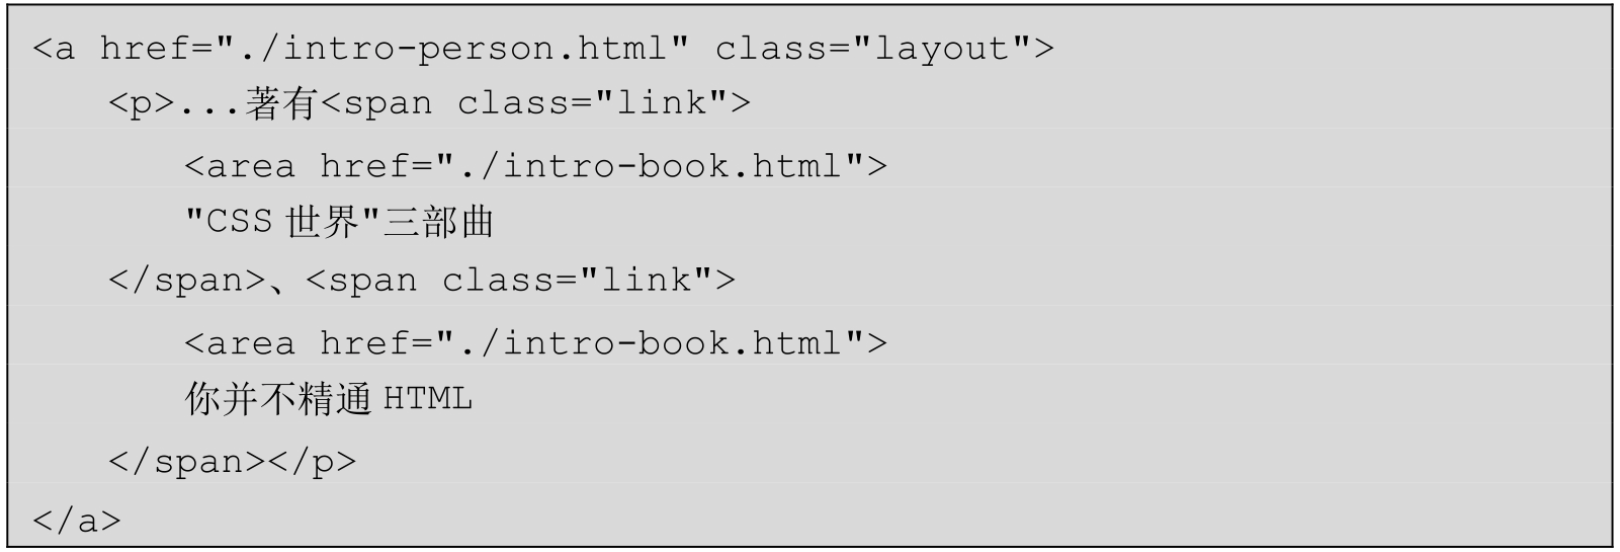
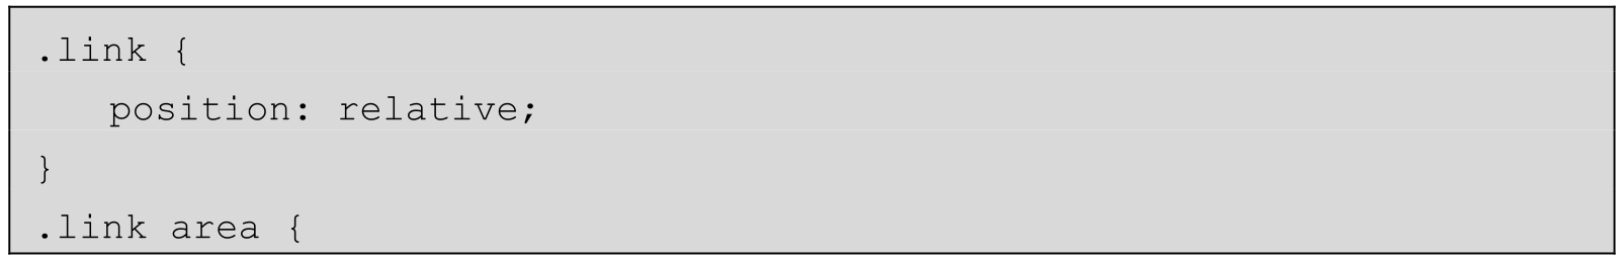
此时,再使用CSS让<area>元素绝对定位覆盖外面的<span>元素就可以了:
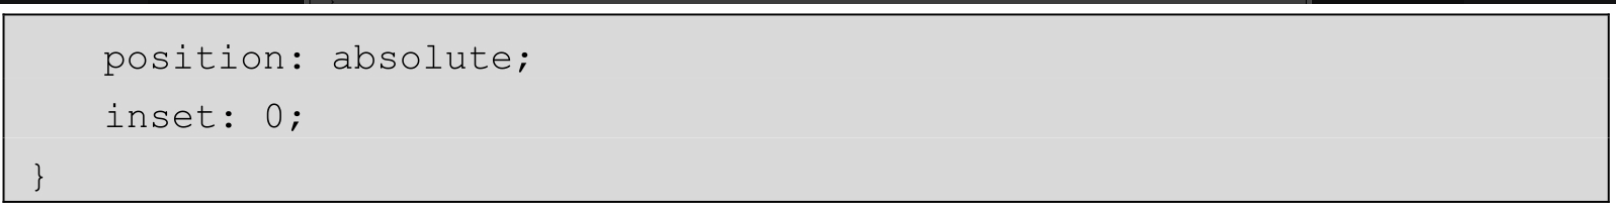
此方法简单又干脆,且语义和无障碍访问都没问题,在桌面端浏览器中,把光标移动到对应的链接上,浏览器也会在左下角显示链接地址(Safari除外,因为Safari没有提示链接地址的行为)。
可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-8.html访问来体验。
然而,上面这种写法目前仅在Chrome浏览器下有效,在Firefox和Safari浏览器下,<area>元素尚不能脱离<map>元素使用。
这一点说来话就长了。
<area>和<map>元素原本的作用
<area>和<map>元素原本的作用是给图片元素上标记不规则的点击区域,例如图所示的饼图的三个分区就属于不规则的点击区域。
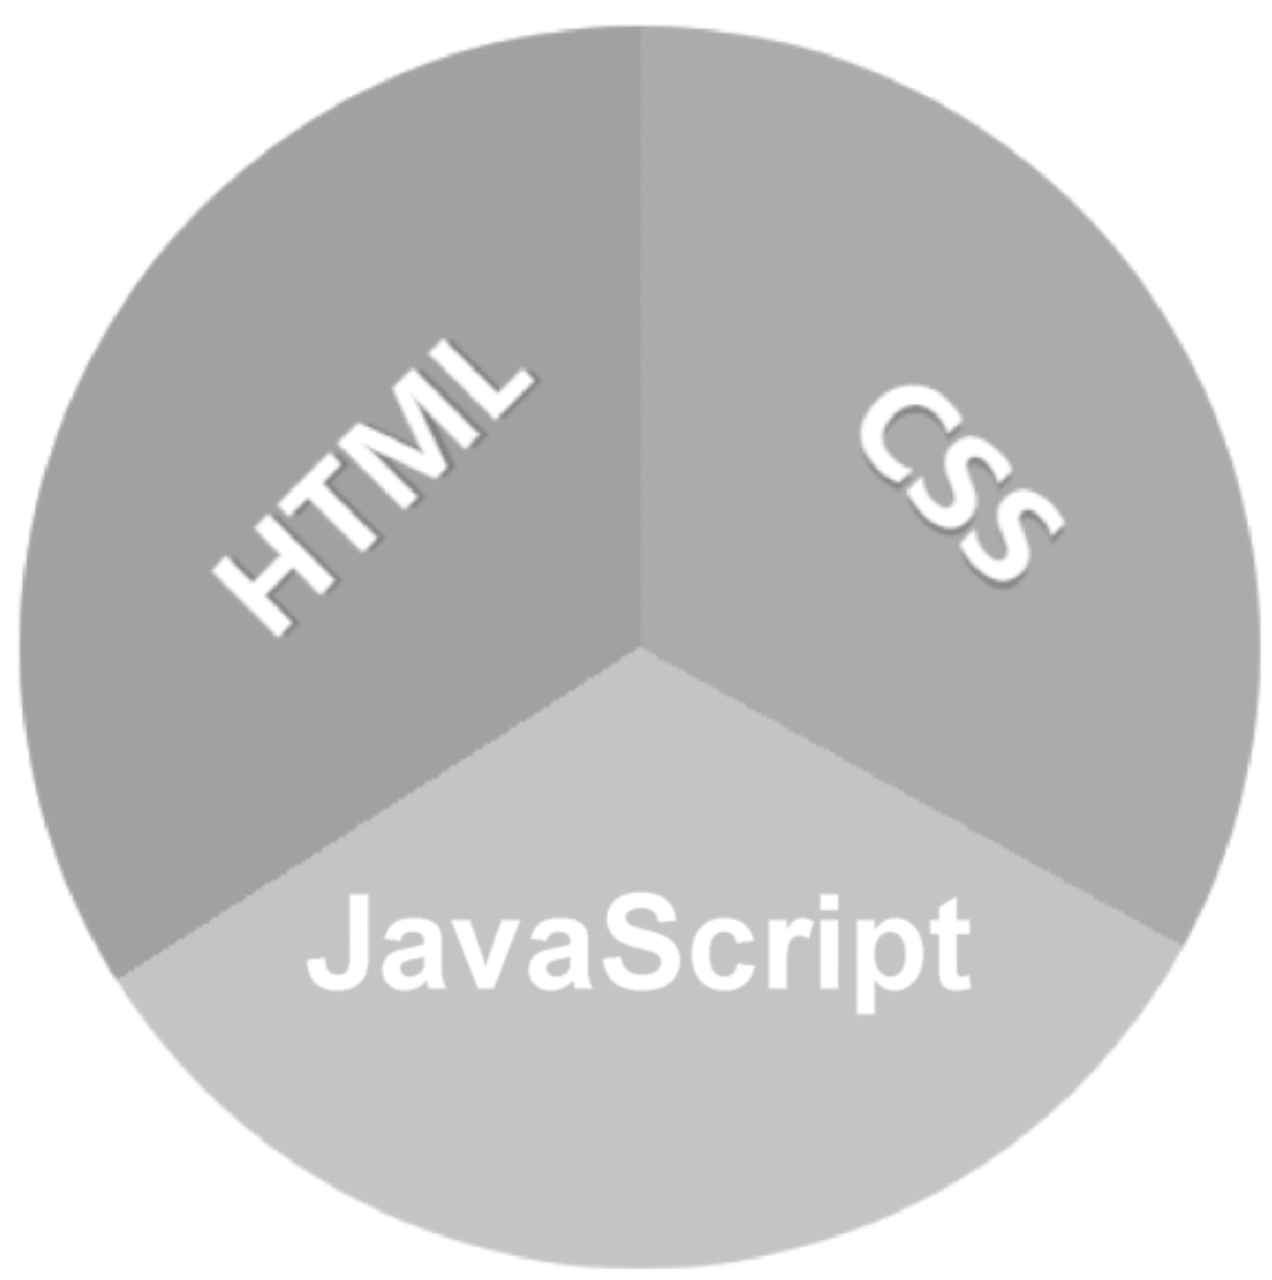
这种场景下的最佳实现一定是使用<area>和<map>元素。
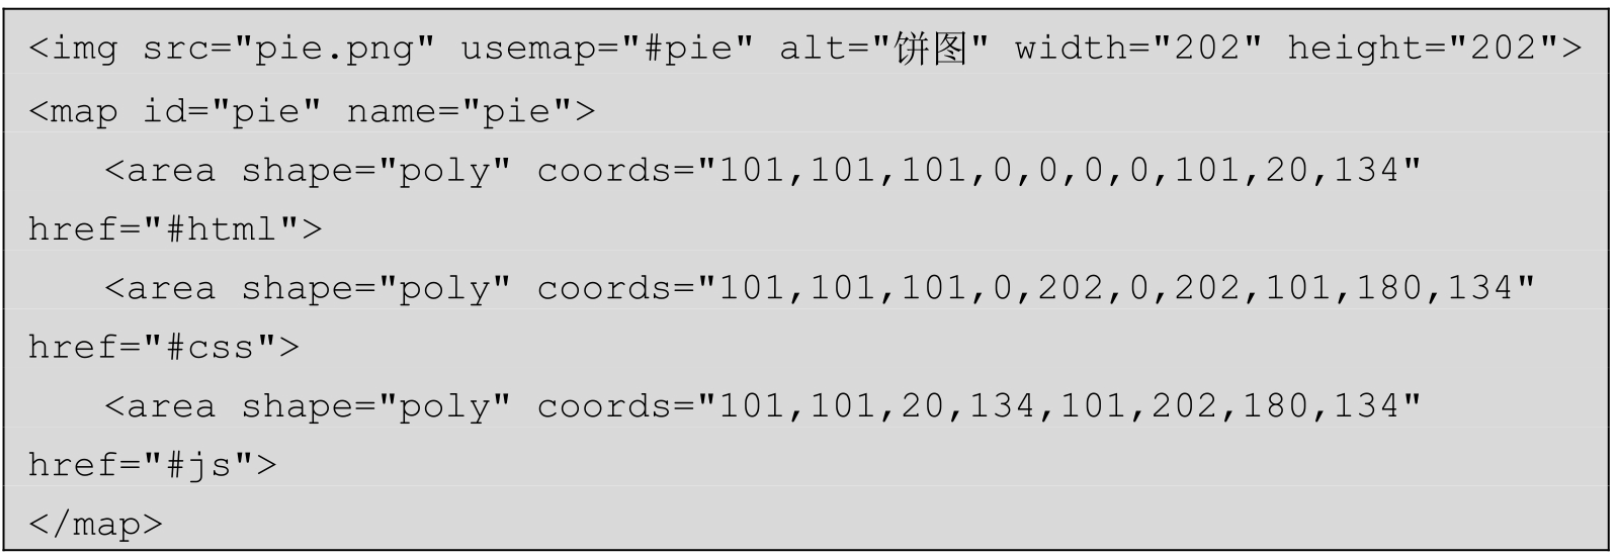
此时,不同的饼图区域就会有不同的链接,有演示页面,可以通过在浏览器中输入地址https://www.htmlapi.cn/2/1-9.html访问来体验。
其中出现了若干个必须要出现的属性和元素。
- <img>元素,<map>元素的生效离不开图片元素。
- usemap属性,用来指向使用哪个热点地图,需要以"#"开头。
- <map>元素,需要设置id或者name属性值,方便和usemap属性值匹配。
- <area>元素,设置链接地址及点击区域的形状与坐标信息。
上面四个要素中,前三个比较简单,不展开讲,重点讲一下<area>元素的几个比较独有的HTML属性。
- shape
shape表示点击热点区域的形状,支持矩形(rect)、圆形(circle)以及多边形(poly)。 - coords
coords表示点击热点区域形状的坐标。坐标点(0, 0)表示图片的左上角。其中rect支持4个数值,2个坐标,分别是矩形左上角坐标和矩形右下角坐标。例如,coords="20,20,80,80"生成的就是一个左上角坐标(20, 20)、宽和高都是60px的矩形区域。circle支持3个数值,前2个值为圆心坐标,第3个值为圆的半径大小。poly就更简单了,每两个数值组合表示一个坐标点,依次连线形成的区域就是最终的热点区域。 - alt
alt同<img>元素的alt,表示热点区域图片的描述信息。
大家可能知道CSS中有个名为clip-path的CSS属性,支持矩形、圆形和多边形的剪裁,<area>元素的coords属性值语法与之类似,区别在于,coords属性的兼容性更好,包括IE8浏览器在内的浏览器都支持。然而,很可惜的是,<area>元素无法像普通元素那样进行样式自定义,边框、背景色之类的样式都是无效的。这个特点限制了其只能覆盖在某些元素上作为点击区域使用。
了解了<area>元素,我们再回到一开始的那个链接嵌套的问题。
既然Firefox和Safari浏览器不支持单纯的<area>覆盖,我们就使用标准的语法,也就是使用<img>元素覆盖,然后将整个<img>元素都做成点击链接。
HTML代码示意如下(只展示核心部分):
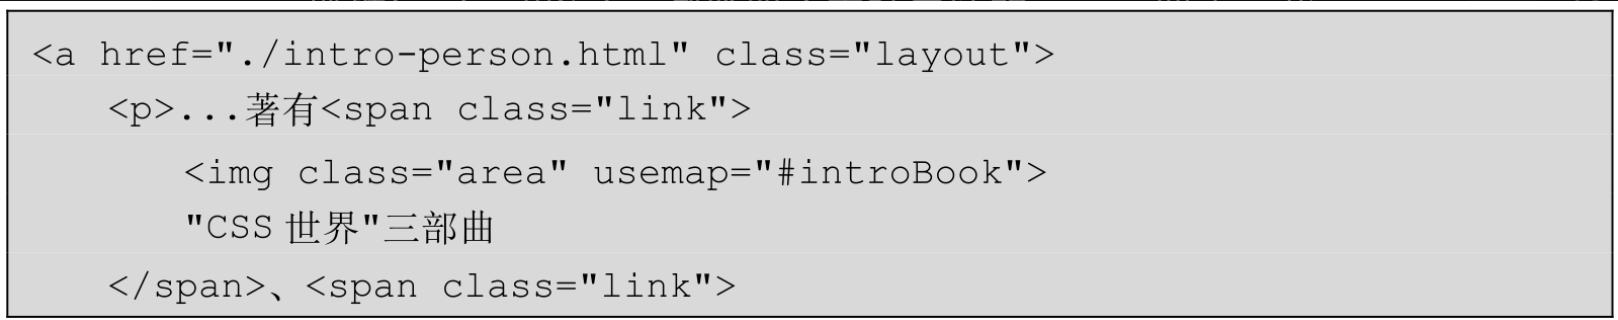
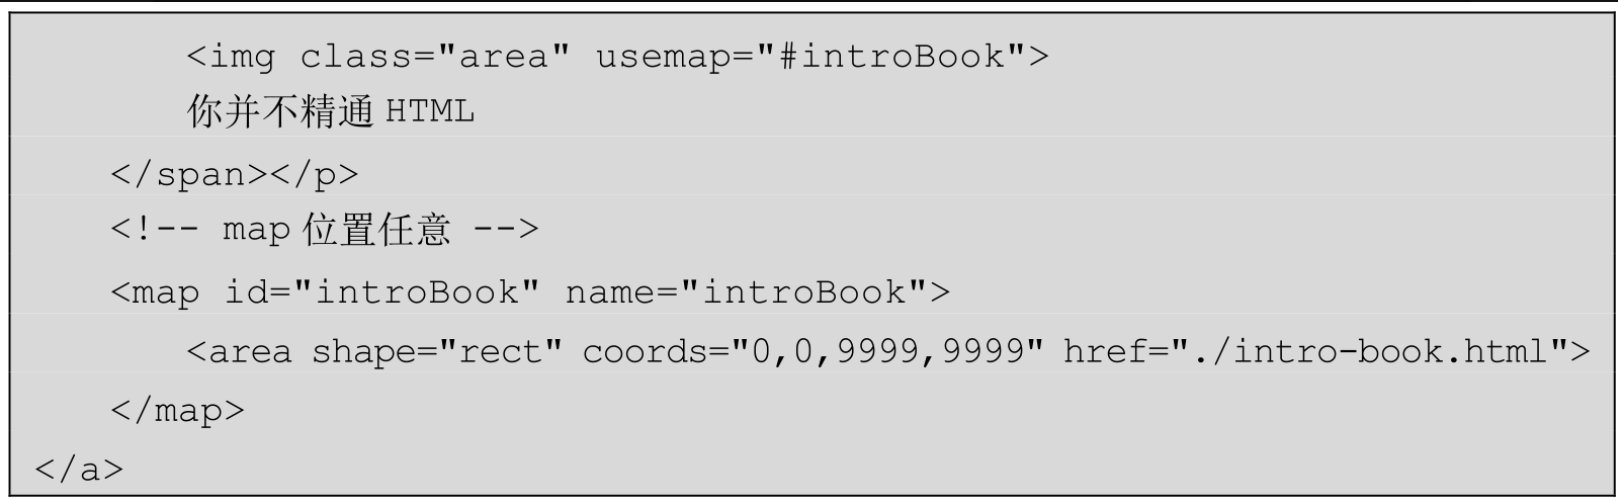
此时,所有的浏览器,包括IE浏览器在内,点击书名都能跳转到另外的链接,不受外部<a>元素链接的影响。
演示页面就是上面出现过的https://www.htmlapi.cn/2/1-8.html,其中有个前端小技巧,就是让\<area>元素的矩形坐标值设置得足够大,这样,可以复用在任意尺寸的点击元素上,而不用关心点击元素具体的尺寸大小,<img>元素的src属性可以不用设置。