反向传播(Backpropagation)详解
本文完整讲透反向传播:它解决什么问题 → 数学基础(链式法则)→ 核心公式(逐层递推)→ 应用场景与作用 → PyTorch autograd 实战代码(逐行详解)→ 常见陷阱 。
配套阅读《深度学习常用公式手册》。
第一章 作用与直觉
1.1 一句话定义
反向传播 = 用"一次前向 + 一次反向"求出损失对全部参数的梯度 ∇ θ L \nabla_\theta \mathcal{L} ∇θL 的算法;它是链式法则在计算图上的记忆化(动态规划)实现,属于反向模式自动微分(reverse-mode AD)。
作用:梯度下降族一切优化方法(SGD/Adam/...)的"燃料供给系统"。没有它,深度学习不存在------因为没有任何其他方法能在千万参数规模上高效求梯度。
1.2 为什么不能用数值差分
数值差分对第 i i i 个参数单独扰动:
∂ L ∂ θ i ≈ L ( θ + ϵ e i ) − L ( θ − ϵ e i ) 2 ϵ \frac{\partial \mathcal{L}}{\partial \theta_i} \approx \frac{\mathcal{L}(\theta + \epsilon e_i) - \mathcal{L}(\theta - \epsilon e_i)}{2\epsilon} ∂θi∂L≈2ϵL(θ+ϵei)−L(θ−ϵei)
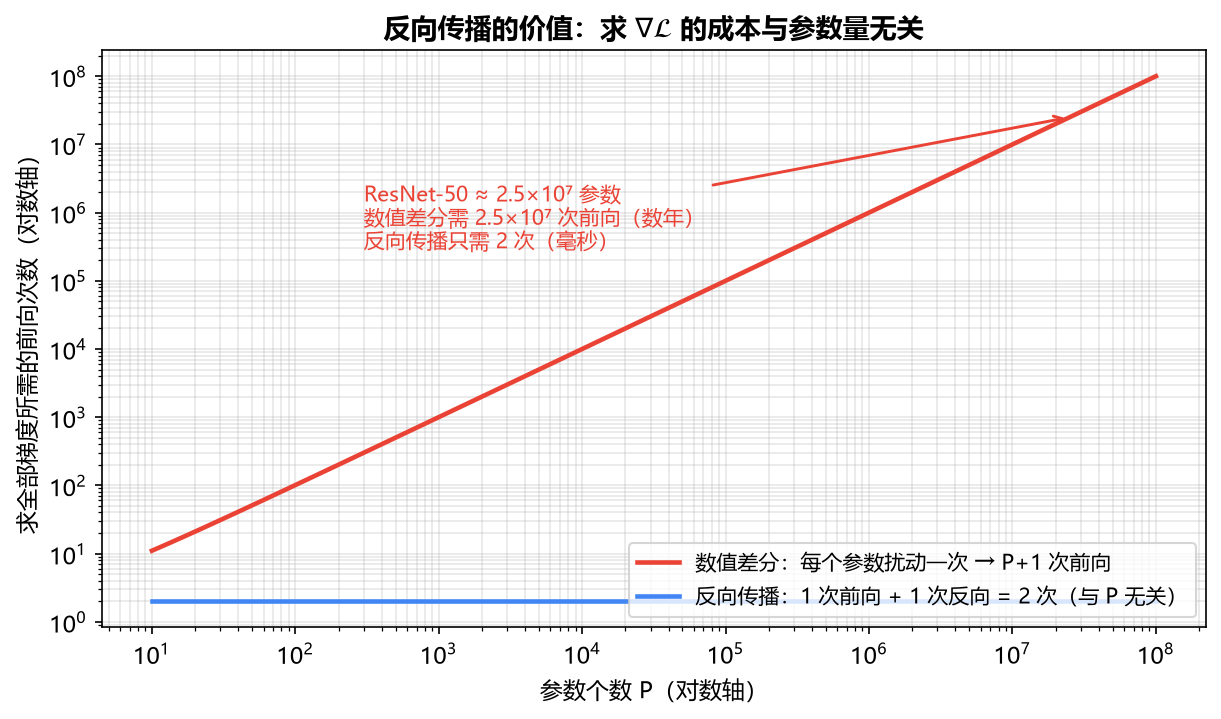
代价 :每个参数要 2 次前向 → 求全梯度共 2 P 2P 2P 次前向( P P P = 参数量)。ResNet-50 有 2.5 × 10 7 2.5\times10^7 2.5×10⁷ 个参数 → 5 千万次前向,单次训练步以年计。
反向传播的代价 : 1 1 1 次前向 + 1 1 1 次反向 ≈ 2 \approx 2 ≈2 次前向的时间,与 P P P 无关。
示意图
1.3 直觉:快递退货链路
把前向看作"原料逐车间加工成成品(损失)",反向就是"成品出了问题,沿生产线倒查每个车间的责任(梯度)"。每个车间只需知道两件事:上游传来的责任 ( ∂ L / ∂ 输出 \partial \mathcal{L}/\partial \text{输出} ∂L/∂输出)和本机器的加工规律 (局部导数),二者相乘即得对下游原料的责任 ( ∂ L / ∂ 输入 \partial \mathcal{L}/\partial \text{输入} ∂L/∂输入)------这就是链式法则的局部化,也是 autograd 每个节点做的事。
第二章 数学基础:链式法则
2.1 标量链式法则
d L d x = d L d y ⋅ d y d x , y = f ( x ) \frac{\mathrm{d}\mathcal{L}}{\mathrm{d}x} = \frac{\mathrm{d}\mathcal{L}}{\mathrm{d}y}\cdot\frac{\mathrm{d}y}{\mathrm{d}x}, \qquad y = f(x) dxdL=dydL⋅dxdy,y=f(x)
多层嵌套时连乘: d L d x = d L d z d z d y d y d x \frac{\mathrm{d}\mathcal{L}}{\mathrm{d}x} = \frac{\mathrm{d}\mathcal{L}}{\mathrm{d}z}\frac{\mathrm{d}z}{\mathrm{d}y}\frac{\mathrm{d}y}{\mathrm{d}x} dxdL=dzdLdydzdxdy。
x ──f──▶ y ──g──▶ z ──h──▶ L        dL/dx = (dL/dz)·(dz/dy)·(dy/dx)
◀────────────── 反向:从 dL/dL=1 出发,逐段乘局部导数 ──────────────
2.2 向量链式法则与 Jacobian(VJP 视角)
当 y = f ( x ) \mathbf{y} = f(\mathbf{x}) y=f(x) 是向量函数时:
∂ L ∂ x = ( ∂ y ∂ x ) ⊤ ∂ L ∂ y = J ⊤ y ˉ , J i j = ∂ y i ∂ x j \frac{\partial \mathcal{L}}{\partial \mathbf{x}} = \left(\frac{\partial \mathbf{y}}{\partial \mathbf{x}}\right)^{\!\top} \frac{\partial \mathcal{L}}{\partial \mathbf{y}} = J^{\top}\, \bar{\mathbf{y}}, \qquad J_{ij} = \frac{\partial y_i}{\partial x_j} ∂x∂L=(∂x∂y)⊤∂y∂L=J⊤yˉ,Jij=∂xj∂yi
符号约定 (autograd 的核心对象): y ˉ ≡ ∂ L / ∂ y \bar{\mathbf{y}} \equiv \partial \mathcal{L}/\partial \mathbf{y} yˉ≡∂L/∂y 称为伴随(adjoint)/ 上游梯度 。每个节点的工作 = 把上游伴随 y ˉ \bar y yˉ 乘上自己的 J ⊤ J^\top J⊤ 传给下游:
x ˉ = J ⊤ y ˉ \bar{\mathbf{x}} = J^{\top} \bar{\mathbf{y}} xˉ=J⊤yˉ
这个"向量-Jacobian 乘积"(VJP)不需要显式构造 J J J(那会是 m × n m\times n m×n 的大矩阵),每种运算都有 O ( 前向成本 ) O(\text{前向成本}) O(前向成本) 的 VJP 公式------见 3.6 节的局部梯度表。
2.3 为什么是"反向"模式
| 模式 | 传播方向 | 一次扫过的产出 | 适合场景 |
|---|---|---|---|
| 前向模式 | 输入 → 输出 | 一个输入方向的方向导数 | 输出多、输入少 |
| 反向模式 | 输出 → 输入 | 全部输入/参数的梯度 | 输出为标量(损失) ← 深度学习 |
损失的维度永远是 1(标量),而参数维度 P P P 巨大 → 反向模式一次扫过拿到全部 P P P 个梯度,是最优选择。这就是"反向传播"名字的由来。
第三章 反向传播核心公式(MLP 逐层递推)
3.0 记号
层索引 l = 1 ... L l = 1\dots L l=1...L; z ( l ) \mathbf{z}^{(l)} z(l) 预激活、 a ( l ) \mathbf{a}^{(l)} a(l) 激活、 a ( 0 ) = x \mathbf{a}^{(0)} = \mathbf{x} a(0)=x;误差项 δ ( l ) ≡ ∂ L / ∂ z ( l ) \boldsymbol{\delta}^{(l)} \equiv \partial \mathcal{L}/\partial \mathbf{z}^{(l)} δ(l)≡∂L/∂z(l)(反传的"货币")。
3.1 前向传播(同时缓存中间值)
z ( l ) = W ( l ) a ( l − 1 ) + b ( l ) , a ( l ) = σ ( z ( l ) ) \mathbf{z}^{(l)} = W^{(l)} \mathbf{a}^{(l-1)} + \mathbf{b}^{(l)}, \qquad \mathbf{a}^{(l)} = \sigma\!\left(\mathbf{z}^{(l)}\right) z(l)=W(l)a(l−1)+b(l),a(l)=σ(z(l))
缓存 { a ( l ) , z ( l ) } \{\mathbf{a}^{(l)}, \mathbf{z}^{(l)}\} {a(l),z(l)} 供反向使用------这就是"前向存激活值"的含义,也是训练比推理费显存的原因。
3.2 输出层误差(递推起点)
δ ( L ) = ∂ L ∂ a ( L ) ⊙ σ ′ ( z ( L ) ) \boldsymbol{\delta}^{(L)} = \frac{\partial \mathcal{L}}{\partial \mathbf{a}^{(L)}} \odot \sigma'\!\left(\mathbf{z}^{(L)}\right) δ(L)=∂a(L)∂L⊙σ′(z(L))
重要特例 :softmax 输出 + 交叉熵损失时,两项相消得到极简形式(推导: ∂ L / ∂ z ( L ) \partial \mathcal{L}/\partial \mathbf{z}^{(L)} ∂L/∂z(L) 中 softmax 的 Jacobian 与 − log -\log −log 的导数逐项相消):
δ ( L ) = y ^ − y (预测概率 − one-hot 真值) \boldsymbol{\delta}^{(L)} = \hat{\mathbf{y}} - \mathbf{y} \qquad \text{(预测概率 − one-hot 真值)} δ(L)=y^−y(预测概率 − one-hot 真值)
这就是"交叉熵+softmax 的梯度只是预测误差"这一著名结论。
3.3 误差反向递推(核心递归)
δ ( l ) = ( ( W ( l + 1 ) ) ⊤ δ ( l + 1 ) ) ⊙ σ ′ ( z ( l ) ) , l = L − 1 , ... , 1 \boldsymbol{\delta}^{(l)} = \left( \left(W^{(l+1)}\right)^{\top} \boldsymbol{\delta}^{(l+1)} \right) \odot \sigma'\!\left(\mathbf{z}^{(l)}\right), \qquad l = L-1, \dots, 1 δ(l)=((W(l+1))⊤δ(l+1))⊙σ′(z(l)),l=L−1,...,1
读法:上一层的误差经权重转置映射回本层 ,再逐元素乘本层激活导数 ( ⊙ \odot ⊙ 是链式法则在非线性处的体现)。
3.4 参数梯度(递推的"副产品")
∂ L ∂ W ( l ) = δ ( l ) ( a ( l − 1 ) ) ⊤ , ∂ L ∂ b ( l ) = δ ( l ) \frac{\partial \mathcal{L}}{\partial W^{(l)}} = \boldsymbol{\delta}^{(l)} \left(\mathbf{a}^{(l-1)}\right)^{\top}, \qquad \frac{\partial \mathcal{L}}{\partial \mathbf{b}^{(l)}} = \boldsymbol{\delta}^{(l)} ∂W(l)∂L=δ(l)(a(l−1))⊤,∂b(l)∂L=δ(l)
∂ L ∂ a ( l − 1 ) = ( W ( l ) ) ⊤ δ ( l ) (传给更前面的层/模块) \frac{\partial \mathcal{L}}{\partial \mathbf{a}^{(l-1)}} = \left(W^{(l)}\right)^{\top} \boldsymbol{\delta}^{(l)} \qquad \text{(传给更前面的层/模块)} ∂a(l−1)∂L=(W(l))⊤δ(l)(传给更前面的层/模块)
记忆口诀 :δ 递归走,外积留梯度 ------ 每层梯度 = 本层 δ 与上游激活的外积;batch 形式即矩阵乘 Δ ( l ) ( A ( l − 1 ) ) ⊤ \Delta^{(l)} (A^{(l-1)})^\top Δ(l)(A(l−1))⊤(逐样本外积之和)。
示意图
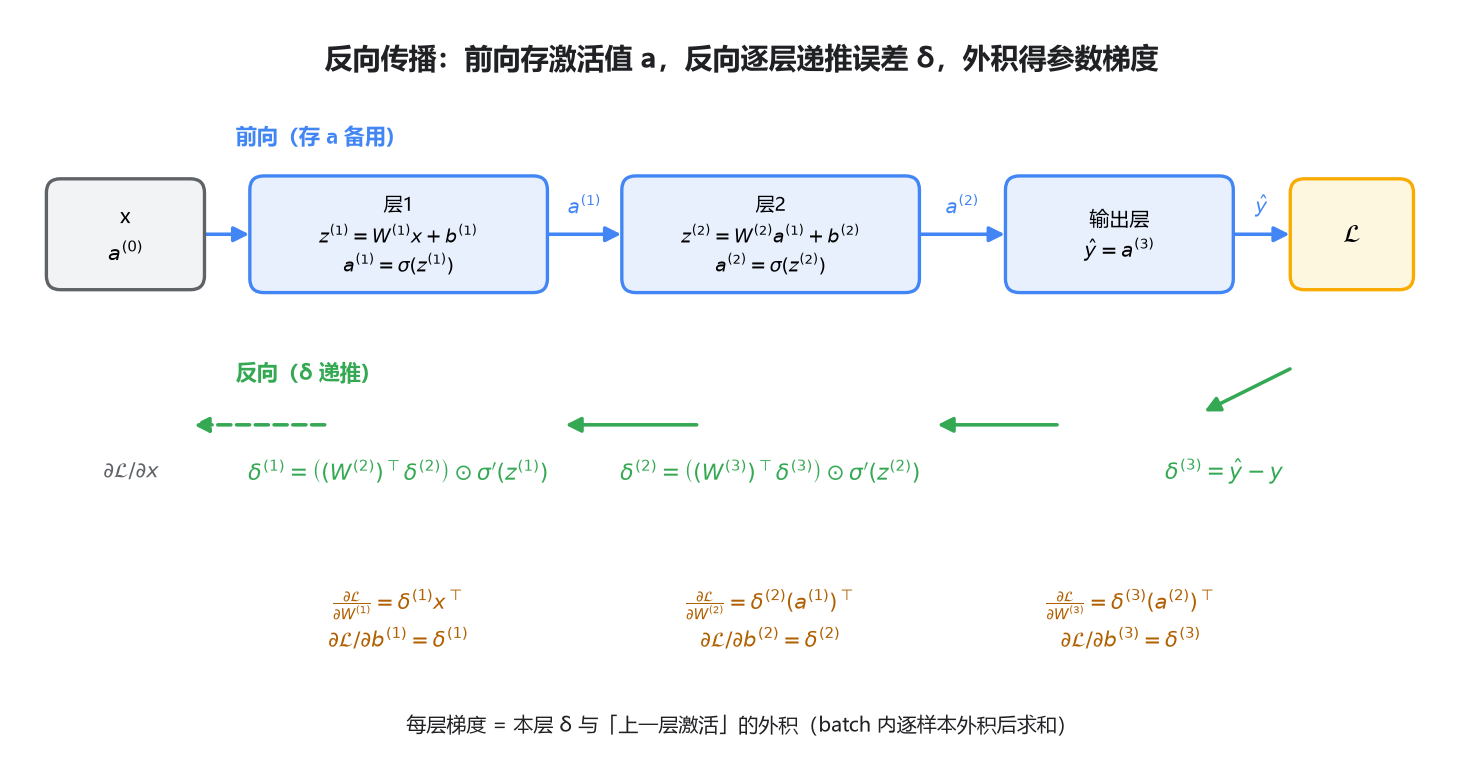
前向:  x ─▶ [层1] ─a¹─▶ [层2] ─a²─▶ [层3] ─ŷ─▶ L     (缓存 a¹, a², z¹, z², z³)
反向:  ∂L/∂x ─ δ¹ ─── δ² ────── δ³ = ŷ−y ◀── L    (δ 从输出层起步逐层递推)
沿途:      ∂L/∂W¹=δ¹xᵀ   ∂L/∂W²=δ²(a¹)ᵀ   ∂L/∂W³=δ³(a²)ᵀ   (外积得参数梯度)
3.5 手推完整例子(两层网络 + MSE,单样本标量版)
网络: z 1 = w 1 x + b 1 , a 1 = σ ( z 1 ) , y ^ = w 2 a 1 + b 2 , L = 1 2 ( y ^ − y ) 2 z_1 = w_1 x + b_1,\ a_1 = \sigma(z_1),\ \hat y = w_2 a_1 + b_2,\ \mathcal{L} = \tfrac{1}{2}(\hat y - y)^2 z1=w1x+b1, a1=σ(z1), y^=w2a1+b2, L=21(y^−y)2。取 x = 1 , w 1 = 2 , b 1 = 0 , w 2 = 1 , b 2 = 0 , y = 0.9 x=1,\ w_1=2,\ b_1=0,\ w_2=1,\ b_2=0,\ y=0.9 x=1, w1=2, b1=0, w2=1, b2=0, y=0.9:
前向 : z 1 = 2 , a 1 = σ ( 2 ) = 0.881 , y ^ = 0.881 , L = 1 2 ( 0.881 − 0.9 ) 2 = 1.8 × 10 − 4 z_1 = 2,\ a_1 = \sigma(2) = 0.881,\ \hat y = 0.881,\ \mathcal{L} = \tfrac12(0.881-0.9)^2 = 1.8\times10^{-4} z1=2, a1=σ(2)=0.881, y^=0.881, L=21(0.881−0.9)2=1.8×10⁻⁴
反向 (从 ∂ L / ∂ L = 1 \partial\mathcal{L}/\partial\mathcal{L}=1 ∂L/∂L=1 倒着乘):
∂ L ∂ y ^ = y ^ − y = − 0.019 \frac{\partial \mathcal{L}}{\partial \hat y} = \hat y - y = -0.019 ∂y^∂L=y^−y=−0.019
δ 2 ≡ ∂ L ∂ z 2 = − 0.019 ( 输出层线性 ) ⇒ ∂ L ∂ w 2 = δ 2 a 1 = − 0.0167 , ∂ L ∂ b 2 = δ 2 = − 0.019 \delta_2 \equiv \frac{\partial \mathcal{L}}{\partial z_2} = -0.019 \quad(\text{输出层线性}) \ \Rightarrow\ \frac{\partial \mathcal{L}}{\partial w_2} = \delta_2 a_1 = -0.0167,\quad \frac{\partial \mathcal{L}}{\partial b_2} = \delta_2 = -0.019 δ2≡∂z2∂L=−0.019(输出层线性) ⇒ ∂w2∂L=δ2a1=−0.0167,∂b2∂L=δ2=−0.019
δ 1 = δ 2 w 2 ⋅ σ ′ ( z 1 ) = ( − 0.019 ) ( 1 ) ( 0.0977 ) = − 1.86 × 10 − 3 ⇒ ∂ L ∂ w 1 = δ 1 x = − 1.86 × 10 − 3 \delta_1 = \delta_2\, w_2 \cdot \sigma'(z_1) = (-0.019)(1)(0.0977) = -1.86\times10^{-3} \ \Rightarrow\ \frac{\partial \mathcal{L}}{\partial w_1} = \delta_1 x = -1.86\times10^{-3} δ1=δ2w2⋅σ′(z1)=(−0.019)(1)(0.0977)=−1.86×10⁻³ ⇒ ∂w1∂L=δ1x=−1.86×10⁻³
注意 σ ′ ( 2 ) = σ ( 2 ) ( 1 − σ ( 2 ) ) = 0.0977 \sigma'(2)=\sigma(2)(1-\sigma(2))=0.0977 σ′(2)=σ(2)(1−σ(2))=0.0977:激活导数把误差"衰减"了一个量级 ------连乘多层即梯度消失(见 figures/graph_act_deriv.png)。
3.6 常见运算的局部梯度表(计算图视角)
autograd = 前向时按节点类型建图,反向时查这张表做 VJP:
| 运算 | 前向 | 反向(已知 z ˉ = ∂ L / ∂ z \bar z = \partial\mathcal{L}/\partial z zˉ=∂L/∂z) |
|---|---|---|
| 加法 z = x + y z = x + y z=x+y | 直接相加 | x ˉ = z ˉ , y ˉ = z ˉ \bar x = \bar z,\ \bar y = \bar z xˉ=zˉ, yˉ=zˉ(梯度原样分发) |
| 逐元素乘 z = x ⊙ y z = x \odot y z=x⊙y | 直接相乘 | x ˉ = z ˉ ⊙ y , y ˉ = z ˉ ⊙ x \bar x = \bar z \odot y,\ \bar y = \bar z \odot x xˉ=zˉ⊙y, yˉ=zˉ⊙x(交换乘子) |
| 矩阵乘 Z = X Y Z = XY Z=XY | matmul | X ˉ = Z ˉ Y ⊤ , Y ˉ = X ⊤ Z ˉ \bar X = \bar Z\, Y^{\top},\ \bar Y = X^{\top} \bar Z Xˉ=ZˉY⊤, Yˉ=X⊤Zˉ |
| Sigmoid z = σ ( x ) z = \sigma(x) z=σ(x) | 压缩 | x ˉ = z ˉ ⊙ σ ( x ) ( 1 − σ ( x ) ) \bar x = \bar z \odot \sigma(x)(1-\sigma(x)) xˉ=zˉ⊙σ(x)(1−σ(x)) |
| ReLU z = max ( 0 , x ) z = \max(0,x) z=max(0,x) | 门控 | x ˉ = z ˉ ⊙ x \> 0 \bar x = \bar z \odot x \> 0 xˉ=zˉ⊙x\>0(开关掩码) |
| tanh | 压缩 | x ˉ = z ˉ ⊙ ( 1 − tanh 2 x ) \bar x = \bar z \odot (1 - \tanh^2 x) xˉ=zˉ⊙(1−tanh2x) |
| softmax + 交叉熵 | 概率+log | z ˉ = y ^ − y \bar z = \hat y - y zˉ=y^−y(著名相消) |
| 均值 z = m e a n ( x ) z = \mathrm{mean}(x) z=mean(x) | 聚合 | x ˉ = z ˉ / n \bar x = \bar z / n xˉ=zˉ/n(梯度平分回每个元素) |
| 广播 | 扩形 | 反向沿广播轴求和收回 |
示意图 :标量计算图版见 figures/fig3_autograd.png
第四章 应用场景与作用
4.1 训练一切可微模型(最基本的作用)
CNN / RNN / Transformer / GAN / VAE / 扩散模型 / 策略梯度------只要损失对参数可微,训练就是"前向→backward→step"循环。RNN 的 BPTT(时间反向传播)= 把按时间展开的计算图跑一遍反向传播,梯度消失/爆炸正来自展开图上 σ ′ \sigma' σ′ 的连乘(figures/graph_act_deriv.png)。
4.2 对输入求梯度:显著性图与对抗攻击
反向传播不只服务于参数------把叶子换成输入 x \mathbf{x} x 就得到 ∂ L / ∂ x \partial \mathcal{L}/\partial \mathbf{x} ∂L/∂x:
- 显著性图 : ∣ ∂ L / ∂ x i j ∣ \lvert \partial \mathcal{L}/\partial x_{ij} \rvert ∣∂L/∂xij∣ 大的像素 = 对决策贡献大的区域(可解释性);
- FGSM 对抗攻击 : x a d v = x + ϵ s i g n ( ∇ x L ) \mathbf{x}{\mathrm{adv}} = \mathbf{x} + \epsilon\, \mathrm{sign}(\nabla{\mathbf{x}} \mathcal{L}) xadv=x+ϵsign(∇xL),沿梯度方向一步即可骗过分类器;
- 代码见 5.4。
4.3 梯度惩罚(WGAN-GP)
Wasserstein GAN 要求判别器 1-Lipschitz: E ∥ ∇ x \^ D ( x \^ ) ∥ 2 − 1 ) 2 → 0 \mathbb{E}\\lVert \\nabla_{\\hat x} D(\\hat x) \\rVert_2 - 1)\^2 \to 0 E∥∇x\^D(x\^)∥2−1)2→0------需要对输入的梯度再求梯度 (二阶),靠 create_graph=True 实现(5.5)。
4.4 高阶梯度:PINN / MAML / 隐函数定理
- PINN(物理信息神经网络) :损失含 ∂ u / ∂ t , ∂ 2 u / ∂ x 2 \partial u/\partial t,\ \partial^2 u/\partial x^2 ∂u/∂t, ∂2u/∂x2 等网络对输入的偏导,必须保留计算图二次反传;
- MAML 元学习:目标是"梯度下降一步之后的损失",即梯度的梯度;
- 牛顿法/Hessian 向量积也可由两次 VJP 组合得到。
4.5 梯度诊断与网络手术
- 梯度消失/爆炸 :逐层打印 ∥ δ ( l ) ∥ \lVert \boldsymbol{\delta}^{(l)} \rVert ∥δ(l)∥(hook,见 5.7)定位病层 → 换激活/加残差/用 LN/裁剪;
- 敏感度分析 : ∥ ∂ L / ∂ θ i ∥ \lVert \partial \mathcal{L}/\partial \theta_i \rVert ∥∂L/∂θi∥ 小的参数可剪枝;
- 特征归因(Integrated Gradients 等)全部建立在输入梯度之上。
4.6 作用总结表
| 作用 | 依赖的反传能力 | 典型公式 |
|---|---|---|
| 参数更新 | ∂ L / ∂ θ \partial\mathcal{L}/\partial\theta ∂L/∂θ | θ ← θ − η ∇ θ L \theta \leftarrow \theta - \eta\nabla_\theta\mathcal{L} θ←θ−η∇θL |
| 可解释性/对抗 | ∂ L / ∂ x \partial\mathcal{L}/\partial x ∂L/∂x | x + ϵ s i g n ( ∇ x L ) x + \epsilon\,\mathrm{sign}(\nabla_x \mathcal{L}) x+ϵsign(∇xL) |
| 正则约束 | ∇ x D ( x ) \nabla_x D(x) ∇xD(x) 的范数 | ( ∥ ∇ x ^ D ∥ − 1 ) 2 (\lVert\nabla_{\hat x}D\rVert-1)^2 (∥∇x^D∥−1)2 |
| 物理约束/元学习 | 二阶导 | ∂ 2 u / ∂ x 2 \partial^2 u/\partial x^2 ∂2u/∂x2、 ∇ θ ( ∇ θ L ) \nabla_\theta(\nabla_\theta \mathcal{L}) ∇θ(∇θL) |
| 训练诊断 | 逐层 ∥ δ ( l ) ∥ \lVert\delta^{(l)}\rVert ∥δ(l)∥ | hook 监控 |
第五章 PyTorch autograd 机制与实战代码
5.1 机制速览
-
动态图 :前向时即时建图(每个运算记录
grad_fn),backward()后即释放(除非retain_graph=True)→ 可用 Python 控制流(if/for)写网络; -
叶子节点 :用户创建的
requires_grad=True张量(参数/输入);只有叶子的梯度被保留在.grad,中间节点梯度用完即弃(省显存); -
梯度累加 :
.grad默认累加 而非覆盖 → 每步训练前必须zero_grad(); -
torch.no_grad():不建图(推理/更新参数时用);detach():从图中切出一支(算 TD 目标、训 D 冻 G 时用)。forward: w ─mul─▶ u ─sub─▶ v ─pow─▶ L 每个节点记住: 自己的 grad_fn + 输入引用
backward: w.grad ◀── 3 ◀── 1 ◀── 2v ◀── 1 逆拓扑序执行 VJP,图随即释放
5.2 代码 1:标量计算图手验链式法则
python
import torch

w = torch.tensor(2.5, requires_grad=True)   # 叶子节点:backward 后梯度存进 w.grad
u = 3 * w                                   # 节点 u(grad_fn=MulBackward),图开始生长
v = u - 6                                   # 节点 v(SubBackward)
L = v ** 2                                  # 节点 L(PowBackward);标量才能直接 backward
L.backward()                                # 逆拓扑序: L→v→u→w,每步乘局部导数
print(w.grad)                               # tensor(9.) = 2v·1·3 = 2·1.5·3 ✓ 与手算一致

# backward 内部做的三步 VJP(对应 3.6 的表):
#   L→v: dL/dv = 2v = 3      v→u: dv/du = 1    u→w: du/dw = 3
#   连乘: 3·1·3 = 9
print(L.grad_fn)                            # <PowBackward0>:图的"节点类型"标签
# ⚠ 再次 backward 会报 "graph freed":动态图用完即释放,需 retain_graph=True 才能二遍
代码解读
requires_grad=True只在叶子上设置;中间张量自动带梯度标志但梯度不保留;backward()只能对标量 调用;非标量需传gradient=参数(指定上游伴随 y ˉ \bar y yˉ);- 打印
grad_fn是理解"图结构"的最快方式:链式即Pow→Sub→Mul→AccumulateGrad。
5.3 代码 2:手写反向传播公式 ↔ autograd 互验(证明 3.3/3.4 公式)
python
import torch
torch.manual_seed(0)

# ---- 两层网络: x(2维) → tanh隐藏(3维) → 线性输出(1维), MSE ----
X = torch.randn(4, 2);  Y = torch.randn(4, 1)                    # 4 个样本
W1 = torch.randn(2, 3, requires_grad=True); b1 = torch.zeros(3, requires_grad=True)
W2 = torch.randn(3, 1, requires_grad=True); b2 = torch.zeros(1, requires_grad=True)

# ---- 前向 + autograd 反向 ----
A1 = torch.tanh(X @ W1 + b1)                 # a⁽¹⁾ = σ(z⁽¹⁾)
loss = ((A1 @ W2 + b2 - Y) ** 2).mean()      # L = mean((ŷ−y)²)
loss.backward()                              # autograd 填充 W1.grad ... b2.grad

# ---- 用第三章公式手工算同样的梯度(batch 矩阵形式)----
with torch.no_grad():
    Z1 = X @ W1 + b1;  A1c = torch.tanh(Z1)
    Yhat = A1c @ W2 + b2
    n = X.shape[0]
    d2 = 2 * (Yhat - Y) / n                  # δ⁽²⁾ = ∂L/∂z⁽²⁾(线性输出 + MSE mean)(4,1)
    gW2 = A1c.T @ d2                         # δ⁽²⁾(a⁽¹⁾)ᵀ 的 batch 形式: Σᵢ δ aᵀ = AᵀΔ  (3,1)
    gb2 = d2.sum(dim=0)                      # 偏置梯度 = δ 沿 batch 求和  (1,)
    dA1 = d2 @ W2.T                          # (W⁽²⁾)ᵀδ⁽²⁾ 传回隐藏层  (4,3)
    d1 = dA1 * (1 - A1c ** 2)                # ⊙ σ'(z⁽¹⁾), tanh' = 1−tanh²  → δ⁽¹⁾
    gW1 = X.T @ d1                           # δ⁽¹⁾xᵀ 的 batch 形式  (2,3)
    gb1 = d1.sum(dim=0)                      # (3,)

# ---- 互验 ----
for name, manual, auto in [("W1", gW1, W1.grad), ("b1", gb1, b1.grad),
                           ("W2", gW2, W2.grad), ("b2", gb2, b2.grad)]:
    assert torch.allclose(manual, auto, atol=1e-6), name
print("手写反传公式 == autograd ✓")          # 公式 3.3/3.4 被数值验证
代码解读
A1c.T @ d2就是 ∑ i δ i a i ⊤ \sum_i \boldsymbol\delta_i \mathbf{a}_i^\top ∑iδiai⊤:单样本外积、batch 求和 = 一次矩阵乘;- 偏置梯度没有"上游激活"可外积 → 直接对 batch 维求和(广播的反向规则);
1 - A1c**2用的是 tanh 导数关于激活值 的形式,避免重存 z z z------工程上常见的小优化;- 这段代码是理解"框架替你做了什么"的最佳练习:改网络结构时照抄递推即可手推梯度。
示意图 :递推结构见 figures/bp_layers.png
5.4 代码 3:对输入求梯度 ------ FGSM 对抗样本与显著性图
python
x = images.clone().requires_grad_(True)     # 把"输入"变成需要梯度的叶子(默认 False!)
logits = model(x)
loss = torch.nn.functional.cross_entropy(logits, labels)
model.zero_grad()                           # 清参数梯度(本例关心的是 x.grad,但习惯上清干净)
loss.backward()                             # 反传一路走到叶子 x → x.grad = ∂L/∂x

adv = x + eps * x.grad.sign()               # FGSM: 沿梯度符号方向走一步 → 对抗样本
saliency = x.grad.abs()                     # 显著性图: |∂L/x| 大的像素 = 决策依据
# 可视化 saliency 叠加原图,可看出模型"在看哪里"(调试错分类的利器)
代码解读
requires_grad_(True)是原地 方法(带下划线),作用于已存在的张量;clone()防止污染原数据;- 同一次 backward 会同时填参数梯度和
x.grad------反传不区分"谁是参数",只认叶子; - FGSM 的直觉: s i g n ( ∇ x L ) \mathrm{sign}(\nabla_x\mathcal{L}) sign(∇xL) 是"让损失上升最快的像素级方向",ε 常取 0.01~0.1(像素归一化到 0,1 时)。
5.5 代码 4:二阶梯度 ------ WGAN-GP 梯度惩罚(create_graph)
python
theta = torch.rand(B, 1, 1, 1)
xhat = (theta * real + (1 - theta) * fake).requires_grad_(True)   # 真假插值点 x̂
d_out = D(xhat).sum()                       # 先对 batch 求和得到标量(sum 不影响逐样本梯度)

grad_x = torch.autograd.grad(outputs=d_out, inputs=xhat,
                             create_graph=True)[0]   # 一阶 ∇_x̂ D;create_graph=保留这次的图
gp = ((grad_x.norm(2, dim=1) - 1) ** 2).mean()       # (‖∇D‖₂ − 1)² 惩罚项
loss = d_loss + 10 * gp
loss.backward()        # 第二次 backward:梯度穿过"第一次的梯度" → 得到二阶信息
代码解读
torch.autograd.grad(...)与tensor.backward()的区别:返回 梯度而不累加进.grad,适合取中间量;create_graph=True让"求梯度"这个操作本身可微------二阶/高阶导数的唯一开关;PINN、MAML 同理;- 不开 create_graph 时
loss.backward()到grad_x处断链 → 惩罚项梯度为 0(静默错误,最难查)。
5.6 代码 5:自定义 autograd.Function(教框架新运算的反向)
python
class Cube(torch.autograd.Function):
    """自定义算子: 前向 y = x³;反向 x̄ = ȳ · 3x²"""
    @staticmethod
    def forward(ctx, x):
        ctx.save_for_backward(x)        # 把反向需要的张量存进 ctx(框架负责生命周期)
        return x ** 3
    @staticmethod
    def backward(ctx, grad_y):          # grad_y = 上游伴随 ȳ = ∂L/∂y
        (x,) = ctx.saved_tensors
        return grad_y * 3 * x ** 2      # 返回值 = ∂L/∂x;顺序与 forward 输入一一对应

x = torch.tensor(2.0, requires_grad=True)
y = Cube.apply(x)                       # ⚠ 用 .apply 调用(直接 Cube.forward 不建图)
y.backward()
print(x.grad)                           # 3·2² = 12 ✓
代码解读
- 何时需要写:调用非 PyTorch 内核(CUDA/C++/numba)、需要定制数值稳定版本、或做梯度裁剪式自定义反传;
ctx.save_for_backward只存张量(存中间结果比重算省时间,但费显存------可改在 backward 重算换显存);- 多输入多输出时:forward 返回元组、backward 返回等长梯度元组(不需要梯度的位置返回
None)。
5.7 代码 6:hook 逐层监控梯度范数(诊断消失/爆炸)
python
hooks = []
for name, p in model.named_parameters():
    def make(n):                        # 闭包工厂:避免循环变量捕获陷阱
        def hook(grad):                 # backward 流过该参数时自动调用
            print(f"{n:28s} ‖grad‖={grad.norm():.3e}")
            return None                 # 返回 None = 不修改梯度;返回张量 = 替换梯度
        return hook
    hooks.append(p.register_hook(make(name)))

loss.backward()                         # 打印顺序 = 反向顺序(输出层先、输入层后)
for h in hooks: h.remove()              # 用完移除,否则每次 backward 都打印
# 判读: 靠近输入的层 ‖grad‖ 逐层 <1e-6 递减 → 梯度消失(换 ReLU→检查激活/加残差)
#       某层 ‖grad‖ >1e3 突增 → 梯度爆炸(clip_grad_norm_ / 检查学习率)
代码解读
register_hook挂在张量上:参数张量在 AccumulateGrad 前触发,是观测 δ 流的最佳探针;- 打印的顺序本身就是反传顺序的直观教材:从输出层往输入层依次出现;
- 想改梯度(如裁剪某层)就在 hook 里返回新张量------gradient surgery 的入口。
示意图 :完整训练循环中 backward 的位置见 figures/fig9_training_loop.png;激活导数与消失的关系见 figures/graph_act_deriv.png
第六章 常见陷阱与调试清单
| 陷阱 | 症状 | 解法 |
|---|---|---|
忘记 zero_grad() |
损失不降反震荡(梯度是历史累加) | 三步曲顺序:zero→backward→step |
对非标量 backward() |
报错要求 gradient 参数 |
传上游伴随,或先 .sum()/.mean() |
目标侧未 detach()/no_grad |
训练发散(自己追自己) | TD 目标、GAN 训 D、蒸馏 teacher 都要切图 |
二次 backward() |
"Trying to backward through the graph a second time" | retain_graph=True 或重构循环 |
| 原地操作破坏图 | 报错或静默错梯度 | 避免对需梯度张量用 x +=、x.mul_ |
推理忘 no_grad |
显存爆、速度慢 | with torch.no_grad(): 或 torch.inference_mode() |
取 .data/.numpy() 断链 |
梯度为 None | 用 .detach() 显式断链,别在训练路径误用 |
| hook 未移除 | 每次 backward 重复执行副作用 | 保存句柄并 remove() |
生成日期:2026-09-20 · 配图脚本:make_bp_figures.py(bp_layers / bp_cost)· 配套:《深度学习常用公式手册.md》《深度学习符号速查表.md》