小米真的是"营销学"大师,无论哪个领域都是,从手机到汽车,再到 AI!
MiMo2.6 还没发布,就把训练过程给直播了,话题十足! 模型未必第一,但是确实是第一个直播 RL 过程的!
模型发布之后,又在 AA 上拿下了"国模第一"的排名!
我是从小米的第一代模型开始测起的,一直跟到了 2.5。
我之前的结论是,它和 MiniMax 这两个 M 就是大模型界的"卧龙·凤雏"!
"凤雏"已经熄火了,"卧龙"还在进步中! 这个还是要点个赞的。
今天 MiMo2.6Pro 新鲜出炉,我们再来实测一波。看看这个头衔还能不能"保住"或者"摘掉"!
1、基础信息
关于 MiMo2.6Pro 我接触到的第一条信息是,听说它是"国模一哥了",依据是下面这张图:
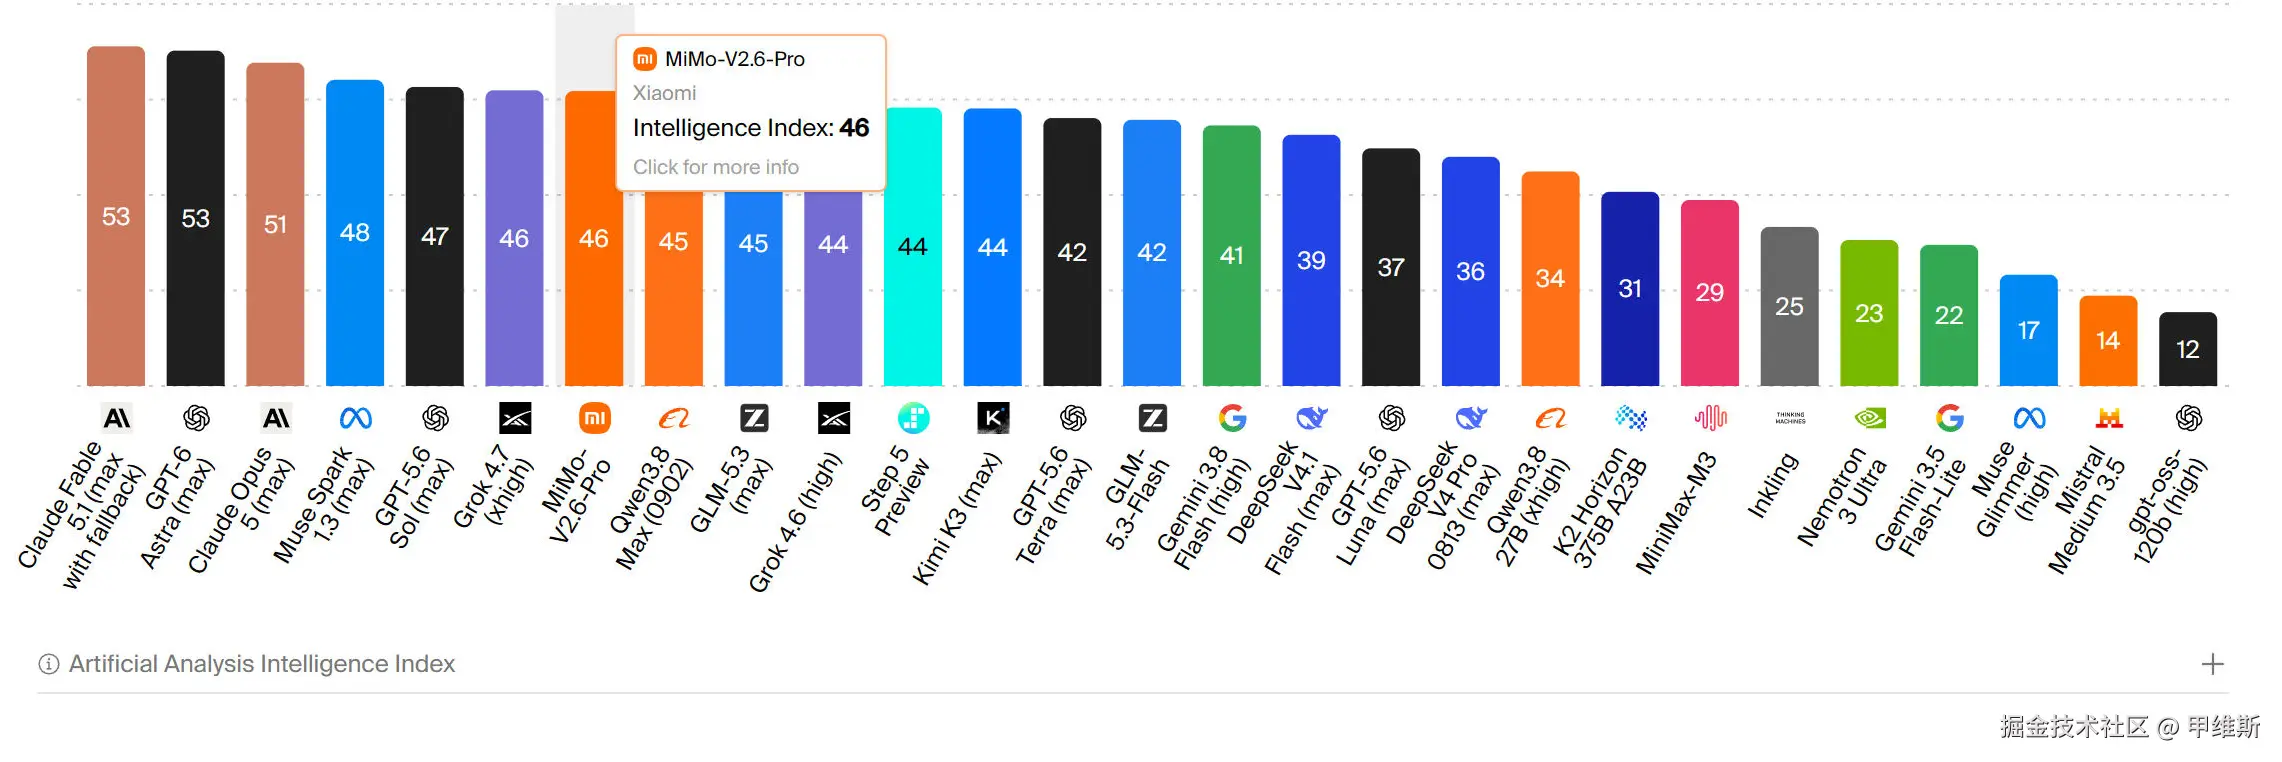
这是 Artificial Analysis 的一个榜单!
Artificial Analysis(artificialanalysis.ai)是一个独立的 AI 大语言模型及 API 推理服务商基准评测与分析平台。相当于 AI 领域的"懂车帝"。
上图显示的是综合智能指数(Intelligence Index) :
通过严苛的复合评测集(包括代码生成、科学推理、长上下文长程推理、事实性与抗幻觉能力等),给出各大模型的综合得分与分项排名。
因为我对大模型竞技场已经毫无信任了,最近主要是看这个平台。
我整体来说还是比较信任它,但是......我们还是往下看吧!
现在先来看各种客观的数据!
AA 上显示它的综合得分情况是:
仅次于 Fable 5.1、GPT-5.6 Astra、Opus 5、Muse 1.3、GPT-5.6。
齐平最新的 Grok 4.7。
超过了所有国产模型,包括 Qwen 3.8 Max、GLM5.3 Max、Step5、Kimi K3。
从这个数据中确实可以得到国模综合第一的结论!
但是,榜单这个东西真的"很迷"的。
Muse 这个模型的水平,谁用谁知道,排名居然这么高!
关于 MiMo2.6 的第二印象来自官方发布页!
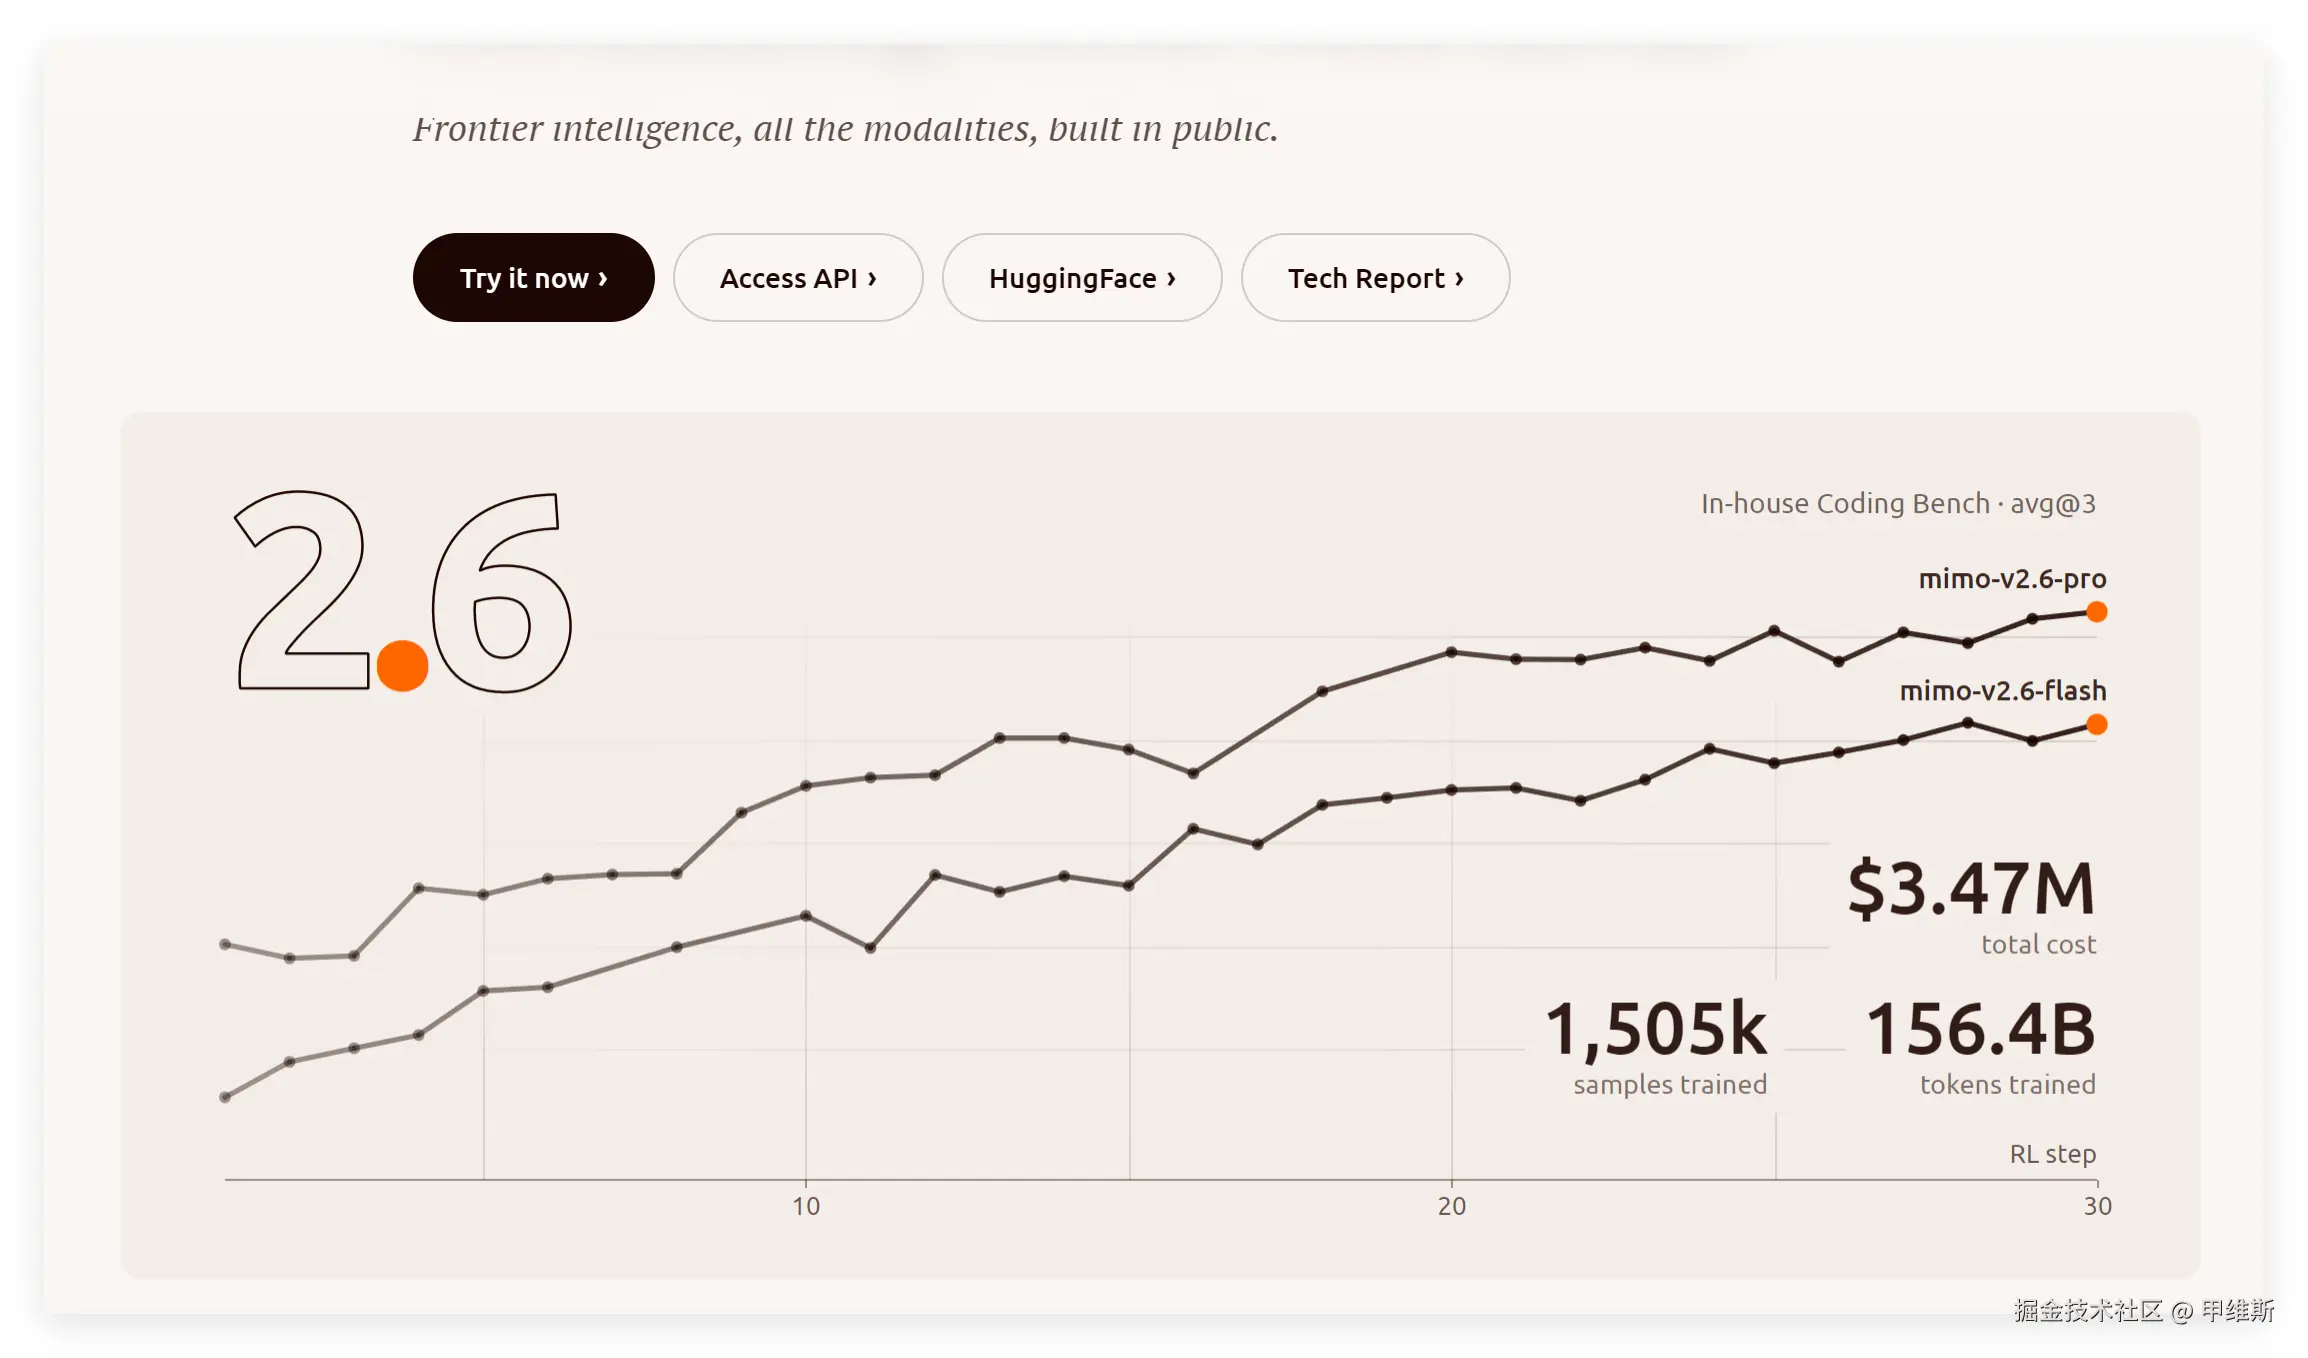
说实话,页面做得非常漂亮,我是蛮喜欢这种配色的!
博客的开头是这样的:
今天,我们正式发布并开源了 MiMo-V2.6 系列。这标志着我们在探索 RSI 路径上迈出了关键一步:在可验证的复杂任务上扩展强化学习计算能力,从而使模型能够通过探索和反馈不断扩展其能力边界。
成功用上了热词"RSI",哈哈!
然后就是核心基准数据了:
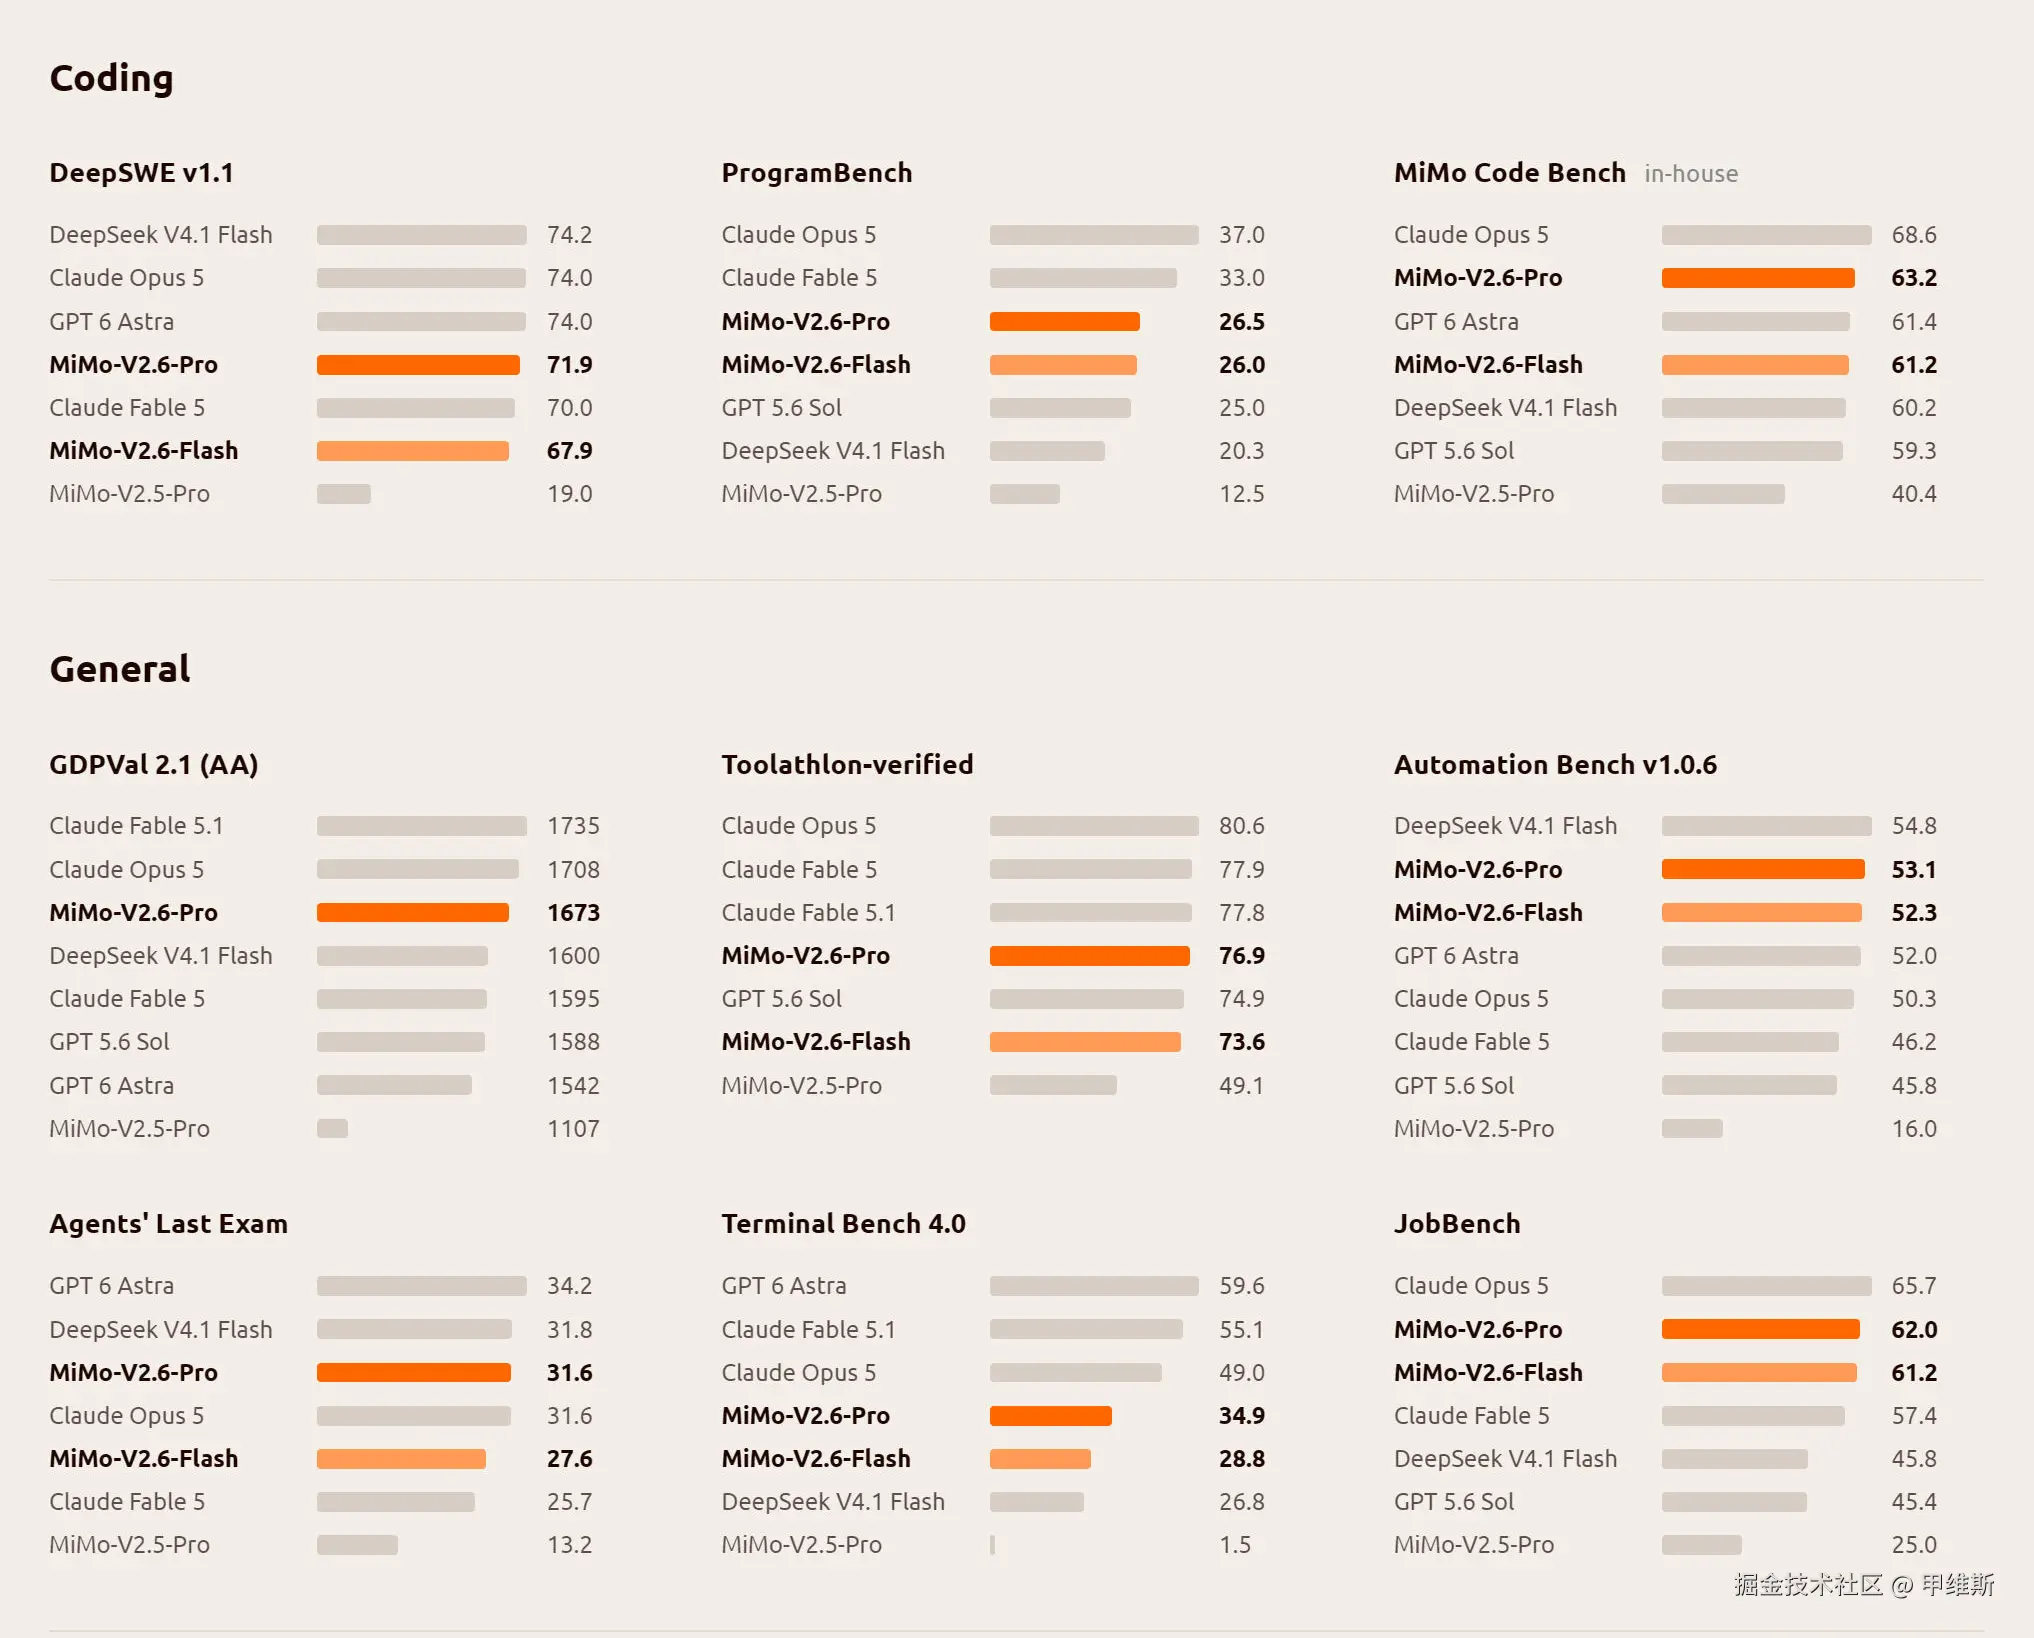
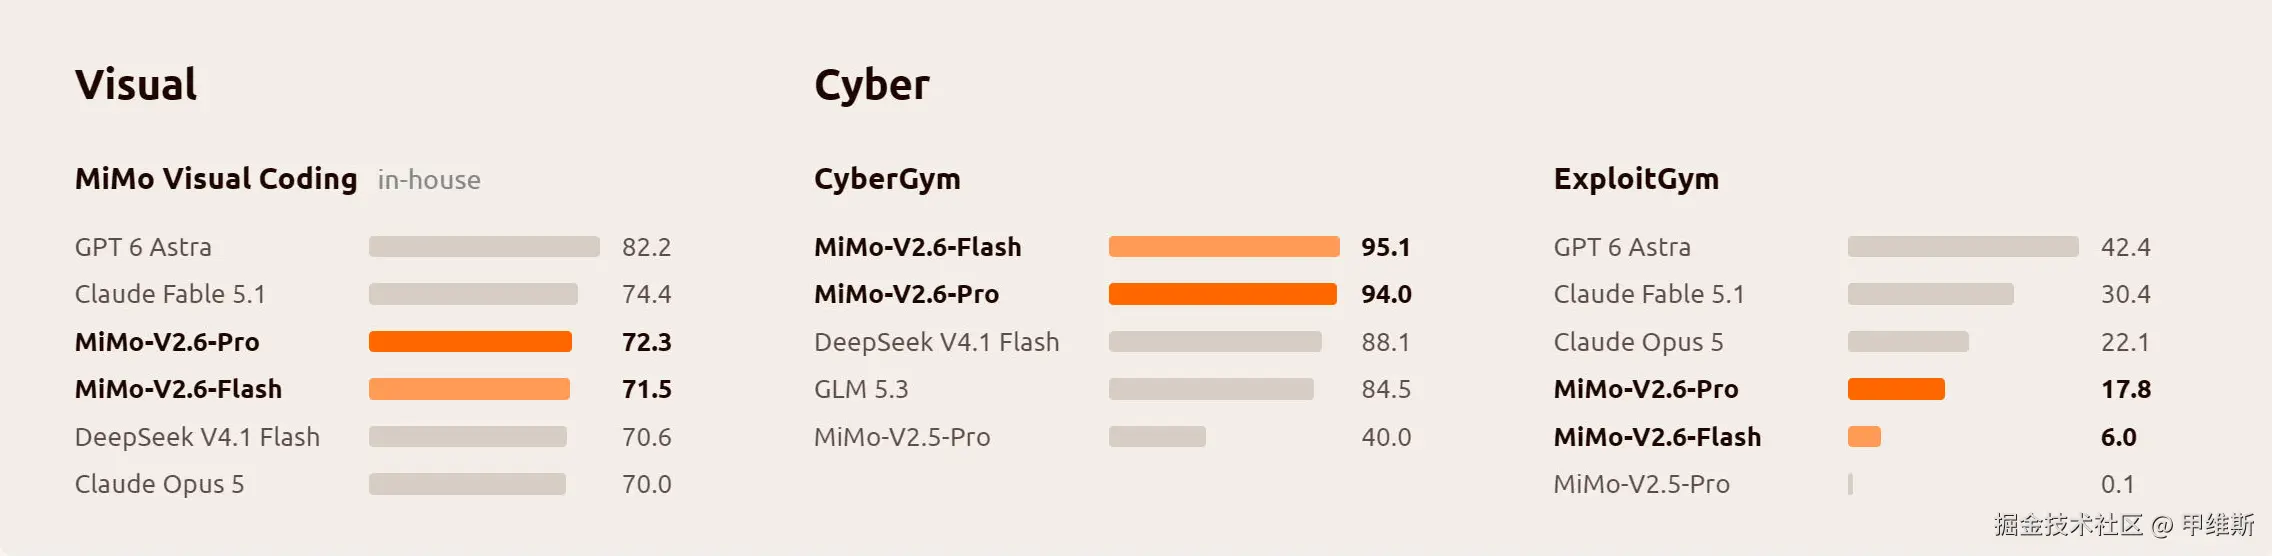
这个基准数据还是很好看的!
我让 G3.8 做了一个基于数据的客观总结:
- 跨代提升极其巨大 相比上一代 MiMo-V2.5-Pro,V2.6 在全维度实现了翻倍式的断崖升级(例如 Terminal Bench 从 1.5% 跃升到 34.9%,编程能力提升数倍)。
- 整体实力:稳居"第一梯队中上游" 在大部分编码(Coding)与通用智能/工作流(General) 任务中,MiMo-V2.6-Pro 紧咬 Claude Opus 5 和 GPT-6 Astra,与 DeepSeek V4.1 Flash、GPT-5.6 互有胜负。
- Flash 轻量版表现极其惊艳(越级逼近 Pro) MiMo-V2.6-Flash 的表现与 Pro 版相差无几(如 JobBench 得分 61.2 vs 62.0,ProgramBench 26.0 vs 26.5); 在轻量/低成本场景下,Flash 的性价比非常突出。
- 优势领域(长板) 网络安全评测(CyberGym):MiMo-V2.6-Flash (95.1) 和 Pro (94.0) 包揽全球前两名,断层领先 DeepSeek 和 GLM; 企业自动化与实际工作任务(JobBench、Automation Bench、GDPVal):排名靠前,甚至超越了部分 Claude/GPT 旗舰。
- 薄弱环节(短板) 高阶终端操作与实战渗透(Terminal Bench、ExploitGym):得分在 17~34 左右,与 GPT-6 Astra(59.6 / 42.4)和 Claude Fable 相比仍有明显代差,在复杂命令行环境和高难度漏洞利用上仍需补强。
这是 G3.8F 根据官方基准得出的结论,仅供参考。
这个数据的注水量有多大,只有测过才知道!
除了基准数据之外,官方博客很显然也是把 AA 的截图放在了靠前的位置!
同时还有一张非常关键的表格:
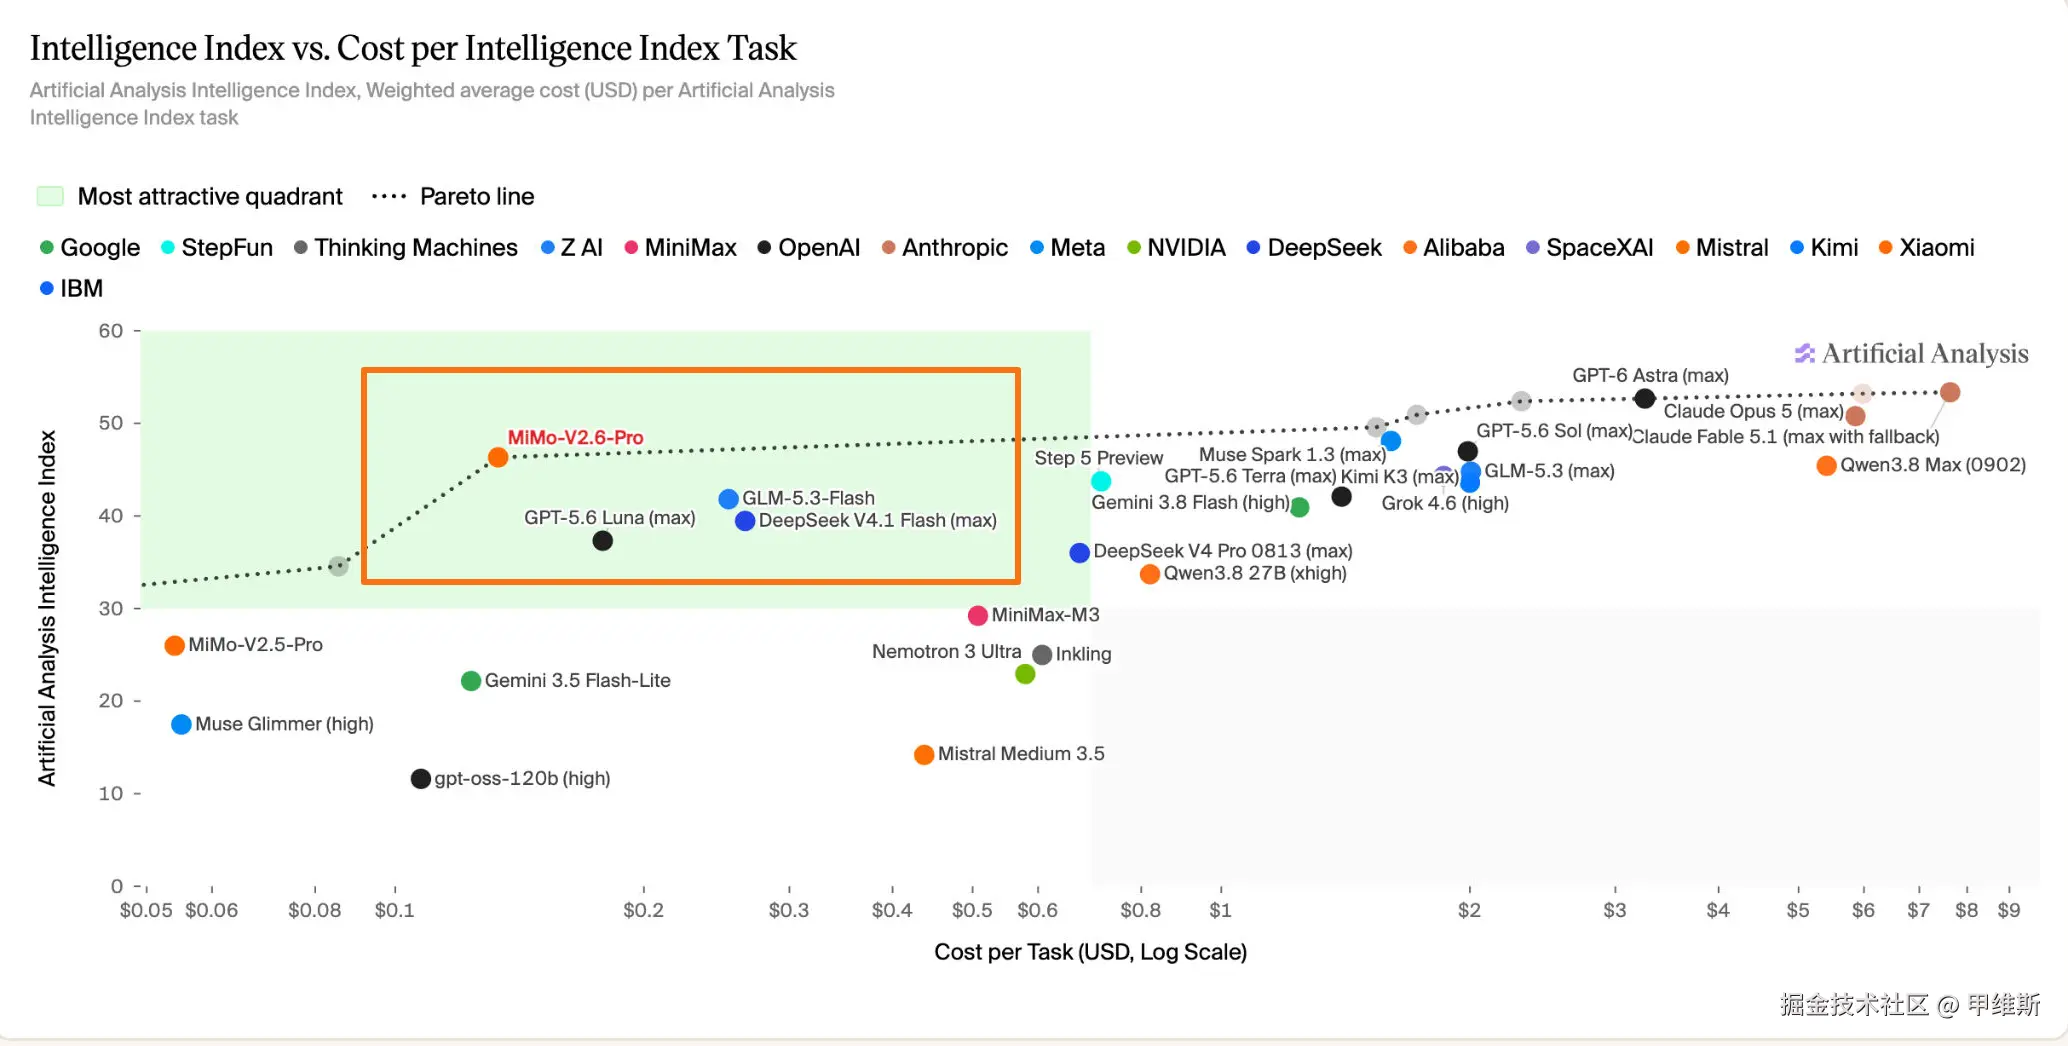
这是单任务消耗表!
就是同样的任务,谁花的钱少,谁更聪明。
纵坐标是能力,横坐标是花费,越是在左上方,越好!
MiMo2.6Pro 的价格是:
输入 ¥3 / 百万 tokens,输出 ¥6 / 百万 tokens,缓存命中甚至只有 ¥0.025 / 百万 tokens
从上面的图中可以看到这个模型性价比极高!
除了秀数据之外,还秀了好多例子:
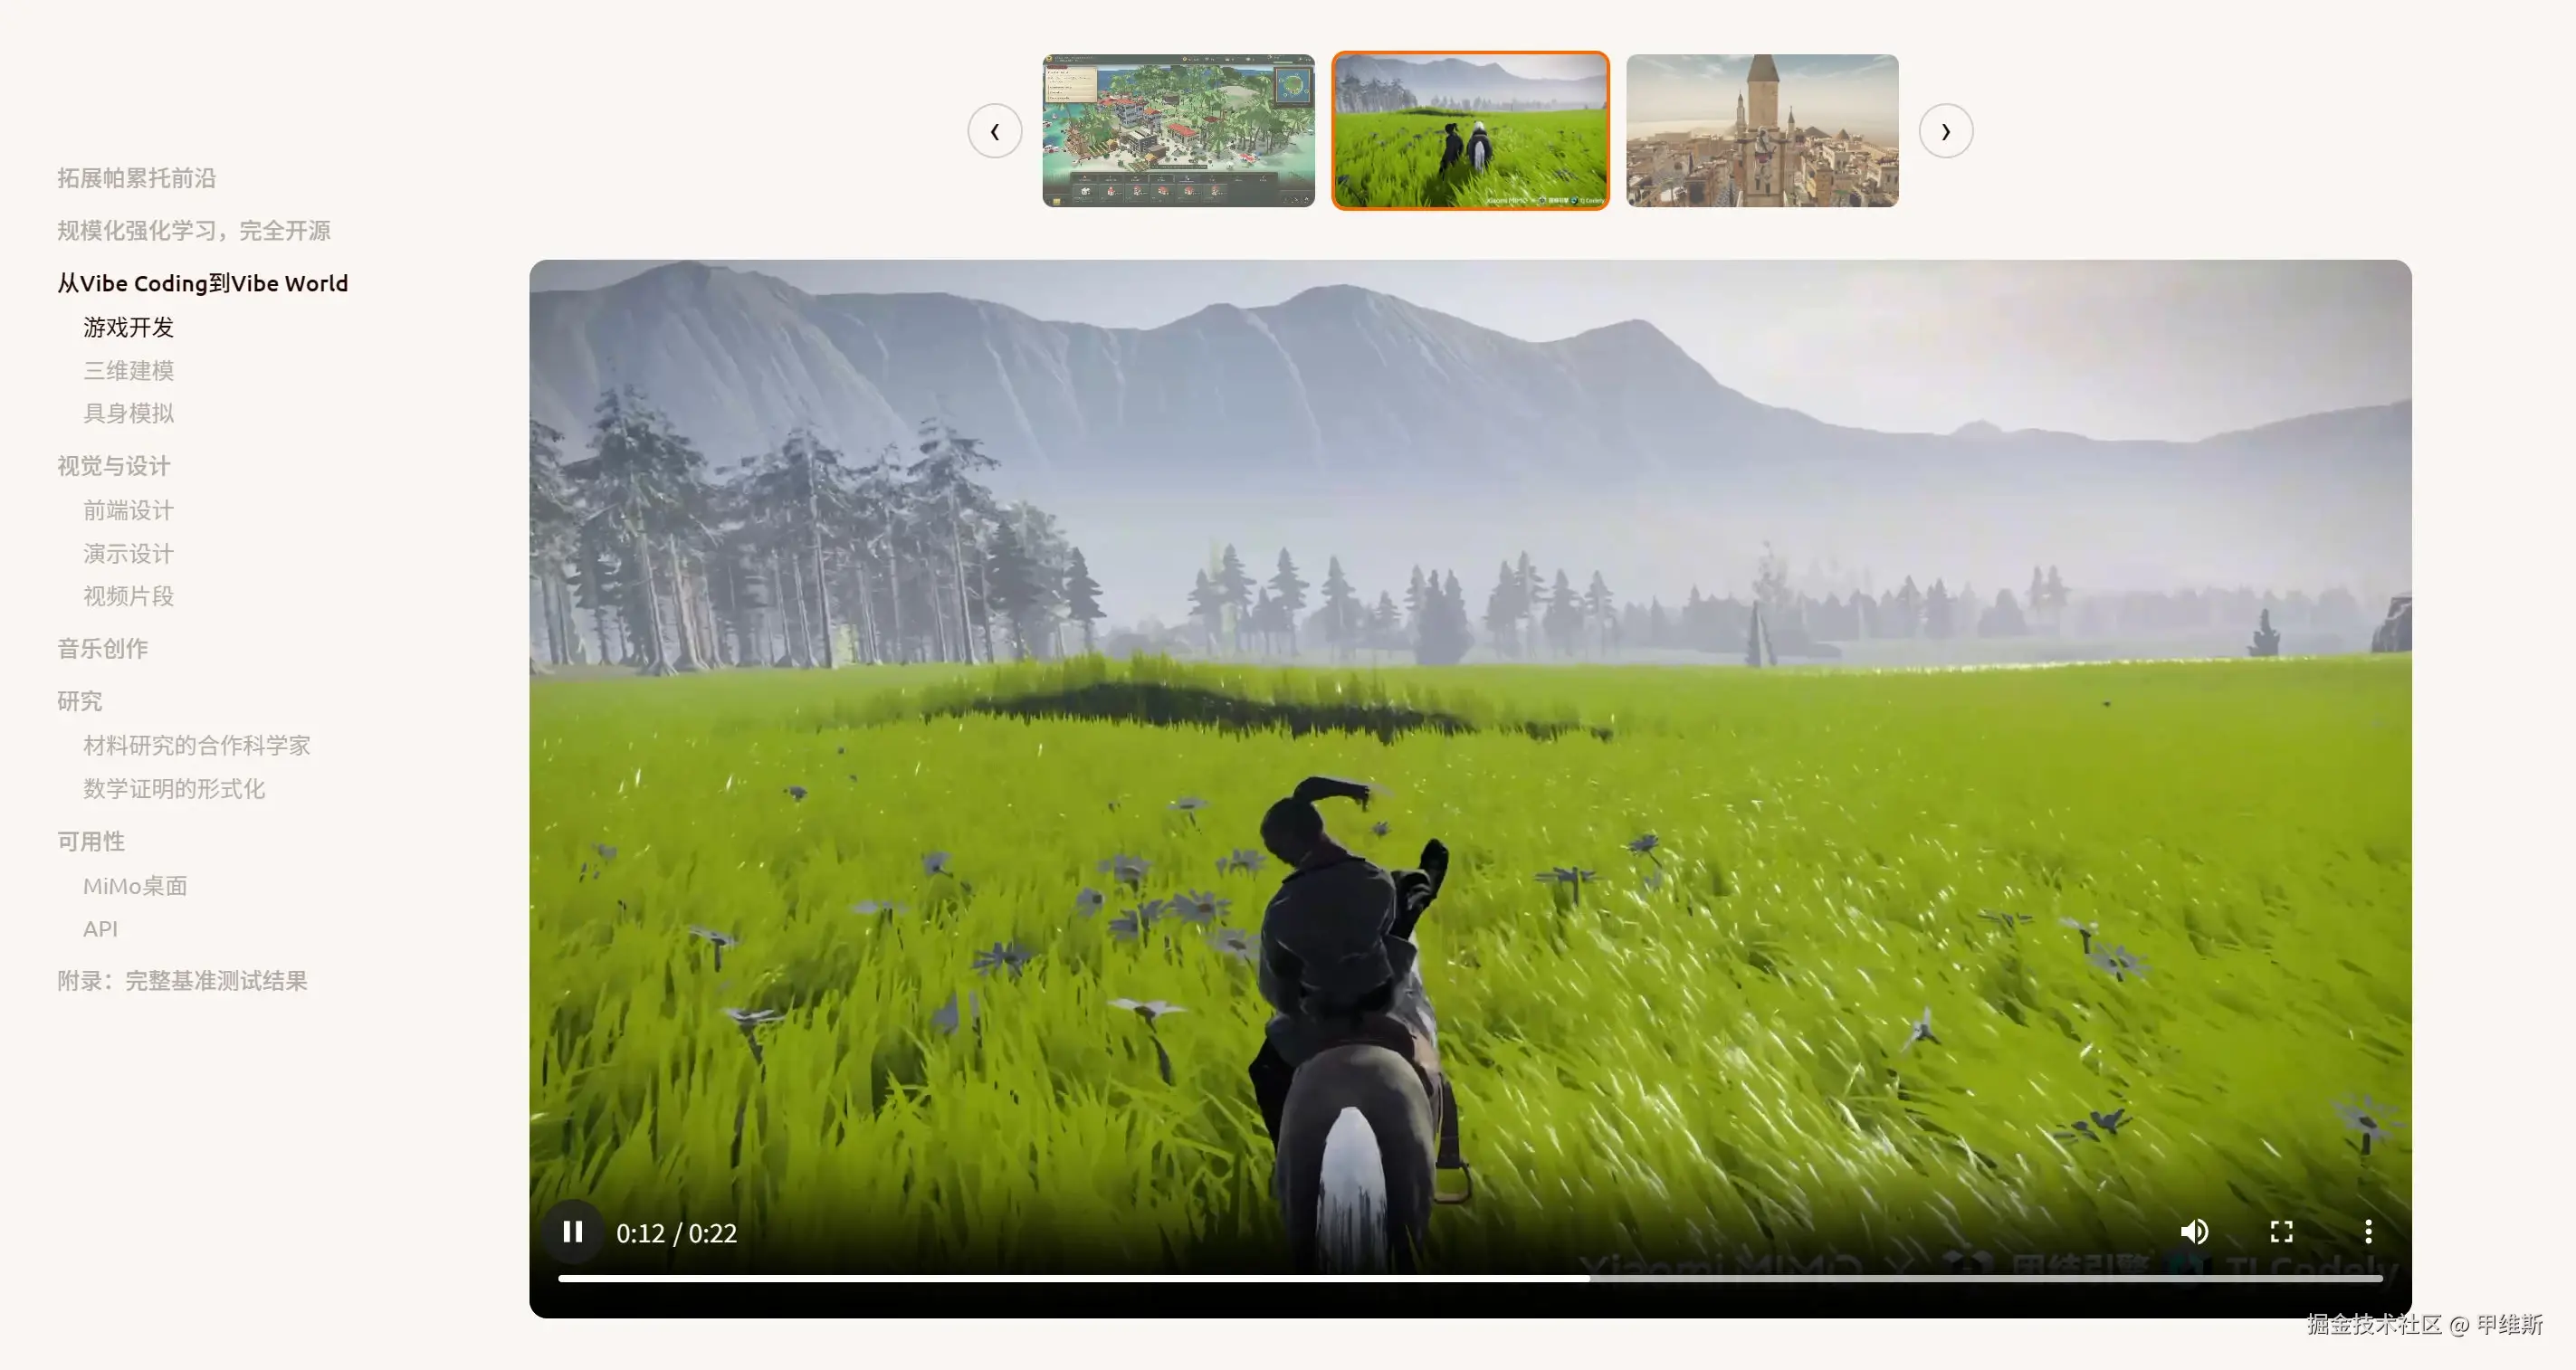
这部分叫做"从 VibeCoding 到 Vibe World!"
主要是讲了,游戏开发、三维建模、具身模拟。然后还有一部分是视觉与设计和音乐创作。
看官方例子做的还是很好的!
游戏开发部分,直接把梦想城镇、"大表哥"和刺客信条的山寨版都给搞出来了。
这都是我比较感兴趣的部分。MiMo 这个饼画得我已经很想吃了!
整体来说,卖家秀做得很好!
无论是数据啊、例子啊、网页设计的效果啊,看起来都非常棒。 单看上面的榜单和官方介绍,我还是蛮想用这个模型的。
完整内容参考:
有需要深入了解、获取客观信息的,可以查看这个地址。大家可以根据官方的卖点和自己工作场景的匹配度来选择使用这个模型。
但是,我测了这么多,这么久的模型。
我非常清楚官方的例子和官方的基准是什么含义,榜单这种东西又有多少可信度!
具体怎么样,只有实测了才知道,而且不能测官方给的例子,也不能测基准中的例子。所以我还是按我自己的节奏来!
我每次测试并不是为了找几个牛逼例子给大家吹一下这个模型有多厉害。
我很早就说过,真正的测试是发现问题,只说优点的叫商单!
2、实测结果
测了一整天,把常跑的几个例子都跑了一遍。它是什么个水平,大致有数了!
接下来,我就要火力全开了。
我先满足一下要"打脸"小米的朋友! 我测到了一个特别糟糕的例子。
MiMo2.6Pro 花了 30 分钟做的超级玛丽如下:
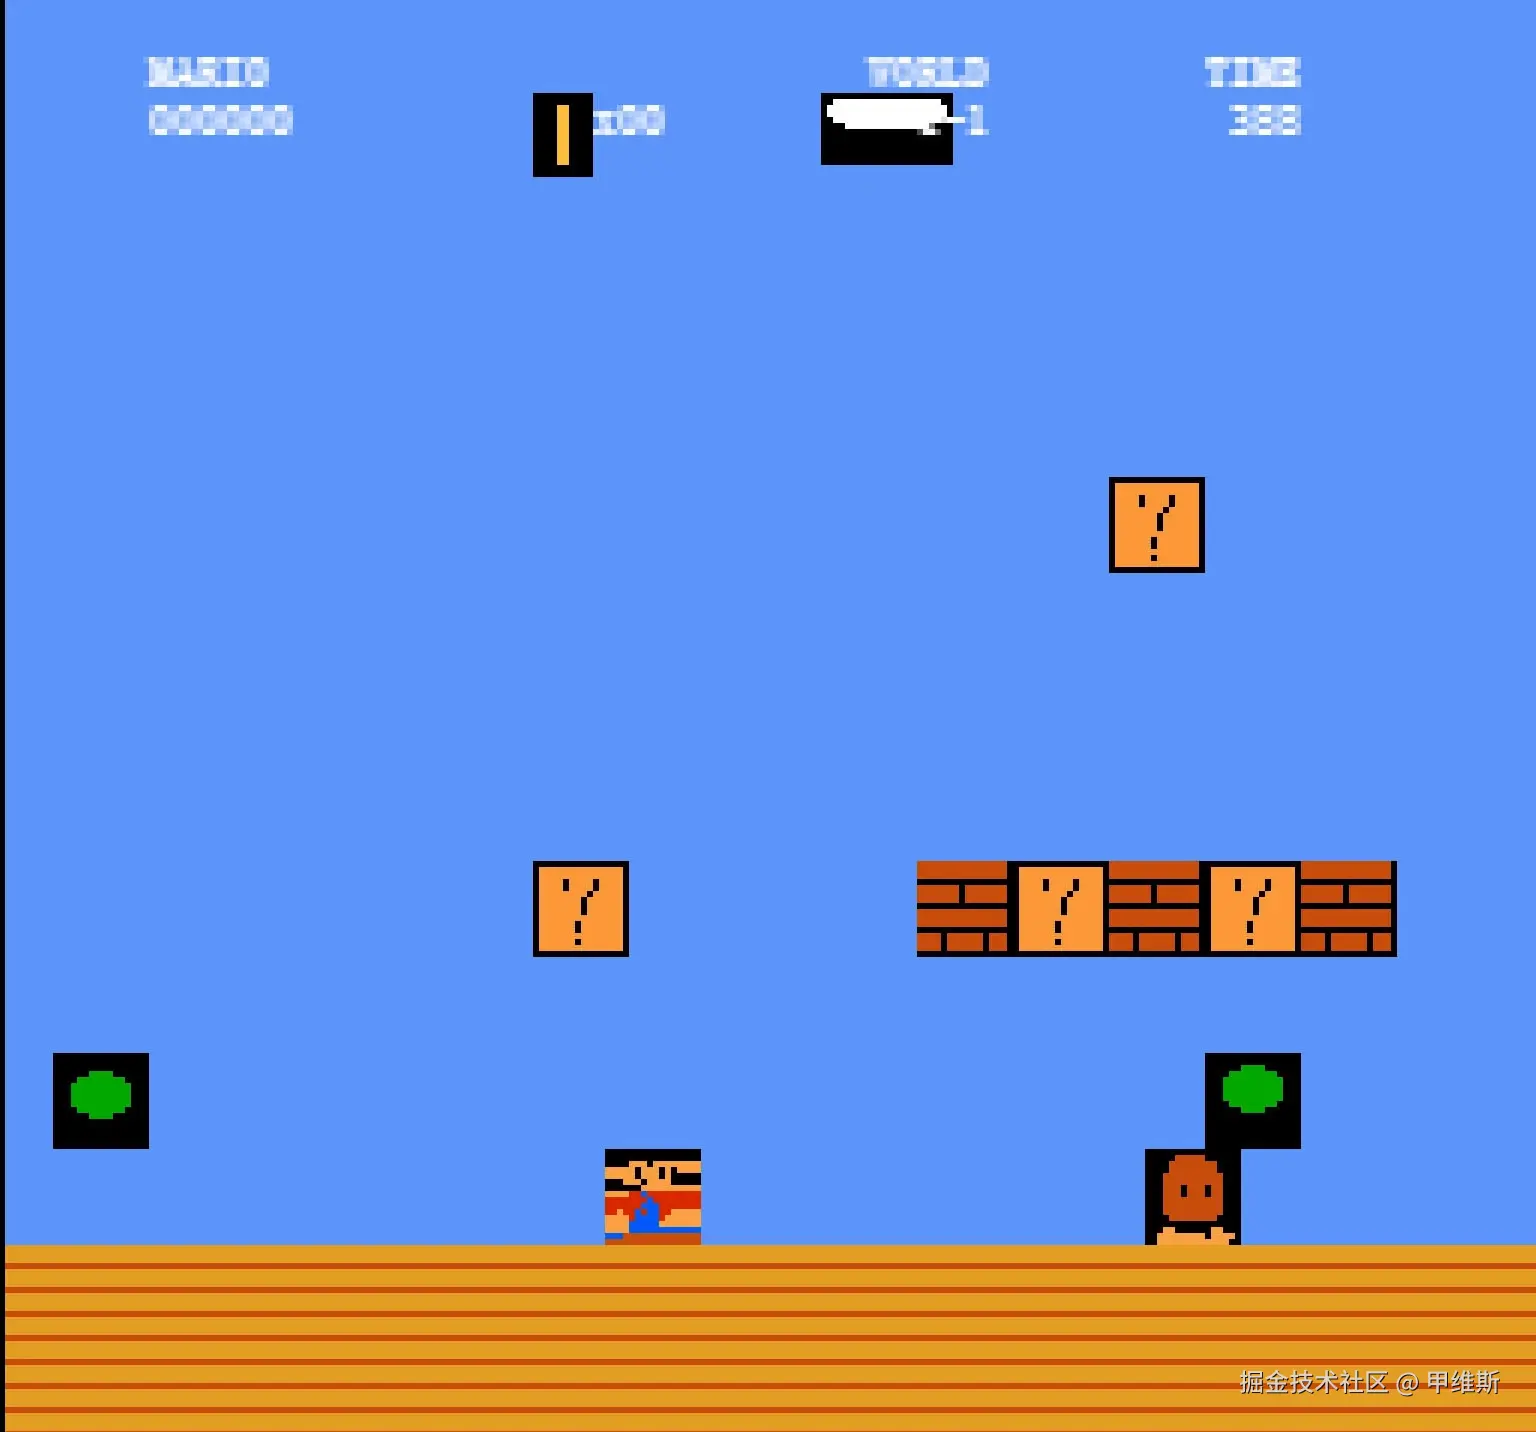
这是妥妥的"卧龙"水平了! 地图、画面、角色、玩法,几乎没有一样是做好了的。
我一直以为这个例子快要淘汰了!
没想到,MiMo2.6Pro充分证明了,这个例子有用!
其实,我提示词里都说了,网络攻略和 GitHub 代码随便抄。厉害的模型,看一下参考代码就能自己手搓个 8090 分。MiMo 是看了代码直接做了 1020 分!
抄都抄不明白。我忍不住要吐槽了。
当然它也可以把锅甩给 OpenCode!
我看了生成过程,它只做了基本的语法检查,完全没有截图分析画面,然后进行迭代升级。
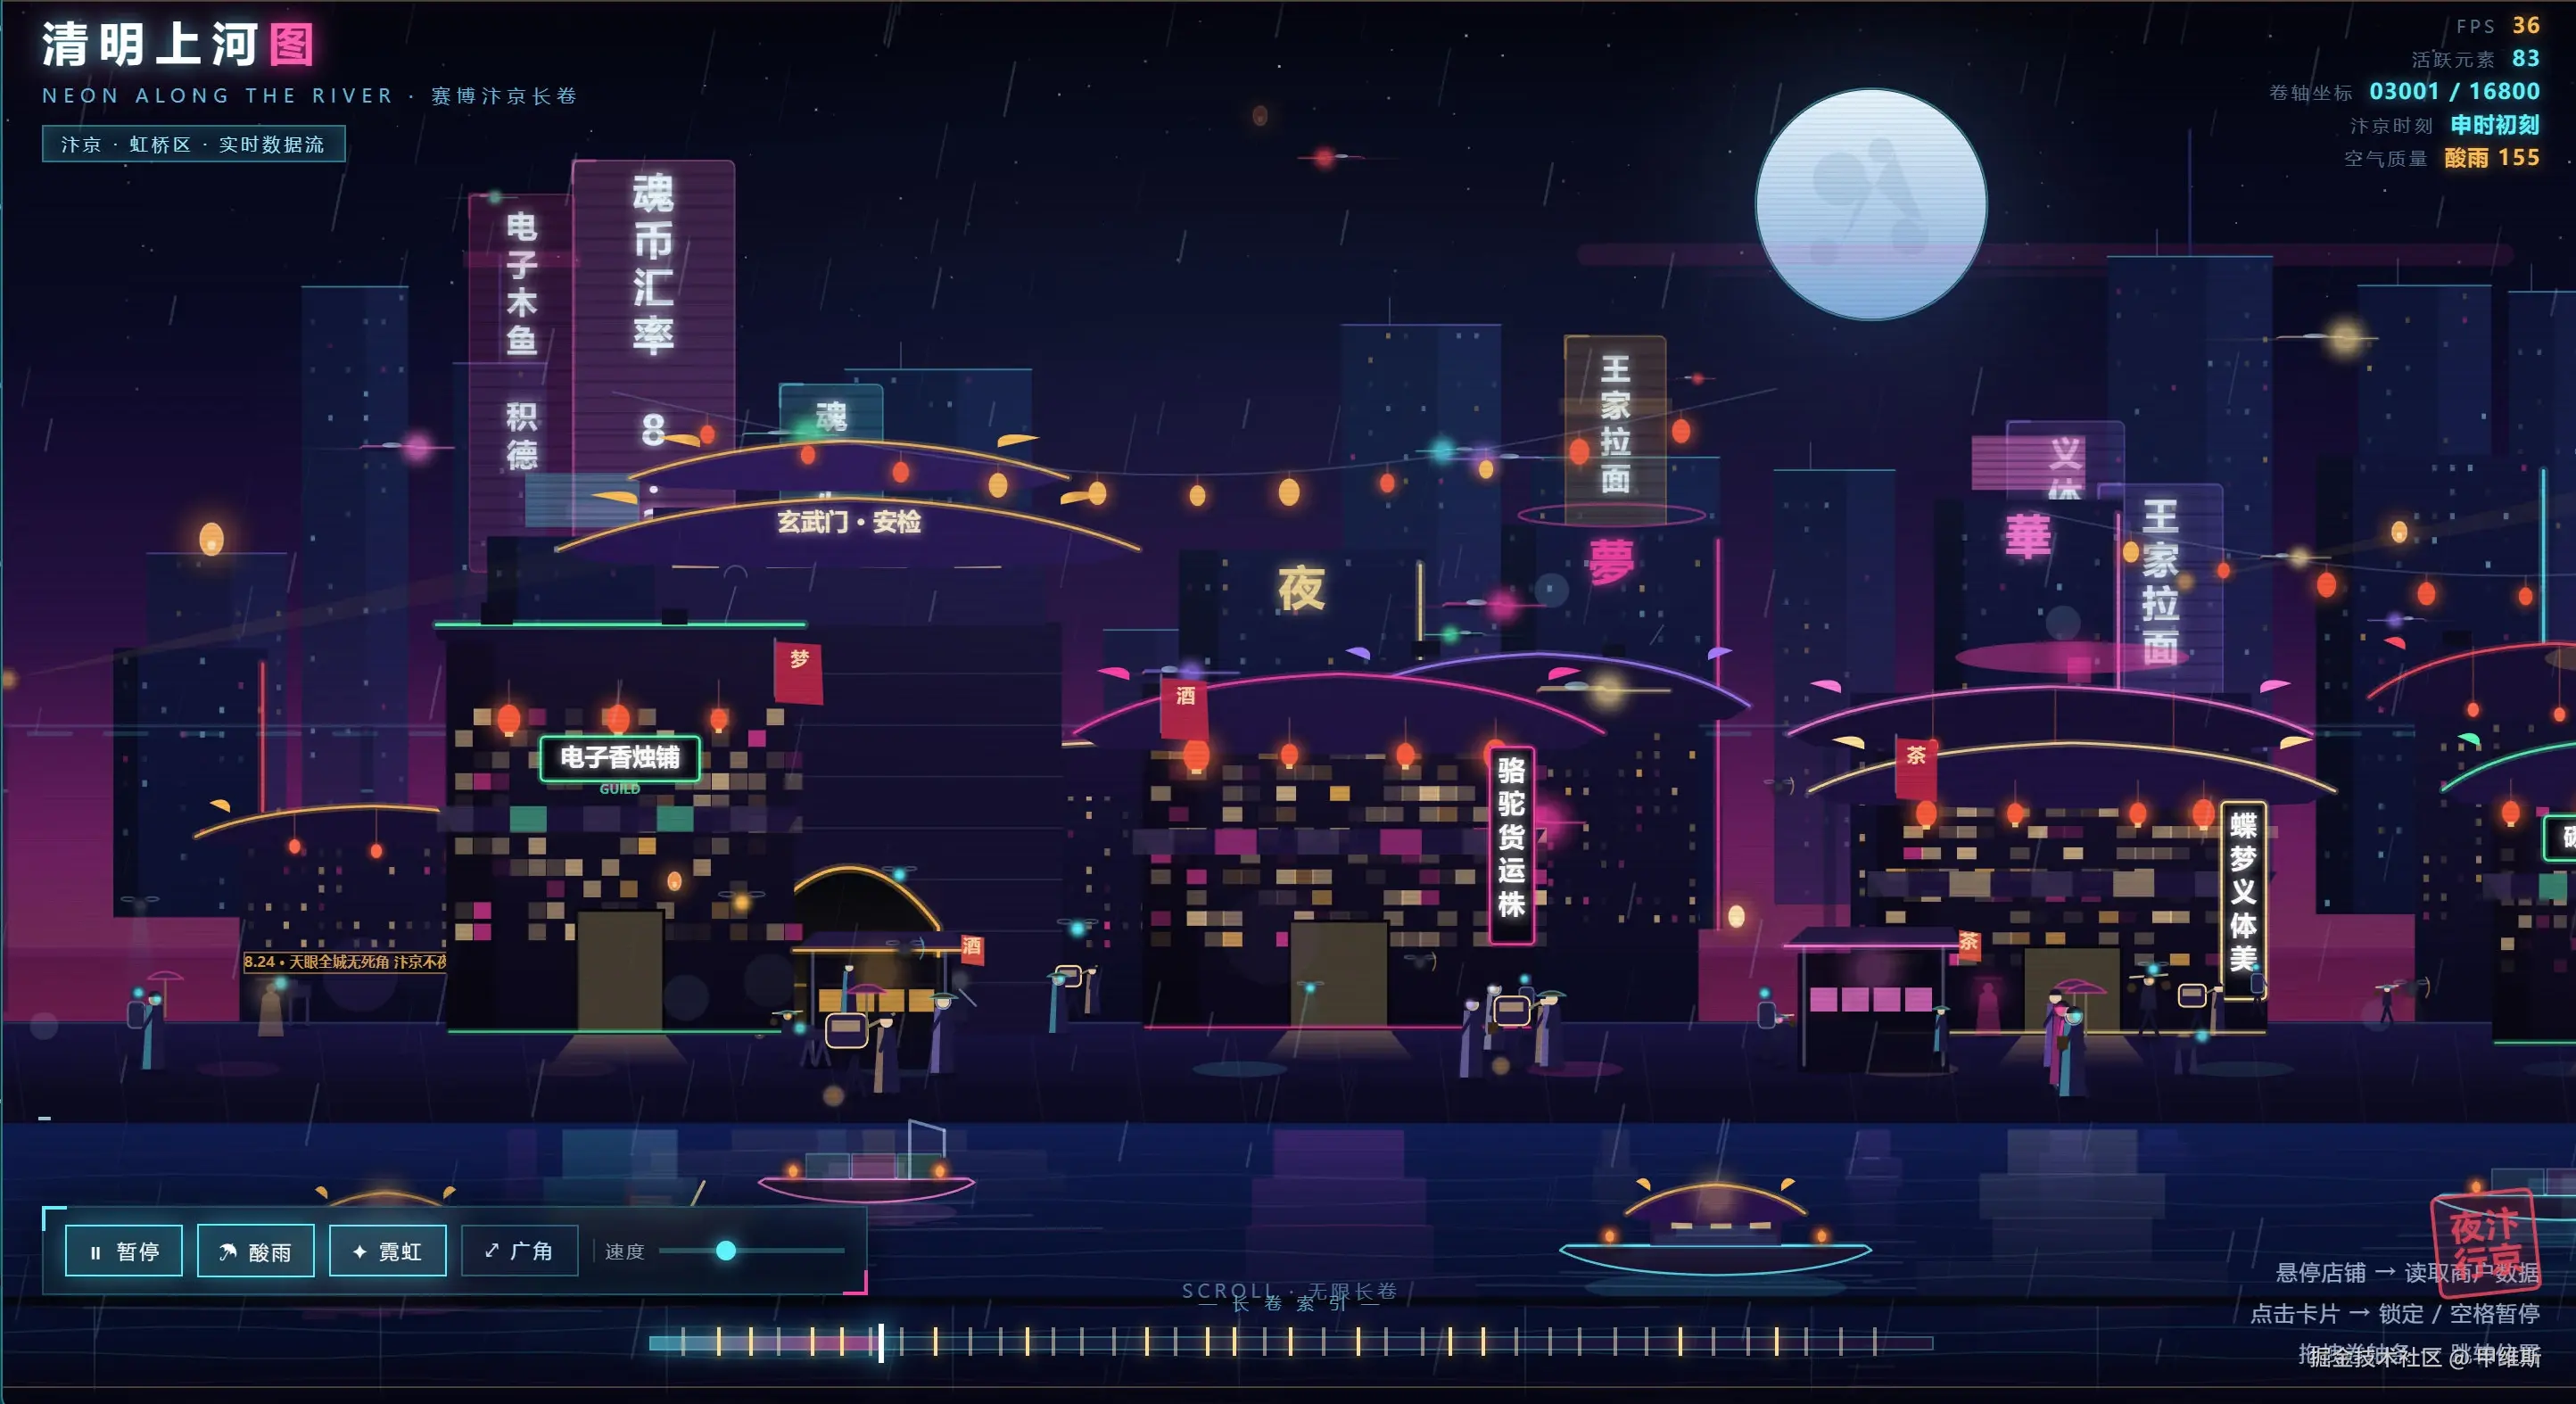
接下来继续看,赛博朋克版清明上河图!
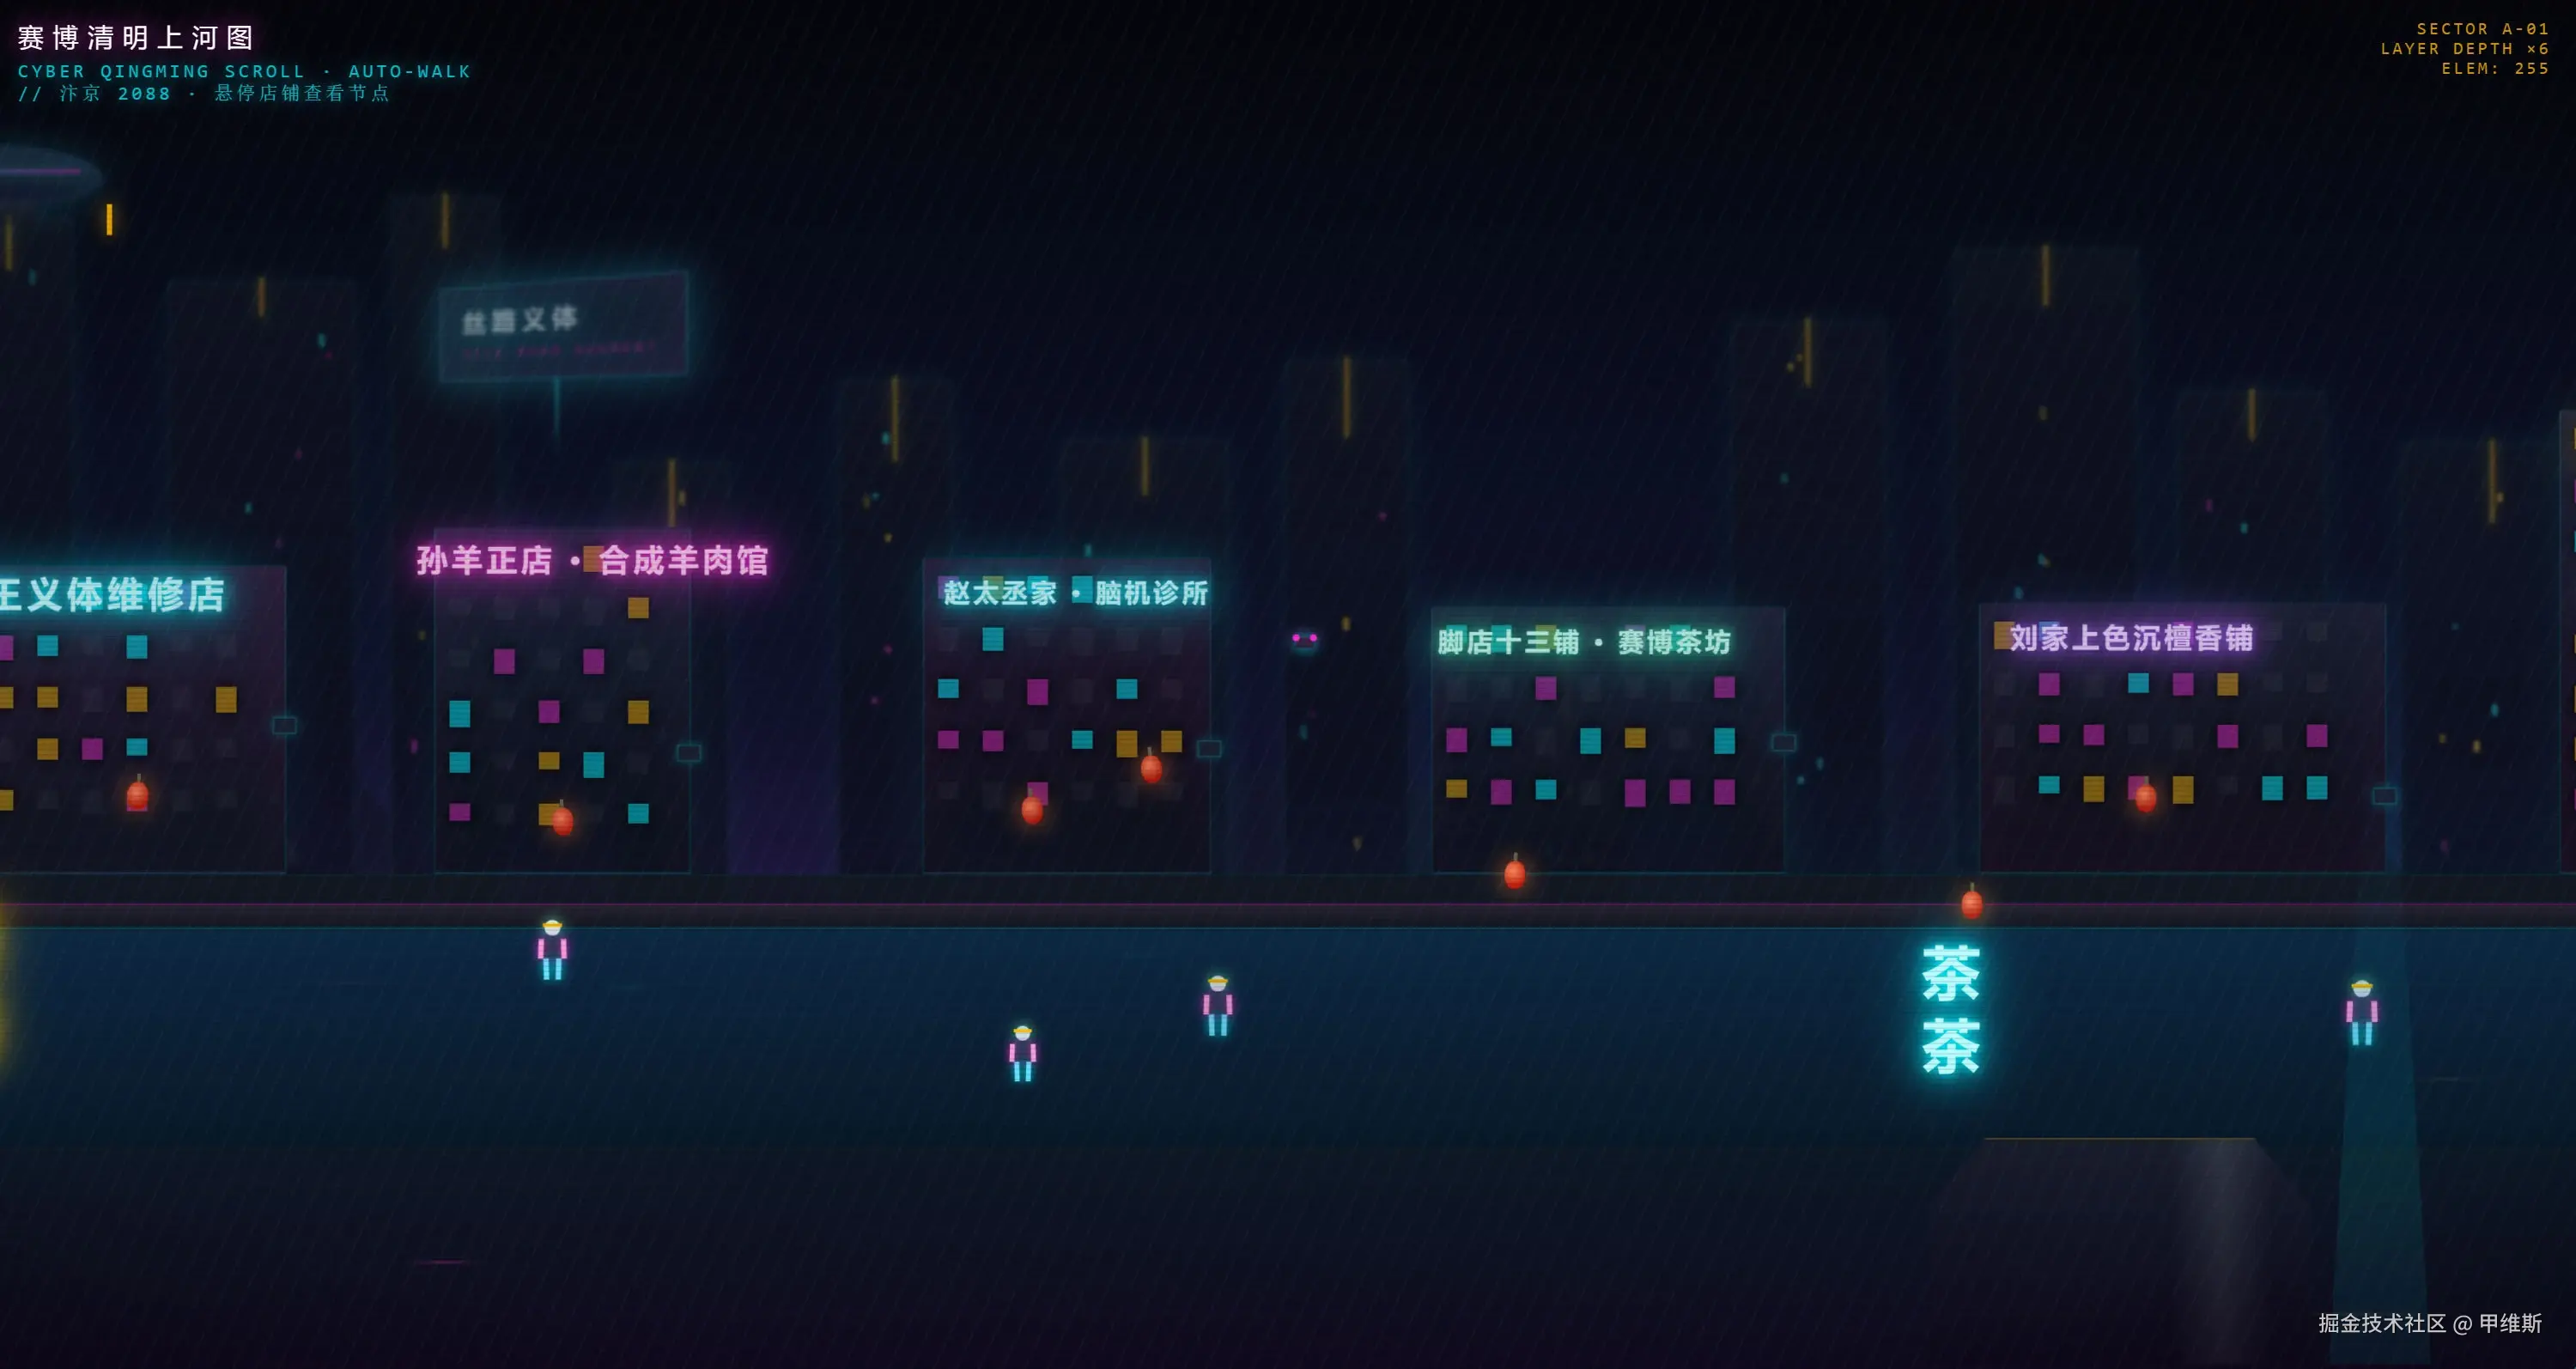
这......也不太行!
空间感和配色勉强还可以,但是内容和细节全无,做得非常简陋和粗糙。
这完全不是国模一哥的水平啊,上个例子和这个例子的表现还不如 HY4、Step5、Grok 4.6 这些选手。
这个是 HY4 的:
这个是 Step5 的:
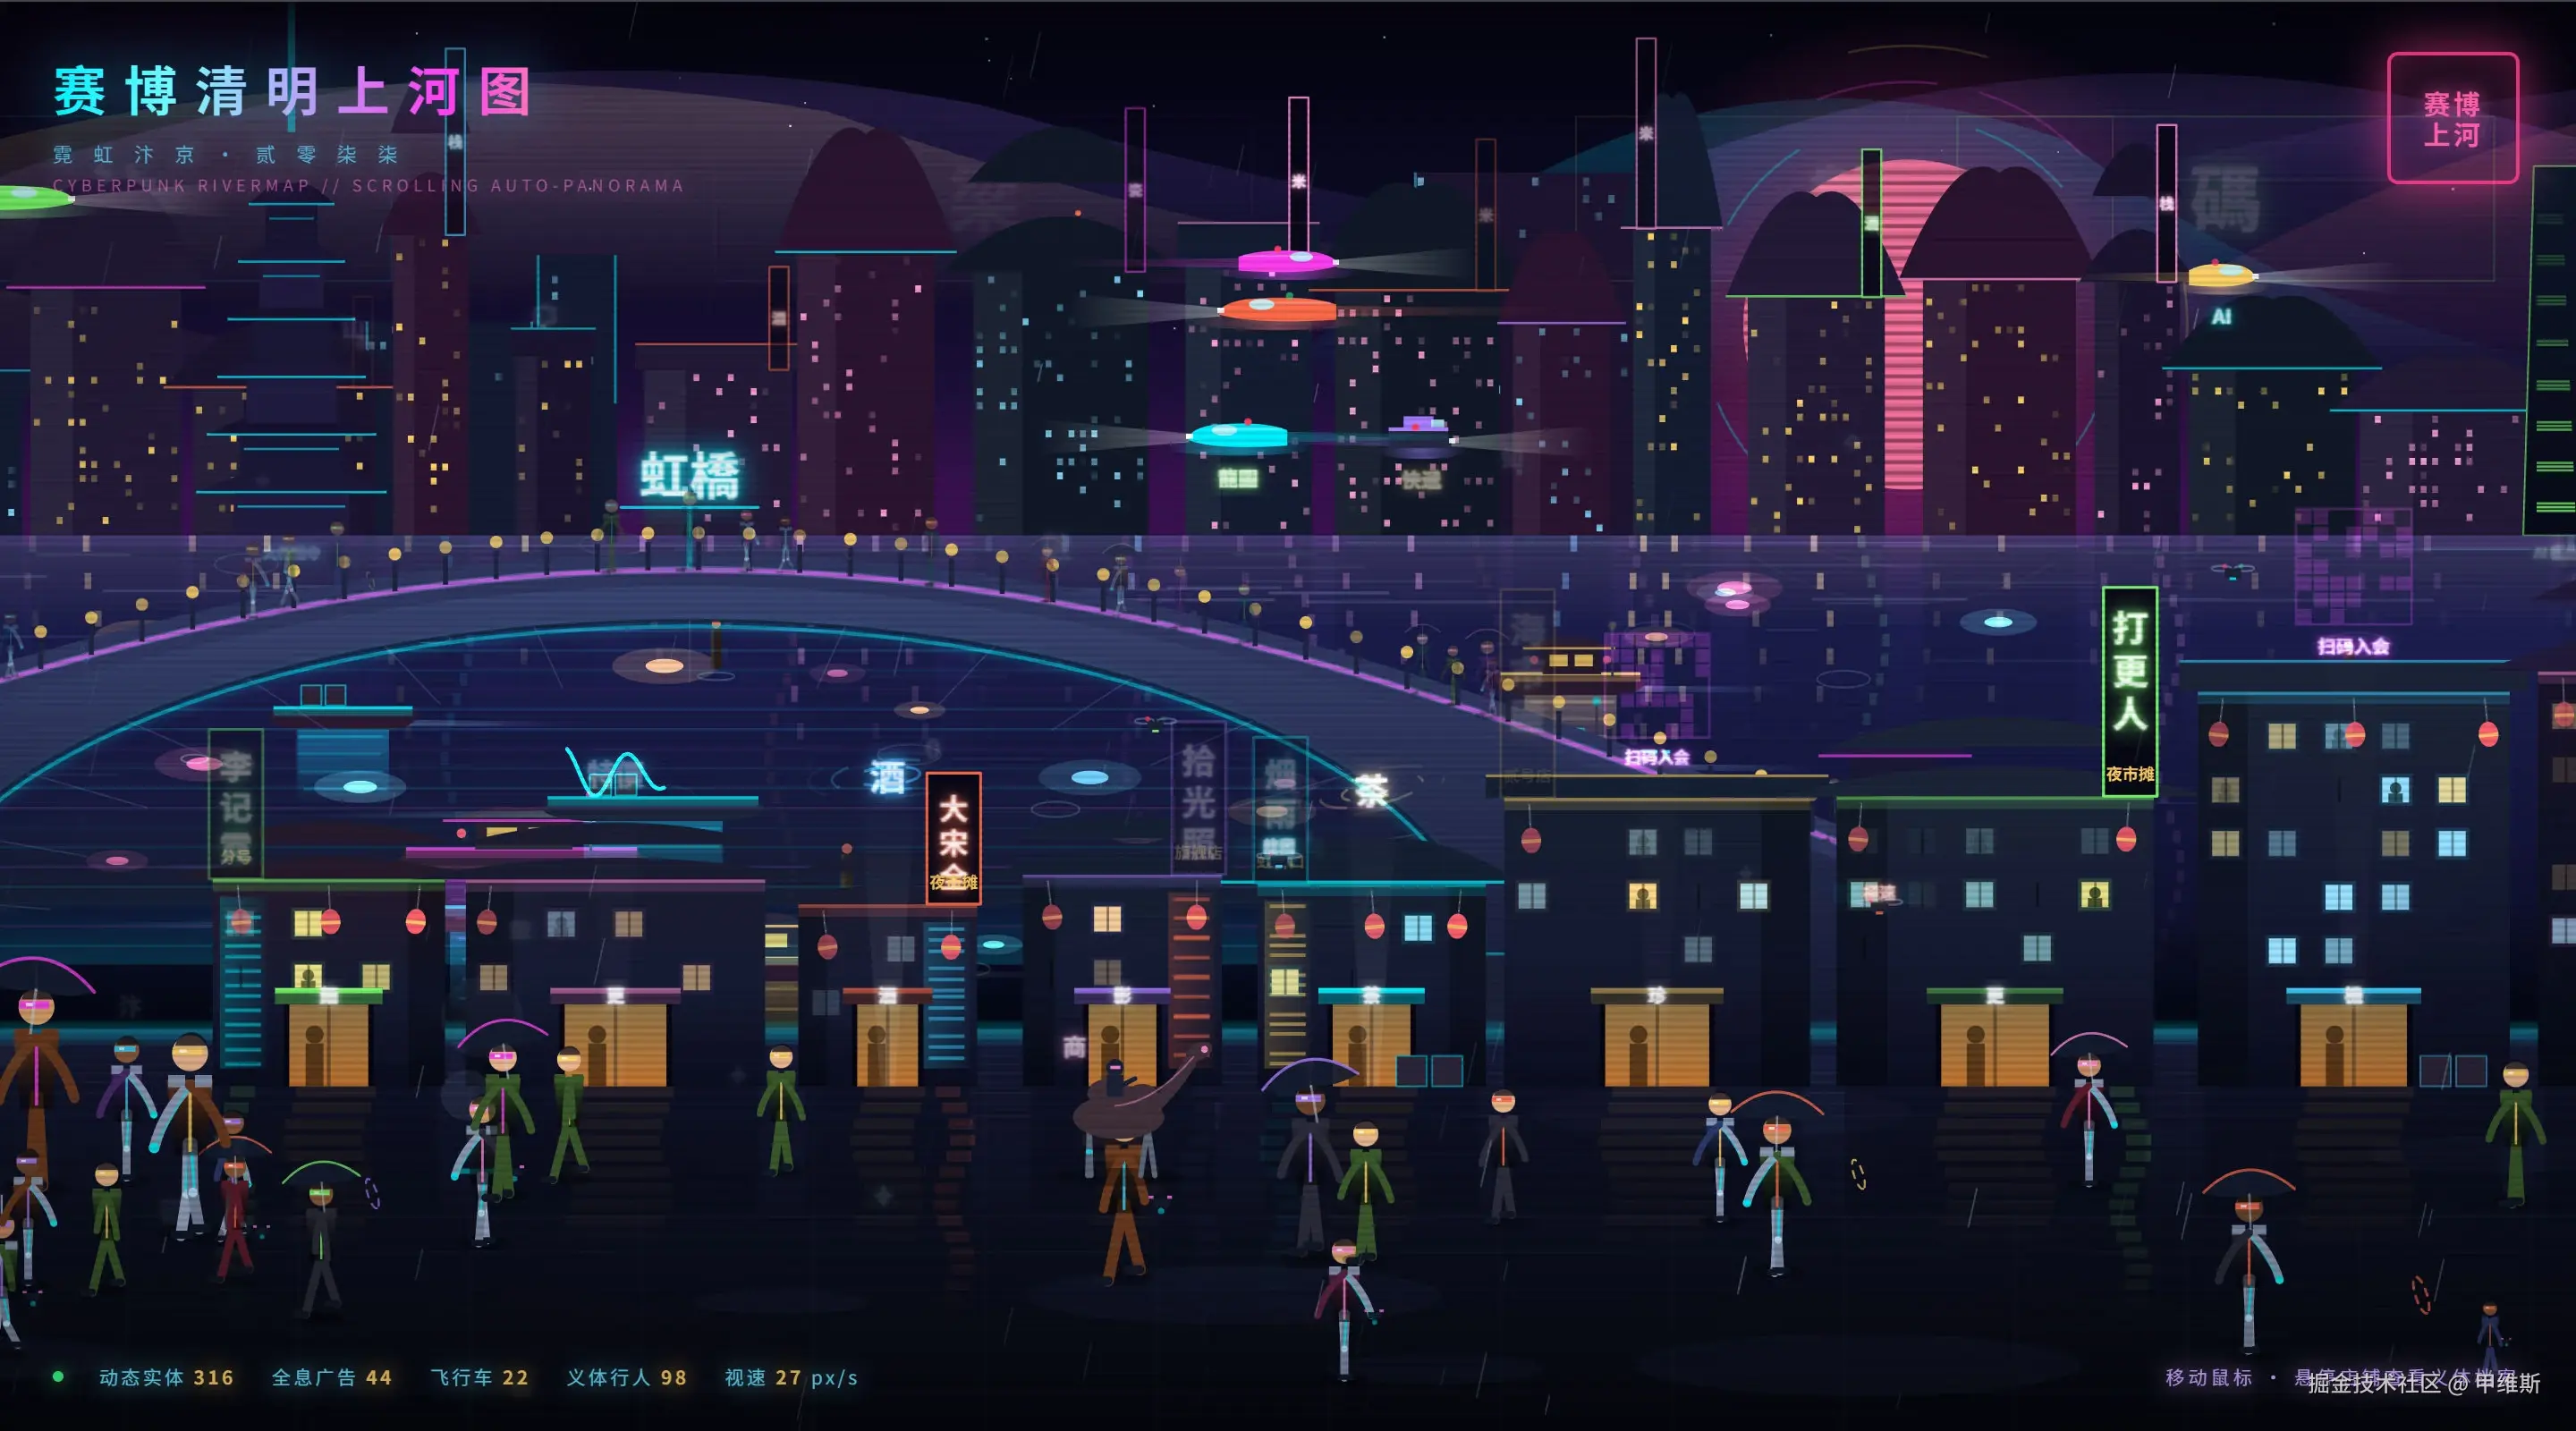
MiMo2.6Pro,两个例子可以说是拉完了,完全是半年前,甚至一年前的水平!
好了,我不多说了,赶紧下面一个例子吧!
天文机械表:
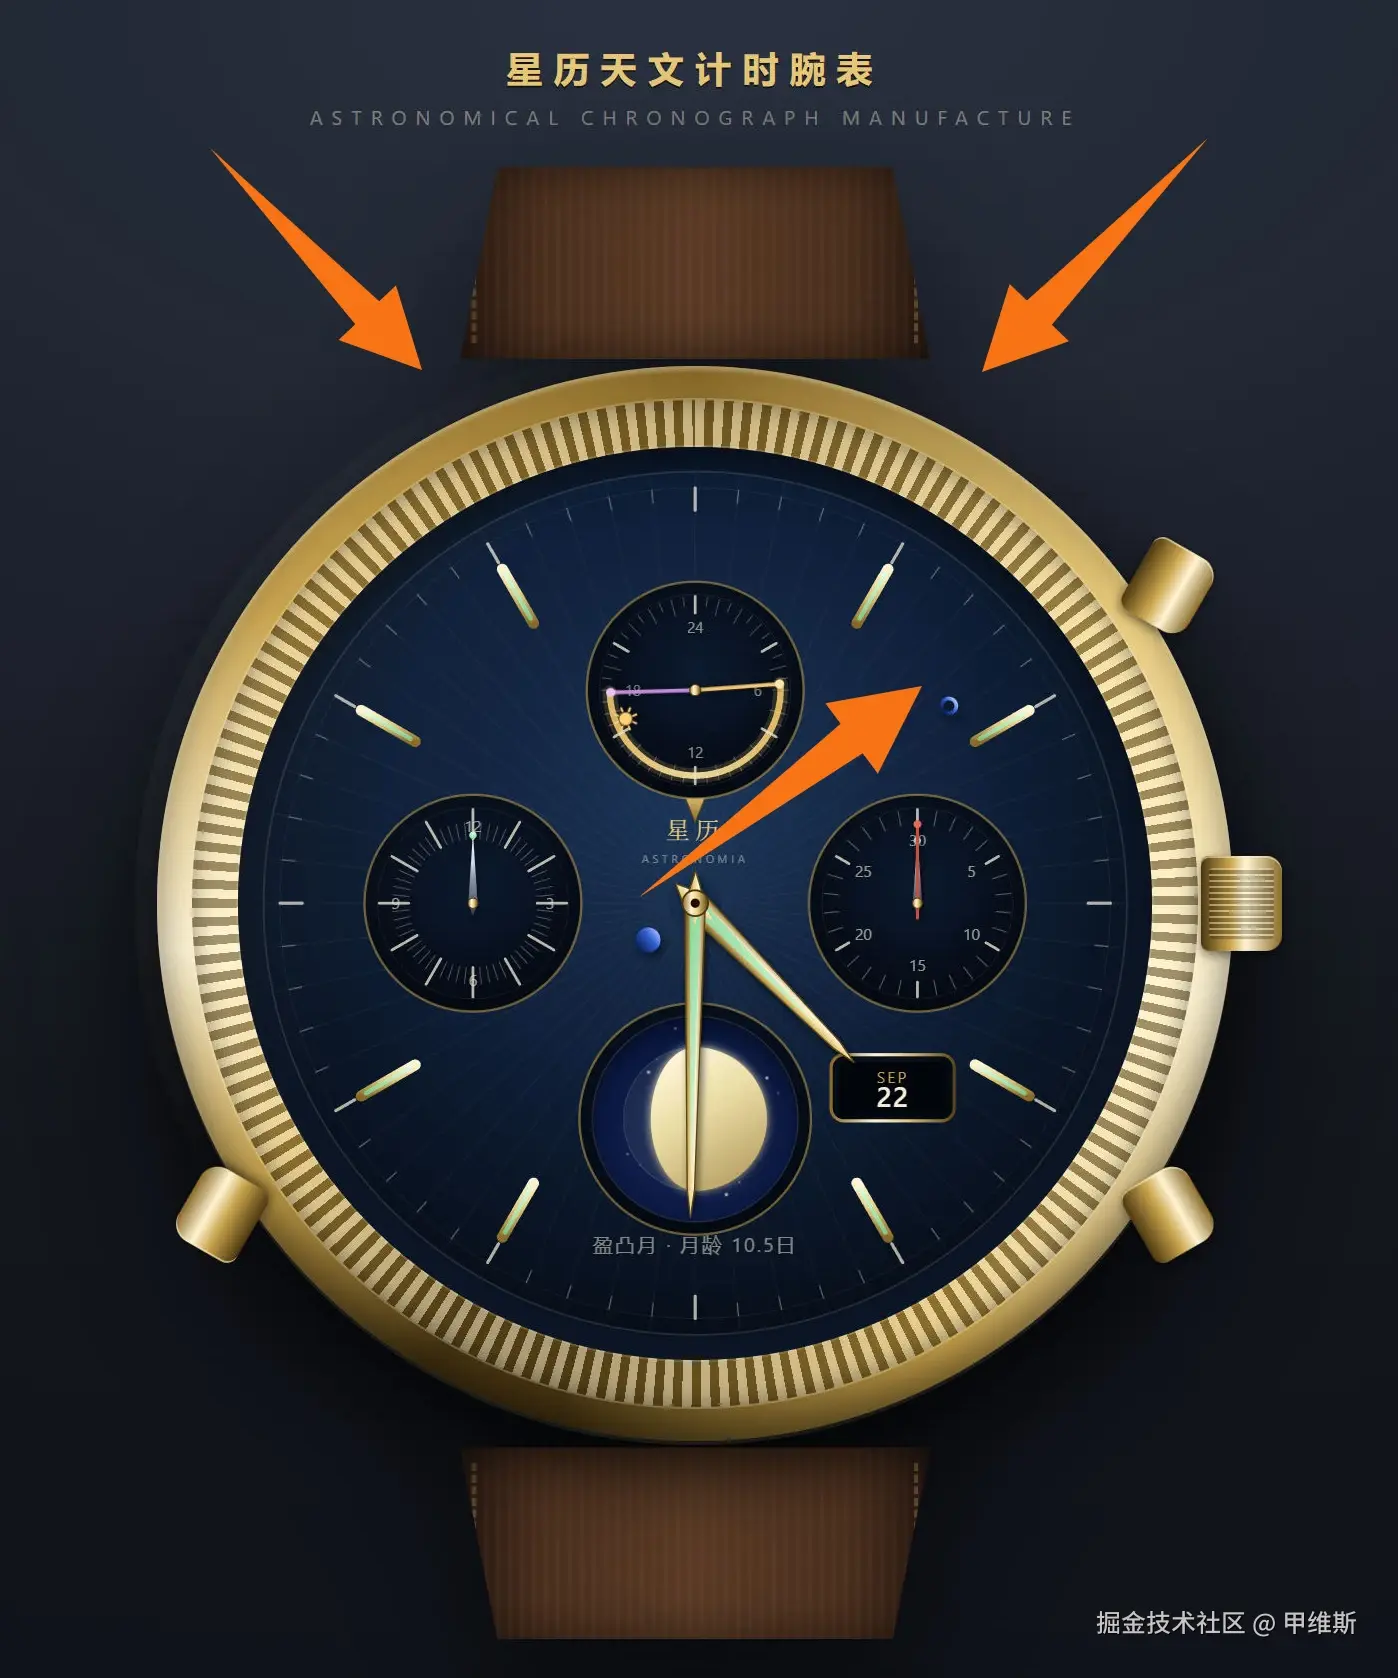
这个还可以!
这个例子除了少了一根秒针和表带衔接的问题之外,没太大问题。这是达到了中等水平的!
MiMo 这个模型也是一个 1M 的多模态模型,同时官方发布博客中强调了 3D 和游戏,官方给的例子也非常酷炫。
所以下面就给两个 3D 的例子吧。
第一个:自主开发一个 3D 台球游戏!
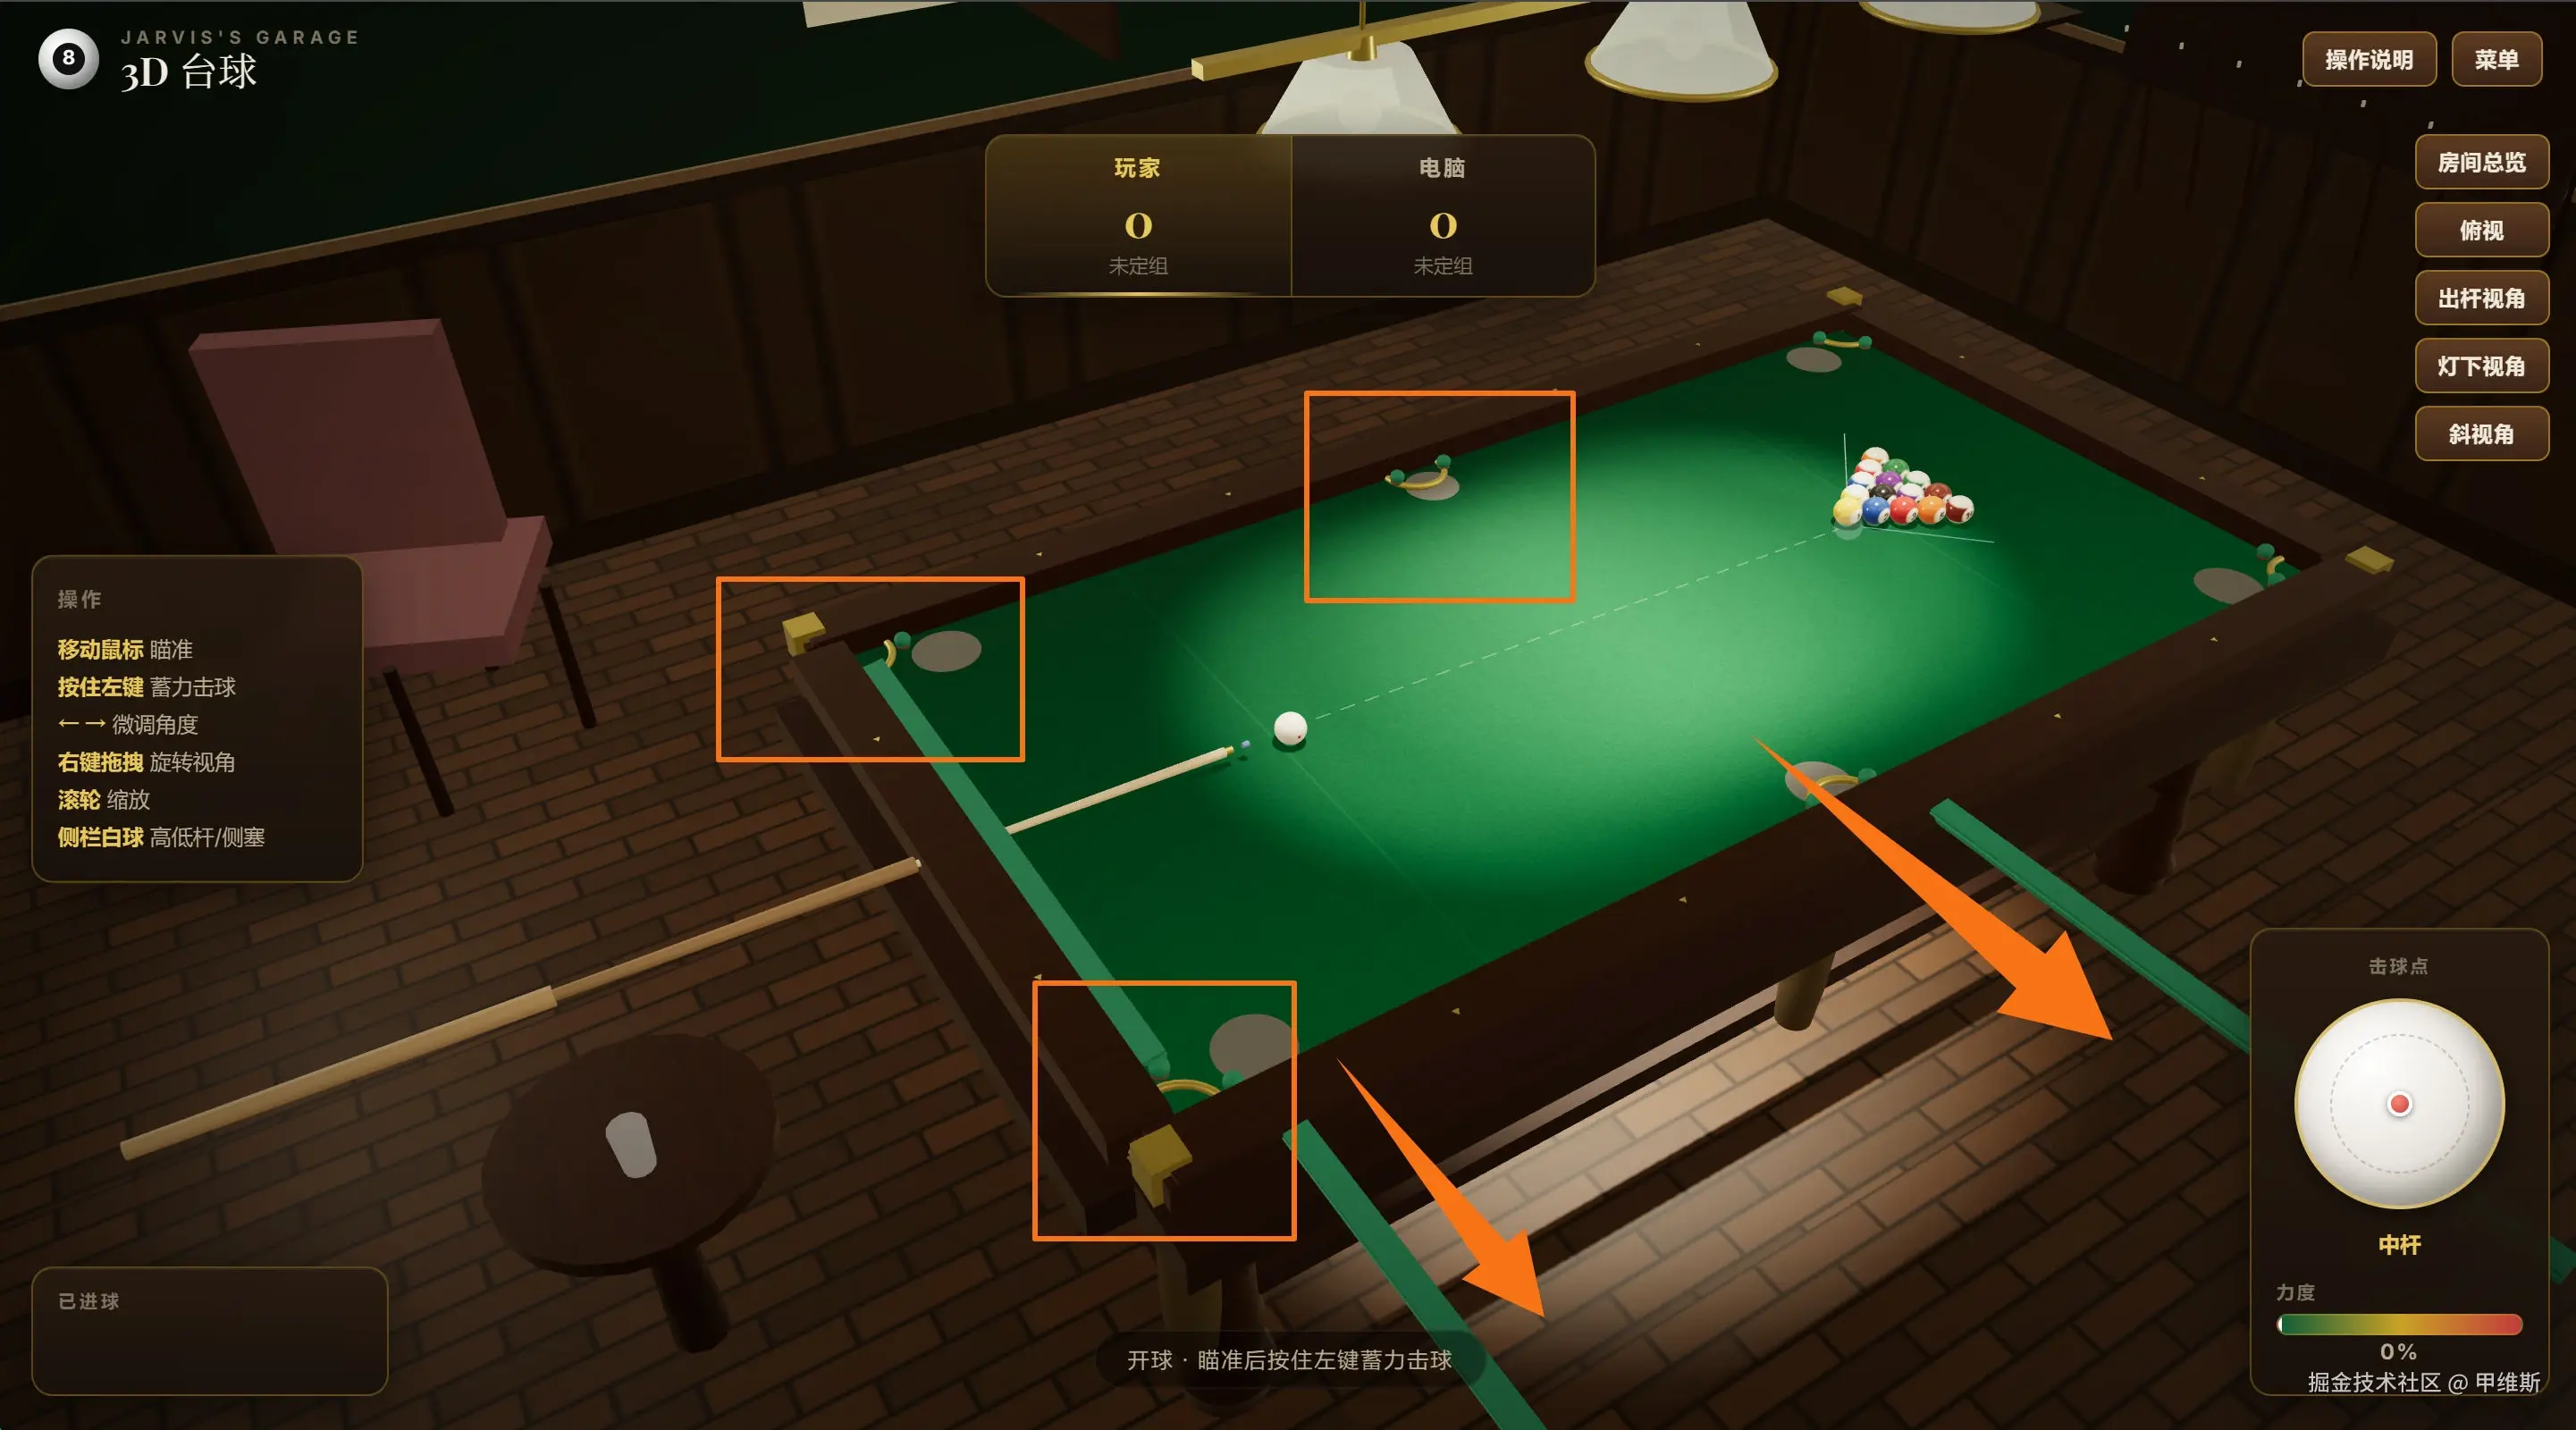
这个例子,整体建模和渲染还可以的,游戏的丰富度还可以,UI 设计还行。
只是有些细节还有问题,比如核心的球桌建模部分,"球袋"建模依旧非常拉胯,然后还多出来两个绿色的杆子,这个本来应该垫在台球桌内侧的。
这种就属于,能用,但是不好!
就这个例子的首轮结果来看是比 K3、DS4.1、Qwen3.8 要好的! 后续我测测它的修改上限高不高。
开发过程也比较清晰的:
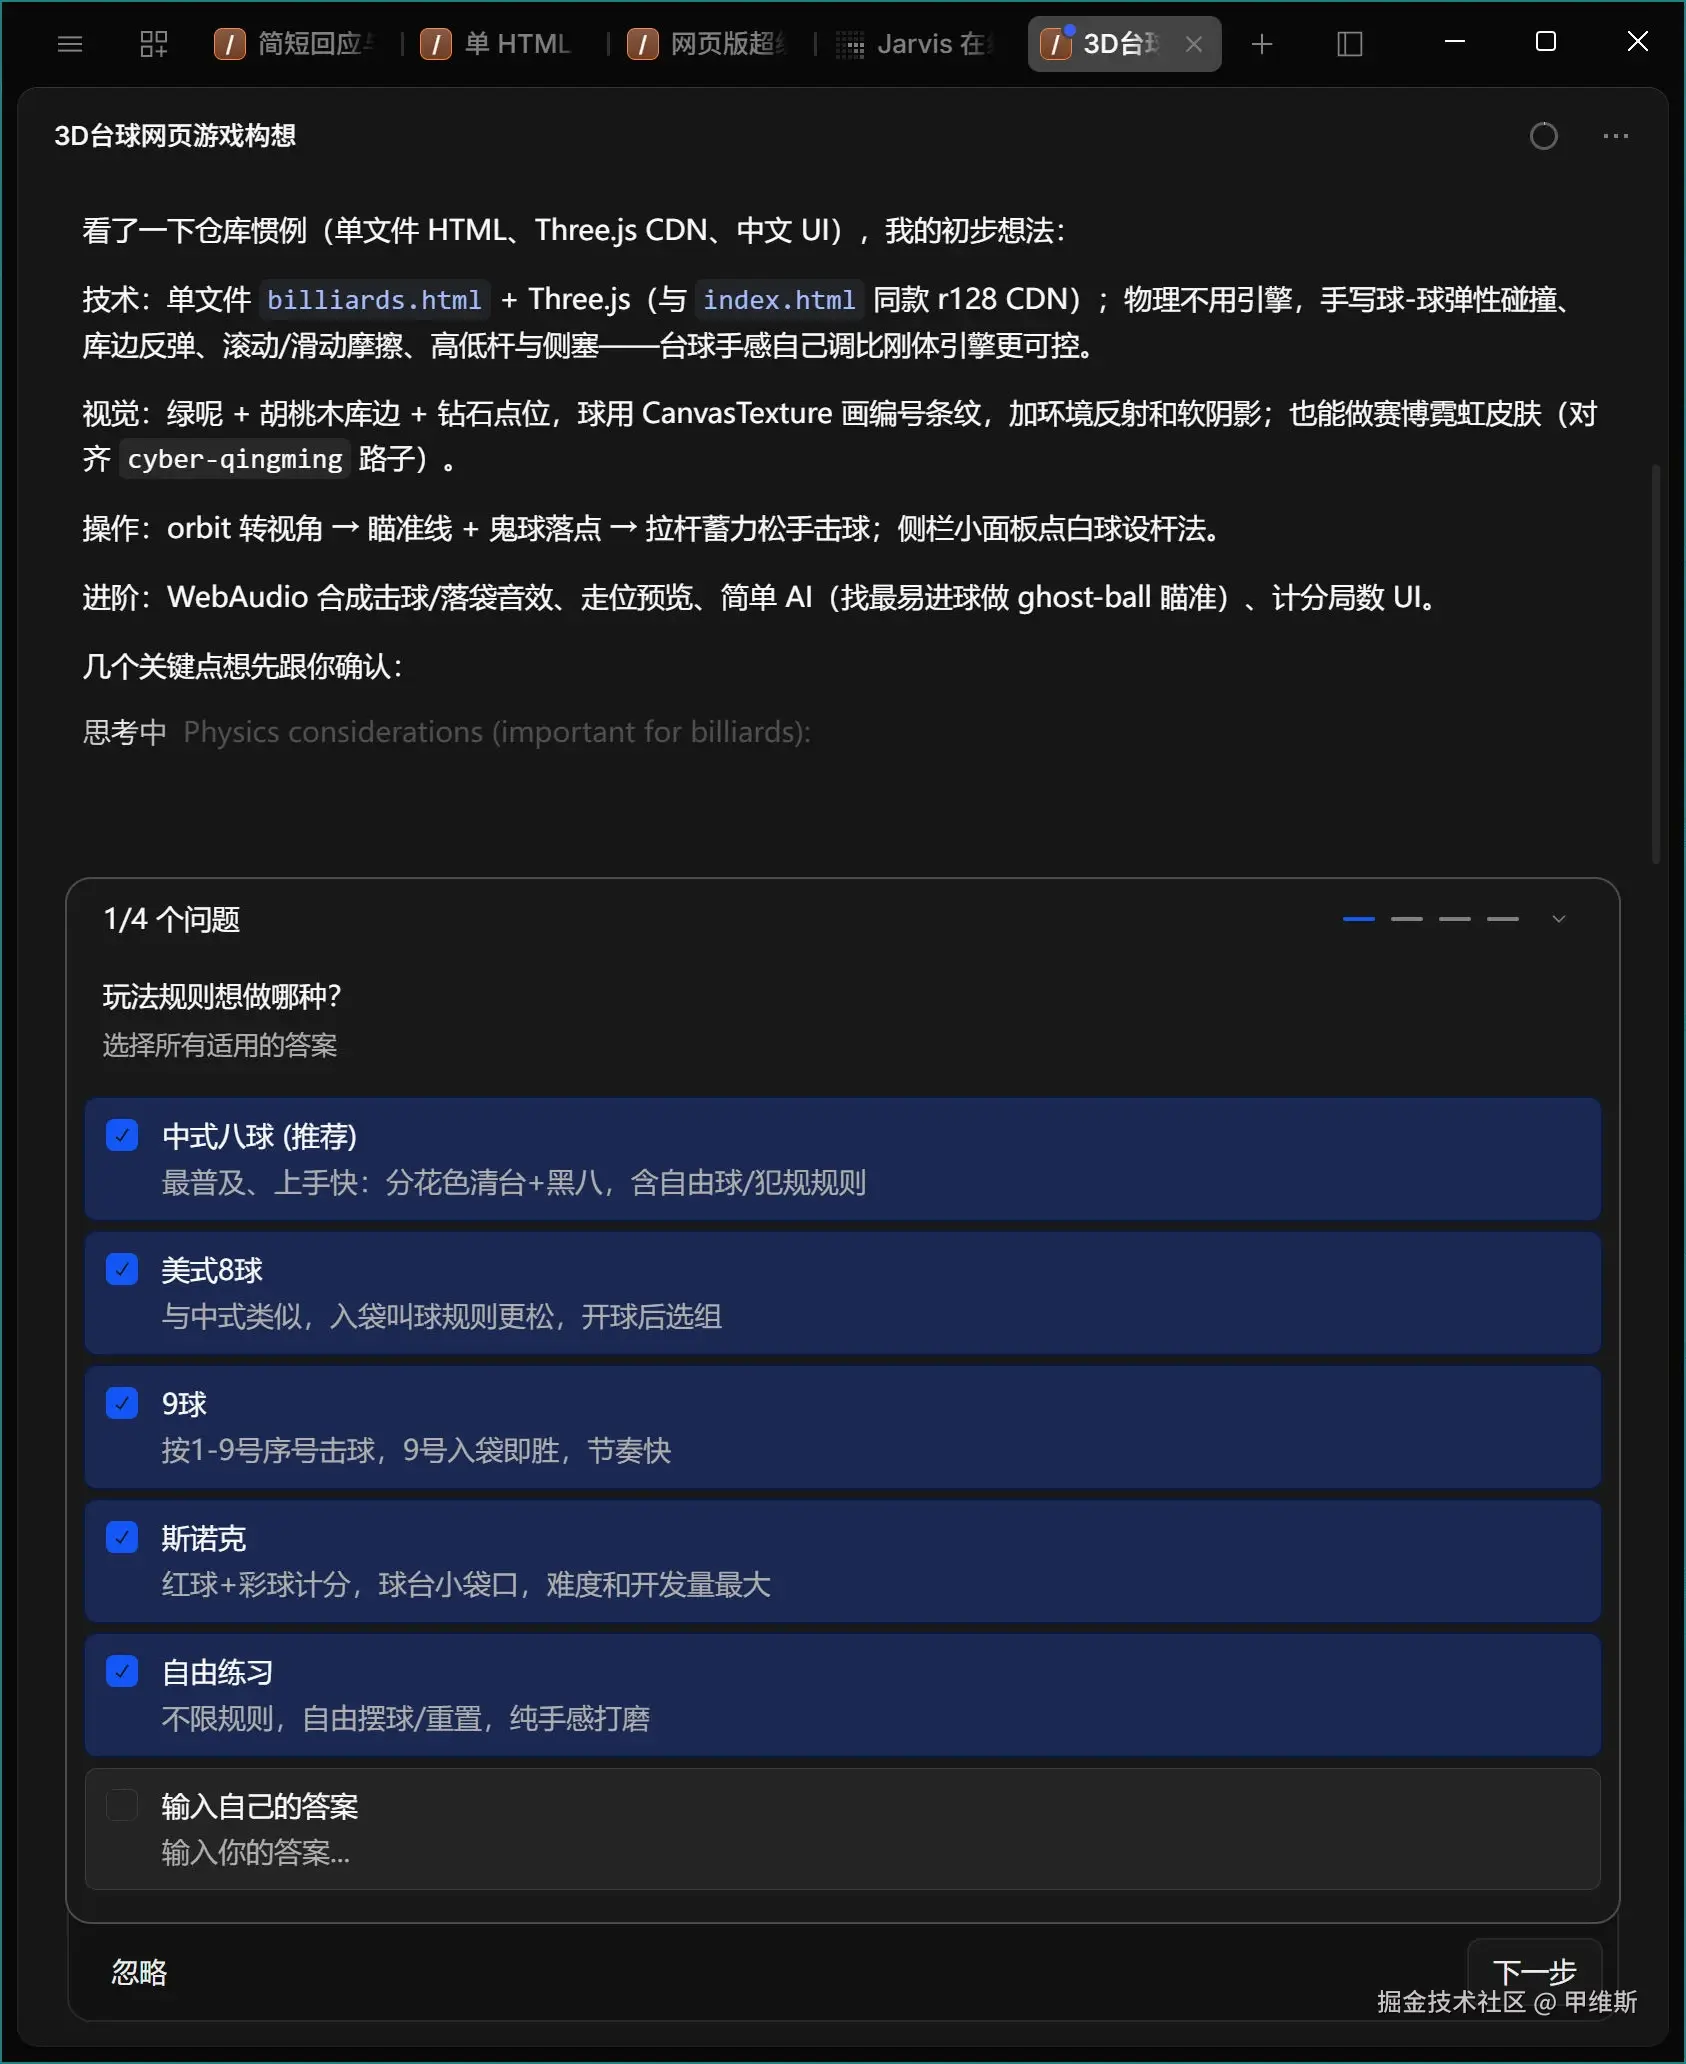
问了好几个问题!比一般模型问得详细,给的选择也要多很多。
整个例子消耗时间为 1 小时左右!
接下来看另外一个例子:甲维斯的车库!
给角色和网页参考图,然后让它克隆这个效果,并且完成各种载具的建模。
效果如下:
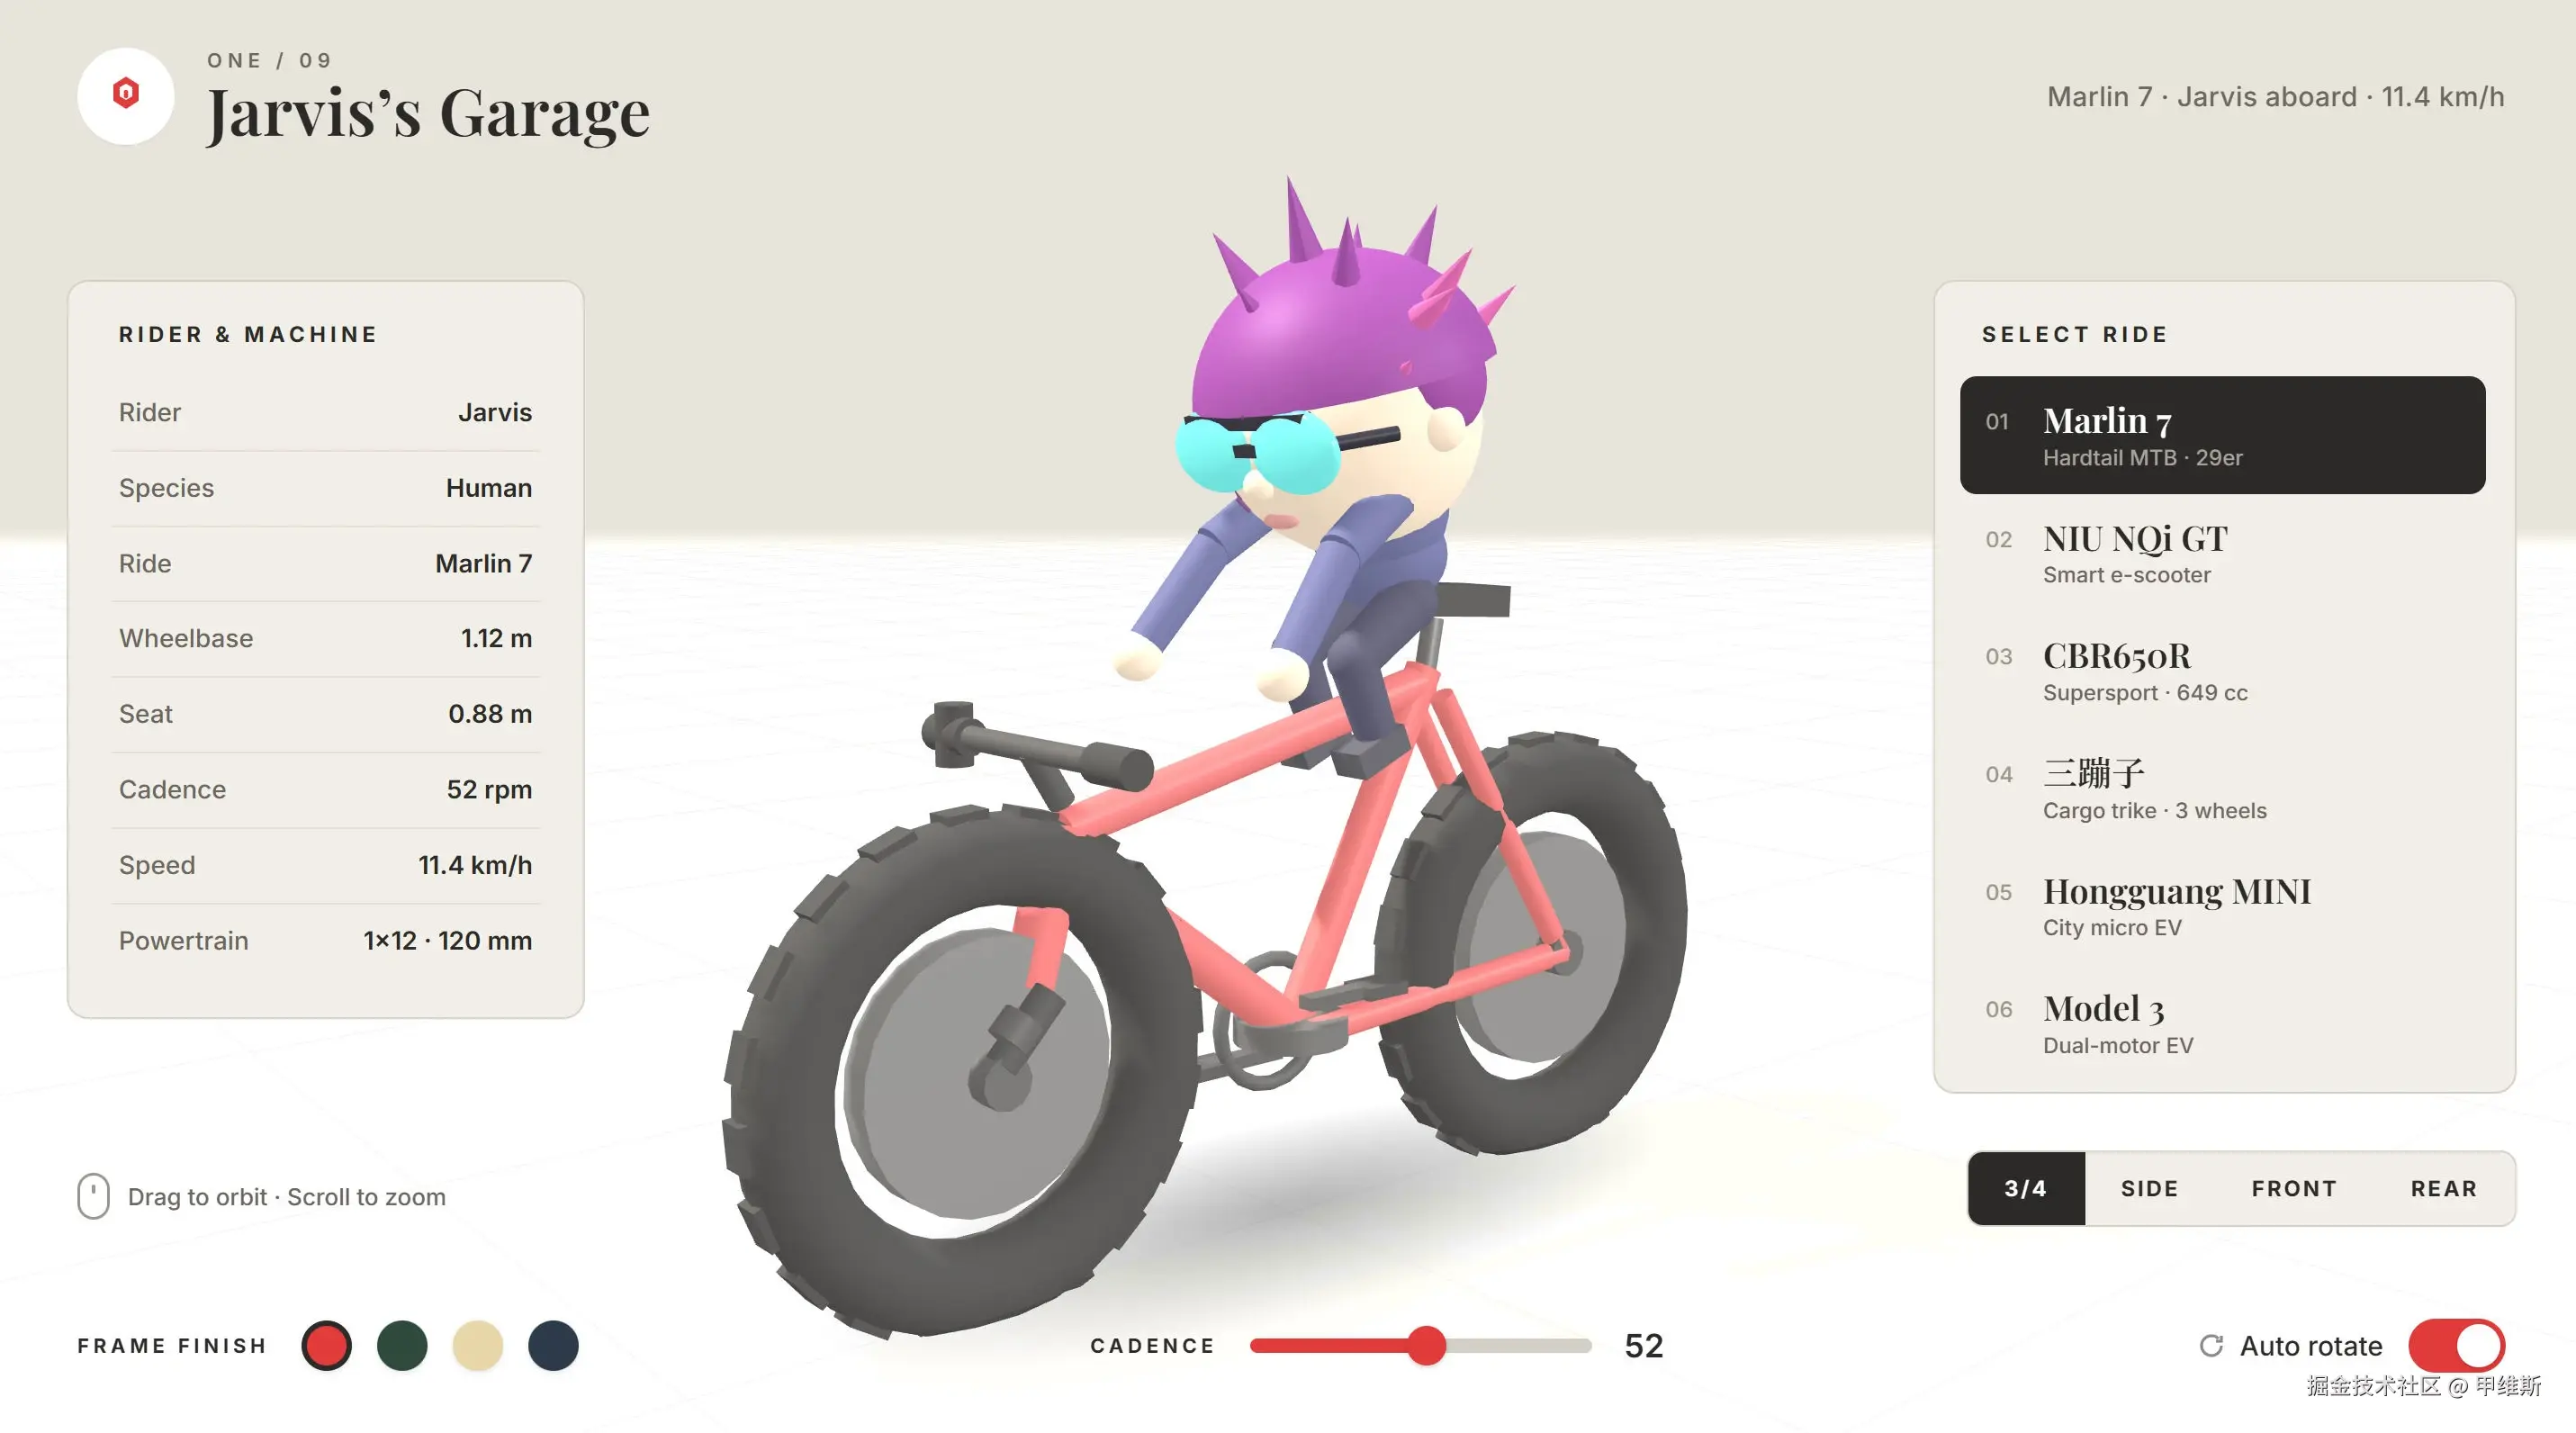
这个结果还不错!
首先是网页复刻基本到位,其次任务和自行车建模基本上没有大毛病。 没有大毛病,就已经很厉害了。
这个例子的问题主要在于"比例"。它的网页布局和内容都是对的,但是控件比例有点偏大。另外建模部分也体现得特别明显,人物特别小自行车特别大。
另外还有一些建模的问题。 它对特斯拉、小米、保时捷的建模部分是有问题的。
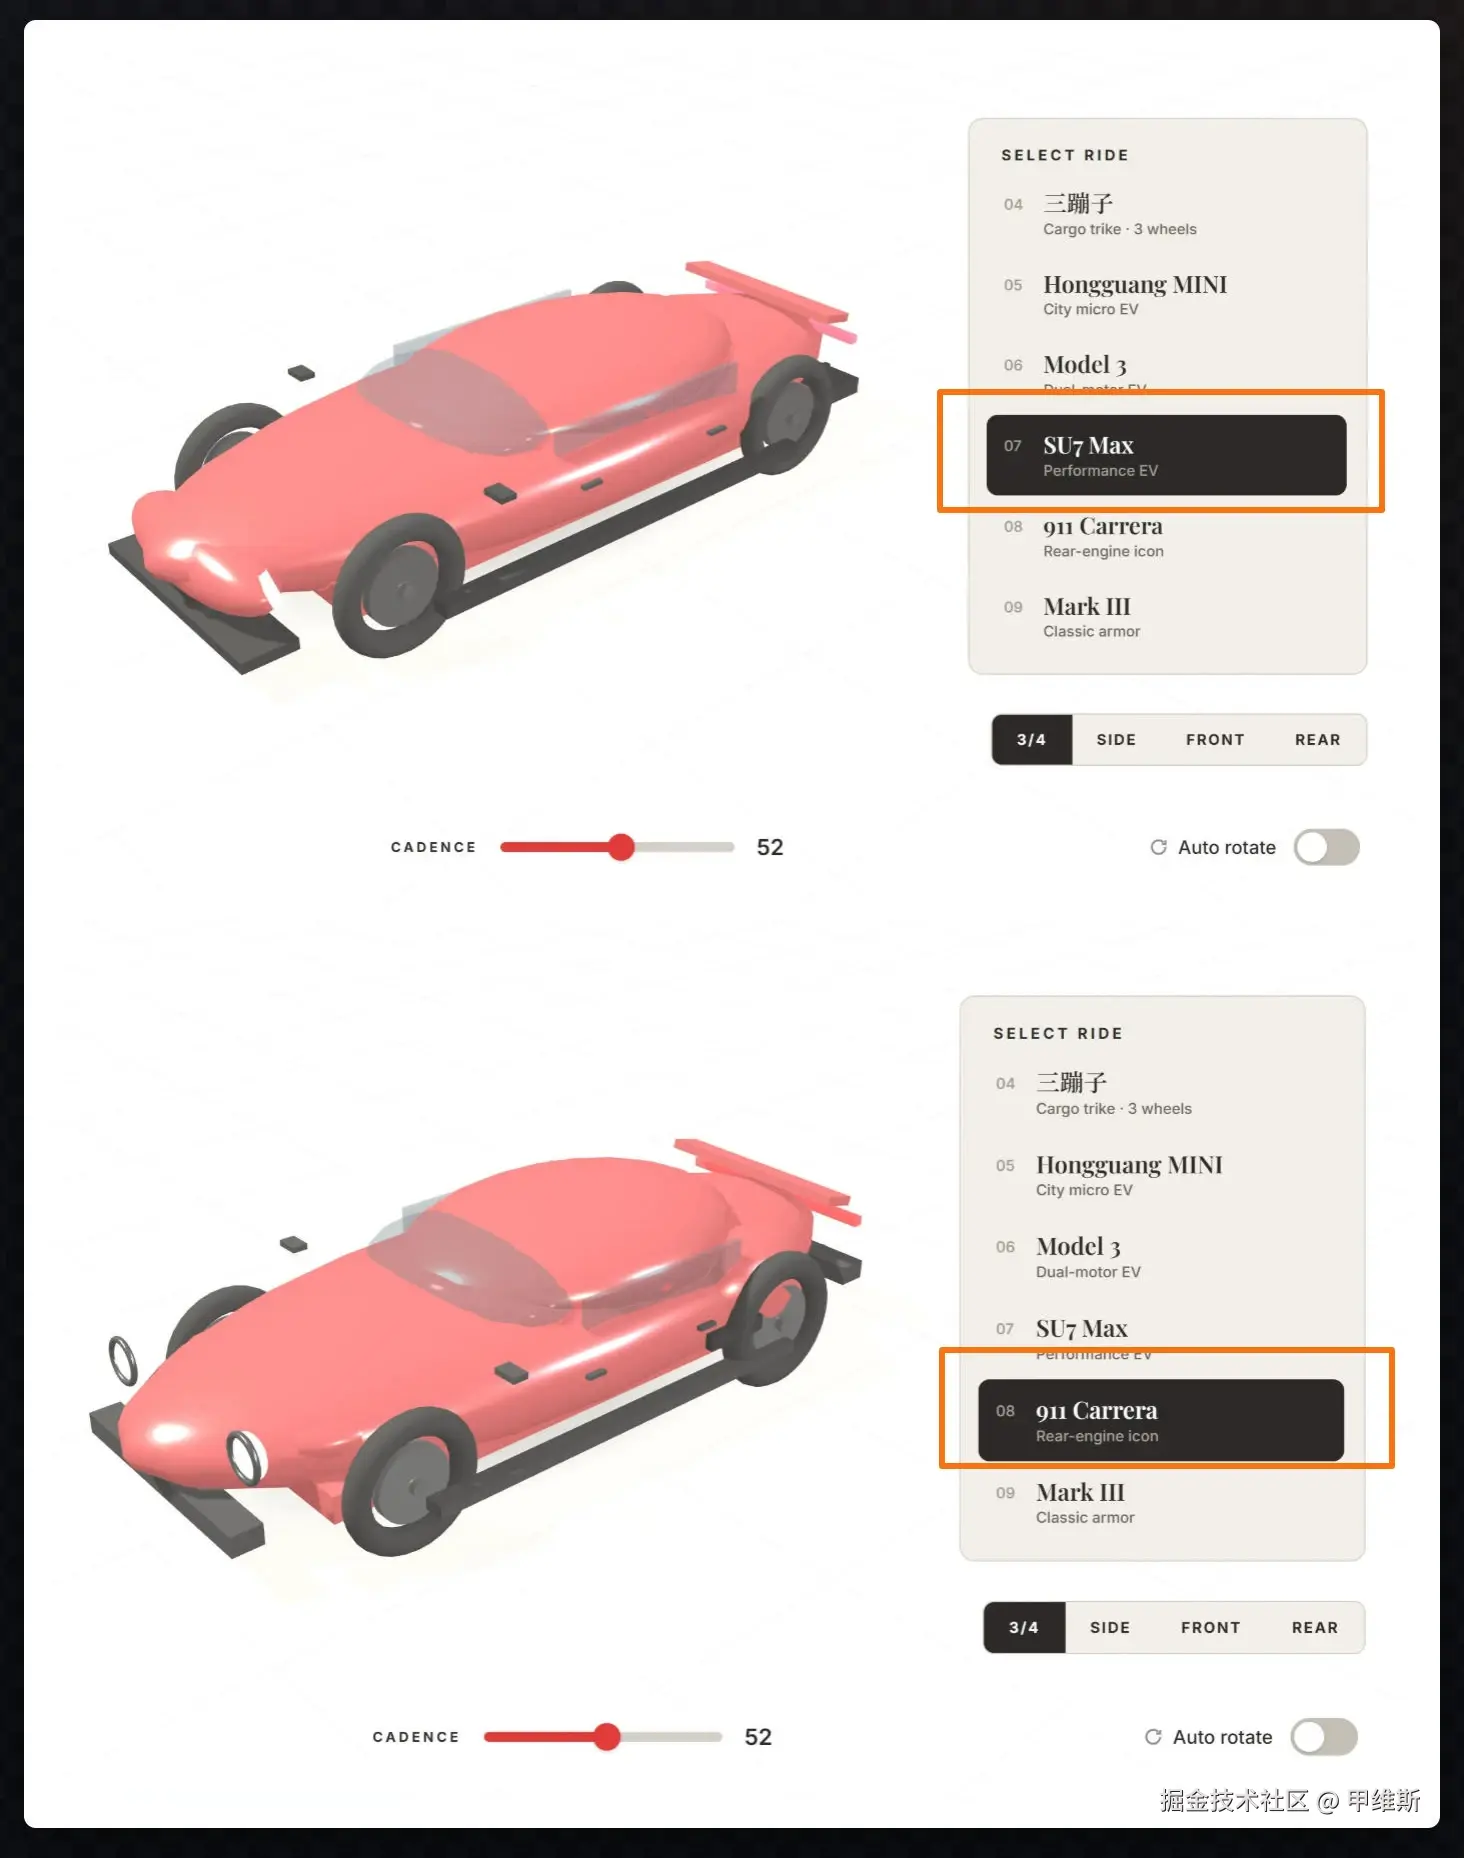
你们看出来 SU7 Max 和 911 的差别了么? 几乎就是用了同一个模具啊! 关键是也不像原来的样子。
还有就是钢铁侠战甲建模的问题:
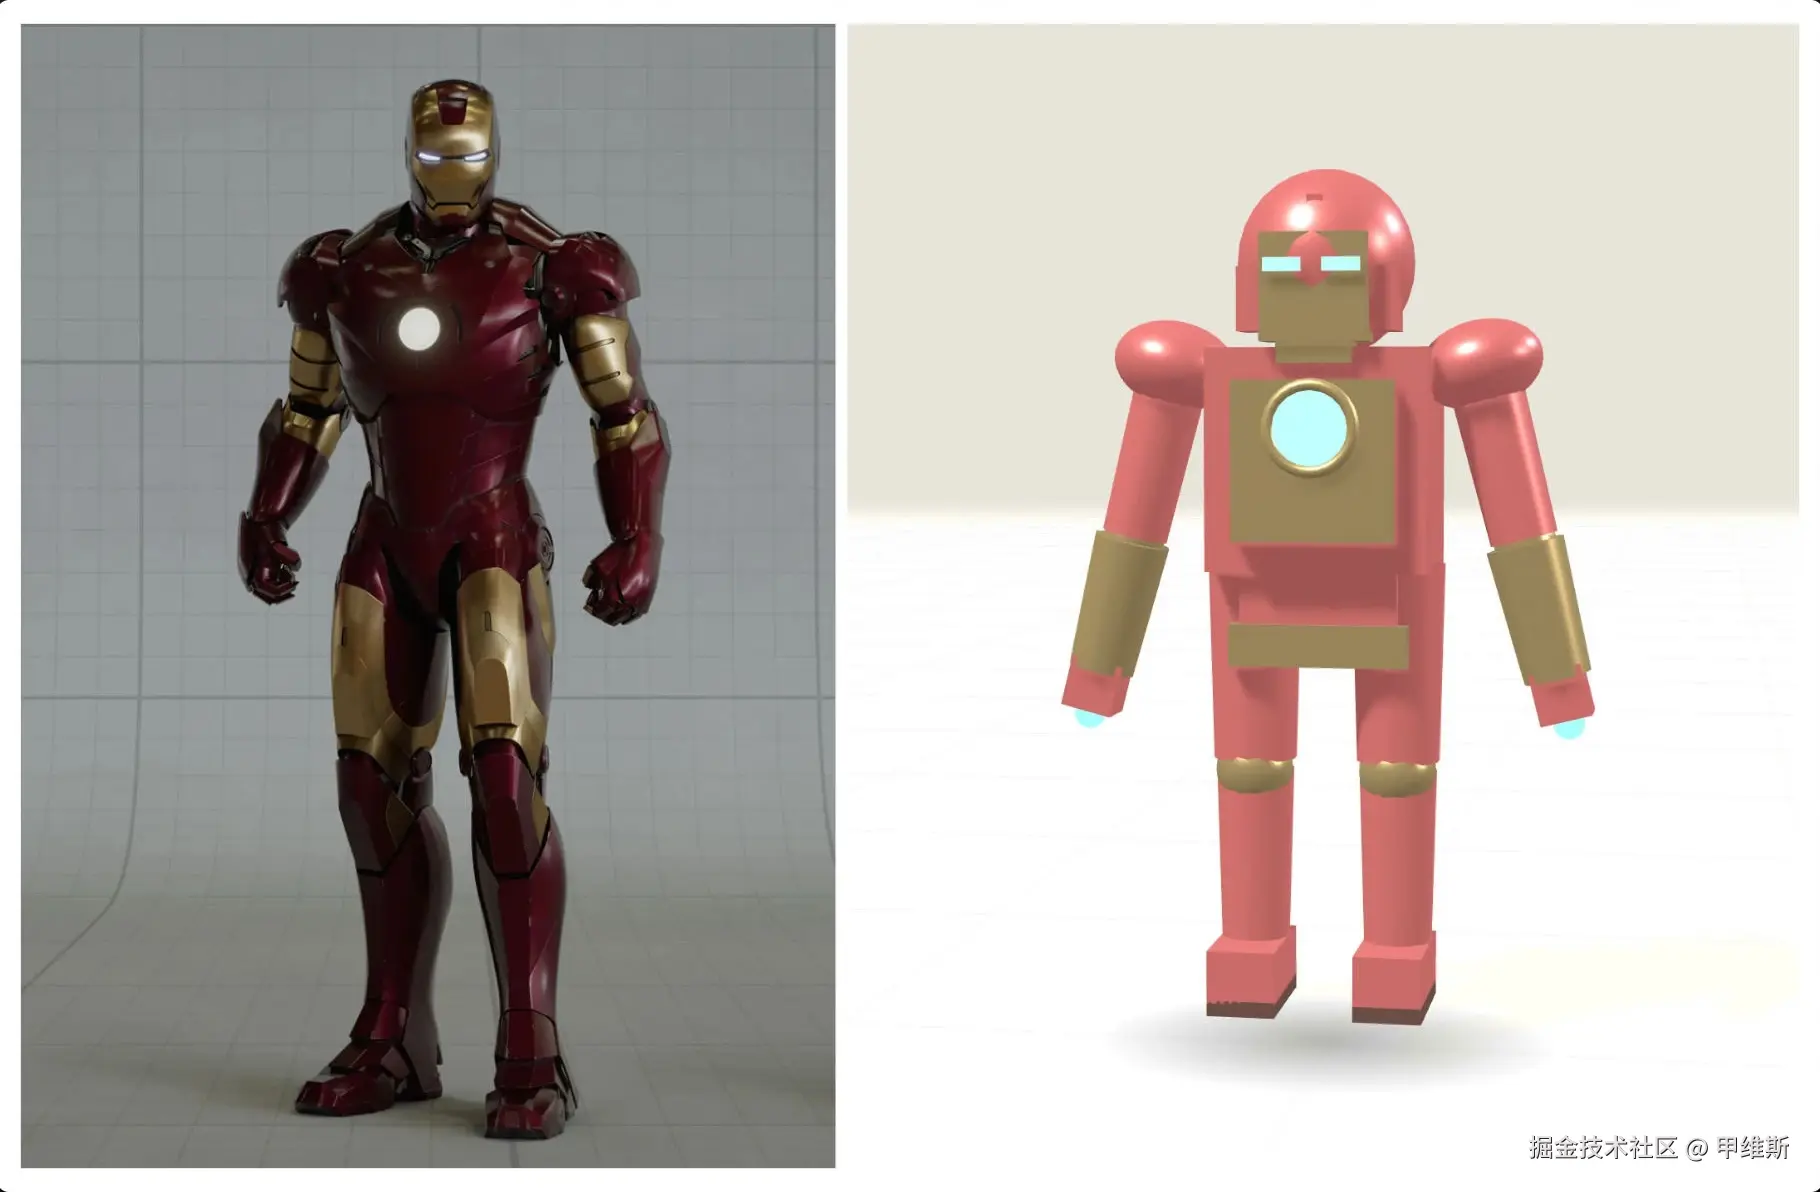
我期望的是左边这样的,它给我的是右边这样的!
不过这部分建模,我也不能对它要求太高,所有模型都做得不好!
这个例子应该最能体现它的完整能力了。
这是它最"长程"的一个任务,消耗了 90 分钟,而且体现了它的多模态能力,以及自我验证的能力。
一开始它就读取并分析了两张参考图:
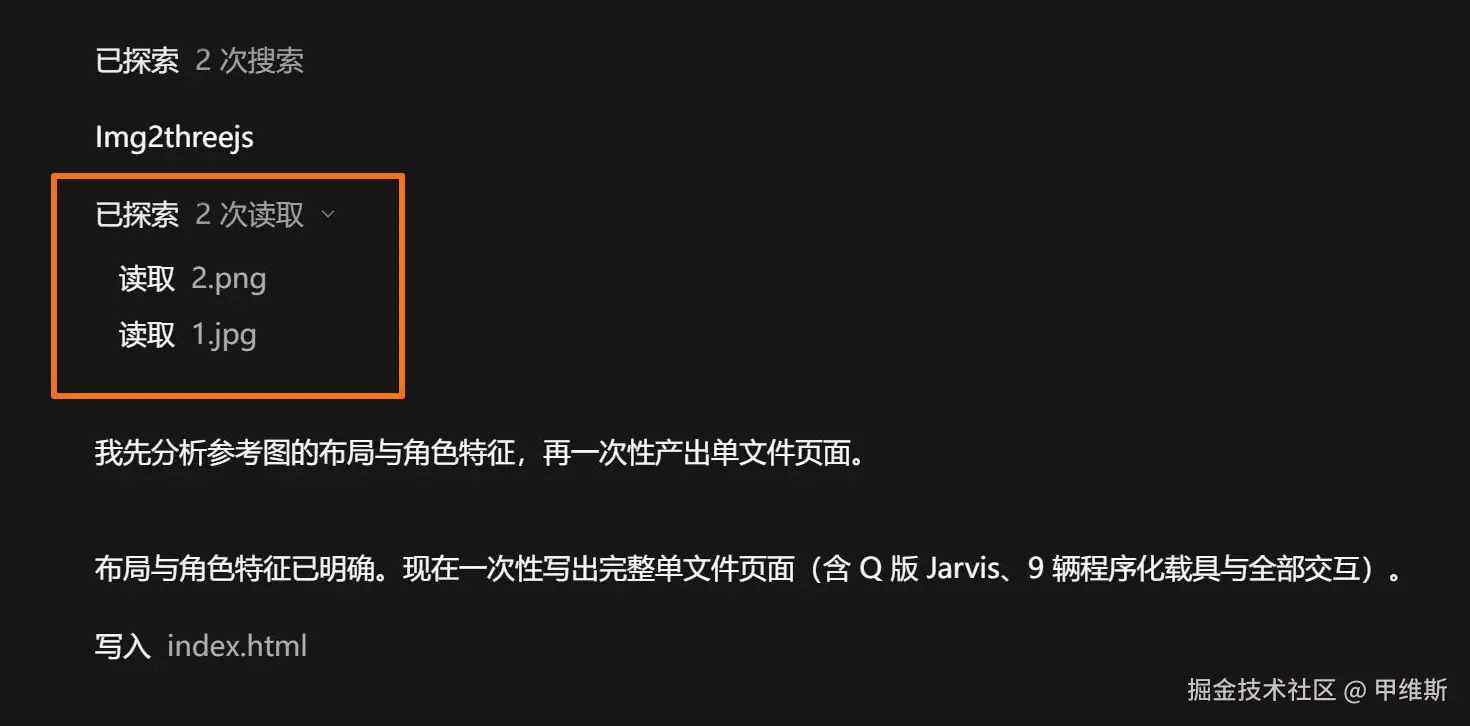
然后做完之后,又逐个分析了建模情况:
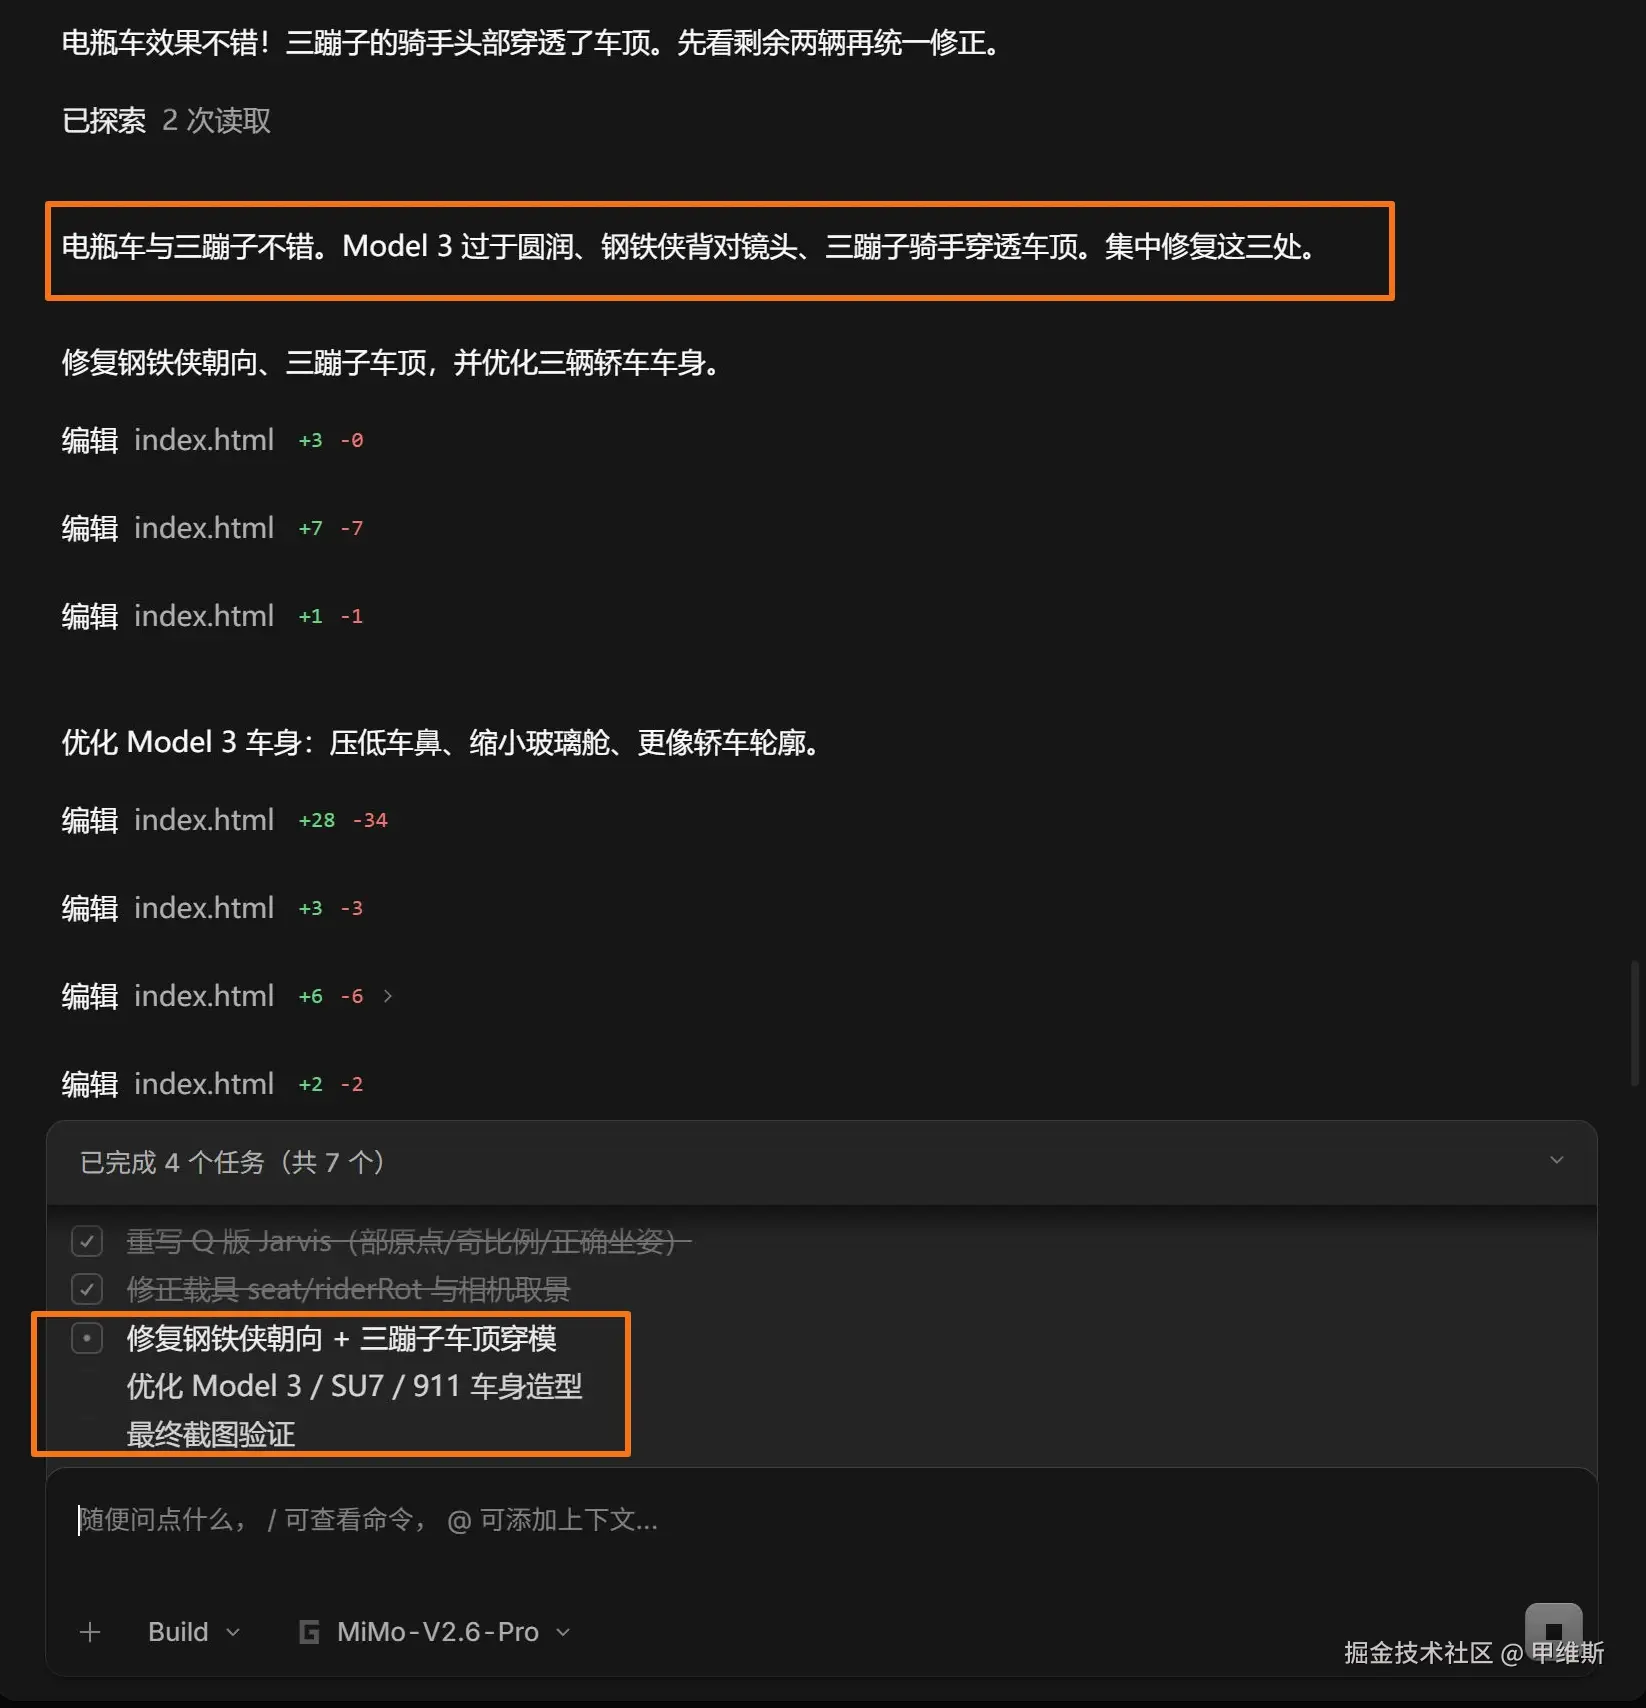
分析过程中发现电车不错,三蹦子有点问题,然后Model过于圆润了,钢铁侠背对镜头。
它能发现这些问题是很不错的。
然后安排了任务来修复这个问题。
并且最后截图验收。
这个流程就非常完善了!
BUT......它并没有修好,基本上没有什么优化。
知错,而无力改错。
除此之外,我也让它做了网页模板的设计:
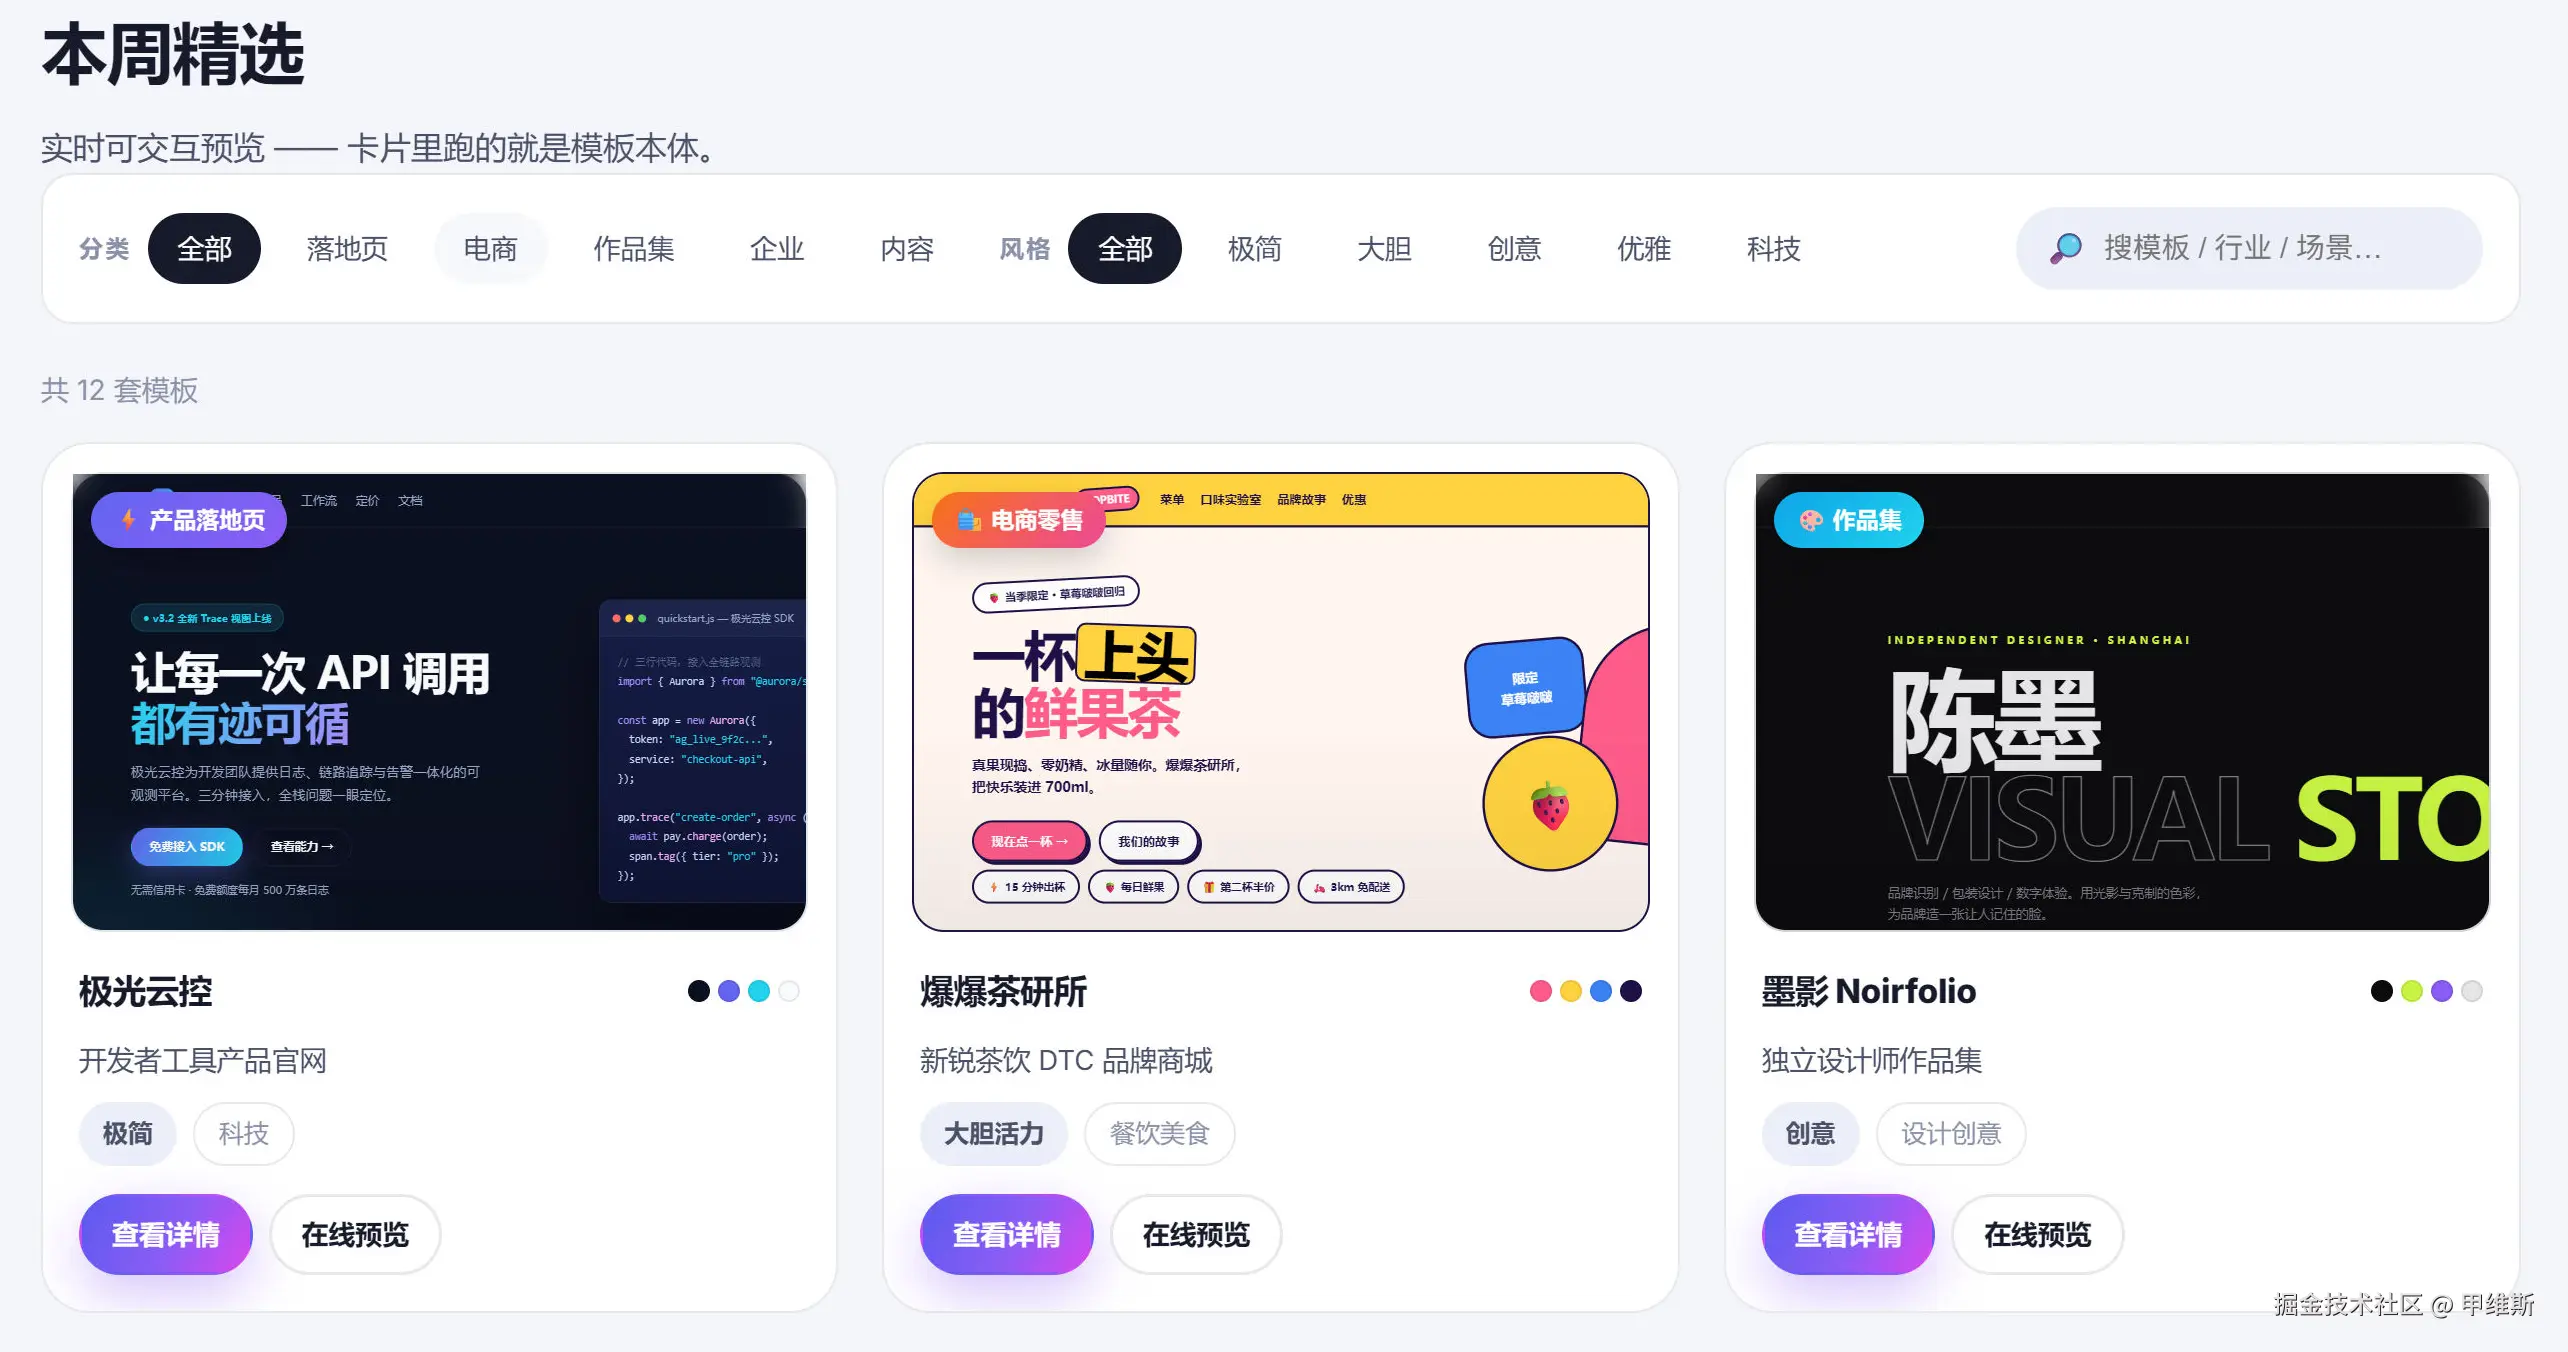
总共设计了 12 套模板。设计水平一般,能用,但是不突出。另外就是在布局控制方面有些 bug!
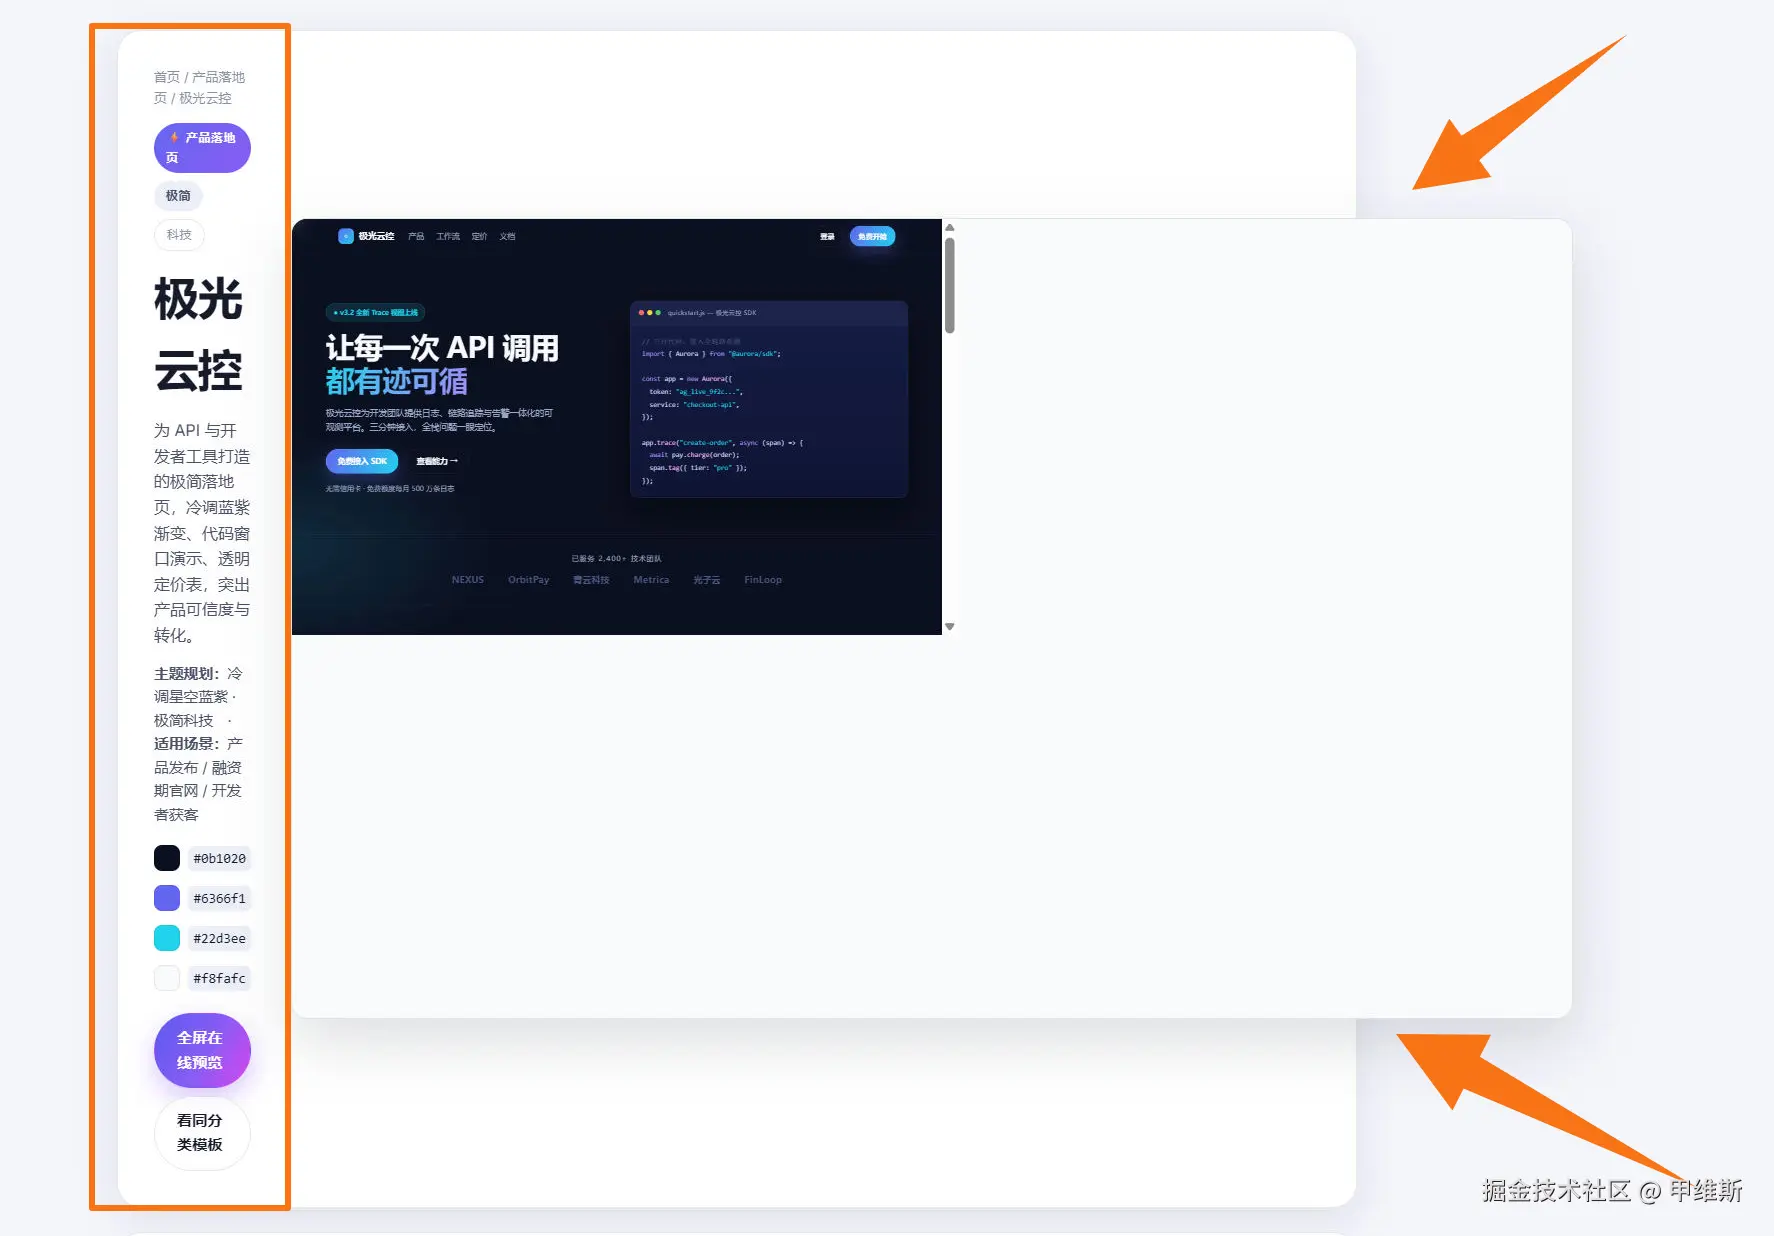
这个地方应该看得很清楚,右边太突出,左边被挤压了。 这个问题挺基础的,时至今日,不应该犯这种错误。
最后我来稍微总结一下。
首先,我测的例子并不是常见的例子,我测试下来效果不好,不代表它常规任务也做不好。
其次,在我们这些例子中,可以看到它的下限还是比较低的,上限不是很高。
反正不要相信它有多牛逼这种描述就对了,它和顶级模型之间没有太大关联。
它的重点 PK 对象应该是 DS 吧。
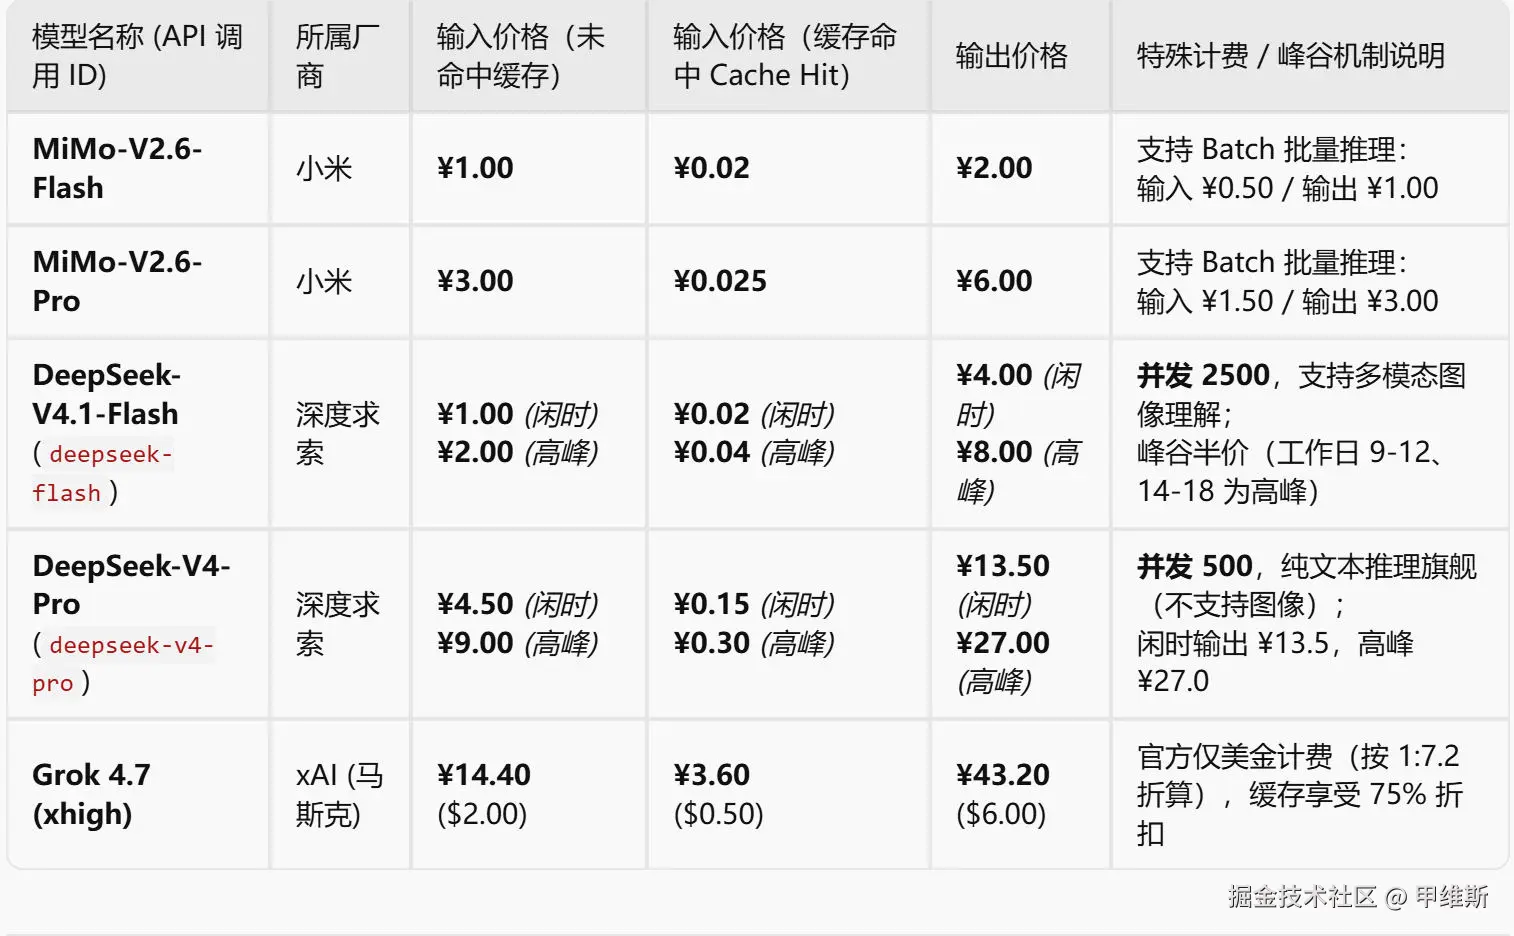
我稍微看了一下价格,它的 Flash 模型跟 DS 的 Flash 的"梁文谷"差不多,比"梁文锋"便宜一半!
Pro 模型比 DS Pro 的"梁文谷"还要便宜!
大家如果不追求能力有多强,只考虑成本的话,现在 MiMo2.6Flash 和 Pro 都极具性价比了。 MiMo 整体来说速度也是比较快的,它开发过程中没有太多纠结的地方,不行就直接躺平呗,这其实也是个优点,省时间。
然后我们再回过头来看一下这张基准图:
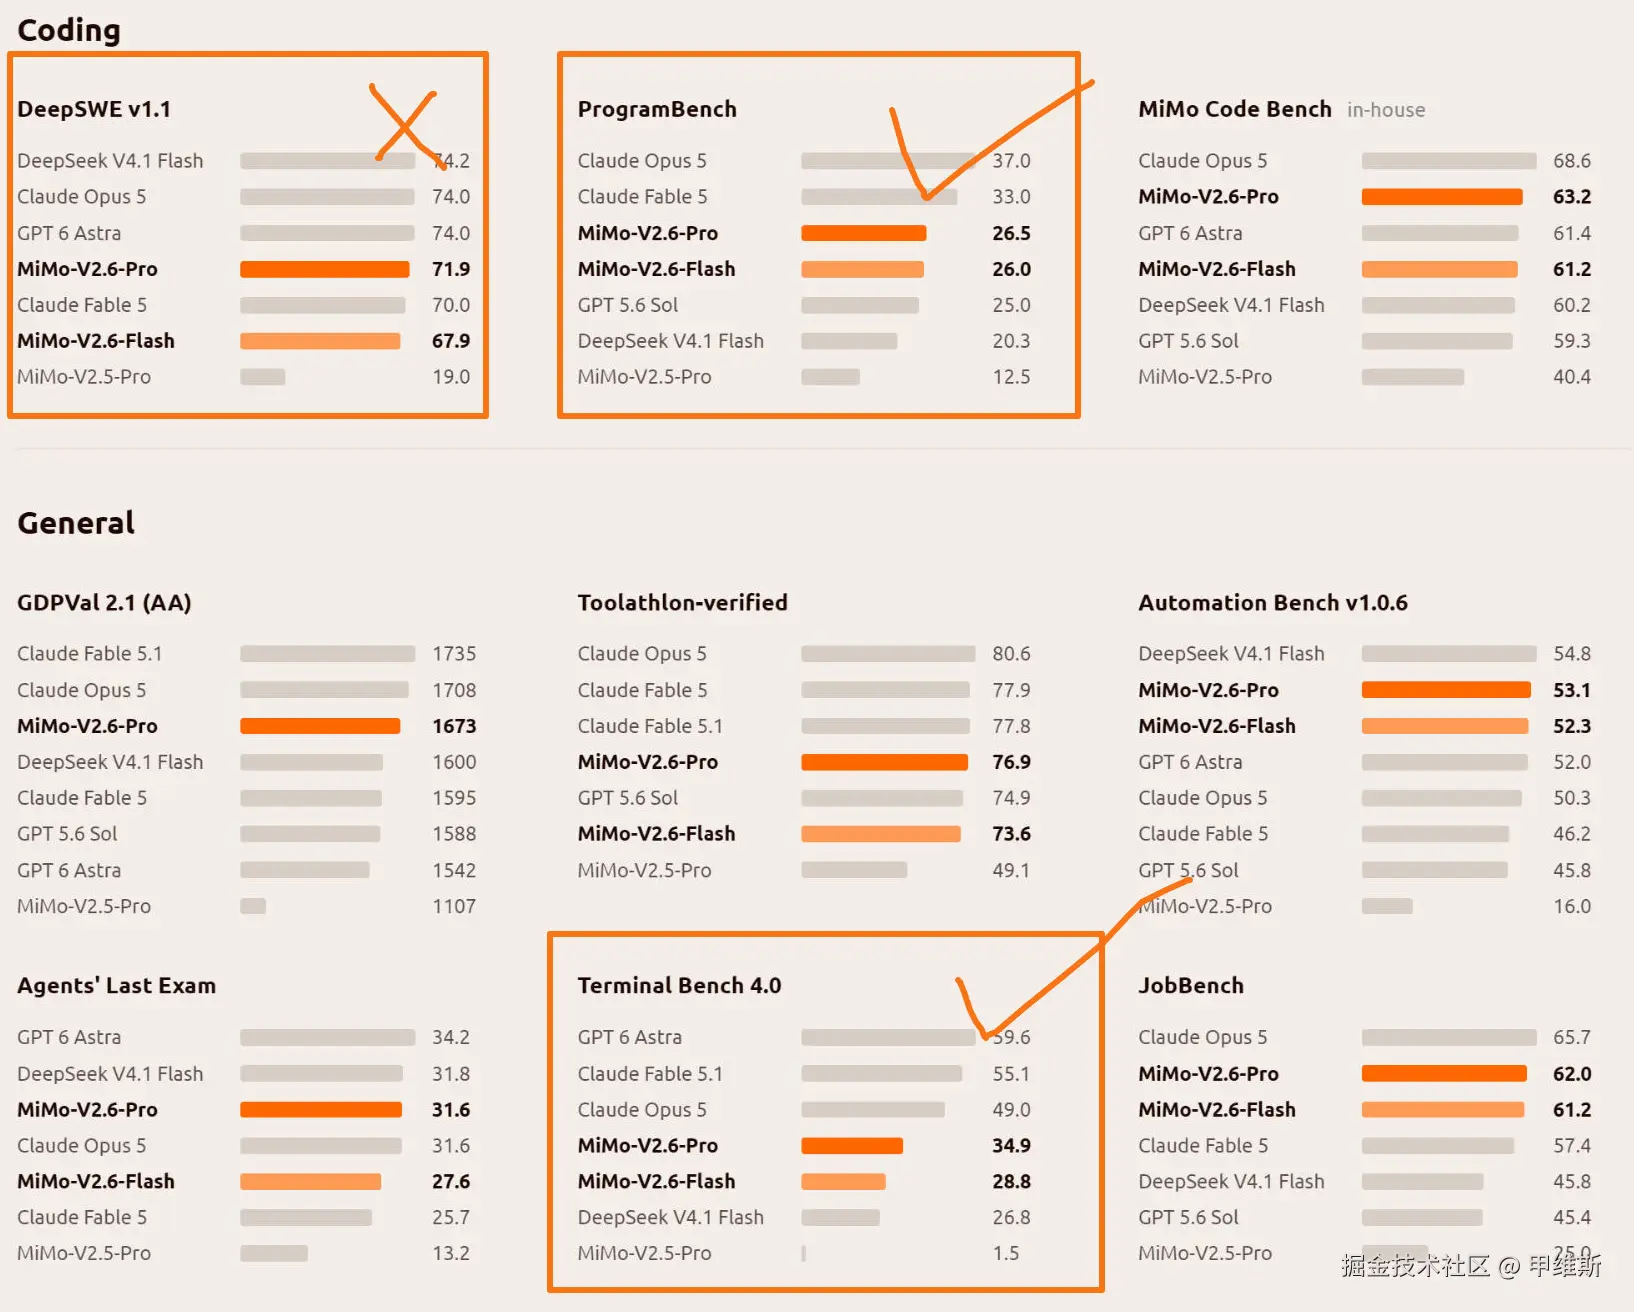
从编程角度来说:
DeepSWE 这个基准非常水,或者说被刷得很凶。
ProgramBench 和 Terminal Bench 4.0 相对来说比较接近真实水平的!
至于 K3 和 GLM5.3,我只想说,"老头子"们赶紧更新一波!
你们甘心所有人都在门前叫阵而不出战么?
现在给 MiMoV2.6 打个评级:"卧龙Pro",慢慢变得有点用了!
最后,最有意思的来了,MiMo2.6Pro 赶上好时候!直接和 Opus 5.5、GPT-5.6 同台竞技!哈哈哈!!!
因为文章内容比较长,我没有放太多模型对比图。
几十个模型横向对比请看:topai.jarvisuni.com/