一.LangSmith是什么
概念
LangSmith 是 LangChain 公司出品的 Agent 工程平台 ------专门用于 追踪、评估、部署和监控 LLM 应用与 AI Agent 。它和 LangChain / LangGraph 是同一家公司的产品,但不绑定 LangChain,OpenAI SDK、Anthropic SDK、LlamaIndex 甚至裸 Python 都能接进去 。
LLM 应用的痛点是:代码能跑通,如果结果不对,你根本不知道错在哪里。
一次 Agent 内部可能会调用很多次模型推理、RAG 检索、工具调用、子 Agent 分发等,中间任何一环出问题,传统 print() 日志根本看不出因果关系。
LangSmith 就把"哪一步调了哪个模型、传了什么、返回了什么、花了多少 Token 和钱、耗时多久"全部利用结构化方式记录下来,让开发者像看调用栈一样看 AI 的运行过程。
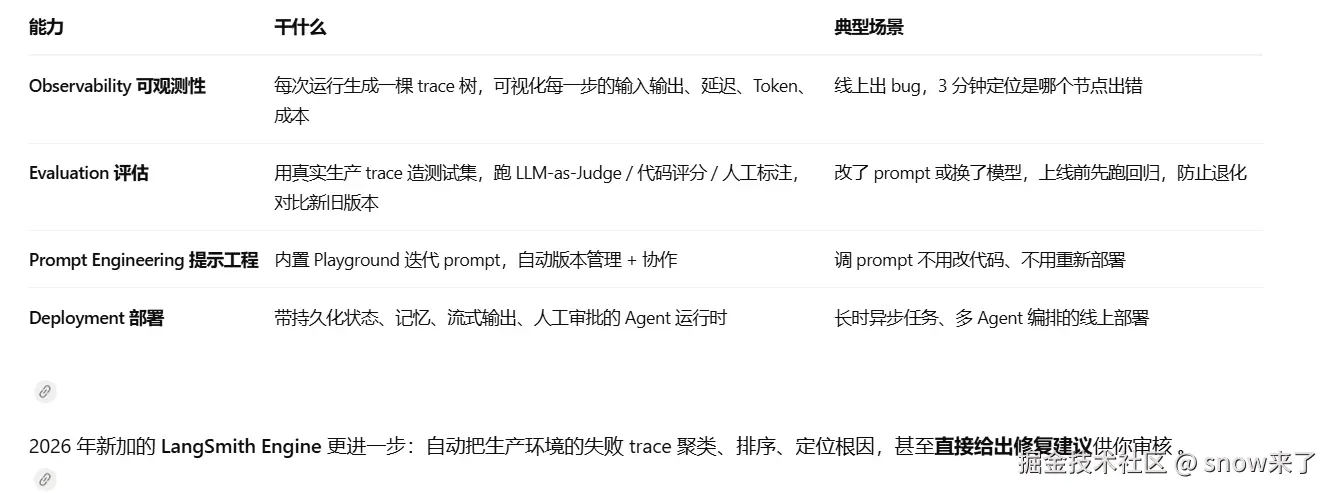
LangSmith 有四大核心能力
对比
- MCP 解决"怎么把工具接进来"。
- LangChain调用大模型。
- LangGraph 解决"怎么编排调用流程"。
- LangSmith 解决"接进来、跑起来之后,知道它干对了没、钱花哪了"。它是套在最外面的监控层,不是替代品而是补充 。
快速上手LangSmith
1.获取apikey
去 smith.langchain.com 用 GitHub 一键登录 → Settings → API Keys → 创建并复制 LANGCHAIN_API_KEY
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
2创建项目
js
mkdir langsmith-demo && cd langsmith-demo
npm init -y
npm install @langchain/openai @langchain/core @langchain/langgraph langsmith zod dotenv
3.环境变量
js
LANGSMITH_TRACING=true
LANGSMITH_API_KEY=lsv2_你的key
LANGSMITH_PROJECT=langsmith-demo
# 非 serverless 环境建议加这一行,能明显降低上报延迟
LANGCHAIN_CALLBACKS_BACKGROUND=true
OPENAI_API_KEY=sk-你的key
4.主动上报数据
基于上面的配置环境,执行下面代码,真正起作用的是LANGCHAIN_CALLBACKS_BACKGROUND=true
js
import "dotenv/config";
import { ChatOpenAI } from "@langchain/openai";
import { ChatPromptTemplate } from "@langchain/core/prompts";
import { StringOutputParser } from "@langchain/core/output_parsers";

const prompt = ChatPromptTemplate.fromMessages([
  ["system", "你是一个养生专家,请回答问题。"],
  ["user", "问题:{question}"],
]);

const model = new ChatOpenAI({
  modelName: process.env.MODEL_NAME,
  apiKey: process.env.OPENAI_API_KEY,
  temperature: 0,
  configuration: {
    baseURL: process.env.OPENAI_BASE_URL
  }
})
const chain = prompt.pipe(model).pipe(new StringOutputParser());

const result = await chain.invoke({
  question: "多喝玫瑰茶又什么好处?",
});
console.log(result);
5.测试自动上报
只需要运行项目及好。
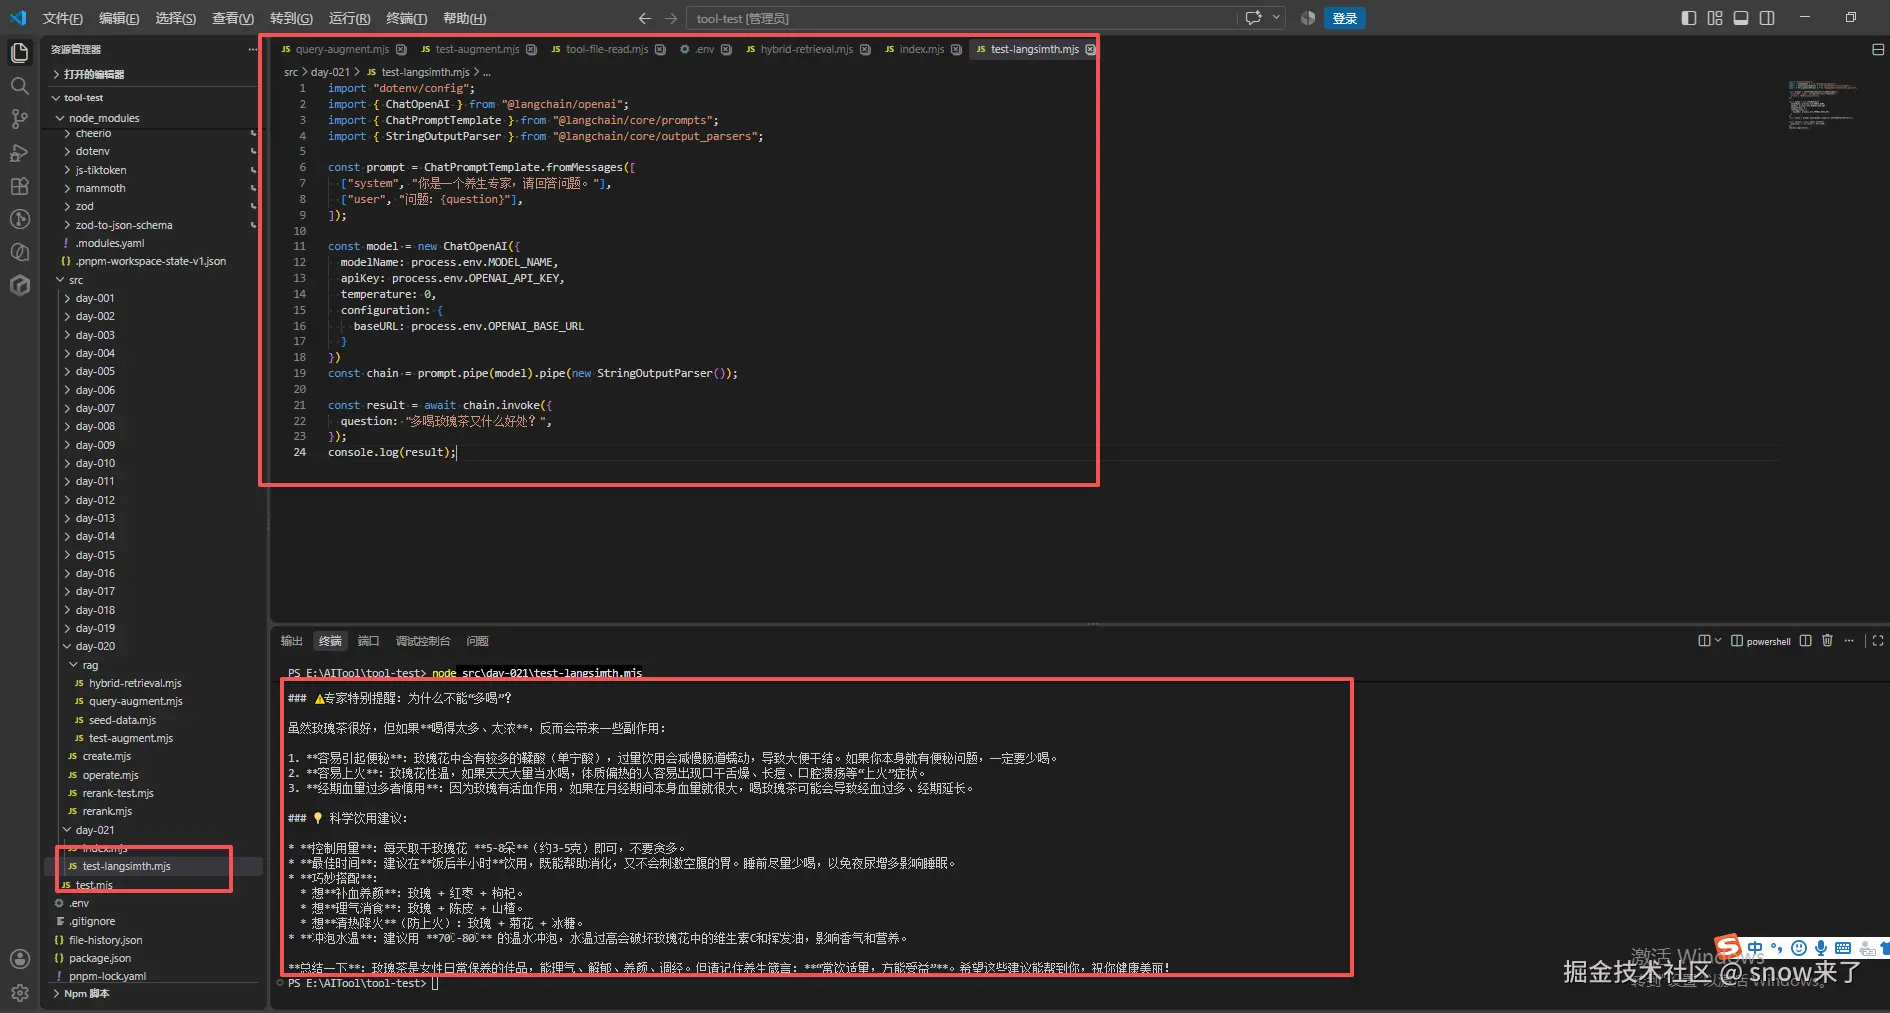
打开langsimth官网地址,smith.langchain.com/o/8ccebf65-...
点击进入tracing查看,只要你启动过,他都有相关记录 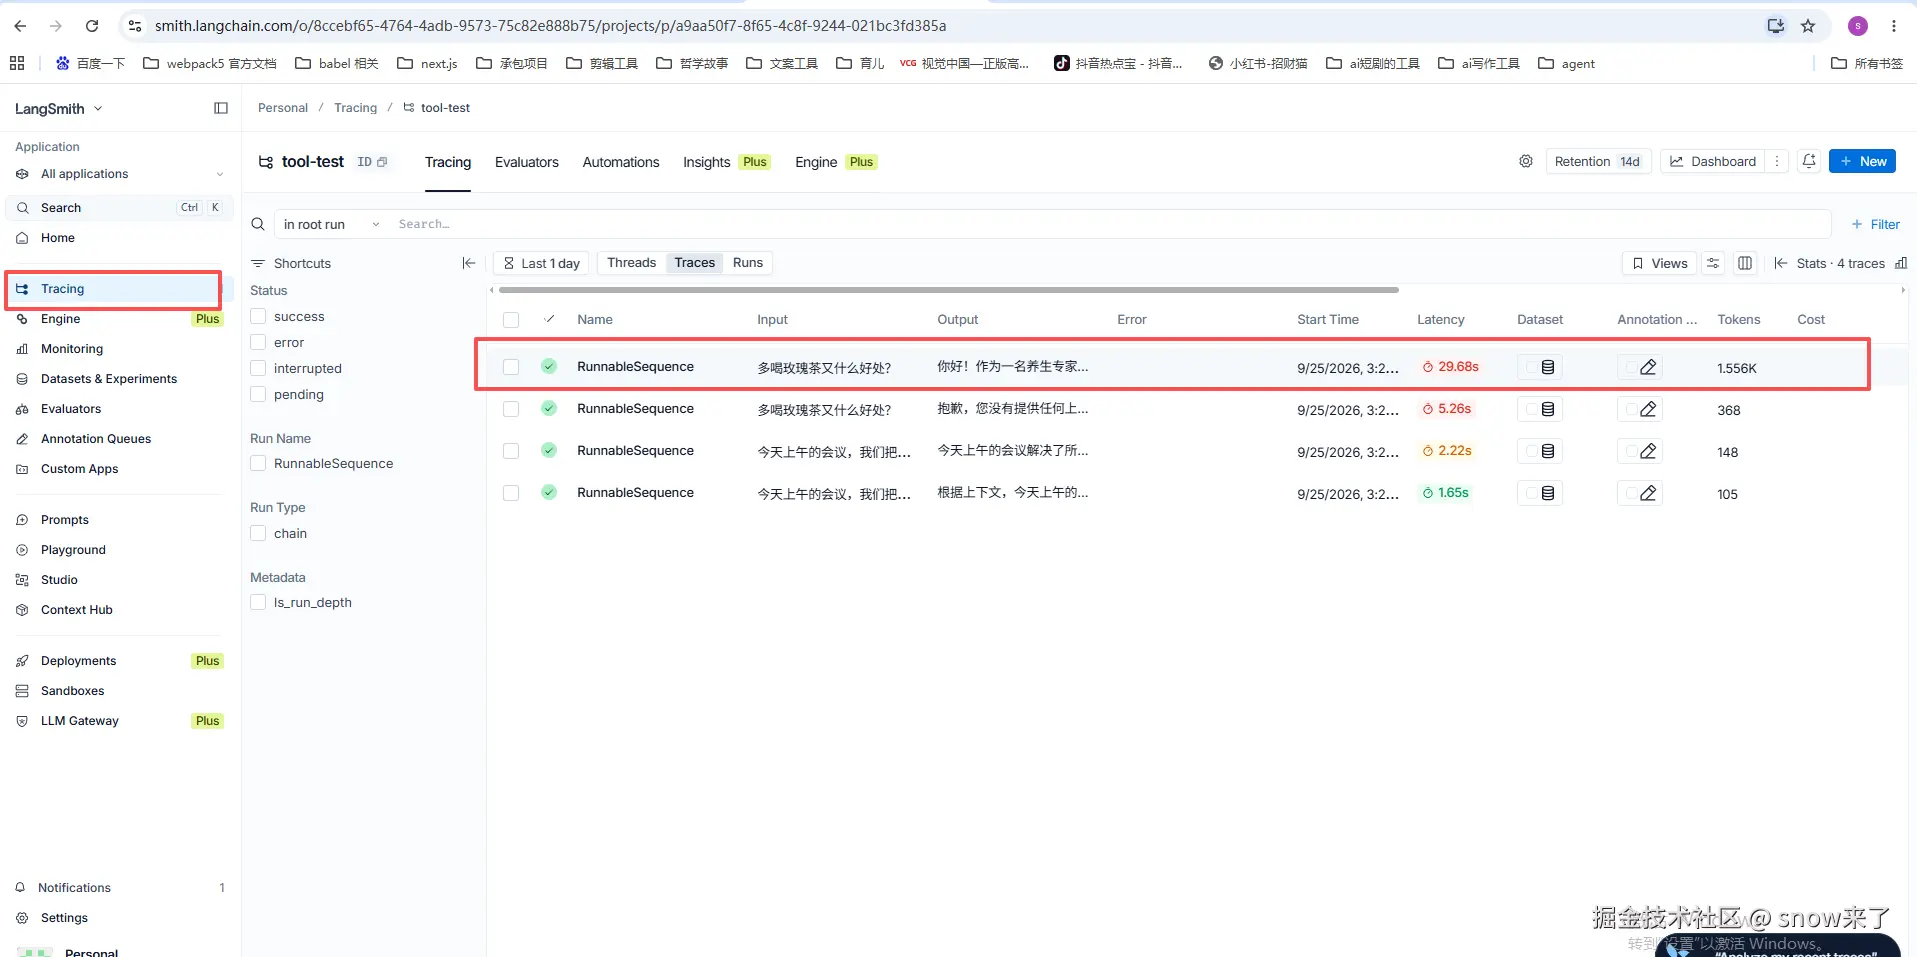
点击最新一条,我们查看他的输入输出。 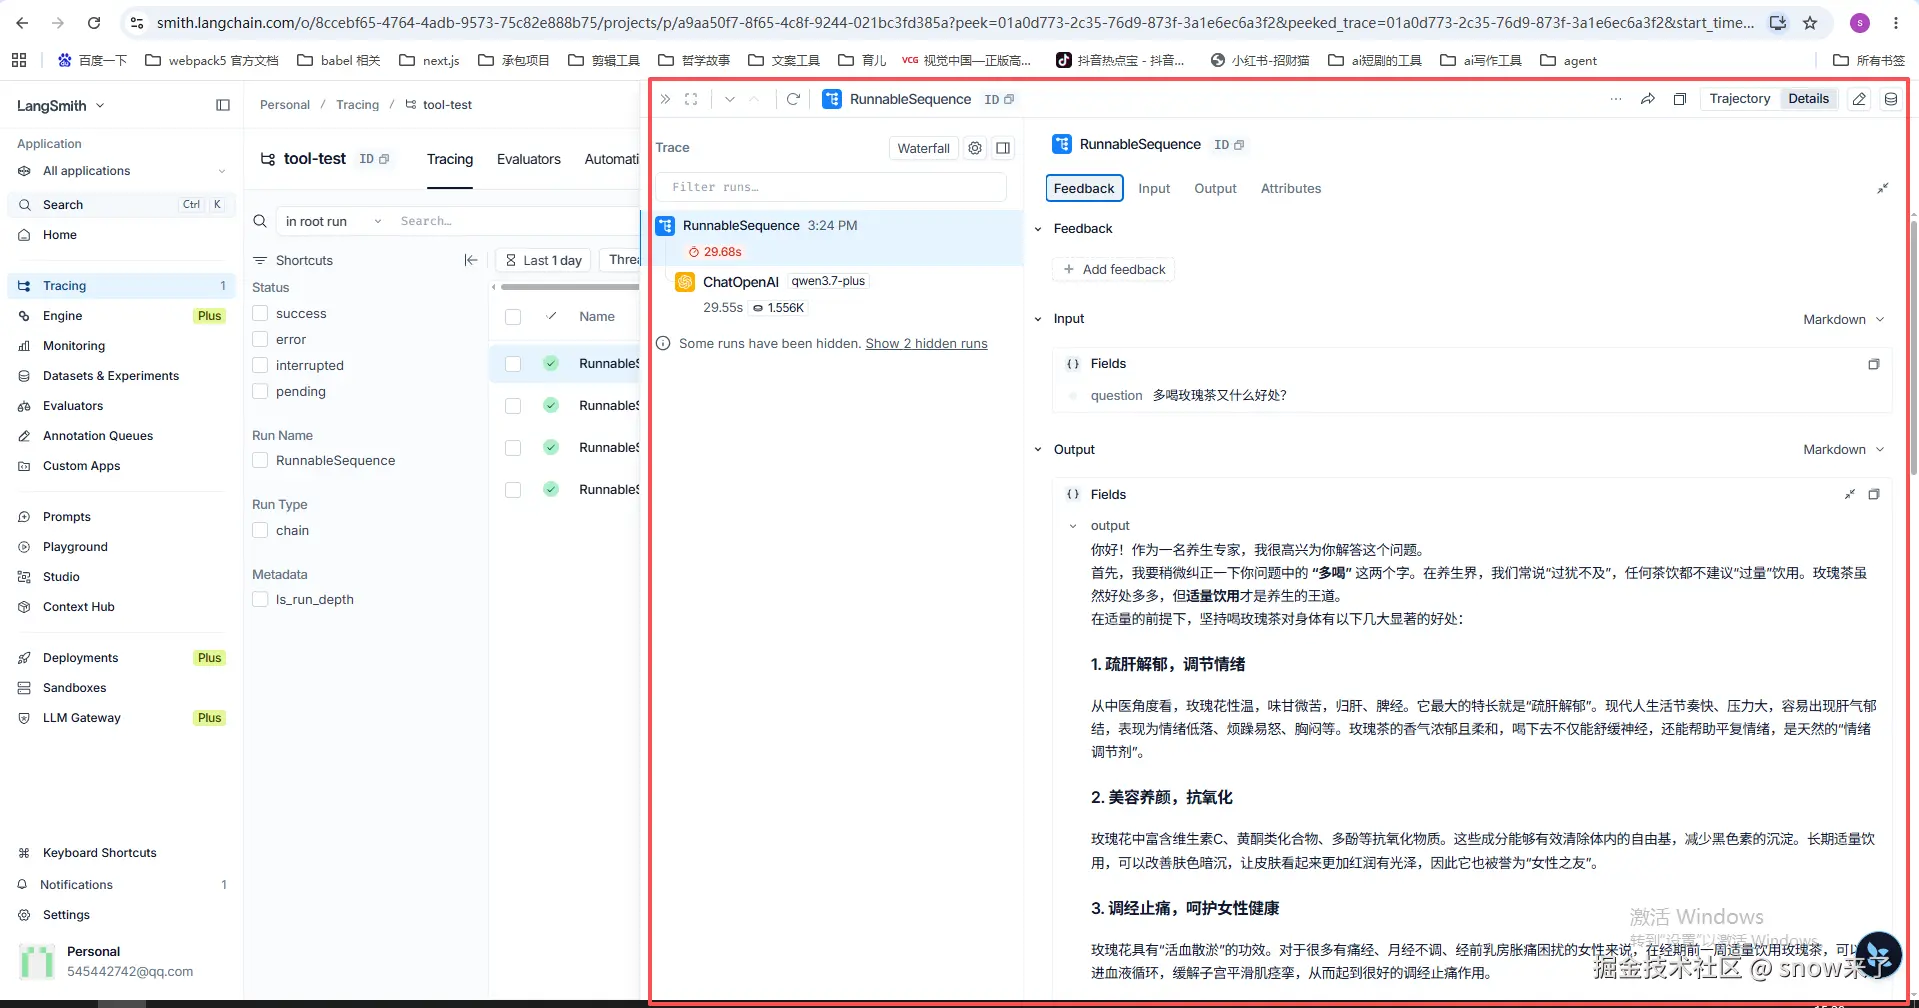
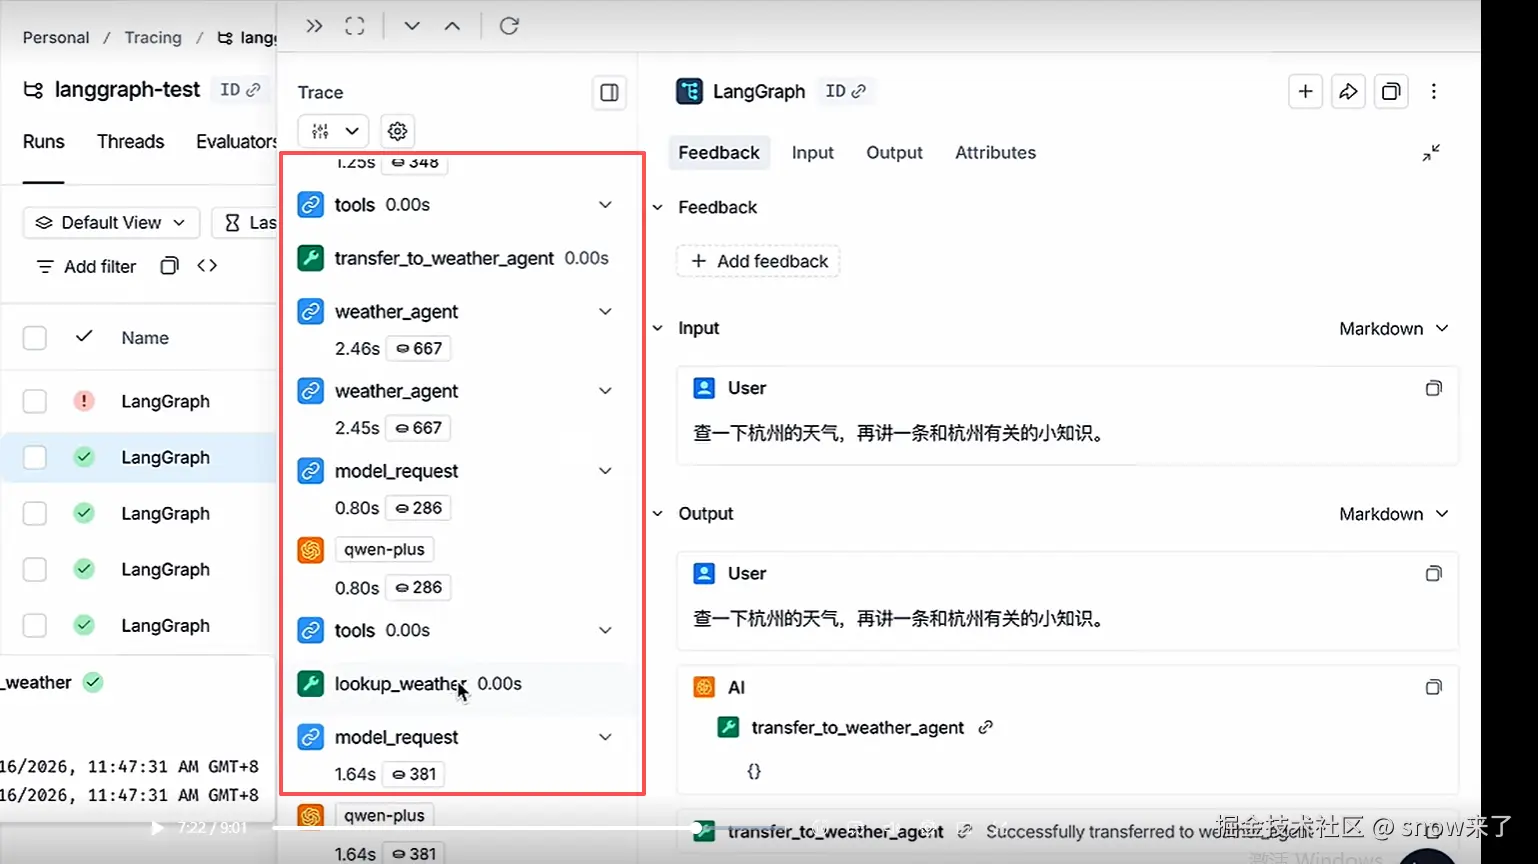
左侧他将显示你用的所有工具,langgraph等信息。TOOL的调用耗时都显示在左侧
6.手动上报数据
向langsmith里面上报数据的方式有两种,一种是LANGCHAIN_CALLBACKS_BACKGROUND=true,全局上报,代码不做任何处理。还有一种是手动上报,如下:
js
// client-demo.js
import "dotenv/config";
import { Client, RunTree } from "langsmith";

const client = new Client();

const parent = new RunTree({
  name: "用户问答会话",
  run_type: "chain",
  inputs: { question: "LangSmith 是干什么的?" },
  tags: ["qa"],
  extra: { metadata: { userId: "u-001" } },
});
await parent.postRun();

const child = await parent.createChild({
  name: "意图识别",
  run_type: "llm",
  inputs: { text: "LangSmith 是干什么的?" },
});
await child.end({ outputs: { intent: "概念解释" } });
await child.patchRun();

await parent.end({ outputs: { answer: "LangSmith 是 LLM 应用的可观测性与评测平台" } });
await parent.patchRun();

// 给这次运行打分,用于评估
const runs = await client.listRuns({ projectName: "langsmith-demo", error: false });
if (runs.length) {
  await client.createFeedback(runs[0].id, "accuracy", {
    score: 0.9,
    comment: "答案正确,但少了部署相关说明",
  });
  console.log("反馈已记录");
}
手动和自动上报后的数据都是按照下面方法进行查看的。
7.测试手动上报
跑一下 node basic-trace.js,然后打开 LangSmith 面板 → langsmith-demo 项目,就能看到一棵 trace 树:RunnableSequence → ChatPromptTemplate → ChatOpenAI → StringOutputParser,每一步的输入、输出、Token、费用、耗时全在里面。
8.openevals在项目中的使用
openevals是给LLM应用做自动化"考试"的开源评测库,由LangChain团队(langchain-ai)开发维护,代码在 GitHub 上开源。
宗旨:用另一个更强的模型当"阅卷老师",拿到你的输入和输出内容,让它按照一定的标准,给问题和答案打分。
其中 RAG 的三个指标 ------rag_groundedness、rag_helpfulness、rag_retrieval_relevance,都是 OpenEvals 内置的预置 prompt,你不需要自己从零写评测逻辑。
下载工具包
js
pnpm install openevals写执行dataset的代码
js
/**
 * OpenEvals 内置 RAG 指标
 */
import {
  createLLMAsJudge,
  RAG_GROUNDEDNESS_PROMPT,
  RAG_HELPFULNESS_PROMPT,
  RAG_RETRIEVAL_RELEVANCE_PROMPT,
} from "openevals";
import { ChatOpenAI } from "@langchain/openai";

const judge = new ChatOpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  configuration: { baseURL: process.env.OPENAI_BASE_URL },
  model: process.env.MODEL_NAME ?? "qwen-plus",
  temperature: 0,
});

// RAG_GROUNDEDNESS_PROMPT ------ 忠实度:答案是否被检索上下文支撑,有无幻觉
const ragGroundednessJudge = createLLMAsJudge({
  prompt: RAG_GROUNDEDNESS_PROMPT,
  feedbackKey: "rag_groundedness",
  judge,
  continuous: true,
});

// RAG_HELPFULNESS_PROMPT ------ 回答有用性:是否切题、是否答非所问
const ragHelpfulnessJudge = createLLMAsJudge({
  prompt: RAG_HELPFULNESS_PROMPT,
  feedbackKey: "rag_helpfulness",
  judge,
  continuous: true,
});

// RAG_RETRIEVAL_RELEVANCE_PROMPT ------ 检索相关性:召回片段与问题是否相关
const ragRetrievalRelevanceJudge = createLLMAsJudge({
  prompt: RAG_RETRIEVAL_RELEVANCE_PROMPT,
  feedbackKey: "rag_retrieval_relevance",
  judge,
  continuous: true,
});

export async function ragGroundednessEvaluator({ outputs }) {
  return ragGroundednessJudge({
    context: { documents: outputs.context },
    outputs: { answer: outputs.answer },
  });
}

export async function ragHelpfulnessEvaluator({ inputs, outputs }) {
  return ragHelpfulnessJudge({ inputs, outputs: { answer: outputs.answer } });
}

export async function ragRetrievalRelevanceEvaluator({ inputs, outputs }) {
  return ragRetrievalRelevanceJudge({
    inputs,
    context: { documents: outputs.context },
  });
}

export const ragEvaluators = [
  ragGroundednessEvaluator,
  ragHelpfulnessEvaluator,
  ragRetrievalRelevanceEvaluator,
];
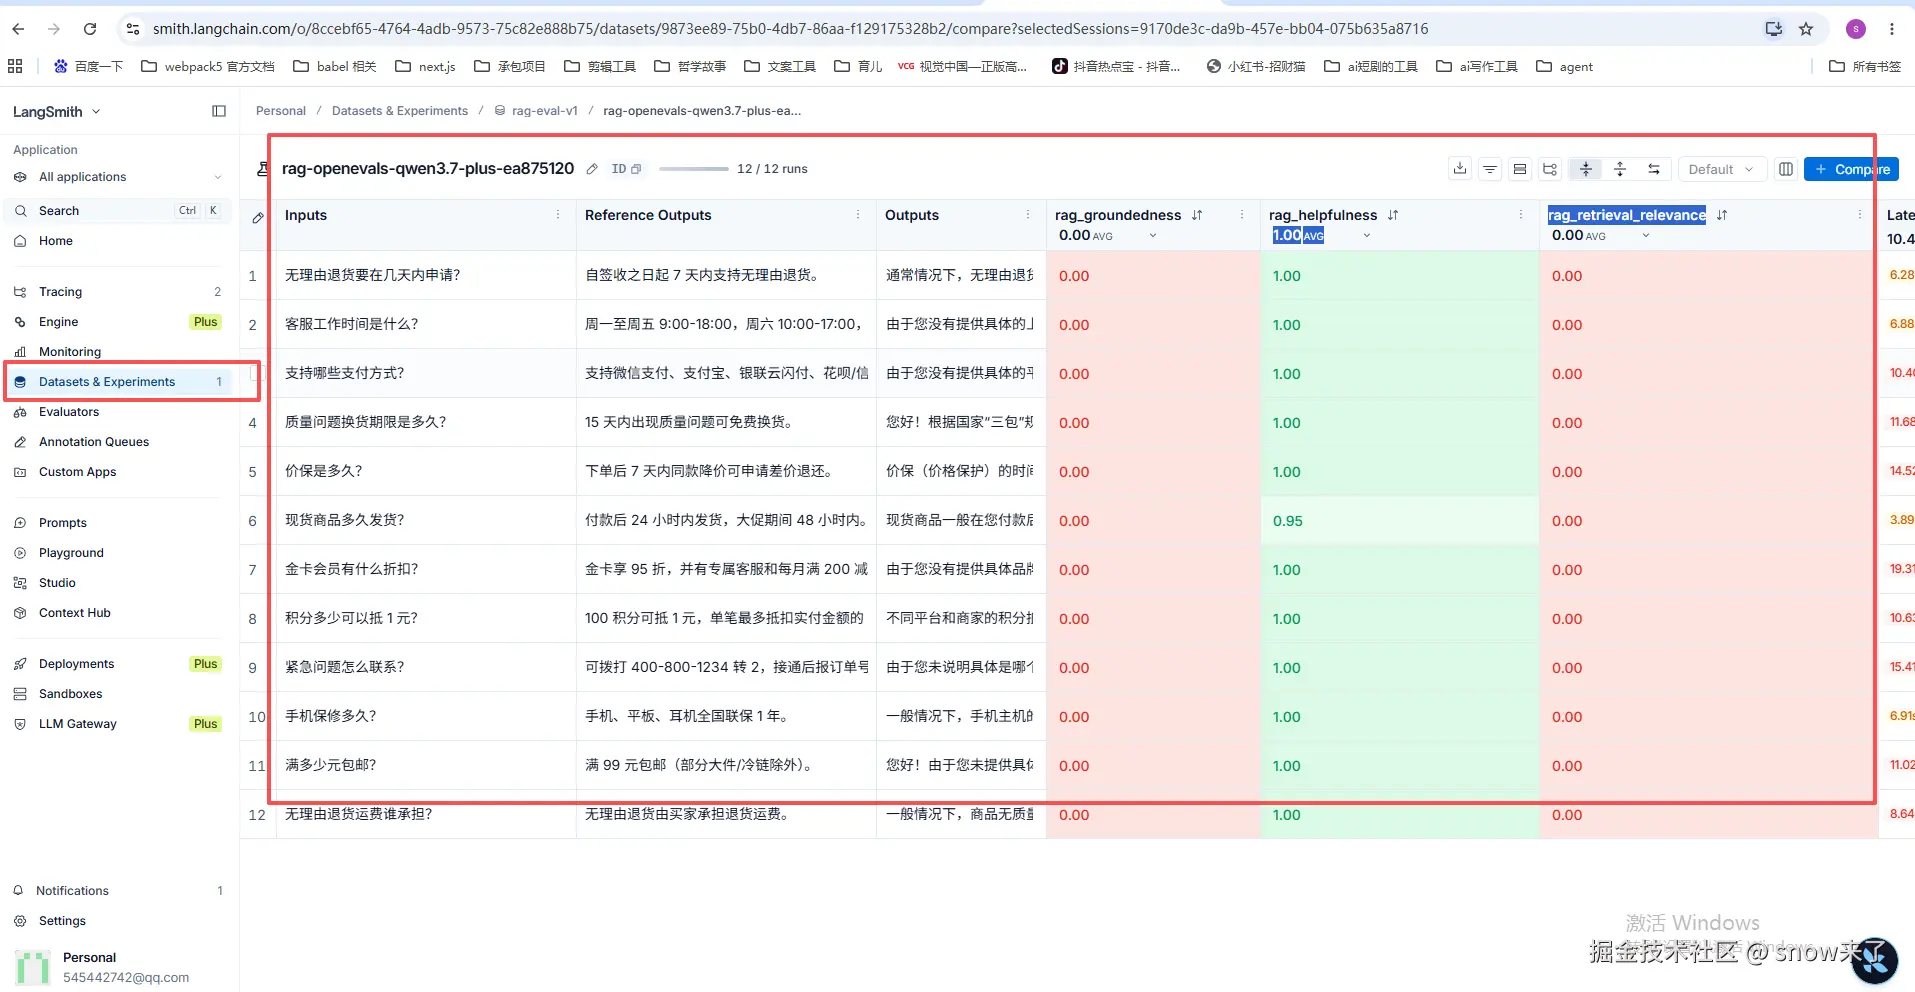
通过dataset就能看到数据的三个指标:
| 指标 | 含义 |
|---|---|
| rag_retrieval_relevance | 召回的文档和问题是否存在关联性,关联性有多大? |
| rag_groundedness | 答案是否被检索上下文所支撑,有没有幻觉?支撑度是多大? |
| rag_helpfulness | 是否切题、是否答非所问,帮助度多大? |
在整个dataset里面最主要的主表就是上面三个。
执行RAG检索的代码
js
import "dotenv/config";
import { Annotation, END, START, StateGraph } from "@langchain/langgraph";
import { ChatPromptTemplate } from "@langchain/core/prompts";
import { StringOutputParser } from "@langchain/core/output_parsers";
import { RunnableSequence } from "@langchain/core/runnables";
import { ChatOpenAI, OpenAIEmbeddings } from "@langchain/openai";
// import { Milvus } from "@langchain/community/vectorstores/milvus";

// const embeddings = new OpenAIEmbeddings({
//   apiKey: process.env.OPENAI_API_KEY,
//   configuration: { baseURL: process.env.OPENAI_BASE_URL },
//   model: process.env.EMBEDDING_MODEL ?? "text-embedding-v3",
// });

const llm = new ChatOpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  configuration: { baseURL: process.env.OPENAI_BASE_URL },
  model: process.env.MODEL_NAME ?? "qwen-plus",
  temperature: 0,
});

// const vectorStore = await Milvus.fromExistingCollection(embeddings, {
//   collectionName: process.env.MILVUS_COLLECTION ?? "rag_docs",
//   url: process.env.MILVUS_URI ?? "http://localhost:19530",
// });

// const retriever = vectorStore.asRetriever({ k: 4 });

const prompt = ChatPromptTemplate.fromMessages([
  [
    "system",
    "你是客服助手。仅根据下面「上下文」回答;上下文没有的信息就自己给出答案。",
  ],
  ["human", "{question}"],
]);

const chain = RunnableSequence.from([prompt, llm, new StringOutputParser()]);

const GraphState = Annotation.Root({
  question: Annotation,
 // context: Annotation,
  answer: Annotation,
});

// 从milvus中检索文档
async function retrieve(state) {
  //const docs = await retriever.invoke(state.question);
 // return { context: "不知道" };
 console.log("这里是检索文档的代码")
}

// 大模型生成答案
async function generate(state) {
 // const contextText = state.context.map((d) => d.pageContent).join("\n\n");
  const answer = await chain.invoke({
  //  context: contextText,
    question: state.question,
  });
  return { answer };
}

const workflow = new StateGraph(GraphState)
  .addNode("retrieve", retrieve)
  .addNode("generate", generate)
  .addEdge(START, "retrieve")
  .addEdge("retrieve", "generate")
  .addEdge("generate", END);

export const ragApp = workflow.compile();

export async function ask(question) {
  const result = await ragApp.invoke({ question });
  return {
    answer: result.answer,
    context: result.context ?? [],
  };
}
将openevals和RAG检索结合起来测试的代码。langsmith/evaluation里面的evaluate方法起执行RAG langph,同时要ragEvaluators去监控数据。
js
/**
 * RAG 评测入口:dataset(问题+标准答案) + evaluate
 */
import "dotenv/config";
import { Client } from "langsmith";
import { evaluate } from "langsmith/evaluation";
import { ask } from "./rag_agent.mjs";
import { ragEvaluators } from "./openeval-test.mjs";

const DATASET_NAME = "rag-eval-v1";
const client = new Client({ apiKey: process.env.LANGCHAIN_API_KEY });

/** 被评测的 RAG Agent */
async function runRagAgent(inputs) {
  const { answer, context } = await ask(inputs.question);
  return {
    answer,
    context: context.map((d) => d.pageContent),
  };
}

async function main() {
  const result = await evaluate(runRagAgent, {
    data: DATASET_NAME,
    evaluators: ragEvaluators,
    client,
    experimentPrefix: `rag-openevals-${process.env.MODEL_NAME ?? "qwen"}`,
    maxConcurrency: 2,
  });

  // 等待全部样例跑完
  for await (const _row of result) {
    /* drain */
  }

  const project = process.env.LANGCHAIN_PROJECT ?? "default";
  console.log("✅ 评测完成");
  console.log("实验名:", result.experimentName);
  console.log(
    "指标: rag_groundedness | rag_helpfulness | rag_retrieval_relevance",
  );
  console.log(
    `报告: https://smith.langchain.com/o/default/projects/p/${encodeURIComponent(project)}`,
  );
}

main().catch((err) => {
  console.error(err);
  process.exit(1);
});