算法竞赛C++常用的STL
- 一.vector动态数组
-
- 1.1初始化
- [1.2 size/empty/push_back/pop_back](#1.2 size/empty/push_back/pop_back)
- [1.3 begin/end](#1.3 begin/end)
- [1.4 resize和clear](#1.4 resize和clear)
- 二.stack栈
- 三.queue队列
- 四.priority_queue优先级队列
- 五.set/multiset
- 五.map/multimap
- 六.unordered_set/unordered_map
一.vector动态数组
我们可以把vector看成一个动态的数组,就是一个可变长数组
定义一个vector有多种定义方法 具体可以看下列的代码以及注释,因为是针对于算法竞赛,所以没有特别细讲、
1.1初始化
cpp
//尖括号里面放的是存储数据的类型,由于牵扯到C++类和模板的知识,所以大概提一下,
vector<int> v1;//定义一个可变长的空数组
vector<int> v2(N);//定义一个初始空间大小为N的可变长数组
vector<int> v3(N,10);//创建一个大小为N的vector,并且存储的数据全是10
vector<int> v4={1,2,3,4,5};//初始化列表的创建方式
vector<int> v5[N];//创建一个长度为N的数组 数组里面存放的全是vector类型的数据
1.2 size/empty/push_back/pop_back
- size就是看这个动态数组的空间大小
- empty判断这个数组是否为空
- push_back尾插数据
- pop_back尾删数据
具体使用代码实现如下
cpp
vector<int> v(N,10);
v.size()//返回10`在这里插入代码片`
v.empty();//返回假
v.push_back(1);//尾插一个1
v.pop_back();//尾删
1.3 begin/end
- begin返回初始位置的迭代器
- end返回末位置的下一个位置的迭代器
具体使用代码如下
cpp
vector<int> v={1,2,3,4,5};
auto it1=v.begin();//用auto去接受迭代器这样更方便
//遍历数组
for(auto it2=it1;it2++;it!=end() )
{
	cout<<*it2<<" ";//解引用得到存储的数据
}
1.4 resize和clear
- resize可以扩大或者缩小空间
- clear清空数组
具体使用代码如下
cpp
vector<int> v={1,2,3,4,5};
v.resize(8);//把空间扩大成8
v.resize(2);//把空间缩小成2
v.clear();//清空数组
二.stack栈
大致了解一下 栈是一个先进后出的数据结构(只允许在一断插入和删除)
由于初始化很简单 所以我们放到下面代码中一起实现
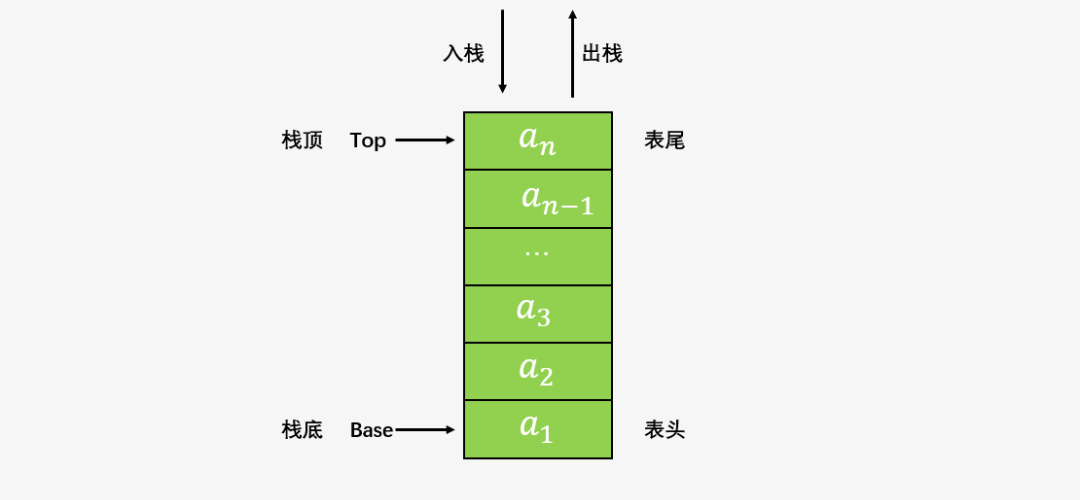
2.1push/pop
- push就是入栈的意思
- pop就是出栈的意思
具体使用代码如下
cpp
stack<int> s1;
s1.push(1);//入栈1
s1.push(2);//入栈2
s1.pop();//出栈2
s1.pop();//出栈1
2.2size/empty
1. size 就是计算栈中的数据
- empty判断栈是否为空
具体使用代码如下
cpp
stack<int> s1;
s1.push(1);//入栈1
s1.push(2);//入栈2
s1.size()//输出2
s1.pop();//出栈2
s1.pop();//出栈1
s1.empty()//返回真
2.3top
- top返回栈顶元素
具体使用代码如下
cpp
stack<int> s1;
s1.push(1);//入栈1
s1.push(2);//入栈2
s1.top();//输出1
三.queue队列
队列是一种特殊的线性表 只能从表的一段插入然后从表的另一端输出(先进先出)
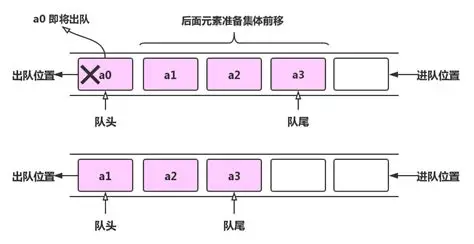
3.1push/pop
- push入队列
- pop出队列
具体代码使用如下
cpp
queue<int> q;
q.push(1);//入队1
q.push(2);//入队2
q.pop();//出队1
q.pop();//出队2
3.2size/empty
- size就是计算表中的数据
- empty判断队列是否为空
具体使用代码如下
cpp
queue<int> q;
q.push(1);//入队1
q.push(2);//入队2
q.size();//返回2
q.pop();//出队1
q.empty();//返回假
q.pop();//出队2
q.empty();//返回真
3.3front/back
- front返回队头元素
- back返回队尾元素
具体实现代码如下
cpp
queue<int> q;
q.push(1);//入队1
q.push(2);//入队2
q.front();//返回1
q.back();//返回2
q.pop();//出队1
q.front();//返回2
q.pop();//出队2
四.priority_queue优先级队列
什么是优先级队列?
这里简单解释一下 因为我们只需要学会使用就行
优先级队列的底层是一个数组因为涉及到了数据的交换 数组交换的效率更高
大家可以把优先级队列想象成一个二叉树的结构 默认的优先级队列就是大根堆 也就是堆顶的那个数据是最大的 小根堆则相反
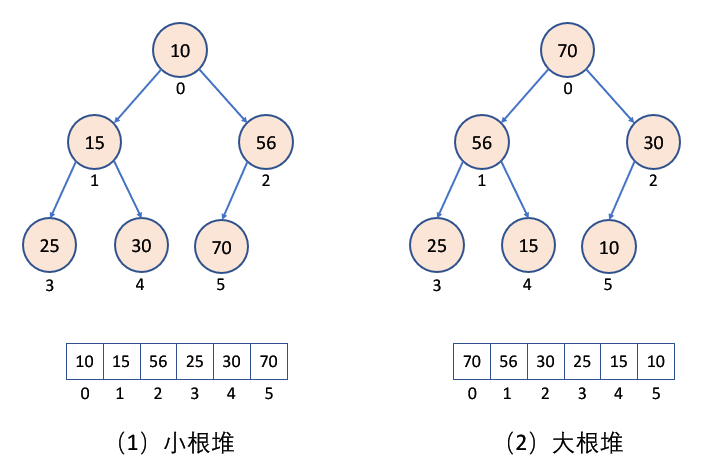
4.1push/pop/top
这里解释一下入堆和出堆我们所建的堆的结构都要发生变化 因为我们要满足堆的特性
具体的使用代码如下
cpp
priority_queue<int> q;
//如果想创建小根堆可以这样写代码
//priority<int,vector<int>,greater<int>>
//默认的大根堆其实是这样的
//priority<int,vector<int>,less<int>>
q.push(1);//入堆1
q.push(55);//入堆55
q.push(33);//入堆33
q.top();//返回堆顶元素55
q.pop();//出堆都是出的堆顶
4.2size/empty
- size就是计算有多少数据
- empty判断堆是否为空
4.3如何存储的是自定义类型怎么办?
我们前面存储的都是内置类型 如果存储的是内置类型比如结构体应该如何做?(这里说一下为什么前面我们没有讨论这个自定义类型 因为堆的结构要完善就要进行数据的比较 一个结构体并不是像int那种可以直接比较 )
答 : 这里介绍一个方法 这个方法记住模板就行了因为涉及到了C++里面的运算符重载和仿函数的知识
我们就以下面的结构体为例 我们要把下面这个结构体放到堆里面就要在结构体里面进行以下操作
cpp
struct node
{
//按照b为基准创建大根堆
	bool operator<(const node& n)
	{
		return b<n.b;//如果是小根堆就要写成大于号
	}
	int a;
	int b;
	int c;
}
五.set/multiset
5.1set和multiset的区别是什么?
这两个数据结构的主要区别就在于set不可以存储相同的数据 ,但是multiset可以存储相同的数据 (set只能存储一个数据 下面讲解的有一个是map可以存储两个元素)
大概说一下底层 它们底层是用一棵红黑树封装起来的 具体了解一下就行 竞赛中不需要过多研究
这里我们只讲set 因为set会用multiset也就会用了
5.2insert/erase
- insert就是往红黑树里面插入一个数据
- erase就是删除红黑树一个元素
具体使用代码如下
cpp
set<int> s;
s.insert(1);
s.insert(5);
s.insert(3);
s.insert(2);
s.erase(2);//删除2
5.3find/count
- find查找一个元素 返回的是迭代器
- count查找一个元素出现的次数
我们平时查找一个元素是否在红黑树中,我们平时使用的都是count因为如果使用find还要判断它的返回值(迭代器)
具体使用代码如下
cpp
set<int> s;
s.insert(2);
s.count(2);//返回1
s.erase(2);//删除2
s.count(2);//返回0
5.4size/empty
- size返回这个红黑树的数据
- empty判断这个红黑树是否为空
具体使用代码如下
cpp
set<int> s;
s.insert(2);
s.size();//返回1
s.empty();//返回假
5.5begin/end
- begin返回的是第一个元素的迭代器
- end返回的时候最后一个元素的下一个位置的迭代器
注意:我们用for遍历是按照中序遍历的 我们输出的最终的结果也是有序的
这里就不演示了 和其他迭代器一样
5.6lower_bound/upper_bound
- lower_bound:大于等于x的最小元素,返回的是迭代器
- upper_bound:大于x的最小元素,返回的是迭代器
具体使用代码如下
cpp
set<int> s;
s.insert(1);
s.insert(2);
s.insert(6);
auto it1=s.lower_bound(2);//返回的是2这个元素的迭代器
cout<<*it1<<endl;//输出2
auto it2=s.upper_bound(2);//返回的是6这个元素的迭代器
cout<<*it2<<endl;//输出6
五.map/multimap
先提前说一下 这里也一样只讲解map
5.1什么是map?我们在什么样的场景可以使用map?存储的是什么?按照谁为基准比较大小?
- 什么是map?
map相对于set可以多存储一个数据 (可以存双关键字)底层也一样只用红黑树实现的- 什么场景下用map?
一个题如果问找出一堆字符串中,某一个字符出现的次数 这个时候就可以用map- 存储的是什么?
存储的是一个pair<key,value> 这个pair大家可以理解为一个结构体有两个元素一个是first(key) 另一个是second(value)- 按照谁为基准比较大小?
我们是按照第一个关键字key来比较大小的
5.2insert/erase
- insert插入一个数据
- erase删除一个数据
具体使用代码如下
cpp
map<string,int> mp;
//这里插入的要用一个花括号,因为插入的是一个结构体
mp.insert({"张三,1"});
mp.insert({"李四,2"});
mp.insert({"王五,3"});
//遍历
for(auto& it:mp)
{
	cout<<it.first<<" "<<it.second<<endl;
}
5.3operator\[\]
重载了\[\],可以让map像一个数组一样使用
具体使用代码如下
cpp
map<string,int> mp;
//这里插入的要用一个花括号,因为插入的是一个结构体
mp.insert({"张三,1"});
mp.insert({"李四,2"});
mp.insert({"王五,3"});
cout<<mp["张三"]<<endl;//输出1
//还可以改变value
mp["张三"]="4"//value修改为4
//还可以新插入一个数据
//如果没有赵六这个人 那么会直接把赵六插入进去
mp["赵六"];//插入赵六
在这里说一下由于size/empty/begin/end/lower_bound/upper_bound
和set使用方法一下就不过多介绍了
六.unordered_set/unordered_map
这里说一下这两个数据结构的使用方法和我们的map/set几乎一模一样,只不过是少了lower_bound和upper_bound这两个函数,并且它们的底层变成了哈希表(可以理解为一个数组查找和删除效率特别高 因为我们在底层通过坐标访问元素),所以这里不过多解释了