 老金我最近用Codex里的GPT-6 Astra做事,会直接开xhigh。
原因是这样,我拿我跑的4万多次做了回测。
数据显示6的Xhigh实测Token消耗对比起来要少,它会走几次弯路,事情更容易做完,在5.6上并不明显,但是在6上尤为明显。
这和很多人的直觉相反。推理档位越高,模型想得越多,怎么还会省?
我也想把这事儿弄明白,于是翻了自己9月的记录,找出40,125次有明确档位和Token明细的请求。
里面有个反差:xhigh平均用来思考的Token,是medium的约2.6倍,平均总Token却低了约8.6%。
第一次看到结果的时候,我开始更在意,每次多想的那一点,究竟能不能换来后面少折腾几轮。
先看看统计的数字,medium平均每次用了69.8个推理Token、141,247个总Token。xhigh对应的是182.5和129,146。
这是原始数据拉出来的表格。 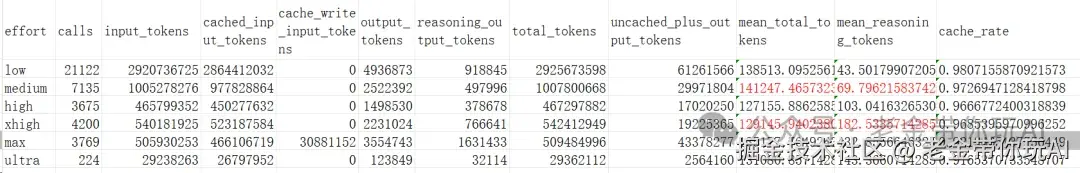 看红字,思考的部分变多了,总量却没跟着变多,这里的总量包含输入和输出。
但这共计40125次调用来自不同任务,也包含子代理。它们是我的实际使用记录,并不是四万多道题分别交给六个档位重做一遍。 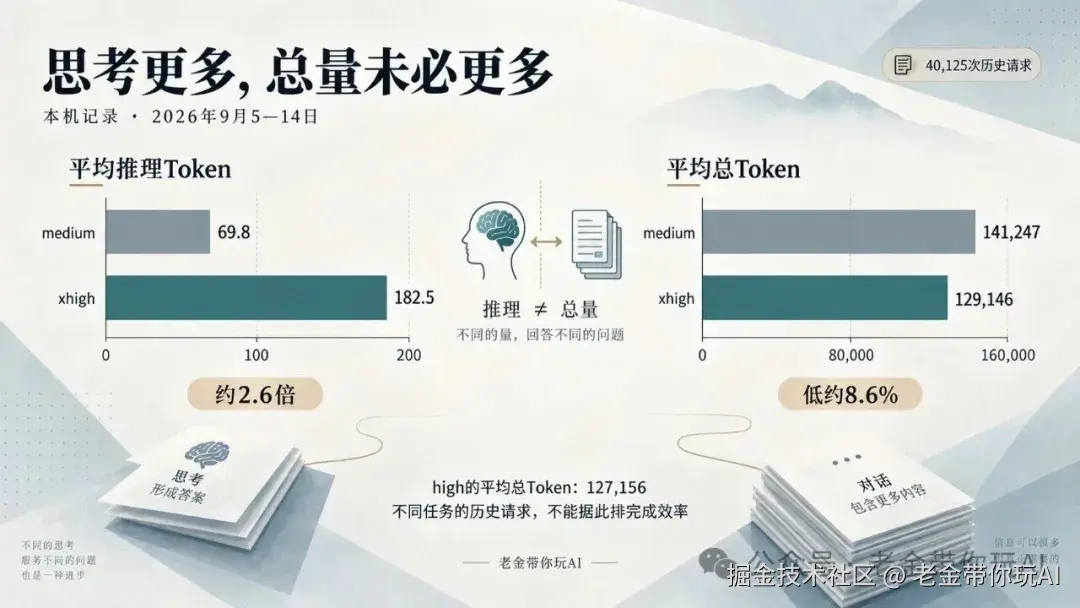 所以,这批数据能提醒我思考更多,不等于总Token更多。
不过High和Xhigh的话,体感上差不多,所以我选了推理更厉害点的Xhigh,原因就是下面这个,我想少一轮返工,这样更能节省时间。
最近推进我的俩小项目,量化应用和多媒体发布助手时,我最不愿意看到的,是翻来覆去的检查同一件事。
9月12日,我在对话里直接说过:\ 我发现多媒体在测相同的东西 测了好几遍了
每次我都要重新交代,它重新读文件、改代码、跑检查,已经走过的路再走一遍。
我发现模型多次处理任务说明、历史对话、代码和工具结果。
xhigh是它更容易先把问题和已有进展理清,再往下做。背后的机制是多花一点思考,换掉后面几轮返工,总投入就有机会下降。
老金给你画个图,让你理解起来容易点儿。 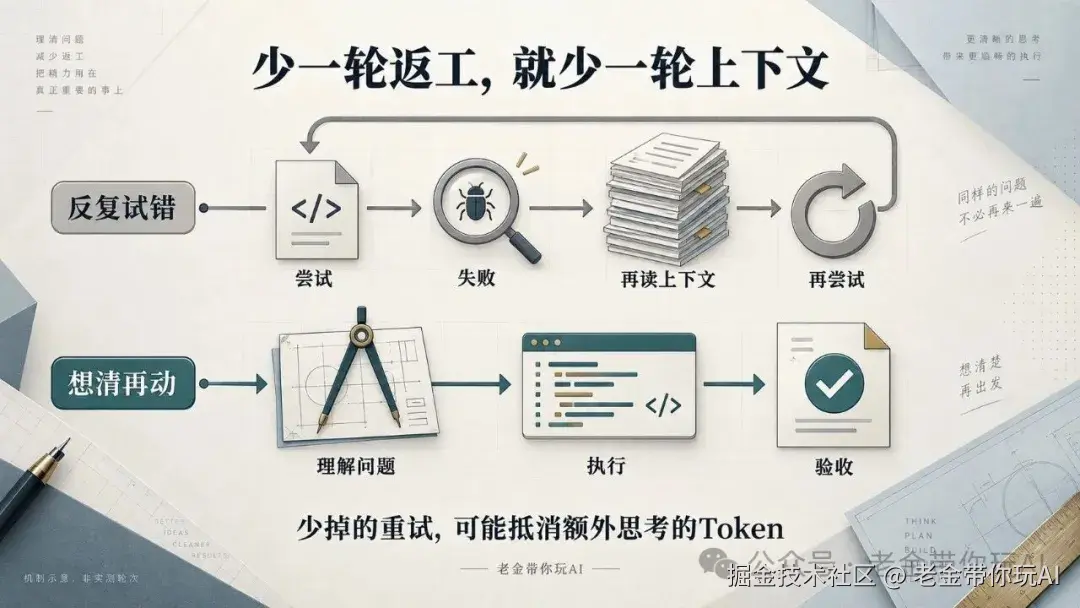 一个看着很小的改动,也可能牵着前面的状态、约束和几轮历史修改。
对我来说,值得比较的是同一件事做到验收时,究竟花了多少。
ARC Prize公布的Astra结果,提供了一组更直接的对照。在ARC-AGI-3的Standard harness下,high得分54.8%,整套评测费用40,705美元。xhigh得分59.3%,费用37,317美元。
得分提高4.5个百分点,费用反而降低约8.3%。
ARC Prize解释,更高的推理投入让模型用更少动作完成任务,减少了模型调用和总Token。它测的是陌生交互环境,不能直接当成我的软件项目结果。 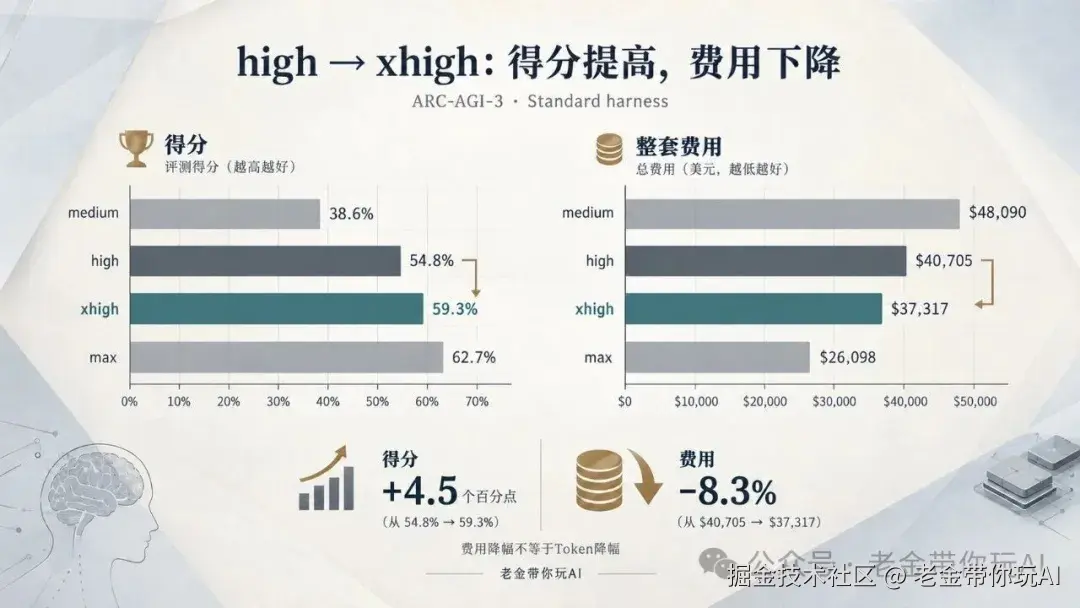 同一组结果里,max得分62.7%,费用26,098美元,表现还更好,这里和我的Max体感差不多,我不选它原因是不知道它怎么推理的。。。做的是快是好,但是缓存命中低,导致费用咣咣消耗。
所以我更愿意试xhigh,也更明确自己该盯什么:多出来的思考,有没有让后面的动作变少、结果更完整。
OpenAI的文档还说明过,推理Token计入输出,屏幕上只看到几句回复,不代表只消耗了那几句话。
算总账的时候,输入加输出才是总Token。 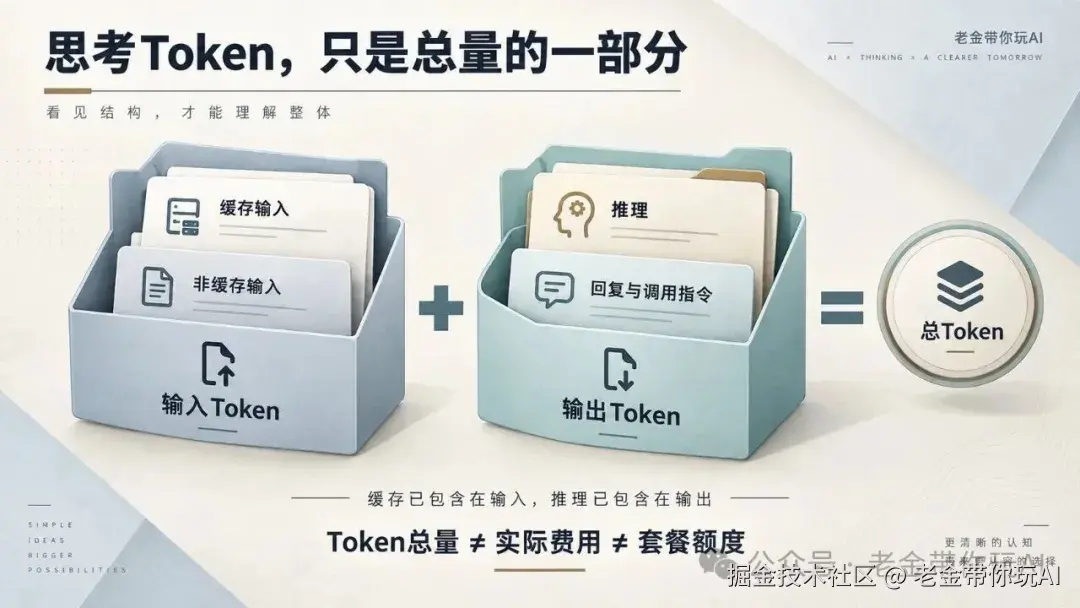 如果一个任务跨了几轮、换过档位、调用了子代理,就把这些调用一起算进去。
只看最后成功的一轮,会漏掉真正贵的部分。
所以现在我乐意开xhigh。它的价值要落在少返工、能完成上。
第一次多想一会儿,我可以接受,一直在回复,事情却还停在昨天,我就得重新检查它的路线。
不过这也不意味着低档位做不好事,在我的记录里,low档位处理过一些有用的小问题。
对,你要注意这个小字,它代表的是简单,比如单文件修改,或者一个文章的修改等等,一旦涉及跨文件,跨项目,多工具使用等等,它就不够看了。
如果你也遇到同一件事反复来回,可以先选一个正在返工的任务,在下一轮把完成标准和现有记录一起交给它。下面这段是我会用的接续要求:
先核对这次任务的完成标准。列出已经完成且有证据的部分、仍未解决的问题,以及最近一轮新增的证据。已通过且未受本次改动影响的部分,复用现有结果。同一种失败反复出现时,先检查原来的判断,再说明下一步验证能排除什么原因。接着完成剩余工作,最后更新原有任务记录,让下一轮能直接接着做。
这段要求要配上真实文件、日志或已有验证结果。
它应该产出能追溯的进展记录,并继续处理剩下的缺口。 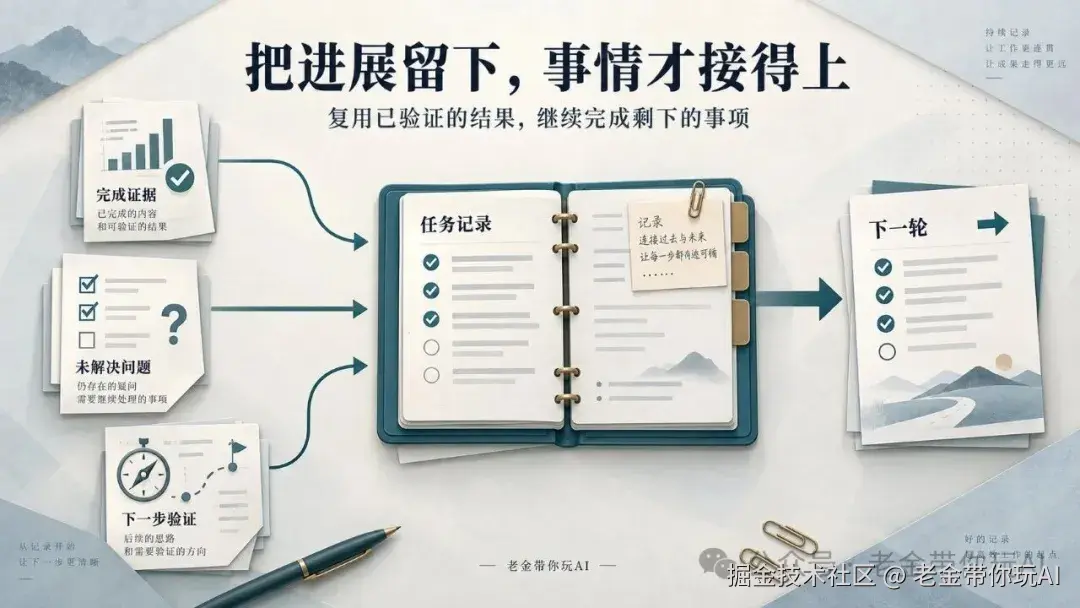
写在最后
翻这四万多次请求,最初是想算清楚Token,看看为什么6消耗这么高,找个低消耗。
翻到后来,我反而更在意,自己在这些请求之间,被叫回来了多少次。
它重新读上下文,我也得跟着重新想一遍,这个项目做到哪儿了,上次为什么这么改,哪些地方已经确认过。好不容易把这些事装回脑子,刚才手头的另一件事又断了。
它重跑的是任务,我重新搭进去的是注意力。
这部分消耗,用量页面里看不到。可实际做事的人都知道,同一个问题回来找你第三遍的时候,光是重新打开那个窗口,就已经有点累了。
所以,我愿意让它在前面多想一会儿。比起立刻开始干活,我更在意这轮结束以后,能不能真的把一段工作放下。
再往下想,AI能同时干的活儿越来越多,我也很容易顺手再开几个任务。做产品的窗口、写文章的窗口、改课程的窗口,一排铺开,确实挺有生产力的样子。
可省下来的时间,要是全用来盯着更多窗口,我大概只是给自己换了一个更忙的工位。
能多做几件事很好,做完之后,能少惦记几件事,也很重要。
该我做的判断,我来做,已经交代清楚的那部分,我希望它能接着继续推进。
下一次任务跑起来,我想放心离开屏幕一会儿。
至于那一会儿拿来干什么,到时候再说。
谢谢你读我的文章。
如果觉得不错,随手点个赞、在看、转发三连吧🙂
如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章。
开源知识库地址(实时更新交流群):