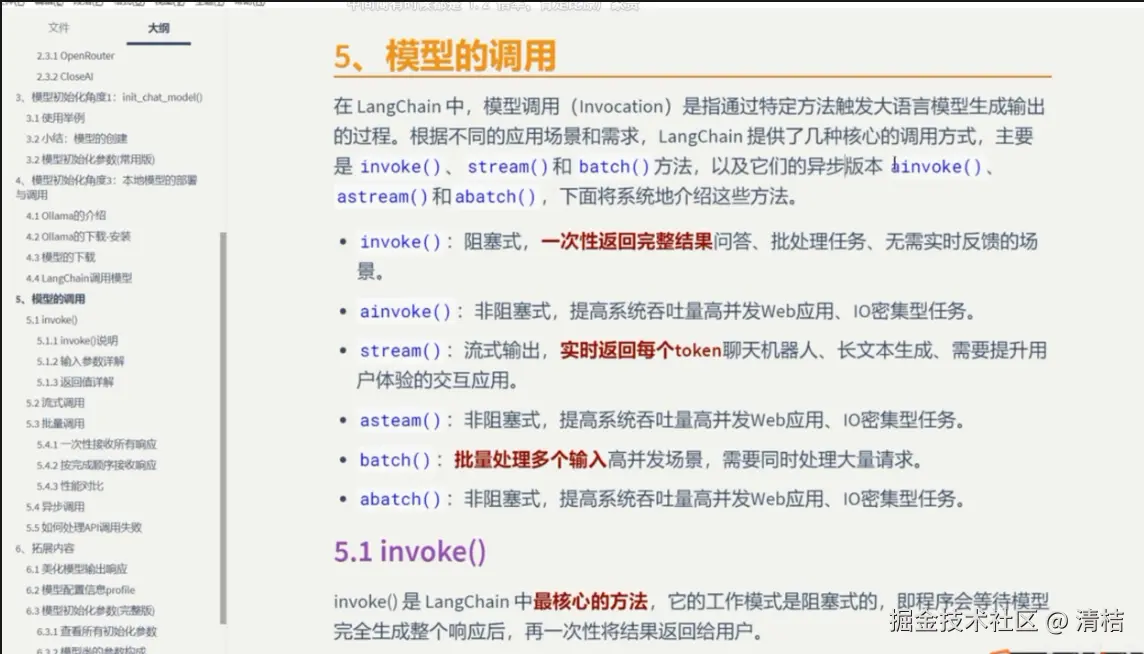
加了a是异步
1.invoke(),阻塞式的,一次性返回完整结构,中间等待一段时间,过程中无法操作
举例 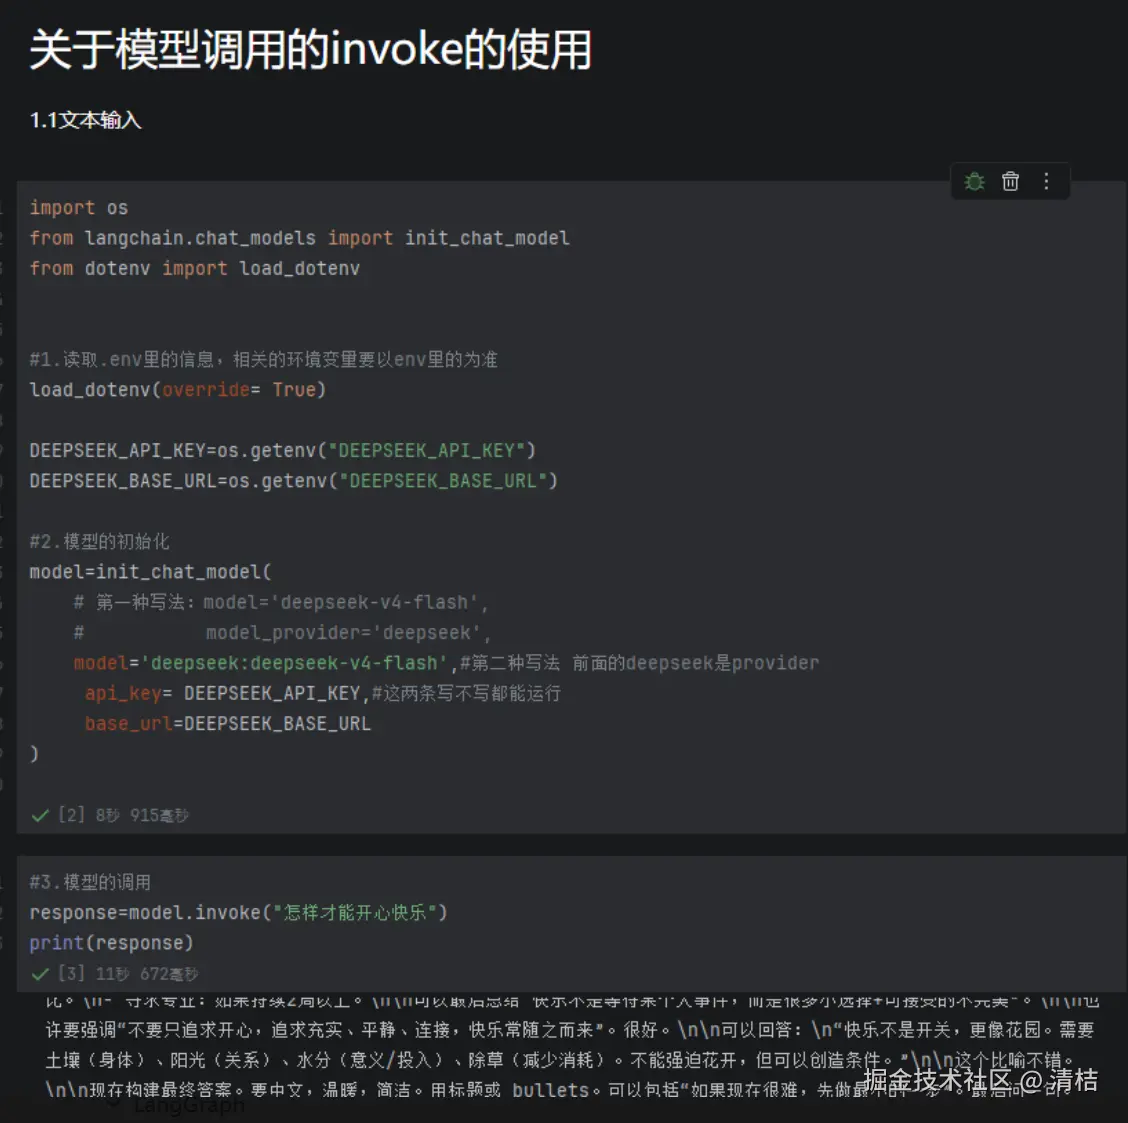
给模型添加记忆功能
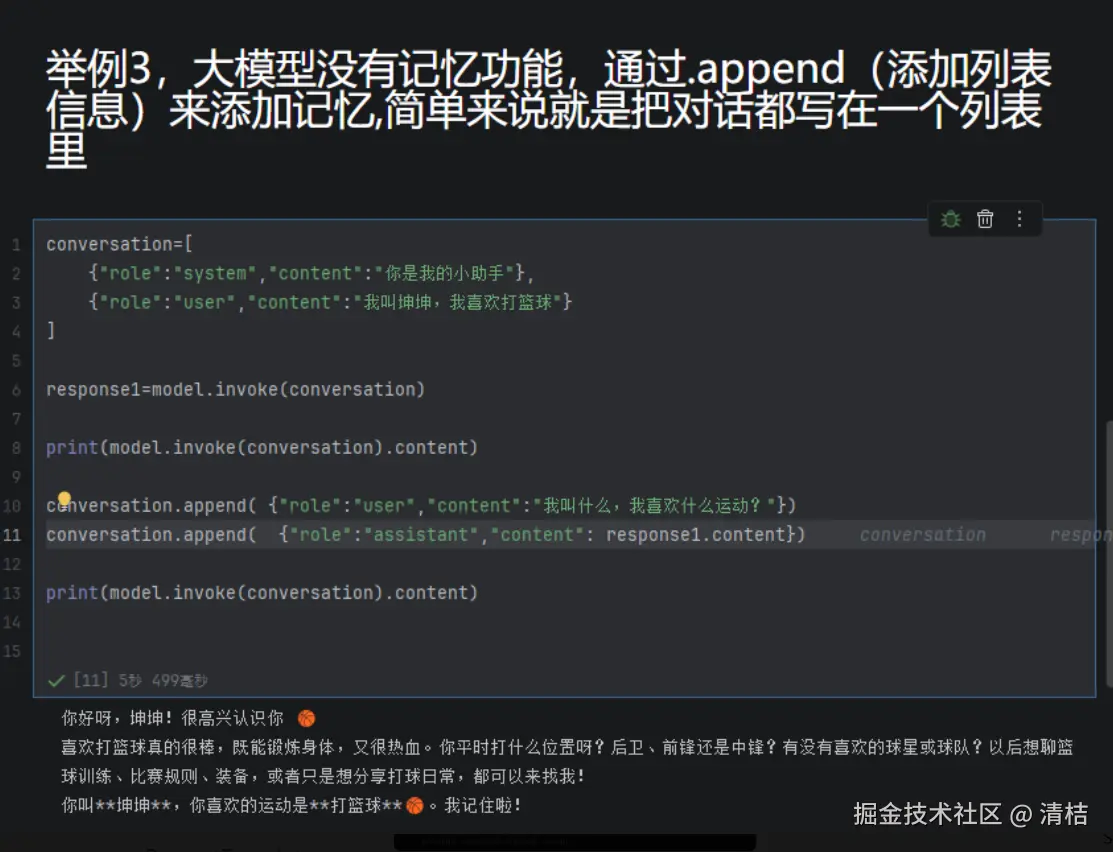
注意:
-
append()一次只能追加1 个元素 -
"response1.content"(带双引号):字符串字面量 ,文本就叫response1.content,不会读取变量的值,不可取 -
response1.content(不带引号):访问变量的属性,拿到模型真实返回的内容
消息对象列表(字典列表vs对象列表)
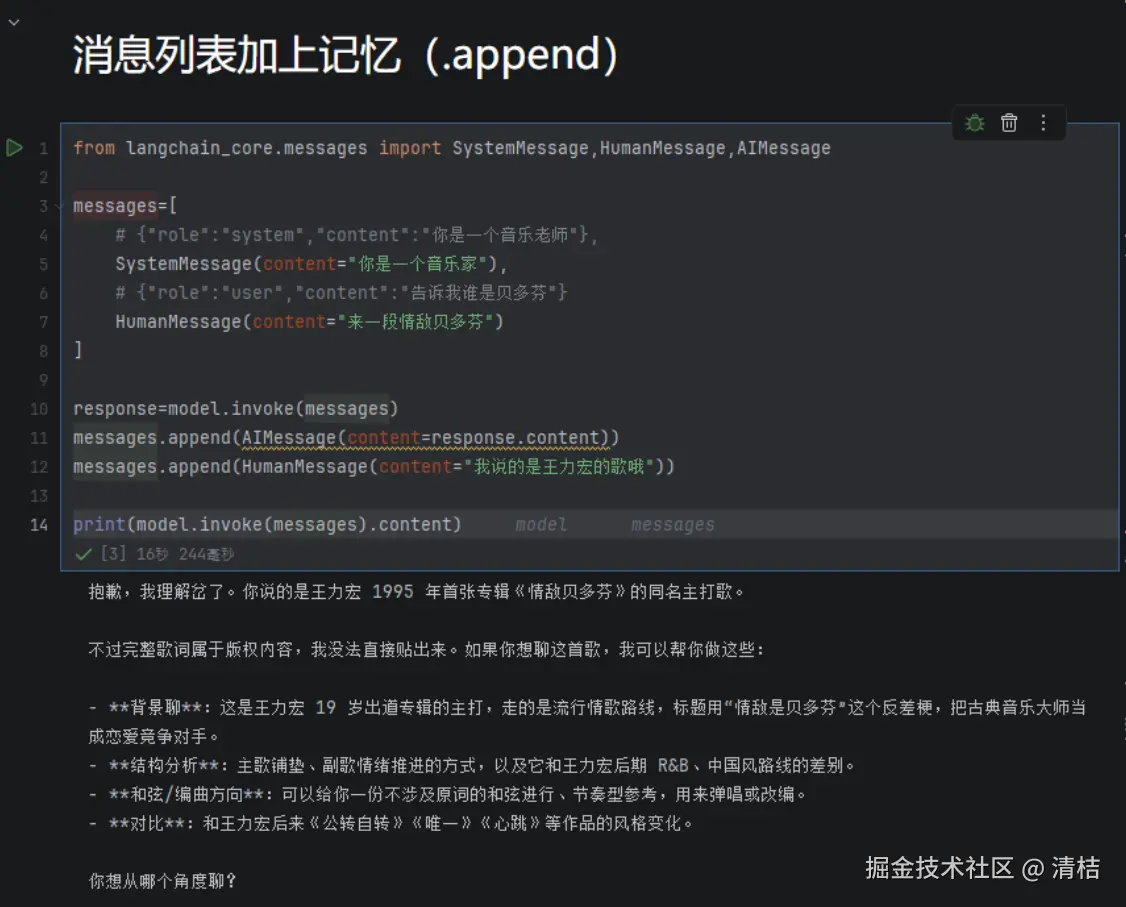
注意:
消息列表必须交替出现 Human ↔ AI ,不能两个 Human 挨在一起,也不能两个 AI 挨在一起: ✅ 合法顺序: SystemMessage → HumanMessage → AIMessage → HumanMessage → AIMessage
LangChain 两种对话格式对比
格式A:字典列表(原生OpenAI格式) 格式B:LangChain消息对象列表(SystemMessage/HumanMessage/AIMessage)
| 对比项 | 字典列表 [{"role":"system", "content":"xxx"}] |
LangChain消息对象列表 [SystemMessage(), HumanMessage(), AIMessage()] |
|---|---|---|
| 底层本质 | Python字典,纯基础数据结构 | LangChain定义的类实例对象 |
| 可读性&上手难度 | ✅ 简单,贴合OpenRouter/OpenAI原生API文档,新手一看就懂 | ⚠️ 需要额外导入类,初学要记3种消息类,门槛稍高 |
| 兼容性 | ✅ 可以直接传给OpenAI、OpenRouter原生API调用 ❌ 不能直接丢给LangChain的model.invoke(),langchain会内部自动转一次,部分场景会有兼容坑 |
✅ 原生适配LangChain全生态 :model.invoke、Chain、Agent、LangGraph、各类Memory记忆组件 ❌ 不能直接发给原始OpenAI接口,LangChain底层自动转字典 |
| 消息类型扩展 | 只支持 system/user/assistant 三种基础role |
除基础三类,额外支持工具消息ToolMessage等,做Agent、函数调用必备 |
| 取内容写法 | msg["content"],字典取值 |
msg.content,对象属性取值 |
| 错误排查 | 打印出来就是普通json字典,一眼看清role和content | 打印对象会附带额外langchain内部属性,内容看起来比较杂乱 |
| 多模态/复杂内容 | 手动构造content数组(图片、多段文本)比较麻烦 | 原生支持多模态,内置content_blocks,图文消息更方便 |
| 序列化(保存对话) | ✅ 直接json.dumps保存,非常方便 | ❌ 对象不能直接json序列化,需要langchain提供的工具转成字典才能持久化 |
字典列表(原生dict)优点
- 最贴近OpenRouter、OpenAI官方API,网上大部分API教程都是这个格式,没有学习额外类的成本
- 打印出来干净,
print之后直接看到role和文本,调试简单 - 存数据库、写入文件时,可以直接json序列化,不需要额外转换
字典列表缺点
- LangChain高级组件不识别字典:后面用到ConversationBufferMemory、LangGraph、Agent工具调用时,必须手动把字典转成LangChain消息对象,写额外转换代码
- 没有类型校验,role写错别字(比如写成
userr),Python不会报错,只会等调用API才返回失败,坑藏得深 - 做工具调用、多模态图文消息,手动写嵌套字典很繁琐
LangChain消息对象(System/Human/AIMessage)优点
- LangChain生态原生适配 ,后续写链式调用、智能Agent、LangGraph对话流程,只能用这套消息对象,不用来回做格式转换
- 自带类型校验:比如
HumanMessage不允许写错role,参数不对直接抛异常,提前发现bug(你之前遇到的ValidationError就是它的类型校验) - 原生支持工具调用、图片多模态消息,做复杂大模型应用更顺手
- LangChain内置记忆组件(Memory)输出的内容,本身就是消息对象列表,可以直接塞进invoke
LangChain消息对象缺点
- 新手要额外import、记忆3个消息类,入门门槛高一点
- 消息对象不能直接用
json.dumps保存对话记录,需要调用.model_dump()转字典才能序列化 - print打印消息对象时,会附带一堆langchain内部属性,调试查看内容不如字典直观
给你的选型建议
✅ 如果你只是简单调用OpenRouter,做基础对话、测试、简单记忆:优先字典列表 ,简单好调试,不容易踩坑。 ✅ 如果你后面打算学习LangChain的Chain、Agent、LangGraph、工具调用:直接用消息对象列表,后面不用重构代码。
互相转换代码(备用,非常实用)
ini
from langchain_core.messages import SystemMessage,HumanMessage,AIMessage
# 对象列表 转 字典列表
msg_objs = [SystemMessage(content="你是音乐家"),HumanMessage(content="你好")]
dict_list = [msg.model_dump() for msg in msg_objs]
print(dict_list)

# 字典列表 转 LangChain消息对象
from langchain_core.messages import messages_from_dict
dict_list = [{"role":"system","content":"你是音乐家"},{"role":"user","content":"你好"}]
msg_objs = messages_from_dict(dict_list)
print(msg_objs)
美化输出
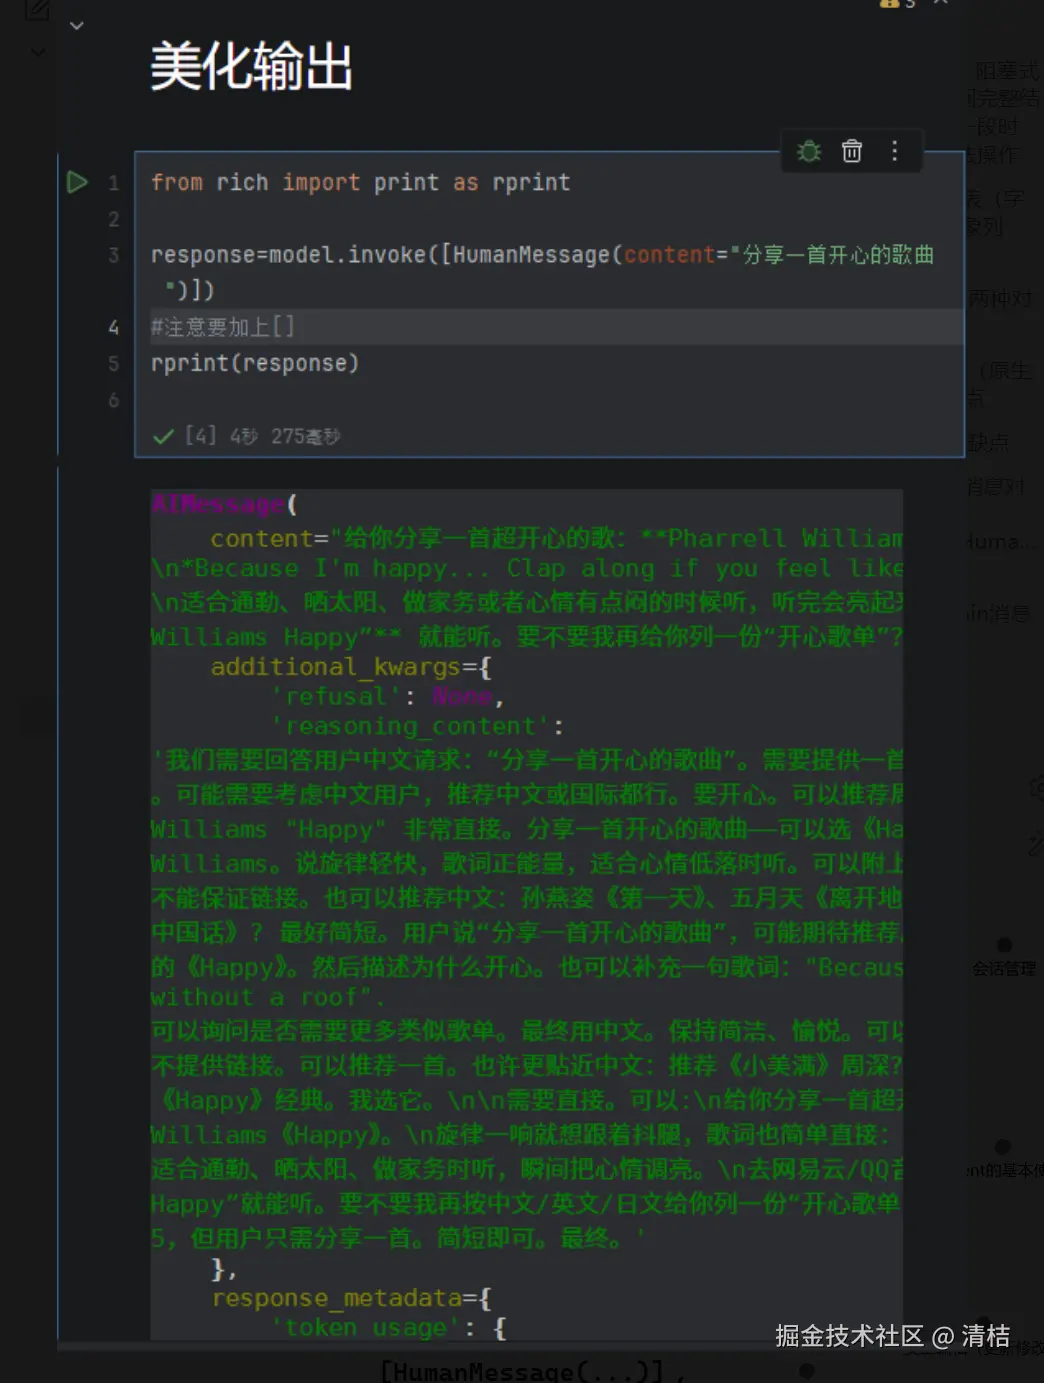 注意点: **为什么要写
[HumanMessage(...)],加方括号[]
这是 LangChain 的规范: model.invoke() 这个方法,接收的参数类型是「消息列表(list)」,不是单个消息对象。
ini
# ✅ 正确:[] 代表列表,里面放消息对象
model.invoke([HumanMessage(content="分享一首开心的歌")])

# ❌ 错误:直接传单个对象,没有列表
model.invoke(HumanMessage(content="分享一首开心的歌"))
AIMessage对象里面的信息
1.content:是模型生成的最终文本答案
2.additional_kwargs:大模型返回时,除了核心回答文本 content 之外,附带返回的所有额外信息,全部塞在这个字典里。 2.1 refusal:模型是否拒绝回答,None表示同意回答
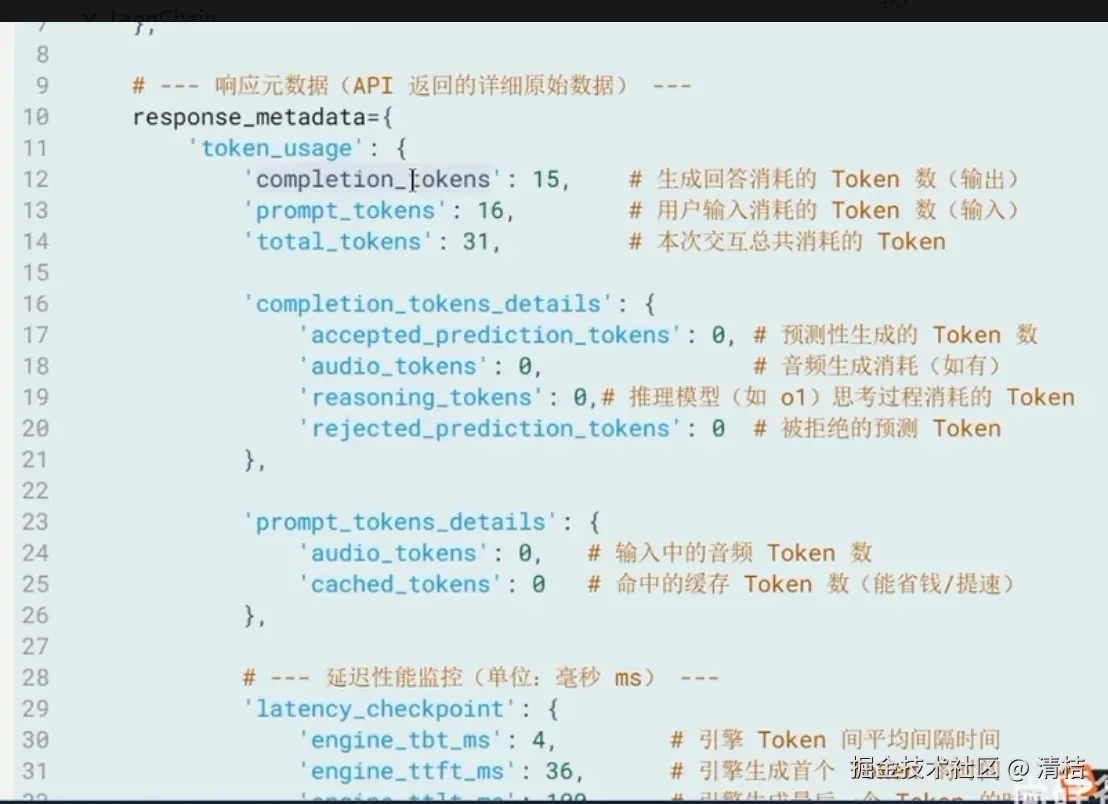
3.response_metadata:响应元数据
!\[Pasted image 20260912143112.png]
找相关信息去AIMessage去找 !\[Pasted image 20260912143645.png]
4.id:langchain内部标识
5.tool_calls:根据调用信息
6.usage_metadata:统一消耗元数据,token消耗信息
!\[Pasted image 20260912142943.png]
2.stream(),流式输出
!\[Pasted image 20260912143922.png]
!\[Pasted image 20260912150245.png] 注意: 1.在print里面要加end=""(意思就是打印结束不换行)不然就会自动换行,默认end="\n"
2.为什么 stream 要用 for 循环? 一句话:model.stream() 返回的是迭代器,迭代器就要用 for 循环逐个拿数据。
!\[Pasted image 20260912150433.png]
补充:什么是迭代器(Iterator)
迭代器:一个可以逐个产出元素的对象,遵循「惰性获取」规则------要一个,才生成一个,不会一次性把全部数据加载到内存。
在 Python 里,只要对象实现了 __iter__() 和 __next__() 方法,它就是迭代器。 model.stream() 返回的就是迭代器。
✅ 迭代器三大核心特点
1. 惰性求值(最重要!)
不会提前把所有数据准备好。 只有你调用 next()(for循环底层自动调用)的时候,它才去生成/拉取下一个元素。
对应你的 stream 场景: 不会一次性把模型全部回答拿回来。你每 next() 一次,代码就等待大模型返回下一小块 chunk。
好处:长文本不会一下子占满内存;可以做到实时流式输出。
对比列表(list):
ini
my_list = ["稻", "香", "七", "里", "香"]
# 列表创建的时候,所有元素已经全部放在内存里了
迭代器:
ini
# stream迭代器,一开始内存里什么文字都没有
stream_iter = model.stream([HumanMessage("推荐歌曲")])
# 只有每次 next(stream_iter),才去网络拿下一个chunk
2. 只能单向遍历,一次性消费,用完就空
迭代器只能从头往后取,不能回头,不能重复遍历 。一旦全部取完,迭代器就耗尽了,再取就报 StopIteration。
示例:
ini
stream_iter = model.stream([HumanMessage("推荐歌曲")])
# 第一轮for:把迭代器里面所有chunk全部取完
for chunk in stream_iter:
    print(chunk.content, end="")

# 第二轮for:迭代器已经空了,什么都打印不出来!
for chunk in stream_iter:
    print(chunk.content, end="")
列表没有这个限制,列表可以反复循环很多次。
3. 不支持下标索引,不能随机访问
不能像列表一样用 stream_iter[0]、stream_iter[1] 获取第几个元素。 迭代器只能:一个接着一个按顺序拿,想拿到第3个,必须先取出第1、第2个。
🧪 手动演示迭代器底层(不用for循环)
for 循环本质就是自动调用 next(),捕获 StopIteration 异常。
python
# 创建迭代器
my_iter = iter(["稻", "香"])

# 手动取下一个元素
print(next(my_iter)) # 输出 稻
print(next(my_iter)) # 输出 香

# 再取,没有元素了,抛出 StopIteration
next(my_iter)StopIteration:迭代器的「结束信号」,代表没有更多元素。 for 循环会自动捕获这个异常,然后退出循环,不用你手动写 try-except。
📊 迭代器 vs 列表(对比表,方便记忆)
| 特性 | 迭代器 Iterator | 列表 List |
|---|---|---|
| 数据加载 | 惰性,要一个才生成一个 | 全部一次性加载进内存 |
| 遍历次数 | 只能遍历一次,用完就空 | 可以反复遍历无数次 |
| 随机访问 | ❌ 不支持 [下标] |
✅ 支持 list[0] |
| 内存占用 | 小,适合大数据/流式 | 数据量大时占用高 |
| 适用场景 | stream、大文件读取、无限序列 | 小数据集,需要反复读取 |
📌 回到你的 LangChain stream 场景总结
model.stream() 返回迭代器:
- 迭代器不会一次性拿到全部回答;
- for循环不断调用
next(),等待模型返回下一块AIMessageChunk; - 每拿到一块,执行打印;
- 模型生成完毕,迭代器抛出
StopIteration,for循环结束。
补充一个容易混淆的概念:可迭代对象(Iterable) vs 迭代器(Iterator)
- 列表是可迭代对象 ,不是迭代器;可以用
iter(列表)转成迭代器。- 迭代器一定是可迭代对象,可迭代对象不一定是迭代器。
要不要我写一个极简的自定义迭代器类,模拟大模型stream分片输出的效果?能一眼看懂底层原理。
!\[Pasted image 20260912152638.png]
一句话:flush=True 强制清空输出缓冲区,立刻把文字打印到屏幕,不要等攒一批再输出。
先搞懂缓冲区是什么
Python 的标准输出有一块内存,叫输出缓冲区。 默认策略:
- 打印短内容的时候,不会直接显示到屏幕,先放到缓冲区里攒着
- 等缓冲区装满 / 遇到换行符
\n/ 程序结束,才一次性全部刷到屏幕上
这是操作系统为了减少 IO 次数、提升性能做的缓存机制。
放到你的流式代码场景
arduino
print(chunk.text, end="", flush=True)end="":不自动加换行,文字连续输出(解决一字一行)flush=True:强制刷新缓冲区,拿到一个 chunk 就立刻显示在终端
如果不加 flush=True : 因为我们写了end="",没有换行符触发自动刷新,文字会暂存在缓冲区里,可能等好多个字攒在一起才一次性蹦出来,打字机效果会卡顿、延迟,不是实时的。
对比两种情况
print(chunk.text, end="")不写 flush:文字存在缓冲区,攒一堆再显示,看起来卡顿。print(chunk.text, end="", flush=True)flush=True:每 print 一次,立刻刷到屏幕,实现顺滑实时打字效果。
!\[Pasted image 20260912153103.png]
3.batch()批处理
!\[Pasted image 20260912153136.png]
batch() 一次性接收多条提问,返回一个【结果列表】 ;列表里面装着多条回答,所以要用 for 循环逐个拿。 invoke() 只发 1 条提问,返回单个 AIMessage 对象,就一个结果,直接用,不用循环。
!\[Pasted image 20260912153904.png]
batch同时跑 3 个任务,返回3 个 AIMessage 放到一个列表里。 列表里面有多个元素,想取出每一个,就需要 for 循环遍历这个列表。
总结:
| 对比项 | invoke | stream | batch |
|---|---|---|---|
| 中文名 | 一次性调用 | 流式调用 | 批量调用 |
| 请求数量 | 1 个对话请求 | 1 个对话请求 | 多个对话请求(并行) |
| 输入格式 | [消息对象](一组对话) |
[消息对象](一组对话) |
[[任务1],[任务2]...](双层列表) |
| 返回类型 | 单个 AIMessage 对象 |
迭代器(产出 AIMessageChunk 碎片) |
列表,元素是多个 AIMessage |
| 是否需要 for 循环 | ❌ 不用,直接 .content |
✅ 必须循环拿碎片 | ✅ 必须循环遍历结果列表 |
| 能否重复遍历 | --- | ❌ 迭代器只能遍历一次 | ✅ 结果列表可反复遍历 |
| 实时性 | 全部生成完一次性返回 | 边生成边返回碎片 | 全部生成完统一返回 |
| 适用场景 | 简单单轮问答、无需实时 | 打字机效果、长回答实时输出 | 批量并发处理多个独立提问 |